SW 마에스트로를 진행하며 작성하는 회고록입니다.
프로젝트를 진행하면서 MSA 구조를 한번 설계해봤다. 학습의 목표도 있고, 무엇보다 지원을 받을 때만 경험해볼 수 있는 아키텍처라고 생각했다. (혼자서 이 구조를 만들고 운영한다면 돈이...)
또한, 프로젝트에서는 사용자가 문서를 추가하면 AI가 문서를 읽고 Wiki를 구성하는 작업을 진행한다. 기존에는 이런 작업들이 순차적으로 실행되고 있었다. 문서 하나를 처리한 뒤 다음 문서를 처리하는 구조였기 때문에, 한 번에 여러 문서를 추가하면 뒤에 있는 문서들은 앞의 작업이 끝날 때까지 계속 기다려야 했다. 문서가 적을 때는 크게 문제가 되지 않았지만, 문서가 늘어날수록 대기 시간이 그대로 길어졌다. 원래도 오래 걸려 테스트도 힘든 작업을 사용자가 사용한다면 불편함을 느낄 것이 분명했다.

기능별로 나누기만 하면 안된다
그래서 처음에는 자연스럽게 이런 생각을 했다. “각각 따로 처리하면 빨라지지 않을까? 그러면 k8s로 python을 잔뜩 띄워서 병렬처리를 하면 그나마 낫지 않을까?"
그래서 하는 김에 MSA를 적용하면 서비스를 독립적으로 확장할 수 있고, 학습 경험도 쌓을 수 있으며, AI 작업도 여러 서버에서 처리할 수 있으니 좋겠다고 생각했다. 그래서 기능을 기준으로 서비스를 나누기 시작했다.
문서 관련 기능은 Document Service, Wiki 관련 기능은 Wiki Service, 사용자와 워크스페이스는 별도의 서비스, AI 작업도 따로 분리했다. 그리고 각각을 AWS와 Kubernetes 위에 어떻게 배치할지까지 그렸다. 처음 만들어놓고 봤을 때는 나름 MSA다운 구조라고 생각했다.
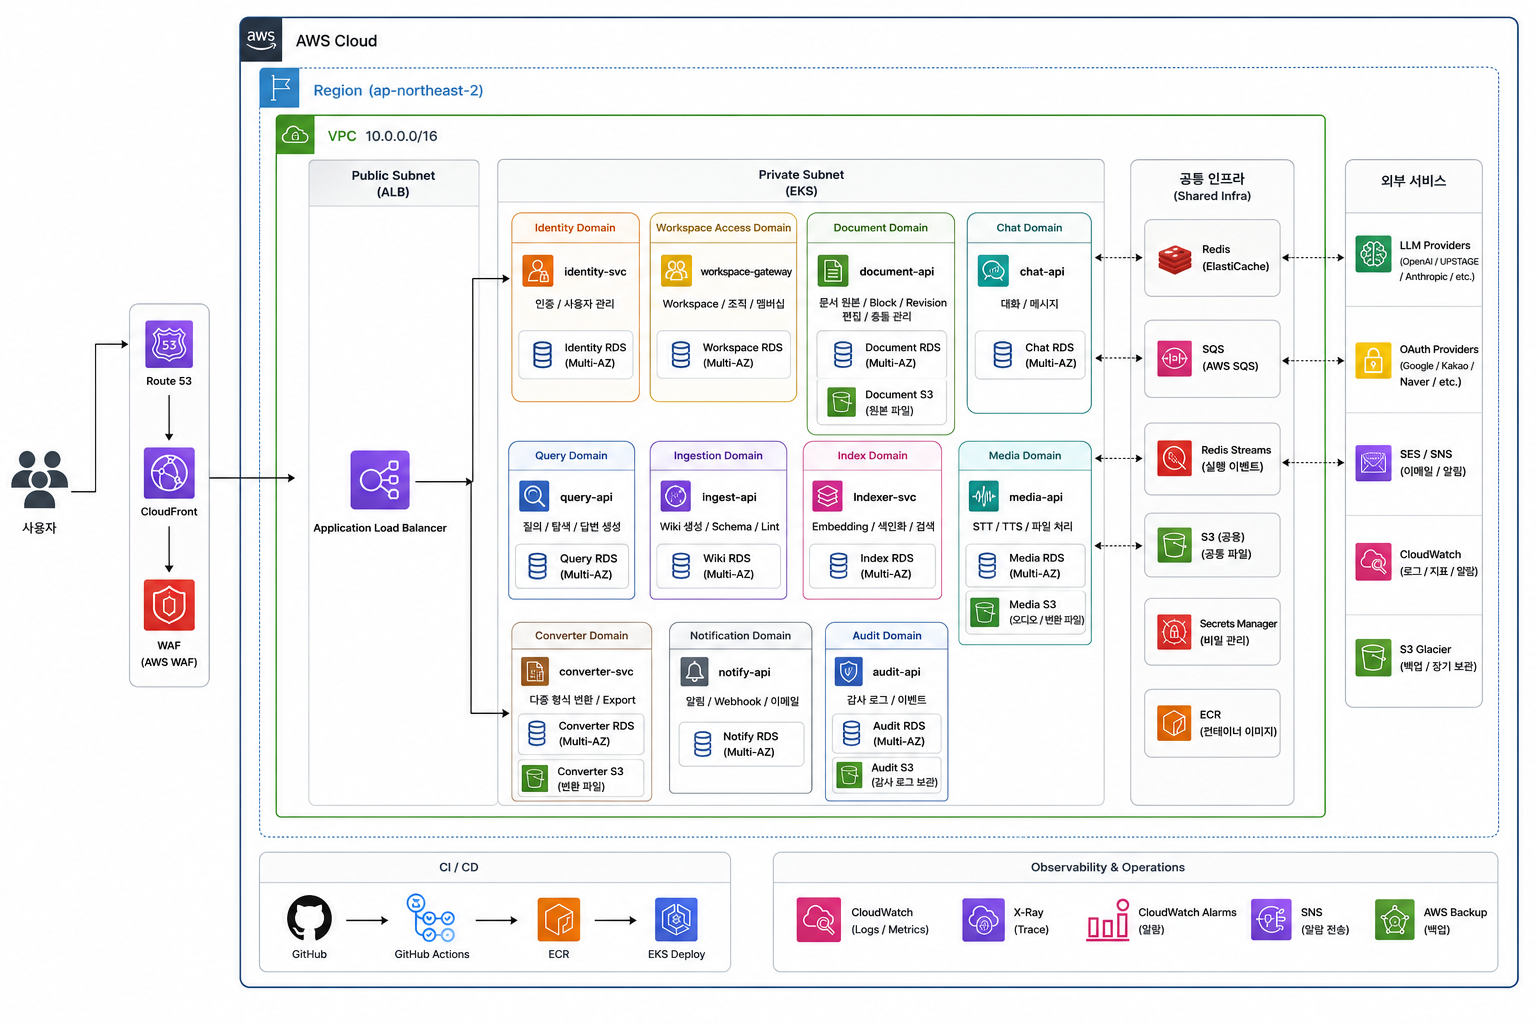
그런데 멘토링을 받으면서 생각보다 많은 문제가 보였다. 가장 먼저 들었던 피드백은 “왜 이 기준으로 서비스를 나눴는가?”였다. 나는 기능이 다르니까 서비스를 나눴다. MSA라고하면 기능을 나누어서 각각의 트래픽을 분산한다는 점이 가장 큰 메리트라고 생각했기 때문이다.
하지만... Fruition의 대부분의 기능은 워크스페이스 권한 확인을 필요로 한다. 문서를 읽을 때도, Wiki를 수정할 때도, AI 작업을 요청할 때도 사용자가 해당 워크스페이스에 접근할 수 있는지를 확인해야 한다. 기존에는 같은 애플리케이션 안에서 처리하던 일이었지만 서비스를 나누고 나니, 요청 하나를 처리하기 위해 다른 서비스를 계속 호출해야 했다. 이 부분이 걸리긴 했지만, 어쩔 수 없다고 생각했다.
또 다른 문제는 데이터베이스였다. 처음 설계에서는 서비스는 여러 개로 나눠놓고도 데이터가 누구의 책임인지 명확하지 않았다. 어떤 서비스가 어떤 테이블을 가져야 하는지, 다른 서비스가 그 데이터가 필요할 때 직접 DB를 봐도 되는지 같은 부분을 깊게 생각하지 않았다. 그래서 기능은 나누었지만, DB의 부하는 나누지 않은 구조가 되어있던 것이다. 결국 겉으로는 서비스가 분리되어 있지만 데이터에서는 여전히 서로 묶여 있는 구조가 될 수 있었다.
데이터 소유권에 대해 고민해보자
이 피드백을 받고 나서 서비스 경계를 다시 보기 시작했다. 이번에는 “이 데이터는 누가 책임져야 하지? 이 서비스가 이 데이터에 접근해야할 이유가 있을까?” 라는 질문부터 시작했다. 그래서 문서는 문서 서비스가 소유하고, Wiki 데이터는 Wiki를 만드는 ai 서비스가 소유하는 식으로 책임을 나누었다. 다른 서비스가 해당 데이터가 필요하다면 데이터베이스에 직접 접근하는 것이 아니라 데이터를 가진 서비스를 통해 접근하도록 했다.
이렇게 정리하고 나니 서비스 경계를 나눈다는 것이 기능을 기준으로 나누는게 아니라 데이터 소유권을 기준으로 경계를 먼저 나누어야한다는 점을 느꼈다.
비동기 병렬 처리의 효과는 엄청났다!
여기서 서비스가 데이터를 소유하게 만들면 그다음에는 자연스럽게 또 다른 문제가 생겼다. “그럼 서비스끼리는 어떻게 통신해야 하지? 그냥 REST API로 전부 연결하면 되지 않나?" 라고 생각했다. 하지만, 서비스가 다르니 통신에 보안이 필요했다. 그래서 팀원들과 논의한 결과, 일단은 Header에 서로를 확인할 수 있는 토큰을 하나 두어서 일종의 통행권처럼 활용하도록 하자는 결론이 나왔다.
그리고 Wiki 구성 관련 기능들은 처리하는 데 시간이 오래 걸리고, 사용자가 요청을 보낸 HTTP 연결을 계속 유지하면서 끝날 때까지 기다릴 필요도 없었다. 그래서 오래 걸리는 AI 작업은 Kafka를 통해 비동기로 전달하도록 했다. 또한, 이를 병렬 처리하는 구조로 변경했다. 얼마나 속도 차이가 날까 궁금해 로컬 Kubernetes 환경에서 동일하게 문서 3개를 처리하는 실험을 여러 번 진행했고, 실행마다 편차가 있어서 중앙값을 기준으로 비교했다. 기존 순차 처리 방식에서는 107.9초가 걸렸고, 병렬 처리 후에는 48.5초가 걸렸다. 약 55.1% 정도 처리 시간이 줄었다.
정리
MSA를 설계해보기 전에는 “기능별로 서비스를 나누는 구조” 정도로 생각했는데, 왜 MSA를 사용하고, 최근엔 쪼개둔 서비스들을 모으는 이유들이 이해가 되는 시간이였다.
실제로 나눠보려고 하니 기능보다 먼저 데이터의 책임을 생각해야 했고, 서비스를 나누면 서비스 간 통신 방식도 정해야 했다. 동기 호출이 많아지면 hop이 늘어나고, 비동기 처리를 위해 Kafka를 넣으면 또 다른 운영 비용이 생기게 된다. 권한 확인도 마찬가지다. 처음에는 권한 서비스에 요청하면 끝이라고 생각했는데, 거의 모든 요청에서 권한 서비스를 거치면 불필요한 hop이 계속 생긴다.
결국 어떤 기술 하나를 추가할 때마다 해결되는 문제와 함께 새로운 문제가 생겼다. 이번 작업을 하면서 가장 크게 배운 점은 아키텍처를 먼저 정하고 문제를 끼워 맞추면 안 된다는 것이었다.
“MSA를 경험 해보자!”에서 출발했지만, 'MSA여도 운영 비용이 얼마인지, 데이터 소유권에 대한 정책 결정을 어떻게 할지, 사용자 트래픽이 어디서 가장 많이 튀는지 등에 따라 구조가 다르겠구나!' 라는 생각이 들었다.
아마 앞으로 다시 MSA를 설계하게 된다면 예전처럼 먼저 서비스 박스부터 그리지는 않을 것 같다. 먼저 현재 시스템의 병목이 어디인지 보고, 데이터를 누가 책임질지 정하고, 정말 분리가 필요한 지점을 찾은 다음에 서비스를 나누게 될 것 같다.