A* 알고리즘
다익스트라 알고리즘을 확장하여 만들어진 경로 탐색 알고리즘
(다익스트라 : 한 정점에서 다른 모든 정점까지의 최단 거리를 구하는 알고리즘)
현실 세계에서 다익스트라를 활용하기에는 노드의 수가 너무 많아
탐색해야하는 공간과 시간 복잡도가 커진다.
또한, 실시간으로 변동되는 장애물 (교통체증) 등으로 인해
모든 노드를 반복적으로 탐색하기에 부담이 크다.
Heuristic(휴리스틱), 추정적으로 최소가 되는 지점을 우선적으로 탐색하는 방법을
A* 알고리즘 이라고 한다.
- 다익스트라 알고리즘에 휴리스틱 함수, h(n) 를 더한 형태
- 가장 가능성 있는 경로부터 탐색
- g(n) : 시작점에서 현재 노드까지의 실제 거리
- h(n) : 현재 노드에서 목표 노드까지의 예상, 추정 거리
* 실제 거리보다 크지 않아야 최단 경로를 보장 - f(n) : g(n) + h(n), 탐색 우선 순위 기준
간단한 예시로 A* 알고리즘을 알아보자.
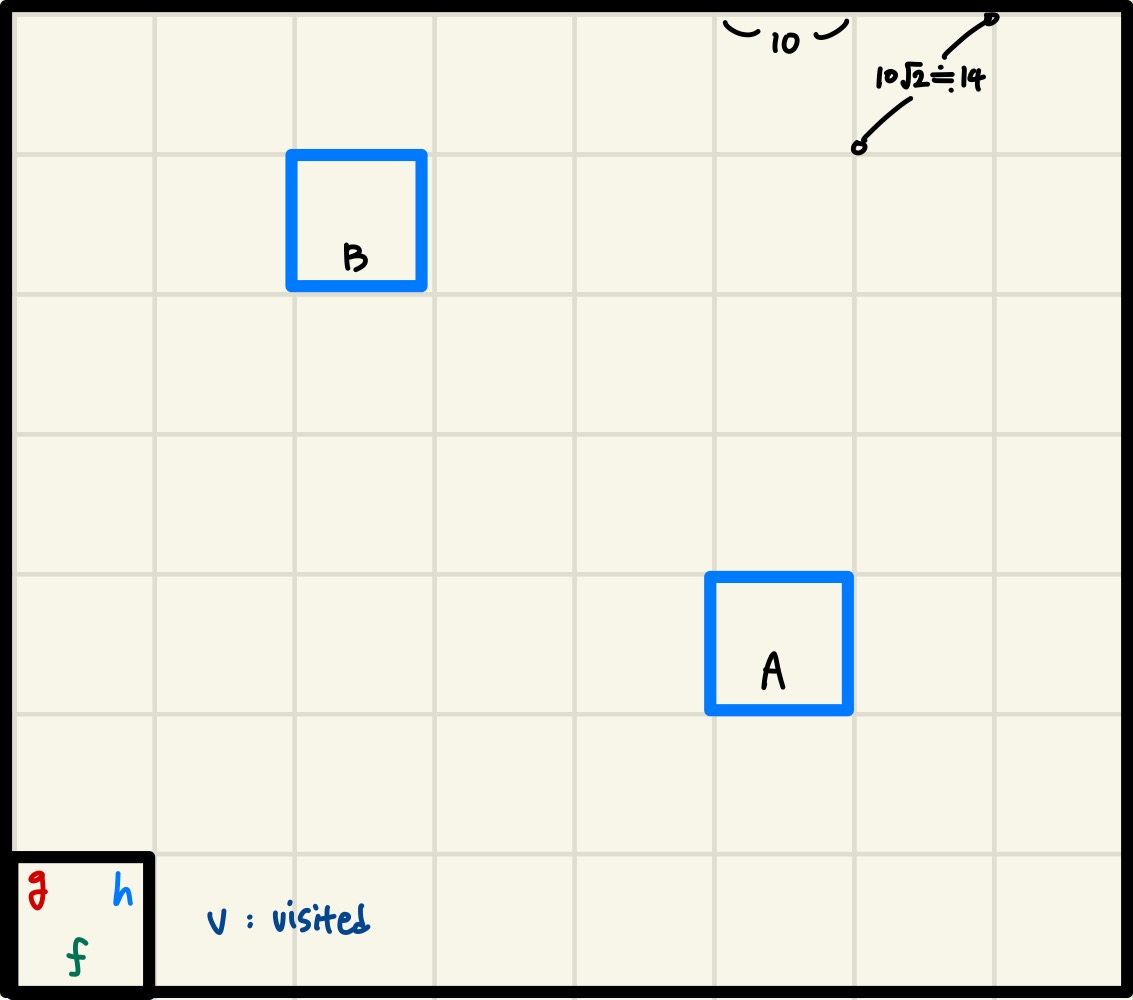
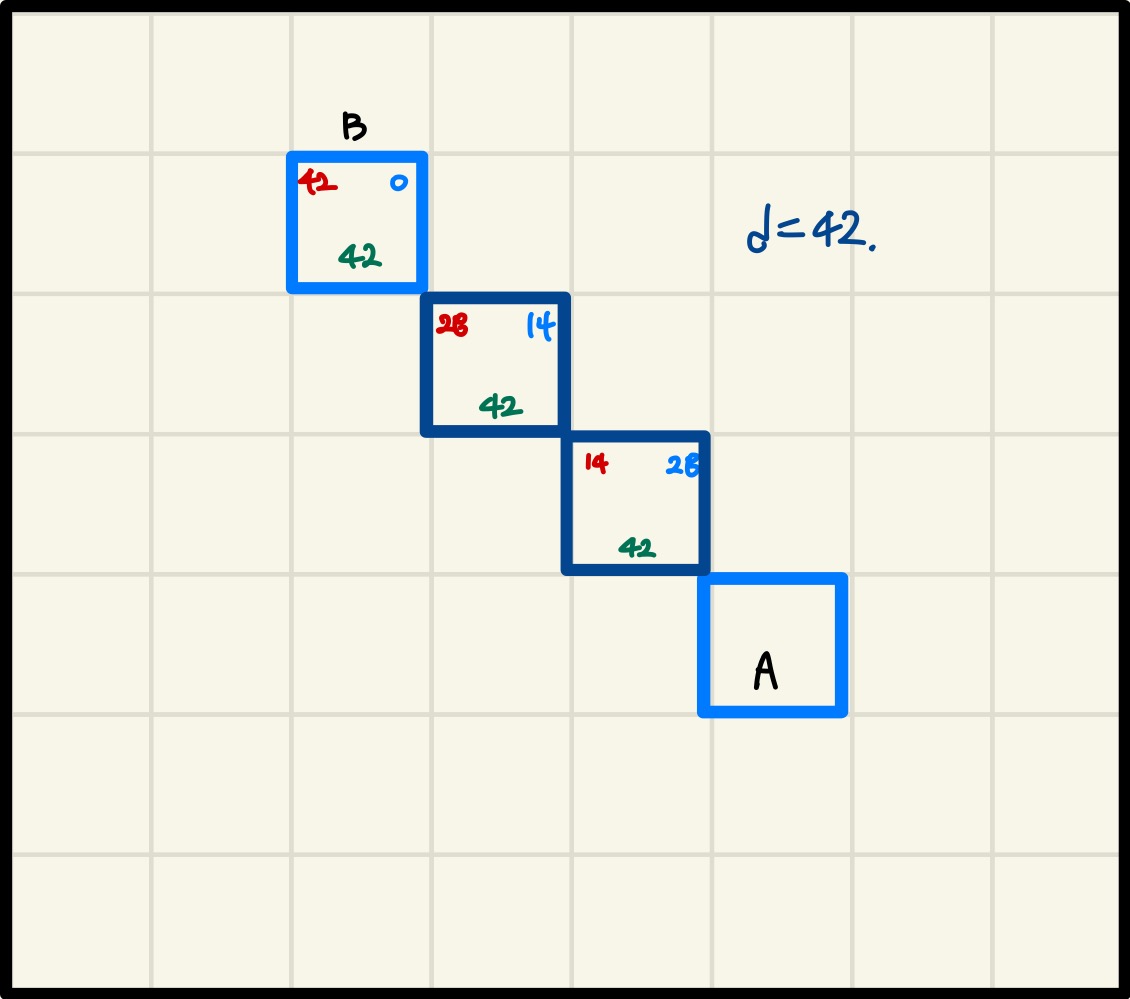
- 한 칸을 10 이라고 가정
- g(n) 은 시작점에서 현재 노드까지의 거리
- h(n) 은 현재 노드에서 목표 노드까지의 예상 거리
- f(n) 은 g(n) + h(n),
- 방문한 노드는 v 로 체크해주었다.
예시 1. 장애물이 없는 공간
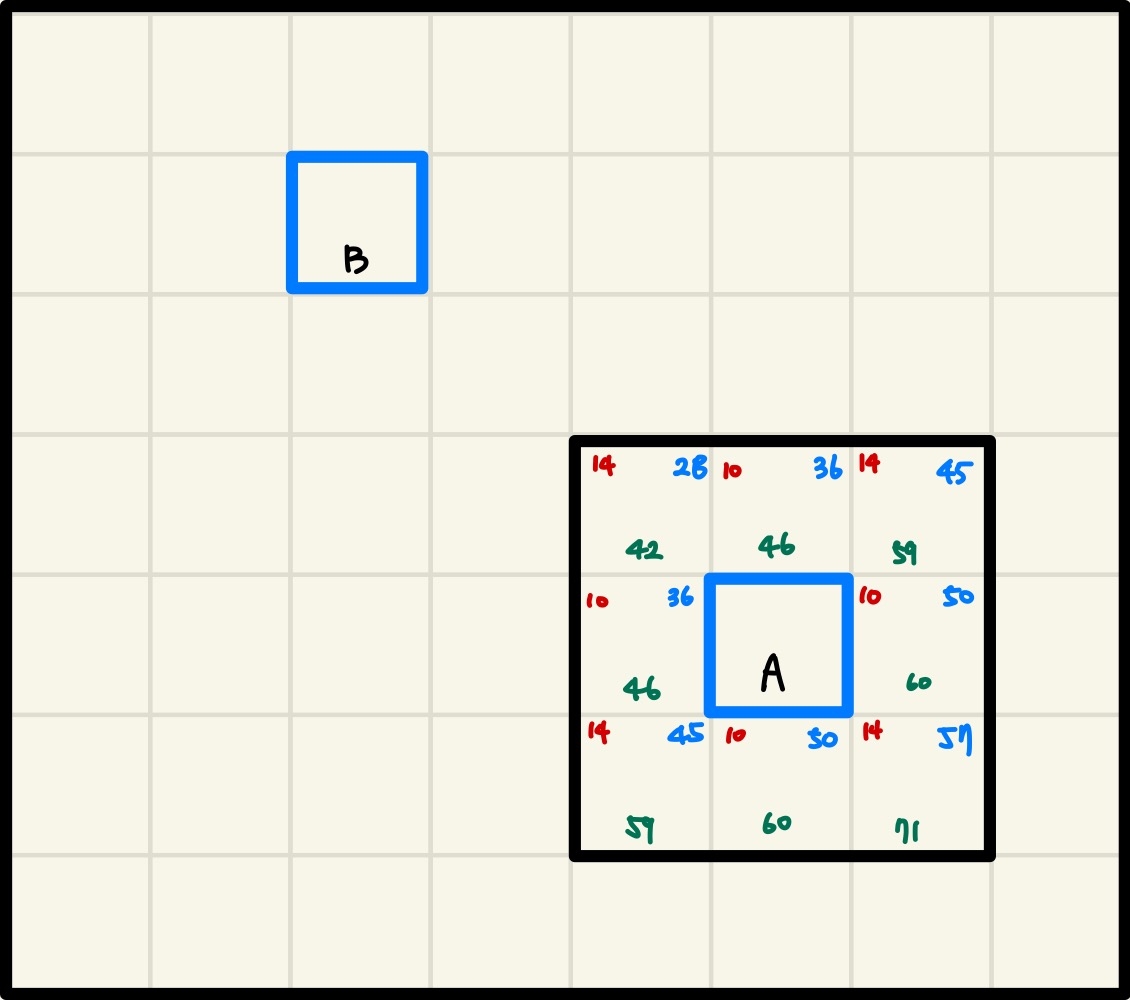
노드 A 에서 시작, 주변의 모든 노드를 방문
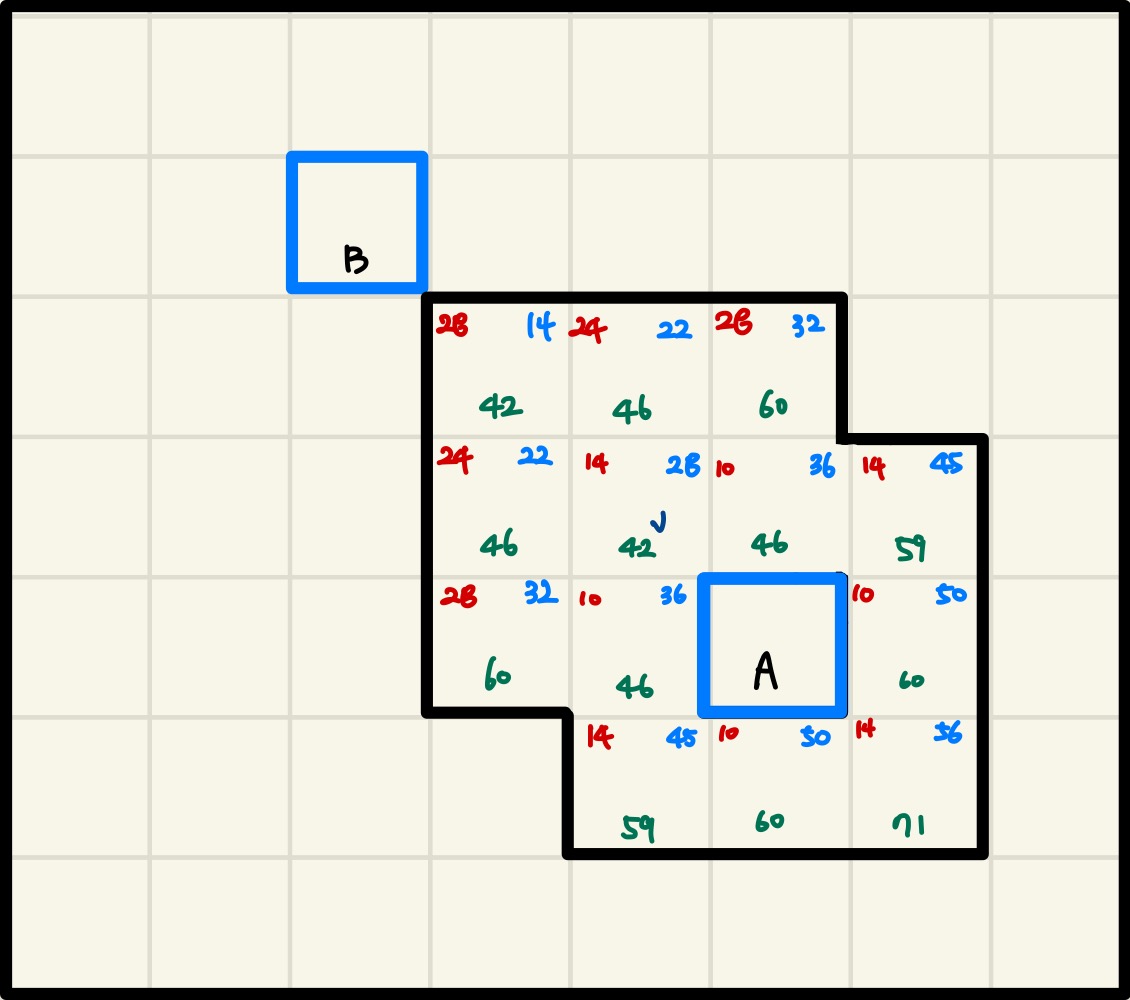
| f(n) : 42 방문 | f(n) : 42 방문 |
|---|---|
 | 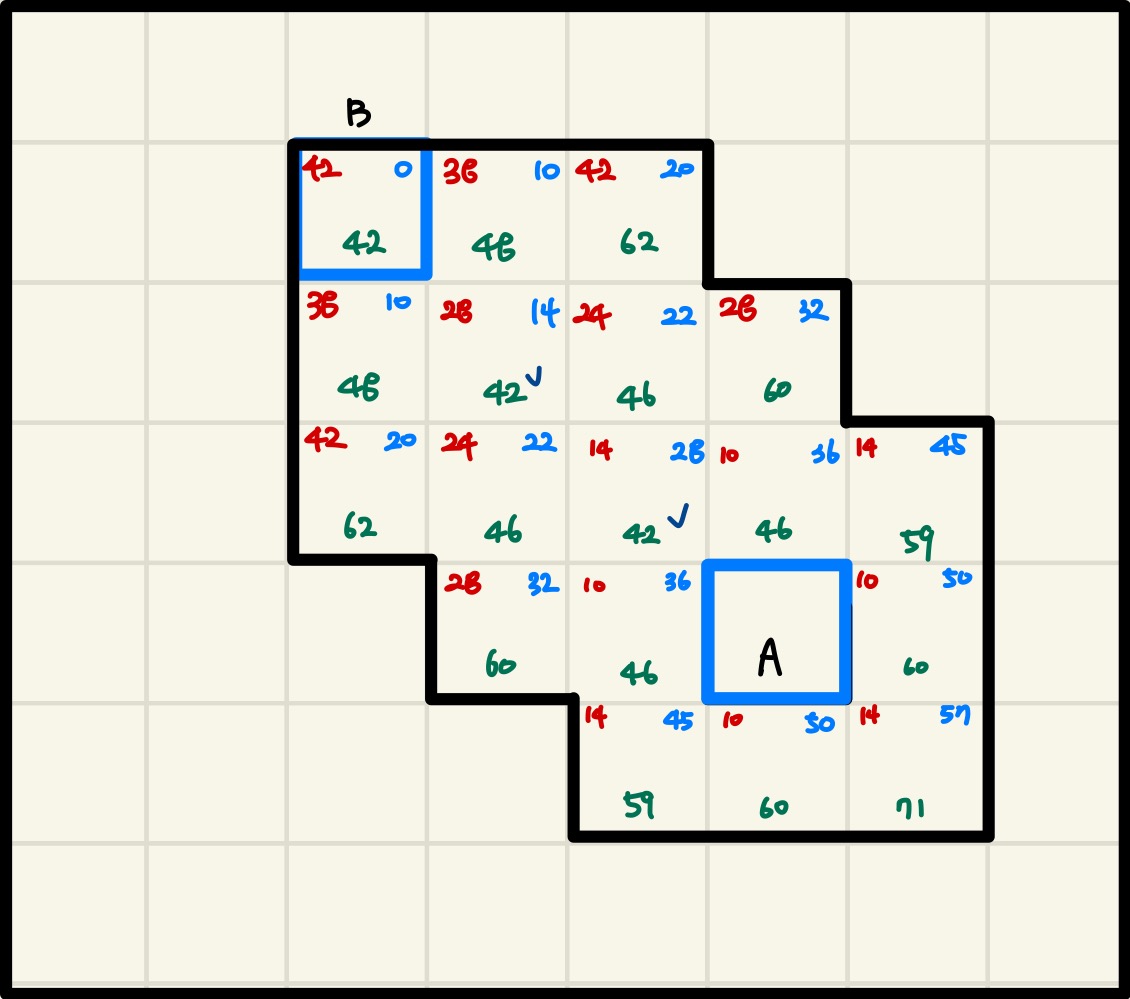 |
결과, 42 거리로 목적지에 도착
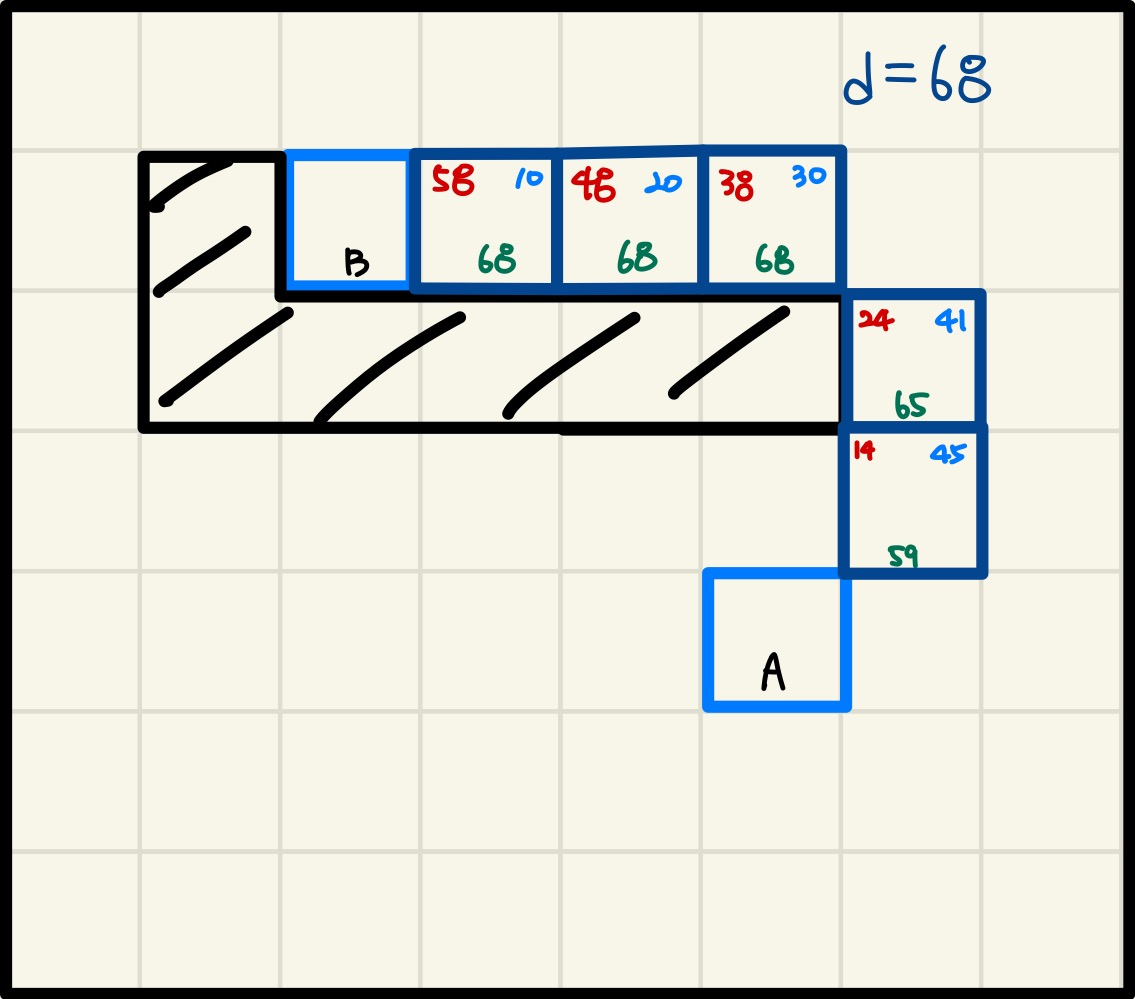
예시 2. 장애물이 있는 공간
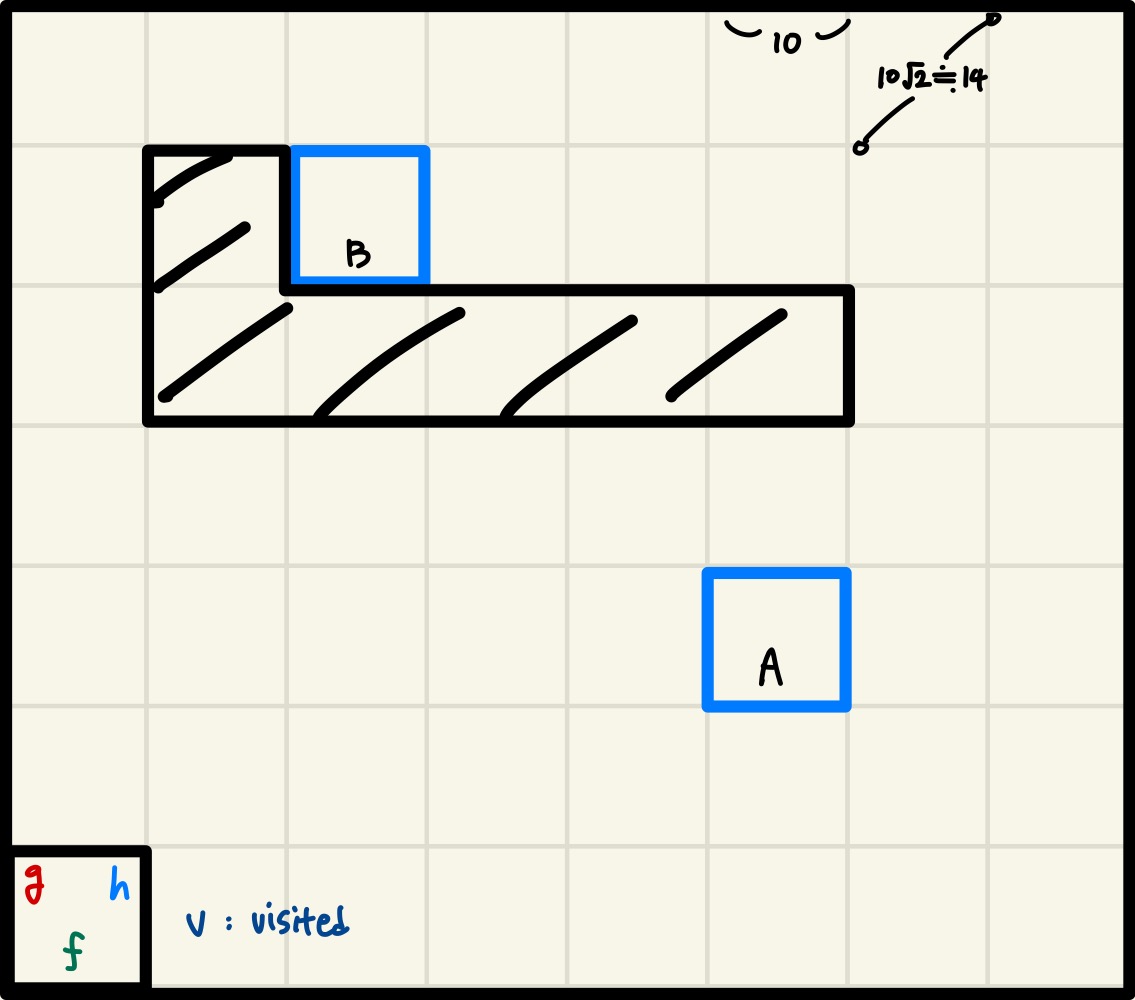
노드 A 에서 시작, 주변의 모든 노드를 방문
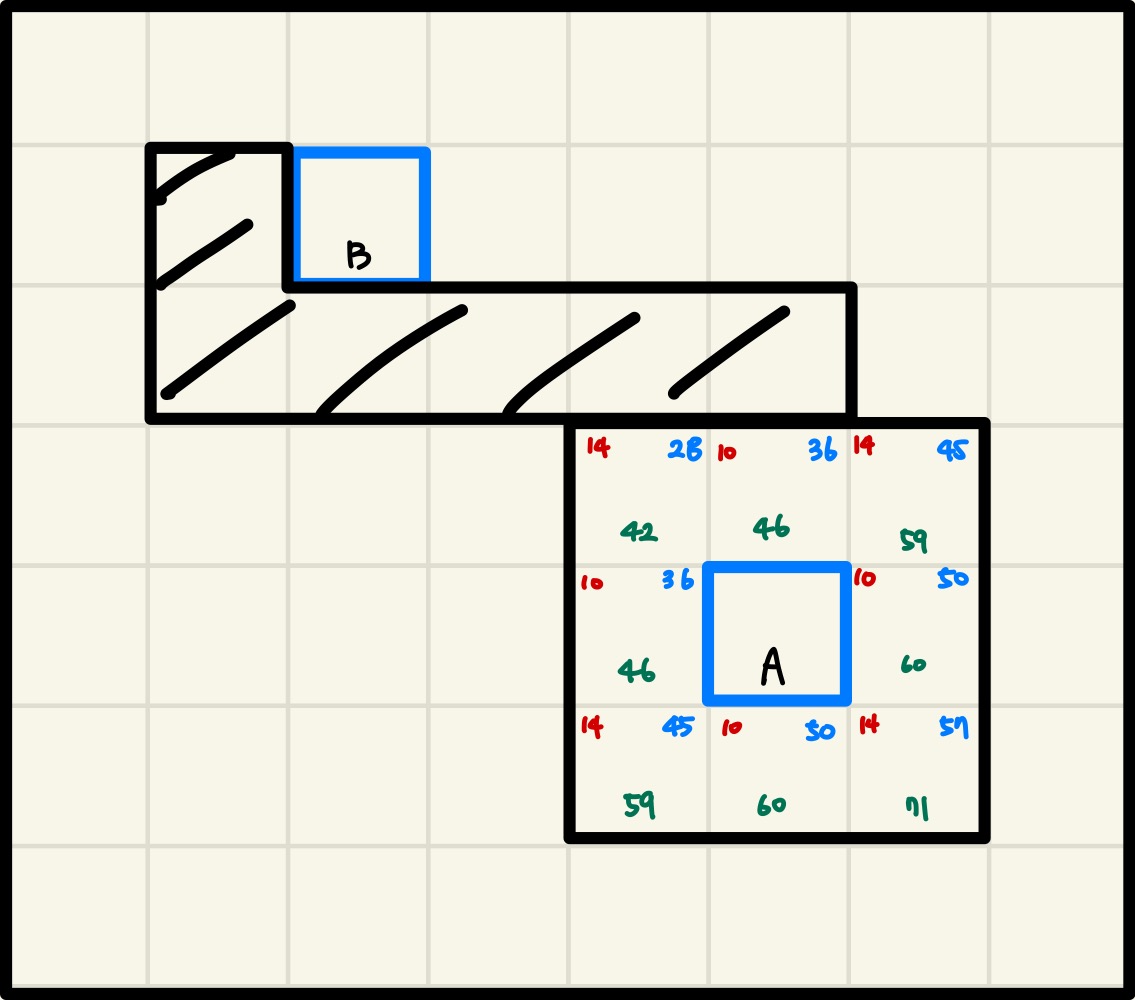
| f(n) : 42 방문 | f(n) : 46 방문 | f(n) : 54 방문 |
|---|---|---|
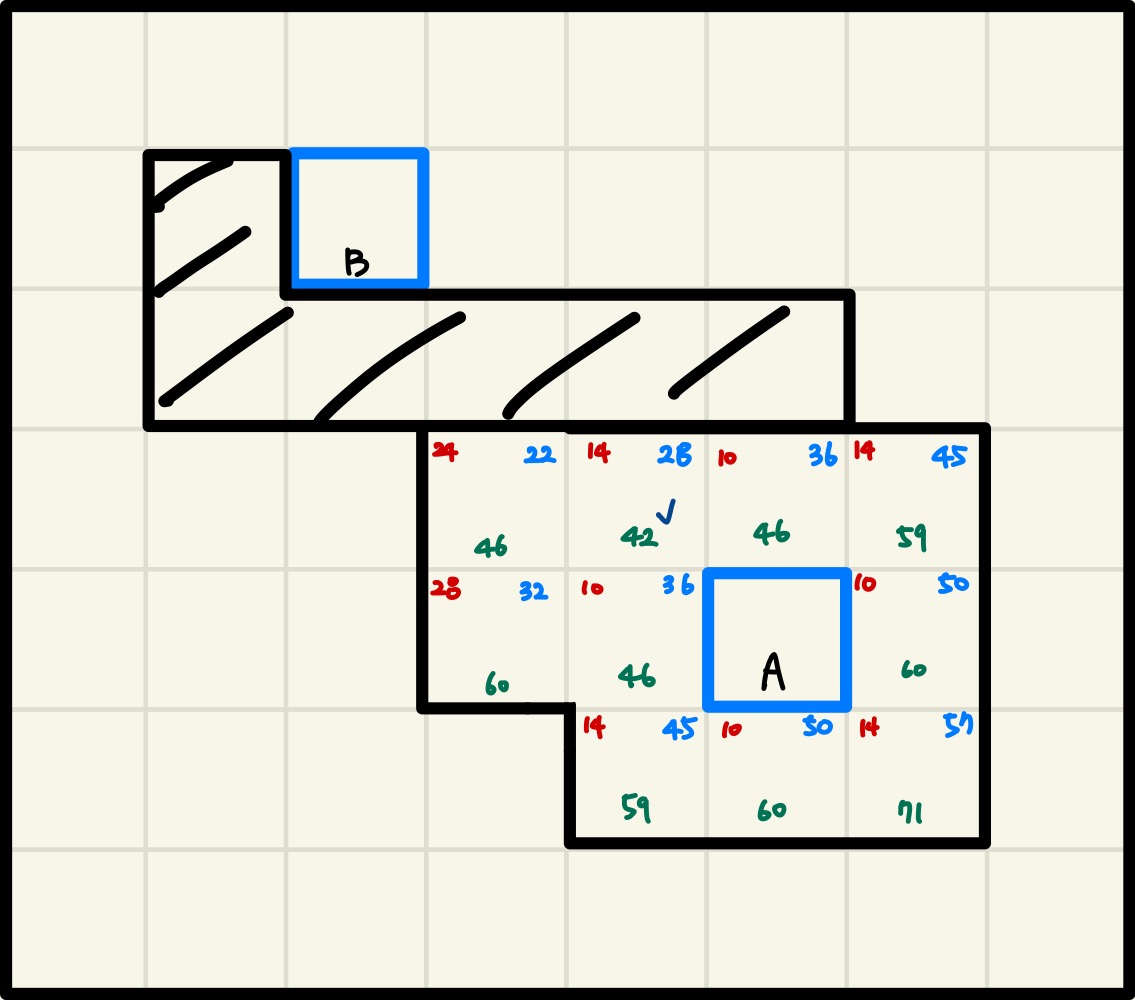 | 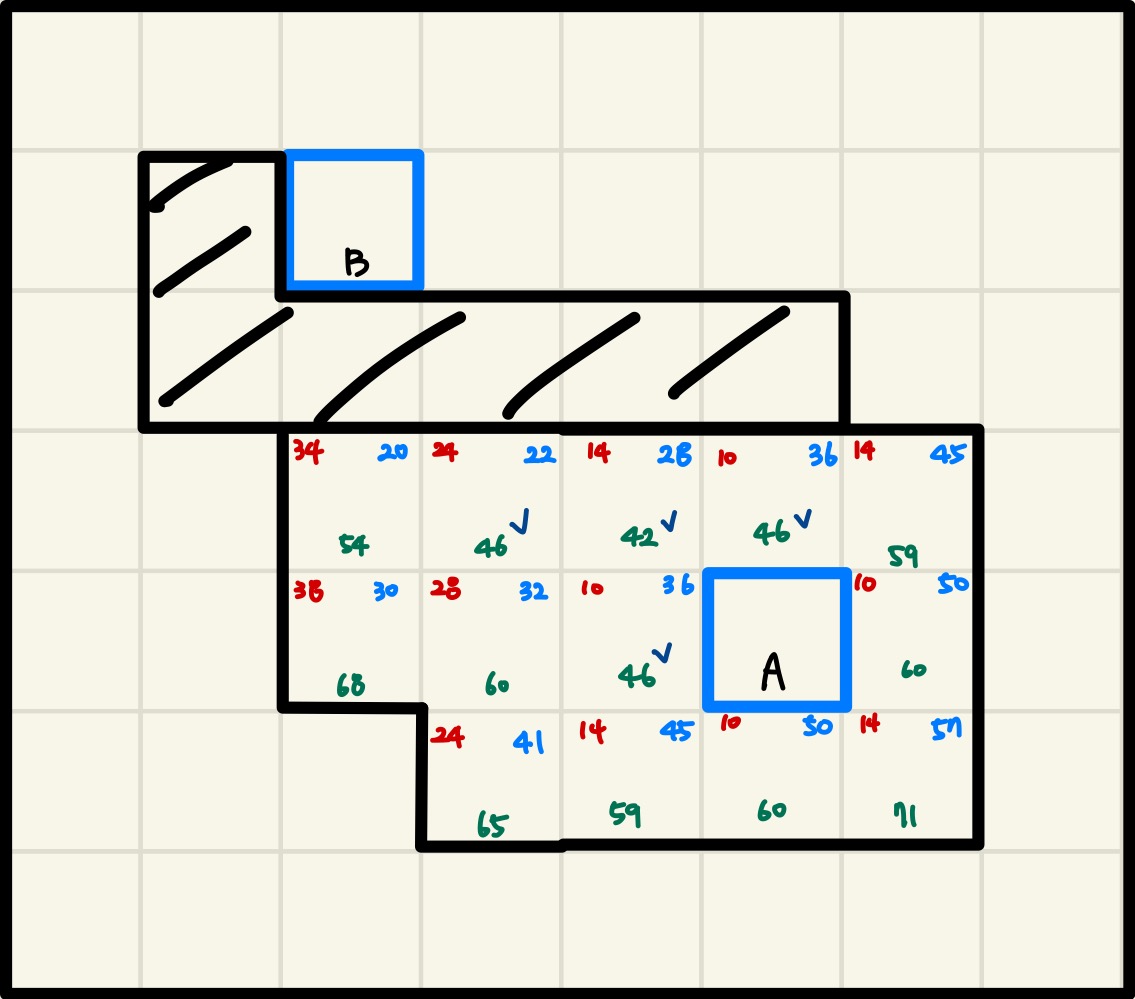 | 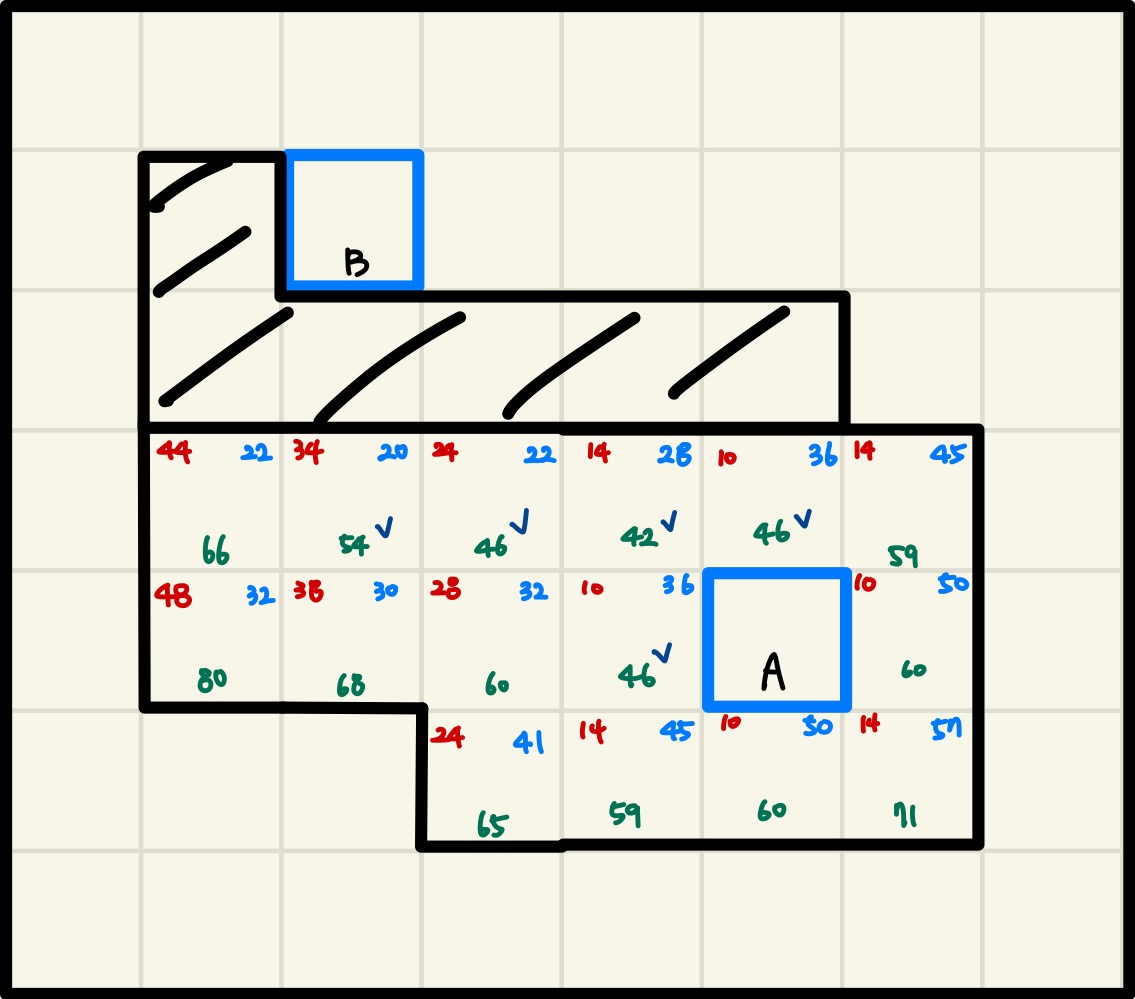 |
| f(n) : 59 방문 | f(n) : 60 방문 | f(n) : 65 |
|---|---|---|
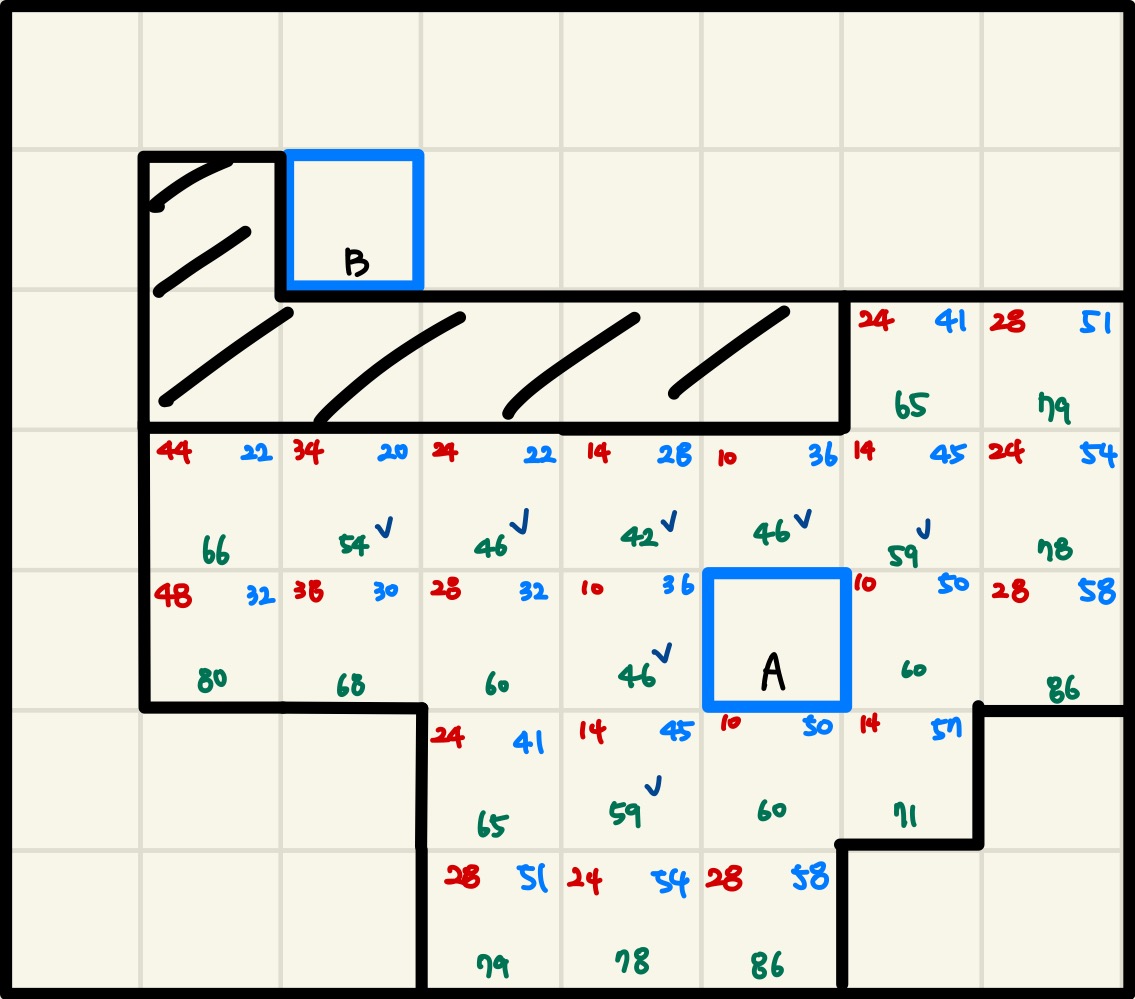 | 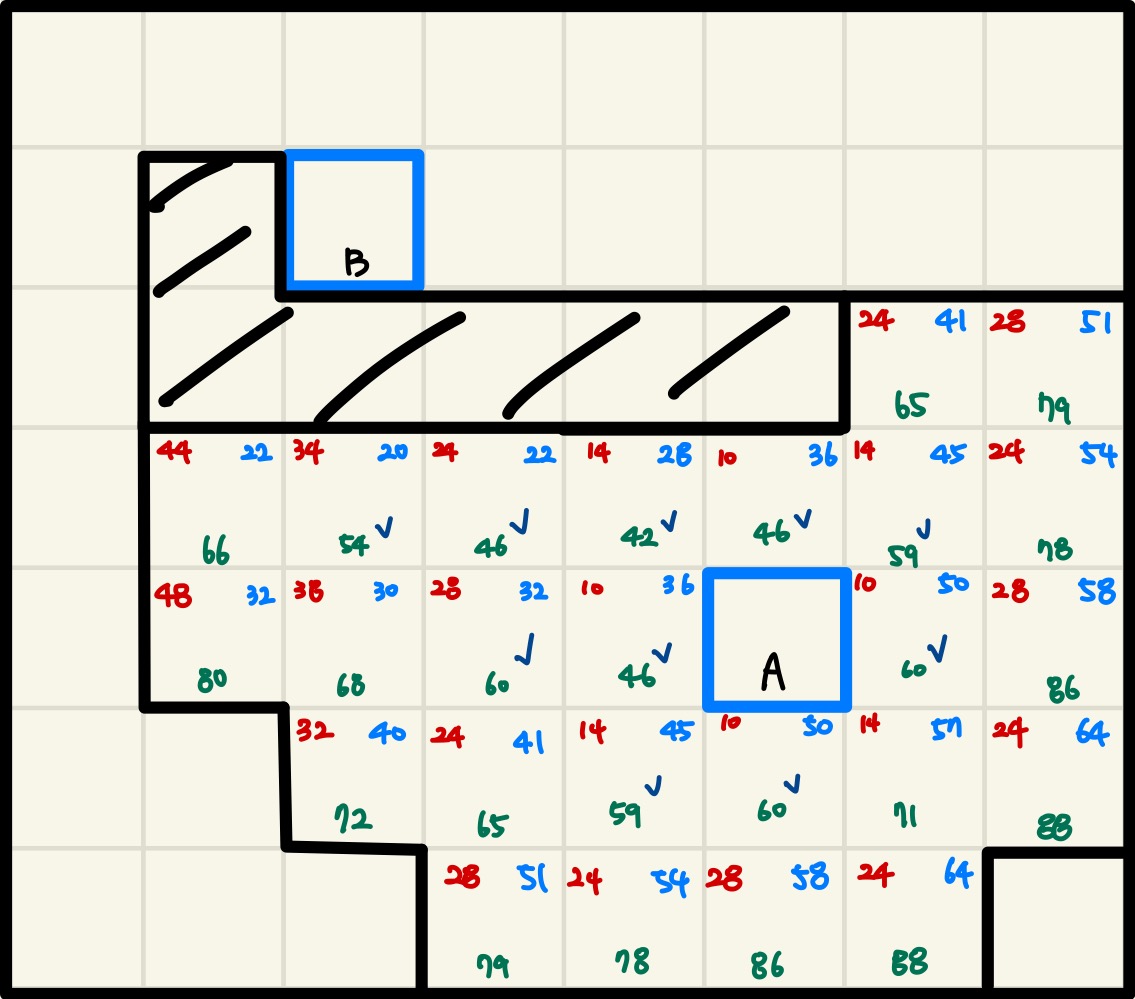 | 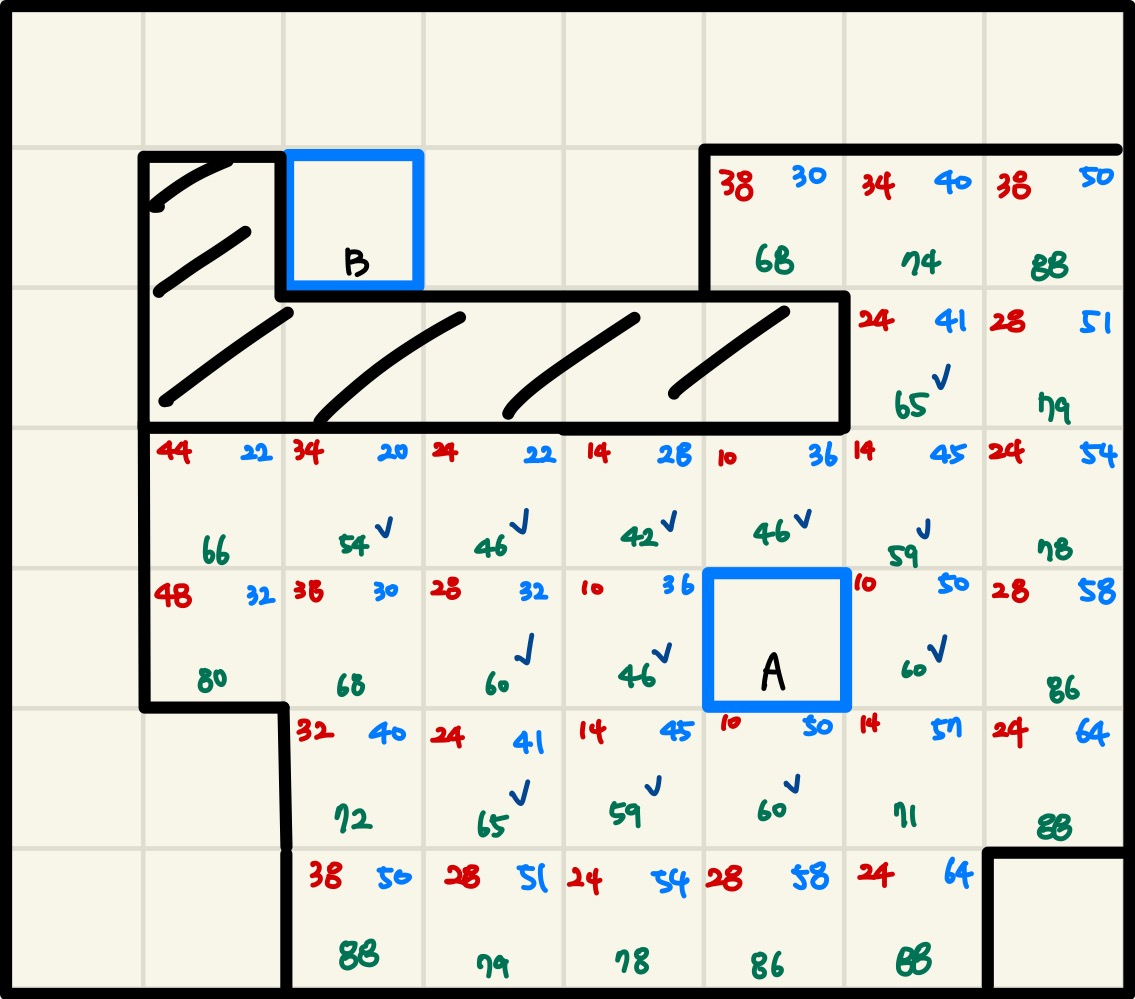 |
| f(n) : 66 방문 | f(n) : 68 방문 | f(n) : 68 방문 |
|---|---|---|
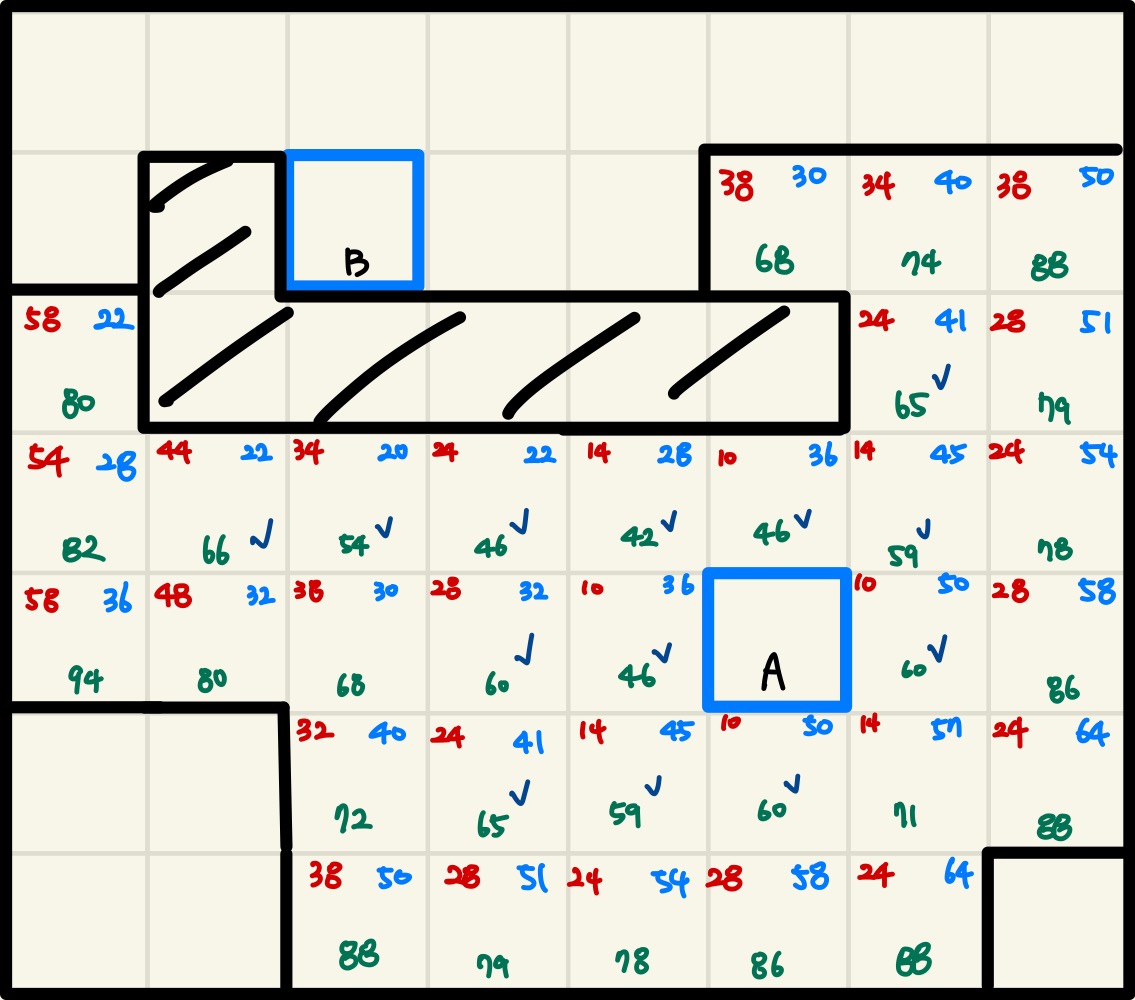 | 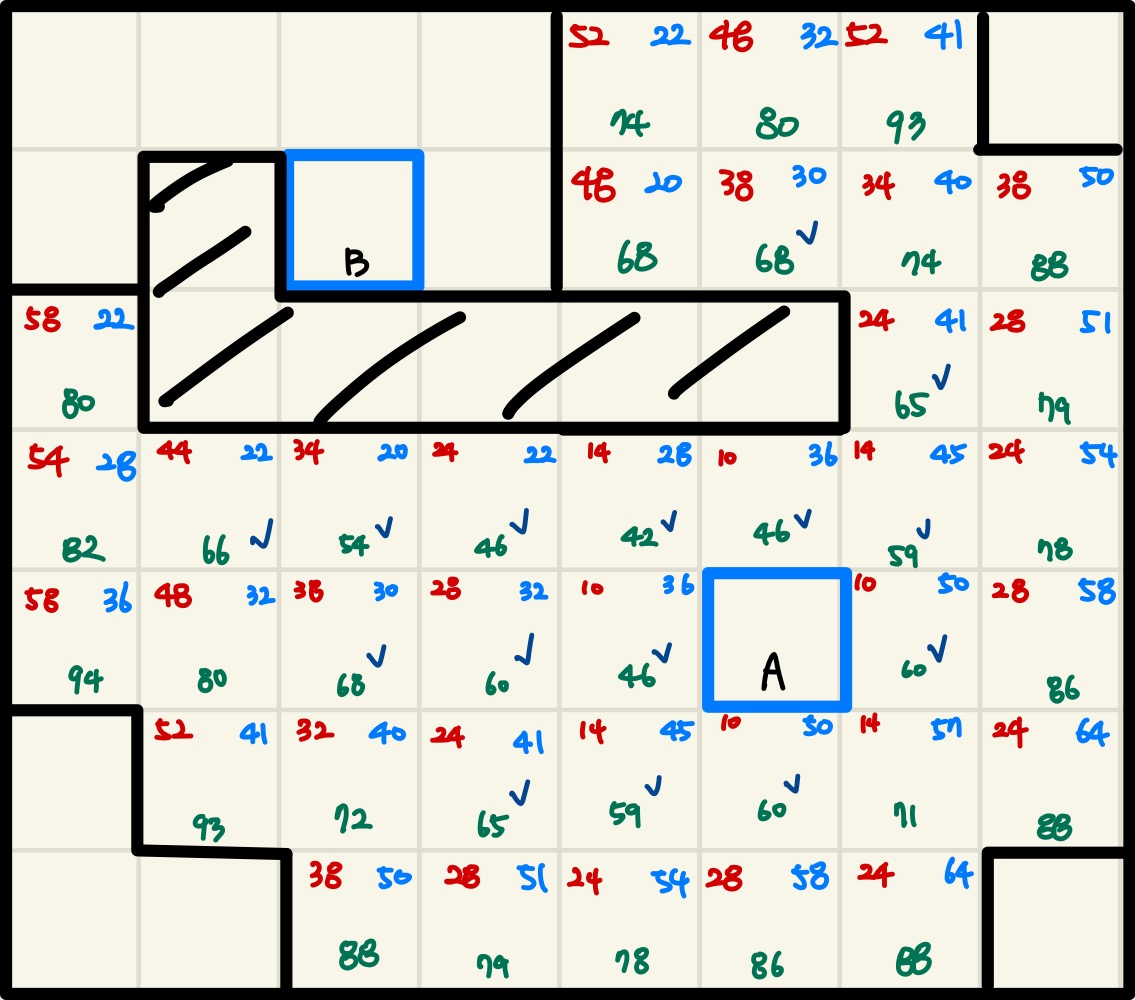 | 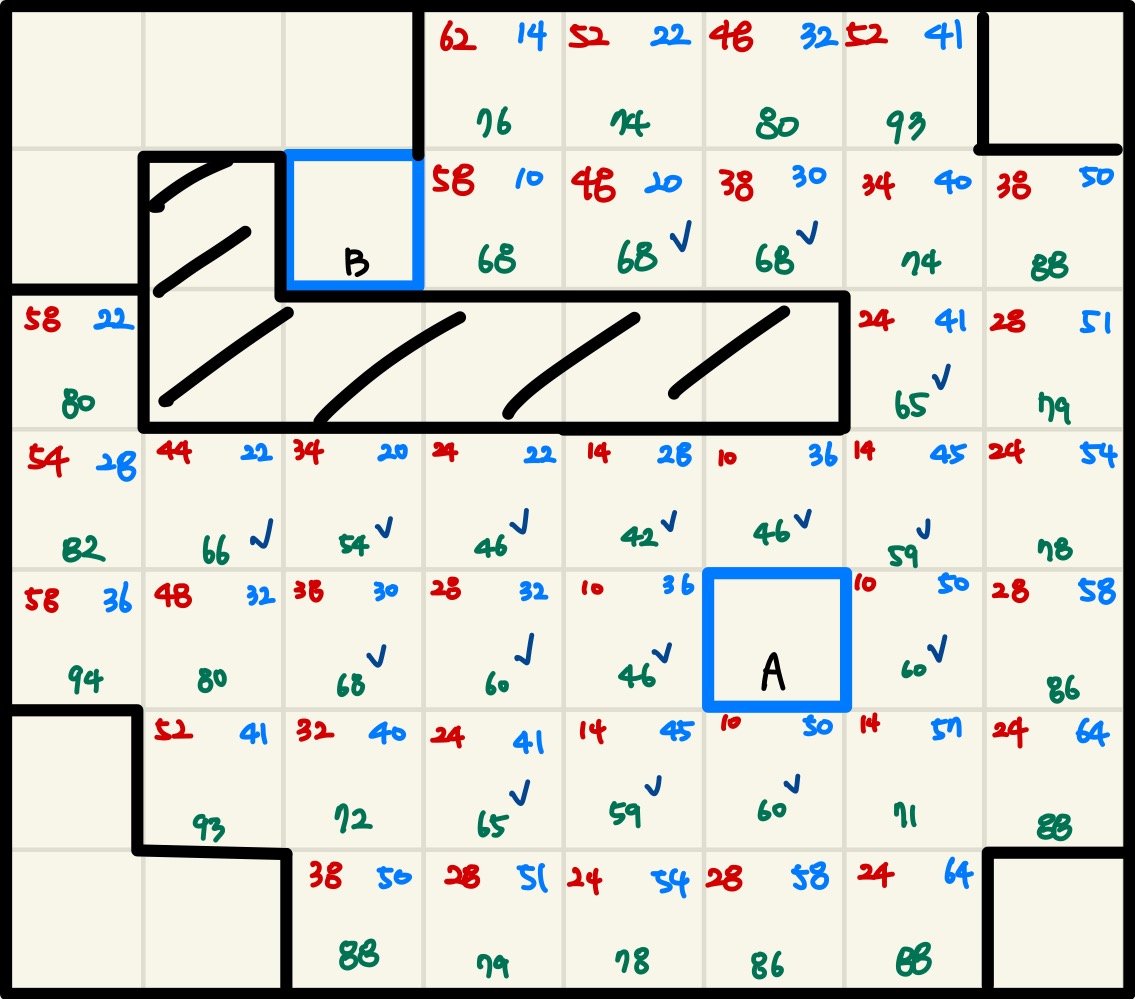 |
결과
우선순위 큐를 활용한 A* 구현
vector<pair<int, int>> graph[N]; // graph[u] = {v, cost}
vector<int> DP(N, INF);          // g(n): 시작점에서 현재 노드까지의 거리
vector<int> heuristic(N);        // h(n): 휴리스틱 값

void a_star(int start, int end)
{
    priority_queue<tuple<int, int, int>, vector<tuple<int, int, int>>, greater<>> pq;
    pq.push({heuristic[start], 0, start});
    DP[start] = 0;

    while (!pq.empty())
    {
        auto [f, g, u] = pq.top();
        pq.pop();

        if (u == end)
            break; // 목표 도착

        for (auto [v, cost] : graph[u])
        {
            int newG = g + cost;
            if (newG < DP[v])
            {
                DP[v] = newG;
                int newF = newG + heuristic[v];
                pq.push({newF, newG, v});
            }
        }
    }
}
안녕하세요 게임 개발하는 MINO 입니다.