일단 DB에 데이터를 채우는게 1순위
쿼리는 ERD 포스팅에서 계속 업데이트 중 + 프로젝트 내 sql 파일에도 저장 중
일단 기본적으로 화가 데이터, 미술사조 데이터는 다 집어 넣었는데 문제는
작품 데이터다...
지금 등록된 화가는 44명
각 사람마다 평균 20장 정도의 작품
약 900장이다...
쿼리를 자동화 하면 이름은 싹다 누구_작품_1 방식으로 통일할 수 밖에 없는데
나중에 update 하는 방식으로 이름을 수정해야하나
약 900번..?
이건 아닌 것 같다
크롤링 해야 할 페이지를 보니까
일단 작품마다 영어로 된 그림 제목이 같이 딸려있다
이걸 파일 이름으로 같이 크롤링 할 수는 없을까??
f12 로 구조를 좀 까보니까
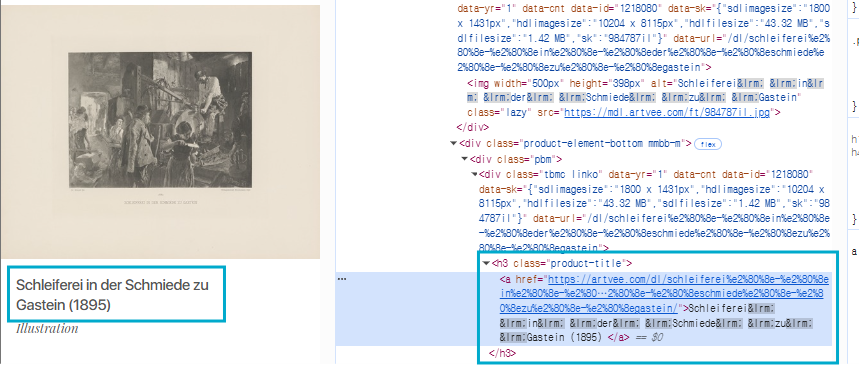
표시해둔 a태그에 작품의 제목도 들어가 있었다
그렇다면 이걸 크롤링할 수 있으면??
beautifulsoup 덕분에 가능한게 확인됐다
html 구조 자체를 까보는 녀석이라서
a 태그 안에 있는 product-title 데이터도 가져올 수 있었다
html 에서 작품 제목 추출, 파일 이름으로 저장
import os # 폴더 관리 도구 로드 #
import requests # 접속 도구 로드 #
from bs4 import BeautifulSoup # 데이터 추출 도구 로드 #
import time # 차단 방지 지연 도구 로드 #

# 1. 경로 설정 #
base_path = r'C:\jje_work\sts-5.0.1.RELEASE-workspace\docentNote\crawling' # 루트 경로 설정 #

# 2. 화가 데이터 정리 #
art_data = {
    'Renaissance': {
        'Da_Vinci': 'https://artvee.com/artist/leonardo-da-vinci/',
        'Michelangelo': 'https://artvee.com/artist/michelangelo/'
    },
    'Baroque': {
        'Rembrandt': 'https://artvee.com/artist/rembrandt-van-rijn/',
        'Vermeer': 'https://artvee.com/artist/johannes-vermeer/',
        'Velazquez': 'https://artvee.com/artist/diego-velazquez/',
        'Brueghel': 'https://artvee.com/artist/jan-brueghel-the-elder/',
        'Caldei': 'https://artvee.com/artist/francesco-caldei/',
        'Honthorst': 'https://artvee.com/artist/gerard-van-honthorst/'
    },
    'Rococo': {
        'Watteau': 'https://artvee.com/artist/jean-antoine-watteau/',
        'Boucher': 'https://artvee.com/artist/francois-boucher/',
        'Fragonard': 'https://artvee.com/artist/jean-honore-fragonard/',
        'Tiepolo': 'https://artvee.com/artist/giovanni-battista-tiepolo/',
        'Le_Brun': 'https://artvee.com/artist/elisabeth-louise-vigee-le-brun/',
        'Canaletto': 'https://artvee.com/artist/canaletto/',
        'Gainsborough': 'https://artvee.com/artist/thomas-gainsborough/'
    },
    'Romanticism': {
        'Delacroix': 'https://artvee.com/artist/eugene-delacroix/',
        'Friedrich': 'https://artvee.com/artist/caspar-david-friedrich/',
        'Turner': 'https://artvee.com/artist/joseph-mallord-william-turner/',
        'Constable': 'https://artvee.com/artist/john-constable/',
        'Goya': 'https://artvee.com/artist/francisco-de-goya/'
    },
    'Realism': {
        'Courbet': 'https://artvee.com/artist/gustave-courbet/',
        'Millet': 'https://artvee.com/artist/jean-francois-millet/',
        'Daumier': 'https://artvee.com/artist/honore-daumier/',
        'Repin': 'https://artvee.com/artist/ilya-efimovich-repin/',
        'Nielsen_A': 'https://artvee.com/artist/amaldus-nielsen/',
        'Zorn': 'https://artvee.com/artist/anders-zorn/',
        'Robie': 'https://artvee.com/artist/jean-baptiste-robie/'
    },
    'Impressionism': {
        'Monet': 'https://artvee.com/artist/claude-monet/',
        'Renoir': 'https://artvee.com/artist/pierre-auguste-renoir/',
        'Degas': 'https://artvee.com/artist/edgar-degas/',
        'Pissarro': 'https://artvee.com/artist/camille-pissarro/',
        'Manet': 'https://artvee.com/artist/edouard-manet/',
        'Morisot': 'https://artvee.com/artist/berthe-morisot/',
        'Sorolla': 'https://artvee.com/artist/joaquin-sorolla/'
    },
    'Post-Impressionism': {
        'Gogh': 'https://artvee.com/artist/vincent-van-gogh/',
        'Gauguin': 'https://artvee.com/artist/paul-gauguin/',
        'Cezanne': 'https://artvee.com/artist/paul-cezanne/',
        'Seurat': 'https://artvee.com/artist/georges-seurat/',
        'Loiseau': 'https://artvee.com/artist/gustave-loiseau/',
        'Rysselberghe': 'https://artvee.com/artist/theo-van-rysselberghe/',
        'Sidaner': 'https://artvee.com/artist/henri-le-sidaner/'
    },
    'Art_Nouveau': {
        'Mucha': 'https://artvee.com/artist/alphonse-mucha/',
        'Cheret': 'https://artvee.com/artist/jules-cheret/',
        'Livemont': 'https://artvee.com/artist/henri-privat-livemont/',
        'Meunier': 'https://artvee.com/artist/georges-meunier/',
        'Nielsen_K': 'https://artvee.com/artist/kay-rasmus-nielsen/',
        'Klimt': 'https://artvee.com/artist/gustav-klimt/'
    },
    'Illustration': {
        'Leyendecker': 'https://artvee.com/artist/joseph-christian-leyendecker/'
    }
} # 설정 #

headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'} # 브라우저 정보 설정 #
# 3. 크롤링 실행 #
for movement, painters in art_data.items(): # 사조별 반복 #
    for painter, url in painters.items(): # 화가별 반복 #

        # 폴더 생성 #
        save_dir = os.path.join(base_path, movement, painter) # 계층 경로 설정 #
        if not os.path.exists(save_dir): # 폴더 확인 #
            os.makedirs(save_dir) # 폴더 생성 #

        try:
            response = requests.get(url, headers=headers) # 데이터 가져옴 #
            soup = BeautifulSoup(response.text, 'html.parser') # HTML 분석 설정 #

            # 컨테이너 추출: 각 그림 카드를 감싸는 부모 요소를 찾음 #
            # 사이트 구조에 따라 클래스명을 확인 #
            items = soup.find_all('div', class_='product-grid-item')

            for i, item in enumerate(items[:20]): # 20개 반복 설정 #
                # 제목 가져옴: h3 태그의 product-title 클래스 탐색 #
                title_tag = item.find('h3', class_='product-title') # 제목 태그 확인 #

                if title_tag and title_tag.find('a'): # a 태그 내부의 텍스트 확인 #
                    raw_title = title_tag.find('a').get_text().strip() # 제목 가져옴 #

                    # 이름 설정: 파일명 금지 문자 제거 및 공백을 언더바(_)로 저장 #
                    import re
                    clean_title = re.sub(r'[\\/*?:"<>|]', "", raw_title) # 특수문자 제거 #
                    clean_title = clean_title.replace(" ", "_") # 공백 저장 #
                    file_name = f"{clean_title}.jpg" # 파일 이름 생성 #
                else:
                    file_name = f"{painter.lower()}_{i}.jpg" # 제목 없을 때 기본값 저장 #

                img_tag = item.find('img') # 이미지 태그 확인 #
                if img_tag:
                    img_url = img_tag.get('data-lazy-src') or img_tag.get('src') # 주소 가져옴 #

                    if img_url:
                        # 저장: 이미지 파일을 경로에 맞게 생성함 #
                        img_data = requests.get(img_url).content # 데이터 가져옴 #
                        full_path = os.path.join(save_dir, file_name) # 경로 설정 #

                        with open(full_path, 'wb') as f: # 파일 저장 #
                            f.write(img_data) # 저장 완료 #
                        print(f"[{movement}] {painter} - {file_name} 저장 완료") # 상태 확인 #

                        time.sleep(1.0) # 지연 설정 #

        except Exception as e:
            print(f"{painter} 크롤링 중 에러 발생: {e}") # 에러 확인 #

print("모든 작업이 완료되었습니다") # 종료 #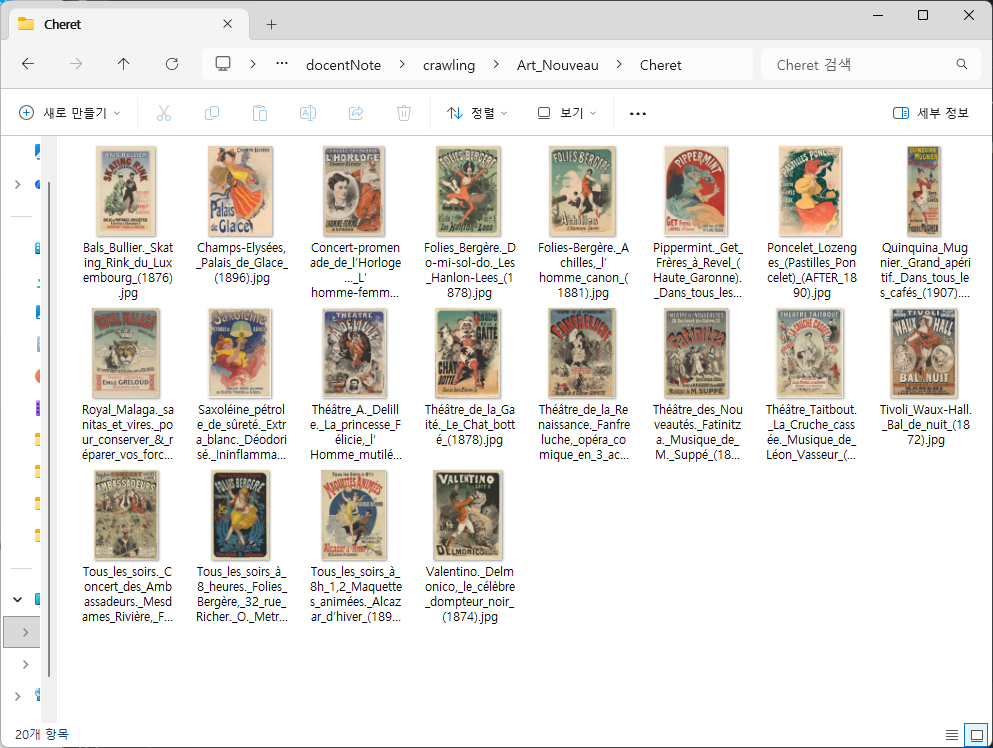
작품 이름이 파일명으로 저장이 됐다
그리고 제목에 작품 제작 연도가 같이 있는 작품들은 제작 연도까지 같이 크롤링이 됐다
제작 연도를 따로 빼지 말고 그냥 제목에 포함시키는걸로 하고 createYear 컬럼은 뺐다
오류 상황 및 해결
error: open("frontend/public/crawlingimages/Renaissance/Da_Vinci/Compositional_Sketches_for_the_Virgin_Adoring_the_Christ_Child,_with_and_without_the_Infant_St._John_the_Baptist;_Diagram_of_a_Perspectival_Projection(1480–85).jpg"): Filename too long
error: unable to index file 'frontend/public/crawlingimages/Renaissance/Da_Vinci/Compositional_Sketches_for_the_Virgin_Adoring_the_Christ_Child,_with_and_without_the_Infant_St._John_the_Baptist;_Diagram_of_a_Perspectival_Projection(1480–85).jpg'
fatal: adding files failed
보자마자 좀 막막했는데
첫줄부터 쭉 읽어가다보면 그냥 파일 경로였을 뿐이었다
네번째 줄 마지막에 보면 Filename too long
이라는 문구가 보인다
직관적이다
그럼 파일 이름이 길어도 저장하게 해야지
Filename 어쩌고를 검색하니까 바로 해결법이 나왔다
git config --system core.longpaths true
Git 이 파일 경로 길이 제한을 무시하게 하는 명령어
이걸 입력하고 다시 add 를 했더니
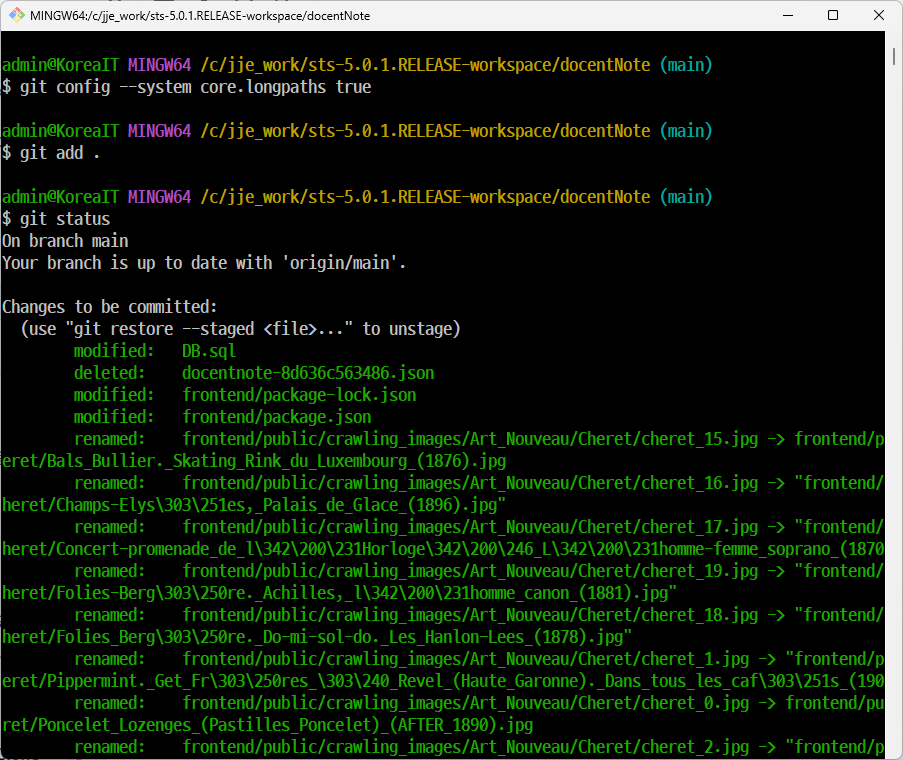
제대로 들어간걸 확인
혹시 몰라서 깃헙에서도 확인해봤는데
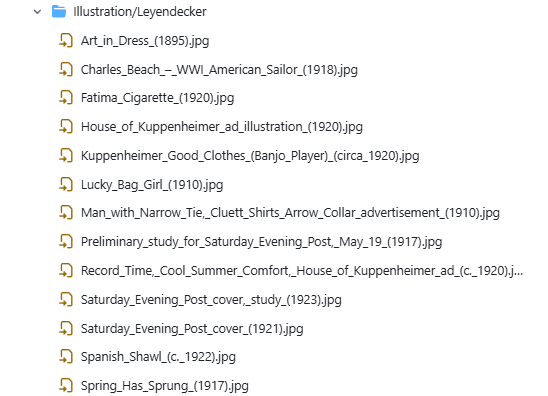
전부 업로드가 됐다
painting 데이터 넣는 과정
이제 다음에 해야 할 고민은
DB에 어떻게 영어이름이랑 한글이름을 다 넣지?
일단 파일명은 작품 영어 제목으로 싹 저장이 됐다
다만 이렇게 된 이상 mysql 만 써서 데이터 삽입 자동화는 불가능
이전에 크롤링 했던 파일명은 rubens_0.jpg 같은 방식이라 DB에서 자동화가 가능했는데...
길게 갈거 없이 제미나이한테 물어보니 파이썬 os 모듈로 가능하다고 한다
이게 뭔데 크롤링도 가능하고 쿼리 작성도 가능한거지?
싶어서 찾아봄
파이썬 OS 모듈
파이썬 모듈(Module)
변수, 함수, 클래스 등을 논리적으로 묶어놓은 .py 확장자를 가진 파이썬 파일
OS 모듈 = Operating System 모듈
운영체제와 상호작용
파일 및 디렉토리 생성
파일 시스템 속성 조회 및 수정
환경 변수 관리
시스템 명령어 실행
별도의 설치 과정 없이 import os 한줄이면 사용 가능
-
파일 목록 얻기
glob.glob(wildcard) - 유닉스 경로명 패턴 스타일로 파일 목록 얻기
os.listdir(path) - 지정된 디렉토리의 전체 파일 목록 얻기
dircache.listdir(path) - os.listdir(path)와 동일한 파일 목록 전달
path가 변경되지 않았을 때, dircache.listdir()은 다시 디렉토리 구조를 읽지 않고 이미 읽은 정보를 활용
dircache.annotate(head, list) - 일반 파일명과 디렉토리명을 구분해주는 함수 -
디렉토리 다루기
os.chdir(path) - 작업하고 있는 디렉토리 변경
os.getcwd() - 현재 프로세스의 작업 디렉토리 얻기
등등 -
파일 이름 다루기
os.path.abspath(filename) - 파일의 상대 경로를 절대 경로로 바꾸는 함수
os.path.exists(filename) - 주어진 경로의 파일이 있는지 확인하는 함수
os.curdir() - 현재 디렉토리 얻기
os.pardir() - 부모 디렉토리 얻기
os.sep() - 디렉토리 분리 문자 얻기 -
경로명 분리하기
os.path.basename(filename) - 파일명만 추출
os.path.dirname(filename) - 디렉토리 경로 추출
os.path.split(filename) - 경로와 파일명을 분리
os.path.splitdrive(filename) - 드라이브명과 나머지 분리 (MS Windows의 경우)
os.path.splitext(filename) - 확장자와 나머지 분리
즉 운영체제랑 상호작용해서, 운영체제가 할 수 있는 기능들을 파이썬 코드로 사용할 수 있게 하는 모듈이다
업무 자동화라는 키워드가 많이 보이는데... 이건 꼭 기억해야할 것 같다
파일명을 번역해서 데이터화
여기에 더해서 파일명 번역도 가능하다고 한다
뭐지? 파이썬 너무 대단한데
사용할 수 있는 선택지는 2개
pip install deep-translator
DeepL 같은 번역기 활용 가능
pip install googletrans==4.0.0-rc1
구글 번역기
일단 deep-translator 를 사용하기로 결정했다
추후 번역엔진을 바꿔야 할 때가 생기면 이쪽이 더 유연하게 대처할 수 있을 것 같다
일단 지금 당장 기본은 구글 번역기로 사용하겠지만
translator_to_ko = GoogleTranslator(source='auto', target='ko')
source 는 auto 로 설정해서
영어, 프랑스어, 독일어 등등 모든 언어를 인식하게 했고
target 은 ko 로 설정해서 무조건 한국어로 번역하게 했다
발음부호 교정
Á É Í Ó Ú Ć Ń Ś Ź
이런 것들을 모두 일반 스펠링으로 교정
하는 것 조차 가능했다
unicodedata 라는 파이썬 기본 라이브러리가 수행할 수 있는 기능이다
이런 발음부호까지 제공하는 폰트가 있지만 대부분은 고려하지 않는 사항이라서..
일단 추출해놓은 화가 이름에서도 발음부호는 싹 알파벳으로 바꿔뒀고
파일명에도 군데군데 발음부호가 보인다
사실 여기까지 총 세번의 쿼리 생성을 했는데
첫번째 쿼리는 데이터 100개 입력 실패
두번째 쿼리는 데이터 20개 입력 실패
세번째 쿼리는 데이터가 다 들어갔지만 확인차 painterId 오름차순으로 정렬한 결과 빠진 화가 번호가 많이 있었다
대충 계산해보니 약 200개~300개 사이 정도의 작품 데이터가 쿼리 생성 때 부터 누락
쿼리 실행 시 누락 데이터에 대한 가설은 잘 세웠는데
아예 쿼리를 생성할 때 누락될 가능성은 생각하지 못했다
폴더명과 DB에 등록된 이름이 100% 일치하지 않아서 생기는 문제일 가능성이 큰 것 같다
insert 로 들어간 화가 이름하고 아이디가 없는 화가 폴더의 이름을 대조해보니까 모두 언더바 or 하이픈이 있었다
일단 insert 페인터 쿼리를 한번 더 검토한 결과 양음부호 í 가 고쳐지지 않아서 수정했고
쿼리 + 폴더 이름에 언더바, 하이픈 들어간 것들은 싹 뺐고
화가 목록에서 제외하기로 했던 폴더도 하나 있어서 삭제해줬다
제발...
통상 다섯번째 쿼리 생성이었는데
또 수정을 해야한다
번역기 오류가 생겼다
영어 외 언어에서 맨 마지막에 들어있는 연도를 중간에 넣어버려서
Voulez vous triompher des Belles (c. 1714 - 1717)
Belles (c. 1714 - 1717)를 이기고 싶습니까?
이런식으로 번역이 됐다
그래서 번역 범위를 제목만으로 좁히는 과정도 필요해졌다
연도 정보는 빼고 싶지 않아서 연도 정보도 유지해야하고
그리고 사소한 번역에서 아쉬움이 있다
Neptune 은 현대적인 의미로는 해왕성이 맞지만
예술적인 의미로 본다면 해왕성이 아니라 이름으로 사용이 되어야 한다
단순 번역으로는 안된다는거...
제미나이 api 받아와서 번역을 시켜봤는데 하나하나 결과를 얻는데에 너무 오래 걸린다
평균 10초정도? 심한건 20초도 넘게 걸린다... 이런 속도로는 다 못끝낼 것 같아서 이 방법은 포기
일단 빠르게 생성 가능한 일반 번역 라이브러리로 데이터 쿼리를 빠르게 만들고 지피티, 제미나이, 클로드 셋 다한테 파일을 주면서 이상한 부분을 수정하라고 한 후 가장 결과가 좋은걸 쓰려고
뭘 수정했는지도 말하라고 해야겠지...
import os
import unicodedata
import time
import re  # 정규 표현식 사용
from deep_translator import GoogleTranslator

# 1. 설정: 연도 추출 및 제목 분리 함수 #
def process_title_and_year(title):
    if not title: return "", ""

    # 괄호 안의 숫자(연도) 패턴 찾기 (예: "(1720)")
    year_match = re.search(r'\(\d+\)', title)

    if year_match:
        year = year_match.group()  # "(1720)" 추출
        # 제목에서 연도 부분 제거하여 번역용 텍스트 생성
        clean_title = title.replace(year, "").strip()
        return clean_title, year
    else:
        # 연도가 없는 경우
        return title.strip(), ""

def remove_accents(input_str):
    if not input_str: return ""
    nfd_form = unicodedata.normalize('NFD', input_str)
    return "".join([c for c in nfd_form if unicodedata.category(c) != 'Mn'])

# 2. 경로 및 번역기 설정 #
base_path = r"C:\jje_work\sts-5.0.1.RELEASE-workspace\docentNote\frontend\public\crawling_images"
output_file = "insert_paintings_with_year_fixed.sql"
translator_to_ko = GoogleTranslator(source='auto', target='ko')

movements = {
    'Art Nouveau': 1, 'Baroque': 2, 'Illustration': 3, 'Impressionism': 4,
    'Post Impressionism': 5, 'Realism': 6, 'Renaissance': 7, 'Rococo': 8, 'Romanticism': 9
}

print("--- 연도 보존 및 한글 번역 시작 ---")
count = 0

with open(output_file, 'w', encoding='utf-8') as f:
    f.write("USE docentNote;\n\n")

    for move_folder, move_id in movements.items():
        move_path = os.path.join(base_path, move_folder)
        if not os.path.exists(move_path): continue

        display_move_name = move_folder.replace("_", " ")

        for painter_folder in os.listdir(move_path):
            painter_path = os.path.join(move_path, painter_folder)
            if not os.path.isdir(painter_path): continue

            clean_painter = remove_accents(painter_folder.replace("_", " ")).strip()

            for img_file in os.listdir(painter_path):
                if img_file.lower().endswith(('.jpg', '.jpeg', '.png')):
                    count += 1

                    # 가져옴: 파일명에서 원본 제목 추출 #
                    original_title = os.path.splitext(img_file)[0].replace("_", " ")

                    # 제목과 연도 분리 #
                    title_for_translate, year_info = process_title_and_year(original_title)

                    # 설정: 영어 스펠링 교정 (연도 포함 원문 유지) #
                    clean_title_en = remove_accents(original_title).replace("'", "''")

                    try:
                        # 설정: 제목만 번역 후 연도 다시 붙이기 #
                        translated_text = translator_to_ko.translate(title_for_translate)

                        # 번역본 뒤에 연도 정보 결합 (예: 별이 빛나는 밤 + (1889))
                        name_kr = f"{translated_text} {year_info}".strip().replace("'", "''")

                        print(f"[{count}] 🖼️ {display_move_name} | {clean_painter}")
                        print(f"      🎨 원문: {original_title} ➡️ 번역: {name_kr}")
                        print("-" * 60)

                    except Exception as e:
                        print(f"[{count}] ❌ 오류: {original_title} ({e})")
                        name_kr = clean_title_en

                    url = f"/crawling_images/{move_folder}/{painter_folder}/{img_file}"
                    painter_id_sub = f"IFNULL((SELECT id FROM `painter` WHERE `painterNameEn` LIKE '%{clean_painter}%' LIMIT 1), 1)"

                    sql = (
                        f"INSERT INTO `painting` (`paintingNameEn`, `paintingNameKr`, `imgUrl`, `painterId`, `movementId`, `regDate`, `updateDate`) "
                        f"VALUES ('{clean_title_en}', '{name_kr}', '{url}', {painter_id_sub}, {move_id}, NOW(), NOW());\n"
                    )
                    f.write(sql)

                    time.sleep(0.3)

print(f"\n 완료! 연도가 보존된 {count}개의 데이터가 생성되었습니다.")
제미나이를 많이 쥐어짜냈다...
번역 검수 과정 3회
지피티 제미나이 클로드한테 동일한 프롬프트, 동일한 파일을 줬다
painterNameEn 이랑 paintingNameKr 에 들어갈 데이터를 읽고
paintingNameKr 에 들어갈 데이터가 문법상, 혹은 예술적으로 어색한 부분이 있으면 고쳐서 sql 파일을 수정하고
고친 내역은 txt 파일로 보여줘
솔직히 어려운거 알면서 일단 보내보긴 했는데
지피티는 sql 파일 자체를 인식 못했다 그래 무료버전이라 그럴 수 있다고 쳐
제미나이는 양이 너무 많다고 자기가 수정한걸 채팅창에 하나하나 보내면서 복붙하세요~ 이러고있고
제대로 수행한건 클로드 밖에 없다
[17] 항목 #77 | 유형: 오역
영문 제목 : Job (1896)
수정 전 : 직업 (1896)
수정 후 : 욥 (1896)
수정 이유 : 뮤샤의 담배 포스터 작품. Job은 담배 브랜드명(성경 욥의 이름에서 유래). '직업'은 오역
이런 식으로 수정내역까지 싹 정리했다
그 뒤 검수과정은 클로드를 통해서 총 3회 진행
- 수정 유형별 요약
고유명사 오역: 4건
문법 오류: 1건
문화적 오역: 1건
번역 어색: 21건
번역 어색/오역: 1건
번역 어색/표기 오류: 1건
번역 오류: 2건
오역: 24건
오역/번역 어색: 2건
표기 오류: 5건
표기 오류/번역 어색: 3건
행성명 → 이름
완벽하게 번역이 된건 아닌데 더 시간쓰면 안될 것 같아서 여기서 끝
쿼리를 sql 에 입력했을 때 나타난 따옴표 오류만 수정해서 데이터 입력했더니
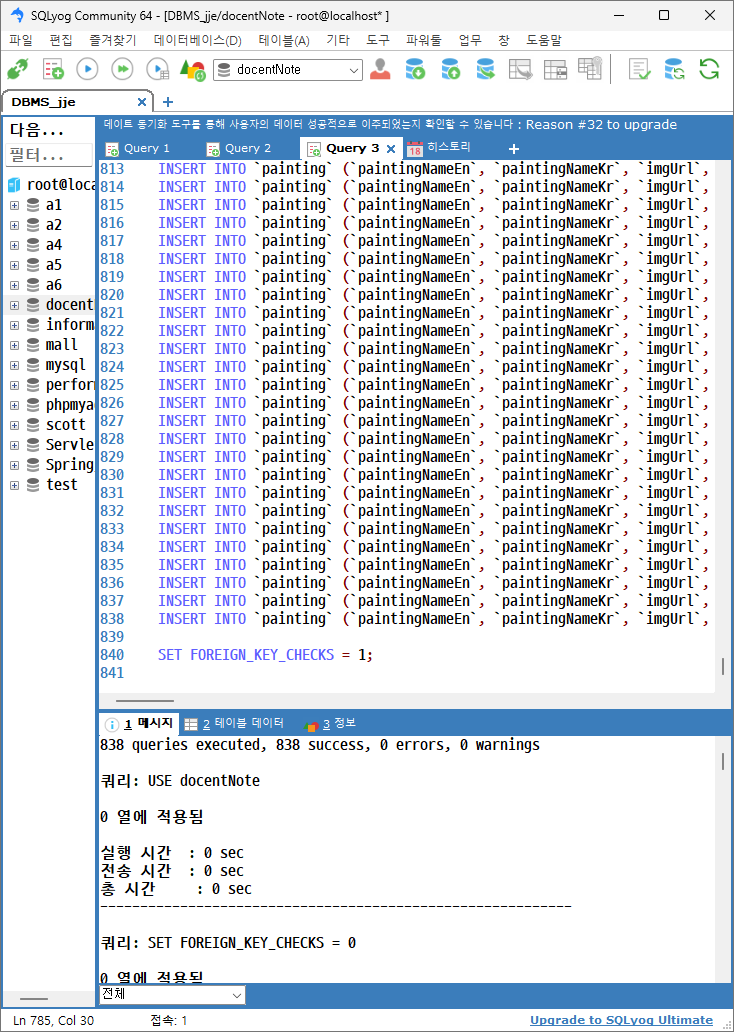
성공했다 드디어
드디어 끝이 났다
select 로 화가 아이디, 사조 아이디 빠진거 없이 다 들어간거 확인했다
painting DB 작업은 여기서 끝내기
일단
파이썬이 생각보다 많이 유능해서 시간이 되면 한번 공부해보고 싶어졌다
내가 개인적으로 쓸 수 있을만한 프로그램 같은거...? 당장 떠오르는건 없는데