파인튜닝 (LLaVA 1.5)
LLaVA(Large Language-and-Vision Assistant)를 활용하여 VLM(Vision-Language Model)의 파인튜닝에 대해서 학습하고 실습해보려한다.
Visual Instruction Tuning
언어 모델에 눈 달아주기
LLaVA(Large Language and Vision Assistant)는 텍스트만 이해하는 거대언어 모델(LLM)을 시각 정보를 이해할 수 있는 멀티모달 모델로 확장하려고한다.
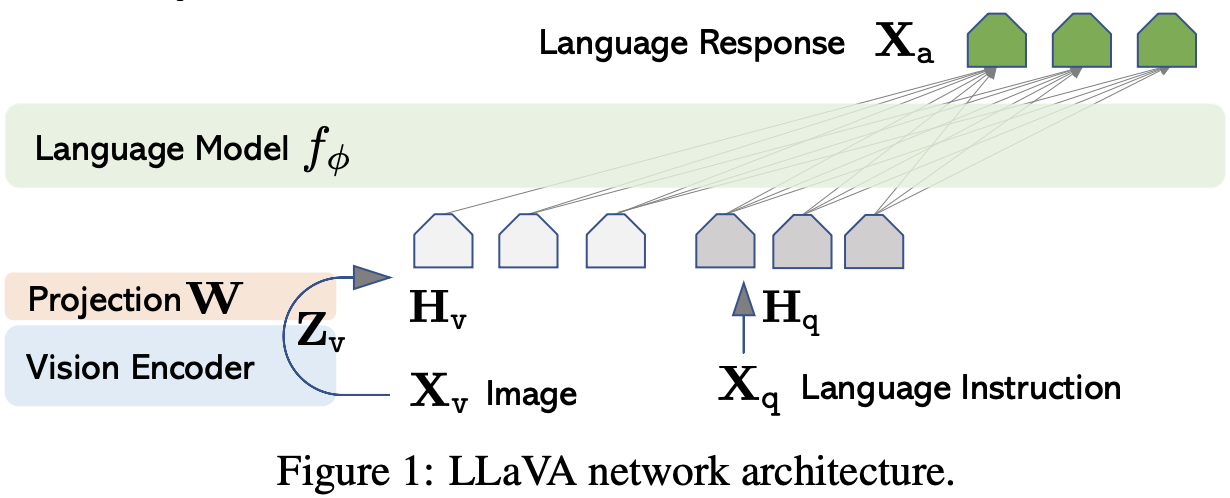
- Vision Encoder: 이미지를 보는 눈으로 사전 학습된 CLIP (ViT-L/14)를 사용한다.
- Language Model: 뇌 역할을 하는 언어 모델로는 Vicuna를 사용한다.
- Projection Layer(연결): 이 둘을 연결하기 위해서 단순한 선형 레이어(Linear Layer)를 사용한다. 이 레이어는 이미지의 특징(Visual Features)을 언어 모델이 이해할 수 있는 단어 임베딩(Word Embedding) 공간으로 변환해 주는 역할을 한다.
GPT-4를 활용한 데이터 생성
파인튜닝을 하려면 이미지를 보고 지시를 따르는 데이터가 필요한데, 기존에는 이런 데이터가 부족했다. 논문에서 텍스트 기반의 GPT-4를 활용해 이미지를 설명하는 텍스트(Caption)와 위치 정보(Bounding Box)만으로 멀티모달 지시-응답 데이터(Multimodal Instruction-following Data)를 생성해냈다.
데이터는 크게 세 가지 유형으로 생성된다.
- Conversation (대화형):이미지에 대해 주고받는 문답.
- Detailed Description (상세 묘사): 이미지를 아주 구체적으로 설명하는 글.
- Complex Reasoning (복합 추론): 이미지 내용을 바탕으로 논리적인 추론을 요구하는 질의응답.
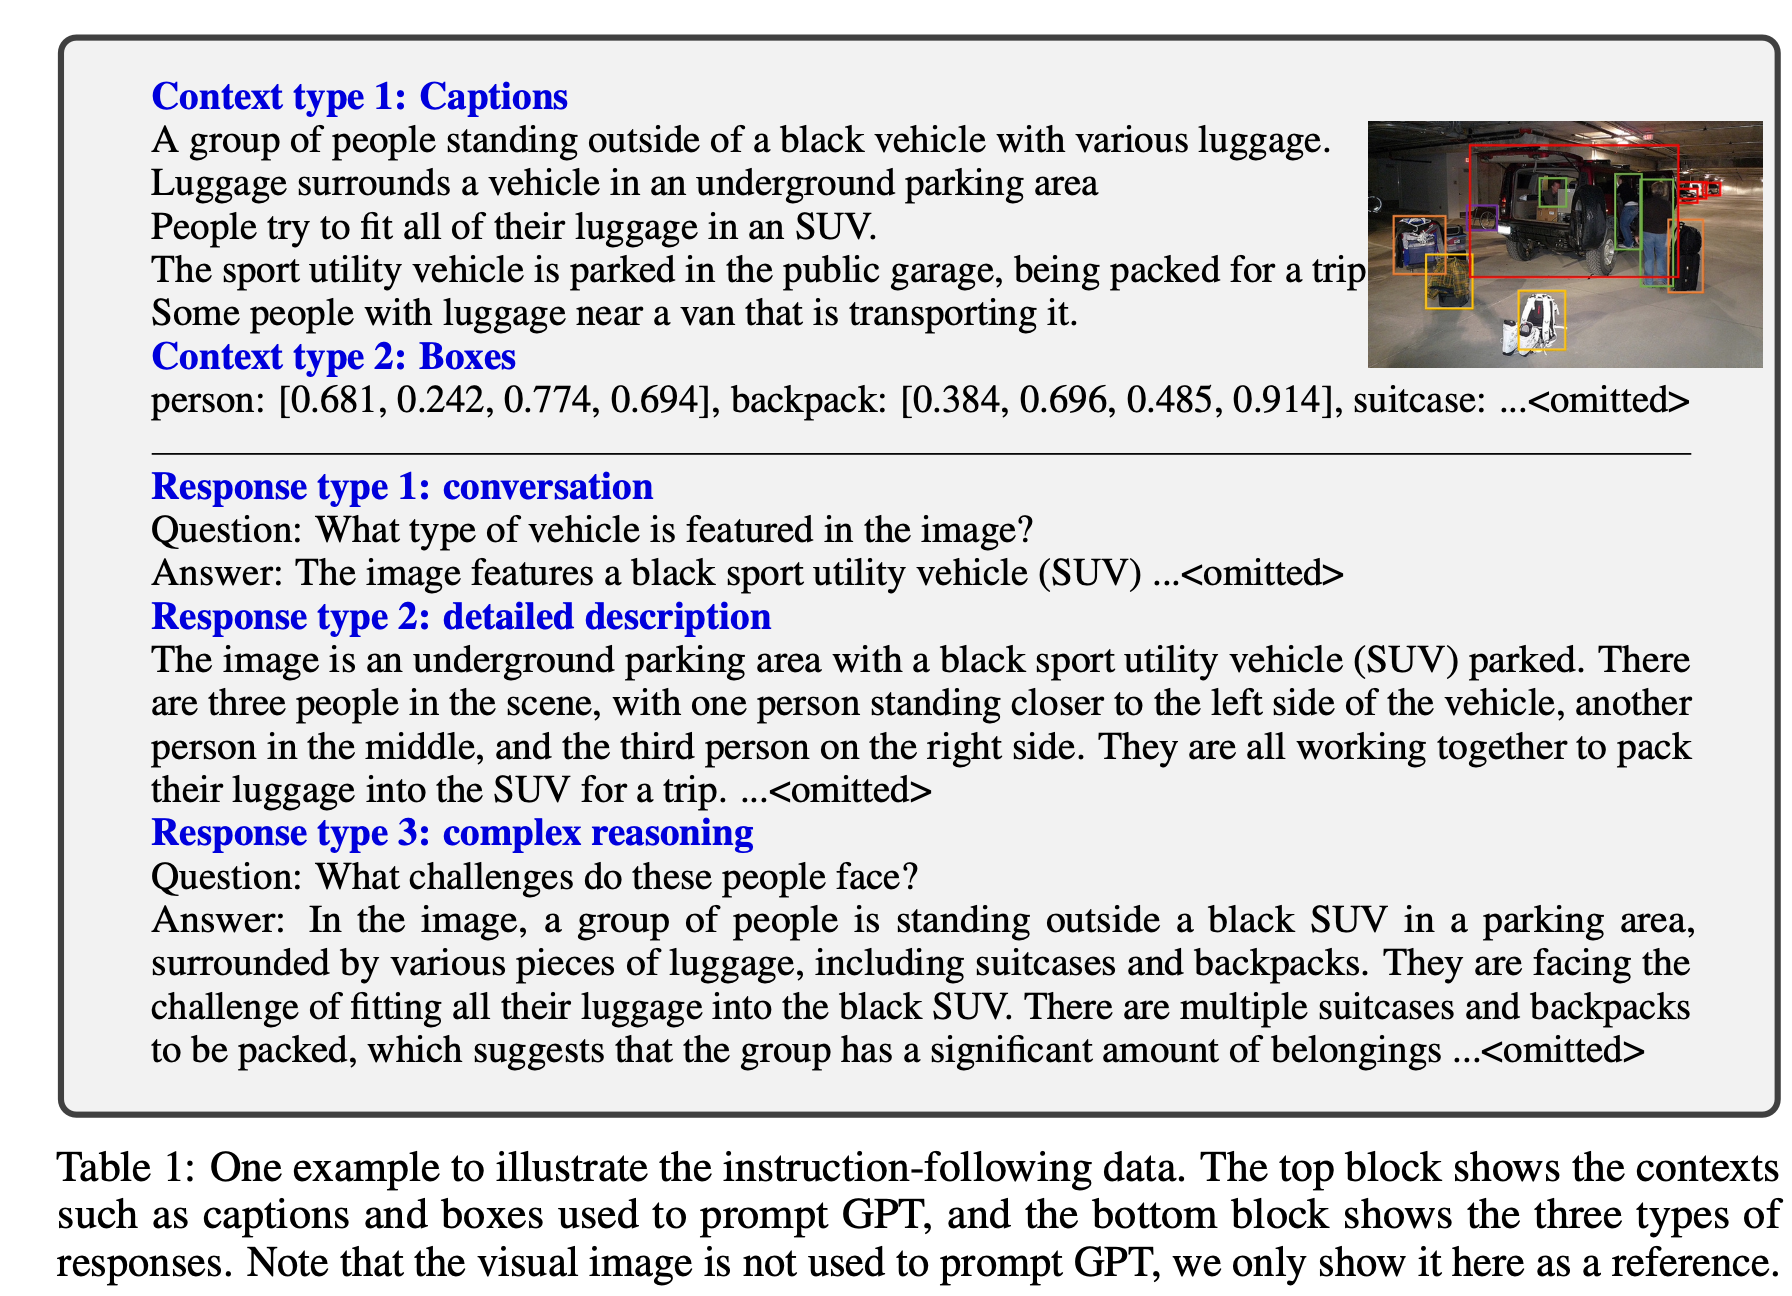
이 그림은 텍스트 전용 GPT-4를 사용해서 마치 이미지를 본 것처럼 풍부한 질의 응답 데이터를 만들어냈다.
- 입력
GPT-4는 텍스트만 이해할 수 있으므로, 이미지를 대신할 수 있는 두 가지 기호적 표현(Symbolic Representations)을 제공한다.
- Context type 1: Captions (캡션): 이미지가 무엇인지 묘사하는 문자들이다. (예: 검은색 차량 밖에 서 있는 사람들, 지하주차장)
- Context type 2: Boxes (박스 좌표): 이미지 속 객체들의 위치와 이름이다. (예: 사람 좌표, 배낭 좌표, 여행 가방 좌표 등).
2.출력
GPT-4는 위 텍스트 정보만을 단서로 삼아, 마치 이미지를 보고 있는 것처럼 세 가지 유형의 지시-응답(Instruction-Response) 데이터를 생성했다.
-
Type 1: Conversation (대화형):
- 사진을 보고 나누는 자연스러운 문답이다.
- 예시: "이 차량은 어떤 종류인가요?" -> "검은색 SUV입니다.".
-
Type 2: Detailed Description (상세 묘사):
- 이미지 전체를 아주 구체적이고 풍부하게 묘사하는 글이다.
- 예시: "지하 주차장에 검은색 SUV가 주차되어 있고, 세 명의 사람이 짐을 싣기 위해 협력하고 있습니다...".
-
Type 3: Complex Reasoning (복합 추론):
- 단순히 보이는 것을 넘어, 논리적인 추론을 요구하는 심화 질문이다.
- 예시: "이 사람들은 어떤 어려움을 겪고 있나요?" -> "많은 짐을 SUV에 다 실어야 하는 도전적인 상황입니다..." (좌표와 캡션을 보고 상황을 추론함).
2단계 파인튜닝 전략 (The core)
LLaVA는 학습을 Stage 1과 Stage 2로 나누어 진행한다.
Stage 1: 특징 정렬을 위한 사전 학습 (Pre-training for Feature Alignment)
- 목표: 이미지 인코더에서 나온 시각 정보를 LLM이 이해할 수 있는 단어장(Embedding Space)에 맞추는 과정이다. 쉽게 말하자면 이미지 신호를 단어 토큰처럼 인식하게 만드는 기초 훈련이다.
- 데이터: CC3M 데이터셋에서 필터링한 595K 개의 이미지-텍스트 쌍을 사용한다.
- 학습 방법:
- Vision Encoder & LLM: 둘 다 동결(Frozen) 상태로 둔다 (가중치를 업데이트하지 않음).
- Projection Matrix (W) 오직 이미지와 언어를 연결하는 이 투영 레이어만 학습한다.
Stage 2: 종단간 파인튜닝 (Fine-tuning End-to-End)
- 목표: 실제로 사용자의 지시(Instruction)를 이해하고, 이미지를 바탕으로 대화를 나눌 수 있는 챗봇으로 만드는 과정이다.
- 데이터: 앞서 GPT-4로 생성한 158K 개의 고품질 멀티모달 지시 데이터 (LLaVA-Instruct-158K)를 사용한다.
- 학습 방법:
- Vision Encoder: 여전히 동결(Frozen) 상태를 유지한다.
- Projection Layer () & LLM (): Stage 1에서 학습된 연결 레이어와 LLM의 가중치를 함께 업데이트한다. 즉, 언어 모델 자체가 시각 정보를 처리하는 법을 배우게 된다.
결과 및 성능
이러한 2단계 학습을 거친 LLaVA는 GPT-4(Text-only)에 비해 멀티모달 추론 능력이 뛰어나며, 학습에 사용하지 않은 이미지에 대해서도 높은 이해도를 보여준다. 특히 ScienceQA 벤치마크에서 92.53%의 정확도를 기록하며 새로운 SOTA(State-of-the-Art)를 달성했다.
파인튜닝은 Stage 2
논문은 학습 과정을 학습 과정을 명확하게 두 단계로 나누어 부른다.
1. 엄밀한 정의 (논문의 용어)
-
Stage 1: Pre-training (사전 학습)
- 이 단계는 '파인튜닝'이라고 부르지 않고 Feature Alignment(특징 정렬)를 위한 Pre-trainig이라고 명시한다.
- 시각 정보(Visual Feature)를 언어 모델이 이해할 수 있게 맞추는 기초 공사 단계이다.
-
Stage 2: Fine-tuning (파인튜닝)
- 논문에서 실제로 Fine-tuning End-to-End라고 부르는 단계는 Stage 2이다.
- 우리가 흔히 말하는 특정 목적(챗봇, 과학 문제 풀이 등)을 위해 모델을 똑똑하게 만드는 과정이다.
2. 우리가 흔히 말하는 LLaVA 파인튜닝
하지만 사용자 실무에서 "LLaVA를 파인튜닝해서 내 데이터에 맞게 쓰고 싶어"라고 할 때는 보통 Stage 2를 의미하는 경우가 많다.
- 일반적인 시나리오: 이미 Stage 1(Pre-training)이 완료된 LLaVA 모델 (Projector가 이미 학습된 상태)을 다운로드 받습니다.
- 사용자의 작업: 그 모델에 내가 가진 커스텀 데이터(예: 의료 이미지, 학국어 데이터 등)를 넣어서 Stage 2 학습을 진행한다.
실습
앞서 설명한 Stage 2(Visual Instruction Tuning)가 실제로 어떻게 작동하는지 확인하기 위해, 닌텐도의 포켓몬(Pokémon) 데이터셋을 사용하여 LLaVA 7B 모델을 파인튜닝한다.
1. 왜 포켓몬인가?
기존 LLaVA 모델도 피카츄 정도는 알아볼 수 있었다. 하지만 우리가 원하는 것은 단순한 인식이 아니라, 포켓몬 도감처럼 상세한 속성, 타입, 능력치를 설명해 주는 전문가 모델이다. 논문에서 ScienceQA 데이터로 모델을 학습시켜 과학 문제 전문가를 만든 것처럼, 우리만의 포켓몬 전문가를 만들기 위해 파인튜닝을 진행한다.
2. 데이터 준비: 지시 만들기
포켓몬 이미지를 모델이 이해할 수 있는 JSON으로 변환했다. 이 과정이 논문에서 말하는 Multimodal Instruction-following data 구축 단계이다.
- 입력 이미지 (): 포켓몬 이미지
- 지시 (): 이 포켓몬의 이름과 특징을 설명해줘.
- 정답 (): 이 포켓몬은 파이리입니다. 꼬리의 불꽃이 특징인 불꽃 타입 포켓몬으로....
아래는 학습용 데이터 포맷이다.
// 데이터셋 중 피카츄 부분
  {
    "id": "pokemon_194",
    "image": "pokemon_194.jpg",
    "conversations": [
      {
        "from": "human",
        "value": "<image>\nDescribe this image."
      },
      {
        "from": "gpt",
        "value": "a drawing of a pikachu in the air"
      }
    ]
  },
3. 학습 과정: Stage 2 & LoRA
실습은 RTX 3090(VRAM 24GB)으로 진행하며, 모델의 모든 파라미터를 업데이터하는 Full Fine-tuning 대신 LoRA(Low-Rank Adaptation) 방식을 사용했다. 논문의 Stage 2정의에 따라, Vision Encoder는 고정(Frozen)하고, Projector와 LLM의 가중치를 미세 조정했다.
4. 결과 비교
파인튜닝 전후의 모델 답변을 비교하여 Visual Alignment(시각적 정렬)가 어떻게 변했는지 확인한다.
- Before (Pre-trained LLaVA):
- User: Describe this image.
- Model: The image features a cartoon-like Pikachu character, a popular Pokemon, standing on its hind legs and waving its arms. The Pikachu is positioned in the center of the image, with its arms spread wide, giving the impression of a friendly and energetic demeanor. The character appears to be in a joyful mood, possibly greeting someone or expressing excitement.
- After (Fine-tuned LLaVA):
- User: Describe this image.
- Model: a cartoon pikachu flying through the air
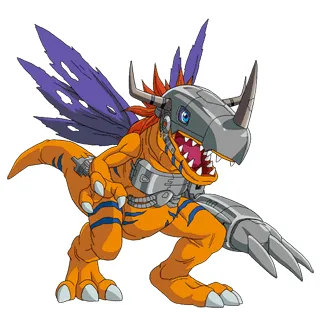
이 친구는 학습데이터에 없던 디지몬 친구이다.
- Before (Pre-trained LLaVA):
- User: Describe this image.
- Model: The image features a cartoon dinosaur with a large, sharp horn on its head. The dinosaur is wearing a metal suit, giving it a futuristic appearance. It has a mouth with sharp teeth, and its body is covered in orange and blue colors. The dinosaur is standing on its hind legs, ready to strike or defend itself. The overall scene is quite dynamic and visually interesting.
- After (Fine-tuned LLaVA):
- User: Describe this image.
- Model: a drawing of a cartoon character with a sword
오! 확실히 내가 넣었던 데이터의 느낌대로 이미지에 대한 설명이 간단해졌다.
결과
사용자의 의도(Intent)에 모델을 정렬(Align)시킨다는 개념을 직접 확인할 수 있었다. 파인튜닝은 단순히 지식을 주입하는 것을 넘어, 모델이 이미지를 보고 사용자가 원하는 방식으로 말하게 만들 수 있다.