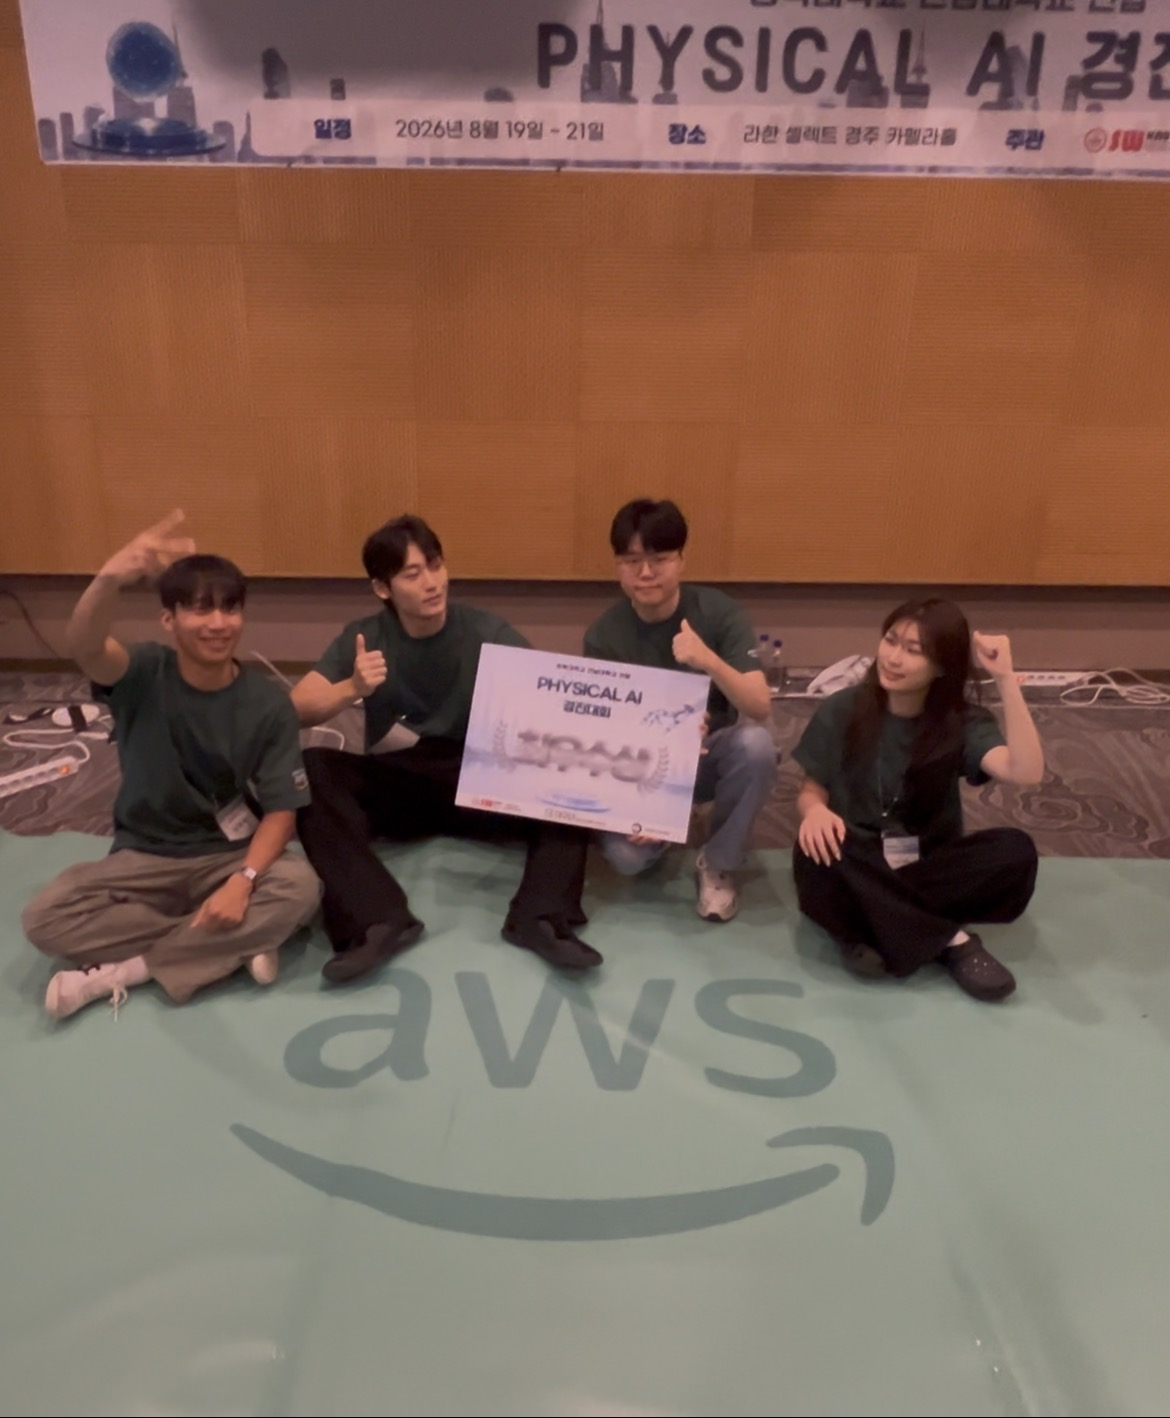
최우수상보다 먼저 남기고 싶은 것
2026년 8월 19일부터 21일까지 2박 3일간 진행한 경북대 × 전남대 Physical AI 경진대회에서
AWS DeepRacer 과제로 최우수상을 받았다.
결과만 적으면 “빠른 모델을 만들어 상을 받았다”로 끝날 수 있다. 하지만 이번
대회에서 더 오래 남기고 싶은 것은 가장 빠르다고 믿었던 모델이 실차에서 가장
먼저 실패했고, 그 실패를 해석하면서 전략을 완전히 바꾼 과정이다.
시뮬레이터에서 이론적으로 최적인 경로는 실제 차에서 최적이 아니었다. 실제
환경에서는 짧은 경로보다 카메라 지연을 흡수할 여유, 노면과 배터리 변화에 대한
안정성, 그리고 빠르게 반복할 수 있는 튜닝 방법이 더 중요했다.
한 번의 실험에 2시간 30분이 걸렸다
가장 큰 제약은 학습 시간이었다. 모델 하나를 학습하고 평가한 뒤 실차에서 확인할
때까지 약 2시간 30분이 필요했다. 하나의 모델을 만들고, 결과를 본 다음, 다시
조금 고치는 순차적인 방식으로는 하루에 몇 번밖에 실험할 수 없었다.
그래서 처음부터 가설을 넓게 벌렸다. 최적 궤적, 곡률 기반 감가속, 중앙선 추종,
조향 변화 억제처럼 성격이 다른 가설 10개를 세우고 약 50개 모델을 병렬로
검증했다. 그중 살아남은 후보 다섯 개만 추가 학습과 실차 테스트 대상으로
좁혔다.
서로 다른 실패 방식을 가진 모델을 동시에 확보했기 때문에, 한 접근이 실차에서
무너졌을 때 다른 가설로 바로 전환할 수 있었다.
첫 번째 승자는 좌표 기반 최적 경로였다
첫 접근은 절대 좌표를 이용한 레이싱 라인이었다. 트랙 구조가 이미 주어졌다면
차가 시행착오로 모든 길을 탐색하게 하는 것보다 이동거리가 짧고 코너 반경이 큰
경로를 먼저 계산해 주는 편이 효율적이라고 판단했다.
A to Z Speedway의 센터라인 웨이포인트를 바탕으로 계산한 경로는 길이가
16.635m에서 15.409m로 약 7.4% 짧아졌다. 목표 좌표와 목표 속도를 보상 함수에
넣어 그 경로에 가까울수록 높은 점수를 주었다.
가상 환경에서는 예상이 맞았다. 좌표와 목표 속도를 함께 사용한 모델은 탈선 없이
안정적으로 수렴했고, 훈련 과정에서는 6초대 기록까지 나왔다. 평가에서도 좌표
모델이 중앙선 기반 모델보다 빨랐다. 이때까지만 해도 최종 모델은 이미 정해졌다고
생각했다.
시뮬레이터 6초대 모델이 실차에서 이탈했다
실차 결과는 정반대였다. 좌표 기반 모델은 코너에서 계속 트랙 반대쪽으로
이탈했다. 반면 시뮬레이터 기록이 상대적으로 느렸던 중앙선 추종 모델은 실제
트랙을 안정적으로 완주했다.
처음에는 학습 시간이 부족했거나 조향각이 작아서라고 의심했다. 하지만 좌표
모델은 가상 평가에서 탈선이 없고 랩타임 편차도 작았다. 학습이 덜 된 정책이라면
시뮬레이터에서도 먼저 흔들렸어야 했다. 문제는 수렴 여부가 아니라 시뮬레이터와
현실 사이의 차이, 즉 Sim2Real 격차였다.
좌표 보상은 자동차가 현재 트랙의 어느 지점에 있는지 알아내고 안쪽 경로에
붙도록 요구한다. 하지만 카메라 한 대만 사용하는 모델이 가상 환경에서 그 위치를
구분하려면 배경과 텍스처 같은 시뮬레이터 고유 단서를 외우기 쉽다. 실제 트랙에는
그 단서가 없었다.
18cm의 여유와 100ms 동안의 20cm
계산된 최적 경로와 흰 선 사이의 최소 여유는 약 18cm였다. 지연이 없는
시뮬레이터에서는 충분해 보이는 거리였다.
하지만 자동차가 2.0m/s로 달릴 때 카메라 인식과 조향 사이에 100ms의 지연이
생기면, 판단이 반영되기 전까지 이미 20cm를 더 이동한다. 18cm의 여유보다 지연
중 이동거리가 더 길다. 코너 안쪽을 노린 정책이 늦게 꺾으면 바깥으로 밀려날
수밖에 없었다.
반면 센터라인의 여유는 약 44cm였다. 최단거리는 아니지만 지연과 오차를 흡수할
공간이 있었다.
| 구분 | 거리 | 의미 |
|---|---|---|
| 최적 경로의 최소 여유 | 18cm | 지연 중 이동거리보다 짧음 |
| 100ms 동안 이동거리 | 20cm | 최적 경로의 여유를 초과 |
| 센터라인의 여유 | 44cm | 지연과 오차를 흡수할 공간 확보 |
이론적인 최적 경로는 지연이 없는 세계에서만 최적이었다.
좌표를 버리고 중앙선으로 돌아오다
최종 모델에서는 좌표를 한 줄도 사용하지 않았다. 트랙 폭 대비 중앙선에서 얼마나
벗어났는지와 조향이 얼마나 급격하게 변하는지만 보았다. 절대 위치 대신 카메라가
실차에서도 동일하게 관찰할 수 있는 상대적인 단서를 사용했다.
액션 공간도 실차 관측에 맞췄다. 코너를 더 잘 돌게 하려고 25도와 30도 조향을
시도했지만, 큰 조향각에서는 바퀴가 헛돌았고 직선에서도 좌우로 흔들렸다. 최종
조향은 ±20도로 제한하고 큰 조향에서는 속도를 낮추고 직진에서는 속도를 높였다.
더 많은 선택지를 주는 것이 항상 더 좋은 정책으로 이어지지는 않았다. 실제로
전이되는 입력과 차가 물리적으로 실행할 수 있는 행동만 남기는 것이 더 강했다.
학습 밖의 손잡이: 스로틀과 출발 위치
최종 후보가 정해진 뒤에는 재학습보다 빠르게 반복할 수 있는 변수를 찾았다.
스로틀 배율은 즉시 바꿀 수 있었고 한 번의 주행은 수십 초면 끝났다. 같은 모델에서
배율을 2% 단위로 올리며 이탈하지 않는 경계선을 찾았다.
장소를 옮기자 같은 배율에서도 실제 속도가 달라졌다. 노면 마찰과 배터리 상태가
바뀌면 이전 장소의 숫자를 그대로 재사용할 수 없었다. 그래서 최종 주행에서는
배율 하나로 전체 랩을 묶지 않았다. 직선에서는 75%, 코너 진입 전에는 62%로
낮추고, 코너를 통과하면 다시 75%로 올렸다. 출발 위치도 뒤로 옮겨 직선에서
가속할 거리를 확보했다.
학습이 병목일 때 성능을 올리는 방법이 반드시 추가 학습인 것은 아니었다.
모델 밖에서 초 단위로 반복할 수 있는 손잡이를 찾는 것이 더 높은 기대값을 만들었다.
최우수상, 그리고 다시 한다면
결국 좌표 기반 최단 경로가 아니라 중앙선 기반의 안정적인 모델을 선택했고,
실차에서 속도와 조향을 다시 맞춘 전략으로 최우수상을 받았다.
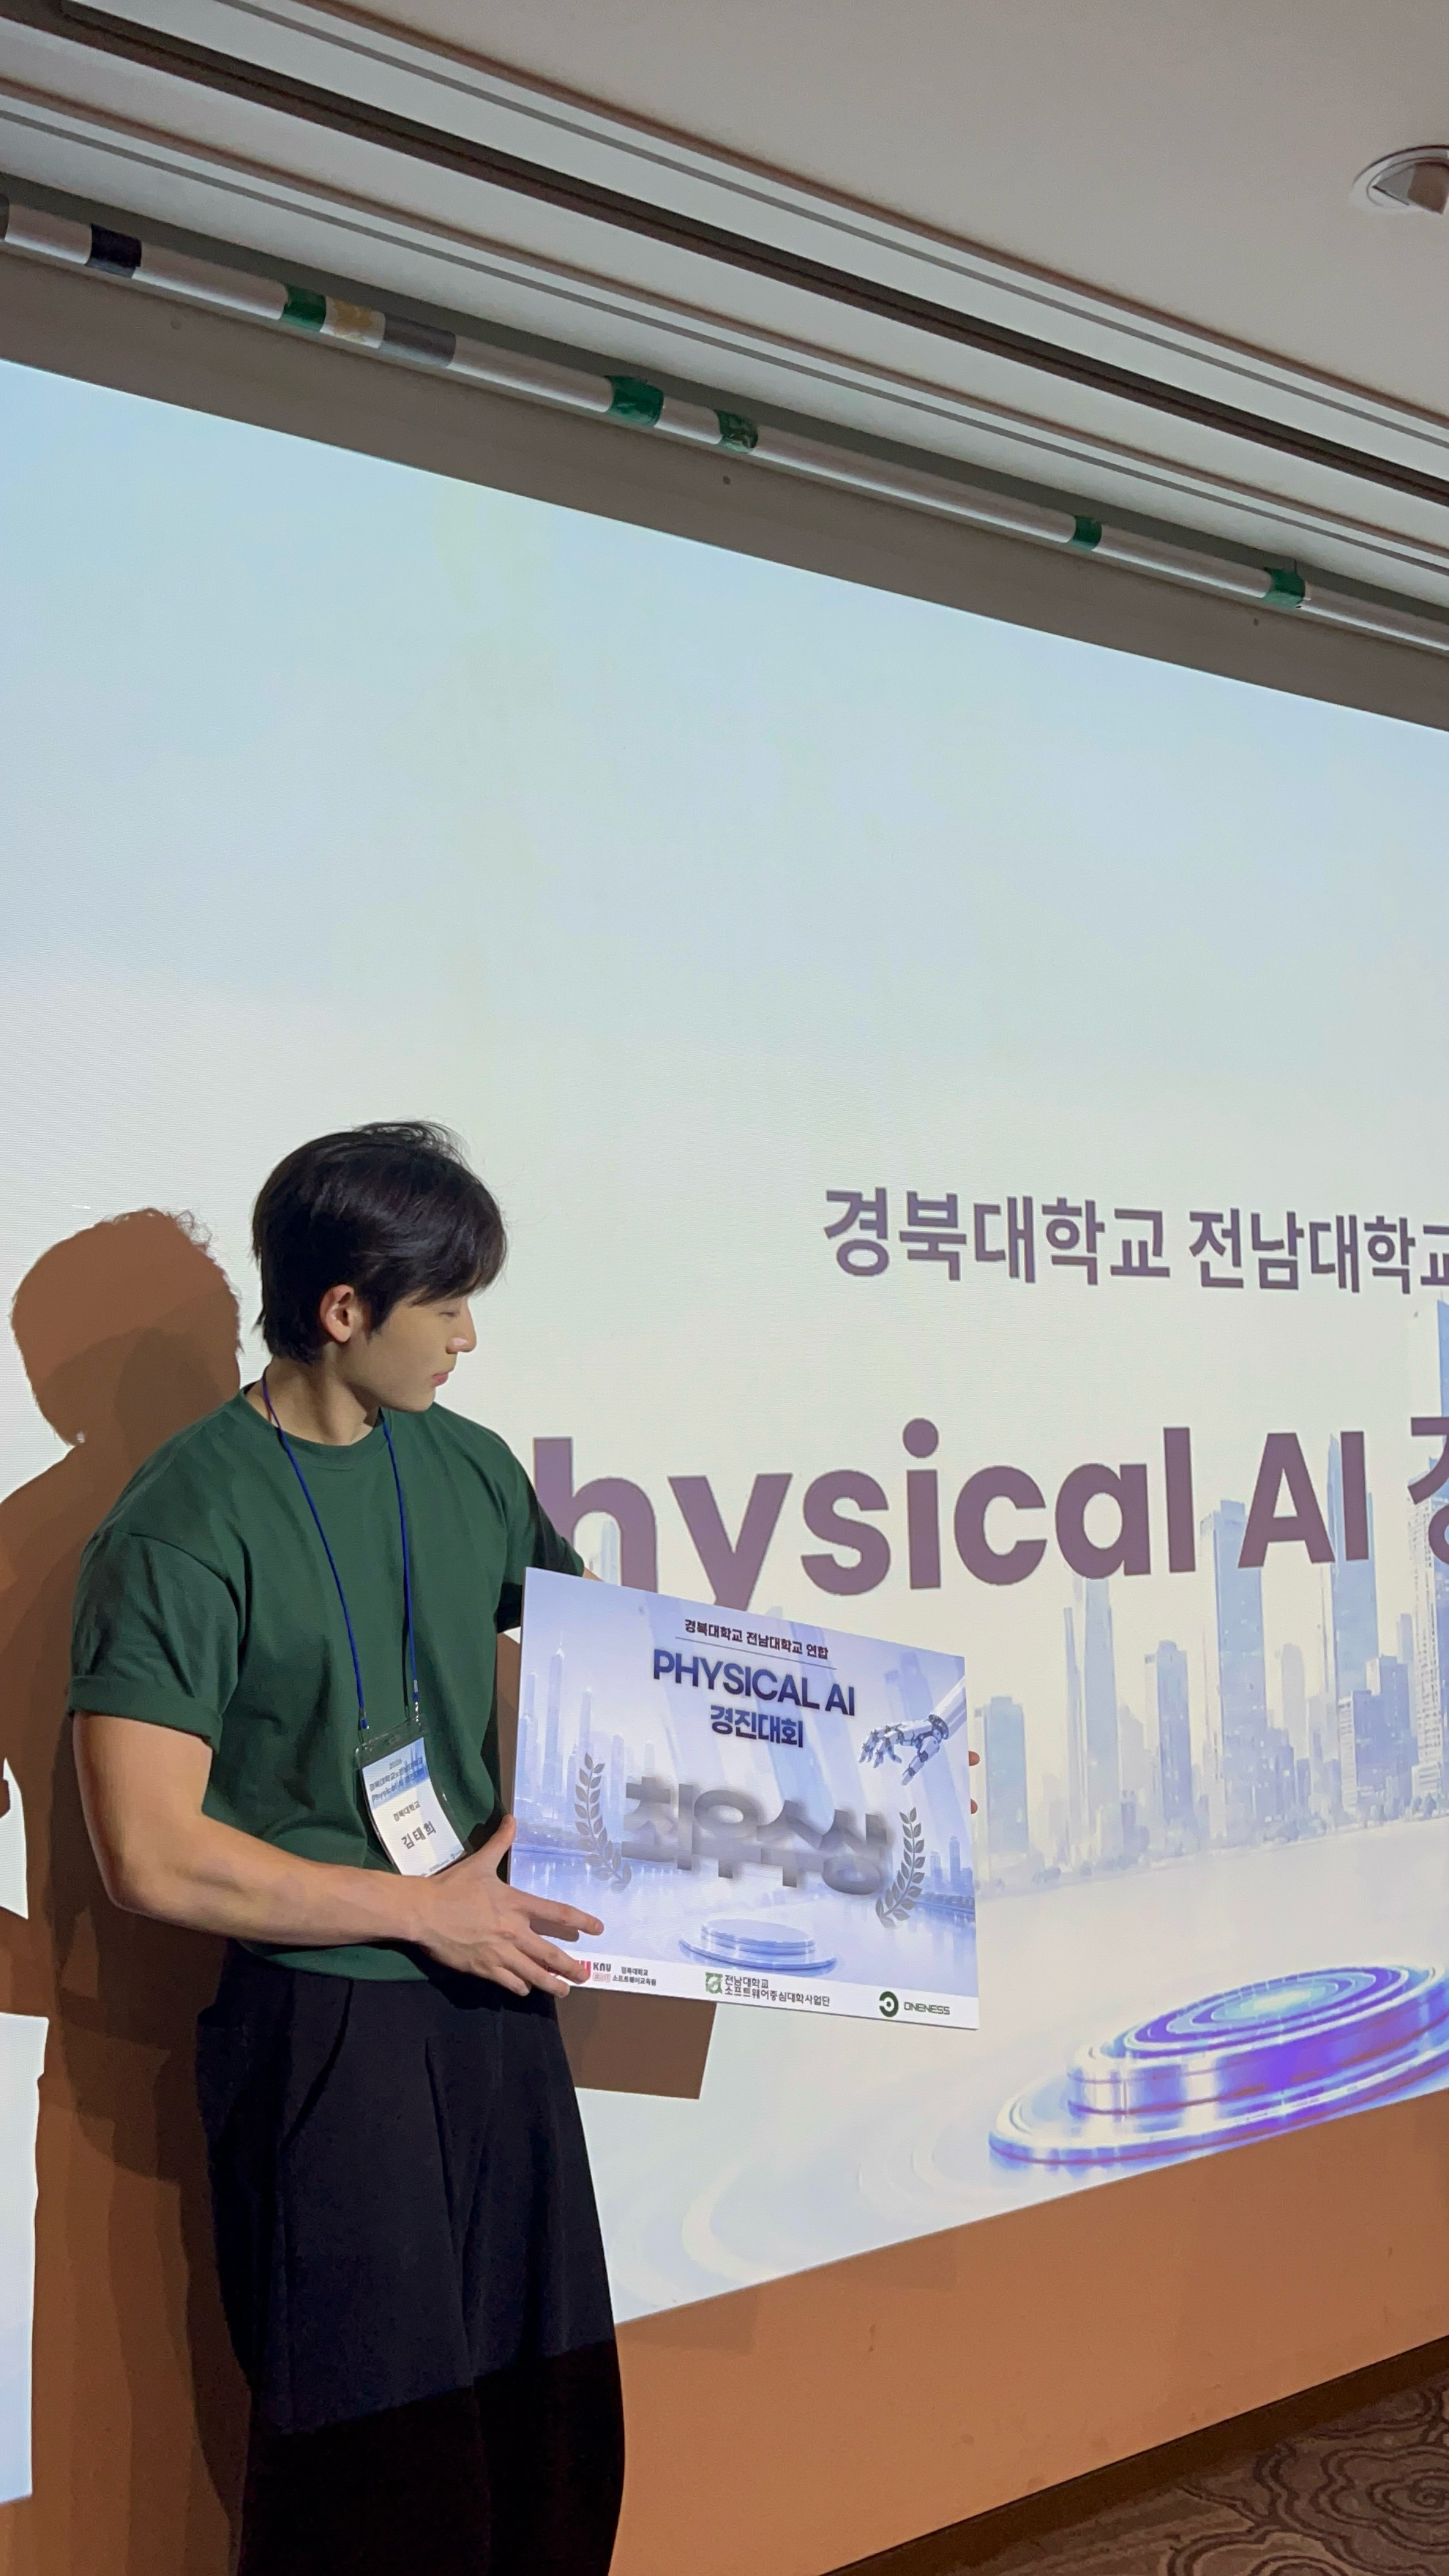
다시 한다면 다음 원칙을 가장 먼저 적용할 것이다.
- 트랙 방향을 기본값에 맡기지 않고 학습 전에 확인한다.
- 시뮬레이터 순위를 실차 순위로 해석하지 않는다.
- 절대 좌표보다 실제 센서에서도 유지되는 상대적 단서를 우선한다.
지연 × 속도보다 큰 여유폭을 확보한다.- 학습 시간이 병목이면 가설을 벌려 병렬로 검증한다.
- 스로틀, 출발 위치, 구간 제어처럼 학습 밖에서 빠르게 반복할 변수를 찾는다.
이번 수상의 핵심은 처음부터 정답을 맞힌 것이 아니었다. 서로 다른 가설을
준비했고, 가장 유력한 가설이 현실에서 실패했을 때 그 이유를 수치로 설명한 뒤
다른 접근으로 전환할 수 있었던 점이었다.
실험 기록과 코드
보상 함수, 모델별 평가 결과, 실차 스로틀 튜닝 기록과 실패 원인은 아래 공개
저장소에 정리했다.
단순히 우승 모델의 코드만 남기기보다, 시뮬레이터에서 잘되던 접근이 왜 실차에서
실패했는지와 어떤 판단을 거쳐 최종 모델을 선택했는지를 함께 기록했다.