문제 요약
단어 배열을 #로 구분한 하나의 문자열 s로 인코딩한다.
각 단어는 s의 어떤 위치에서 읽기 시작해 다음 #까지 읽은 문자열과 같아야 한다.
가능한 s 중 가장 짧은 길이를 구한다.
핵심 아이디어
다른 단어의 접미사인 단어는 따로 적을 필요가 없다.
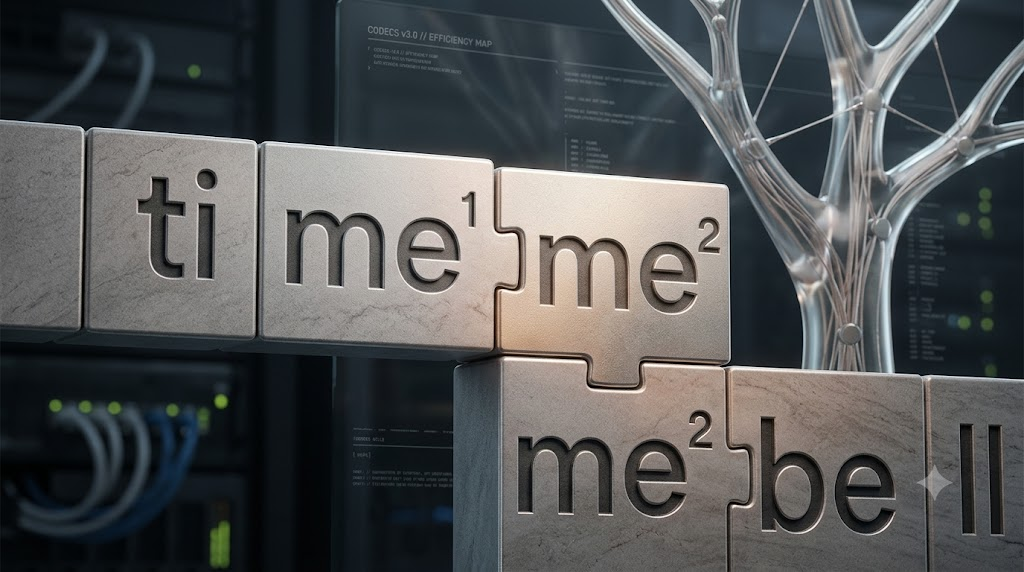
["time", "me", "bell"]
- 전부 붙이면
time#me#bell#(13) me는time의 접미사라서time#의 2번 위치부터 읽으면me가 된다- 따라서
time#bell#(10)
읽기가 #에서 끝나기 때문에 공유할 수 있는 건 끝부분(접미사)뿐이다.
ti는 time 안에 있어도 뒤에 #가 없어서 공유할 수 없다.
즉 답은 다른 단어의 접미사가 아닌 단어들의 길이 + 1 합이다.
풀이
- 모든 단어를 Set에 넣는다 (중복 제거)
- 각 단어의 자기 자신을 제외한 접미사를 Set에서 지운다
- 남은 단어마다
길이 + 1을 더한다
function minimumLengthEncoding(words: string[]): number {
    const wordSet = new Set<string>(words);

    for (const word of wordSet) {
        for (let i = 1; i < word.length; i++) wordSet.delete(word.slice(i));
    }

    const encodeLen = [...wordSet].reduce((acc, cur) => acc + cur.length + 1, 0);
    return encodeLen;
};
복잡도
- 시간: O(N · L²) (N = 단어 수, L = 단어 최대 길이,
slice비용 포함) - 공간: O(N · L)
L ≤ 7이라 사실상 O(N)이다. 그래서 트라이 없이 Set만으로 충분하다.
정리
#로 끝나는 구조라서 공유되는 건 접미사뿐이다- 접미사를 지우고 남은 단어만 세면 된다
- 단어 길이 제한이 작으면 트라이 대신 Set으로 접미사를 직접 지우는 편이 간단하다
내 지식을 공유할 수 있는 대담함