프로그래머스_알고리즘
1.해시 : 프로그래머스 - 위장
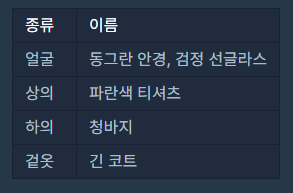
: 어떻게 하지 어떻게 하지 하다가, 일단 노트에다가 \-> 23개가 나온다. 1번 예제를 표로 그려보면 : 사용안한다라는 표현을 + 1 추가하는 방식으로 생각을 해볼수 있다.그렇다면 head에는 사용안함, "yellowhat","green_turban"그러면 eye에
2.dp : 프로그래머스 - 가장 큰 정사각형
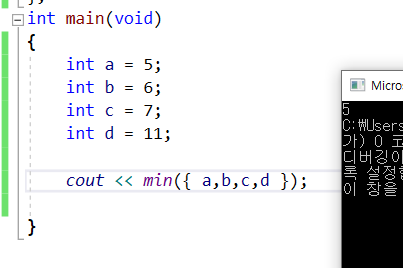
1) 처음에는 정사각형이니까 우측 하단부가 1일 경우에 상하좌우를 일일 확인하는 방식으로 하려고 했는데, 정사각형이 클수록 효율이 좋지 않아지므로 이건 아니다 싶음2) 정사각형을 작게 만들어보면서 생각해보면 다이나믹 프로그래밍으로 접근하면 풀수 있다고 생각함. 2by
3.프로그래머스 - 기능개발
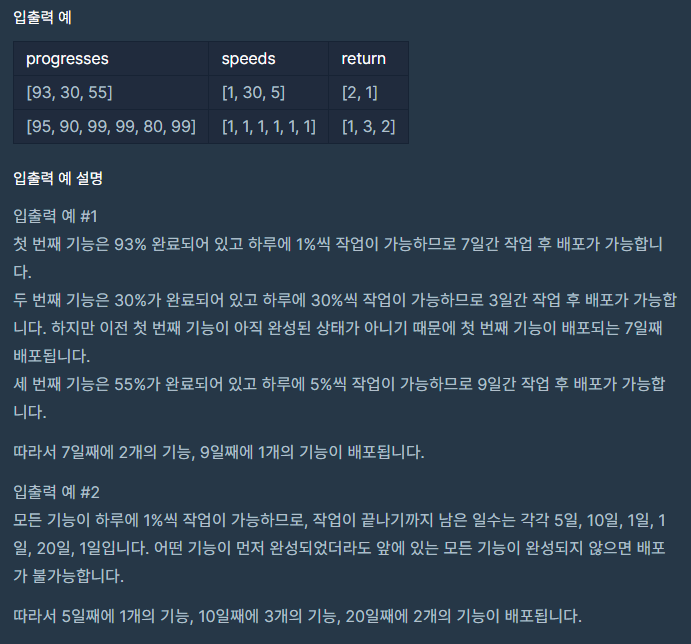
입출력 1번에서는 7 - 3 - 9 일작업순 이고 입출력 2번에서는 5 - 10 - 1 - 1 - 20 - 1 일작업순이다 .규칙성을 찾을 수 있다. 1번의 결과는 2 - 1 이고2번의 결과는 1 - 3 - 2 이다. 7번을 가지고 마지막 인덱스까지 비교하면서 큰 값이
4.프로그래머스 - 프린터

문제를 읽어보면, priority가 가장 큰 친구부터 빼야되는 것을 확인할 수 있다.1) 2,1,3,2 에서 제일 큰 친구가 3이므로 맨 앞의 친구 2를 빼서 꼬리에다가 추가를 해야한다. -> queue stl을 사용하면 되겟다. 라고 생각함.2) 우선 순위가 가장
5.(한줄 한줄 생각)다리를 지나는 트럭
먼저 들어간 친구가 먼저 나오는 방식이어서 큐를 사용해야겠다고 생각함.대키 트럭과 카운트값을 pair형식으로 가지고 진행하면서 카운트값이 bridge_length가 되면 pop하는 방식으로 진행하려고 했다. pair로 가지고 있으려면 vector를 사용한다. 문제점으로
6.프로그래머스 - 완주하지 못한 선수
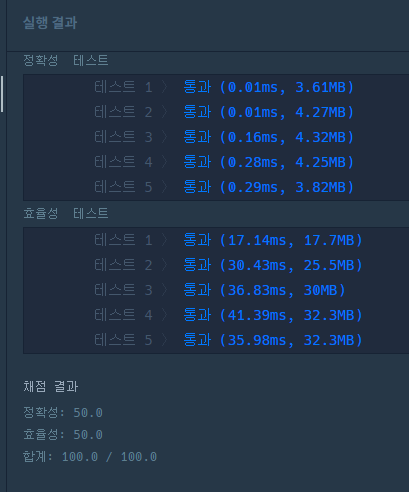
문제를 읽어보면 참가자 - 완주한 사람으로 이루어짐.낙오자가 단 한명만 있다고 한다.중복됨=> unordered_map으로 풀이하면 된다고 생각함.unordered_map<string, int>man;
7.(중요_sort + set 비용문제)전화번호 목록
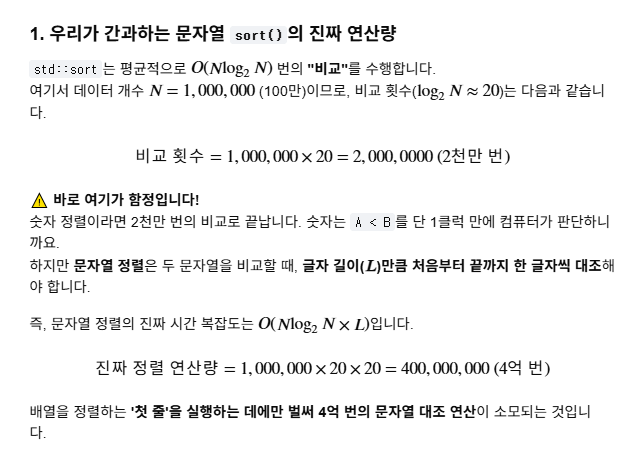
phone_book이라는 컨테이너에 전화번호를 저장 , 중복 처리 안됨.문제를 보면 접두어가 다른 목록에 있다면 false를 리턴하고,만약에 다른 목록 중에 접두어가 없다면 true라고 한다. => 찾는 문제다. 그리고 제한사항으로 phone_book에는 1 ~ 100
8.프로그래머스 - 베스트 앨범.
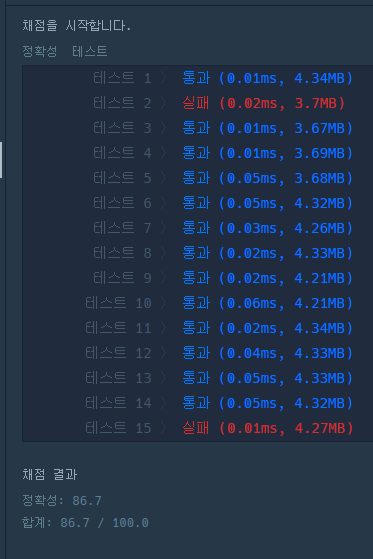
: first 값만으로 정렬이 가능하므로, multimap으로 풀경우 머리 아파진다...
9.프로그래머스 - k번째 수
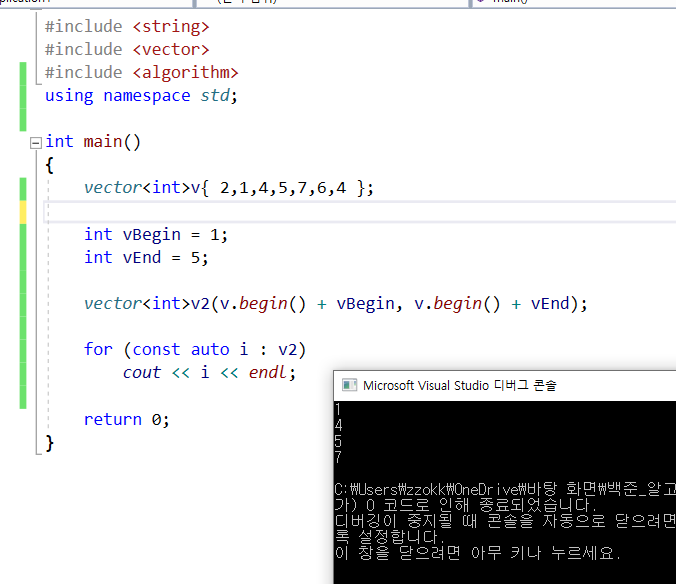
vectorv(v1.begin(), v1.end()) 이렇게 복사를 해왔다.그래서 index값을 넣을수 있지 않을까 생각했는데 안된다.벡터 초기화 : 이런식으로 가능하다. 하지만 + 1을 더 진행해야 한다. sort(v.begin(), v.end()) 이런식으로 했다.
10.프로그래머스 - 정렬
정렬을 해야하므로 생각할 수 있는 점으로 원소 2개를 이용한다는 것을 캐치해야 한다. 예를 들어 6 vs 2 일때62 vs 26을 비교한다
11.프로그래머스 - hIndex
\-> 코드 실행은 맞았다. 다른방법으로 접근하자.
12.프로그래머스 - 더 맵게
https://velog.io/@kwt0124/%EC%9A%B0%EC%84%A0%EC%88%9C%EC%9C%84%ED%81%90가장 작은 친구 + 그 다음 친구 \* 2를 추가해야 한고예외처리로 진행 중, 2번째 친구를 추출해야 하는데 추출못하는 상황즉, 첫번
13.프로그래머스 - 모의고사
수포자 3명의 규칙성을 찾고, 벡터로 도식화하자 문제랑 수포자 3명의 답안 이랑 비교해야 하므로 2차원 for문 을 사용해야 함.수포자 3명의 답안이 마지막번 다음에 첫번째로 복귀해 하므로 이부분을 주의 깊게 생각해보자 \-> 나머지를 이용하면 첫번째 답안으로 복귀 가
14.소수찾기
아래의 코드는 순열로 작성한 코드이지만, 나는 조합으로 해야 겠다는 생각을 함. 그런데 왜 순열로도 가능하냐면? : string을 순열로 뺑뺑이 돌리면서 문자열에 한자씩 더하고 있는 상황이기 때문에 , 더하고 나서 소수 찾기를 하면 되기 때문에 순열로도 풀 수가 있
15.프로그래머스 - 카펫
테두리의 갈색은 한줄이다. 가로의 길이는 세로보다 크거나 같다. 문제를 읽고 그림을 그려보면서 공통점을 찾아보면 일단 (yellow의 가로 2) + (yellow의 세로 2) + 4 => brown의 갯수라는 것을 찾을 수 있다. yellow의 개수만을 이용한 경우
16.(중요!)체육복_상태 알고리즘
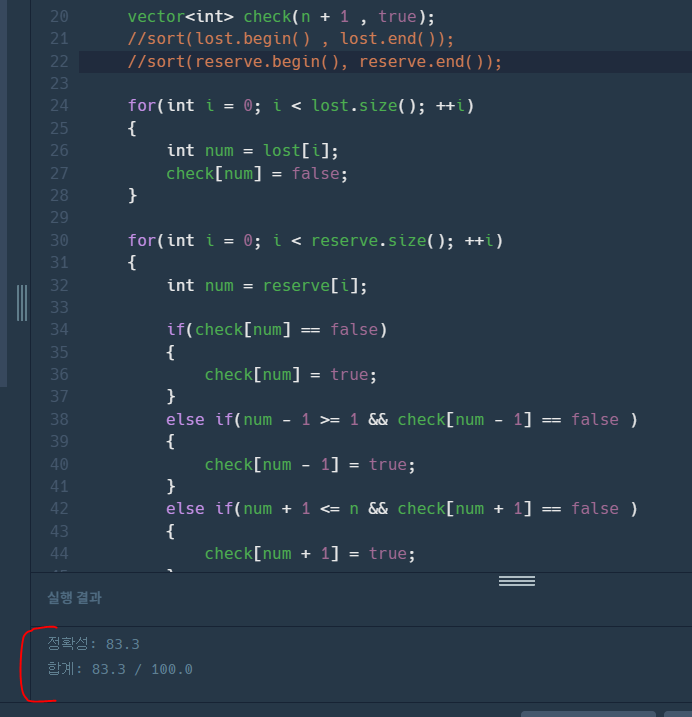
중복 없고, 두개의 값이 있어서 unordered_map으로 접근하려고 햇다. 앞뒤 인덱스를 확인해야 하므로\-> 인덱스 접근을 해야했다. unordered_map 접근 잘못 되었다.vector<pair<int,int>> 로도 접근 해볼까? 라는 생각도 함.
17.조이스틱
조이스틱
18.구명보트_틀림
1번 : 문제를 보고 처음 들었떤 생각은 가장 큰 친구와 가장 작은 친구의 합이 limit보다 작거나 같다면 최소비용으로 구조할수 있다고 생각했다.\-> 일단 sort 시키자.한번 생각할 점이... 만약에 20,40,40,60,80 이 있다면 limit은 가장 큰 친구
19.프로그래머스 - 정수삼각형
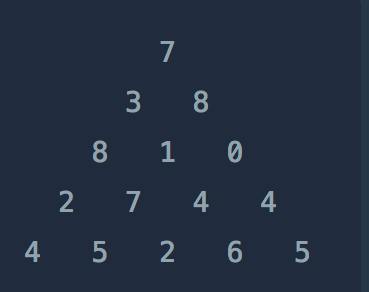
문제를 보면 대각선 왼쪽, 오른쪽 아래로 향하면서 가장 큰값을 출력해는 문제이다. 처음 생각으로는 아래를 보았을때 가장 큰 친구를 뽑아서 진행할까?라는 생각을 했지만,,,, 추후를 생각했을때 문제가 될 소지가 있는 생각이다.왜냐하면 8을 선택했다면... 7-3-8 이
20.프로그래머스 - 타켓 넘버
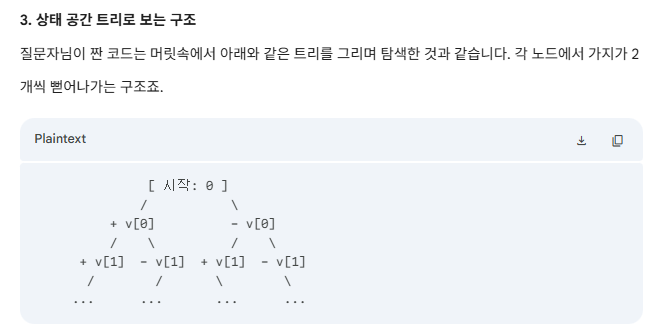
dfs를 이용해서 함수안에서 + 와 - 를 이용해 인덱스값을 이용해야 겠다고 생각했다.: 매개변수로 인덱스의 갯수를 증가하고, sum에 누적하는 방식으로 진행하고자함. 그런데 복귀해서 - 값 연산을 해야한다. \-> 문제점이 무엇이냐면... 전위 증감연산을 함으로써 i
21.프로그래머스 - 네트워크
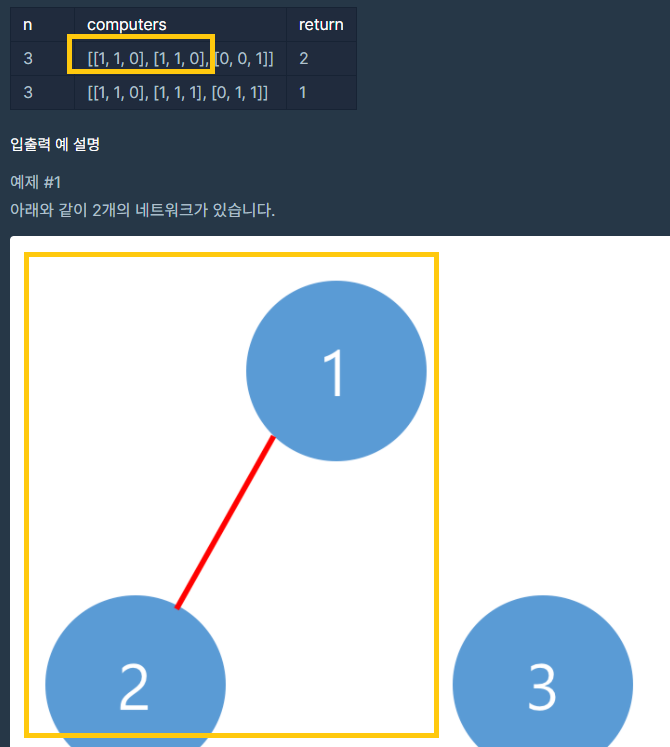
인덱스 번호 증가함에 따라 1이 포함된 값을 큐에 집어 넣고, 바로 옆에 붙어 잇는 친구들을 탐색하는 것이므로 bfs로 풀어야 겟다고 생각햇다.solution에다가 바로 작성하면 되지 않을까 생각을 했는데, 연결이 안되어 있는 친구들 접근을 못하므로, 바깥으로 뺀후,
22.bfs로 푼 : 프로그래머스 - 단어변환
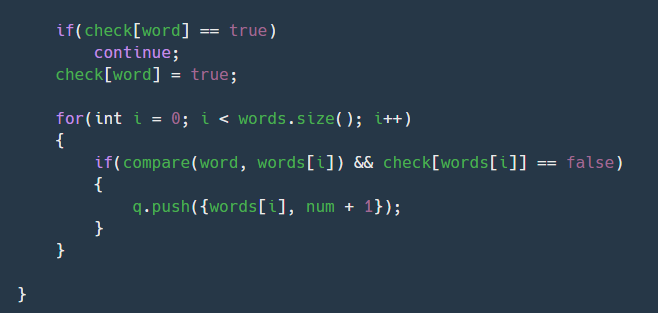
최소거리를 구하는 것이므로 bfs로 접근하는 것이 빠르다. 어떻게 bfs로 접근할지에 대해 고민해봐야 하는 문제다. 가. hot - dot - dog- log - cog나. hot - dot - dog - cog다. hot - lot - log - cog이런방식으로 접
23.프로그래머스 - 등굣길
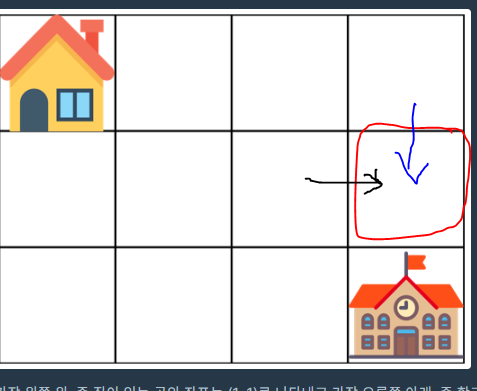
1) 일단 기존의 좌표체계가 뒤집어졌다. 이것을 염두에 두고 풀어야한다. 우리의 좌표체계에 맞게 설계해야 한다. : 학교의 위치가 (4,3) 이라고 하는데, 우리의 좌표체계로는 저 부분은 (3,4)일 수 밖에 없다. 2) 놓친점으로는 부등호처리를 못해줬다는 점... :
24.(예전..260515)여행경로_dfs vs 백트래킹
문제에서 모든 도시를 방문해야 한다고 하므로 dfs를 생각할 수 있다. dfs vs bfs dfs : 모든 정점을 방문해야 한다. , 집합을 표현할때 사용한다. bfs : 모든 정점을 방문할 필요는 없다. , 최단 거리 구할때 사용한다.
25.프로그래머스 - 방문길이
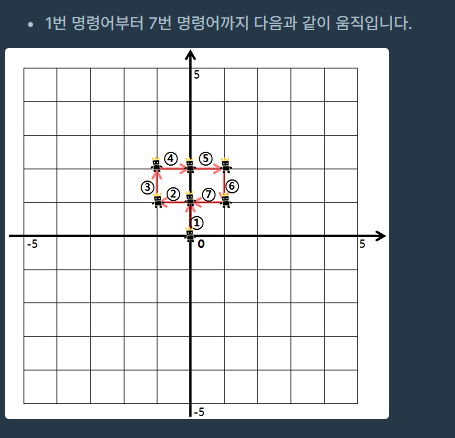
tuple을 활용하자. //헤더가 필요하다. 예외처리 중요하다.
26.프로그래머스 - 베스트 앨범
mapping을 이용해 <string, int> : 동일한 string에서의 합계를 구한 후 reverse 하자. reverse 상태에서 내림차순으로 만든 다음에 가장 큰 친구의 string을 뽑아서 전체 컨테이너 중에서 가장 plays 높은 두명의 친구를 뽑아서
27.이분탐색 : 프로그래머스 - 입국 심사.
소스코드
28.bfs : 프로그래머스 - 게임맵 최단거리
x값은 second값이고, y값은 first값이다. 그리고 x값은 가로의 총길이를 나타내고,y값은 세로를 나타낸다. vector<vector>v에서 v.size()는 세로의 길이고, v0.size()는 가로의 길이이므로second는 v0.size()와 매칭이 되어
29.(이분탐색 초기값, ll 붙이자)입국 심사
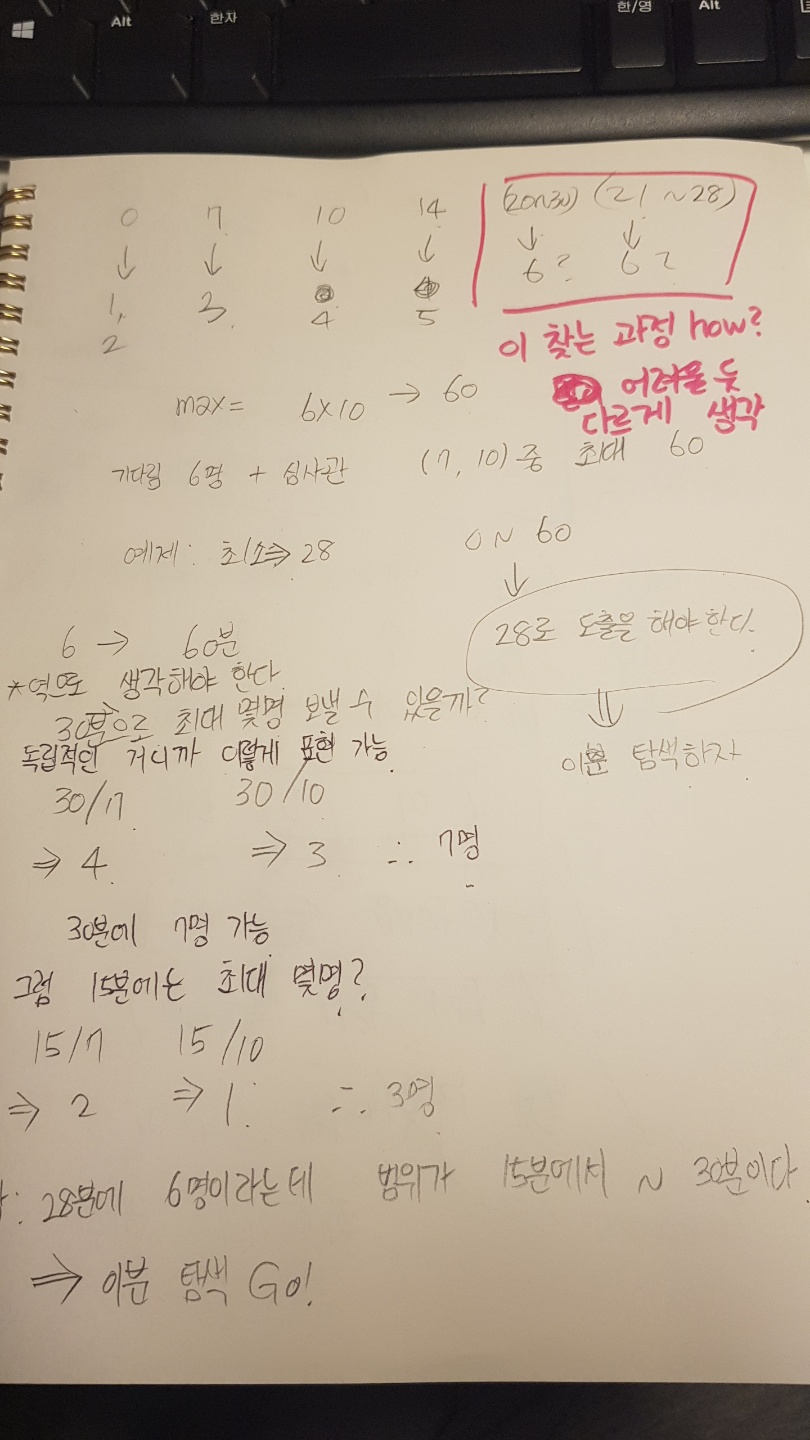
느낀점 : 왜 이분탐색인가? 어떻게 접근할 것인가???? 모든 사람이 입국심사 거치는데 걸리는 시간의 최소값을 구하는 문제이다. 맨 처음에 노트로 그림을 그렸을때는 30초가 걸리지 않을까? 생각을 했지만,,, 입출력 설명에서 1분을 더 기다리면 가능하다고 했다. 여
30.(260728 )n으로 표현
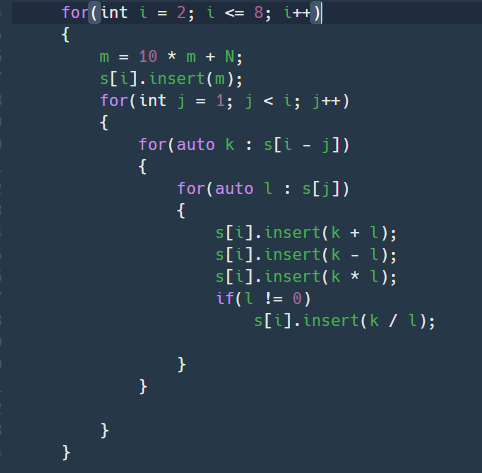
소스코드
31.(틀림_원형 dp 중요!) 도둑질
https://chosh95.tistory.com/371
32.bfs : 프로그래머스 - 가장 먼 노드
최단 경로를 구하는 것인데 , 단순히 노드의 연결되어 있는 노드로 접근하는 것이다. \-> bfs로 접근하자 .원소의 갯수를 얻어야 하므로 lower_bound를 사용하자.
33.프로그래머스 - 좌석 구매 : 스쿨에 있는 문제
map의 key값을 pair값으로 사용하기
34.백트래킹 : 프로그래머스 단어 변환
백트래킹으로 풀어보았다!
35.괄호 회전하기
: 스택과 큐를 사용했다.내가 몰랐던부분은 queue q;q.push('b');q.push('o');q.push('m');q.push('i');queue<char q2 = q1; 을 하게 되면 q2에 bomi가 들어있다는 것이다.
36.귤 고르기
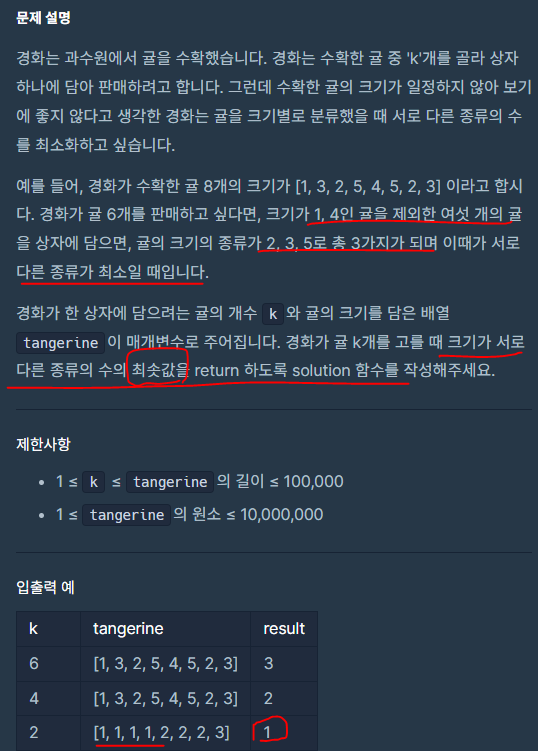
문제를 읽어보면, 카운팅 수가 가장 많은 거를 먼저 처리할 때야 귤의 종류를 최소화할 수 있다. 그래서 map으로 numbering에 카운팅 넣어놓고,vector에다가 카운팅 : number 저장하고pair<int,int> sortring 헷갈려서 그냥 rever
37.기지국 설치_라인 스위핑
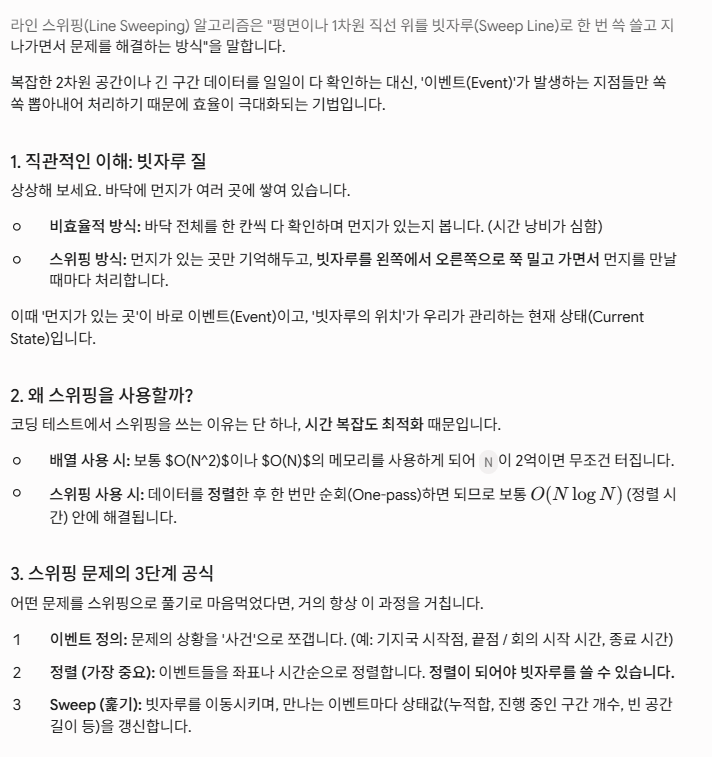
문제 해결전략
38.큰 수 만들기
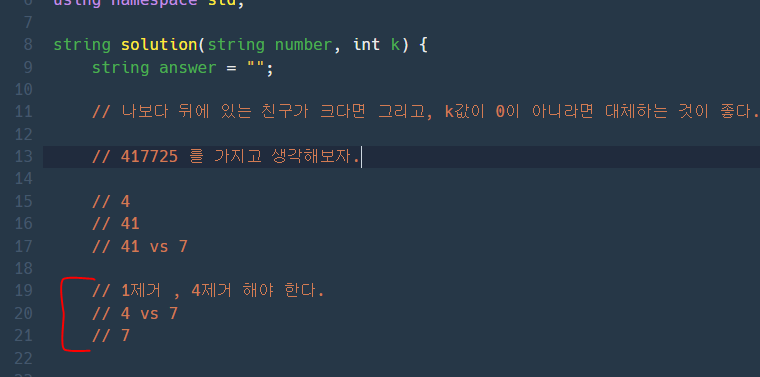
풀이전략 공책에 써나가다가 for문을 돌려볼까? 조합은 아니다. 자릿수를 계속 유지하고 있으므로... 규칙성 발견 > 삽입하기 전에 맨 뒤에 있는 값과 삽입하려는 값을 비교한다. 삽입하려는 값이 더 크다면 back에 있는 것을 pop해야 한다. 이걸 반복문으로 확인해야
39.(✨✨✨✨✨ 별이 다섯개)조이스틱
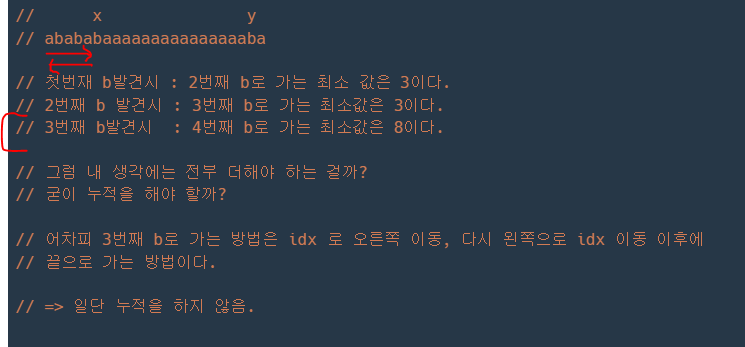
복귀를 해야 하고,나를 대상으로 뒤에 오는 value 중에 'a'가 아닌 값을 대상으로 확인하는 식으로 하면 이전에 오는 알파벳에 대해 생각할 필요 없다.\-> 이미 완료된 상태다. 핵심!빨간색 1번과 2번을 비교하고 있는데, b에 대해서는 생각할 필요가 없다. 나중에
40.(다시 풀자_좌표 변경)교점에 별 만들기
: 뭔가 부족하다.
41.(다시 풀자.)행렬의 곱셈
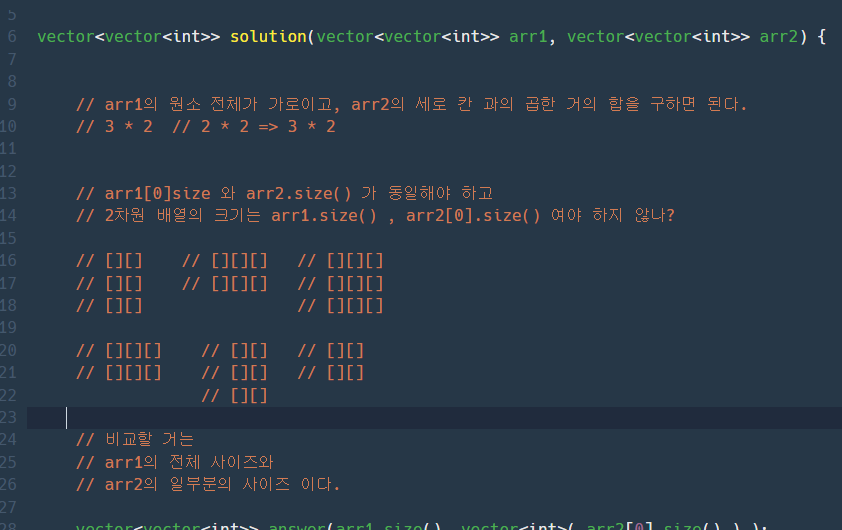
주석을 확인하면 arr1.size 는 세로이고, arr20.size()는 가로 의 길이로 행렬의 곱셈에 해당하는 행렬 크기를 만들 수 있따. 따라서 세로과 가로에 맞는 for문을 작성해야 한다.1) 문제 해결에서 세로는 arr1 전체 크기이고2) rkfhsms arr
42.(복습 필요.)모음사전.
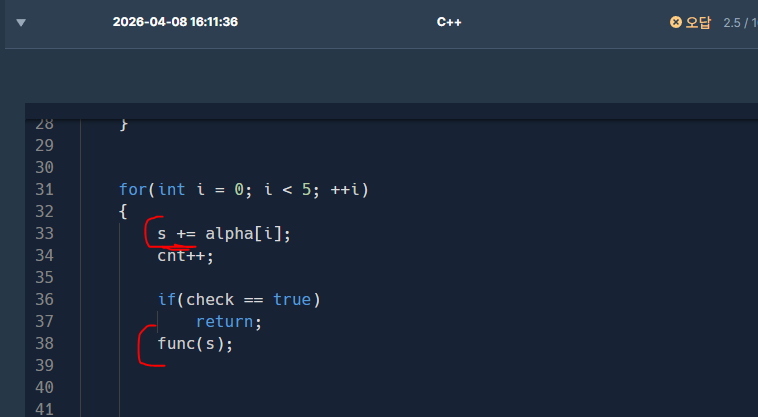
첫번째 풀이 : 틀림 : 누적값으로 비교해서 틀림... 코드를 다시 살펴보면서 뭐가 잘못됬는지를 확인해야 한다. \-> AAAAA 가 마치고 나서 AAAAE가 들어와야 하는데... \-> 가)번 코드를 진행하면 AAAAA 에서 AAAAAE가 되어 버린다. 이러한 상황이
43.하노이 탑._그리고 그리기
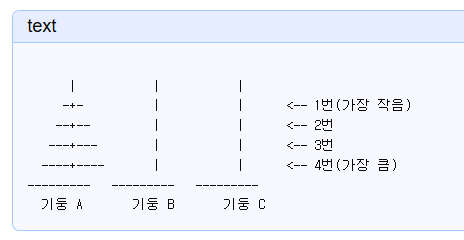
https://school.programmers.co.kr/learn/courses/30/lessons/12946문제를 보고 원판이 4개인 경우를 어떻게 처리할 것인가? 를 주석으로 작성하면서 생각해봤는데. 여기서 모든 과정에 대해서 풀어헤치려고 했다. 어떻게
44.(정말 중요.)불량사용자.
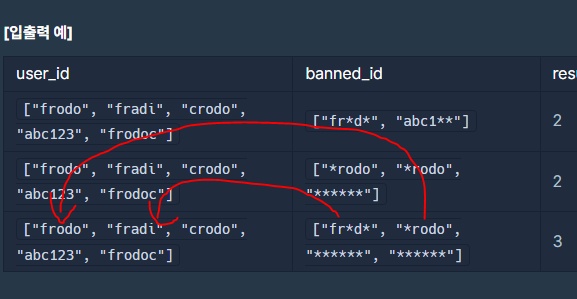
조합으로 생각할 수 있는데, 하지만, 지금의 경우는 user_id와 banned_id 를 비교하면서 중복을 처리하는 문제이다. 조합의 경우에는 앞선 것을 넘어가면 안된다. 그런데 입출력 예제를 보면, banned_id 의 두번째가 먼저 frodo 앞에 있는 것을 탐색하
45.(string 비교는 사전순으로 진행.)문자열 내 마음대로 정렬하기
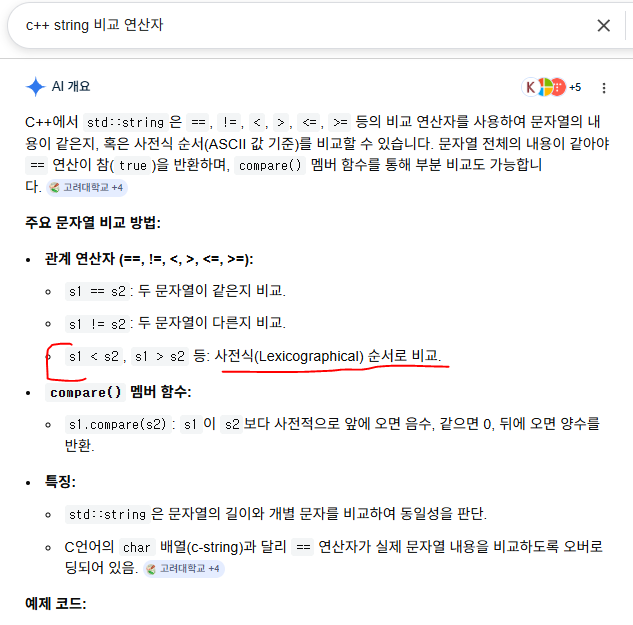
compare 사용자 정의 함수로 진행하다가 idx 인자 뒤부터의 정렬은 어떻게 할까? 고민함.idx가 동일한 경우, 문제에서 사전식으로 정렬해야 한다고 한다.입출력 개념문자열 비교 연산자에서는 사전 순으로 비교한다.
46.<조건을 분리하지 말자.>영어 끝말잇기
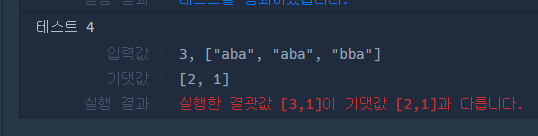
문제를 읽어보면, 1번) 이미 말한 단어를 또 말한 경우2번) 앞뒤가 다른 단어를 말한 경우인데 그래서 나는 편하게 하려고 2개를 분류해서 진행했는데 틀림. \-> 260429 15시에 제출한 내용이고 반례가 있다.2개의 조건을 분리하지 말고, 하나에다가 몰아서 작성해
47.신고 결과 받기.
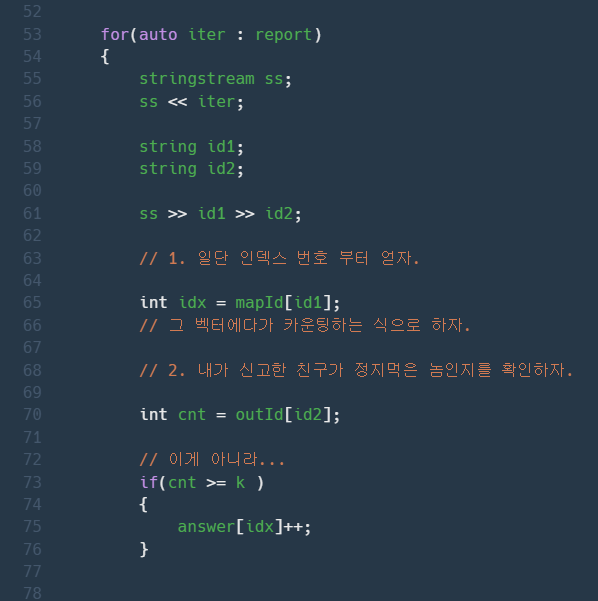
: 코드가 길어지니까. 문제에서 물어보는 요구대로 하지 못했다. 문제에서는 id_list 순서에 따라서 카운팅 값을 출력하라인데, 나는 이것을 망각하고, report 순서대로 for문 돌리면서 하고 있따. \-> 260517 제출한 내용다시 고!
48.(26최신)메뉴 리뉴얼.
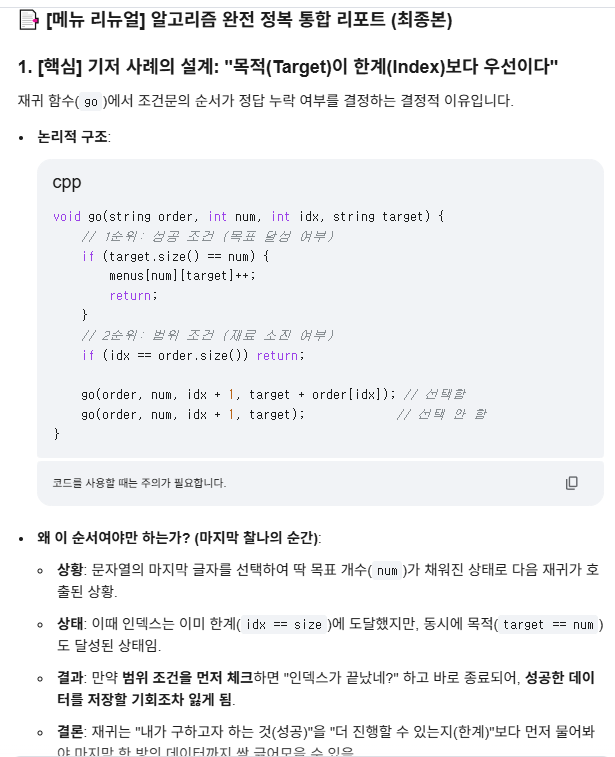
구글링 정리
49.표 편집.
여기에 작성된 해결 전략 복기하고, 놓친 부분이 있따.이것 때문에 그냥 벡터로 하려고 했다. 하지만,,, C를 할 때 시간복잡도가 X에 관계없이 여기서 시간복잡도가 올라간다.
50.섬 연결하기.(백트래킹 한계) <유니온 파인드 어떻게 사용>
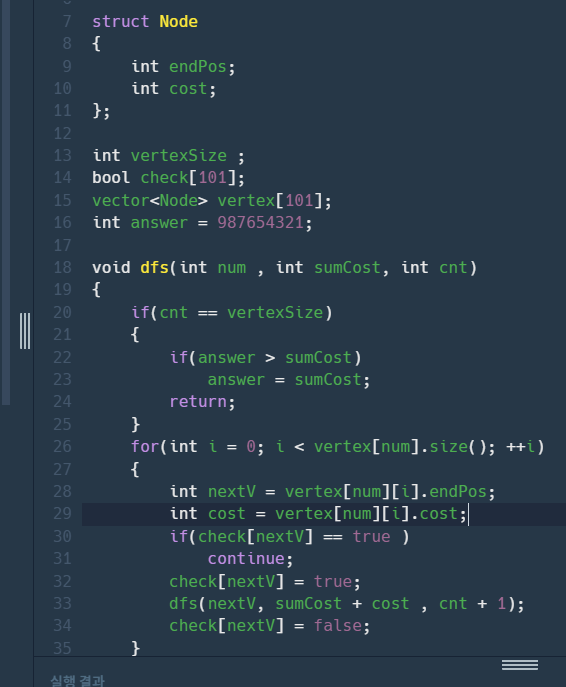
작성한 코드이고, 반례가 있다. : dfs의 한계점 dfs로 한곳만 집중적으로 방문하는데, 아래의 반례 처리 못한다. \-> 부채꼴 형태의 그래프의 경우는 절대 풀 수 없다.실행 결과여행경로의 조건을 보면, 이러한 경우는 없다. 는 것을 증명할 수 있고, 여기서는 df
51.(반례를 통해 전략 검증!)순위
1번째 전ㄹ략 문제에서 순서가 정해져있고, 모순이 없다고 했다. -> 그래서 나의 알고 전략인데, 반례가 있다. 뒤의 등수부터 완료하지 않았는데도 2등이 만들어질수 있다면 어떻게 할건데??? -> 나의 1번째 전략인 하위 등수가 정해지지 않았는데도 2등확정할수 있따. -> 위의 1,2,3,4 반례를 통해서 나의 첫번째 전략은 잘못됨 2번째 전략 문제...
52.(지문 함정카드)미로 탈출.
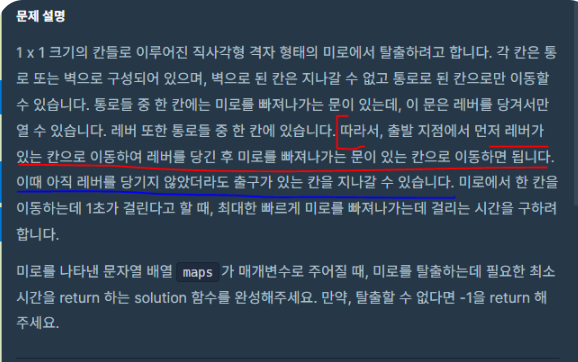
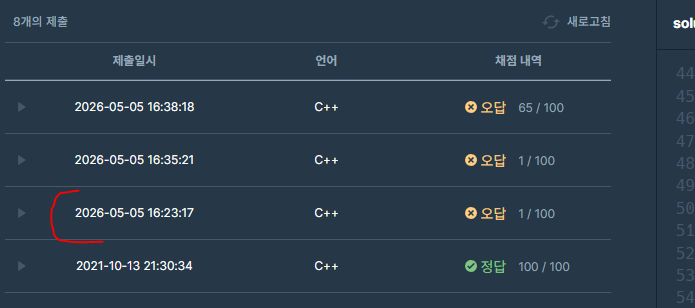
지문 분석을 제멋대로 했다. 1) 레버바를 경유해서 도착지로2) 바로 도착지로 가도 된다. \-> 2개를 가지고 비교했는데. 문제를 제대로 보면? : 출구를 도착하는 것이 아니라, 지나갈수 있따? 라는 내용이 있다. 그리고 제한사항을 읽어보면? : 출구를 여러번 지나갈
53.길 찾기 게임
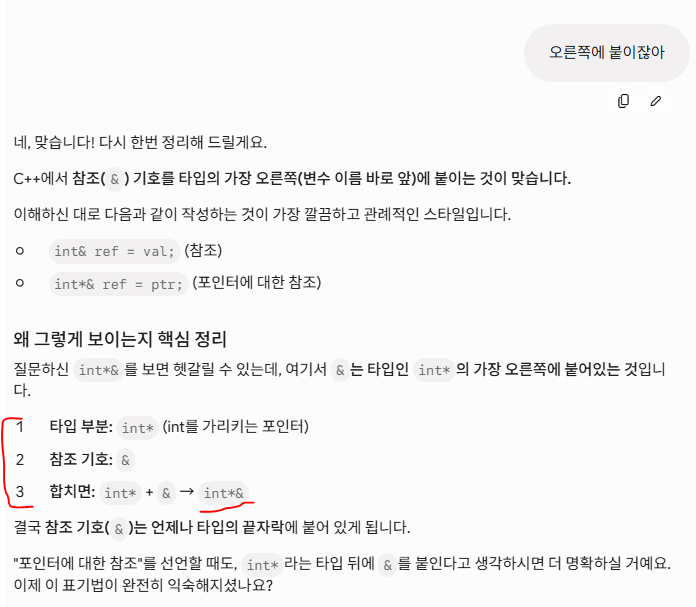
이분탐색 트리의 경우, 편향트리가 만들어 질 수 있다. 생각해보면, 데이터를 정렬한 상태에서 mid 에 있는 값부터 넣게 되면,이분탐색의 성능을 그대로 발휘 할 수 있다. 하지만, 조건이 있따.1.데이터가 정적이어야 함.2\. 정렬한 상태에서 해야 한다. 1 2 3 4
54.배달. - 다익스트라 총 정리.
pq에 넣을 때는 operator 연산자를 만들어주는데, 타입을 반드시 이렇게 const 로 해야 오류 발생하지 않음. 비교 연산자에 대해서 이렇게 하면 오류발생하는데 , pq의 디폴트는 operater
55.(마음가짐.)양궁 대회
appeach 점수는 정해져 있고, rion의 과녁 선택의 모든 경우의 수로 구하면서 최대 diff가 나오게 해야 하므로, => 선택, 선택하지 않는다. 백트래킹으로 감. 92.9점 코드인데 \-> 입력 4번이 문제다. : cnt가 남는다고 한다면 어떻게 할건가?여기서
56.튜플
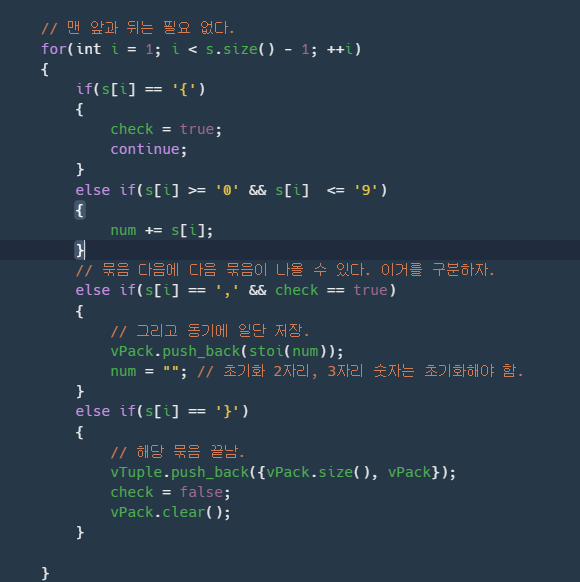
문자열 파싱할 때 너무 복잡하게 작성했다. check 변수를 통해 stringNumber를 int로 저장하려고 했는데. 정작 위의 코드로 하면, 마지막 숫자 저장못한다. ㅇㅇ
57.(틀림.)호텔 대실.
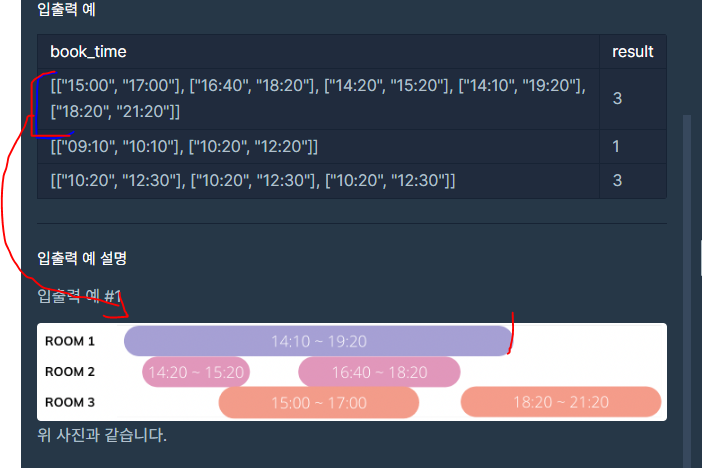
뭔가 시작점 - 끝점을 가지고 문제를 해결해야 할때는 그리디를 생각하자.: 그리디 이므로, 정렬 또는 pq로 해결해야겠다는 생각을 해야 함.book_time을 정렬한 상태로, pq에는 endTime으로 처리하자. 1) 아래의 그림을 보면, 19:20 분과 14:20 (
58.줄 서는 방법.
몫과 나머지를 가지고 접근하는 문제인듯 하다. 앞번호가 1인 것들의 몫은 0으로 하고,\-> 몫이 0이면 앞에는 1로 위치\-> 몫이 1이면 앞에는 2로 위치하는 방식으로 생각함.
59.(중요! _추론 )야근 지수
문제 이해를 못함. 문제를 읽어보고 이렇게 작성했다. 그런데 갑자기 (4,3,3) => (2,2,2) 가 되는데, 어떻게 해서 (2,2,2)가 되는거지를 생각했어야 했다. 즉 이문제는 중간 과정이 생략된 문제이고, 문제 이해가 가지 않는다면, 다시 처음부터 읽어보고, 여러 과정 중에서 최소값이 될수 있게 하는 방법을 생각해야 한다. 코드 구현은 쉽다...
60.이중 우선 순위 큐
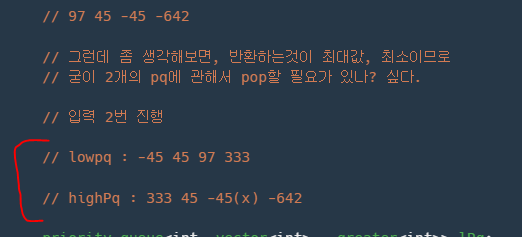
문제의 내용대로 pq 2개를 만들어서 진행하려고 하는데, 이렇게 되면, 한쪽pq에서만 pop해서 제거하려는 전략인데, 문제가 한쪽에서만 꺼냈기 때문에 pq에 남아있는 ,쓸모 없는 정보에 대한 처리를 명확히 할 수 가 없다.다른 방법이 없을까?? 를 생각해야 한다. 힌트
61.(문제 지문 중요)디스크 컨트롤러
1) 초기화는 가장 startTime 앞선거를 놓자.2) 그 다음부터는 1번과 2번 작업을 넣을건데, 2번작업의 비용이 더 좋다. 아무리 1번이 앞선다고 하더라도, 걸리는 시간이 2번작업이 5ms이기 때문에 2번을 먼저 넣어야 한다.=> 즉 pq를 통해서 top을 관리
62.(260605 수정)보석 쇼핑
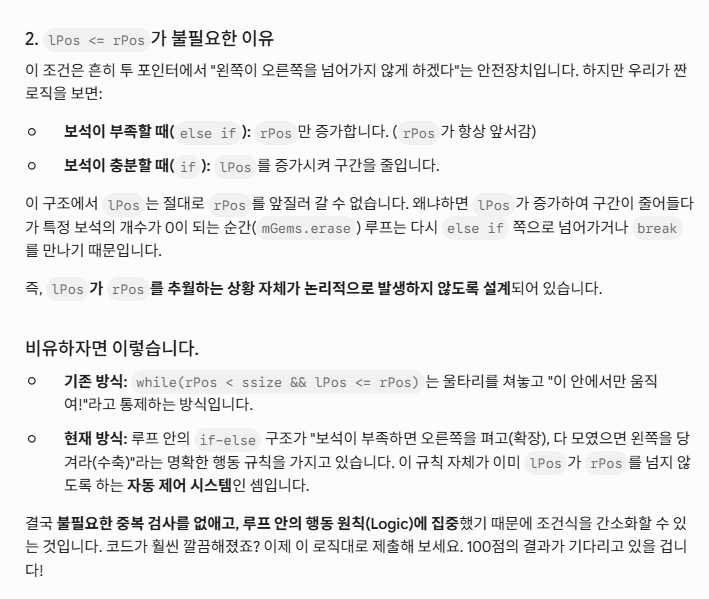
1) 투포인터를 알아야한다.2) 나동빈 이코테 : 특정한 합을 가지는 부분 연속 수열 찾기 (투 포인터) 공부3) set과, map에서의 erase를 어떻게 사용할 것이냐?가 관건 : 하면 아예 키와 value값이 사라진다.
63.(투포인터 잘 사용하기)연속된 부분 수열의 합
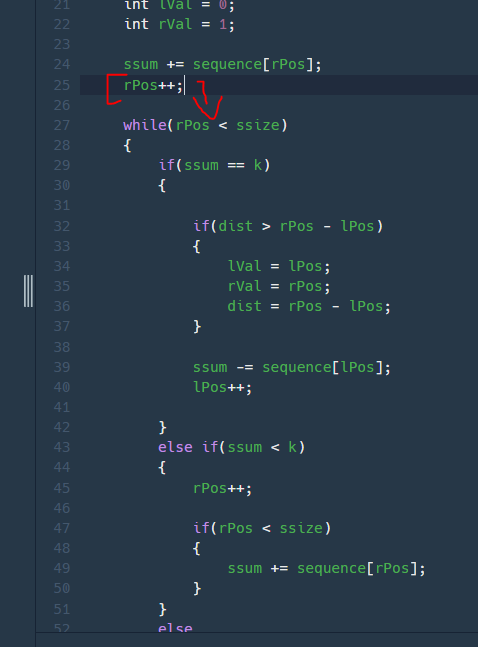
투포인터에서 시작값을 넣고 하라고 해서 이렇게 했다.\-> 그런데 이렇게 하면, while문에서 확인하는 코드에서 ssize가 1이라고 하면 확인도 못한다. \-> 그리고 else if 코드는 인덱스를 갱신하고, 누적하는 코드인데, 코드를 음미해보면, 누적한 다음에 인
64.(replace)옹알이 (1)
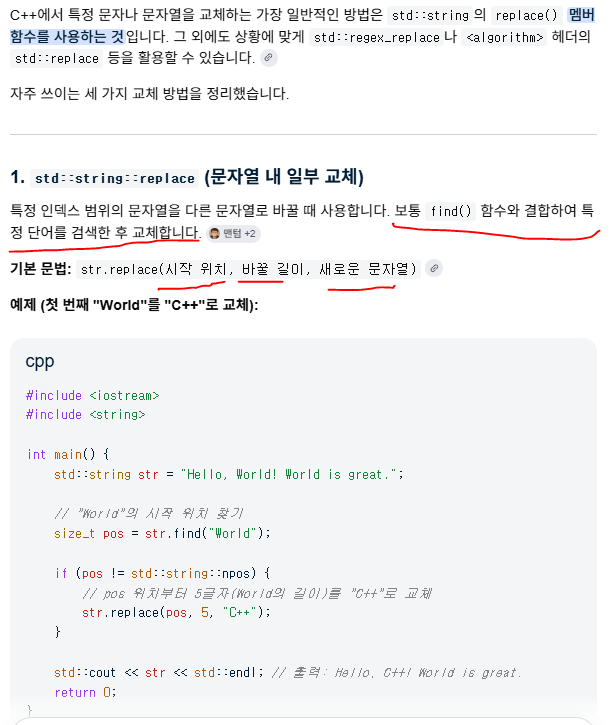
string 얼마나 잘 사용하나?반례가 있다. \-> 문제에서는 4개의 문자열을 이어 나열한 상태로 조합하는 것이지만, 우리는 erase하면서 구하려고 한다. \-> 그런데 wyeoo 가 있다고 하면 erase로 인해 ye가 지워지고,woo가 되는데, 이러한 상황은 발
65.(while문)연속된 수의 합.
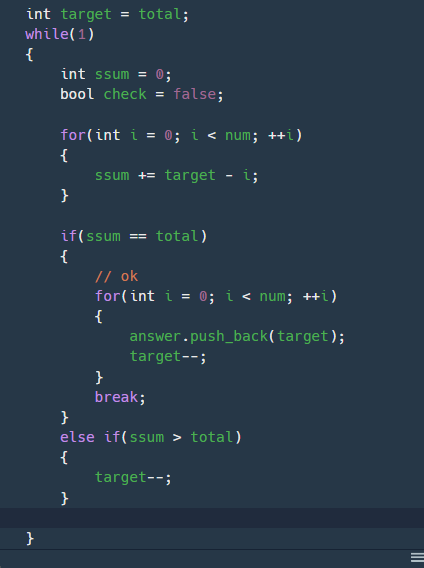
완탐으로 범위 없이 진행하기에는 비효율적이라고 판단함.\-> target인 total을 잡아놓고, -1 하면서 누적하는 식으로 진행함. 이렇게 하면 90점 이다.멘붕오지 말고,, 로직상 문제는 없다고 판단하므로, 제한사항을 한 번 더 보자. total이 0이고, num
66.명예의 전당 (1)
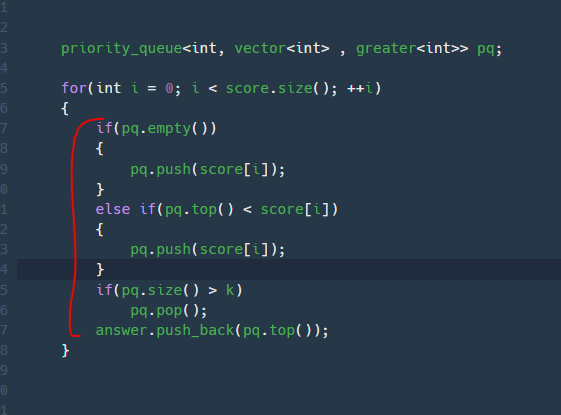
모든 상황에 대해서 조건 처리를 하면서 작성했는데 틀림.나의 생각, pq 사용, 로직 완벽하다 생각했는데, 20점 맞음.\-> 코드 뒤집어야 한다.: pq 사용은 맞으므로, 더 간단하게 작성함.정답 코드
67.(오버플로우 문제)콜라츠 추측
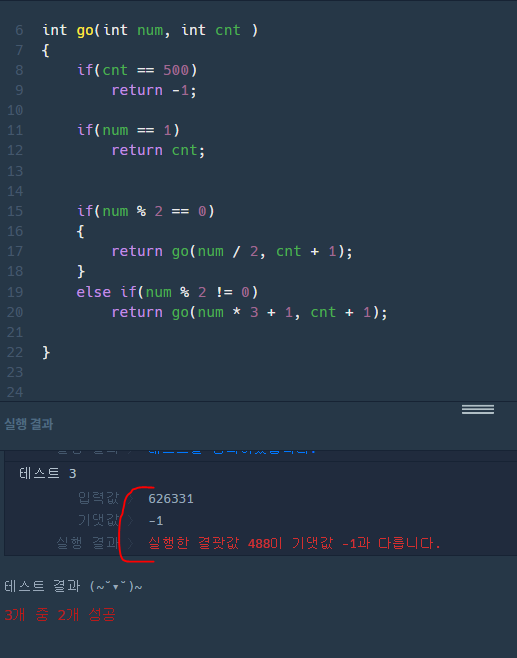
int로 하면, 488 개수가 출력된다. \-> 그래서 나는 뭐야.. 무슨 문제인거지?? 생각을 했다. => 로직상 문제가 없는데. 나는 차라리 오버플로우 발생하면 런타임 에러가 나와야 한다고 생각했는데., 비주얼로도 확인해보니까. 터지지 않는다.여기에서 음수가 발생하
68.(한붓 그리기)여행경로.
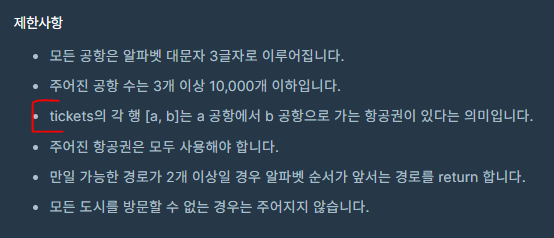
dfs는 그래프를 탐색하는 방법론이고, 한 방향으로 나아가며 탐색하는 방법으로, 막다른길 도착하면(더이상 진행 못하면,) 방문하지 않은 노드로 돌아와서 , 새로운 방향으로 설정해서 깊이있게 탐색함. 그런데 이것이 후퇴를 한다는 개념은 아니고, 방문체크 해제하지 않음.
69.등수 매기기
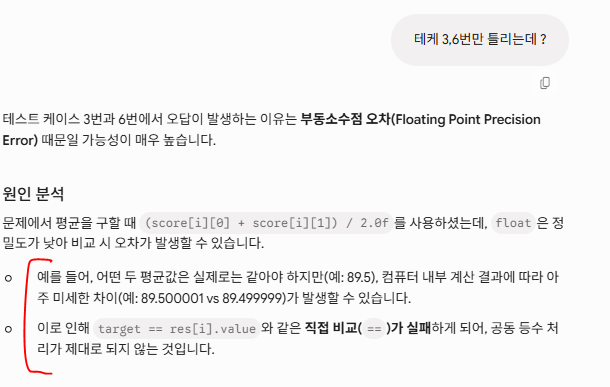
2개의 평균값을 만들어서 rank , 순위를 정하게 되는데, 부동소수점에서 등호 비교는 오차 발생한다고 한다.\-> 그냥 합산결과를 가지고 순위를 만들자. 부동소수점이 발생하는 경우, 예를 들어 나누기를 할 때, 인간이 모르는 오차가 발생한다는 것을 인지해야 하고, 다
70.(카운팅 배열, 나누기 주의사항) 실패율
스테이지 번호마다 카운팅을 해서, 번호마다의 실패율 을 기록함.=> 카운팅 배열로 접근하자.동등 비교 주의하자.분모값이 0이 되면, 무한대값이 반환된다.이 문제에서 81.5점이 나온다 => 분모 처리를 안했기 때문이다.
71.(sort 최적화 )단속카메라
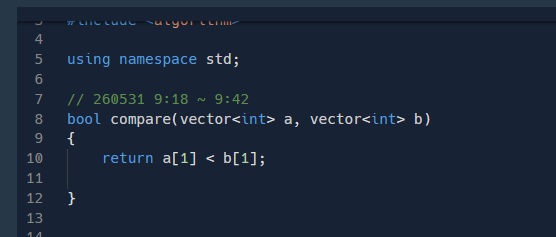
sort 할때 복사해서 했는데 정답이다. 5.31 코드와 동일하게 작성했는데 틀림.\-> 실제로 비교compare 함수도 동일한데 4번에서 틀림.프로그래머스 설정 변경인듯 하고, 복사하는 식으로 하지 말고, const 참조하는 식으로 변경하자.정답 코드
72.(sqrt 사용.)기사 단원의 무기
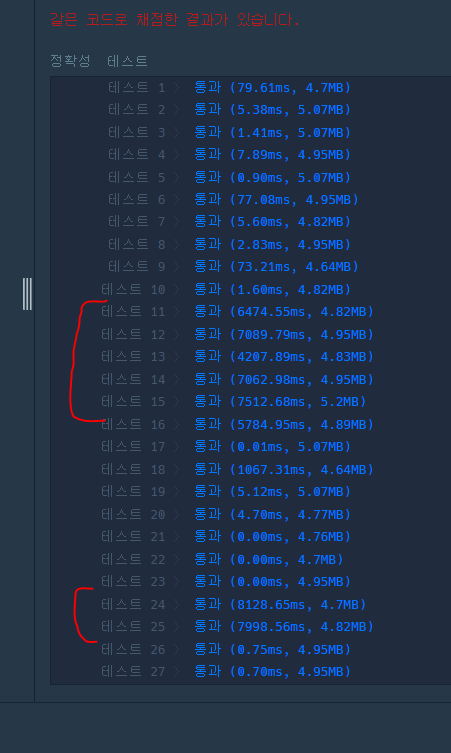
제곱근까지만 구해서 해결할수 있다고 한다면, sqrt를 적극적으로 사용해서 시간복잡도를 최소화하자.시간복잡도 10만 \* 10만이므로, Count 함수에서 limit 넘어가면 조건처리 반드시 해야 한다 생각함. 조건처리하므로, 굳이 전부다 순회하면 되지 않을까? 생각함
73.(나누기 연산에 대해)두 수의 나눗셈.
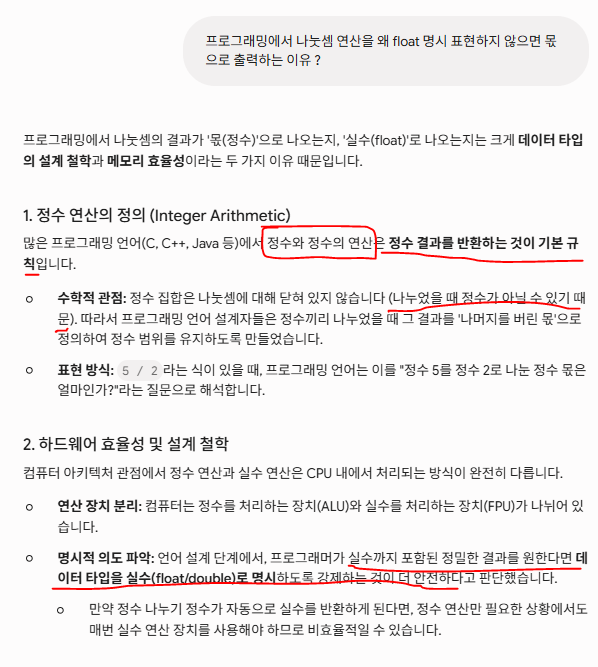
나누기 연산자는 몫을 반환함. ㅈㅁㄴㅇ 속도 측면 나누기 연산을 먼저 하게 되면, 몫만 반환해서 계산하므로,\-> 곱셈 연산을 하면 문제에서 의도한 바와 같다.
74.(문제 분석 중요_반례)대충만든 자판.
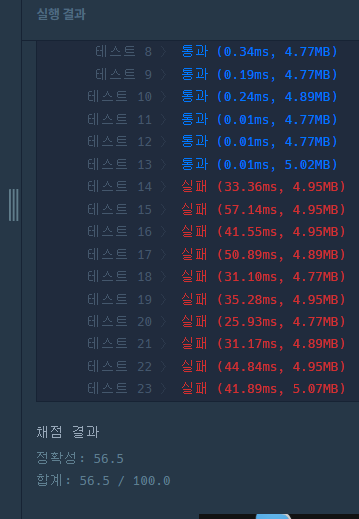
뛰고 와서 작성하자.
75.(문제 전략 변경할까? 에 대해)최고의 집합.
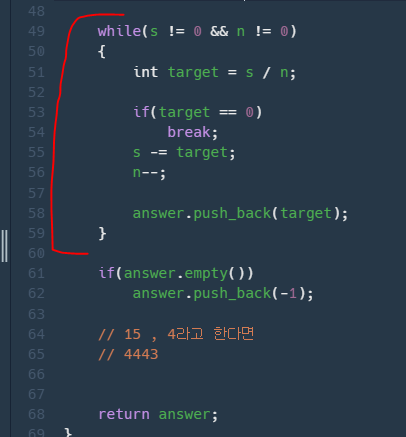
n이 1만이고, s는 1억이므로, while 돌려도 문제 없을거 같다 판단하는데, \-> 효율성에서 틀린다.n이 1만이므로 while 돌려도 시간복잡도는 1만이라서 문제 없을듯 한데, 시간 초과이므로,=> 다른 문제 해결전략을 세워야 한다.
76.(중요 : 최고 비트 확인 )이진 변환.
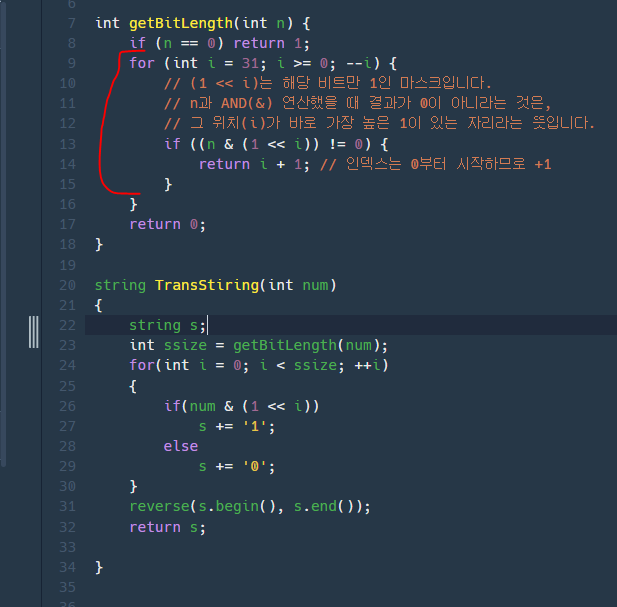
int 정수의 최고비트는 몇번째 카운팅을 알아야 한다.\-> 최고비트가 1인 순간이 이진 상태에서의 길이를 증명함.
77.(map대신 unordered_map 사용하자)롤케이크 자르기
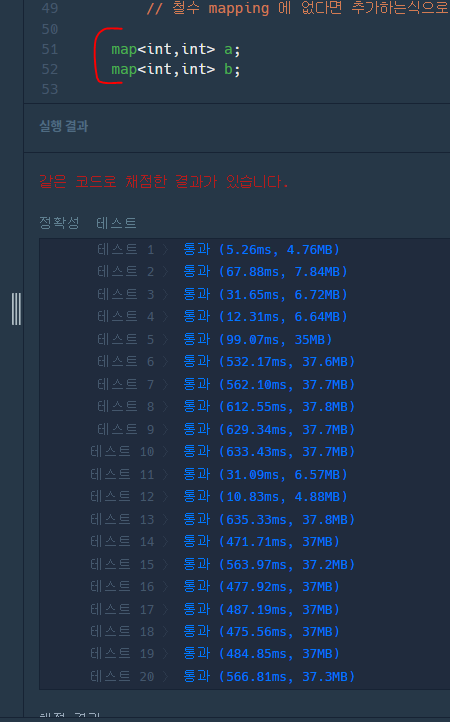
시간이 굉장히 많이 소요됨.시간이 단축됨.: key값이 정렬된상태로 보지 않는다고 하면, map 대신에 unordered_map 을 사용하자.
78.(생각해보기 문제)점프와 순간이동.
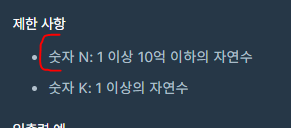
재귀를 생각했는데, 현재 n이 10억이다...\-> 재귀로 하면 시간초과 발생할듯 해서, 다른 해결전략 있는지 생각함. 아래의 내용을 토대로 진행함.
79.(재풀이_최신) 다리를 지나는 트럭.
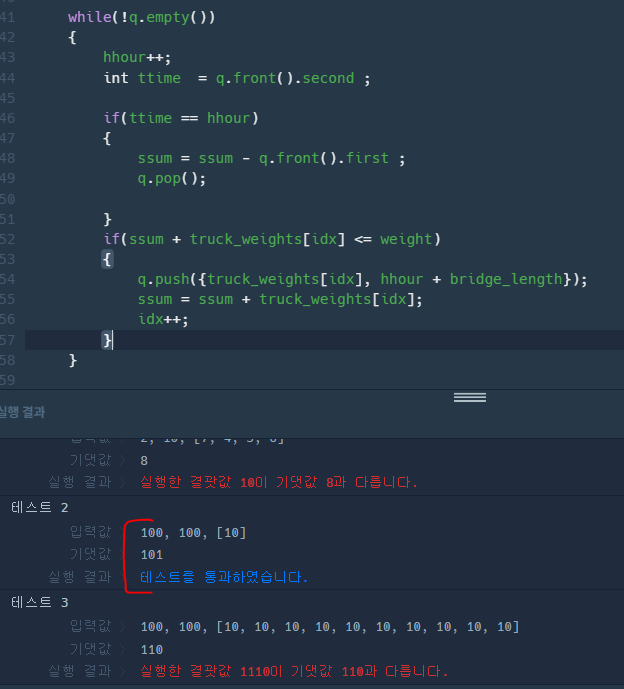
아래의 결과로 인해서 딱히 문제없고, 조금만 수정해야 하나? 생각이 들지만,,, \-> 오답 결과를 가지고 접근하지 말고, 내가 작성한 코드에서 조건처리라든가? 뭐가 잘못되었을까? 를 가지고 생각하자.인덱스 번호를 가진 원소와 비교시에는 항상 size 체크하자.정답코드
80.(부족한 점들 여기서 증명됨.)베스트 앨범.
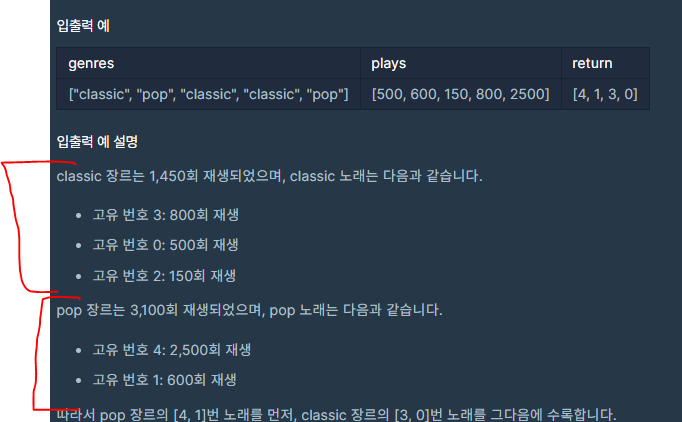
classic , pop을 인덱스 0,1번이고, 이거를 pair<int idx, int play> 형태로 vector에 저장하려고 했다. \-> 0 = {3,800} , {0,500} , {2,150} 이런식으로.그래서 나는 이런식으로 했는데, 잘못된 생각이다.
81.(중요한 그리디 문제)최소 직사각형.
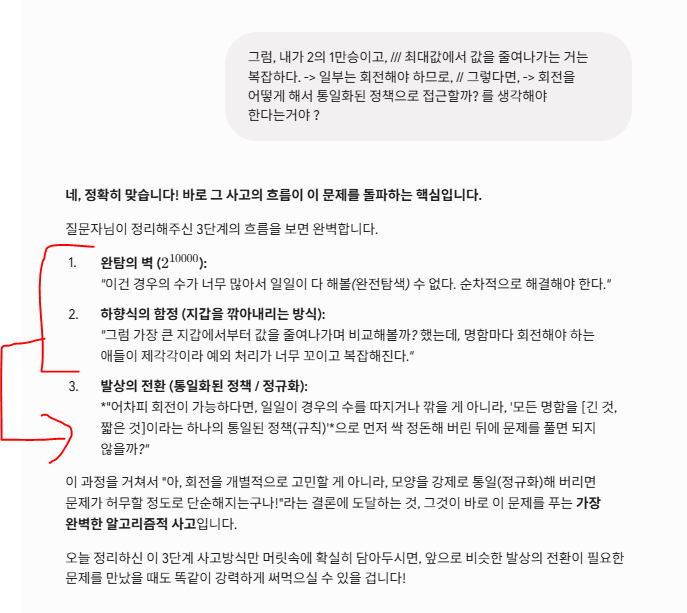
제미나이랑. 1번과 2번에 의해 그리디 적으로 접근해야겠따. 는 생각을 함. 문제가 되는 해결 때문에 2의 1만승이다. \-> 이거를 어떻게 해결할지가 관건이고, \-> 솔직히 가로는 큰것만, 세로는 작은것만 할까? 라는 생각하는거는 코테에서 어렵다.그리디라고 생각했기
82.(다시 풀기)콜라 - 구현
다시 풀어보자.
83.(틀림_가장작은 단위로 통합)개인정보 수집 유효기간
틀림 \-> 년도, 월, day를 통일하지 않고, 분류 해서 처리했는데, 예상치 못한 조건 처리를 해야 함.아래의 두번째 풀이와 비교하면 , 복잡하다.문제를 보고, 가장 작은 단위로 통일하지 않아도 되겠구나. 했는데, 그랬다가 틀렸다. 이와 같이 단위가 여러개인 문제가
84.피로도_next_per
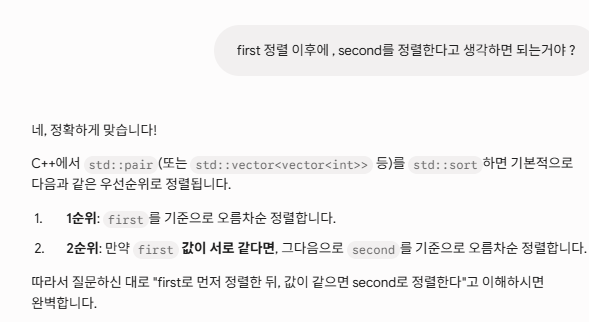
pair 를 sort 한 다음에 next_per 로 하려고 했는데, pair 형식이라서 sort한후, next_per가 잘 동작할까? 의문인데, \-> 내가 알아야할 개념이 있따. first로 먼저 정렬하다가, first가 동일하면, second로 정렬 진행함.next
85.피로도_백트래킹.
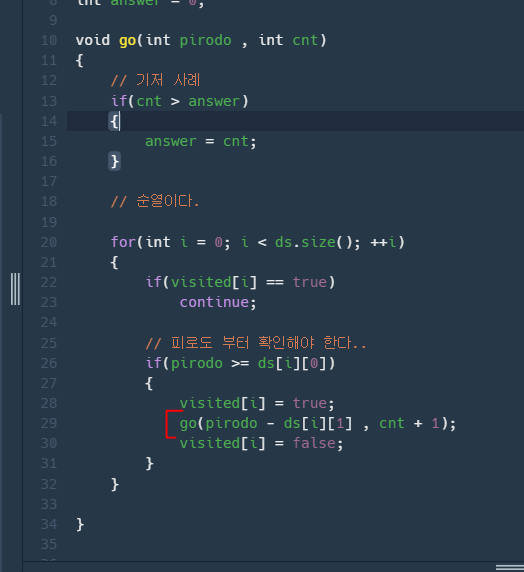
go함수 의 인자로 넣어줄때 반드시 증감연산자 사용하면 안된다! 이렇게 해야 , 백트래킹 다시 돌아와서 진행할때 원본값으로 진행이 가능하다.이렇게 해버리면? : 0->1->2 번 원소 재귀가 마친 다음에 1->0->2로 가는 경우도 존재하는데 원본 pirodo가 아닌
86.(시간복잡도를 생각.)N-Queen
1) 가로에는 한개의 퀸만 놓을 수 있다. 2) 모든 영역에 배치를 하면서, 다시 돌아와서 진ㄴ행하는 구조이므로, => 백트래킹을 해야 한다. 기저사례의 최대값이 12이기 때문에 12승이고,for문은 12\*12 이므로 => 최종적으로는 144의 12승이다...
87.(구현)n^2 배열 자르기
1) 이중포문으로 해야겠다는 생각을 함. \-> 코드 작성하지 말고, 시간복잡도부터 계산하면, n이 천만이기 때문에불가하다. 2) for문 한개로만 처리해야 한다. \-> 정사각형을 직접만들어서 데이터를 set하려고 하면 절대 안됨. 3) 데이터 총 갯수는 right
88.(중요!)뒤에 있는 큰 수 찾기
pq랑 스택 2개로 생각했는데 0) numbers가 백만이므로, 하나 for문으로 접근해야 함.1) 뒤의 원소부터 넣어가면서, 나보다 큰게 나오면, 전부 지워야 하는 스택을 결정함. 2) 이러한 반례를 생각해서 pq는 아니다. 굉장히 꼬일듯 하고, \-> 반례를 통해서
89.(틀림.) 택배상자.
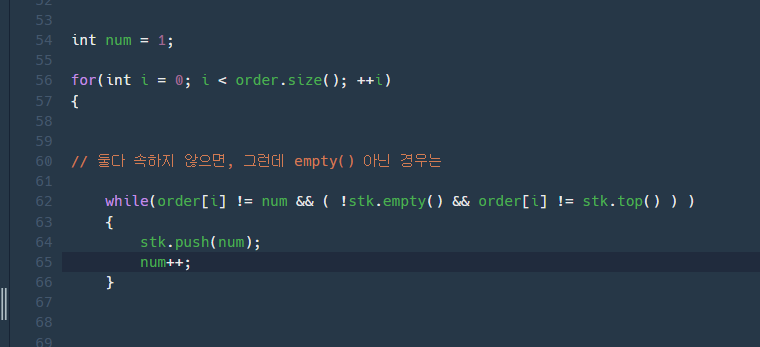
메인 컨테이너와 보조 컨테이너 2개를 가지고 orderi 와 비교하는 식으로 작성함. 아래의 코드이고, 굉장히 복잡해짐.업로드중..
90.배달_다익스트라_업뎃
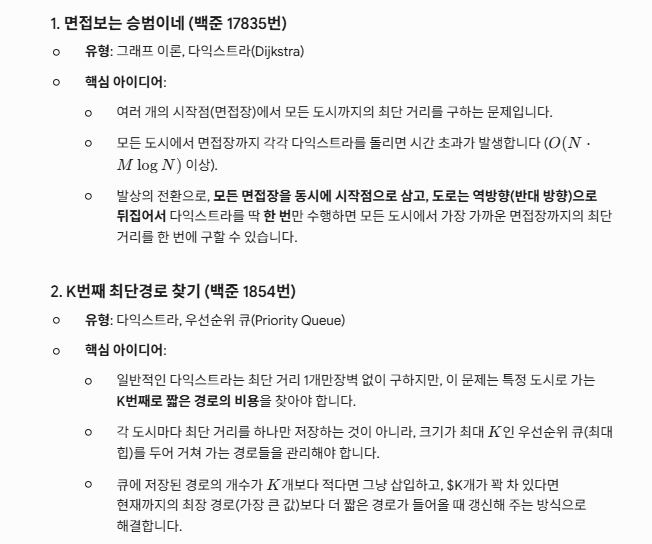
0) 시작정점에서부터 모든 정점에 대한 최단거리를 구함.0-1) bfs와는 다르게 가중치가 모두 다르다.0-2) distTable 필요. 1) bfs처럼 시작정점에서부터 시작함.2) 그리디 : 매순간 최고의 선택을 하는데, 매순간 가중치가 짧은 가중치를 먼저 처리하려고