1초 단위 랭킹을 설계해보자 - 1편
시작하면서
컴퓨터공학과 4명의 학생들이 교내에서 운영 중인 금품타 프로젝트를 진행하면서 겪었던 랭킹 설계 과정을 적어보고자 합니다.
서비스에서 요구한 실시간성이란 무엇인가 ❓
먼저 저희 서비스를 소개하고 시작하겠습니다.
금품타는 교내 사용자가 스톱워치로 공부 시간을 측정하고, 누적 공부 시간을 기준으로 다른 사용자와 순위를 비교할 수 있는 서비스입니다.
사용자가 스톱워치로 공부 시간을 재고, 그 시간을 기반으로 개인·학과 랭킹을 보여주는 서비스입니다. 여기에 한 가지 까다로운 요구사항이 붙어 있었습니다.
사용자가 공부 종료 버튼을 누르지 않아도, 현재까지 공부한 시간이 랭킹에 1초 단위로 반영되어야 한다.
예를 들어 A 사용자가 1시간을 공부한 상태에서 새 세션을 시작했다고 해봅시다. 10분 뒤에 랭킹을 조회하면, A의 점수는 1시간이 아니라 1시간 10분이어야 합니다. 종료 요청을 안 보냈어도 서버는 지금까지 흐른 시간을 포함해서 순위를 계산해야 한다는 뜻이죠.
설계 당시 예상한 서비스 규모는 다음과 같습니다.
| 항목 | 특징 |
|---|---|
| 전체 잠재 사용자 | 교내 재학생 약 5,000명 |
| 일일 이용자 | 최대 500명 |
| 동시 공부 사용자 | 평시 100명, 시험 기간 최대 500명 |
| 제공 랭킹 | 개인·학과 일간/주간/월간 |
| EC2 t3.medium (2 vCPU, 메모리 4GB) | Spring 애플리케이션, MySQL, Redis가 도커 컨테이너로 한 인스턴스에 같이 올라가 있음 |
서비스의 목표는 무조건 가장 성능이 좋은 시스템을 개발하는 것이 아니라, 1초 단위 실시간성을 지키면서도, 정합성과 운영 복잡도까지 같이 고려한 적절한 구조를 설계하는 것이 목표였습니다.
1️⃣ 1초 Update 방식
1초 Update 방식이란 1초 단위의 실시간성을 보장하기 위해 매번 쿼리를 날리는 방식입니다.
먼저 랭킹 업데이트를 누가 트리거하는지 정해야 합니다.
서버 스케줄러가 1초마다, 진행 중인 모든 세션의 공부 시간을 쿼리 한 문장으로 갱신하는 방식입니다.
-- 서버의 @Scheduled(fixedRate = 1000)가 매초 실행하는 쿼리
UPDATE study_session
SET total_millis = TIMESTAMPDIFF(MICROSECOND, start_time, NOW(6)) / 1000
WHERE status = 'STARTED';
한 사용자가 하루에 여러 세션을 만들 수 있으므로, 랭킹은 SUM(total_millis) ... GROUP BY user_id로 조회할 수 있습니다.
어떤 부하가 발생할까?
레코드 잠금
UPDATE 쿼리는 대상 행에 배타 락을 겁니다.
문제는, 락이 조건에 맞는 행에만 걸리는 게 아니라 스캔하면서 지나간 행에도 걸린다는 점입니다. 그래서 매초 도는 UPDATE가 풀 스캔을 타면, 트랜잭션이 도는 동안 테이블 레코드 전반에 락이 걸립니다.
게다가 MySQL 기본 격리 수준인 REPEATABLE READ에서는 행과 행 사이의 갭까지 잠글 수 있어서, 정작 중요한 공부 종료 UPDATE가 뒤에서 대기하는 시나리오가 생길 수 있습니다.
물론 status에 인덱스를 걸면 나아질 여지가 있습니다. 하지만 카디널리티가 낮기 때문에 옵티마이저가 인덱스를 무시하고 그냥 풀 스캔을 택할 가능성도 있습니다.
매초마다 커넥션을 점유한다
DB에 쿼리를 보내려면 커넥션이 필요하고, 애플리케이션은 커넥션을 미리 만들어 두고 빌려 쓰는 풀을 운영합니다. 저희는 이 풀을 10개로 잡아뒀는데, 이 설계에서는 매초 도는 벌크 트랜잭션이 그중 하나를 실행 내내 붙잡고 있습니다.
즉, 랭킹을 조회하는 사람이 0명인 시간에도 DB 커넥션·락·트랜잭션 비용이 상시로 나가는 구조입니다. 아무도 안 쓰는데 서버 혼자 바쁜 셈이죠.
사용자가 늘어난다면?
설계를 고를 때는 지금 규모만이 아니라, 사용자가 늘어났을 때 어느 방향으로 확장할 수 있는지도 봐야 합니다.
1초마다 진행 중인 사용자의 공부 시간을 갱신하는 방식은 부하를 쓰기 경로에 만듭니다. 동시 공부 사용자가 5,000명이라면 매초 5,000번의 갱신이 필요합니다. 앱 서버는 로드밸런서 뒤에서 여러 대로 늘릴 수 있지만, 이 쓰기는 결국 primary 저장소 한 곳으로 모입니다.
반면 조회 시점 계산 방식은 쓰기를 늘리지 않습니다. 사용자가 많아져도 원본 세션 쓰기는 시작과 종료, 세션당 2번입니다. 시간이 흐른다는 이유만으로 매초 데이터를 갱신하지 않습니다. 읽기 부하는 인덱스와 쿼리 튜닝, 짧은 TTL 캐시, 리드 레플리카, Redis read model 순서로 단계적으로 분산할 수 있습니다.
읽기는 캐시와 리드 레플리카로 여러 곳에 흩뿌릴 수 있지만, 쓰기는 결국 primary 한 곳으로 모입니다. 그래서 이 구조 안에서는 부하를 읽기 쪽에 두는 설계가 곧 확장 경로를 가진 설계라고 행각했습니다.
위 3가지의 이유로, 1초 Update 방식은 기각하게 되었습니다.
2️⃣ Redis Sorted Set 방식
Redis Sorted Set은 중복되지 않는 member를 score에 연결하고, 그 score를 기준으로 자동 정렬해주는 자료구조입니다. 사용자 ID를 member로, 누적 공부 시간을 score로 넣으면 이런 모습이 됩니다.
member      score
user:42     7,200,000
user:17     5,400,000
user:93     3,600,000
score를 밀리초 단위 누적 공부 시간이라고 하면, user:42는 2시간, user:17은 1시간 30분, user:93은 1시간을 공부한 사용자입니다.
member를 추가하거나 score를 갱신하는 비용은 보통 O(log N)입니다. 사용자가 아무리 늘어나도 전체 세션을 매번 집계하지 않고, 이미 정렬된 결과에서 필요한 범위만 읽으면 됩니다.
그런데 공부 시간에는 조금 골치 아픈 특성이 하나 있었습니다.
공부 시간은 멈춰 있는 점수가 아니라 흐르는 점수다
일반적인 게임 점수를 한번 생각해볼까요?
사용자가 적을 처치하면 100점, 퀘스트를 완료하면 500점이 오릅니다. 점수가 바뀌는 순간에는 반드시 이벤트가 있습니다.
적 처치 이벤트 → score +100
퀘스트 완료 이벤트 → score +500
서버는 이벤트가 올 때마다 Redis score를 갱신하면 그만입니다. 이벤트가 없는 동안에는 점수도 가만히 있고요.
공부 시간은 좀 다릅니다. 사용자가 공부를 시작하면, 그 뒤로는 아무 요청이 없어도 점수가 알아서 계속 올라갑니다.
10:00:00 → 0초
10:00:01 → 1초
10:00:02 → 2초
10:00:03 → 3초
Redis에 지금까지의 누적 시간을 넣어둬도, 시간이 흐를 때마다 score를 갱신하지 않으면 Redis 안의 값은 과거 어느 시점에 멈춰 있게 됩니다.
방안 1. 진행 중인 사용자의 score를 매초 갱신한다
동시에 100명이 공부 중이라면, 스케줄러가 매초 100명의 score를 갱신하는 방식입니다.
1초마다 실행
→ 진행 중인 사용자 조회
→ 현재 공부 시간 계산
→ 사용자별 ZADD 실행
동시 공부 사용자가 100명이면 초당 약 100회의 갱신이 발생합니다.
100회/초
= 6,000회/분
= 360,000회/시간
그럼 Redis가 이 정도를 못 버티느냐? 그건 아닙니다. 이 정도 단순 연산은 Redis가 충분히 감당합니다.
문제는 Redis가 이 쓰기를 감당할 수 있느냐가 아니라, 굳이 이 쓰기를 계속해야 할 이유가 있느냐였습니다. 1초 업데이트와 비슷하게, 랭킹을 아무도 안 보고 있는 순간에도 서버는 매초 쉬지 않고 score를 갱신하고 있는 불필요한 구조였습니다.
방안 2. 종료된 사용자와 진행 중인 사용자를 분리한다
그래서 매초 갱신을 피할 방법을 고민하다가, 사용자를 두 그룹으로 나누는 방식을 떠올렸습니다.
stopped ZSET
- 현재 공부 중이 아닌 사용자
- score: 확정된 누적 공부 시간

running ZSET
- 현재 공부 중인 사용자
- score: 기존 누적 공부 시간 - 세션 시작 시각- 하나는 지금 공부 중이 아닌 사용자입니다. 이 사용자의 누적 시간은 새 세션을 시작하기 전까지 변하지 않습니다.
- 다른 하나는 지금 공부 중인 사용자입니다. 이 사용자의 시간은 서버 현재 시각에 따라 계속 늘어납니다.
이걸 각각 별도의 Sorted Set으로 관리합니다. 키는 이런 식으로 구성할 수 있습니다.
rank:personal:daily:2026-07-12:stopped
rank:personal:daily:2026-07-12:running
주간, 월간 랭킹도 같은 구조를 그대로 적용하면 됩니다.
rank:personal:weekly:2026-W28:stopped
rank:personal:weekly:2026-W28:running

rank:personal:monthly:2026-07:stopped
rank:personal:monthly:2026-07:running
stopped ZSET
공부를 끝낸 사용자의 시간은 고정입니다. 오늘 총 2시간을 공부했다면 이렇게 저장하면 됩니다.
ZADD rank:personal:daily:2026-07-12:stopped 7200000 user:42새 세션을 시작하기 전까진 이 값을 건드릴 일이 없습니다.
running ZSET
실제 누적 시간을 직접 넣지 않고, 이 값을 저장합니다.
running score = 기존 확정 공부 시간 - 세션 시작 시각랭킹을 조회할 때 서버 현재 시각을 더해주면 실제 공부 시간이 복원됩니다.
실제 공부 시간
= running score + 현재 시각
= 기존 확정 공부 시간 - 시작 시각 + 현재 시각
= 기존 확정 공부 시간 + (현재 시각 - 시작 시각)
도입하지 않은 이유
1️⃣ 현재 규모에서는 조회 성능보다 추가 복잡성의 비용이 더 컸다
당시 서비스는 평시 약 100명, 최대 500명의 동시 사용자를 예상하고 있었습니다. 이 규모에서는 MySQL로 개발을 해도 조회 병목이 발생하지 않을 것이라고 판단했습니다.
만약 Redis를 사용한다고 하면 장애 감지, 재시도, 장애 복구같은 운영 복잡도가 늘어나게 됩니다.
당시에 개발자를 위한 레디스라는 책으로 Redis Sorted Set을 간단하게 실습은 해봤지만, 위 같은 사항을 많이 경험해보지 못한 상황이었기 때문에 시간이 많이 소요될 것이라고 생각했습니다.
따라서 제한된 개발 기간을 아직 발생하지 않은 문제의 운영 구조에 사용하기보다, MySQL 조회 방식의 실행 계획과 인덱스를 먼저 개선하는 것이 더 높은 우선순위라고 판단했습니다.
2️⃣ Redis는 원본 저장소가 되기 어렵다
MySQL
→ 공부 세션의 원본

Redis
→ 원본을 기반으로 미리 정렬해둔 랭킹 read model
공부 세션은 랭킹뿐 아니라 개인 통계, 기간별 통계, 시즌 랭킹, 이상 세션 검증 등 여러 곳에서 쓰입니다. 그래서 세션의 원본은 결국 MySQL에 남아 있어야 합니다.
Redis를 도입하면 조회는 빨라지지만, 저장소가 하나에서 둘로 늘어납니다. 그리고 여기서 결정적인 문제가 생깁니다. MySQL과 Redis의 변경을 하나의 로컬 트랜잭션으로 묶을 수 없다는 것입니다.
1. MySQL에 세션 시작 저장
2. Redis stopped → running 이동
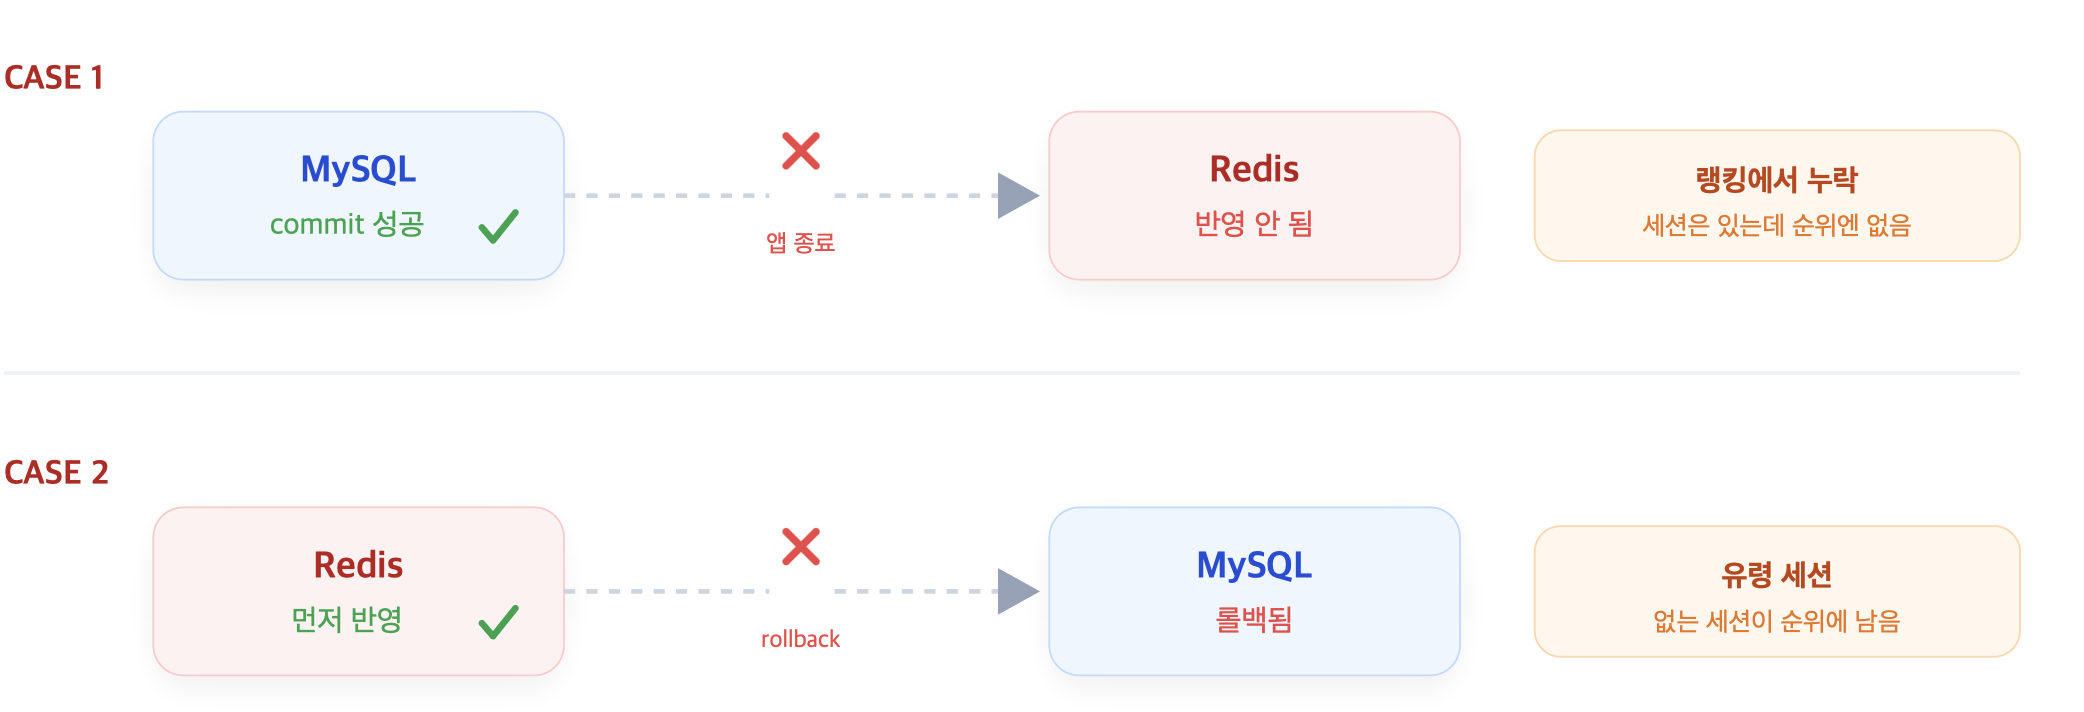
MySQL 저장은 성공했는데 Redis 반영 직전에 애플리케이션이 죽을 수 있습니다. 그러면 MySQL엔 진행 중인 세션이 있는데, Redis 랭킹엔 이 사용자가 빠지게 됩니다.
반대로 Redis를 먼저 바꿀 수도 있는데, 이번엔 Redis 반영 후 MySQL 트랜잭션이 롤백될 수 있습니다. 그러면 실제로는 없는 세션이 Redis 랭킹에 유령처럼 남습니다.
!MySQL과 Redis는 하나의 트랜잭션으로 묶을 수 없어, 누락되거나 유령 세션이 남는다
네트워크 장애, Redis 타임아웃, 애플리케이션 재시작, 중복 재시도까지 겹치기 시작하면, 단순한 이중 쓰기만으로는 믿을 수 있는 랭킹을 만들기 어렵습니다.]
두 구조의 트레이드오프 비교
지금까지 이야기한 걸 표로 정리하면 이렇습니다.
| 관점 | 1초 DB UPDATE | Redis Sorted Set Read Model | MySQL 조회 시점 계산 |
|---|---|---|---|
| 기본 방식 | 진행 중인 모든 세션의 total_millis를 매초 갱신 | 누적 공부 시간을 Redis에 미리 정렬해 관리 | 시작·종료 시각만 저장하고 조회 순간에 공부 시간을 계산 |
| 공부 중 쓰기 | 활성 세션 수만큼 매초 발생 | 시작·종료 이벤트에만 발생 | 없음 |
| 세션당 쓰기 | 시작·종료 외에도 공부 중 계속 발생 | MySQL 시작·종료 저장과 Redis 상태 변경 필요 | 시작 1회, 종료 1회 |
| 랭킹 조회 | 저장된 시간을 SUM, GROUP BY, ORDER BY | 정렬된 ZSET에서 Top N 후보를 빠르게 조회 | 세션 시간을 계산한 뒤 SUM, GROUP BY, ORDER BY |
| DB 부하 | 지속적인 UPDATE로 쓰기 부하 증가 | 랭킹 읽기를 Redis로 분리 가능 | 읽기 요청이 들어올 때만 집계 부하 발생 |
| 정합성 | MySQL 하나만 사용하므로 비교적 단순 | MySQL 원본과 Redis Read Model 사이의 최종적 일관성 관리 필요 | MySQL 원본 하나를 기준으로 계산하므로 단순함 |
| 주요 장점 | 구현이 직관적이고 저장값을 바로 조회 가능 | Top N 조회가 빠르고 조회 비용을 예측하기 쉬움 | 쓰기 부하가 작고 단일 원본으로 정합성을 유지하기 쉬움 |
| 주요 단점 | 지속적인 쓰기, 락 경합, Primary 확장 한계 | 동기화·기간 관리·장애 복구 등 운영 복잡도 증가 | 데이터가 증가하면 집계와 정렬 비용이 커질 수 있음 |
| 적합한 상황 | 매초 갱신된 값을 여러 기능에서 반드시 재사용해야 하는 경우 | 랭킹 조회량이 크고 MySQL 집계가 명확한 병목인 경우 | 현재 규모가 크지 않고 정확성과 운영 단순성이 중요한 경우 |
| 현재 서비스 판단 | 기각 | 향후 조회 병목 발생 시 재검토 | 현재 선택 |
언제 고려해야할까
다음과 같은 상황이 오면 저는 언제든 Redis read model 전환을 다시 검토할 생각입니다.
- 인덱스와 사전 집계를 다 적용한 뒤에도, 현재 기간 랭킹의 p95 응답 시간이 서비스 목표를 계속 초과하는 경우
- 랭킹 집계 쿼리가 MySQL CPU 사용량이나 커넥션 풀 점유의 주요 원인이 되는 경우
- 랭킹 조회 트래픽이 크게 늘어, 조회마다 원본 세션을 집계하는 비용이 전체 시스템 확장을 막는 경우
마치며
다음 글에서는 실제로 선택한 조회 시점 계산 방식의 구현 과정을 다룰 예정입니다.
진행 중인 세션에 현재 시각을 반영하는 방법, 일간·주간·월간 경계를 넘는 세션의 시간을 자르는 방법, 사용자별 공부 시간을 집계하는 SQL과 학과별 상위 30명을 계산하는 윈도 함수까지 순서대로 살펴보겠습니다.
또한 세션 데이터가 증가하면서 발생한 Full Table Scan과 커넥션 점유 문제를 어떻게 확인했는지, 실행 계획을 바탕으로 복합 인덱스와 커버링 인덱스를 어떻게 설계했는지 설명하겠습니다.
마지막으로 실제 부하 테스트 조건과 함께, p95 응답 시간을 약 30초에서 0.22초까지 개선한 과정을 공유하겠습니다.
