AI Agent 도입은 끝났다: 이제 개발팀이 증명해야 할 것은 생산성이다
AI Agent 도입은 끝났다: 이제 개발팀이 증명해야 할 것은 생산성이다
몇 년 전까지만 해도 개발 조직의 질문은 단순했다.
AI Coding Tool을 도입해야 할까?이제 이 질문은 거의 끝났다.
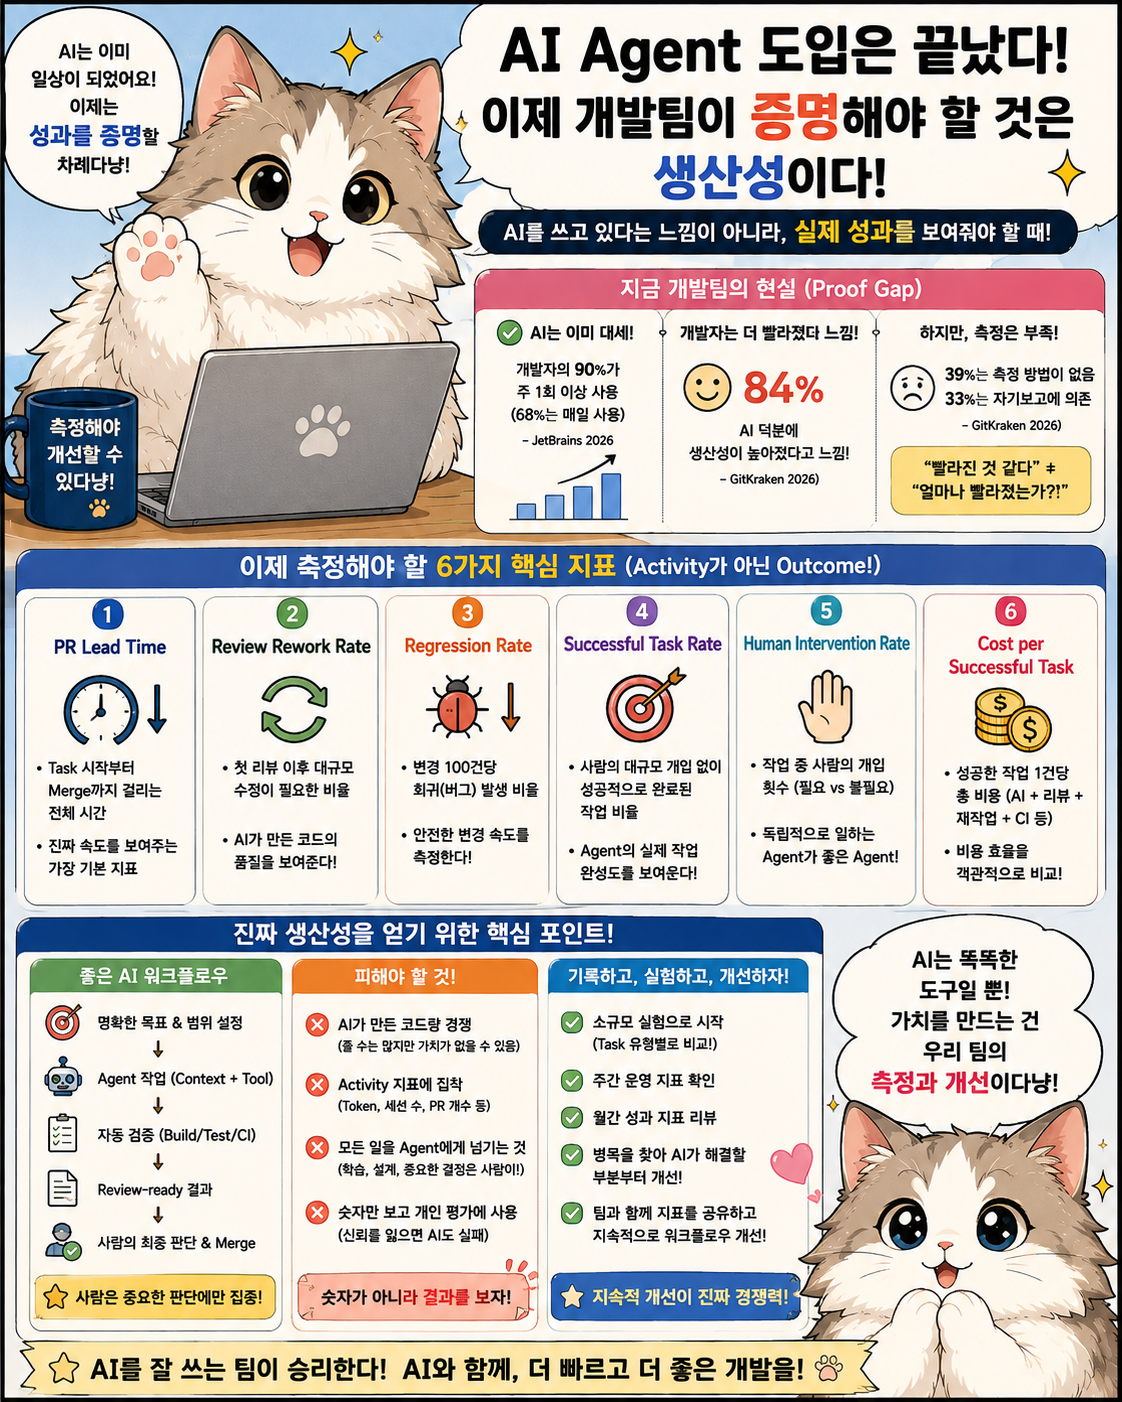
2026년 JetBrains Developer Ecosystem Survey에서는 전문 개발자의 90%가 업무에서 AI Coding Agent를 최소 주 1회 사용하고, 68%는 매일 사용한다고 답했다.
GitKraken의 2026 조사에서도 96.4%의 팀이 이미 AI Coding Tool을 도입한 상태였다.
즉 이제:
AI를 쓰는 팀

vs

AI를 안 쓰는 팀
의 경쟁이 아니다.
질문이 바뀌었다.
AI를 쓰고 있는데

그래서 실제 개발팀은
얼마나 좋아졌는가?
이다.
그리고 이 질문에 제대로 답할 수 있는 회사는 생각보다 많지 않다.
GitKraken 조사에서 개발자의 84%는 AI 덕분에 생산성이 높아졌다고 느꼈다.
하지만 조직의:
39%
→ AI 효과를 측정하는 방법이 없음

33%
→ 개발자 자기평가에 의존
하고 있었다.
즉:
"확실히 빨라진 것 같은데요?"라는 느낌은 강한데,
"얼마나 빨라졌습니까?"라고 물으면 답하기 어려운 것이다.
2026년 AI Coding의 진짜 문제는 Adoption Gap이 아니라 Proof Gap이다.
1. AI Coding Tool 도입 자체는 더 이상 성과가 아니다
예전에는 이런 발표만으로도 충분했다.
전 개발자에게 Copilot 도입

Claude Code 사용 허용

Codex 라이선스 제공

Cursor 도입
회사 입장에서는 새로운 개발 환경을 제공한 것이고,
개발자 입장에서는 생산성 Tool을 얻은 것이었다.
하지만 지금은 거의 모든 팀이 비슷한 Tool을 사용할 수 있다.
OpenAI의 2026 Enterprise Signals에서도 흥미로운 점이 나온다.
AI 활용도가 높은 선도 기업이라고 해서 특별한 모델을 독점적으로 사용하는 것이 아니다.
차이를 만드는 것은:
같은 모델

+

더 많은 Context

+

더 많은 Tool

+

더 깊은 업무 위임
이다.
즉 경쟁력은:
어떤 AI를 샀는가보다:
AI에게 실제 일을
어떻게 맡기고 있는가
로 이동한다.
2. “개발자가 빨라졌다”와 “개발팀이 빨라졌다”는 다르다
예를 들어 개발자 한 명이 Agent를 사용한다.
예전:
Feature 구현

3일
AI Agent 사용 후:
Feature 구현

1.5일
굉장한 개선처럼 보인다.
그런데 이후를 보자.
PR Review

+ 4시간
Agent가 만든 코드가 커서 Review가 오래 걸렸다.
QA

+ 3시간
예외 Case가 늘었다.
Rework

+ 4시간
Architecture Rule을 일부 어겨 다시 수정했다.
결국 실제 Delivery는:
Coding ↓

Review ↑

Rework ↑
가 된다.
개발자 개인은 분명 빨라졌다.
하지만 팀 전체가 빨라졌는지는 다른 문제다.
3. 그래서 가장 위험한 지표가 “AI가 만든 코드량”이다
예를 들어 조직 Dashboard에 이런 숫자가 있다고 하자.
AI Generated LOC

이번 달 1,200,000줄
굉장해 보인다.
하지만 이것만으로 알 수 있는 것은 거의 없다.
오히려 질문해야 한다.
그중 실제 Production에 들어간 코드는?

Review에서 다시 수정한 비율은?

Regression은 늘지 않았나?

삭제된 코드는?

불필요하게 생성된 코드는?
Agent는 코드 생산 비용을 극단적으로 낮춘다.
그러므로:
Lines of Code는 AI 시대에 오히려 더 나쁜 생산성 지표가 될 수 있다.
4. PR 개수도 마찬가지다
예:
AI 도입 전

PR 100개 / 월
↓
AI 도입 후

PR 180개 / 월
생산성이 80% 오른 걸까?
그렇지 않을 수 있다.
PR이:
작아졌는지

커졌는지

Review 시간이 늘었는지

Merge가 실제로 빨라졌는지

Revert가 늘었는지
를 함께 봐야 한다.
Agent는 PR을 만드는 속도도 매우 빠르다.
따라서 단순 PR Count는:
Agent Activity를 보여줄 뿐
Business Value를 보여주지는 않는다.
5. Token 사용량도 생산성 지표가 아니다
Agent Monitoring Tool이 늘면서:
Token

Cost

Model Usage

Agent Session
을 쉽게 볼 수 있게 됐다.
좋은 데이터다.
하지만:
Token 많이 사용
=
AI를 잘 사용
은 아니다.
예를 들어:
Developer A

100M tokens
Developer B
20M tokens라고 하자.
A가 AI를 5배 잘 쓰는 것이 아닐 수 있다.
A는 같은 Repository를 계속 다시 읽고 있을 수도 있다.
B는:
Skill

Script

Context File

Test Automation
을 잘 만들어 Agent가 적은 Context로 일을 끝내게 할 수도 있다.
Token은 Resource Metric이지 Productivity Metric이 아니다.
6. AI 시대에는 “결과까지 걸리는 시간”을 봐야 한다
가장 먼저 보기 좋은 지표가:
PR Lead Time이다.
예를 들어:
Task 시작

↓

Code

↓

PR 생성

↓

Review

↓

수정

↓

CI

↓

Merge
까지 걸린 시간이다.
AI를 도입했다면 정말 봐야 할 것은:
Coding Time하나가 아니라:
Task → Merge전체 시간이 줄었는가다.
7. 첫 번째 핵심 지표: PR Lead Time
예:
AI 도입 전

Median PR Lead Time
18시간
AI 도입 후
11시간이라면 꽤 좋은 신호다.
반대로:
Coding

50% 빨라짐
인데:
PR Lead Time

18시간 → 21시간
이라면 문제가 있다.
Agent가:
큰 PR 생성

Review 부담 증가

수정 반복 증가
를 만들고 있을 가능성이 있다.
8. 두 번째 지표: Review Rework Rate
Agent가 만든 PR이 첫 Review에서 얼마나 다시 수정되는지도 중요하다.
예:
PR 100개

↓

첫 Review 이후
대규모 수정 38개
라면:
Rework Rate

38%
다.
AI가 코드를 빨리 만들고 있지만 Review에서 계속 다시 만드는 상황이다.
이 경우 문제는 Agent Capability 자체보다:
Task Context 부족

Architecture Rule 부족

Acceptance Criteria 불명확

Agent Permission 과다
일 수 있다.
9. Review Comment 개수만 보면 안 된다
예:
PR A

Comment 20개
PR B
Comment 3개PR B가 더 좋은 것은 아니다.
20개가:
Naming

Formatting
일 수도 있고,
3개가:
Architecture 잘못됨

Security 문제

데이터 손실 위험
일 수도 있다.
그래서 Review Comment를 Risk로 분류하면 좋다.
Style

Correctness

Architecture

Security

Product Requirement
AI 도입 이후 어떤 종류의 Rework가 늘었는지를 본다.
10. 세 번째 지표: Regression Rate
AI 생산성 논의에서 이 지표는 반드시 들어가야 한다.
예:
AI 도입 전

100 Change당 Regression 3건
AI 도입 후
100 Change당 Regression 7건이라면 개발 속도가 빨라졌다는 이유만으로 성공이라고 보기 어렵다.
반대로:
Delivery ↑

Regression 유지
또는:
Delivery ↑

Regression ↓
라면 상당히 강한 생산성 개선이다.
11. AI는 코드를 만드는 속도뿐 아니라 “잘못된 코드의 속도”도 높인다
이 점을 잊으면 안 된다.
Agent에게:
이 Module 전부 Refactor해줘.라고 하면 사람보다 훨씬 빠르게 수십 개 파일을 수정할 수 있다.
방향이 맞다면 좋다.
방향이 틀렸다면:
잘못된 변경

×

속도
도 빨라진다.
그래서 AI 시대에는:
생성 속도보다:
안전한 변경 속도를 봐야 한다.
12. 네 번째 지표: Successful Task Rate
Agent에게 Task 100개를 맡겼다.
단순히:
100개 완료라고 하지 않는다.
실제로:
사람의 대규모 재작업 없이 완료

Build/Test 통과

요구사항 충족

Merge 가능
한 Task를 본다.
예:
Agent Tasks

100
↓
Successful

72
이라면:
Successful Task Rate

72%
다.
이 숫자가 Agent Workflow 품질을 꽤 잘 보여줄 수 있다.
13. “Agent가 완료했다고 말한 것”은 성공이 아니다
Agent:
완료했습니다.

모든 테스트가 통과했습니다.
라고 했다.
그걸 Successful Task로 세면 안 된다.
성공 조건은 외부 검증을 사용한다.
CI

Compiler

Test Result

Human Acceptance
같은 것이다.
즉:
Agent Self-report와:
Verified Completion을 분리한다.
14. 다섯 번째 지표: Human Intervention Rate
이 지표는 Agent 시대에 특히 재미있다.
Agent에게 Task를 하나 맡긴다.
작업 중:
질문

확인

방향 수정

권한 요청

Retry 요청
이 몇 번 발생했는지 센다.
예:
Task A

Human Intervention 1회
Task B
Human Intervention 14회둘 다 성공했어도 Developer Experience는 완전히 다르다.
15. Agent가 사람을 계속 호출하면 완전한 생산성 개선이 아니다
예를 들어:
Agent

30분 작업
인데 개발자가:
3분마다 확인해야 한다면 실제로 다른 일을 하기 어렵다.
그래서:
Human Intervention Rate를 보면 Agent가 얼마나 독립적으로 일을 처리하는지 알 수 있다.
이건 특히:
Remote Agent

Cloud Agent

Background Agent
환경에서 중요하다.
16. Human Intervention에도 종류가 있다
모든 개입을 줄이는 것이 목표는 아니다.
예:
외부 Dependency 추가 승인

Public API 변경 승인

Database Migration

Production 변경
같은 개입은 오히려 필요하다.
줄여야 할 것은:
Formatting할까요?

Import 정리할까요?

Test 실행할까요?
같은 사소한 개입이다.
그래서 Intervention을:
Required

Unnecessary
로 나누는 것이 좋다.
17. 여섯 번째 지표: Cost per Successful Task
AI Coding 비용도 단순 월 API Bill로 보면 부족하다.
예:
팀 A

$10,000 / month
팀 B
$4,000 / monthB가 더 효율적일까?
실제 성공 Task를 봐야 한다.
팀 A:
Successful Tasks

1,000
↓
$10 / Successful Task팀 B:
Successful Tasks

200
↓
$20 / Successful Task오히려 A가 더 효율적이다.
18. 그런데 AI 비용만 넣어도 부족하다
더 현실적으로는:
AI Compute Cost

+

Human Review Cost

+

Rework Cost

+

CI Cost
를 함께 봐야 한다.
예:
Agent

$0.80
로 만든 코드가:
Senior Review

45분
을 요구하면 실제 비용 구조는 완전히 달라진다.
AI 시대의 가장 비싼 Resource는 Token이 아니라 Senior Engineer의 Attention일 수도 있다.
19. 그래서 추천하는 비용 지표
단순:
Cost per PR보다:
Cost per Verified Merge또는:
Cost per Successful Task가 낫다.
좀 더 발전시키면:
AI Cost

+

Review Time × Internal Rate

+

Rework Time × Internal Rate
를 계산할 수도 있다.
완벽한 회계 숫자를 만들 필요는 없다.
팀 간 Trend를 보는 것만으로도 의미가 있다.
20. 일곱 번째 지표: Developer Friction
숫자로 잡기 어려운 영역도 있다.
AI를 쓰면서 개발자가:
편해졌는가?

오히려 피곤해졌는가?

Review 부담이 늘었는가?

Context Switching이 늘었는가?
다.
지난 글에서 다룬 것처럼 Agent가 Coding Time을 줄이면서 Decision과 Review 부담을 늘릴 수도 있다.
그래서 정기적으로 아주 간단하게 묻는다.
이번 주 AI Agent가
업무를 더 쉽게 만들었나?

1 ───── 5
그리고:
어떤 단계에서
가장 불편했나?
를 체크한다.
이 정도면 충분하다.
21. 자기평가는 버릴 게 아니라 “보조 지표”로 사용한다
GitKraken 조사에서 많은 조직이 개발자의 자기보고에 의존하고 있다는 점은 Measurement Gap의 문제로 지적됐다.
하지만 자기평가 자체가 쓸모없다는 뜻은 아니다.
예:
PR Lead Time ↓

Regression 유지

Developer Friction ↓
라면 굉장히 좋은 변화다.
반면:
PR Lead Time ↓

Developer Friction ↑↑
라면 장기 지속 가능성을 봐야 한다.
Quantitative + Qualitative를 같이 본다.
22. 가장 위험한 것은 “활동량 Dashboard”를 생산성 Dashboard라고 부르는 것이다
이런 Dashboard가 있다고 하자.
AI Sessions

2,831

Tokens

4.8B

Generated LOC

890K

AI PRs

412
멋있다.
하지만 대부분:
Activity다.
실제 Productivity는:
Delivery

Quality

Cost

Developer Experience
에 더 가깝다.
23. Dashboard를 두 층으로 나누면 좋다
첫 번째:
Agent Operations여기에는:
Session

Token

Cost

Model

Latency

Tool Call
을 본다.
두 번째:
Engineering Outcomes여기에는:
Lead Time

Rework

Regression

Successful Task

Intervention

Cost / Success
를 본다.
둘을 섞지 않는다.
24. Agent Usage가 늘었는데 Outcome이 그대로라면?
예:
Agent Token

+180%
Lead Time
변화 없음Regression
변화 없음Throughput
변화 없음이라면 다시 봐야 한다.
Agent가:
이미 사람이 빨리 하던 Task에 집중돼 있을 수도 있다.
혹은:
불필요한 탐색

Retry

중복 Agent
가 많을 수도 있다.
AI 사용량 자체를 성과로 보면 이 문제를 놓친다.
25. 반대로 AI 사용량이 적어도 성과가 클 수 있다
예:
Agent가 Release Pipeline의 반복적인 Failure Analysis 하나만 자동화했다.
월 Agent Token은 적다.
하지만:
Release Failure 대응

90분 → 15분
으로 줄었다.
이런 AI 활용은 사용량은 작지만 ROI가 매우 크다.
따라서:
AI Adoption Depth와:
AI Usage Volume는 다르다.
26. OpenAI Enterprise Signals에서도 비슷한 힌트가 나온다
2026년 6월 기준 OpenAI 기업 고객에서는 Codex가 ChatGPT와 Codex 합산 Output Token의 64%를 차지했다.
즉 기업 AI가 단순 질문·답변에서 실제 업무 위임으로 빠르게 이동하고 있다는 신호다.
하지만 OpenAI가 강조하는 차이는 단순 Token량만이 아니다.
선도 기업은 Agent에게:
Context

Tools

Persistence
를 더 잘 제공하고 실제 업무를 끝까지 위임한다.
즉 Agent 사용량이 아니라 Agent가 완료할 수 있는 Task Boundary가 중요하다.
27. AI Adoption Maturity를 단계로 나눌 수도 있다
LEVEL 1 — Assistant
질문

코드 설명

Autocomplete
LEVEL 2 — Coding Agent
Repository 탐색

파일 수정

Test
LEVEL 3 — Delegated Task
Goal 전달

↓

Agent가 조사

↓

구현

↓

검증

↓

Review-ready 결과
LEVEL 4 — Agentic Workflow
Issue

↓

Agent

↓

CI

↓

Review Agent

↓

Human Gate

↓

Merge
단순 사용 횟수보다 어느 단계까지 업무를 위임했는지를 보는 편이 훨씬 의미 있다.
28. JetBrains 조사도 Agent가 이미 일상 Tool이 됐다는 걸 보여준다
2026년 5~7월 조사에서:
90%

주 1회 이상 Agent 사용
68%
매일 사용이었다.
즉 이제:
Agent 사용 여부는 좋은 조직과 나쁜 조직을 구분하기 어려운 지표가 된다.
다음 차이는:
Agent를 어디까지
업무 시스템에 통합했는가
에서 생길 가능성이 크다.
29. 그렇다고 “AI가 작성한 코드 비율”을 KPI로 만들면 안 된다
예:
올해 목표

AI Generated Code 70%
이런 KPI는 위험하다.
개발자는 자연스럽게 AI에게 더 많은 코드를 생성시킨다.
그게 필요한지와 무관하게.
좋은 KPI는 행동을 올바른 방향으로 유도해야 한다.
AI Generated Code 비율은 오히려:
불필요한 코드 생성

과도한 Refactor

Review 증가
를 유도할 수 있다.
30. JetBrains의 최근 조사도 코드 작성 자체가 빠르게 Agent로 이동하는 것을 보여준다
2026 Developer Ecosystem Survey에서는 개발자들이 실제 업무 코드 중 어느 정도를:
Agent가 완전히 생성

AI 도움을 받아 작성

완전 수동 작성
했는지를 따로 조사했다.
JetBrains는 수동 Coding이 빠르게 감소하고 있지만 모든 개발자가 완전히 Agentic Workflow로 이동한 것은 아니라고 설명한다.
이것도 중요한 포인트다.
AI 코드 비율은 Adoption을 보여줄 수는 있지만 성과 자체를 보여주지는 않는다.
31. 개발자 개인 평가에 AI 지표를 쓰는 것은 특히 위험하다
예:
Developer A

Agent Usage 90%
Developer B
Agent Usage 30%A를 더 높은 성과라고 평가한다면 문제가 생긴다.
B는:
Architecture

Critical Debugging

Mentoring
같은 AI 사용량으로 드러나지 않는 일을 하고 있을 수도 있다.
또 Team Lead가:
AI Token

PR Count

Agent Session
을 개인 KPI로 만들면 개발자가 숫자를 최적화하기 시작한다.
32. AI 생산성은 팀 단위로 보는 편이 낫다
추천:
Team / Project단위로 본다.
예:
Mobile Team

Lead Time

Rework

Regression

Agent Cost

Developer Friction
변화를 본다.
개별 개발자를 순위화하지 않는다.
목적은:
누가 AI를 잘 쓰나?가 아니라:
우리 Workflow 어디에서
AI가 실제 효과를 내나?
를 찾는 것이다.
33. 가장 좋은 방법은 Before / After가 아니라 Cohort 비교다
단순:
AI 도입 전

vs

AI 도입 후
는 다른 변수가 많다.
Release Season이 달라졌을 수 있고,
팀원이 바뀌었을 수도 있고,
프로젝트 난도가 달라졌을 수도 있다.
가능하면 Task 유형을 나눈다.
Bug Fix

Small Feature

Refactor

Migration

Documentation
그리고 비슷한 Task끼리 비교한다.
34. 예를 들어 Bug Fix
AI 없는 Bug Fix:
Median Lead Time

9.4h
AI Agent Bug Fix:
6.1hRegression:
3.1% → 3.0%Rework:
18% → 16%라면 꽤 강한 성과다.
35. 그런데 Feature에서는 다를 수 있다
AI 없는 Feature:
Lead Time

2.8d
AI Feature:
2.2d빨라졌다.
하지만:
Rework

21% → 39%
라면 Agent Context나 요구사항 전달 구조를 개선해야 한다.
이렇게 Task 종류별로 보면 AI가 어디에서 강한지 보인다.
36. AI가 잘하는 작업을 찾아내는 것이 중요하다
예:
Test Generation

효과 매우 큼
Migration
효과 큼Simple Feature
효과 큼Architecture-heavy Feature
Rework 많음이면:
Architecture

Human
Implementation
Agent로 역할을 나눈다.
이게 실제 AI Transformation이다.
37. AI를 사람 대체율로 보지 않는다
나쁜 질문:
이 Agent가 개발자 몇 명을 대체하는가?좋은 질문:
이 Agent가
어떤 종류의 작업 시간을 줄이는가?
이다.
예:
Repository Search

80% 감소

Boilerplate

70% 감소

Test Skeleton

60% 감소

Architecture Review

10% 감소
처럼 본다.
38. 그러면 Agent 투자도 훨씬 합리적으로 할 수 있다
예:
팀에서 가장 큰 병목이:
PR Review인데 AI 예산 대부분을:
Code Generation에 쓰고 있다.
그럼 Agent가 PR을 더 많이 만들면서 오히려 병목을 키울 수 있다.
대신:
PR Summarization

Risk Classification

Architecture Check

Test Evidence
에 Agent를 붙이는 것이 더 효과적일 수 있다.
39. “AI가 더 코딩하게 한다”보다 “병목을 AI로 없앤다”
이게 중요한 전환이다.
기존:
AI Strategy

=

개발자 코드 생성량 증가
보다:
AI Strategy

=

Software Delivery Flow의
가장 느린 부분 제거
가 낫다.
팀마다 병목은 다르다.
Coding

Review

Testing

Release

Incident

Documentation
어디인지 먼저 본다.
40. Agent 투입 순서도 병목 기준으로 정한다
예:
Review 2일

Coding 4시간
이라면 Coding Agent를 더 강하게 만드는 것보다 Review를 먼저 개선한다.
예:
Agent

PR Summary
Risk Areas
Dependency Change
Test Coverage
Architecture Violation
↓
Reviewer가 바로 중요한 Diff부터 본다.
41. 반대로 테스트가 병목이라면
Implementation

2시간

Test 작성

5시간
이라면:
Test Agent가 훨씬 높은 ROI를 낼 수 있다.
AI Adoption은 Tool 중심이 아니라 Constraint 중심으로 해야 한다.
42. 생산성 Dashboard를 너무 크게 시작하지 않는다
처음부터 Metric 30개를 모으면 아무도 안 본다.
추천은 딱 6개다.
PR Lead Time

Review Rework Rate

Regression Rate

Successful Task Rate

Human Intervention Rate

Cost per Successful Task
그리고 개발자 경험은:
Developer Friction하나 추가한다.
43. 가장 작은 Dashboard
예:
AI ENGINEERING

Lead Time
11.2h       ↓ 28%

Rework
17%         ↓ 4%p

Regression
3.2%        → stable

Task Success
78%         ↑ 9%p

Human Intervention
2.3 / task  ↓ 31%

Cost / Success
$3.80       ↓ 18%

Developer Friction
3.9 / 5     ↑
이 정도면 훨씬 읽기 쉽다.
44. 이 Dashboard를 매일 볼 필요도 없다
AI Agent 운영 지표:
Token

Quota

Failure
는 실시간으로 볼 수 있다.
하지만 생산성은:
주간

월간
으로 봐야 한다.
하루 데이터는 Noise가 너무 크다.
45. 주간에는 운영 문제를 본다
Agent Failure 증가?

Retry 증가?

Human Intervention 증가?

Cost Spike?
같은 것이다.
46. 월간에는 Outcome을 본다
Lead Time

Rework

Regression

Delivery

Cost
변화를 본다.
그리고 한 가지 개선만 선택한다.
예:
다음 달

Agent-generated PR을
400줄 이하로 제한해본다.
같은 식이다.
47. 실험으로 운영하는 게 가장 좋다
예:
Team A

기존 Workflow
Team B
Agent Plan → Agent Implementation4주간 비교.
또는 같은 팀에서:
Bug Fix

Agent 사용
Feature
기존 방식으로 나눈다.
조직 전체에 한 번에 Policy를 적용하기보다 작은 Experiment로 검증한다.
48. “AI 생산성”이 아니라 “AI Workflow 생산성”을 측정한다
모델 하나의 성능만 보는 것도 부족하다.
예:
Claude Code

vs

Codex
를 비교한다고 하자.
단순 Benchmark보다 실제 Workflow를 비교한다.
Task Success

Review Time

Human Intervention

Cost

Regression
을 본다.
그러면:
Agent A

더 똑똑하지만
사람을 자주 호출
Agent B
조금 덜 강하지만
독립적으로 완료같은 차이가 보인다.
실제 팀에서는 B가 더 생산적일 수 있다.
49. Agent 성능도 “최종 결과까지” 측정해야 한다
예:
Coding Success

95%
만 봐서는 부족하다.
실제:
Merge Success

78%
Production Success
74%라면 그 차이를 봐야 한다.
Agent Benchmark가 아닌 Software Delivery Benchmark가 필요하다.
50. AI 생산성의 네 축으로 정리할 수 있다
복잡한 지표를 네 그룹으로 줄이면 편하다.
SPEEDQUALITYCOSTHUMAN이다.
51. SPEED
Task Lead Time

PR Lead Time

Review Lead Time
52. QUALITY
Rework

Regression

Failed CI

Rollback
53. COST
Agent Cost

CI Cost

Cost / Successful Task
54. HUMAN
Human Intervention

Review Time

Developer Friction

Context Switching
이 네 개가 균형을 이뤄야 한다.
55. 하나만 좋아지면 성공이라고 보기 어렵다
예:
Speed

+70%
Quality
-30%이면 문제가 있다.
또:
Speed

+20%
Cost
+400%도 재검토해야 한다.
반대로:
Speed

+25%

Quality

Stable

Cost

+10%

Human Friction

-20%
이라면 매우 좋은 AI 도입일 수 있다.
56. AI Coding ROI를 단순한 인건비 절감으로 계산하지 않는다
예:
개발자 시간

30% 절약
이라고 해서:
개발자 30% 줄일 수 있음으로 계산하면 잘못된 방향으로 갈 수 있다.
절약된 시간은:
Architecture

Testing

Customer Problem

Technical Debt

Platform Improvement
으로 이동할 수 있다.
실제로 AI가 만든 가장 큰 가치는 같은 개발자 수로 더 중요한 문제를 처리하는 것일 수도 있다.
57. OpenAI Enterprise Signals의 방향도 여기에 가깝다
OpenAI의 최신 Enterprise Signals에서는 선도 기업이 단순히 AI를 더 많이 사용하는 것을 넘어:
Assistance

↓

Delegation

↓

Execution
으로 이동하고 있다고 설명한다.
AI가:
답을 알려주는 Tool에서:
업무를 끝내는 Worker로 바뀌는 것이다.
그렇다면 조직의 측정 방식도:
질문 수

Prompt 수

Token
에서:
완료된 업무

품질

비용

사람 개입
으로 바뀌어야 자연스럽다.
58. 개발팀에서 가장 먼저 측정해볼 세 가지
처음 시작한다면 모든 지표가 필요하지 않다.
딱:
PR Lead TimeReview Rework RateRegression Rate만 봐도 된다.
이 세 개가:
Lead Time ↓

Rework ↓

Regression 유지
로 간다면 AI Workflow가 꽤 잘 동작하고 있을 가능성이 높다.
59. 그다음 Agent 지표를 추가한다
Successful Task RateHuman Intervention Rate를 추가한다.
그러면 Agent 자체의 작업 품질이 보이기 시작한다.
60. 마지막에 Cost를 붙인다
Workflow가 안정된 뒤:
Cost per Successful Task를 본다.
처음부터 Cost만 줄이면 Agent 품질을 과하게 희생할 수 있다.
순서는:
Quality

↓

Workflow

↓

Cost
가 좋다.
61. AI Tool 선택도 이런 데이터로 하면 된다
예:
Claude Code

Task Success 82%
Human Intervention 1.8
Cost $4.2
Codex
Task Success 79%
Human Intervention 1.1
Cost $3.5Tool C
Task Success 65%
Human Intervention 5.2
Cost $1.8그럼 실제 팀 환경에서 무엇이 좋은지 훨씬 판단하기 쉽다.
인터넷 Benchmark 하나보다 유용하다.
62. 모델 Routing에도 그대로 사용할 수 있다
예:
Simple Bug

빠른 모델
Architecture
강한 모델Search
작은 모델로 나눴다.
그 뒤 Successful Task와 Cost를 본다.
데이터가 좋으면 유지.
나쁘면 변경.
이렇게 Model Routing도 경험이 아니라 측정으로 개선한다.
63. AI Productivity 측정의 목적은 감시가 아니다
이 부분이 중요하다.
이 데이터를:
개발자 순위

성과 평가

AI 사용 강제
에 사용하면 개발자가 숫자를 Gaming하기 시작한다.
그 순간 Metric의 의미가 사라진다.
목적은:
Workflow 개선

Tool 선택

병목 발견

Budget 조절
이어야 한다.
64. 개발자에게 Metric이 투명해야 한다
예:
이 지표는 개인 평가에 사용하지 않습니다.

팀 Workflow 개선에만 사용합니다.
를 명확하게 한다.
그리고 개인별 Token Dashboard보다:
Project

Team

Task Type
중심으로 본다.
이게 조직 신뢰에도 훨씬 낫다.
65. “AI를 많이 쓰는 사람이 좋은 개발자”라는 메시지를 만들지 않는다
Senior Developer는 어떤 Task에서는 AI를 거의 사용하지 않을 수 있다.
예:
신규 Architecture

Production Incident

Security Decision
이다.
반대로 Junior는:
Documentation

Test

Boilerplate
에서 Agent 사용량이 높을 수 있다.
사용량은 역할에 따라 다르다.
그래서 AI Adoption을 개인 역량으로 해석하지 않는다.
66. 개발자에게 중요한 것은 AI 활용률보다 위임 품질이다
좋은 위임:
Goal 명확

Scope 명확

Constraint 명확

Validation 명확
나쁜 위임:
알아서 해줘.AI를 많이 쓰는 사람이 아니라 잘 위임하는 사람이 더 좋은 결과를 낼 수 있다.
이것도 앞으로 중요한 Engineering Skill이 될 가능성이 크다.
67. 결국 회사가 해야 할 일은 Tool 배포 이후부터 시작된다
AI Coding Tool을 사는 것:
STEP 1이다.
진짜 어려운 부분은:
STEP 2

Workflow 통합
STEP 3
PolicySTEP 4
ValidationSTEP 5
Measurement이다.
Tool 배포가 AI Transformation의 끝이 아니다.
오히려 시작이다.
68. JetBrains도 비슷한 문제를 지적하고 있다
JetBrains가 2026년 Agentic Software Development Platform을 소개하면서 지적한 부분 중 하나도 이 점이다.
AI가 개인 생산성에는 크게 기여했지만, 조직 차원에서:
Software Delivery Speed

Reliability

Cost Efficiency
로 연결되는 효과는 아직 제한적이라는 것이다.
즉:
개발자가 AI를 잘 씀과:
회사의 Software Engineering 성과가 좋아짐사이에 간극이 있다.
이 간극을 메우는 것이 다음 단계다.
69. 그래서 2026년 Engineering Leader의 질문도 바뀌어야 한다
예전:
우리 개발자 몇 %가 AI를 사용하나?지금:
AI를 사용하는 Task는
Lead Time이 얼마나 줄었나?
Rework가 늘었나 줄었나?Regression은?사람 개입은 얼마나 필요한가?Task 하나를 끝내는 비용은?로 가야 한다.
70. 마무리
AI Coding Agent 도입 자체는 이제 특별한 일이 아니다.
JetBrains 조사에서는 전문 개발자의 90%가 이미 주 1회 이상 Coding Agent를 사용하고 있고, GitKraken 조사에서는 96.4%의 팀이 AI Coding Tool을 도입했다.
즉:
AI를 도입했는가?라는 질문은 빠르게 의미를 잃고 있다.
그런데 동시에 재미있는 모순이 있다.
GitKraken 조사에서는:
84%

"AI 때문에 생산성이 높아졌다."
고 느끼지만,
39%

측정 방법 없음
33%
개발자 자기보고 의존이었다.
즉 대부분의 팀은:
빨라진 것 같다.까지는 알고 있다.
하지만:
어디가

얼마나

왜

좋아졌는가?
는 잘 모른다.
이게 2026년 AI Coding의 Proof Gap이다.
그래서 이제 개발팀이 봐야 할 것은:
Token

AI 사용 횟수

Generated LOC

PR 개수
같은 Activity가 아니다.
더 중요한 것은:
PR Lead Time

Review Rework

Regression

Successful Task

Human Intervention

Cost per Successful Task
이다.
그리고 이 지표들은 한 가지 질문에 답해야 한다.
AI Agent가
더 많은 코드를 만들었는가?
가 아니라:
AI Agent 덕분에
더 좋은 Software가

더 적은 사람의 노력으로

더 빠르게 Production에 도착했는가?
이다.
OpenAI의 최신 Enterprise Signals도 기업 AI 활용이 단순한 Assistance에서 Delegation과 Execution으로 이동하고 있다고 보여준다.
그렇다면 측정 방식도 같이 바뀌어야 한다.
AI가 몇 번 사용됐는지를 세는 시대에서,
AI에게 맡긴 일이 실제로 얼마나 잘 끝났는지를 측정하는 시대로 가야 한다.
한 문장으로 정리하면 이렇다.
AI Coding Agent 도입 경쟁은 이미 끝나가고 있다. 이제 좋은 개발 조직을 구분하는 것은 AI를 얼마나 많이 쓰는가가 아니라, AI가 실제 Software Delivery를 얼마나 개선했는지 증명할 수 있는가다.
앞으로 CTO나 Engineering Leader에게 가장 어려운 질문은:
우리 회사도 AI Agent 씁니다.가 아닐 것이다.
그 다음 질문이다.
그래서

Lead Time은 얼마나 줄었고,

Quality는 유지됐으며,

개발자는 얼마나 덜 개입했고,

Task 하나당 비용은 어떻게 변했습니까?
여기에 답할 수 있는 팀부터 AI를 도구가 아니라 Engineering System으로 쓰기 시작한 팀이라고 볼 수 있다.
참고 자료
-
JetBrains — AI Coding Agents: Adoption Trends 2026
15,000명 이상의 전문 개발자를 대상으로 한 2026 Developer Ecosystem Survey에서 90%가 주 1회 이상, 68%가 매일 AI Coding Agent를 사용한다고 보고한다. -
GitKraken — State of AI 2026
554명의 개발자와 Engineering Leader를 대상으로 조사. 팀의 96.4%가 AI Coding Tool을 도입했고, 개발자 84%가 더 생산적이라고 느끼지만 39%의 조직은 AI 영향을 측정할 방법이 없고 33%는 자기보고에 의존한다고 설명한다. -
GitKraken — Everyone Feels Faster. Almost Nobody Can Prove It
AI Engineering에서 Adoption보다Proof Gap이 중요한 문제가 됐다는 2026년 분석. 실제 생산성을 구체적으로 측정하는 조직은 약 20%에 불과하다고 설명한다. -
OpenAI — Enterprise Signals: What frontier firms are doing differently
2026년 6월 기업 고객의 Codex와 ChatGPT 합산 Output Token 가운데 Agentic AI 사용량이 64%를 차지했으며, 선도 기업은 같은 모델을 사용하면서도 Agent에게 Context·Tool·Persistence를 제공하고 Assistance에서 Delegation으로 더 깊게 이동하고 있음을 보여준다. -
JetBrains — How Much Code Do Developers Really Let Agents Write?
2026 Developer Ecosystem Survey를 바탕으로 업무 코드 중 Agent 완전 생성·AI 지원 작성·수동 작성 비율을 조사하며, 코드 생성 자체가 빠르게 Agent 쪽으로 이동하고 있음을 보여준다. -
JetBrains — Introducing JetBrains Central
AI가 개인 개발자의 생산성에는 크게 영향을 주고 있지만 전체 Software Delivery Lifecycle과 Reliability·Cost Efficiency 개선으로 연결되는 조직은 아직 제한적이라는 문제를 지적한다.
핵심 참고 포인트
2026년 데이터에서 가장 분명한 것은 AI Coding Agent Adoption 자체가 거의 차별화 요소가 아니라는 것이다. JetBrains 조사에서는 90%의 전문 개발자가 이미 Agent를 주 1회 이상 사용하고 있으며 GitKraken 조사에서는 96.4%의 팀이 AI Coding Tool을 도입했다. 따라서 조직의 다음 경쟁은 Adoption Rate보다 실제 Engineering Outcome으로 이동할 가능성이 높다.
반면 생산성 증명에는 큰 간극이 남아 있다. 개발자의 84%가 AI 때문에 더 생산적이라고 느끼지만 상당수 조직은 이를 객관적인 지표로 측정하지 못한다. 그래서 Token·Generated LOC·AI PR Count 같은 Activity Metric보다 PR Lead Time·Review Rework·Regression·Successful Task Rate·Human Intervention·Cost per Successful Task처럼 실제 Software Delivery 결과와 연결된 지표를 보는 편이 더 적합하다.
OpenAI의 최신 기업 데이터에서도 AI 활용은 질문과 보조에서 실제 업무를 위임하는 Agentic Execution으로 이동하고 있다. 따라서 앞으로 생산성 측정도 “AI를 사용했는가”가 아니라 Agent에게 맡긴 일이 사람의 불필요한 개입 없이 검증 가능한 결과까지 얼마나 자주 도달하는가를 중심으로 바뀌는 것이 자연스럽다.