GPT-6 Astra 이후, Coding Agent는 Engineering Agent가 된다
GPT-6 Astra 이후, Coding Agent는 Engineering Agent가 된다
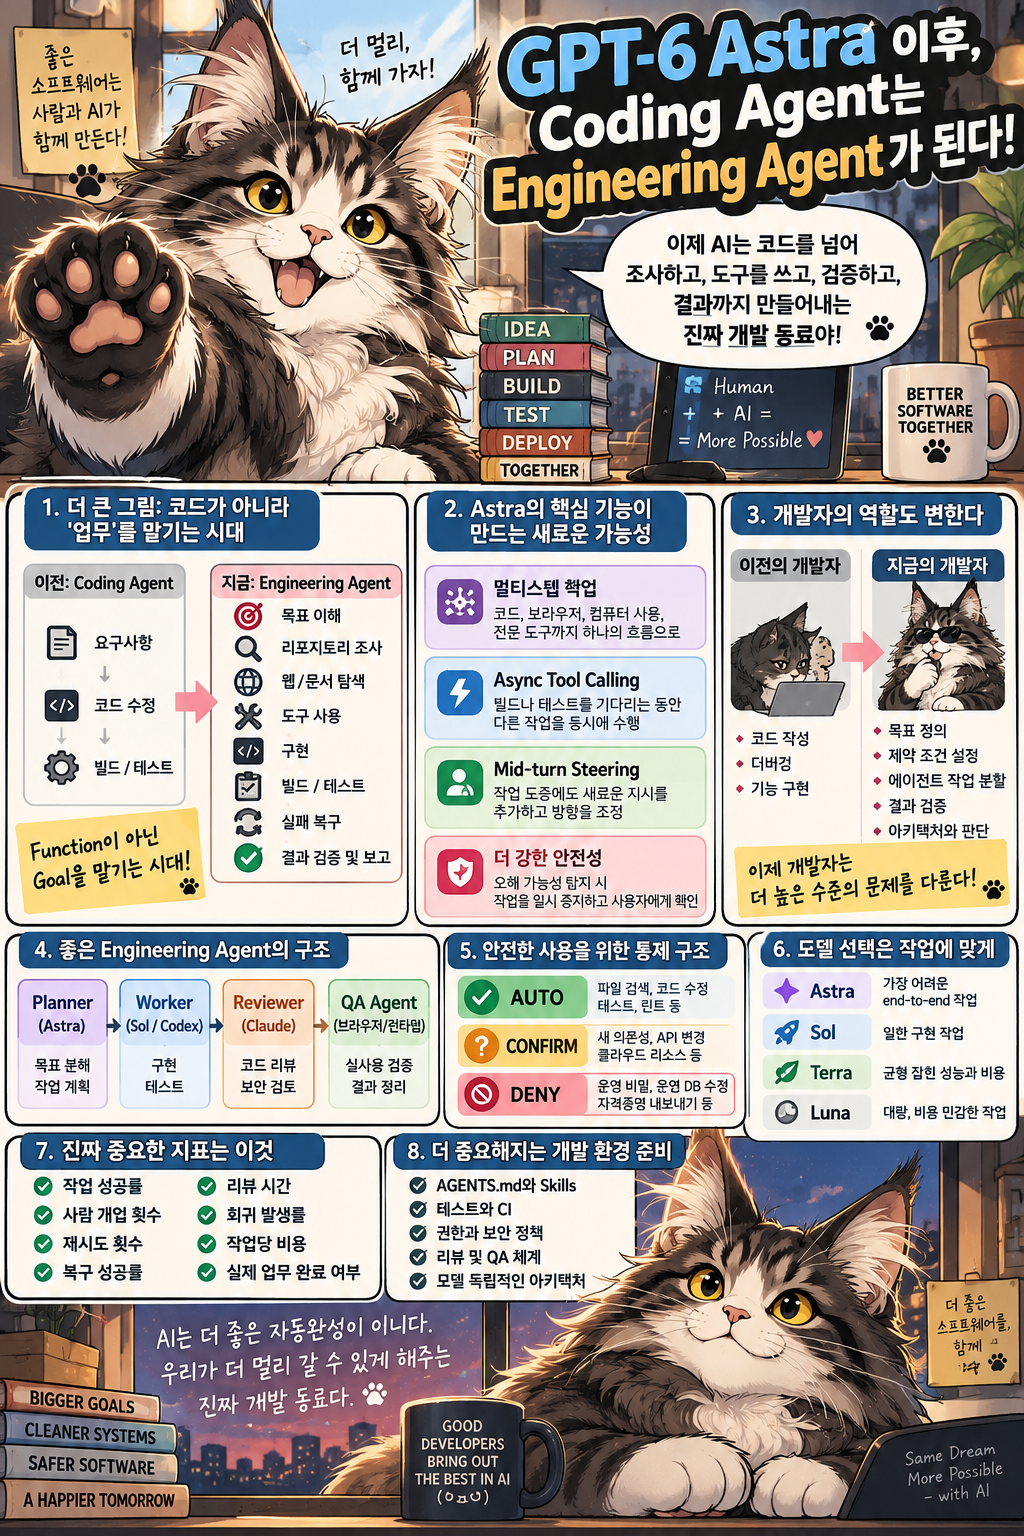
GPT-6 Astra가 나온 지금, 개발자 입장에서 가장 중요한 변화는 모델 점수 하나가 더 올라갔다는 사실이 아니다.
OpenAI는 Astra를 단순한 코딩 모델이 아니라 복잡한 추론·코딩·브라우징·컴퓨터 사용·전문 업무를 하나의 멀티스텝 작업으로 수행하는 모델로 소개하고 있다. 특히 코드, 브라우저, 전문 소프트웨어를 오가며 end-to-end 작업을 수행하는 능력을 전면에 내세웠다.
이 변화는 Coding Agent라는 말의 의미를 바꾼다.
지금까지의 Coding Agent가 대략 이런 역할이었다면,
요구사항
  ↓
Repository 조사
  ↓
코드 수정
  ↓
Build / Test
Astra 이후의 Agent는 점점 이런 형태에 가까워진다.
Goal
  ↓
Repository 조사
  ↓
관련 문서 조사
  ↓
Browser 사용
  ↓
전문 도구 실행
  ↓
구현
  ↓
Build / Test
  ↓
실패 원인 분석
  ↓
다른 방법으로 복구
  ↓
Runtime 확인
  ↓
결과물 생성
  ↓
Human Review
즉 Coding Agent에서 Engineering Agent로 이동하고 있다.
1. Astra의 핵심은 코드를 더 잘 쓰는 것이 아니다
GPT-6 Astra는 2026년 9월 3일 발표됐다.
OpenAI는 Astra를 “가장 어려운 end-to-end work”를 위한 모델이라고 설명하고 있으며, software engineering뿐 아니라 computer use, browsing, science, research, 문서·스프레드시트·프레젠테이션 제작까지 하나의 작업 흐름에서 다룰 수 있도록 설계했다고 밝히고 있다.
이 설명에서 중요한 단어는 coding보다 end-to-end다.
기존 Coding Agent의 성공 기준은 보통:
코드를 수정했는가?였다.
Engineering Agent의 성공 기준은 다르다.
요청된 업무가
실제로 완료됐는가?
다.
예를 들어:
신규 결제 Flow를 만들고 실제 브라우저에서 검증한 뒤 QA 결과까지 정리해.
라는 Goal이 있다고 하자.
Coding Agent라면:
React 코드 작성
API 연결
Test 작성
정도까지 갈 수 있다.
Engineering Agent는:
기존 결제 구조 조사
        ↓
Backend API 확인
        ↓
Frontend 구현
        ↓
브라우저 실행
        ↓
결제 Flow 사용
        ↓
Console / Network 확인
        ↓
실패 발견
        ↓
코드 수정
        ↓
재검증
        ↓
결과 정리
까지가 하나의 Task다.
개발 단위 자체가 달라지는 것이다.
2. 코드가 아니라 ‘업무’를 맡기기 시작한다
예전 Prompt는 이런 식이었다.
이 함수 리팩터링해줘.조금 지나서는:
이 Feature 구현하고 테스트까지 해줘.였다.
앞으로는 점점 이렇게 바뀔 가능성이 크다.
회원가입 전환율이 떨어지는 원인을 조사하고,
관련 Frontend 문제를 수정한 뒤
실제 Browser에서 Flow를 검증해.
이 요청에는:
Data 조사
UI 분석
코드 탐색
구현
브라우저 조작
QA
결과 보고
가 동시에 들어 있다.
Astra가 강조하는 것도 이런 멀티스텝 Workflow다. OpenAI 공식 문서는 Astra가 코드, 브라우저, 전문 소프트웨어 사이를 오가며 복합적인 작업을 수행하도록 설계됐다고 설명한다.
이제 AI에게 맡기는 단위가:
Function에서:
Feature를 거쳐:
Engineering Goal로 커지고 있다.
3. Async Tool Calling이 이 변화에서 상당히 중요하다
Astra에는 눈에 띄는 기능이 하나 있다.
Async Tool Calling이다.
기존 Agent Workflow는 흔히:
Agent
  ↓
Tool 호출
  ↓
기다림
  ↓
Tool 결과
  ↓
다음 작업
형태였다.
Build가 3분 걸리면 Agent도 사실상 기다렸다.
Astra에서는 Tool을 비동기로 호출한 상태에서도 다른 작업을 계속 수행할 수 있다. Application이 실제 Tool 실행과 Pending 상태를 관리하고, 결과가 준비되면 기존 call_id를 이용해 다시 전달하는 구조다.
개발 Workflow에 적용하면:
Agent
 ├─ Backend Test 실행 ───────────┐
 │                              │
 ├─ 기다리지 않고 Frontend 조사 │
 │                              │
 ├─ Docs 확인                    │
 │                              │
 └─ Test 결과 수신 ◀────────────┘
이런 형태가 가능해진다.
사람 개발자와 비슷하다.
개발자가:
빌드 돌려놓고

↓

다른 파일 확인하고

↓

문서 읽고

↓

빌드 끝나면 결과 확인
하는 것처럼 Agent도 Tool Waiting Time을 다른 작업에 사용할 수 있다.
이건 단순한 속도 개선 이상의 변화다.
Agent가 작업 Scheduler처럼 행동하기 시작한다.
4. Mid-turn Steering도 개발환경에서는 큰 변화다
Astra의 또 다른 새 기능은 Mid-turn Steering이다.
Agent가 긴 작업을 수행하는 도중 추가 지시를 넣을 수 있다.
예를 들어 Agent가 작업 중이다.
Repository 조사
↓
Architecture 분석
↓
Implementation 진행 중...
그때 개발자가:
잠깐.
기존 Public API는 절대 변경하지 마.
라고 추가한다.
예전에는 작업을 중단하고 다시 Prompt를 만들어야 하는 경우가 많았다.
Mid-turn Steering에서는:
기존 Goal
+
현재 Context
+
추가 Constraint
를 유지한 상태에서 방향을 바꿀 수 있다.
실제 개발팀에서 Tech Lead가:
그 방향 말고 기존 Interface 유지하면서 해주세요.
라고 중간에 이야기하는 것과 비슷하다.
Agent가 단순 명령 실행기가 아니라 계속 협업 중인 Worker에 가까워진다.
5. 그러면 개발자의 역할도 바뀐다
AI가 코드를 더 많이 작성한다고 개발자의 역할이 사라지는 것은 아니다.
오히려 개발자가 다뤄야 하는 추상화 수준이 올라간다.
기존:
Developer

코드 작성
Agent 시대:
Developer

Goal 정의
Constraint 정의
Architecture 판단
Agent 작업 분할
결과 검증
즉 개발자는:
어떻게 구현할까?를 고민하는 시간 일부를 줄이고,
무엇을 맡길까?

어디까지 맡길까?

어떤 결과면 성공인가?

어떤 판단은 사람이 해야 하나?
를 더 많이 고민하게 된다.
최근 Coding Agent에서 이미 보이던 변화인데 Astra 같은 모델에서는 훨씬 명확해질 가능성이 크다.
6. 가장 중요한 것은 Goal을 제대로 만드는 능력이다
Engineering Agent에게:
이 앱 개선해줘.라고 하면 너무 넓다.
반대로:
Button padding을 8에서 12로 바꿔.라고 하면 Engineering Agent를 사용하는 의미가 줄어든다.
좋은 Goal은 이 중간이다.
예:
Goal:
신규 사용자의 가입 완료율을 떨어뜨리는
Frontend UX 문제를 조사하고 수정한다.

Scope:
signup 관련 React components만 수정 가능.

Constraints:
Backend API 변경 금지.
새 Dependency 추가 금지.

Validation:
Desktop + Mobile Browser에서
회원가입 Flow를 실제 수행한다.

Completion:
- Build PASS
- E2E PASS
- Console Error 없음
- 변경 내용과 발견된 UX 문제 보고
이 정도가 Engineering Agent에게 적절하다.
즉 Prompt Engineering보다 앞으로 더 중요한 것은 Goal Engineering일 수 있다.
7. AGENTS.md와 Skills가 오히려 더 중요해진다
모델이 강해질수록:
이제 세부 규칙 안 적어도 알아서 잘하겠지.라고 생각하기 쉽다.
그런데 OpenAI의 Astra 가이드는 오히려 반대 방향을 주의시킨다.
Astra는 이전 모델보다 instruction following이 강하고, AGENTS.md나 Skills처럼 접근 가능한 파일의 지침에도 더 민감하게 반응할 수 있다. OpenAI는 여러 Skills와 instruction file을 사용하는 환경에서는 서로 충돌하거나 조용히 영향을 주는 지침을 감사할 것을 권장하고 있다.
즉 모델이 강할수록:
AGENTS.md
Skills
Architecture Docs
Security Policy
Testing Rules
의 품질이 더 중요해질 수 있다.
강한 Agent는 잘못된 지시도 더 충실히 수행할 가능성이 있기 때문이다.
8. AGENTS.md는 ‘설명서’보다 경계선이어야 한다
좋은 AGENTS.md는 모든 Architecture를 설명하는 2만 줄짜리 문서가 아니다.
예:
# Project Rules

- Public API 변경 전 확인한다.
- 새 Dependency를 임의로 추가하지 않는다.
- Production Credential을 읽지 않는다.
- 관련 테스트 없이 완료 처리하지 않는다.
- 테스트하지 못한 부분은 Not Verified로 보고한다.
- Architecture 변경은 먼저 계획을 제시한다.
이런 규칙이 더 중요하다.
Agent 입장에서:
무엇을 할 수 있는가?보다:
무엇은 하면 안 되는가?를 명확하게 만드는 것이다.
Engineering Agent의 자율성이 높아질수록 Boundaries가 중요해진다.
9. Skill은 ‘작업 방법’을 고정한다
예를 들어 iOS Bug Fix Skill을 만들 수 있다.
Goal 확인
↓
관련 코드 조사
↓
재현
↓
가설 작성
↓
수정
↓
Build
↓
관련 Test
↓
Simulator 확인
↓
완료 보고
Web QA Skill:
Scenario 확인
↓
Browser 실행
↓
실제 사용자 Flow 수행
↓
Console 확인
↓
Network 확인
↓
Screenshot / Trace
↓
UX Finding
Security Skill:
Git Diff
↓
Secret
↓
Auth
↓
Authorization
↓
PII
↓
Cloud Permission
↓
Dependency
↓
Risk 등급
Astra가 강해졌다고 Workflow가 사라지는 것이 아니다.
오히려 좋은 Workflow를 훨씬 더 안정적으로 수행할 수 있게 되는 것에 가깝다.
10. Engineering Agent에게 모든 권한을 주면 안 된다
여기서 중요한 문제가 발생한다.
Astra는 OpenAI가 지금까지 광범위하게 배포한 모델 가운데 처음으로 사이버보안 능력이 Preparedness Framework의 Critical 기준에 도달한 모델이다. OpenAI는 Astra가 적절한 도구와 접근권한이 있을 경우 새로운 보안 취약점을 찾고 활용하는 작업까지 매우 강해졌다고 설명한다.
이건 개발자에게도 중요한 신호다.
모델이 강해질수록:
Shell
Git
AWS
Production
Database
Browser
Credential
에 대한 접근을 더 신중하게 관리해야 한다.
Agent Capability가 올라갈수록 Permission 설계가 더 중요해진다.
11. 그래서 AUTO / CONFIRM / DENY가 필요하다
예를 들어:
AUTO
파일 검색
코드 수정
Unit Test 실행
Local Build
Formatting
Lint
CONFIRM
새 Dependency 추가
Public API 변경
Database Migration
새 Cloud Resource
외부 서비스 연결
DENY
Production Secret 읽기
Production DB 직접 수정
main 강제 Push
Security Policy 해제
Credential Export
이런 식으로 나눈다.
강한 Agent에게:
알아서 해.가 아니라:
여기까지는 알아서 해.
그 이상은 물어봐.
여기는 절대 건드리지 마.
를 정의한다.
12. OpenAI가 Astra에 추가 Safety Monitoring을 넣은 이유도 여기 있다
OpenAI는 Astra가 사용자의 지시를 잘못 해석했을 가능성을 탐지하는 추가 Safety Monitoring을 도입했다고 밝혔다.
잠재적인 문제가 감지되면 Conversation이나 작업을 일시 중지하거나 종료하고 사용자가 검토하도록 할 수 있다.
이건 앞으로 Agent Runtime에 중요한 개념이 될 수 있다.
Agent
   ↓
Action
   ↓
Runtime Monitor
   ↓
Expected Boundary?
     │
 YES │ NO
     │
     ▼
 Continue   Pause
               ↓
            Human
즉 AI Model 자체만 강해지는 것이 아니라:
AI
+
Monitor
+
Policy
+
Human Gate
형태의 시스템이 중요해진다.
13. Coding Agent 하나가 모든 걸 할 필요도 없다
Astra가 매우 강한 모델이라고 해서 모든 작업을 Astra 하나에게 맡기는 것이 반드시 좋은 Architecture는 아니다.
오히려 역할을 나눌 수 있다.
Astra
= Planner / Complex Engineering

Codex Worker
= Implementation

Claude
= Independent Review

Playwright
= Web Runtime Verification

CI
= Deterministic Gate
또는 OpenAI 모델 안에서도:
Astra
= 어려운 판단

Sol
= 일반 구현

Terra
= 반복 작업

Luna
= 대량 저비용 작업
처럼 Routing할 수 있다.
OpenAI의 현재 모델 가이드에서도 Astra는 가장 어려운 end-to-end work를 위한 모델로, Terra는 intelligence와 cost의 균형, Luna는 비용 민감한 대량 작업에 적합한 모델로 분류하고 있다.
즉 Engineering Agent 시대에는 모델 하나보다 팀 구성이 중요해진다.
14. 개인 개발자도 작은 AI 개발팀을 만들 수 있다
예를 들어 Workspace가:
workspace/

├── ios-app/
├── android-app/
├── web/
└── backend/
처럼 여러 Git Repository로 나뉘어 있다고 하자.
상위 Orchestrator:
Codex / Astra하위 작업:
ios-app
→ 구현 Agent

android-app
→ 조사 Agent

web
→ Browser QA Agent

backend
→ Test Agent
그리고 독립 Reviewer:
Claude Review를 붙인다.
구조는:
                    Human
                      │
                      ▼
                Astra / Codex
                  Orchestrator
                      │
       ┌──────────────┼──────────────┐
       ▼              ▼              ▼
     iOS Agent    Android Agent   Web Agent
       │              │              │
       └──────────────┼──────────────┘
                      ▼
                 Build / Tests
                      │
                      ▼
                Claude Review
                      │
                      ▼
                  Runtime QA
                      │
                      ▼
                    Human
한 명의 개발자가 작은 개발조직을 운영하는 구조다.
15. 여기서 Astra는 ‘최고의 코더’보다 ‘상위 오케스트레이터’에 더 어울릴 수 있다
Astra는 API 기준 input 100만 토큰당 10달러, output 50달러다.
GPT-5.6 Sol은 input 4달러, output 20달러다. 두 모델 모두 1,050,000 token context와 최대 128,000 output token을 지원한다.
Astra는 Sol보다 토큰 단가가 2.5배 높다.
따라서 모든 작은 작업을 Astra에 맡기는 것은 비용 면에서 비효율적일 수 있다.
예:
Import 정리
→ Astra

Naming 수정
→ Astra

Unit Test Fixture
→ Astra
보다:
복잡한 Goal 분해
→ Astra

Repository-wide 설계 판단
→ Astra

일반 구현
→ Sol / Terra

반복적인 작업
→ Luna
가 훨씬 현실적이다.
16. 하지만 단순 Token 가격만 보면 안 된다
OpenAI는 Astra가 일부 평가에서 이전 모델보다 훨씬 적은 출력 토큰으로 더 높은 성능을 달성해, 높은 토큰 단가에도 불구하고 Task 단위 예상 비용을 낮출 수 있다고 설명한다.
이건 Coding Agent에서도 중요하다.
예:
Sol

3번 시도
+
긴 Log
+
Human Intervention
대:
Astra

1번 시도
+
완료
라면 Astra가 비싸더라도 전체 비용은 낮을 수 있다.
그래서 봐야 하는 것은:
Cost per Token보다:
Cost per Successful Task다.
17. Engineering Agent 시대의 진짜 KPI
이제 Agent 성능을:
Generated LOC

Token

PR Count
로 보면 안 된다.
더 중요한 지표는:
Successful Task Rate

Human Intervention Count

Retry Count

Recovery Success Rate

Review Time

Regression Rate

Cost per Successful Task
이다.
예를 들어:
Agent A

작업 성공 95%
사람 개입 1회
Review 10분
Agent B
작업 성공 95%
사람 개입 9회
Review 40분같은 성공률이라도 실제 생산성은 완전히 다르다.
18. 특히 Human Attention이 핵심 자원이 된다
Agent는 동시에 여러 개 돌릴 수 있다.
사람은 그렇지 않다.
Agent 1
Agent 2
Agent 3
Agent 4
가 동시에 작업을 끝내면:
Review Queue가 생긴다.
그래서 좋은 Engineering Agent는:
많은 일을 하는 Agent보다:
사람이 쉽게 검토할 수 있는
완료된 결과를 가져오는 Agent
가 되어야 한다.
19. 그래서 완료 보고 형식도 바꿔야 한다
Agent가:
완료했습니다.라고 하면 부족하다.
추천하는 완료 Report:
## 변경

관련 파일 4개 수정

## 이유

원인은 Task cancellation 이후
state update가 계속 발생한 것.

## 실제 검증

Build PASS
Unit Test 42/42 PASS

## Runtime

Simulator 정상

## 미검증

Physical Device

## Human Decision

없음
이런 결과가 훨씬 Review하기 쉽다.
Engineering Agent의 생산성을 높이려면 출력량이 아니라 Review 비용을 줄여야 한다.
20. Agent가 강해질수록 Test는 더 중요하다
역설적으로 AI가 더 똑똑해질수록 테스트가 덜 필요해지는 게 아니다.
오히려 더 중요해진다.
강한 Agent는 더 많은 코드를 더 빠르게 수정할 수 있기 때문이다.
Agent Capability ↑

↓

Change Surface ↑
좋은 방향이면 생산성이 빠르게 올라간다.
틀린 방향이면 잘못된 변경도 빠르게 확산된다.
그래서:
Agent Opinion보다:
Compiler
Test
Runtime
를 우선해야 한다.
21. Agent가 만든 Test도 그대로 믿으면 안 된다
Agent가:
구현
+
Test
를 같이 작성했다.
그리고 Test가 통과했다.
끝일까?
아니다.
Agent가 요구사항을 잘못 이해했다면:
틀린 구현
+
틀린 테스트
=
PASS
가 가능하다.
그래서 중요한 기능에서는:
Acceptance Criteria

↓

독립 Reviewer

↓

Runtime Verification
을 분리해야 한다.
22. Review Agent와 Coding Agent를 분리하는 이유
예를 들어 Codex가 구현했다고 하자.
Claude에게 별도로 Review를 맡긴다.
Codex
→ Implementation

Claude
→ Review
서로 다른 모델을 반드시 써야 한다는 의미는 아니다.
중요한 것은 Context를 분리하는 것이다.
작성 과정의 가정을 가진 Agent가 자기 코드를 평가하는 것보다:
Task
Diff
Architecture
Tests
만 받은 Reviewer가 독립적으로 보는 편이 좋다.
23. QA도 또 다른 Agent로 분리한다
Review:
Source
Diff
Architecture
QA:
Running Product
User Goal
Runtime
를 본다.
예:
Implementation
      ↓
Build/Test
      ↓
Code Review
      ↓
Runtime QA
      ↓
Human Gate
이 구조가 Engineering Agent 시대에 더 자연스럽다.
24. Web에서는 이미 상당 부분 가능하다
Web Frontend라면:
Goal
  ↓
Agent 구현
  ↓
Browser
  ↓
Playwright
  ↓
DOM / ARIA
  ↓
Click / Type / Scroll
  ↓
Console
  ↓
Network
  ↓
Screenshot / Video / Trace
까지 하나의 Workflow로 묶을 수 있다.
Astra가 Computer Use와 Browser Use에서 강해지는 방향은 결국 이런 Runtime Engineering을 더 자연스럽게 만들 가능성이 높다. OpenAI는 Astra를 browser와 computer use에서 새로운 frontier를 세운 모델로 소개하고 있다.
25. 모바일도 결국 같은 방향으로 갈 가능성이 높다
iOS:
Source
↓
Build
↓
Simulator
↓
Accessibility
↓
Interaction
↓
Recording
↓
Runtime Log
Android:
Source
↓
Gradle
↓
Emulator
↓
Semantics
↓
Interaction
↓
Logcat
현재는 Browser보다 연결이 복잡하다.
하지만 개발도구가 Agent에게 Semantic UI와 Runtime 상태를 더 많이 제공할수록 Web과 비슷한 구조가 될 가능성이 높다.
26. Engineering Agent는 코딩만 하는 개발자가 아니다
앞으로 Agent 역할을 개발팀 역할에 대응시키면 이렇게 볼 수 있다.
Research Agent
= 코드 조사

Architecture Agent
= 설계 검토

Implementation Agent
= 구현

Review Agent
= 코드 리뷰

QA Agent
= Runtime QA

Security Agent
= 보안 검토
그리고 상위에는:
Orchestrator가 있다.
Astra가 흥미로운 이유는 이 상위 역할과 여러 역할 사이를 한 모델이 오갈 수 있는 능력이 크게 올라갔다는 점이다.
27. 하지만 ‘AI 개발자 한 명’보다는 ‘AI 개발팀’이 더 현실적이다
Astra 하나에게:
조사하고
설계하고
코딩하고
리뷰하고
QA하고
배포해.
라고 하는 것도 가능해질 수 있다.
하지만 좋은 개발 조직은 역할을 분리한다.
AI도 마찬가지다.
Astra
→ Goal / Planning

Sol
→ Implementation

Claude
→ Review

Playwright
→ QA

CI
→ Gate
처럼 구성할 수 있다.
중요한 것은 어떤 모델을 쓰느냐보다:
역할

권한

검증

완료 조건
이다.
28. 앞으로 개발 Architecture에는 AI Control Plane이 들어간다
지금까지 개발팀 Architecture를 생각하면:
GitHub
CI
Issue Tracker
Monitoring
정도가 중심이었다.
앞으로는:
Agent Tasks
Agent Permissions
Skills
Worktrees
Model Routing
Tool Access
Agent Logs
Human Gates
같은 것도 관리해야 한다.
즉:
Developer Control Plane이 필요해진다.
Astra 같은 모델은 이 필요성을 더 빠르게 만든다.
29. 멀티에이전트의 목표는 Agent 숫자가 아니다
Agent가 강해지면:
10 Agent
20 Agent
50 Agent
를 돌리고 싶어질 수 있다.
하지만 Agent 숫자가 많을수록 좋은 것이 아니다.
중요한 건:
Human Cognitive Load ↓

Software Throughput ↑
이다.
Agent 20개가 동시에 질문을 던진다면 실패한 오케스트레이션이다.
좋은 Agent Team은:
조사
구현
검증
을 알아서 수행하고,
사람에게는:
Decision Needed만 올린다.
30. 결국 좋은 Engineering Agent는 잠시 잊을 수 있는 Agent다
개발자가 Agent에게 작업을 맡긴다.
그리고 다른 일을 한다.
30분 뒤 돌아왔을 때:
Finding
Evidence
Result
Decision Needed
가 정리돼 있다.
이게 이상적인 형태다.
반대로:
3분마다 질문

5분마다 승인

같은 실패 반복

긴 설명
을 하면 Agent Capability가 높아도 실제 생산성은 낮다.
31. Astra가 보여주는 미래는 ‘더 좋은 Copilot’이 아니다
Copilot이라는 이름에는 기본적으로:
사람이 운전

AI가 보조
라는 의미가 있다.
Engineering Agent는 조금 다르다.
사람
→ 목적과 경계 결정

Agent
→ 실제 업무 수행

사람
→ 결과 판단
형태다.
즉 개발자는 항상 키보드를 잡고 있을 필요가 없다.
더 높은 수준에서:
Goal

Architecture

Trade-off

Risk

Approval
을 담당한다.
32. 그렇다면 개발자는 코딩을 덜 배워도 될까?
오히려 반대일 수 있다.
Agent 결과를 제대로 검증하려면:
Architecture

Concurrency

Networking

Database

Security

Runtime

Performance
를 이해해야 한다.
직접 작성하는 코드량이 줄어들어도 판단의 난도는 올라갈 수 있다.
특히 Senior Developer 역할은:
코드를 많이 쓰는 사람에서:
좋은 변경인지 판단할 수 있는 사람으로 더 이동할 가능성이 높다.
33. Junior 개발자에게는 다른 문제가 생긴다
기존 학습:
직접 구현
↓
실수
↓
Debug
↓
Review
↓
이해
Agent 시대:
Prompt
↓
Agent
↓
Merge
가 되면 중간 학습 단계가 줄어든다.
따라서 Junior에게는 일부 Task를:
Human Implementation
+
AI Review
로 남기는 방식도 필요하다.
모든 것을 Agent에게 위임하는 것이 반드시 좋은 Engineering 교육은 아니다.
34. Astra를 당장 모든 곳에 적용할 필요도 없다
Astra는 현재 가격과 토큰 소비량이 Sol보다 2.5배 가량 높다.
따라서 현실적인 도입은:
Hard Task
→ Astra

Normal Coding
→ Sol / Terra

High-volume
→ Luna
같은 구조가 낫다.
OpenAI도 현재 모델 선택 가이드에서 Astra는 가장 복잡한 reasoning과 coding용, Terra는 비용과 intelligence의 균형, Luna는 비용 민감한 대량 작업용으로 구분하고 있다.
35. 개발팀이 지금 준비해야 할 것은 Astra Prompt가 아니다
신규 모델이 나오면 흔히:
Astra용 Prompt Best Practice부터 찾는다.
물론 필요하다.
하지만 더 중요한 것은:
Repository Structure

AGENTS.md

Skills

Tests

CI

Permissions

Security Policy

Runtime Evidence

Review Rules
다.
모델은 계속 바뀐다.
개발 시스템은 남는다.
36. 가장 좋은 구조는 Model-independent하다
오늘:
GPT-6 Astra가 가장 강할 수 있다.
몇 달 뒤:
다음 GPT
다음 Claude
다른 Frontier Model
이 더 좋아질 수 있다.
그러므로:
Task
  ↓
Agent Runtime
  ↓
Model
을 분리한다.
Model은 교체 가능한 Worker다.
Astra
Fable
Sol
다음 모델
무엇이 들어와도:
Goal
→ Implementation
→ Validation
→ Review
→ QA
→ Human
Workflow는 유지한다.
37. 개인 개발자에게 가장 현실적인 구조
앞으로 개인 개발 환경은 이런 모습이 될 가능성이 높다.
                    Developer
                        │
                        ▼
                  Goal / Policy
                        │
                        ▼
                   Orchestrator
                        │
           ┌────────────┼────────────┐
           ▼            ▼            ▼
        Research     Implement       Test
         Agent         Agent         Agent
           │            │            │
           └────────────┼────────────┘
                        ▼
                  Automated Checks
                        │
                        ▼
                  Independent Review
                        │
                        ▼
                    Runtime QA
                        │
                        ▼
                      Human
그리고 Astra 같은 모델은 이 구조의:
Orchestrator

또는

가장 어려운 Worker
역할을 맡을 가능성이 크다.
38. 완료 기준도 바뀌어야 한다
예전 Coding Agent:
Code Generated이 완료였다.
앞으로는:
Goal Achieved
+
Build PASS
+
Tests PASS
+
Runtime Verified
+
Critical Review 0
+
Not Verified 명시
정도가 되어야 한다.
Code Complete가 아니라 Engineering Complete다.
마무리
GPT-6 Astra의 가장 중요한 변화는 코드를 조금 더 잘 작성하게 된 것이 아니다.
OpenAI가 Astra를 설명할 때 반복해서 강조하는 것은:
Coding

Browsing

Computer Use

Professional Tools

Complex Multistep Work
를 하나의 end-to-end Workflow 안에서 수행하는 능력이다.
이건 Coding Agent의 역할을 근본적으로 바꾼다.
예전에는:
Developer
→ Agent
→ Code
였다.
앞으로는:
Developer
        ↓
Goal + Constraints
        ↓
Engineering Agent
        ↓
Research
        ↓
Implementation
        ↓
Tool Use
        ↓
Build / Test
        ↓
Recovery
        ↓
Runtime Verification
        ↓
Review-ready Result
        ↓
Developer
에 가까워진다.
그리고 이 변화가 커질수록 개발팀에서 가장 중요한 것은 모델 자체가 아닐 가능성이 높다.
오히려:
AGENTS.md

Skills

Permissions

Tests

CI

Runtime Evidence

Review Policy

Security Guardrails
같은 Agent가 일할 수 있는 Engineering Environment가 중요해진다.
Astra가 똑똑하다고 모든 권한을 넘겨주는 것도 좋은 설계가 아니다.
OpenAI가 Astra에 추가적인 안전 모니터링을 넣고, Astra가 최초로 Critical 수준의 사이버보안 Capability에 도달했다고 별도로 강조한 이유도 결국 같은 문제를 보여준다. Agent Capability가 높아질수록 Control Plane과 Permission Boundary가 더 중요해진다.
그래서 GPT-6 Astra 이후 개발팀이 준비해야 하는 질문은:
Astra로 코드를 얼마나 많이 만들 수 있을까?가 아니다.
더 중요한 질문은:
이제 AI에게 어디까지 Engineering Goal을 맡길 수 있고, 그 결과를 어떤 시스템으로 검증할 것인가?
이다.
Coding Agent의 다음 단계는 더 좋은 자동완성이 아니다.
Engineering Agent다.
그리고 Engineering Agent 시대의 개발자는 코드를 가장 많이 작성하는 사람이 아니라, AI에게 올바른 목표와 경계를 주고, 결과가 실제 Software Change로 신뢰할 만한지 판단할 수 있는 사람에 더 가까워질 가능성이 크다.
참고 자료
OpenAI는 2026년 9월 3일 GPT-6 Astra를 발표하고 coding, research, computer use 및 복잡한 multi-step work가 크게 향상된 모델이라고 설명했다. Astra는 현재 제한된 조직부터 배포 중이며 API 및 Plus·Pro·Business·Enterprise 사용자로 확대될 예정이다.
OpenAI의 공식 개발자 가이드에서는 Astra를 코드·브라우저·전문 소프트웨어 사이를 오가는 복잡한 Workflow에 적합한 모델로 소개하며, Async Tool Calling과 Mid-turn Steering을 새 기능으로 제공한다. 또한 AGENTS.md와 Skills 등 외부 지침에 대한 instruction following이 더 강해졌기 때문에 접근 가능한 지침 파일을 점검할 것을 권장한다.
GPT-6 Astra API 모델은 1,050,000 token context, 최대 128,000 output token과 low·medium·high·xhigh·max reasoning effort를 지원한다. API 가격은 100만 input token당 10달러, output token당 50달러다.
OpenAI는 Astra가 Preparedness Framework에서 Critical 수준의 cybersecurity capability에 도달한 첫 모델이라고 밝히고 있으며, 이에 따라 추가적인 모니터링과 격리·안전 조치를 강화했다.
핵심 참고 포인트
GPT-6 Astra를 단순히 GPT-5.6 Sol보다 더 높은 성능의 Coding Model로 보는 것은 변화의 일부만 보는 것이다. OpenAI가 Astra에서 강조하는 핵심은 코딩과 Browser·Computer Use·Professional Tool을 하나의 긴 Workflow로 묶어 실제 업무 결과까지 도달하는 능력이다.
특히 Async Tool Calling은 Build나 Test처럼 오래 걸리는 작업 동안 Agent가 다른 일을 진행할 수 있게 하고, Mid-turn Steering은 긴 작업 중에도 사람이 새로운 요구사항이나 Constraint를 추가할 수 있게 한다. 이것은 Agent를 단발성 코드 생성기보다 지속적으로 일하는 Engineering Worker에 가깝게 만든다.
따라서 앞으로 개발환경의 핵심 경쟁력은 특정 Frontier Model 하나보다 Goal 설계 → Agent 작업 → 자동 검증 → 독립 Review → Runtime QA → Human Gate를 얼마나 안정적으로 운영할 수 있느냐에 있을 가능성이 높다.