멀티에이전트가 항상 답은 아니다 《1》
멀티에이전트가 항상 답은 아니다
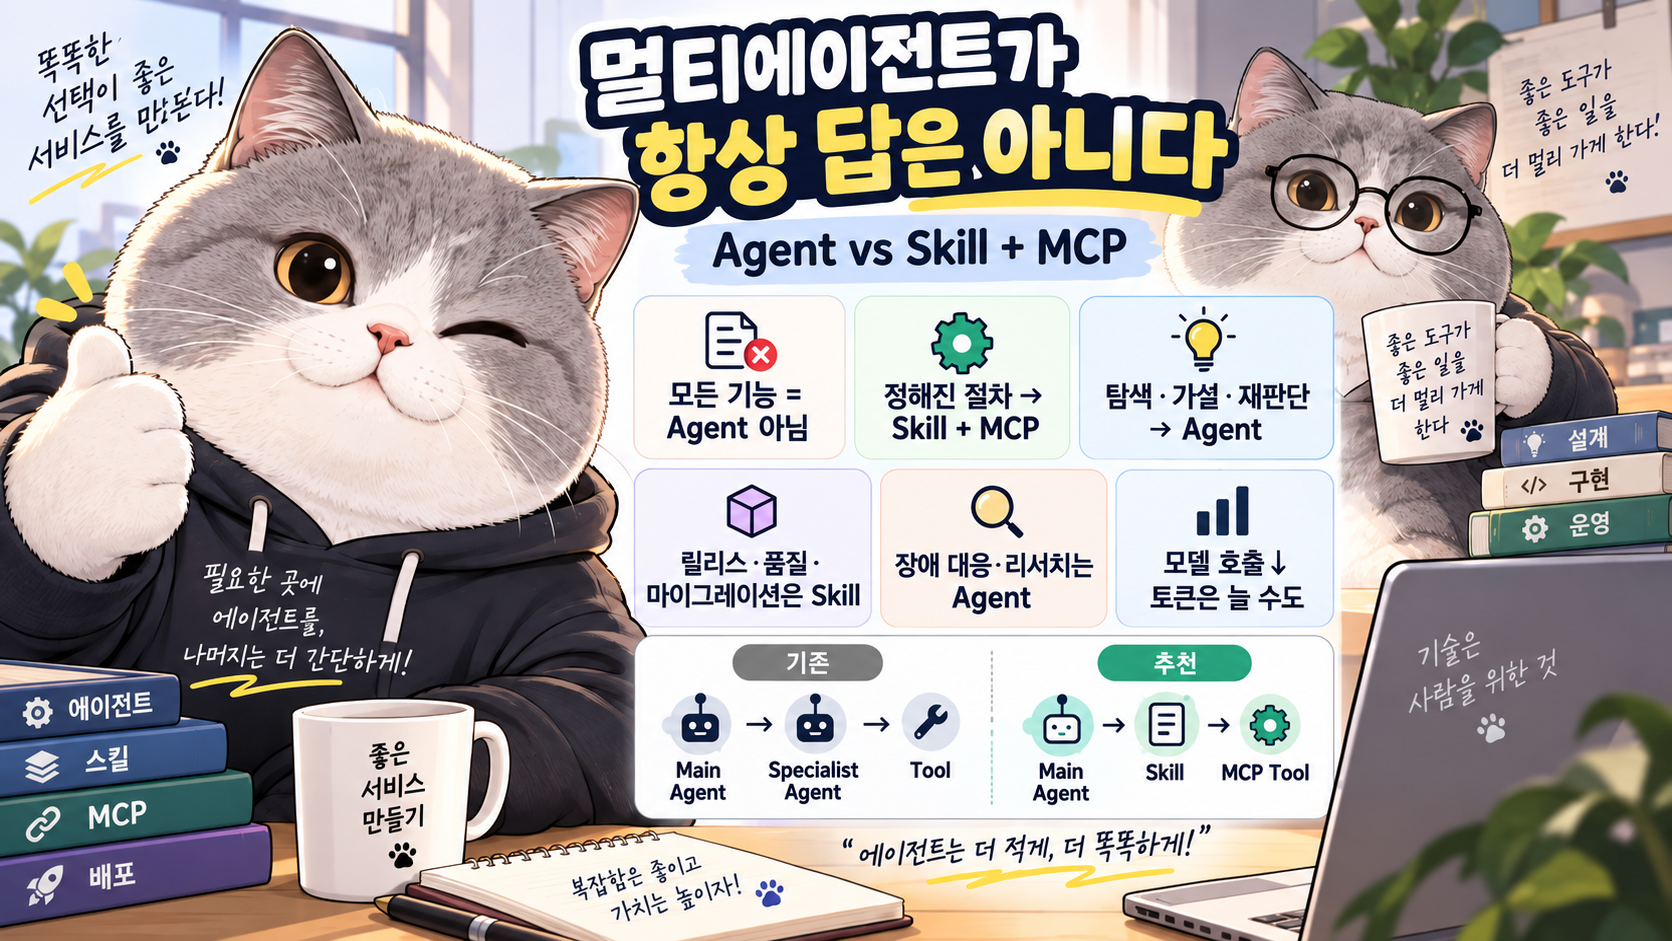
Agent를 Skill로 바꾸는 아키텍처
AI Agent 시스템을 만들기 시작하면 구조가 빠르게 커집니다.
처음에는 하나의 Agent가 여러 Tool을 사용합니다.
User
 ↓
Main Agent
 ↓
Tools
기능이 늘어나면 역할을 분리하기 시작합니다.
Main Agent
   │
   ├─ Release Agent
   ├─ Refactoring Agent
   ├─ Migration Agent
   └─ Research Agent
겉으로 보면 깔끔합니다.
각 Agent가 자기 역할만 담당하니 Microservice처럼 책임도 명확해 보입니다.
그런데 여기서 한 번 생각해볼 필요가 있습니다.
저 기능마다 정말 별도의 LLM Agent가 필요한가?
Microsoft가 9월 16일 공개한 Agent Framework 사례에서도 같은 질문을 던졌습니다.
기존에는 상위 Advisor가 여러 Specialist Agent를 A2A로 호출했지만, 일부 Specialist를 SKILL.md + MCP Tool 구조로 바꿨습니다.
서비스 자체를 합친 것은 아닙니다.
없어진 것은 Specialist마다 존재하던 별도의 Model Loop였습니다.
이 차이는 실제 개발 시스템에서 더 중요합니다.
1. Multi-Agent를 만들면 Agent 하나만 추가되는 것이 아니다
예를 들어 Release Agent를 하나 만든다고 생각해보겠습니다.
구조는 단순해 보입니다.
Main Agent
   ↓
Release Agent
   ↓
CI / Git / App Store
하지만 실제 Release Agent 안에는 이런 것들이 들어갑니다.
Release Agent

├─ System Prompt
├─ Model
├─ Context
├─ Tools
├─ Agent Loop
└─ Result Generation
Main Agent가 Release Agent에게 일을 넘기면 Release Agent는 다시 모델을 호출합니다.
Main Agent
   ↓
Model 판단
   ↓
Release Agent 호출
   ↓
Release Agent Model 판단
   ↓
Tool 호출
   ↓
Release Agent Model 정리
   ↓
Main Agent
   ↓
최종 응답
단순히 기능 하나가 추가된 것 같지만 실제로는 Reasoning Layer 하나가 더 생긴 것입니다.
Agent가 늘어날수록 함께 늘어나는 것도 있습니다.
Model Call
Context
Token
Latency
Failure Point
Observability
Permission
그래서 Multi-Agent는 역할을 나누는 좋은 방법이지만, 무조건 가벼운 구조는 아닙니다.
2. Microsoft는 Specialist Agent 일부를 Skill로 바꿨다
Microsoft 사례에서는 Weather, Safety, Lift Traffic 같은 Specialist가 각각 독립적인 Agent였습니다.
구조는 이런 형태였습니다.
Advisor
   ↓
Specialist Agent
   ↓
Domain Tool
   ↓
Domain Service
이 구조를 다음처럼 바꿨습니다.
Advisor
   ↓
Skill
   ↓
MCP Tool
   ↓
Domain Service
여기서 중요한 것은 Domain Service가 그대로 남아 있다는 점입니다.
Weather Service
Safety Service
Lift Service
는 계속 독립적으로 배포되고 관리됩니다.
달라진 것은 어디에서 판단하느냐입니다.
기존에는:
Advisor Reasoning
+
Specialist Reasoning
이었다면,
변경 후에는:
Advisor Reasoning하나가 Domain Operation까지 선택합니다.
Specialist가 가지고 있던 절차와 지식은 SKILL.md로 이동합니다.
3. Agent를 없앤다고 Domain을 없애는 것은 아니다
이 구분이 중요합니다.
Microservice가 네 개 있다고 Agent도 네 개일 필요는 없습니다.
예를 들어 Backend가 이렇게 구성돼 있다고 해보겠습니다.
Release Service

Quality Service

Artifact Service

Notification Service
이걸 그대로
Release Agent

Quality Agent

Artifact Agent

Notification Agent
로 옮길 이유는 없습니다.
Service Boundary는 주로 이런 것을 위한 것입니다.
Business Logic
Data Ownership
Deployment
Scaling
Security
Team Ownership
Agent Boundary는 다릅니다.
Independent Reasoning
Private Context
Autonomy
Long-running Workflow
Specialized Model
즉
서비스가 분리돼 있다는 것과 Reasoning을 분리해야 한다는 것은 다른 문제입니다.
4. 가장 현실적인 예 — Release Agent가 정말 필요한가
iOS 앱 배포를 자동화한다고 해보겠습니다.
Release Agent를 따로 만들 수도 있습니다.
Main Agent
   ↓
Release Agent
   ↓
Git
CI
TestFlight
App Store
하지만 실제 업무를 보면 꽤 정형화돼 있습니다.
현재 Branch 확인

↓

변경사항 확인

↓

Version / Build Number 확인

↓

Test 실행

↓

Archive

↓

Upload

↓

Release Note 생성
이 정도라면 별도의 LLM Agent보다 Release Skill이 더 자연스러울 수 있습니다.
Release Skill

1. release branch를 확인한다.
2. working tree가 clean인지 확인한다.
3. test를 실행한다.
4. build number를 증가시킨다.
5. archive를 생성한다.
6. TestFlight에 업로드한다.
실행 기능은 MCP Tool이나 다른 Tool Interface로 제공합니다.
git_status

run_tests

increment_build_number

archive_app

upload_testflight
구조는 단순해집니다.
Main Agent
    ↓
Release Skill
    ↓
필요한 Tool 선택
    ↓
CI / App Store
Release를 수행하는 방법은 Skill이 알려주고,
실제 실행은 Tool이 담당합니다.
5. 그런데 “지금 배포해도 되는가?”라면 이야기가 달라진다
같은 Release 영역이라도 질문이 달라질 수 있습니다.
예를 들어:
지금 이 버전을 배포해도 괜찮을까?
라면 단순 절차가 아닙니다.
다음 정보를 확인해야 할 수도 있습니다.
QA 결과

Crash 증가 여부

최근 Production 장애

Backend 호환성

Feature Flag

Rollout 상태

최근 Commit 위험도
그리고 상황에 따라 추가 정보를 다시 조회할 수도 있습니다.
Crash 증가
 ↓
특정 OS인가?
 ↓
해당 Feature 변경 확인
 ↓
최근 Commit 확인
 ↓
Rollout 범위 판단
이 정도가 되면 별도의 Release/Deployment Agent가 의미를 가질 수 있습니다.
즉 같은 Domain이라도 기준은 기능 이름이 아닙니다.
독립적인 Reasoning이 필요한가가 기준입니다.
6. 코드 품질 작업도 대부분 Skill 후보가 될 수 있다
두 번째 예는 Code Quality입니다.
처음에는 이런 구조를 만들기 쉽습니다.
Main Coding Agent
        ↓
Refactoring Agent
        ↓
SwiftLint
Tests
CodeQL
하지만 Refactoring Agent가 하는 작업을 자세히 보면:
SwiftLint violation 수정

unused code 제거

deprecated API 교체

간단한 중복 제거

test 실행
정도일 수 있습니다.
이런 작업은 대부분 절차가 명확합니다.
Code Quality Skill

1. Analyzer를 실행한다.
2. Finding을 Rule별로 분류한다.
3. 작은 Batch로 묶는다.
4. 코드를 수정한다.
5. Build한다.
6. Test한다.
7. Finding이 사라졌는지 확인한다.
Tool은:
run_swiftlint

find_usages

apply_patch

run_build

run_tests
만 제공하면 됩니다.
구조는:
Coding Agent
     ↓
Code Quality Skill
     ↓
Analyzer / Build / Test
로 충분합니다.
굳이 Refactoring Agent라는 두 번째 Reasoning Loop가 필요하지 않을 수 있습니다.
7. Swift 6 Migration도 Agent 여러 개보다 Skill이 더 자연스러울 수 있다
iOS 프로젝트를 Swift 6으로 Migration한다고 해보겠습니다.
Multi-Agent 구조를 과하게 만들면 이런 모습도 가능합니다.
Main Agent
   │
   ├─ Concurrency Agent
   ├─ Sendable Agent
   ├─ Actor Agent
   ├─ Build Agent
   └─ Test Agent
기능 이름만 보면 역할이 잘 분리돼 보입니다.
하지만 실제 Migration 절차는 상당 부분 정형화돼 있습니다.
Compiler Warning 수집

↓

오류 유형 분류

↓

Sendable 문제 확인

↓

Actor Isolation 확인

↓

@MainActor 적용 여부 확인

↓

코드 수정

↓

Build

↓

Test
이것을 하나의 Skill로 만들 수 있습니다.
Swift 6 Migration Skill그리고 Tool은:
run_build

search_symbol

find_concurrency_diagnostics

apply_patch

run_tests
를 제공합니다.
Main Coding Agent
        ↓
Swift 6 Migration Skill
        ↓
Compiler / Search / Test
이 정도 구조면 상당수 Migration 작업을 처리할 수 있습니다.
8. Skill이 좋은 영역의 특징은 꽤 분명하다
지금까지 예를 보면 공통점이 있습니다.
Release

Code Quality

Swift Migration
모두 일정한 절차가 있습니다.
그리고 사용할 Tool도 명확합니다.
정리하면 이런 특징을 가진 기능은 Skill 후보입니다.
Bounded Domain

명확한 Procedure

명확한 Input / Output

Typed Tool

Parent Agent가 판단 가능
이런 업무에 매번 별도의 Agent를 만들면 Reasoning Layer만 불필요하게 늘어날 수 있습니다.
9. 반대로 장애 대응은 Agent로 남기는 편이 자연스럽다
이번에는 반대 사례를 보겠습니다.
Production 장애가 발생했다고 해보겠습니다.
API Error Rate 급증단순한 절차로 끝나지 않습니다.
Error Rate 확인
 ↓
최근 Deploy 확인
 ↓
특정 API인가?
 ↓
DB Latency 확인
 ↓
관련 Trace 확인
 ↓
최근 Commit 확인
 ↓
원인 가설 생성
 ↓
추가 로그 조회
 ↓
가설 수정
이 과정은 계속 달라집니다.
첫 번째 조사 결과에 따라 다음 Tool이 달라집니다.
Logs

Metrics

Tracing

Git

Deployment History

Feature Flag
를 어떤 순서로 사용할지도 미리 정하기 어렵습니다.
이런 작업은:
Explore
 ↓
Hypothesis
 ↓
Verify
 ↓
Re-plan
이 반복됩니다.
이 경우는 Skill보다 Incident Agent가 더 자연스럽습니다.
10. Research Agent도 같은 이유로 Agent로 남는다
Microsoft의 실제 사례에서도 모든 Specialist를 Skill로 바꾸지는 않았습니다.
Web Research 기능은 Agent로 유지했습니다.
Research는 보통:
검색
 ↓
결과 판단
 ↓
추가 검색
 ↓
출처 비교
 ↓
새로운 질문
 ↓
재검색
 ↓
정리
과정을 반복합니다.
미리 정해진 Tool 호출 순서가 없습니다.
독립적인 Reasoning이 필요합니다.
그래서:
Main Agent
   ↓
Research Agent
   ↓
Search Tools
구조가 자연스럽습니다.
이 부분이 중요한 이유는 Microsoft 사례의 메시지가
“Multi-Agent를 없애라”
가 아니기 때문입니다.
11. 실무에서 구분하는 기준은 생각보다 단순하다
Agent를 만들기 전에 다음 질문을 해보면 됩니다.
독립적으로 판단해야 하는가?
YES
→ Agent 후보
작업 중 새로운 가설을 만들고 재계획해야 하는가?
YES
→ Agent 후보
자체적으로 긴 Workflow를 수행하는가?
YES
→ Agent 후보
다른 모델이나 Private Context가 필요한가?
YES
→ Agent 후보
반대로:
절차가 명확한가?
YES
→ Skill 후보
Tool의 Input / Output이 명확한가?
YES
→ Skill 후보
Parent Agent가 Operation을 선택해도 되는가?
YES
→ Skill 후보
결국 이렇게 줄일 수 있습니다.
정해진 절차
+
명확한 Tool
        ↓
      Skill
탐색
+
가설
+
반복 판단
↓
Agent12. SKILL.md는 Agent의 System Prompt를 재사용 가능한 자산으로 만든다
Specialist Agent를 Skill로 바꿀 때 System Prompt가 사라지는 것은 아닙니다.
예를 들어 Release Agent에 이런 지침이 있었다고 해보겠습니다.
release branch에서만 배포한다.

working tree가 dirty면 중단한다.

test 실패 시 archive하지 않는다.

배포 후 build number를 기록한다.
기존에는 Release Agent의 System Prompt 안에 들어가 있습니다.
Release Agent
   ↓
System Prompt
Skill 구조에서는:
release/SKILL.md로 이동합니다.
이 변화가 중요한 이유는 해당 지식이 더 이상 특정 Agent Runtime에 묶이지 않기 때문입니다.
Agent Prompt가 아니라
Reusable Engineering Procedure가 됩니다.
13. 팀의 개발 규칙도 Skill이 될 수 있다
이 구조를 한 단계 더 확장하면 팀 내부 Engineering Rule도 Skill로 만들 수 있습니다.
예를 들어:
ios-feature-development/SKILL.md안에:
1. Feature Module 생성
2. Domain Interface 정의
3. Repository 연결
4. ViewModel 작성
5. SwiftUI View 작성
6. Unit Test 추가
7. Build 검증
을 정의합니다.
다른 Skill로는:
swift6-migration

ios-release

code-quality

dependency-update
를 둘 수 있습니다.
이렇게 되면 팀의 Engineering Knowledge가
Wiki
Confluence
README
에만 있는 것이 아니라 Agent가 실행할 수 있는 형태로도 존재하게 됩니다.
14. MCP Tool은 Skill과 역할이 다르다
여기서 Skill과 MCP를 하나로 생각하면 안 됩니다.
Skill은:
무엇을 해야 하는가?

어떤 순서로 해야 하는가?

어떤 기준을 따라야 하는가?
를 알려줍니다.
MCP Tool은:
무엇을 실행할 수 있는가?를 제공합니다.
예를 들어:
Swift 6 Migration Skill은 이런 절차를 설명합니다.
Concurrency Diagnostic을 먼저 분류한다.MCP Tool은 실제 기능을 제공합니다.
run_build()

search_symbol()

apply_patch()

run_tests()
그리고 최종 판단은 Agent가 합니다.
Skill
 → Procedure

MCP
 → Capability

Agent
 → Reasoning
으로 나누면 이해하기 쉽습니다.
15. Tool을 처음부터 전부 Context에 넣을 필요도 없다
Agent 시스템이 커지면 Tool 수가 빠르게 늘어납니다.
예를 들어 개발 Agent에:
Git Tools             15개
CI Tools              10개
Xcode Tools           12개
GitHub Tools          20개
Monitoring Tools      18개
Database Tools        15개
가 있다면 이미 90개입니다.
모든 Tool Schema를 매 요청마다 모델에게 보여주는 것은 비효율적입니다.
Microsoft 사례에서는 Skill이 로드된 뒤 해당 Domain의 MCP Tool만 Context에 추가하는 방식을 사용했습니다.
처음

Release Skill
Migration Skill
Quality Skill
Incident Agent
정도만 보여줍니다.
사용자가:
Swift 6 Migration 진행해줘.
라고 하면:
load_skill("swift6-migration")후에 관련 Tool만 추가합니다.
run_build
search_symbol
apply_patch
run_tests
나머지는 Context에 들어오지 않습니다.
이게 Progressive Disclosure의 핵심입니다.
16. Skill은 Context Engineering 수단이기도 하다
Tool이 많아지는 문제는 단순 UI 문제가 아닙니다.
각 Tool에는:
Name
Description
Input Schema
Output Schema
가 있습니다.
전부 Context에 들어가면 Token을 소비합니다.
그래서:
100 Tools전체를 넣는 대신
10 Skill Summaries만 먼저 제공하고,
선택된 Skill의 Tool만 뒤에서 추가하는 구조가 더 유리할 수 있습니다.
즉 Agent Skill은 단순한 Prompt 관리 기법이 아니라 Context Engineering 전략이기도 합니다.
17. Microsoft 사례에서는 Model Call이 절반 수준으로 줄었다
Microsoft는 동일한 Ski Resort 애플리케이션에서 기존 A2A Specialist 구조와 Skill + MCP 구조를 직접 비교했습니다.
A2A 구조에서는 세 번의 실행에서 Model Call이 각각:
6회
6회
7회
였습니다.
Skill + MCP 구조는 모두:
3회였습니다.
Skill 방식에서는:
Model #1
→ 필요한 Skill 로드

Model #2
→ 필요한 MCP Operation 호출

Model #3
→ 최종 응답
으로 끝났습니다.
Specialist마다 별도의 Model Loop를 돌지 않았기 때문입니다.
18. 하지만 Token은 오히려 증가했다
여기서 중요한 결과가 하나 나옵니다.
Model Call이 줄었으니 Token도 줄었을 것 같지만 그렇지 않았습니다.
세 번의 실행을 합치면:
A2A

11,134 tokens
Skill 방식은:
13,533 tokens이었습니다.
약 22% 많았습니다.
이유 중 하나는 Parent Agent의 Context가 계속 커졌기 때문입니다.
Skill Instruction
+
Tool Schema
+
Tool Result
+
Conversation Context
가 상위 Agent에 누적됩니다.
따라서
Model Call이 줄었다 = Token이 줄었다
는 공식은 성립하지 않습니다.
19. Multi-Agent의 Context Isolation은 여전히 장점이다
Specialist Agent를 유지하면 Context를 자연스럽게 분리할 수 있습니다.
예를 들어 Incident Agent는:
Logs
Metrics
Tracing
만 보면 됩니다.
Release Agent는:
Git
CI
App Store
만 봅니다.
Main Agent Context
≠
Incident Context
≠
Release Context
가 됩니다.
Skill 중심 구조에서는 Parent Agent가 더 많은 Domain Instruction과 Tool 정보를 가져가게 됩니다.
그래서 Agent를 줄이는 것이 항상 좋은 것도 아닙니다.
대규모 시스템에서는 Context Isolation 때문에 Agent를 분리하는 것이 더 나은 경우도 있습니다.
20. 보안 정책은 Skill에 맡기면 안 된다
예를 들어 Release Skill에:
Production 배포는 관리자만 가능하다.라고 적었다고 해보겠습니다.
이것은 Security Policy가 아닙니다.
LLM Instruction일 뿐입니다.
실제 Tool이나 Service에서는 반드시 다시 검증해야 합니다.
Authentication

Authorization

Validation

Audit Log
를 코드에서 강제해야 합니다.
구조는 이렇게 보는 것이 맞습니다.
Skill

→ 어떻게 작업할지 설명
Tool
→ 실행 가능한 Operation 제공Service
→ 실제 Business Rule과 Security 강제Agent Architecture에서 이 경계를 흐리면 위험합니다.
21. 개발팀에서 가장 현실적인 구조는 Hybrid다
실제 개발 시스템에서는 다음 형태가 가장 현실적일 수 있습니다.
                   Main Coding Agent
                          │
          ┌───────────────┼───────────────┐
          │               │               │
    Release Skill   Migration Skill   Incident Agent
          │               │               │
      MCP Tools        MCP Tools       Agent Loop
          │               │               │
         CI            Compiler       Logs / Metrics
여기에:
Code Quality Skill

Dependency Update Skill

SPM Migration Skill
같은 것을 추가할 수 있습니다.
반면:
Incident Analysis

Research

Architecture Investigation
처럼 탐색과 판단이 필요한 작업은 Agent로 유지합니다.
22. 결국 중요한 건 Agent의 개수가 아니다
멀티에이전트 시스템을 설계하다 보면 Agent가 많을수록 역할이 명확하고 구조가 고도화된 것처럼 보이기도 합니다.
하지만 Agent 하나는 단순한 Class 하나가 아닙니다.
Model
Context
Reasoning
Tools
Lifecycle
Failure
Observability
Cost
를 가진 Runtime입니다.
그래서 기능 하나가 추가될 때마다 먼저 물어볼 질문은:
어떤 Agent를 만들까?가 아니라
이 기능에
별도의 Reasoning Loop가 필요한가?
가 되어야 합니다.
필요 없다면:
Skill
+
Tool
이 더 단순합니다.
필요하다면:
Agent가 맞습니다.
마치며
Multi-Agent Architecture가 잘못된 것은 아닙니다.
독립적인 판단과 긴 Workflow가 필요한 작업에서는 여전히 강력합니다.
하지만
Release

Code Quality

Migration

Dependency Update
처럼 절차가 비교적 명확한 기능까지 각각 Agent로 만드는 것은 과할 수 있습니다.
이런 영역은:
SKILL.md
+
MCP Tools
정도로도 충분히 구현할 수 있습니다.
반대로:
Incident Response

Research

Architecture Investigation
처럼
탐색
 ↓
가설
 ↓
검증
 ↓
재계획
이 반복되는 작업은 별도의 Agent가 자연스럽습니다.
Microsoft의 사례에서도 같은 결론이 나옵니다.
일부 Specialist Agent를 Skill + MCP로 바꾸면서 Model Call은 줄었지만 Token 사용량까지 자동으로 줄지는 않았고, Research처럼 독립성이 필요한 기능은 계속 Agent로 유지했습니다.
결국 기준은 간단합니다.
정해진 절차와 명확한 Tool이 있다면 Skill.
탐색하고 가설을 세우고 다시 판단해야 한다면 Agent.
그리고 Multi-Agent Architecture를 설계할 때는 Agent를 하나 더 만들기 전에 한 번쯤 물어볼 필요가 있습니다.
이 기능에 정말 또 하나의 LLM이 필요한가?
참고자료
-
Microsoft Agent Framework — From Specialist Agents to Distributed Skills over MCP
Specialist Agent 구조를 Skill + MCP Tool 구조로 변경하고 Model Call, Latency, Token 사용량을 직접 비교한 Microsoft 공식 사례입니다.
공식 글 보기 -
Microsoft Agent Framework — Discover Agent Skills from MCP servers in .NET
MCP Server에서 Skill을 중앙 배포하고, Agent가 필요한 Skill을 On-demand로 가져오는 구조와 Progressive Disclosure 방식을 확인할 수 있습니다.
공식 글 보기 -
Microsoft Agent Framework — Give Your Agents Domain Expertise with Agent Skills
SKILL.md를 중심으로 Domain Instruction, Reference, Script 등을 Agent에 필요할 때만 제공하는 기본 Agent Skills 구조를 설명합니다.
공식 글 보기 -
Microsoft Agent Framework — Agent Skills for .NET Is Now Released
Agent Skills for .NET의 Stable API와 Production 환경에서 Skill을 재사용·배포하는 방식을 확인할 수 있습니다.
공식 글 보기
Microsoft 공식 사례 기준으로 보면, 이번 Architecture 변경의 핵심은 Domain Service를 합치는 것이 아닙니다. Service와 Data, Deployment Boundary는 그대로 유지하고 Specialist가 갖고 있던 별도 Model Loop만 제거한 뒤, Domain Instruction은 Skill로, 실행 기능은 MCP Tool로 제공했습니다.
같은 질문을 비교한 세 번의 실행에서 A2A Specialist 방식은 6회·6회·7회의 Model Call이 발생했고 Skill + MCP 방식은 모두 3회였습니다. 반면 전체 Token 사용량은 Skill 방식이 13,533개로 A2A의 11,134개보다 약 22% 많았습니다. Microsoft 역시 이 결과를 통제된 성능 비교로 보지 말아야 한다고 명시하고 있습니다.
또한 Research Agent처럼 독립적인 탐색, 긴 Workflow, 별도 Context나 Specialized Model이 필요한 Component는 Agent로 유지했습니다. 실제 Production Architecture 역시 Agent 또는 Skill 중 하나를 고르는 구조보다, 둘을 역할에 따라 함께 사용하는 Hybrid 형태가 더 현실적입니다.