클라우드 AI가 계획하고 로컬 AI가 코딩한다
클라우드 AI가 계획하고 로컬 AI가 코딩한다
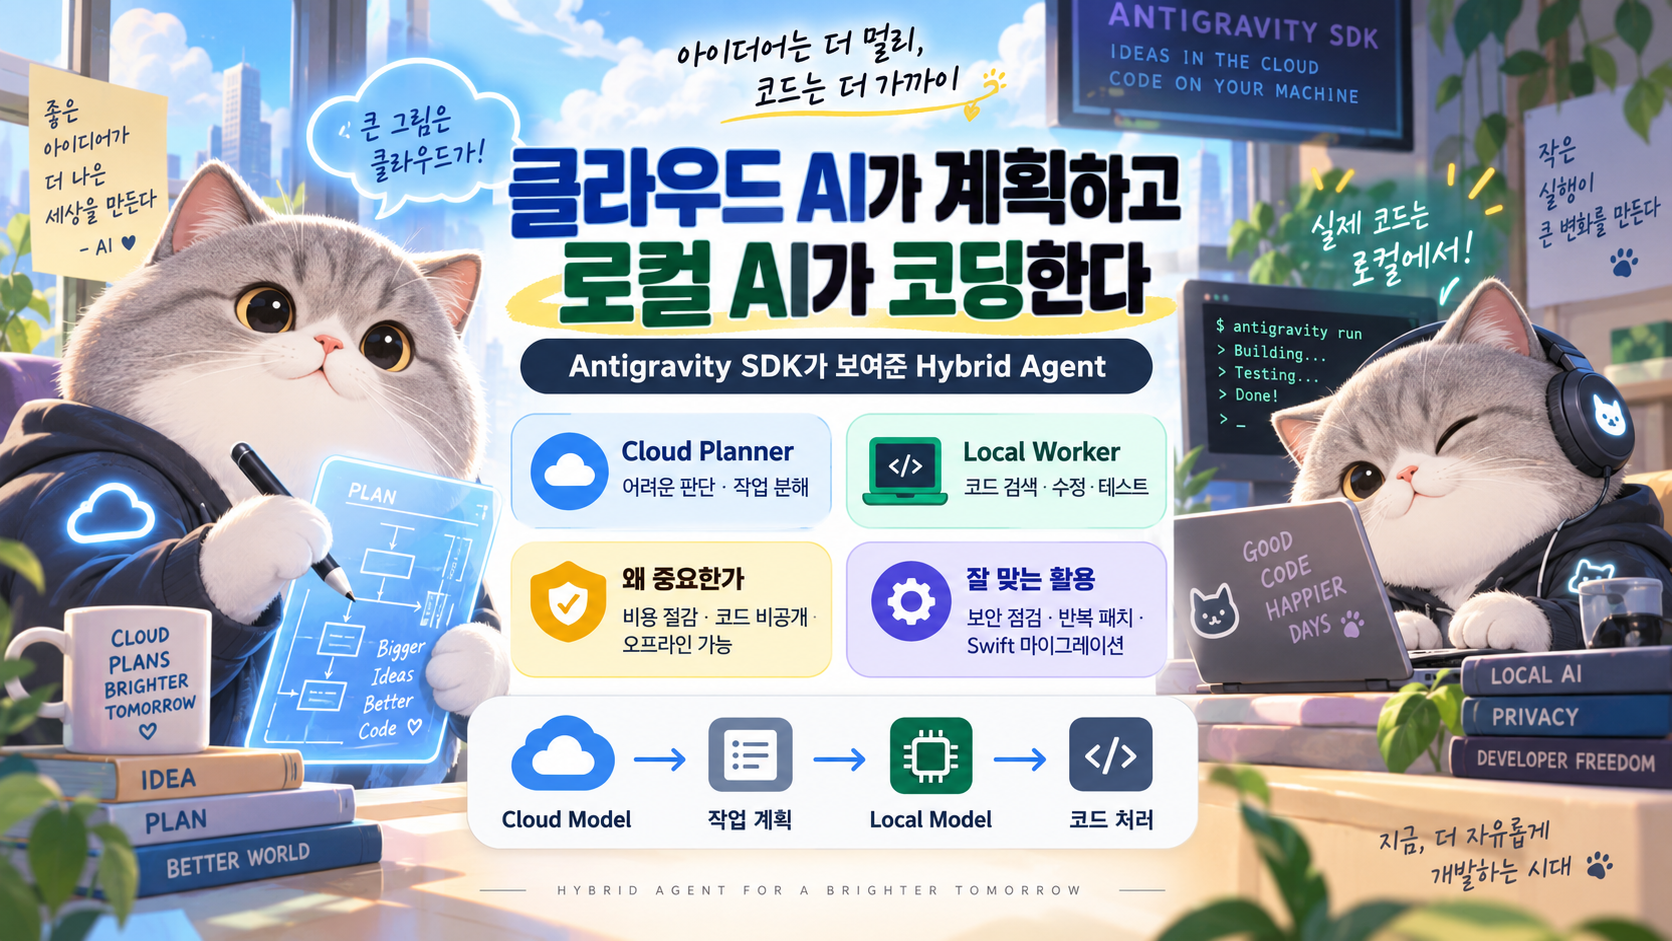
Antigravity SDK가 보여준 Hybrid Agent — Gemma 4·LiteRT·Ollama로 만드는 로컬 개발 Agent
AI Coding Agent를 쓰다 보면 조금 아까운 순간이 있습니다.
복잡한 설계를 잡거나 어려운 버그를 찾을 때는 강한 클라우드 모델이 필요합니다.
그런데 이런 작업까지 모두 같은 모델이 처리할 필요가 있을까요?
파일 검색

반복적인 코드 점검

취약점 확인

패치 후보 작성

테스트 실행

간단한 리팩터링
이런 일까지 매번 큰 클라우드 모델에 맡기면 비용도 들고, 회사 코드를 외부로 보내야 하는 문제도 생깁니다.
Google이 2026년 9월 23일 공개한 Antigravity SDK의 Local AI Model 지원은 이 문제를 꽤 재미있는 방법으로 풀었습니다.
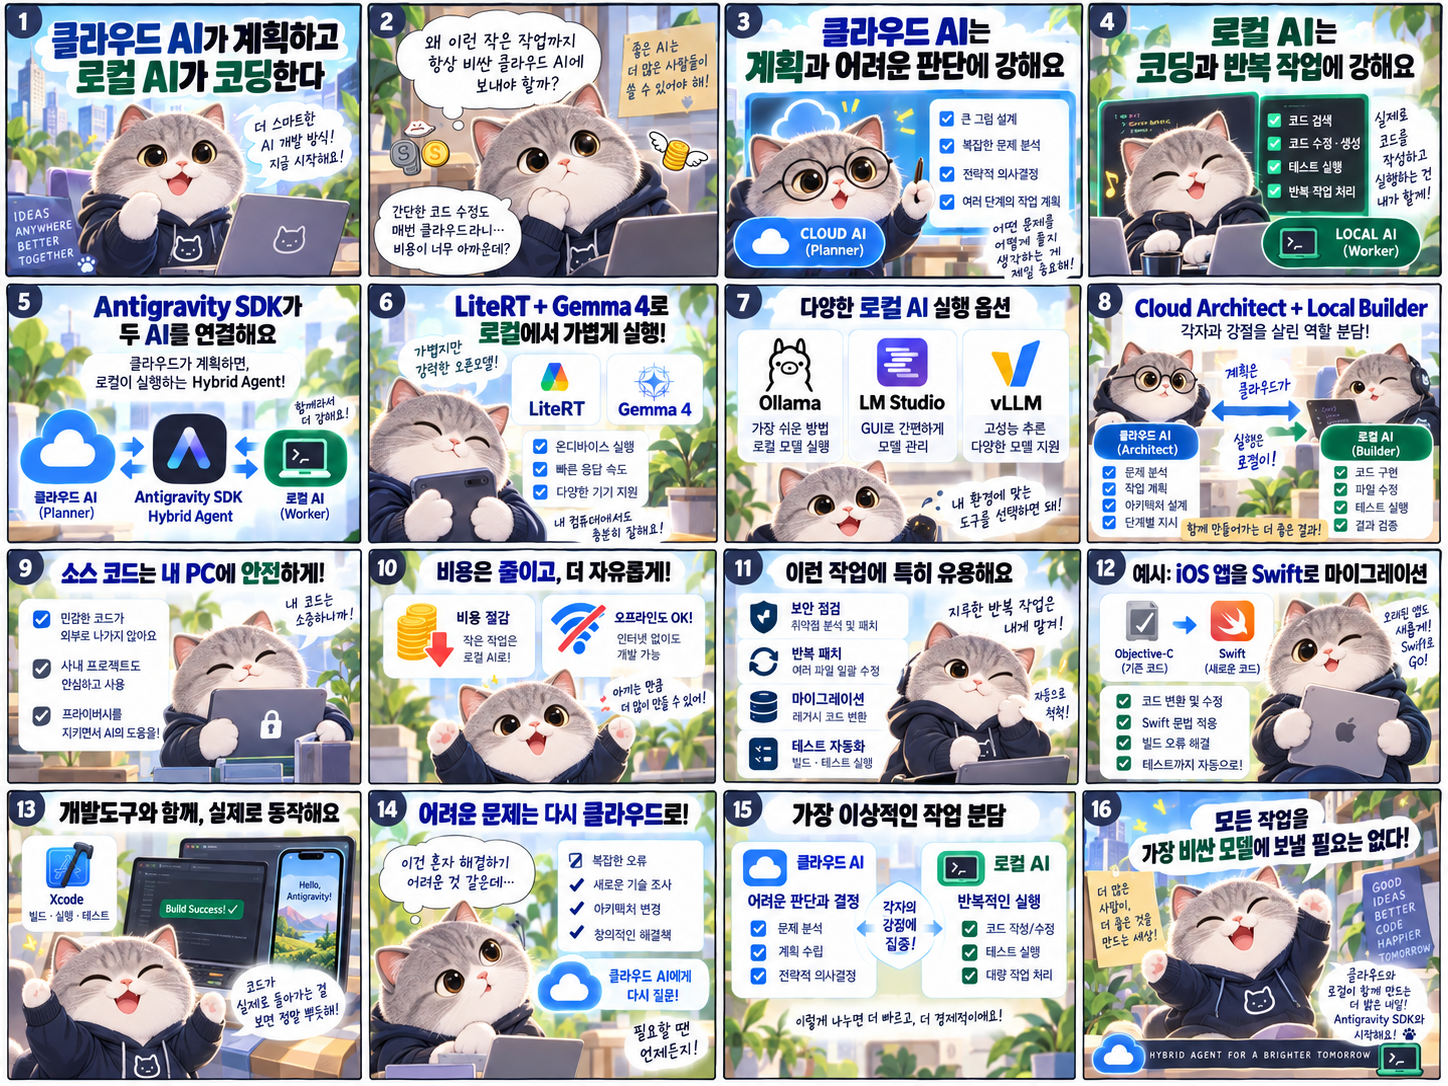
강한 클라우드 모델이 전체 작업을 계획하고,
실제 코드를 많이 읽고 수정하는 작업은 내 컴퓨터에서 돌아가는 로컬 모델에게 맡기는 방식입니다.
Cloud Model
    ↓
작업 계획 / 분해
    ↓
Local Model
    ↓
코드 읽기
수정
테스트
반복 작업
단순히 "Gemma를 로컬에서 돌릴 수 있다"는 업데이트보다 이 구조가 훨씬 흥미롭습니다.
1. Antigravity SDK가 뭐냐
Antigravity SDK는 Google Antigravity에서 사용하는 Agent 기능을 개발자가 직접 이용할 수 있도록 만든 Python SDK입니다.
쉽게 말하면 모델 하나를 호출하는 API보다 조금 위에 있습니다.
Model
+
Tools
+
Workspace
+
Policy
+
MCP
+
Subagent
+
Agent Loop
를 묶어 Agent를 만드는 쪽에 가깝습니다.
기존에는 이런 Agent가 클라우드 모델을 중심으로 동작했다면, 이번 업데이트로 Agent의 두뇌 자체를 로컬 모델로 바꿀 수 있게 됐습니다.
로컬 실행에서는 API Key도 필요하지 않고 인터넷 연결 없이 Agent를 실행할 수도 있습니다.
2. 로컬 실행 방법은 크게 두 가지다
Antigravity SDK의 Local Model 지원은 크게 두 방식으로 나뉩니다.
LiteRT
Google의 LiteRT를 이용해서 모델을 직접 로컬에서 실행합니다.
현재 Google이 가장 적극적으로 보여주는 조합은:
Antigravity SDK
+
LiteRT
+
Gemma 4 26B A4B
입니다.
OpenAI Compatible Server
이미 로컬 LLM 환경을 운영하고 있다면:
Ollama

LM Studio

vLLM
같은 서버도 연결할 수 있습니다.
구조는:
Antigravity Agent
       ↓
OpenAI-compatible API
       ↓
Ollama / LM Studio / vLLM
       ↓
Local Model
입니다.
그래서 꼭 Gemma만 사용해야 하는 구조는 아닙니다.
3. 가장 간단한 설치부터 해보자
Python 환경이라면 먼저 가상환경을 만듭니다.
python3 -m venv .venv
source .venv/bin/activate
그리고 Antigravity SDK와 LiteRT-LM을 설치합니다.
pip install google-antigravity litert-lmGemma 4 26B 모델을 가져옵니다.
litert-lm import \
  --from-huggingface-repo=litert-community/gemma-4-26B-A4B-it-litert-lm \
  gemma-4-26B-A4B-it-web.litertlm \
  gemma4-26b
현재 공식 예제 기준 모델 파일은 약 16.8GB이고, 26B 모델을 돌리려면 24GB 이상의 VRAM 또는 Unified Memory를 권장합니다.
Apple Silicon Mac이라면 Metal을 통해 GPU를 사용합니다.
즉 MacBook Pro나 Mac Studio처럼 Unified Memory가 충분한 환경에서는 꽤 현실적인 구성이 됩니다.
4. 로컬 Agent 자체는 생각보다 간단하게 만든다
기본 코드는 이 정도입니다.
import asyncio
import os

from google.antigravity import Agent, LiteRTAgentConfig


async def main():
    config = LiteRTAgentConfig(
        model_path=os.path.expanduser(
            "~/.litert-lm/models/gemma4-26b/model.litertlm"
        ),
    )

    async with Agent(config=config) as agent:
        response = await agent.chat(
            "현재 프로젝트의 인증 코드를 검토해줘."
        )

        async for token in response:
            print(token, end="", flush=True)


asyncio.run(main())
여기서 중요한 건 단순히 모델에게 질문하는 게 아닙니다.
Antigravity의 Agent 구조를 그대로 사용하기 때문에:
파일 읽기

파일 수정

Shell 실행

검색

Workspace 접근
같은 Agent 기능도 같이 사용할 수 있습니다.
5. 로컬 모델에서는 일부러 Agent를 가볍게 만든다
26B 로컬 모델을 클라우드의 거대한 Reasoning Model과 똑같이 운영하면 비효율적입니다.
그래서 LiteRTAgentConfig에는 Local Model을 위한 가벼운 기본 설정이 들어갑니다.
현재 공식 구현에서는 기본적으로:
View

Edit

Write

Bash

List Directory

Grep
같은 핵심 Coding Tool 위주로 제한합니다.
그리고:
복잡한 System Prompt 축소

Subagent 비활성화

Context Compaction 설정
등도 자동 적용합니다.
이 부분이 꽤 중요합니다.
로컬 모델을:
클라우드 모델의 작은 복제품
으로 쓰려는 게 아닙니다.
로컬 모델이 잘하는 일을 좁혀서 맡기는 방식입니다.
여기서 진짜 재미있는 Hybrid Agent가 나온다
6. Cloud Planner + Local Worker
Google이 이번 발표에서 직접 보여준 구조가 있습니다.
            Cloud Model
          Gemini 3.8 Flash
                 ↓
             Architect
                 ↓
          작업을 작게 분해
                 ↓
     ┌───────────┼───────────┐
     ↓           ↓           ↓
 Local Gemma  Local Gemma  Local Gemma
    Agent        Agent        Agent
     ↓           ↓           ↓
 auth.py     billing.py   database.py
클라우드 모델은 전체 문제를 보고 작업 순서만 정합니다.
실제 Source Code는 로컬 모델이 읽고 수정합니다.
이걸 Google은 Architect-Builder 패턴으로 설명합니다.
7. 클라우드 모델은 코드를 안 봐도 된다
Google이 공개한 보안 패치 Demo가 꽤 재미있습니다.
세 개의 Python Module:
auth.py

billing.py

database.py
에 취약점이 있다고 해보겠습니다.
Cloud Architect인 Gemini 3.8 Flash에는 Source Code를 보내지 않습니다.
대신:
파일 이름

작업 설명

목표
정도만 제공합니다.
Gemini는:
어떤 순서로 검사할지

어떤 Agent가 어떤 파일을 맡을지
만 결정합니다.
그리고 실제 코드는 전부 로컬 Gemma가 처리합니다.
Google이 공개한 해당 Demo에서는 Cloud Planner가 사용한 Token이 95개였고, Source Code는 클라우드로 올라가지 않았습니다.
8. 실제 Token 대부분은 로컬에서 처리했다
같은 Demo에서 전체 작업의 97.2%에 해당하는 3,322 Token이 로컬에서 처리됐습니다.
로컬 Agent는 단순 코드 생성만 한 것이 아닙니다.
취약점 재현

패치 작성

패치 비판

다시 수정

Regression Test
까지 수행했습니다.
이 숫자는 Google이 공개한 특정 Demo 결과입니다.
모든 프로젝트에서 97%가 로컬로 바뀐다는 뜻은 아닙니다.
하지만 구조는 충분히 참고할 만합니다.
비싼 판단
→ Cloud

많이 반복되는 작업
→ Local
로 나누는 방식입니다.
9. 왜 굳이 이렇게 나눌까
이 구조에는 세 가지 장점이 있습니다.
비용
로컬 실행에는 API Token 비용이 없습니다.
작업량이 많아질수록 차이가 커집니다.
보안
Source Code를 외부 API로 보내지 않을 수 있습니다.
회사 내부 코드나 NDA가 걸린 프로젝트에서는 꽤 큰 장점입니다.
인터넷 없이 실행
모델과 필요한 파일이 로컬에 있다면 오프라인에서도 Agent를 돌릴 수 있습니다.
10. 특히 코드 전체를 읽는 작업은 로컬과 잘 맞는다
예를 들어:
이 Repository에서
deprecated API를 전부 찾아줘.
라고 했다고 해보겠습니다.
이건 굉장히 어려운 Reasoning 문제라기보다:
파일 검색

패턴 확인

반복 검사
가 많은 작업입니다.
또:
Swift 6 Migration 대상 찾아줘.

강제 unwrap 전부 찾아줘.

사용하지 않는 API 찾아줘.

보안상 위험한 코드 검사해줘.
같은 작업도 비슷합니다.
클라우드의 최고급 모델에게 수천 파일을 계속 읽히는 것보다:
Cloud
→ 검사 규칙 결정

Local
→ Repository 전체 검사
로 나누는 게 더 자연스럽습니다.
11. 반복적인 패치도 Local Worker와 잘 맞는다
예를 들어 API 이름이 바뀌었다고 해보겠습니다.
oldAPI()를:
newAPI()로 바꿔야 합니다.
처음 몇 개 파일을 보고 Migration 방법을 결정하는 것은 강한 모델이 잘합니다.
하지만 방법이 정해진 뒤:
200개 파일 검색

수정

Build

오류난 곳 다시 수정
하는 작업까지 모두 최고급 모델에게 맡길 필요는 없습니다.
구조를 나누면:
Cloud Architect
→ Migration Pattern 결정

Local Worker
→ 반복 적용

Compiler / Test
→ 검증
이 됩니다.
12. Local Agent가 모든 걸 대신하는 건 아니다
여기서 가장 중요한 구분이 있습니다.
로컬 모델이 좋아졌다고 해서:
Claude

GPT

Gemini
같은 클라우드 모델이 필요 없어지는 것은 아닙니다.
오히려 역할이 나뉩니다.
Local Model이 잘 맞는 작업
코드 검색

단순 수정

반복 작업

Lint성 검사

보안 Audit

테스트 실행

정해진 패턴의 Migration
Cloud Model이 더 잘 맞는 작업
복잡한 Architecture

애매한 요구사항 분석

어려운 Debugging

여러 시스템을 함께 보는 판단

Research

큰 설계 변경
입니다.
13. 그래서 좋은 구조는 ‘Local Only’보다 Hybrid다
모든 작업을 로컬에서 처리하려고 하면 작은 모델이 어려운 문제에서 계속 헤맬 수 있습니다.
반대로 모든 작업을 Cloud에 보내면:
비용

Latency

보안
문제가 생깁니다.
그래서 구조를:
                  Request
                     ↓
                Cloud Planner
                     ↓
              작업 난이도 판단
                     ↓
       ┌─────────────┴─────────────┐
       ↓                           ↓
 Local Worker                Cloud Worker
반복적인 작업                 어려운 작업
       ↓                           ↓
       └─────────────┬─────────────┘
                     ↓
                  Verify
처럼 가져가는 것이 자연스럽습니다.
14. Ollama를 이미 쓰고 있다면 더 간단하다
Gemma + LiteRT를 새로 구성하지 않아도 됩니다.
Ollama를 이미 사용하고 있다면:
from google.antigravity import Agent, LocalOpenAIAgentConfig


config = LocalOpenAIAgentConfig(
    model="gemma4:26b",
    base_url="http://localhost:11434/v1",
).lightweight()
처럼 연결할 수 있습니다.
즉 Antigravity SDK가:
Agent Runtime을 담당하고,
Ollama가:
Model Runtime을 담당합니다.
15. LM Studio나 vLLM도 같은 방식이다
OpenAI-compatible API만 제공한다면 비슷하게 연결할 수 있습니다.
Antigravity SDK
       ↓
LocalOpenAIAgentConfig
       ↓
OpenAI Compatible API
       ↓
Ollama
LM Studio
vLLM
모델을 바꾸더라도 Agent 코드 대부분을 유지할 수 있다는 게 장점입니다.
16. 기존 Local LLM과 다른 점은 ‘Agent’라는 것이다
Ollama로 로컬 모델을 돌리는 것 자체는 새롭지 않습니다.
예전에도:
Prompt
 ↓
Local LLM
 ↓
Answer
는 가능했습니다.
이번 업데이트에서 중요한 건:
Prompt
 ↓
Local Agent
 ↓
파일 검색
 ↓
코드 수정
 ↓
Shell 실행
 ↓
Test
 ↓
다시 수정
까지 할 수 있다는 점입니다.
즉 Local Chatbot이 아니라 Local Coding Agent가 됩니다.
17. 회사 개발환경에서는 꽤 매력적이다
특히 회사에서는 Source Code를 외부 AI에 보내는 것이 문제가 될 수 있습니다.
예를 들어:
은행

의료

국방

게임 미공개 프로젝트

사내 Backend

고객 데이터가 포함된 코드
등입니다.
이런 환경에서는:
Cloud AI 사용 금지라는 결론으로 끝나는 경우가 많았습니다.
Hybrid Agent를 사용하면 조금 다른 선택지가 생깁니다.
민감한 Source Code
→ Local

일반 Architecture 질문
→ Cloud
로 분리할 수 있습니다.
18. 그렇다고 자동으로 보안이 해결되는 건 아니다
로컬에서 실행한다고 무조건 안전한 것도 아닙니다.
Agent에는:
Shell

File Write

Network

Package Install
같은 권한이 있습니다.
실제로 공식 예제에는 빠른 테스트를 위해:
policies=[policy.allow_all()]같은 설정도 등장합니다.
개인 테스트에는 편하지만 회사 환경에서 그대로 사용하는 건 좋지 않습니다.
Production에서는:
허용 Directory

Shell Command

Network

Credential

Write Permission
을 제한하는 Policy가 필요합니다.
19. Local Model의 가장 큰 현실적인 문제는 하드웨어다
Gemma 4 26B를 제대로 돌리려면 현재 공식 권장 기준으로 24GB 이상의 VRAM 또는 Unified Memory가 필요합니다.
그래서:
MacBook Air 8GB같은 환경에서 돌리는 모델은 아닙니다.
반면:
MacBook Pro 32GB

Mac Studio

NVIDIA GPU 24GB+
정도라면 현실적으로 검토할 수 있습니다.
로컬 AI에서는 API 비용 대신:
RAM

GPU

전력

모델 다운로드

추론 속도
가 비용이 됩니다.
20. Apple Silicon에서 재미있는 이유도 여기 있다
Apple Silicon은 CPU와 GPU가 Unified Memory를 같이 사용합니다.
그래서 32GB, 64GB 이상의 메모리를 가진 Mac에서는 꽤 큰 로컬 모델도 실행할 수 있습니다.
Antigravity SDK의 LiteRT 실행도 Apple Silicon에서는 Metal GPU를 자동으로 사용합니다.
iOS 개발자라면:
Xcode

Simulator

Local Coding Agent
를 같은 Mac에서 돌리는 구성을 생각해볼 수 있습니다.
물론 Xcode와 Simulator도 메모리를 많이 쓰기 때문에 실제로는 24GB보다 여유가 있는 시스템이 훨씬 편합니다.
21. iOS 개발이라면 이런 식으로도 쓸 수 있다
예를 들어 Swift 6 Migration을 한다고 해보겠습니다.
Cloud Agent에게:
이 프로젝트에서
Swift 6 Migration 전략을 세워줘.
를 맡깁니다.
Cloud Agent가:
Concurrency

Sendable

Actor Isolation

MainActor
같은 우선순위를 결정합니다.
그리고 Local Agent에게:
Sendable warning이 발생하는 파일을 찾아.

정해진 Migration Rule에 따라
수정 후보를 만들어.
를 맡깁니다.
구조는:
Cloud
→ Migration 전략

Local
→ 파일 탐색
→ 반복 수정

Xcode
→ Build

Local
→ 오류 수정

Cloud
→ 어려운 오류만 다시 분석
입니다.
이런 구조가 꽤 현실적입니다.
22. XcodeBuildMCP까지 붙이면 한 단계 더 간다
iOS에서는:
Antigravity Agent
+
Local Model
+
XcodeBuildMCP
같은 구성도 생각할 수 있습니다.
그러면 Local Agent가:
코드 검색

수정

Build

Test

Simulator 확인
같은 반복작업을 맡을 수 있습니다.
그리고 정말 어려운 문제가 생겼을 때만 Cloud Agent에게 넘깁니다.
Local
 ↓
Build 실패
 ↓
두 번 수정해도 해결 안 됨
 ↓
Cloud Reasoning Model
 ↓
원인 분석
 ↓
Local Agent에게 수정 지시
이런 Escalation 구조가 만들어집니다.
23. 결국 Model Routing이 더 중요해진다
최근 AI Agent Architecture에서 계속 반복해서 나오는 이야기가 있습니다.
모든 요청을 가장 비싼 모델에게 보내지 않는다.
이전에는:
Request
 ↓
Claude / GPT / Gemini
정도였습니다.
이제는:
Request
 ↓
Router
 ↓
┌───────────┬───────────┐
↓           ↓           ↓
Local     Cheap Cloud  Strong Cloud
처럼 나눌 수 있습니다.
여기서 Local Model은 새로운 선택지가 하나 더 생긴 것입니다.
24. Jev 같은 Decision Model과도 자연스럽게 연결된다
앞에서 다뤘던 Jev 같은 모델을 사용하면 Routing을 더 가볍게 만들 수도 있습니다.
예를 들어:
이 작업은 단순 반복 수정인가?

YES
→ Local Agent

복잡한 설계 판단이 필요한가?

YES
→ Cloud Agent
처럼 분류할 수 있습니다.
구조는:
Request
   ↓
  Jev
   ↓
┌───────┴────────┐
↓                ↓
Local          Cloud
Agent          Agent
가 됩니다.
물론 처음부터 이렇게 복잡하게 만들 필요는 없습니다.
Agent 수와 요청량이 많아졌을 때 고려할 구조입니다.
25. Paseo나 Hermes 같은 Orchestrator와도 조합할 수 있다
예를 들어 Paseo를 쓴다면:
              Paseo
                ↓
       ┌────────┼────────┐
       ↓        ↓        ↓
    Claude    Codex   Local Gemma
     설계      구현     반복 작업
같은 구조를 만들 수 있습니다.
Hermes를 사용한다면:
Hermes
 ↓
Cloud Provider
+
Local OpenAI-compatible Provider
같은 역할 분담도 생각할 수 있습니다.
중요한 건 모델을 많이 붙이는 게 아닙니다.
작업의 성격에 맞게 모델을 고르는 것입니다.
26. 비용을 줄이는 방식도 달라진다
최근까지 Agent 비용 최적화는 주로:
Prompt Cache

Effort

Context 관리
를 이야기했습니다.
여기에 이제 하나가 더 들어옵니다.
Local Execution입니다.
그래서 비용 구조가:
Cloud Token 가격만 있는 것이 아니라:
Cloud Token

+

Local Hardware
로 바뀝니다.
반복 작업량이 크다면 이미 가지고 있는 GPU나 Mac의 여유 자원을 사용하는 것이 유리할 수 있습니다.
27. 어떤 작업부터 로컬로 옮겨보면 좋을까
처음부터 핵심 Feature 구현 전체를 로컬 Agent에게 맡길 필요는 없습니다.
오히려 이런 것부터 시작하면 됩니다.
Repository 검색

Deprecated API 탐색

Lint성 검사

중복 코드 검색

Test 추가

문서화

Security Audit

정해진 Migration

작은 Refactoring
여기서 품질을 확인한 뒤 범위를 넓히는 것이 좋습니다.
28. 이런 작업은 아직 강한 Cloud Model에 맡기는 편이 낫다
반대로:
Architecture 변경

복잡한 Race Condition

새 Framework 설계

대규모 요구사항 분석

애매한 Product Decision
같은 작업은 여전히 강한 Reasoning Model의 가치가 큽니다.
결국:
Local
= 많이 일하는 Worker

Cloud
= 어려운 결정을 하는 Architect
정도로 시작하면 이해하기 쉽습니다.
29. 이번 Antigravity 업데이트에서 가장 중요한 건 Gemma가 아니다
표면적으로 보면 이번 발표는:
Gemma 4를 Antigravity SDK에서 로컬로 돌릴 수 있게 됐다.
입니다.
하지만 더 중요한 변화는:
Agent
=
Cloud Model
이라는 고정관념이 깨진 것입니다.
이제 하나의 Agent Workflow 안에서:
Cloud Model

Local Model

Tool

Compiler

Test
이 각각 다른 역할을 가질 수 있습니다.
30. AI 개발환경도 CPU와 GPU처럼 역할이 나뉠 수 있다
컴퓨터도 모든 일을 하나의 Processor가 처리하지 않습니다.
CPU

GPU

NPU
가 각각 잘하는 일을 나눠 처리합니다.
AI Agent도 비슷해질 수 있습니다.
Strong Cloud Model
→ 어려운 판단

Fast Cloud Model
→ 일반 작업

Local Model
→ 반복 작업

Code
→ 확실한 검증
이런 구조입니다.
가장 비싼 모델 하나를 계속 호출하는 것보다 훨씬 자연스럽습니다.
마치며
이번 Antigravity SDK 업데이트를 단순히:
Google도 로컬 LLM을 지원한다.
정도로 보면 조금 아깝습니다.
재미있는 부분은 Cloud Agent와 Local Agent를 어떻게 나눠 쓰는지를 공식적으로 보여줬다는 것입니다.
Google이 공개한 Demo도 구조가 명확합니다.
Cloud Gemini
→ 작업을 계획

Local Gemma
→ Source Code 처리

Local Gemma
→ 취약점 재현

Local Gemma
→ Patch 작성

Local Test
→ 검증
Cloud Model은 Source Code를 받지 않고 전체 전략만 결정했습니다.
그리고 실제 Token 대부분은 Local Model이 처리했습니다.
이 구조가 의미하는 것은 꽤 단순합니다.
모든 작업에 가장 강한 모델을 사용할 필요가 없습니다.
앞으로는:
어려운 판단
→ Cloud

반복적인 실행
→ Local

명확한 검증
→ Code / Test
로 역할을 나누는 Agent가 더 많아질 가능성이 큽니다.
특히 회사 Source Code처럼 외부로 보내기 어려운 데이터가 있거나, 대규모 Repository에서 반복적인 작업을 많이 돌린다면 로컬 Agent의 가치는 훨씬 커집니다.
로컬 모델이 클라우드 AI를 대체하는 방향이라기보다,
클라우드 AI가 해야 할 일을 줄여주는 방향에 가깝습니다.
이번 Antigravity SDK 업데이트에서 가장 흥미로운 변화도 바로 그 부분입니다.
참고자료
Google Developers Blog — Introducing Support for Local AI Models in the Antigravity SDK
2026년 9월 23일 공개된 공식 발표입니다. Gemma 4 26B A4B와 LiteRT 기반 로컬 Agent, Cloud Architect + Local Worker 구조, 보안 패치 Demo와 Local Token 비율 등을 확인할 수 있습니다.
Google Antigravity SDK — Running Agents with Local Models
LiteRTAgentConfig, LocalOpenAIAgentConfig, Gemma 4 설치, Ollama·LM Studio 연동, 하드웨어 요구사항과 Local Agent 설정을 설명한 공식 문서입니다.
Google Antigravity SDK — Local Models Getting Started
Python 가상환경부터 SDK와 LiteRT-LM 설치, Gemma 4 다운로드, Workspace를 가진 Local Coding Agent 실행 예제까지 단계별로 확인할 수 있습니다.
Google Antigravity SDK — GitHub
Antigravity SDK 전체 코드와 Local Agent 예제, Tools, Trigger, MCP 및 최신 변경사항을 확인할 수 있습니다.
이번 발표에서 Google이 직접 공개한 95 cloud tokens, 97.2% local tokens, 3,322 local tokens는 보안 취약점 3개를 수정한 Google의 특정 Demo 결과입니다. 일반적인 프로젝트에서도 같은 비율이 나온다는 의미는 아니지만, Cloud Planner와 Local Worker를 어떻게 나눌 수 있는지는 꽤 잘 보여주는 사례입니다.