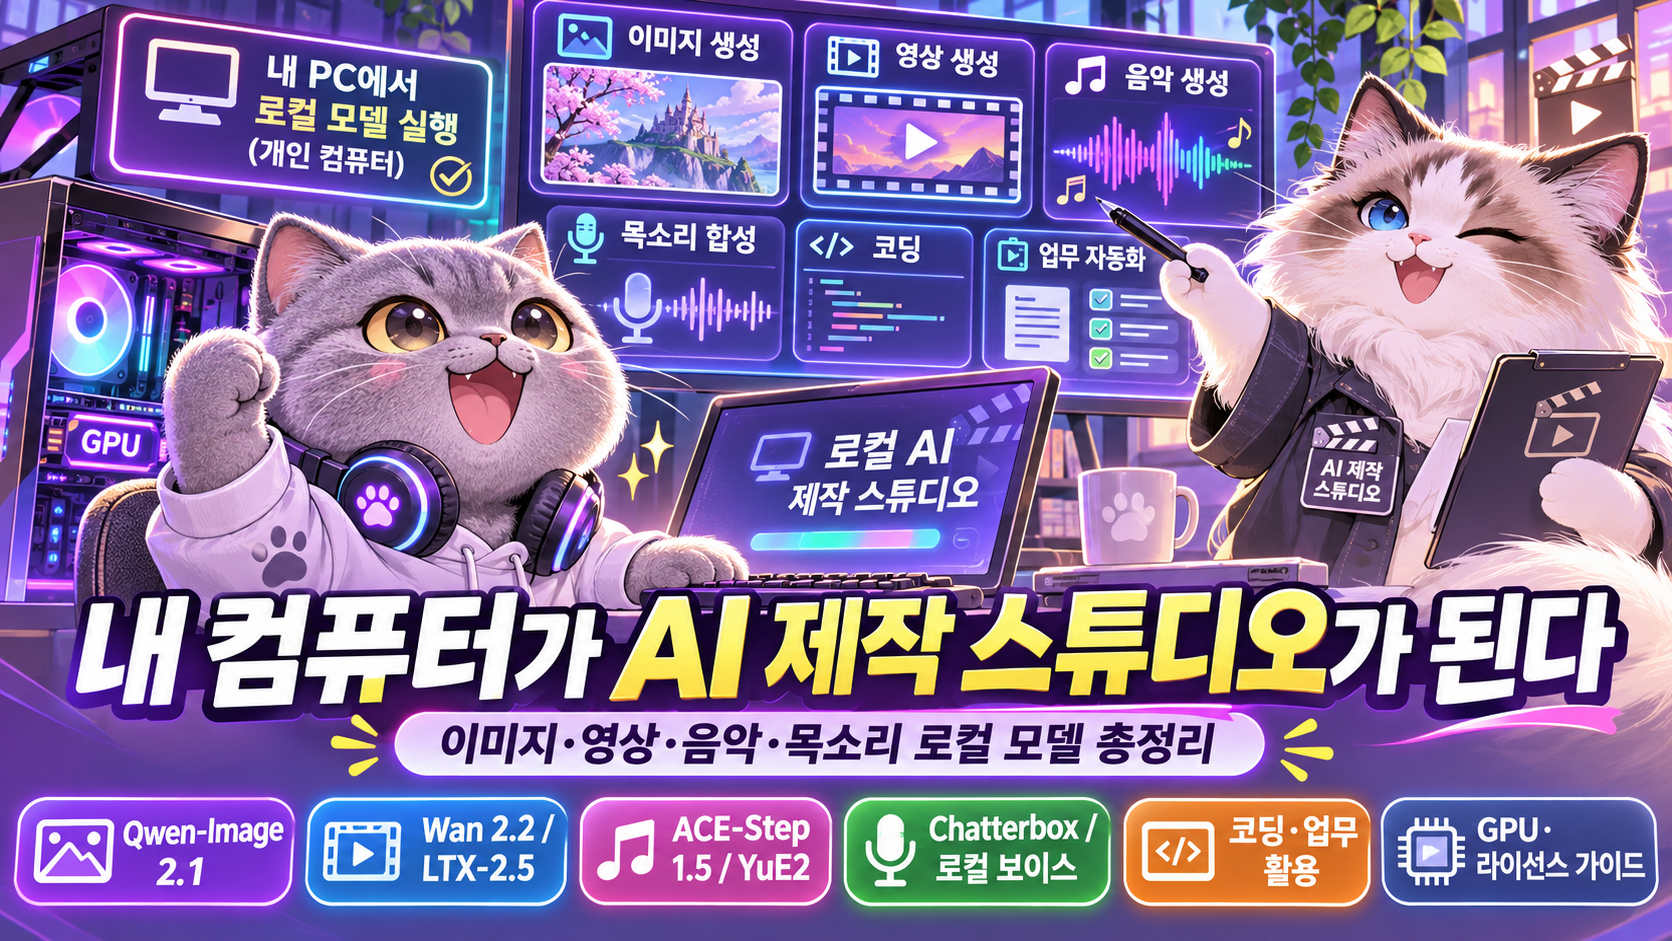
내 컴퓨터가 AI 제작 스튜디오가 된다 — 이미지·영상·음악·목소리 로컬 모델 총정리
내 컴퓨터가 AI 제작 스튜디오가 된다 — 이미지·영상·음악·목소리 로컬 모델 총정리
2026년 최신 로컬 AI 비교: 이미지 생성부터 영상 제작, 음악·더빙, 코딩과 업무 활용까지
2026년 11월 2일 기준
몇 년 전까지만 해도 로컬 AI라고 하면 대부분 텍스트를 생성하는 언어모델을 떠올렸다.
Ollama를 설치하고, 작은 LLM을 다운로드하고, 터미널에서 질문을 입력하는 방식이었다.
물론 그때도 이미지 생성 모델은 존재했다. Stable Diffusion을 설치해 그림을 만들거나, Whisper로 음성을 텍스트로 변환하는 일도 가능했다.
하지만 최근 로컬 AI의 활용 범위는 훨씬 넓어졌다.
이제 내 컴퓨터에서 캐릭터를 만들고, 사진을 움직이는 영상으로 바꾸고, 가사가 있는 노래를 생성하고, 영상에 들어갈 목소리까지 만들 수 있다.
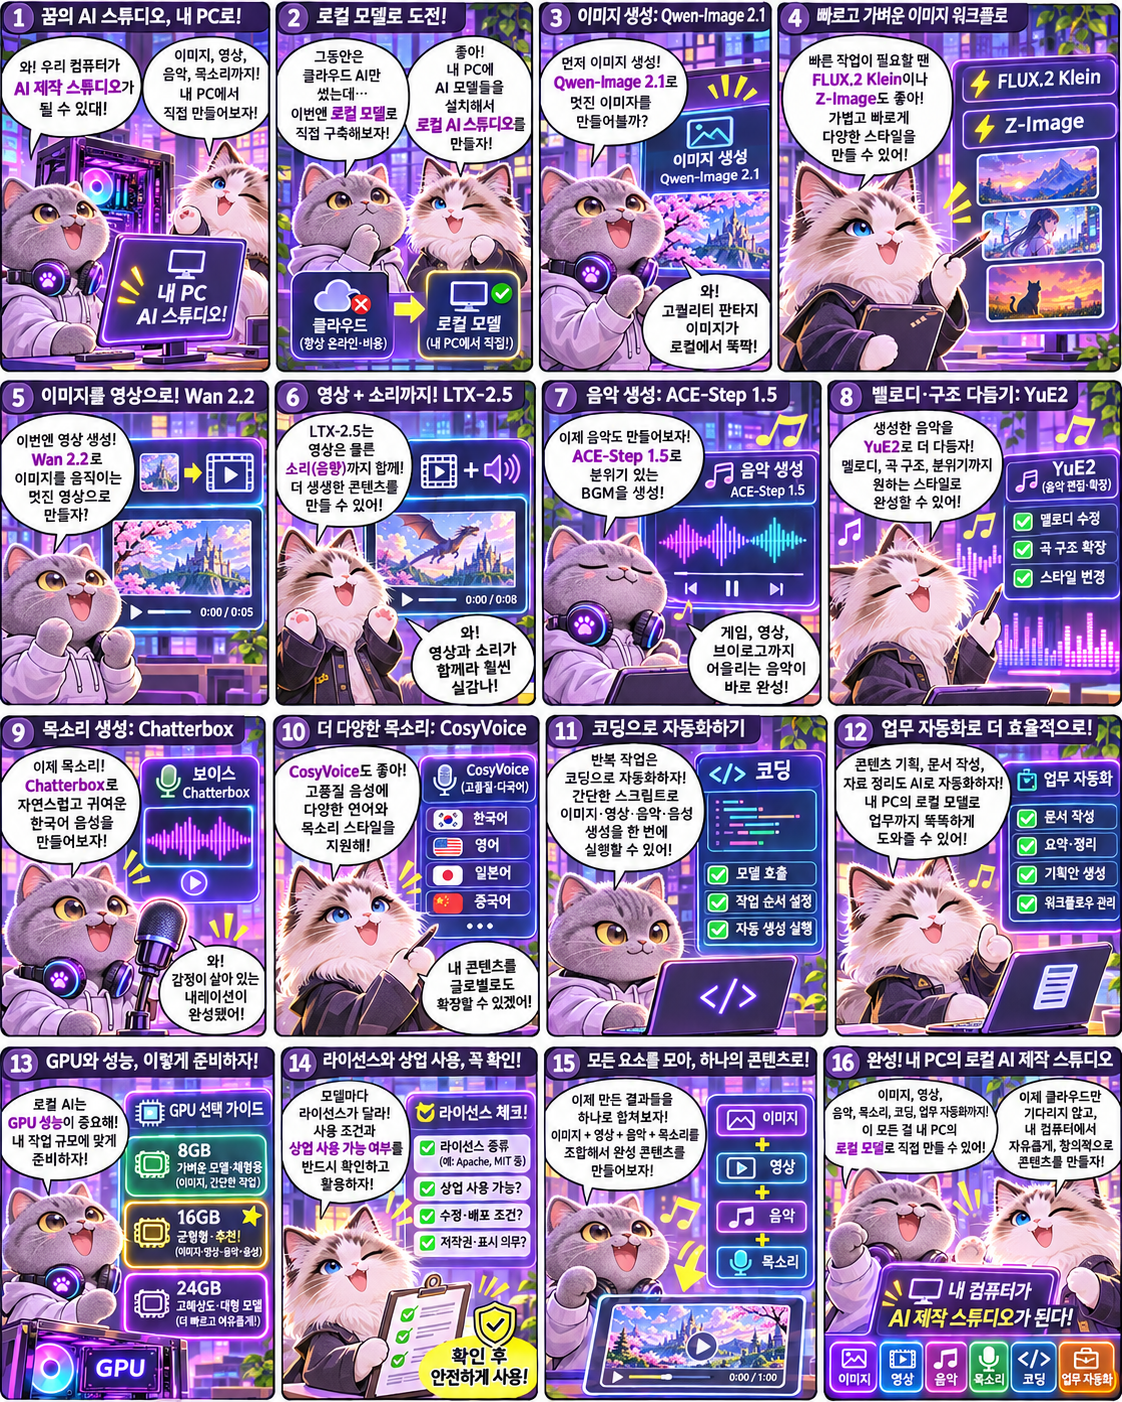
더 흥미로운 것은 이미지·영상·음악·음성을 각각 생성하는 단계를 넘어 하나의 콘텐츠 제작 과정으로 연결할 수 있다는 점이다.
예를 들어 이런 방식이다.
콘텐츠 아이디어
       ↓
캐릭터·배경 이미지
       ↓
이미지를 움직이는 영상으로 변환
       ↓
배경음악·효과음 제작
       ↓
내레이션·캐릭터 음성 제작
       ↓
영상 편집
       ↓
완성된 콘텐츠
이런 작업을 꼭 외부 AI 서비스에서만 처리할 필요는 없다.
모델 가중치와 실행 코드가 공개돼 있다면 자신의 GPU에서 직접 추론할 수 있다.
물론 현실적인 제약도 많다.
이미지 생성은 상대적으로 접근하기 쉬워졌지만, 고품질 영상은 여전히 많은 메모리와 계산량을 요구한다.
음악 모델은 낮은 VRAM에서도 실행 가능한 구성이 등장했지만, 한국어 가사의 자연스러움과 음질은 모델마다 차이가 있다.
또 모델을 다운로드할 수 있다고 해서 모든 결과물을 자유롭게 상업적으로 사용할 수 있는 것도 아니다.
이번 글에서는 이미지·영상·음악·보이스 제작을 중심으로 현재 어떤 로컬 모델을 선택할 만한지 살펴본다.
코딩과 업무용 모델도 다루지만 이번에는 보조적인 역할이다.
핵심은 한 가지다.
내 컴퓨터를 실제로 사용할 수 있는 AI 콘텐츠 제작 스튜디오로 만들려면 어떤 모델부터 선택해야 할까?
1. 로컬 AI의 중심이 챗봇에서 콘텐츠 제작으로 넓어졌다
로컬 AI의 가장 큰 장점은 직접 실행할 수 있다는 점이다.
클라우드 API는 요청할 때마다 외부 서버에서 연산이 이뤄진다.
반면 로컬 모델은 자신의 컴퓨터나 별도 서버에서 추론한다.
클라우드 AI

사용자
  ↓
인터넷
  ↓
서비스 제공자 GPU
  ↓
생성 결과
로컬 AI
사용자
↓
내 컴퓨터의 모델
↓
GPU 연산
↓
생성 결과이 차이는 이미지 한 장을 생성할 때보다 여러 번 수정하는 작업에서 더 크게 체감할 수 있다.
예를 들어 웹툰 캐릭터 하나를 만든다고 생각해보자.
첫 결과에서 표정이 마음에 들지 않아 다시 생성한다.
의상을 바꾼다.
배경을 수정한다.
같은 캐릭터의 다른 포즈를 만든다.
영상으로 움직이게 한 뒤에는 음성과 배경음악을 추가한다.
이렇게 반복하는 작업은 결과물 하나를 만드는 것보다 훨씬 많은 생성 과정을 거친다.
로컬 AI는 적절한 하드웨어를 이미 가지고 있다면 이런 반복 작업을 별도 API 호출 요금 없이 수행할 수 있다.
하지만 무료라는 표현은 정확하지 않다.
GPU 구입비, 전기 요금, 스토리지, 실행 시간, 유지보수 비용은 여전히 존재한다.
또 최신 상용 서비스가 제공하는 품질과 편의성을 모든 로컬 모델이 따라잡은 것도 아니다.
따라서 로컬 AI를 선택하는 이유는 단순한 요금 절감만이 아니다.
모델을 직접 선택하고, 제작 과정을 수정하고, 반복 생성과 데이터를 스스로 통제할 수 있다는 점이 더 중요한 장점이다.
2. 클라우드 AI와 로컬 AI, 무엇이 더 유리할까?
대표적인 클라우드 제작 서비스로는 이미지의 Midjourney, 영상의 Runway, 음악의 Suno, 음성의 ElevenLabs 등을 떠올릴 수 있다.
이런 서비스는 설치와 환경 구성이 간단하고, 모델 실행을 위한 GPU를 직접 준비하지 않아도 된다.
반면 로컬 AI는 설정이 어렵더라도 제작 과정에 개입할 여지가 많다.
| 비교 항목 | 클라우드 AI | 로컬 AI |
|---|---|---|
| 시작하기 | 대체로 간편 | 설치·환경 설정 필요 |
| GPU 구매 | 불필요 | 자체 장비 또는 서버 필요 |
| 반복 생성 | 서비스별 요금·제한 | GPU 성능과 시간에 영향 |
| 모델 수정 | 서비스가 허용한 범위 | 지원 모델에서 LoRA·파인튜닝 가능 |
| 데이터 처리 | 제공자 정책 확인 | 로컬 처리 경로 직접 구성 가능 |
| 최신 기능 | 빠르게 제공되는 경우 많음 | 공개 모델과 구현체에 따라 다름 |
| 유지보수 | 서비스 제공자가 담당 | 사용자가 관리 |
| 상업적 사용 | 서비스 약관 확인 | 모델·가중치 라이선스 확인 |
특히 구분해야 할 것은 로컬 실행과 오픈소스의 차이다.
모델 가중치가 공개돼 있어도 학습 데이터나 학습 코드까지 모두 공개됐다는 뜻은 아니다.
또 오픈 가중치라고 해서 반드시 상업적 이용을 허용하는 것도 아니다.
이번에 살펴볼 Qwen-Image 2.1은 공개 가중치 모델이지만 Qwen Research License가 적용된다.
반면 FLUX.2 Klein 4B는 Apache 2.0 라이선스를 사용하고, 같은 Klein 계열의 9B 모델은 비상업적 라이선스를 적용한다.
따라서 모델을 선택할 때는 품질과 속도 못지않게 정확한 모델 변형과 라이선스를 확인해야 한다.
Part 1. 이미지 — 로컬에서도 썸네일과 포스터를 만든다
3. Stable Diffusion 이후 이미지 모델은 무엇이 달라졌을까?
로컬 이미지 생성의 대중화를 이끈 모델은 Stable Diffusion이었다.
Stable Diffusion 1.5와 SDXL을 사용하면 개인용 GPU에서도 다양한 스타일의 이미지를 만들 수 있었다.
커뮤니티에서는 LoRA와 ControlNet, 인페인팅, 업스케일링 같은 도구가 발전했다.
이후 이미지 모델 경쟁의 중심은 단순히 더 사실적인 이미지를 만드는 것에서 벗어났다.
최근에는 다음 기능들이 중요해지고 있다.
첫 번째는 프롬프트 이해력이다.
예를 들어 고양이 캐릭터 두 마리를 서로 다른 위치에 배치하고, 특정 손동작과 표정을 요구하는 상황이다.
모델이 요청한 구성요소를 얼마나 정확하게 반영하는지가 중요하다.
두 번째는 텍스트 표현이다.
썸네일이나 포스터에는 글자가 들어간다.
이미지가 아무리 좋아도 한글이 깨지거나 문장이 틀리면 실제로 사용할 수 없다.
세 번째는 편집이다.
이미지를 새로 만드는 것보다 기존 결과물의 일부분을 수정하는 일이 많다.
배경만 바꾸거나 인물의 옷을 수정하면서 캐릭터의 모습은 유지해야 하는 상황이다.
네 번째는 일관성이다.
같은 캐릭터를 여러 장면에서 사용하려면 얼굴과 의상이 지나치게 달라지지 않아야 한다.
최근 이미지 모델은 이런 실사용 문제를 해결하는 방향으로 발전하고 있다.
4. Qwen-Image 2.1 — 이미지 생성과 편집을 하나로 연결한다
2026년 9월 20일 공개된 Qwen-Image 2.1은 이번 글에서 가장 먼저 살펴볼 이미지 모델이다.
Qwen-Image 2.1은 이미지 생성과 편집을 하나의 구조로 제공한다.
공식 발표에서 강조한 특징은 다음과 같다.
| 항목 | Qwen-Image 2.1 |
|---|---|
| 이미지 생성 핵심 구성 | 7B 파라미터 |
| 기본 기능 | Text-to-Image, 이미지 편집 |
| 투명 배경 | 네이티브 RGBA 지원 |
| 참조 이미지 | 최대 10장 지원 |
| 부분 편집 | 마스크·표시 영역 기반 편집 |
| 실행 환경 | Diffusers, ComfyUI 등 |
| 라이선스 | Qwen Research License |
특히 투명 배경과 이미지 편집을 함께 제공한다는 점이 흥미롭다.
예를 들어 캐릭터 스티커를 만든다면 다음 흐름으로 사용할 수 있다.
캐릭터 이미지 생성
        ↓
배경 제거·투명화
        ↓
표정 수정
        ↓
다른 포즈 생성
        ↓
PNG 리소스로 활용
또 여러 장의 참조 이미지를 입력받아 인물이나 제품의 특성을 유지한 채 다른 장면을 만드는 작업도 지원한다.
2026년 10월 9일에는 Qwen-Image 2.1 Turbo도 공개됐다.
Turbo는 8단계의 디노이징으로 이미지 생성과 편집을 수행하도록 구성돼 있다.
이것은 고품질 이미지를 무조건 가장 빠르게 만든다는 보장이 아니라 반복적인 시안 제작에 유리하도록 추론 단계를 줄인 변형이라고 이해하는 것이 정확하다.
Qwen-Image 2.1은 ComfyUI와 Diffusers에서 지원되며, Apple Silicon용 로컬 실행 경로도 공식 저장소에서 안내한다.
다만 7B라는 숫자만 보고 7B 언어모델과 메모리 요구량이 같다고 생각하면 안 된다.
텍스트 인코더와 VAE, 이미지 생성 모델을 함께 실행하기 때문에 실제 메모리 요구량은 더 복잡하다.
추천 용도는 썸네일·포스터, 캐릭터 제작, 제품 이미지 편집, 여러 참조 이미지를 사용하는 작업이다.
5. FLUX.2 Klein과 Z-Image-Turbo — 빠르고 가벼운 이미지 제작
Qwen-Image 2.1이 다양한 편집 기능을 강조한다면, FLUX.2 Klein과 Z-Image-Turbo는 개인용 GPU에서의 실행 효율을 살펴볼 만하다.
FLUX.2 Klein 4B
Black Forest Labs는 2026년 1월 FLUX.2 Klein 계열을 공개했다.
그중 4B 모델은 비교적 작은 규모와 빠른 생성이 특징이다.
공식 자료에서는 약 8GB VRAM 환경에서 실행 가능한 구성으로 안내한다.
주요 기능은 이미지 생성, 단일 참조 이미지 편집, 여러 참조 이미지를 활용한 편집이다.
| 모델 | 특징 | 라이선스 |
|---|---|---|
| FLUX.2 Klein 4B | 빠른 생성·편집, 개인용 GPU | Apache 2.0 |
| FLUX.2 Klein 4B Base | 파인튜닝에 적합 | Apache 2.0 |
| FLUX.2 Klein 9B | 더 높은 품질을 지향 | 비상업적 라이선스 |
| FLUX.2 Klein 9B KV | 다중 참조 편집 효율 개선 | 비상업적 라이선스 |
같은 이름의 모델 계열이라도 라이선스가 다르다는 점이 중요하다.
특히 상업적인 앱이나 콘텐츠 제작 파이프라인에 도입하려면 4B와 9B를 구분해야 한다.
Z-Image-Turbo
Z-Image는 Tongyi-MAI가 공개한 이미지 모델 계열이다.
6B 규모의 이미지 생성 모델을 기반으로 하며, Turbo 변형은 적은 추론 단계로 빠르게 이미지를 생성하도록 설계됐다.
공식 저장소에서는 Z-Image-Turbo가 16GB VRAM급 소비자 GPU에서 실행 가능한 구성을 안내한다.
사실적인 이미지와 영어·중국어 텍스트 표현을 주요 강점으로 내세운다.
| 항목 | FLUX.2 Klein 4B | Z-Image-Turbo |
|---|---|---|
| 모델 규모 | 4B | 6B |
| 주요 특징 | 빠른 생성·편집 | 빠른 생성·사실적 이미지 |
| 공식 VRAM 안내 | 약 8GB | 약 16GB |
| 이미지 편집 | 지원 | 별도 편집 모델·워크플로 확인 |
| 라이선스 | Apache 2.0 | Apache 2.0 |
여기서 VRAM은 공식적인 실행 가이드 수준으로 이해해야 한다.
GPU와 해상도, 정밀도, 오프로딩 여부에 따라 실제 사용량은 달라질 수 있다.
어떤 이미지 모델을 선택할까?
개인적으로 모델 선택 기준은 다음처럼 정리할 수 있다.
8GB급 GPU에서 빠르게 시안을 만들고 싶다면 FLUX.2 Klein 4B.
사실적인 이미지를 반복 생성하고 싶다면 Z-Image-Turbo.
참조 이미지와 투명 배경, 부분 편집까지 하나의 워크플로로 연결하려면 Qwen-Image 2.1.
다만 한글이 들어간 최종 썸네일은 모델별로 같은 문장을 생성해 실제 정확도를 비교하는 것이 좋다.
공식적으로 텍스트 표현이 개선됐다는 설명만으로 한국어 문장이 항상 정확하게 만들어진다고 판단할 수는 없다.
Part 2. 영상 — 사진 한 장에서 움직이는 영상까지
6. 로컬 영상 생성은 어디까지 가능해졌을까?
영상 생성은 이미지보다 계산량이 훨씬 크다.
이미지는 한 장의 공간적인 정보를 생성하지만, 영상은 여러 프레임이 시간에 따라 자연스럽게 이어져야 한다.
등장인물의 얼굴이나 의상이 갑자기 바뀌어서는 안 되고, 배경과 카메라 움직임도 연속성을 유지해야 한다.
영상 생성에는 대표적으로 세 가지 방식이 있다.
| 방식 | 설명 |
|---|---|
| Text-to-Video | 텍스트만으로 영상 생성 |
| Image-to-Video | 이미지에 움직임을 추가 |
| Video-to-Video | 기존 영상을 다른 스타일이나 장면으로 변환 |
최근에는 여기에 오디오까지 결합되고 있다.
이전에는 영상을 생성한 뒤 음성을 따로 만들고 편집하는 경우가 많았다.
이제 일부 모델은 영상과 오디오를 동시에 생성하도록 설계된다.
예를 들어 사람이 문을 열고 들어오는 장면에서 발소리와 주변 환경음까지 함께 만드는 방식이다.
하지만 영상 제작에서 중요한 것은 단순히 클립 하나가 만들어졌는지가 아니다.
여러 장면을 연결했을 때 캐릭터와 공간이 유지되는지, 원하는 움직임을 수정할 수 있는지가 더 중요하다.
7. Wan 2.2 — 로컬 영상 생성의 대표적인 선택지
Wan 2.2는 공개 영상 생성 모델 중에서 검토할 가치가 큰 계열이다.
텍스트와 이미지 기반 영상 생성 워크플로를 제공한다.
특히 ComfyUI를 활용한 커뮤니티 워크플로가 다양하다는 점이 장점이다.
Wan 2.2는 모델 변형에 따라 규모와 실행 요구사항이 크게 달라진다.
가벼운 모델과 대형 모델을 동일한 하드웨어 기준으로 비교해서는 안 된다.
영상의 길이와 해상도, 프레임 수에 따라 메모리 사용량도 달라진다.
예를 들어 짧은 저해상도 영상은 오프로딩과 최적화를 통해 실행할 수 있어도, 같은 모델의 고해상도 장시간 생성은 훨씬 부담스러울 수 있다.
Wan 2.2를 사용할 만한 상황은 다음과 같다.
- 정지 이미지를 짧은 영상으로 만들기
- 캐릭터 애니메이션 시도
- 광고용 짧은 클립 생성
- ComfyUI를 활용한 반복적인 생성 워크플로
- 로컬에서 영상 생성 파라미터 조정
이 모델의 장점은 다양한 영상 생성 작업을 직접 구성할 수 있다는 것이다.
반면 클립을 여러 개 연결했을 때 인물과 장면이 항상 일관되게 유지되는 것은 아니다.
또 프레임마다 손이나 얼굴, 물체가 어색하게 변하는 문제도 발생할 수 있다.
따라서 Wan 2.2는 완성된 영화를 자동으로 만드는 도구보다 직접 장면을 생성하고 수정하는 영상 제작 엔진으로 이해하는 편이 적절하다.
## 8. LTX-2.5 — 영상과 소리를 함께 생성하는 방향으로 발전하다
최근 영상 모델에서 특히 주목할 만한 변화는 오디오와 영상의 결합이다.
Lightricks의 LTX 계열은 영상 생성과 오디오 생성을 하나의 제작 과정으로 연결하는 방향으로 발전하고 있다.
2026년 8월 공개된 LTX-2.5는 기존 LTX-2.3을 기반으로 여러 기능을 개선했다.
공식 문서에서는 다음 특징을 강조한다.
- 영상과 오디오의 동기화 생성
- 텍스트·이미지·영상 기반 입력
- 여러 장면을 연결하는 멀티샷 생성
- 캐릭터와 장면의 일관성 개선
- 증류 모델을 이용한 연산 비용 감소
- LoRA·IC-LoRA를 활용한 커스터마이징
여기서 중요한 것은 LTX-2.5라는 이름으로 제공되는 모델과 API 상품을 구분해야 한다는 점이다.
LTX-2.5에는 공개 가중치 기반 로컬 실행 구성이 있으며, API에서 제공하는 Fast·Pro 변형도 있다.
특히 LTX Desktop의 로컬 생성은 LTX-2.5 Fast를 기본으로 사용한다.
반면 LTX-2.5 Pro는 LTX Desktop에서 API 전용으로 안내돼 있다.
| 항목 | LTX-2.5 Fast | LTX-2.5 Pro |
|---|---|---|
| 로컬 실행 | 지원 구성 존재 | LTX Desktop 기준 API 전용 |
| 주요 목적 | 빠른 생성·반복 제작 | 클라우드 고품질 제작 |
| 영상·오디오 | 지원 | 지원 |
| 하드웨어 | 로컬 GPU 요구 | 서비스 측에서 실행 |
따라서 LTX-2.5가 4K 영상을 지원한다고 해서 일반적인 개인 GPU로 최고 품질의 모든 설정을 원활하게 실행할 수 있다는 뜻은 아니다.
왜 멀티샷이 중요할까?
영상 제작에서는 한 장면만 필요한 경우보다 여러 장면을 연결해야 하는 경우가 많다.
예를 들어 다음과 같은 광고를 만든다고 생각해보자.
장면 1
주인공이 카페에 들어온다.

장면 2
커피를 주문한다.

장면 3
창가에 앉아 커피를 마신다.
기존에 각 장면을 독립적으로 생성하면 주인공의 얼굴이나 옷이 달라질 수 있다.
카페의 공간 구조와 조명도 이어지지 않을 수 있다.
LTX-2.5는 여러 장면을 연결하면서 인물과 공간의 일관성을 유지하는 방향으로 개선됐다.
물론 이런 기능이 모든 장면에서 완벽하게 동작한다는 뜻은 아니다.
그러나 영상 모델의 경쟁이 짧은 클립 하나의 품질에서 여러 장면을 연결하는 제작 능력으로 이동하고 있다는 점은 분명하다.
Wan과 LTX 중 무엇을 선택할까?
Wan 2.2는 다양한 로컬 영상 생성 워크플로를 탐색하기에 좋다.
LTX-2.5는 영상과 오디오를 결합하거나 여러 장면의 연속성을 유지하는 제작 흐름을 검토할 만하다.
다만 실제 품질과 생성 속도는 GPU, 해상도, 모델 변형, 최적화 설정에 따라 달라진다.
영상 분야에서는 모델 이름만으로 우열을 정하기보다 내 하드웨어에서 원하는 길이의 클립을 만들 수 있는지부터 확인하는 것이 좋다.
9. HunyuanVideo까지 비교한다면 무엇을 봐야 할까?
Tencent의 HunyuanVideo 계열도 로컬 영상 생성에서 자주 언급되는 모델이다.
영상의 사실감과 움직임, 프롬프트 표현 능력을 비교할 때 함께 살펴볼 만하다.
하지만 영상 모델을 선택할 때는 기능 외에 중요한 문제가 하나 더 있다.
바로 라이선스다.
일부 영상 모델은 코드가 공개돼 있어도 모델 가중치에는 별도의 커뮤니티 라이선스가 적용된다.
특정 지역에서의 이용 제한이나 서비스 규모에 따른 조건이 있을 수도 있다.
따라서 HunyuanVideo처럼 별도 라이선스를 사용하는 모델은 정확한 체크포인트를 기준으로 확인해야 한다.
개인적인 연구와 상업용 앱에 모델을 탑재하는 것은 다른 사용 방식이다.
콘텐츠를 생성해 게시하는 행위와 모델을 재배포하거나 서비스로 제공하는 행위도 구분할 필요가 있다.
이런 이유로 상업용 영상 제작 파이프라인은 품질 비교 전에 모델 라이선스부터 확인하는 것이 안전하다.
10. 이미지와 영상 모델을 연결하면 제작 방식이 달라진다
이미지와 영상을 각각 생성하는 것보다 두 모델을 연결했을 때 활용 범위가 커진다.
예를 들어 웹툰 캐릭터가 움직이는 짧은 영상을 제작한다고 생각해보자.
첫 번째 단계에서는 이미지 모델을 사용한다.
Qwen-Image 2.1이나 FLUX.2 Klein으로 캐릭터의 기본 모습을 만든다.
두 번째 단계에서는 캐릭터 시트를 구성한다.
정면, 측면, 표정, 의상 등을 정의한다.
세 번째 단계에서는 영상 모델을 활용한다.
Wan이나 LTX 계열로 캐릭터에 움직임을 추가한다.
캐릭터 콘셉트
       ↓
이미지 생성
       ↓
캐릭터 디자인 확정
       ↓
장면별 이미지 생성
       ↓
Image-to-Video
       ↓
클립 선택·수정
       ↓
영상 편집
이런 제작 흐름에서는 처음부터 영상 모델로 모든 것을 해결하려는 것보다 이미지를 통해 구도와 캐릭터를 먼저 확정하는 방식이 유용할 수 있다.
특히 여러 장면에서 같은 캐릭터를 사용하려면 참조 이미지와 스타일 관리가 중요하다.
다만 참조 이미지 하나를 제공했다고 해서 모든 프레임의 캐릭터가 완전히 동일하게 유지되는 것은 아니다.
표정이나 손동작, 머리카락, 의상 같은 부분은 후속 검수가 필요할 수 있다.
로컬 영상 제작의 장점은 완벽한 결과물을 한 번에 만드는 것이 아니라, 결과물을 여러 단계로 나눠 수정할 수 있다는 점에 있다.
Part 3. 음악 — 로컬 AI가 가장 흥미로워진 영역
11. 이제 로컬에서도 가사와 보컬이 있는 노래를 만든다
최근 로컬 AI에서 개인적으로 가장 흥미로운 변화는 음악 분야다.
이미지 생성은 이미 다양한 공개 모델이 존재했고, 영상도 꾸준히 발전하고 있었다.
반면 음악은 Suno처럼 완성된 클라우드 서비스의 편의성이 강점으로 여겨졌다.
자연어로 장르와 분위기를 입력하고 가사를 제공하면 보컬이 포함된 노래를 만들어주는 경험 때문이다.
그런데 최근 공개 음악 모델도 비슷한 작업을 지원하는 방향으로 발전하고 있다.
이제 로컬에서도 다음과 같은 작업을 시도할 수 있다.
- 가사에서 노래 생성
- 장르와 분위기에 맞는 음악 제작
- 보컬이 없는 배경음악 생성
- 특정 구간 수정
- 곡의 구조와 멜로디 편집
- 참조 음악 기반 커버 또는 변형
물론 상용 서비스와 같은 품질이 보장되는 것은 아니다.
특히 가사의 명료도, 보컬의 감정 표현, 곡 전체의 일관성은 모델별 차이가 크다.
그럼에도 개인용 GPU에서 완성곡 생성과 편집을 실험할 수 있다는 사실 자체가 중요한 변화다.
이번 글에서는 ACE-Step 1.5, YuE2, HeartMuLa를 중심으로 비교한다.
12. ACE-Step 1.5 — 로컬 음악 제작을 시작한다면 먼저 볼 모델
ACE-Step 1.5는 로컬 음악 생성에 관심이 있다면 우선 검토할 만한 모델이다.
ACE Studio와 StepFun이 함께 개발한 공개 음악 생성 프로젝트다.
공식 저장소는 MIT 라이선스를 적용한다.
ACE-Step 1.5의 특징은 음악 생성뿐 아니라 부분 편집과 여러 제작 작업을 지원한다는 점이다.
특히 하드웨어에 맞춰 모델 구성을 바꿀 수 있도록 설계됐다.
공식 GPU 호환성 안내를 살펴보면 다음과 같다.
| VRAM | 공식적으로 안내하는 구성 |
|---|---|
| 4GB 이하 | INT8·CPU 오프로딩, 제한적인 구성 |
| 6~8GB | 0.6B LM 조합 가능 |
| 8~12GB | 0.6B LM 중심 |
| 12~16GB | 1.7B LM 사용 가능 |
| 16~20GB | 대형 구성 일부 오프로딩 |
| 24GB 이상 | 고품질 구성 선택 폭 확대 |
낮은 VRAM에서 실행 가능한 것은 장점이다.
하지만 4GB GPU에서 최고 품질의 모든 기능을 원활하게 사용할 수 있다는 뜻은 아니다.
실제로는 CPU 오프로딩과 양자화에 의존할 수 있고, 생성 속도가 상당히 느려질 수 있다.
어떤 음악을 만들 수 있을까?
예를 들어 다음과 같은 프롬프트를 생각해보자.
Style:
Warm acoustic indie pop

Mood:
Relaxed, nostalgic

Instruments:
Acoustic guitar, piano, soft drums

Vocals:
Gentle female vocal

Language:
Korean

Structure:
Intro, verse, chorus, verse, chorus, outro
모델은 이런 정보를 바탕으로 음악을 생성할 수 있다.
하지만 한국어 발음이 자연스럽고 가사가 정확하게 전달되는지는 결과를 직접 들어봐야 한다.
특히 한국어처럼 조사와 받침, 음절 길이가 중요한 언어에서는 발음이 부자연스러울 수 있다.
ACE-Step의 진짜 장점은 편집이다
음악을 한 번 생성한 뒤 후렴이 마음에 들지 않는다면 어떻게 해야 할까?
처음부터 노래 전체를 다시 만드는 방법도 있지만, 특정 구간만 다시 생성하는 방식이 더 효율적일 수 있다.
ACE-Step 1.5는 이런 편집 중심의 제작 흐름을 지원한다.
초기 음악 생성
       ↓
전체 곡 청취
       ↓
문제 구간 선택
       ↓
부분 재생성
       ↓
새 결과 비교
       ↓
최종 버전 선택
이런 방식은 반복적으로 음악을 만드는 사람에게 특히 유용하다.
낮은 VRAM에서 시작할 수 있고, 단순 생성보다 편집까지 연결할 수 있다는 점이 ACE-Step 1.5의 가장 큰 매력이다.
13. YuE2 — 노래를 만들고 악보와 멜로디까지 수정한다
2026년 9월 공개된 YuE2는 음악 제작을 조금 다른 방향으로 접근한다.
단순히 프롬프트를 입력해 오디오를 만드는 것뿐 아니라 음악의 구조를 표현하는 Symbolic Plan을 함께 활용한다는 점이 특징이다.
여기서 Symbolic Plan은 멜로디나 코드 같은 음악적 정보를 구조화해서 다루는 방식을 의미한다.
이런 구조를 활용하면 완성된 오디오만 수정하는 것이 아니라 음악 구성 자체를 편집하는 접근이 가능해진다.
가사·스타일
      ↓
음악 구조 계획
      ↓
멜로디·코드 정보
      ↓
오디오 생성
      ↓
계획 수정
      ↓
다시 생성
예를 들어 후렴의 멜로디를 바꾸고 싶을 때 기존 오디오를 단순히 다시 생성하는 대신 음악 구조를 변경해 새로운 결과를 만드는 방식을 생각할 수 있다.
YuE2는 가사 기반 노래 생성과 커버, 에이전트 기반 음악 편집을 소개한다.
9월 말에는 악기 연주 중심의 음악 생성과 커버를 지원하는 스킬 업데이트도 공개됐다.
YuE2와 ACE-Step은 무엇이 다를까?
| 항목 | ACE-Step 1.5 | YuE2 |
|---|---|---|
| 주요 접근 | 음악 생성·편집 | 구조화된 음악 계획과 생성 |
| 가사 기반 노래 | 지원 | 지원 |
| 곡 수정 | 부분 생성·편집 워크플로 | 멜로디·코드 계획 편집 |
| 로컬 실행 | 지원 | 지원 |
| 라이선스 | MIT | YuE2 가중치 비상업적 조건 |
| 추천 대상 | 로컬 음악 제작 입문·반복 작업 | 곡 구성과 편곡까지 다루는 제작자 |
YuE2의 모델 가중치는 CC BY-NC 4.0 라이선스를 적용한다.
따라서 상업적 사용을 검토한다면 별도의 허가 조건을 확인해야 한다.
또 공식 프로젝트가 공개한 다른 음악 모델과의 벤치마크는 평가 방식과 선택한 샘플 수에 따라 결과가 달라질 수 있다.
특히 여러 번 생성한 뒤 가장 좋은 결과를 선택하는 Best-of-N 평가와 한 번 생성한 결과를 직접 비교해서는 안 된다.
이 점을 고려하면 YuE2의 강점은 단순히 다른 모델보다 음악을 잘 만든다는 주장보다 음악의 구조를 계획하고 수정하는 제작 방식에 있다.
14. HeartMuLa — 가사·스타일 기반 음악 생성과 커버 제작
HeartMuLa도 공개 음악 생성 모델 가운데 살펴볼 만하다.
가사와 스타일 정보를 기반으로 음악을 생성하는 방향으로 개발됐다.
관련 프로젝트에서는 음악 생성뿐 아니라 커버와 스타일 변환을 위한 모델도 제공한다.
ACE-Step과 YuE2가 각각 빠른 로컬 생성과 구조화된 음악 편집에 강점을 둔다면, HeartMuLa는 다른 생성 방식과 음악 모델 생태계를 비교할 만한 후보다.
다만 모델의 성능을 평가할 때는 데모에서 잘 나온 예제만 보면 안 된다.
같은 장르와 같은 가사로 생성한 결과를 여러 번 비교해야 한다.
특히 다음 요소를 들어보는 것이 좋다.
| 평가 항목 | 확인할 내용 |
|---|---|
| 보컬 자연스러움 | 사람 목소리처럼 들리는가 |
| 한국어 가사 | 발음과 음절 전달이 정확한가 |
| 곡 구조 | 벌스와 후렴이 자연스럽게 이어지는가 |
| 편곡 | 악기 구성과 리듬이 안정적인가 |
| 반복 생성 | 같은 조건에서 품질이 얼마나 일관적인가 |
| 편집 | 특정 구간을 다시 수정하기 쉬운가 |
또 커버 생성 기능은 저작권과 직접 연결된다.
이미 발표된 곡을 모델에 입력해 유사한 멜로디나 보컬을 생성하는 경우에는 원곡과 음원, 실연자의 권리를 확인해야 한다.
특정 가수의 목소리를 허락 없이 복제하는 작업도 피해야 한다.
따라서 음악 모델을 상업적으로 사용하려면 모델 라이선스와 입력 음악·출력 결과물의 권리를 각각 확인해야 한다.
15. 음악 제작에서 더 중요한 것은 '다시 수정할 수 있는가'다
클라우드 음악 서비스를 사용해보면 한 번에 상당히 완성도 높은 결과가 나올 때가 있다.
하지만 실무 제작에서는 처음 생성한 결과를 그대로 사용하는 일이 생각보다 드물 수 있다.
도입부가 너무 길거나 후렴이 약할 수도 있다.
보컬의 특정 단어가 부자연스럽게 발음될 수도 있다.
영상 길이에 맞춰 음악을 줄여야 하는 상황도 생긴다.
그래서 음악 생성 모델은 결과물의 첫인상뿐 아니라 편집 능력을 함께 평가해야 한다.
음악 생성
    ↓
청취 및 검수
    ↓
문제 구간 선택
    ↓
편집 또는 재생성
    ↓
최종 믹싱
    ↓
영상·게임에 적용
이때 보컬과 악기를 분리할 수 있다면 더 다양한 편집을 시도할 수 있다.
하지만 보컬·반주 분리 기능이 있다고 해서 항상 완벽하게 분리되는 것은 아니다.
악기 간 간섭과 음질 손실이 발생할 수 있다.
또 음악의 특정 구간을 다시 생성하면 앞뒤의 음색이나 리듬이 자연스럽게 연결되지 않을 수도 있다.
그래서 실제 제작에서는 최종적으로 사람이 듣고 수정하는 과정이 필요하다.
로컬 음악 모델의 가치는 한 곡을 자동 생성하는 능력뿐 아니라 계속 고치고 발전시킬 수 있는 제작 환경을 만들 수 있다는 데 있다.
# Part 4. 보이스 — 내레이션과 캐릭터 목소리도 로컬에서 만든다
16. TTS는 이제 단순히 문장을 읽는 기술이 아니다
음성 합성은 오래전부터 존재했다.
하지만 예전 TTS는 텍스트를 정확하게 읽는 것이 주된 목표였다.
최근 음성 모델은 그보다 더 다양한 요소를 다룬다.
예를 들어 다음과 같은 문장이 있다고 생각해보자.
정말? 오늘 드디어 끝났다고?
같은 문장이라도 말하는 방식에 따라 전혀 다른 느낌이 난다.
놀란 목소리일 수도 있고, 기쁜 목소리일 수도 있다.
화가 나거나 믿기 어렵다는 감정을 담을 수도 있다.
최근 음성 모델은 이런 발화 스타일과 화자 특징을 더 자연스럽게 표현하려는 방향으로 발전하고 있다.
여기서 기술을 세 가지로 구분할 필요가 있다.
| 기술 | 설명 |
|---|---|
| TTS | 텍스트에서 음성 생성 |
| Voice Cloning | 참조 음성의 화자 특징 반영 |
| Voice Conversion | 기존 녹음의 음색 변환 |
이 세 가지는 비슷해 보이지만 용도가 다르다.
예를 들어 유튜브 영상에 내레이션을 추가한다면 TTS를 사용한다.
게임 캐릭터마다 다른 목소리를 만들려면 화자 조건이 있는 TTS를 사용할 수 있다.
기존에 녹음한 연기를 다른 음색으로 바꾸려면 Voice Conversion을 검토할 수 있다.
그리고 음성 합성에서는 이미지나 영상만큼이나 한국어 품질이 중요하다.
영어에서 자연스럽게 들리는 모델이라도 한국어의 받침과 숫자, 외래어, 문장 억양에서는 문제가 발생할 수 있다.
17. Chatterbox Multilingual V3 — 한국어 음성 제작을 위한 후보
Resemble AI의 Chatterbox는 로컬 음성 합성에 활용할 수 있는 공개 프로젝트다.
특히 Multilingual 계열은 여러 언어의 음성 생성을 지원한다.
공식 구현의 지원 언어 목록에는 한국어(ko)가 포함돼 있다.
Multilingual V3 체크포인트도 제공한다.
이 점은 한국어 콘텐츠 제작에 관심이 있는 개발자에게 중요한 부분이다.
예를 들어 다음과 같은 작업을 생각할 수 있다.
- 유튜브 내레이션
- 웹툰 캐릭터 더빙
- 게임 대사
- 교육용 음성 콘텐츠
- 앱의 음성 안내
하지만 언어 지원 목록에 한국어가 있다는 사실만으로 한국어 발음이 항상 자연스럽다는 뜻은 아니다.
실제 도입 전에는 다음 항목을 확인해야 한다.
숫자 읽기: 2026년, 15,000원, 3.5% 같은 숫자와 단위를 자연스럽게 읽는가?
외래어: AI, Swift, iPhone 같은 기술 용어를 적절하게 발음하는가?
문장 억양: 질문과 감탄, 설명 문장의 차이를 표현하는가?
긴 문장: 여러 문장을 연속 생성했을 때 목소리와 속도가 유지되는가?
화자 일관성: 같은 인물의 여러 대사를 생성했을 때 음색이 지나치게 바뀌지 않는가?
캐릭터 더빙 워크플로
캐릭터 대본
      ↓
화자별 음성 설정
      ↓
한국어 TTS
      ↓
발음·감정 검수
      ↓
문제 문장 재생성
      ↓
영상 타임라인에 배치
영상 제작에서는 완전히 자연스러운 음성 한 번을 생성하는 것보다 대사를 수정했을 때 같은 목소리로 다시 만들 수 있는지가 중요할 수 있다.
Chatterbox는 이런 로컬 음성 제작 파이프라인을 구성할 때 검토할 만하다.
다만 실제 프로젝트에서는 체크포인트별 라이선스와 화자 참조 음성의 사용 권한을 확인해야 한다.
18. CosyVoice 3 — 음성 합성의 자연스러움과 스트리밍
FunAudioLLM의 CosyVoice 계열도 공개 음성 합성 모델 가운데 주목할 만하다.
CosyVoice는 자연스러운 발화와 음성 생성, 스트리밍 처리 등을 주요 기능으로 발전해왔다.
최근 CosyVoice 3 계열도 공개됐다.
다만 음성 모델은 버전별로 지원 언어가 달라질 수 있다는 점을 기억해야 한다.
공식적으로 여러 언어를 지원한다고 해서 한국어가 포함됐다고 자동으로 판단해서는 안 된다.
특히 중국어와 영어를 중심으로 개발된 체크포인트를 한국어 TTS 용도로 사용하려면 실제 지원 목록과 발음 품질을 별도로 확인해야 한다.
한국어 콘텐츠를 만든다면 다음처럼 비교하는 편이 실용적이다.
| 항목 | Chatterbox Multilingual V3 | CosyVoice 3 |
|---|---|---|
| 한국어 지원 | 공식 언어 목록에 포함 | 체크포인트별 확인 필요 |
| 음성 합성 | 지원 | 지원 |
| 자연스러운 발화 | 실제 청취 비교 필요 | 실제 청취 비교 필요 |
| 화자 특징 반영 | 지원 구성 확인 | 지원 구성 확인 |
| 실시간 처리 | 실행 환경별 측정 | 스트리밍 기능 검토 |
| 추천 용도 | 한국어 내레이션·더빙 우선 검토 | 지원 언어의 음성 합성·스트리밍 |
여기서 중요한 것은 모델의 공식 데모가 아니라 실제 사용할 문장으로 비교하는 것이다.
한국어 내레이션이라면 뉴스 문장, 자연스러운 대화, 감정이 있는 대사, 긴 설명문을 각각 테스트하는 것이 좋다.
또 음성 복제 기능을 사용할 경우에는 본인 또는 허락받은 화자의 음성만 사용해야 한다.
목소리는 이미지보다 개인의 정체성과 직접 연결될 수 있기 때문에 사용 동의와 공개 여부를 더 신중하게 다뤄야 한다.
Part 5. 코딩과 업무용 로컬 모델도 여전히 유용하다
19. 코딩에는 Qwen3-Coder-Next 같은 공개 모델이 있다
이번 글의 중심은 엔터테인먼트 제작이지만, 로컬 코딩 모델도 짧게 살펴볼 필요가 있다.
로컬 AI 제작 환경에서는 이미지와 영상 모델만 사용하는 것이 아니기 때문이다.
예를 들어 ComfyUI 워크플로를 자동화하거나, 생성된 파일을 정리하거나, 음악·영상 제작 스크립트를 작성하는 데 코딩 모델을 활용할 수 있다.
Qwen3-Coder 계열은 이런 용도로 살펴볼 만하다.
특히 Qwen3-Coder-Next는 로컬 개발 및 코딩 에이전트를 위한 공개 가중치 모델로 소개됐다.
| 모델 | 활용 방향 |
|---|---|
| Qwen3-Coder-Next | 로컬 코딩 에이전트와 도구 실행 |
| Qwen3-Coder 30B 계열 | 코드 작성·수정과 분석 |
| gpt-oss 20B | 로컬 추론과 도구 활용 |
| Devstral Small 계열 | 개발 에이전트 구성 검토 |
다만 이 모델들을 모두 같은 규모나 성능으로 비교해서는 안 된다.
특히 MoE 모델은 전체 파라미터와 실제 활성 파라미터가 다를 수 있다.
활성 파라미터가 작다고 해서 모델 전체를 작은 메모리에서 실행할 수 있다는 뜻도 아니다.
코딩 모델은 다음 작업에 활용할 수 있다.
생성형 AI 워크플로
        ↓
Python 스크립트 작성
        ↓
파일 자동 정리
        ↓
생성 결과 검사
        ↓
FFmpeg 영상 처리
        ↓
최종 결과물 저장
Swift 개발자라면 로컬 모델을 보조 도구로 연결해 macOS용 콘텐츠 제작 앱을 만들 수도 있다.
예를 들어 SwiftUI로 화면을 만들고 내부에서는 로컬 이미지·음성 생성 서버를 호출하는 구조다.
다만 Xcode 빌드와 테스트는 실제 개발 머신의 도구가 담당해야 한다.
AI 모델 자체가 Xcode를 실행하는 것은 아니다.
20. 문서 작업과 한국어 업무 자동화에도 로컬 모델을 사용할 수 있다
로컬 AI는 콘텐츠 제작 외에도 업무용으로 활용할 수 있다.
예를 들어 다음과 같은 작업이다.
- 회의록 요약
- PDF 문서 분석
- 한국어 보고서 초안
- 표 데이터 정리
- 코드와 기술 문서 비교
- 이미지가 포함된 문서 분석
이런 경우에는 Qwen이나 Gemma 계열의 언어·멀티모달 모델을 검토할 수 있다.
다만 PDF나 엑셀 파일을 모델에 전달하기 위해서는 별도의 문서 처리 과정이 필요할 수 있다.
텍스트 추출, 표 구조 분석, 파일 저장 같은 기능은 모델 자체가 아니라 주변 애플리케이션이 담당한다.
특히 수치와 계약 조건, 법적 문서처럼 정확성이 중요한 자료는 AI의 답변을 반드시 원문과 비교해야 한다.
로컬에서 실행한다고 환각이나 계산 오류가 사라지는 것은 아니다.
보안 관점에서는 외부 API에 문서를 전송하지 않는 구조를 만들 수 있다는 장점이 있다.
하지만 로컬 서버의 접근 권한과 로그, 파일 저장 위치, 네트워크 설정을 함께 관리해야 한다.
Part 6. 내 컴퓨터에서는 무엇까지 실행할 수 있을까?
21. VRAM 8GB, 16GB, 24GB에서 가능한 작업은 다르다
로컬 AI에서 가장 현실적인 제약은 하드웨어다.
특히 NVIDIA GPU를 사용하는 Windows·Linux 환경에서는 VRAM이 중요한 기준이 된다.
다만 필요한 메모리는 모델 크기만으로 결정되지 않는다.
정밀도와 양자화, CPU 오프로딩, 이미지 해상도, 영상 길이, 생성 프레임 수 등이 모두 영향을 준다.
아래 표는 모델을 선택하기 위한 출발점이다.
| VRAM | 우선 검토할 작업 | 주의할 점 |
|---|---|---|
| 8GB | FLUX.2 Klein 4B, 경량 음성, ACE-Step | 오프로딩·양자화 필요할 수 있음 |
| 12GB | 이미지 생성·편집, 음악 생성 | 일부 대형 구성 제한 |
| 16GB | Z-Image-Turbo, 이미지 편집, 음악 고급 구성 | 영상은 설정에 따라 부담 |
| 24GB | 더 큰 이미지 모델, 일부 영상 생성 | 고해상도·장시간 영상은 여전히 무거움 |
| 32~48GB | 대형 이미지·영상 워크플로 | 모델별 요구사항 확인 필요 |
| 다중 GPU | 대규모 영상 생성·서비스 운영 | 구성과 유지보수 복잡 |
8GB GPU
FLUX.2 Klein 4B처럼 상대적으로 작은 이미지 모델을 우선 검토할 수 있다.
ACE-Step 1.5도 낮은 VRAM을 위한 구성을 제공한다.
다만 속도와 최대 생성 길이, 모델 변형에는 제약이 있을 수 있다.
16GB GPU
이미지 생성과 음악 제작의 선택지가 넓어진다.
Z-Image-Turbo도 공식적으로 16GB급 GPU 실행을 안내한다.
하지만 영상 생성은 모델과 설정에 따라 메모리 부족이 발생할 수 있다.
24GB GPU
개인용 로컬 AI 제작 환경에서 활용 범위가 상당히 넓어진다.
큰 이미지 모델과 여러 음악 구성을 시도할 수 있고, 일부 영상 워크플로에도 접근할 수 있다.
그러나 고품질 4K 영상이나 긴 동영상의 생성이 모두 원활하다는 뜻은 아니다.
Apple Silicon Mac은 어떨까?
Apple Silicon은 NVIDIA GPU와 달리 통합 메모리 구조를 사용한다.
따라서 단순히 24GB 통합 메모리와 24GB VRAM을 같은 조건으로 비교하면 안 된다.
Metal이나 MLX, PyTorch MPS, 모델별 macOS 실행 지원 등을 확인해야 한다.
Qwen-Image 2.1 Turbo는 공식적으로 Apple Silicon용 로컬 실행 경로를 안내한다.
LTX Desktop도 지원되는 Apple Silicon Mac에서 로컬 영상 생성을 제공한다.
반면 모든 CUDA 중심 모델이 동일한 기능과 속도로 Mac에서 실행되는 것은 아니다.
Mac이라면 총 메모리 용량뿐 아니라 해당 모델이 macOS에서 실제 지원되는지를 먼저 확인하는 것이 중요하다.
22. ComfyUI, Ollama, LM Studio — 목적에 따라 실행 도구도 달라진다
로컬 모델을 실행한다고 해서 모든 모델에 같은 프로그램을 사용할 수 있는 것은 아니다.
이미지·영상 모델과 언어모델은 실행 구조가 다르다.
| 도구 | 주요 역할 |
|---|---|
| ComfyUI | 이미지·영상 생성 워크플로 |
| Diffusers | Python 기반 이미지·영상 추론 |
| LTX Desktop | LTX 모델 영상 제작 |
| Ollama | 로컬 언어모델 실행 및 API |
| LM Studio | 로컬 LLM GUI·API |
| ACE-Step 전용 UI·CLI | 음악 생성·편집 |
| Python TTS 서버 | 음성 합성·앱 연동 |
예를 들어 ComfyUI에서는 이미지 생성 모델과 영상 생성 모델을 연결해 복잡한 워크플로를 만들 수 있다.
Ollama나 LM Studio는 주로 언어모델을 실행하고 외부 프로그램이 API로 호출하도록 하는 데 적합하다.
ACE-Step이나 Chatterbox 같은 모델은 공식 프로젝트의 실행 방법을 먼저 확인하는 편이 좋다.
실제로 여러 모델을 조합한다면 다음과 같은 구조를 만들 수 있다.
콘텐츠 제작 앱
       ↓
작업 관리 프로그램
       ├─ 이미지 생성 서버
       ├─ 영상 생성 서버
       ├─ 음악 생성 서버
       ├─ 음성 생성 서버
       └─ 로컬 LLM 서버
       ↓
파일 저장 및 편집
여기서 꼭 모든 모델을 동시에 실행할 필요는 없다.
메모리가 부족하다면 작업 종류에 따라 필요한 모델만 실행하고 종료하는 방식이 현실적이다.
23. 실제 제작 워크플로 — 30초짜리 캐릭터 영상을 만든다면?
앞에서 살펴본 모델들을 하나의 제작 과정으로 연결해보자.
예를 들어 귀여운 고양이 캐릭터가 카페에서 하루를 보내는 30초짜리 짧은 영상을 만든다고 생각해보자.
1단계 — 캐릭터 디자인
Qwen-Image 2.1 또는 FLUX.2 Klein을 사용해 캐릭터 이미지를 만든다.
정면과 측면, 대표 표정을 구성한다.
2단계 — 스토리보드
장면을 여러 개로 나눈다.
장면 1
고양이가 카페에 들어온다.

장면 2
커피를 주문한다.

장면 3
창가에서 커피를 마신다.

장면 4
석양을 바라본다.
3단계 — 영상 생성
Wan 또는 LTX 모델로 각 장면을 짧은 클립으로 만든다.
영상이 실제로 자연스럽게 연결되는지 확인한다.
4단계 — 배경음악
ACE-Step 1.5로 따뜻한 분위기의 음악을 생성한다.
영상 길이에 맞춰 편집한다.
5단계 — 캐릭터 목소리
Chatterbox로 대사를 생성한다.
한국어 발음과 억양을 확인하고 필요한 문장을 다시 만든다.
6단계 — 최종 편집
영상과 음성을 결합한다.
자막을 넣고 장면 전환을 조정한다.
Qwen-Image / FLUX
        ↓
캐릭터·배경 이미지
        ↓
Wan / LTX
        ↓
영상 클립
        ├───────────┐
        ↓           ↓
    ACE-Step    Chatterbox
        ↓           ↓
       BGM         음성
        └─────┬─────┘
              ↓
         영상 편집
              ↓
          최종 결과물
여기서 영상 편집에는 FFmpeg를 활용할 수도 있고, DaVinci Resolve 같은 편집 프로그램을 사용할 수도 있다.
완전히 자동화하는 것도 기술적으로 일부 가능하지만, 캐릭터 일관성과 음질, 저작권, 장면 연결을 검수하는 과정은 필요하다.
로컬 AI는 콘텐츠 제작자를 완전히 대신하는 도구라기보다 반복적인 생성과 수정 작업을 맡는 제작 도구로 이해하는 것이 현실적이다.
24. 로컬 모델이라고 마음대로 상업적으로 사용해도 될까?
모델을 자신의 컴퓨터에서 실행할 수 있다는 것과 결과물을 상업적으로 사용할 수 있다는 것은 다른 문제다.
특히 이미지와 음악은 라이선스 확인이 중요하다.
대표적인 모델의 공개 라이선스를 간단히 비교하면 다음과 같다.
| 모델 | 라이선스·확인 사항 |
|---|---|
| Qwen-Image 2.1 | Qwen Research License |
| FLUX.2 Klein 4B | Apache 2.0 |
| FLUX.2 Klein 9B | 비상업적 라이선스 |
| Z-Image-Turbo | Apache 2.0 |
| ACE-Step 1.5 | MIT |
| YuE2 | CC BY-NC 4.0 조건 |
| LTX-2.5 | 모델·체크포인트별 라이선스 확인 |
| HunyuanVideo | 해당 모델의 커뮤니티 라이선스 확인 |
이 표는 라이선스의 이름만 요약한 것이다.
실제 상업적 이용 가능성은 모델 가중치와 코드, 추가 이용 조건을 정확하게 확인해야 한다.
또 모델을 사용할 권리가 있다고 해서 타인의 콘텐츠를 자유롭게 이용할 권리까지 생기는 것은 아니다.
예를 들어 다음은 별도의 검토가 필요하다.
- 타인의 사진을 허락 없이 학습·편집에 사용하는 경우
- 기존 노래와 유사한 멜로디를 생성하는 경우
- 유명 가수의 목소리를 복제하는 경우
- 특정 배우나 인물의 모습을 광고에 사용하는 경우
- 상업용 게임에 생성 콘텐츠를 넣는 경우
모델 라이선스, 입력 자료의 권리, 결과물의 권리는 서로 다른 문제다.
따라서 실제 제품이나 유튜브 채널, 게임 제작에 사용할 계획이라면 제작 기록과 사용한 모델 버전, 라이선스 정보를 함께 보관하는 것이 좋다.
25. 그래서 어떤 모델부터 선택하면 좋을까?
분야별로 모든 모델을 설치할 필요는 없다.
처음에는 가장 많이 사용할 작업에 맞춰 하나씩 선택하는 편이 좋다.
| 하고 싶은 작업 | 우선 추천 후보 | 선택 이유 |
|---|---|---|
| 가벼운 이미지 생성 | FLUX.2 Klein 4B | 속도·낮은 VRAM |
| 포스터·이미지 편집 | Qwen-Image 2.1 | 참조 이미지·부분 편집·투명 배경 |
| 사실적인 이미지 생성 | Z-Image-Turbo | 빠른 생성과 사실적인 표현 |
| 짧은 영상 만들기 | Wan 2.2 | 로컬 영상 워크플로 |
| 영상과 오디오 함께 제작 | LTX-2.5 Fast | 동기화 생성·멀티샷 |
| 로컬에서 노래 만들기 | ACE-Step 1.5 | 접근성과 편집 기능 |
| 멜로디·코드까지 수정 | YuE2 | 음악 구조 기반 편집 |
| 한국어 음성 제작 | Chatterbox Multilingual V3 | 공식 한국어 지원 |
| 코딩 자동화 | Qwen3-Coder-Next | 로컬 코딩 에이전트 |
| 문서·업무 | Qwen·Gemma 계열 | 로컬 언어·문서 분석 |
이 표는 절대적인 성능 순위가 아니다.
각 모델의 공식 기능과 공개된 실행 조건을 바탕으로 정리한 용도별 선택 가이드다.
이미지 품질이나 음악의 자연스러움처럼 주관적인 요소는 실제 결과물을 비교해야 한다.
특히 한국어가 중요한 작업에서는 공식 영어 데모보다 한국어 프롬프트와 한국어 가사를 직접 테스트하는 것이 좋다.
26. 마치며 — 로컬 AI는 이제 나만의 콘텐츠 제작 환경이 된다
몇 년 전 로컬 AI를 사용한다는 것은 주로 작은 언어모델을 실행하거나 이미지를 한 장 생성하는 일이었다.
하지만 최근에는 상황이 많이 달라졌다.
이미지를 만들고, 캐릭터를 편집하고, 사진에 움직임을 추가하고, 노래와 목소리까지 제작할 수 있다.
특히 음악 모델의 발전이 흥미롭다.
ACE-Step 1.5처럼 비교적 낮은 VRAM에서도 실행 가능한 구성이 등장했고, YuE2처럼 멜로디와 코드 계획을 편집하는 모델도 공개됐다.
영상에서는 LTX-2.5처럼 영상과 오디오를 하나의 생성 과정으로 결합하고, 여러 장면의 일관성을 유지하는 방향으로 발전하고 있다.
이미지 분야에서는 Qwen-Image 2.1이 생성과 편집, 투명 배경과 다중 참조 이미지를 함께 지원한다.
FLUX.2 Klein과 Z-Image-Turbo는 개인용 GPU에서 실행 효율을 높이는 방향을 보여준다.
물론 여전히 한계는 있다.
영상은 하드웨어 요구량이 크다.
한국어 음성과 노래는 발음과 자연스러움을 확인해야 한다.
모델을 다운로드할 수 있다고 해서 모든 상업적 이용이 허용되는 것도 아니다.
또 모든 모델을 하나의 프로그램에서 완벽하게 실행할 수 있는 것은 아니다.
하지만 선택지는 분명히 넓어졌다.
예전에는 이미지와 음악, 영상 제작을 위해 각각의 외부 AI 서비스에 접속해야 했다.
이제는 공개 모델을 다운로드하고 자신의 환경에 맞는 실행 도구를 연결해 하나의 제작 파이프라인을 구성할 수 있다.
그 과정에서 모델을 교체하거나, 생성 단계를 수정하거나, 결과물을 반복해서 개선하는 것도 가능하다.
로컬 AI의 경쟁력은 클라우드 서비스를 무조건 대체하는 데 있지 않다.
자신에게 필요한 콘텐츠 제작 과정을 직접 설계하고 통제할 수 있다는 점에 있다.
그리고 앞으로는 어떤 AI 모델이 가장 뛰어난가보다 내 컴퓨터에서 어떤 모델들을 연결해 실제 결과물을 만들 수 있는가가 더 중요한 질문이 될 수 있다.
이제 AI 제작 스튜디오는 반드시 거대한 서버에 있어야 하는 것이 아니다. 적절한 하드웨어와 공개 모델, 실행 환경이 있다면 내 컴퓨터에서도 이미지·영상·음악·목소리를 연결한 콘텐츠 제작을 시작할 수 있다.
참고자료
이미지 생성 모델
Qwen-Image 2.1 공식 GitHub
2026년 9월 공개. 7B 이미지 생성 구조와 이미지 편집, RGBA 투명 배경, 다중 참조, Turbo 변형, Apple Silicon 지원 경로를 안내한다.
Qwen-Image 2.1 모델 카드
공식 모델 설명과 Qwen Research License, 체크포인트 관련 정보를 확인할 수 있다.
FLUX.2 공식 GitHub
FLUX.2 Klein 4B·9B 모델의 차이, 추론 요구사항과 라이선스를 설명한다.
Z-Image 공식 GitHub
Z-Image-Turbo의 이미지 생성 특성과 16GB급 GPU 지원, 모델 변형을 확인할 수 있다.
영상 생성 모델
Wan 2.2 공식 GitHub
Wan 2.2 영상 생성 모델과 실행 환경, 모델별 구성 정보를 제공한다.
LTX-Video 공식 GitHub
LTX 영상 모델과 영상·오디오 생성, 이미지 기반 영상 제작 관련 자료를 제공한다.
LTX-2.5 공개 모델 문서
LTX-2.5의 공개 가중치, 멀티샷, 오디오·영상 생성과 로컬 실행 관련 설명.
LTX Desktop 공식 GitHub
LTX-2.5 Fast의 로컬 실행과 LTX-2.5 Pro API 사용 범위를 구분한다.
HunyuanVideo 공식 GitHub
Tencent의 영상 생성 모델과 실행 방법, 라이선스 관련 자료.
음악 생성 모델
ACE-Step 1.5 공식 GitHub
로컬 음악 생성과 편집, 모델 구성 및 MIT 라이선스.
ACE-Step 1.5 GPU 호환성 가이드
4GB 이하부터 24GB 이상까지 VRAM 등급별 모델 구성과 오프로딩 조건을 설명한다.
YuE2 공식 GitHub
음악 생성, Symbolic Plan, 멜로디와 코드 편집, 커버와 에이전트 기반 작업.
YuE2 공식 릴리스
2026년 9월 YuE2와 음악 스킬 업데이트, 비상업적 라이선스 정보를 확인할 수 있다.
HeartMuLa 공식 프로젝트
가사·스타일 기반 음악 생성과 관련 음악 모델 도구.
음성 생성 모델
Chatterbox 공식 GitHub
다국어 음성 생성 및 음성 복제, 한국어 지원과 Multilingual 체크포인트.
CosyVoice 공식 GitHub
CosyVoice 계열 음성 합성과 지원 언어, 스트리밍 추론.
코딩·업무·실행 도구
Qwen3-Coder 공식 GitHub
Qwen3-Coder-Next를 포함한 공개 코딩 모델과 에이전트 개발 관련 내용.
ComfyUI 공식 GitHub
이미지·영상 생성용 노드 기반 워크플로 실행 환경.
Ollama
로컬 언어모델 실행 및 API 제공.
LM Studio
데스크톱 로컬 언어모델 실행과 관리, API 기능.