※ 이 글은 Lilian Weng의 「LLM Powered Autonomous Agents」를 읽고, 다시 정리한 글입니다.
원문: https://lilianweng.github.io/posts/2023-06-23-agent/
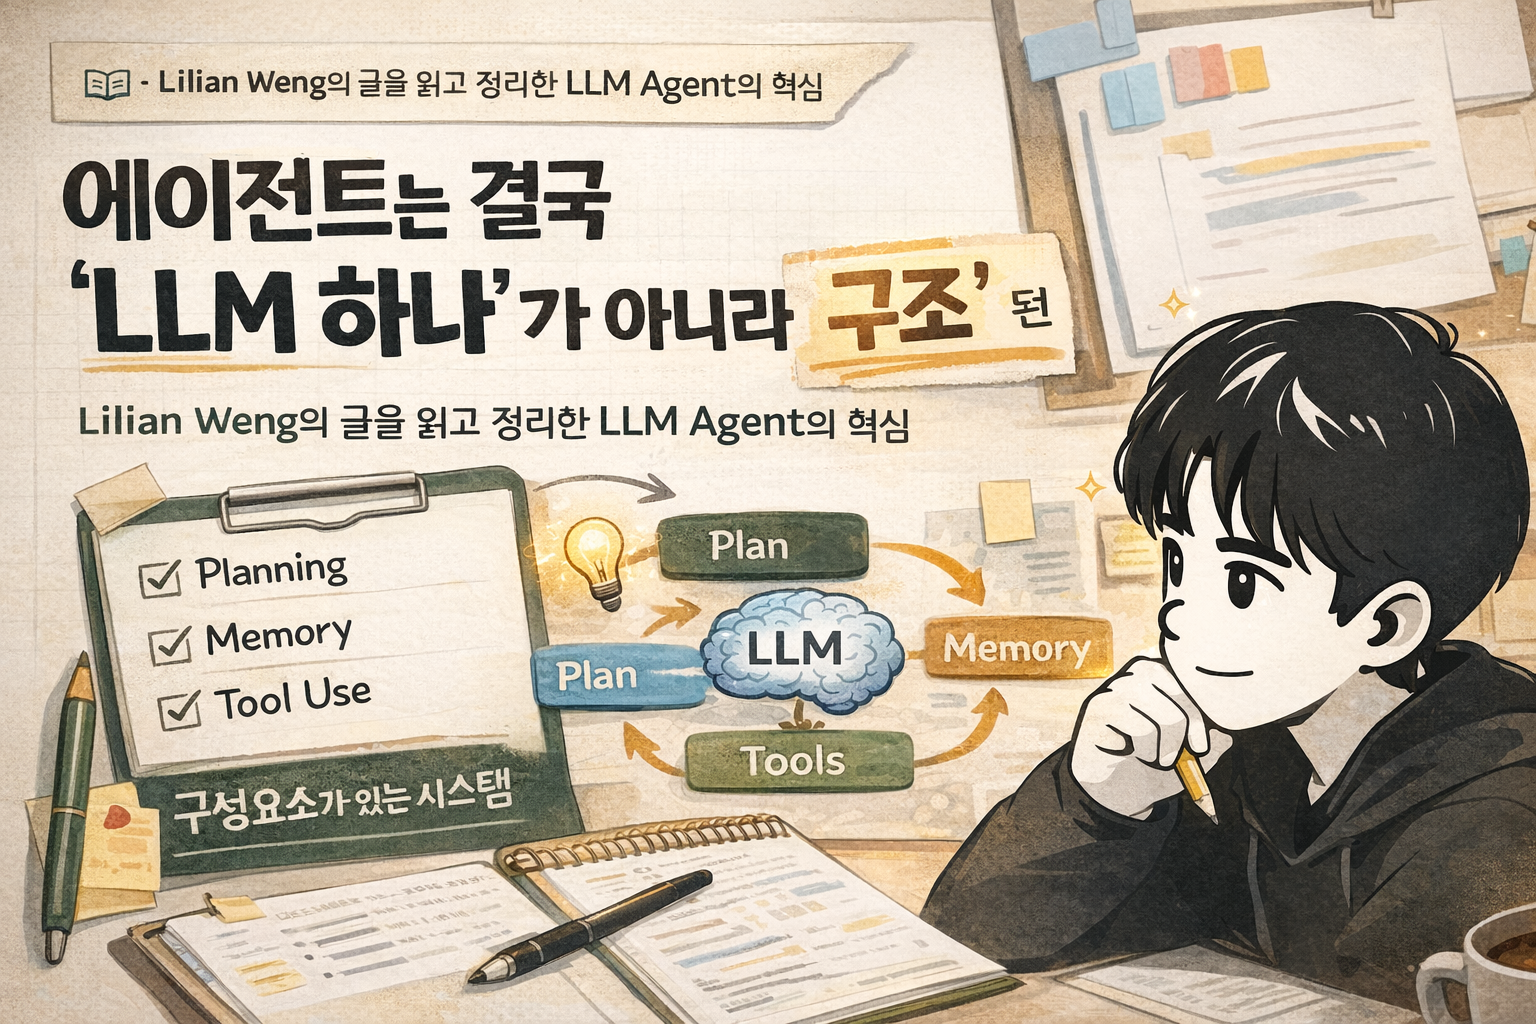
에이전트는 결국 ‘LLM 하나’가 아니라 ‘구조’였다
Lilian Weng의 글을 읽고 정리한 LLM Agent의 핵심
요즘 AI 이야기를 하다 보면
정말 자주 나오는 단어가 있다.
바로 Agent다.
처음에는 나도 이 단어를 조금 막연하게 받아들였던 것 같다.
그냥 LLM이 조금 더 똑똑해져서
스스로 판단하고, 도구도 쓰고, 알아서 일하는 느낌 정도로 생각했다.
그런데 Lilian Weng의 「LLM Powered Autonomous Agents」를 읽고 나서는
생각이 꽤 많이 정리됐다.
에이전트는 그냥
“LLM이 혼자 다 하는 무언가”가 아니었다.
오히려 반대에 가까웠다.
에이전트는 LLM 하나로 완성되는 게 아니라,
LLM 주위에 계획, 기억, 도구를 붙여서
문제를 풀 수 있는 구조를 만드는 일에 더 가까웠다.
이 글이 좋았던 이유도 바로 그 점이다.
에이전트를 막연한 미래 기술처럼 포장하지 않고,
무엇이 필요하고, 왜 필요한지를 구조적으로 보여준다.
1. 에이전트의 중심은 LLM이지만, LLM만으로는 부족하다
Lilian Weng는 LLM 기반 자율 에이전트 시스템을 설명하면서
핵심 구성요소를 크게 세 가지로 정리한다.
- Planning
- Memory
- Tool Use
이 구조를 보고 나는 되게 명확해졌다.
결국 에이전트라는 건 “똑똑한 모델 하나”가 아니라,
생각하고, 기억하고, 행동하는 시스템이어야 한다는 거다.
LLM은 여기서 뇌(Brain) 역할을 한다.
하지만 사람도 뇌만 있다고 일을 다 잘하는 건 아니다.
할 일을 나눌 줄 알아야 하고,
이전 경험을 기억해야 하고,
필요하면 계산기나 검색 같은 외부 도구도 써야 한다.
에이전트도 똑같다.
2. 첫 번째 축은 Planning이다
잘게 나누고, 스스로 점검하고, 다시 고치는 능력
복잡한 일은 한 번에 못 푼다.
이건 사람도 마찬가지고, 에이전트도 마찬가지다.
그래서 에이전트에게 제일 먼저 필요한 건
계획을 세우는 능력이다.
2-1. 큰 문제를 작은 문제로 쪼개는 것부터 시작된다
Lilian Weng가 정리한 첫 번째 핵심은 Task Decomposition이다.
쉽게 말하면, 큰 일을 작은 일로 나누는 능력이다.
여기서 바로 떠오르는 게
Chain of Thought(CoT) 다.
모델에게 “step by step으로 생각해”라고 하면
복잡한 문제를 더 잘 푸는 이유도 결국 여기에 있다.
한 번에 정답을 던지는 대신,
중간 단계를 만들면서 문제를 쪼개기 때문이다.
그다음으로 나오는 게 Tree of Thoughts(ToT) 인데,
이건 한 방향만 파는 게 아니라
각 단계에서 여러 가능성을 동시에 펼쳐놓고 탐색하는 방식이다.
즉,
- CoT는 한 줄로 생각을 이어가는 느낌이고
- ToT는 가지를 치면서 더 넓게 탐색하는 느낌이다
나는 이 부분이 되게 좋았다.
사실 사람도 어려운 문제를 풀 때
처음 떠오른 답 하나만 밀어붙이지 않는다.
이 방향도 보고, 저 방향도 보고,
틀리면 다시 돌아온다.
에이전트를 잘 만든다는 건
결국 이런 탐색 구조를 어떻게 설계하느냐와도 연결된다.
2-2. 생각만 하는 게 아니라, 행동도 같이 해야 한다
여기서 중요한 개념이 ReAct다.
ReAct는 말 그대로
Reasoning + Acting 이다.
즉,
생각만 하는 것도 아니고,
행동만 하는 것도 아니다.
보통 이런 식으로 흘러간다.
- Thought
- Action
- Observation
그리고 이 흐름을 반복한다.
이 구조가 좋은 이유는 명확하다.
에이전트가 그냥 머릿속으로 상상만 하는 게 아니라,
실제로 검색을 하거나, 환경과 상호작용하고,
그 결과를 보고 다시 생각할 수 있기 때문이다.
이건 그냥 “답변 잘하는 모델”과
“일을 처리하는 에이전트”를 가르는 꽤 큰 차이처럼 느껴진다.
2-3. 한 번 틀렸다고 끝이 아니라, 스스로 돌아봐야 한다
에이전트가 진짜 일을 하려면
결국 실수를 하게 된다.
문제는 실수를 하느냐가 아니라,
그 실수에서 무엇을 배우느냐다.
이 지점에서 나오는 게 Reflexion이다.
Reflexion은 에이전트가
이전 행동을 돌아보고,
왜 실패했는지 반성하고,
그걸 다음 시도에 반영하게 만든다.
나는 이 부분이 꽤 인상 깊었다.
왜냐하면 에이전트를 자율적으로 만든다는 건
단순히 “혼자 실행하게 한다”는 뜻이 아니라,
혼자 수정하게 한다는 뜻까지 포함해야 하기 때문이다.
그냥 시키는 대로 한 번 달리는 모델은
생각보다 금방 한계가 온다.
반면, 실패를 쌓고 거기서 방향을 바꾸는 구조는
훨씬 사람처럼 느껴진다.
Lilian Weng의 글에서도
이런 self-reflection이 real-world task에서 중요하다고 본다.
실제 세계는 trial and error가 기본이기 때문이다.
이건 정말 맞는 말 같다.
현실의 문제는 대부분 한 번에 안 풀린다.
3. 두 번째 축은 Memory다
결국 기억이 없으면 에이전트도 금방 막힌다
에이전트를 생각할 때
많은 사람들이 planning이나 tool use는 직관적으로 이해한다.
그런데 실제로는 memory도 정말 중요하다.
왜냐하면 에이전트가 일을 하다 보면
앞에서 했던 행동, 얻은 정보, 실패한 이유, 중요한 문맥을
계속 가지고 가야 하기 때문이다.
3-1. 단기 기억과 장기 기억은 다르다
이 글에서는 메모리를 크게 두 가지로 나눈다.
- Short-term memory
- Long-term memory
여기서 단기 기억은
현재 컨텍스트 안에 들어 있는 정보에 가깝다.
즉, 지금 대화창 안에서 모델이 보고 있는 것들이다.
하지만 이건 한계가 분명하다.
컨텍스트 윈도우는 유한하고,
길어질수록 중요한 정보가 밀려난다.
그래서 필요한 게 장기 기억이다.
장기 기억은 보통
외부 벡터 스토어(Vector Store) 같은 형태로 구현된다.
필요할 때 검색해서 다시 꺼내오는 방식이다.
이걸 보고 든 생각은 단순했다.
에이전트는 결국 “전부 기억하는 존재”가 아니라,
“필요할 때 잘 찾아오는 존재”여야 한다.
사람도 모든 걸 머릿속에 들고 살지 않는다.
대신 필요할 때 꺼내쓴다.
에이전트도 비슷하다.
3-2. 그래서 벡터 검색이 중요해진다
Lilian Weng의 글에서는
장기 기억을 구현하는 기술적 기반으로
MIPS(Maximum Inner Product Search) 와
여러 ANN 알고리즘들을 설명한다.
예를 들면,
- LSH
- ANNOY
- HNSW
- FAISS
- ScaNN
이 부분은 솔직히 읽을수록
“에이전트는 결국 LLM만의 문제가 아니구나”라는 생각이 더 강해진다.
많은 사람들이 에이전트를
프롬프트나 모델 성능의 문제로만 생각하는데,
실제로는 정보를 얼마나 빠르게 찾고, 다시 붙이고, 활용하느냐가 꽤 중요하다.
즉, 에이전트 성능은
모델만으로 결정되는 게 아니라
검색 구조와 메모리 구조에도 많이 걸려 있다.
이게 되게 현실적이었다.
4. 세 번째 축은 Tool Use다
도구를 쓸 줄 알아야, 진짜 할 수 있는 일이 늘어난다
도구 사용은 인간의 가장 큰 특징 중 하나다.
사람은 손만 쓰는 존재가 아니라,
계산기, 검색엔진, 달력, 현미경, 컴퓨터 같은
외부 도구를 이용해서 자기 한계를 넘는다.
LLM도 마찬가지다.
모델 파라미터 안에 없는 정보는
밖에서 가져와야 하고,
계산이 필요하면 계산기를 써야 하고,
실행이 필요하면 코드를 돌리거나 API를 호출해야 한다.
그래서 tool use는
에이전트에서 사실상 핵심이다.
4-1. LLM은 전문가가 아니라, 라우터에 가깝기도 하다
이 지점에서 나오는 개념이 MRKL이다.
MRKL은
여러 expert module이 있고,
LLM이 그중 적절한 모듈로 요청을 라우팅하는 구조다.
이 설명이 되게 좋았다.
왜냐하면 LLM을 “모든 걸 혼자 잘하는 존재”로 보는 게 아니라,
적절한 전문가를 연결하는 중심 라우터로 보는 시선이기 때문이다.
실제로 이게 더 맞는 방향 같기도 하다.
수학은 계산기로,
날씨는 API로,
현재 뉴스는 검색으로,
코드는 실행기로 해결하는 게 낫다.
LLM이 전부 다 암기하고 해결하려고 하는 것보다,
언제 어떤 도구를 써야 하는지 판단하는 것이 더 중요해진다.
4-2. 결국 중요한 건 ‘도구가 있느냐’가 아니라 ‘도구를 제대로 쓰느냐’다
글에서 반복해서 드러나는 포인트는 이거다.
도구 자체보다, 그 도구를 언제 어떻게 써야 하는지가 더 어렵다.
도구가 있어도,
- API를 호출해야 하는지 판단해야 하고
- 어떤 API가 맞는지 골라야 하고
- 입력값을 제대로 만들어야 하고
- 결과를 다시 해석해야 한다
그래서 API-Bank 같은 벤치마크도
단순 호출 여부만 보는 게 아니라,
- API가 필요한지
- 어떤 API를 써야 하는지
- 여러 API를 엮어 계획할 수 있는지
까지 본다.
이걸 보면 Agent는 진짜로
“도구를 달아놓은 챗봇”이 아니다.
오히려
계획 + 검색 + 선택 + 실행 + 해석이 연결된 시스템에 가깝다.
5. 사례들을 보면 더 명확해진다
Agent는 이미 여러 방향으로 실험되고 있었다
이 글이 좋은 또 하나의 이유는
그냥 개념만 말하는 게 아니라
여러 사례를 같이 보여준다는 점이다.
5-1. 과학 연구용 에이전트: ChemCrow
ChemCrow는 화학 도구들을 붙여서
유기합성, 신약, 재료 설계 같은 작업을 수행하는 에이전트다.
여기서 특히 흥미로웠던 건
LLM이 자기 성능을 평가했을 때와,
실제 전문가가 평가했을 때의 차이다.
LLM은 GPT-4와 ChemCrow가 비슷하다고 봤지만,
전문가 평가는 ChemCrow 쪽이 훨씬 좋았다.
이건 꽤 중요한 포인트다.
LLM은 자기 한계를 잘 모를 수도 있다.
깊은 전문성이 필요한 영역에서는
모델이 그럴듯하게 말한다고 해서
정확성까지 보장되지는 않는다.
이 부분은 Agent를 만들 때도 진짜 중요하다고 생각했다.
결국 실무에서는
“모델이 잘한다고 말하는 것”보다
도메인 전문가가 봤을 때 맞는 결과를 내는지가 훨씬 중요하니까.
5-2. Generative Agents: 사람처럼 살아가는 시뮬레이션
이 사례는 솔직히 되게 재밌다.
25명의 가상 캐릭터가
자기 기억, 계획, 반응 구조를 가지고
샌드박스 환경에서 살아가는 실험인데,
The Sims 같은 느낌에 가깝다.
여기서 핵심은
- 기억을 저장하고
- 관련 기억을 다시 꺼내오고
- 반성(reflection)을 만들고
- 그걸 바탕으로 행동한다는 점이다
그러다 보니 정보 전파, 관계 기억, 사회적 이벤트 같은
예상하지 못한 사회적 행동이 튀어나온다.
이 사례를 보면
에이전트는 단순히 “정답 맞히는 도구”가 아니라,
행동을 만들어내는 구조라는 점이 더 분명해진다.
5-3. AutoGPT와 GPT-Engineer가 보여준 것
AutoGPT는 한때 정말 많은 관심을 받았다.
이유는 단순했다.
“LLM이 메인 컨트롤러가 되어서, 스스로 목표를 향해 움직일 수 있지 않을까?”
이 가능성을 처음 강하게 보여줬기 때문이다.
물론 Lilian Weng도 지적하듯,
실제로는 format parsing 문제나 신뢰성 문제가 꽤 컸다.
자연어 인터페이스가 생각보다 불안정하기 때문이다.
GPT-Engineer도 비슷하게 흥미롭다.
자연어로 요구사항을 받고,
불명확한 부분은 되묻고,
그다음 전체 코드베이스를 생성하는 흐름을 보여줬다.
이 두 사례를 보고 느낀 건 하나였다.
초기 데모는 종종 투박하지만,
그 안에 미래 인터페이스의 방향이 먼저 숨어 있다.
6. 결국 Agent의 가장 큰 문제도 꽤 현실적이다
글 마지막에서 Lilian Weng는
에이전트의 공통 한계를 몇 가지 정리한다.
나는 이 부분이 특히 좋았다.
왜냐하면 Agent를 너무 낭만적으로 포장하지 않기 때문이다.
6-1. 컨텍스트는 여전히 유한하다
에이전트는 긴 히스토리, 툴 사용 기록, API 응답, 반성 결과를
계속 들고 가야 한다.
그런데 컨텍스트 윈도우는 한정적이다.
즉,
에이전트가 잘 일하려면 많은 정보를 가져야 하는데,
정작 그 정보를 계속 품고 가는 건 어렵다.
벡터 스토어와 retrieval이 이를 완화해주지만,
full attention을 완전히 대체하는 건 또 아니다.
이건 지금도 꽤 큰 한계다.
6-2. 긴 계획은 아직 어렵다
짧은 문제는 그럭저럭 푼다.
그런데 여러 단계를 거쳐야 하고,
중간에 오류가 나고,
계획을 수정해야 하는 긴 작업이 들어가면
LLM은 여전히 흔들린다.
이 부분은 나도 많이 공감했다.
사람은 하다가 틀리면
“아 이건 아닌데” 하고 방향을 바꾼다.
그런데 에이전트는 생각보다 그 전환이 매끄럽지 않다.
즉, planning이 있다고 해서
곧바로 robust한 long-horizon planning이 되는 건 아니다.
6-3. 자연어 인터페이스는 강력하지만, 동시에 불안정하다
지금 에이전트 시스템은
기억, 도구, 외부 시스템과 대부분 자연어로 연결된다.
문제는 자연어가 유연한 대신,
그만큼 불안정하다는 점이다.
모델은 포맷을 깨뜨릴 수도 있고,
엉뚱하게 거부할 수도 있고,
명령을 이상하게 해석할 수도 있다.
그래서 많은 에이전트 데모 코드가
실제로는 “얼마나 잘 파싱하느냐”에 많은 시간을 쓴다.
이 대목이 되게 현실적이었다.
겉으로 보기엔 엄청 똑똑해 보여도,
막상 시스템으로 묶으면
사소한 포맷 오류 하나가 전체 흐름을 깨버릴 수 있다.
7. 이 글을 읽고 나서 내가 정리한 한 줄
이 글을 읽고 나서 내 머릿속에는
에이전트가 이렇게 정리됐다.
에이전트는 LLM이 혼자 똑똑해진 결과가 아니라,
LLM이 계획하고, 기억하고, 도구를 쓰도록 시스템을 설계한 결과물이다.
이게 되게 중요하다고 느꼈다.
왜냐하면 Agent를 이야기할 때
자꾸 “어떤 모델이 더 좋냐”로만 흘러가기 쉬운데,
실제로는 그보다
어떤 구조로 묶었는지가 훨씬 중요할 수 있기 때문이다.
- 계획을 어떻게 나눴는지
- 실패를 어떻게 반영하는지
- 장기 기억을 어떻게 저장하고 꺼내는지
- 도구를 언제 어떻게 호출하는지
- 자연어 출력을 얼마나 안정적으로 다루는지
이런 게 다 Agent의 실력을 만든다.
마무리
Lilian Weng의 이 글은
에이전트를 막연한 유행어가 아니라
구성요소가 있는 시스템으로 보게 만들어준 글이었다.
나는 이 글이 특히 좋았다.
에이전트를 과장하지도 않았고,
반대로 단순한 데모 수준으로 축소하지도 않았다.
무엇이 가능했고,
어디서 막히고 있고,
왜 planning, memory, tool use가 다 필요한지
꽤 차분하게 보여준다.
결국 에이전트는
“LLM이 만능이 되는 순간”의 이야기가 아니라,
LLM이 혼자 못하는 걸 인정하고
그 주변 구조를 잘 짜는 이야기에 더 가깝다.
그리고 오히려 그래서 더 현실적이고,
더 재밌다.
진짜 중요한 건
모델 하나를 숭배하는 게 아니라,
문제를 풀 수 있는 구조를 설계하는 것이라는 점을
이 글이 되게 잘 보여줬다고 느꼈다.
참고
- Lilian Weng, LLM Powered Autonomous Agents
- 원문: https://lilianweng.github.io/posts/2023-06-23-agent/