오늘 학습한 내용
SQL 코드카타
문제
테이블:Sales

+-------------+-------+
| 열 이름 | 유형 |
+-------------+-------+
| 판매_ID | 정수 |
| 제품_ID | 정수 |
| 년 | 정수 |
| 수량 | 정수 |
| 가격 | 정수 |
+-------------+-------+
(sale_id, year)는 이 테이블의 기본 키(고유한 값을 가진 열의 조합)입니다.
product_id는 테이블에 대한 외래 키(참조 열)입니다 Product.
각 행에는 해당 연도의 제품 판매 내역이 기록됩니다.
하나의 제품에는 같은 해에 여러 개의 판매 항목이 있을 수 있습니다.
단위당 가격을 참고하세요.

각 제품이 판매된 첫 해 에 발생한 모든 매출을 찾는 솔루션을 작성하세요 .

각 항목에 대해 표 에 나타난 product_id가장 빠른 항목을 식별하세요 .yearSales

해당 연도의 해당 제품에 대한 모든 판매 항목을 반환합니다 .

product_id , first_year , quantity, price 열 이 있는 테이블을 반환합니다 .
결과를 순서에 관계없이 반환합니다.
작성 쿼리
select product_id, year as first_year, quantity, price
from sales where (product_id, year) in (
    select product_id, min(year)
    from sales
    group by product_id
)
PYTHON 코드카타
문제
함수 solution은 정수 n을 매개변수로 입력받습니다.
n의 각 자릿수를 큰것부터 작은 순으로 정렬한 새로운 정수를 리턴해주세요.
예를들어 n이 118372면 873211을 리턴하면 됩니다.

제한 조건
n은 1이상 8000000000 이하인 자연수입니다.
문제 풀이
def solution(n):
    ls = list(str(n))
    ls.sort(reverse=True)
    return int(''.join(ls))
.join 메서드에 대한 설명
'구분자'.join(리스트나 튜플 등 순회 가능한 값)
.join()은 문자열 메서드입니다.
문자열들의 리스트나 튜플을 하나의 문자열로 "구분자"를 사이에 두고 합칩니다.
결합하려는 각 요소는 반드시 문자열(str)이어야 합니다.
통계학 학습내용
상관관계(Correlation)가 무엇일까요?
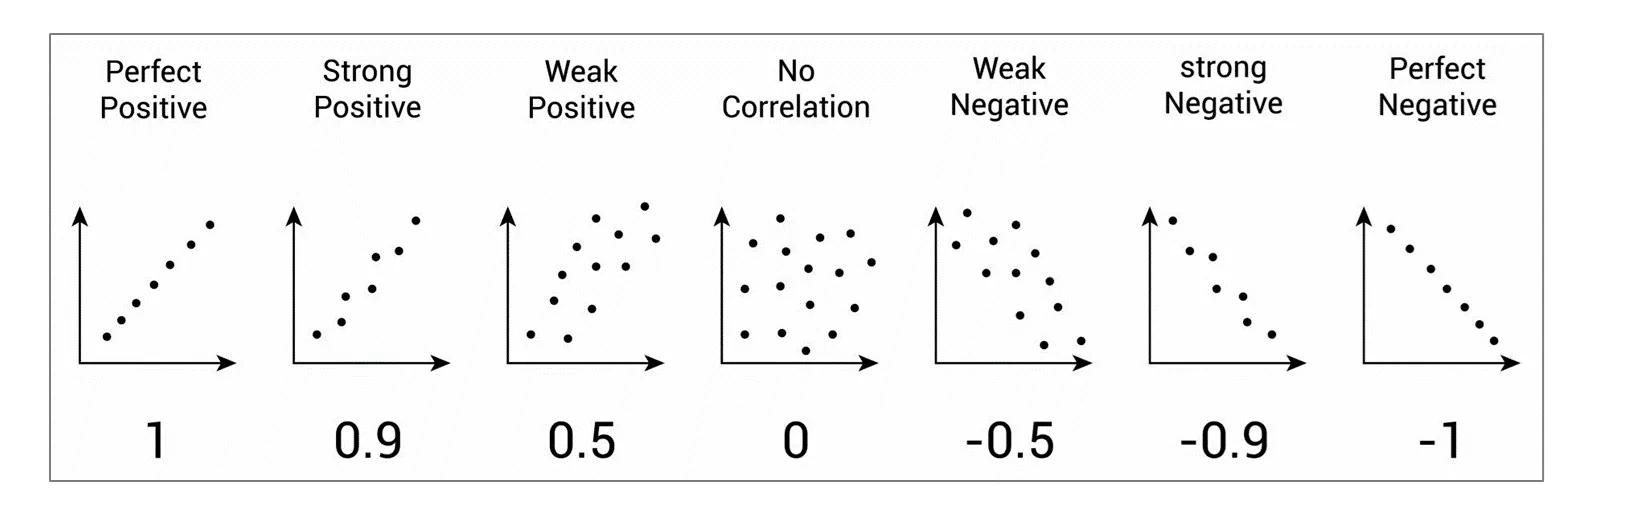
상관관계는 두 개 이상의 "수치형 변수"가 서로 어떤 관계를 가지고 있는지, 그리고 그 관계의 "강도"와 "방향성"이 어떤지를 나타내는 통계적 척도입니다.
즉, "하나의 수치형 변수가 커질 때, 다른 수치형 변수도 함께 커지는지 혹은 작아지는지" 같은 "수치형-수치형 관계"를 파악할 때 사용됩니다.
-
양의 상관관계(Positive Correlation): 한 변수의 값이 증가할 때 다른 변수의 값도 함께 증가하는 경향을 보이는 관계입니다. (예: 광고비와 매출액)
-
음의 상관관계 (Negative Correlation): 한 변수의 값이 증가할 때 다른 변수의 값은 감소하는 경향을 보이는 관계입니다. (예: 상품 가격과 판매량)
-
무상관 (No Correlation): 두 변수 사이에 일정한 선형적인 관계가 없는 경우입니다. (예: 고객의 거주 지역과 구매하는 상품의 색상)
-
상관관계 분석의 활용 및 과정
- 상관관계 분석의 목적
- 두 변수 간에 통계적으로 유의미한 선형적 관계가 존재하는 검정
- 그 관계의 방향(양의/음의)과 강도(얼마나 강하게 관련되어 있는지)를 파악
- 데이터 간의 숨겨진 패턴이나 상호작용을 탐색하여 인사이트 도출
분석 과정
** 1. 가설 설정:
- 귀무가설 (H0): 두 변수 간에는 선형적 상관관계가 없다 (상관계수 ρ = 0).
- 대립가설 (H1): 두 변수 간에는 선형적 상관관계가 있다 (상관계수 ρ != 0).- 데이터 준비: 분석할 변수들을 선택하고 결측치 처리, 이상치 확인 등 데이터 전처리 과정을 수행합니다.
- 산점도 확인: 먼저 시각적으로 변수 간의 관계 패턴을 확인하여 선형 관계 가정이 적절한지 판단합니다.
- 상관계수 계산: 피어슨 또는 스피어만 상관계수를 계산합니다.
- 가설 검정: 계산된 상관계수에 대한 유의확률(p-value)을 통해 귀무가설의 기각 여부를 결정합니다.
- 일반적으로 p<0.05 이면 귀무가설을 기각하고, "두 변수 간에는 통계적으로 유의미한 상관관계가 있다"고 결론 내립니다.
- 결과 해석: 상관계수의 값과 p-value를 종합하여 관계의 방향, 강도, 유의미성을 설명합니다.**
- 상관관계 분석의 목적
