멀티스레드가 무엇인지 먼저 잡기
멀티스레드를 이해하려면 가장 먼저프로세스와스레드를 구분해야 한다.
이 둘을 헷갈리면 뒤에서 배우는싱글 스레드,멀티 스레드,동기화,interrupt()같은 내용도 전부 흐릿하게 느껴진다.
이 주제에서는 문법부터 외우지 않는다.
먼저 무엇이프로세스인지, 무엇이스레드인지, 그리고 왜 하나의 프로그램 안에서 실행 흐름을 나눠야 하는지를 쉬운 말로 잡는다.
처음에는 이렇게 이해하면 된다.
프로세스는 실행 중인 프로그램이고,스레드는 그 프로그램 안에서 실제로 코드를 실행하는 흐름이다.
즉, 프로그램이 실행되고 있다고 해서 일이 저절로 처리되는 것이 아니라, 그 안에서 실제로 움직이는스레드가 있어야 작업이 진행된다.
프로세스와스레드를 먼저 구분하기
프로세스는 실행 중인 프로그램이다
프로세스는 저장된 파일 자체가 아니다.- 지금 실제로 메모리에 올라와 동작 중인 프로그램을 뜻한다.
- 브라우저, 메모장, 음악 재생 프로그램을 각각 실행했다면 그것들은 각각 하나의
프로세스다.파일로 저장되어 있는 프로그램은 아직 “일하는 상태”가 아니다.
실행되어 메모리에 올라오고, 운영체제로부터 필요한 작업 공간을 받아야 실제 동작이 시작된다.
이렇게 실행 중인 상태가 된 프로그램이프로세스다.
여기서 작업 공간이라는 말은 어렵게 느껴질 수 있다.
이 단계에서는 메모리, 데이터, 파일, 화면 출력처럼 프로그램이 일할 때 쓰는 재료와 공간이라고 이해하면 충분하다.
즉,프로세스는 단순한 프로그램 파일이 아니라 일할 준비를 마친 실행 단위다.
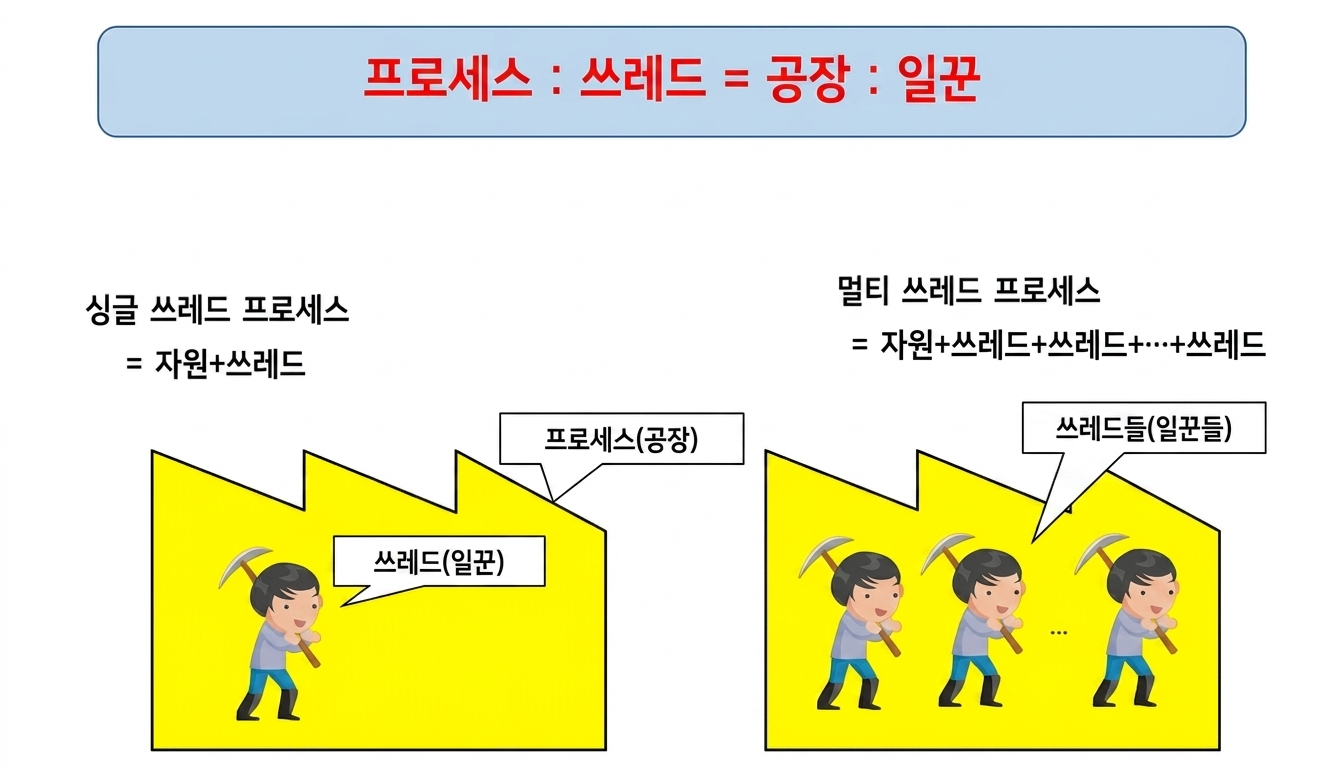
프로세스를 조금 더 정확하게 보면, 실행 중인 프로그램이라고 끝나는 것이 아니라 자원과스레드를 함께 가진 실행 단위다.
여기서 자원은 메모리, 데이터, 파일, 화면 출력처럼 프로그램이 일할 때 필요한 재료와 공간이고,스레드는 그 자원 위에서 실제 코드를 실행하는 흐름이다.
즉,프로세스는 일할 공간만 따로 뜻하는 것이 아니라, 그 공간과 그 안에서 움직이는 실행 흐름을 함께 가진 구조라고 이해하면 더 정확하다.
스레드는 그 안에서 실제로 코드를 실행하는 흐름이다
스레드는프로세스안에서 실제로 코드를 따라 움직이는 실행 흐름이다.- 쉽게 말하면 프로그램 안의 “일하는 줄기”다.
- 모든
프로세스는 적어도 하나 이상의스레드를 가진다.초보자 입장에서는
프로세스와스레드가 둘 다 “실행되는 것”처럼 보여서 헷갈리기 쉽다.
하지만 기준이 다르다.
프로세스는 실행 중인 프로그램 자체이고,스레드는 그 안에서 실제로 일을 하는 흐름이다.
예를 들어 프로그램 안에 코드가 아무리 많아도 그것을 실제 순서대로 실행하는 흐름이 없으면 일은 진행되지 않는다.
그 역할을 맡는 것이스레드다.
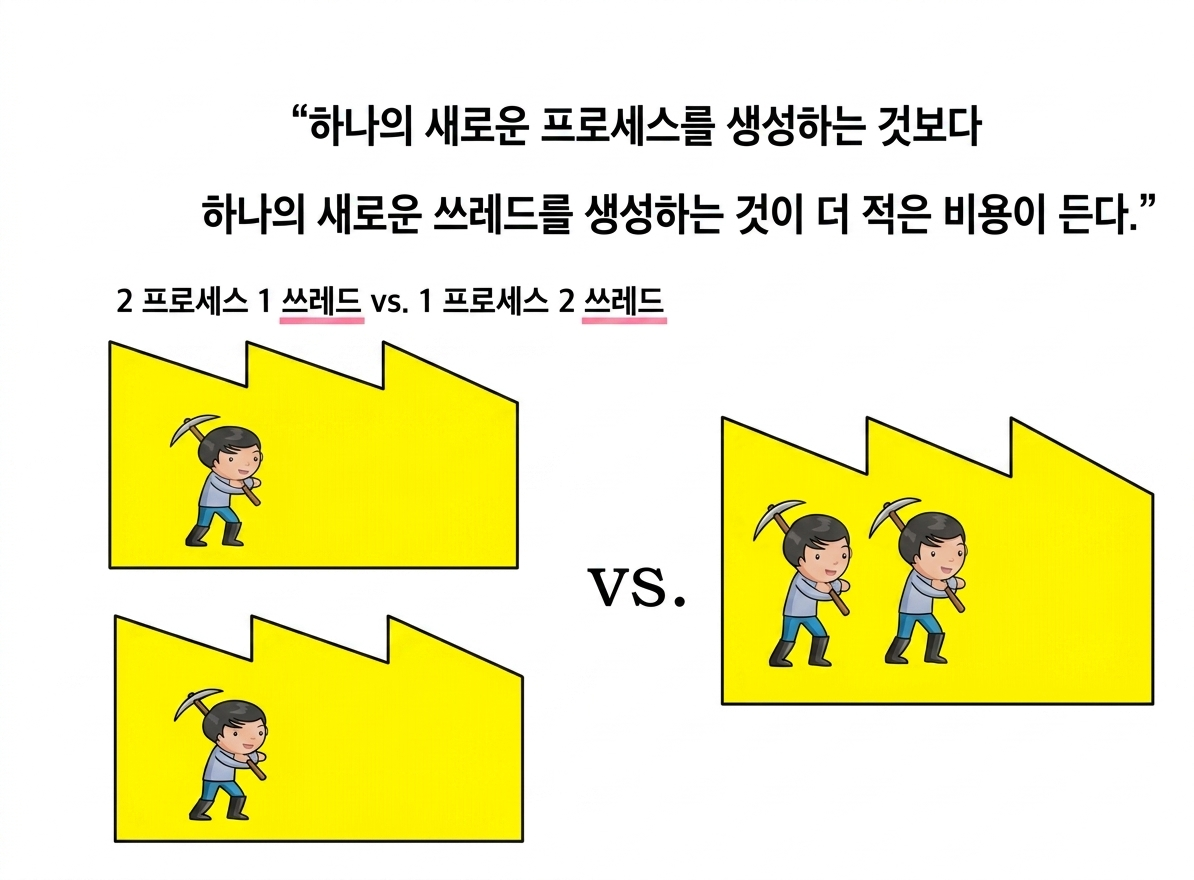
그래서프로세스는 작업 공간에 가깝고,스레드는 그 공간 안에서 실제로 움직이는 작업자에 가깝다.
프로세스는 공장처럼 작업 공간을 뜻하고,스레드는 그 안에서 실제로 일하는 일꾼처럼 이해하면 관계를 훨씬 쉽게 잡을 수 있다.
왜 이 둘을 꼭 구분해야 하는가
프로세스와스레드를 구분해야멀티 프로세스와멀티 스레드차이도 정확하게 보인다.- 뒤에서 배우는
동기화도 여러스레드가 같은 자원을 함께 쓰기 때문에 필요한 개념이다.- 즉, 이 구분은 앞부분만 이해할 때 필요한 것이 아니라 뒤의 모든 내용으로 이어지는 시작점이다.
예를 들어 같은 프로그램 안에서 출력 순서가 섞이거나 값이 꼬이는 문제는, 프로그램이 여러 개라서 생기는 것이 아니다.
하나의프로세스안에서 여러스레드가 함께 움직이기 때문에 생기는 문제다.
그래서 지금 이 구분을 정확히 해 두어야 뒤의 개념도 자연스럽게 연결된다.
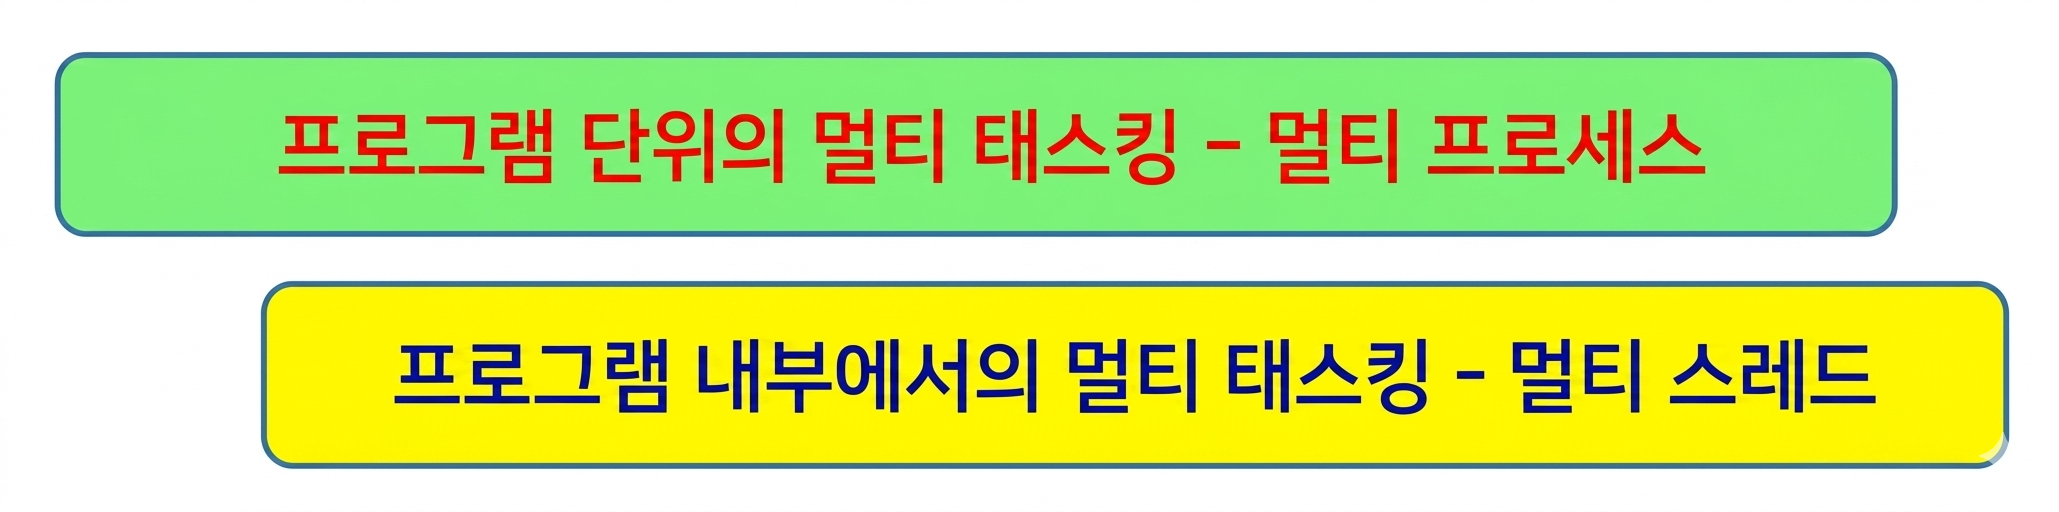
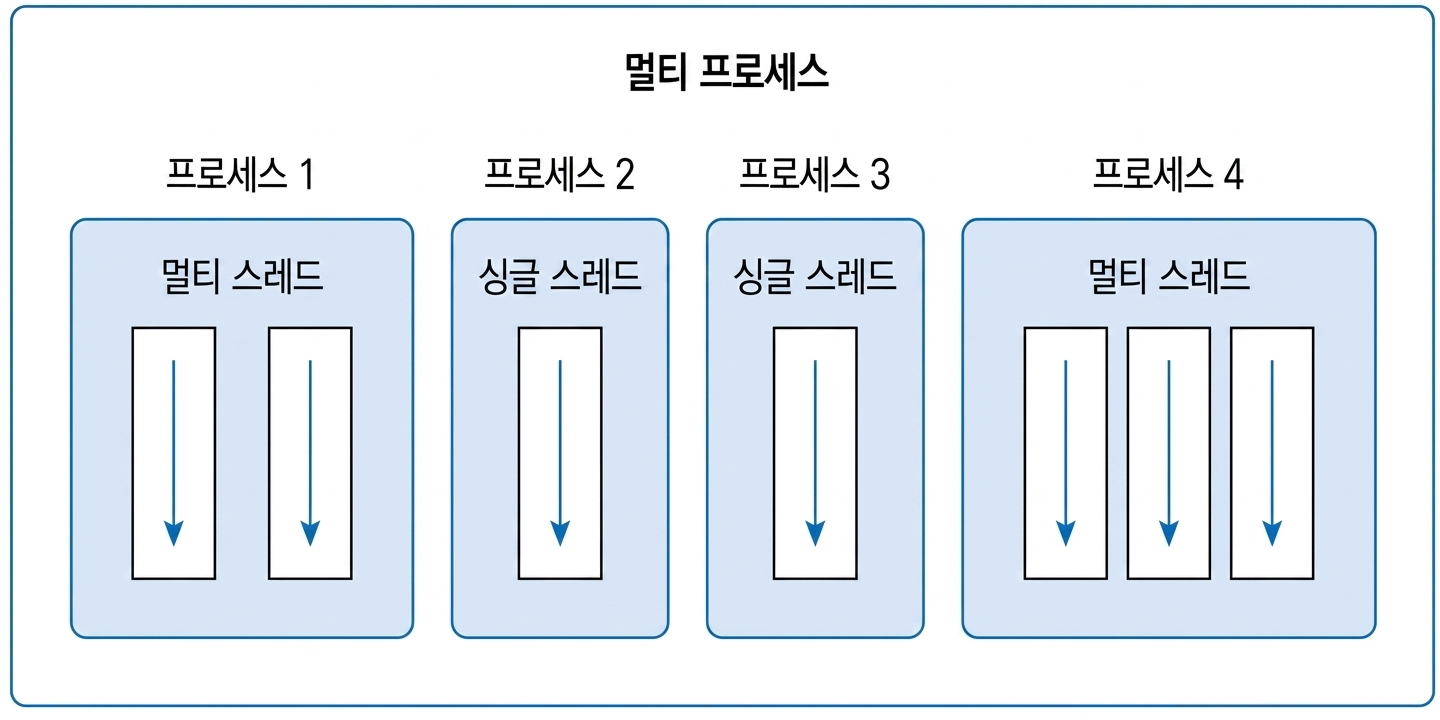
멀티 프로세스와멀티 스레드는 무엇이 다른가가장 큰 기준부터 먼저 잡기
- 프로그램 여러 개가 동시에 실행되는 것은
멀티 프로세스다.- 프로그램 하나 안에서 여러 실행 흐름이 나뉘어 움직이는 것은
멀티 스레드다.이 둘은 이름이 비슷해서 자주 헷갈린다.
하지만 기준은 아주 단순하다.
프로그램이 여러 개냐, 아니면 프로그램은 하나인데 그 안의 실행 흐름이 여러 개냐의 차이다.
프로그램 단위로 여러 개가 동시에 도는 것은
멀티 프로세스이고, 하나의 프로그램 안에서 여러 실행 흐름이 함께 움직이는 것은멀티 스레드다.
비슷한 말로멀티 태스킹이라는 표현도 같이 알아두면 좋다.
멀티 태스킹은 여러 작업을 함께 처리하는 큰 흐름을 말하고, 그 안에는 여러프로세스가 각각 도는 경우도 있고 하나의프로세스안에서 여러스레드가 나뉘어 움직이는 경우도 있다.
그리고 화면에서는 모든 일이 정말 완전히 동시에 일어나는 것처럼 보여도, 실제로는CPU코어 수와 스케줄러, 즉 운영체제가 일을 나누는 방식에 따라 아주 빠르게 번갈아 실행되기도 한다.
그래서 초보자 단계에서는 “여러 흐름이 동시에 보이도록 처리된다” 정도로 이해하면 충분하다.
멀티 프로세스는 프로그램 여러 개가 함께 도는 구조다
멀티 프로세스는 여러프로세스가 동시에 실행되는 방식이다.- 브라우저 하나, 메신저 하나, 음악 재생 프로그램 하나처럼 서로 다른 프로그램이 각자 실행되는 상황을 떠올리면 이해하기 쉽다.
이 방식에서는 실행 주체가 프로그램 단위로 여러 개 존재한다.
그래서 한 프로그램이 종료되었다고 해서 다른 프로그램이 같은 흐름으로 묶여 움직인다고 볼 필요는 없다.
프로그램 자체가 각각 따로 실행되고 있기 때문이다.
여러
프로세스는 각각 따로 존재하는 실행 단위이고, 어떤프로세스는싱글 스레드일 수도 있고 어떤프로세스는멀티 스레드일 수도 있다.
멀티 스레드는 프로그램 하나 안에서 흐름을 나누는 구조다
멀티 스레드는 프로그램을 여러 개 띄우는 것이 아니다.- 하나의 프로그램 안에서 여러 실행 흐름을 두는 구조다.
- 즉, 프로그램은 하나지만 그 안에서 일하는 줄기는 여러 개일 수 있다.
예를 들어 하나의 프로그램 안에서 화면을 그리는 작업, 사용자 입력을 받는 작업, 데이터를 받아 오는 작업을 서로 다른 흐름으로 나눌 수 있다.
이때 프로그램은 하나다.
하지만 그 안에서는 여러스레드가 자기 역할을 나눠서 움직인다.
초보자가 가장 많이 오해하는 부분이 바로 이것이다.
멀티 스레드를 프로그램이 여러 개 뜬 상태로 이해하면 안 된다.
프로그램은 하나다.
다만 그 안에서 실행 흐름만 여러 갈래로 나뉜 것이다.
싱글 스레드와멀티 스레드도 여기서 갈린다
싱글 스레드는 하나의프로세스안에 실행 흐름이 하나인 구조다.멀티 스레드는 하나의프로세스안에 실행 흐름이 여러 개인 구조다.즉,
프로세스개수와스레드개수는 같은 기준이 아니다.
프로그램 하나 안에도스레드는 여러 개 있을 수 있다.
이 점을 이해해야 “하나의 프로그램인데 왜 일이 여러 갈래로 움직이지?”라는 의문이 풀린다.
왜
멀티 스레드가 필요한가한 흐름만 있으면 기다림이 그대로 막힘이 된다
- 실행 흐름이 하나뿐이면 구조는 단순하다.
- 하지만 어떤 작업이 오래 걸리면 그 뒤의 작업도 같이 기다려야 한다.
- 그래서 한쪽 작업이 멈추는 순간 다른 작업도 함께 밀리기 쉽다.
예를 들어 사용자 입력을 기다리는 동안 화면 갱신도 멈추고, 파일을 읽는 동안 다른 버튼 반응도 늦어지고, 네트워크 응답을 기다리는 동안 프로그램이 멈춘 것처럼 보일 수 있다.
이것이싱글 스레드구조의 가장 큰 한계다.
즉, 실행 흐름이 하나뿐이면 앞 작업이 막히는 순간 뒤 작업도 같이 멈춘다.
작업이 단순할 때는 괜찮지만, 여러 일을 함께 처리해야 할 때는 불편해진다.
멀티 스레드는 작업을 나눠서 막힘을 줄인다
멀티 스레드는 여러 일을 복잡하게 만들기 위해 쓰는 구조가 아니다.- 오히려 여러 일이 한 줄에 묶여서 같이 막히는 것을 줄이기 위해 쓰는 구조다.
예를 들어 한쪽에서는 사용자 입력을 기다리고, 다른 쪽에서는 화면을 계속 갱신하고, 또 다른 쪽에서는 네트워크 작업을 처리하게 만들 수 있다.
그러면 입력이 잠깐 멈춰도 화면 쪽 흐름이나 다른 작업 흐름은 자기 일을 이어 갈 수 있다.
초보자 단계에서는 “완전히 동시에 일어난다”라고 너무 딱 잘라 이해할 필요는 없다.
이 단계에서는 작업 흐름이 나뉘어 있어서 한쪽이 기다려도 다른 쪽이 이어서 일할 수 있다 정도로 이해하면 충분하다.
멀티 스레드의 핵심은 여러 일을 멋지게 동시에 보이게 만드는 것이 아니라, 한쪽 작업 때문에 전체가 같이 멈추지 않게 만드는 데 있다.
왜 새
프로세스보다 새스레드가 더 자주 쓰이는가
- 새로운 작업이 필요할 때마다 매번 새
프로세스를 만드는 것도 가능하다.- 하지만 보통은 하나의 프로그램 안에서
스레드를 늘리는 쪽이 더 가볍다.새
프로세스를 만든다는 것은 새로운 실행 단위를 하나 더 준비하는 것이다.
반면 새스레드를 만든다는 것은 이미 실행 중인 프로그램 안에 실행 흐름을 하나 더 추가하는 것에 가깝다.
그래서 같은 프로그램 안에서 여러 일을 나눠 처리할 때는멀티 스레드구조가 더 자연스럽게 쓰인다.
새로운
프로세스를 여러 개 만드는 것보다, 하나의프로세스안에서스레드를 늘리는 쪽이 보통 더 적은 부담으로 작업을 나눌 수 있다.
이 주제에서 꼭 남겨야 하는 핵심
지금 단계에서는 이렇게 이해하면 된다
프로세스는 실행 중인 프로그램이다.스레드는 그프로세스안에서 실제로 코드를 실행하는 흐름이다.- 프로그램 여러 개가 동시에 도는 것은
멀티 프로세스다.- 프로그램 하나 안에서 여러 실행 흐름이 나뉘는 것은
멀티 스레드다.멀티 스레드는 한 작업이 기다릴 때 다른 작업까지 같이 막히지 않게 하려고 사용한다.이 다섯 줄만 정확히 이해해도 뒤에서 나오는
싱글 스레드,메인 스레드,작업 스레드,동기화까지 훨씬 자연스럽게 이어진다.
즉, 지금 이 주제는 단순한 정의 암기 구간이 아니라, 멀티스레드 전체를 이해하는 출발점이다.
싱글스레드와 멀티스레드는 실제로 어떻게 다른가
프로세스와스레드의 뜻을 구분했다면, 이제는 실제 실행 모습이 어떻게 다른지 봐야 한다.
초보자가싱글 스레드와멀티 스레드를 헷갈리는 가장 큰 이유는 둘 다 “일을 한다”는 점만 보고, 어떻게 실행되느냐를 보지 않기 때문이다.
핵심은 단순하다.
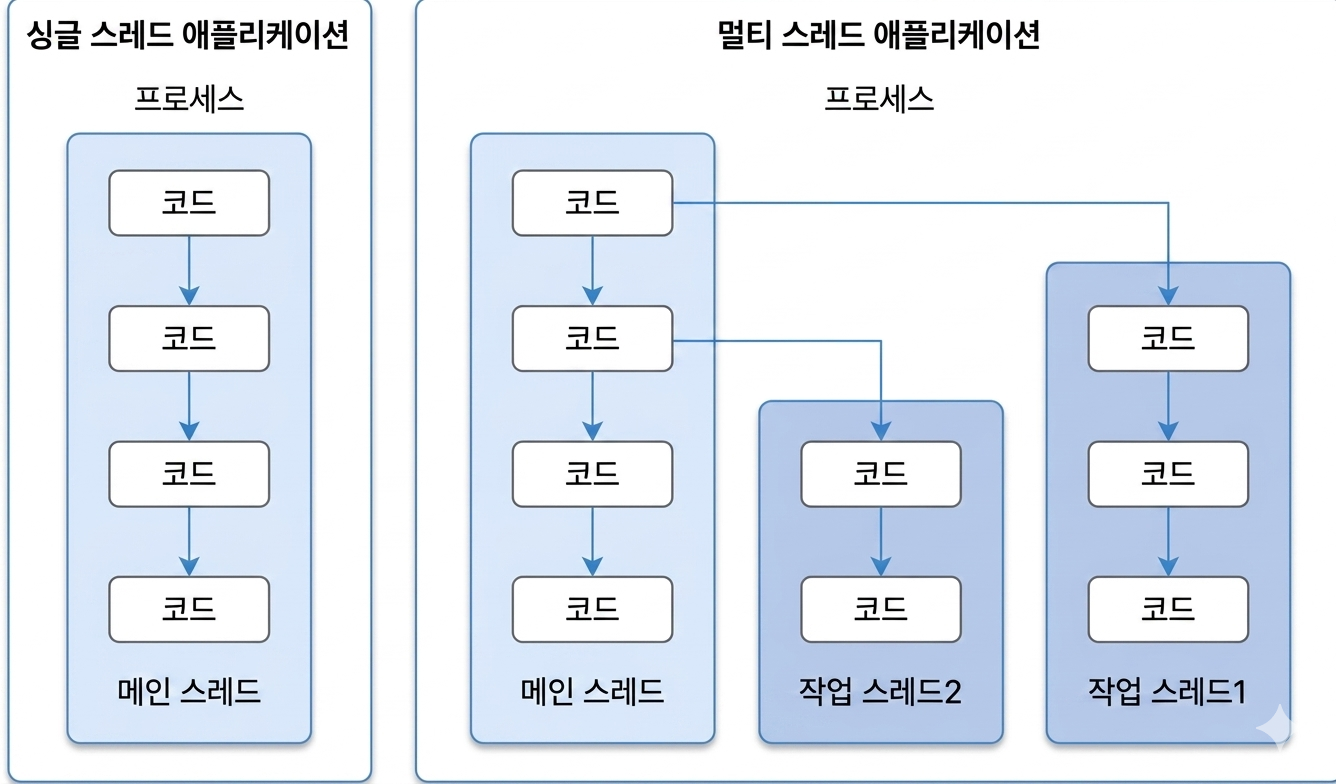
싱글 스레드는 하나의 실행 흐름으로 차례대로 처리하는 구조이고,멀티 스레드는 여러 실행 흐름으로 작업을 나누는 구조다.
이 차이는 문장으로만 보면 단순해 보이지만, 실제로는 프로그램이 멈춰 보이느냐, 기다리는 동안 다른 일이 가능하냐 같은 차이로 바로 이어진다.
싱글 스레드는 어떻게 동작하는가하나의 흐름으로 순서대로 처리한다
싱글 스레드는 실행 흐름이 하나뿐이다.- 그래서 앞의 작업이 끝나야 다음 작업으로 넘어갈 수 있다.
- 코드는 위에서 아래로 순서대로 흘러가고, 중간에 다른 실행 줄기가 끼어들지 않는다.
이 구조는 처음 배울 때는 이해하기 쉽다.
실행 줄기가 하나뿐이기 때문에 “지금 무엇을 하고 있는지”를 따라가기가 비교적 편하다.
예를 들어 첫 번째 코드가 실행되고, 그 일이 끝나면 두 번째 코드가 실행되고, 그다음 세 번째 코드로 넘어간다.
이 흐름은 우리가 보통 코드를 읽는 방식과 비슷하다.
그래서 초보자에게는 가장 익숙한 구조다.
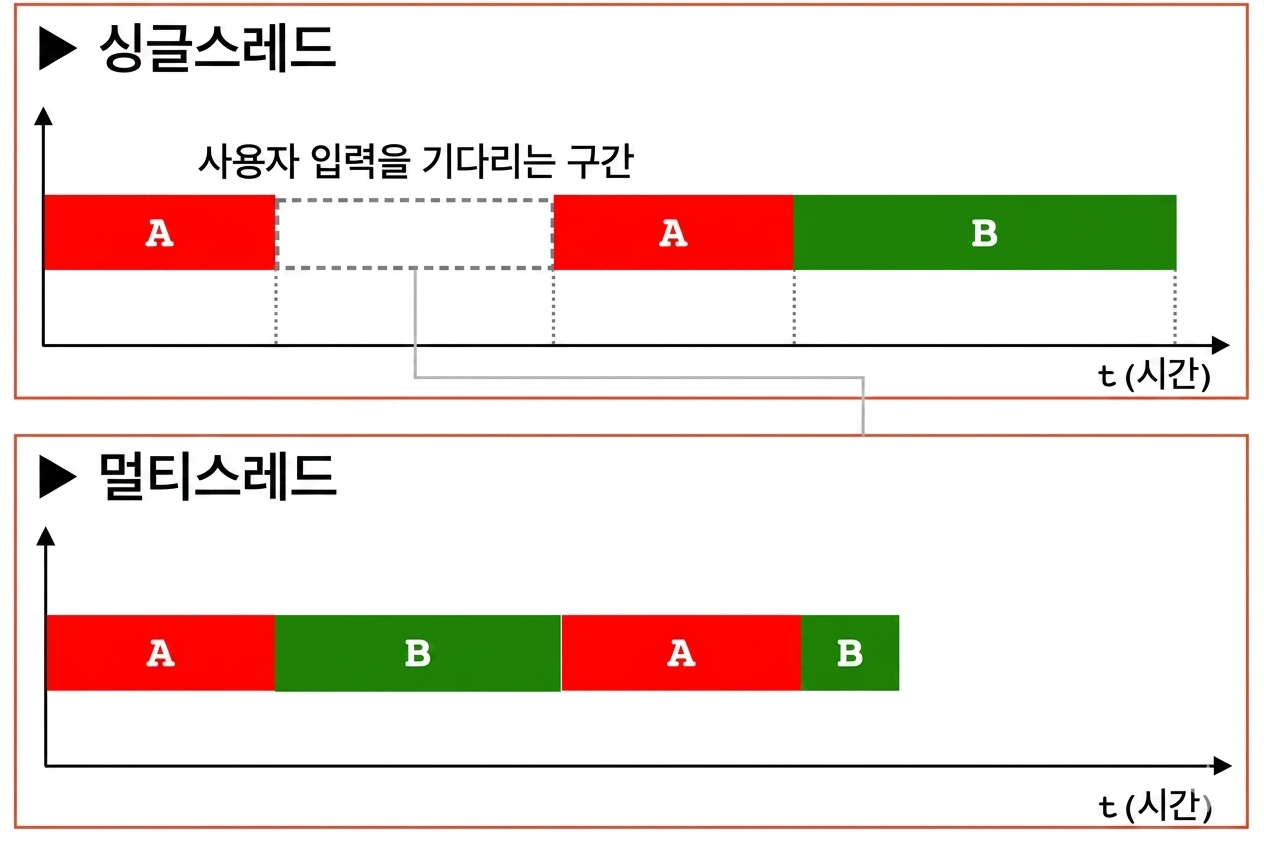
싱글 스레드는 하나의 실행 흐름만 따라 아래로 내려가고,멀티 스레드는메인 스레드외에 작업 스레드가 더 나뉘어 움직일 수 있다.
기다리는 작업이 생기면 뒤의 작업도 같이 기다린다
- 실행 흐름이 하나뿐이기 때문에, 앞 작업이 멈추면 뒤 작업도 시작하지 못한다.
- 그래서 입력 대기, 파일 읽기, 네트워크 응답 대기 같은 작업이 들어오면 프로그램이 답답하게 느껴질 수 있다.
예를 들어 사용자 입력을 기다리는 동안 카운트다운도 멈추고, 화면 갱신도 멈추고, 다른 계산도 시작하지 못한다면 프로그램은 멈춘 것처럼 보이기 쉽다.
이것이싱글 스레드구조의 가장 큰 한계다.
즉,싱글 스레드는 단순한 대신 한쪽 작업이 막히는 순간 전체 흐름도 같이 막히기 쉽다.
그래서 처리할 일이 하나뿐일 때는 괜찮지만, 여러 일을 함께 다뤄야 할 때는 불편해진다.
멀티 스레드는 어떻게 다른가하나의 프로그램 안에서 일을 나눠서 처리한다
멀티 스레드는 프로그램을 여러 개 띄우는 구조가 아니다.- 하나의 프로그램 안에서 실행 흐름을 여러 개로 나누는 구조다.
- 그래서 같은 프로그램 안에서도 각 흐름이 맡은 일을 따로 처리할 수 있다.
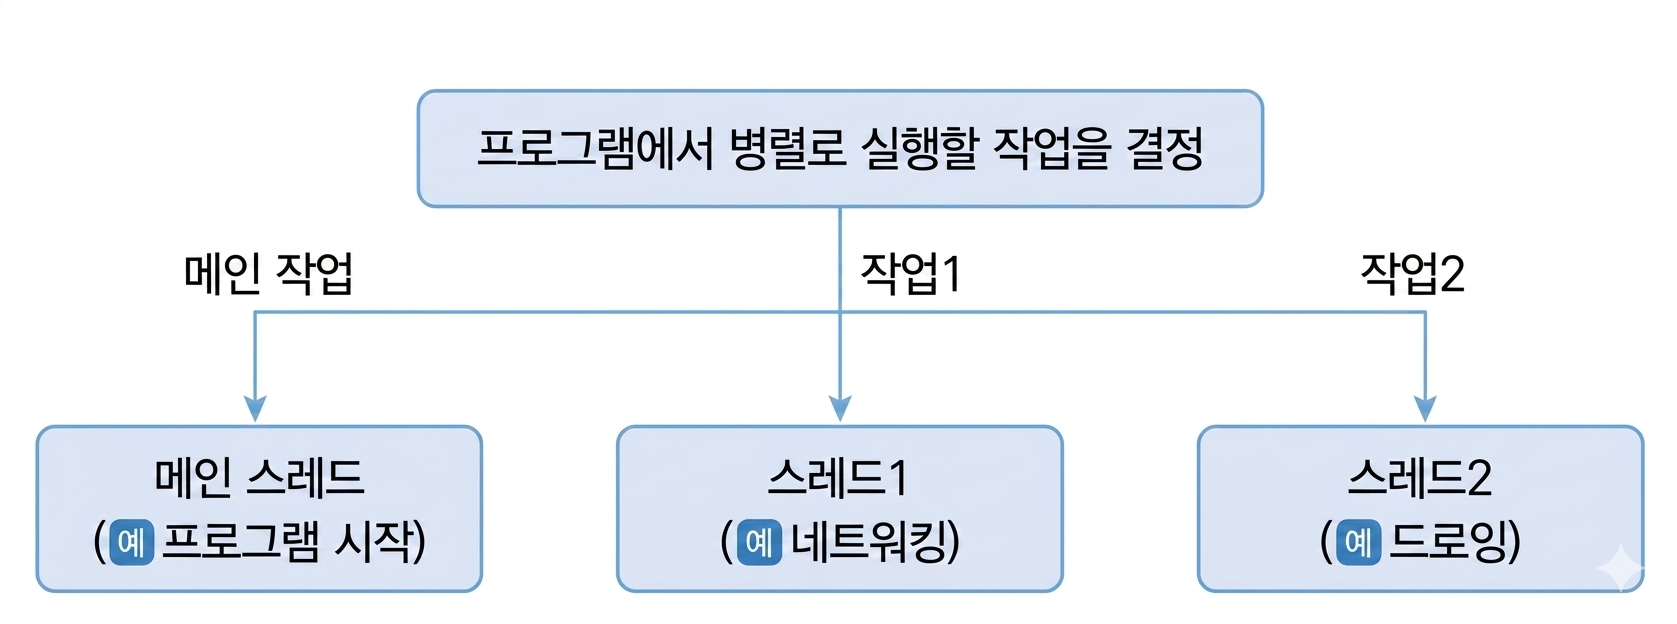
예를 들어 프로그램은 하나지만, 그 안에서 시작을 담당하는
메인 스레드가 있고, 다른 한쪽에서는 네트워크 작업을 처리하고, 또 다른 한쪽에서는 화면을 그리는 작업을 맡을 수 있다.
즉, 프로그램은 하나인데 그 안의 일하는 줄기만 여러 개인 것이다.
프로그램은 기본적으로
메인 스레드에서 시작하고, 필요한 작업을 나눠서 다른스레드에 맡길 수 있다.
메인 스레드와 작업 스레드는 역할이 다르다
- 프로그램은 보통
메인 스레드에서 시작된다.메인 스레드는 프로그램의 기본 흐름을 잡는 중심 역할을 한다.- 필요한 작업이 생기면 별도의 작업 스레드를 만들어 일을 나눌 수 있다.
예를 들어 프로그램 시작, 기본 제어, 주요 흐름은
메인 스레드가 담당하고, 시간이 걸리는 작업이나 별도로 계속 돌아가야 하는 작업은 다른 스레드가 맡을 수 있다.
이렇게 나누는 이유는 단순하다.
하나의 흐름에 모든 일을 몰아 넣으면, 어느 한쪽이 기다릴 때 나머지도 함께 멈추기 쉽기 때문이다.
그래서 작업을 나누면 한쪽이 잠깐 쉬거나 기다리는 동안 다른 쪽은 자기 일을 이어 갈 수 있다.
시간 흐름으로 보면 차이가 더 분명해진다
싱글 스레드는 한 줄로 길게 이어진다
싱글 스레드에서는A작업을 하다가 입력을 기다리면 그 시간 동안B작업도 시작하지 못한다.- 즉, 기다림이 생긴 구간 자체가 그대로 전체 흐름의 멈춤으로 이어진다.
이 점은 초보자에게 매우 중요하다.
왜냐하면 코드를 순서대로만 읽으면 “뒤에B가 있으니까 곧 실행되겠지”라고 생각하기 쉽기 때문이다.
하지만 실제 실행 흐름이 하나뿐이라면 앞의 기다림이 끝나기 전에는 뒤의 작업이 움직일 수 없다.
그래서싱글 스레드에서는 프로그램이 멈춘 것처럼 보이는 순간이 생기기 쉽다.
특히 사용자 입력을 기다리거나 응답을 받아야 하는 작업에서는 이 차이가 더 크게 느껴진다.
멀티 스레드는 다른 흐름이 이어서 움직일 수 있다
멀티 스레드에서는 한쪽 흐름이 잠깐 멈춰도 다른 흐름이 자기 일을 계속할 수 있다.- 그래서 입력을 기다리는 동안에도 다른 작업이 함께 진행될 수 있다.
이것을 처음 볼 때는 “그럼 모든 게 완전히 동시에 일어나는 건가?”라고 생각할 수 있다.
하지만 초보자 단계에서는 그렇게까지 딱 잘라 이해하지 않아도 된다.
이 단계에서는 실행 흐름이 나뉘어 있기 때문에 한쪽이 기다릴 때 다른 쪽도 꼭 같이 멈출 필요는 없다 정도로 이해하면 충분하다.
즉,멀티 스레드의 핵심은 여러 일을 멋지게 한꺼번에 보여 주는 데 있는 것이 아니라, 한 작업 때문에 전체가 같이 멈추지 않게 만드는 데 있다.
싱글 스레드는 한 작업이 기다리면 뒤 작업도 같이 밀리기 쉽고,멀티 스레드는 다른 실행 흐름이 이어서 움직일 수 있다.
개념을 예제로 확인하기
ThreadEx04는싱글 스레드흐름을 보여준다
-를 20번 출력한 뒤, 그다음에|를 20번 출력한다.- 중간에
sleep()이 있어도 실행 흐름은 하나뿐이다.- 그래서 앞의 반복이 전부 끝나야 뒤의 반복이 시작된다.
즉, 이 예제는 “쉬는 시간이 있다고 해서 자동으로
멀티 스레드가 되는 것은 아니다”라는 점을 잘 보여 준다.
지금 쉬고 있는 것도 결국 같은 흐름 하나가 잠깐 멈춘 것일 뿐이다.// ThreadEx04.java class ThreadEx04 { public static void main(String args[]) throws InterruptedException { for (int i = 0; i < 20; i++) { System.out.print("-"); // 첫 번째 작업 Thread.sleep(1000); // 1초 대기 } for (int i = 0; i < 20; i++) { System.out.print("|"); // 두 번째 작업 Thread.sleep(1000); // 1초 대기 } } }// 출력결과 // --------------------|||||||||||||||||||| // 앞 작업이 전부 끝난 뒤 뒤 작업이 시작된다.이 예제의 핵심은
sleep()이 있어도 실행 흐름은 여전히 하나라는 점이다.
즉, “쉬는 것”과 “여러 흐름으로 나뉘는 것”은 다르다.
ThreadEx05는멀티 스레드흐름을 보여준다
- 메인 흐름에서는
-를 출력한다.- 별도의 작업 스레드에서는
|를 출력한다.- 실행 흐름이 둘로 나뉘었기 때문에 출력이 섞여 보일 수 있다.
이 예제는
ThreadEx04와 비교해서 봐야 더 잘 보인다.
앞 예제는 한 줄로 길게 처리되었지만, 이번에는 실행 흐름이 두 개라서 출력 순서가 하나로 고정되지 않는다.// ThreadEx05.java class ThreadEx05 { public static void main(String args[]) throws InterruptedException { ThreadEx5_1 th1 = new ThreadEx5_1(); th1.start(); // 새 스레드 시작 for (int i = 0; i < 20; i++) { System.out.print("-"); // 메인 스레드 작업 Thread.sleep(1000); // 1초 대기 } } } class ThreadEx5_1 extends Thread { public void run() { for (int i = 0; i < 20; i++) { try { System.out.print("|"); // 작업 스레드 작업 Thread.sleep(1000); // 1초 대기 } catch (InterruptedException e) { } } } }// 출력결과 // -|-|-||--|-|--||-... // 출력 순서는 실행할 때마다 달라질 수 있다.출력이 섞여 나온다는 것은 코드가 틀렸다는 뜻이 아니다.
오히려 실행 흐름이 둘로 나뉘어 있다는 뜻에 가깝다.
즉,멀티 스레드에서는 실행 순서가 항상 똑같다고 기대하면 안 된다.
ThreadEx06과ThreadEx07을 같이 보면 차이가 더 선명해진다
ThreadEx06은 입력이 끝날 때까지 뒤의 카운트다운이 시작되지 않는다.ThreadEx07은 카운트다운을 별도 스레드로 돌리기 때문에 입력을 기다리는 동안에도 숫자가 계속 줄어든다.이 두 예제는
멀티 스레드가 왜 필요한지를 가장 쉽게 체감하게 해 준다.
특히 “사용자 입력을 기다리는 동안 다른 일도 계속할 수 있는가”를 직접 보여 주기 때문에 초보자 입장에서는 매우 중요한 비교 예제다.// ThreadEx06.java class ThreadEx06 { public static void main(String[] args) throws Exception { String input = javax.swing.JOptionPane.showInputDialog("입력"); System.out.println("입력값: " + input); // 입력 후에야 아래 코드 진행 for (int i = 10; i > 0; i--) { System.out.println(i); // 입력이 끝난 뒤 시작 Thread.sleep(1000); } } }// 출력결과 // 입력창이 먼저 뜬다. // 값을 입력하고 나서야 // 10 // 9 // 8 // ...// ThreadEx07.java class ThreadEx07 { public static void main(String[] args) throws Exception { ThreadEx7_1 th1 = new ThreadEx7_1(); th1.start(); // 카운트다운을 별도 스레드로 실행 String input = javax.swing.JOptionPane.showInputDialog("입력"); System.out.println("입력값: " + input); // 입력 중에도 숫자는 계속 출력될 수 있다. } } class ThreadEx7_1 extends Thread { public void run() { for (int i = 10; i > 0; i--) { System.out.println(i); // 카운트다운 작업 try { sleep(1000); // 1초 대기 } catch (Exception e) { } } } }// 출력결과 // 입력창이 떠 있는 동안에도 // 10 // 9 // 8 // ... // 숫자가 먼저 계속 줄어들 수 있다.즉,
ThreadEx06은 한 흐름이 기다리면 다른 작업도 같이 밀린다는 점을 보여 주고,ThreadEx07은 작업을 나누면 기다리는 동안에도 다른 흐름이 계속 움직일 수 있다는 점을 보여 준다.
이 주제에서 꼭 남겨야 하는 핵심
지금 단계에서는 이렇게 이해하면 된다
싱글 스레드는 하나의 실행 흐름으로 차례대로 처리한다.- 그래서 한 작업이 기다리면 뒤의 작업도 같이 기다리기 쉽다.
멀티 스레드는 여러 실행 흐름으로 작업을 나눌 수 있다.- 그래서 한쪽 흐름이 잠깐 멈춰도 다른 쪽 흐름은 자기 일을 이어 갈 수 있다.
- 이 차이는 실제 프로그램이 멈춰 보이느냐, 계속 반응하느냐에 직접 연결된다.
즉,
싱글 스레드와멀티 스레드의 차이는 단순히 개수가 다른 것이 아니다.
하나의 흐름으로 모든 일을 줄 세워 처리할 것인지, 여러 흐름으로 나눠서 막힘을 줄일 것인지의 차이다.
이 감각을 잡고 나면 뒤에서 나오는start(),run(),join(),sleep()같은 개념도 훨씬 쉽게 이해된다.
스레드는 어떻게 만드는가
멀티 스레드를 만든다는 것은 결국 실행 흐름을 하나 더 만드는 것이다.
그래서 이 주제에서는 새로운 실행 흐름을 어떻게 만들고, 왜start()와run()을 다르게 봐야 하는지를 먼저 정확히 잡아야 한다.
초보자가 여기서 가장 많이 헷갈리는 부분은 두 가지다.
하나는Thread를 만드는 방법이 두 가지라는 점이고, 다른 하나는run()을 직접 호출해도 새스레드가 만들어지는 것이 아니라는 점이다.
이 두 가지만 제대로 잡아도 뒤 예제가 훨씬 쉽게 읽힌다.
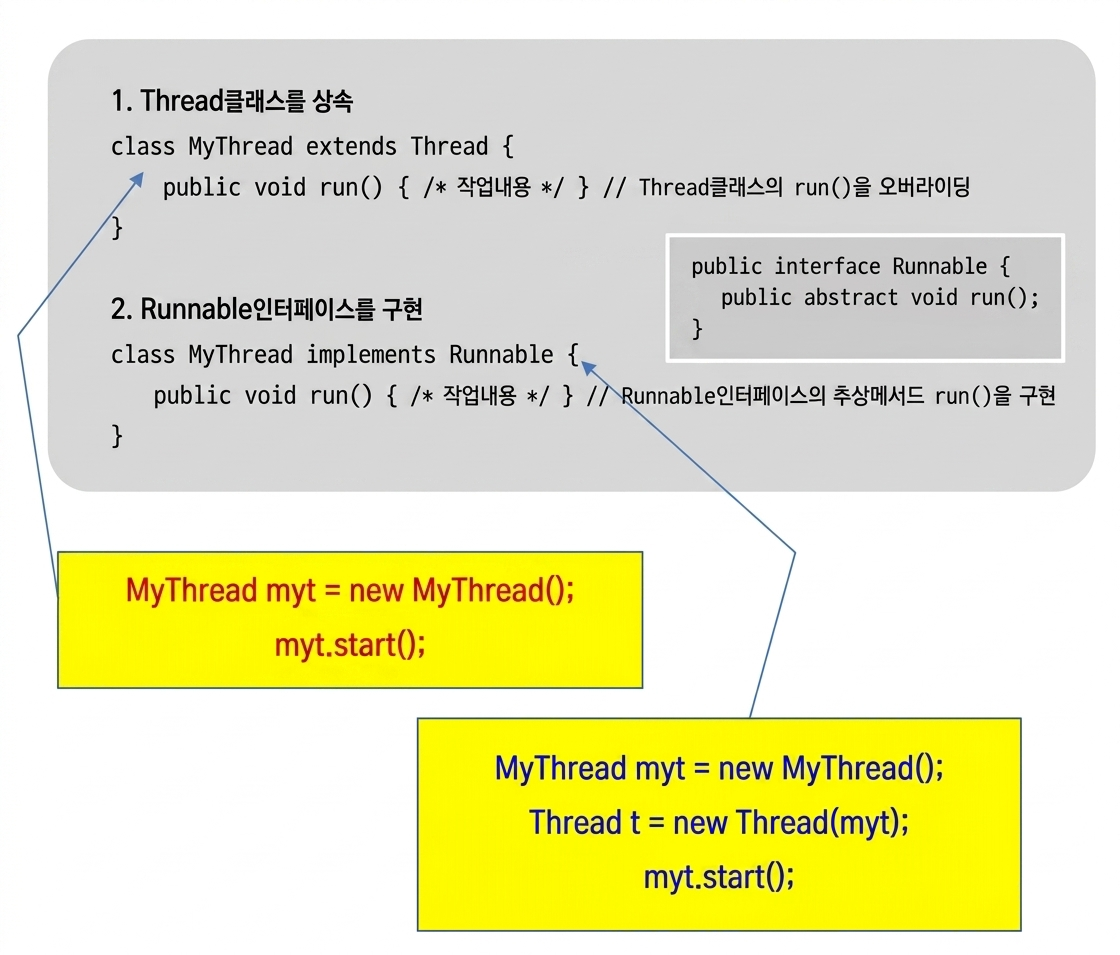
스레드를 만드는 방법은 두 가지다
Thread클래스를 상속하는 방법
Thread클래스를 상속하면 그 클래스 자체가스레드역할을 하게 된다.- 이 방식에서는
run()메서드를 오버라이딩해서 그 안에 실제 작업 내용을 적는다.- 구조가 단순해서 처음 배울 때 이해하기 쉽다.
이 방법은 “
스레드를 직접 하나 만든다”는 느낌에 가깝다.
그래서 초보자 입장에서는 가장 눈에 잘 들어온다.
클래스를 만들고, 그 안에run()을 적고, 객체를 생성한 뒤start()를 호출하면 된다고 이해하면 된다.
Runnable인터페이스를 구현하는 방법
Runnable은 “이 안에 실행할 작업이 들어 있다”는 역할을 맡는 인터페이스다.- 이 방식에서도 실제 작업 내용은
run()안에 적는다.- 다만
Runnable구현 객체만으로는 바로 실행되지 않고, 이것을Thread객체에 넣어서 실행해야 한다.이 방법은
스레드자체와 실행할 작업 내용을 분리해서 보는 방식이다.
즉,Runnable구현 클래스는 “할 일”을 만들고,Thread객체는 그 할 일을 실제 실행 흐름으로 돌리는 역할을 한다.
그래서 처음에는 조금 더 낯설 수 있지만, 구조를 나눠서 보는 연습에는 도움이 된다.
Thread를 직접 상속할 수도 있고,Runnable을 구현해서Thread에 넣어 실행할 수도 있다.
두 방법의 공통점도 먼저 봐야 한다
- 두 방법 모두 결국
run()안에 실제 작업 내용을 적는다.- 즉, 겉모양은 달라도 “무슨 일을 할지”는 둘 다
run()이 담당한다.초보자는 두 방법을 완전히 다른 것으로 느끼기 쉽다.
하지만 핵심은 같다.
둘 다 실행할 작업을run()안에 적는다는 점은 똑같다.
차이는 그 작업을 어떤 형태로 감싸서 실행하느냐에 있다.
start()와run()은 완전히 다르다
run()은 작업 내용이다
run()은 “이스레드가 실행되면 무슨 일을 할지”를 적어 둔 메서드다.- 즉, 실제 작업 설명서에 가깝다.
이 부분이 중요하다.
run()안에 코드를 적었다고 해서 그것만으로 새 실행 흐름이 생기는 것은 아니다.
run()은 어디까지나 “할 일”이 적힌 메서드다.
그래서run()만 직접 호출하면 그냥 일반 메서드를 호출한 것처럼 동작한다.
start()는 새 실행 흐름을 시작시키는 호출이다
start()를 호출해야 새로운스레드가 시작된다.- 그리고 그 새 실행 흐름 안에서
run()이 동작한다.즉,
start()는 “새스레드를 만들어서 그 안에서run()을 돌려라”에 가깝다.
반면run()을 직접 호출하면 지금 흐르고 있는 현재 실행 줄기 안에서 그냥 메서드 하나를 호출한 것과 비슷하다.
그래서멀티 스레드를 만들고 싶다면run()이 아니라 반드시start()를 호출해야 한다.
여기서 한 가지 더 중요한 점이 있다.
start()를 호출했다고 해서 그 순간 바로run()이 즉시 눈앞에서 실행된다고 생각하면 안 된다.
먼저 실행 가능한 상태로 들어가고, 그다음 자기 차례를 받았을 때 실제 실행이 시작된다고 이해하는 것이 더 정확하다.
즉,start()는 바로 작업을 실행한다기보다, 새스레드를 실행 가능한 흐름으로 올려놓는 호출에 가깝다.
왜 이 차이가 그렇게 중요한가
run()을 직접 호출하면 새스레드가 생기지 않는다.- 그래서 코드는 비슷해 보여도 실제 실행 결과는 달라진다.
- 초보자가
스레드를 만들었는데도멀티 스레드처럼 안 보이는 가장 흔한 이유가 여기 있다.즉, 겉보기에는 둘 다
run()이 실행되기 때문에 비슷해 보일 수 있다.
하지만 중요한 것은 누가run()을 실행했느냐다.
현재 흐름이 직접 실행한 것인지, 새스레드가 실행한 것인지에 따라 의미가 완전히 달라진다.
같은
Thread객체를 다시 시작할 수는 없다
- 한 번
start()한Thread객체에 다시start()를 호출할 수는 없다.- 이미 시작된
스레드는 처음 시작 상태로 되돌아가지 않기 때문이다.- 다시 실행하고 싶다면 새로운
Thread객체를 만들어야 한다.초보자는 같은 객체에
start()를 다시 호출하면 처음처럼 한 번 더 시작될 것 같다고 느끼기 쉽다.
하지만스레드는 한 번 시작되면 상태가 바뀌고, 종료된 뒤에도 그 객체를 다시 새것처럼 되돌려 쓸 수는 없다.
그래서 같은 작업을 다시 돌리고 싶다면 기존Thread객체를 재사용하는 것이 아니라 새Thread객체를 다시 만들어서 시작해야 한다.
개념을 예제로 확인하기
ThreadEx01은 두 가지 생성 방법을 같이 보여준다
- 하나는
Thread클래스를 상속한다.- 다른 하나는
Runnable인터페이스를 구현한다.- 그리고 두 객체를 각각
start()로 실행한다.이 예제는 “만드는 방법은 두 가지지만, 결국 둘 다 새 실행 흐름으로 돌릴 수 있다”는 점을 보여 준다.
// ThreadEx01.java
class ThreadEx1_1 extends Thread {
    public void run() {
        for (int i = 0; i < 5; i++) {
            System.out.println(getName()); // 자기 스레드 이름 출력
        }
    }
}
class ThreadEx1_2 implements Runnable {
    public void run() {
        for (int i = 0; i < 5; i++) {
            System.out.println(Thread.currentThread().getName()); // 현재 스레드 이름 출력
        }
    }
}
class ThreadEx01 {
    public static void main(String args[]) {
        ThreadEx1_1 t1 = new ThreadEx1_1(); // Thread 상속 방식
        Runnable r = new ThreadEx1_2(); // Runnable 구현 방식
        Thread t2 = new Thread(r); // Runnable을 Thread에 넣음
        t1.start(); // 첫 번째 스레드 시작
        t2.start(); // 두 번째 스레드 시작
    }
}
// 출력결과 // Thread-0 // Thread-1 // Thread-0 // Thread-1 // ... // 실행 순서는 섞여 나올 수 있다.이 예제의 핵심은 방법이 달라도 결국
start()를 호출하면 각각 별도의 실행 흐름으로 움직인다는 점이다.
여기서Runnable쪽은Thread를 직접 상속한 클래스가 아니기 때문에getName()을 바로 쓰지 않고,Thread.currentThread()로 지금 실제 실행 중인스레드를 가져와 이름을 확인한다.
또 출력 순서가 항상 같지 않을 수 있다는 점도 함께 확인할 수 있다.
ThreadEx02는start()를 호출한 경우다
t1.start()를 호출한다.- 그러면 새로운 실행 흐름이 시작되고, 그 안에서
run()이 실행된다.이 예제는 코드 길이는 짧지만 의미는 매우 크다.
start()가 단순히run()을 대신 불러 주는 메서드가 아니라, 새로운스레드를 시작시키는 호출이라는 점을 보여 준다.// ThreadEx02.java class ThreadEx02 { public static void main(String args[]) throws Exception { ThreadEx2_1 t1 = new ThreadEx2_1(); t1.start(); // 새 스레드 시작 } } class ThreadEx2_1 extends Thread { public void run() { throwException(); // 새 스레드 안에서 실행 } public void throwException() { try { throw new Exception(); // 예외 발생 } catch (Exception e) { e.printStackTrace(); // 호출 흐름 출력 } } }// 출력결과 // java.lang.Exception // ... // run() 쪽 호출 흐름이 출력된다. // 새 스레드 안에서 작업이 실행된다고 이해하면 된다.여기서 꼭 남겨야 하는 핵심은
run()이 실행되기는 하지만, 그것이 현재 흐름에서 바로 호출된 것이 아니라 새스레드안에서 실행된 것이라는 점이다.
ThreadEx03은run()을 직접 호출한 경우다
- 이번에는
t1.start()가 아니라t1.run()을 직접 호출한다.- 그러면 새로운
스레드가 생기지 않는다.- 그냥 현재 실행 흐름에서 일반 메서드처럼
run()이 실행된다.이 예제는
ThreadEx02와 꼭 비교해서 봐야 한다.
겉모양은 거의 비슷하지만 실제 의미는 완전히 다르다.// ThreadEx03.java class ThreadEx03 { public static void main(String args[]) throws Exception { ThreadEx3_1 t1 = new ThreadEx3_1(); t1.run(); // 그냥 메서드 직접 호출 } } class ThreadEx3_1 extends Thread { public void run() { throwException(); // 현재 흐름에서 실행 } public void throwException() { try { throw new Exception(); // 예외 발생 } catch (Exception e) { e.printStackTrace(); // 호출 흐름 출력 } } }// 출력결과 // java.lang.Exception // ... // 예외는 출력되지만 새 스레드가 생긴 것은 아니다. // 현재 실행 흐름에서 run()이 직접 호출된 것이다.즉,
ThreadEx02와ThreadEx03의 차이는 “예외가 출력되느냐”가 아니다.
겉으로 보이는 예외 출력은 비슷할 수 있지만, 핵심은 그 코드를 현재 흐름이 실행했는지, 아니면 새로 시작된스레드가 실행했는지다.
새 실행 흐름이 생겼느냐 아니냐가 핵심이다.
이 세 예제를 같이 보면 무엇이 보이는가
ThreadEx01은스레드를 만드는 두 가지 방법을 보여 준다.ThreadEx02는start()를 써야 새스레드가 시작된다는 점을 보여 준다.ThreadEx03은run()을 직접 호출하면 그냥 일반 메서드 호출처럼 동작한다는 점을 보여 준다.즉, 이 세 예제는 각각 따로 외우는 것이 아니라 하나로 연결해서 봐야 한다.
먼저 만드는 방법 두 가지를 알고, 그다음 실제로 실행을 시작시키는 것은start()라는 점을 확인하면 흐름이 훨씬 분명해진다.
이 주제에서 꼭 남겨야 하는 핵심
지금 단계에서는 이렇게 이해하면 된다
스레드를 만드는 방법은Thread상속 방식과Runnable구현 방식 두 가지다.- 두 방법 모두 실제 작업 내용은
run()안에 적는다.run()은 작업 내용이고,start()는 새 실행 흐름을 시작시키는 호출이다.run()을 직접 호출하면 새스레드가 생기지 않는다.멀티 스레드를 만들고 싶다면 반드시start()를 호출해야 한다.이 다섯 줄만 정확히 잡고 있으면, 뒤에서 나오는
join(),sleep(),interrupt()같은 제어 메서드도 훨씬 쉽게 이해된다.
즉, 지금 이 주제의 핵심은 문법이 아니라 새 실행 흐름이 언제 실제로 시작되는지를 구분하는 것이다.
실행 중인 스레드를 어떻게 구분하고 제어하는가
멀티 스레드에서는 실행 흐름이 여러 개이기 때문에, 지금 누가 일하고 있는지를 구분할 수 있어야 한다.
그래야 출력이 섞여 나와도 어떤스레드가 만든 결과인지 해석할 수 있고, 필요한 순간에는 특정스레드가 끝날 때까지 기다리게 만들 수도 있다.
이 주제에서는 먼저 현재 실행 중인스레드를 어떻게 확인하는지, 스레드 이름은 왜 필요한지, 그리고join()이 정확히 어떤 역할을 하는지를 쉬운 말로 잡는다.
현재 실행 중인 스레드는 어떻게 확인하는가
프로그램도 처음에는 하나의 스레드에서 시작한다
- 자바 프로그램은 보통
main()에서 시작한다.- 그런데
main()메서드도 그냥 혼자 실행되는 것이 아니라, 하나의스레드안에서 실행된다.- 이 시작 흐름을 보통
메인 스레드라고 부른다.즉, 프로그램이 시작되었다는 말은 그냥 코드가 저절로 흐른다는 뜻이 아니다.
처음부터main()을 실행하는 기본스레드가 하나 있고, 그 흐름 위에서 프로그램이 시작된다고 이해하면 된다.
그래서 뒤에서 다른 작업 스레드를 새로 만들어도, 기준이 되는 출발점은 항상메인 스레드다.
초보자 단계에서는 프로그램은 기본적으로메인 스레드하나에서 시작하고, 필요하면 작업 스레드를 추가한다고 이해하면 충분하다.
Thread.currentThread()는 지금 실행 중인 스레드를 돌려준다
- 현재 이 코드를 실제로 실행하고 있는
스레드가 누구인지 알고 싶을 때Thread.currentThread()를 사용한다.- 이 메서드는 말 그대로 “지금 일하고 있는
스레드객체”를 돌려준다.이 메서드가 중요한 이유는,
멀티 스레드에서는 같은 코드처럼 보여도 실제로 누가 실행했는지가 다를 수 있기 때문이다.
예를 들어main()안에서 호출하면메인 스레드를 돌려주고, 작업 스레드 안에서 호출하면 그 작업 스레드를 돌려준다.
즉,Thread.currentThread()는 “현재 실행 주체가 누구인가”를 확인하는 도구라고 이해하면 된다.
스레드 이름은 왜 필요한가
여러 스레드가 함께 돌면 출력이 섞일 수 있다
멀티 스레드에서는 여러 실행 흐름이 함께 움직인다.- 그래서 콘솔 출력도 섞여 나올 수 있다.
- 이때 이름이 없으면 어떤 출력이 어느
스레드에서 나온 것인지 구분하기 어렵다.초보자가
멀티 스레드예제를 처음 보면 출력 순서가 일정하지 않아서 코드가 틀린 것처럼 느낄 수 있다.
하지만 실제로는 여러스레드가 번갈아 실행되면서 각자 자기 출력을 남기기 때문에 섞여 보이는 경우가 많다.
그래서스레드이름을 같이 출력하면 훨씬 해석하기 쉬워진다.
즉, 이름은 단순한 장식이 아니라 지금 누가 실행 중인지 구분하는 표식이다.
이름을 정하는 방법도 여러 가지다
setName()으로 직접 이름을 붙일 수 있다.- 생성자에서 이름을 넘겨줄 수도 있다.
- 이름을 따로 정하지 않으면 기본 이름이 붙을 수도 있다.
중요한 것은 어떤 방법을 쓰느냐보다, 각 작업 흐름을 사람이 알아보기 쉽게 구분할 수 있느냐다.
그래서 예제에서는ThreadA,ThreadB처럼 이름을 확인하기 쉽게 맞춰 두는 경우가 많다.
초보자 입장에서는스레드를 만들었다는 사실만 보는 것보다, 이름을 통해 각 흐름을 눈에 보이게 만드는 것이 훨씬 이해에 도움이 된다.
이름 말고도 우선순위와 그룹으로 구분할 수 있다
스레드는 이름만 있는 것이 아니다.- 어떤
스레드는 더 먼저 실행 기회를 받도록 우선순위를 가질 수 있고, 여러스레드를 하나의 그룹으로 묶어서 관리할 수도 있다.우선순위는 말 그대로 “실행 기회를 어느 정도 더 얻기 쉬운가”를 나타내는 값이라고 보면 된다.
다만 이것이 항상 절대적인 순서를 강제로 만드는 것은 아니다.
초보자 단계에서는 실행 기회를 조절하는 힌트 같은 값이라고 이해하면 충분하다.
스레드 그룹은 여러스레드를 묶어서 관리하기 위한 단위다.
이름을 보면 각각의스레드를 구분할 수 있고, 그룹을 보면 그스레드들이 어떤 묶음으로 관리되는지도 볼 수 있다.
특별히 지정하지 않으면 보통 기본 흐름인main쪽 그룹에 포함된다고 이해하면 된다.
join()은 무엇을 하는가
join()은 끝날 때까지 기다리게 만드는 메서드다
join()은 어떤스레드가 끝날 때까지 다른 쪽 흐름이 기다리게 만드는 메서드다.- 쉽게 말하면 “저 작업 끝나면 그다음 하자”에 가깝다.
이 메서드는
스레드를 멈춰 버리는 것이 아니다.
정확히는 다른 쪽이 끝날 때까지 현재 흐름이 잠깐 기다리게 만드는 것이다.
예를 들어 작업 스레드 여러 개를 먼저 시작해 놓고, 그 작업이 다 끝난 뒤에 마지막 결과를 출력하고 싶을 수 있다.
그럴 때join()을 사용하면메인 스레드가 작업 스레드가 끝날 때까지 기다렸다가 뒤 코드를 실행하게 만들 수 있다.
join()은 실행 순서를 하나로 고정하는 메서드는 아니다
join()은 모든 출력을 차례대로 정렬해 주는 기능이 아니다.- 각 작업 스레드가 실행되는 동안의 순서는 여전히 섞일 수 있다.
- 다만 그 스레드가 끝나기 전에는 다음 코드로 넘어가지 않게 만드는 역할을 한다.
이 부분을 많이 헷갈린다.
join()을 썼다고 해서 처음부터 끝까지 모든 실행 순서가 한 줄로 정리되는 것은 아니다.
작업 스레드들끼리는 여전히 번갈아 실행될 수 있다.
중요한 것은 마지막 시점이다.
즉,join()은 작업 중간의 순서를 정리하는 것이 아니라, 뒤에 있는 코드의 실행 시점을 늦추는 것이라고 이해하면 정확하다.
개념을 예제로 확인하기
ThreadEx08은 스레드 이름을 구분하는 예제다
- 먼저
Thread.currentThread()로 현재 실행 중인메인 스레드를 가져온다.- 그다음 여러 작업 스레드를 만들고, 각 이름을 확인한 뒤 실행한다.
- 이름을 붙이는 방식도 같이 보여 준다.
이 예제는 “프로그램은
메인 스레드에서 시작한다”는 점과 “작업 스레드는 이름으로 구분해서 보는 것이 좋다”는 점을 함께 보여 준다.// ThreadEx08.java public class ThreadEx08 { public static void main(String[] args) { Thread mainThread = Thread.currentThread(); // 현재 실행 중인 메인 스레드 System.out.println("[ 프로그램 시작 스레드 이름 ] : " + mainThread.getName()); ThreadA threadA = new ThreadA(); // setName()으로 이름 지정 ThreadB threadB = new ThreadB("ThreadB"); // 생성자로 이름 지정 ThreadC threadC = new ThreadC(); // 기본 이름 사용 System.out.println("작업 스레드 이름: " + threadA.getName()); System.out.println("작업 스레드 이름: " + threadB.getName()); System.out.println("작업 스레드 이름: " + threadC.getName()); threadA.start(); threadB.start(); threadC.start(); for (int i = 0; i < 3; i++) { System.out.println("프로그램 시작 스레드 이름: " + mainThread.getName()); } } } class ThreadA extends Thread { public ThreadA() { setName("ThreadA"); // 이름 직접 지정 } public void run() { for (int i = 0; i < 2; i++) { System.out.println(getName() + "가 출력한 내용"); } } } class ThreadB extends Thread { public ThreadB(String name) { super(name); // 생성자로 이름 전달 } public void run() { for (int i = 0; i < 2; i++) { System.out.println(getName() + "가 출력한 내용"); } } } class ThreadC extends Thread { public void run() { for (int i = 0; i < 2; i++) { System.out.println(getName() + "가 출력한 내용"); } } }// 출력결과 // [ 프로그램 시작 스레드 이름 ] : main // 작업 스레드 이름: ThreadA // 작업 스레드 이름: ThreadB // 작업 스레드 이름: Thread-0 // main // ThreadA가 출력한 내용 // ThreadB가 출력한 내용 // ... // 실제 출력 순서는 섞여 나올 수 있다.이 예제의 핵심은
메인 스레드도 하나의스레드라는 점, 그리고 작업 스레드는 이름을 통해 훨씬 쉽게 구분할 수 있다는 점이다.
ThreadEx09는join()의 의미를 보여 준다
- 여러 작업 스레드를 시작한 뒤
join()을 호출한다.- 그러면
메인 스레드는 그 작업 스레드들이 끝날 때까지 기다린다.- 그래서 뒤쪽의
main관련 출력은 작업이 끝난 다음에 나온다.이 예제는
join()이 왜 필요한지 가장 직접적으로 보여 준다.
작업 스레드를 먼저 시작하는 것만으로는,메인 스레드가 곧바로 아래 코드를 계속 실행해 버릴 수 있다.
그런데join()을 넣으면 작업이 끝날 때까지 기다렸다가 다음 코드로 넘어가게 된다.// ThreadEx09.java public class ThreadEx09 { public static void main(String[] args) throws Exception { Thread mainThread = Thread.currentThread(); // 메인 스레드 확인 ThreadD threadA = new ThreadD(); ThreadE threadB = new ThreadE("ThreadE"); ThreadF threadC = new ThreadF(); threadA.start(); // 작업 스레드 시작 threadB.start(); // 작업 스레드 시작 threadC.start(); // 작업 스레드 시작 threadA.join(); // A가 끝날 때까지 기다림 threadB.join(); // B가 끝날 때까지 기다림 threadC.join(); // C가 끝날 때까지 기다림 for (int i = 0; i < 3; i++) { System.out.println("프로그램 시작 스레드 이름: " + mainThread.getName()); } } }// 출력결과 // ThreadD가 출력한 내용 // ThreadE가 출력한 내용 // Thread-1가 출력한 내용 // ... // 프로그램 시작 스레드 이름: main // 프로그램 시작 스레드 이름: main // 프로그램 시작 스레드 이름: main여기서 중요한 것은 작업 스레드끼리의 출력 순서는 여전히 섞일 수 있다는 점이다.
하지만main관련 마지막 출력은join()때문에 작업 스레드들이 끝난 뒤에 나오게 된다.
즉,join()은 마지막 진행 시점을 뒤로 미루는 역할을 한다.
이 주제에서 꼭 남겨야 하는 핵심
지금 단계에서는 이렇게 이해하면 된다
- 프로그램은 기본적으로
메인 스레드에서 시작한다.Thread.currentThread()는 지금 실행 중인스레드를 확인할 때 사용한다.스레드이름을 보면 여러 실행 흐름을 훨씬 쉽게 구분할 수 있다.join()은 다른스레드가 끝날 때까지 현재 흐름을 기다리게 만든다.join()은 전체 순서를 하나로 만드는 것이 아니라, 뒤 코드의 실행 시점을 늦추는 메서드다.즉, 이 주제의 핵심은 여러
스레드를 만들었다는 사실보다, 지금 누가 실행 중인지 구분하고, 필요한 순간에는 어느 흐름이 끝날 때까지 기다리게 만들 수 있어야 한다는 점이다.
이 감각을 잡고 나면 뒤에서 배우는스레드 상태,sleep(),interrupt()도 훨씬 쉽게 이어진다.
스레드 상태는 어떻게 바뀌는가
스레드는 한 번 시작되면 끝날 때까지 같은 상태로만 움직이지 않는다.
실행을 기다리기도 하고, 실제로 일하기도 하고, 잠깐 멈추기도 하고, 마지막에는 종료되기도 한다.
초보자가 여기서 가장 헷갈리는 이유는 상태 이름이 많아서가 아니라, 왜 그 상태로 바뀌는지 흐름이 잘 안 보이기 때문이다.
그래서 이 주제에서는 용어를 외우기보다, 어떤 메서드가 상태를 바꾸고 왜 그렇게 되는지를 먼저 쉬운 말로 잡아야 한다.
스레드는 계속 같은 상태로만 있는 것이 아니다
크게 보면 이렇게 상태가 바뀐다
스레드는 시작 전 상태에 있다가 실행 가능한 상태가 된다.- 실행 중에는 실제로 코드를 수행한다.
- 어떤 상황에서는 잠깐 멈춘다.
- 일이 끝나면 마지막에는 종료 상태가 된다.
처음 배울 때는 상태 이름을 전부 한꺼번에 외우려고 하지 않아도 된다.
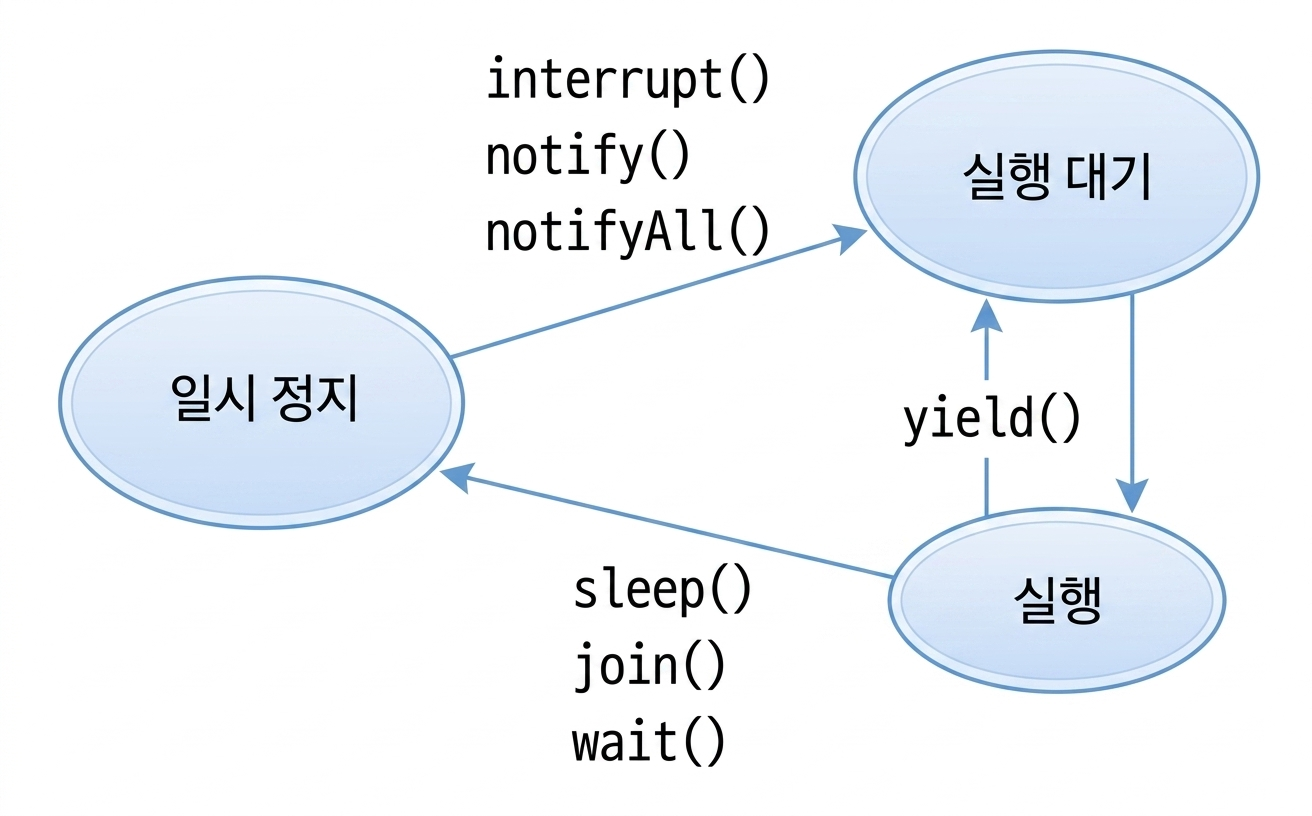
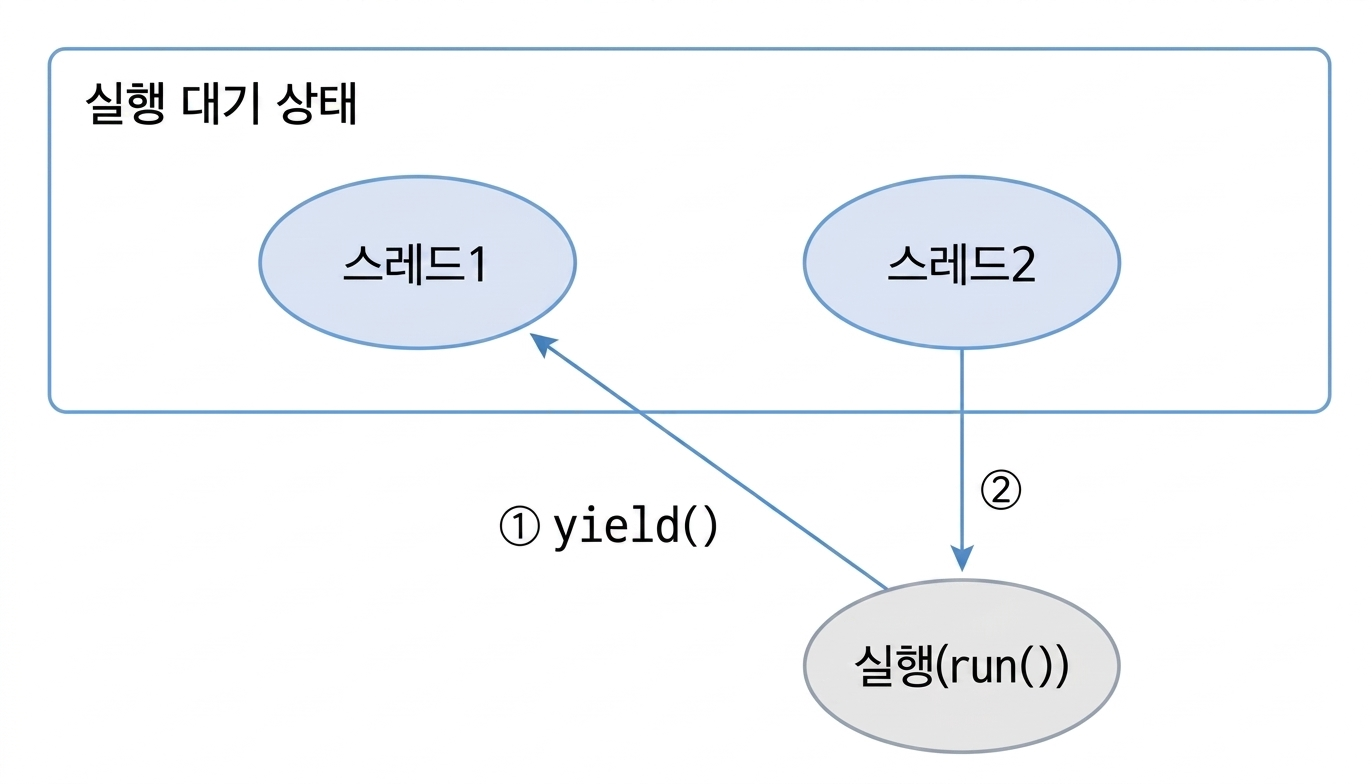
이 단계에서는 실행 대기 → 실행 → 일시 정지 → 다시 실행 → 종료라는 큰 흐름을 먼저 이해하는 것이 더 중요하다.
예를 들어start()를 호출했다고 해서 바로 계속 일만 하는 것이 아니다.
실행을 기다릴 수도 있고, 잠깐 쉬었다가 다시 움직일 수도 있다.
즉,스레드는 상황에 따라 상태를 바꾸면서 움직인다.
스레드는 실행하다가 잠깐 멈출 수도 있고, 다시 실행 대기 상태로 돌아갈 수도 있다.
interrupt(),notify(),notifyAll()은 멈춘 흐름을 다시 움직일 수 있게 하고,sleep(),join(),wait()는 실행 중인 흐름을 잠시 멈추게 만든다.
실행 대기 상태와 실행 상태는 무엇이 다른가
- 실행 대기 상태는 당장 실행할 준비는 되었지만 아직 실제로 일하고 있지는 않은 상태다.
- 실행 상태는 실제로 코드를 수행하고 있는 상태다.
이 둘은 비슷해 보여서 자주 헷갈린다.
하지만 차이는 분명하다.
실행 대기 상태는 “이제 일할 준비는 끝났고 차례를 기다리는 상태”에 가깝고, 실행 상태는 “지금 실제로 일하고 있는 상태”에 가깝다.
즉,start()를 호출했다고 해서 항상 그 순간 바로 실행 상태가 된다고만 보면 안 된다.
먼저 실행 가능한 상태가 되고, 그다음 실제 실행 흐름으로 들어간다고 이해하면 자연스럽다.
다만 실제 상태 값을 확인할 때는 우리가 설명에서 나눈 것처럼 둘이 항상 따로 찍히지는 않을 수 있다.
예를 들어Thread.State에서 보이는RUNNABLE은 초보자가 말로 이해하는 실행 대기와 실행 중을 넓게 묶어서 보여 줄 수 있다.
그래서 개념 설명에서는 둘을 나눠 이해해도 되지만, 실제 상태 이름에서는 하나로 보일 수 있다는 점을 같이 기억해야 덜 헷갈린다.
일시 정지 상태는 왜 생기는가
스레드는 계속 일만 하지 않는다.- 어떤 메서드를 만나거나, 다른 작업이 끝나기를 기다리거나, 일정 시간 쉬어야 할 때 잠깐 멈춘다.
이 멈춤은 “작업이 완전히 끝났다”는 뜻이 아니다.
그냥 잠시 기다리고 있는 상태다.
그래서 조건이 맞으면 다시 실행 가능한 상태로 돌아가고, 다시 실행될 수 있다.
즉, 일시 정지는 종료와 다르다.
스레드가 없어지는 것이 아니라, 지금은 잠깐 쉬거나 기다리는 중인 상태라고 보면 된다.
어떤 메서드가 상태를 바꾸는가
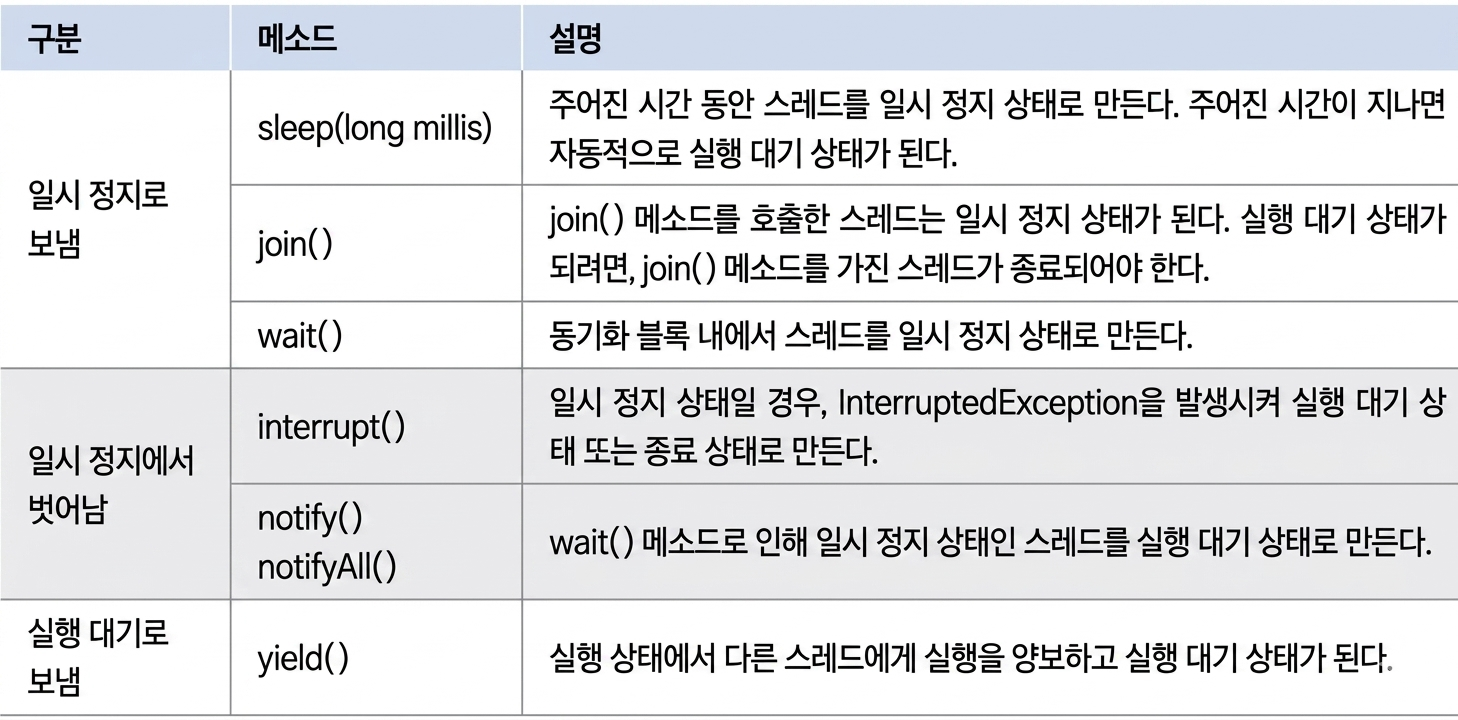
sleep(),join(),wait()는 실행 중인 흐름을 잠깐 멈추게 만든다
sleep()은 정해진 시간 동안 현재스레드를 쉬게 만든다.join()은 다른스레드가 끝날 때까지 현재 흐름을 기다리게 만든다.wait()는 동기화 구역 안에서 기다리게 만든다.이 셋은 공통점이 있다.
모두 지금 실행 중인 흐름을 바로 앞으로 나가게 하지 않고 잠깐 멈추게 만든다는 점이다.
하지만 멈추는 이유는 다르다.
sleep()은 시간을 기준으로 쉬는 것이고,join()은 다른스레드의 종료를 기다리는 것이고,wait()는 어떤 조건이 맞을 때까지 기다리는 쪽에 가깝다.
여기서join()도 계속 무조건 기다리기만 하는 메서드로 보면 안 된다.
대기 중인 흐름은interrupt()신호를 받으면sleep()처럼 기다림에서 빠져나올 수 있다.
즉,join()도 “기다리는 상태”를 만드는 메서드라는 점에서 실행 제어 흐름과 연결해서 봐야 한다.
처음에는 세부 차이를 깊게 파기보다, 셋 다 지금 흐름을 잠시 멈춘다는 공통점을 먼저 잡으면 된다.
sleep(),join(),wait()는 실행 중인스레드를 잠시 멈추게 만든다.
반대로interrupt(),notify(),notifyAll()은 멈춘 흐름이 다시 실행 가능한 상태로 돌아가게 만드는 쪽에 가깝다.
interrupt(),notify(),notifyAll()은 멈춘 흐름을 다시 움직이게 할 수 있다
interrupt()는 멈춰 있는스레드에게 신호를 주고,sleep()이나wait()같은 상태에서는 그 신호로 빠져나오게 될 수 있다.notify()와notifyAll()은wait()로 기다리던 흐름을 다시 깨우는 메서드다.이 셋도 공통점이 있다.
모두 멈춰 있던 흐름이 다시 움직일 수 있는 쪽으로 연결된다는 점이다.
다만interrupt()는 주로 “이제 멈춤 상태에서 빠져나와라”라는 신호 느낌이고,notify()계열은wait()로 기다리던 흐름을 다시 실행 가능하게 만든다고 이해하면 된다.
이 단계에서는 세부 동작 차이보다, 멈춘 흐름을 다시 실행 가능한 상태로 돌려보내는 역할이라는 큰 흐름을 먼저 잡는 것이 중요하다.
yield()는 다른 스레드에게 실행 기회를 양보하는 쪽에 가깝다
yield()는 지금 실행 중인스레드가 잠깐 비켜 주는 느낌의 메서드다.- 즉, 다른
스레드가 실행할 기회를 얻을 수 있게 양보하는 쪽에 가깝다.여기서 중요한 점은
yield()를 “무조건 상대에게 실행을 넘기는 강제 명령”처럼 이해하면 안 된다는 것이다.
이 단계에서는 현재 실행 흐름이 잠깐 양보해서 다른 흐름이 실행될 가능성을 높이는 메서드 정도로 이해하면 충분하다.
즉,sleep()처럼 시간을 정해 놓고 쉬는 것과는 다르다.
yield()는 쉬는 것이 아니라 양보하는 것에 가깝다.
yield()는 현재 실행 중인스레드가 잠깐 비켜서 다른스레드가 실행 기회를 얻을 수 있게 만드는 쪽에 가깝다.
상태 이름을 어떻게 보면 좋은가
처음에는 세세한 영어 이름보다 흐름으로 먼저 본다
- 시작 전 상태
- 실행 가능한 상태
- 실제 실행 중인 상태
- 잠깐 멈춘 상태
- 끝난 상태
처음부터 모든 상태 이름을 외우려고 하면 오히려 더 헷갈릴 수 있다.
그래서 먼저 “시작 전인지”, “실행 가능한지”, “실제로 실행 중인지”, “잠깐 멈췄는지”, “끝났는지”처럼 흐름으로 보는 것이 좋다.
그다음 예제를 보면서NEW,RUNNABLE,TERMINATED같은 이름을 연결하면 훨씬 쉽게 들어온다.
개념을 예제로 확인하기
ThreadEx10은 스레드 상태가 실제로 어떻게 바뀌는지 보여준다
StatePrintThread가TargetThread의 상태를 계속 확인한다.- 시작 전이면
NEW가 나온다.- 아직 시작하지 않았으면
start()를 호출한다.- 끝나면
TERMINATED가 나오고 반복을 멈춘다.이 예제는 상태를 단어로만 외우는 예제가 아니다.
실제로스레드가 움직이면서 상태가 바뀌는 모습을 눈으로 확인하게 해 주는 예제다.// ThreadEx10.java class ThreadEx10 { public static void main(String[] args) { StatePrintThread statePrintThread = new StatePrintThread(new TargetThread()); // 상태를 확인할 스레드 전달 statePrintThread.start(); // 상태 출력 스레드 시작 } } class StatePrintThread extends Thread { private Thread targetThread; // 상태를 볼 대상 스레드 public StatePrintThread(Thread targetThread) { this.targetThread = targetThread; // 대상 저장 } public void run() { while (true) { Thread.State state = targetThread.getState(); // 현재 상태 확인 System.out.println("타겟 스레드 상태: " + state); // 상태 출력 if (state == Thread.State.NEW) { System.out.println("START"); targetThread.start(); // 아직 시작 전이면 시작 } if (state == Thread.State.TERMINATED) { break; // 종료 상태면 반복 종료 } try { Thread.sleep(5); // 잠깐 쉬었다가 다시 상태 확인 } catch (Exception e) { } } } } class TargetThread extends Thread { public void run() { for (long i = 0; i < 100000; i++) { System.out.print("T"); // 실행 중 작업 } try { Thread.sleep(1500); // 일시 정지 상태로 들어감 } catch (Exception e) { } for (long i = 0; i < 1000000000; i++) { } } }// 출력결과 // 타겟 스레드 상태: NEW // START // 타겟 스레드 상태: RUNNABLE // 타겟 스레드 상태: RUNNABLE // ... // 타겟 스레드 상태: TIMED_WAITING // ... // 타겟 스레드 상태: RUNNABLE // ... // 타겟 스레드 상태: TERMINATED출력 순서나 반복 횟수는 실행할 때마다 조금 달라질 수 있다.
하지만 큰 흐름은 같다.
처음에는 시작 전 상태였다가, 실행 가능한 상태와 실행 중 흐름을 거치고,sleep()때문에 잠깐 멈췄다가, 마지막에는 종료 상태가 된다.
이 예제에서 꼭 봐야 하는 부분
getState()로 현재 상태를 확인한다.NEW면 아직 시작 전이라는 뜻이다.sleep()이 실행되면 잠깐 멈춘 상태가 나타날 수 있다.- 작업이 끝나면 마지막에는
TERMINATED가 된다.즉, 이 예제는
스레드가 처음부터 끝까지 한 상태로만 움직이지 않는다는 점을 보여 준다.
그래서 뒤에서interrupt(),join(),yield()같은 메서드를 배울 때도 “아, 상태를 바꾸는 흐름이구나”라고 연결해서 볼 수 있다.
이 주제에서 꼭 남겨야 하는 핵심
지금 단계에서는 이렇게 이해하면 된다
스레드는 시작 전, 실행 가능, 실행 중, 일시 정지, 종료처럼 상태를 바꾸며 움직인다.sleep(),join(),wait()는 실행 중인 흐름을 잠시 멈추게 만든다.interrupt(),notify(),notifyAll()은 멈춘 흐름이 다시 움직일 수 있게 만든다.yield()는 다른스레드에게 실행 기회를 양보하는 쪽에 가깝다.- 중요한 것은 이름을 외우는 것보다 왜 그 상태로 바뀌는지 흐름을 이해하는 것이다.
즉, 이 주제의 핵심은 상태 이름 자체가 아니라,
스레드가 상황에 따라 계속 상태를 바꾸며 움직이고, 여러 메서드는 그 흐름을 바꾸는 역할을 한다는 점이다.
이 감각을 잡고 나면 뒤의interrupt()와 안전한 종료도 훨씬 쉽게 이해된다.
스레드는 어떻게 안전하게 종료하는가
스레드를 끝낸다는 것은 단순히 멈추게 하는 것이 아니다.
실제로는 반복을 빠져나오고, 쓰던 자원을 정리하고,run()을 자연스럽게 끝내는 것이 더 중요하다.
초보자는 보통 “그냥 멈추면 되는 것 아닌가”라고 생각하기 쉽다.
하지만스레드가 파일을 쓰는 중이거나, 데이터를 바꾸는 중이거나, 다른 작업과 함께 움직이는 중이라면 갑자기 끊는 방식은 문제를 만들 수 있다.
그래서 이 주제에서는 왜 강제 종료가 위험한지, 안전하게 종료하는 방법은 무엇인지,interrupt()는 어떤 식으로 쓰는지를 차례대로 이해해야 한다.
왜 강제로 바로 끊으면 안 되는가
갑자기 멈추면 정리할 시간이 없어진다
- 예전에는
stop()같은 강제 종료 방식이 있었지만 지금은 더 이상 권장하지 않는다.- 이유는 아주 단순하다.
스레드를 작업 중간에 갑자기 끊어 버리면, 그 뒤에 해야 할 정리 작업이 실행되지 못할 수 있기 때문이다.예를 들어 어떤
스레드가 파일을 열어 두고 작업 중이거나, 공유 데이터를 수정하고 있는 중이라고 생각해 보면 이해가 쉽다.
이때 중간에 갑자기 끊어 버리면 파일이 제대로 닫히지 않을 수도 있고, 값이 애매한 상태로 남을 수도 있다.
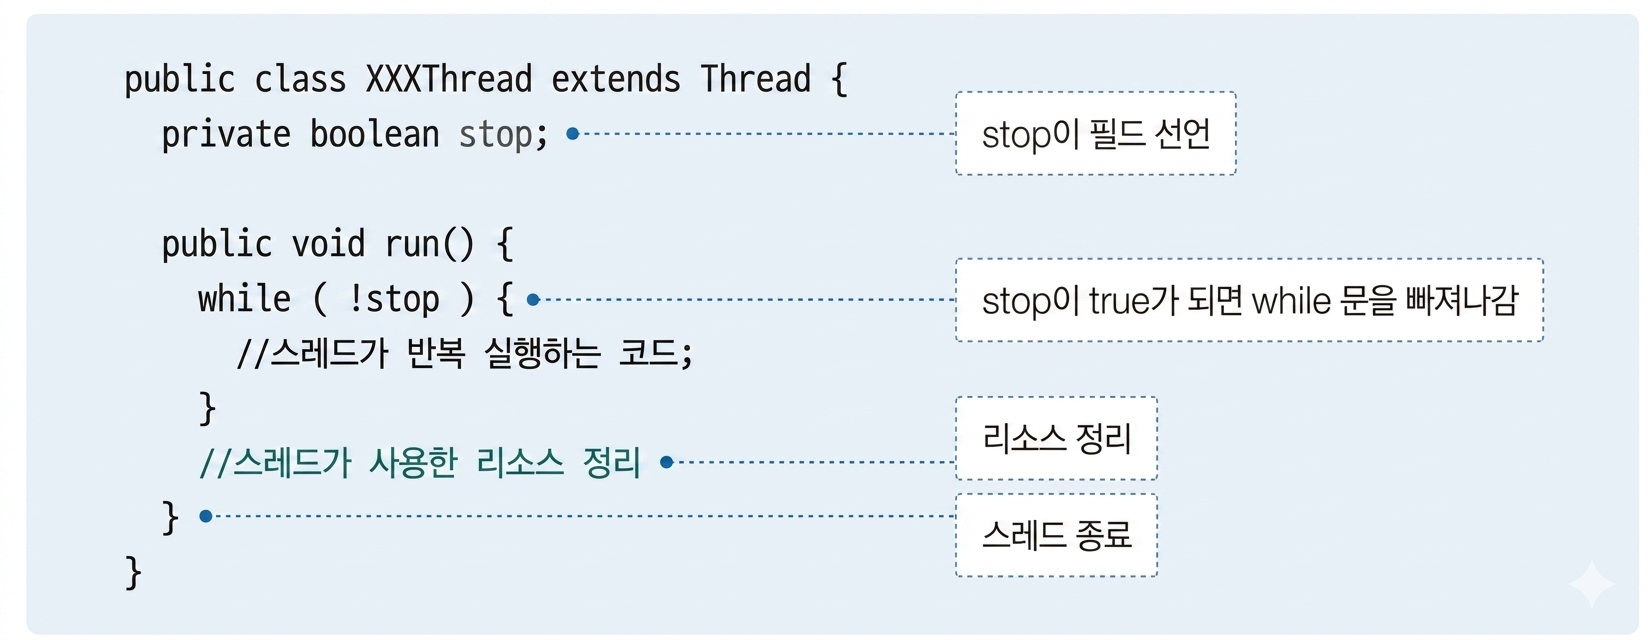
즉, 안전한 종료의 핵심은 “지금 당장 없애기”가 아니라 정리할 기회를 주고 끝내기다.
스레드종료는 끊는 기술이 아니라, 정리하고 빠져나오게 만드는 기술에 가깝다.
그래서
stop(),suspend(),resume()은 안전하지 않다
- 예전에는
stop(),suspend(),resume()같은 메서드로스레드를 직접 멈추거나 다시 움직이게 하는 방식이 있었다.- 하지만 이런 방식은 작업 중간에 흐름을 끊어서 정리 기회를 빼앗을 수 있기 때문에 안전하지 않다.
- 그래서 지금은 이런 식의 강한 제어보다, 종료 신호를 주고 스스로 빠져나오게 만드는 흐름이 더 중요하다.
예를 들어 어떤
스레드가 공유 데이터를 바꾸는 중이거나 자원을 열어 둔 상태에서 갑자기 멈추면, 값이 어중간한 상태로 남을 수 있다.
그래서 안전한 종료는 “강제로 끊기”보다 반복을 빠져나오고 정리 후 끝내기에 더 가깝다.
그래서 종료도 흐름으로 처리해야 한다
- 반복 중이면 반복문을 빠져나오게 한다.
- 빠져나온 뒤에는 필요한 정리 작업을 한다.
- 마지막에
run()이 끝나면서 자연스럽게 종료되게 만든다.즉, 안전한 종료는 보통 이런 순서로 이해하면 된다.
종료 신호 전달 → 반복 중단 → 자원 정리 →run()종료
이 흐름을 기억하고 예제를 보면boolean값으로 끝내는 방식과interrupt()로 끝내는 방식이 훨씬 쉽게 보인다.
가장 쉬운 방법은 종료 신호 값을 두는 것이다
반복을 멈출지 말지를 값으로 결정한다
- 가장 단순한 방법은 종료용
boolean값을 두는 것이다.- 반복문은 그 값을 계속 확인한다.
- 값이 바뀌면 반복을 빠져나오고 정리 후 종료한다.
이 방법이 쉬운 이유는 흐름이 눈에 잘 보이기 때문이다.
“지금은 계속 실행”, “이제는 멈춰라”를 값 하나로 표현할 수 있어서 초보자가 이해하기 좋다.
즉,스레드를 억지로 죽이는 것이 아니라 스스로 반복을 멈추고 끝으로 가게 만드는 방식이다.
종료용
boolean값을 두면, 반복문을 빠져나온 뒤 자원을 정리하고 자연스럽게run()을 끝내는 흐름으로 안전하게 종료할 수 있다.
ThreadEx12는 종료 플래그 방식을 보여준다
stop값이false일 때는 계속 실행한다.stop값이true가 되면 반복문을 빠져나온다.- 그다음 자원 정리와 종료 메시지를 출력하고 끝난다.
// ThreadEx12.java
public class ThreadEx12 {
    public static void main(String[] args) {
        PrintThread1 printThread = new PrintThread1(); // 작업 스레드 생성
        printThread.start(); // 스레드 시작
        try {
            Thread.sleep(1000); // 잠깐 실행하게 둠
        } catch (InterruptedException e) {
        }
        printThread.setStop(true); // 종료 신호 전달
    }
}
class PrintThread1 extends Thread {
    private boolean stop; // 종료 여부 저장
    public void setStop(boolean stop) {
        this.stop = stop; // 종료 신호 설정
    }
    public void run() {
        while (!stop) { // stop이 false인 동안 반복
            System.out.println("실행 중");
        }
        System.out.println("자원 정리"); // 반복 종료 후 정리
        System.out.println("실행 종료"); // 종료 메시지
    }
}
// 출력결과 // 실행 중 // 실행 중 // 실행 중 // ... // 자원 정리 // 실행 종료이 예제의 핵심은
스레드를 갑자기 없애지 않는다는 점이다.
종료 신호를 받고, 반복을 멈추고, 정리한 뒤 끝난다.
즉, 안전하게 종료한다는 말이 실제 코드에서 어떻게 보이는지 가장 쉽게 보여 주는 예제다.
인터럽트는 바로 없애는 명령이 아니다
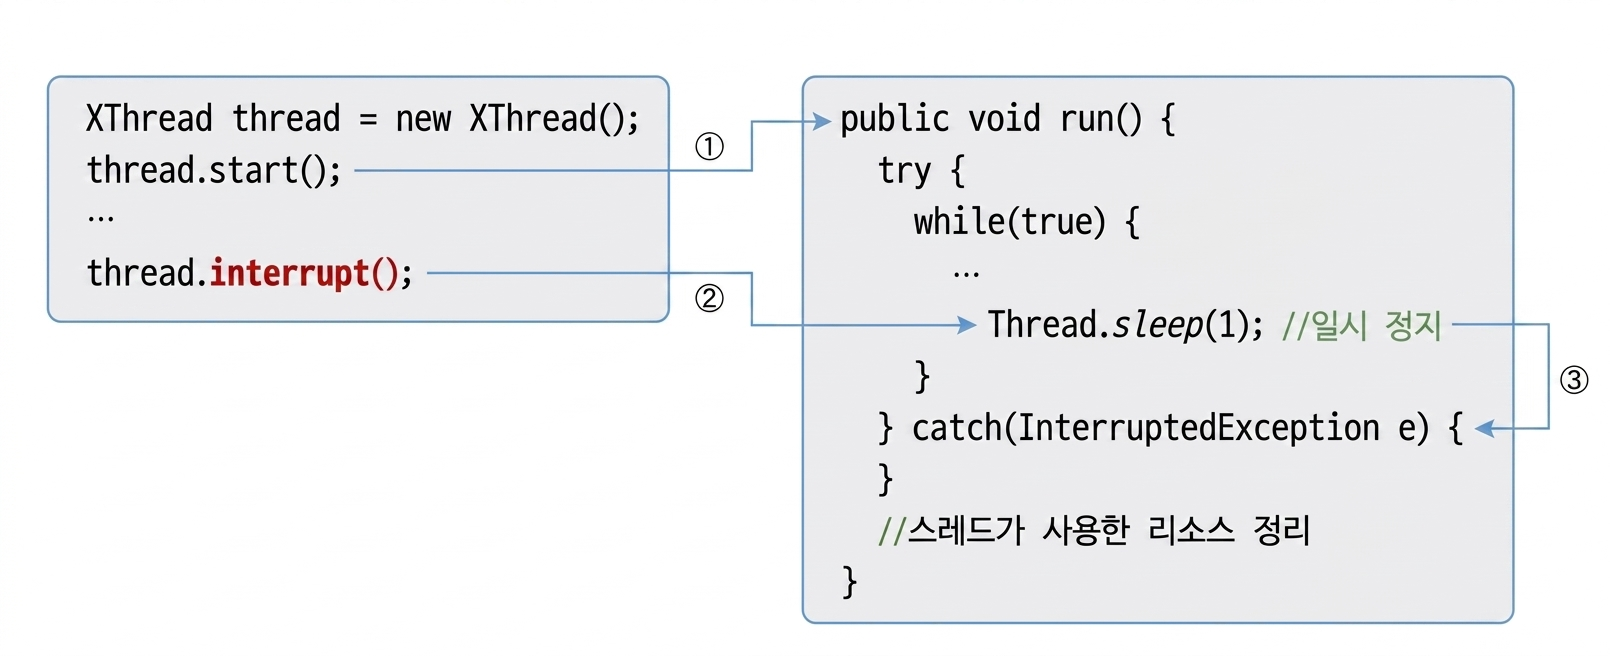
인터럽트는 멈추라고 신호를 주는 쪽에 가깝다
interrupt()는스레드를 즉시 삭제하는 명령이 아니다.- 지금 실행 중인 흐름에게 “이제 멈출 준비를 해라”라고 신호를 주는 쪽에 가깝다.
이 부분을 정확히 이해해야 한다.
초보자는interrupt()를 “끝내라”라는 직접 명령으로 오해하기 쉽다.
하지만 실제로는 멈춤 상태에서 빠져나오게 하거나, 반복문 안에서 종료 쪽으로 흐름을 바꾸게 만드는 신호에 가깝다.
그래서interrupt()를 받았다고 해서 무조건 같은 방식으로 끝나는 것은 아니다.
어떤 코드 안에 있느냐에 따라 반응 방식이 달라진다.
잠자고 있거나 기다리는 중이면 예외가 발생할 수 있다
sleep()처럼 잠깐 멈춰 있는 상태에서interrupt()를 받으면InterruptedException이 발생할 수 있다.- 그러면 그 예외를 이용해서 종료 흐름으로 연결할 수 있다.
이 방식은 특히 쉬운 편이다.
왜냐하면 잠자고 있던스레드가 예외를 통해 “이제 멈춤 상태를 끝내야 한다”는 신호를 눈에 보이게 받기 때문이다.
즉,interrupt()는 단독으로 마법처럼 종료시키는 것이 아니라, 예외 처리나 조건 검사와 함께 써야 안전한 종료 흐름이 완성된다.
interrupt()는 잠자고 있던스레드를 바로 없애는 것이 아니라,sleep()같은 일시 정지 상태에서 예외를 발생시켜 종료 흐름으로 빠져나오게 만드는 쪽에 가깝다.
ThreadEx11은 잠자고 있는 스레드에 인터럽트를 보내는 예제다
- 자식
스레드는 숫자를 출력하고sleep()으로 잠깐씩 쉰다.main쪽에서 중간에interrupt()를 보낸다.- 그러면 자식
스레드는InterruptedException을 만나고 종료 흐름으로 들어간다.// ThreadEx11.java class NewThread implements Runnable { public void run() { try { for (int i = 100; i > 94; i--) { System.out.println("Child Thread: " + i); // 자식 스레드 출력 Thread.sleep(500); // 잠깐 잠듦 } } catch (InterruptedException e) { System.out.println("Child interrupted.!!!!!"); // 인터럽트 신호 확인 } System.out.println("Exiting child thread."); // 종료 직전 메시지 } } class ThreadEx11 { public static void main(String args[]) { Thread t = new Thread(new NewThread(), "DEMO THREAD"); // 자식 스레드 생성 t.start(); // 자식 스레드 시작 try { for (int i = 5; i > 0; i--) { System.out.println("Main Thread: " + i); // 메인 스레드 출력 Thread.sleep(1000); // 잠깐 대기 if (i == 4) { t.interrupt(); // 자식 스레드에 인터럽트 전달 } } } catch (InterruptedException e) { System.out.println("Main thread interrupted."); } System.out.println("Main thread exiting."); // 메인 종료 } }// 출력결과 // Main Thread: 5 // Child Thread: 100 // Child Thread: 99 // Main Thread: 4 // Child Thread: 98 // Child interrupted.!!!!! // Exiting child thread. // Main thread exiting. // 실제 출력 순서는 실행할 때마다 조금 달라질 수 있다.이 예제에서 꼭 봐야 하는 것은
interrupt()를 보냈을 때 자식스레드가 바로 사라지는 것이 아니라,sleep()중 예외를 만나고 그 흐름을 통해 빠져나온다는 점이다.
인터럽트 상태를 직접 확인하면서 끝낼 수도 있다
반복문 안에서 종료 신호를 검사하는 방식이다
- 어떤 경우에는
sleep()예외에 기대지 않고, 반복문 안에서 직접 인터럽트 상태를 확인할 수도 있다.- 이 방식에서는 반복 중간중간 “종료 신호가 들어왔는가”를 체크하고, 맞으면 반복을 빠져나온다.
이 방식의 핵심도 같다.
중요한 것은 결국 반복을 빠져나와 정리 후 종료한다는 점이다.
다만 이번에는 예외가 아니라 상태 확인으로 흐름을 제어하는 것이다.
ThreadEx13은 인터럽트 상태를 확인하며 종료하는 예제다
- 반복 중 계속
"실행 중"을 출력한다.- 중간에
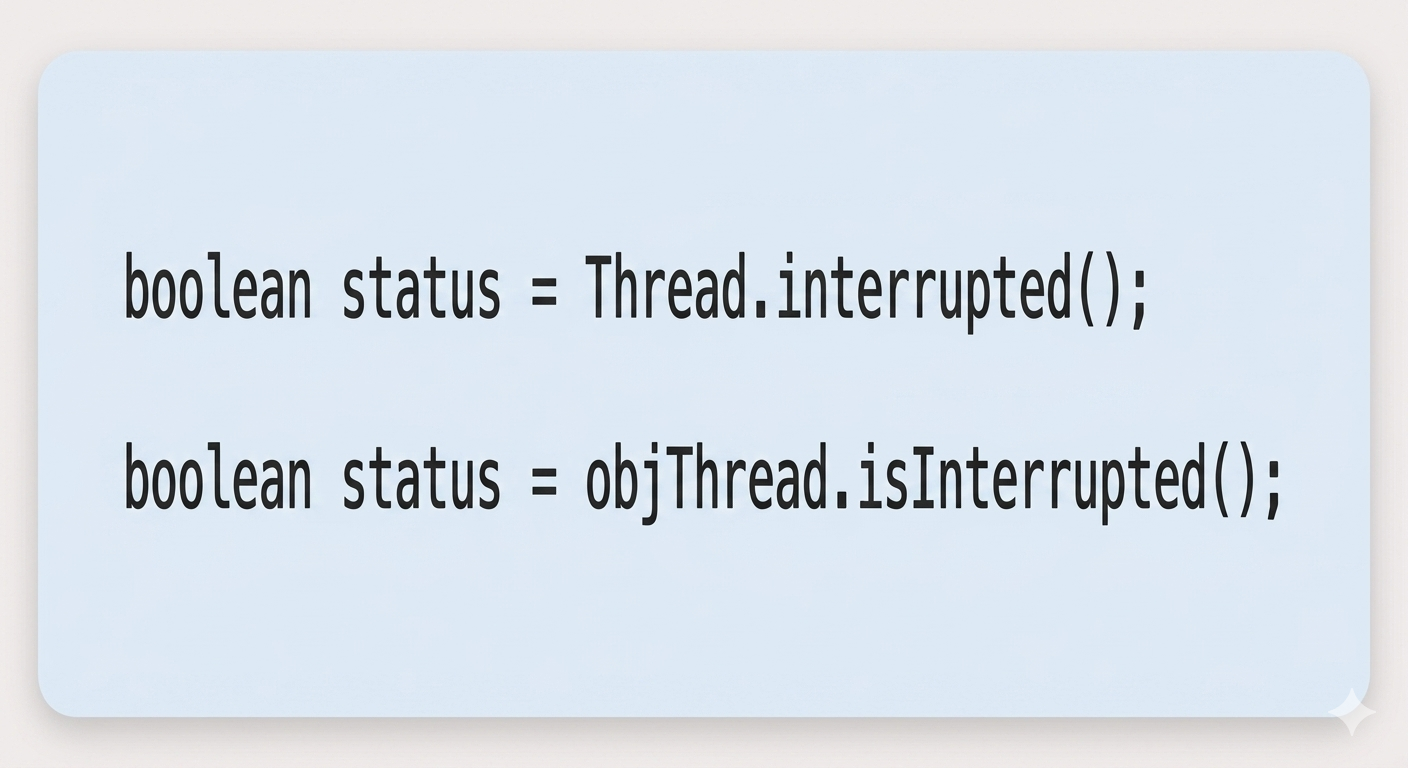
Thread.interrupted()를 확인한다.- 값이
true가 되면 반복을 멈추고 정리 후 종료한다.// ThreadEx13.java public class ThreadEx13 { public static void main(String[] args) { Thread thread = new PrintThread2(); // 작업 스레드 생성 thread.start(); // 스레드 시작 try { Thread.sleep(1000); // 잠깐 실행하게 둠 } catch (InterruptedException e) { } thread.interrupt(); // 인터럽트 신호 전달 } } class PrintThread2 extends Thread { public void run() { while (true) { // 계속 반복 System.out.println("실행 중"); if (Thread.interrupted()) { // 현재 스레드 인터럽트 상태 확인 break; // 인터럽트가 들어오면 반복 종료 } } System.out.println("자원 정리"); // 정리 작업 System.out.println("실행 종료"); // 종료 메시지 } }// 출력결과 // 실행 중 // 실행 중 // 실행 중 // ... // 자원 정리 // 실행 종료이 예제는
interrupt()를 보낸 뒤, 그 신호를 반복문 안에서 직접 확인해서 종료 흐름으로 연결하는 방식이다.
즉,ThreadEx11과 다르게 예외가 아니라 상태 검사로 끝내는 예제라고 보면 된다.
두 확인 메서드는 어떻게 다르게 보면 되는가
하나는 현재 실행 중인 스레드 기준이고, 하나는 특정 스레드 객체 기준이다
Thread.interrupted()는 현재 실행 중인 스레드 기준으로 인터럽트 상태를 확인한다.isInterrupted()는 특정 스레드 객체 기준으로 인터럽트 상태를 확인할 때 쓴다.초보자 단계에서는 이 정도로 구분하면 충분하다.
지금 당장 중요한 것은 둘의 내부 차이를 깊게 파는 것이 아니라, 현재 흐름을 보는지, 아니면 특정스레드객체를 보는지를 나눠서 이해하는 것이다.
즉,ThreadEx13처럼run()안에서 지금 실행 중인 자기 자신의 상태를 확인할 때는Thread.interrupted()가 자연스럽게 쓰일 수 있다.
Thread.interrupted()는 현재 실행 중인스레드기준이고,isInterrupted()는 특정스레드객체 기준으로 인터럽트 상태를 확인할 때 사용한다.
이 주제에서 꼭 남겨야 하는 핵심
지금 단계에서는 이렇게 이해하면 된다
스레드를 안전하게 종료한다는 것은 강제로 끊는 것이 아니라, 반복을 빠져나오고 정리 후 끝내는 것이다.- 종료 플래그 방식은
boolean값으로 반복을 멈추게 만드는 방법이다.interrupt()는스레드를 바로 없애는 명령이 아니라 종료 쪽으로 흐름을 바꾸는 신호에 가깝다.sleep()중에는InterruptedException으로 종료 흐름을 만들 수 있다.- 반복문 안에서 인터럽트 상태를 직접 확인하며 끝낼 수도 있다.
즉, 이 주제의 핵심은 종료 방법 이름을 외우는 것이 아니라, 안전한 종료는 언제나 정리할 시간을 주고 자연스럽게
run()이 끝나게 만드는 흐름이라는 점이다.
이 감각을 잡고 나면 뒤에서 나오는데몬 스레드와동기화도 훨씬 덜 헷갈리게 된다.
데몬 스레드는 무엇인가
스레드가 모두 같은 중요도를 가지는 것은 아니다.
어떤스레드는 프로그램의 핵심 작업을 직접 처리하고, 어떤스레드는 그 핵심 작업을 뒤에서 도와주는 보조 역할만 맡는다.
이렇게 다른 일반스레드의 작업을 뒤에서 돕는 보조 역할 스레드를데몬 스레드라고 한다.
이 주제에서는데몬 스레드가 무엇인지, 왜 필요한지, 일반스레드와 무엇이 다른지, 그리고 예제에서는 어떤 모습으로 보이는지를 차례대로 이해하면 된다.
데몬 스레드는 어떤 스레드인가
주 작업을 뒤에서 돕는 보조 스레드다
데몬 스레드는 다른 일반스레드의 작업을 돕는 보조적인 역할을 수행하는스레드다.- 프로그램의 중심 작업을 직접 맡기보다, 뒤에서 계속 필요한 일을 도와주는 흐름에 가깝다.
- 예를 들어 자동 저장, 백그라운드 감시, 메모리 정리 같은 작업이 여기에 잘 어울린다.
핵심은 역할이다.
데몬 스레드는 보통 프로그램의 “주인공 작업”을 맡지 않는다.
대신 일반스레드의 작업이 잘 돌아가도록 옆에서 지원하는 일을 맡는다.
그래서데몬 스레드는 혼자서 끝까지 프로그램을 붙잡고 있어야 하는 존재라기보다, 주 작업이 있는 동안만 같이 움직이면 되는 보조 흐름으로 이해하는 것이 좋다.
일반
스레드가 모두 끝나면 같이 종료된다
데몬 스레드의 가장 중요한 특징은 일반스레드가 모두 종료되면 함께 자동 종료된다는 점이다.- 즉, 보조 역할만 하고 있기 때문에 주 작업이 끝난 뒤에도 혼자 남아서 계속 프로그램을 붙잡고 있지 않는다.
이 점이 일반
스레드와 가장 크게 다르다.
일반스레드는 자기 작업이 끝날 때까지 프로그램 종료 시점에 직접 영향을 줄 수 있다.
반면데몬 스레드는 일반스레드가 모두 끝나면 같이 정리되는 쪽에 가깝다.
즉,데몬 스레드는 “프로그램이 끝날 때까지 반드시 살아 있어야 하는 스레드”가 아니라, “일반스레드가 살아 있는 동안만 보조로 함께 도는 스레드”다.
왜 데몬 스레드가 필요한가
어떤 작업은 계속 뒤에서 돌기만 하면 된다
- 자동 저장처럼 일정 시간마다 반복 확인하는 작업이 있다.
- 메모리 상태를 살피거나, 필요할 때만 반응하는 보조 작업도 있다.
- 이런 일은 주 작업을 직접 대신하는 것이 아니라, 뒤에서 계속 돕는 역할에 가깝다.
예를 들어 문서를 작성하는 프로그램을 생각해 보면, 가장 중요한 것은 사용자가 글을 쓰는 흐름이다.
자동 저장은 중요하지만, 그것만 혼자 남아서 프로그램 종료를 막아야 하는 주 작업은 아니다.
그래서 이런 작업은데몬 스레드로 두는 것이 자연스럽다.
즉, 있으면 편하고 필요하지만, 주 작업이 끝난 뒤까지 혼자 살아 있을 필요는 없는 작업이데몬 스레드와 잘 맞는다.
그래서 보조 스레드에 잘 어울린다
- 주 작업이 끝나면 같이 종료되어도 되는 일
- 뒤에서 계속 감시하거나 확인하면 되는 일
- 반복적으로 실행되지만 프로그램의 중심 흐름은 아닌 일
이런 종류의 작업은 일반
스레드보다데몬 스레드로 두는 쪽이 더 자연스럽다.
왜냐하면 프로그램의 핵심 흐름을 방해하지 않으면서, 필요한 동안만 보조적으로 움직이면 되기 때문이다.
일반 스레드와 무엇이 다른가
가장 큰 차이는 종료 시점이다
- 일반
스레드는 자기 작업이 끝나기 전까지 프로그램 종료에 영향을 줄 수 있다.데몬 스레드는 일반스레드가 모두 끝나면 함께 종료된다.초보자 입장에서는 둘 다 그냥
스레드처럼 보일 수 있다.
실제로 둘 다run()안에 작업을 적고start()로 실행한다는 점은 같다.
하지만 역할과 종료 시점이 다르다.
즉, 일반스레드는 끝까지 자기 일을 마치는 쪽에 가깝고,데몬 스레드는 일반스레드가 모두 끝나면 같이 정리되는 보조 흐름이라고 구분하면 된다.
설정은
setDaemon(true)로 한다
데몬 스레드로 만들고 싶다면start()전에setDaemon(true)를 호출한다.- 이 호출을 해야 해당
스레드가 보조 역할 스레드로 동작한다.여기서 중요한 것은 순서다.
데몬 스레드여부는 시작하기 전에 정해야 한다.
즉,start()를 호출한 뒤가 아니라start()하기 전에setDaemon(true)를 호출해야 한다고 이해하면 된다.
개념을 예제로 확인하기
ThreadEx14는 자동 저장 보조 스레드를 보여준다
ThreadEx14는Runnable을 구현한 뒤Thread객체를 만들어 실행한다.- 그리고
setDaemon(true)를 호출해서데몬 스레드로 만든다.- 이 스레드는 3초마다 확인하다가
autoSave값이true가 되면 자동 저장 메서드를 호출한다.// ThreadEx14.java class ThreadEx14 implements Runnable { static boolean autoSave = false; // 자동 저장 가능 여부 public static void main(String[] args) { Thread t = new Thread(new ThreadEx14()); // 보조 스레드 생성 t.setDaemon(true); // 데몬 스레드로 설정 t.start(); // 스레드 시작 for (int i = 1; i <= 10; i++) { try { Thread.sleep(2000); // 메인 흐름은 2초마다 진행 } catch (InterruptedException e) { } System.out.println(i); if (i == 5) { autoSave = true; // 5 이후부터 자동 저장 가능 } } System.out.println("프로그램을 종료합니다."); } public void run() { while (true) { try { Thread.sleep(3 * 1000); // 3초마다 확인 } catch (InterruptedException e) { } if (autoSave) { autoSave(); // 자동 저장 실행 } } } public void autoSave() { System.out.println("작업파일이 자동저장되었습니다."); } }// 출력결과 // 1 // 2 // 3 // 4 // 5 // 작업파일이 자동저장되었습니다. // 6 // 7 // 작업파일이 자동저장되었습니다. // ... // 프로그램을 종료합니다.이 예제의 핵심은 자동 저장 스레드가 계속 뒤에서 돌고는 있지만, 프로그램의 주 작업이 끝나면 그 보조 스레드도 같이 종료된다는 점이다.
즉, 자동 저장은 중요하지만 주 작업을 대신하는 것이 아니라 보조 역할이라는 점을 보여 준다.
ThreadEx15는 메모리 정리 보조 스레드를 보여준다
GCThread를 만들고setDaemon(true)로데몬 스레드로 설정한다.- 이 스레드는 평소에는 잠자고 있다가, 필요할 때
interrupt()를 받아 깨어난다.- 깨어나면 메모리 정리 작업을 수행한다.
// ThreadEx15.java
class ThreadEx15 {
    public static void main(String args[]) {
        GCThread gc = new GCThread(); // 보조 스레드 생성
        gc.setDaemon(true); // 데몬 스레드 설정
        gc.start(); // 시작

        int requiredMemory = 0;

        for (int i = 0; i < 20; i++) {
            requiredMemory = (int) (Math.random() * 10) * 20;

            if (gc.freeMemory() < requiredMemory || gc.freeMemory() < gc.totalMemory() * 0.4) {
                gc.interrupt(); // 필요하면 보조 스레드 깨움
                try {
                    gc.join(100); // 잠깐 기다림
                } catch (InterruptedException e) {
                }
            }

            gc.usedMemory += requiredMemory; // 메모리 사용량 증가
            System.out.println("usedMemory:" + gc.usedMemory);
        }
    }
}

class GCThread extends Thread {
    final static int MAX_MEMORY = 1000;
    int usedMemory = 0;

    public void run() {
        while (true) {
            try {
                Thread.sleep(10 * 1000); // 평소에는 잠자고 있음
            } catch (InterruptedException e) {
                System.out.println("Awaken by interrupt()."); // 깨워짐
            }

            gcDo(); // 메모리 정리
            System.out.println("Garbage Collected. Free Memory :" + freeMemory());
        }
    }

    public void gcDo() {
        usedMemory -= 300;
        if (usedMemory < 0) {
            usedMemory = 0;
        }
    }

    public int totalMemory() {
        return MAX_MEMORY;
    }

    public int freeMemory() {
        return MAX_MEMORY - usedMemory;
    }
}
// 출력결과 // usedMemory:... // usedMemory:... // Awaken by interrupt(). // Garbage Collected. Free Memory : ... // ...이 예제는
데몬 스레드가 평소에는 뒤에서 대기하다가, 필요할 때만 보조 작업을 수행하는 흐름을 잘 보여 준다.
즉, 이 스레드는 프로그램의 중심 흐름을 직접 이끄는 것이 아니라 필요할 때 반응하는 지원 역할을 맡는다.
두 예제를 같이 보면 무엇이 보이는가
자동 저장과 메모리 정리는 둘 다 보조 역할이다
ThreadEx14는 자동 저장을 보조로 수행한다.ThreadEx15는 메모리 정리를 보조로 수행한다.- 둘 다 프로그램의 중심 흐름이 아니라, 주 작업을 도와주는 뒤쪽 역할이다.
이 두 예제를 같이 보면
데몬 스레드가 어떤 느낌인지 훨씬 쉽게 잡힌다.
한쪽은 일정 시간마다 확인하며 자동 저장을 하고, 다른 한쪽은 필요할 때 깨어나 메모리를 정리한다.
공통점은 둘 다 프로그램의 주 작업을 대신하는 것이 아니라 뒤에서 지원하는 역할이라는 점이다.
이 주제에서 꼭 남겨야 하는 핵심
지금 단계에서는 이렇게 이해하면 된다
데몬 스레드는 주 스레드의 작업을 돕는 보조 역할 스레드다.- 주 스레드가 종료되면
데몬 스레드도 함께 자동 종료된다.- 자동 저장, 백그라운드 감시, 메모리 정리 같은 작업에 잘 어울린다.
데몬 스레드로 만들려면start()전에setDaemon(true)를 호출한다.- 핵심은 주 작업을 대신하는 것이 아니라, 필요한 동안만 뒤에서 돕는 보조 흐름이라는 점이다.
즉, 이 주제의 핵심은
데몬 스레드를 특별한 새로운 종류의 어려운 스레드로 보는 것이 아니라, 주 작업이 있는 동안만 함께 움직이는 보조 스레드로 이해하는 것이다.
이 감각을 잡고 나면 뒤에서 나오는동기화와동기화 컬렉션도 훨씬 덜 헷갈리게 된다.
여러 스레드가 같은 데이터를 만질 때 왜 문제가 생기는가
멀티 스레드가 편리한 이유는 작업을 나눠서 처리할 수 있기 때문이다.
하지만 여러 실행 흐름이 같은 객체와 같은 데이터를 함께 만지기 시작하면, 그 순간부터는 단순히 빨라지는 문제가 아니라 값이 꼬일 수 있는 문제가 생긴다.
초보자가 여기서 가장 많이 헷갈리는 부분은 이것이다.
“같은 프로그램 안에서 같이 일하면 더 좋은 것 아닌가?”
물론 작업을 나눠서 처리하는 장점은 있다.
하지만 같은 데이터를 여러스레드가 동시에 읽고 바꾸면, 생각한 순서대로 값이 처리되지 않을 수 있다.
그래서 이 주제에서는 왜 문제가 생기는지,동기화가 왜 필요한지,synchronized메서드와synchronized블록은 어떻게 다른지를 먼저 잡아야 한다.
왜 같은 데이터를 함께 만지면 문제가 생기는가
문제는 공유 객체에서 시작된다
멀티 스레드에서는 여러스레드가 같은 객체를 함께 사용할 수 있다.- 이때 그 객체 안에 있는 필드도 함께 공유된다.
- 그래서 한
스레드가 값을 바꾸는 동안 다른스레드도 같은 값을 읽거나 바꿀 수 있다.핵심은 객체를 따로따로 갖고 있는 것이 아니라, 하나의 객체를 함께 본다는 점이다.
스레드가 여러 개라고 해서 데이터도 자동으로 여러 개 생기는 것은 아니다.
같은 객체를 바라보고 있으면 그 안의 필드도 결국 같이 쓰게 된다.
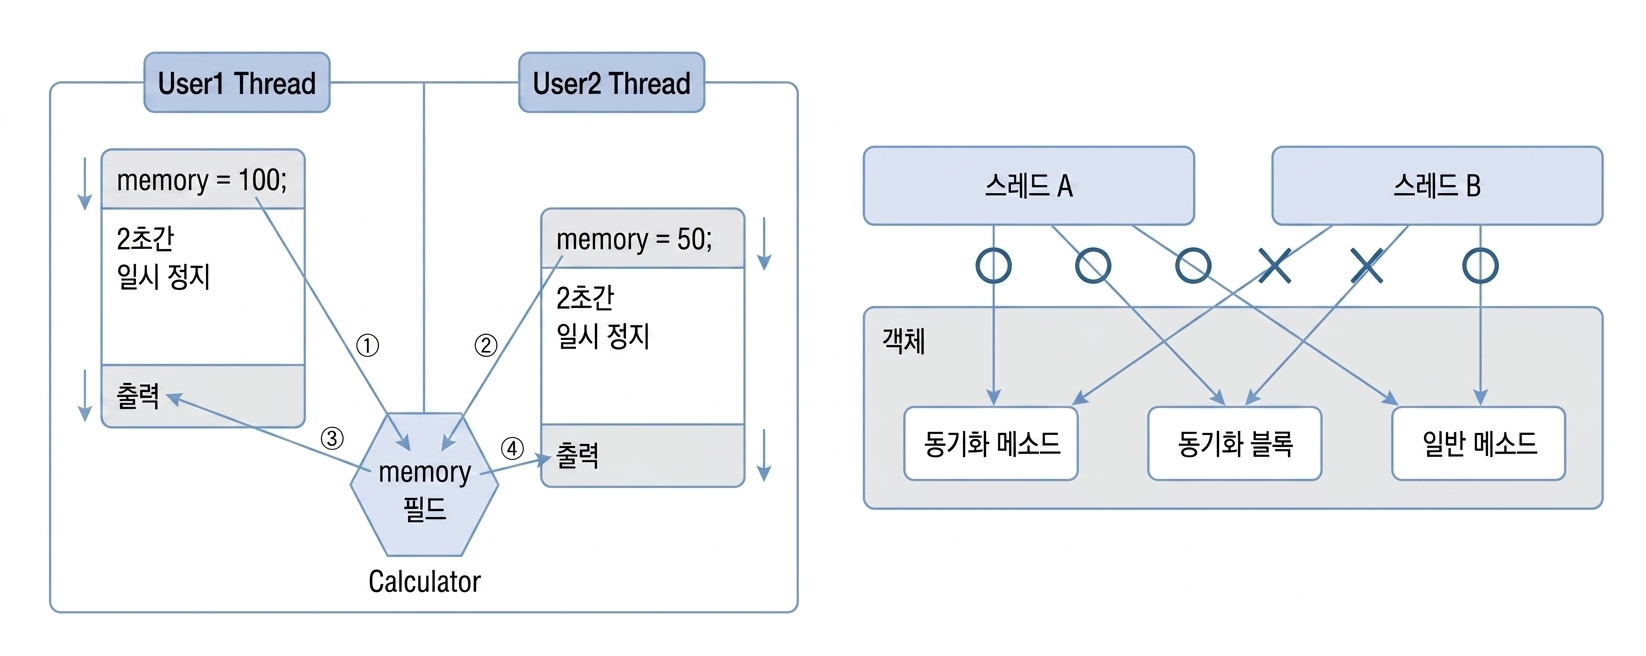
예를 들어 어떤 객체 안에memory같은 필드가 있다고 생각해 보자.
한스레드가 그 값을100으로 바꾼 뒤 잠깐 멈추고, 그 사이 다른스레드가50으로 다시 바꾸면, 처음스레드가 다시 이어서 작업할 때는 자기가 넣은 값이 아니라 이미 바뀐 값을 만나게 될 수 있다.
이렇게 되면 출력 결과가 예상과 다르게 나온다.
여러
스레드가 같은 객체의 필드를 함께 사용하면, 한쪽이 값을 바꾸는 동안 다른 쪽도 같은 값을 건드릴 수 있어서 결과가 뒤섞일 수 있다.
순서대로 보이는 코드도 실제 실행은 뒤섞일 수 있다
- 코드는 한 줄씩 순서대로 적혀 있어 보인다.
- 하지만
멀티 스레드에서는 실제 실행 순서가 그 코드 줄 순서 그대로 유지된다고 볼 수 없다.- 그래서 값 저장, 잠깐 대기, 출력 같은 과정 사이에 다른
스레드가 끼어들 수 있다.초보자는 코드를 보면 “이 줄이 끝나고 다음 줄이 실행되겠지”라고 생각하기 쉽다.
그 생각 자체는싱글 스레드에서는 크게 어긋나지 않는다.
하지만멀티 스레드에서는 내 코드 흐름 사이에 다른스레드의 실행이 들어올 수 있다는 점이 다르다.
즉, 문제는 문법이 틀려서가 아니다.
같은 자원을 함께 쓰는 상황에서 실행 타이밍이 엇갈리기 때문이다.
그래서멀티 스레드문제는 보통 “코드가 이상해서”가 아니라, “같은 데이터를 여러 흐름이 동시에 건드려서” 생긴다고 이해해야 한다.
그래서 공유 데이터는 보호가 필요하다
- 모든 데이터가 위험한 것은 아니다.
- 여러
스레드가 함께 만지는 공유 데이터가 특히 문제다.- 그래서 그런 부분만 따로 보호해야 한다.
이 지점이 중요하다.
멀티 스레드라고 해서 프로그램 전체를 무조건 막아야 하는 것은 아니다.
정말로 보호가 필요한 부분은 여러스레드가 같이 접근하는 공유 데이터 영역이다.
즉,동기화는 프로그램 전체를 느리게 만드는 장치가 아니라, 값이 꼬이지 않게 꼭 필요한 구간만 보호하는 장치라고 이해하면 된다.
동기화는 왜 필요한가
한 번에 하나의 흐름만 들어오게 만들어야 한다
- 여러
스레드가 같은 데이터를 동시에 만지면 문제가 생긴다.- 그래서 어떤 구간은 한 번에 하나의
스레드만 들어오게 해야 한다.- 이런 보호 처리를
동기화라고 본다.쉽게 말하면 문 하나를 만들어 두고, 지금 한
스레드가 그 안에서 작업하는 동안에는 다른스레드가 잠깐 기다리게 만드는 것이다.
그러면 값 저장과 출력 같은 중요한 흐름이 중간에 끊기지 않고 한 덩어리로 처리될 수 있다.
그래서동기화는 여러스레드를 없애는 기능이 아니다.
여러스레드는 그대로 두되, 문제가 생기는 구간만 차례대로 지나가게 만드는 기능이다.
임계 영역과lock으로 생각하면 이해가 쉽다
- 여러
스레드가 함께 들어오면 문제가 생기는 코드 구간을임계 영역이라고 볼 수 있다.- 이 구간은 공유 데이터를 읽고 바꾸는 중요한 부분이기 때문에, 한 번에 하나의
스레드만 들어와야 한다.- 객체는 이런 구간을 보호하기 위한
lock을 가지고 있다고 이해하면 흐름이 쉽다.어떤
스레드가 먼저lock을 얻으면 그동안 다른스레드는 같은 보호 구간에 바로 들어오지 못하고 기다리게 된다.
그리고 작업이 끝나서lock이 풀리면 그다음스레드가 들어올 수 있다.
즉,synchronized는 눈에 보이지 않는 문을 하나 세우는 것이 아니라, 공유 객체의lock을 이용해임계 영역을 차례대로 통과하게 만드는 방식이라고 이해하면 된다.
모든 메서드를 막는 것이 아니라 필요한 부분만 막는다
- 공유 데이터를 건드리지 않는 일반 메서드는 여러
스레드가 함께 실행해도 큰 문제가 없을 수 있다.- 하지만 공유 필드를 읽고 바꾸는 메서드는 보호가 필요하다.
- 그래서
동기화는 필요한 구간에만 걸어야 한다.이 부분을 잘못 이해하면 “그럼 전부 다
synchronized붙이면 되는 것 아닌가?”라고 생각할 수 있다.
물론 그렇게 하면 겉으로는 안전해 보일 수 있다.
하지만 꼭 그렇다고 좋은 것은 아니다.
필요 없는 곳까지 전부 막아 버리면 여러스레드를 쓰는 장점도 줄어들 수 있다.
그래서 중요한 것은 어디가 공유 데이터에 접근하는 위험 구간인지 구분하는 것이다.
그 구간만 정확히 보호하는 것이 더 자연스럽다.
synchronized메서드와synchronized블록은 어떻게 다른가
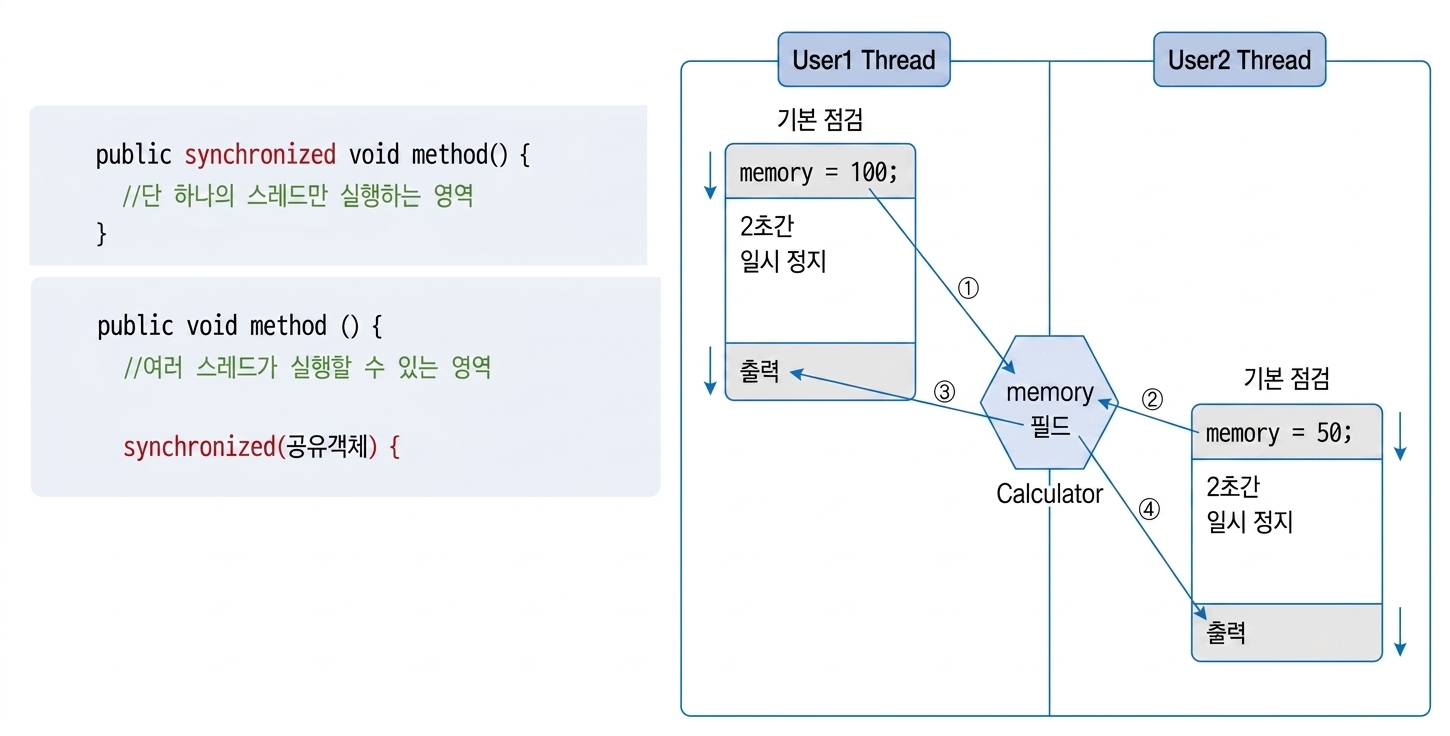
synchronized메서드는 메서드 전체를 보호한다
- 메서드 선언부에
synchronized를 붙이면 그 메서드 전체가 보호 대상이 된다.- 같은 객체 기준으로는 한 번에 하나의
스레드만 그 메서드에 들어갈 수 있다.이 방식은 이해하기 쉽다.
공유 데이터를 다루는 작업이 메서드 전체에 걸쳐 있다면, 그냥 그 메서드 전체를 묶어 버리면 되기 때문이다.
그래서 처음 배울 때는 가장 직관적으로 보인다.
즉, 메서드 처음부터 끝까지 하나의 보호 구간으로 보는 방식이다.
그래서 간단한 경우에는 설명하기도 쉽고 적용하기도 쉽다.
synchronized블록은 필요한 부분만 골라서 보호한다
- 메서드 전체가 아니라 일부 코드만 보호하고 싶을 때는
synchronized블록을 사용한다.- 이 방식은 정말 필요한 구간만 묶을 수 있다.
- 그래서 보호 범위를 더 세밀하게 정할 수 있다.
예를 들어 메서드 안에 여러 작업이 있는데, 그중 실제로 공유 데이터를 건드리는 부분만 문제라면 굳이 메서드 전체를 막을 필요는 없다.
그럴 때는 딱 그 부분만synchronized블록으로 감싸면 된다.
보호 범위를 작게 잡을수록 다른스레드가 기다려야 하는 시간도 줄어들 수 있다.
그래서 실제로는 필요한 부분만 최소한으로 묶는 쪽이 더 효율적일 때가 많다.
즉,synchronized메서드는 넓게 보호하는 방식이고,synchronized블록은 필요한 부분만 골라 보호하는 방식이라고 이해하면 된다.
공유 데이터를 다루는 메서드 전체를 보호할 수도 있고, 정말 필요한 코드 구간만
synchronized블록으로 묶어 보호할 수도 있다.
둘 중 무엇이 더 좋다기보다 상황이 다르다
- 공유 데이터 작업이 메서드 전체에 걸쳐 있으면
synchronized메서드가 이해하기 쉽다.- 메서드 안에서 일부 구간만 보호하면 될 때는
synchronized블록이 더 알맞다.중요한 것은 어떤 문법이 더 멋진가가 아니다.
공유 데이터가 실제로 어디서 만져지는가를 보고 거기에 맞는 범위를 잡는 것이다.
그래서 초보자 단계에서는 이렇게 기억하면 충분하다.
메서드 전체를 보호할지, 일부만 보호할지는 결국 보호가 필요한 범위가 어디까지인지에 따라 달라진다.
wait()와notify()계열은 동기화 흐름 안에서 같이 봐야 한다
wait()는 기다리는 동안 해당 객체의lock을 놓고 잠깐 멈춘다.notify()는 기다리던스레드중 하나를 깨운다.notifyAll()은 기다리던스레드를 모두 깨운다.이 세 메서드는 상태 변화 이야기로만 보면 반쪽 이해가 되기 쉽다.
핵심은 동기화된 구간에서 누가 먼저 일하고, 누가 기다리고, 누가 다시 들어올 수 있는가를 조절한다는 점이다.
즉,wait()는 그냥 쉬는 것이 아니라 기다리면서lock을 놓는 동작이고,notify()계열은 기다리던 흐름에게 “이제 다시 시도할 수 있다”는 신호를 주는 쪽에 가깝다.
그래서 이 개념은 상태 설명으로만 보는 것보다동기화흐름 안에서 함께 이해해야 자연스럽다.
예제로 보면 왜 값이 꼬이는지 더 분명해진다
ThreadEx16은 동기화하지 않았을 때 문제를 보여준다
Calculator객체 하나를 두스레드가 함께 사용한다.- 한쪽은
memory를100으로 바꾸고, 다른 쪽은50으로 바꾼다.- 그런데 값 저장과 출력 사이에 다른
스레드가 끼어들 수 있어서, 먼저 넣은 값이 그대로 출력되지 않을 수 있다.// ThreadEx16.java // Calculator 공유 객체 class Calculator { private int memory; // 공유 필드 public int getMemory() { return memory; // 현재 값 반환 } public void setMemory(int memory) { this.memory = memory; // 값 저장 try { Thread.sleep(2000); // 다른 스레드가 끼어들 수 있는 구간 } catch (InterruptedException e) { } System.out.println(Thread.currentThread().getName() + " : " + this.memory); // 현재 값 출력 } } // User1Thread class User1Thread extends Thread { private Calculator calculator; // 공유 객체 참조 public void setCalculator(Calculator calculator) { this.setName("User1Thread"); // 스레드 이름 지정 this.calculator = calculator; // 공유 객체 저장 } public void run() { calculator.setMemory(100); // 100 저장 요청 } } // User2Thread class User2Thread extends Thread { private Calculator calculator; // 공유 객체 참조 public void setCalculator(Calculator calculator) { this.setName("User2Thread"); // 스레드 이름 지정 this.calculator = calculator; // 공유 객체 저장 } public void run() { calculator.setMemory(50); // 50 저장 요청 } } // 실행 클래스 public class ThreadEx16 { public static void main(String[] args) { Calculator calculator = new Calculator(); // 공유 객체 생성 User1Thread user1 = new User1Thread(); user1.setCalculator(calculator); // 같은 객체 전달 User2Thread user2 = new User2Thread(); user2.setCalculator(calculator); // 같은 객체 전달 user1.start(); // 첫 번째 스레드 시작 user2.start(); // 두 번째 스레드 시작 } }// 출력결과 // User1Thread : 50 // User2Thread : 50이 예제의 핵심은
User1Thread가 분명100을 넣었는데도, 출력할 때는50이 나올 수 있다는 점이다.
왜냐하면 값을 저장하고 잠깐 멈춘 사이에User2Thread가 같은memory를50으로 다시 바꿔 버렸기 때문이다.
즉, 같은 공유 필드를 여러스레드가 함께 건드리면, 저장한 값과 출력되는 값 사이의 연결이 끊어질 수 있다.
ThreadEx16Sync는 동기화를 걸어서 문제를 막는다
- 이번에는
setMemory()에synchronized를 걸어 한 번에 하나의스레드만 들어오게 만든다.- 그러면 한
스레드가 값 저장부터 출력까지 끝낼 때까지 다른스레드는 기다린다.- 그래서 자기 차례의 값이 중간에 다른
스레드에 의해 덮어써지지 않는다.// ThreadEx16Sync.java // Calculator 공유 객체 class Calculator { private int memory; // 공유 필드 public int getMemory() { return memory; // 현재 값 반환 } public synchronized void setMemory(int memory) { this.memory = memory; // 값 저장 try { Thread.sleep(2000); // 잠깐 대기 } catch (InterruptedException e) { } System.out.println(Thread.currentThread().getName() + " : " + this.memory); // 현재 값 출력 } } // User1Thread class User1Thread extends Thread { private Calculator calculator; // 공유 객체 참조 public void setCalculator(Calculator calculator) { this.setName("User1Thread"); // 스레드 이름 지정 this.calculator = calculator; // 공유 객체 저장 } public void run() { calculator.setMemory(100); // 100 저장 요청 } } // User2Thread class User2Thread extends Thread { private Calculator calculator; // 공유 객체 참조 public void setCalculator(Calculator calculator) { this.setName("User2Thread"); // 스레드 이름 지정 this.calculator = calculator; // 공유 객체 저장 } public void run() { calculator.setMemory(50); // 50 저장 요청 } } // 실행 클래스 public class ThreadEx16Sync { public static void main(String[] args) { Calculator calculator = new Calculator(); // 공유 객체 생성 User1Thread user1 = new User1Thread(); user1.setCalculator(calculator); // 같은 객체 전달 User2Thread user2 = new User2Thread(); user2.setCalculator(calculator); // 같은 객체 전달 user1.start(); // 첫 번째 스레드 시작 user2.start(); // 두 번째 스레드 시작 } }// 출력결과 // User1Thread : 100 // User2Thread : 50 // 실행 순서는 달라질 수 있어도, 각 스레드는 자기 차례의 값을 꼬이지 않게 출력할 수 있다.여기서 중요한 것은 출력 순서를 완전히 고정하는 것이 아니다.
핵심은 한 번에 하나의스레드만 보호 구간에 들어가게 해서, 값 저장과 출력이 중간에 끊기지 않게 만드는 것이다.
그래서User1Thread가100을 넣고 출력하는 동안에는User2Thread가 같은 구간에 들어오지 못한다.
이 주제에서 꼭 남겨야 하는 핵심
지금 단계에서는 이렇게 이해하면 된다
- 여러
스레드가 같은 객체의 같은 필드를 함께 만지면 값이 꼬일 수 있다.- 문제는 코드 문법보다 공유 데이터에 여러 실행 흐름이 동시에 접근하는 상황에서 생긴다.
- 그래서 공유 데이터를 다루는 구간은 한 번에 하나의
스레드만 들어오게 보호해야 한다.synchronized메서드는 메서드 전체를 보호한다.synchronized블록은 필요한 부분만 골라서 보호한다.즉, 이 주제의 핵심은
멀티 스레드가 위험하다는 말이 아니라, 공유 데이터를 여러스레드가 함께 다룰 때는 보호 장치가 필요하다는 점이다.
이 흐름을 이해하면 다음에 나오는동기화 컬렉션도 왜 필요한지 훨씬 자연스럽게 이어진다.
동기화 컬렉션은 왜 필요한가
멀티 스레드에서는 여러 실행 흐름이 같은 데이터를 함께 사용할 수 있다.
이전 주제에서는 그 문제를synchronized로 막는 방법을 봤다.
그런데 공유되는 것이 단순한 필드만 있는 것은 아니다.
List,Set,Map같은 컬렉션도 결국 객체이기 때문에, 여러스레드가 같은 컬렉션 객체를 함께 쓰면 같은 문제가 생길 수 있다.
그래서 이 주제에서는 일반 컬렉션이 왜 위험할 수 있는지, 동기화 컬렉션이 무엇을 해 주는지,List,Set,Map은 각각 어떻게 감싸서 쓰는지를 차례대로 이해하면 된다.
일반 컬렉션도 공유 객체가 되면 문제가 생긴다
컬렉션도 결국 여러 스레드가 함께 볼 수 있는 객체다
ArrayList,HashSet,HashMap도 결국 객체다.- 하나의 컬렉션 객체를 여러
스레드가 함께 사용하면, 그 안에 들어 있는 데이터도 함께 공유된다.- 그래서 값을 넣고, 지우고, 읽는 과정에서 실행 타이밍이 엇갈리면 결과가 예상과 다르게 나올 수 있다.
초보자는 컬렉션을 “값을 담는 상자”처럼만 생각하기 쉽다.
물론 그 이해도 맞다.
하지만멀티 스레드에서는 그 상자를 누가 동시에 만지고 있는가까지 같이 봐야 한다.
즉, 같은List나 같은Map을 여러스레드가 함께 쓰는 순간, 그 컬렉션도 공유 데이터가 된다.
그래서 컬렉션 문제는 새로운 별도 문제가 아니라, 결국 공유 객체를 여러 실행 흐름이 함께 만질 때 생기는 문제의 연장선이라고 보면 된다.
그래서 원래 컬렉션을 그대로 공유하면 안전하지 않을 수 있다
- 한
스레드가 데이터를 추가하는 동안 다른스레드도 같은 컬렉션에 접근할 수 있다.- 한쪽은 값을 바꾸고 있는데 다른 쪽은 그 값을 읽으려고 할 수도 있다.
- 이처럼 접근 시점이 겹치면, 코드가 문법상 틀리지 않아도 결과는 꼬일 수 있다.
중요한 것은 “컬렉션 문법이 위험하다”가 아니다.
문제는 같은 컬렉션 객체에 여러 실행 흐름이 동시에 접근하는 상황이다.
즉, 컬렉션도 공유 객체라면 보호가 필요하다.
그래서멀티 스레드환경에서는 그냥ArrayList,HashSet,HashMap을 그대로 공유하는 것보다, 동기화된 형태로 바꿔서 사용하는 방법이 필요해진다.
동기화 컬렉션은 무엇을 해 주는가
핵심은 컬렉션 접근을 더 안전하게 만드는 것이다
- 동기화 컬렉션은 여러
스레드가 같은 컬렉션 객체를 함께 써도 더 안전하게 접근할 수 있게 도와준다.- 쉽게 말하면 컬렉션을 그냥 쓰는 것이 아니라, 보호 장치를 둘러서 쓰는 방식이다.
- 자바에서는
Collections클래스의 메서드로 이런 동기화 컬렉션을 만들 수 있다.이전 주제에서
synchronized메서드와synchronized블록을 봤다면 흐름은 같다.
여기서도 결국 목적은 하나다.
공유 자원에 여러스레드가 동시에 엉키지 않게 만드는 것이다.
차이는 적용 대상이다.
이전에는 메서드나 코드 구간을 보호했다면, 이번에는 컬렉션 객체 자체를 동기화된 형태로 감싸서 사용한다고 이해하면 된다.
동기화 컬렉션은 새 종류를 배우는 것이 아니라 감싸서 쓰는 방식이다
ArrayList를List로 감싸서 동기화된 컬렉션으로 바꿀 수 있다.HashSet도Set으로 감싸서 동기화된 컬렉션으로 바꿀 수 있다.HashMap도Map으로 감싸서 동기화된 컬렉션으로 바꿀 수 있다.여기서 중요한 것은 새로운 자료구조를 외우는 것이 아니다.
원래 있던 컬렉션을 그대로 쓰는 것이 아니라, 동기화된 형태로 감싸서 사용한다는 점이다.
즉, 원래 컬렉션을 버리고 완전히 다른 것을 배우는 흐름이 아니라, 기존 컬렉션에 보호 장치를 씌워서 쓰는 흐름으로 이해하면 된다.
왜 기본 컬렉션은 처음부터 전부 동기화하지 않는가
- 모든 컬렉션이 항상 여러
스레드에서 함께 쓰이는 것은 아니다.- 그래서 기본 컬렉션을 처음부터 전부 동기화해 두면, 필요 없는 상황에서도 불필요하게 보호 비용이 생길 수 있다.
- 그래서 보통은
ArrayList,HashMap처럼 기본 컬렉션을 가볍게 두고, 정말 공유가 필요할 때만Collections.synchronizedXxx()로 감싸서 쓴다.예전에는
Vector,Hashtable처럼 처음부터 동기화가 걸린 컬렉션도 있었다.
하지만 요즘에는 상황에 따라 필요한 쪽만 선택하는 방식이 더 자연스럽다.
즉, 평소에는 가볍게 쓰고, 여러스레드가 함께 쓰는 순간에만 보호 장치를 둘러서 사용한다는 흐름으로 이해하면 된다.
List는 어떻게 동기화해서 쓰는가
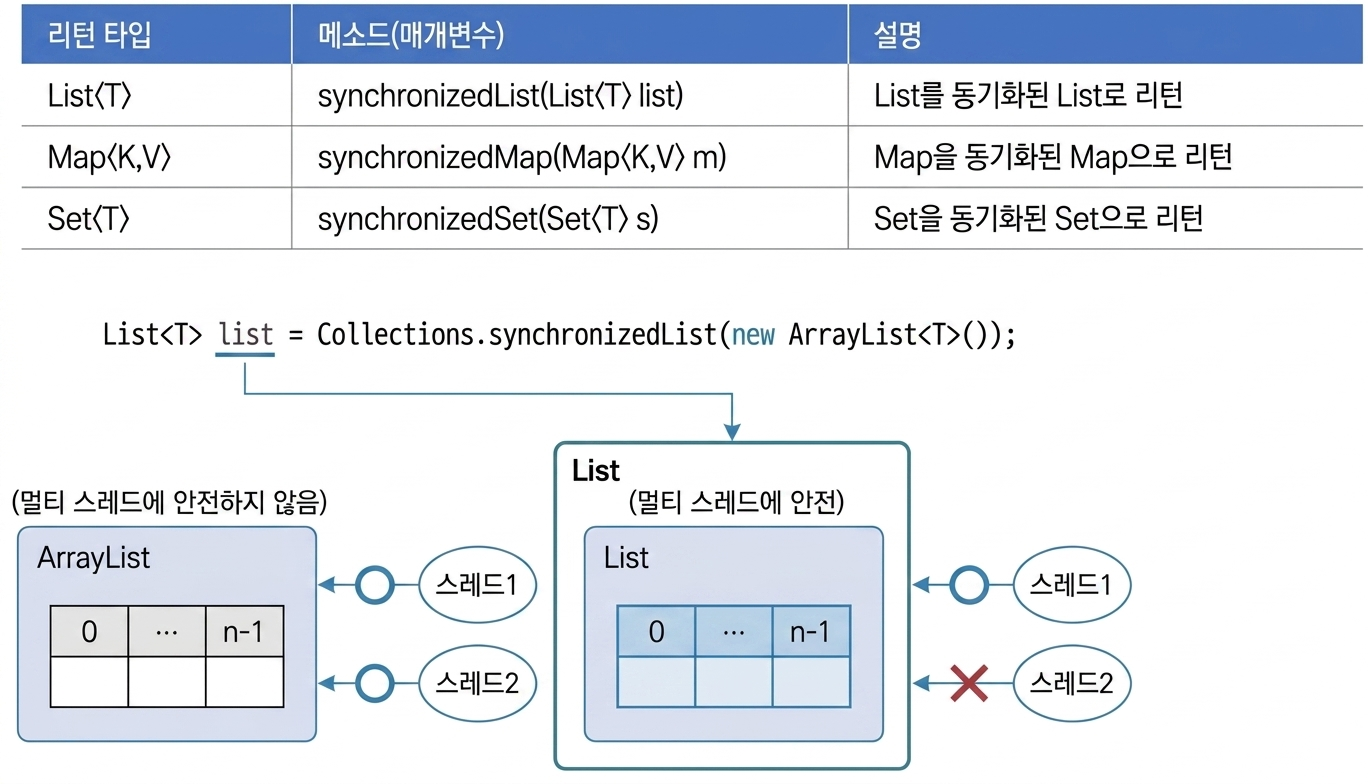
synchronizedList()로 감싸서 사용한다
ArrayList는 여러스레드가 함께 쓰는 상황에서 그대로 공유하면 안전하지 않을 수 있다.- 그래서
Collections.synchronizedList()로 감싸서 동기화된List로 사용한다.- 핵심은
ArrayList를 바로 공유하는 것이 아니라, 동기화된List형태로 바꿔서 공유한다는 점이다.이 방식은 “같은
List를 여러스레드가 함께 써야 하는데, 그냥 두면 위험할 수 있으니 보호 장치를 둘러서 쓰자”라는 흐름이다.
즉, 원래 컬렉션을 그대로 노출하는 것이 아니라, 동기화 처리가 된 컬렉션으로 바꿔서 사용한다고 보면 된다.
ArrayList를 그대로 여러스레드가 함께 쓰는 대신,Collections.synchronizedList()로 감싼List를 사용하면멀티 스레드환경에서 더 안전하게 접근할 수 있다.
왜
List를 바로 안 쓰고 감싸서 쓰는가
- 문제는
List라는 이름 자체가 아니라, 그 안의 실제 구현 객체를 여러스레드가 동시에 만지는 상황이다.- 그래서 그냥 원래 컬렉션 객체를 공유하지 않고, 보호된 형태를 공유해야 한다.
초보자는 여기서 “그럼 그냥
ArrayList를 조심해서 쓰면 되는 것 아닌가?”라고 생각할 수 있다.
하지만멀티 스레드에서는 실행 타이밍이 엇갈릴 수 있기 때문에, 사람의 주의만으로는 항상 막기 어렵다.
그래서 컬렉션 차원에서 보호된 형태를 사용하는 것이 더 자연스럽다.
Set과 Map도 같은 방식으로 동기화한다
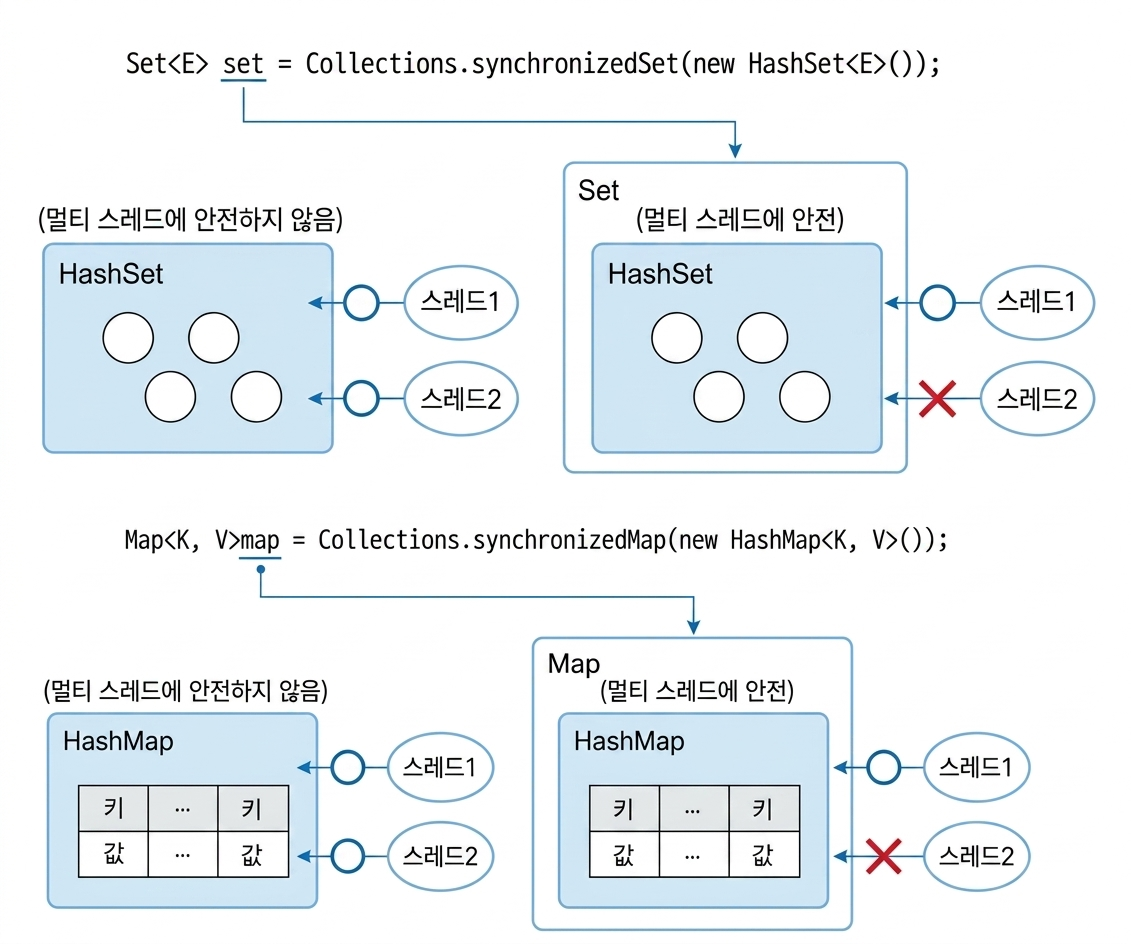
Set은synchronizedSet()으로,Map은synchronizedMap()으로 감싼다
HashSet은Collections.synchronizedSet()으로 감싸서 사용한다.HashMap은Collections.synchronizedMap()으로 감싸서 사용한다.- 즉, 자료형은 달라도 원리는 같다.
핵심은 한 가지다.
원래 컬렉션을 그대로 여러스레드가 함께 쓰지 않고, 동기화된 컬렉션 형태로 바꾼 뒤 공유한다는 것이다.
즉,List만 특별한 것이 아니다.
Set,Map도 공유 컬렉션이 되는 순간 같은 문제를 가질 수 있고, 그래서 같은 방향으로 보호가 필요하다.
HashSet과HashMap도 그대로 공유하지 않고,Collections.synchronizedSet(),Collections.synchronizedMap()으로 감싼 형태를 사용하면멀티 스레드환경에서 더 안전하게 사용할 수 있다.
결국 세 가지 모두 같은 흐름으로 보면 된다
List는synchronizedList()Set은synchronizedSet()Map은synchronizedMap()즉, 이름만 다를 뿐 핵심 생각은 같다.
공유 컬렉션을 그냥 두지 말고, 동기화된 컬렉션으로 감싸서 사용한다는 것이다.
초보자 단계에서는 이 세 개를 각각 따로 외우기보다, “컬렉션 종류에 맞는synchronized메서드가 하나씩 있다”는 감각으로 먼저 잡아 두면 충분하다.
이전 주제의 동기화와 어떻게 이어지는가
컬렉션도 결국 공유 데이터 보호의 연장선이다
- 이전에는 공유 필드와 메서드를 보호하기 위해
synchronized를 봤다.- 이번에는 공유 컬렉션 객체를 더 안전하게 사용하기 위해 동기화 컬렉션을 본다.
- 즉, 두 주제는 따로 떨어진 것이 아니라 같은 흐름이다.
이전 주제에서 “같은 데이터를 여러
스레드가 함께 만지면 값이 꼬일 수 있다”는 점을 이해했다면, 이번 주제도 자연스럽게 이어진다.
컬렉션도 결국 데이터 묶음이 들어 있는 공유 객체이기 때문이다.
그래서 동기화 컬렉션은 완전히 새로운 어려운 개념이라기보다, 공유 데이터를 보호하는 방법이 컬렉션 쪽으로 확장된 것이라고 이해하면 된다.
이 주제에서 꼭 남겨야 하는 핵심
지금 단계에서는 이렇게 이해하면 된다
ArrayList,HashSet,HashMap도 공유 객체가 되면 여러스레드가 함께 접근하면서 문제가 생길 수 있다.- 그래서
멀티 스레드환경에서는 컬렉션도 보호가 필요하다.- 자바에서는
Collections.synchronizedList(),Collections.synchronizedSet(),Collections.synchronizedMap()으로 동기화 컬렉션을 만들 수 있다.- 핵심은 원래 컬렉션을 그대로 공유하지 않고, 동기화된 형태로 감싸서 사용한다는 점이다.
- 즉, 동기화 컬렉션도 결국 공유 데이터를 더 안전하게 다루기 위한 장치다.
이 주제의 핵심은 컬렉션 이름을 외우는 것이 아니라, 컬렉션도 공유 객체가 되는 순간 보호가 필요하고, 그 보호 방법으로 동기화 컬렉션을 사용할 수 있다는 점이다.
이 흐름까지 잡으면멀티 스레드에서 왜 데이터 보호가 중요한지 훨씬 더 선명하게 보인다.
멀티스레드에서 꼭 잡아야 하는 핵심만 다시 정리하기
이제 이 파트는 단어를 외우는 수준에서 끝내면 안 된다.
각 개념이 왜 필요한지 흐름으로 연결되어야 한다.
프로세스는 실행 중인 프로그램이고,스레드는 그 안에서 실제로 코드를 실행하는 흐름이다.싱글 스레드는 하나의 흐름으로 순서대로 처리하고,멀티 스레드는 여러 흐름으로 작업을 나눌 수 있다.run()은 작업 내용이고,start()는 새 실행 흐름을 시작시키는 호출이다.sleep()은 잠깐 쉬게 하고,yield()는 다른 스레드에게 실행 기회를 양보한다.join()은 다른 스레드가 끝날 때까지 기다리게 만든다.- 안전한 종료는 강제로 끊는 것이 아니라, 정리 후 자연스럽게 끝내는 것이다.
interrupt()는 종료를 위한 신호로 자주 사용된다.데몬 스레드는 보조 역할을 하고, 일반스레드가 모두 끝나면 함께 종료된다.- 여러 스레드가 같은 데이터를 만질 때는
동기화가 필요하다.멀티스레드의 핵심은 “여러 개의 흐름” 자체가 아니라, 그 여러 흐름을 어떻게 안전하게 나누고, 기다리게 하고, 끝내고, 보호할 것인가를 이해하는 데 있다.
이 흐름만 제대로 잡히면 뒤에서 더 복잡한 예제를 봐도 훨씬 덜 헷갈리게 된다.