[형변환]
1. 형변환이 왜 필요한가
개념자바에서는 값을 아무 자료형에나 넣어서 쓸 수 없다.
각 값은 반드시 어떤 자료형 규칙 안에서 해석되고, 자바는 그 자료형에 맞게 값을 다룬다.
그래서 같은 값이라도 어떤 자료형으로 보느냐에 따라 결과가 달라질 수 있다.
예를 들어65를int로 보면 숫자65지만,char로 보면 문자'A'가 된다.
또 연산할 때도 내가 눈으로 보는 타입 그대로 계산되는 것이 아니다.
자바는 계산이 가능하도록 타입을 맞춘 뒤 연산한다.
이 과정에서 어떤 값은 자동으로 더 큰 타입으로 바뀌고, 어떤 값은 직접(타입)을 붙여서 바꿔줘야 한다.
이처럼 값을 다른 자료형으로 바꿔 해석하게 만드는 것이형변환이다.
핵심 특징
형변환은 값을 다른 타입으로 바꿔서 해석하게 만드는 것이다.- 같은 값도 자료형에 따라 다르게 보일 수 있다.
- 서로 다른 타입끼리 대입하거나 연산할 때 형변환이 필요하다.
- 자바가 자동으로 바꿔주는 경우도 있고, 직접 써야 하는 경우도 있다.
헷갈리기 쉬운 부분형변환을 “값 자체가 완전히 다른 값으로 바뀐다”라고만 생각하면 헷갈린다.
핵심은 같은 값을 다른 타입 규칙으로 읽게 만든다는 데 있다.
예를 들어65라는 값이 갑자기 다른 숫자가 되는 것이 아니라,
char규칙으로 보면'A',int규칙으로 보면65가 되는 것이다.
2. 형변환의 기본 방법
개념형변환 문법은 아래처럼 쓴다.
(타입)값예를 들어
double값을int로 바꾸고 싶으면(int)를 앞에 붙인다.
그러면 소수 부분은 사라지고 정수 부분만 남는다.
중요한 점은 형변환이 원래 변수 자체를 바꿔놓는 것이 아니라,
그 값을 읽어서 잠깐 다른 타입으로 본 결과를 만드는 것이라는 점이다.
코드 예제예제:
CastingExdouble d = 85.4; int score = (int)d; System.out.println("score=" + score); System.out.println("d=" + d); // 출력결과 // score=85 // d=85.4이 코드는
double값을int로 바꾸는 가장 기본적인 예제다.
d는85.4를 가지고 있지만,
(int)d는85로 형변환된 결과를 만든다.
그래서score에는85가 저장된다.
하지만 원래 변수d자체는 바뀌지 않기 때문에 그대로85.4가 출력된다.
핵심 특징
- 형변환 문법은
(타입)값이다.- 형변환 결과를 다른 변수에 저장해서 사용한다.
- 원래 변수 값이 자동으로 바뀌는 것은 아니다.
- 기본형에서는
boolean을 제외한 나머지 타입끼리 형변환이 가능하다.
헷갈리기 쉬운 부분아래처럼 쓰면 에러가 난다.
double d = 85.4;
int score = d;   // 에러
double이int보다 더 큰 범위를 표현할 수 있기 때문이다.
그래서 아래처럼 직접 형변환을 써야 한다.int score = (int)d;즉, 큰 범위의 타입을 작은 범위의 타입에 넣을 때는 직접 형변환이 필요하다는 점을 먼저 잡아야 한다.
3. 자동 형변환과 강제 형변환
개념형변환은 크게 두 가지로 볼 수 있다.
하나는 자바가 알아서 처리해주는자동 형변환,
다른 하나는 개발자가 직접 써줘야 하는강제 형변환이다.
자바는 기본적으로 값이 안전하게 들어갈 수 있는 방향이면 자동으로 바꿔준다.
반대로 값이 잘릴 수 있거나 달라질 가능성이 있으면 자동으로 바꾸지 않고, 직접 쓰라고 요구한다.
핵심 특징
- 작은 범위 타입 → 큰 범위 타입: 보통 자동 형변환
- 큰 범위 타입 → 작은 범위 타입: 직접 형변환 필요
- 자동 형변환은 값 손실 위험이 적을 때 일어난다.
- 강제 형변환은 값이 달라질 수도 있다는 것을 알고 직접 하는 것이다.
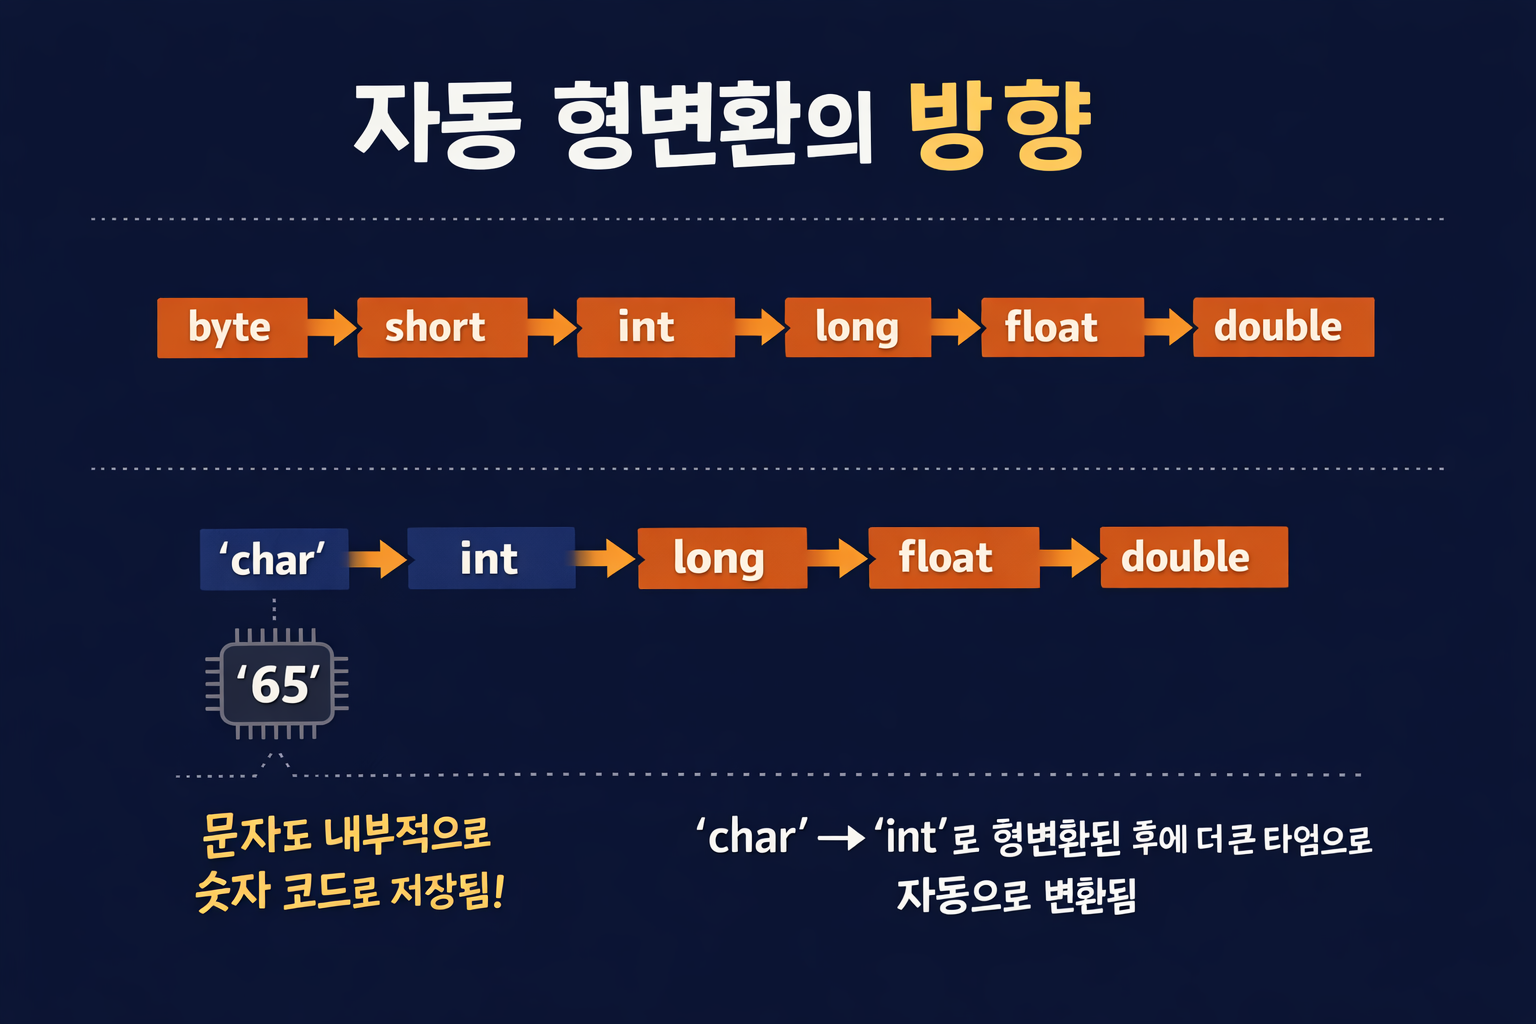
자동 형변환 방향은 대체로 이렇게 이해하면 된다.
byte → short → int → long → float → double
              char → int → long → float → double
코드 예제예제:
TypeTest5long var1 = 10; long var2 = 20L; // long var3 = 1000000000000; // 에러 long var4 = 1000000000000L; System.out.println(var1); System.out.println(var2); System.out.println(var4); // 출력결과 // 10 // 20 // 1000000000000이 코드는 큰 정수를 다룰 때 자료형을 맞춰줘야 한다는 점을 보여준다.
10은 기본적으로int리터럴이지만long변수에 안전하게 들어갈 수 있으므로 자동으로 들어간다.
반면1000000000000처럼int범위를 넘는 큰 정수는 기본int로 처리할 수 없어서 에러가 난다.
그래서 뒤에L을 붙여서long값이라는 것을 분명히 써줘야 한다.
헷갈리기 쉬운 부분자동 형변환이 된다고 해서 아무거나 다 되는 것은 아니다.
예를 들어 아래는 안 된다.byte b = 128; // 에러
byte가 담을 수 있는 범위를 넘기기 때문이다.
또 아래처럼 직접 형변환을 쓰면 문법상 가능해질 수는 있다.char ch = (char)1000;하지만 이렇게 했다고 해서 항상 원하는 값이 나오는 것은 아니다.
즉, 강제 형변환은 가능하다고 해서 항상 안전한 것은 아니다.
4. 문자형과 숫자형 형변환
개념
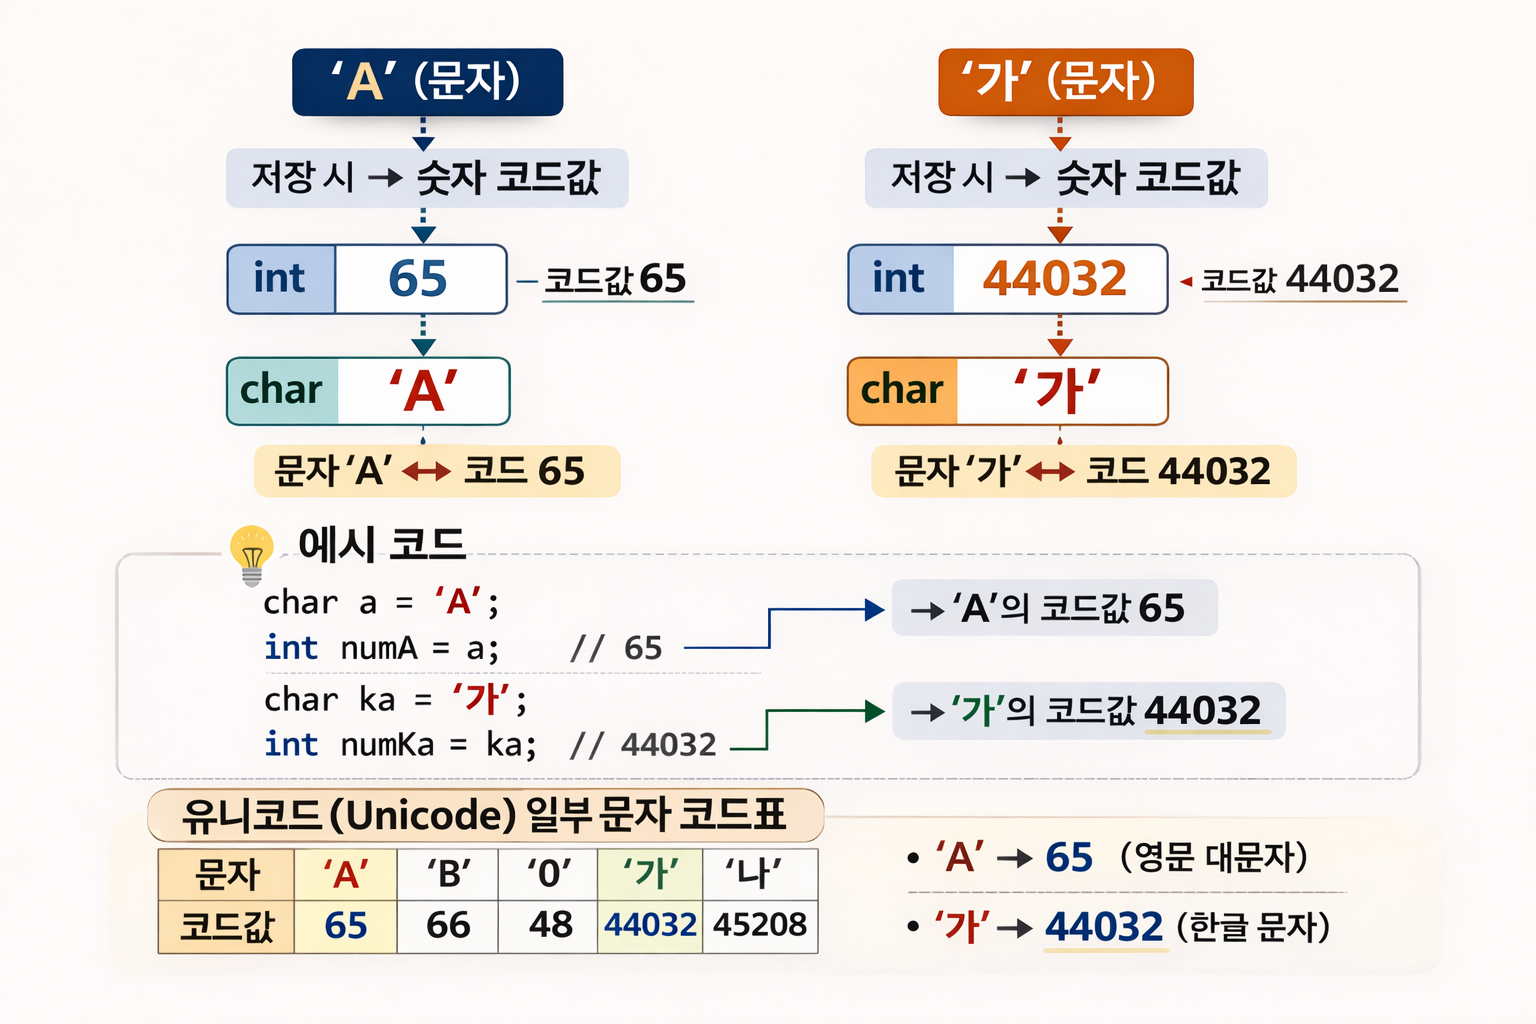
char는 문자형이지만, 내부적으로는 문자에 해당하는 숫자 코드값을 저장한다.
그래서 문자와 숫자는 완전히 끊어진 개념이 아니라 연결되어 있다.
예를 들어'A'는 문자이지만 내부 코드값은65다.
그래서char에65를 넣으면A가 되고, 반대로'A'를int에 넣으면65가 된다.
이 규칙은 영문자만 해당하는 것이 아니다.
한글도 마찬가지로 각각의 코드값을 가진다.
즉,char는 “문자를 저장한다”라고만 외우기보다 문자 코드를 저장하는 타입이라고 이해하는 게 더 정확하다.
핵심 특징
char는 내부적으로 숫자 코드값을 가진다.int → char형변환이 가능하다.char → int도 가능하다.- 영문자뿐 아니라 한글도 같은 방식으로 저장된다.
코드 예제예제:
TypeTest6char c1 = 'A'; char c2 = 65; char c3 = '\u0041'; char c4 = 0x41; char c5 = '가'; char c6 = 44032; char c7 = '\uAC00'; char c8 = 0xAC00; System.out.println(c1); System.out.println(c2); System.out.println(c3); System.out.println(c4); System.out.println(c5); System.out.println(c6); System.out.println(c7); System.out.println(c8); int c9 = 'A'; System.out.println(c9); // 출력결과 // A // A // A // A // 가 // 가 // 가 // 가 // 65이 코드는 문자와 숫자가 연결되어 있다는 점을 아주 잘 보여준다.
'A',65,'\u0041',0x41은 결국 모두 같은 문자A를 가리킨다.
표현 방법만 다를 뿐 결과는 같다.
또가도 마찬가지다.
'가',44032,'\uAC00',0xAC00은 모두 같은 한글 문자다.
즉, 문자 하나하나는 내부적으로 숫자 코드값과 연결되어 있다.
그리고int c9 = 'A';는 문자'A'의 코드값을 정수로 꺼낸 예다.
그래서 결과는65가 나온다.
헷갈리기 쉬운 부분
char는 문자형이지만 숫자를 넣을 수도 있다.
이게 이상하게 느껴질 수 있지만,char가 내부적으로 코드값을 저장하기 때문에 가능한 일이다.
반대로 아래 둘은 완전히 다르다.
'A': 문자 1개"A": 문자열즉, 작은따옴표와 큰따옴표는 같은 것이 아니다.
5. 정수형과 실수형 형변환
개념정수형과 실수형 사이의 형변환도 자주 나온다.
정수를 실수로 바꾸는 것은 비교적 단순하다.
정수10을double로 바꾸면10.0처럼 보이게 된다.
반대로 실수를 정수로 바꾸면 소수점 아래는 저장할 수 없기 때문에 잘려 나간다.
이때 중요한 점은 반올림이 아니라 버림이라는 것이다.
또float와double은 둘 다 실수형이지만 정밀도가 다르다.
그래서 큰 수나 소수 자리가 많은 값을 다룰 때는 결과 차이가 생길 수 있다.
코드 예제예제:
CastingEx4int i = 91234567; float f = (float)i; int i2 = (int)f; double d = (double)i; int i3 = (int)d; float f2 = 1.666f; int i4 = (int)f2; System.out.printf("i=%d\n", i); System.out.printf("f=%f i2=%d\n", f, i2); System.out.printf("d=%f i3=%d\n", d, i3); System.out.printf("(int)%f=%d\n", f2, i4); // 출력결과 // i=91234567 // f=91234568.000000 i2=91234568 // d=91234567.000000 i3=91234567 // (int)1.666000=1이 코드는 형변환에서 중요한 두 가지를 보여준다.
첫 번째는float의 정밀도 문제다.
91234567을float로 바꿨다가 다시int로 바꾸면91234568이 된다.
즉, 값이 완전히 그대로 유지되지 않는다.
두 번째는 실수에서 정수로 바꿀 때 소수점 아래가 버려진다는 점이다.
1.666f를int로 바꾸면1이 된다.
예제:
TypeTest7float var1 = 0.1234567890123456789f; double var2 = 0.1234567890123456789; System.out.println("var1: " + var1); System.out.println("var2: " + var2); System.out.printf("%.3f\n", var1); System.out.printf("%.6f\n", var1); // 출력결과 // var1: 0.12345679 // var2: 0.12345678901234568 // 0.123 // 0.123457이 코드는
float와double의 정밀도 차이를 보여준다.
둘 다 같은 수를 저장하려고 했지만,
float는 더 적은 자리까지만 정확하게 담을 수 있어서 뒤쪽이 더 빨리 잘린다.
그래서 정밀한 계산이 중요할수록double이 더 유리하다.
헷갈리기 쉬운 부분실수형을 정수형으로 바꿀 때 많이 하는 착각이 “반올림되겠지”라고 생각하는 것이다.
하지만 자바는 그렇지 않다.(int)1.9 (int)1.1 (int)1.666이 결과는 모두
1이다.
즉, 소수점 아래는 버려진다고 기억해야 한다.
또 정수를 실수로 바꾼다고 해서 언제나 완벽하게 안전한 것도 아니다.
특히float는 정밀도가 낮아서 큰 정수에서는 값이 달라질 수 있다.
6. 연산할 때 일어나는 형변환
개념형변환은 대입할 때만 일어나는 것이 아니다.
연산할 때도 자주 일어난다.
자바는 계산 전에 피연산자 타입을 맞추려고 한다.
이때 기억할 핵심 규칙은 두 가지다.
1. 서로 다른 타입이면 더 큰 타입으로 맞춘다.
2.byte,short,char처럼int보다 작은 정수형은 연산 전에int로 바뀐다.그래서 작은 타입끼리 계산해도 결과가 그대로 작은 타입으로 나오지 않을 수 있다.
핵심 특징
int + double이면int쪽이double처럼 맞춰진다.byte + byte도 결과는byte가 아니라int다.char + char도 결과는char가 아니라int다.- 연산 결과를 다시 작은 타입 변수에 넣으려면 형변환이 필요할 수 있다.
코드 예제예제:
TypeTest8final int NUM = 10; System.out.println(1 + NUM); System.out.println(1.0 + NUM); System.out.println('1' + NUM); System.out.println("1" + NUM); // 출력결과 // 11 // 11.0 // 59 // 110이 예제는 연산 결과가 피연산자 종류에 따라 완전히 달라질 수 있다는 점을 보여준다.
1 + NUM→ 정수 계산1.0 + NUM→double계산'1' + NUM→ 문자 코드값49에10을 더한 계산"1" + NUM→ 문자열 결합특히
'1' + NUM과"1" + NUM을 같이 보는 것이 중요하다.
겉보기에는 비슷하지만, 하나는 문자라서 숫자처럼 계산되고,
다른 하나는 문자열이라서 뒤에 이어 붙는다.
코드 예제예제:
char연산 예제char munja1 = '('; char munja2 = ')'; char result2 = '@'; // result2 = munja1 + munja2; // 에러 result2 = (char)(munja1 + munja2); System.out.println(result2); // 출력결과 // Q이 예제에서 중요한 점은
munja1 + munja2의 결과가char가 아니라int라는 것이다.
'('의 코드값은40,')'의 코드값은41이다.
둘을 더하면81이 되고, 이 값은 문자로 보면Q다.
하지만 연산 과정에서는char끼리 계산해도int로 바뀌기 때문에,
결과를 다시char변수에 넣으려면(char)형변환이 필요하다.
헷갈리기 쉬운 부분초보자가 자주 헷갈리는 문장이 바로 이것이다.
char result = 'A' + 1; // 에러겉으로 보기에는 문자에
1을 더했으니 문자일 것 같지만,
실제로는 연산 과정에서int가 되기 때문에 그대로는 넣을 수 없다.
그래서 아래처럼 써야 한다.char result = (char)('A' + 1);즉, 작은 타입끼리 연산했다고 해서 결과도 작은 타입이 되는 것은 아니다.
7. 응용 예제
문제에서 무엇을 하려는지숫자
1부터26까지를 알파벳A부터Z로 바꾸는 예제다.
형변환이 실제 코드에서 어떻게 활용되는지 보기 좋은 문제다.
이 예제에서 사용된 개념
- 난수 생성
switch- 문자 코드값
int → char형변환
코드 흐름처음에는
switch를 사용해서1이면A,2면B처럼 하나씩 나눠서 처리할 수 있다.
이 방식은 동작은 분명하지만 경우가 많아질수록 코드가 길어진다.
그런데 알파벳 대문자의 코드값 범위를 알고 있으면 훨씬 짧게 만들 수 있다.
대문자A의 코드값은65이므로,1 ~ 26범위의 숫자에64를 더하면65 ~ 90이 된다.
이 값 범위는 바로A ~ Z의 코드값 범위다.
즉, 숫자를 코드값으로 바꾸고 마지막에char로 형변환하면 알파벳을 바로 만들 수 있다.
코드 예제예제:
AlphaTestint num = (int)(Math.random() * 26) + 1; switch (num) { case 1: System.out.println('A'); break; case 2: System.out.println('B'); break; case 3: System.out.println('C'); break; // ... case 26: System.out.println('Z'); break; } // 아스키코드를 활용해서 할 수 있음 System.out.println((char)(num + 64)); // 출력결과 // A ~ Z 중 하나 // A ~ Z 중 하나이 예제의 핵심은 같은 결과를 더 짧고 자연스럽게 만들 수 있다는 점이다.
예를 들어num이1이면1 + 64 = 65가 된다.
그리고(char)65는'A'다.
num이17이면17 + 64 = 81,
(char)81은'Q'가 된다.
즉, 처음에는switch로 하나씩 나눠서 생각할 수 있지만,
문자 코드값을 이해하면 형변환 한 줄로 같은 결과를 만들 수 있다.
헷갈리기 쉬운 부분
num + 64까지만 하면 결과는 아직 숫자다.
문자로 보고 싶으면 마지막에 반드시(char)를 붙여야 한다.
또64를 그냥 외우기보다,
대문자A의 코드값이65라서 1을 A로 만들기 위해 64를 더하는 것이라고 이해하는 것이 더 중요하다.
8. 헷갈리기 쉬운 부분
1) 형변환은 원래 변수 자체를 바꾸는 것이 아니다double d = 85.4; int n = (int)d;이렇게 써도
d는 여전히85.4다.
형변환 결과를 따로 받아서 쓰는 것이다.
2) 실수 → 정수는 반올림이 아니라 버림이다(int)1.999 // 1 (int)3.14 // 3소수점 아래는 그냥 사라진다.
3) 큰 타입에서 작은 타입으로 갈 때는 값이 달라질 수 있다큰 정수를
float로 바꾸면 정밀도 문제로 값이 달라질 수 있다.
또 큰 정수를 작은 정수형에 넣으면 범위를 넘는 부분이 잘릴 수 있다.
즉, 형변환이 가능하다고 해서 원래 값이 항상 그대로 보존되는 것은 아니다.
4)char는 문자형이지만 숫자처럼 다뤄질 수도 있다
'A'는 문자지만 코드값은65다.
그래서char와 숫자형은 형변환으로 이어질 수 있다.
한글도 마찬가지다.
'가'역시 고유한 코드값을 가진 문자다.
5)'1'과"1"은 완전히 다르다
'1'→ 문자 1개"1"→ 문자열그래서 아래 결과도 달라진다.
System.out.println('1' + 10);   // 59
System.out.println("1" + 10);   // 110
보기에 비슷해도 동작은 전혀 다르다.