[다차원 배열]
1. 다차원 배열이란
1-1. 1차원 배열과 무엇이 다른가지금까지 본 일반 배열은 값을 한 줄로 저장하는
1차원 배열이다.
예를 들어 점수 5개를 저장하면int[] score = new int[5];처럼 한 줄로 담는다.
그런데 데이터가 한 줄이 아니라 여러 줄로 구성되면1차원 배열하나로는 다루기 불편하다.
이럴 때 사용하는 것이다차원 배열이다.
이번 범위에서 핵심은2차원 배열이다.
2차원 배열은 쉽게 말해 배열 안에 또 배열이 들어 있는 구조다.
즉,
1차원 배열은 값을 한 줄로 저장하고2차원 배열은 값을 여러 줄로 저장한다고 이해하면 된다.
1-2. 행과 열로 이해하기
2차원 배열은 처음에는 표처럼 이해하면 가장 쉽다.
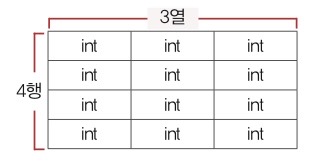
그래서 보통행과열로 나눠서 본다.int[][] score = new int[4][3];이 코드는
4행 3열크기의2차원 배열을 만든다는 뜻이다.
즉,
4행→ 줄이 4개3열→ 각 줄마다 칸이 3개
라고 보면 된다.
처음에는 표처럼 생각해도 괜찮다.
다만 자바의
2차원 배열은 실제로는 진짜 표 하나가 아니라 배열의 배열이라는 점을 뒤에서 다시 보게 된다.
1-3. 인덱스가 두 개인 이유
1차원 배열은 한 줄이기 때문에 인덱스가 하나면 된다.nums[0] nums[1] nums[2]하지만
2차원 배열은 몇 번째 줄인지, 그 줄의 몇 번째 칸인지를 함께 알아야 한다.
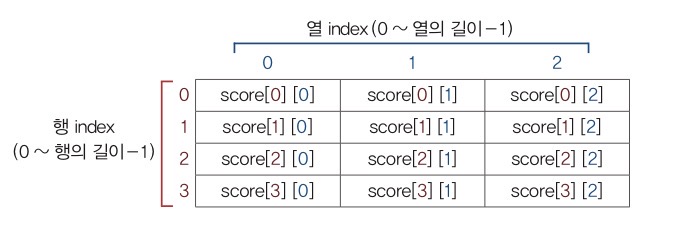
그래서 인덱스를 두 개 쓴다.score[행][열]예를 들어
score[1][2]는
두 번째 행,세 번째 열의 값이다.
여기서 많이 헷갈리는 부분이 있다.
배열 인덱스는0부터 시작하므로score[2][3]은2행 3열이 아니라 세 번째 행, 네 번째 열이다.
즉,
score[0][0]→ 1행 1열score[1][2]→ 2행 3열score[2][3]→ 3행 4열
이 그림은
score[행][열]구조를 처음 이해할 때 가장 도움이 된다.
2. 2차원 배열의 선언, 생성, 초기화
2-1. 선언 방법 3가지
2차원 배열선언은 아래 세 가지 방식이 모두 가능하다.int[][] score; int score[][]; int[] score[];모양만 조금 다를 뿐 의미는 모두 같다.
전부int형2차원 배열을 선언한 것이다.
보통은 아래처럼 쓰는 경우가 가장 많다.int[][] score;이 방식이
2차원 배열이라는 점이 가장 눈에 잘 들어오기 때문이다.
2-2. 5행 3열 배열 만들기
2차원 배열을 실제로 만들 때는new를 사용한다.int[][] srcoe // 2차원 배열 선언 score = new int[5][3]; // 2차원 배열 생성 or int[][] score = new int[5][3]; // 2차월 배열 선언 + 생성이 코드는
5행 3열배열을 만든다.
즉,int값을 저장할 수 있는 칸이15개생긴다.
이때 배열을 만들기만 해도 각 칸이 비어 있는 것은 아니다.
자바는 배열을 생성하면 각 요소를 기본값으로 자동 초기화한다.
int의 기본값은0이므로 아직 값을 따로 넣지 않았다면 전부0이 들어 있다.
2-3. 선언과 생성을 한 뒤, 값을 나눠서 대입하는 방법
2차원 배열은 먼저 배열만 만든 뒤, 나중에 각 칸에 값을 따로 넣을 수도 있다.int[][] score = new int[2][3]; score[0][0] = 100; score[0][1] = 90; score[0][2] = 80; score[1][0] = 70; score[1][1] = 60; score[1][2] = 50;이 방식은 배열의 구조를 먼저 만들고,
그다음행 인덱스와열 인덱스를 이용해 원하는 위치에 값을 넣는 방법이다.
즉,
score[0][0] = 100;→ 첫 번째 행, 첫 번째 열에100저장score[0][1] = 90;→ 첫 번째 행, 두 번째 열에90저장score[1][2] = 50;→ 두 번째 행, 세 번째 열에50저장이런 식으로 한 칸씩 직접 대입할 수 있다.
이 방식의 장점은 어느 위치에 어떤 값이 들어가는지 눈으로 확인하기 쉽다는 점이다.
반대로 칸 수가 많아지면 직접 하나씩 넣기 번거롭다는 점도 있다.
예제:
TwoArrayTest1int [][] score = new int [5][3]; // 5행의 3열 크기의 다차원배열 생성 System.out.println(score); System.out.println(score[0]); // 첫번째 행의 값 출력 System.out.println(score[0][0]); // 첫번째 행의 첫번째 열 출력 System.out.println(); for (int i = 0; i < score.length; i++) { for (int j = 0; j < score[i].length; j++) { System.out.print(score[i][j]); } System.out.println(); } // 출력결과 // [[I@... // [I@... // 0 // // 000 // 000 // 000 // 000 // 000이 코드는 배열을 생성했을 때 바로 무엇이 보이는지 보여준다.
score를 출력하면 전체2차원 배열의 참조 정보가 나온다.
score[0]을 출력하면 첫 번째 행 배열의 참조 정보가 나온다.
반면score[0][0]은 실제 값 하나를 꺼낸 것이므로0이 나온다.
그리고 아래 이중for문을 보면5행이기 때문에 줄은 5줄 나오고, 각 줄은3열이기 때문에0이 3개씩 출력된다.
값을 넣지 않았는데도0이 나오는 이유는int의 기본값이0이기 때문이다.
2-3. 선언, 생성, 초기화를 한 번에 하는 방법
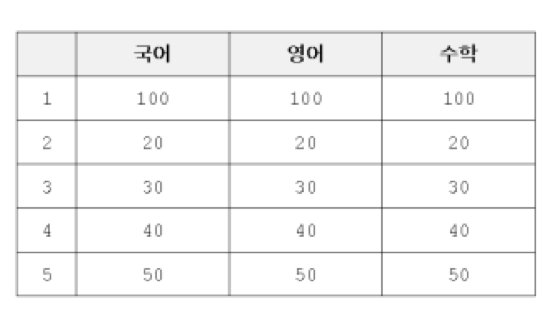
2차원 배열도 선언과 동시에 값을 넣을 수 있다.int[][] score = { {100, 100, 100}, {20, 30, 20} }; or int[][] score new int[][] = { {100, 100, 100}, {20, 30, 20} };여기서 중괄호가 한 번 더 들어가는 이유는 각 행이 각각 하나의 배열이기 때문이다.
즉,
- 바깥 중괄호 → 전체
2차원 배열- 안쪽 중괄호 → 각 행의
1차원 배열이다.
초보자는 여기서 안쪽 중괄호가 왜 필요한지 헷갈릴 수 있는데,
2차원 배열은 결국 행 하나하나가 각각 배열이라고 생각하면 이해하기 쉽다.
예제:
TwoArrayTest3int[][] twoA = { {1,2,3}, {4,5,6}, {7,8,9}, {0,0,0} }; System.out.println(twoA); // 행 배열들의 참조값 System.out.println(twoA[0]); // 첫 번째 행 배열의 참조값 System.out.println(twoA[0][0]);// 1행 1열의 값 for(int row = 0; row < twoA.length; row++) { for(int col = 0; col < twoA[row].length; col++) { System.out.print(twoA[row][col] + "\t"); } System.out.println(); } // 출력결과 // [[I@... // [I@... // 1 // 1 2 3 // 4 5 6 // 7 8 9 // 0 0 0이 코드는 선언과 동시에 값을 넣는 가장 기본적인 형태를 보여준다.
그리고 이중for문으로 전체 데이터를 표처럼 출력한다.
여기서도 중요한 것은 바깥 반복이행, 안쪽 반복이열이라는 점이다.
3. 2차원 배열의 구조와 접근
3-1. score,score[0],score[0][0]의 차이
2차원 배열을 배울 때 가장 먼저 정확히 구분해야 하는 것이 이 세 가지다.score score[0] score[0][0]셋은 완전히 다르다.
score→ 전체2차원 배열score[0]→ 첫 번째 행 배열score[0][0]→ 첫 번째 행의 첫 번째 값즉,
score[0]은 값 하나가 아니라 한 줄 전체다.
그래서System.out.println(score[0]);처럼 출력하면 값이 쭉 나오는 것이 아니라, 첫 번째 행 배열의 참조 정보가 나온다.
실제 값 하나를 꺼내려면score[0][0]처럼 두 번 들어가야 한다.
또score[2]의 크기는 얼마인지 생각해보면,
new int[5][3]으로 만들었으므로 세 번째 행의 길이는3이다.
즉,score[2].length는3이다.
3-2. score.length와score[i].length의 의미
2차원 배열에서는length도 구분해서 봐야 한다.score.length는 바깥 배열의 길이이므로
행의 개수다.
그리고score[i].length는
i번째 행 배열의 길이이므로열의 개수다.
예제:
TwoArrayTest2int[] a4[] = new int[5][12]; // 5행 12열 생성 System.out.println(a4); System.out.println(a4[0]); System.out.println(a4[1]); System.out.println(a4[2]); System.out.println(a4[3]); System.out.println(a4[4]); System.out.println(); System.out.println(a4.length); System.out.println(a4[0].length); System.out.println(a4[1].length); System.out.println(a4[2].length); System.out.println(a4[3].length); System.out.println(a4[4].length); // 출력결과 // [[I@... // [I@... // [I@... // [I@... // [I@... // [I@... // // 5 // 12 // 12 // 12 // 12 // 12이 코드에서는
a4.length가5- 각 행의
length가12로 나온다.
즉,
a4.length→ 행이 5개a4[0].length→ 첫 번째 행의 열이 12개라는 뜻이다.
초보자가 자주 헷갈리는 부분은score.length를 열 개수라고 생각하는 것이다.
하지만2차원 배열에서는score.length가 행 개수라는 점을 먼저 잡아야 한다.
3-3. 표처럼 보이지만 실제로는 배열의 배열이다겉으로 보면
2차원 배열은 네모난 표처럼 보인다.
그래서 처음에는 엑셀 표처럼 이해하기 쉽다.
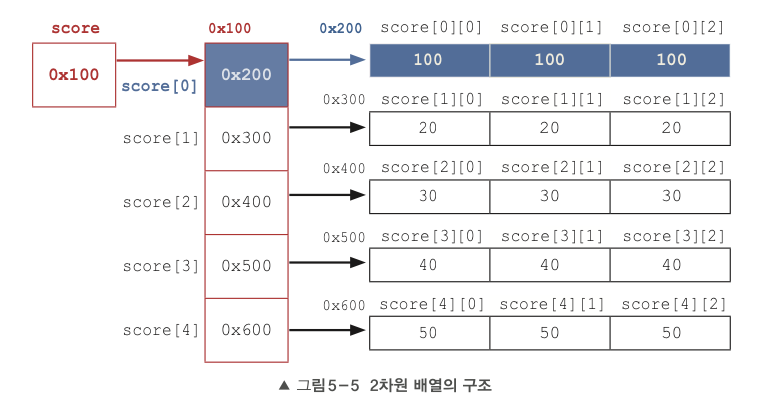
하지만 자바에서2차원 배열은 실제로 배열 안에 또 배열이 들어 있는 구조다.
즉, 여러 개의1차원 배열을 다시 하나의 배열이 묶고 있는 형태다.
그래서
score는 각 행 배열들을 가리키고score[0],score[1]같은 값은 각각 한 행 배열을 가리키며- 그 안의
score[0][0],score[0][1]같은 것이 실제 값이다이렇게 이해해야 한다.
이런 구조 때문에 자바의2차원 배열은 모든 행의 길이가 같을 필요가 없고, 그래서가변 배열도 만들 수 있다.
이 그림은 바깥 배열이 각 행 배열의 참조를 들고 있다는 점을 보여줘서,
2차원 배열을 단순한 표가 아니라 배열의 배열로 이해하는 데 잘 맞는다.
4. 2차원 배열과 반복문
4-1. 왜 이중 for문을 써야 하는가
2차원 배열은 값이 여러 줄로 들어 있으므로 한 번의 반복문만으로는 전체를 다 돌 수 없다.
그래서 보통이중 for문을 사용한다.
기본 형태는 아래와 같다.for (int row = 0; row < score.length; row++) { for (int col = 0; col < score[row].length; col++) { System.out.print(score[row][col] + " "); } System.out.println(); // 여기에 println을 두게되면 표 형태로 가독성 좋게 결과값이 나오게 된다 }이 구조는 꼭 익혀두는 것이 좋다.
- 바깥 반복 →
행- 안쪽 반복 →
열을 담당한다.
4-2. 바깥 반복과 안쪽 반복의 역할바깥
for문은 몇 번째 행인지를 바꿔가며 반복한다.
안쪽for문은 현재 행 안에서 몇 번째 열인지를 바꿔가며 반복한다.
즉, 흐름은 이렇게 된다.
1. 첫 번째 행 선택
2. 그 행의 열들을 처음부터 끝까지 출력
3. 줄바꿈
4. 다음 행 선택
5. 다시 그 행의 열들을 출력이 순서 때문에
2차원 배열은 행 단위로 내려가면서 값이 출력된다.
4-3. 전체 데이터를 출력하는 방법전체 데이터를 출력하려면 모든 행과 모든 열을 다 돌아야 한다.
그래서 안쪽 반복문 조건도 반드시 현재 행의 길이를 기준으로 써야 한다.for (int row = 0; row < score.length; row++) { for (int col = 0; col < score[row].length; col++) { System.out.print(score[row][col] + " "); } }여기서 안쪽 반복 조건을
score.length로 쓰면 안 된다.
안쪽 반복은 열을 도는 것이므로score[row].length를 써야 한다.
이 부분을 잘못 쓰면 열 개수만큼 정확히 반복하지 못한다.
특히 나중에 나오는가변 배열에서는 이 차이가 더 중요해진다.
4-4. 특정 행과 특정 열만 다루는 방법
2차원 배열에서는 전체를 다 도는 경우도 있지만, 특정 행이나 특정 열만 따로 처리할 때도 많다.
예를 들어마지막 행만 보고 싶다면 행을 고정하고 열만 바꾸면 된다.for (int col = 0; col < score[마지막행].length; col++) { System.out.print(score[마지막행][col] + " "); }System.out.println();
반대로
두 번째 열만 보고 싶다면 열을 고정하고 행만 바꾸면 된다.for (int row = 0; row < score.length; row++) { System.out.print(score[row][1] + " "); }여기서도 조심할 점이 있다.
두 번째 열이라고 해서 인덱스를2로 쓰면 안 된다.
배열 인덱스는0부터 시작하므로 두 번째 열은1이다.
즉,
- 행을 고정하면 한 줄만 볼 수 있고
- 열을 고정하면 같은 위치의 칸들을 세로로 볼 수 있다
는 감각을 잡아두면 된다.
5. 가변 배열
5-1. 가변 배열이란
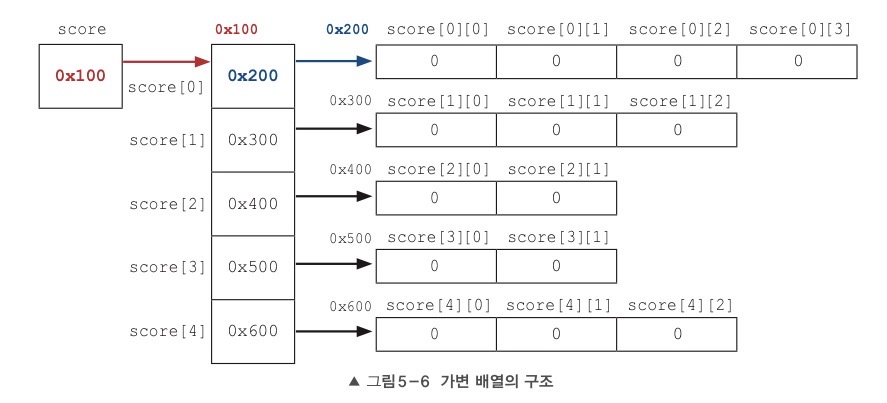
가변 배열은 행마다 열의 개수가 다른2차원 배열이다.
보통new int[5][3]처럼 만들면 모든 행의 길이가 같다.
즉, 항상3열씩 있는 직사각형 구조다.
그런데 자바의2차원 배열은 실제로배열의 배열이기 때문에
각 행이 가지는 열의 개수를 다르게 줄 수도 있다.
예를 들면
- 첫 번째 행은
3칸=> 열의 크기가3개- 두 번째 행은
4칸=> 열의 크기가4개- 세 번째 행은
2칸=> 열의 크기가2개처럼 만들 수 있다.
이런 구조를가변 배열이라고 한다.
5-2. new int[5][]의 의미아래 코드는 처음 보면 조금 어색할 수 있다.
int[][] score = new int[5][];이 코드는
2차원 배열이 맞다.
다만 아직열의 길이를 정하지 않은 상태다.
즉,
- 바깥쪽
5행은 만들어졌고- 각 행 안의 열 배열은 아직 연결되지 않았다
고 이해하면 된다.
그래서 이 상태에서 바로score[0][0]처럼 값을 쓰려고 하면 안 된다.
먼저score[0],score[1]같은 각 행에 실제 배열을 연결해야 한다.
초보자는 여기서이거 1차원 배열 아닌가?하고 헷갈릴 수 있는데,
이건 이미2차원 배열이고 마지막 차수만 나중에 정하는 형태일 뿐이다.
5-3. 행마다 열의 길이를 다르게 주는 방법
new int[5][]로 만든 뒤에는 각 행마다 따로 배열을 연결할 수 있다.int[][] score = new int[5][]; score[0] = new int[3]; score[1] = new int[4]; score[2] = new int[5]; score[3] = new int[6]; score[4] = new int[7];이렇게 하면 각 행이 가지는 열의 개수가 서로 달라진다.
즉,
- 첫 번째 행의 열 개수
3- 두 번째 행의 열 개수
4- 세 번째 행의 열 개수
5- 네 번째 행의 열 개수
6- 다섯 번째 행의 열 개수
7처럼 서로 다른 구조를 만들 수 있다.
여기서 바뀌는 것은 행의 개수가 아니라 각 행 안에 들어 있는 열의 길이다.
행의 개수는 처음에new int[5][]로 만들 때 이미5로 정해져 있고, 바뀌지 않는다.
이게 가능한 이유도 자바의2차원 배열이 진짜 표 하나가 아니라,
1차원 배열 여러 개를 묶는 방식으로 되어 있기 때문이다.
5-4. 가변 배열을 순회할 때 주의할 점
가변 배열은 행마다 길이가 다르기 때문에 반복문을 더 조심해서 써야 한다.
예를 들어 첫 번째 행이10칸, 두 번째 행이20칸, 세 번째 행이50칸일 수 있다.
이럴 때 안쪽 반복문을 모두 같은 횟수로 돌리면 안 된다.
반드시 현재 행 기준으로 써야 한다.for (int row = 0; row < emp.length; row++) { for (int col = 0; col < emp[row].length; col++) { System.out.print(emp[row][col] + " "); } System.out.println(); }예제:
TwoArrayTest5int[][] emp = new int[5][]; emp[0] = new int[10]; emp[1] = new int[20]; emp[2] = new int[50]; emp[3] = new int[10]; emp[4] = new int[30]; for(int row = 0; row < emp.length; row++) { for(int col = 0; col < emp[row].length; col++) { System.out.print(emp[row][col] + " "); } System.out.println(); } // 출력결과 // 첫 번째 행: 0이 10개 출력 // 두 번째 행: 0이 20개 출력 // 세 번째 행: 0이 50개 출력 // 네 번째 행: 0이 10개 출력 // 다섯 번째 행: 0이 30개 출력이 예제에서 중요한 것은 값보다 행마다 반복 횟수가 달라진다는 점이다.
각 행마다 길이가 다르기 때문에
- 첫 번째 줄은 10번 반복
- 두 번째 줄은 20번 반복
- 세 번째 줄은 50번 반복
된다.
또 아직 값을 따로 넣지 않았으므로int의 기본값인0이 출력된다.
여기서emp[0] = new int[10];을 보고 값을 넣는 코드라고 착각하기 쉬운데,
이건 값 초기화가 아니라 첫 번째 행의 열 크기를 10으로 정한 것이다.
6. 응용 예제 1 - 2차원 배열의 전체 합, 행의 합, 열의 합 구하기
문제에서 무엇을 하려는지이 예제는
2차원 배열안에 들어 있는 값을 여러 방식으로 더해 보는 연습이다.
전체 데이터의 합을 구하고, 마지막 행의 합과 두 번째 열의 합까지 따로 구하면서 행과 열을 어떻게 나눠서 다루는지 복습하는 것이 핵심이다.
이 예제에서 사용된 개념
2차원 배열행 인덱스,열 인덱스length- 이중
for문- 특정 행 고정
- 특정 열 고정
가변 배열
코드 흐름먼저
2차원 배열안에 여러 줄의 값을 저장한다.
이 배열은 행마다 길이가 서로 다르므로가변 배열형태다.
그다음 이중for문을 사용해서 모든 행과 모든 열을 돌며 전체 합을 구한다.
이후에는 마지막 행을 하나 고정한 뒤, 그 행 안의 열만 반복해서 마지막 행의 합을 구한다.
마지막으로는 두 번째 열을 고정하고 각 행을 차례대로 돌면서 해당 열의 값만 더한다.
즉, 같은2차원 배열이라도 전체를 돌 때, 행 하나만 볼 때, 열 하나만 볼 때 반복 방식이 달라진다는 점을 보여주는 예제다.
코드 예제예제:
TwoArrayTest4int nums[][] = { {10, 20, 30}, {11, 21, 31, 41}, {12, 22} }; int sum = 0; for(int i = 0; i < nums.length; i++) { for(int j = 0; j < nums[i].length; j++) { sum += nums[i][j]; } } System.out.println("전체 데이터의 합 : " + sum); int sumRow = 0; // 마지막 행의 데이터만 합산 for(int col = 0; col < nums[2].length; col++) { sumRow += nums[2][col]; } int sumCol = 0; // 두 번째 열의 데이터만 합산 for(int row = 0; row < nums.length; row++) { sumCol += nums[row][1]; } System.out.println("마지막 행 데이터의 합 : " + sumRow); System.out.println("두번째 열 데이터의 합 : " + sumCol); // 출력결과 // 전체 데이터의 합 : 198 // 마지막 행 데이터의 합 : 34 // 두번째 열 데이터의 합 : 63
헷갈리기 쉬운 부분전체 합을 구할 때 안쪽 반복문의 조건은 반드시
nums[i].length로 써야 한다.
안쪽 반복문은 현재 행의 열을 도는 것이므로, 현재 행 기준 길이를 써야 한다.
또두번째 열이라고 해서 인덱스를2로 쓰면 안 된다.
배열 인덱스는0부터 시작하므로 두 번째 열은1이다.
그리고 이 배열은 행마다 길이가 다르므로, 모든 행의 열 개수가 같다고 생각하면 안 된다.
이 점 때문에가변 배열에서는 반복문의 조건을 더 정확하게 써야 한다.