[객체지향 2 - 생성자, 변수와 메서드의 종류, 메모리 구조, 초기화]
이전 글에서는 클래스로 객체를 만들고, 참조변수로 그 객체를 가리키는 가장 기본적인 흐름을 봤다.
또 객체 안에는 값이 들어가고, 메서드로 동작을 만들 수 있다는 감각까지 먼저 잡았다.
이번에는 여기서 한 단계 더 들어간다.
객체를 만들 때생성자가 정확히 어떤 역할을 하는지, 변수와 메서드는 어떤 종류로 나뉘는지, 그 값들이 메모리 어디에 잡히는지, 그리고 초기화는 어떤 순서로 일어나는지까지 연결해서 이해해야 한다.
즉, 이번 파트는 객체를 단순히 만드는 법에서 끝나는 것이 아니라,
객체가 실제로 어떻게 준비되고 동작하는지를 이해하는 단계다.
1. 생성자 다시 보기
기본 생성자이전 글에서는 객체를 만들 때 필요한 값을 바로 넘기는 방식부터 봤다.
예를 들어new Car("포르쉐", "빨강", 120)처럼 객체를 만들면서 브랜드, 색상, 속도를 함께 전달하는 흐름이었다.
그런데 객체를 만들 때마다 항상 값을 직접 넘겨야 하는 것은 아니다.
상황에 따라서는 아무 값 없이 객체를 먼저 만들고, 미리 정해 둔 기본값으로 시작하게 만들 수도 있다.
이럴 때 사용하는 것이기본 생성자다.
즉, 이전에는
new Car("포르쉐", "빨강", 120)처럼 값을 직접 넣어 만들었다면
이제는new Car()처럼 아무 값 없이 객체를 만들고, 기본값으로 시작하게 만들 수도 있다는 뜻이다.
기본 생성자는 매개변수가 없는 생성자다.Car() {// 기본생성자}여기서 중요한 규칙이 하나 있다.
기본 생성자는 항상 자동으로 생기는 것이 아니다.
- 클래스 안에 생성자를 하나도 작성하지 않았을 때만 컴파일러가 기본 생성자를 자동으로 넣어 준다
- 생성자를 하나라도 직접 작성하면, 그다음부터는 필요한 생성자를 직접 만들어야 한다
즉,
new Car()를 쓰고 싶다면Car()생성자가 실제로 있어야 한다.
예를 들어 아래처럼 생성자를 전혀 쓰지 않은 클래스가 있으면class Car { String brand; }컴파일러가 보이지 않게 기본 생성자를 넣어 준다.
class Car {
    String brand;

    Car() {// 기본생성자}
}
그래서 아래처럼 사용할 수 있다.
Car c = new Car();
반대로 아래처럼 생성자를 하나라도 직접 만들면
class Car {
    String brand;

    Car(String brand) {
        this.brand = brand;
    }
}
이제는 컴파일러가
Car()를 자동으로 넣어 주지 않는다.
그래서 이 코드는 가능하지만Car c1 = new Car("포르쉐");이 코드는 에러가 난다.
Car c2 = new Car(); // 에러왜냐하면 지금 클래스 안에는
Car(String brand)만 있고,
매개변수가 없는Car()생성자는 없기 때문이다.
즉, 이번에 새로 봐야 할 핵심은 이것이다.
- 이전에는 값을 넘겨서 객체를 만들었다
- 이제는 아무 값 없이 객체를 만들고 기본값으로 시작하는 방식도 있다
- 하지만 그 방식은
Car()가 실제로 있을 때만 가능하다
this()이전 글에서는 기본 생성자 안에서 값을 직접 넣는 방식도 봤다.
Car() {
    brand = "기본자동차";
    color = "흰색";
    speed = 0;
}
이 방식도 틀린 것은 아니다.
다만 생성자가 여러 개 있을 때는 비슷한 초기화 코드가 반복될 수 있다.
그래서 이번에는 같은 일을 다른 생성자를 다시 호출하는 방식으로도 처리할 수 있다는 점을 보면 된다.
이때 사용하는 것이this()다.
this()는 같은 클래스 안의 다른 생성자를 호출하는 문법이다.class Car { String brand; String color; int speed; Car() { this("기본자동차", "흰색", 0); } Car(String brand, String color, int speed) { this.brand = brand; this.color = color; this.speed = speed; } }이 코드는
Car()생성자 안에서
Car(String brand, String color, int speed)생성자를 다시 호출한 것이다.
즉, 이전에는 기본 생성자 안에서 값을 하나씩 직접 넣었다면
이제는this()를 사용해서 이미 만들어 둔 다른 생성자에게 초기화를 맡길 수도 있다는 뜻이다.
흐름을 보면 이렇다.
1.new Car()로 객체를 만든다.
2.Car()생성자가 호출된다.
3.Car()안의this("기본자동차", "흰색", 0)가 실행된다.
4. 그러면Car(String brand, String color, int speed)생성자가 다시 호출된다.
5. 전달한 값이 멤버변수에 저장된다.즉,
this()는
생성자 안에서 다른 생성자를 불러서 초기화 코드를 재사용하는 방법이라고 이해하면 된다.
예를 들어 아래처럼 직접 값을 넣는 방식보다Car() { brand = "기본자동차"; color = "흰색"; speed = 0; }
이렇게 쓰면
Car() {
    this("기본자동차", "흰색", 0);
}
실제 초기화 코드를 한 생성자에만 모아 둘 수 있어서 더 깔끔해진다.
즉, 이번 파트에서 새로 봐야 할 핵심은 이것이다.
- 이전에는 생성자마다 값을 직접 적었다
- 이제는
this()로 다른 생성자를 다시 호출해서 초기화를 맡길 수도 있다- 그래서 중복 코드를 줄이고, 초기화 기준을 한곳에 모을 수 있다
이처럼 생성자를 같은 이름으로 여러 개 두고, 전달받는 값의 형태에 따라 다르게 준비하는 것을
생성자 오버로딩이라고 한다.
헷갈리기 쉬운 부분
this()는 아무 데서나 쓸 수 있는 것이 아니다.
- 생성자 안에서만 사용할 수 있다
- 반드시 첫 줄에서만 사용할 수 있다
그래서 아래 코드는 에러다.
Car() {
    speed = 10;
    this("기본자동차", "흰색", 0);   // 에러
}
왜냐하면
this()보다 앞에 다른 코드가 먼저 왔기 때문이다.
즉,this()는 생성자 안에서 다른 생성자를 부르는 문법이기 때문에, 시작하자마자 바로 호출해야 한다고 이해하면 된다.
또 하나 헷갈리기 쉬운 점은
this와this()는 완전히 다르다는 것이다.
this는 현재 객체 자신을 가리키는 참조값이고, 보통 멤버변수와 매개변수의 이름이 같을 때 둘을 구분하기 위해 사용한다.Car(String brand, String color, int speed) { this.brand = brand; this.color = color; this.speed = speed; }
반면
this()는 값을 저장하는 문법이 아니라, 같은 클래스 안의 다른 생성자를 다시 호출하는 문법이다.
Car() { this("기본자동차", "흰색", 0); }이 코드는
Car()가 직접brand,color,speed를 하나씩 넣는 것이 아니라,
이미 만들어 둔Car(String brand, String color, int speed)생성자에게 초기화를 맡기는 방식이다.
그래서this()를 사용할 때는 호출할 대상 생성자가 실제로 존재해야 한다.
예를 들어 아래처럼Car() { this("기본자동차", "흰색", 0); }작성했다면, 이 호출을 받아 줄 생성자도 클래스 안에 있어야 한다.
Car(String brand, String color, int speed) { this.brand = brand; this.color = color; this.speed = speed; }만약 이런 생성자가 없다면
this()가 넘긴 값을 받을 곳이 없기 때문에 에러가 난다.
즉,this()는 혼자 쓰는 문법이 아니라, 다른 생성자가 있을 때 그 생성자를 재사용하기 위해 쓰는 문법이라고 보면 된다.
반대로 다른 생성자가 없다면 기본 생성자 안에서 값을 직접 넣어야 한다.Car() { brand = "기본자동차"; color = "흰색"; speed = 0; }즉, 정리하면 다음 흐름이다.
this→ 멤버변수와 매개변수를 구분할 때 사용this()→ 같은 클래스의 다른 생성자를 호출할 때 사용this()를 쓰려면 호출할 생성자가 반드시 있어야 한다- 호출할 생성자가 없으면 기본 생성자 안에서 값을 직접 초기화해야 한다
1-2. 생성자를 이용한 인스턴스 복사
개념객체를 하나 만들고 나면, 그 객체와 거의 같은 값으로 시작하는 다른 객체가 필요할 때가 있다.
이럴 때 생성자를 이용하면 기존 객체의 값을 받아서 새 객체를 같은 상태로 만들어낼 수 있다.
여기서 중요한 것은 “복사”의 뜻이다.
처음 보면 복사라고 해서 기존 객체 자체가 통째로 하나 더 생기는 것처럼 느껴질 수 있는데, 자바에서 이 부분은 그렇게 이해하면 헷갈린다.
여기에서 말하는 복사는
기존 객체의 멤버변수 값을 하나씩 읽어서, 새로 만들어지는 객체의 멤버변수에 다시 넣는 것이다.
즉, 복사의 본질은 새 객체 생성 + 값 옮기기다.
또 같은 클래스로 만든 객체들은 원래 메서드와 클래스 변수는 공통 구조를 이미 공유한다.
그래서 객체마다 실제로 달라질 수 있는 부분은 인스턴스 변수의 값이다.
결국 “같은 상태의 객체”라는 말은 인스턴스 변수들의 값이 같다는 뜻으로 이해하면 된다.
왜 필요한가예를 들어 자동차 객체 하나가 이미 잘 만들어져 있다고 해보자.
색상, 기어 종류, 문 개수까지 다 들어 있는 상태다.
그런데 거의 똑같은 자동차를 하나 더 만들고 싶다면,
처음부터 값을 다시 다 적는 것도 가능하지만 번거롭다.
이럴 때 기존 객체를 생성자에 넘기면,
그 객체의 값을 기준으로 새 객체를 빠르게 만들 수 있다.
즉, 이미 만들어진 객체를 설계도처럼 한번 더 활용하는 방식이다.
핵심 특징생성자를 이용한 인스턴스 복사는 보통 아래 형태로 작성한다.
Car(Car c) {
    color = c.color;
    gearType = c.gearType;
    door = c.door;
}
이 생성자는
Car객체 하나를 매개변수로 받는다.
그리고 그 객체가 가지고 있던color,gearType,door값을
지금 새로 만들어지고 있는 객체 쪽으로 옮긴다.
여기서 매개변수c는 기존 객체를 가리키고,
생성자 안에서 값을 저장받는 쪽은 새로 만들어지는 객체다.
즉, 이 생성자의 역할은
“기존Car객체 하나를 받아서, 그 값과 같은 값으로 새Car객체를 만들기”라고 보면 된다.
가장 먼저 이해해야 하는 그림이 파트는 아래 흐름으로 이해하면 된다.
1. 먼저 원본 객체를 하나 만든다.
2. 그 객체를 매개변수로 넘기면서 새 객체를 만든다.
3. 생성자 안에서 원본 객체의 값을 읽는다.
4. 읽어 온 값을 새 객체의 멤버변수에 저장한다.
5. 결과적으로 값은 같지만, 객체는 서로 다른 두 개가 된다.즉,
원본 객체
→생성자 매개변수로 전달
→원본의 값 읽기
→새 객체에 저장
→같은 상태의 새 객체 완성이 흐름이다.
코드 예제예제:
CarCopyTest.javaclass Car { String color; String gearType; int door; Car() { color = "white"; gearType = "auto"; door = 4; } Car(Car c) { // [1] c는 이미 만들어져 있는 기존 Car 객체를 가리킨다. // [2] c가 가진 값을 하나씩 꺼내서 // [3] 지금 새로 만들어지는 객체의 멤버변수에 저장한다. this.color = c.color; this.gearType = c.gearType; this.door = c.door; } } public class CarCopyTest { public static void main(String[] args) { // [1] 원본 객체 생성 Car c1 = new Car(); // [2] c1을 넘겨서 새 객체 c2 생성 // 이때 c2는 c1과 같은 값으로 시작한다. Car c2 = new Car(c1); // [3] 복사된 객체 c2의 값만 변경 c2.color = "red"; c2.door = 2; // [4] 두 객체 출력 // c2를 바꿨지만 c1은 그대로인지 확인 System.out.println("c1 : " + c1.color + ", " + c1.gearType + ", " + c1.door); System.out.println("c2 : " + c2.color + ", " + c2.gearType + ", " + c2.door); // 출력결과 // c1 : white, auto, 4 // c2 : red, auto, 2 } }이 코드는 생성자로 객체를 복사하는 가장 기본적인 형태를 보여준다.
Car c2 = new Car(c1);이 핵심인데, 이 한 줄에서 c1의 값을 기준으로 c2라는 새 객체가 만들어진다.
그리고 그다음c2.color = "red";,c2.door = 2;처럼 값을 바꿔도c1은 바뀌지 않는다.
왜냐하면 둘은 같은 객체가 아니라, 서로 다른 객체이기 때문이다.
즉, 이 예제에서 꼭 봐야 할 포인트는 이것이다.
new Car(c1)은 기존 객체를 그냥 공유하는 게 아니다.- 생성자 안에서 값을 복사해서 새 객체를 하나 더 만든다.
- 그래서 나중에 복사본을 바꿔도 원본은 그대로 남는다.
헷갈리기 쉬운 부분
1) 객체 복사와 참조값 대입은 다르다가장 많이 헷갈리는 부분이 바로 이것이다.
아래 코드는 복사가 아니다.Car c1 = new Car(); Car c2 = c1;이 코드는
c1과c2가 같은 객체를 같이 가리키는 상태다.
즉, 객체가 하나인데 이름표만 두 개 붙은 것과 비슷하다.
그래서c2.color = "red";를 하면c1.color도 같이 바뀐 것처럼 보인다.
왜냐하면 둘이 같은 객체를 보고 있기 때문이다.
반면 아래 코드는 복사다.Car c1 = new Car(); Car c2 = new Car(c1);이 코드는
c1을 기준으로 새 객체 c2를 따로 만든 것이다.
그래서 둘은 값은 같게 시작할 수 있지만, 객체 자체는 서로 다르다.
즉,
c2 = c1→ 같은 객체를 같이 봄c2 = new Car(c1)→ 새 객체를 따로 만듦이 차이를 분명히 잡아야 한다.
2) 복사는 “객체 자체 이동”이 아니라 “값 복사”다처음 보면
new Car(c1)을 했을 때
c1이 통째로c2가 되는 것처럼 느껴질 수 있다.
하지만 실제로는 그렇지 않다.
생성자 안에서는 그냥 이런 일이 일어난다.this.color = c.color; this.gearType = c.gearType; this.door = c.door;즉,
- 기존 객체
c의 값을 읽고- 새 객체
this에 넣는 것뿐이다.
그래서
“객체를 복사한다”보다
“기존 객체의 값으로 새 객체를 초기화한다”라고 이해하면 훨씬 덜 헷갈린다.
3) 왜 굳이 생성자를 쓰는가이 방법의 장점은 초기화 기준을 한곳에 모을 수 있다는 것이다.
객체를 새로 만들 때마다 값을 하나하나 다시 적지 않아도 되고,
이미 잘 만들어진 객체를 기준으로 새 객체를 만들 수 있다.
즉, 기존 객체를 바탕으로
“거의 같은 객체 하나 더 만들기”가 쉬워진다.
한 번에 이해하는 정리이 파트는 아래 한 문장으로 정리하면 된다.
생성자를 이용한 인스턴스 복사는 기존 객체를 그대로 공유하는 것이 아니라, 기존 객체의 인스턴스 변수 값을 읽어서 같은 상태의 새 객체를 만드는 것이다.
1-3. this, this(), 복사 생성자를 같이 보기
개념앞에서 생성자를 이용한 인스턴스 복사를 봤다면, 이제
this,this()까지 같이 묶어서 보는 것이 좋다.
셋은 이름이 비슷해서 처음엔 헷갈리지만, 역할은 분명히 다르다.
this는 현재 만들어지고 있는 객체 자신을 가리킨다.
그래서 보통 멤버변수와 매개변수의 이름이 같을 때 둘을 구분하는 데 사용한다.
반면this()는 같은 클래스 안의 다른 생성자를 다시 호출하는 문법이다.
즉,this는 참조이고,this()는 생성자 호출이다. 둘은 생긴 것만 비슷할 뿐 역할은 전혀 다르다.
그리고 복사 생성자는
같은 클래스의 다른 객체를 매개변수로 받아서, 그 객체가 가진 인스턴스 변수 값을 지금 새로 만들어지는 객체에 옮겨 담는 생성자다.
즉, 셋을 한 번에 정리하면 이렇게 된다.
this→ 지금 이 객체 자신this()→ 다른 생성자 호출Car(Car c)같은 복사 생성자 → 다른 객체의 값을 받아 새 객체를 같은 상태로 만들기
왜 같이 봐야 하는가이 셋은 전부 객체를 어떻게 초기화할 것인가와 연결된다.
결국 생성자는 객체가 만들어질 때 값을 준비하는 역할을 하고,
this,this(), 복사 생성자도 모두 그 초기화 과정 안에서 등장하는 것이다.
예를 들어 자동차 객체를 만들 때를 생각해보자.
- 아무 값 없이 만들면 기본값으로 시작할 수도 있고
- 필요한 값을 직접 넘겨서 만들 수도 있고
- 이미 만들어져 있는 자동차를 기준으로 거의 같은 객체를 하나 더 만들 수도 있다
이 세 가지를 처리하는 과정에서
this()는 생성자끼리 연결해 중복을 줄이고this는 현재 객체의 멤버변수에 정확히 값을 저장하게 도와주고- 복사 생성자는 기존 객체의 상태를 기준으로 새 객체를 만들게 해준다
즉, 셋을 따로따로 외우기보다
“객체를 만드는 여러 방식”을 정리하는 도구들로 보면 훨씬 이해가 쉽다.
가장 먼저 이해해야 하는 흐름생성자 관련 내용은 아래 세 가지 흐름으로 정리하면 된다.
1) 기본값으로 객체 만들기
new Car()
→ 기본 생성자 호출
→ 필요하면this()로 다른 생성자에게 초기화 맡김
→ 새 객체 완성
2) 값을 직접 넘겨서 객체 만들기
new Car("blue", "auto", 4)
→ 매개변수가 있는 생성자 호출
→ 전달받은 값을 현재 객체의 멤버변수에 저장
→ 새 객체 완성
3) 기존 객체를 기준으로 새 객체 만들기
new Car(c1)
→ 복사 생성자 호출
→c1의 값을 읽음
→ 현재 객체에 저장
→ 같은 상태의 새 객체 완성즉, 다 다르게 보이지만 결국은 전부
새 객체를 만들고, 그 객체의 멤버변수 값을 채우는 과정이다.
코드 예제예제:
CarConstructorFlowTest.javaclass Car { String color; String gearType; int door; Car() { // [1] 아무 값 없이 객체를 만들면 // 아래 생성자에게 기본값 초기화를 맡긴다. this("white", "auto", 4); } Car(String color, String gearType, int door) { // [2] this.color 는 현재 객체의 멤버변수 // color 는 매개변수 // 둘의 이름이 같기 때문에 this로 구분한다. this.color = color; this.gearType = gearType; this.door = door; } Car(Car c) { // [3] c는 이미 만들어져 있는 다른 Car 객체 // [4] c의 값을 읽어서 현재 객체에 복사한다. this.color = c.color; this.gearType = c.gearType; this.door = c.door; } void printInfo() { System.out.println(color + ", " + gearType + ", " + door); } } public class CarConstructorFlowTest { public static void main(String[] args) { // [1] 기본 생성자로 객체 생성 Car c1 = new Car(); // [2] 값을 직접 넘겨서 객체 생성 Car c2 = new Car("blue", "manual", 2); // [3] c2를 기준으로 복사 객체 생성 Car c3 = new Car(c2); // [4] c3만 따로 값 변경 c3.color = "red"; // [5] 출력으로 상태 비교 c1.printInfo(); c2.printInfo(); c3.printInfo(); // 출력결과 // white, auto, 4 // blue, manual, 2 // red, manual, 2 } }이 코드는 생성자 관련 흐름을 한 번에 보여준다.
c1은new Car()로 만들었기 때문에
기본 생성자가 호출되고, 그 안에서 다시this("white", "auto", 4)가 실행된다.
즉, 기본값 객체를 만드는 흐름이다.
같은 클래스 안의 다른 생성자를this()로 호출할 수 있다는 점은 책에서도 생성자 호출 규칙으로 설명한다.
c2는 값을 직접 넘긴 경우다.
Car(String color, String gearType, int door)생성자가 호출되고,
그 안에서this.color = color;처럼 현재 객체의 멤버변수에 값이 저장된다.
여기서this는 현재 객체를 가리키는 참조다.
c3는 복사 생성자로 만든 객체다.
Car(Car c)가 호출되면서c2의 값을 읽어 와 새 객체에 복사한다.
즉,c3는c2와 같은 값으로 시작하지만, 둘은 서로 다른 객체다.
그래서c3.color = "red";를 해도c2.color는 그대로다.
헷갈리기 쉬운 부분
1) 복사 생성자도 결국 생성자다복사 생성자라고 해서 특별한 별도 문법이 있는 것은 아니다.
그냥 매개변수 타입이 같은 클래스인 생성자일 뿐이다.Car(Car c) { this.color = c.color; this.gearType = c.gearType; this.door = c.door; }즉, 이름이 따로 정해져 있는 것이 아니라
“복사용으로 쓰는 생성자”라서 복사 생성자라고 부르는 것이다.
2. 오버로딩
개념
오버로딩(overloading)은 이름은 같지만, 매개변수의 개수나 타입이 다른 생성자나 메서드를 여러 개 만드는 것이다.
쉽게 말하면, 같은 이름의 기능을 여러 형태로 준비해 두는 것이라고 보면 된다.
예를 들어 자동차를 만들 때
- 아무 정보 없이 만들 수도 있고
- 브랜드만 넣어서 만들 수도 있고
- 브랜드, 색상, 속도를 모두 넣어서 만들 수도 있다.
이런 식으로 하는 일은 비슷하지만, 전달하는 값이 다른 경우에 오버로딩을 사용한다.
자바에서는
생성자 오버로딩메서드 오버로딩둘 다 가능하다.
핵심 특징오버로딩은 이름만 같다고 되는 것이 아니다.
반드시 매개변수 목록이 달라야 한다.
여기서 매개변수 목록이 다르다는 말은 이런 뜻이다.
- 매개변수의 개수가 다르다.
- 매개변수의 자료형이 다르다.
- 매개변수의 순서가 다르다.
(int, String과String, int는 다르게 본다)반대로 아래처럼 매개변수 이름만 다른 것은 오버로딩이 아니다.
void test(int a) {}
void test(int b) {}   // 에러
둘 다
int하나를 받는 같은 형태이기 때문이다.
또 하나 주의할 점이 있다.
반환형이 다르다고 해서 오버로딩이 되는 것은 아니다.int print() { return 1; } double print() { return 1.0; } // 에러메서드를 구분할 때는 반환형이 아니라 매개변수 목록을 기준으로 보기 때문이다.
생성자 오버로딩생성자도 이름이 모두 클래스명으로 같기 때문에,
매개변수를 다르게 해서 여러 개 만들 수 있다.
이렇게 하면 객체를 만드는 방법을 여러 가지로 준비할 수 있다.예제:
CarTestclass Car { String brand; String color; int speed; Car() { // 아무 값 없이 객체를 만들면 이 생성자가 먼저 호출된다. // 여기서 바로 값을 넣지 않고, 아래 생성자에게 기본값 전달을 맡긴다. this("기본자동차", "흰색", 0); } Car(String brand) { // 브랜드만 전달되면 이 생성자가 호출된다. // 전달받은 brand는 그대로 넘기고, // color와 speed는 기본값으로 채운다. this(brand, "흰색", 0); } Car(String brand, String color, int speed) { // 최종적으로는 이 생성자에서 실제 값 저장이 이루어진다. this.brand = brand; this.color = color; this.speed = speed; } void printInfo() { System.out.println(brand + ", " + color + ", " + speed); } } public class CarTest { public static void main(String[] args) { // new Car() // → Car() // → this("기본자동차", "흰색", 0) // → Car(String, String, int) // → brand, color, speed 저장 Car c1 = new Car(); // new Car("현대") // → Car(String brand) // → this(brand, "흰색", 0) // → Car(String, String, int) // → brand, color, speed 저장 Car c2 = new Car("현대"); // new Car("기아", "검정", 100) // → Car(String, String, int) 바로 호출 // → 전달한 값이 바로 저장 Car c3 = new Car("기아", "검정", 100); c1.printInfo(); c2.printInfo(); c3.printInfo(); } } // 출력결과 // 기본자동차, 흰색, 0 // 현대, 흰색, 0 // 기아, 검정, 100이 코드는 생성자를 여러 형태로 만들 수 있다는 점을 보여준다.
Car()는 아무 값도 주지 않고 객체를 만든다.Car(String brand)는 브랜드만 받아서 만든다.Car(String brand, String color, int speed)는 필요한 정보를 전부 받아서 만든다.여기서 핵심은 결국 가장 아래 생성자 하나로 값 저장을 모으고 있다는 점이다.
앞에서 본this()가 이런 상황에서 특히 자주 쓰인다.
즉, 생성자 오버로딩은
객체를 여러 방식으로 만들 수 있게 해 주고,
this()는 그 여러 생성자를 하나의 공통 처리로 연결해 주는 역할을 한다.
메서드 오버로딩메서드도 이름은 같게 두고,
매개변수를 다르게 해서 여러 개 만들 수 있다.
이렇게 하면 비슷한 기능을 하나의 이름으로 묶을 수 있다.예제:
PrintTestpublic class PrintTest { void print() { // 전달한 값이 없을 때 실행 System.out.println("출력할 값이 없습니다."); } void print(int num) { // int 하나를 전달했을 때 실행 System.out.println("정수: " + num); } void print(String text) { // String 하나를 전달했을 때 실행 System.out.println("문자열: " + text); } void print(int num, String text) { // int와 String을 함께 전달했을 때 실행 System.out.println(num + " / " + text); } public static void main(String[] args) { PrintTest p = new PrintTest(); // 매개변수가 없으므로 print() 호출 p.print(); // int 하나를 전달했으므로 print(int) 호출 p.print(10); // String 하나를 전달했으므로 print(String) 호출 p.print("hello"); // int, String 순서로 전달했으므로 print(int, String) 호출 p.print(7, "java"); } } // 출력결과 // 출력할 값이 없습니다. // 정수: 10 // 문자열: hello // 7 / java이 코드는
- 전달하는 값이 없으면
print()- 정수를 주면
print(int num)- 문자열을 주면
print(String text)- 정수와 문자열을 같이 주면
print(int num, String text)처럼 전달한 값의 형태에 따라 알맞은 메서드가 선택된다.
즉, 메서드 오버로딩은
기능 이름은 하나로 유지하면서도,
상황에 따라 다른 입력을 받을 수 있게 만드는 방법이다.
왜 오버로딩을 쓰는가오버로딩을 쓰면 이름을 억지로 여러 개 만들지 않아도 된다.
예를 들어 출력 기능이라고 해서
printInt()printString()printNothing()처럼 이름을 전부 따로 만들 수도 있다.
하지만 이렇게 하면 기능은 비슷한데 이름이 너무 흩어진다.
반면 오버로딩을 사용하면 모두
이름은 하나로 정리되고 사용법은 더 자연스러워진다.
생성자도 마찬가지다.
- 기본값으로 만들기
- 일부 값만 넣고 만들기
- 모든 값을 넣고 만들기
이런 여러 경우를 하나의 클래스 안에서 자연스럽게 처리할 수 있다.
헷갈리기 쉬운 부분
1) 매개변수 이름만 바꾸면 오버로딩이 되는 것이 아니다아니다.
중요한 것은 변수 이름이 아니라 매개변수의 형태다.void test(int a) {} void test(int b) {} // 에러이 둘은 똑같이
int하나를 받는 메서드이기 때문에 같은 메서드로 본다.
2) 반환형만 다르면 오버로딩이 되는 것이 아니다이것도 많이 헷갈린다.
int add(int x, int y) { return x + y; }
double add(int x, int y) { return x + y; }   // 에러
반환형은 다르지만, 매개변수 목록이 같기 때문에 오버로딩이 아니다.
3) 생성자 오버로딩과 메서드 오버로딩은 따로 떨어진 개념이 아니다둘은 완전히 다른 개념처럼 보이지만, 핵심 규칙은 같다.
- 이름은 같다.
- 매개변수 목록은 다르다.
즉, 생성자든 메서드든 같은 기준으로 이해하면 된다.
4) 오버로딩은 이름이 같다고 무조건 좋은 것이 아니다비슷한 기능을 묶을 때는 좋지만,
너무 관계없는 기능까지 같은 이름으로 묶으면 오히려 헷갈릴 수 있다.
즉, 오버로딩은
같은 목적의 기능을 입력값만 다르게 처리할 때 쓰는 것이 가장 자연스럽다.
한 번에 정리하면오버로딩은 같은 이름의 생성자나 메서드를 여러 형태로 만드는 방법이다.
이때 중요한 기준은 반환형이 아니라 매개변수 목록이다.
- 생성자 오버로딩 → 객체를 여러 방식으로 만들기 위해 사용
- 메서드 오버로딩 → 비슷한 기능을 하나의 이름으로 묶기 위해 사용
즉, 오버로딩은
기능은 비슷하지만 받는 값이 다를 때 코드를 더 자연스럽게 만들기 위한 문법이라고 이해하면 된다.
3. 변수의 종류와 스코프
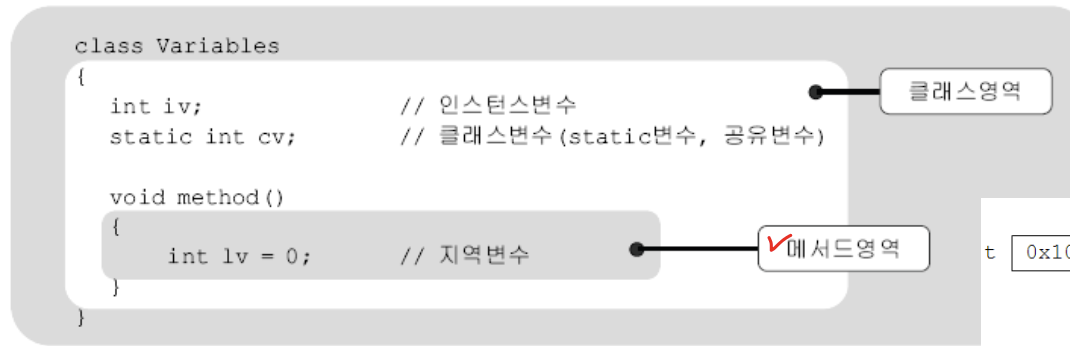
개념자바의 변수는 값의 종류만으로 나뉘는 것이 아니라, 어디에 선언했는가에 따라서도 나뉜다.
여기서scope는 변수를 사용할 수 있는 범위를 뜻한다.
그리고 이 선언 위치에 따라 그 변수가 언제 만들어지는지, 어디까지 사용할 수 있는지, 객체마다 따로 가지는 값인지 아니면 모두가 함께 쓰는 값인지가 결정된다.
자바에서 구분해야 하는 변수는 크게 세 가지다.
클래스 변수인스턴스 변수지역 변수먼저 큰 기준부터 잡으면 이렇다.
- 클래스 안, 메서드 밖에 선언된 변수 →
멤버변수- 메서드 안에 선언된 변수 →
지역 변수
클래스 변수와인스턴스 변수를 묶어서멤버변수라고 한다.
그리고
멤버변수는 다시 두 가지로 나뉜다.
static이 붙으면 →클래스 변수static이 없으면 →인스턴스 변수
인스턴스 변수
인스턴스 변수는 클래스 안에 선언된멤버변수중에서,static이 붙지 않은 변수를 말한다.
쉽게 말하면 객체를 만들 때마다 각 객체가 따로 가지는 변수라고 보면 된다.
예를 들어 아래와 같이Car클래스를 만들었다고 해보자.class Car { String name; String color; int speed; }여기서
name,color,speed는 모두 클래스 안에 선언되어 있으므로멤버변수다.
그리고static이 붙어 있지 않으므로, 이 변수들은 모두인스턴스 변수다.
여기서 중요한 점은, 클래스 안에 이렇게 변수를 선언했다고 해서 바로 값이 사용되는 것은 아니라는 점이다.
이 단계는 자동차가 가져야 할 속성을 설계해 둔 상태에 가깝다.
즉, 자동차는 이름이 있을 수 있고, 색상이 있을 수 있고, 속도가 있을 수 있다는 틀만 만들어 둔 것이다.
실제로 이 변수들이 각자 따로 생기는 시점은 객체를 생성할 때다.
예를 들어 아래처럼new Car()를 실행하면Car객체가 하나 만들어지고, 그 객체 안에name,color,speed라는인스턴스 변수도 함께 만들어진다.Car c1 = new Car(); c1.name = "포르쉐"; c1.color = "빨강"; c1.speed = 120;여기서
c1은Car객체를 가리키는참조변수다.
그리고name,color,speed는c1이 가리키는 객체 안에 들어 있는인스턴스 변수다.
즉,"포르쉐","빨강",120은c1객체만의 값이다.
객체를 하나 더 만들면 상황이 더 분명해진다.Car c2 = new Car(); c2.name = "페라리"; c2.color = "노랑"; c2.speed = 200;이제
c1과c2는 서로 다른 객체다.
같은Car클래스로 만들었지만, 각 객체 안의인스턴스 변수값은 따로 존재한다.
즉, 이렇게 이해하면 된다.
c1.name→"포르쉐"c2.name→"페라리"둘 다
name이라는 같은 변수를 쓰는 것처럼 보이지만, 실제로는 서로 다른 객체 안에 들어 있는 별개의 값이다.
그래서c1.speed를 바꾼다고 해서c2.speed가 함께 바뀌지 않는다.
여기서 하나 더 구분해야 할 것이 있다.Car c1 = new Car();이 코드에서
c1자체가인스턴스 변수는 아니다.
c1은 객체를 가리키는참조변수이고, 보통main()안에서 선언했다면지역 변수다.
실제인스턴스 변수는new Car()로 만들어진 객체 안에 들어 있는name,color,speed같은 변수들이다.
즉, 정리하면 아래와 같다.
c1→ 객체를 가리키는참조변수name,color,speed→ 객체 안에 들어 있는인스턴스 변수
또 하나 중요한 점이 있다.
객체는 한 번 만들어졌다고 해서 무조건 계속 남아 있는 것이 아니다.
어떤 객체를 가리키는참조변수가 하나도 없어지면, 그 객체는 더 이상 프로그램에서 사용할 수 없는 상태가 된다.
예를 들어 어떤 객체를 만들었는데, 그 객체를 가리키던 변수가 사라지거나 다른 객체를 가리키게 되면, 원래 객체는 더 이상 접근할 수 없게 된다.
이런 객체는garbage collector가 나중에 정리할 대상으로 본다.
즉, 프로그램에서 더 이상 쓰지 않는 객체를 자동으로 정리해 주는 것이다.
다만 여기서 헷갈리면 안 되는 점이 있다.
참조가 끊어졌다고 해서 객체가 바로 즉시 메모리에서 사라지는 것은 아니다.
garbage collector는 필요한 시점에 동작하면서 사용하지 않는 객체를 정리한다.
보통 일정한 시점에 실행되기도 하고, 사용할 수 있는 메모리가 부족해졌을 때 동작하기도 한다.
그래서 참조가 없어졌다고 해도, 그 객체가 바로 그 순간 즉시 사라진다고 단정해서 생각하면 안 된다.
이 말을인스턴스 변수와 연결해서 보면 더 이해하기 쉽다.
인스턴스 변수는 객체 안에 들어 있는 값이므로, 그 객체가 살아 있는 동안 함께 존재한다.
그리고 객체가 더 이상 사용되지 않아 정리 대상이 되면, 그 객체 안에 들어 있던인스턴스 변수도 함께 의미를 잃게 된다.
즉,인스턴스 변수는
객체를 만들 때 함께 생기고, 객체마다 따로 존재하며, 그 객체가 살아 있는 동안 유지되는 개별적인 값이라고 이해하면 된다.
클래스 변수
클래스 변수는 클래스 안에 선언된멤버변수중에서,static이 붙어 있는 변수를 말한다.
쉽게 말하면 객체마다 따로 생기는 값이 아니라, 같은 클래스로 만든 모든 객체가 함께 쓰는 공통 변수다.
예를 들어 아래와 같이Car클래스를 만든다고 해보자.class Car { String name; String color; int speed; static int wheelCount = 4; }여기서
name,color,speed는 자동차마다 달라질 수 있는 값이므로인스턴스 변수다.
반면wheelCount는static이 붙어 있으므로클래스 변수다.
이렇게 나누는 이유는 자동차마다 달라져야 하는 값과, 모든 자동차가 공통으로 가지는 값을 구분해야 하기 때문이다.
예를 들어
- 자동차 이름은
포르쉐,페라리처럼 달라질 수 있고- 색상도
빨강,노랑처럼 달라질 수 있고- 속도도 각각 다를 수 있다
이런 값들은 객체마다 따로 가져야 하므로
인스턴스 변수로 두는 것이 맞다.
하지만 바퀴 수는 보통 모든 자동차가 공통으로 가지는 값이다.
어떤 자동차는 바퀴가4개인데, 같은 구조의 다른 자동차는 바퀴가10개라고 하면 일반적인 자동차 개념으로 보기 어렵다.
이처럼 모든 객체가 똑같이 공유해야 하는 값은클래스 변수로 두는 것이 자연스럽다.
클래스 변수는 객체를 생성할 때마다 새로 만들어지지 않는다.
클래스가 메모리에 올라갈 때 한 번 만들어지고, 같은 클래스로 만든 모든 객체가 그 값을 함께 사용한다.
그래서클래스 변수는 객체를 만들지 않아도 사용할 수 있다.
보통 아래처럼클래스이름.변수명형태로 접근한다.
Car 예제
이 예제에서
name,color,speed는c1객체 안에 들어 있는인스턴스 변수다.
반면wheelCount는Car클래스 전체가 함께 사용하는클래스 변수다.class Car { String name; // 인스턴스 변수 String color; // 인스턴스 변수 int speed; // 인스턴스 변수 static int wheelCount = 4; // 클래스 변수 } public class CarTest { public static void main(String[] args) { Car c1 = new Car(); c1.name = "포르쉐"; // c1 객체의 인스턴스 변수에 값 저장 c1.color = "빨강"; // c1 객체의 인스턴스 변수에 값 저장 c1.speed = 120; // c1 객체의 인스턴스 변수에 값 저장 System.out.println(c1.name); // c1 객체의 name 값 출력 System.out.println(Car.wheelCount); // Car 클래스가 공통으로 가지는 wheelCount 출력 // 출력결과 // 포르쉐 // 4 } }보통
클래스 변수는 이렇게클래스이름.변수명형태로 접근한다.
여기서Car.wheelCount는c1만의 값이 아니라,Car클래스로 만든 모든 객체가 함께 쓰는 공통값이라는 뜻이다.
물론c1.wheelCount처럼 객체를 통해 접근할 수도 있지만,클래스 변수는 특정 객체의 값이 아니라 클래스 전체가 공유하는 값이므로Car.wheelCount처럼 클래스 이름으로 접근하는 것이 더 알맞다.
즉,클래스 변수는
객체마다 따로 둘 필요가 없는 공통 속성을 저장할 때 사용하는 변수라고 이해하면 된다.
지역 변수
지역 변수는 메서드 안에 선언되는 변수다.
이 변수는 멤버처럼 오래 살아 있는 값이 아니라,
메서드가 실행되는 동안만 잠깐 사용되는 값이다.
예를 들어public static void main(String[] args) { int num = 10; }여기서
num은main()안에 선언되었으므로지역 변수다.
지역 변수는 메서드가 호출되었다고 해서 바로 다 만들어지는 것이 아니라,
그 변수 선언문이 실제로 수행되는 순간 생성된다.
그리고 메서드가 끝나면 함께 사라진다.
이 규칙은 조건문이나 반복문 블록 안에서도 똑같다.
예를 들어if (true) { int a = 10; }이렇게 블록 안에서 선언한 변수
a는
그 블록을 벗어나면 더 이상 사용할 수 없다.
즉,지역 변수는
계산하거나 잠깐 저장해 두기 위해 메서드 안에서만 쓰는 변수라고 이해하면 된다.
또, 클래스 영역에 선언되지 않은 변수는 모두지역 변수이며,지역 변수에는static을 붙일 수 없다.
한 번에 정리하면여기까지 나온 변수들을 가장 쉽게 구분하는 방법은,
“이 값이 누구를 위한 값인가?”를 생각해 보는 것이다.
어떤 값이 객체마다 따로 있어야 하는 값이라면인스턴스 변수다.
예를 들어 자동차마다 이름, 색상, 속도가 다를 수 있으므로 이런 값은 객체별로 따로 있어야 한다.
반대로 어떤 값이 모든 객체가 함께 써야 하는 공통값이라면클래스 변수다.
예를 들어 자동차의 바퀴 수처럼, 객체마다 따로 둘 필요가 없는 값은static을 붙여서 클래스 전체가 공유하게 만든다.
그리고 어떤 값이 메서드 안에서 잠깐 계산하거나 잠깐 저장해 두기 위한 값이라면지역 변수다.
이 값은 메서드가 실행되는 동안만 존재하고, 실행이 끝나면 함께 사라진다.
즉, 아주 간단하게 정리하면 이렇다.
인스턴스 변수→ 객체마다 따로 가져야 하는 값클래스 변수→ 모든 객체가 함께 쓰는 공통 값지역 변수→ 메서드 안에서 잠깐 사용하는 값결국 판단 기준은 이것이다.
객체마다 달라야 하면인스턴스 변수, 모두가 함께 써야 하면클래스 변수, 메서드 안에서 잠깐만 쓰면지역 변수다.
멤버변수와 지역 변수의 차이여기서 꼭 같이 알아둬야 하는 중요한 규칙이 있다.
바로 멤버변수는 자동으로 초기화되지만, 지역 변수는 자동으로 초기화되지 않는다는 점이다.
먼저멤버변수는 클래스 안에 선언된 변수다.
이 변수들은 객체가 만들어지거나 클래스가 메모리에 올라갈 때, 자바가 기본값을 자동으로 넣어 준다.
그래서 값을 따로 넣지 않았더라도, 일단은 사용할 수 있는 상태로 준비된다.
반면지역 변수는 메서드 안이나 블록 안에서 잠깐 사용하는 변수다.
이 변수는 자바가 자동으로 값을 넣어 주지 않는다.
즉, 개발자가 직접 값을 넣기 전까지는 사용할 수 없다.
예를 들어 아래 코드를 보자.void test() { int num; System.out.println(num); // 에러 }여기서
num은 메서드 안에서 선언되었으므로지역 변수다.
그런데 아직num에 아무 값도 넣지 않았다.
이 상태에서 바로 출력하려고 하면, 자바는 “이 변수에 어떤 값이 들어 있는지 확실하지 않다”라고 보고 에러를 낸다.
즉,지역 변수는 이런 식으로 반드시 값을 직접 넣은 뒤에 사용해야 한다.void test() { int num = 10; System.out.println(num); }이 경우에는
num에10을 넣고 나서 출력하므로 문제가 없다.
반대로멤버변수는 기본값이 자동으로 들어간다.
그래서 값을 따로 넣지 않아도, 처음에는 아래와 같은 값으로 준비된다.
- 숫자형 →
0boolean→false- 참조형 →
null예를 들어
int age;라는 멤버변수를 선언해 두었다면, 값을 따로 넣지 않았을 때 처음에는0이 들어 있다고 보면 된다.
이 차이는 배열이나 객체를 배울 때도 같이 연결된다.
클래스 변수, 인스턴스 변수, 그리고new로 생성한 배열의 요소들은 기본값으로 자동 초기화된다.
하지만 메서드 안에서 선언한지역 변수는 자동 초기화되지 않는다.
즉, 가장 간단하게 정리하면 이렇다.
멤버변수→ 자바가 기본값을 자동으로 넣어 준다지역 변수→ 개발자가 직접 값을 넣어야 한다그래서 변수 선언 위치를 보면 어느 정도 판단할 수 있다.
클래스 안에 있으면 자동 초기화 대상이고, 메서드 안에 있으면 직접 초기화해야 한다고 이해하면 된다.
4. 클래스 메서드와 인스턴스 메서드
개념메서드는 기능을 묶어 둔 코드다.
그런데 자바에서는 모든 메서드를 똑같이 다루지 않는다.
어떤 메서드는 객체가 가지고 있는 값을 이용해서 동작하고, 어떤 메서드는 객체가 없어도 독립적으로 실행할 수 있기 때문이다.
이 기준에 따라 메서드는 크게 두 가지로 나뉜다.
인스턴스 메서드클래스 메서드
겉으로는
static이 있느냐 없느냐로 구분한다.
static이 없으면인스턴스 메서드static이 있으면클래스 메서드
하지만 더 중요한 기준은 따로 있다.
이 메서드가 인스턴스 변수에 의존하느냐, 의존하지 않느냐가 핵심이다.
즉,
- 객체 안에 들어 있는 값을 사용해야 하면
인스턴스 메서드- 객체의 값이 없어도 실행할 수 있으면
클래스 메서드이렇게 이해하면 된다.
인스턴스 메서드
인스턴스 메서드는 객체를 만든 뒤에 호출하는 메서드다.
보통 객체가 가지고 있는 인스턴스 변수의 값을 이용해서 동작할 때 사용한다.
예를 들어 자동차 객체가speed라는 값을 가지고 있다고 해보자.
이 자동차의 현재 속도를 출력하거나, 속도를 올리는 기능은 그 자동차가 가진 값을 사용해야 한다.
이런 기능은인스턴스 메서드로 만드는 것이 자연스럽다.class Car { String name; // 인스턴스 변수 String color; // 인스턴스 변수 int speed; // 인스턴스 변수 void printSpeed() { // 인스턴스 메서드 System.out.println(speed); } }여기서
printSpeed()는 괄호 안에서 값을 따로 받지 않는다.
대신 현재 객체가 가지고 있는speed값을 그대로 사용한다.
그래서 이 메서드는 객체가 먼저 만들어져 있어야 호출할 수 있다.Car c1 = new Car(); c1.name = "포르쉐"; c1.color = "빨강"; c1.speed = 120; c1.printSpeed(); // 출력결과 // 120이 코드는
c1객체 안에 들어 있는speed값을printSpeed()가 그대로 출력하는 예제다.
즉, 같은 메서드라도 어떤 객체로 호출하느냐에 따라 사용하는 값이 달라질 수 있다.
예를 들어c2라는 다른 자동차 객체를 만들고speed를200으로 넣은 뒤c2.printSpeed()를 호출하면, 이번에는200이 출력된다.
그 이유는인스턴스 메서드가 호출한 객체 자신의 값을 기준으로 동작하기 때문이다.
즉,인스턴스 메서드는
객체의 상태를 읽거나, 객체 안에 들어 있는 값을 이용해서 작업할 때 사용하는 메서드라고 이해하면 된다.
클래스 메서드
클래스 메서드는 메서드 앞에static이 붙은 메서드다.
쉽게 말하면 객체를 만들지 않아도 호출할 수 있는 메서드다.
이 메서드는 보통 특정 객체가 가진 개별 값이 없어도 실행할 수 있는 기능일 때 사용한다.
즉, 어떤 한 자동차의name,color,speed같은 값을 꼭 알아야만 동작하는 기능이 아니라,
클래스 자체 기준으로 바로 사용할 수 있는 기능에 어울린다.
예를 들어Car클래스에 모든 자동차가 공통으로 가지는 바퀴 수가 있다고 해보자.class Car { String name; // 인스턴스 변수 String color; // 인스턴스 변수 int speed; // 인스턴스 변수 static int wheelCount = 4; // 클래스 변수 static void printWheelCount() { // 클래스 메서드 System.out.println(wheelCount); } }여기서
printWheelCount()는static이 붙어 있으므로클래스 메서드다.
이 메서드는 어떤 특정 자동차 객체의 값을 사용하는 것이 아니라,
Car클래스가 공통으로 가지고 있는wheelCount를 출력한다.
그래서 이 메서드는 객체를 먼저 만들지 않아도 바로 호출할 수 있다.Car.printWheelCount(); // 출력결과 // 4이렇게
클래스이름.메서드명()형태로 호출하는 것이클래스 메서드의 대표적인 사용 방식이다.
왜 이렇게 나누는가이 구분은 문법을 괜히 복잡하게 만들기 위한 것이 아니다.
핵심은 객체와 관련된 기능인지, 객체와 무관한 기능인지를 나누는 데 있다.
인스턴스 메서드는 객체 안에 들어 있는 값을 사용해야 할 때 필요하다.
예를 들어 자동차마다name,color,speed값은 서로 다를 수 있다.
그래서 이런 값을 읽거나 바꾸는 기능은, 어느 객체를 기준으로 할지 먼저 정해져 있어야 한다.
이런 경우에는 객체를 만든 뒤 호출하는인스턴스 메서드가 자연스럽다.
반대로클래스 메서드는 특정 객체의 상태에 의존하지 않는 기능에 사용한다.
예를 들어wheelCount처럼 모든 자동차가 함께 쓰는 값이나, 객체를 만들지 않아도 바로 처리할 수 있는 기능은 굳이 객체를 먼저 만들 필요가 없다.
이럴 때는static을 붙여클래스 메서드로 만드는 것이 더 알맞다.
즉, 가장 중요한 판단 기준은 이것이다.
- 객체 안의 값이 필요하면
인스턴스 메서드- 객체 안의 값이 필요 없으면
클래스 메서드이 기준이 잡히면
static을 외워서 구분하는 것이 아니라,
왜 그렇게 나누는지 이해하면서 구분할 수 있게 된다.
참고로main()메서드도static이다.
프로그램은 객체를 만들기 전부터 시작되어야 하므로, 시작점인main()은 특정 객체에 의존하면 안 되기 때문이다.
핵심 특징
1) 인스턴스 메서드는 객체가 있어야 호출할 수 있다
인스턴스 메서드는 어떤 객체를 기준으로 동작하는 메서드다.
즉, 객체 안에 들어 있는 값을 읽거나 바꾸기 위해 사용하는 메서드이므로, 먼저 객체가 만들어져 있어야 한다.
그래서 보통 아래처럼참조변수.메서드이름()형태로 호출한다.참조변수.메서드이름()예를 들어 자동차 객체의 속도를 출력하는
printSpeed()같은 메서드는, 어떤 자동차의 속도를 출력할 것인지 기준이 있어야 한다.
그래서 객체를 먼저 만든 뒤에 호출해야 한다.
2) 클래스 메서드는 객체 없이 호출할 수 있다
클래스 메서드는static이 붙은 메서드다.
이 메서드는 특정 객체의 값이 없어도 실행할 수 있는 기능에 사용한다.
즉, 어떤 자동차 하나의name,color,speed를 꼭 알아야 하는 것이 아니라,
클래스 자체 기준으로 바로 처리할 수 있는 기능이라는 뜻이다.
그래서 객체를 만들지 않아도 아래처럼클래스이름.메서드이름()형태로 바로 호출할 수 있다.클래스이름.메서드이름()예를 들어
Car.printWheelCount()같은 메서드는 특정 자동차 한 대가 아니라,Car클래스 전체 기준으로 동작하는 기능이라고 볼 수 있다.
3) 인스턴스 메서드는 인스턴스 변수와 클래스 변수를 모두 사용할 수 있다
인스턴스 메서드는 이미 어떤 객체를 기준으로 호출되는지가 정해져 있다.
예를 들어c1.printSpeed()라고 호출했다면, 이 메서드는c1객체를 기준으로 실행된다.
이렇게 기준이 되는 객체가 이미 정해져 있으므로,
그 객체 안에 들어 있는인스턴스 변수도 사용할 수 있고,
모든 객체가 함께 쓰는클래스 변수도 함께 사용할 수 있다.
즉,인스턴스 메서드는
- 자기 객체의 값도 사용할 수 있고
- 클래스 전체의 공통값도 사용할 수 있다
고 이해하면 된다.
4) 클래스 메서드는 인스턴스 변수를 직접 사용할 수 없다이 부분이 가장 중요하다.
클래스 메서드는 객체를 만들지 않아도 호출할 수 있다.
그런데 객체 없이 호출된다는 말은, 어느 객체를 기준으로 해야 하는지가 정해져 있지 않다는 뜻이다.
예를 들어 자동차마다speed값이 다를 수 있는데,
객체도 없이speed를 바로 사용하려고 하면 자바 입장에서는 이런 문제가 생긴다.
c1의speed를 써야 하나?c2의speed를 써야 하나?- 아직 객체가 하나도 없으면 누구 값을 써야 하나?
기준이 없기 때문에
클래스 메서드에서는인스턴스 변수를 직접 사용할 수 없다.
예를 들어 아래 코드는 에러가 난다.static void printValue() { System.out.println(a); // 에러 }여기서
a가인스턴스 변수라면,static메서드 안에서는 바로 사용할 수 없다.
왜냐하면a는 객체 안에 들어 있는 값인데, 지금은 어느 객체의a인지 정해져 있지 않기 때문이다.
즉,클래스 메서드는 객체 기준이 없어서인스턴스 변수를 직접 다룰 수 없다고 이해하면 된다.
5) 메서드 호출에도 제한이 있다이 부분도 같이 알아두면 훨씬 덜 헷갈린다.
먼저인스턴스 메서드는
인스턴스 메서드클래스 메서드를 모두 호출할 수 있다.
왜냐하면인스턴스 메서드는 이미 객체를 기준으로 실행되고 있기 때문이다.
그래서 객체 안의 값도 사용할 수 있고, 클래스 전체의 공통 기능도 함께 사용할 수 있다.
반면클래스 메서드는
클래스 메서드는 호출할 수 있지만인스턴스 메서드는 바로 호출할 수 없다그 이유도 같다.
클래스 메서드는 객체 없이 실행될 수 있으므로, 어떤 객체의인스턴스 메서드를 불러야 하는지 기준이 없다.
즉,클래스 메서드안에서인스턴스 메서드를 바로 부를 수 없는 이유는
결국 객체 기준이 없기 때문이다.
이 내용을 가장 짧게 정리하면 이렇다.
인스턴스 메서드→ 객체 기준이 있으므로 인스턴스 멤버도, 클래스 멤버도 다룰 수 있다클래스 메서드→ 객체 기준이 없으므로 클래스 멤버만 바로 다룰 수 있다즉, 여기서도 핵심 판단 기준은 똑같다.
객체가 기준으로 필요한 기능이면인스턴스 메서드, 객체 없이도 되는 기능이면클래스 메서드다.
헷갈리기 쉬운 부분
1) static이 붙으면 무조건 더 좋은 메서드인가?그렇지 않다.
static이 붙은클래스 메서드는 더 편하거나 더 좋은 메서드가 아니라, 객체 없이도 실행할 수 있을 때 사용하는 메서드다.
처음 보면 객체를 만들지 않고도 바로 호출할 수 있으니 더 편해 보일 수 있다.
하지만 그렇다고 해서 모든 메서드를static으로 만들면 안 된다.
예를 들어 자동차의 현재 속도나 색상처럼 객체마다 다른 값을 다뤄야 하는 기능이라면, 그 메서드는 특정 객체를 기준으로 움직여야 한다.
이런 기능까지 억지로static으로 만들면 오히려 객체지향 구조가 어색해진다.
즉,static은 “더 좋은 메서드”가 아니라, 객체가 없어도 되는 상황에서만 맞는 메서드라고 이해해야 한다.
2) 객체 없이 호출 가능하다는 것만 외우면 부족하다
클래스 메서드를 그냥
“객체 없이 호출하는 메서드”라고만 외우면 나중에 자꾸 헷갈리게 된다.
왜냐하면 진짜 중요한 기준은 호출 방법보다 무슨 값을 써야 하느냐이기 때문이다.
핵심은 이것이다.
- 이 기능이
인스턴스 변수를 써야 하는가?- 아니면 객체와 상관없이 바로 실행할 수 있는가?
예를 들어 자동차의 속도를 출력하는 기능은 객체마다 값이 다르므로
인스턴스 변수가 필요하다.
이런 기능은인스턴스 메서드가 되어야 한다.
반대로 자동차의 공통 바퀴 수를 출력하는 기능처럼, 특정 객체의 상태가 필요 없는 기능은클래스 메서드로 만들 수 있다.
즉, 단순히 “객체 없이 호출 가능”만 외우기보다,
인스턴스 값이 필요한지 아닌지를 기준으로 구분하는 것이 훨씬 정확하다.
3) 클래스 메서드 안에서는 this를 사용할 수 없다
this는 현재 객체 자기 자신을 가리키는 말이다.
즉,this를 쓴다는 것은 “지금 이 객체”를 기준으로 코드를 실행하겠다는 뜻이다.
그런데클래스 메서드는 객체 없이도 호출될 수 있다.
이 말은 곧, 메서드 안에서 현재 어떤 객체를 가리키는지 정해져 있지 않다는 뜻이기도 하다.
예를 들어Car.printWheelCount()처럼 호출하면, 여기에는 특정 자동차 객체가 하나 정해져 있는 것이 아니다.
그냥Car클래스 기준으로 실행되는 것이다.
그래서static메서드 안에서는this를 사용할 수 없다.
왜냐하면this가 가리켜야 할 현재 객체가 없기 때문이다.
즉,this는 객체가 있을 때만 의미가 있고,
객체 없이 실행될 수 있는클래스 메서드안에서는 사용할 수 없다고 이해하면 된다.
4) 인스턴스 메서드는 객체마다 따로 복사되는 것이 아니다이 부분도 처음에는 많이 헷갈린다.
객체마다인스턴스 변수가 따로 있으니까,인스턴스 메서드도 객체마다 복사되어 따로 생긴다고 생각하기 쉽다.
하지만 그렇게 이해하면 안 된다.
중요한 것은 메서드가 객체마다 복제되는가가 아니라,
그 메서드가 어느 객체의 값을 기준으로 실행되는가다.
예를 들어printSpeed()라는 메서드가 있다고 해보자.
c1.printSpeed()를 호출하면c1의speed값을 사용하고,
c2.printSpeed()를 호출하면c2의speed값을 사용한다.
즉, 메서드 이름과 동작 자체가 객체마다 따로 복사되는 것이 아니라,
같은 메서드가 호출된 객체에 따라 다른 인스턴스 값을 사용해서 동작하는 것이다.
그래서인스턴스 메서드를 이해할 때는
“객체마다 메서드가 하나씩 생긴다”보다
“같은 메서드가 어느 객체를 기준으로 실행되느냐가 달라진다”라고 이해하는 편이 맞다.
한 번에 정리하면
인스턴스 메서드는 객체 안에 들어 있는 값을 사용해서 동작하는 메서드다.
그래서 어떤 객체를 기준으로 실행할지 먼저 정해져 있어야 하고, 객체를 만든 뒤에 호출해야 한다.
반대로클래스 메서드는 객체의 인스턴스 값이 없어도 실행할 수 있는 메서드다.
그래서 특정 객체를 만들지 않아도클래스이름.메서드이름()형태로 바로 호출할 수 있다.
결국 가장 중요한 기준은 이것이다.
- 메서드가 객체 안의 값에 의존하면
인스턴스 메서드, 객체 안의 값이 없어도 되면클래스 메서드다.즉,
static을 겉모양으로 외우기보다
이 기능이 정말 객체 기준으로 동작해야 하는가를 먼저 생각하면 훨씬 덜 헷갈린다.
5. JVM의 메모리 구조와 클래스/인스턴스 멤버의 실행 흐름
개념
클래스 변수,인스턴스 변수,클래스 메서드,인스턴스 메서드는 따로따로 외우면 금방 헷갈린다.
이 네 가지는 결국 메모리에서 어디에 준비되고, 언제 만들어지고, 어떻게 연결되어 실행되는가로 같이 봐야 이해가 된다.
그래서 이 부분은 먼저JVM의 큰 메모리 구조를 잡고, 그 위에 변수와 메서드를 얹어서 보는 흐름으로 이해하는 것이 좋다.
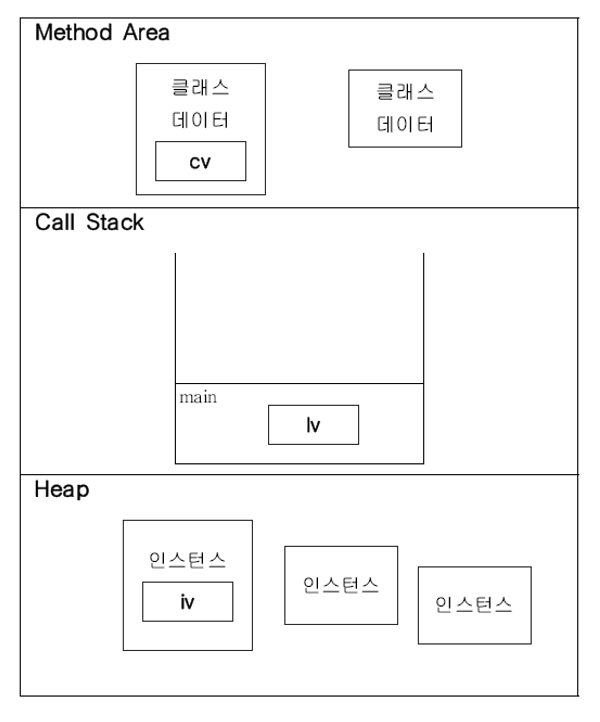
자바 프로그램이 실행될 때는 메모리를 크게 세 부분으로 나누어 이해하면 된다.
Method AreaHeapCall Stack이 세 공간을 기준으로 보면
클래스는 어디에 올라가는지,
객체는 어디에 생기는지,
메서드는 어디에서 실행되는지가 한 번에 정리된다.
1) JVM 메모리 구조를 먼저 잡기
Method Area
Method Area는 클래스 정보가 올라가는 공간이다.
클래스가 필요해지면 이곳에 클래스 정보가 올라오고, 그때static으로 선언한클래스 변수도 함께 준비된다.
즉, 클래스 자체에 대한 정보와클래스 변수는 이쪽에서 먼저 준비된다고 보면 된다.
Heap
Heap은 객체가 생성되는 공간이다.
new를 사용해서 만든 객체와 배열은 모두 여기에 생성된다.
그래서인스턴스 변수는 결국 객체 안에 들어 있으므로Heap쪽에서 생긴다고 이해하면 된다.
Call Stack
Call Stack은 메서드가 실행될 때 생기는 작업 공간이다.
메서드가 호출되면 실행에 필요한 공간이 스택에 쌓이고, 메서드가 끝나면 그 공간은 사라진다.
여기에는 매개변수, 지역 변수, 계산에 쓰는 값, 그리고 메서드 실행 흐름이 잡힌다.
즉, 메서드는Heap에서 실행되는 것이 아니라 호출될 때마다Call Stack에 작업 공간이 잡혀서 실행된다.
2) 클래스 변수와 인스턴스 변수를 메모리로 보면
Card예제를 기준으로 보면 구분이 아주 잘 된다.
kind,number→ 카드마다 달라져야 하는 값width,height→ 모든 카드가 함께 써야 하는 값그래서
kind,number는인스턴스 변수가 되고,
width,height는static이 붙은클래스 변수가 된다.
카드마다 무늬와 숫자는 달라질 수 있지만, 카드의 폭과 높이까지 카드마다 달라지면 이상하기 때문이다.
예제:
CardTest_1.javapackage day6; class Card_1 { public String kind; int number; static int width = 100; static int height = 250; } public class CardTest_1 { public static void main(String args[]) { Card_1 c1 = new Card_1(); c1.kind = "Heart"; c1.number = 7; Card_1 c2 = new Card_1(); c2.kind = "Spade"; c2.number = 4; System.out.println("c1은 " + c1.kind + ", " + c1.number + "이며, 크기는 (" + Card_1.width + ", " + Card_1.height + ")"); System.out.println("c2는 " + c2.kind + ", " + c2.number + "이며, 크기는 (" + Card_1.width + ", " + Card_1.height + ")"); Card_1.width = 50; Card_1.height = 80; System.out.println("c1은 " + c1.kind + ", " + c1.number + "이며, 크기는 (" + Card_1.width + ", " + Card_1.height + ")"); System.out.println("c2는 " + c2.kind + ", " + c2.number + "이며, 크기는 (" + Card_1.width + ", " + Card_1.height + ")"); } // 출력결과 // c1은 Heart, 7이며, 크기는 (100, 250) // c2는 Spade, 4이며, 크기는 (100, 250) // c1은 Heart, 7이며, 크기는 (50, 80) // c2는 Spade, 4이며, 크기는 (50, 80) }이 코드는
Card객체 두 개를 만들고,인스턴스 변수와클래스 변수가 실제로 어떻게 다르게 보이는지를 한 번에 보여 준다.
전체 코드를 먼저 보고, 그다음 메모리 흐름을 코드 단위로 잘라서 따라가면 훨씬 이해하기 쉽다.
즉, 아래의실행 흐름 1~6은 방금 본 전체 코드를 순서대로 쪼개서 읽는 방식이라고 생각하면 된다.
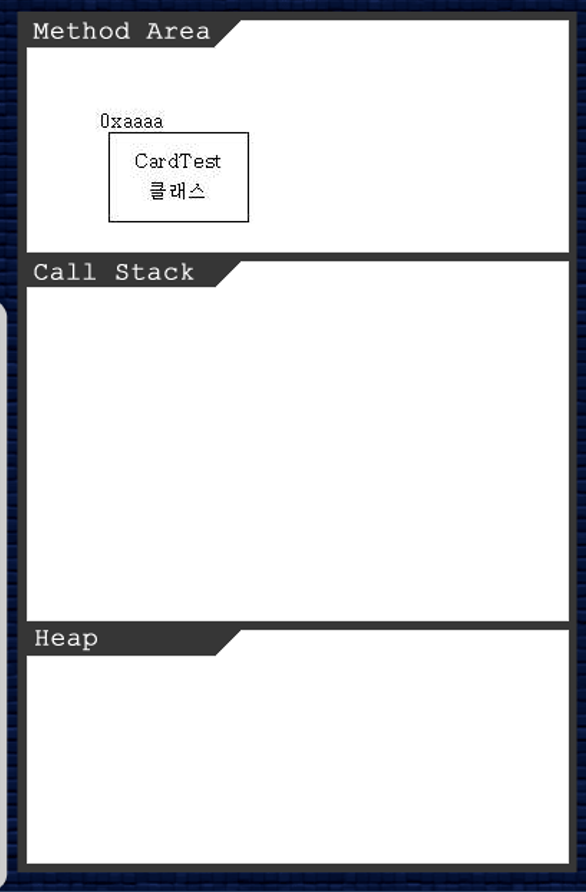
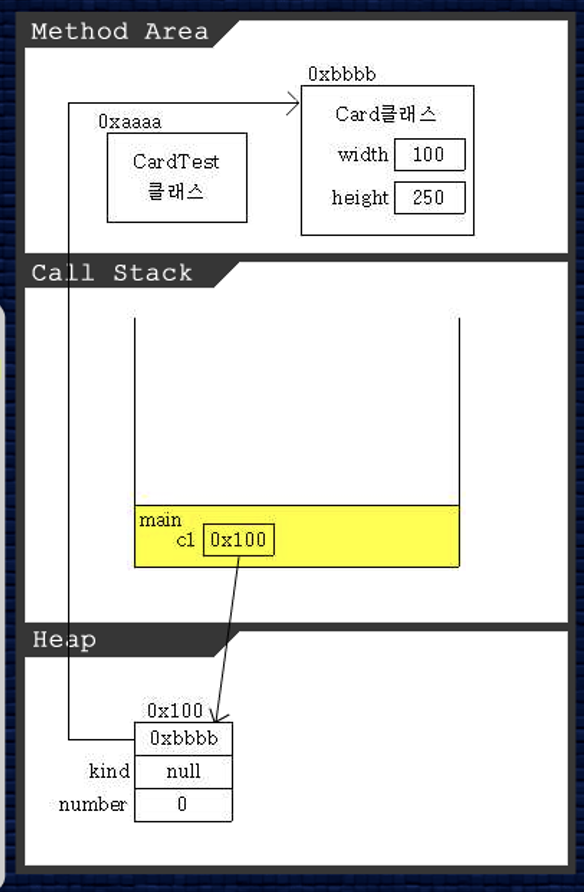
실행 흐름 1 - 프로그램 시작프로그램이 시작되면 먼저
CardTest_1클래스가 필요해진다.
그래서CardTest_1클래스 정보가 먼저Method Area쪽에 올라가고,main()이 호출되면서 프로그램이 시작된다.
이때 실제 실행 중인 메서드인main()의 작업 공간은Call Stack에 생긴다.
즉, 시작할 때부터 클래스 쪽과 실행 공간 쪽이 나뉘어 움직인다고 보면 된다.public class CardTest_1 { public static void main(String args[]) { // 여기서부터 실행 시작 } }여기서는 아직 객체를 만든 것이 아니다.
지금은main()이 들어와서 프로그램이 실행될 준비를 마친 상태라고 보면 된다.
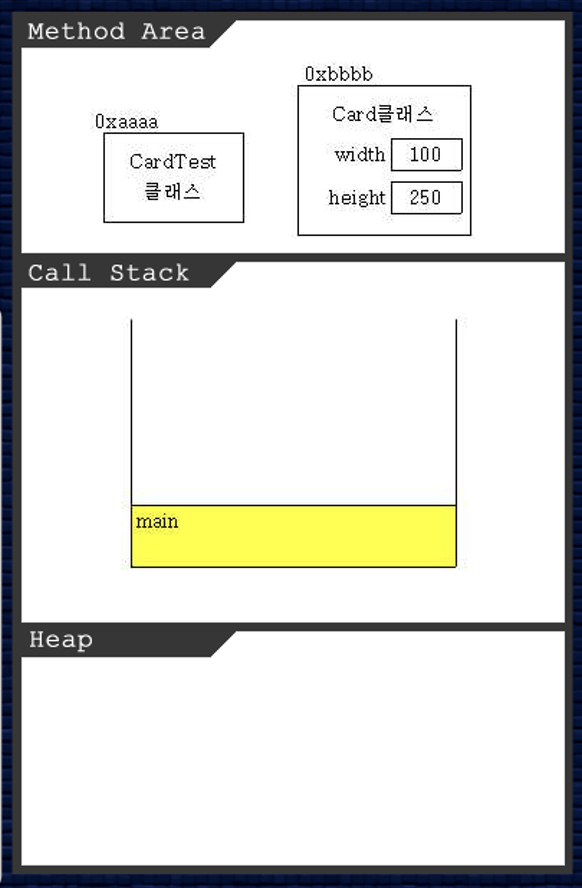
실행 흐름 2 - 첫 번째 객체를 만들기 전
main()안에서new Card_1()를 만나면 바로 객체부터 생기는 것이 아니다.
그 전에 먼저Card_1클래스가 메모리에 올라가야 한다.
이때Card_1클래스 정보가Method Area에 로딩되고,static int width,static int height가 생성되어100,250으로 초기화된다.
즉,클래스 변수는 객체를 만들기 전에 이미 준비된다.class Card_1 { public String kind; int number; static int width = 100; static int height = 250; }여기서 핵심은
static이 붙은width,height다.
이 값들은Card_1객체를 하나도 만들지 않았더라도, 클래스가 메모리에 올라가는 순간 먼저 준비된다.
실행 흐름 3 - 첫 번째 객체 생성그다음
new Card_1()가 실제로 실행되면Heap에 첫 번째Card_1객체가 생성된다.
이 객체 안에는kind,number가 들어갈 자리가 생기고, 처음에는 기본값으로 준비된다.
그리고main()안의 참조변수c1은Call Stack의main작업 공간에 있으면서,Heap에 생성된 그 객체를 가리키게 된다.
즉, 객체는Heap에 있고, 그 객체를 가리키는 참조변수는Call Stack쪽에 있다는 점이 중요하다.
이후c1.kind = "Heart",c1.number = 7이 실행되면
Heap에 있는 첫 번째 카드 객체의 값이 바뀐다.
여기서 바뀌는 것은c1자체가 아니라,c1이 가리키는 객체 안의인스턴스 변수값이다.Card_1 c1 = new Card_1(); c1.kind = "Heart"; c1.number = 7;이 코드 한 덩어리에서 봐야 할 것은 두 가지다.
Card_1 c1 = new Card_1();→Heap에 객체가 생기고,c1이 그 객체를 가리킨다.c1.kind,c1.number→ 첫 번째 객체 안의 값을 채운다.
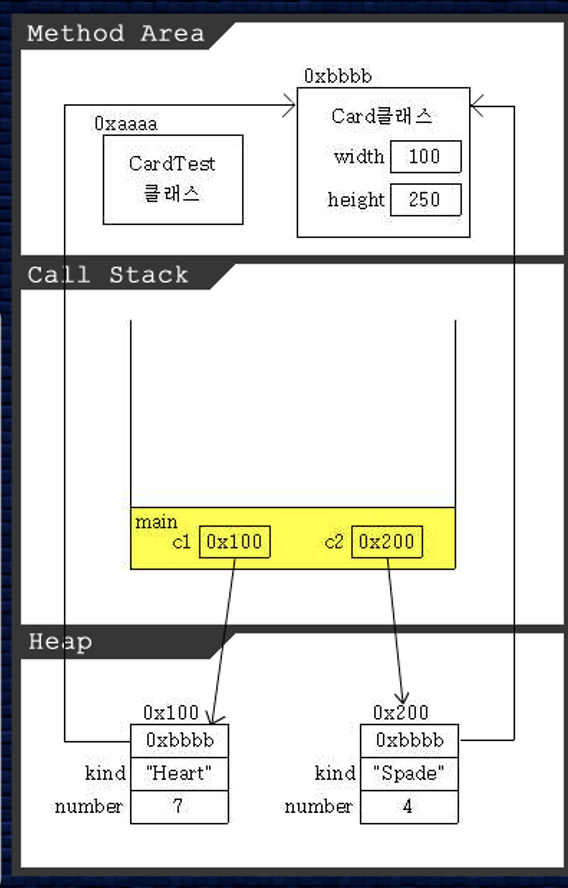
실행 흐름 4 - 두 번째 객체 생성
new Card_1()를 한 번 더 실행하면Heap에 또 다른 카드 객체가 하나 더 생긴다.
이번에는c2가 그 객체를 가리키게 된다.
이렇게 되면Heap에는 카드 객체가 두 개 생기고,Call Stack의main안에는c1,c2라는 참조변수가 각각 자기 객체를 가리키고 있게 된다.
그리고 두 번째 객체의kind,number에는"Spade",4가 들어간다.
그래서 첫 번째 카드와 두 번째 카드는 서로 다른인스턴스 변수값을 가지게 된다.
이게 바로 인스턴스 변수의 핵심이다.
객체마다 따로 저장공간이 있으므로 서로 다른 값을 가질 수 있다.Card_1 c2 = new Card_1(); c2.kind = "Spade"; c2.number = 4;첫 번째 카드와 두 번째 카드는 같은 클래스로 만들었지만 서로 다른 객체다.
그래서c1.kind와c2.kind는 얼마든지 다른 값을 가질 수 있다.
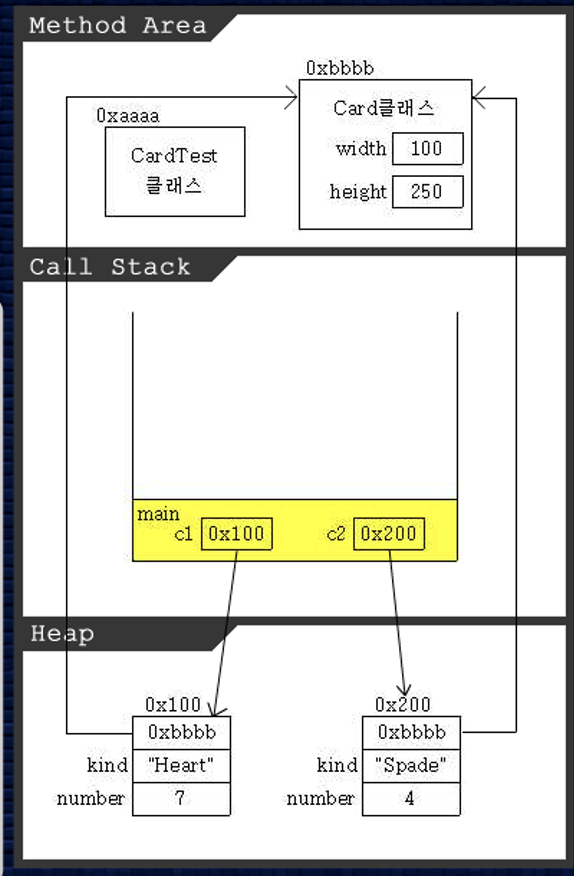
실행 흐름 5 - 두 객체를 출력해 보기이 상태에서
c1과c2를 출력하면kind,number는 서로 다르게 나온다.
왜냐하면 이 값들은 객체마다 따로 있는인스턴스 변수이기 때문이다.
반면width,height는 두 객체 모두100,250으로 똑같이 나온다.
이 값들은 객체 안에 각각 따로 있는 것이 아니라, 클래스 쪽에 하나만 있는클래스 변수를 함께 보고 있기 때문이다.
즉, 인스턴스 변수는 객체마다 다를 수 있고, 클래스 변수는 모든 객체가 함께 본다는 차이가 여기서 눈에 보인다.System.out.println("c1은 " + c1.kind + ", " + c1.number + "이며, 크기는 (" + Card_1.width + ", " + Card_1.height + ")"); System.out.println("c2는 " + c2.kind + ", " + c2.number + "이며, 크기는 (" + Card_1.width + ", " + Card_1.height + ")");여기서 접근 방식도 같이 봐야 한다.
c1.kind,c2.number처럼 객체마다 다른 값은 참조변수로 접근한다.Card_1.width,Card_1.height처럼 공통값은 클래스이름으로 접근한다.
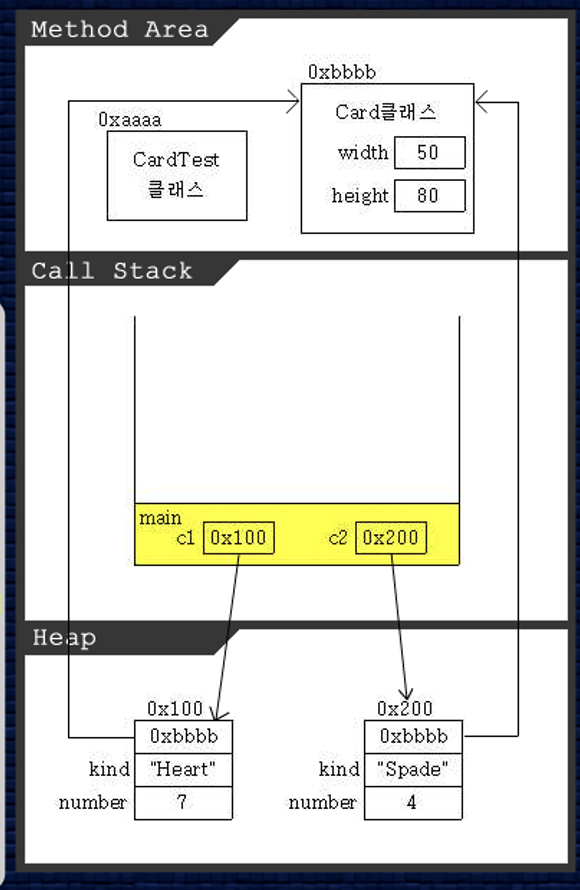
실행 흐름 6 - 클래스 변수 값을 바꾸기이제
Card_1.width = 50,Card_1.height = 80처럼 값을 바꾸면 처음에는 특정 객체만 바뀌는 것처럼 보일 수 있다.
하지만 실제로는 어떤 한 객체 안의 값을 바꾼 것이 아니라,Card_1클래스가 공유하는클래스 변수값을 바꾼 것이다.
그래서 다시 출력해 보면c1도 바뀌고c2도 같이 바뀐다.
여기서 꼭 잡아야 하는 포인트가 있다.
클래스 변수는 객체 이름으로 접근할 수도 있지만, 초보자는 그것을 그 객체만의 값처럼 오해하기 쉽다.
그래서 클래스 변수는Card_1.width,Card_1.height처럼 반드시 클래스 이름으로 접근하는 습관을 들이는 것이 맞다.Card_1.width = 50; Card_1.height = 80; System.out.println("c1은 " + c1.kind + ", " + c1.number + "이며, 크기는 (" + Card_1.width + ", " + Card_1.height + ")"); System.out.println("c2는 " + c2.kind + ", " + c2.number + "이며, 크기는 (" + Card_1.width + ", " + Card_1.height + ")");이 출력 결과에서 가장 중요한 부분은 둘 다 같이 바뀐다는 점이다.
그래서클래스 변수는 모든 객체가 하나의 값을 공유한다고 이해해야 한다.
3) 호출 스택까지 같이 보면 메서드 흐름이 완성된다
클래스 메서드와인스턴스 메서드의 개념 구분은 앞의3번에서 이미 정리했다.
그래서 여기서는 그 차이를 다시 반복하기보다, 메서드가 호출될 때Call Stack에 어떻게 쌓이고 빠지는가에 집중해서 보면 된다.
여기서 마지막으로Call Stack을 따로 한 번 더 봐야 한다.
교안에서도JVM전체 구조를 설명한 뒤, 가장 중요하게 다시 잡는 것이 바로호출 스택이다.
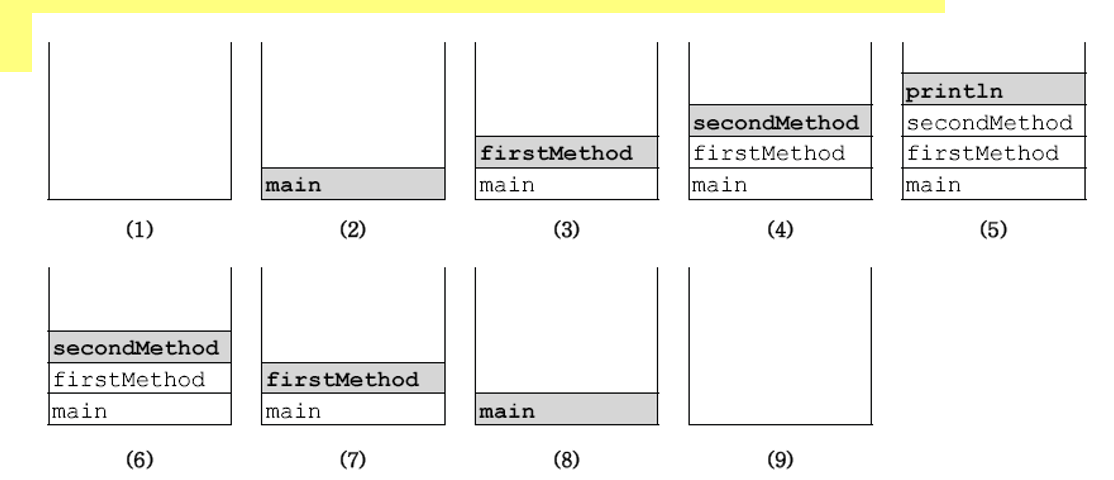
메서드는 호출될 때마다 스택에 작업 공간이 생기고, 끝나면 빠져나간다.
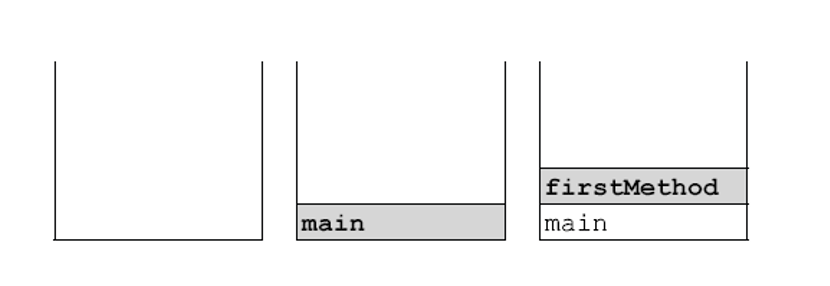
그리고 스택의 맨 위에 있는 메서드가 지금 실행 중인 메서드다.
아래쪽에 있는 메서드는 위 메서드를 호출하고 기다리는 메서드다.
예제:
CallStackTest.javaclass CallStackTest { public static void main(String[] args) { firstMethod(); } static void firstMethod() { secondMethod(); } static void secondMethod() { System.out.println("secondMethod()"); } // 출력결과 // secondMethod() }이 코드는
main()이firstMethod()를 호출하고, 다시firstMethod()가secondMethod()를 호출하는 아주 기본적인 호출 흐름을 보여 준다.
전체 코드를 먼저 보고, 그다음 어느 줄이 실행될 때 스택이 어떻게 쌓이는지를 순서대로 보면Call Stack이 훨씬 잘 잡힌다.
호출 흐름 1 - main() 시작프로그램이 시작되면 가장 먼저
main()이 호출된다.
그래서Call Stack에는main()의 작업 공간이 먼저 생긴다.public static void main(String[] args) { firstMethod(); }여기서 아직
firstMethod()는 실행 전이다.
지금은main()이 스택 맨 아래에서 실행을 시작한 상태라고 보면 된다.
호출 흐름 2 - firstMethod() 호출이제
main()안에서firstMethod()를 호출한다.
그러면Call Stack의 맨 위에firstMethod()의 작업 공간이 새로 쌓인다.
이 순간main()은 사라지는 것이 아니라, 아래에서 잠깐 기다리는 상태가 된다.firstMethod(); static void firstMethod() { secondMethod(); }즉,
main()이 끝난 뒤에firstMethod()가 실행되는 것이 아니라,
main()이 실행되다가firstMethod()를 불렀고, 그 위에 새 작업 공간이 쌓인 것이다.
호출 흐름 3 - secondMethod() 호출이제
firstMethod()안에서 다시secondMethod()를 호출한다.
그러면 스택 맨 위에secondMethod()가 또 올라간다.
이때 실제로 실행 중인 메서드는 가장 위에 있는secondMethod()다.secondMethod(); static void secondMethod() { System.out.println("secondMethod()"); }이 흐름을 따라가면 스택은 아래에서부터
main() -> firstMethod() -> secondMethod()순서로 쌓인다.
즉, 나중에 호출한 메서드가 스택의 더 위에 올라간다는 점이 핵심이다.
호출 흐름 4 - println() 실행 후 역순으로 빠져나오기
secondMethod()안의System.out.println()도 실제로는 메서드 호출이다.
그래서 호출 스택 그림에서는println()까지 한 단계 더 쌓인 모습으로 이해하면 된다.
출력이 끝나면 가장 위에 있던println()이 먼저 빠지고, 그다음secondMethod(),firstMethod(),main()순서로 빠져나간다.static void secondMethod() { System.out.println("secondMethod()"); }즉, 메서드 호출은 쌓일 때는 아래에서 위로, 끝날 때는 가장 위에서부터 역순으로 빠져나간다.
그래서Call Stack은후입선출구조라고 설명한다.
6. 기본형 매개변수, 참조형 매개변수, 참조형 반환타입
개념앞에서
JVM메모리 구조를 볼 때, 메서드가 호출되면Call Stack에 그 메서드만의 작업 공간이 생긴다고 했다. 그 안에는매개변수,지역 변수, 계산에 필요한 값이 들어간다. 즉, 메서드는 호출되는 순간 자기만의 작업 공간을 따로 받아서 실행된다.
이제 여기서 같이 이해해야 하는 것이 메서드를 호출할 때 값이 어떻게 전달되는가다.
자바에서는 메서드를 호출하면, 호출할 때 넘긴 값이 메서드의 매개변수로 복사되어 전달된다. 이때기본형이면 값 자체가 복사되고,참조형이면 객체를 가리키는 참조값이 복사된다.참조값은 객체를 가리키는 값이라고 이해하면 된다.
즉, 이 파트의 핵심은 세 줄이다.
기본형 매개변수→ 값 자체가 복사된다참조형 매개변수→ 객체를 가리키는 참조값이 복사된다참조형 반환타입→ 객체를 가리키는 참조값을return으로 돌려준다결국 자바는 항상 복사해서 전달하지만, 무엇을 복사했는지에 따라 결과가 달라진다.
핵심 특징
기본형 매개변수는int,double,char처럼 실제 값을 저장하는 타입이다.
그래서 메서드를 호출할 때도 그 값만 복사된다. 메서드 안에서 값을 바꿔도 바뀌는 것은 복사된 매개변수일 뿐이고, 바깥 원본 값은 그대로다.
반대로참조형 매개변수는 객체 자체를 저장하는 것이 아니라 객체를 가리키는 참조값을 저장한다.
그래서 메서드를 호출할 때도 객체가 통째로 넘어가는 것이 아니라, 같은 객체를 가리키는 참조값이 복사된다. 이 때문에 메서드 안에서 객체 내부 값을 바꾸면 바깥에서도 그 변화가 보인다.
그리고반환타입도참조형이 될 수 있다.
이 말은 메서드가 객체 자체를 통째로 돌려주는 것이 아니라, 그 객체를 가리키는 참조값을 반환한다는 뜻이다. 그래서 메서드 안에서 새 객체를 만들었다면, 그 참조값을return해야 바깥에서도 그 객체를 계속 다룰 수 있다.
6-1. 기본형 매개변수예제:
PrimitiveParamEx.javaclass Data { int x; } public class PrimitiveParamEx { public static void main(String[] args) { Data d = new Data(); // 1. 객체 생성 d.x = 10; // 2. 객체 안의 x에 10 저장 System.out.println("main() : x = " + d.x); change(d.x); // 3. d.x의 값 10만 복사해서 전달 System.out.println("After change(d.x)"); System.out.println("main() : x = " + d.x); // 출력결과 // main() : x = 10 // change() : x = 1000 // After change(d.x) // main() : x = 10 } static void change(int x) { // 기본형 매개변수 x = 1000; // 4. 복사된 지역 변수 x만 바뀜 System.out.println("change() : x = " + x); } }이 코드는
기본형 매개변수의 동작을 가장 기본적으로 보여준다.
change(d.x)를 호출할 때 넘어가는 것은 객체d가 아니라,d.x에 들어 있던 정수값10이다. 그래서change()안의x는main()의d.x와 같은 변수가 아니라,10을 복사해서 받은 별도의 지역 변수다.
즉,change()안에서x = 1000;을 해도 바뀌는 것은 복사본뿐이다.
원래 객체 안에 있던d.x는 그대로10이고, 그래서main()에서 다시 출력하면 여전히10이 나온다.
데이터 흐름// 1. main()에서 Data 객체 생성 Data d = new Data(); // 2. Heap에 생성된 객체 안에 x = 10 저장 d.x = 10; // 3. change(d.x) 호출 // → 객체가 넘어가는 것이 아니라 값 10이 복사됨 change(d.x); // 4. change()의 매개변수 x는 복사본이므로 // x = 1000;을 해도 원본 d.x는 바뀌지 않음 // 5. change() 종료 // → change()의 작업 공간은 사라짐 // → main()의 d.x는 그대로 10이 흐름에서 봐야 할 핵심은, 메서드 안의
x는 바뀌지만 원본d.x는 바뀌지 않는다는 점이다.
즉,기본형 매개변수는 메서드 안에서 값을 바꿀 수는 있어도, 바깥 원본 값을 직접 바꾸지는 못한다.
6-2. 참조형 매개변수
참조형은 객체 자체를 변수 안에 저장하는 것이 아니라,Heap에 생성된 객체를 가리키는 참조값을 저장한다.
여기서Heap은 생성된 객체가 저장되는 메모리 영역이다.예제:
ReferenceParamEx.javaclass Data2 { int x; } public class ReferenceParamEx { public static void main(String[] args) { Data2 d = new Data2(); // 1. 객체 생성 d.x = 10; // 2. 객체 안의 x에 10 저장 System.out.println("main() : x = " + d.x); change(d); // 3. 객체를 가리키는 참조값을 복사해서 전달 System.out.println("After change(d)"); System.out.println("main() : x = " + d.x); // 출력결과 // main() : x = 10 // change() : x = 1000 // After change(d) // main() : x = 1000 } static void change(Data2 d) { // 참조형 매개변수 d.x = 1000; // 4. 같은 객체의 x 값을 변경 System.out.println("change() : x = " + d.x); } }이번에는
change(d)로 참조값이 전달된다.
여기서 중요한 점은 객체가 통째로 넘어가는 것이 아니라,main()의d가 가지고 있던 참조값이 복사되어change()의 매개변수d로 들어간다는 것이다.
그런데 그 복사된 참조값도 결국 같은 객체 하나를 가리킨다.
그래서change()안에서d.x = 1000;을 하면, 같은 객체의 값이 바뀌고main()에서도 그 객체를 그대로 보고 있으므로 결과가1000으로 보이게 된다.
즉,참조형 매개변수는 원본 객체 자체를 넘기는 것이 아니라 같은 객체를 가리키는 복사된 참조값을 넘긴다. 그래서 객체 내부 값은 바꿀 수 있다.
데이터 흐름// 1. main()에서 Data2 객체 생성 Data2 d = new Data2(); // 2. Heap에 생성된 객체 안에 x = 10 저장 d.x = 10; // 3. change(d) 호출 // → d가 가진 참조값이 change()의 매개변수 d에 복사됨 change(d); // 4. main()의 d와 change()의 d는 // 서로 다른 변수이지만 같은 객체를 가리킴 // 5. change() 안에서 d.x = 1000; // → Heap의 같은 객체 값이 바뀜 // 6. change() 종료 후에도 // main()의 d는 같은 객체를 보고 있으므로 d.x는 1000이 흐름에서 중요한 것은 바깥 참조변수 자체가 통째로 바뀌는 것이 아니라, 같은 객체를 보고 있기 때문에 객체 내부 값이 바뀌는 것이라는 점이다.
이 부분을 헷갈리지 않아야 한다.
6-3. 참조형 반환타입예제:
ReferenceReturnEx.javaclass Data3 { int x; } public class ReferenceReturnEx { public static void main(String[] args) { Data3 d = new Data3(); // 1. 원본 객체 생성 d.x = 10; Data3 d2 = copy(d); // 2. 새 객체의 참조값을 반환받아 d2에 저장 System.out.println("d.x = " + d.x); System.out.println("d2.x = " + d2.x); // 출력결과 // d.x = 10 // d2.x = 10 } static Data3 copy(Data3 d) { // 참조형 반환타입 Data3 tmp = new Data3(); // 3. 새 객체 생성 tmp.x = d.x; // 4. 원본 객체의 값을 새 객체에 복사 return tmp; // 5. 새 객체를 가리키는 참조값을 반환 } }
참조형 반환타입은 메서드가 객체를 가리키는 참조값을 반환하는 경우다.
위 예제에서copy(d)는d자체를 돌려주는 것이 아니라,copy()안에서 새로 만든tmp객체를 가리키는 참조값을 반환한다. 그래서main()에서는 그 반환값을 받을 참조변수d2가 필요하다.
여기서 봐야 할 핵심은,copy()안에서 새 객체를 만들었다고 해서 그 객체를 바깥에서 자동으로 계속 쓸 수 있는 것은 아니라는 점이다.
return tmp;로 참조값을 넘겨줘야main()의d2가 그 새 객체를 이어서 가리킬 수 있다.
즉,참조형 반환타입은 메서드 안에서 만든 객체를return으로 바깥에 넘겨 다시 사용할 수 있게 하는 방식이다.
데이터 흐름// 1. main()에서 원본 객체 d 생성 Data3 d = new Data3(); d.x = 10; // 2. copy(d) 호출 // → d가 가진 참조값이 copy()의 매개변수 d에 복사됨 Data3 d2 = copy(d); // 3. copy() 안에서 새 객체 tmp 생성 Data3 tmp = new Data3(); // 4. 원본 객체의 값 d.x를 새 객체 tmp.x에 복사 tmp.x = d.x; // 5. return tmp; // → tmp를 가리키는 참조값이 main()으로 반환됨 // 6. 반환된 참조값을 main()의 d2가 받음 // → 이제 d2는 새 객체를 가리킴 // 7. 결과적으로 // d → 원본 객체 // d2 → 복사된 새 객체이 예제에서
d와d2는 이름이 비슷하지만, 결국 서로 다른 객체를 가리킨다.
그래서d2는d의 값을 복사해 만든 새 객체라고 보면 된다.
헷갈리기 쉬운 부분가장 많이 하는 오해는 참조형은 원본 객체 자체가 넘어간다고 생각하는 것이다.
하지만 자바는 여기서도 객체 자체를 통째로 넘기지 않는다. 객체를 가리키는 참조값이 복사될 뿐이다. 다만 그 복사된 참조값이 같은 객체를 가리키기 때문에, 객체 내부 값을 바꾸면 바깥에서도 바뀐 것처럼 보이는 것이다.
참조형 매개변수라고 해서 바깥 참조변수 자체가 통째로 바뀌는 것은 아니다.
예를 들어d.x = 1000;은 같은 객체의 내부 값을 바꾸는 것이고,d = new Data2();는 매개변수d가 다른 객체를 가리키게 만드는 것이다.
즉, 객체 내부 값을 바꾸는 것과 참조변수 자체가 다른 대상을 보게 만드는 것은 서로 다르다.
또 하나는참조형 매개변수와참조형 반환타입을 같은 것으로 보는 경우다.
둘은 비슷하지만 역할이 다르다.
참조형 매개변수→ 바깥에서 만든 객체를 메서드 안으로 넘겨서 그 객체를 다루게 함참조형 반환타입→ 메서드 안에서 만든 객체나 다루던 객체를 바깥으로 돌려줌즉, 하나는 들어오는 쪽, 다른 하나는 나가는 쪽이라고 보면 된다.
배열도 결국 객체이기 때문에참조형이다.
그래서 배열을 매개변수로 넘기면 배열 전체가 복사되는 것이 아니라, 그 배열을 가리키는 참조값이 넘어간다. 그래서 메서드 안에서 배열 요소를 바꾸면 바깥에서도 그 변화가 보일 수 있다.
한 번에 정리하면이 파트는 아래 세 줄로 정리하면 된다.
기본형 매개변수는 값이 복사되므로 원본이 바뀌지 않는다참조형 매개변수는 참조값이 복사되므로 같은 객체의 내부 값을 바꿀 수 있다참조형 반환타입은 객체를 가리키는 참조값을 반환해서 메서드 밖에서도 그 객체를 계속 다룰 수 있게 한다
7. 접근제어자: public과 private (자세한건 다음 제어자에서!!)
개념객체지향에서는 객체 안의 값을 아무 데서나 직접 바꾸게 두는 것이 항상 좋은 것은 아니다.
객체가 가진 중요한 값은 함부로 건드리지 못하게 숨기고, 필요한 기능만 바깥에 열어 두는 방식이 더 안전하다.
지금 단계에서는public과private를 먼저 구분하면 된다.
public→ 외부에서 접근할 수 있다private→ 클래스 내부에서만 접근할 수 있다즉, 모든 것을 다 열어 두는 것이 아니라,
숨겨야 할 값은 숨기고 필요한 기능만 밖으로 보여 주는 것이 핵심이다.
왜 필요한가예를 들어 자동차의 속도를 나타내는 값에
-30같은 잘못된 값이 들어가면 안 된다.
그런데 속도 값을 아무 데서나 직접 바꿀 수 있게 두면, 이런 이상한 값이 쉽게 들어갈 수 있다.
그래서 중요한 값은private으로 숨기고,
값을 바꿀 때는 검사하는 메서드를 거쳐서만 바꾸게 만드는 구조가 필요하다.
이렇게 하면 객체 안의 값을 더 안전하게 관리할 수 있다.
코드 예제예제:
Car의 속도 제어class Car { private int speed; public void setSpeed(int speed) { if (speed < 0) return; this.speed = speed; } public void printSpeed() { System.out.println(speed); } } public class CarTest { public static void main(String[] args) { Car c1 = new Car(); c1.setSpeed(120); c1.printSpeed(); // 출력결과 // 120 } }이 코드는 자동차의 속도 값을 아무 데서나 직접 바꾸게 두지 않고,
setSpeed()같은 메서드를 통해서만 바꾸게 만드는 형태다.
여기서 중요한 흐름은 이렇다.
speed는private이므로 클래스 바깥에서 직접 접근할 수 없다- 대신
setSpeed()는public이므로 바깥에서 호출할 수 있다setSpeed()안에서는 값이 올바른지 검사한 뒤에만speed를 바꾼다즉, 값은 숨기고, 값을 다루는 통로만 열어 둔 것이다.
헷갈리기 쉬운 부분
public이 더 편해 보여서 값을 전부 다 열어 두고 싶을 수 있다.
하지만 그렇게 하면 객체 안의 값이 어디서든 바뀔 수 있어서, 나중에는 오히려 관리가 더 어려워진다.
예를 들어speed를public으로 두면 바깥에서 바로 이런 식으로 값을 넣을 수도 있다.c1.speed = -30;이런 값은 자동차의 속도로 자연스럽지 않다.
그래서 객체지향에서는 값을 직접 만지게 하기보다,
메서드를 통해 검사한 뒤 다루게 만드는 방식이 더 자연스럽다.
즉,public과private의 핵심은
값을 보호하고, 필요한 기능만 안전하게 열어 두는 것이라고 이해하면 된다.
8. 초기화와 초기화 블럭
개념
초기화는 변수를 선언한 뒤, 그 변수에 처음 값을 넣는 것이다.
변수가 만들어졌다고 해서 곧바로 우리가 원하는 값을 가지는 것은 아니다.
그래서 프로그램에서 제대로 사용하려면, 필요한 시점에 알맞은 값으로 먼저 준비해 두어야 한다.
그런데 자바에서는 모든 변수가 같은 방식으로 초기화되지 않는다.
가장 먼저 구분해야 할 것은 지역 변수와 멤버변수다.
지역 변수는 메서드 안에서 잠깐 사용하는 변수다.
이 변수는 자바가 자동으로 값을 넣어 주지 않기 때문에, 반드시 개발자가 직접 초기화한 뒤 사용해야 한다.
반대로멤버변수는 클래스 안에 선언되는 변수다.
이 변수는 객체가 만들어지거나 클래스가 로딩될 때 자료형에 맞는 기본값으로 자동 초기화된다.
즉, 지역 변수는 초기화하지 않고 쓰면 에러가 나지만, 멤버변수는 일단 기본값이 들어간 상태로 시작한다.
이 차이는 꼭 기억해야 한다.
지역 변수는 메서드가 실행될 때 잠깐 생겼다가 사라지기 때문에, 값을 넣지 않고 읽게 두면 무엇이 들어 있는지 보장할 수 없다.
그래서 자바는 지역 변수에 대해 직접 값을 넣기 전에는 사용할 수 없다는 규칙을 둔다.
반면 멤버변수는 객체나 클래스가 준비되는 순간부터 사용할 수 있어야 하므로, 자바가 먼저 기본값을 넣어 주는 것이다.
멤버변수 초기화 방법멤버변수를 초기화하는 방법은 크게 세 가지다.
명시적 초기화생성자초기화 블럭이 세 가지는 아무렇게나 나열된 것이 아니다.
보통은 명시적 초기화부터 먼저 생각하고, 객체마다 다른 값을 넣어야 하면 생성자를 사용한다.
그리고 선언과 동시에 처리하기 어려운 조금 더 복잡한 초기화가 필요할 때 초기화 블럭을 사용한다.
1) 명시적 초기화명시적 초기화는 선언과 동시에 값을 넣는 가장 기본적인 방법이다.
static int width = 100;
int door = 4;
이렇게 변수를 선언하면서 바로 값을 넣는 방식이 명시적 초기화다.
가장 단순하고 읽기 쉬워서, 멤버변수를 초기화할 때는 보통 이 방법을 먼저 생각하면 된다.
예를 들어 자동차의 바퀴 수가 항상4라면static int wheelCount = 4;처럼 바로 적어 둘 수 있다.
또 자동차 문 개수가 보통
4라면int door = 4;처럼 인스턴스 변수도 선언과 동시에 값을 줄 수 있다.
즉, 값이 처음부터 명확하게 정해져 있다면 명시적 초기화가 가장 자연스럽다.
2) 생성자생성자는 객체를 만들 때 호출되는 메서드다.
그래서 객체마다 다른 값으로 초기화해야 하는 경우에 잘 맞는다.
예를 들어 자동차마다 색상이 다를 수 있다고 해보자.
어떤 자동차는white, 어떤 자동차는red일 수 있다.
이럴 때는 생성자를 통해 객체를 만들면서 값을 넘겨주는 방식이 자연스럽다.예제:
CarConstructorTest.javaclass Car { String color; Car(String color) { this.color = color; } } public class CarConstructorTest { public static void main(String[] args) { Car c1 = new Car("white"); Car c2 = new Car("red"); System.out.println(c1.color); System.out.println(c2.color); // 출력결과 // white // red } }이 코드는 자동차 객체를 만들 때 색상을 함께 넘겨서 초기화하는 예제다.
c1과c2는 같은Car클래스로 만들었지만, 생성자를 통해 서로 다른 값을 가질 수 있다.
즉, 생성자는
객체마다 다르게 들어가야 하는 값을 초기화할 때 사용하는 방법이라고 이해하면 된다.
3) 초기화 블럭초기화 블럭은 멤버변수를 조금 더 복잡하게 초기화할 때 사용하는 문법이다.
초기화 블럭은 두 종류가 있다.
static { }→클래스 초기화 블럭{ }→인스턴스 초기화 블럭이름이 비슷해서 처음엔 헷갈릴 수 있지만, 기준은 간단하다.
클래스 초기화 블럭→ 클래스가 처음 준비될 때 한 번 실행인스턴스 초기화 블럭→ 객체를 만들 때마다 실행즉, 누구를 초기화하려는가를 보면 된다.
클래스 전체가 함께 쓰는 값을 준비하려면static { }를 생각하고,
객체를 만들 때마다 공통으로 처리할 일이 있으면{ }를 생각하면 된다.
클래스 초기화 블럭클래스 초기화 블럭은
static { }형태로 작성한다.
이 블럭은 클래스가 처음 로딩될 때 딱 한 번 실행된다.
그래서 클래스 변수의 복잡한 초기화에 잘 어울린다.
예를 들어 아래처럼 로또 번호를 저장할 배열을클래스 변수로 준비했다고 해보자.예제:
LottoInitTest.javaclass Lotto { // [1] 클래스 전체가 함께 쓰는 배열이다. // 객체마다 따로 가지는 값이 아니라, Lotto 클래스에 하나만 존재한다. static int[] ball = new int[6]; // [2] static 초기화 블럭 // 클래스가 메모리에 올라갈 때 딱 한 번 실행된다. // 그래서 클래스 변수의 복잡한 초기화에 사용한다. static { // [3] ball 배열의 각 칸에 1~45 난수를 넣는다. for (int i = 0; i < ball.length; i++) { ball[i] = (int)(Math.random() * 45) + 1; } } } public class LottoInitTest { public static void main(String[] args) { // [4] main에서 Lotto.ball을 사용하는 순간 // Lotto 클래스가 로딩되면서 static 블럭이 먼저 실행된다. for (int i = 0; i < Lotto.ball.length; i++) { System.out.print(Lotto.ball[i] + " "); } // 출력결과 예시 // 7 21 33 4 41 12 } }이 코드에서
ball은Lotto클래스 전체가 함께 쓰는클래스 변수다.
그런데 배열만 선언하면 안의 값은 기본값인0으로 들어간다.
우리가 원하는 것은0이 아니라1~45사이의 난수다.
이럴 때static { }블럭을 사용하면, 클래스가 메모리에 올라갈 때 배열을 한 번에 준비해 둘 수 있다.
즉, 이 예제는 클래스 변수는 객체를 만들지 않아도 미리 준비될 수 있다는 점과,
복잡한 초기화는 클래스 초기화 블럭에서 처리할 수 있다는 점을 보여 준다.
중요한 점은 이 작업이 객체를 만들 때마다 반복되는 것이 아니라,
클래스가 처음 준비될 때 한 번만 실행된다는 것이다.
즉, 클래스 초기화 블럭은
모든 객체가 함께 쓰는 공통 값을 미리 준비할 때 사용하는 문법이라고 보면 된다.
인스턴스 초기화 블럭인스턴스 초기화 블럭은
{ }형태로 작성한다.
이 블럭은 객체를 만들 때마다 자동으로 실행된다.
그리고 생성자보다 먼저 실행된다는 점이 가장 중요하다.
즉, 생성자와 비슷하게 객체 생성 시점에 동작하지만,
생성자보다 한 단계 앞에서 공통 준비를 담당하는 코드라고 보면 된다.
다만 이 문법을 너무 크게 잡고 갈 필요는 없다.
실제로는 생성자를 더 자주 사용하고, 인스턴스 초기화 블럭은
생성자마다 공통으로 들어가는 코드를 따로 빼서 정리할 때 쓸 수 있는 문법 정도로 이해해 두면 충분하다.
예를 들어 자동차 객체를 만들 때마다 번호를 1씩 증가시켜 붙이고 싶다고 해보자.예제:
CarBlockTest.javaclass Car { // [1] 모든 Car 객체가 함께 쓰는 클래스 변수 // 자동차가 만들어질 때마다 번호를 1씩 증가시키는 용도 static int serialNo = 0; // [2] 각 객체가 따로 가지는 인스턴스 변수 int carNo; String color; // [3] 인스턴스 초기화 블럭 // 객체를 만들 때마다 자동 실행된다. // 생성자보다 먼저 실행된다는 점이 중요하다. { serialNo++; // 전체 번호를 1 증가 carNo = serialNo; // 증가된 번호를 현재 객체의 번호로 저장 } // [4] 기본 생성자 // 인스턴스 블럭이 끝난 뒤 실행된다. Car() { color = "white"; } // [5] 매개변수 생성자 // 역시 인스턴스 블럭이 끝난 뒤 실행된다. Car(String color) { this.color = color; } } public class CarBlockTest { public static void main(String[] args) { // [6] 첫 번째 객체 생성 // 순서: 인스턴스 블럭 -> 생성자 Car c1 = new Car(); // [7] 두 번째 객체 생성 // 순서: 인스턴스 블럭 -> 생성자 Car c2 = new Car("red"); // [8] 각 객체의 번호와 색상 출력 System.out.println(c1.carNo + " : " + c1.color); System.out.println(c2.carNo + " : " + c2.color); // 출력결과 // 1 : white // 2 : red } }이 코드에서
serialNo는 전체 자동차가 함께 쓰는클래스 변수다.
반면carNo는 각 자동차가 따로 가져야 하는인스턴스 변수다.
여기서 중요한 부분은 인스턴스 초기화 블럭이다.{ serialNo++; carNo = serialNo; }이 코드는 객체가 생성될 때마다 자동으로 실행된다.
즉, 자동차를 한 대 만들면 번호가1, 다음 자동차를 만들면 번호가2처럼 붙는다.
이 예제에서Car()와Car(String color)는 색상을 다르게 처리하고 있다.
하지만 자동차 번호를 하나씩 증가시키는 공통 작업은 두 생성자 모두에서 똑같이 필요하다.
이 공통 작업을 생성자마다 반복해서 쓰는 대신,
인스턴스 초기화 블럭에 한 번만 적어 둔 것이다.
즉, 인스턴스 초기화 블럭은
객체를 만들 때마다 공통으로 먼저 처리해야 하는 코드를 모아 둘 때 사용하는 문법이라고 이해하면 된다.
초기화 순서초기화에서 정말 중요한 것은 순서가 정해져 있다는 점이다.
값이 한 번에 그냥 정해지는 것이 아니라, 자바가 정해진 단계대로 차례차례 초기화를 진행한다.
이 순서를 알아야 왜 값이 이렇게 바뀌었지? 같은 혼란이 생기지 않는다.
그리고 이 순서는 단순히 외우기보다,
값이 앞 단계에서 한 번 정해지고, 뒤 단계에서 다시 덮어써질 수 있다고 이해하는 것이 좋다.
즉, 초기화는 한 번에 끝나는 것이 아니라 여러 단계를 거쳐 최종값이 결정되는 과정이다.
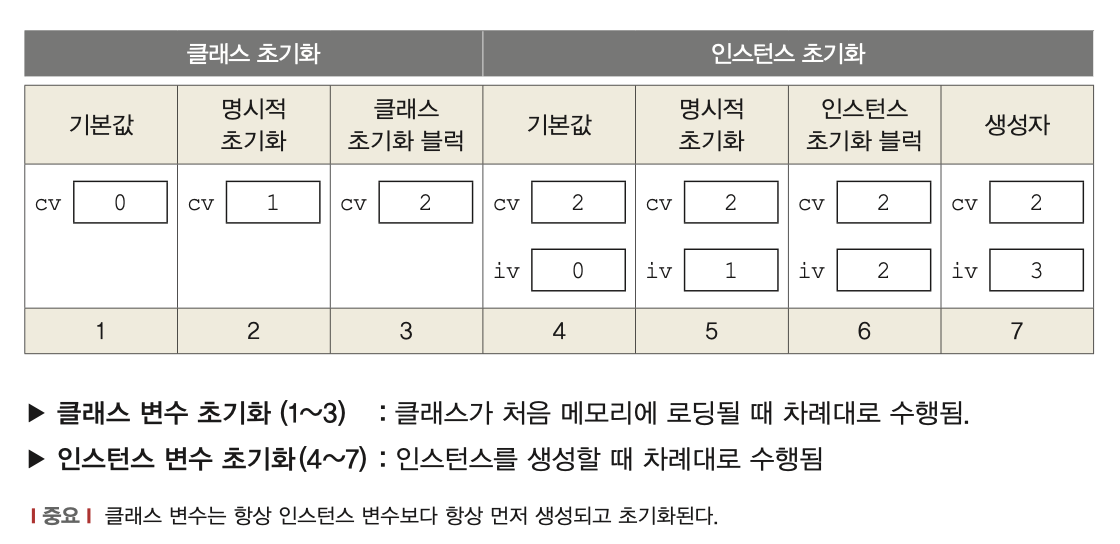
클래스 변수 초기화 순서
기본값 초기화명시적 초기화클래스 초기화 블럭즉, 클래스 변수는 먼저 자료형의 기본값으로 초기화되고,
그다음 선언하면서 적어 둔 값이 반영되며,
마지막으로static블럭이 실행되면서 최종값이 정해진다.
인스턴스 변수 초기화 순서
기본값 초기화명시적 초기화인스턴스 초기화 블럭생성자이 순서를 보면 생성자가 가장 먼저가 아니라 가장 마지막 단계라는 것을 알 수 있다.
보통은new를 보면 곧바로 생성자가 실행된다고 생각하기 쉽다.
하지만 실제로는 생성자에 들어가기 전에, 자바가 먼저 기본값 초기화와 명시적 초기화, 인스턴스 초기화 블럭까지 처리해 둔다.
즉, 객체를 만들자마자 바로 생성자가 실행되는 것이 아니라,
그 전에 여러 초기화 단계가 먼저 지나간 뒤에 마지막으로 생성자가 실행된다.
이 부분은 꼭 기억해야 한다.
코드 예제위의 두 예제는 초기화 블럭이 왜 필요한지를 보여 주는 예제였다.
아래BlockTest는static블럭, 인스턴스 초기화 블럭, 생성자의 실행 순서를 한 번에 확인하는 예제다.예제:
BlockTest.javapackage day6; public class BlockTest { // [1] static 초기화 블럭 // 클래스가 처음 로딩될 때 한 번만 실행된다. static { System.out.println("*static 블럭 수행*"); } // [2] 인스턴스 초기화 블럭 // 객체를 만들 때마다 생성자보다 먼저 실행된다. { System.out.println("#instance 블럭 수행#"); } // [3] 생성자 // 인스턴스 초기화 블럭 다음에 실행된다. public BlockTest() { System.out.println("#생성자 수행#"); } public static void main(String args[]) { // [4] 첫 번째 객체 생성 전 안내 출력 System.out.println("BlockTest bt = new BlockTest(); "); // [5] 첫 번째 객체 생성 // 실행 순서: // static 블럭(처음 한 번만) -> instance 블럭 -> 생성자 BlockTest bt = new BlockTest(); System.out.println(bt); // [6] 두 번째 객체 생성 전 안내 출력 System.out.println("BlockTest bt2 = new BlockTest(); "); // [7] 두 번째 객체 생성 // 이번에는 클래스가 이미 로딩되었으므로 static 블럭은 실행되지 않는다. // 실행 순서: // instance 블럭 -> 생성자 BlockTest bt2 = new BlockTest(); System.out.println(bt2); // 출력결과 예시 // *static 블럭 수행* // BlockTest bt = new BlockTest(); // #instance 블럭 수행# // #생성자 수행# // day6.BlockTest@어떤값 // BlockTest bt2 = new BlockTest(); // #instance 블럭 수행# // #생성자 수행# // day6.BlockTest@다른값 } }이 코드는
static블럭, 인스턴스 초기화 블럭, 생성자의 실행 순서를 한 번에 보여 주는 예제다.
프로그램이 시작되면BlockTest클래스가 먼저 준비된다.
이때 클래스가 로딩되면서static블럭이 한 번 실행된다.
그래서 첫 번째 객체를 만들기 전에*static 블럭 수행*이 먼저 출력된다.
그다음new BlockTest()가 실행되면 객체가 생성된다.
이때는 인스턴스 초기화 블럭이 먼저 실행되고, 그다음에 생성자가 실행된다.
그래서 객체 하나를 만들 때마다
#instance 블럭 수행##생성자 수행#순서로 출력된다.
두 번째 객체를 만들 때는 클래스가 이미 한 번 로딩된 상태이므로static블럭은 다시 실행되지 않는다.
대신 객체를 새로 만들었기 때문에 인스턴스 초기화 블럭과 생성자는 다시 실행된다.
이 예제를 통해
클래스 초기화 블럭은 한 번만 실행되고인스턴스 초기화 블럭과생성자는 객체를 만들 때마다 실행된다는 흐름을 눈으로 확인할 수 있다.
헷갈리기 쉬운 부분
1) 지역 변수는 자동 초기화되지 않는다멤버변수는 기본값이 들어가지만, 지역 변수는 그렇지 않다.
int num;
System.out.println(num); // 에러
이 코드는
num이 지역 변수일 때 사용할 수 없다.
먼저 값을 넣어 주지 않았기 때문이다.int num = 10; System.out.println(num); // 10이렇게 직접 초기화한 뒤에는 사용할 수 있다.
즉, 지역 변수는 반드시 직접 초기화해야 한다는 점을 분명히 기억해야 한다.
2) 생성자가 가장 먼저 실행되는 것이 아니다객체를 만들면 생성자가 바로 실행된다고 생각하기 쉽지만, 실제 순서는 다르다.
기본값 초기화명시적 초기화인스턴스 초기화 블럭생성자즉, 생성자는 객체 초기화의 마지막 단계다.
초기화 블럭과 생성자를 같이 쓰는 예제를 볼 때 이 순서를 모르면 흐름이 쉽게 꼬인다.
3) 초기화 블럭은 항상 쓰는 문법이 아니다초기화 블럭은 존재 자체가 목적이 아니라,
명시적 초기화만으로 부족할 때 또는
생성자들의 공통 코드를 묶고 싶을 때 쓰는 문법이다.
간단한 값은 명시적 초기화가 가장 좋고,
객체마다 다른 값은 생성자가 더 자연스럽다.
초기화 블럭은 그 둘만으로 정리되지 않을 때 생각하면 된다.
즉, 초보자 입장에서는
명시적 초기화 → 생성자 → 필요할 때 초기화 블럭
이 순서로 이해하면 충분하다.
4) static 블럭은 객체를 만들 때마다 실행되지 않는다
static블럭은 객체를 생성할 때마다 실행되는 코드가 아니다.
이 블럭은 클래스가 처음 로딩될 때 한 번만 실행된다.
그래서 객체를 여러 개 만들어도static블럭은 반복 실행되지 않는다.
반복되는 것은 인스턴스 초기화 블럭과 생성자다.
이 부분을 헷갈리면
static블럭도 객체 생성용 코드처럼 오해하기 쉽다.
하지만 실제로는 클래스 전체를 준비하는 코드라고 이해해야 한다.
참고초기화 블럭은 문법 자체가 아주 자주 등장하는 것은 아니다.
실제 코드에서는 명시적 초기화와 생성자를 훨씬 더 자주 보게 된다.
그래도 이 문법을 알아 두면 좋은 이유는,
자바가 객체를 만들 때 값을 어떤 순서로 준비하는지 이해하는 데 큰 도움이 되기 때문이다.
즉, 이 파트의 핵심은
초기화 블럭을 무조건 많이 쓰는 것이 아니라,
초기화가 한 번에 끝나는 것이 아니라 정해진 순서대로 진행된다는 점을 이해하는 데 있다.