컬렉션 프레임워크와 지네릭스
개념프로그램에서는 값 하나만 저장하는 경우보다, 여러 값을 모아서 저장하고 관리하는 경우가 훨씬 많다.
예를 들어 과일 이름 여러 개를 순서대로 저장하고 싶을 수도 있고, 최근에 넣은 값을 먼저 꺼내고 싶을 수도 있고, 이름으로 점수를 바로 찾고 싶을 수도 있다.
이럴 때 먼저 떠올려야 하는 것이 자료를 저장하는 방식이고, 자바에서는 이런 구조들을 컬렉션 프레임워크 안의 클래스들로 다룬다.
즉,List,Set,Map같은 큰 틀을 이해하고, 그 안에서ArrayList,LinkedList,HashMap,HashSet같은 클래스를 어떻게 쓰는지 함께 보는 것이 이번 범위의 핵심이다.
그리고 컬렉션을 배우다 보면 바로 같이 나오는 것이지네릭스다.
컬렉션은 여러 값을 담는 그릇인데, 이 그릇에 아무 타입이나 막 넣게 두면 나중에 꺼낼 때 문제가 생길 수 있다.
그래서 자바는 이 컬렉션에는 어떤 타입의 데이터만 담겠다는 것을 미리 정할 수 있게 해 두었고, 그 문법이 바로지네릭스다.
이번 정리는 크게 세 흐름으로 보면 된다.
- 첫째, 컬렉션 프레임워크가 어떤 구조인지 이해한다.
- 둘째, 지네릭스로 타입을 안전하게 제한하는 이유를 이해한다.
- 셋째,
List,Collections,Comparable,Comparator,HashMap,HashSet처럼 실제 코드에서 많이 쓰는 흐름을 연결해서 본다.
핵심 특징
List는 순서가 있고 중복을 허용한다.Set은 순서가 없고 중복을 허용하지 않는다.Map은key와value를 짝으로 저장한다.지네릭스는 컬렉션에 저장할 타입을 미리 제한하는 문법이다.Collections는 컬렉션 안의 데이터를 정렬, 섞기, 탐색하는 유틸리티 클래스다.- 객체를 정렬하려면
Comparable또는Comparator가 필요하다.- 같은
LinkedList라도 어떤 메서드를 쓰느냐에 따라 리스트, 스택, 큐처럼 다르게 사용할 수 있다.
1. 컬렉션 프레임워크는 무엇을 위한 것일까
개념컬렉션은 여러 개의 데이터를 모아서 저장하고 관리하는 구조다.
프로그램에서는 값 하나만 잠깐 쓰고 끝나는 경우보다, 여러 값을 한꺼번에 모아 두고 필요할 때 꺼내 쓰는 경우가 훨씬 많다.
예를 들어 과일 이름 여러 개를 저장할 수도 있고, 중복 없이 이름 목록만 모아둘 수도 있고, 이름을 기준으로 점수를 바로 찾고 싶을 수도 있다.
배열도 여러 데이터를 담을 수 있다.
하지만 배열은 길이를 미리 정해야 하고, 한 번 만들어 두면 중간에 값을 넣거나 빼고, 원하는 데이터를 찾고, 정렬하는 작업을 직접 다루기가 번거로운 편이다.
자바는 이런 불편을 줄이기 위해 여러 저장 구조를 미리 만들어 두었고, 이것을 컬렉션 프레임워크라고 한다.
여기서프레임워크라는 말은 어려운 뜻으로 볼 필요는 없다.
여러 저장 클래스를 비슷한 방식으로 다룰 수 있게 정리해 둔 공통 틀 정도로 이해하면 된다.
즉, 데이터를 저장하는 방법은 여러 가지지만, 자바는 그것들을 제각각 따로 배우게 두지 않고 일정한 규칙 안에서 다룰 수 있게 묶어 둔 것이다.
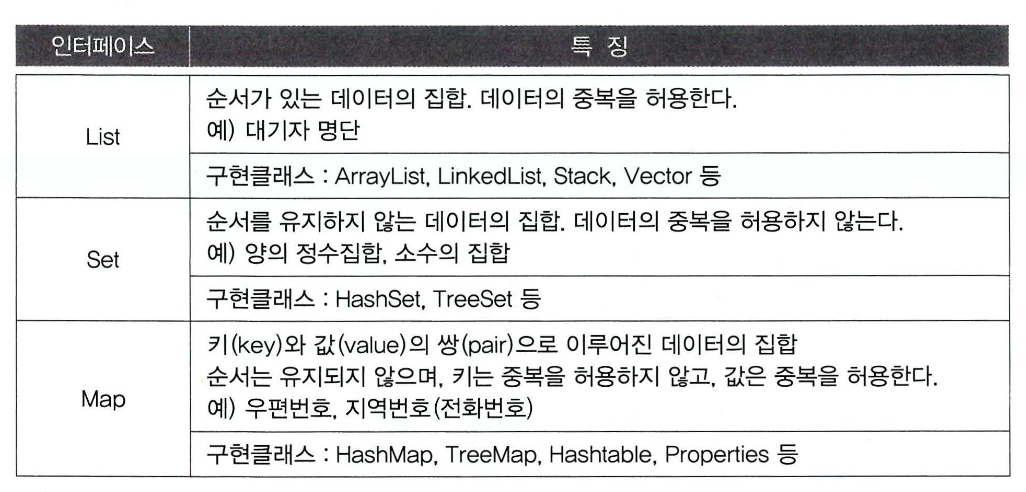
컬렉션 프레임워크를 볼 때 가장 먼저 익혀야 하는 큰 구조는List,Set,Map이다.
List와Set은 여러 값을 모아 두는 공통 계열이고, 이 둘은Collection이라는 큰 흐름 안에서 함께 이해할 수 있다.
반면Map은 값을 하나씩 담는 방식이 아니라key와value를 짝으로 저장하는 구조라서 결이 조금 다르다.
여기서 구조를 한 번 더 정리하면,
Collection은 여러 값을 모아 두는 큰 흐름이고, 그 안에List와Set이 들어간다.List는 순서가 있는 값 모음이고,Set은 중복 없는 값 모음이다.Map은Collection과 같은 계열로 묶이지 않고,key와value를 짝으로 다루는 별도 구조다.
핵심 특징
List는 순서가 있고 중복을 허용하는 구조다.Set은 중복을 허용하지 않고, 인덱스로 순서를 다루는 구조가 아니다.Map은key와value를 짝으로 저장하는 구조다. (같은key는 중복될 수 없고,key를 이용해 값을 찾는다.)List와Set은 여러 값을 모아 두는 공통 계열이고,Map은 값을 찾는 방식이 다른 별도 구조다.- 컬렉션 프레임워크는 클래스를 외우는 것이 아니라, 상황에 따라 어떤 저장 방식을 고를지 판단하는 기준이 중요하다.
예를 들면 이렇게 생각하면 쉽다.
- 값을 넣은 순서대로 꺼내고 싶다 →
List- 같은 값이 여러 번 들어가면 안 된다 →
Set- 이름 같은 기준으로 값을 바로 찾고 싶다 →
Map
헷갈리기 쉬운 부분
List,Set,Map은 전부 비슷한 저장소처럼 보이지만, 값을 저장하고 찾는 기준이 서로 다르다.List와Set은 여러 값을 모아 두는 구조라는 점에서는 비슷하지만, 중복 허용 여부와 순서 개념이 다르다.Map은 값을 그냥 차례대로 넣는 구조가 아니라, 키로 값을 찾는 구조라는 점에서List,Set과 구분해서 봐야 한다.- 컬렉션 프레임워크는 단순히
ArrayList,HashSet,HashMap같은 클래스 이름을 외우는 단원이 아니라, 데이터를 어떤 방식으로 저장해야 하는지 먼저 판단하는 단원이다.
참고이 단계에서는 아직 세부 클래스 사용법보다,
“내가 저장하려는 데이터는 순서가 중요한가, 중복이 가능한가, 키로 바로 찾아야 하는가”
이 기준부터 잡는 것이 더 중요하다.
이 감각이 잡혀야 뒤에서ArrayList,LinkedList,HashMap,HashSet을 배울 때도 구조가 훨씬 자연스럽게 이어진다.
2. 지네릭스가 왜 필요할까
컬렉션은 여러 값을 담는 그릇이다.
문제는 이 그릇에 아무 타입이나 함께 넣을 수 있게 두면, 저장할 때는 괜찮아 보여도 나중에 꺼내서 사용할 때 문제가 생길 수 있다는 점이다.
예를 들어 한 리스트에"java",100,"jdbc"가 함께 들어 있다고 해 보자.
겉으로 보기에는 값이 잘 들어간 것처럼 보인다.
하지만 나중에 이 값들을 전부 문자열이라고 생각하고 꺼내서 쓰려고 하면 문제가 생긴다.
"java"와"jdbc"는 문자열이니까 괜찮다.
그런데100은 문자열이 아니라Integer객체다.
즉, 저장할 때는 한 리스트 안에 같이 들어가 있었지만, 실제로는 타입이 서로 다른 값들이 섞여 있었던 것이다.
이 상태에서100까지 문자열처럼 다루려고 하면 실행 중에 예외가 발생한다.
이런 문제가 생기는 이유는, 타입을 넓게 받아 두면 일단은 여러 값을 다 담을 수 있기 때문이다.
대표적으로Object를 사용하면 여러 종류의 객체를 한꺼번에 담을 수 있다.
그래서 저장하는 순간에는 편해 보인다.
하지만 진짜 문제는 값을 꺼낼 때 드러난다.
Object로 저장해 두면, 나중에 꺼낸 값이 원래 문자열이었는지, 숫자였는지, 다른 객체였는지를 사람이 다시 구분해야 한다.
결국 직접 형변환해서 써야 하고, 이 과정에서 타입을 잘못 판단하면 에러가 난다.
즉, 아무거나 담을 수 있다는 편함 대신, 꺼낼 때마다 사람이 타입을 계속 신경 써야 하는 구조가 되는 것이다.
여기서 필요한 것이지네릭스다.
지네릭스는 쉽게 말하면 이 컬렉션에는 어떤 타입의 값만 담을지 미리 정해 두는 문법이다.
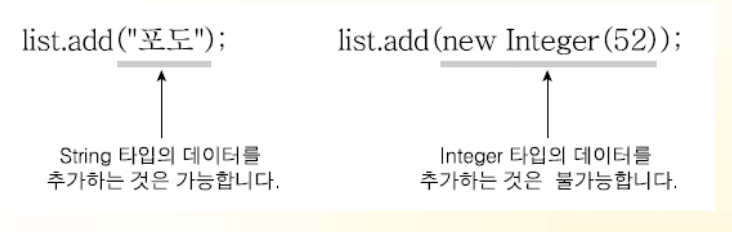
예를 들어List<String>이라고 쓰면, 이 리스트는 문자열만 담겠다는 뜻이 된다.
이렇게 해 두면"java"나"jdbc"같은 문자열은 넣을 수 있지만,
100처럼 문자열이 아닌 값을 넣으려고 할 때는 바로 막힌다.
즉, 예전처럼 아무 값이나 넣어 두고 나중에 꺼낼 때 불안해하는 방식이 아니라,
처음 저장하는 단계에서부터 타입을 분명하게 제한하는 방식으로 바뀌는 것이다.
그래서지네릭스는 단순히 문법을 더 복잡하게 만드는 기능이 아니다.
핵심은 타입이 섞이는 실수를 줄여 주는 것이다.
잘못된 값을 넣고 한참 뒤에 실행하다가 문제를 만나는 것이 아니라,
처음부터 “이 리스트에는 이 타입만 담는다”라고 기준을 정해 두는 것이다.
이렇게 하면 좋은 점이 두 가지다.
- 첫째, 컬렉션 안에 엉뚱한 타입이 섞이는 일을 줄일 수 있다.
- 둘째, 값을 꺼낼 때도 어떤 타입인지 더 분명하므로 형변환 부담이 줄어든다.
정리하면, 지네릭스가 필요한 이유는 단순하다.
여러 값을 담는 구조를 더 안전하고 분명하게 쓰기 위해서다.
아무 타입이나 섞이게 두면 꺼낼 때 문제가 생길 수 있고, 타입을 사람이 계속 직접 확인해야 한다.
반대로List<String>처럼 처음부터 타입을 정해 두면, 저장할 때도 더 안전하고 꺼내서 쓸 때도 훨씬 편해진다.
3. 지네릭스 기본 문법
가장 기본 형태는 이렇다.
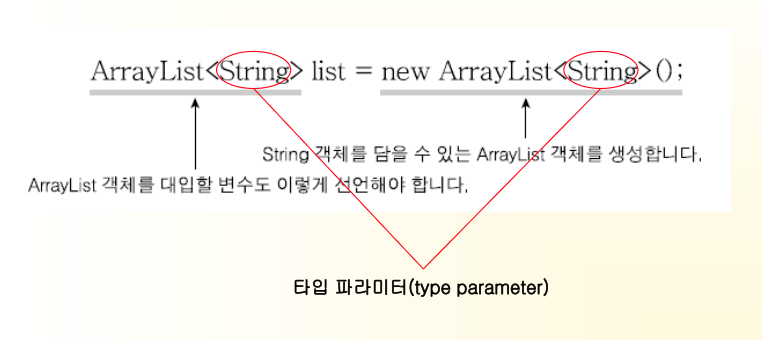
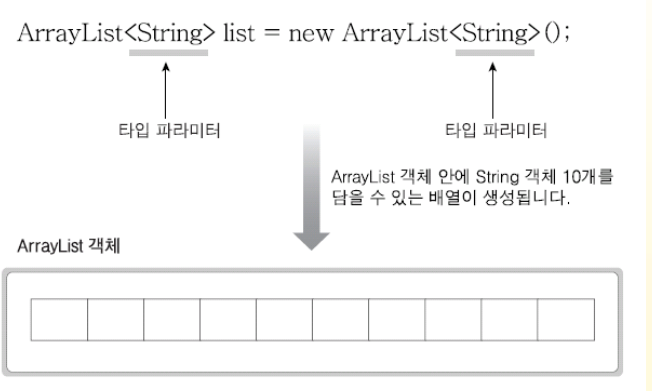
ArrayList<String> list = new ArrayList<String>();이 코드에서 가장 중요한 부분은
<String>이다.
이 표시는 이 리스트에는 문자열만 담겠다는 뜻이다.
즉, 이 리스트는 문자열 전용 리스트가 되는 것이다.
왼쪽 변수 선언에도<String>이 있고, 오른쪽 객체 생성 부분에도<String>이 있다.
양쪽에 같은 타입이 적혀 있기 때문에, 이 리스트가 어떤 타입용인지 더 분명하게 보인다.
그래서"java"같은 문자열은 넣을 수 있지만, 숫자나 다른 종류의 객체를 넣으려고 하면 막히게 된다.
요즘은 오른쪽을 줄여서 이렇게도 많이 쓴다.
ArrayList<String> list = new ArrayList<>();이렇게 써도 되는 이유는, 왼쪽에서 이미
String타입을 정해 두었기 때문이다.
즉, 오른쪽도 똑같이String이라는 것을 알 수 있으니, 같은 내용을 다시 다 적지 않고<>만 써도 된다.
처음 볼 때는 더 짧아서 이상해 보일 수 있지만, 의미는 위의 코드와 같다.
그런데 여기서 초보자가 자주 헷갈리는 부분이 있다.
앞에서는<String>을 보다가, 다른 코드나 설명에서는 갑자기<T>,<E>,<K>,<V>같은 문자가 나오기 때문이다.
<String>은 실제로 정해서 넣은 타입이다.
반면<T>,<E>,<K>,<V>는 아직 어떤 타입이 들어올지 정하지 않았을 때 쓰는 이름표 같은 문자다.
쉽게 말하면, 지금 당장은 타입을 비워 두고 나중에 정해서 쓰겠다는 뜻이다.
예를 들어 이런 코드를 보면class Box<T> { T item; }여기서
T는 “나중에 정할 타입” 자리라고 보면 된다.
그리고 실제로 사용할 때Box<String>이라고 쓰면, 그때T자리에String이 들어간다고 이해하면 된다.
그럼 나중에는 언제 타입을 정할까
T는 클래스를 만들 때 정하는 것이 아니라,
그 클래스로 객체를 만들 때 실제 타입을 적으면서 정한다.
예를 들어Box<T>라는 클래스는 설계도 단계에서는 아직T가 무엇인지 정해져 있지 않다.
대신 이 설계도를 가지고 객체를 만드는 순간,String용으로 쓸지,Integer용으로 쓸지 결정하게 된다.Box<String> b1 = new Box<>(); Box<Integer> b2 = new Box<>();첫 번째 줄에서는
T가String으로 정해진다.
그래서b1은 문자열만 다루는 상자가 된다.
두 번째 줄에서는T가Integer로 정해진다.
그래서b2는 정수용 상자가 된다.
즉, 같은Box<T>클래스라도
어떤 타입으로 객체를 만들었는지에 따라 전혀 다른 용도로 쓸 수 있다.b1.item = "hello"; // 가능 b2.item = 100; // 가능b1.item = 100; // 오류 b2.item = "hello"; // 오류이렇게 되는 이유는
객체를 만드는 순간T가 이미 정해졌기 때문이다.
한 번Box<String>으로 만들었으면 그 객체 안에서는 계속String만 다뤄야 한다.
즉, 여기서 흐름은 이렇게 이해하면 된다.
class Box<T>→ 아직 타입을 정하지 않은 설계도Box<String>→T자리에String을 넣어서 실제 타입을 정한 것new Box<>()→ 왼쪽에서 이미 타입이 정해졌으므로 오른쪽은 줄여 쓴 것
이 차이만 알아도 훨씬 덜 헷갈린다.
T→ 아직 정하지 않은 타입 자리String→ 실제로 정해서 넣은 타입
\
자주 보는 타입 문자
T: 타입을 뜻할 때 자주 쓰는 문자E: 컬렉션에 들어가는 요소를 뜻할 때 자주 쓰는 문자K:Map의 키를 뜻할 때 자주 쓰는 문자V:Map의 값을 뜻할 때 자주 쓰는 문자예를 들어
HashMap<K, V>는 키 타입과 값 타입을 따로 정해서 쓴다는 뜻이다.
즉,K와V는 실제 타입이 아니라, 나중에 어떤 타입이 들어올지 표시해 두는 자리라고 보면 된다.
기본형은 그대로 못 넣는다지네릭스에는
int,double,char같은 기본형을 그대로 넣을 수 없다.
지네릭스는 타입 자리에int같은 기본형이 아니라,Integer같은 클래스 타입을 넣어서 사용하는 방식이다.
그래서 기본형 대신, 그에 대응되는래퍼 클래스를 사용해야 한다.
int→Integerdouble→Doublechar→Characterboolean→Boolean그래서 실제로는 이렇게 쓴다.
ArrayList<Integer> list = new ArrayList<>();이 코드는
int값을 저장하는 느낌으로 보이지만, 지네릭스 문법에서는Integer처럼 객체형으로 적어야 한다.
그리고 값을 넣을 때10처럼 써도, 자바가 알아서Integer형태로 다루게 된다.
결국<String>같은 표시는 단순히 괄호를 붙여 꾸민 것이 아니다.
이 컬렉션이 어떤 타입 전용인지 눈에 보이게 표시해 주는 문법이다.
즉, “이 리스트는 문자열용”, “이 리스트는 정수용”처럼 사용 범위를 미리 분명하게 정해 두는 역할을 한다.
그래서 지네릭스 기본 문법은 이렇게 이해하면 된다.
<String>→ 문자열만 담는다는 뜻<>→ 왼쪽에서 타입이 이미 정해져 있어서 줄여 쓴 형태<T>같은 문자 → 나중에 타입을 정하기 위해 비워 둔 자리Box<String>→ 객체를 만들 때 실제 타입을 확정한 형태Integer→ 기본형int대신 쓰는 객체형이 감각만 잡히면, 뒤에서 나오는
Value3<T>,HashMap<K, V>,GenericTestNew같은 예제도 훨씬 자연스럽게 읽힌다.
4. 지네릭스는 어떤 흐름으로 이해하면 쉬울까
지네릭스는 문법만 따로 보면 낯설고 딱딱하게 느껴질 수 있다.
그래서 이 문법을 외우기보다, 왜 이런 방식이 필요해졌는지를 흐름으로 보는 것이 훨씬 이해하기 쉽다.
CreateGenericTest예제는 이 흐름을 세 단계로 비교해서 보여준다.
1.Value1은 처음부터String만 저장하게 만든 클래스다.
2.Value2는Object로 넓혀서 여러 객체를 저장할 수 있게 만든 클래스다.
3.Value3<T>는 클래스를 하나만 만들어 두고, 객체를 만들 때 타입을 정해서 쓰는 클래스다.
즉, 이 예제는
한 타입만 받는 방식 → 아무 객체나 받는 방식 → 필요한 타입만 정해서 받는 방식
으로 지네릭스가 왜 나오게 되었는지를 보여준다.
4-1. CreateGenericTest로 한 번에 보기
코드 보는 순서
- 먼저
Value1,Value2,Value3<T>세 클래스의 선언을 본다.- 그다음
put()과get()의 타입이 어떻게 다른지 본다.- 이후
main에서 실제로 어떤 식으로 사용하는지 본다.- 마지막으로 세 방식의 장단점을 비교해서 정리한다.
예제:
CreateGenericTestimport java.util.Date; class Value1 { String obj; // String 타입 값만 저장하는 변수 void put(String obj) { // String 값만 저장 가능 this.obj = obj; } String get() { // 꺼낼 때도 String으로 바로 반환됨 return obj; } } class Value2 { Object obj; // 모든 객체를 저장할 수 있도록 Object로 선언 void put(Object obj) { // 어떤 객체든 저장 가능 this.obj = obj; } Object get() { // 꺼낼 때 Object로 반환되므로 형변환이 필요함 return obj; } } class Value3<T> { T obj; // 아직 정해지지 않은 타입 T로 선언 void put(T obj) { // 객체를 만들 때 정한 타입만 저장 가능 this.obj = obj; } T get() { // 꺼낼 때도 같은 타입으로 바로 반환됨 return obj; } } public class CreateGenericTest { public static void main(String[] args) { Value1 v1 = new Value1(); v1.put("듀크"); // String만 저장 가능 String name = v1.get(); // 형변환 없이 바로 사용 가능 System.out.println(name); Value2 v2 = new Value2(); v2.put("듀크2"); // String 저장 가능 name = (String) v2.get(); // Object로 나오므로 String으로 형변환 System.out.println(name); v2.put(new Date()); // Date 객체도 저장 가능 Date now = (Date) v2.get(); // 꺼낼 때 다시 Date로 형변환 System.out.println(now); Value3<String> v3 = new Value3<String>(); // String 전용 객체 생성 Value3<Date> v4 = new Value3<Date>(); // Date 전용 객체 생성 v4.put(new Date()); // Date만 저장 가능 v3.put("듀크3"); // String만 저장 가능 name = v3.get(); // 형변환 없이 바로 String으로 꺼낼 수 있음 System.out.println(name); } }
코드 해설이 예제는 지네릭스를 한 문장으로 설명하기 어려울 때,
왜 타입을 제한하는 문법이 필요해졌는지를 비교로 보여주는 예제다.먼저
Value1은String만 저장할 수 있다.
그래서 꺼낼 때도String으로 바로 받을 수 있어서 안전하고 단순하다.
하지만 다른 타입을 저장하고 싶어지면 문제가 생긴다.
예를 들어Date를 저장하고 싶다면,Value1과 비슷한 클래스를 또 새로 만들어야 한다.
즉, 타입은 분명하지만 너무 고정적이다.
그다음
Value2는Object를 사용한다.
Object는 거의 모든 객체를 받을 수 있으니,String도 넣을 수 있고Date도 넣을 수 있다.
그래서 처음 보면 훨씬 편하고 유연해 보인다.
하지만 꺼낼 때는 이야기가 달라진다.
get()의 결과가Object이기 때문에, 지금 꺼낸 값이 정말String인지Date인지 사람이 다시 판단하고 직접 형변환해야 한다.
즉, 넓게 받을 수는 있지만 타입 정보가 흐려져서 꺼낼 때마다 불편하고 위험하다.
마지막
Value3<T>는 이 두 방식의 중간 문제를 해결한다.
클래스는 하나만 만들어 두고, 객체를 만들 때 어떤 타입으로 쓸지 정할 수 있다.
예를 들어Value3<String>이라고 만들면 문자열 전용으로 쓰는 것이고,
Value3<Date>라고 만들면 날짜 전용으로 쓰는 것이다.
즉,T는 “아무거나 다 넣는다”는 뜻이 아니라, 객체를 만들 때 어떤 타입으로 쓸지 정하기 위해 비워 둔 자리라고 보면 된다.
그래서
Value3<T>의 장점은 두 가지다.
- 첫째,
Value1처럼 타입마다 비슷한 클래스를 여러 개 만들 필요가 없다.- 둘째,
Value2처럼 꺼낼 때마다 형변환에 의존하지 않아도 된다.
정리하면 이 예제는 이렇게 이해하면 된다.
Value1→ 안전하지만 타입마다 클래스를 따로 만들어야 한다.Value2→ 여러 객체를 담을 수 있지만 꺼낼 때 형변환이 필요하다.Value3<T>→ 클래스는 하나로 두고, 객체를 만들 때 타입을 정해서 안전하게 쓸 수 있다.
즉, 지네릭스의 핵심은
한 클래스를 여러 타입용으로 재사용하면서도, 타입을 분명하게 유지할 수 있게 해 주는 것이다.
5. 지네릭스를 안 쓰면 왜 위험할까
지네릭스를 배우는 이유는 문법 모양을 익히기 위해서가 아니라,
타입이 섞여서 생기는 위험을 줄이기 위해서다.
이 예제는 지네릭스를 사용하지 않았을 때, 저장 단계에서는 문제가 없어 보여도 값을 꺼내서 사용하는 순간 어떤 위험이 생길 수 있는지를 보여준다.
코드 보는 순서
- 먼저
LinkedList list선언 부분을 본다.- 그다음 문자열과 숫자가 함께 들어가는 부분을 본다.
- 이후 첫 번째 반복문이 왜 멀쩡해 보이는지 본다.
- 마지막으로 두 번째 반복문과
Iterator에서 왜 예외가 나는지 확인한다.예제:
GenericTestimport java.util.Iterator; import java.util.LinkedList; public class GenericTest { public static void main(String[] args) { LinkedList list = new LinkedList(); // 지네릭스를 쓰지 않으면 여러 타입의 객체가 섞여 들어갈 수 있다 list.add("java"); list.add(100); list.add("servlet"); list.add("jdbc"); for (int i = 0; i < list.size(); i++) System.out.println(list.get(i)); System.out.println(); for (Object value : list) { String s = (String) value; // 100은 실제로 Integer인데 String으로 바꾸려 해서 예외가 난다 System.out.println(s); } System.out.println(); Iterator iter = list.iterator(); while (iter.hasNext()) { Object value = iter.next(); String s = (String) value; System.out.println(s); } } }// 출력결과 // java // 100 // servlet // jdbc // // java // Exception in thread "main" java.lang.ClassCastException ...
코드 해설이 예제에서 먼저 봐야 하는 것은
LinkedList list = new LinkedList();부분이다.
지네릭스를 쓰지 않았기 때문에, 이 리스트는 처음부터 어떤 타입만 담겠다는 제한이 없다.
그래서"java"같은 문자열도 들어가고,100도 함께 들어갈 수 있다.
여기서100은 기본형int처럼 보이지만, 실제로 리스트에는Integer객체 형태로 들어간다.처음 반복문은 겉으로 보면 아무 문제가 없어 보인다.
그 이유는 값을 그냥 꺼내서 그대로 출력만 하기 때문이다.
즉, 이 단계에서는 값이 문자열인지 숫자인지를 따로 맞춰 쓰지 않고, 단순히 화면에 보여 주기만 하므로 타입이 섞여 있어도 바로 문제가 드러나지 않는다.
그래서 초보자는 “잘 되네?” 하고 넘어가기 쉽다.
하지만 진짜 문제는 두 번째 반복문에서 드러난다.
for (Object value : list)자체는 문제가 아니다.
문제는 그다음 줄인String s = (String) value;이다.
이 코드는 리스트 안의 값을 전부 문자열이라고 가정하고 강제로String으로 바꾸고 있다.
여기서
"java"는 원래 문자열이니까 괜찮다.
그래서 첫 번째 값은 정상적으로 출력된다.
하지만 다음 값인100은 실제로는Integer객체다.
그런데 이것까지 문자열로 바꾸려고 하니까 실행 중에ClassCastException이 발생한다.
즉, 문제는 반복문이 아니라, 타입이 섞여 있는 값을 모두 같은 타입이라고 믿고 형변환한 것이다.
아래의
Iterator부분도 마찬가지다.
반복하는 방식만 바뀌었을 뿐, 리스트에서 꺼낸 값은 여전히Object이고 다시String으로 형변환해야 한다.
즉, 향상된for문을 쓰든Iterator를 쓰든, 지네릭스를 쓰지 않으면 같은 위험이 계속 남는다.
정리하면 이 예제의 핵심은 단순하다.
- 지네릭스를 쓰지 않으면 여러 타입의 값이 한 컬렉션 안에 섞여 들어갈 수 있다.
- 저장할 때는 멀쩡해 보여도, 꺼내서 실제로 사용하는 순간 문제가 터질 수 있다.
- 특히 잘못된 형변환은 컴파일할 때가 아니라 실행 중에 뒤늦게 예외로 나타날 수 있다.
즉, 지네릭스를 안 쓰면 위험한 이유는
문제를 미리 막지 못하고, 한참 뒤에 값을 꺼내는 순간 예외로 만나게 될 수 있기 때문이다.
6. 지네릭스를 쓰면 뭐가 달라질까
앞의
GenericTest예제는 지네릭스를 쓰지 않았을 때 어떤 위험이 생기는지를 보여줬다.
이번 예제는 그 반대로, 지네릭스를 사용하면 무엇이 달라지는지를 보여준다.
핵심은 단순하다.
처음부터 어떤 타입의 값만 담을지 정해 두면, 타입이 섞여서 생기는 문제를 훨씬 줄일 수 있다는 것이다.
코드 보는 순서
- 먼저
LinkedList<String>선언을 본다.- 그다음 어떤 값만 넣을 수 있는지 본다.
- 이후 값을 꺼낼 때 형변환이 왜 없어지는지 본다.
- 마지막으로 향상된
for문과Iterator<String>에서도 타입이 어떻게 유지되는지 확인한다.예제:
GenericTestNewimport java.util.Iterator; import java.util.LinkedList; public class GenericTestNew { public static void main(String[] args) { LinkedList<String> list = new LinkedList<>(); // 처음부터 String만 저장하겠다고 타입을 정한다 list.add("java"); list.add("100"); list.add("servlet"); list.add("jdbc"); for (int i = 0; i < list.size(); i++) System.out.println(list.get(i)); System.out.println(); for (String value : list) { System.out.println(value); } System.out.println(); Iterator<String> iter = list.iterator(); while (iter.hasNext()) { String s = iter.next(); System.out.println(s); } } }// 출력결과 // java // 100 // servlet // jdbc // // java // 100 // servlet // jdbc // // java // 100 // servlet // jdbc
코드 해설이 예제에서 가장 먼저 봐야 하는 부분은
LinkedList<String> list = new LinkedList<>();이다.
여기서<String>은 이 리스트를 문자열 전용으로 쓰겠다는 뜻이다.
즉, 이 리스트에는 처음부터 문자열만 들어갈 수 있다.
그래서
list.add("java"),list.add("servlet"),list.add("jdbc")는 당연히 들어간다.
그리고100도 여기서는 숫자가 아니라"100"처럼 문자열로 넣고 있다.
즉, 숫자처럼 보이더라도 따옴표가 붙어 있으면 문자열이기 때문에LinkedList<String>에 들어갈 수 있는 것이다.
반대로 따옴표 없는100처럼 다른 타입의 값을 넣으려고 하면 맞지 않기 때문에 막히게 된다.
이 점이 앞의
GenericTest와 가장 큰 차이다.
앞의 예제에서는 지네릭스를 쓰지 않았기 때문에 문자열과Integer객체가 한 리스트 안에 같이 들어갈 수 있었다.
그래서 저장할 때는 괜찮아 보여도, 나중에 꺼내서 형변환하는 순간 문제가 터질 수 있었다.
하지만 이번 예제는 애초에String전용 리스트이기 때문에, 그런 식으로 타입이 섞여 들어갈 여지가 훨씬 줄어든다.
값을 꺼낼 때도 차이가 분명하다.
앞의 예제에서는 리스트에서 꺼낸 값을String으로 직접 형변환해야 했다.
하지만 여기서는 리스트 자체가String용으로 정해져 있으므로,list.get(i)의 결과도 문자열로 생각하면 된다.
그래서 억지로(String)같은 형변환 코드를 붙이지 않아도 된다.
즉, 꺼낼 때마다 다시 타입을 맞춰 주는 부담이 줄어드는 것이다.
향상된
for문(forEach)에서도 마찬가지다.
for (String value : list)라고 바로 쓸 수 있다는 것은, 이 리스트에서 꺼내는 값이 문자열이라는 점이 이미 분명하다는 뜻이다.
즉, 반복문을 도는 쪽에서도 타입이 더 분명하게 드러난다.
아래의
Iterator<String>부분도 같은 의미를 가진다.
반복하는 방법이 달라졌을 뿐,iter.next()로 꺼낸 값 역시String이다.
즉, 일반for문이든 향상된for문이든Iterator<String>이든,
지네릭스를 쓰면 값을 꺼낼 때 타입 정보가 계속 유지된다고 보면 된다.
출력 결과가 세 번 반복되는 이유도 여기서 이해할 수 있다.
리스트 안의 같은 데이터를
- 일반
for문으로 한 번- 향상된
for문으로 한 번Iterator<String>으로 한 번이렇게 세 가지 방식으로 꺼내서 출력했기 때문이다.
즉, 반복 방법은 달라도 리스트 안의 데이터와 타입은 그대로 유지된다.
정리하면 이 예제의 핵심은 이렇다.
LinkedList<String>은 문자열만 담는 리스트다.- 그래서 다른 타입이 섞여 들어가는 위험을 줄일 수 있다.
- 값을 꺼낼 때도 형변환 부담이 줄어든다.
- 반복하는 방식이 바뀌어도 타입 정보는 계속 분명하게 유지된다.
즉, 지네릭스를 쓰면 달라지는 점은
문제를 나중에 실행하다가 만나는 것이 아니라, 처음부터 타입을 제한해서 더 안전하게 다룰 수 있게 된다는 것이다.
참고지네릭스는 여기서 끝나는 것이 아니라,
뒤로 가면와일드카드,지네릭 메서드,지네릭 타입의 제거같은 내용으로 더 이어진다.
이번 글에서는 기본 사용 흐름까지 먼저 잡고,
이후에 더 복잡한 문법은 필요할 때 다시 연결해서 보면 된다.
7. 리스트 - ArrayList
개념
ArrayList는 리스트를 구현한 가장 대표적인 클래스다.
순서가 있는 데이터를 저장하고 꺼낼 때 가장 먼저 떠올리면 되는 구조다.
그래서 컬렉션을 처음 배울 때도 가장 기본이 되는 리스트로 자주 등장한다.
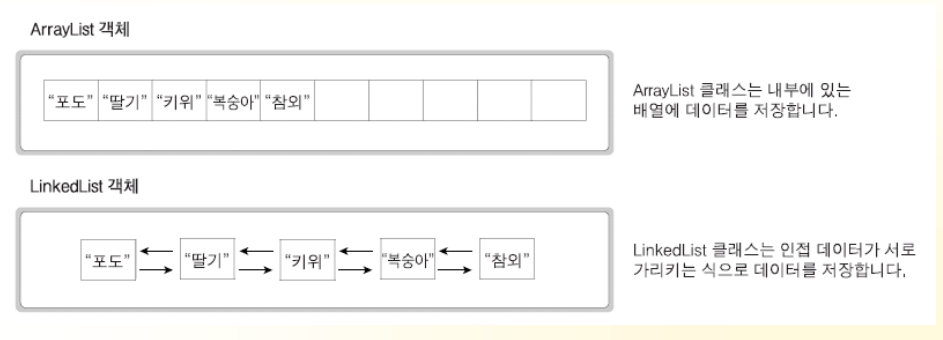
ArrayList는 내부적으로는 배열처럼 값을 관리한다.
하지만 배열처럼 길이를 딱 정해 두고 조심스럽게 다루는 느낌보다는,
값을 추가하고 꺼내고 수정하면서 더 유연하게 사용할 수 있는 리스트에 가깝다.
즉, 배열처럼 순서대로 저장하는 감각은 살리면서도, 실제 사용은 더 편하게 만든 구조라고 보면 된다.
또
ArrayList는 순서가 있는 리스트이기 때문에,
몇 번째 값인지 인덱스로 다루는 감각이 중요하다.
get(index),add(index, 값),set(index, 값),remove(index)같은 메서드도 전부 이 인덱스 감각 위에서 이해해야 헷갈리지 않는다.
그리고
ArrayList를 볼 때는 메서드를 하나씩 따로 외우기보다,
저장 → 조회 → 중간 삽입 → 수정 → 삭제 → 검색 흐름으로 묶어서 보는 것이 훨씬 쉽다.
이번 글에서는 성능 비교를 깊게 파기보다,
ArrayList에서 어떤 메서드를 언제 쓰는지를 먼저 확실히 잡는 것이 중요하다.
먼저 메서드부터 한눈에 보기
add(값): 맨 뒤에 값을 추가한다.add(index, 값): 원하는 위치에 값을 끼워 넣는다.get(index): 해당 위치의 값을 꺼낸다.set(index, 값): 해당 위치의 값을 다른 값으로 바꾼다.remove(index): 해당 위치의 값을 삭제한다.remove(값): 같은 값을 찾아서 삭제한다.size(): 현재 들어 있는 데이터 개수를 구한다.indexOf(값): 앞에서부터 찾아서 처음 나온 위치를 구한다.lastIndexOf(값): 뒤쪽 기준으로 찾아서 마지막 위치를 구한다.
즉,
ArrayList는
값을 넣고, 꺼내고, 바꾸고, 지우고, 찾는 메서드를 중심으로 이해하면 된다.
여기서 특히 많이 쓰는 흐름은 이렇다.
- 저장할 때 →
add()- 꺼낼 때 →
get()- 개수 확인할 때 →
size()- 값 바꿀 때 →
set()- 지울 때 →
remove()- 위치 찾을 때 →
indexOf(),lastIndexOf()
7-1. 기본 저장과 조회
코드 보는 순서
- 먼저
ArrayList<String>선언을 본다.- 그다음
add()로 값을 넣는 부분을 본다.- 이후
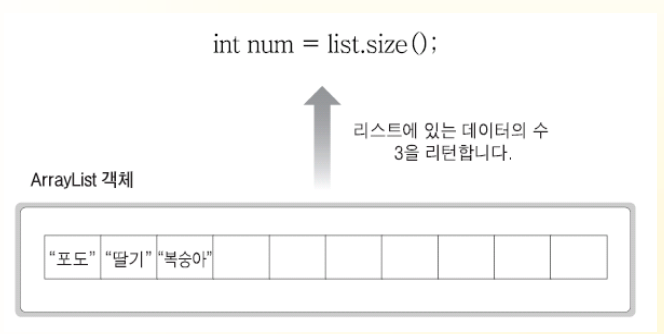
size()로 개수를 구하는 부분을 본다.- 마지막으로
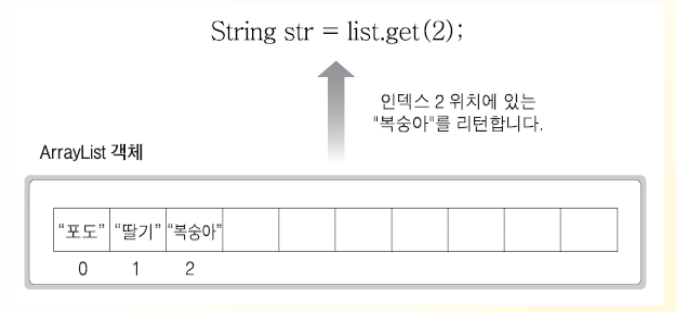
get(index)로 값을 꺼내는 흐름을 본다.
예제:
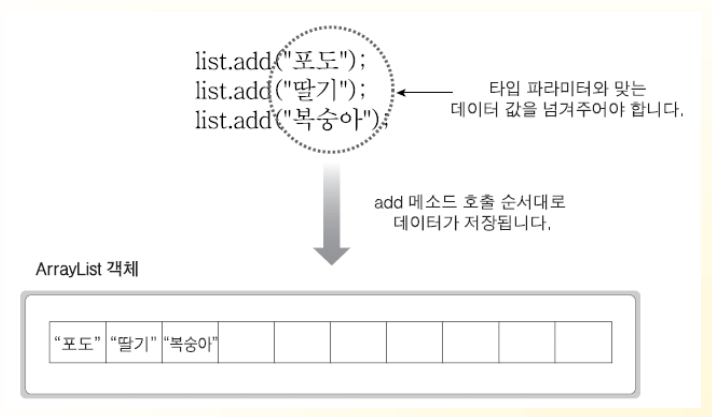
ArrayListExample1import java.util.ArrayList; class ArrayListExample1 { public static void main(String args[]) { // 1. 문자열만 저장하는 ArrayList를 생성함 ArrayList<String> list = new ArrayList<String>(); // 2. add()로 값을 차례대로 저장함 list.add("포도"); list.add("딸기"); list.add("복숭아"); // 3. size()로 저장된 데이터 개수를 구함 int num = list.size(); // 4. get(index)로 각 위치의 값을 꺼내 출력함 for (int cnt = 0; cnt < num; cnt++) { String str = list.get(cnt); System.out.println(str); } // 추가 확인: ArrayList도 지네릭스로 타입을 제한할 수 있음 ArrayList<Integer> list2 = new ArrayList<Integer>(); list2.add(Integer.valueOf(100)); list2.add(1000); // 오토박싱 // list2.add("1000"); // 에러: Integer 리스트라서 문자열은 저장할 수 없음 } }// 출력결과 // 포도 // 딸기 // 복숭아
1 2 3 4
코드 해설이 예제는
ArrayList를 가장 기본적인 방식으로 사용하는 흐름이다.
add(): 값을 뒤에 차례대로 넣는다.size(): 지금 몇 개 들어 있는지 확인한다.get(index): 각 위치의 값을 하나씩 꺼낸다.
즉, 이 예제는
저장한 값을 순서대로 다시 꺼내 보는 가장 기본적인 사용법을 보여준다.
여기서 중요한 것은
ArrayList가 순서가 있는 리스트라는 점이다.
"포도"를 먼저 넣고"딸기","복숭아"를 그 뒤에 넣었기 때문에,
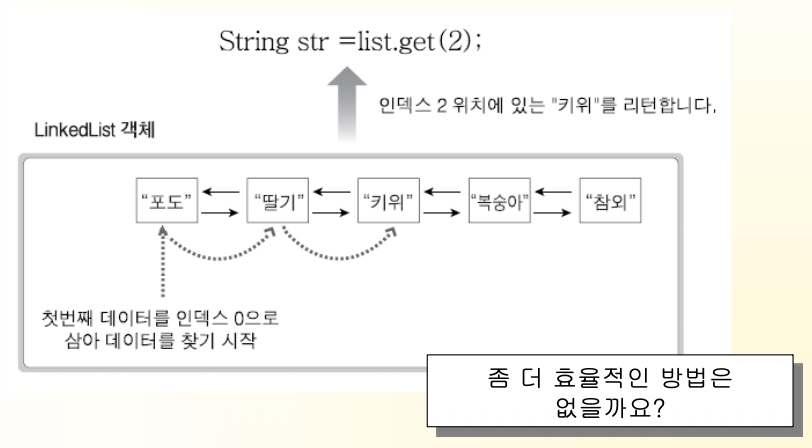
get(0),get(1),get(2)처럼 꺼냈을 때도 그 순서를 기준으로 값을 읽게 된다.
또
size()는 반복문과 자주 같이 나온다.
ArrayList안에 값이 몇 개 들어 있는지 먼저 알아야,
반복문이 어디까지 돌아야 하는지 정할 수 있기 때문이다.
아래의
ArrayList<Integer>부분은
ArrayList도 지네릭스를 써서 어떤 타입만 저장할지 제한할 수 있다는 점을 다시 보여준다.
숫자용 리스트이기 때문에Integer값은 저장할 수 있지만,
"1000"처럼 문자열은 저장할 수 없다.
즉, 이 예제는 메서드로 보면 이렇게 정리하면 된다.
- 넣기 →
add()- 개수 확인 →
size()- 꺼내기 →
get()
7-2. 삽입, 수정, 삭제
코드 보는 순서
- 먼저 처음 리스트 상태를 본다.
- 그다음
add(index, 값)으로 중간 삽입을 본다.- 이후
set(index, 값)으로 수정하는 부분을 본다.- 마지막으로
remove(index)와remove(값)차이를 본다.
예제:
ArrayListExample2import java.util.ArrayList; import java.util.Iterator; public class ArrayListExample2 { public static void main(String args[]) { // 1. 문자열을 저장할 ArrayList를 생성하고 기본 데이터를 넣음 ArrayList<String> list = new ArrayList<String>(); list.add("포도"); list.add("딸기"); list.add("복숭아"); System.out.println(list); // 2. add(index, 값)으로 중간 위치에 데이터를 삽입함 list.add(2, "키위"); System.out.println(list); // 3. set(index, 값)으로 특정 위치의 값을 수정함 list.set(0, "오렌지"); System.out.println(list); // 4. remove(index)로 위치 기준 삭제를 수행함 list.remove(1); System.out.println(list); // 5. remove(값)으로 값 기준 삭제를 수행함 list.remove("키위"); System.out.println(list); // 6. 일반 for문으로 전체 데이터를 출력함 for (int cnt = 0; cnt < list.size(); cnt++) { String str = list.get(cnt); System.out.println(str); } // 7. 향상된 for문으로 전체 데이터를 출력함 for (String fruit : list) System.out.println(fruit); // 8. Iterator로 전체 데이터를 출력함 Iterator<String> iter = list.iterator(); while (iter.hasNext()) System.out.println(iter.next()); } }// 출력결과 // [포도, 딸기, 복숭아] // [포도, 딸기, 키위, 복숭아] // [오렌지, 딸기, 키위, 복숭아] // [오렌지, 키위, 복숭아] // [오렌지, 복숭아] // 오렌지 // 복숭아 // 오렌지 // 복숭아 // 오렌지 // 복숭아
1 2 3 4
코드 해설이 예제는
ArrayList에서 자주 헷갈리는 메서드들을 한 번에 보여준다.
먼저 이 네 가지를 구분해서 보면 훨씬 쉽다.
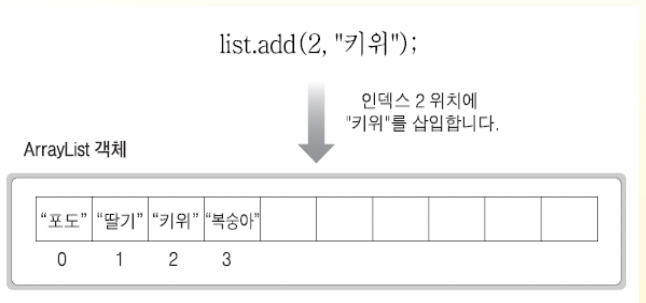
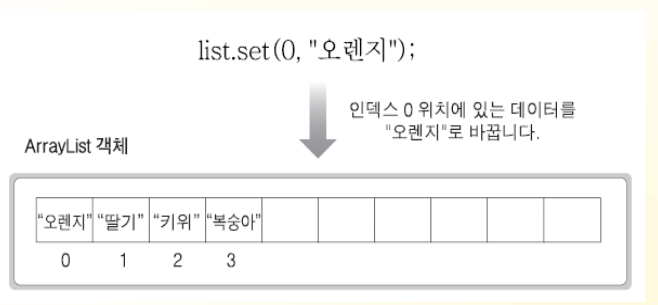
add(index, 값): 값을 새로 끼워 넣는다.set(index, 값): 원래 있던 값을 다른 값으로 바꾼다.remove(index): 몇 번째 값을 지운다.remove(값): 같은 값을 찾아서 지운다.
즉, 비슷해 보여도 역할은 전부 다르다.
add()는 추가이고,set()은 수정이다.
이 둘은 초보자가 가장 많이 헷갈리는 부분이다.
예를 들어
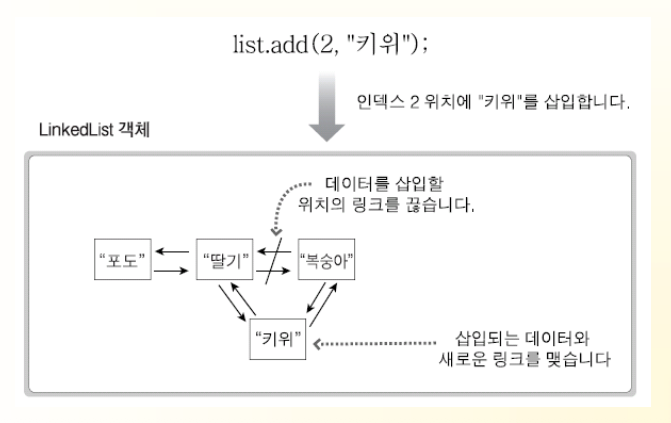
list.add(2, "키위")는
2번 위치에"키위"를 넣으면서 뒤의 값들을 한 칸씩 밀어낸다.
즉, 없던 값을 새로 넣는 동작이다.
반면
list.set(0, "오렌지")는
0번 위치에 원래 들어 있던"포도"를"오렌지"로 바꾸는 것이다.
즉, 새 칸이 생기는 것이 아니라 원래 값이 교체되는 것이다.
삭제도 두 가지로 나뉜다.
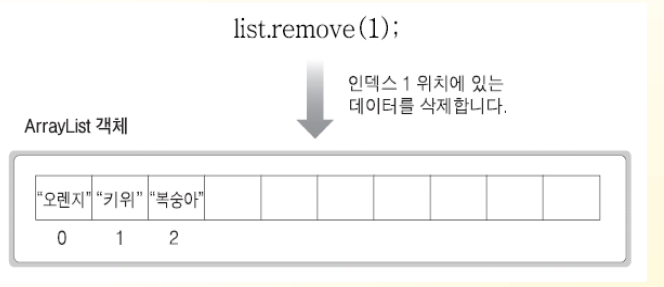
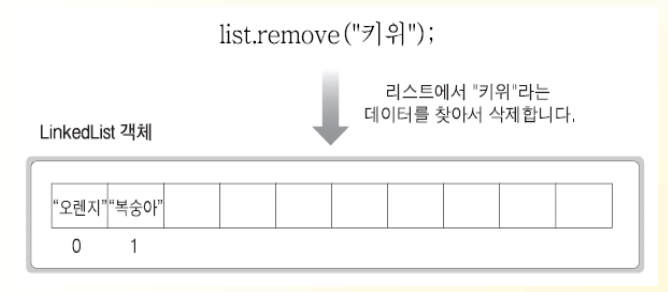
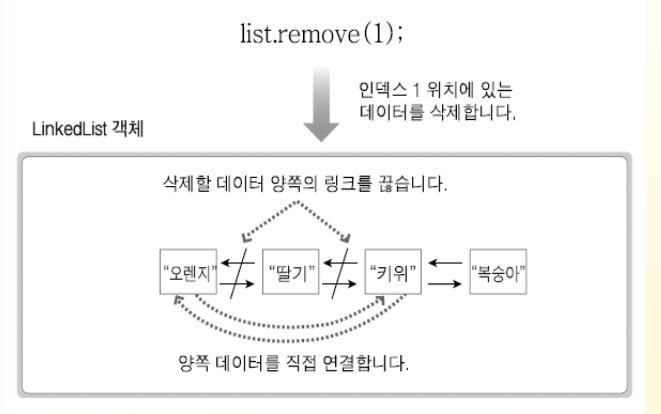
remove(1): 두 번째 위치의 값을 삭제remove("키위"):"키위"라는 값을 찾아서 삭제
여기서 핵심은 같은
remove()라도 괄호 안에 무엇을 넣느냐에 따라 기준이 달라진다는 점이다.
숫자를 넣으면 위치 기준이고, 값을 넣으면 값 기준이다.
즉, 이 예제는 흐름으로 보면 이렇게 읽으면 된다.
- 기본 데이터 저장
- 중간에 새 값 추가
- 기존 값 수정
- 위치로 삭제
- 값으로 삭제
- 최종 결과 출력
그래서 이 구간은 메서드별로 이렇게 기억하면 된다.
- 새로 끼워 넣기 →
add(index, 값)- 기존 값 바꾸기 →
set(index, 값)- 위치로 삭제 →
remove(index)- 값으로 삭제 →
remove(값)
7-3. 검색
코드 보는 순서
- 먼저 같은 값이 두 번 들어간 리스트를 본다.
- 그다음
indexOf()를 본다.- 이후
lastIndexOf()를 본다.- 마지막으로 두 결과가 왜 다른지 확인한다.
예제:
ArrayListExample3import java.util.ArrayList; class ArrayListExample3 { public static void main(String args[]) { // 1. 문자열을 저장할 ArrayList를 생성함 ArrayList<String> list = new ArrayList<String>(); // 2. 같은 값이 두 번 들어가도록 데이터를 저장함 list.add("머루"); list.add("사과"); list.add("앵두"); list.add("자두"); list.add("사과"); // 3. indexOf()로 처음 나온 "사과"의 위치를 찾음 int index1 = list.indexOf("사과"); // 4. lastIndexOf()로 마지막에 나온 "사과"의 위치를 찾음 int index2 = list.lastIndexOf("사과"); // 5. 검색 결과를 출력함 System.out.println("첫번째 사과: " + index1); System.out.println("마지막 사과: " + index2); } }// 출력결과 // 첫번째 사과: 1 // 마지막 사과: 4
1 2
코드 해설이 예제는
ArrayList에서 값을 찾을 때 어떤 메서드를 쓰는지 보여준다.
여기서 구분할 것은 두 가지다.
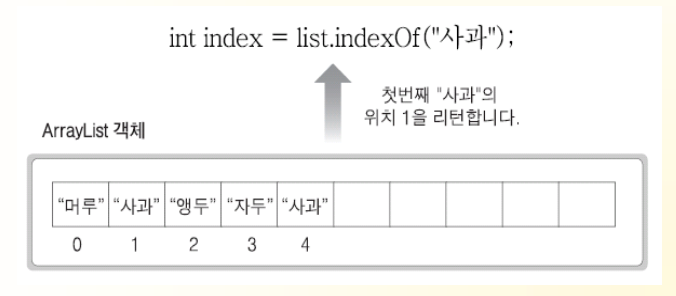
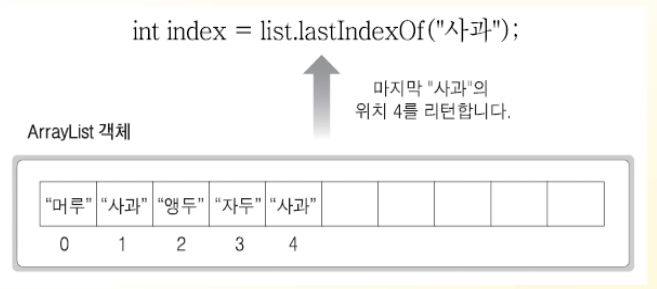
indexOf(값): 앞에서부터 찾아서 처음 나온 위치를 반환lastIndexOf(값): 뒤쪽 기준으로 찾아서 마지막 위치를 반환
즉, 둘 다 위치를 찾는 메서드이지만,
어느 방향 기준으로 찾느냐가 다르다.
이 예제에서는
"사과"가 두 번 들어 있다.
그래서indexOf("사과")는 첫 번째"사과"위치인1을 반환하고,
lastIndexOf("사과")는 마지막"사과"위치인4를 반환한다.
이 메서드는 중복이 가능한 리스트에서 특히 의미가 있다.
같은 값이 여러 번 들어갈 수 있기 때문에,
처음 위치를 찾을지 마지막 위치를 찾을지 구분해서 볼 필요가 있기 때문이다.
그리고 찾는 값이 없으면 두 메서드 모두
-1을 반환한다.
즉, 검색 결과가-1이면 리스트 안에 그 값이 없다는 뜻이다.
그래서 검색 메서드는 이렇게 기억하면 된다.
- 처음 나온 위치 →
indexOf()- 마지막 위치 →
lastIndexOf()- 못 찾음 →
-1
헷갈리기 쉬운 부분
add(값)과add(index, 값)은 다르다. 하나는 맨 뒤 추가이고, 하나는 원하는 위치 삽입이다.add()와set()은 다르다.add()는 새 값을 넣는 것이고,set()은 기존 값을 바꾸는 것이다.remove(index)와remove(값)도 다르다. 하나는 위치 기준, 하나는 값 기준이다.indexOf()와lastIndexOf()는 둘 다 위치를 찾지만, 앞에서 찾는지 뒤에서 찾는지가 다르다.size()는 마지막 인덱스가 아니라 데이터 개수다. 그래서 마지막 인덱스는size() - 1이다.
참고
ArrayList는 결국
순서 있는 데이터를 저장하고, 인덱스로 다루는 리스트다.
그래서 복습할 때는 메서드를 따로따로 외우기보다,
아래 흐름으로 묶어 두는 것이 훨씬 잘 들어온다.
- 저장 →
add()- 조회 →
get()- 개수 확인 →
size()- 수정 →
set()- 삭제 →
remove()- 검색 →
indexOf(),lastIndexOf()이 흐름만 잡혀도
ArrayList는 훨씬 덜 헷갈리게 된다.
8. 리스트 - LinkedList
개념
LinkedList도List를 구현한 클래스다.
그래서 순서가 있는 데이터를 저장하고, 인덱스로 값을 꺼내고, 중간에 값을 넣거나 지우는 기본 흐름은ArrayList와 많이 비슷하다.
즉, 겉으로 보이는 메서드 이름만 보면 거의 같은 리스트처럼 느껴진다.
하지만 내부에서 데이터를 관리하는 방식은 다르다.
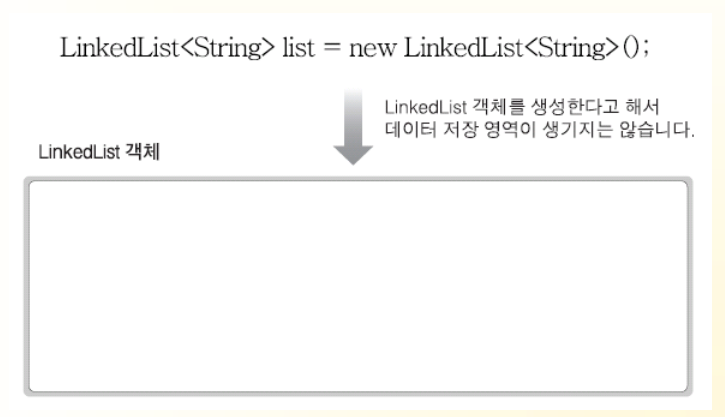
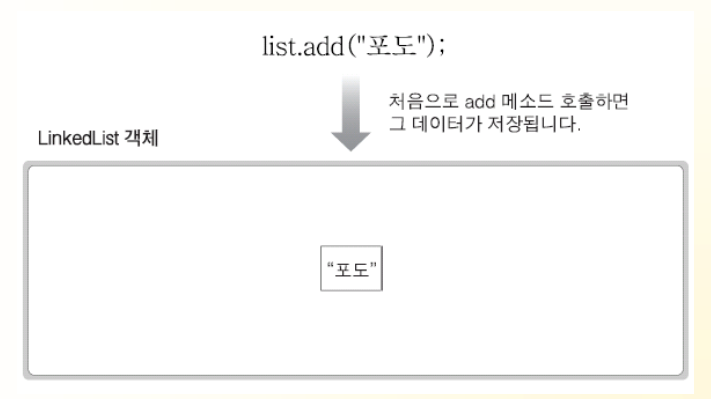
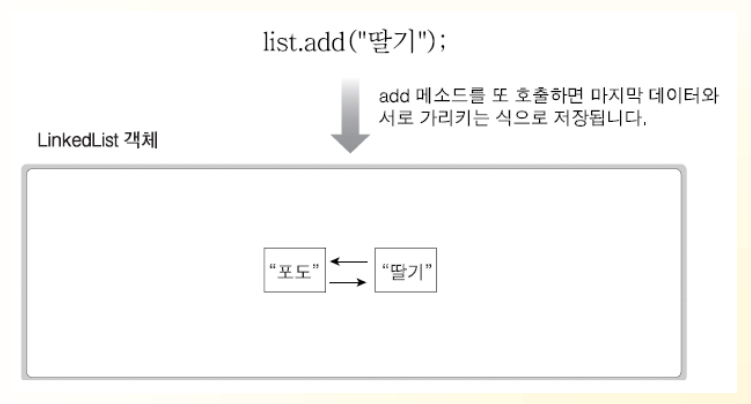
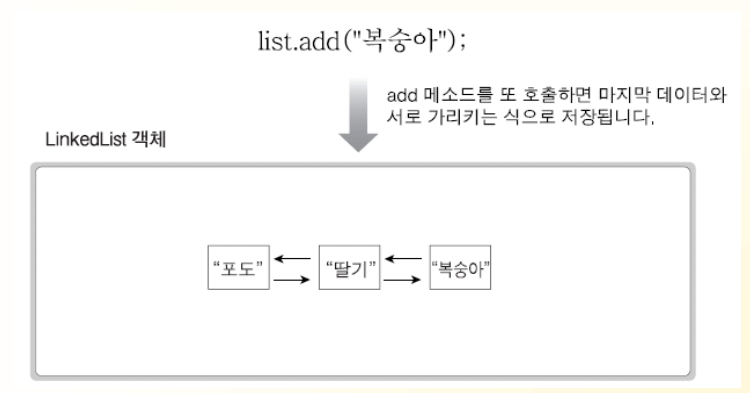
ArrayList가 배열처럼 값을 관리하는 구조라면,LinkedList는 각 데이터가 앞뒤로 이어지는 연결 구조로 관리된다고 이해하면 된다.
그래서 이름도LinkedList인 것이다.
즉,
LinkedList는 값을 배열 칸에 차례대로 넣는 느낌보다,
각 데이터가 서로 연결되어 있는 구조라고 보면 된다.
그래서add(),get(),remove()같은 메서드는 비슷하게 보여도, 내부에서는 값을 다루는 방식이 다르다.
여기서는 성능 비교를 깊게 파기보다,
LinkedList도 순서 있는 데이터를 다루는 리스트이고, 내부 구조만 다르다는 감각을 먼저 잡는 것이 중요하다.
먼저 메서드부터 한눈에 보기
add(값): 맨 뒤에 값을 추가한다.add(index, 값): 원하는 위치에 값을 끼워 넣는다.get(index): 해당 위치의 값을 꺼낸다.set(index, 값): 해당 위치의 값을 다른 값으로 바꾼다.remove(index): 해당 위치의 값을 삭제한다.remove(값): 같은 값을 찾아서 삭제한다.size(): 현재 들어 있는 데이터 개수를 구한다.iterator(): 값을 순서대로 꺼내기 위한 반복 도구를 만든다.hasNext(): 다음 값이 남아 있는지 확인한다.next(): 다음 값을 하나 꺼낸다.
즉,
LinkedList도 결국
값을 넣고, 꺼내고, 바꾸고, 지우고, 순서대로 반복해서 읽는 메서드를 중심으로 이해하면 된다.
여기서 먼저 잡아야 하는 흐름은 이렇다.
- 저장할 때 →
add()- 꺼낼 때 →
get()- 개수 확인할 때 →
size()- 값 바꿀 때 →
set()- 지울 때 →
remove()- 순서대로 반복할 때 →
iterator(),hasNext(),next()
8-1. 기본 저장과 조회
코드 보는 순서
- 먼저
LinkedList<String>선언을 본다.- 그다음
add()로 값을 넣는 부분을 본다.- 이후
size()로 개수를 구하는 부분을 본다.- 마지막으로
get(index)로 값을 꺼내는 흐름을 본다.
예제:
LinkedListExample1// exam01.java import java.util.LinkedList; class LinkedListExample1 { public static void main(String args[]) { // 문자열만 저장하는 LinkedList를 생성함 LinkedList<String> list = new LinkedList<String>(); // add()로 값을 차례대로 저장함 list.add("포도"); list.add("딸기"); list.add("복숭아"); // size()로 저장된 데이터 개수를 구함 int num = list.size(); // get(index)로 각 위치의 값을 꺼내 출력함 for (int cnt = 0; cnt < num; cnt++) { String str = list.get(cnt); System.out.println(str); } // LinkedList도 지네릭스로 타입을 제한할 수 있음 LinkedList<Integer> list2 = new LinkedList<Integer>(); list2.add(Integer.valueOf(100)); list2.add(1000); // 오토박싱 // list2.add("1000"); // 에러: Integer 리스트라서 문자열은 저장할 수 없음 } }// 출력결과 // 포도 // 딸기 // 복숭아
1 2 3 4
코드 해설이 예제는
LinkedList를 가장 기본적인 방식으로 사용하는 흐름을 보여준다.
먼저 메서드 역할만 간단히 보면 이렇다.
add(): 값을 뒤에 차례대로 넣는다.
size(): 지금 몇 개 들어 있는지 확인한다.
get(index): 각 위치의 값을 하나씩 꺼낸다.
즉, 이 예제는
저장한 값을 순서대로 다시 꺼내 보는 가장 기본적인 사용법을 보여주는 예제다.
여기서 중요한 점은
LinkedList도List이기 때문에
"포도","딸기","복숭아"처럼 넣은 순서를 기준으로 값을 다룬다는 것이다.
그래서get(0),get(1),get(2)처럼 인덱스로 값을 꺼낼 수 있다.
또
size()는 반복문과 자주 같이 나온다.
리스트 안에 값이 몇 개 들어 있는지 알아야,
반복문을 어디까지 돌릴지 정할 수 있기 때문이다.
여기까지의 흐름만 보면
ArrayList와 거의 비슷해 보인다.
그래서 처음 배우는 단계에서는LinkedList도 같은List계열이라는 점부터 익히는 것이 중요하다.
다만 내부 구조를 생각하면 차이가 있다.
ArrayList는 배열처럼 값을 관리하는 느낌이라면,
LinkedList는 각 데이터가 서로 이어진 연결 구조라고 이해하면 된다.
아래의
LinkedList<Integer>부분은LinkedList도 지네릭스를 함께 써서
어떤 타입만 담을지 제한할 수 있다는 점을 다시 확인하는 예제다.
숫자용 리스트이기 때문에Integer값은 들어갈 수 있지만,
"1000"처럼 문자열은 들어갈 수 없다.
즉, 이 예제는 메서드 기준으로 이렇게 기억하면 된다.
- 넣기 →
add()- 개수 확인 →
size()- 꺼내기 →
get()
8-2. 삽입, 수정, 삭제
코드 보는 순서
- 먼저 초기 리스트 상태를 본다.
- 그다음
add(index, 값)으로 중간 삽입을 본다.- 이후
set(index, 값)으로 수정하는 부분을 본다.- 마지막으로
remove()로 삭제하는 흐름을 본다.예제:
LinkedListExample2// exam02.java import java.util.LinkedList; class LinkedListExample2 { public static void main(String args[]) { // 문자열을 저장할 LinkedList를 생성하고 기본 데이터를 넣음 LinkedList<String> list = new LinkedList<String>(); list.add("포도"); list.add("딸기"); list.add("복숭아"); // add(index, 값)으로 중간 위치에 데이터를 삽입함 list.add(2, "키위"); // set(index, 값)으로 특정 위치의 값을 수정함 list.set(0, "오렌지"); // remove(index)와 remove(값)으로 데이터를 삭제함 list.remove(1); list.remove("키위"); // 최종 결과를 출력함 for (int cnt = 0; cnt < list.size(); cnt++) { String str = list.get(cnt); System.out.println(str); } } }// 출력결과 // 오렌지 // 복숭아
1 2
코드 해설이 예제는
LinkedList도ArrayList처럼
add(),set(),remove()를 사용할 수 있다는 점을 보여준다.
여기서 먼저 메서드 역할을 나눠서 보면 훨씬 쉽다.
add(index, 값): 원하는 위치에 새 값을 끼워 넣는다.
set(index, 값): 원래 있던 값을 다른 값으로 바꾼다.
remove(index): 몇 번째 값을 삭제한다.
remove(값): 같은 값을 찾아서 삭제한다.
즉, 비슷해 보여도 역할은 전부 다르다.
add()는 추가이고,set()은 수정이다.
이 둘은 초보자가 가장 많이 헷갈리는 부분이다.
예를 들어
list.add(2, "키위")는
2번 위치에"키위"를 새로 넣는 것이다.
즉, 없던 값이 하나 더 들어가는 동작이다.
반면
list.set(0, "오렌지")는
0번 위치의 기존 값"포도"를"오렌지"로 바꾸는 것이다.
즉, 새 값을 하나 더 넣는 것이 아니라 기존 값을 교체하는 것이다.
삭제도 두 가지로 나뉜다.
remove(1): 두 번째 위치의 값을 삭제
remove("키위"):"키위"라는 값을 찾아서 삭제
즉, 같은
remove()라도 괄호 안에 무엇을 넣느냐에 따라
삭제 기준이 달라진다고 이해해야 한다.
이 예제의 전체 흐름은 이렇게 보면 된다.
기본 데이터 저장
중간에 새 값 추가
기존 값 수정
위치 기준 삭제
값 기준 삭제
최종 결과 출력
여기서
LinkedList답게 이해해야 하는 부분은,
겉으로는ArrayList와 비슷하게 보이지만 내부에서는
배열 칸을 다루는 느낌보다 앞뒤 연결 관계가 바뀐다고 보는 것이 더 자연스럽다는 점이다.
그래서 이 구간은 메서드별로 이렇게 기억하면 된다.
- 새로 끼워 넣기 →
add(index, 값)- 기존 값 바꾸기 →
set(index, 값)- 위치로 삭제 →
remove(index)- 값으로 삭제 →
remove(값)
8-3. Iterator로 순서대로 꺼내기
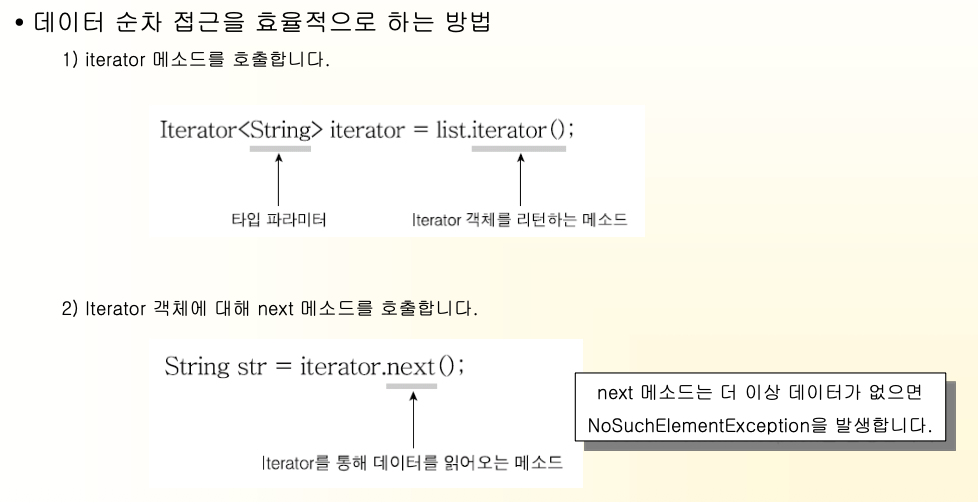
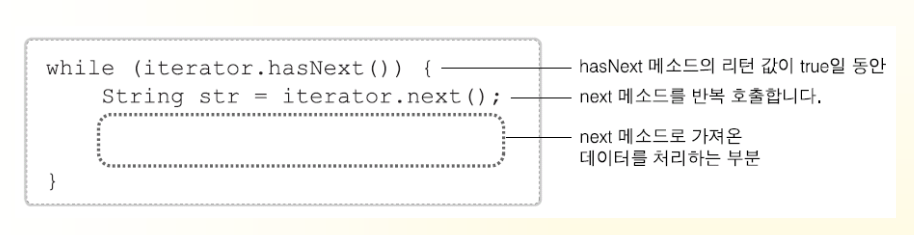
LinkedList안의 값을 하나씩 차례대로 꺼내고 싶을 때Iterator를 사용할 수 있다.
Iterator는 컬렉션 값을 순서대로 꺼내기 위한 도구라고 보면 된다.
여기서 먼저 구분할 것은 두 가지다.
iterator():Iterator도구를 받아오는 메서드
Iterator: 값을 하나씩 꺼낼 때 사용하는 반복 도구
그리고 이 도구는 보통 아래 순서로 사용한다.
iterator()로 반복 도구를 만든다.hasNext()로 다음 값이 남아 있는지 확인한다.next()로 다음 값을 하나 꺼낸다.
코드 보는 순서
- 먼저
iterator()로 반복자 객체를 만드는 부분을 본다.- 그다음
hasNext()로 다음 값이 있는지 확인하는 흐름을 본다.- 이후
next()로 값을 하나씩 꺼내는 부분을 본다.- 마지막으로 이 방식이 향상된
for문과 어떻게 이어지는지 본다.예제:
LinkedListExample3// exam03.java import java.util.Iterator; import java.util.LinkedList; class LinkedListExample3 { public static void main(String args[]) { // 문자열을 저장할 LinkedList를 생성하고 값을 넣음 LinkedList<String> list = new LinkedList<String>(); list.add("망고"); list.add("파인애플"); list.add("바나나"); // iterator()로 반복자 객체를 생성함 Iterator<String> iterator = list.iterator(); // hasNext()로 다음 값이 있는지 확인하고, next()로 값을 꺼내 출력함 while (iterator.hasNext()) { String str = iterator.next(); System.out.println(str); } } }// 출력결과 // 망고 // 파인애플 // 바나나
1 2
코드 해설
Iterator는 컬렉션 안의 값을 앞에서부터 차례대로 하나씩 꺼내기 위한 도구다.
여기서 메서드 역할은 이렇게 보면 된다.
iterator(): 반복 도구를 만든다.
hasNext(): 다음 값이 남아 있는지 확인한다.
next(): 다음 값을 하나 꺼낸다.
즉,
Iterator는 복잡한 문법이라기보다
컬렉션 안의 값을 순서대로 읽기 위한 도구라고 이해하면 된다.
이 예제는 흐름이 단순하다.
LinkedList에 값을 저장한다.
iterator()로 반복 도구를 만든다.
hasNext()가true인 동안 반복한다.
next()로 값을 하나씩 꺼내서 출력한다.
즉, 반복의 핵심은
남은 값이 있는지 먼저 확인하고, 있으면 하나 꺼내는 것이다.
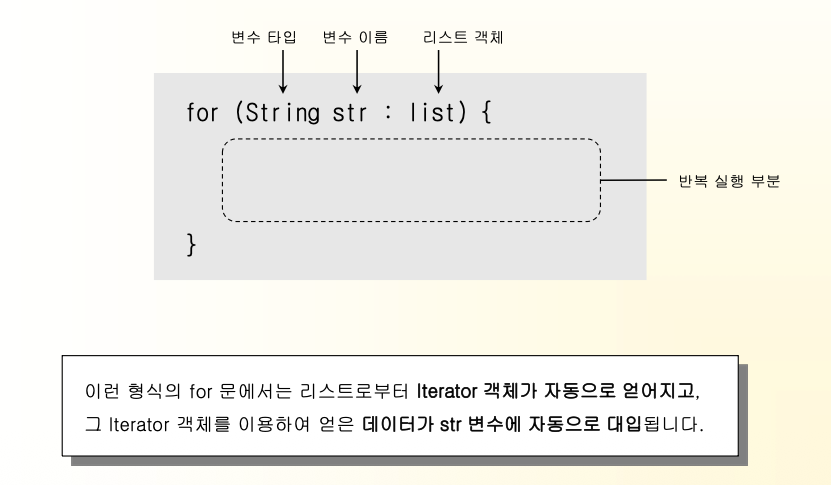
그리고 향상된
for문도 결국은 이런 흐름을 더 간단하게 쓴 형태라고 보면 된다.
즉,Iterator를 이해하면 향상된for문도 더 자연스럽게 연결된다.
ListIterator도 함께 알아두면 좋다.
ListIterator는List전용 반복자이고,Iterator보다 기능이 더 확장된 형태다.
그래서next()로 뒤로 가는 것뿐 아니라previous()로 앞으로도 이동할 수 있다.
헷갈리기 쉬운 부분
LinkedList도List이기 때문에add(),get(),set(),remove()흐름은ArrayList와 비슷하다.- 하지만 내부 구조는 다르다.
LinkedList는 각 데이터가 이어지는 연결 구조라고 이해해야 한다.add()와set()은 다르다.add()는 새 값을 넣는 것이고,set()은 기존 값을 바꾸는 것이다.remove(index)와remove(값)도 다르다. 하나는 위치 기준, 하나는 값 기준이다.iterator()는 값을 꺼내는 것이 아니라, 값을 꺼내기 위한 반복 도구를 만드는 메서드다.hasNext()는 확인이고,next()는 실제로 값을 꺼내는 동작이다.
참고
LinkedList는 결국
순서 있는 데이터를 저장하는 리스트다.
그래서 복습할 때는 메서드를 따로따로 외우기보다,
아래 흐름으로 묶어 두는 것이 훨씬 잘 들어온다.
- 저장 →
add()- 조회 →
get()- 개수 확인 →
size()- 수정 →
set()- 삭제 →
remove()- 순차 반복 →
iterator(),hasNext(),next()이 흐름만 잡혀도
LinkedList는 훨씬 덜 헷갈리게 된다.
9. List와 Collections 유틸리티
개념
List는 여러 데이터를 순서대로 저장하는 구조다.
즉, 값을 담아 두는 그릇이라고 보면 된다.
앞에서 본ArrayList,LinkedList도 모두 이런List계열이다.
반면
Collections는 데이터를 저장하는 클래스가 아니다.
이미 만들어진 컬렉션 안의 데이터를 정렬하거나, 섞거나, 최대값과 최소값을 구하고, 탐색하는 기능을 모아 둔 유틸리티 클래스다.
즉,List가 데이터를 담는 구조라면,Collections는 그 안의 데이터를 다루는 도구 모음이라고 이해하면 된다.
그래서 이 파트는
컬렉션을 새로 만드는 법보다
이미 담겨 있는 데이터를 어떻게 다룰 수 있는지를 익히는 쪽에 가깝다.
먼저 메서드부터 한눈에 보기
Collections.addAll(list, 값들): 여러 값을 한 번에 리스트에 넣는다.Collections.max(list): 가장 큰 값을 구한다.Collections.min(list): 가장 작은 값을 구한다.Collections.sort(list): 리스트를 정렬한다.Collections.binarySearch(list, 값): 정렬된 리스트에서 값의 위치를 찾는다.Collections.shuffle(list): 리스트 안의 값을 섞는다.
즉,
Collections는
저장소를 새로 만드는 클래스가 아니라, 이미 들어 있는 데이터를 처리하는 도구라고 보면 된다.
여기서 먼저 잡아야 하는 흐름은 이렇다.
- 값을 한 번에 옮길 때 →
addAll()- 가장 큰 값, 작은 값 구할 때 →
max(),min()- 정렬할 때 →
sort()- 정렬된 상태에서 위치 찾을 때 →
binarySearch()- 순서를 섞을 때 →
shuffle()
9-1. CollectionSort로 보는 Collections 유틸리티
코드 보는 순서
- 먼저 배열 데이터를 준비하는 부분을 본다.
- 그다음
List를 만들고Collections.addAll()로 값을 옮기는 흐름을 본다.- 이후
max(),min()으로 값을 비교하는 부분을 본다.- 그다음
sort()로 정렬하는 흐름을 본다.- 정렬된 상태에서
binarySearch()로 위치를 찾는 흐름을 본다.- 마지막으로
shuffle()과 숫자 리스트 예제를 확인한다.
예제:
CollectionSort// exam01.java package day10; import java.util.ArrayList; import java.util.Collections; import java.util.List; public class CollectionSort { public static void main(String[] args) { // 문자열 배열 데이터를 준비함 String[] array = { "JAVA", "SERVLET", "JDBC", "JSP", "RMI" }; // List를 생성함 List<String> list = new ArrayList<String>(); // Collections.addAll()로 배열 데이터를 List에 한 번에 저장함 Collections.addAll(list, array); System.out.println("list에 저장된 모든 데이터 : " + list); // max()와 min()으로 최대값, 최소값을 구함 String maxStr = Collections.max(list); String minStr = Collections.min(list); System.out.println("최대값:" + maxStr); System.out.println("최소값:" + minStr); // sort()로 데이터를 오름차순 정렬함 Collections.sort(list); System.out.println("list의 데이터들을 오름차순으로 소팅한 결과 : " + list); // binarySearch()로 정렬된 리스트에서 "JDBC"의 위치를 찾음 int index = Collections.binarySearch(list, "JDBC"); System.out.println("\"JDBC\" 가 저장된 위치 : " + index); // shuffle()로 데이터를 섞음 Collections.shuffle(list); System.out.println("list의 데이터들을 섞은 결과 : " + list); // 숫자 리스트에도 같은 방식으로 max(), min()을 적용할 수 있음 List<Integer> list2 = new ArrayList<Integer>(); list2.add(10); list2.add(20); list2.add(15); list2.add(5); int maxNum = Collections.max(list2); int minNum = Collections.min(list2); System.out.println("최대값:" + maxNum); System.out.println("최소값:" + minNum); } }// 출력결과 예 // list에 저장된 모든 데이터 : [JAVA, SERVLET, JDBC, JSP, RMI] // 최대값:SERVLET // 최소값:JAVA // list의 데이터들을 오름차순으로 소팅한 결과 : [JAVA, JDBC, JSP, RMI, SERVLET] // "JDBC" 가 저장된 위치 : 1 // list의 데이터들을 섞은 결과 : 실행할 때마다 달라짐 // 최대값:20 // 최소값:5
코드 해설이 예제는
Collections메서드를 한 번에 보여주는 예제다.
그래서 코드를 읽을 때는 지금 어떤 메서드가 어떤 역할을 하는지를 끊어서 보는 것이 중요하다.
먼저 전체 흐름은 이렇게 잡으면 된다.
배열 데이터를 준비한다.
List를 만든다.
Collections.addAll()로 값을 한 번에 옮긴다.
max(),min()으로 가장 큰 값과 작은 값을 구한다.
sort()로 정렬한다.
binarySearch()로 위치를 찾는다.
shuffle()로 순서를 섞는다.
즉, 이 예제는
배열에 있던 데이터를List로 옮긴 뒤,Collections로 여러 방식으로 가공하는 흐름이라고 보면 된다.
여기서 먼저
Collections.addAll()은
여러 값을 리스트에 한 번에 넣을 때 쓰는 메서드다.
배열에 이미 값이 들어 있다면, 하나씩add()를 반복하지 않고 한 줄로 옮길 수 있다.
Collections.max()와Collections.min()은 이름 그대로
가장 큰 값과 가장 작은 값을 구하는 메서드다.
즉, 리스트 안에 들어 있는 값들 중에서 최대값, 최소값을 바로 뽑아내는 역할을 한다.
Collections.sort()는 리스트를 정렬하는 메서드다.
이 예제에서는 문자열 리스트를 오름차순으로 정렬하고 있다.
즉, 정렬 전에는["JAVA", "SERVLET", "JDBC", "JSP", "RMI"]처럼 들어 있던 값이,
정렬 후에는 사전순 기준으로 다시 배열된다.
여기서 특히 주의해서 봐야 하는 것은
binarySearch()다.
이 메서드는 그냥 아무 상태의 리스트에서 쓰는 검색 메서드가 아니다. 먼저 정렬된 리스트를 기준으로 위치를 찾는 메서드라고 이해해야 한다.
그래서 이 코드도
먼저Collections.sort(list)를 호출한 뒤,
그 다음에Collections.binarySearch(list, "JDBC")를 호출하고 있다.
즉, 복습할 때는 정렬 → 위치 찾기 순서로 같이 묶어 기억하는 것이 맞다.
Collections.shuffle()은 정렬과 반대 느낌으로 보면 쉽다.
sort()가 일정한 기준으로 순서를 정리하는 메서드라면,
shuffle()은 리스트 안의 값을 무작위로 섞는 메서드다.
그래서 출력 결과는 실행할 때마다 달라질 수 있다.
아래의
List<Integer>부분도 같이 봐야 한다.
이 부분은Collections메서드가 문자열 리스트에만 쓰이는 것이 아니라,
숫자 리스트에도 같은 방식으로 적용된다는 점을 보여준다.
즉, 이 예제는 메서드 기준으로 이렇게 정리하면 된다.
- 여러 값 한 번에 넣기 →
addAll()- 가장 큰 값 찾기 →
max()- 가장 작은 값 찾기 →
min()- 정렬하기 →
sort()- 정렬된 상태에서 위치 찾기 →
binarySearch()- 순서 섞기 →
shuffle()
헷갈리기 쉬운 부분
List와Collections는 다르다.List는 데이터를 담는 구조이고,Collections는 데이터를 다루는 도구 모음이다.Collections.addAll()은List를 만드는 메서드가 아니라, 이미 만든 리스트에 여러 값을 넣는 메서드다.max()와min()은 정렬을 하는 것이 아니라, 가장 큰 값과 가장 작은 값만 구하는 것이다.sort()는 정렬이고,shuffle()은 섞기다. 둘은 완전히 반대 역할이다.binarySearch()는 아무 리스트에서 바로 쓰는 것이 아니라, 정렬된 리스트 기준으로 이해해야 한다.
참고
Collections는 결국
컬렉션 안에 이미 들어 있는 데이터를 가공하는 도구 모음이다.
그래서 복습할 때는 메서드를 따로따로 외우기보다,
아래 흐름으로 묶어 두는 것이 훨씬 잘 들어온다.
- 한 번에 넣기 →
addAll()- 값 비교 →
max(),min()- 정렬 →
sort()- 위치 찾기 →
binarySearch()- 순서 섞기 →
shuffle()이 흐름만 잡혀도
Collections파트는 훨씬 덜 헷갈리게 된다.
10. 객체 정렬은 왜 따로 기준이 필요할까
문자열이나 숫자는 정렬 기준이 이미 정해져 있다.
예를 들어 문자열은 보통 사전순으로, 숫자는 크기순으로 비교할 수 있다.
그래서 리스트에 넣고 정렬을 시키면 자바가 어떤 기준으로 앞뒤를 나눠야 할지 이미 알고 있다.
하지만 직접 만든 객체는 다르다.
예를 들어Person객체 안에 이름과 나이가 함께 들어 있다면, 자바는 이 객체를 이름순으로 정렬해야 하는지, 나이순으로 정렬해야 하는지 스스로 알 수 없다.
즉, 객체를 정렬하려면 비교 기준을 따로 알려줘야 한다.
여기서 중요한 점은toString()은 객체를 화면에 어떻게 보여줄지를 정하는 메서드일 뿐이고, 정렬 기준을 정해 주는 메서드는 아니라는 것이다.
그래서 객체가 보기 좋게 출력된다고 해서, 바로 정렬까지 되는 것은 아니다.
10-1. 비교 기준이 없으면 왜 정렬이 안 될까직접 만든 객체는 자바가 어떤 기준으로 비교해야 하는지 알지 못한다.
그래서 리스트에 저장하고 출력하는 것은 가능해도, 바로sort()를 호출하는 것은 불가능할 수 있다.
이 구간에서는 왜 정렬이 안 되는지를 먼저 이해하는 것이 중요하다.
코드 보는 순서
- 먼저
Person1클래스에 정렬 기준이 있는지 본다.- 그다음 리스트에 객체를 저장하는 흐름을 본다.
- 이후
toString()덕분에 출력은 되는지 확인한다.- 마지막으로 왜
Collections.sort(list)를 바로 쓸 수 없는지 본다.예제:
ListSort1// exam01.java package day14; import java.util.Collections; import java.util.LinkedList; import java.util.List; import java.util.Random; class Person1 { public String name; public int age; public Person1(String name, int age) { this.name = name; this.age = age; } @Override public String toString() { return name + "(" + age + ")"; } } public class ListSort1 { public static void main(String[] args) { // Person1 객체를 저장할 리스트를 생성함 List<Person1> list = new LinkedList<>(); Random rand = new Random(); // 이름과 나이를 가진 Person1 객체를 여러 개 만들어 리스트에 저장함 for (int i = 1; i <= 5; i++) { String tempName = "duke" + i; int tempAge = rand.nextInt(30); Person1 p = new Person1(tempName, tempAge); list.add(p); } // toString() 덕분에 객체가 보기 쉬운 문자열 형태로 출력됨 System.out.println(list); // 비교 기준이 없어서 바로 정렬할 수는 없음 // Collections.sort(list); // reverse()는 정렬이 아니라 현재 순서를 거꾸로 뒤집는 기능임 Collections.reverse(list); System.out.println(list); } }// 출력결과 예 // [duke1(12), duke2(4), duke3(21), duke4(8), duke5(17)] // [duke5(17), duke4(8), duke3(21), duke2(4), duke1(12)] // 나이 값은 실행할 때마다 달라질 수 있음
코드 해설이 예제의 핵심은 객체는 그냥 리스트에 넣었다고 바로 정렬되지 않는다는 점이다.
Person1은 이름과 나이를 가진 객체이지만, 자바는 이 객체를 무엇을 기준으로 비교해야 할지 모른다.
이름순인지, 나이순인지, 혹은 다른 기준인지 알 수 없기 때문이다.
toString()덕분에 출력은 잘 된다.
그래서 리스트를 출력하면duke1(12)같은 형태로 보기 쉽게 나타난다.
하지만 이것은 출력 형식을 정한 것이지, 정렬 기준을 정한 것은 아니다.
즉, 문자열이나 숫자는 자바가 기본 비교 기준을 알고 있지만, 직접 만든 객체는 비교 기준이 없으면sort()를 바로 사용할 수 없다고 이해하면 된다.
또 여기서reverse()는 이름 때문에 내림차순 정렬처럼 보일 수 있다.
하지만 실제로는 정렬이 아니라 현재 들어 있는 순서를 그대로 거꾸로 뒤집는 기능이다.
즉,reverse()를 썼다고 해서 정렬 기준이 생기는 것은 아니다.
10-2. Comparable로 기본 정렬 기준 만들기객체를 정렬하려면 기준이 필요하다.
그 기준을 객체 안에 직접 넣는 방식이Comparable이다.
즉, 이 클래스의 기본 정렬 기준을 클래스 스스로 가지게 만드는 방식이라고 보면 된다.
코드 보는 순서
- 먼저
Person2 implements Comparable<Person2>선언을 본다.- 그다음
compareTo()가 어떤 기준으로 비교하는지 본다.- 이후
Collections.sort(list)가 왜 가능해지는지 본다.- 마지막으로
reverse()를 하면 왜 내림차순처럼 보이는지 확인한다.예제:
ListSort2// exam02.java package day14; import java.util.Collections; import java.util.LinkedList; import java.util.List; import java.util.Random; class Person2 implements Comparable<Person2> { public String name; public int age; public Person2(String name, int age) { this.name = name; this.age = age; } @Override public int compareTo(Person2 o) { // 나이를 기준으로 비교함 if (age < o.age) return -1; else if (age == o.age) return 0; else return 1; } @Override public String toString() { return name + "(" + age + ")"; } } public class ListSort2 { public static void main(String[] args) { // Person2 객체를 저장할 리스트를 생성함 List<Person2> list = new LinkedList<>(); Random rand = new Random(); // 객체를 여러 개 만들어 리스트에 저장함 for (int i = 1; i <= 5; i++) { String tempName = "duke" + i; int tempAge = rand.nextInt(30); Person2 p = new Person2(tempName, tempAge); list.add(p); } System.out.println(list); // compareTo() 기준에 따라 정렬함 Collections.sort(list); System.out.println(list); // 정렬된 결과를 reverse()로 뒤집어 내림차순처럼 보이게 함 Collections.reverse(list); System.out.println(list); } }// 출력결과 예 // [duke1(12), duke2(4), duke3(21), duke4(8), duke5(17)] // [duke2(4), duke4(8), duke1(12), duke5(17), duke3(21)] // [duke3(21), duke5(17), duke1(12), duke4(8), duke2(4)] // 나이 값은 실행할 때마다 달라질 수 있음
코드 해설
Comparable은 객체 스스로 자신의 기본 정렬 기준을 정하는 방식이다.
즉, “이 객체는 무엇을 기준으로 정렬될 것인지”를 클래스 안에 직접 정해 둔다고 보면 된다.
여기서는Person2가Comparable<Person2>를 구현하고 있고,compareTo()안에서age를 기준으로 비교하고 있다.
그래서Collections.sort(list)를 호출하면, 자바는compareTo()를 이용해서 각 객체의 순서를 정할 수 있게 된다.
compareTo()의 반환값도 같이 봐야 한다.
- 앞 객체가 더 작으면 → 음수
- 두 객체가 같으면 →
0- 앞 객체가 더 크면 → 양수
즉, 자바는 이 값을 보고 앞에 둘지 뒤에 둘지를 판단한다.
정리하면Comparable은 이 클래스의 기본 정렬 기준은 이것이다라고 객체 안에 미리 정해 두는 방식이다.
그래서 이 구간은 이렇게 기억하면 된다.- 기본 기준을 객체 안에 넣는다 →
Comparable- 그 기준을 실제로 적는 메서드 →
compareTo()- 그 결과
Collections.sort(list)가 가능해진다
10-3. Comparator로 외부에서 정렬 기준 주기정렬 기준을 항상 객체 안에 넣어야 하는 것은 아니다.
상황에 따라서는 객체 밖에서 비교 기준을 따로 만드는 방식이 더 자연스럽다.
이럴 때 사용하는 것이Comparator다.
코드 보는 순서
- 먼저
Person3클래스에는 정렬 기준이 없다는 점을 본다.- 그다음
Person3Comparator가 어떤 비교 기준을 만드는지 본다.- 이후
list.sort(new Person3Comparator())가 어떻게 동작하는지 본다.- 마지막으로
Comparable과 무엇이 다른지 정리한다.예제:
ListSort3// exam03.java package day14; import java.util.Comparator; import java.util.LinkedList; import java.util.List; import java.util.Random; class Person3 { public String name; public int age; public Person3(String name, int age) { this.name = name; this.age = age; } @Override public String toString() { return name + "(" + age + ")"; } } class Person3Comparator implements Comparator<Person3> { @Override public int compare(Person3 o1, Person3 o2) { // 외부에서 나이 기준 비교 규칙을 만듦 if (o1.age < o2.age) return -1; else if (o1.age > o2.age) return 1; else return 0; } } public class ListSort3 { public static void main(String[] args) { // Person3 객체를 저장할 리스트를 생성함 List<Person3> list = new LinkedList<>(); // 객체를 여러 개 만들어 리스트에 저장함 for (int i = 1; i <= 5; i++) { String tempName = "duke" + i; int tempAge = new Random().nextInt(30); list.add(new Person3(tempName, tempAge)); } System.out.println(list); // Comparator를 외부에서 전달해서 정렬함 list.sort(new Person3Comparator()); System.out.println(list); } }// 출력결과 예 // [duke1(12), duke2(4), duke3(21), duke4(8), duke5(17)] // [duke2(4), duke4(8), duke1(12), duke5(17), duke3(21)] // 나이 값은 실행할 때마다 달라질 수 있음
코드 해설
Comparator는 정렬 기준을 객체 밖에서 따로 만드는 방식이다.
즉, 원래 클래스 안에 기준을 넣지 않고, 외부에서 이번 정렬에 사용할 비교 규칙을 따로 만드는 것이다.
여기서는Person3클래스 자체에는 정렬 기준이 없다.
대신Person3Comparator라는 별도 클래스를 만들어서, 나이를 기준으로 비교하도록 했다.
그래서list.sort(new Person3Comparator())처럼 정렬할 때 비교 기준을 함께 넘겨주는 방식으로 순서를 정할 수 있다.
이 방식의 장점은 분명하다.
원본 클래스Person3를 수정하지 않고도 정렬 기준을 추가할 수 있다.
즉, 기존 클래스를 건드리지 않고도 이번에 필요한 기준으로 정렬할 수 있는 것이다.
정리하면 이 구간은 이렇게 기억하면 된다.
- 기준을 객체 밖에서 따로 만든다 →
Comparator- 실제 비교 규칙을 적는 메서드 →
compare()- 정렬할 때
sort()에 기준을 함께 넘긴다
10-4. Comparable과 Comparator 한 번에 정리여기까지 오면 두 방식의 차이를 한 번에 묶어서 봐야 한다.
이 구간의 핵심은 문법 모양보다 정렬 기준이 어디에 있느냐다.
정리하면 이렇게 구분하면 된다.
Comparable→ 객체 안에 기본 정렬 기준을 넣는 방식Comparator→ 객체 밖에서 정렬 기준을 따로 만드는 방식
즉, 클래스 자체의 기본 정렬 기준을 정하고 싶으면Comparable을 쓰고, 기존 클래스를 수정하지 않고 이번에만 다른 기준으로 정렬하고 싶으면Comparator를 쓰면 된다.
더 쉽게 말하면 이렇게 이해하면 된다.Comparable→ 원래 기준Comparator→ 바깥에서 추가한 기준
이 차이만 정확히 잡아도, 객체 정렬 파트는 훨씬 덜 헷갈리게 된다.
헷갈리기 쉬운 부분
toString()은 출력 형식을 정하는 메서드이지, 정렬 기준을 만드는 메서드는 아니다.reverse()는 정렬이 아니라 현재 순서를 그대로 뒤집는 기능이다.Comparable과Comparator는 둘 다 정렬 기준을 만들지만, 하나는 객체 안이고 하나는 객체 밖이다.compareTo()는Comparable에서 쓰고,compare()는Comparator에서 쓴다.- 객체를 정렬하려면 결국 비교 기준이 필요하다는 점이 가장 중요하다.
참고객체 정렬 파트는 메서드를 외우는 단원이라기보다, 정렬 기준을 어디에 둘 것인지 구분하는 단원이라고 보면 된다.
그래서 복습할 때는 아래 흐름으로 묶어 두는 것이 가장 잘 들어온다.
- 기준이 없으면 정렬이 안 됨
- 객체 안에 기준 넣기 →
Comparable- 객체 밖에 기준 만들기 →
Comparator
이 흐름만 잡혀도Comparable과Comparator는 훨씬 덜 헷갈리게 된다.
11. Stack과 Queue는 무엇이 다를까
Stack과Queue는 둘 다 값을 넣고 꺼내는 구조다.
겉으로 보기에는 비슷해 보이지만, 값을 꺼내는 순서가 완전히 다르다는 점이 핵심이다.
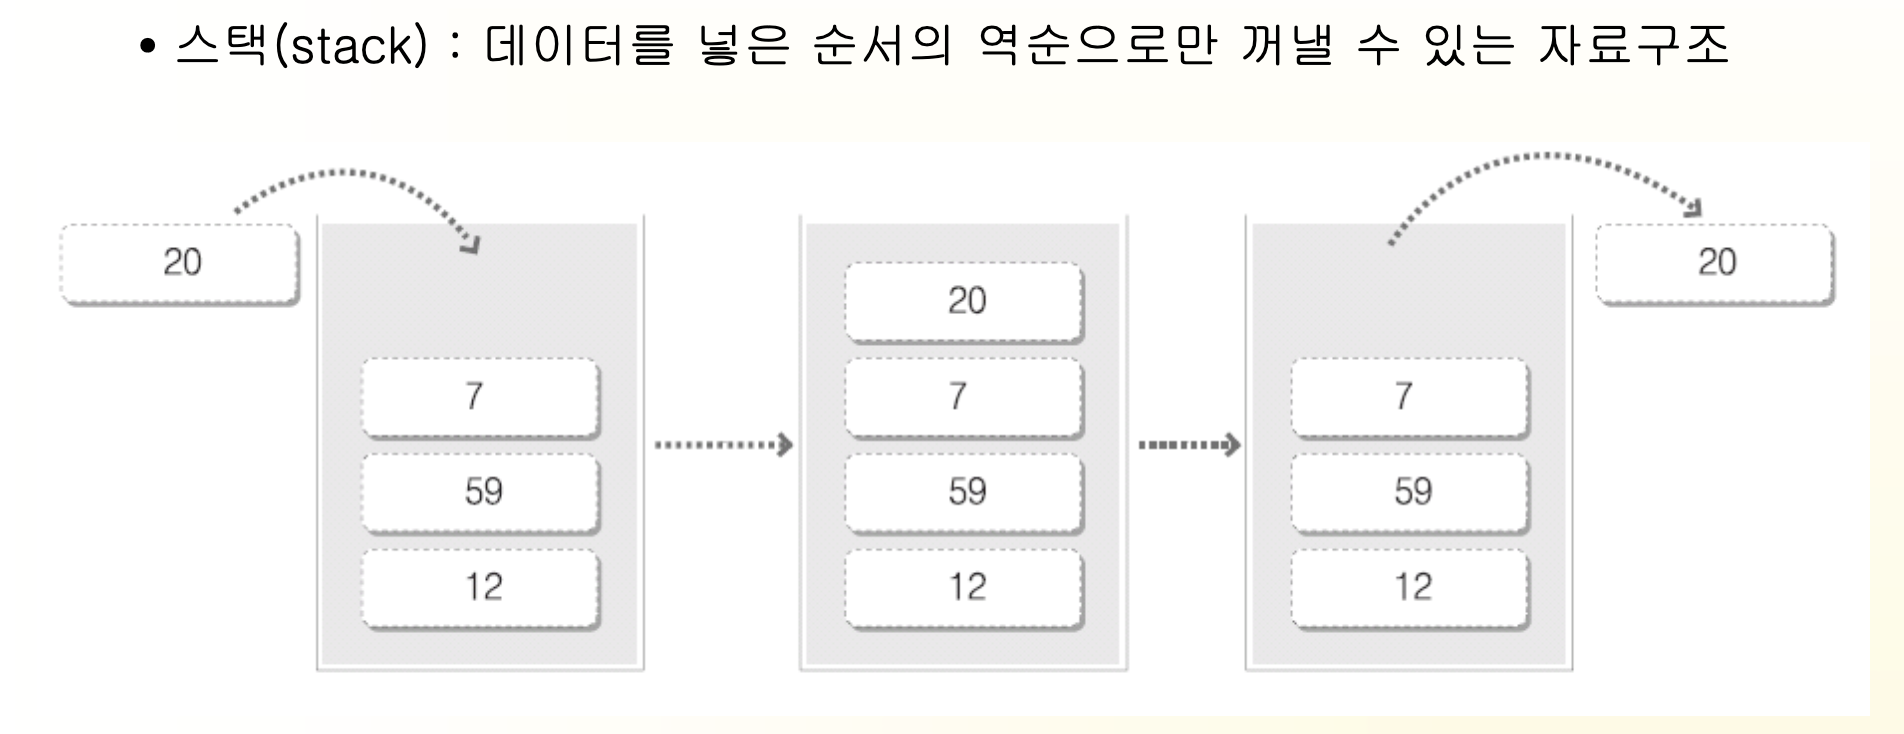
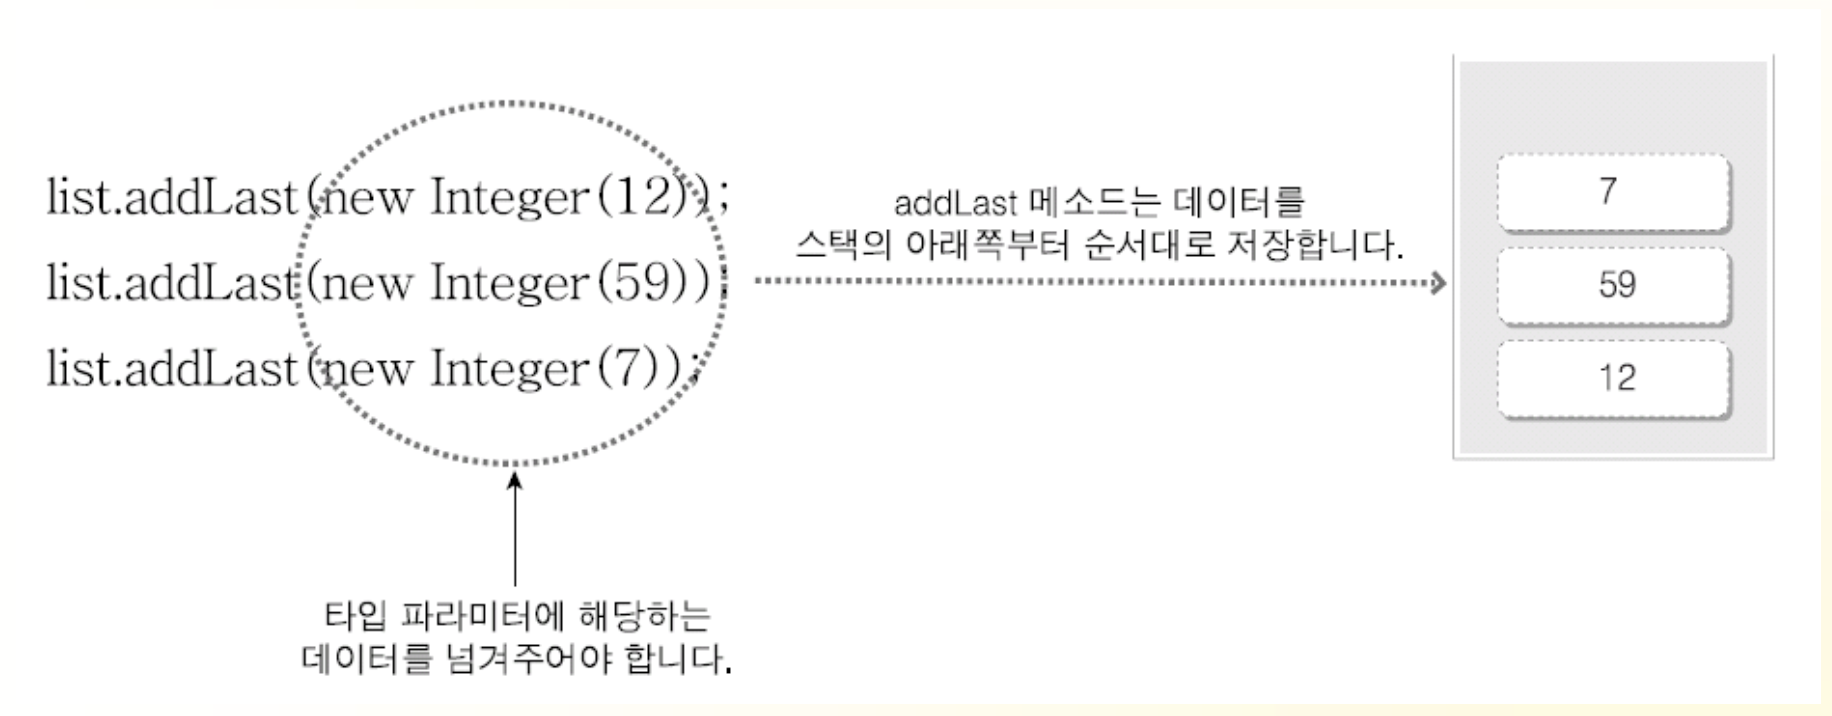
Stack은 나중에 넣은 값을 먼저 꺼내는 구조다.
즉, 마지막에 들어간 값이 가장 먼저 나온다.
이런 방식을LIFO(Last In First Out)라고 한다.
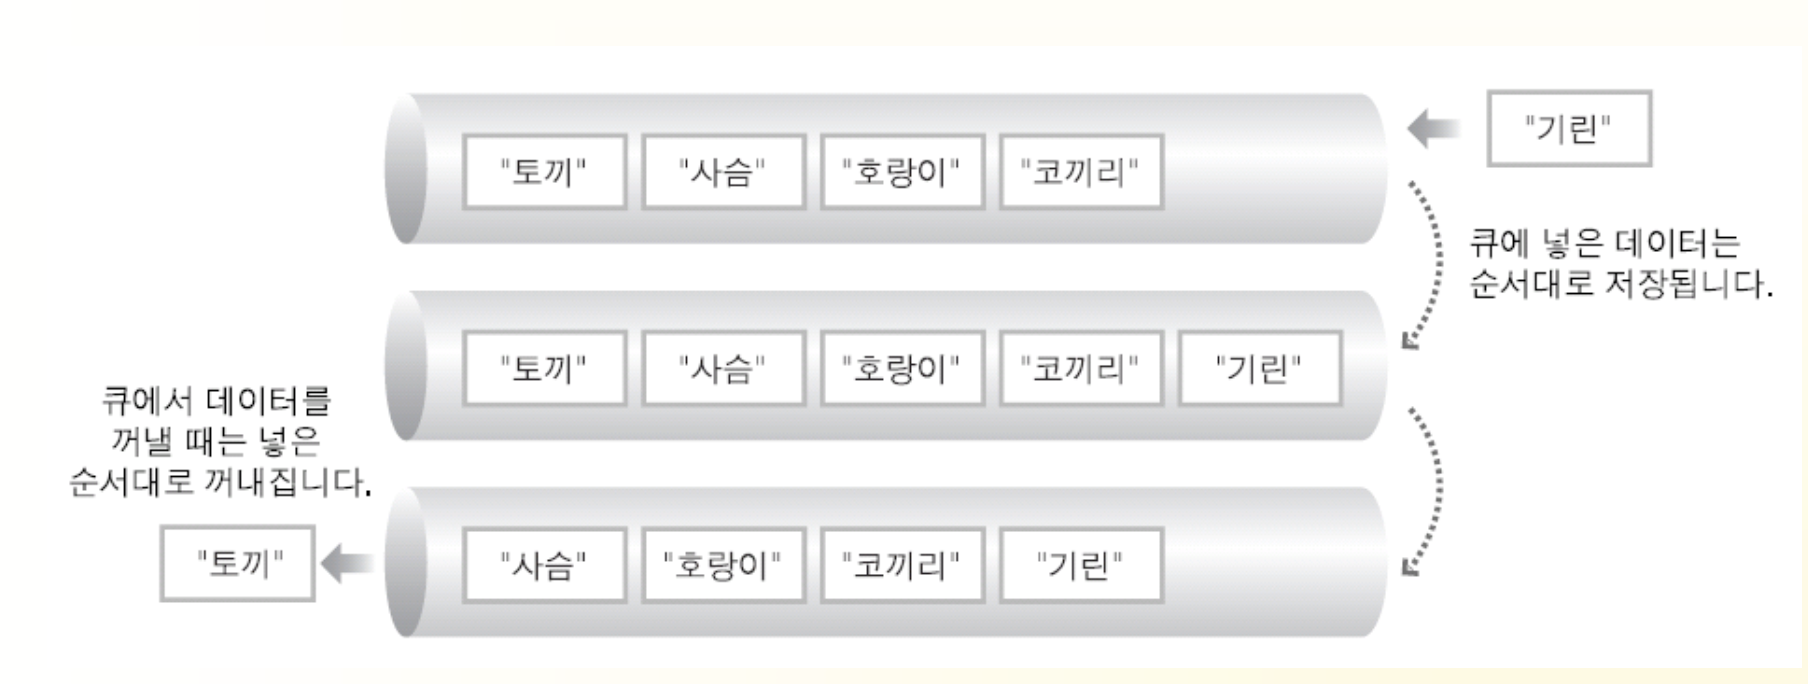
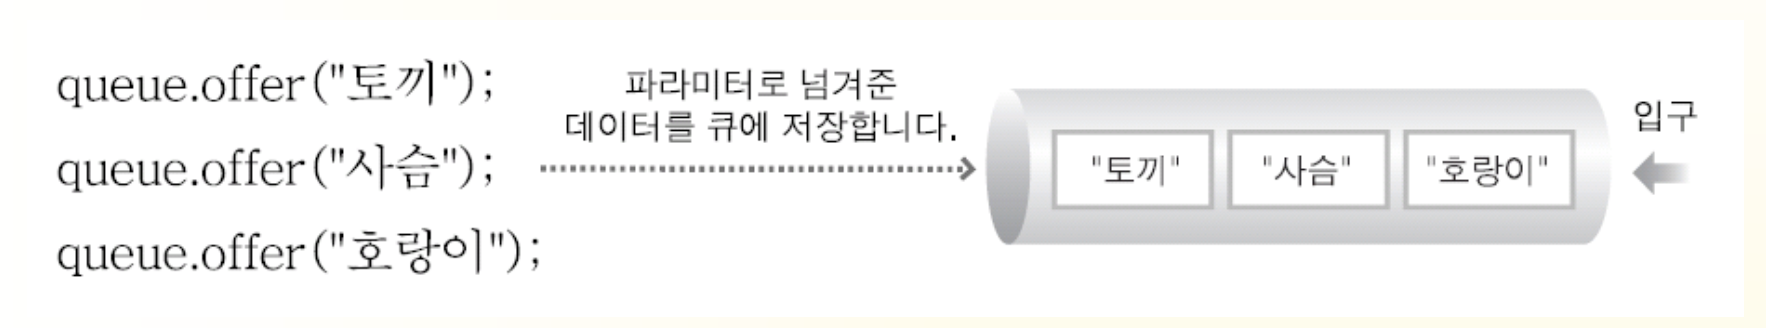
반면Queue는 먼저 넣은 값을 먼저 꺼내는 구조다.
즉, 먼저 들어간 값이 가장 먼저 나온다.
이런 방식을FIFO(First In First Out)라고 한다.
여기서 중요한 점은, 같은LinkedList라도 어떤 메서드를 쓰느냐에 따라Stack처럼도,Queue처럼도 사용할 수 있다는 것이다.
즉, 구조 자체는 하나여도 값을 넣고 꺼내는 방식에 따라 전혀 다른 자료구조처럼 동작하게 된다.
먼저 메서드부터 한눈에 보기
addLast(값): 맨 뒤에 값을 넣는다.getLast(): 맨 뒤 값을 확인만 한다.removeLast(): 맨 뒤 값을 실제로 꺼낸다.offer(값): 큐의 맨 뒤에 값을 넣는다.peek(): 큐의 맨 앞 값을 확인만 한다.poll(): 큐의 맨 앞 값을 실제로 꺼낸다.
즉, 이 파트는 메서드를 이렇게 나눠서 보면 훨씬 쉽다.Stack에서 많이 보는 메서드 →addLast(),getLast(),removeLast()Queue에서 많이 보는 메서드 →offer(),peek(),poll()
그리고 이 흐름을 먼저 잡아 두면 된다.- 마지막 값 중심 →
Stack- 첫 번째 값 중심 →
Queue
11-1. Stack - 나중에 넣은 값이 먼저 나온다
Stack은 마지막에 넣은 값을 먼저 꺼내는 구조다.
그래서 항상 맨 뒤에 들어간 값을 기준으로 생각하면 된다.
즉, 최근에 넣은 값부터 처리하는 흐름이라고 보면 된다.
코드 보는 순서
- 먼저
LinkedList<Integer>를 생성하는 부분을 본다.- 그다음
addLast()로 값을 넣는 흐름을 본다.- 이후
getLast()로 마지막 값을 먼저 확인하는 부분을 본다.- 마지막으로
removeLast()로 마지막 값을 꺼내는 흐름을 본다.예제:
StackExample1// exam01.java import java.util.LinkedList; class StackExample1 { public static void main(String args[]) { // Integer 값을 저장할 LinkedList를 생성함 LinkedList<Integer> stack = new LinkedList<Integer>(); // addLast()로 값을 뒤에 차례대로 넣음 stack.addLast(10); stack.addLast(20); stack.addLast(30); // getLast()로 마지막에 들어간 값을 먼저 확인함 System.out.println("마지막 값 확인 : " + stack.getLast()); // removeLast()로 마지막 값을 실제로 꺼냄 System.out.println("꺼낸 값 : " + stack.removeLast()); // removeLast()를 다시 호출하면 그다음 마지막 값이 꺼내짐 System.out.println("다음으로 꺼낸 값 : " + stack.removeLast()); } }// 출력결과 // 마지막 값 확인 : 30 // 꺼낸 값 : 30 // 다음으로 꺼낸 값 : 20
1 2
코드 해설이 예제는
Stack을 가장 단순한 흐름으로 보여준다.
여기서는 맨 뒤 값만 계속 보면 된다.
먼저 메서드 역할을 짧게 정리하면 이렇다.
addLast(): 값을 맨 뒤에 넣는다.getLast(): 맨 뒤 값을 확인만 한다.removeLast(): 맨 뒤 값을 실제로 꺼낸다.
addLast()로10,20,30을 차례대로 넣으면, 가장 마지막에는30이 놓인다.
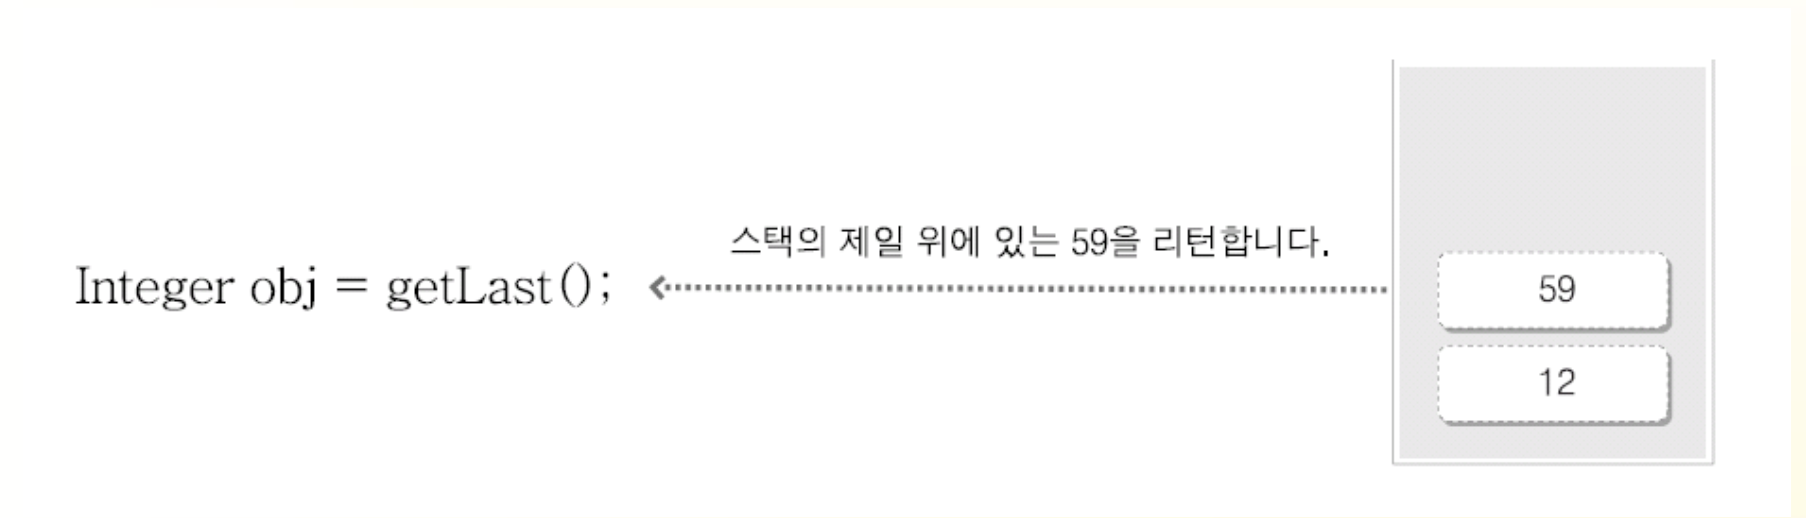
그래서getLast()를 호출하면 가장 최근에 들어간 값인30이 보인다.
그다음removeLast()를 호출하면 마지막 값인30이 실제로 꺼내진다.
그리고 한 번 더removeLast()를 호출하면, 그다음 마지막 값인20이 꺼내진다.
즉, 이 예제는Stack이 마지막에 넣은 값을 먼저 확인하고, 먼저 꺼내는 구조라는 점을 보여준다.
이것이 바로LIFO다.
그래서 이 구간은 이렇게 기억하면 된다.- 넣기 →
addLast()- 마지막 값 보기 →
getLast()- 마지막 값 꺼내기 →
removeLast()- 최근에 넣은 값부터 처리 →
Stack
11-2. Queue - 먼저 넣은 값이 먼저 나온다
Queue는 먼저 넣은 값을 먼저 꺼내는 구조다.
그래서 항상 맨 앞에 있는 값을 기준으로 생각하면 된다.
즉, 먼저 들어온 것부터 차례대로 처리하는 흐름이라고 보면 된다.
코드 보는 순서
- 먼저
Queue<String>를 생성하는 부분을 본다.- 그다음
offer()로 값을 넣는 흐름을 본다.- 이후
peek()로 가장 앞 값을 먼저 확인하는 흐름을 본다.- 마지막으로
poll()로 가장 앞 값을 꺼내는 흐름을 본다.예제:
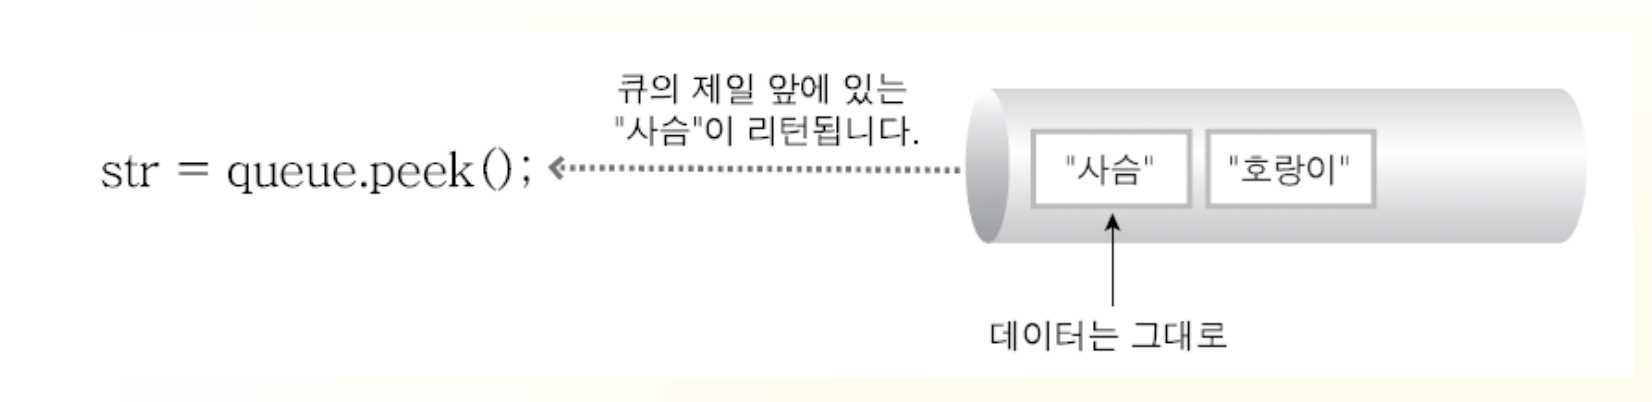
QueueExample1// exam02.java import java.util.LinkedList; import java.util.Queue; class QueueExample1 { public static void main(String args[]) { // Queue로 사용할 LinkedList를 생성함 Queue<String> queue = new LinkedList<String>(); // offer()로 값을 차례대로 넣음 queue.offer("토끼"); queue.offer("사슴"); queue.offer("호랑이"); // peek()로 가장 앞의 값을 먼저 확인함 System.out.println("맨 앞 값 확인 : " + queue.peek()); // poll()로 가장 앞의 값을 꺼냄 System.out.println("꺼낸 값 : " + queue.poll()); // 다시 peek()를 하면 그다음 값이 맨 앞에 보임 System.out.println("다음 맨 앞 값 확인 : " + queue.peek()); } }// 출력결과 // 맨 앞 값 확인 : 토끼 // 꺼낸 값 : 토끼 // 다음 맨 앞 값 확인 : 사슴
1 2
코드 해설이 예제는
Queue의 흐름을 가장 단순하게 보여준다.
여기서는 맨 앞 값만 계속 보면 된다.
먼저 메서드 역할을 짧게 정리하면 이렇다.
offer(): 값을 맨 뒤에 넣는다.peek(): 맨 앞 값을 확인만 한다.poll(): 맨 앞 값을 실제로 꺼낸다.
offer()로토끼,사슴,호랑이를 차례대로 넣으면, 가장 먼저 들어간 값은토끼다.
그래서peek()를 호출하면 가장 앞에 있는토끼가 먼저 보인다.
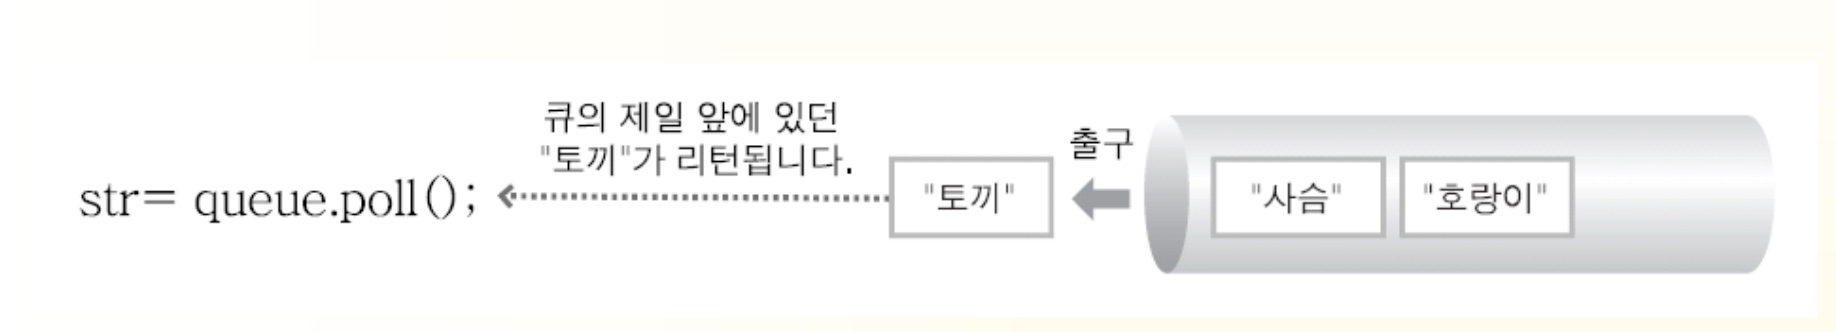
그다음poll()을 호출하면, 맨 앞에 있던토끼가 실제로 꺼내진다.
그리고 다시peek()를 하면, 이제 그다음 값인사슴이 맨 앞에 보이게 된다.
즉, 이 예제는Queue가 먼저 넣은 값을 먼저 확인하고, 먼저 꺼내는 구조라는 점을 보여준다.
이것이 바로FIFO다.
그래서 이 구간은 이렇게 기억하면 된다.- 넣기 →
offer()- 맨 앞 값 보기 →
peek()- 맨 앞 값 꺼내기 →
poll()- 먼저 들어온 값부터 처리 →
Queue
헷갈리기 쉬운 부분
Stack과Queue는 둘 다 값을 넣고 꺼내는 구조이지만, 꺼내는 기준 위치가 다르다.Stack은 맨 뒤 값을 기준으로 보고,Queue는 맨 앞 값을 기준으로 본다.getLast()와peek()는 둘 다 값을 먼저 확인하는 느낌이 있지만, 보는 위치가 다르다.removeLast()와poll()도 둘 다 값을 꺼내는 메서드지만, 하나는 맨 뒤 값을 꺼내고 하나는 맨 앞 값을 꺼낸다.- 결국
Stack은 최근 값 중심,Queue는 처음 값 중심으로 이해하면 가장 덜 헷갈린다.
참고이 단계에서는
Stack과Queue의 내부 구현을 깊게 따지기보다, 꺼내는 순서가 어떻게 다른지를 정확히 구분하는 것이 더 중요하다.
그래서 복습할 때는 아래 흐름으로 묶어 두는 것이 가장 잘 들어온다.
Stack→LIFO→ 마지막 값 중심Queue→FIFO→ 첫 번째 값 중심
이 감각만 확실히 잡혀도Stack과Queue는 훨씬 덜 헷갈리게 된다.
12. HashMap과 HashSet
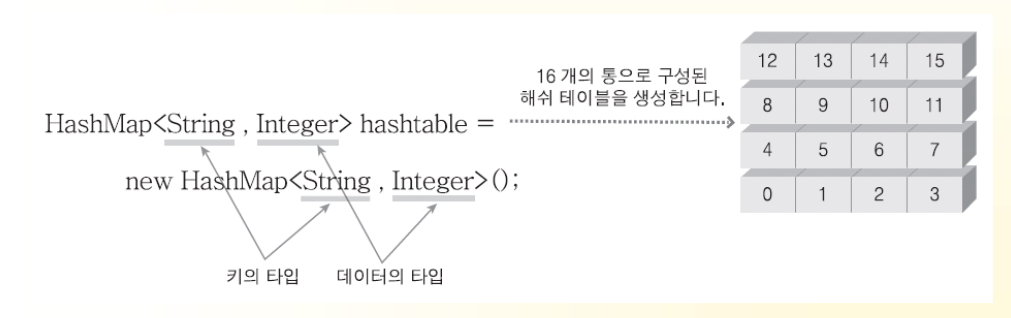
HashMap과HashSet은 둘 다List와는 다른 방식으로 데이터를 다루는 컬렉션이다.
List가 순서대로 값을 저장하고 인덱스로 접근하는 구조였다면,HashMap은key로 값을 찾는 구조,HashSet은 중복 없는 값만 저장하는 구조라고 이해하면 된다.
즉, 이 파트에서 중요한 것은 단순히 새로운 클래스 이름을 외우는 것이 아니다.
앞에서List가 “몇 번째 값”을 다루는 구조였다면, 여기서는 값을 어떻게 찾고, 중복을 어떻게 막는지가 핵심이다.
먼저 메서드부터 한눈에 보기
put(key, value):HashMap에key-value를 저장한다.get(key):key에 해당하는 값을 꺼낸다.add(값):HashSet에 값을 저장한다.size(): 저장된 데이터 개수를 구한다.iterator(): 값을 순서대로 꺼내기 위한 반복 도구를 만든다.hasNext(): 다음 값이 남아 있는지 확인한다.next(): 다음 값을 하나 꺼낸다.
즉, 이 파트는 이렇게 나눠서 보면 쉽다.HashMap에서 먼저 봐야 하는 메서드 →put(),get()HashSet에서 먼저 봐야 하는 메서드 →add(),size()- 둘 다 반복해서 볼 때 연결되는 메서드 →
iterator(),hasNext(),next()
그리고 흐름은 이렇게 잡으면 된다.- 기준값으로 찾는다 →
HashMap- 중복 없이 모은다 →
HashSet
12-1. HashMap - key로 값을 찾는 구조
HashMap은 값을 그냥 차례대로 넣는 구조가 아니다.
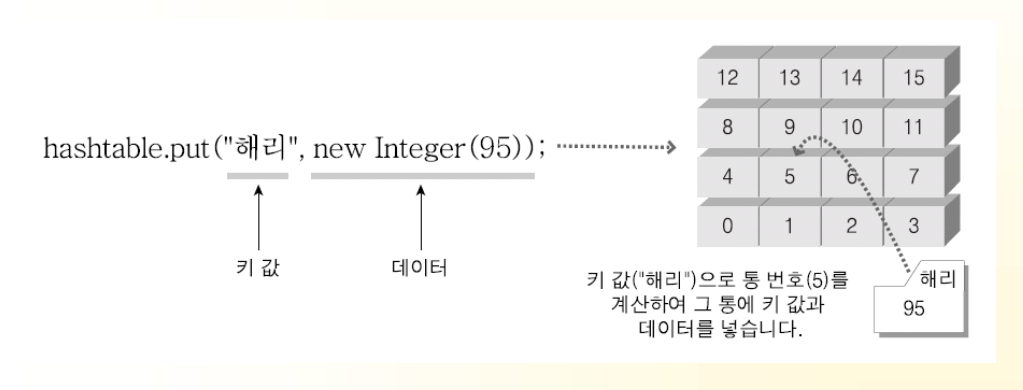
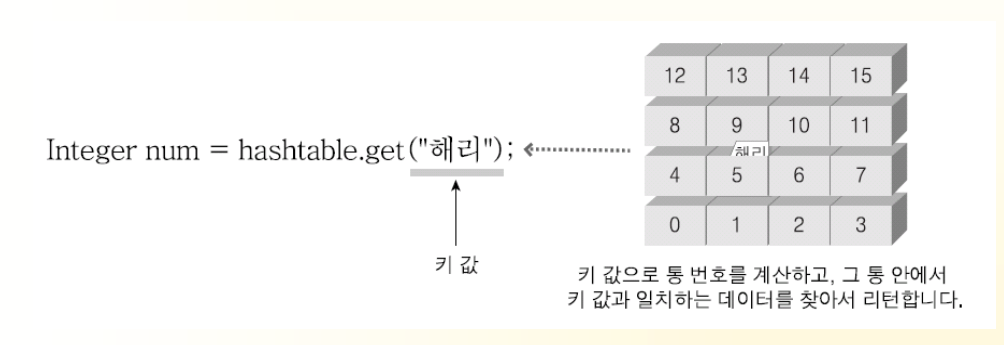
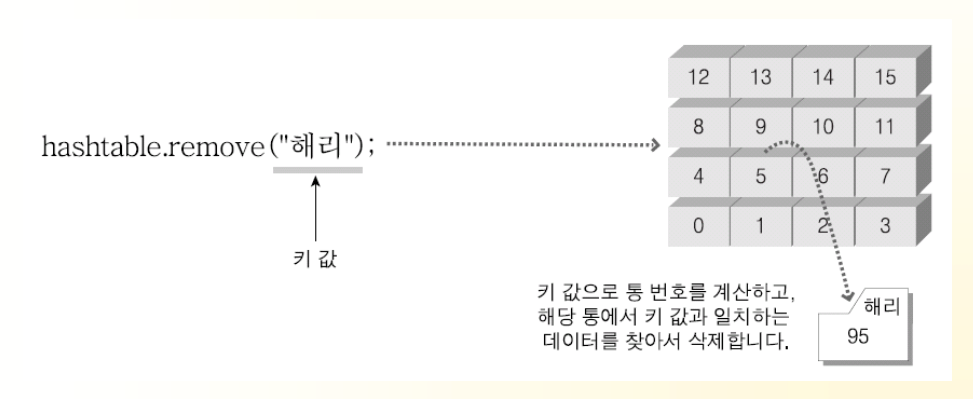
key와value를 한 쌍으로 저장하고,key를 기준으로 값을 찾는 구조다.
즉, 몇 번째 값인지보다 어떤 이름표로 찾을 것인지가 중요하다.
코드 보는 순서
- 먼저
HashMap<String, Integer>선언을 본다.- 그다음
put()으로key-value를 저장하는 흐름을 본다.- 같은
key를 다시 넣으면 어떻게 되는지 본다.- 마지막으로
get()으로 값을 꺼내는 흐름을 본다.예제:
HashMapExample1// exam01.java import java.util.HashMap; public class HashMapExample1 { public static void main(String args[]) { // 이름(String)을 key로, 점수(Integer)를 value로 저장하는 HashMap을 생성함 HashMap<String, Integer> map = new HashMap<String, Integer>(); // put()으로 key-value를 저장함 System.out.println(map.put("해리", Integer.valueOf(95))); System.out.println(map.put("헤르미온느", 100)); // 다른 key들도 계속 저장함 map.put("론", 85); map.put("드레이코", 93); map.put("네빌", 70); // 같은 key를 다시 넣으면 기존 값이 교체되고, 예전 값이 반환됨 System.out.println(map.put("헤르미온느", 55)); // 현재 map 전체 데이터를 확인함 System.out.println(map); // get()으로 key에 해당하는 값을 찾음 Integer num = map.get("헤르미온느"); System.out.println("헤르미온느의 성적은? " + num); // 다시 전체 데이터를 출력해 최종 상태를 확인함 System.out.println(map); } }// 출력결과 예 // null // null // 100 // {해리=95, 론=85, 드레이코=93, 헤르미온느=55, 네빌=70} // 헤르미온느의 성적은? 55 // {해리=95, 론=85, 드레이코=93, 헤르미온느=55, 네빌=70}
1 2 3 4
코드 해설이 예제에서 가장 먼저 봐야 하는 것은
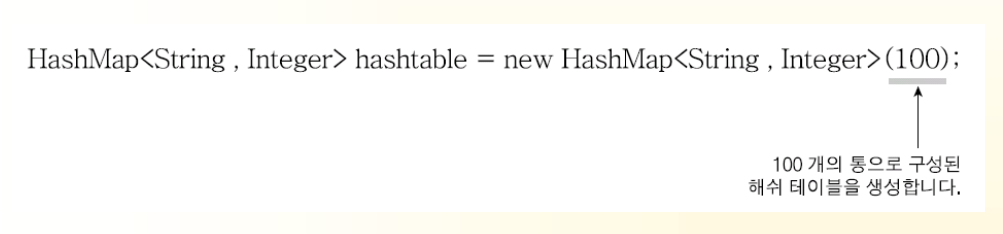
HashMap<String, Integer>다.
이 구조는 문자열key와 정수value를 짝으로 저장한다.
즉,HashMap은 리스트처럼 몇 번째 값을 찾는 구조가 아니라, 어떤key에 어떤 값이 연결되어 있는지를 다루는 구조다.
먼저 메서드 역할을 짧게 정리하면 이렇다.
put(key, value):key-value를 저장한다.get(key):key에 연결된 값을 꺼낸다.
put()은 데이터를 저장하는 메서드다.
그런데 이 메서드는 저장만 하는 것이 아니라, 이미 같은key가 있을 때는 예전 값을 반환한다.
그래서 처음"해리","헤르미온느"를 넣을 때는 기존 값이 없으므로null이 나온다.
하지만"헤르미온느"를 다시 넣으면 이야기가 달라진다.
이 경우는 새로운 항목이 하나 더 추가되는 것이 아니라, 기존"헤르미온느"의 값100이55로 바뀐다.
그래서 이때put()의 반환값으로는 예전 값인100이 나온다.
즉,HashMap은 같은key를 두 번 저장하면 항목이 늘어나는 구조가 아니라, 값이 교체되는 구조다.
그리고get("헤르미온느")를 하면,"헤르미온느"라는key에 연결된 값인55를 바로 찾을 수 있다.
이것이HashMap의 가장 큰 특징이다.
HashMap은 넣은 순서를 기준으로 보는 구조가 아니므로,System.out.println(map)를 했을 때 출력 순서가 입력 순서와 같다고 기대하면 안 된다.
또get()은 찾는key가 없으면null을 반환한다.
즉,HashMap은key를 기준으로 값을 찾고 관리하는 구조라고 이해하면 된다.
그래서 이 구간은 이렇게 기억하면 된다.- 저장 →
put()- 같은
key다시 저장 → 기존 값 교체- 값 찾기 →
get()- 몇 번째 값이 아니라
key로 찾는다 →HashMap
12-2. HashSet - 중복을 허용하지 않는 구조
HashSet은 값만 저장하는 구조다.
하지만 같은 값을 여러 번 넣으려고 해도 하나만 남는다.
즉,HashSet은 중복 없는 값 모음이라고 이해하면 된다.
코드 보는 순서
- 먼저
HashSet<String>선언을 본다.- 그다음
add()를 여러 번 호출하는 흐름을 본다.- 같은 값을 다시 넣었을 때 결과가 어떻게 달라지는지 본다.
size()로 실제 저장 개수를 확인한다.- 마지막으로 향상된
for,Iterator, 전체 출력으로 저장 상태를 확인한다.예제:
SetExample1// exam02.java import java.util.HashSet; import java.util.Iterator; public class SetExample1 { public static void main(String args[]) { // 문자열을 저장할 HashSet을 생성함 HashSet<String> set = new HashSet<String>(); // add()로 값을 저장함 System.out.println(set.add("자바")); System.out.println(set.add("카푸치노")); System.out.println(set.add("에스프레소")); // 같은 값을 다시 넣으면 저장되지 않음 System.out.println(set.add("자바")); // 실제 저장된 데이터의 개수를 확인함 System.out.println("저장된 데이터의 수 = " + set.size()); // 향상된 for문으로 전체 데이터를 출력함 for (String s : set) System.out.println(s); // Iterator로도 전체 데이터를 출력할 수 있음 Iterator<String> iterator = set.iterator(); while (iterator.hasNext()) { String str = iterator.next(); System.out.println(str); } // 마지막으로 set 전체를 출력함 System.out.println(set); } }// 출력결과 예 // true // true // true // false // 저장된 데이터의 수 = 3 // 자바 // 카푸치노 // 에스프레소 // 자바 // 카푸치노 // 에스프레소 // [자바, 카푸치노, 에스프레소]
1 2 3 4
코드 해설
HashSet은 중복 없는 값 모음이라고 이해하면 된다.
즉, 같은 값을 여러 번 넣으려고 해도 하나만 저장된다.
먼저 메서드 역할을 짧게 정리하면 이렇다.
add(값): 값을 저장한다.size(): 실제 저장된 개수를 구한다.iterator(): 반복 도구를 만든다.hasNext(): 다음 값이 남아 있는지 확인한다.next(): 다음 값을 하나 꺼낸다.
이 예제에서"자바","카푸치노","에스프레소"를 처음 넣을 때는 모두 저장되므로add()결과가true가 나온다.
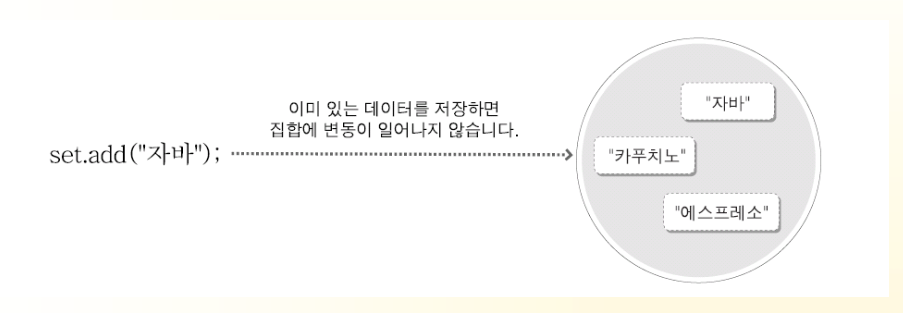
하지만"자바"를 한 번 더 넣으려고 하면 이미 같은 값이 들어 있으므로 저장되지 않고false가 나온다.
즉,HashSet에서add()는 단순히 값을 넣는 역할만 하는 것이 아니라, 실제로 저장이 되었는지 아닌지까지 알려주는 메서드라고 볼 수 있다.
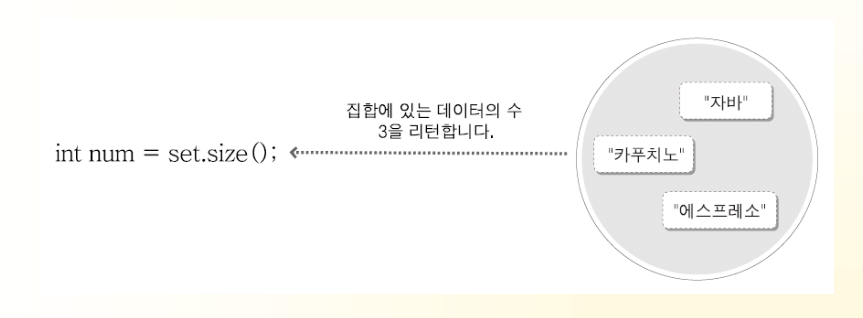
그리고size()를 보면 저장된 데이터의 수가3인 것을 확인할 수 있다.
"자바"를 두 번 넣으려고 했지만, 중복은 허용되지 않기 때문에 실제 개수는 늘어나지 않은 것이다.
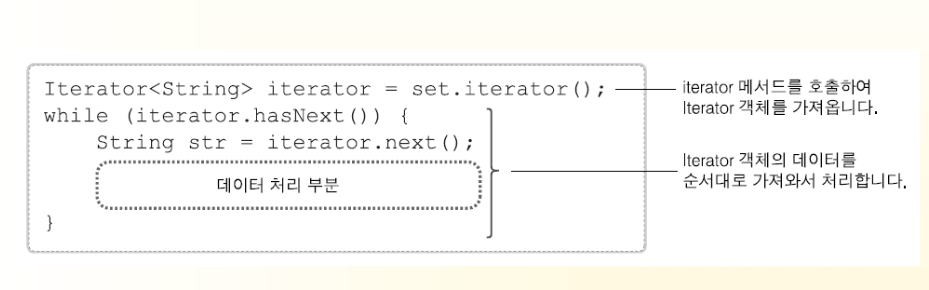
또 이 예제는 단순히 중복 제거만 보여주는 것이 아니라, 향상된for문,Iterator, 마지막 전체 출력으로도 값을 확인할 수 있다는 점을 함께 보여준다.
다만HashSet도 저장 순서를 유지하는 구조는 아니므로, 출력 순서가 넣은 순서와 항상 같다고 기대하면 안 된다.
즉,HashSet은 중복 없는 값의 모음이라고 이해하면 된다.
그래서 이 구간은 이렇게 기억하면 된다.- 저장 →
add()- 같은 값 다시 저장 → 저장되지 않음
- 개수 확인 →
size()- 반복해서 보기 →
iterator(),hasNext(),next()- 중복 없이 모은다 →
HashSet
헷갈리기 쉬운 부분
HashMap은 값 자체만 모으는 구조가 아니라,key-value를 짝으로 저장하는 구조다.HashMap은 같은key를 다시 넣으면 항목이 하나 더 늘어나는 것이 아니라, 기존 값이 교체된다.HashSet은 같은 값을 다시 넣어도 저장되지 않는다.HashMap과HashSet모두 넣은 순서를 그대로 유지하는 구조로 보면 안 된다.HashMap은key로 값을 찾고,HashSet은 중복 없는 값 자체를 관리하는 구조라고 구분해야 한다.
참고코드에는 바로 나오지 않았지만, 같이 알아두면 좋은 메서드도 있다.
HashMap에서 자주 같이 보는 메서드는 이렇다.
containsKey(key): 해당key가 있는지 확인한다.containsValue(value): 해당 값이 있는지 확인한다.remove(key): 해당key의 항목을 삭제한다.keySet():key들만 따로 본다.values(): 값들만 따로 본다.entrySet():key와value를 한 쌍씩 함께 본다.
HashSet에서 자주 같이 보는 메서드는 이렇다.contains(값): 해당 값이 들어 있는지 확인한다.remove(값): 해당 값을 삭제한다.isEmpty(): 비어 있는지 확인한다.clear(): 전체 데이터를 비운다.
즉, 복습할 때는 이렇게 묶어 두면 된다.HashMap→put(),get(),containsKey(),keySet(),entrySet()HashSet→add(),contains(),remove(),size()
이 흐름만 잡혀도HashMap과HashSet은 훨씬 덜 헷갈리게 된다.
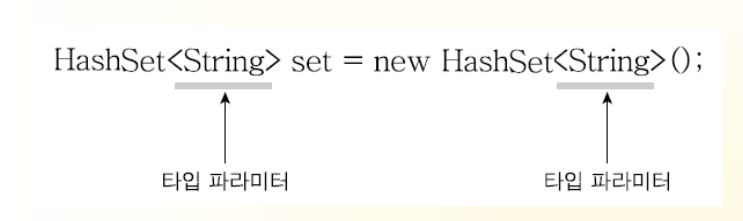
13. TreeSet - 트리 구조로 정렬되는 Set
HashSet은 중복을 막는 데 집중한 구조였다.
반면TreeSet은 중복도 막고, 저장된 값을 정렬된 상태로 유지하는 구조다.
즉,TreeSet은 중복 없는 값 모음 + 정렬 유지를 함께 처리하는Set이라고 이해하면 된다.
HashSet은 값을 넣고 나면 출력 순서가 일정하지 않을 수 있었지만,TreeSet은 값을 넣는 순간부터 정렬 기준에 따라 자리를 잡는다.
그래서 나중에 따로sort()를 하지 않아도, 꺼내 보면 이미 정렬된 상태로 보인다.
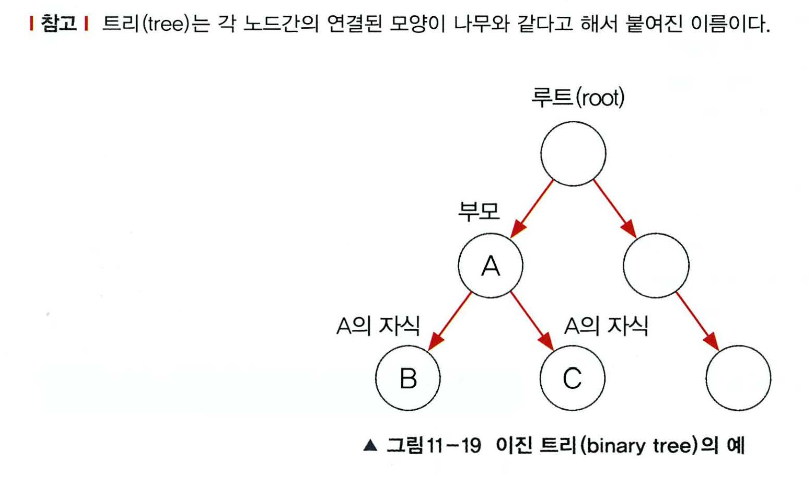
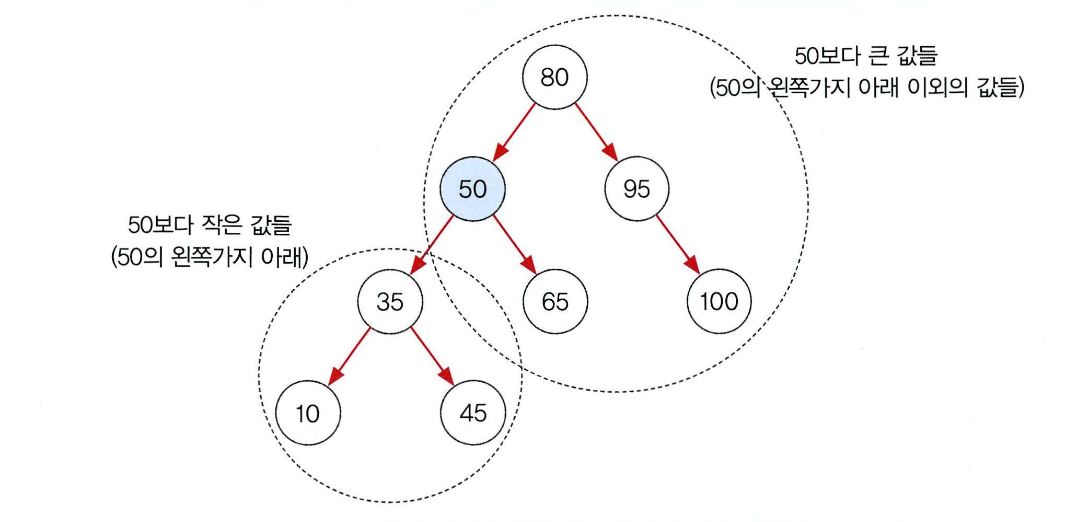
이 구조를 이해하려면 먼저 트리(tree) 를 떠올리면 된다.
트리는 값이 한 줄로 나열되는 것이 아니라, 가지처럼 연결되어 내려가는 구조다.
TreeSet은 이런 트리 구조를 이용해서 값을 관리한다.
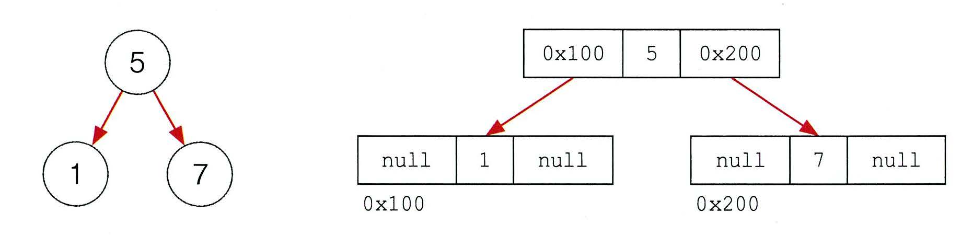
예를 들어 이런 구조를 보면class TreeNode { TreeNode left; // 왼쪽 자식노드 Object element; // 값을 저장하는 변수 TreeNode right; // 오른쪽 자식노드 }이 코드는
TreeSet의 전체 구현을 보여주는 것이 아니라, 트리 노드가왼쪽 / 값 / 오른쪽으로 연결된다는 감각을 이해하기 위한 예시다.
즉,TreeSet은 값을 그냥 순서 없이 담아 두는 것이 아니라, 이런 식으로 왼쪽 / 값 / 오른쪽 흐름을 가지는 트리 모양으로 저장한다고 이해하면 된다.
여기서 같이 알아두면 좋은 개념이 이진 탐색 트리 감각이다.
TreeSet은 이진 탐색 알고리즘 그 자체라기보다, 작은 값은 왼쪽, 큰 값은 오른쪽으로 나뉘는 트리 구조 감각으로 이해하는 것이 맞다.
즉, 중요한 것은 비교하면서 왼쪽과 오른쪽으로 나뉘는 구조를 사용한다는 점이다.
또 이런 구조가 가능하려면 당연히 비교 기준이 있어야 한다.
숫자나 문자열처럼 원래 비교 기준이 있는 값은 바로 저장할 수 있지만, 직접 만든 객체를 넣으려면 앞에서 본Comparable이나Comparator와 연결해서 봐야 한다.
먼저 메서드부터 한눈에 보기
add(값): 값을 저장한다.headSet(기준값): 기준값보다 작은 값들을 본다.tailSet(기준값): 기준값 이상인 값들을 본다.size(): 저장된 데이터 개수를 구한다.contains(값): 해당 값이 들어 있는지 확인한다.
즉,TreeSet은 이렇게 보면 쉽다.- 저장하면서 정렬되는 구조 →
add()- 기준값보다 작은 쪽 보기 →
headSet()- 기준값보다 크거나 같은 쪽 보기 →
tailSet()
그리고 흐름은 이렇게 잡으면 된다.- 중복 없이 저장 + 자동 정렬 →
TreeSet- 기준값으로 범위를 나눠 보기 →
headSet(),tailSet()
13-1. TreeSet은 왜 저장하면서 정렬될까
TreeSet은 값을 다 넣고 나서 마지막에 정렬하는 구조가 아니다.
값을 저장하는 순간부터 비교하면서 자리를 잡기 때문에, 꺼내 보면 이미 정렬된 상태가 된다.
이 구간에서는 왜 넣는 순서와 출력 순서가 다른지를 이해하는 것이 중요하다.
코드 보는 순서
- 먼저
TreeSet<Integer>를 생성하는 부분을 본다.- 그다음
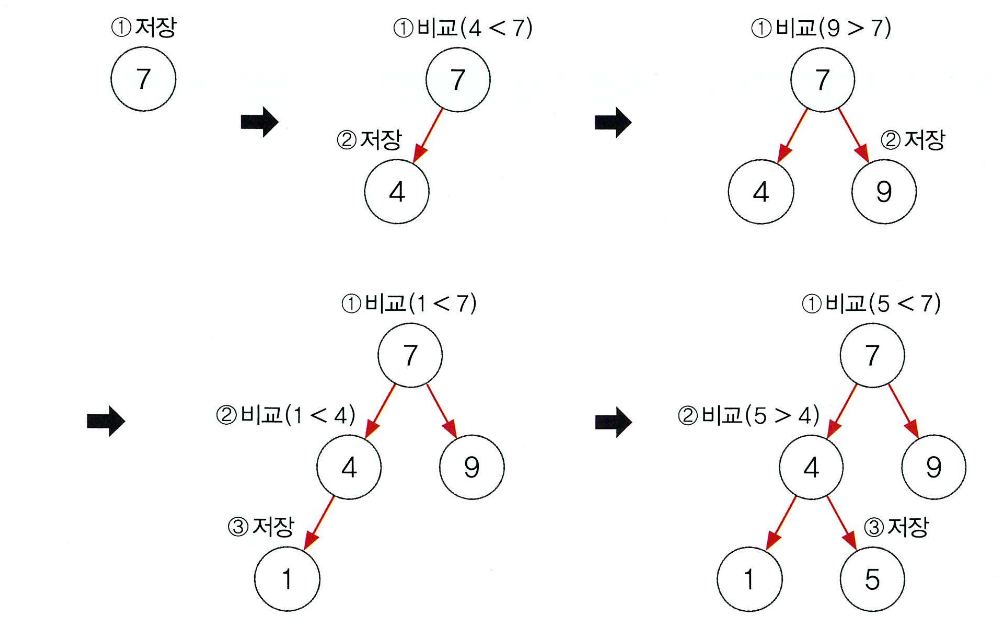
7,4,9,1,5를 차례대로 저장하는 흐름을 본다.- 저장할 때마다 작은 값은 왼쪽, 큰 값은 오른쪽으로 비교되는 흐름을 떠올린다.
- 마지막으로 그냥 출력했을 때 이미 정렬된 결과가 나오는지 확인한다.
예제:
TreeSetExample1// exam01.java import java.util.TreeSet; public class TreeSetExample1 { public static void main(String[] args) { // 정수를 저장할 TreeSet을 생성함 TreeSet<Integer> set = new TreeSet<Integer>(); // 값을 차례대로 저장함 set.add(7); set.add(4); set.add(9); set.add(1); set.add(5); // 전체 데이터를 출력하면 이미 정렬된 상태로 보임 System.out.println(set); } }// 출력결과 // [1, 4, 5, 7, 9]
코드 해설이 예제에서 가장 중요한 것은 넣은 순서와 출력 순서가 다르다는 점이다.
코드에서는7,4,9,1,5순서로 값을 넣었다.
하지만 출력하면[1, 4, 5, 7, 9]처럼 오름차순으로 정렬된 결과가 나온다.
그 이유는TreeSet이 값을 저장할 때마다 단순히 맨 뒤에 붙이는 것이 아니라, 기존 값과 비교해서 작으면 왼쪽, 크면 오른쪽으로 자리를 잡아 가기 때문이다.
예를 들면 흐름은 이렇게 된다.
7을 먼저 저장한다.4는7보다 작으므로 왼쪽으로 간다.9는7보다 크므로 오른쪽으로 간다.1은7보다 작고, 다시4보다도 작으므로 더 왼쪽으로 간다.5는7보다 작지만4보다 크므로4의 오른쪽으로 간다.
즉,TreeSet은 값을 다 넣고 나서 나중에 정렬하는 구조가 아니라, 저장하는 순간부터 정렬이 유지되는 구조라고 이해하면 된다.
그래서 이 구간은 이렇게 기억하면 된다.- 저장 →
add()- 저장하면서 비교 → 작은 값은 왼쪽, 큰 값은 오른쪽
- 결과 → 꺼내 보면 이미 정렬되어 있음
- 중복 제거 + 자동 정렬 →
TreeSet
13-2. TreeSet은 범위로도 값을 나눠 볼 수 있다
TreeSet은 정렬된 상태를 유지하기 때문에, 기준값을 중심으로 앞부분과 뒷부분을 나눠서 보는 것도 자연스럽다.
이 구간에서는 정렬 구조이기 때문에 범위 검색도 가능하다는 점을 보면 된다.
코드 보는 순서
- 먼저
TreeSet<Integer>에 점수를 저장하는 흐름을 본다.- 그다음
headSet(50)으로50보다 작은 값들을 확인한다.- 이후
tailSet(50)으로50이상인 값들을 확인한다.- 마지막으로
TreeSet이 정렬 구조라서 이런 범위 검색이 자연스럽게 가능하다는 점을 본다.예제:
TreeSetExample2// exam02.java import java.util.TreeSet; public class TreeSetExample2 { public static void main(String[] args) { // 정수를 저장할 TreeSet을 생성함 TreeSet<Integer> set = new TreeSet<Integer>(); // 점수를 저장함 set.add(80); set.add(50); set.add(95); set.add(35); set.add(65); set.add(10); set.add(45); set.add(100); // 50보다 작은 값들을 확인함 System.out.println("50보다 작은 값 : " + set.headSet(50)); // 50 이상인 값들을 확인함 System.out.println("50 이상인 값 : " + set.tailSet(50)); } }// 출력결과 // 50보다 작은 값 : [10, 35, 45] // 50 이상인 값 : [50, 65, 80, 95, 100]
코드 해설
TreeSet은 정렬된 상태를 유지하기 때문에, 기준값을 중심으로 앞부분과 뒷부분을 나눠서 보는 것도 자연스럽다.
여기서 먼저 메서드 역할을 보면 이렇다.
headSet(50):50보다 작은 값들을 보여준다.tailSet(50):50이상인 값들을 보여준다.
headSet(50)은50보다 작은 값들을 보여준다.
그래서[10, 35, 45]가 나온다.
tailSet(50)은50이상인 값들을 보여준다.
그래서[50, 65, 80, 95, 100]이 나온다.
즉,TreeSet은 단순히 정렬만 되는 구조가 아니라, 기준값을 중심으로 범위를 나눠서 볼 수 있는 구조라는 점도 중요하다.
이런 점 때문에TreeSet은 정렬된 결과가 항상 필요하거나, 특정 값보다 작은 값과 큰 값을 나눠서 보고 싶을 때 특히 잘 맞는다.
그래서 이 구간은 이렇게 기억하면 된다.- 기준값보다 작은 값 보기 →
headSet()- 기준값 이상인 값 보기 →
tailSet()- 정렬 구조라서 범위 검색도 자연스럽다 →
TreeSet
헷갈리기 쉬운 부분
TreeSet도Set이기 때문에 중복은 허용하지 않는다.- 하지만
HashSet과 달리 저장하면 바로 정렬된다.TreeSet은 이진 탐색 그 자체는 아니지만, 작은 값은 왼쪽, 큰 값은 오른쪽으로 나뉘는 트리 구조 감각으로 이해하면 쉽다.headSet(50)은50보다 작은 값들이고,tailSet(50)은50이상인 값들이라는 점을 꼭 구분해야 한다.- 직접 만든 객체를 넣을 때는 정렬 기준이 필요하므로
Comparable이나Comparator가 필요할 수 있다.
참고
TreeSet에서 코드에는 바로 나오지 않았지만, 같이 알아두면 좋은 메서드도 있다.
first(): 가장 작은 값을 가져온다.last(): 가장 큰 값을 가져온다.lower(값): 해당 값보다 작은 값 중에서 가장 가까운 값을 찾는다.higher(값): 해당 값보다 큰 값 중에서 가장 가까운 값을 찾는다.subSet(시작값, 끝값): 범위를 지정해서 그 사이 값들을 본다.
즉, 복습할 때는 이렇게 묶어 두면 된다.- 저장하면서 정렬 →
add()- 앞쪽 범위 보기 →
headSet()- 뒤쪽 범위 보기 →
tailSet()- 양쪽 끝 값 보기 →
first(),last()- 특정 값 근처 찾기 →
lower(),higher()
이 흐름만 잡혀도TreeSet은 훨씬 덜 헷갈리게 된다.
14. 한 번에 비교하기
앞에서
List,Set,Map,Stack,Queue,Comparable,Comparator,Collections까지 하나씩 따로 봤다면, 이제는 각각을 언제 어떤 감각으로 구분해야 하는지 한 번에 정리할 차례다.
이 파트의 목적은 새로운 개념을 더 배우는 것이 아니다.
지금까지 나온 구조들을 다시 한 번 묶어서, “순서가 중요한가?”, “중복을 막아야 하는가?”, “정렬이 필요한가?”, “값을 어떻게 꺼내는가?”, “무엇으로 값을 찾는가?” 이 기준으로 빠르게 구분하는 데 있다.
즉, 여기서는 각 구조의 문법을 다시 외우는 것보다 어떤 상황에서 어떤 구조를 떠올려야 하는지를 정리하는 것이 더 중요하다.
먼저 기준부터 한눈에 보기
- 순서 있는 데이터를 저장한다 →
List- 중복 없는 값만 저장한다 →
Setkey-value를 짝으로 저장한다 →Map- 마지막에 넣은 값을 먼저 꺼낸다 →
Stack- 먼저 넣은 값을 먼저 꺼낸다 →
Queue- 객체 안에 기본 정렬 기준을 넣는다 →
Comparable- 객체 밖에서 정렬 기준을 따로 만든다 →
Comparator- 컬렉션 안의 데이터를 가공한다 →
Collections
즉, 마지막 정리는 저장 방식, 꺼내는 순서, 정렬 기준, 데이터 처리 도구를 구분하는 정리라고 보면 된다.
14-1. ArrayList vs LinkedList
- 둘 다
List이므로 순서가 있는 데이터를 저장한다.- 둘 다
add(),get(),remove()같은 기본 메서드를 사용할 수 있다.- 차이는 내부 구조다.
ArrayList는 배열처럼 값을 관리하는 구조로 이해하면 된다.LinkedList는 데이터가 앞뒤로 연결된 구조로 이해하면 된다.
즉, 둘 다 겉으로는 비슷한 리스트지만, 안에서 값을 관리하는 방식이 다르다.
복습할 때는 이렇게 구분하면 된다.- 인덱스로 다루는 가장 기본적인 리스트 감각 →
ArrayList- 연결 구조로 이어지는 리스트 감각 →
LinkedList
더 쉽게 말하면,- 보통 가장 먼저 떠올리는 기본 리스트 →
ArrayList- 연결 구조 차이를 함께 이해해야 하는 리스트 →
LinkedList
14-2. Stack vs Queue
- 둘 다 값을 넣고 꺼내는 구조다.
- 하지만 꺼내는 순서가 정반대다.
Stack은 마지막에 넣은 값을 먼저 꺼낸다.Queue는 먼저 넣은 값을 먼저 꺼낸다.
즉, 이 구간은 아래 두 줄로 정리하면 된다.Stack→LIFOQueue→FIFO
더 쉽게 말하면,- 최근에 넣은 값부터 처리해야 하면 →
Stack- 먼저 들어온 것부터 순서대로 처리해야 하면 →
Queue
그래서 복습할 때는 마지막 값 중심이면Stack, 첫 번째 값 중심이면Queue라고 잡으면 된다.
14-3. HashSet vs TreeSet
- 둘 다
Set이므로 중복을 허용하지 않는다.HashSet은 중복 제거에 집중한 구조다.TreeSet은 중복 제거에 더해 자동 정렬까지 유지하는 구조다.
즉, 이렇게 구분하면 된다.- 정렬은 필요 없고, 중복만 막으면 된다 →
HashSet- 중복도 막고, 항상 정렬된 상태도 필요하다 →
TreeSet
여기서TreeSet은 작은 값은 왼쪽, 큰 값은 오른쪽으로 나뉘는 트리 구조 감각으로 이해하면 쉽다.
그래서headSet(),tailSet()처럼 기준값을 중심으로 범위를 나누는 기능도 자연스럽게 연결된다.
즉, 복습할 때는 중복 제거만이면HashSet, 중복 제거 + 정렬이면TreeSet으로 구분하면 된다.
14-4. HashMap vs HashSet
HashMap은key-value를 짝으로 저장한다.HashSet은 값 자체만 저장한다.HashMap은key를 이용해서 값을 찾는다.HashSet은 값의 중복 여부를 관리하는 데 더 가깝다.
즉, 이렇게 구분하면 된다.- 어떤 이름이나 번호 같은 기준으로 값을 바로 찾고 싶다 →
HashMap- 값이 중복되면 안 된다 →
HashSet
예를 들면"헤르미온느" → 55처럼 연결해서 저장한다 →HashMap"자바","JDBC","서블릿"처럼 값만 모으고 중복만 막는다 →HashSet
즉,key로 찾는 구조면HashMap, 값만 저장하면서 중복을 막는 구조면HashSet이라고 보면 된다.
14-5. Comparable vs Comparator
- 둘 다 정렬 기준을 만드는 역할과 관련 있다.
Comparable은 객체 안에 기본 정렬 기준을 넣는 방식이다.Comparator는 객체 밖에서 정렬 기준을 따로 만드는 방식이다.
즉, 이렇게 구분하면 된다.- 이 클래스의 기본 정렬 기준을 미리 정해 두고 싶다 →
Comparable- 기존 클래스를 수정하지 않고, 이번에만 다른 기준으로 정렬하고 싶다 →
Comparator
더 쉽게 말하면,Comparable→ 원래 기준Comparator→ 바깥에서 추가한 기준
즉, 기준이 객체 안에 있으면Comparable, 기준이 객체 밖에 있으면Comparator라고 정리하면 된다.
14-6. Collections는 어디에 끼는가
Collections는List,Set,Map처럼 데이터를 저장하는 구조가 아니다.
이미 만들어진 컬렉션 안의 데이터를 정렬하거나, 섞거나, 최대값·최소값을 구하고, 탐색하는 도구 모음이다.
즉, 이렇게 구분하면 된다.
- 데이터를 담는 구조 →
ArrayList,LinkedList,HashSet,TreeSet,HashMap- 담겨 있는 데이터를 다루는 도구 →
Collections
예를 들면Collections.sort()→ 정렬Collections.shuffle()→ 섞기Collections.max()/min()→ 최대값, 최소값 찾기
즉,Collections는 저장하는 쪽이 아니라, 이미 저장된 데이터를 가공하는 쪽이라고 보면 된다.
성능과 사용 감각까지 같이 보기단순히 구조만 외우는 것보다, 정렬이 필요한지, 중복 제거가 중요한지, 인덱스로 자주 꺼낼지,
key로 바로 찾을지를 함께 생각하면 훨씬 구분이 잘 된다.
실제로는 모든 구조를 똑같이 쓰는 것이 아니라, 상황에 따라 더 자주 먼저 떠올리는 구조가 있다.
- 일반적인 리스트 사용 →
ArrayList- 중복 제거만 필요함 →
HashSet- 중복 제거 + 정렬 필요함 →
TreeSetkey-value로 바로 찾기 →HashMap- 상황마다 다른 정렬 기준 필요함 →
Comparator
즉, 마지막 복습은 이렇게 정리하면 된다.- 기본 리스트 →
ArrayList- 연결 구조 리스트 →
LinkedList- 최근 것부터 꺼냄 →
Stack- 먼저 온 것부터 꺼냄 →
Queue- 중복 제거만 →
HashSet- 중복 제거 + 정렬 →
TreeSetkey로 값 찾기 →HashMap- 기본 정렬 기준 →
Comparable- 외부 정렬 기준 →
Comparator- 컬렉션 데이터 가공 도구 →
Collections
헷갈리기 쉬운 부분
ArrayList와LinkedList는 둘 다List라서 비슷해 보이지만, 내부 구조가 다르다.Stack과Queue는 둘 다 넣고 꺼내는 구조지만, 꺼내는 순서가 완전히 반대다.HashSet과TreeSet은 둘 다 중복을 막지만,TreeSet은 정렬까지 유지한다.HashMap은 값 자체를 저장하는 구조처럼 보일 수 있지만, 실제로는key로 값을 찾는 구조다.Comparable과Comparator는 둘 다 정렬 기준을 만들지만, 하나는 객체 안이고 하나는 객체 밖이다.Collections는 컬렉션 클래스 이름과 비슷해서 헷갈리기 쉽지만, 저장 구조가 아니라 도구 모음이다.
참고이 단계에서는 각 클래스의 모든 메서드를 다시 외우는 것보다, 어떤 상황에서 어떤 구조를 떠올려야 하는지를 정리하는 것이 더 중요하다.
그래서 마지막 정리는 이렇게 묶어 두면 된다.
- 순서 있는 데이터 →
List- 중복 없는 값 →
Setkey-value연결 →Map- 최근 것부터 꺼냄 →
Stack- 먼저 온 것부터 꺼냄 →
Queue- 기본 정렬 기준 →
Comparable- 외부 정렬 기준 →
Comparator- 데이터 가공 도구 →
Collections
이 감각만 정리되어 있으면, 컬렉션 프레임워크 전체 흐름이 훨씬 덜 헷갈리게 된다.