1. JPA를 배우기 전에 전체 흐름 먼저 잡기
JPA는Java객체와 데이터베이스 테이블을 연결해서 다루는 기술이다.
Java에서는 데이터를 객체로 다루고, 데이터베이스에서는 데이터를 테이블과 행으로 저장한다.
두 구조는 데이터를 표현하는 방식이 다르다.
그래서 객체와 테이블 사이를 맞춰 주는 과정이 필요하다.
JPA는 이 과정을 도와서 개발자가 객체를 저장하고 조회하듯이 데이터베이스 작업을 할 수 있게 만든다.
하지만JPA가SQL을 없애는 것은 아니다.
개발자는 객체 중심으로 코드를 작성하고,JPA구현체는 매핑 정보를 바탕으로 필요한SQL을 만들어 데이터베이스와 통신한다.
JPA를 처음 배울 때 가장 중요한 흐름은 객체 → 매핑 정보 →SQL실행 → 데이터베이스 반영이다.
이 흐름을 잡아야 뒤에서 나오는Entity,EntityManager, 영속성 컨텍스트,JPQL, 연관관계 매핑이 따로 떨어진 개념처럼 보이지 않는다.
1-1. JPA는 객체와 테이블을 연결해서 다룬다
JPA에서 가장 먼저 잡아야 할 핵심은 매핑이다.
매핑은 서로 다른 두 대상을 연결하는 작업이다.
여기서는Java객체와 데이터베이스 테이블을 연결한다는 뜻이다.
예를 들어 회원 정보를 다룬다고 생각해 보자.
Java에서는 회원 한 명을Member객체로 만들 수 있다.
데이터베이스에서는 회원 한 명을member테이블의 한 행으로 저장할 수 있다.
JPA는 이 객체와 테이블 사이의 연결을 관리한다.
먼저 일반Java클래스만 보면 아래와 같다.// MemberPlain.java public class MemberPlain { private Long id; // 회원을 구분하는 값 private String name; // 회원 이름 public MemberPlain(Long id, String name) { // 객체 생성 시 값 저장 this.id = id; this.name = name; } }이 코드는 회원 정보를 담는 일반
Java클래스이다.
객체를 만들 수는 있지만, 아직JPA가 이 클래스를 데이터베이스 테이블과 연결할 대상으로 알지는 못한다.
즉, 데이터만 담을 수 있을 뿐이고, 데이터베이스의 어떤 테이블과 연결되는지는 알 수 없는 상태이다.
JPA가 관리할 수 있는 클래스로 만들려면 클래스에@Entity를 붙인다.
그리고 어떤 필드가 기본키인지 알려 주기 위해@Id를 붙인다.
기본키는 테이블에서 각 행을 구분하는 값이다.// MemberEntity.java import jakarta.persistence.Entity; import jakarta.persistence.Id; @Entity // JPA가 관리할 Entity 클래스라는 표시 public class MemberEntity { @Id // 기본키로 사용할 필드 private Long id; private String name; // 테이블 컬럼과 연결될 필드 protected MemberEntity() { // JPA가 사용할 기본 생성자 } public MemberEntity(Long id, String name) { // 객체 생성 시 값 저장 this.id = id; this.name = name; } }
@Entity는 이 클래스가JPA의 관리 대상이라는 표시이다.
@Id는 이 필드가 테이블의 기본키와 연결된다는 표시이다.
이 두 표시가 있어야JPA가 이 클래스를 데이터베이스 테이블과 연결할 수 있는 대상으로 인식한다.
일반 객체와Entity객체는 겉으로 보기에는 비슷해 보일 수 있다.
둘 다 필드를 가진Java클래스이기 때문이다.
하지만 일반 객체는JPA가 관리하지 않는다.
반면Entity객체는JPA가 테이블과 연결해서 저장, 조회, 수정, 삭제 흐름 안에서 관리할 수 있다.
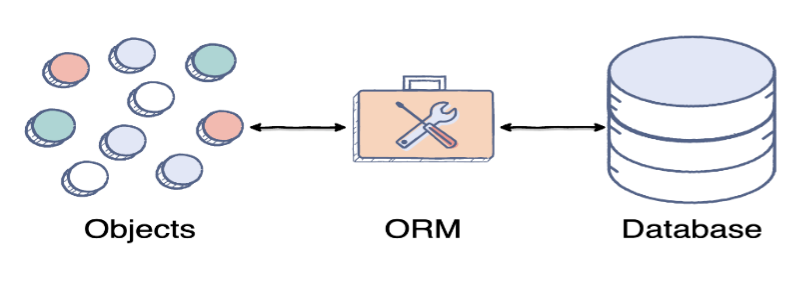
ORM은 객체와 데이터베이스 사이에서 서로 다른 구조를 연결해 주는 방식이다.
애플리케이션은 객체를 사용하고, 데이터베이스는 테이블을 사용한다.
ORM은 객체의 정보가 테이블의 데이터와 이어질 수 있도록 중간에서 맞춰 주는 역할을 한다.
이 흐름을JPA관점으로 보면 개발자는 객체를 다룬다.
그리고JPA는 객체와 테이블의 매핑 정보를 확인한다.
그 결과 필요한SQL이 만들어지고 데이터베이스 작업으로 이어진다.
JPA의 핵심은 객체를 데이터베이스 테이블과 연결하고, 객체 상태를 기준으로 데이터베이스 작업을 이어 가는 것이다.
1-2. ORM, JPA, Hibernate의 관계
ORM은Object Relational Mapping의 줄임말이다.
뜻을 풀면 객체와 관계형 데이터베이스를 매핑한다는 의미이다.
여기서 객체는Java의 객체를 말한다.
관계형 데이터베이스는MySQL처럼 데이터를 테이블로 저장하는 데이터베이스를 말한다.
ORM은 특정 프로그램 이름이 아니다.
객체와 테이블을 연결해서 다루는 방식 자체를 의미한다.
JPA는Java에서ORM을 사용하기 위한 표준 규칙이다.
표준 규칙은 “이런 기능은 이런 방식으로 사용하자”라고 정해 둔 약속이다.
하지만 표준 규칙만 있으면 실제 코드는 동작하지 않는다.
규칙을 실제로 실행해 주는 구현체가 필요하다.
구현체는 정해진 표준을 실제 코드로 동작하게 만든 프로그램이다.
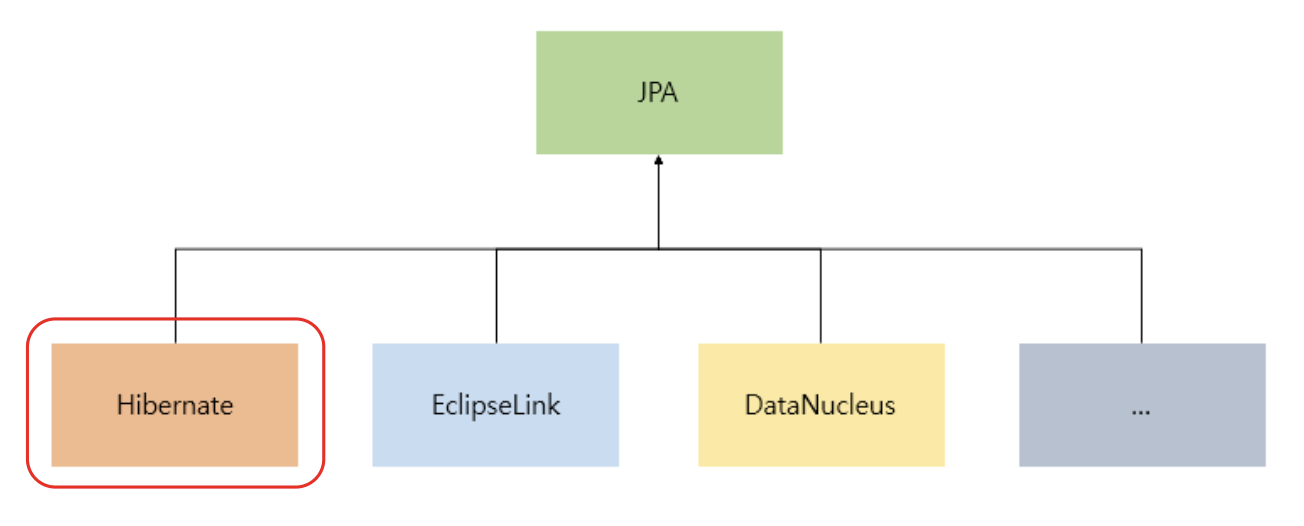
이번 실습에서 사용하는 대표 구현체가Hibernate이다.
JPA는 객체와 데이터베이스를 매핑하기 위한 표준 규칙이다.
Hibernate,EclipseLink,DataNucleus같은 구현체는 그 표준을 실제로 동작하게 만든다.
따라서 개발자는JPA문법으로 코드를 작성하지만, 실제 실행은 구현체가 담당한다.
이 관계는 아래처럼 정리할 수 있다.
ORM은 객체와 테이블을 연결하는 방식이다.JPA는Java에서ORM을 사용하기 위한 표준 규칙이다.Hibernate는JPA표준을 실제로 실행하는 구현체이다.이 세 가지를 구분해야 뒤에서
JPA코드와Hibernate로그가 같이 나와도 헷갈리지 않는다.
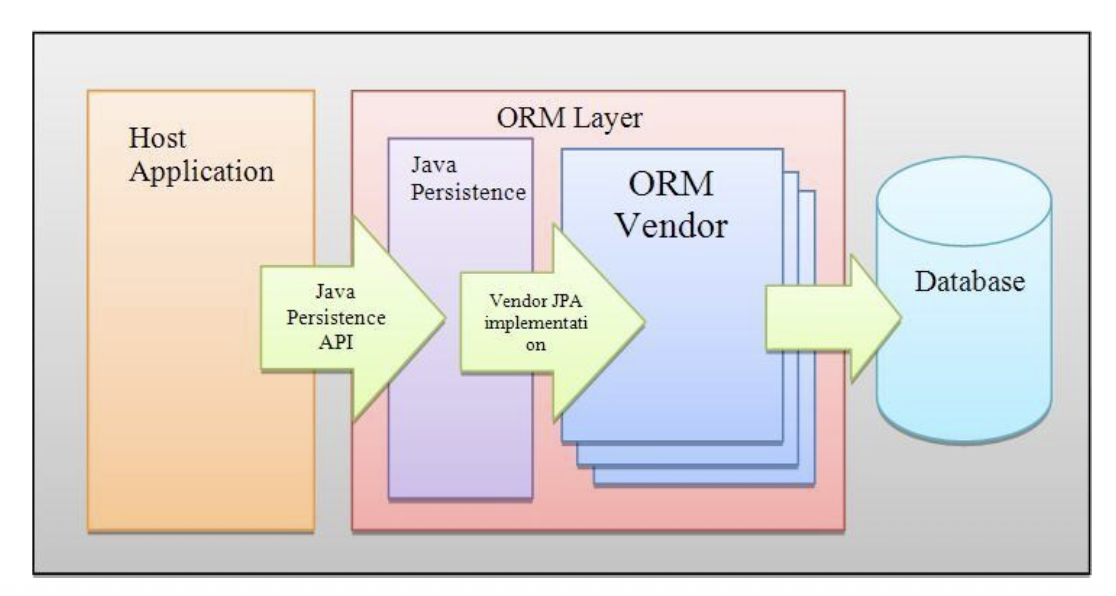
코드에서는JPA의 표준 타입과 메서드를 사용한다.
하지만 실행 과정에서는Hibernate가 내부에서SQL을 만들고 데이터베이스와 통신한다.
애플리케이션은
JPA표준 인터페이스를 사용한다.
그 아래에서는Hibernate같은ORM Vendor가 실제 데이터베이스 접근을 처리한다.
즉,JPA는 개발자가 사용하는 표준 입구이고, 구현체는 그 요청을 실제 데이터베이스 작업으로 바꾸는 실행 담당자이다.
JPA와Hibernate는 같은 말이 아니다.
JPA는 표준이고,Hibernate는 구현체이다.
쉽게 말하면JPA는 사용 규칙이고,Hibernate는 그 규칙대로 실제 일을 처리하는 도구이다.
그래서 코드에서는EntityManager,persist(),find()같은JPA표준 기능을 사용한다.
그런데 콘솔 로그에서는Hibernate이름이 보일 수 있다.
이것은 이상한 일이 아니다.
표준은JPA이고, 실제 실행 구현체가Hibernate이기 때문이다.
JPA를 공부할 때는 표준인JPA와 구현체인Hibernate를 구분해서 이해해야 한다.
1-3. Entity는 객체와 테이블을 연결하는 중심이다
JPA는 아무 객체나 데이터베이스와 연결하지 않는다.
JPA가 관리할 수 있는 객체는Entity클래스로 만들어야 한다.
Entity는 데이터베이스 테이블과 연결되는Java클래스이다.
Entity클래스의 필드는 테이블의 컬럼과 연결될 수 있다.
그리고Entity객체 하나는 테이블의 한 행과 대응될 수 있다.
이 흐름을 먼저 잡아야persist(),find(),remove()같은 메서드가 왜 객체를 대상으로 동작하는지 이해할 수 있다.
아래 예제는 객체 저장 요청이 어떤 느낌인지 보여 준다.// JpaPersistFlow.java MemberEntity member = new MemberEntity(1L, "홍길동"); // 저장할 Entity 객체 생성 entityManager.persist(member); // JPA에게 저장 요청
new MemberEntity(1L, "홍길동")은 저장할 객체를 만드는 코드이다.
entityManager.persist(member)는 이 객체를 저장 대상으로 등록하라고JPA에게 요청하는 코드이다.
개발자는insert SQL을 직접 작성하지 않고, 객체를 저장하라고 요청한다.
이 코드만 보면 데이터베이스 작업이 보이지 않는다.
하지만 내부에서는JPA구현체인Hibernate가MemberEntity의 매핑 정보를 확인한다.
그리고 데이터베이스에 저장하기 위한insert SQL을 만들 수 있다.
여기서 중요한 점은persist()가 테이블을 직접 대상으로 하는 메서드가 아니라는 것이다.
persist()는Entity객체를 대상으로 한다.
이 객체가 어떤 테이블과 연결되는지는@Entity,@Id, 필드 매핑 정보가 알려 준다.
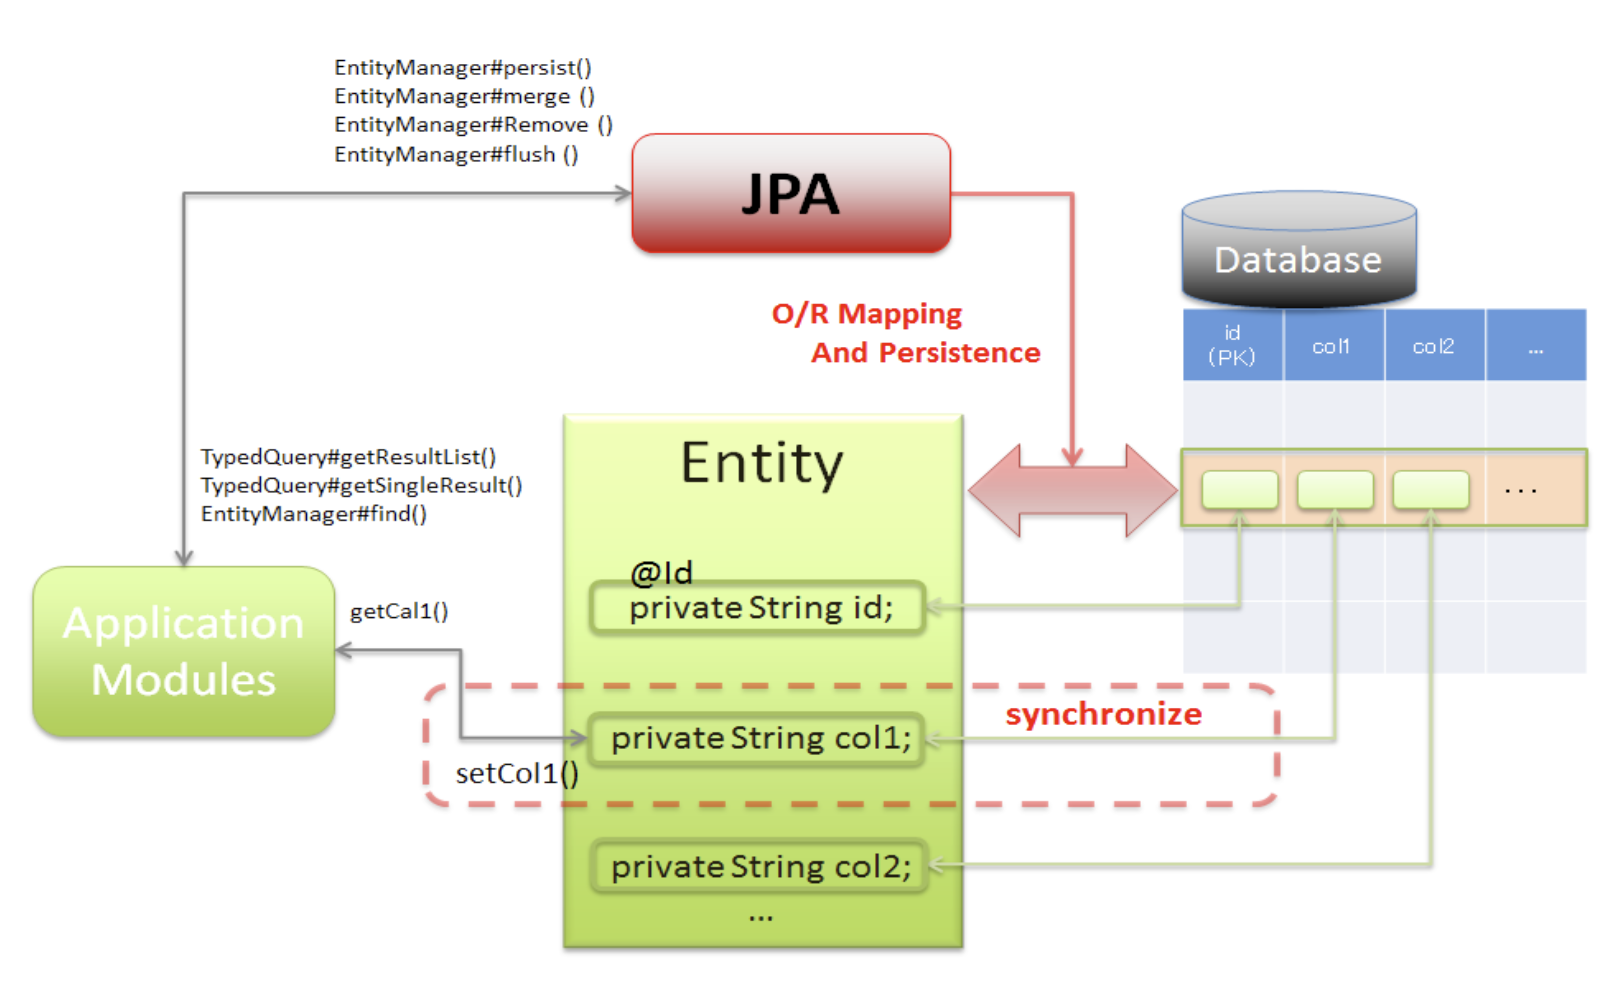
Entity클래스의 필드는 데이터베이스 테이블의 컬럼과 연결된다.
id,col1,col2같은 필드는 테이블의id,col1,col2컬럼과 매핑될 수 있다.
애플리케이션은 객체의 메서드로 값을 다루고,JPA는 이 객체 상태를 데이터베이스 레코드와 맞춰 간다.
위쪽의persist(),merge(),remove(),flush(),find()는Entity를 저장, 병합, 삭제, 반영, 조회할 때 사용하는 주요 메서드이다.
중요한 점은 이 메서드들이 테이블이 아니라Entity객체를 대상으로 동작한다는 것이다.
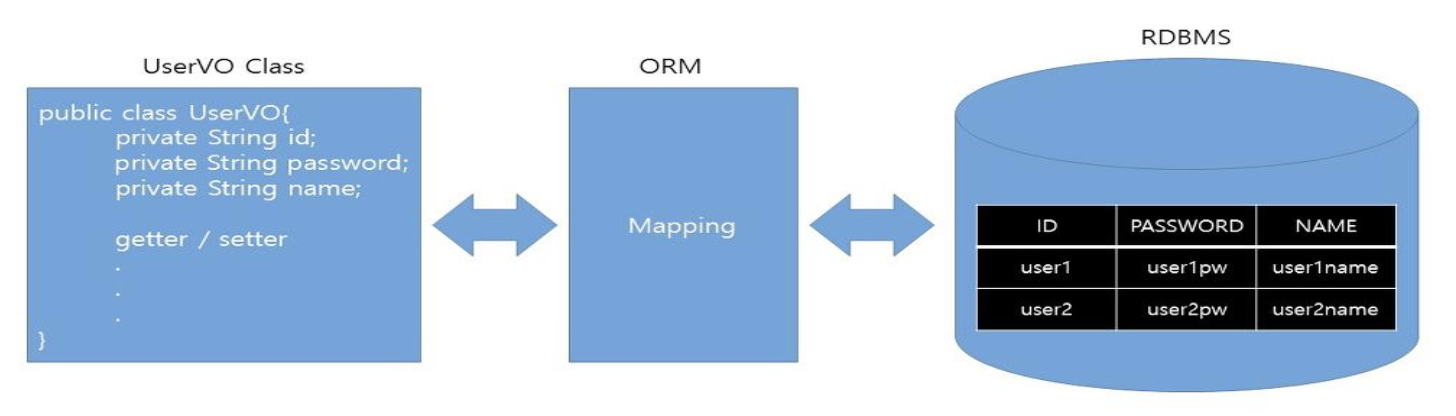
객체와 테이블의 연결은 더 단순하게 보면 아래처럼 이해할 수 있다.
UserVO클래스에는id,password,name필드가 있고, 데이터베이스 테이블에는ID,PASSWORD,NAME컬럼이 있다.
ORM은 객체의 필드와 테이블의 컬럼을 연결한다.
이 연결 덕분에 개발자는 테이블의 행을 직접 다루기보다Java객체를 중심으로 데이터를 다룰 수 있다.
객체 저장 흐름은 아래처럼 이어진다.
- 개발자가
Entity객체를 만든다.persist()로 저장을 요청한다.JPA는 엔티티와 테이블의 매핑 정보를 확인한다.Hibernate가 필요한SQL을 만든다.- 데이터베이스에 저장 작업이 전달된다.
처음부터 모든 내부 동작을 외우려고 하면 어렵다.
이 단계에서는 객체를 다루는 코드가 실제 데이터베이스 작업으로 이어진다는 큰 흐름을 잡으면 된다.
1-4. JPA를 사용해도 SQL은 사라지지 않는다
JPA를 사용하면 개발자가 직접 작성하는SQL은 줄어든다.
하지만 데이터베이스가SQL없이 동작하는 것은 아니다.
데이터베이스는 여전히insert,select,update,delete같은SQL명령으로 데이터를 처리한다.
차이는 누가SQL을 작성하느냐이다.
기존 방식에서는 개발자가 직접SQL을 많이 작성한다.
JPA방식에서는 개발자가 객체를 저장하거나 조회하라고 요청한다.
그러면Hibernate가 매핑 정보를 바탕으로 필요한SQL을 만들어 실행한다.
먼저SQL중심 방식은 아래처럼 생각한다.// SqlInsertFlow.java String sql = "insert into member(id, name) values(1, '홍길동')"; // 저장 SQL 직접 작성 executeUpdate(sql); // SQL 실행이 방식에서는 개발자가 테이블 이름, 컬럼 이름, 저장할 값을 직접
SQL안에 작성한다.
즉, 데이터베이스 구조를 기준으로 코드를 작성한다.
반면JPA중심 방식은 아래처럼 생각한다.// JpaInsertFlow.java MemberEntity member = new MemberEntity(1L, "홍길동"); // 저장할 Entity 객체 생성 entityManager.persist(member); // 객체 저장 요청이 흐름에서는 먼저 객체를 만든다.
그리고 그 객체를 저장하라고 요청한다.
테이블과 컬럼의 연결 정보는Entity매핑이 담당한다.
실제insert SQL은JPA구현체가 만들어 실행한다.
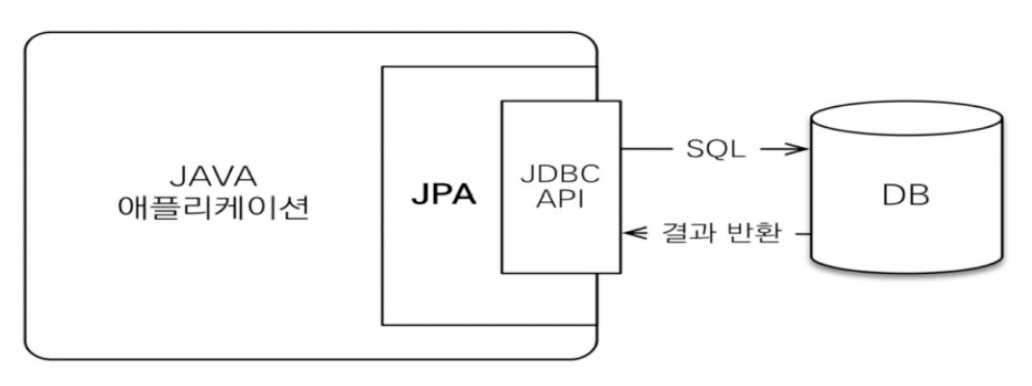
JPA는 데이터베이스와 직접 마법처럼 연결되는 것이 아니다.
내부적으로는JDBC API를 통해 데이터베이스에SQL을 전달한다.
데이터베이스에서 결과가 돌아오면,JPA는 그 결과를 다시 객체 형태로 변환해 애플리케이션에서 사용할 수 있게 한다.
그래서JPA를 배울 때는 두 가지를 함께 봐야 한다.
하나는 객체 중심 코드이다.
다른 하나는 그 코드가 실행될 때 실제로 만들어지는SQL이다.
JPA는SQL을 없애는 기술이 아니라, 객체 상태와 매핑 정보를 바탕으로 필요한SQL을 대신 만들어 주는 기술이다.
여기까지 이해하면 다음 단계에서 왜JPA가 필요해졌는지 자연스럽게 연결된다.
기존 방식에서는 개발자가 직접SQL을 작성하고, 조회 결과를 객체에 다시 담는 일이 많았다.
JPA는 그 반복을 줄이고, 객체 중심으로 데이터베이스 작업을 이어 가게 도와준다.
2. JPA가 필요한 이유 이해하기
JPA가 왜 필요한지 이해하려면 기존 데이터베이스 작업 방식과 비교해야 한다.
데이터베이스 작업은 결국 데이터를 저장하고, 조회하고, 수정하고, 삭제하는 일이다.
이 작업을CRUD라고 한다.
CRUD는Create,Read,Update,Delete의 줄임말이다.
기존 방식에서는SQL을 직접 작성하고, 실행 결과를 다시Java객체에 담는 일이 많았다.
처음에는 이 방식이 직관적이다.
하지만 기능이 많아지고 테이블이 늘어나면 비슷한 코드가 계속 반복된다.
JPA는 이 반복을 줄이고, 개발자가 테이블보다 객체의 상태와 관계를 중심으로 코드를 작성할 수 있게 도와준다.
JPA가 필요한 가장 큰 이유는 반복되는SQL중심 작업을 줄이고, 객체 중심으로 데이터베이스 작업을 이어가기 위해서이다.
2-1. JDBC만 사용할 때 생기는 반복 작업
JDBC는Java에서 데이터베이스에 직접 접근하기 위한 기본 기술이다.
JDBC를 사용하면 개발자가 직접 데이터베이스 연결을 만들고,SQL을 실행하고, 결과를 읽고, 사용한 자원을 닫아야 한다.
이 방식은 데이터베이스 동작을 세밀하게 제어할 수 있다는 장점이 있다.
하지만 단순한 저장이나 조회에도 반복 코드가 많다.
연결을 얻고,SQL을 만들고, 값을 넣고, 실행하고, 예외를 처리하고, 자원을 닫는 흐름이 계속 반복된다.
이런 반복 코드를 보일러플레이트 코드라고 부른다.
보일러플레이트 코드는 핵심 기능을 만들기 위해 거의 매번 비슷하게 작성해야 하는 반복 코드를 의미한다.
회원 한 명을 저장한다고 생각해 보자.
JDBC중심 사고에서는 먼저 저장할 객체보다 실행할SQL을 떠올리게 된다.// JdbcSaveThinking.java String sql = "insert into member(id, name) values(1, '홍길동')"; // 저장할 SQL 직접 작성 executeUpdate(sql); // SQL 실행 요청이라고 가정이 예시는 전체
JDBC코드를 완성한 것이 아니라, 사고 흐름을 보여 주는 코드이다.
중요한 점은 저장 작업의 출발점이 객체가 아니라SQL이라는 점이다.
조회도 마찬가지이다.
데이터베이스에서 조회한 결과가 처음부터MemberPlain객체로 돌아오는 것이 아니다.
컬럼 값을 하나씩 꺼내고, 그 값을 다시 객체에 담아야 한다.// JdbcFindThinking.java String sql = "select id, name from member where id = 1"; // 조회할 SQL 직접 작성 Long id = 1L; // 조회 결과에서 꺼낸 id라고 가정 String name = "홍길동"; // 조회 결과에서 꺼낸 name이라고 가정 MemberPlain member = new MemberPlain(id, name); // 조회 결과를 객체로 변환이 흐름에서는 데이터베이스 조회 결과를 객체로 바꾸는 작업을 개발자가 직접 신경 써야 한다.
테이블 컬럼이 늘어나면 꺼내야 할 값도 늘어난다.
객체 필드가 바뀌면 값을 담는 코드도 함께 바뀐다.
즉,JDBC만 사용할 때의 부담은 단순히 코드가 길다는 데서 끝나지 않는다.
데이터베이스 구조와 객체 구조 사이를 개발자가 계속 직접 맞춰야 한다는 점이 가장 큰 부담이다.
2-2. SQL Mapper 방식의 장점과 한계
SQL Mapper는 직접 작성한SQL과Java객체를 연결해 주는 방식이다.
대표적으로MyBatis가 있다.
MyBatis를 사용하면 순수JDBC보다 반복 코드가 줄어든다.
데이터베이스 연결 처리나 조회 결과 매핑을 프레임워크가 도와주기 때문이다.
Mapper는 연결해 주는 도구라고 이해하면 된다.
SQL Mapper는SQL실행 결과와Java객체를 연결해 주는 방식이다.
그래서 개발자는 순수JDBC처럼 모든 코드를 직접 작성하지 않아도 된다.
예를 들어MyBatis방식에서는 조회할SQL을Mapper XML에 작성할 수 있다.
그리고Java코드에서는Mapper메서드를 호출해서 결과를 객체로 받을 수 있다.// MemberMapper.xml <select id="findMember" resultType="MemberPlain"> select id, name from member where id = #{id} </select>// MyBatisFindThinking.java MemberPlain member = mapper.findMember(1L); // Mapper에 정의된 SQL 실행 후 객체로 받음이 방식은 순수
JDBC보다 훨씬 편하다.
개발자가 직접 연결 객체를 만들고, 결과를 하나씩 꺼내 객체에 담는 반복이 줄어들기 때문이다.
하지만 중심은 여전히SQL이다.
어떤 테이블에서 어떤 컬럼을 조회할지 개발자가 직접SQL로 작성해야 한다.
테이블 구조가 바뀌면 관련SQL도 함께 수정해야 한다.
조회 조건이 바뀌면SQL도 바뀐다.
저장, 수정, 삭제도 직접 작성한SQL을 기준으로 동작한다.
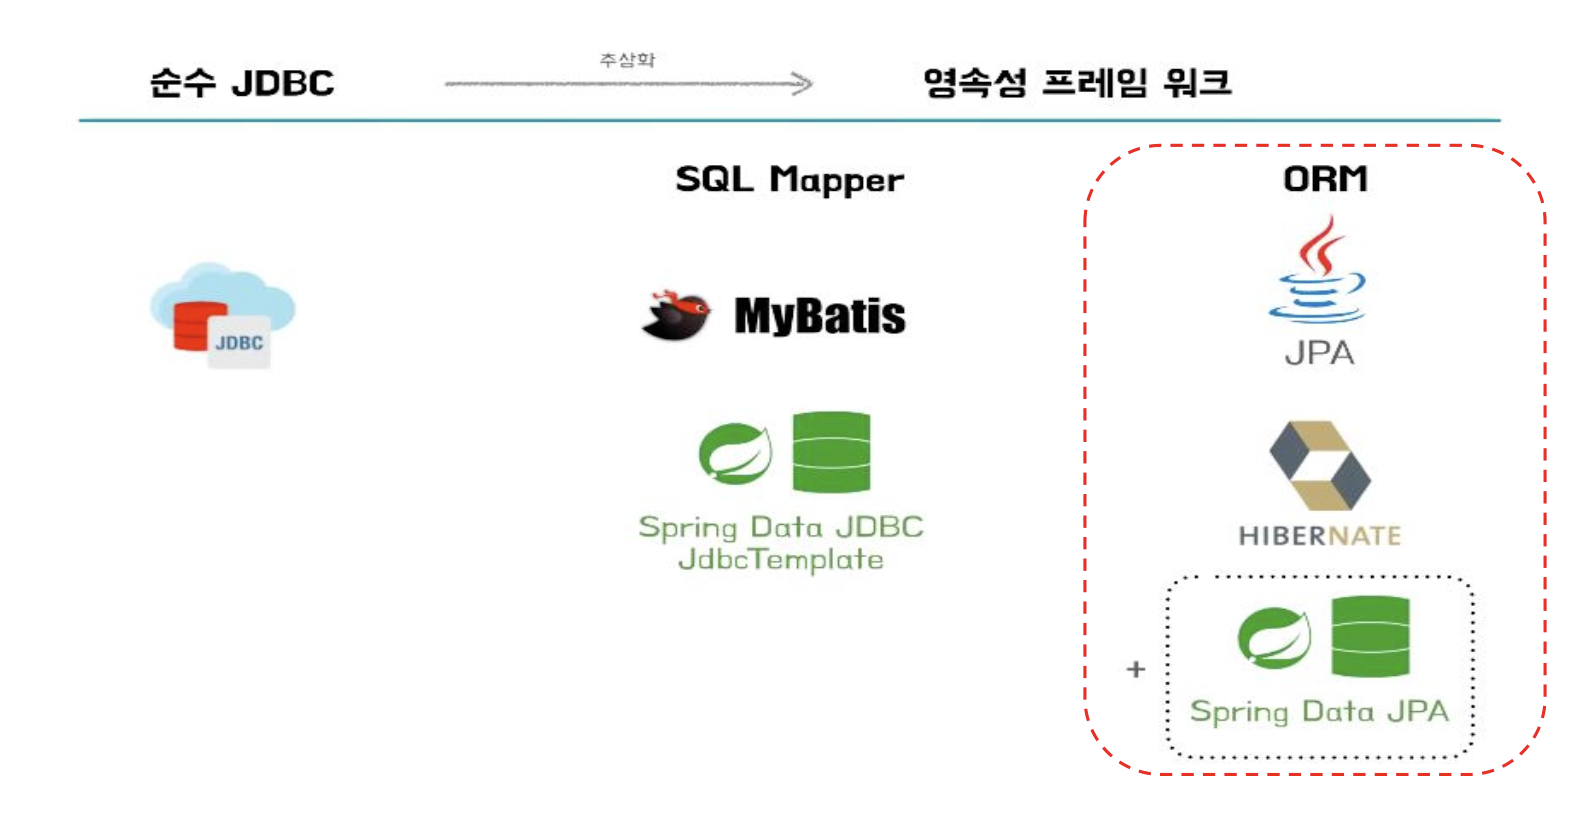
데이터베이스 접근 기술은
JDBC에서SQL Mapper,ORM으로 갈수록 반복 작업을 줄이고 추상화 수준을 높인다.
순수JDBC는 개발자가 연결,SQL실행, 결과 처리를 직접 많이 작성한다.
SQL Mapper는SQL은 직접 작성하되 반복되는 처리 과정을 줄여 준다.
ORM은 객체와 테이블을 매핑해서 객체 중심으로 데이터베이스를 다룰 수 있게 해 준다.
추상화 수준이 높아진다는 말은 내부 동작을 몰라도 된다는 뜻이 아니다.
JPA를 사용해도 실제로 어떤SQL이 실행되는지 확인할 수 있어야 한다.
그래야 성능 문제나 조회 문제를 해결할 수 있다.
SQL Mapper의 장점은 직접SQL을 제어하기 쉽다는 점이다.
복잡한 조회문을 정확히 작성하고 싶을 때 유리하다.
하지만 객체와 테이블의 구조 차이를 근본적으로 해결하는 방식은 아니다.
2-3. MyBatis와 JPA의 차이
MyBatis와JPA는 둘 다 데이터베이스 작업을 도와주는 기술이다.
하지만 작업을 바라보는 기준이 다르다.
MyBatis는SQL Mapper방식이다.
개발자가 직접 작성한SQL을 기준으로 데이터베이스 작업을 진행한다.
그리고 그 결과를 객체에 담아 준다.
즉, 중심은SQL이다.
JPA는ORM방식이다.
객체와 테이블의 매핑 정보를 기준으로 데이터베이스 작업을 진행한다.
개발자는 엔티티 객체를 저장하거나 조회하라고 요청한다.
그러면JPA구현체가 필요한SQL을 만들어 실행한다.
즉, 중심은 객체이다.
같은 회원 저장 작업을 비교하면 차이가 더 잘 보인다.
먼저MyBatis나SQL중심 방식에서는 실행할SQL이 먼저 보인다.// MemberMapper.xml <insert id="saveMember"> insert into member(id, name) values(#{id}, #{name}) </insert>// SqlMapperSaveFlow.java MemberPlain member = new MemberPlain(1L, "홍길동"); // 저장할 값이 담긴 객체 mapper.saveMember(member); // Mapper에 정의된 SQL 실행이 흐름에서는
Java코드에서 객체를 넘기더라도, 실제 저장 기준은Mapper XML에 작성된SQL이다.
즉, 저장 작업의 핵심은 직접 작성한insert SQL에 있다.
반면JPA방식에서는 저장할 엔티티 객체가 먼저 보인다.// JpaSaveFlow.java MemberEntity member = new MemberEntity(1L, "홍길동"); // 저장할 Entity 객체 생성 entityManager.persist(member); // 객체 저장 요청이 흐름에서는 개발자가
MemberEntity객체를 만들고 저장을 요청한다.
테이블과 컬럼의 연결은 엔티티 매핑 정보가 담당한다.
필요한SQL은Hibernate가 만들어 실행한다.
둘의 차이는 아래처럼 정리할 수 있다.
MyBatis는 직접 작성한SQL이 중심이다.JPA는 매핑된Entity객체가 중심이다.MyBatis는SQL제어가 직관적이다.JPA는 반복적인CRUD작업을 객체 중심으로 처리하기 좋다.둘 중 하나가 무조건 더 좋다는 식으로 이해하면 안 된다.
중요한 것은 방식의 차이다.
이번 글에서는JPA가 객체 중심 데이터 처리를 어떻게 이어 가는지에 집중한다.
2-4. SQL 중심 개발과 객체 중심 개발 비교
SQL중심 개발에서는 데이터베이스 테이블과SQL을 먼저 생각한다.
회원 한 명을 저장하려면 어떤 테이블에 어떤 컬럼 값을 넣을지 먼저 생각한다.
그리고insert SQL을 작성한다.
// SqlCenteredInsert.java
String sql = "insert into member(id, name) values(1, '홍길동')"; // SQL을 직접 작성

executeUpdate(sql); // SQL 실행 요청이라고 가정
이 방식에서는 개발자가 데이터베이스 구조를 계속 의식해야 한다.
저장할 때도SQL, 조회할 때도SQL, 수정할 때도SQL이 중심이다.
객체 중심 개발에서는 먼저 저장할 객체를 만든다.
그리고 그 객체를 저장하라고 요청한다.// ObjectCenteredInsert.java MemberEntity member = new MemberEntity(1L, "홍길동"); // 객체를 먼저 생성 entityManager.persist(member); // 객체 저장 요청이 방식에서는 개발자가 객체를 먼저 생각한다.
MemberEntity객체가 어떤 테이블과 연결되는지는 엔티티 매핑 정보가 담당한다.
실제insert SQL은JPA구현체가 만들어 실행한다.
조회도 비교할 수 있다.
SQL중심 방식에서는 조회할SQL을 작성하고, 결과를 다시 객체로 바꾼다.// SqlCenteredFind.java String sql = "select id, name from member where id = 1"; // 조회 SQL 작성 MemberPlain member = convertResultToMember(sql); // 조회 결과를 객체로 변환한다고 가정
JPA방식에서는 기본키로 엔티티를 조회할 수 있다.// ObjectCenteredFind.java MemberEntity member = entityManager.find(MemberEntity.class, 1L); // 기본키로 Entity 조회
find()는 기본키를 기준으로 엔티티를 조회하는JPA메서드이다.
이 코드는 테이블 이름을 직접 쓰지 않는다.
조회할 대상인MemberEntity클래스와 기본키 값1L을 전달한다.
둘의 차이는 코드 길이만의 문제가 아니다.
중요한 차이는 작업의 기준이다.
기존 방식은SQL과 테이블이 중심이다.
JPA방식은 객체와 엔티티가 중심이다.
JPA를 사용하면 개발자는 객체의 상태와 관계를 중심으로 코드를 작성하고, 데이터베이스 작업은 매핑 정보를 바탕으로 이어진다.
2-5. JPA를 사용할 때 얻는 장점
JPA를 사용하면 생산성이 좋아질 수 있다.
생산성은 같은 기능을 만들 때 필요한 반복 작업이 줄어드는 정도라고 이해하면 된다.
객체를 저장하려면persist()를 사용하고, 기본키로 조회하려면find()를 사용할 수 있다.
반복적인SQL작성과 결과 변환 코드가 줄어든다.
아래처럼 저장과 조회 흐름이 객체 중심으로 단순해진다.// JpaCrudSimpleFlow.java MemberEntity member = new MemberEntity(1L, "홍길동"); // 저장할 Entity 생성 entityManager.persist(member); // 저장 요청 MemberEntity findMember = entityManager.find(MemberEntity.class, 1L); // 기본키로 조회이 예제는
JPA의 기본 작업 흐름이 객체 중심이라는 점을 보여 준다.
저장할 때는 객체를 넘기고, 조회할 때는 조회할 엔티티 타입과 기본키를 넘긴다.
유지보수도 쉬워질 수 있다.
필드가 하나 추가될 때마다 관련insert,select,update문장을 직접 모두 수정해야 하는 상황이 줄어든다.
엔티티와 매핑 정보를 기준으로 데이터 처리 흐름을 관리할 수 있기 때문이다.
객체와 관계형 데이터베이스 사이의 차이도 줄여 준다.
객체는 참조로 관계를 맺고, 테이블은 외래키로 관계를 맺는다.
JPA는 이런 차이를 매핑 정보로 연결한다.
성능 최적화 기회도 제공한다.
영속성 컨텍스트의1차 캐시, 동일성 보장, 쓰기 지연, 변경 감지 같은 기능은 단순히 문법 편의를 위한 것이 아니다.
데이터베이스와의 통신을 줄이거나 필요한 시점에 모아서 처리할 수 있게 도와준다.
데이터베이스 독립성도 장점이다.
데이터베이스마다SQL문법이 조금씩 다르다.
JPA는Dialect라는 데이터베이스별 방언 정보를 사용해서 데이터베이스 종류에 맞는SQL을 만들 수 있다.
Dialect는 방언이라는 뜻이다.
사람이 지역마다 말투가 조금씩 다른 것처럼, 데이터베이스도 종류마다SQL문법이 조금씩 다르다.
정리하면JPA의 장점은 아래와 같다.
- 반복적인
CRUD코드가 줄어든다.- 객체 중심으로 데이터베이스 작업을 작성할 수 있다.
- 객체와 테이블의 구조 차이를 매핑으로 연결할 수 있다.
- 영속성 컨텍스트를 통해 성능 최적화 기회를 얻을 수 있다.
- 데이터베이스마다 다른
SQL문법 차이를 줄일 수 있다.다만
JPA를 사용한다고 해서 데이터베이스를 몰라도 되는 것은 아니다.
실제로 어떤SQL이 실행되는지, 언제 실행되는지 확인할 수 있어야 한다.
2-6. SQL 중심 저장 흐름과 JPA 중심 저장 흐름 다시 정리하기
같은 회원 저장 작업을 마지막으로 한 번 더 비교해 보자.
SQL중심 방식은 저장할 테이블과 컬럼을 직접 지정한다.// SqlSaveSummary.java String sql = "insert into member(id, name) values(1, '홍길동')"; // 테이블과 컬럼을 직접 지정 executeUpdate(sql); // SQL 실행 요청이라고 가정이 흐름에서는 개발자가 데이터베이스 구조를 기준으로 저장 코드를 작성한다.
그래서 테이블명, 컬럼명, 값의 순서를 직접 신경 써야 한다.
JPA중심 방식은 저장할 객체를 먼저 만든다.// JpaSaveSummary.java MemberEntity member = new MemberEntity(1L, "홍길동"); // 저장할 Entity 객체 생성 entityManager.persist(member); // JPA에게 저장 요청이 흐름에서는 개발자가 객체를 기준으로 저장 코드를 작성한다.
테이블과 컬럼의 연결은Entity매핑 정보가 담당한다.
필요한insert SQL은JPA구현체가 만들어 실행한다.
정리하면 아래와 같다.
SQL중심 방식은 실행할SQL을 직접 작성한다.JPA중심 방식은 저장할 객체를 만들고 저장을 요청한다.JPA를 사용해도 내부에서는 결국SQL이 실행된다.- 차이는 개발자가 직접 모든
SQL을 작성하느냐, 객체와 매핑 정보를 기준으로JPA가SQL을 만들어 주느냐이다.이제
JPA를 왜 사용하는지 이해했다면, 다음으로는JPA가 관리하는 핵심 대상인Entity를 더 자세히 봐야 한다.
Entity를 이해해야 저장, 조회, 수정, 삭제 흐름이 자연스럽게 이어진다.
3. Entity 이해하기
Entity는JPA가 데이터베이스 테이블과 연결해서 관리하는Java클래스이다.
Java에서는 데이터를 객체로 다루고, 데이터베이스에서는 데이터를 테이블의 행으로 저장한다.
Entity는 이 두 구조를 이어 주는 기준이 된다.
Entity를 이해할 때는 “클래스 하나가 테이블 하나와 연결될 수 있고, 객체 하나가 테이블의 한 행과 연결될 수 있다”는 흐름을 먼저 잡아야 한다.
그래야 뒤에서 나오는 저장, 조회, 수정, 삭제가 단순한 메서드 호출이 아니라 데이터베이스 작업으로 이어지는 과정이라는 점을 이해할 수 있다.
Entity는JPA가 데이터베이스 테이블과 연결해서 관리하는 핵심 클래스이다.
3-1. Entity는 테이블과 연결되는 Java 클래스이다
Entity는 데이터베이스 테이블과 연결되는Java클래스이다.
테이블은 행과 컬럼으로 데이터를 저장하고,Java클래스는 필드로 데이터를 표현한다.
JPA는Entity클래스를 기준으로 이 둘을 연결한다.
먼저 일반Java클래스만 보면 아래와 같다.// MemberPlain.java public class MemberPlain { private Long id; // 회원 번호 private String name; // 회원 이름 public MemberPlain(Long id, String name) { // 객체 생성 시 값 저장 this.id = id; this.name = name; } }이 코드는 회원 정보를 담는 일반 클래스이다.
id와name이라는 필드를 가지고 있지만, 아직JPA가 관리하는 클래스는 아니다.
즉, 이 클래스만으로는 데이터베이스의 어떤 테이블과 연결되는지 알 수 없다.
JPA가 테이블과 연결할 수 있는 클래스로 인식하게 하려면@Entity를 붙인다.// MemberEntityBasic.java import jakarta.persistence.Entity; import jakarta.persistence.Id; @Entity // JPA가 관리할 Entity 클래스라는 표시 public class MemberEntityBasic { @Id // 기본키로 사용할 필드 private Long id; private String name; // 회원 이름 protected MemberEntityBasic() { // JPA가 사용할 기본 생성자 } public MemberEntityBasic(Long id, String name) { // 객체 생성 시 값 저장 this.id = id; this.name = name; } }
@Entity가 붙으면JPA는 이 클래스를 관리 대상으로 인식한다.
그리고@Id가 붙은 필드를 기준으로 객체를 구분한다.
일반 클래스와Entity클래스의 차이는 단순히 어노테이션이 붙었는지의 차이만은 아니다.
일반 클래스는Java안에서만 사용되는 객체 설계도이다.
Entity클래스는JPA가 데이터베이스 테이블과 연결해서 관리할 수 있는 객체 설계도이다.
3-2. Entity 객체는 테이블의 한 행과 대응된다
Entity클래스는 테이블과 연결될 수 있다.
그리고Entity객체 하나는 테이블의 한 행과 대응될 수 있다.
이 차이를 구분해야 한다.
MemberEntityBasic클래스가member_entity_basic테이블과 연결된다고 생각해 보자.
그러면new MemberEntityBasic(1L, "홍길동")으로 만든 객체 하나는 테이블의 한 행과 연결될 수 있다.// MemberEntityRowExample.java MemberEntityBasic member = new MemberEntityBasic(1L, "홍길동"); // 테이블의 한 행과 대응될 수 있는 객체 entityManager.persist(member); // Entity 객체 저장 요청이 코드에서
member객체는 회원 한 명의 정보를 가진다.
이 객체가 저장되면 데이터베이스에는 회원 한 명에 해당하는 행이 만들어질 수 있다.
객체와 테이블의 대응 관계는 아래처럼 이해하면 된다.
Entity클래스는 테이블과 연결된다.Entity필드는 테이블 컬럼과 연결된다.Entity객체 하나는 테이블의 한 행과 연결된다.이 흐름을 알아야
persist()를 호출했을 때 왜 객체 하나가 데이터베이스 행 하나로 저장될 수 있는지 이해할 수 있다.
3-3. @Entity는 JPA 관리 대상이라는 표시이다
@Entity는 클래스 위에 붙이는 어노테이션이다.
어노테이션은 코드에 붙이는 특별한 표시이다.
JPA는 이 표시를 보고 어떤 클래스를 관리할지 판단한다.
// EntityAnnotationExample.java
import jakarta.persistence.Entity;
import jakarta.persistence.Id;

@Entity // 이 클래스는 JPA가 관리할 Entity라는 표시
public class EntityAnnotationExample {
    @Id // Entity를 구분할 기본키 필드
    private Long id;

    private String name; // 일반 필드
}
@Entity가 없으면JPA는 이 클래스를 엔티티로 인식하지 못한다.
필드 이름이 테이블 컬럼처럼 생겼어도,JPA입장에서는 그냥 일반Java클래스일 뿐이다.
따라서 데이터베이스 테이블과 연결해서 저장하거나 조회할 클래스에는@Entity를 붙여야 한다.
그리고Entity에는 각 객체를 구분할 기준이 필요하므로@Id도 함께 필요하다.
@Entity는 “이 클래스는JPA가 관리할 테이블 매핑 클래스이다”라고 알려 주는 표시이다.
3-4. @Table은 매핑할 테이블 이름을 지정한다
@Table은Entity클래스가 어떤 테이블과 연결될지 지정할 때 사용한다.
클래스 이름과 테이블 이름이 같거나 기본 규칙으로 충분하다면 생략할 수 있다.
하지만 테이블 이름을 명확하게 지정하고 싶을 때는@Table을 사용한다.
// MemberTableMapping.java
import jakarta.persistence.Entity;
import jakarta.persistence.Id;
import jakarta.persistence.Table;

@Entity // JPA 관리 대상
@Table(name = "member_table") // member_table 테이블과 매핑
public class MemberTableMapping {
    @Id // 기본키 필드
    private Long id;

    private String name; // 회원 이름
}
@Table(name = "member_table")은 이Entity가member_table테이블과 연결된다는 뜻이다.
클래스 이름은MemberTableMapping이지만, 실제 데이터베이스 테이블 이름은member_table로 지정한 것이다.
테이블 이름을 직접 지정하면 코드만 봐도 어떤 테이블과 연결되는지 알 수 있다.
초보자 입장에서는 자동 규칙에만 맡기는 것보다 명확하게 보인다.
3-5. @Table을 생략했을 때의 테이블 이름 규칙
@Table을 생략하면JPA는 기본 규칙에 따라 테이블 이름을 정한다.
기본적으로는Entity클래스 이름을 기준으로 테이블 이름을 매핑한다.
다만 실제 테이블 이름이 어떻게 만들어지는지는 설정에 따라 달라질 수 있다.
예를 들어 클래스 이름이MemberTableDefault라고 생각해 보자.// MemberTableDefault.java import jakarta.persistence.Entity; import jakarta.persistence.Id; @Entity // Table을 생략한 Entity public class MemberTableDefault { @Id // 기본키 필드 private Long id; private String memberName; // 회원 이름 }이 코드에는
@Table이 없다.
그러면JPA는 클래스 이름을 기준으로 테이블 이름을 정한다.
설정에 따라MemberTableDefault,membertabledefault,member_table_default같은 방식으로 매핑될 수 있다.
그래서 자동 이름 규칙을 사용할 때는 현재 프로젝트의 이름 변환 설정을 확인해야 한다.
테이블 이름이 예상과 다르게 생성되면@Table(name = "...")로 직접 지정하는 편이 안전하다.
테이블 이름이 헷갈릴 수 있는 상황에서는@Table로 매핑할 테이블 이름을 직접 지정하는 것이 좋다.
3-6. camel case와 snake case 자동 변환 설정
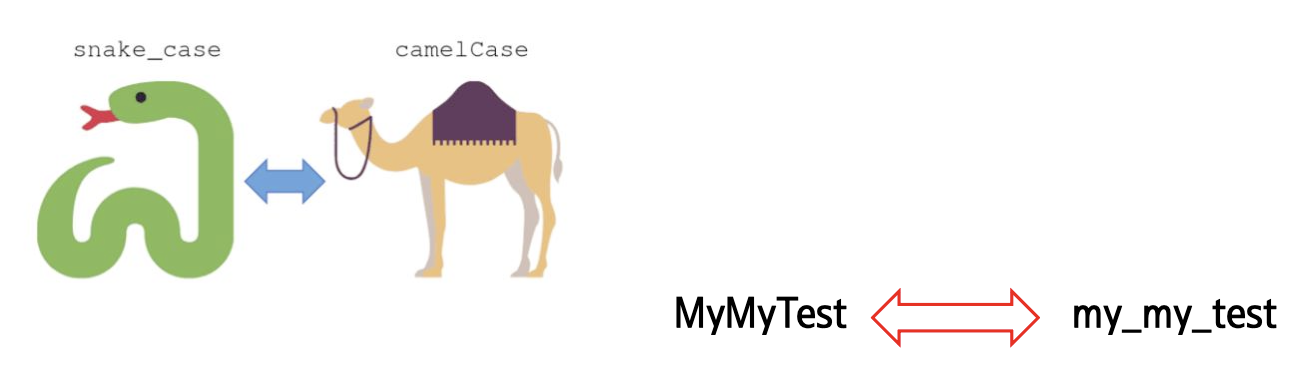
Java에서는 보통camel case이름을 많이 사용한다.
camel case는 여러 단어를 붙여 쓰되, 중간 단어의 첫 글자를 대문자로 쓰는 방식이다.
예를 들어memberName,createdDate,MyMyTest같은 이름이 있다.
데이터베이스에서는snake case를 많이 사용한다.
snake case는 단어 사이를 밑줄로 연결하는 방식이다.
예를 들어member_name,created_date,my_my_test같은 이름이 있다.
JPA와Hibernate설정에 따라camel case이름이snake case이름으로 자동 변환될 수 있다.// NamingStrategyExample.java import jakarta.persistence.Entity; import jakarta.persistence.Id; @Entity // 설정에 따라 테이블명이 naming_strategy_example 형태가 될 수 있음 public class NamingStrategyExample { @Id // 기본키 필드 private Long id; private String memberName; // 설정에 따라 member_name 컬럼명으로 변환될 수 있음 }이 예제에서
memberName이라는 필드는 설정에 따라member_name컬럼과 연결될 수 있다.
즉,Java코드의 이름 규칙과 데이터베이스의 이름 규칙을 자동으로 맞춰 줄 수 있다.
Java에서는MyMyTest처럼camel case를 사용할 수 있고, 데이터베이스에서는my_my_test처럼snake case를 사용할 수 있다.
이름 변환 전략이 적용되면 코드의 이름 규칙과 데이터베이스의 이름 규칙을 자동으로 맞출 수 있다.
다만 자동 변환 결과가 헷갈리면@Table이나@Column으로 이름을 직접 지정하는 것이 더 명확하다.
자동 변환은 편리하지만 무조건 외워서 믿으면 안 된다.
프로젝트 설정에 따라 결과가 달라질 수 있기 때문이다.
실제 테이블명이나 컬럼명이 예상과 다르면Entity이름,@Table,@Column, 이름 변환 설정을 함께 확인해야 한다.
3-7. @Id는 기본키 필드를 지정한다
@Id는Entity의 기본키 필드를 지정한다.
기본키는 테이블에서 각 행을 구분하는 값이다.
JPA는 이 기본키 값을 기준으로Entity객체를 구분한다.
// MemberIdMapping.java
import jakarta.persistence.Entity;
import jakarta.persistence.Id;

@Entity // JPA 관리 대상
public class MemberIdMapping {
    @Id // 기본키로 사용할 필드
    private Long id;

    private String name; // 회원 이름
}
이 코드에서
id필드는MemberIdMapping객체를 구분하는 기준이다.
데이터베이스 테이블에서도id는 각 행을 구분하는 기본키 컬럼과 연결될 수 있다.
기본키가 없으면JPA는 어떤 객체가 어떤 데이터베이스 행과 연결되는지 안정적으로 관리하기 어렵다.
예를 들어 같은 이름을 가진 회원이 여러 명 있을 수 있다.
하지만 기본키 값은 각 회원을 구분하는 고유한 값이어야 한다.
@Id는JPA가Entity객체를 구분하기 위해 반드시 필요한 기본키 표시이다.
3-8. @Column은 필드와 컬럼을 연결한다
@Column은Entity의 필드가 테이블의 어떤 컬럼과 연결되는지 지정할 때 사용한다.
필드 이름과 컬럼 이름이 같고 별도 조건이 필요 없다면 생략할 수 있다.
하지만 이름이 다르거나 컬럼 조건을 지정해야 할 때는@Column을 사용한다.
// MemberColumnMapping.java
import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.Id;
import jakarta.persistence.Table;

@Entity // JPA 관리 대상
@Table(name = "member_column") // 테이블 이름 지정
public class MemberColumnMapping {
    @Id // 기본키 필드
    @Column(name = "member_id") // member_id 컬럼과 연결
    private Long id;

    @Column(name = "member_name") // member_name 컬럼과 연결
    private String name;
}
@Column(name = "member_id")는id필드가member_id컬럼과 연결된다는 뜻이다.
@Column(name = "member_name")은name필드가member_name컬럼과 연결된다는 뜻이다.
모든 필드에 무조건@Column을 붙여야 하는 것은 아니다.
컬럼 이름을 직접 지정하거나, 컬럼의 제약 조건을 설정하고 싶을 때 사용한다고 이해하면 된다.
3-9. nullable, unique, length 속성 이해하기
@Column은 컬럼 이름만 지정하는 어노테이션이 아니다.
컬럼에 대한 조건도 함께 지정할 수 있다.
대표적으로nullable,unique,length가 있다.
nullable은null을 허용할지 정한다.
null은 값이 없음을 의미한다.
nullable = false로 지정하면 해당 컬럼에는 값이 반드시 있어야 한다.
unique는 값이 중복될 수 없는지 정한다.
unique = true로 지정하면 해당 컬럼에는 같은 값이 중복 저장될 수 없다.
length는 문자열 길이를 지정한다.
예를 들어length = 30이면 문자열 컬럼의 최대 길이를30으로 설정할 수 있다.
// MemberColumnOptions.java
import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.Id;

@Entity // JPA 관리 대상
public class MemberColumnOptions {
    @Id // 기본키 필드
    private Long id;

    @Column(nullable = false, unique = true, length = 30) // 필수값, 중복 불가, 길이 제한
    private String name;
}
이 코드는
name컬럼에 세 가지 조건을 준다.
값은 비어 있으면 안 되고, 중복되면 안 되며, 길이는30으로 제한된다.
이 설정들은 데이터베이스 테이블 구조와 연결될 수 있다.
따라서Entity필드를 설계할 때는Java필드만 보는 것이 아니라, 데이터베이스 컬럼 조건도 함께 생각해야 한다.
3-10. 기본 생성자가 필요한 이유
Entity클래스에는 기본 생성자가 필요하다.
기본 생성자는 매개변수가 없는 생성자이다.
매개변수는 메서드나 생성자에 값을 전달하기 위해 괄호 안에 적는 변수이다.
JPA는 엔티티 객체를 만들 때 내부적으로 기본 생성자를 사용할 수 있다.
그래서Entity클래스에는 매개변수가 없는 생성자를 만들어 두어야 한다.
// MemberDefaultConstructor.java
import jakarta.persistence.Entity;
import jakarta.persistence.Id;

@Entity // JPA 관리 대상
public class MemberDefaultConstructor {
    @Id // 기본키 필드
    private Long id;

    private String name;

    protected MemberDefaultConstructor() { // JPA가 사용할 기본 생성자
    }

    public MemberDefaultConstructor(Long id, String name) { // 값을 넣어 객체 생성
        this.id = id;
        this.name = name;
    }
}
기본 생성자는
public또는protected로 만들 수 있다.
학습 단계에서는public으로 만들어도 이해하기 쉽다.
하지만 외부에서 의미 없이 빈 객체를 만드는 것을 줄이려면protected로 두는 방식도 사용한다.
중요한 점은 접근 제한자보다 기본 생성자의 존재이다.
Entity에는JPA가 객체를 만들 수 있도록 매개변수가 없는 기본 생성자가 필요하다.
3-11. 지금까지의 Entity 설정을 하나로 합치기
지금까지 본 내용을 하나로 합치면 기본
Entity클래스 구조가 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라, 앞에서 본@Entity,@Table,@Id,@Column, 기본 생성자를 한 번에 연결해 보는 마무리이다.
// MemberEntityComplete.java
package jpaexam1.entity;

import jakarta.persistence.Column;
import jakarta.persistence.Entity;
import jakarta.persistence.Id;
import jakarta.persistence.Table;

@Entity // JPA가 관리할 Entity 클래스
@Table(name = "member_basic") // member_basic 테이블과 매핑
public class MemberEntityComplete {
    @Id // 기본키 필드
    @Column(name = "member_id") // member_id 컬럼과 매핑
    private Long id;

    @Column(name = "member_name", nullable = false, length = 30) // 이름 컬럼 설정
    private String name;

    protected MemberEntityComplete() { // JPA가 사용할 기본 생성자
    }

    public MemberEntityComplete(Long id, String name) { // 값을 넣어 객체 생성
        this.id = id;
        this.name = name;
    }

    public Long getId() { // id 반환
        return id;
    }

    public String getName() { // name 반환
        return name;
    }
}
이 클래스는
member_basic테이블과 매핑된다.
id필드는member_id컬럼과 연결되고,name필드는member_name컬럼과 연결된다.
@Entity는JPA관리 대상이라는 표시이다.
@Table은 테이블 이름을 지정한다.
@Id는 기본키 필드를 지정한다.
@Column은 필드와 컬럼을 연결하고, 필요한 컬럼 조건을 지정한다.
기본 생성자는JPA가 엔티티 객체를 만들 수 있도록 제공한다.
이제Entity가 무엇인지 이해했다면 다음으로 기본키 매핑을 더 자세히 볼 수 있다.
기본키는JPA가 엔티티를 구분하는 기준이므로, 직접 넣는 방식과 자동 생성 방식의 차이를 알아야 한다.
4. 기본키 매핑 이해하기
기본키는 데이터베이스 테이블에서 각 행을 구분하는 값이다.
JPA에서는 기본키를 기준으로Entity객체를 구분한다.
그래서Entity에는 반드시 기본키 역할을 하는 필드가 있어야 하고, 그 필드에는@Id를 붙인다.
기본키 매핑은 크게 두 방식으로 나눌 수 있다.
하나는 개발자가 기본키 값을 직접 넣는 방식이고, 다른 하나는 데이터베이스나JPA가 기본키 값을 자동으로 만들어 주는 방식이다.
기본키는JPA가Entity객체와 데이터베이스의 행을 연결하고 구분하는 기준이다.
기본키를 어떻게 만들고 저장할지 이해해야 저장 흐름과 영속성 컨텍스트 흐름도 자연스럽게 이어진다.
4-1. 기본키는 Entity를 구분하는 기준이다
Entity객체는 데이터베이스 테이블의 한 행과 대응될 수 있다.
그렇다면JPA는 여러Entity객체 중 어떤 객체가 어떤 행과 연결되는지 구분할 수 있어야 한다.
이때 사용하는 기준이 기본키이다.
예를 들어 회원 테이블에 여러 회원이 있다고 생각해 보자.
회원 이름은 같을 수 있다.
하지만 회원 번호는 각 회원을 구분하는 고유한 값이어야 한다.
이 회원 번호 같은 값이 기본키 역할을 한다.
JPA에서는 기본키 필드에@Id를 붙인다.// MemberPrimaryKey.java import jakarta.persistence.Entity; import jakarta.persistence.Id; @Entity // JPA가 관리할 Entity 클래스 public class MemberPrimaryKey { @Id // 기본키로 사용할 필드 private Long id; private String name; // 회원 이름 }
@Id가 붙은id필드는 이Entity를 구분하는 기준이 된다.
이 값이 있어야JPA가 저장, 조회, 수정, 삭제할 대상을 정확히 판단할 수 있다.
예를 들어 기본키1L인 회원을 조회하려면 아래처럼 조회할 수 있다.// FindByPrimaryKey.java MemberPrimaryKey member = entityManager.find(MemberPrimaryKey.class, 1L); // 기본키 1L로 Entity 조회
find()는 기본키를 기준으로Entity를 조회하는 메서드이다.
여기서MemberPrimaryKey.class는 조회할Entity타입이고,1L은 찾을 기본키 값이다.
기본키가 없으면JPA는 어떤 객체가 어떤 데이터베이스 행과 연결되는지 안정적으로 관리하기 어렵다.
따라서Entity를 만들 때는 기본키 필드를 먼저 생각해야 한다.
4-2. 직접 할당 방식은 개발자가 기본키 값을 넣는 방식이다
직접 할당 방식은 개발자가 기본키 값을 직접 정해서 넣는 방식이다.
Entity객체를 만들 때id값을 직접 전달하거나, 저장하기 전에 기본키 값을 직접 넣어 둔다.
아래 예제는 기본키를 직접 넣는Entity구조이다.// MemberDirectKey.java import jakarta.persistence.Entity; import jakarta.persistence.Id; import jakarta.persistence.Table; @Entity // JPA가 관리할 Entity 클래스 @Table(name = "member_direct_key") // member_direct_key 테이블과 매핑 public class MemberDirectKey { @Id // 개발자가 직접 넣을 기본키 필드 private Long id; private String name; // 회원 이름 protected MemberDirectKey() { // JPA가 사용할 기본 생성자 } public MemberDirectKey(Long id, String name) { // 기본키와 이름을 직접 받아 객체 생성 this.id = id; this.name = name; } }이 구조에서는
@GeneratedValue를 사용하지 않는다.
@GeneratedValue는 기본키 값을 자동 생성하겠다는 표시이다.
직접 할당 방식은 자동 생성이 아니므로 개발자가 기본키 값을 넣어야 한다.
저장할 때는 아래처럼 기본키 값을 직접 넣은 객체를 만든다.// DirectKeyPersistFlow.java MemberDirectKey member = new MemberDirectKey(1L, "홍길동"); // 기본키 1L을 직접 지정 entityManager.persist(member); // JPA에게 저장 요청이 흐름에서는 개발자가
1L이라는 기본키 값을 직접 정한다.
그래서 저장될 기본키 값이 무엇인지 코드에서 바로 보인다.
하지만 직접 할당 방식은 중복에 주의해야 한다.
이미 기본키 값이1인 데이터가 있는데 다시1을 저장하려고 하면 기본키 중복 문제가 생길 수 있다.
기본키는 각 행을 구분하는 값이므로 같은 값이 중복되면 안 된다.
직접 할당 방식에서는 기본키 값을 개발자가 직접 관리하므로, 중복되지 않게 신경 써야 한다.
4-3. 자동 생성 방식은 DB나 JPA가 기본키 값을 만드는 방식이다
자동 생성 방식은 기본키 값을 개발자가 직접 넣지 않고, 데이터베이스나
JPA가 만들어 주는 방식이다.
이때 사용하는 어노테이션이@GeneratedValue이다.
@GeneratedValue는 기본키 값을 자동으로 생성하겠다는 표시이다.
이 어노테이션은@Id와 함께 사용한다.
@Id가 “이 필드는 기본키이다”라는 표시라면,@GeneratedValue는 “이 기본키 값은 자동으로 만들겠다”라는 표시이다.
아래 예제는 기본키 자동 생성 구조이다.// MemberGeneratedKey.java import jakarta.persistence.Entity; import jakarta.persistence.GeneratedValue; import jakarta.persistence.Id; import jakarta.persistence.Table; @Entity // JPA가 관리할 Entity 클래스 @Table(name = "member_generated_key") // member_generated_key 테이블과 매핑 public class MemberGeneratedKey { @Id // 기본키 필드 @GeneratedValue // 기본키 자동 생성 private Long id; private String name; // 회원 이름 protected MemberGeneratedKey() { // JPA가 사용할 기본 생성자 } public MemberGeneratedKey(String name) { // id 없이 이름만 받아 객체 생성 this.name = name; } }이 코드에서는 생성자에서
id를 받지 않는다.
기본키 값은 저장 과정에서 자동으로 만들어질 수 있기 때문이다.
저장 흐름은 아래처럼 볼 수 있다.// GeneratedKeyPersistFlow.java MemberGeneratedKey member = new MemberGeneratedKey("이순신"); // id 없이 Entity 객체 생성 entityManager.persist(member); // 저장 요청 시 기본키 자동 생성 흐름 사용자동 생성 방식은 실제 프로젝트에서 자주 사용된다.
회원 번호, 게시글 번호, 주문 번호처럼 순서대로 증가하는 값을 기본키로 사용할 때 편리하다.
자동 생성 방식에는 여러 전략이 있다.
대표적으로IDENTITY,SEQUENCE,TABLE,AUTO가 있다.
전략은 어떤 방식으로 기본키 값을 만들지 정하는 방법이다.
4-4. IDENTITY 전략은 기본키 생성을 DB에 맡긴다
IDENTITY전략은 기본키 생성을 데이터베이스에 맡기는 방식이다.
위임한다는 말은 직접 처리하지 않고 다른 대상에게 맡긴다는 뜻이다.
여기서는JPA가 기본키 값을 직접 만드는 것이 아니라 데이터베이스가 기본키 값을 만든다.
MySQL의AUTO_INCREMENT가 대표적인 예이다.
새로운 행이 저장될 때 데이터베이스가 자동으로 다음 번호를 만들어 준다.
아래 예제는IDENTITY전략을 사용하는Entity구조이다.// MemberIdentityKey.java import jakarta.persistence.Entity; import jakarta.persistence.GeneratedValue; import jakarta.persistence.GenerationType; import jakarta.persistence.Id; import jakarta.persistence.Table; @Entity // JPA가 관리할 Entity 클래스 @Table(name = "member_identity_key") // member_identity_key 테이블과 매핑 public class MemberIdentityKey { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.IDENTITY) // DB에 기본키 생성을 맡김 private Long id; private String name; // 회원 이름 protected MemberIdentityKey() { // JPA가 사용할 기본 생성자 } public MemberIdentityKey(String name) { // id 없이 이름만 받아 객체 생성 this.name = name; } }
GenerationType.IDENTITY는 데이터베이스가 기본키를 생성하도록 맡기는 전략이다.
그래서 객체를 만들 때id를 직접 넣지 않는다.
저장 흐름은 아래처럼 볼 수 있다.// IdentityPersistFlow.java MemberIdentityKey member = new MemberIdentityKey("강감찬"); // id 없이 Entity 생성 entityManager.persist(member); // DB가 기본키 값을 만들 수 있도록 저장 요청여기서 중요한 특징이 있다.
보통JPA는commit()시점에insert SQL을 실행할 수 있다.
하지만IDENTITY전략은 데이터베이스에 실제로 저장해야 생성된 기본키 값을 알 수 있다.
그래서persist()시점에insert SQL이 바로 실행될 수 있다.
IDENTITY전략은 기본키 값을 데이터베이스가 만들어 주므로,JPA가 생성된 기본키를 알기 위해persist()시점에insert SQL을 실행할 수 있다.
4-5. SEQUENCE 전략은 DB 시퀀스를 사용한다
SEQUENCE전략은 데이터베이스의 시퀀스를 사용해서 기본키 값을 만든다.
시퀀스는 유일한 값을 순서대로 만들어 주는 데이터베이스 객체이다.
여기서 객체는Java객체가 아니라 데이터베이스 안에 만들어지는 특수한 구조를 의미한다.
Oracle,PostgreSQL,DB2,H2 Database처럼 시퀀스를 지원하는 데이터베이스에서 사용할 수 있다.
MySQL의 일반적인 자동 증가 방식과는 다르게, 시퀀스라는 별도 객체에서 먼저 번호를 받아올 수 있다.
아래 예제는SEQUENCE전략을 사용하는 구조이다.// MemberSequenceKey.java import jakarta.persistence.Entity; import jakarta.persistence.GeneratedValue; import jakarta.persistence.GenerationType; import jakarta.persistence.Id; import jakarta.persistence.SequenceGenerator; import jakarta.persistence.Table; @Entity // JPA가 관리할 Entity 클래스 @Table(name = "member_sequence_key") // member_sequence_key 테이블과 매핑 @SequenceGenerator( name = "MEMBER_SEQ_GENERATOR", // JPA에서 사용할 생성기 이름 sequenceName = "member_seq", // DB 시퀀스 이름 initialValue = 1, // 시작 값 allocationSize = 1 // 한 번에 가져올 증가 크기 ) public class MemberSequenceKey { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.SEQUENCE, generator = "MEMBER_SEQ_GENERATOR") // 시퀀스 전략 사용 private Long id; private String name; // 회원 이름 protected MemberSequenceKey() { // JPA가 사용할 기본 생성자 } public MemberSequenceKey(String name) { // id 없이 이름만 받아 객체 생성 this.name = name; } }
@SequenceGenerator는 어떤 시퀀스를 사용할지 설정한다.
name은JPA코드에서 사용할 생성기 이름이다.
sequenceName은 실제 데이터베이스에 있는 시퀀스 이름이다.
저장 흐름은 아래처럼 볼 수 있다.// SequencePersistFlow.java MemberSequenceKey member = new MemberSequenceKey("유관순"); // id 없이 Entity 생성 entityManager.persist(member); // 시퀀스에서 기본키 값을 얻은 뒤 영속 상태로 관리
SEQUENCE전략은persist()를 호출할 때 먼저 데이터베이스 시퀀스에서 기본키 값을 가져온다.
그다음 가져온 기본키 값을Entity에 넣고,Entity를 영속성 컨텍스트에 저장한다.
이후flush시점에 실제insert SQL이 데이터베이스로 전달될 수 있다.
IDENTITY전략과SEQUENCE전략은 둘 다 자동 생성 방식이지만 내부 동작 시점이 다르다.
IDENTITY는 데이터베이스에 저장해야 기본키를 알 수 있다.
SEQUENCE는 먼저 시퀀스에서 기본키 값을 얻고 나중에 저장할 수 있다.
4-6. TABLE 전략은 키 생성 전용 테이블을 사용한다
TABLE전략은 기본키 값을 만들기 위한 전용 테이블을 사용하는 방식이다.
데이터베이스의 특정 테이블에 다음 기본키 값을 저장해 두고, 필요할 때 그 값을 꺼내 사용하는 구조이다.
이 방식은 데이터베이스가 시퀀스를 지원하지 않아도 비슷한 방식으로 기본키를 만들 수 있다는 장점이 있다.
하지만 기본키를 만들기 위해 별도의 테이블을 조회하고 수정해야 하므로 성능 부담이 생길 수 있다.
아래 예제는TABLE전략의 형태를 보여 준다.// MemberTableKey.java import jakarta.persistence.Entity; import jakarta.persistence.GeneratedValue; import jakarta.persistence.GenerationType; import jakarta.persistence.Id; import jakarta.persistence.Table; import jakarta.persistence.TableGenerator; @Entity // JPA가 관리할 Entity 클래스 @Table(name = "member_table_key") // member_table_key 테이블과 매핑 @TableGenerator( name = "MEMBER_TABLE_GENERATOR", // JPA에서 사용할 생성기 이름 table = "key_generator", // 키 생성 전용 테이블 이름 pkColumnName = "sequence_name", // 키 종류를 구분할 컬럼 valueColumnName = "next_value", // 다음 키 값을 저장할 컬럼 pkColumnValue = "member_key", // 이 Entity에서 사용할 키 이름 allocationSize = 1 // 한 번에 증가시킬 크기 ) public class MemberTableKey { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.TABLE, generator = "MEMBER_TABLE_GENERATOR") // TABLE 전략 사용 private Long id; private String name; // 회원 이름 }
TABLE전략은 기본키 생성을 위한 별도 테이블을 사용한다.
그래서 여러 데이터베이스에서 비슷한 방식으로 사용할 수 있지만, 키 값을 얻기 위해 추가 작업이 필요하다.
처음 배우는 단계에서는TABLE전략을 깊게 외우기보다, 기본키 값을 만들기 위한 별도 테이블을 사용하는 방식이라고 이해하면 된다.
실습에서는 사용하는 데이터베이스와 예제 흐름에 맞춰IDENTITY전략이 더 자주 보일 수 있다.
4-7. AUTO 전략은 DB에 맞는 방식을 자동 선택한다
AUTO전략은 사용하는 데이터베이스와JPA구현체에 맞춰 기본키 생성 방식을 자동으로 선택하는 전략이다.
직접IDENTITY,SEQUENCE,TABLE중 하나를 명시하지 않고 맡기는 방식이다.
아래 예제처럼 사용할 수 있다.// MemberAutoKey.java import jakarta.persistence.Entity; import jakarta.persistence.GeneratedValue; import jakarta.persistence.GenerationType; import jakarta.persistence.Id; import jakarta.persistence.Table; @Entity // JPA가 관리할 Entity 클래스 @Table(name = "member_auto_key") // member_auto_key 테이블과 매핑 public class MemberAutoKey { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.AUTO) // DB와 구현체에 맞는 전략 자동 선택 private Long id; private String name; // 회원 이름 }
AUTO는 편해 보인다.
하지만 어떤 전략이 선택되는지는 데이터베이스와 구현체에 따라 달라질 수 있다.
그래서 학습 단계에서는 자동 선택에만 의존하기보다, 현재 사용하는 데이터베이스에서 어떤 전략이 적절한지 이해하는 것이 좋다.
MySQL에서 자동 증가 기본키를 다룬다면IDENTITY전략을 명시하는 방식이 더 이해하기 쉽다.
자동으로 맡기는 것보다 코드에 의도가 드러나기 때문이다.
4-8. 직접 할당과 자동 생성 흐름 비교하기
지금까지 본 내용을 정리하면 기본키 매핑은 “누가 기본키 값을 정하는가”로 나눌 수 있다.
직접 할당 방식에서는 개발자가 기본키 값을 넣는다.
자동 생성 방식에서는 데이터베이스나JPA가 기본키 값을 만든다.
직접 할당 방식은 아래처럼 기본키 값을 직접 넣는다.// DirectKeySummary.java MemberDirectKey member = new MemberDirectKey(1L, "홍길동"); // 개발자가 기본키 1L 지정 entityManager.persist(member); // 저장 요청이 방식은 기본키 값이 코드에 직접 보인다.
하지만 중복되지 않도록 개발자가 관리해야 한다.
자동 생성 방식은 아래처럼 기본키 값을 넣지 않는다.// IdentityKeySummary.java MemberIdentityKey member = new MemberIdentityKey("이순신"); // id 없이 Entity 생성 entityManager.persist(member); // DB가 기본키를 생성하는 흐름이 방식은 기본키 값을 개발자가 직접 관리하지 않아도 된다.
하지만 어떤 전략을 사용하는지에 따라SQL실행 시점이나 동작 방식이 달라질 수 있다.
비교하면 아래와 같다.
- 직접 할당: 개발자가 기본키 값을 직접 넣는다.
IDENTITY: 데이터베이스가 기본키 값을 만든다.SEQUENCE: 데이터베이스 시퀀스에서 기본키 값을 가져온다.TABLE: 키 생성 전용 테이블에서 기본키 값을 관리한다.AUTO: 데이터베이스와 구현체에 맞춰 전략을 자동 선택한다.기본키 매핑에서 중요한 것은 어노테이션을 외우는 것이 아니라, 기본키 값을 누가 언제 만들어 주는지 이해하는 것이다.
기본키는JPA가Entity를 구분하는 기준이다.
이제 기본키를 직접 넣는 방식과 자동 생성하는 방식을 이해했으므로, 다음 단계에서는Entity를 실제로 관리하는EntityManagerFactory와EntityManager를 볼 수 있다.
5. EntityManagerFactory와 EntityManager 이해하기
JPA에서Entity를 실제로 다루려면 핵심 객체 두 개를 이해해야 한다.
하나는EntityManagerFactory이고, 다른 하나는EntityManager이다.
이름이 비슷해서 처음에는 헷갈릴 수 있지만 역할은 완전히 다르다.
EntityManagerFactory는EntityManager를 만드는 공장 역할을 한다.
EntityManager는Entity를 저장, 조회, 수정, 삭제하는 실제 작업 객체이다.
즉, 하나는 만드는 역할이고, 하나는 사용하는 역할이다.
EntityManagerFactory는EntityManager를 만들고,EntityManager는 영속성 컨텍스트를 통해Entity를 실제로 관리한다.
5-1. EntityManagerFactory는 EntityManager를 만드는 공장이다
EntityManagerFactory에서Factory는 공장이라는 뜻이다.
공장은 직접 물건을 사용하는 곳이 아니라, 필요한 물건을 만들어 내는 곳이다.
EntityManagerFactory도 마찬가지이다.
직접Entity를 저장하고 조회하는 객체라기보다, 실제 작업에 사용할EntityManager를 만들어 주는 객체이다.
아래 코드는EntityManagerFactory를 만들고, 그 공장에서EntityManager를 만드는 흐름이다.// EntityManagerFactoryCreateFlow.java EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // EntityManagerFactory 생성 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성
Persistence.createEntityManagerFactory("entitytest")는EntityManagerFactory를 생성하는 코드이다.
여기서"entitytest"는 이미 준비된JPA설정 묶음의 이름이다.
이 글에서는 세팅을 다시 다루지 않으므로, “JPA실행에 필요한 설정 이름을 넘겨 공장을 만든다” 정도로 이해하면 된다.
그다음factory.createEntityManager()를 호출한다.
이 코드가 실제 작업 객체인EntityManager를 만든다.
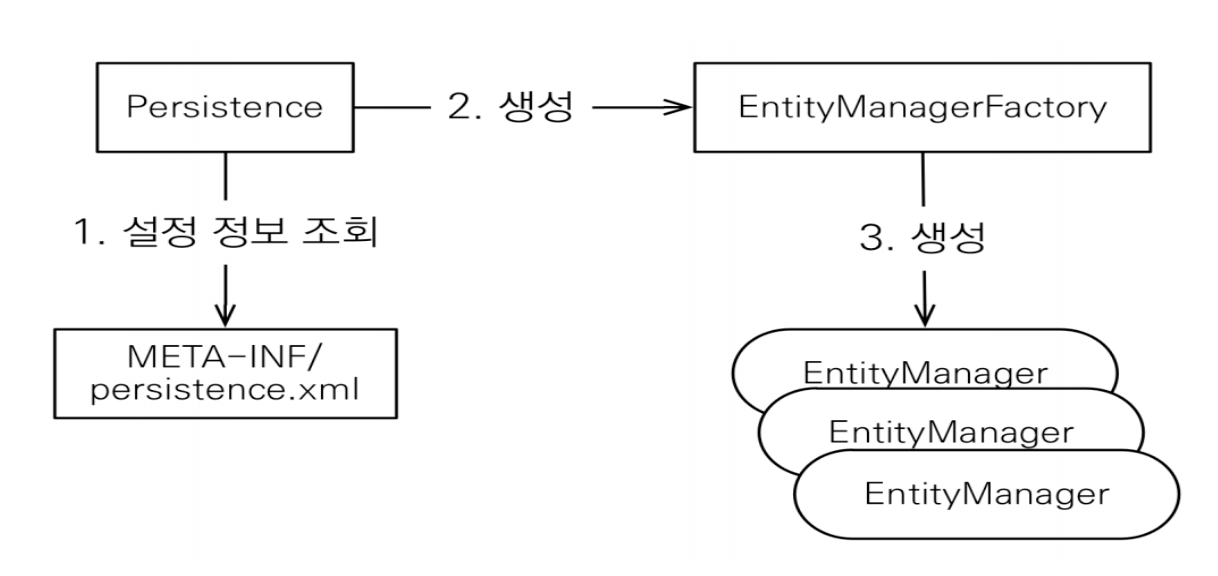
따라서 흐름은Persistence→EntityManagerFactory→EntityManager순서로 이어진다.
Persistence를 통해EntityManagerFactory가 만들어지고,EntityManagerFactory는 여러EntityManager를 생성할 수 있다.
실제 엔티티 저장, 조회, 수정, 삭제 작업은 생성된EntityManager가 담당한다.
이 구조를 보면 왜EntityManagerFactory라는 이름이 붙었는지 이해할 수 있다.
EntityManagerFactory는EntityManager를 직접 대신하는 객체가 아니다.
EntityManager를 만들어 내는 출발점이다.
5-2. EntityManagerFactory는 애플리케이션에서 한 번 생성해 공유한다
EntityManagerFactory는 생성 비용이 큰 객체이다.
생성 비용이 크다는 말은 객체 하나를 만들기 위해 내부적으로 많은 준비 작업이 필요하다는 뜻이다.
JPA설정 정보를 읽고,Entity매핑 정보를 분석하고, 데이터베이스와 연결할 준비를 한다.
그래서EntityManagerFactory는 작업할 때마다 계속 새로 만들지 않는다.
보통 애플리케이션이 시작될 때 한 번 만들고, 애플리케이션 전체에서 공유해서 사용한다.
아래처럼 저장 작업을 할 때마다EntityManagerFactory를 새로 만드는 흐름은 좋지 않다.// EntityManagerFactoryBadFlow.java public void saveMember() { EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // 매번 생성하면 부담이 큼 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 }이 코드는 저장 메서드가 호출될 때마다
EntityManagerFactory를 다시 만든다.
EntityManagerFactory는 가볍게 만들고 버리는 객체가 아니기 때문에 이런 흐름은 피하는 것이 좋다.
더 자연스러운 흐름은 아래처럼 한 번 만든EntityManagerFactory에서 필요한 만큼EntityManager를 만드는 것이다.// EntityManagerFactoryReuseFlow.java EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // 애플리케이션 시작 시 한 번 생성 EntityManager entityManager1 = factory.createEntityManager(); // 첫 번째 작업용 EntityManager EntityManager entityManager2 = factory.createEntityManager(); // 두 번째 작업용 EntityManager
EntityManagerFactory는 여러EntityManager를 만들 수 있다.
그리고EntityManagerFactory자체는 여러 스레드에서 함께 사용해도 안전하다.
스레드는 프로그램 안에서 실행되는 작업 흐름이다.
웹 애플리케이션에서는 여러 사용자의 요청이 동시에 처리될 수 있기 때문에 여러 스레드가 같은 객체를 사용할 수 있다.
정리하면 아래와 같다.
EntityManagerFactory는 생성 비용이 크다.- 보통 애플리케이션에서 한 번만 만든다.
- 여러 스레드가 함께 사용해도 안전하다.
- 실제 작업 객체인
EntityManager를 생성한다.
EntityManagerFactory는 오래 공유하는 공장 객체이고, 매 작업마다 새로 만드는 객체가 아니다.
5-3. EntityManager는 Entity를 실제로 관리하는 객체이다
EntityManager는Entity를 실제로 관리하는 객체이다.
저장, 조회, 삭제 같은 작업은EntityManager를 통해 진행된다.
수정도EntityManager가 관리하는 영속성 컨텍스트 안에서 변경 감지로 처리된다.
아래 코드는EntityManager가 자주 사용하는 대표 메서드의 흐름이다.
여기서는 전체 실행 코드를 완성하는 것이 아니라, 각 메서드가 어떤 역할을 하는지 먼저 확인한다.// EntityManagerMethodFlow.java MemberEntityComplete member = new MemberEntityComplete(2L, "저장회원"); // 저장할 Entity 생성 MemberEntityComplete findMember = entityManager.find(MemberEntityComplete.class, 1L); // 기본키로 Entity 조회 entityManager.persist(member); // Entity 저장 요청, 실제 변경 작업은 Transaction 안에서 처리 if (findMember != null) { // 조회 결과가 있을 때만 삭제 요청 entityManager.remove(findMember); // Entity 삭제 요청, 실제 변경 작업은 Transaction 안에서 처리 } entityManager.flush(); // 변경 내용을 DB에 반영, 일반적으로 Transaction 안에서 사용
find()는 기본키로Entity를 조회한다.
persist()는Entity를 저장 대상으로 관리하게 만든다.
remove()는Entity를 삭제 대상으로 만든다.
flush()는 영속성 컨텍스트의 변경 내용을DB에 반영하는 과정이다.
persist()와remove()는 데이터베이스 상태를 바꾸는 작업과 연결된다.
그래서 실제 저장과 삭제는 뒤에서 볼Transaction안에서 처리해야 한다.
flush()도 영속성 컨텍스트의 변경 내용을 데이터베이스로 보내는 과정이므로, 일반적으로 변경 작업을 처리하는Transaction안에서 사용한다.
여기서는EntityManager가 어떤 메서드로Entity를 다루는지만 먼저 확인하는 단계이다.
여기서 중요한 점은EntityManager가 단순히SQL실행 메서드만 모아 둔 객체가 아니라는 것이다.
EntityManager는 내부적으로 영속성 컨텍스트를 사용한다.
영속성 컨텍스트는Entity객체를 보관하고, 같은 객체인지 확인하고, 변경 내용을 추적하는 관리 공간이다.
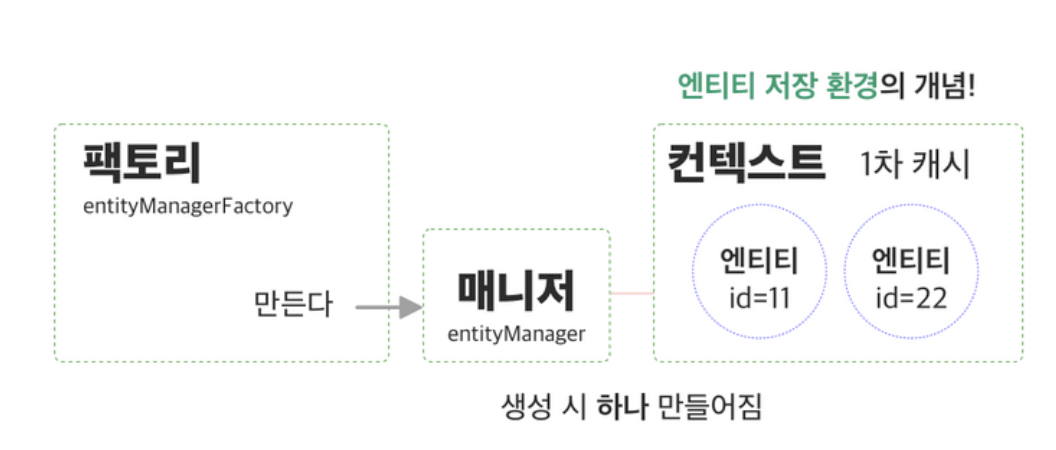
EntityManagerFactory가EntityManager를 만들고,EntityManager가 생성되면 엔티티를 관리하는 영속성 컨텍스트가 함께 사용된다.
영속성 컨텍스트 안에는1차 캐시가 있으며, 조회하거나 저장한 엔티티 객체가 이 공간에서 관리된다.
EntityManager가Entity를 관리한다는 말은 결국 영속성 컨텍스트를 통해 관리한다는 뜻이다.
그래서EntityManager를 이해하면 뒤에서 나오는1차 캐시, 쓰기 지연, 변경 감지 같은 개념도 자연스럽게 이어진다.
5-4. EntityManager는 여러 스레드가 공유하면 안 된다
EntityManagerFactory는 여러 스레드가 공유해도 안전하다.
하지만EntityManager는 여러 스레드가 공유하면 안 된다.
두 객체의 가장 중요한 차이 중 하나이다.
이유는EntityManager가 실제 엔티티 상태를 관리하기 때문이다.
EntityManager내부에는 영속성 컨텍스트가 있고, 이 안에는 현재 관리 중인Entity객체들이 들어간다.
여러 스레드가 같은EntityManager를 동시에 사용하면 서로의 작업 상태가 섞일 수 있다.
아래 코드는 실제 실행용 예제가 아니라, 공유하면 안 되는 상황을 보여 주는 개념 예시이다.// EntityManagerShareBadFlow.java EntityManager sharedEntityManager = factory.createEntityManager(); // 공유하면 안 되는 EntityManager // 여러 요청이나 여러 작업 흐름이 같은 EntityManager를 함께 사용하면 위험하다 // EntityManager 안의 영속성 컨텍스트 상태가 서로 섞일 수 있기 때문이다같은
EntityManager를 여러 작업 흐름이 동시에 사용하면, 어떤Entity가 어떤 작업의 대상인지 꼬일 수 있다.
그래서EntityManager는 공유용으로 만들어 두고 여러 요청이 함께 쓰는 방식으로 사용하면 안 된다.
올바른 흐름은 작업 단위마다EntityManager를 따로 만들고, 작업이 끝나면 닫는 것이다.// EntityManagerWorkUnitFlow.java EntityManager entityManager = factory.createEntityManager(); // 작업 단위 EntityManager 생성 try { // Entity 저장, 조회, 수정, 삭제 작업 수행 } finally { entityManager.close(); // 작업이 끝나면 닫기 }이렇게 하면 각 작업이 자기
EntityManager와 자기 영속성 컨텍스트를 사용한다.
작업 상태가 다른 작업과 섞이지 않는다.
정리하면 아래와 같다.
EntityManagerFactory는 공유해도 된다.EntityManager는 공유하면 안 된다.EntityManager는 작업 단위마다 만들고 닫는다.공장은 공유할 수 있지만, 실제 작업 도구는 작업 단위마다 따로 사용한다고 이해하면 된다.
5-5. EntityManagerFactory와 EntityManager의 차이
EntityManagerFactory와EntityManager는 이름이 비슷하지만 역할이 다르다.
EntityManagerFactory는EntityManager를 만드는 객체이다.
EntityManager는Entity를 실제로 다루는 객체이다.
차이를 코드 흐름으로 보면 더 명확하다.// EntityManagerFactoryAndEntityManagerFlow.java EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // 공장 생성 EntityManager entityManager = factory.createEntityManager(); // 작업 객체 생성 MemberEntityComplete member = new MemberEntityComplete(1L, "홍길동"); // 저장할 Entity 생성 entityManager.persist(member); // Entity 작업은 EntityManager가 담당, 실제 저장은 Transaction 안에서 처리첫 번째 줄에서는
EntityManagerFactory를 만든다.
두 번째 줄에서는 그 공장에서EntityManager를 만든다.
마지막으로Entity작업은entityManager.persist(member)처럼EntityManager를 통해 요청한다.
다만 실제 저장처럼 데이터베이스 상태가 바뀌는 작업은Transaction안에서 처리해야 한다.
이 흐름을 보면EntityManagerFactory와EntityManager를 같은 역할로 보면 안 된다는 것을 알 수 있다.
EntityManagerFactory는 준비와 생성의 중심이고,EntityManager는 실제 작업의 중심이다.
비교하면 아래와 같다.
EntityManagerFactory는 애플리케이션에서 보통 한 번 만든다.EntityManagerFactory는 여러 스레드가 공유해도 안전하다.EntityManagerFactory는EntityManager를 생성한다.EntityManager는Entity를 저장, 조회, 수정, 삭제한다.EntityManager는 여러 스레드가 공유하면 안 된다.EntityManager는 작업이 끝나면 닫는다.이 차이를 이해해야
JPA코드의 기본 구조가 보인다.
먼저 공장을 만들고, 공장에서 작업 객체를 만들고, 작업 객체가 엔티티를 다룬다.
5-6. close를 호출해야 하는 이유
close()는 사용한 자원을 정리하는 메서드이다.
JPA관련 객체는 내부적으로 데이터베이스 연결이나 영속성 컨텍스트 같은 자원을 사용할 수 있다.
사용이 끝난 뒤에는 정리해야 한다.
특히EntityManager는 작업 단위마다 만들고 닫는 흐름을 가져야 한다.
작업이 끝났는데도 닫지 않으면 불필요한 자원이 남을 수 있다.
그리고 닫힌EntityManager는 다시 사용하면 안 된다.
아래처럼 작업이 끝난 뒤EntityManager를 닫는다.// EntityManagerCloseFlow.java EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 try { MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 1L); // Entity 조회 } finally { entityManager.close(); // EntityManager 자원 정리 }
finally는 예외가 발생해도 마지막에 실행되는 구간이다.
데이터베이스 관련 자원은 오류가 발생하더라도 정리되어야 하므로,close()를finally에서 호출하는 흐름이 자주 사용된다.
EntityManagerFactory도 마지막에는 닫아야 한다.
다만EntityManagerFactory는 애플리케이션 전체에서 오래 사용하는 객체이므로 보통 애플리케이션 종료 시점에 닫는다.
지금처럼main()메서드로 실습하는 예제에서는 프로그램이 짧게 끝나기 때문에 마지막에 함께 닫아 준다.// EntityManagerFactoryCloseFlow.java entityManager.close(); // EntityManager 자원 정리 factory.close(); // EntityManagerFactory 자원 정리정리하면 아래와 같다.
EntityManager는 작업이 끝나면 닫는다.- 닫힌
EntityManager는 다시 사용하지 않는다.EntityManagerFactory는 애플리케이션 종료 시점에 닫는다.- 실습용
main()코드에서는 마지막에factory.close()까지 호출한다.초보자는 기능이 실행되는 코드에만 집중하기 쉽다.
하지만 데이터베이스와 연결되는 코드는 사용한 자원을 정리하는 흐름까지 함께 봐야 한다.
5-7. 생성부터 정리까지 흐름 한 번에 보기
지금까지 본 내용을 하나로 연결하면
EntityManagerFactory와EntityManager의 기본 사용 흐름이 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라, 공장 생성 → 작업 객체 생성 → 작업 수행 → 자원 정리 흐름을 한 번에 확인하는 마무리이다.
// EntityManagerLifecycleFlow.java
package jpaexam1.app;

import jakarta.persistence.EntityManager;
import jakarta.persistence.EntityManagerFactory;
import jakarta.persistence.Persistence;

public class EntityManagerLifecycleFlow {
    public static void main(String[] args) {
        EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // EntityManagerFactory 생성
        EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성

        try {
            System.out.println("EntityManagerFactory 생성 완료"); // 공장 생성 확인
            System.out.println("EntityManager 생성 완료"); // 작업 객체 생성 확인
        } finally {
            entityManager.close(); // EntityManager 자원 정리
            factory.close(); // EntityManagerFactory 자원 정리
        }
    }
}
// 출력결과 // EntityManagerFactory 생성 완료 // EntityManager 생성 완료이 코드는 데이터를 저장하거나 조회하지 않는다.
목표는EntityManagerFactory와EntityManager가 어떤 순서로 만들어지고 정리되는지 확인하는 것이다.
흐름은 단순하다.
먼저Persistence.createEntityManagerFactory("entitytest")로EntityManagerFactory를 만든다.
그다음factory.createEntityManager()로EntityManager를 만든다.
마지막으로close()를 호출해 사용한 자원을 정리한다.
이 구조는 앞으로 나오는 저장, 조회, 수정, 삭제 예제의 기본 틀이 된다.
데이터 작업을 하려면 먼저EntityManager가 필요하고,EntityManager는EntityManagerFactory에서 만들어진다.
6. Transaction 이해하기
Transaction은 데이터베이스 변경 작업을 하나의 작업 단위로 묶는 기능이다.
작업 단위라는 말은 여러 작업을 따로따로 확정하지 않고, 하나의 흐름으로 함께 처리한다는 뜻이다.
데이터를 저장하거나 수정하거나 삭제하는 과정에서는 중간에 오류가 날 수 있다.
이때 일부 작업만 데이터베이스에 반영되고 나머지는 실패하면 데이터가 어긋날 수 있다.
그래서 성공하면 전체를 확정하고, 실패하면 전체를 되돌리는 기준이 필요하다.
Transaction은 데이터 변경 작업을 안전하게 처리하기 위해 시작, 확정, 되돌리기 흐름을 관리하는 단위이다.
6-1. Transaction은 데이터 변경 작업을 묶는 단위이다
Transaction은 데이터베이스 작업의 시작과 끝을 정해 준다.
작업을 시작하고, 문제가 없으면 확정하고, 문제가 생기면 되돌린다.
예를 들어 회원을 저장한다고 생각해 보자.
회원 객체를 만들고, 저장 요청을 하고, 데이터베이스에 반영해야 한다.
이 과정이 정상적으로 끝나면 저장을 확정한다.
중간에 오류가 나면 저장을 취소해야 한다.
이런 흐름을 하나로 묶는 것이Transaction이다.
JPA에서는EntityTransaction을 사용해서Transaction을 제어할 수 있다.// TransactionBasicFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 // 저장, 수정, 삭제 같은 데이터 변경 작업 수행 transaction.commit(); // Transaction 확정
entityManager.getTransaction()은 현재EntityManager에서 사용할Transaction객체를 가져오는 코드이다.
begin()은 작업 시작이고,commit()은 작업 확정이다.
이 구조를 처음 볼 때는 어렵게 느껴질 수 있다.
하지만 핵심은 단순하다.
데이터를 바꾸는 작업은 시작하고, 작업하고, 성공하면 확정하는 흐름 안에서 처리한다.
6-2. begin은 Transaction 시작이다
begin()은Transaction을 시작하는 메서드이다.
저장, 수정, 삭제처럼 데이터베이스 상태를 바꾸는 작업을 하기 전에 호출한다.// TransactionBeginFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // 데이터 변경 작업 시작
begin()을 호출하면 이제부터 하나의 작업 단위가 시작된다.
이 안에서persist(),remove()같은 데이터 변경 작업을 수행할 수 있다.
조회는 상황에 따라Transaction없이도 가능할 수 있다.
하지만 저장, 수정, 삭제는 데이터베이스 상태를 바꾸는 작업이다.
그래서 반드시Transaction안에서 처리하는 흐름으로 이해해야 한다.
아래처럼begin()없이 저장 요청만 하는 흐름은 올바른 전체 흐름이 아니다.// TransactionMissingBadFlow.java MemberEntityComplete member = new MemberEntityComplete(3L, "트랜잭션없음"); // 저장할 Entity 생성 entityManager.persist(member); // Transaction 없이 저장 요청하면 잘못된 흐름이 코드는
Entity저장 요청만 보여 준다.
하지만 실제 저장 작업은 데이터베이스 상태를 바꾸므로Transaction안에서 처리해야 한다.
따라서 저장 흐름은 아래처럼begin()이후에 들어가야 한다.// TransactionBeginPersistFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(3L, "트랜잭션저장"); // 저장할 Entity 생성 entityManager.persist(member); // Transaction 안에서 저장 요청이제 저장 요청은
Transaction이 시작된 뒤에 수행된다.
이후 문제가 없으면commit()으로 작업을 확정한다.
6-3. commit은 작업 확정이다
commit()은Transaction안에서 수행한 작업을 확정하는 메서드이다.
정상적으로 작업이 끝났다면commit()을 호출한다.// TransactionCommitFlow.java transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(4L, "커밋회원"); // 저장할 Entity 생성 entityManager.persist(member); // 저장 요청 transaction.commit(); // 저장 작업 확정
persist()는 저장 요청이다.
그리고commit()은 그 요청을 최종 확정하는 단계이다.
여기서 중요한 점은commit()이 단순히 코드의 끝을 표시하는 메서드가 아니라는 것이다.
commit()과정에서는 영속성 컨텍스트의 변경 내용이 데이터베이스에 반영될 수 있다.
이때flush가 자동으로 호출된다.
flush는 영속성 컨텍스트에 모아 둔 변경 내용을 데이터베이스로 보내는 과정이다.
즉,commit()은Transaction을 확정하는 과정이고, 그 전에 변경 내용을 데이터베이스에 맞추기 위해flush가 일어날 수 있다.
commit()은 성공한 데이터 변경 작업을 데이터베이스에 최종 확정하는 단계이다.
6-4. rollback은 작업 되돌리기이다
rollback()은 작업을 되돌리는 메서드이다.
Transaction안에서 오류가 발생하면 변경 내용을 확정하면 안 된다.
이때rollback()을 호출해서 진행 중이던 작업을 취소한다.
오류가 발생했을 때는 현재Transaction이 아직 진행 중인지 확인한 뒤 되돌리는 흐름이 안전하다.
이미 끝난Transaction에 다시rollback()을 호출하는 상황을 피할 수 있기 때문이다.// TransactionRollbackFlow.java try { transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(5L, "롤백회원"); // 저장할 Entity 생성 entityManager.persist(member); // 저장 요청 transaction.commit(); // 정상 처리 시 확정 } catch (Exception e) { if (transaction.isActive()) { // Transaction이 아직 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } }
try-catch는 오류가 발생할 수 있는 코드를 안전하게 처리하기 위한 문법이다.
try안에는 정상적으로 실행할 코드를 넣는다.
실행 중 오류가 발생하면catch로 이동한다.
transaction.isActive()는Transaction이 현재 진행 중인지 확인하는 메서드이다.
진행 중인Transaction이 있을 때만rollback()을 호출하면 더 안전하다.
rollback()을 호출하면 아직 확정되지 않은 작업을 취소한다.
그래서 데이터가 어중간하게 반영되는 상황을 막을 수 있다.
commit()은 성공한 작업을 확정하고,rollback()은 실패한 작업을 되돌린다.
6-5. 저장, 수정, 삭제는 Transaction 안에서 처리해야 한다
JPA에서 저장, 수정, 삭제는 데이터가 바뀌는 작업이다.
이런 작업은 반드시Transaction안에서 처리해야 한다.
저장은persist()로 요청한다.
수정은 영속 상태의Entity값을 변경해서 처리한다.
삭제는remove()로 요청한다.
이 작업들은 모두 데이터베이스 상태를 바꿀 수 있다.
먼저 저장 흐름은 아래처럼 볼 수 있다.// TransactionPersistFlow.java transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(6L, "저장회원"); // 저장할 Entity 생성 entityManager.persist(member); // 저장 요청 transaction.commit(); // 저장 확정저장은 새
Entity객체를 만들고persist()로 저장 요청을 한다.
그 작업은Transaction안에서 처리하고, 마지막에commit()으로 확정한다.
수정 흐름은 아래처럼 볼 수 있다.// TransactionUpdateFlow.java transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 6L); // 수정할 Entity 조회 // member.changeName("수정회원"); // 영속 상태 Entity 값 변경이라고 가정 transaction.commit(); // 변경 감지 후 수정 확정수정은 별도의
update()메서드를 호출하는 방식이 아니다.
영속 상태의Entity값을 바꾸면,JPA가 나중에 변경을 감지할 수 있다.
이 내용은 뒤에서 변경 감지를 볼 때 더 자세히 연결된다.
삭제 흐름은 아래처럼 볼 수 있다.// TransactionRemoveFlow.java transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 6L); // 삭제할 Entity 조회 if (member != null) { // 조회 결과가 있을 때만 삭제 요청 entityManager.remove(member); // 삭제 요청 } transaction.commit(); // 삭제 확정삭제는 먼저 삭제할
Entity를 조회하고, 조회 결과가 있을 때remove()를 호출하는 흐름으로 보면 안전하다.
조회 결과가 없는데 삭제 요청을 하려고 하면 흐름이 어색해질 수 있기 때문이다.
정리하면 아래와 같다.
- 저장은
persist()를Transaction안에서 처리한다.- 수정은 영속 상태
Entity의 값을Transaction안에서 변경한다.- 삭제는
remove()를Transaction안에서 처리한다.데이터베이스 상태를 바꾸는 저장, 수정, 삭제는
Transaction안에서 처리하고commit()으로 확정해야 한다.
6-6. try, catch, finally로 안전한 Transaction 흐름 만들기
Transaction코드는 정상 흐름만 생각하면 부족하다.
데이터베이스 작업은 중간에 오류가 발생할 수 있기 때문에 실패 흐름까지 함께 잡아야 한다.
그래서 보통try,catch,finally구조를 사용한다.
try에는 정상적으로 실행할 코드를 넣는다.
catch에는 오류가 발생했을 때 처리할 코드를 넣는다.
finally에는 오류 여부와 상관없이 마지막에 실행할 정리 코드를 넣는다.
기본 구조는 아래와 같다.// TransactionTryCatchFinallyFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 try { transaction.begin(); // Transaction 시작 // 저장, 수정, 삭제 같은 데이터 변경 작업 수행 transaction.commit(); // 정상 처리 시 확정 } catch (Exception e) { if (transaction.isActive()) { // Transaction 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } e.printStackTrace(); // 오류 내용 출력 } finally { entityManager.close(); // EntityManager 자원 정리 }이 구조의 핵심은 세 가지이다.
정상 실행이면commit()으로 확정한다.
오류가 나면 진행 중인Transaction을rollback()으로 되돌린다.
마지막에는close()로 사용한 자원을 정리한다.
finally에서close()를 호출하는 이유는 오류가 나도 자원을 정리해야 하기 때문이다.
데이터베이스 작업에서는 실행 성공 여부만큼 자원 정리도 중요하다.
6-7. Transaction 전체 흐름 한 번에 보기
지금까지 본 내용을 하나로 연결하면
Transaction의 기본 사용 흐름이 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라,begin()→ 작업 →commit()→ 오류 시rollback()→ 자원 정리 흐름을 한 번에 확인하는 마무리이다.// TransactionLifecycleFlow.java package jpaexam1.app; import jakarta.persistence.EntityManager; import jakarta.persistence.EntityManagerFactory; import jakarta.persistence.EntityTransaction; import jakarta.persistence.Persistence; import jpaexam1.entity.MemberEntityComplete; public class TransactionLifecycleFlow { public static void main(String[] args) { EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // EntityManagerFactory 생성 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 EntityTransaction transaction = entityManager.getTransaction(); // Transaction 가져오기 try { transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(7L, "트랜잭션회원"); // 저장할 Entity 생성 entityManager.persist(member); // 저장 요청 transaction.commit(); // 정상 처리 시 확정 System.out.println("Transaction 저장 완료"); // 결과 확인 } catch (Exception e) { if (transaction.isActive()) { // Transaction 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } e.printStackTrace(); // 오류 출력 } finally { entityManager.close(); // EntityManager 닫기 factory.close(); // EntityManagerFactory 닫기 } } }// 출력결과 // Transaction 저장 완료이 예제에서 중요한 부분은
transaction.begin()과transaction.commit()사이에entityManager.persist(member)가 들어간다는 점이다.
저장 작업은 데이터베이스 상태를 바꾸므로Transaction안에서 처리한다.
직접 할당 기본키를 사용하는 예제이므로 같은 코드를 여러 번 실행하면 기본키 중복 오류가 발생할 수 있다.
다시 실행하려면 기본키 값을 바꾸거나 기존 데이터를 삭제해야 한다.
오류가 발생하면catch로 이동한다.
이때transaction.isActive()로 아직 진행 중인지 확인하고, 진행 중이라면rollback()으로 되돌린다.
마지막에는finally에서entityManager.close()와factory.close()를 호출해 자원을 정리한다.
Transaction의 기본 흐름은 시작하고, 작업하고, 성공하면 확정하고, 실패하면 되돌리고, 마지막에 자원을 정리하는 것이다.
이 흐름이 잡히면 뒤에서 영속성 컨텍스트의flush, 쓰기 지연, 변경 감지를 볼 때도 코드 실행 순서가 훨씬 쉽게 보인다.
7. 영속성 컨텍스트 이해하기
영속성 컨텍스트는
EntityManager가Entity를 관리하는 공간이다.
영속성은 데이터를 계속 유지한다는 뜻이고, 컨텍스트는 어떤 대상을 관리하는 환경이나 공간이라고 이해하면 된다.
즉, 영속성 컨텍스트는EntityManager가Entity객체를 보관하고, 조회하고, 변경을 추적하는 핵심 공간이다.
JPA에서는 객체를 만들었다고 해서 바로 데이터베이스와 연결되는 것이 아니다.
객체가EntityManager의 관리 대상이 되어야JPA의 관리 흐름 안에 들어온다.
이때 객체가 영속성 컨텍스트에 저장된다고 표현한다.
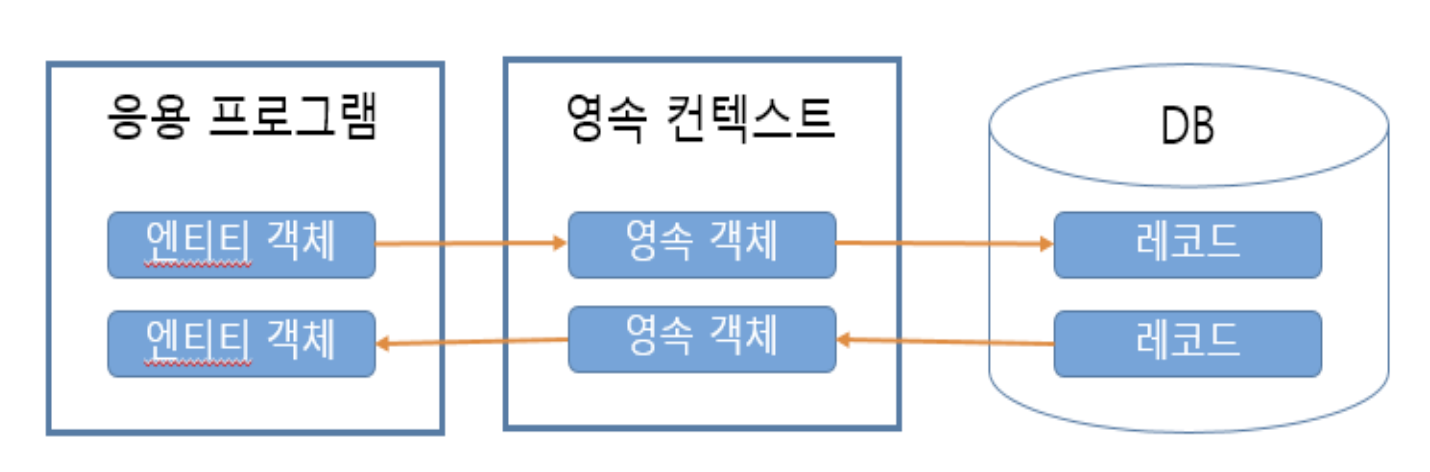
애플리케이션에서 만든 엔티티 객체는 바로 데이터베이스로 이동하지 않는다.
먼저 영속성 컨텍스트 안에서 관리 대상이 되고, 필요한 시점에 데이터베이스와 연결된다.
그래서 영속성 컨텍스트를 이해해야persist(),find(),flush(),commit()의 흐름이 자연스럽게 보인다.
영속성 컨텍스트는JPA가Entity를 관리하고, 변경을 감지하고, 데이터베이스 반영 시점을 조절하는 핵심 공간이다.
7-1. 영속성 컨텍스트는 EntityManager가 Entity를 관리하는 공간이다
EntityManager는Entity를 실제로 다루는 객체이다.
하지만EntityManager가Entity를 다룬다는 말은 단순히 메서드만 호출한다는 뜻이 아니다.
EntityManager는 내부적으로 영속성 컨텍스트를 사용하고, 그 공간 안에서Entity객체를 관리한다.
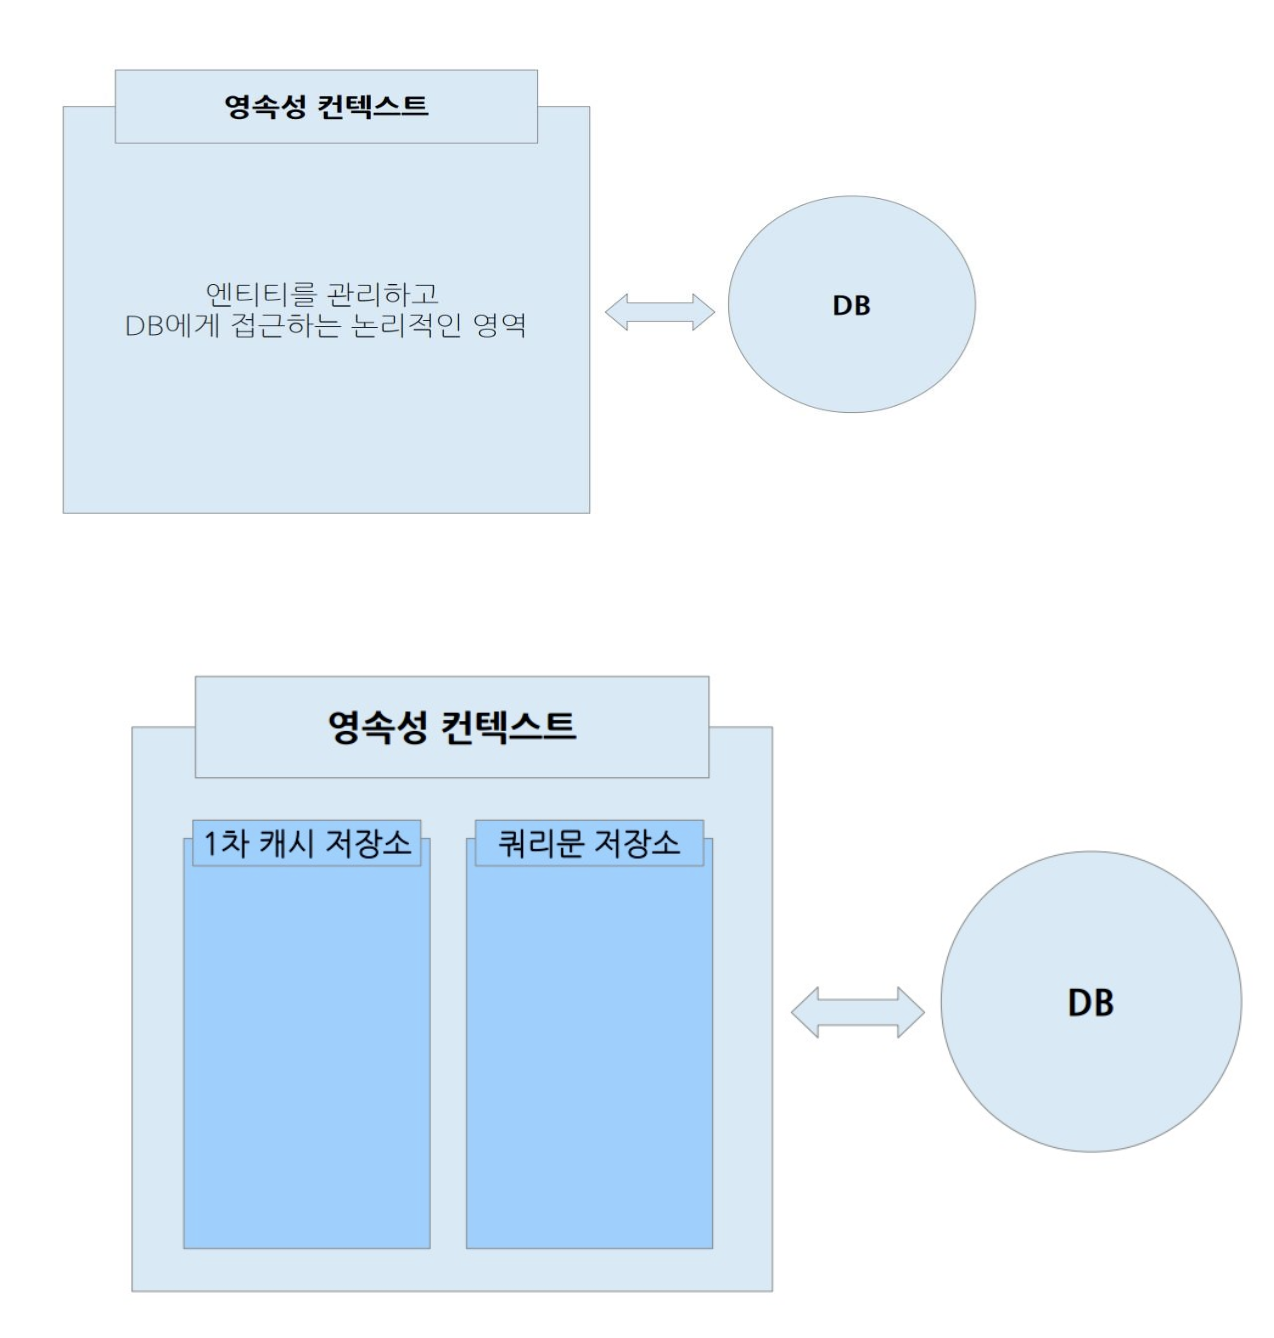
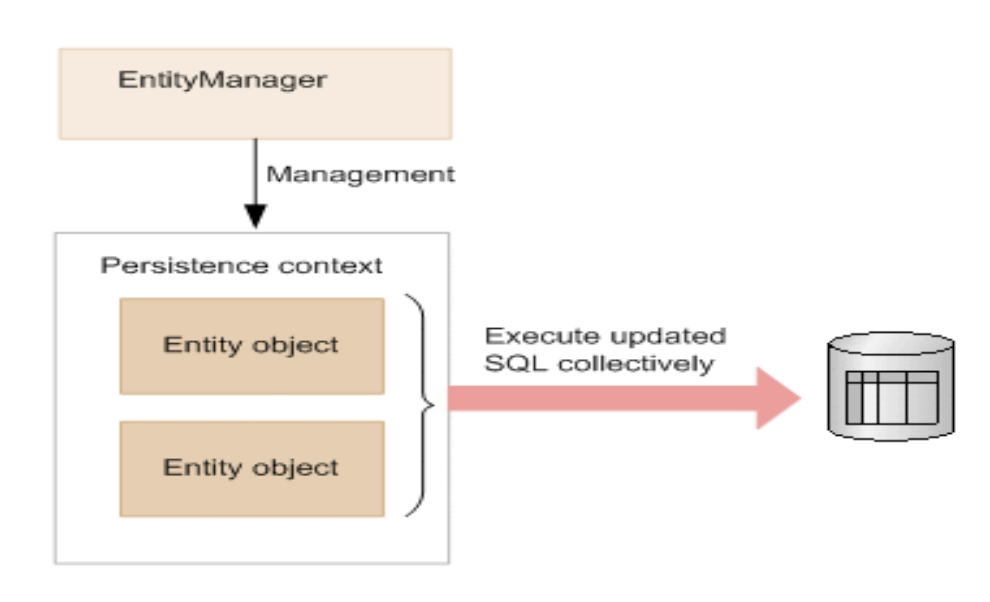
영속성 컨텍스트는 애플리케이션과
DB사이에서 엔티티를 관리하는 논리적인 공간이다.
애플리케이션이 만든 엔티티 객체는 이 공간에 들어가면JPA의 관리 대상이 된다.
이후 영속성 컨텍스트에 모인 변경 내용은 필요한 시점에 데이터베이스와 맞춰진다.
동기화는 서로의 상태를 맞춘다는 뜻이다.
JPA에서는 영속성 컨텍스트에 있는 엔티티 상태와 데이터베이스 상태를 맞추는 흐름을 의미한다.
이때 중요한 메서드가flush()이다.
flush()는 영속성 컨텍스트의 변경 내용을 데이터베이스로 보내는 과정이다.
먼저 객체만 만든 상태를 보자.// NewEntityBeforePersist.java MemberEntityComplete member = new MemberEntityComplete(8L, "영속성회원"); // 아직 JPA가 관리하지 않는 Entity 객체이 객체는 아직
JPA가 관리하지 않는다.
단순히Java메모리에 만들어진 객체이다.
이 상태에서는 값을 바꿔도 영속성 컨텍스트가 변경을 추적하지 않는다.
이제persist()를 호출하면 흐름이 달라진다.
저장 작업은 데이터베이스 상태를 바꾸는 작업과 연결되므로 실제 흐름에서는Transaction안에서 처리해야 한다.// PersistToPersistenceContext.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(8L, "영속성회원"); // 비영속 상태의 Entity 객체 entityManager.persist(member); // 영속성 컨텍스트에 관리 대상으로 등록 transaction.commit(); // flush 후 저장 확정
persist()를 호출하면member객체가 영속성 컨텍스트의 관리 대상이 된다.
이제EntityManager가 이 객체를 관리할 수 있다.
여기서 초보자가 가장 많이 오해하는 부분이 있다.
persist()는 무조건 그 순간 데이터베이스에 바로 저장한다는 뜻이 아니다.
정확히는 비영속 상태의Entity를 영속성 컨텍스트의 관리 대상으로 등록하는 메서드이다.
다만 기본키 생성 전략에 따라 예외적인 흐름이 있을 수 있다.
예를 들어IDENTITY전략은 데이터베이스가 기본키를 만들어 주기 때문에, 기본키 값을 알기 위해persist()시점에insert SQL이 먼저 실행될 수 있다.
이 부분은 기본키 매핑에서 본 내용과 함께 이해하면 된다.
7-2. EntityManager 하나는 자기 영속성 컨텍스트를 사용한다
영속성 컨텍스트는
EntityManager를 통해 접근한다.
지금 실습처럼 직접EntityManager를 만드는 흐름에서는 하나의EntityManager가 자기 영속성 컨텍스트를 사용한다고 이해하면 된다.
즉,EntityManager를 만들면 그EntityManager가 관리하는 영속성 컨텍스트가 함께 있다고 보면 된다.
EntityManagerFactory는EntityManager를 만들고, 생성된EntityManager는 엔티티를 관리하는 영속성 컨텍스트를 사용한다.
영속성 컨텍스트 안에는 조회하거나 저장한 엔티티가 보관될 수 있다.
이 공간이 있기 때문에JPA는 같은 엔티티를 다시 조회했을 때 같은 객체를 반환하거나, 변경된 값을 감지할 수 있다.
이 구조를 이해하면EntityManager를 여러 스레드가 공유하면 안 되는 이유도 더 잘 보인다.
EntityManager는 자기 영속성 컨텍스트 안에서 현재 관리 중인Entity를 기억한다.
여러 작업이 같은EntityManager를 함께 쓰면 관리 중인 객체 상태가 서로 섞일 수 있다.
그래서EntityManagerFactory는 공유하고,EntityManager는 작업 단위마다 만들어 사용하는 구조가 적절하다.
이 기준은 앞에서 본EntityManagerFactory와EntityManager의 차이와 그대로 이어진다.
7-3. 1차 캐시는 Entity를 식별자 값으로 보관한다
영속성 컨텍스트 안에는
1차 캐시가 있다.
캐시는 자주 쓰거나 이미 읽은 데이터를 다시 사용하기 위해 임시로 저장해 두는 공간이다.
1차 캐시는 영속성 컨텍스트 안에서Entity를 식별자 값으로 보관하는 저장소이다.
식별자는 어떤 대상을 구분하는 값이다.
JPA에서는 보통@Id가 붙은 기본키 값이 식별자 역할을 한다.
따라서1차 캐시는 엔티티 타입과 기본키 값을 기준으로 엔티티 객체를 기억한다.
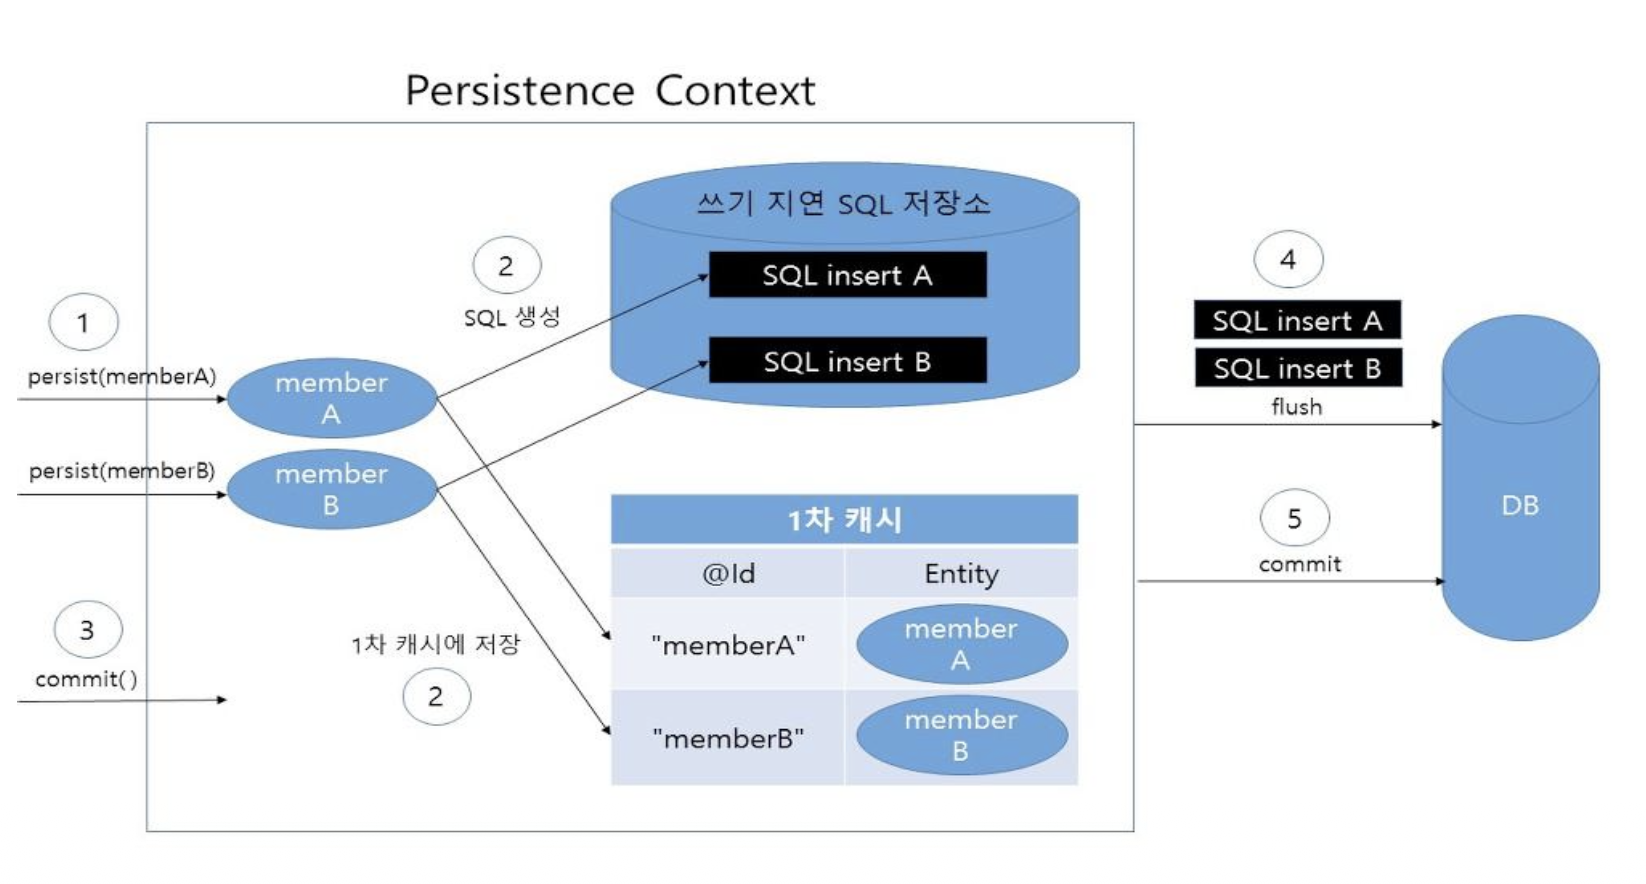
영속성 컨텍스트 안에는
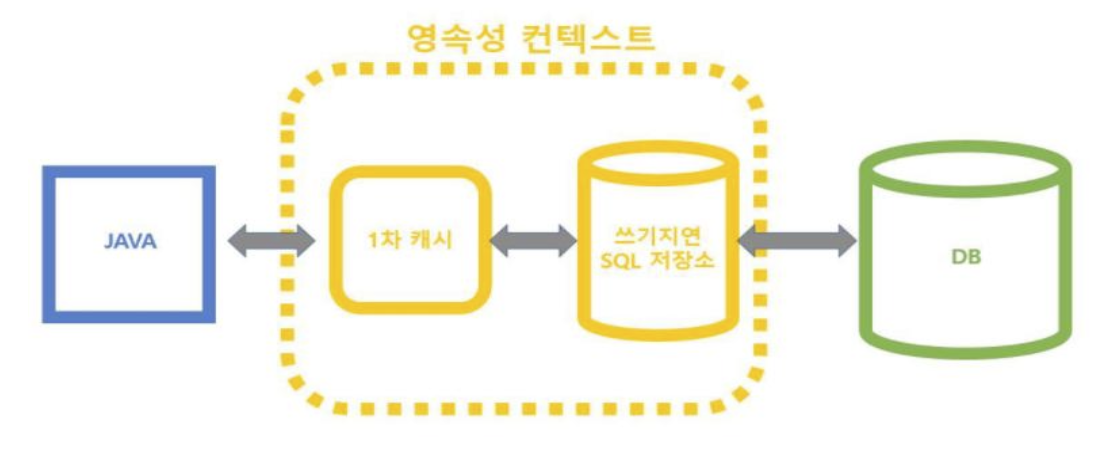
1차 캐시저장소와 쓰기 지연SQL저장소가 있다.
1차 캐시는 조회하거나 저장한 엔티티 객체를 기억하는 공간이다.
쓰기 지연SQL저장소는 나중에 데이터베이스로 보낼insert,update,delete문장을 모아 두는 공간이다.
아래 흐름은 기본키8L인 데이터가 이미 저장되어 있다고 가정하고 본다.// FirstCacheFindFlow.java MemberEntityComplete member1 = entityManager.find(MemberEntityComplete.class, 8L); // 기본키 8L로 첫 번째 조회 MemberEntityComplete member2 = entityManager.find(MemberEntityComplete.class, 8L); // 같은 기본키로 두 번째 조회첫 번째 조회에서 영속성 컨텍스트 안에 해당
Entity가 없으면 데이터베이스에서 조회한다.
조회한 결과는Entity객체로 만들어지고1차 캐시에 저장된다.
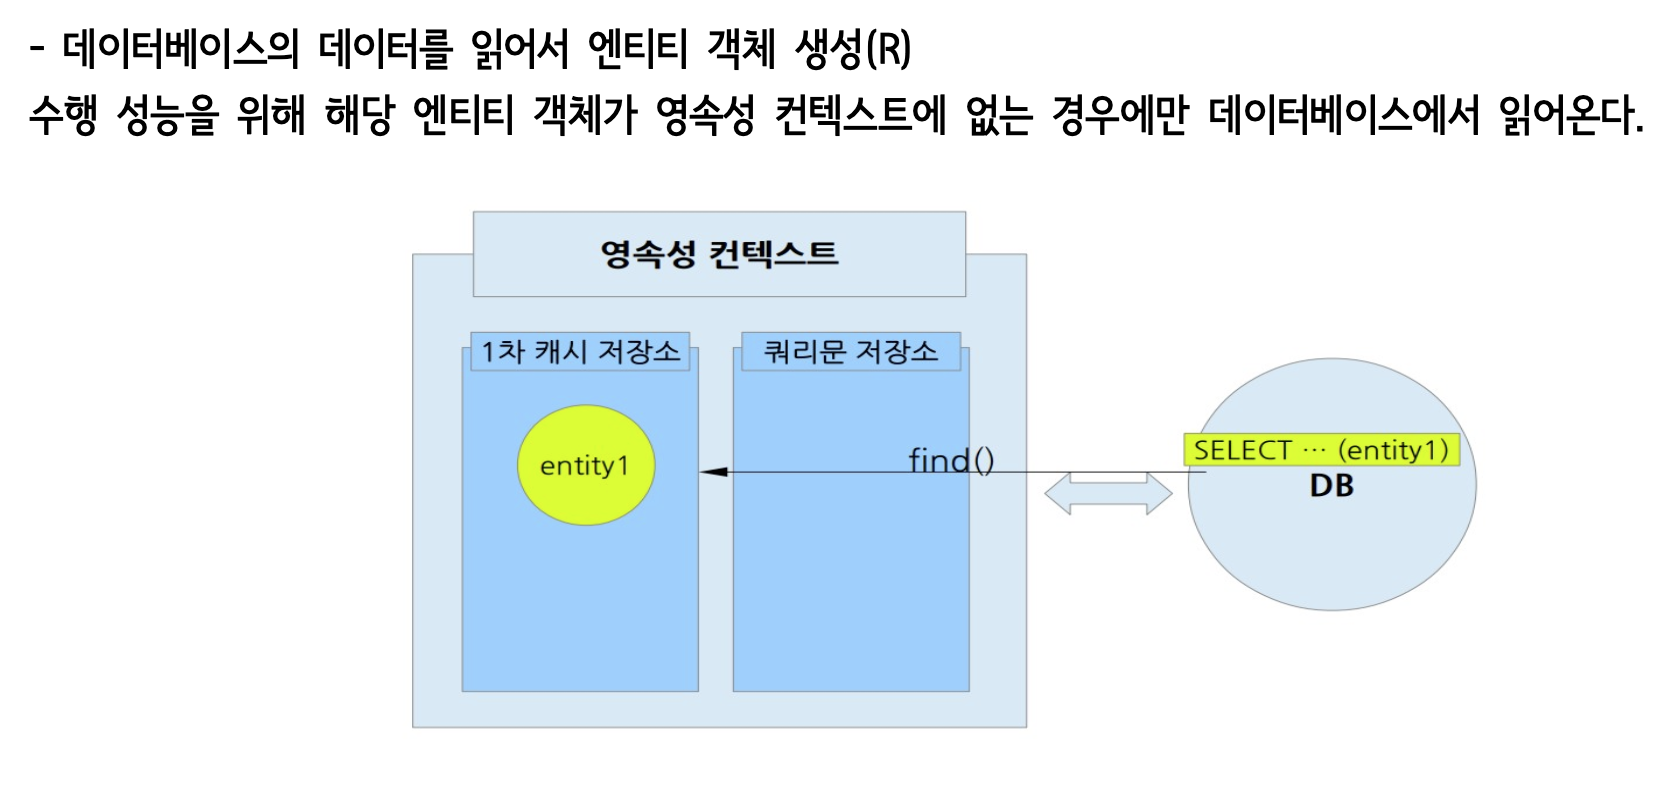
find()를 호출했을 때 해당 엔티티가1차 캐시에 없으면 데이터베이스에SELECT SQL을 보낸다.
데이터베이스에서 조회된 결과는 단순한 값으로 끝나는 것이 아니라Entity객체로 만들어진다.
이렇게 만들어진Entity는 영속성 컨텍스트의1차 캐시에 저장되고, 이후 애플리케이션에 반환된다.
그다음 같은 기본키로 다시 조회하면JPA는 먼저1차 캐시를 확인한다.
이미 같은 식별자의Entity가 있으면 데이터베이스에 다시 가지 않고 그 객체를 반환할 수 있다.
1차 캐시는 같은Entity를 반복 조회할 때 데이터베이스 접근을 줄이고, 같은 객체를 계속 관리할 수 있게 도와준다.
7-4. 동일성 보장은 같은 Entity 객체를 반환한다는 뜻이다
동일성 보장은 같은 영속성 컨텍스트 안에서 같은 식별자로 조회한
Entity가 같은 객체로 반환된다는 뜻이다.
여기서 동일성은==비교가true가 되는 관계라고 이해하면 된다.
==는 두 변수가 같은 객체를 가리키는지 확인하는 비교이다.
값이 같은지 비교하는 것과는 다르다.
예를 들어 이름이 같은 회원 객체 두 개가 있을 수 있지만, 두 객체가 메모리에서 같은 객체인지는 별개의 문제이다.
같은EntityManager안에서 같은 기본키로 두 번 조회하면 아래처럼 같은 객체가 반환될 수 있다.
이 예제도 기본키8L인 데이터가 이미 저장되어 있다고 가정한다.// EntityIdentityCheckFlow.java MemberEntityComplete member1 = entityManager.find(MemberEntityComplete.class, 8L); // 첫 번째 조회 MemberEntityComplete member2 = entityManager.find(MemberEntityComplete.class, 8L); // 같은 기본키로 두 번째 조회 System.out.println(member1 == member2); // 같은 객체인지 비교// 출력결과 // true출력 결과가
true라면member1과member2가 같은 객체를 가리킨다는 뜻이다.
이것이 영속성 컨텍스트가 제공하는 동일성 보장이다.
동일성 보장이 중요한 이유는JPA가 같은 데이터베이스 행을 여러 객체로 흩어 관리하지 않도록 도와주기 때문이다.
같은 식별자의Entity가 하나의 객체로 관리되면 변경 추적도 안정적으로 이루어진다.
7-5. 쓰기 지연은 SQL을 바로 보내지 않고 모아 두는 구조이다
쓰기 지연은 저장, 수정, 삭제 같은 변경 작업의
SQL을 바로 데이터베이스로 보내지 않고 잠시 모아 두는 구조이다.
영속성 컨텍스트 안에는 쓰기 지연SQL저장소가 있다.
이곳에 필요한insert,update,delete문장이 쌓일 수 있다.
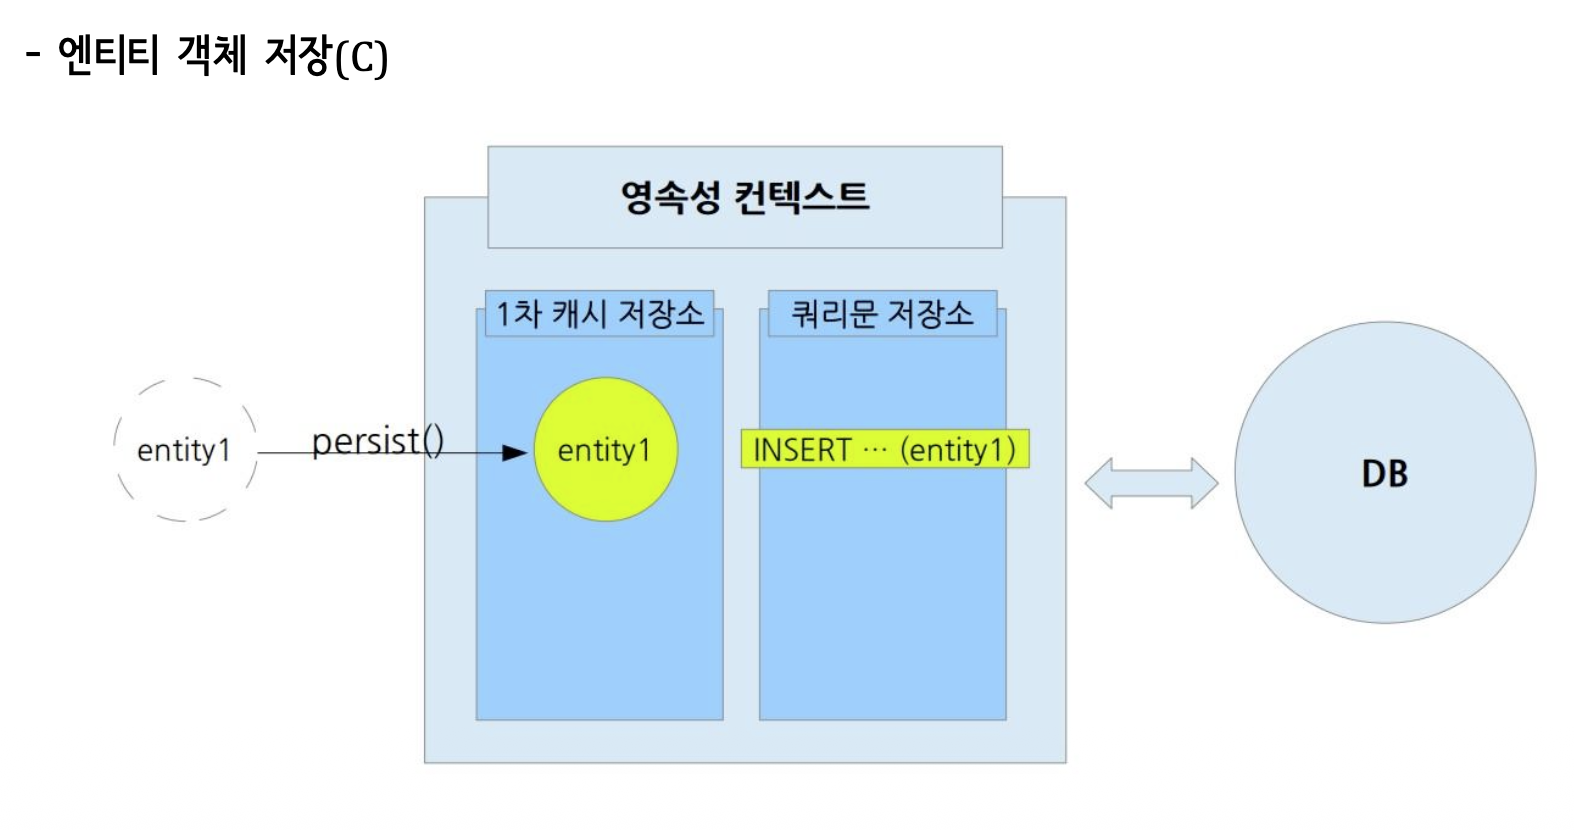
persist()를 호출하면 엔티티는 영속성 컨텍스트의1차 캐시에 들어간다.
그리고 저장에 필요한insert SQL은 쓰기 지연SQL저장소에 저장될 수 있다.
아직 이 시점에 데이터베이스에 바로 반영됐다고 단정하면 안 된다.
여러Entity를 저장하면SQL도 모일 수 있다.
저장 요청은 데이터베이스 상태를 바꾸는 흐름이므로Transaction안에서 처리한다.// WriteBehindPersistFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete memberA = new MemberEntityComplete(9L, "회원A"); // 저장할 첫 번째 Entity 생성 MemberEntityComplete memberB = new MemberEntityComplete(10L, "회원B"); // 저장할 두 번째 Entity 생성 entityManager.persist(memberA); // 첫 번째 Entity 저장 요청 entityManager.persist(memberB); // 두 번째 Entity 저장 요청 transaction.commit(); // flush 후 저장 확정이 코드에서
persist()는 저장 요청이다.
일반적인 흐름에서는 영속성 컨텍스트가 저장 대상Entity를 관리하고,insert SQL을 모아 둔다.
그리고flush시점에 데이터베이스로 전달한다.
다만 모든 기본키 전략에서 항상 같은 시점에SQL이 나가는 것은 아니다.
IDENTITY전략처럼 데이터베이스가 기본키를 만들어 주는 경우에는 기본키 값을 알아야 하므로persist()시점에insert SQL이 실행될 수 있다.
따라서 쓰기 지연은 기본 구조로 이해하되, 기본키 전략에 따른 차이도 함께 기억해야 한다.
쓰기 지연이 있으면 변경 작업을 모아서 처리할 수 있다.
이것은 데이터베이스와의 통신 시점을 조절하고, 성능 최적화 기회를 제공한다.
EntityManager는 영속성 컨텍스트 안의 엔티티를 관리한다.
저장 요청이 들어오면 엔티티 객체를 관리 대상으로 두고, 변경에 필요한SQL은 필요한 시점까지 모아 둘 수 있다.
이 구조 때문에JPA에서는 메서드 호출 시점과 실제SQL실행 시점을 구분해서 봐야 한다.
7-6. flush는 변경 내용을 DB에 반영하는 과정이다
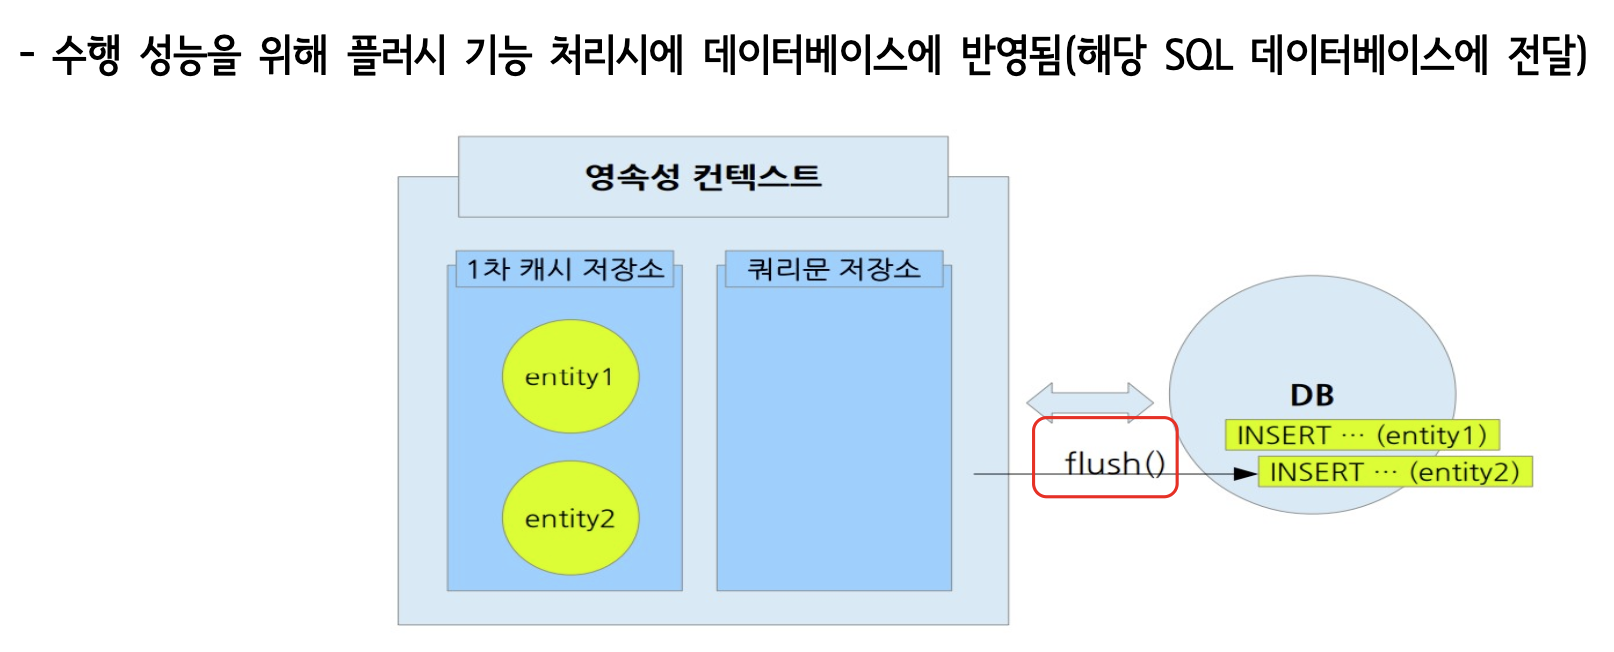
flush는 영속성 컨텍스트의 변경 내용을 데이터베이스에 반영하는 과정이다.
반영한다는 말은 영속성 컨텍스트에 모아 둔SQL을 데이터베이스로 전달한다는 뜻이다.
flush()가 실행되면 쓰기 지연SQL저장소에 모아 둔INSERT문장이 데이터베이스로 전달된다.
영속성 컨텍스트 안의 엔티티 상태와 데이터베이스 상태를 맞추기 위해 변경SQL이 실행되는 것이다.
flush는 직접 호출할 수도 있다.
다만 변경 내용을 데이터베이스로 보내는 과정이므로 일반적으로 변경 작업을 처리하는Transaction안에서 사용한다.// FlushDirectCallFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(11L, "직접플러시"); // 저장할 Entity 생성 entityManager.persist(member); // 저장 요청 entityManager.flush(); // 영속성 컨텍스트의 변경 내용을 DB에 반영 transaction.commit(); // Transaction 확정일반적인 코드에서는
flush()를 직접 자주 호출하지 않는다.
보통commit()시점에 자동으로 실행된다.
여기서 중요한 점이 있다.
flush는 데이터베이스에SQL을 전달하는 과정이다.
commit은Transaction을 최종 확정하는 과정이다.
둘은 관련되어 있지만 완전히 같은 말은 아니다.
flush()가 실행되어SQL이 데이터베이스에 전달되더라도Transaction이 끝난 것은 아니다.
아직commit()전이라면 오류가 발생했을 때rollback()으로 되돌릴 수 있다.
flush는 영속성 컨텍스트의 변경 내용을 데이터베이스에 보내는 과정이고,commit은Transaction을 최종 확정하는 과정이다.
7-7. flush가 자동 호출되는 시점
flush는 직접 호출할 수도 있지만, 자동으로 호출되는 시점이 있다.
중요한 자동 호출 시점은 세 가지이다.
첫 번째는entityManager.flush()를 직접 호출할 때이다.
이 경우 개발자가 명시적으로 영속성 컨텍스트의 변경 내용을 데이터베이스에 반영하라고 요청한다.
두 번째는Transaction을commit()할 때이다.
저장, 수정, 삭제 작업을 확정하려면 데이터베이스에 변경 내용이 반영되어야 하므로,commit()과정에서flush가 자동 호출된다.
세 번째는JPQL쿼리를 실행할 때이다.
JPQL조회 전에 아직 반영되지 않은 변경 내용이 있으면, 조회 결과가 실제 상태와 어긋날 수 있다.
그래서JPQL실행 전에flush가 자동 호출될 수 있다.
예를 들어 저장 요청 후 바로JPQL로 목록을 조회한다고 생각해 보자.
저장 요청은 데이터 변경 작업이므로Transaction안에서 처리한다.// FlushBeforeJpqlFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 entityManager.persist(new MemberEntityComplete(12L, "쿼리전저장")); // 저장 요청 entityManager.createQuery("select m from MemberEntityComplete m", MemberEntityComplete.class) .getResultList(); // JPQL 실행 전 flush가 자동 호출될 수 있음 transaction.commit(); // Transaction 확정
JPQL은 데이터베이스를 대상으로 조회 결과를 가져와야 한다.
그래서 영속성 컨텍스트에만 변경 내용이 남아 있으면, 조회 결과가 맞지 않을 수 있다.
이런 상황을 막기 위해JPQL실행 전에flush가 일어날 수 있다.
정리하면 아래와 같다.
entityManager.flush()를 직접 호출할 때Transaction을commit()할 때JPQL쿼리를 실행할 때이 세 가지 시점을 이해하면 왜
persist()직후가 아니라commit()이나JPQL실행 시점에SQL이 보일 수 있는지 이해할 수 있다.
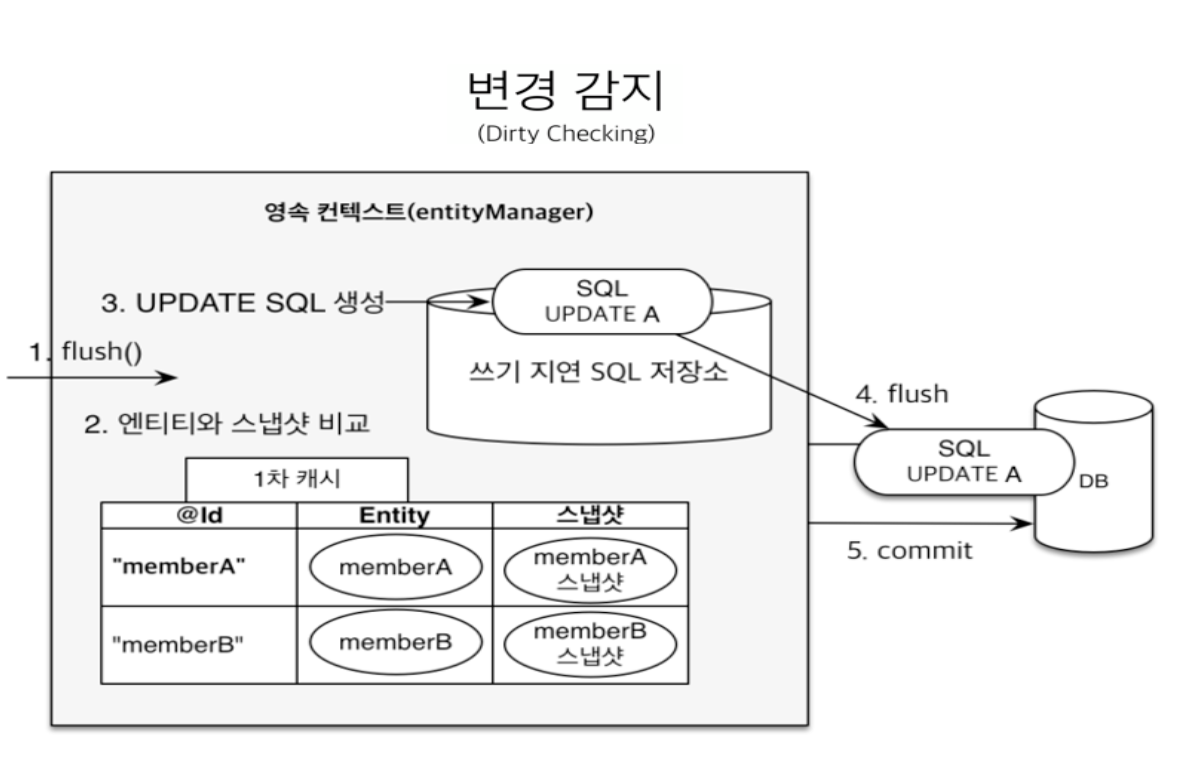
7-8. Dirty Checking은 변경된 Entity를 자동으로 감지하는 기능이다
Dirty Checking은 변경 감지라고 부른다.
영속성 컨텍스트가 관리 중인Entity의 값이 바뀌었는지 자동으로 확인하는 기능이다.
JPA에서는 수정할 때 보통update()메서드를 직접 호출하지 않는다.
대신 영속 상태의Entity값을 변경한다.
그러면JPA가flush시점에 변경 여부를 확인하고 필요한update SQL을 만든다.
영속 상태의 엔티티 값을 바꾸면 영속성 컨텍스트가 변경 여부를 확인한다.
변경된 값이 있으면 수정에 필요한UPDATE SQL이 쓰기 지연SQL저장소에 저장될 수 있다.
그래서JPA수정 흐름에서는 별도의update()메서드를 호출하지 않아도 된다.
먼저 엔티티 안에 이름을 바꾸는 메서드가 있다고 생각해 보자.
아래 흐름은MemberEntityComplete안에changeName()메서드가 추가되어 있다고 가정한다.// MemberChangeNameMethod.java public void changeName(String name) { // 이름 변경 메서드 this.name = name; // 현재 Entity의 이름 값 변경 }이제 영속 상태의 엔티티 값을 변경하는 흐름을 볼 수 있다.
수정도 데이터베이스 상태가 바뀌는 작업과 연결되므로Transaction안에서 처리한다.// DirtyCheckingUpdateFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 8L); // 영속 상태 Entity 조회 member.changeName("수정된 이름"); // Entity 값 변경 transaction.commit(); // commit 과정에서 변경 감지 후 UPDATE 가능이 코드에는
entityManager.update(member)가 없다.
그래도member가 영속 상태라면JPA는 값이 바뀐 것을 감지할 수 있다.
변경 감지가 가능한 이유는 이Entity가 영속성 컨텍스트 안에서 관리되고 있기 때문이다.
영속성 컨텍스트 밖에 있는 객체라면 값을 바꿔도JPA가 자동으로 추적하지 않는다.
JPA수정 흐름의 핵심은 관리 중인Entity값을 바꾸면 변경 감지를 통해UPDATE SQL이 만들어질 수 있다는 점이다.
7-9. 스냅샷은 변경 전 Entity 상태를 저장한 기준값이다
스냅샷은 특정 시점의 상태를 복사해 둔 기준값이다.
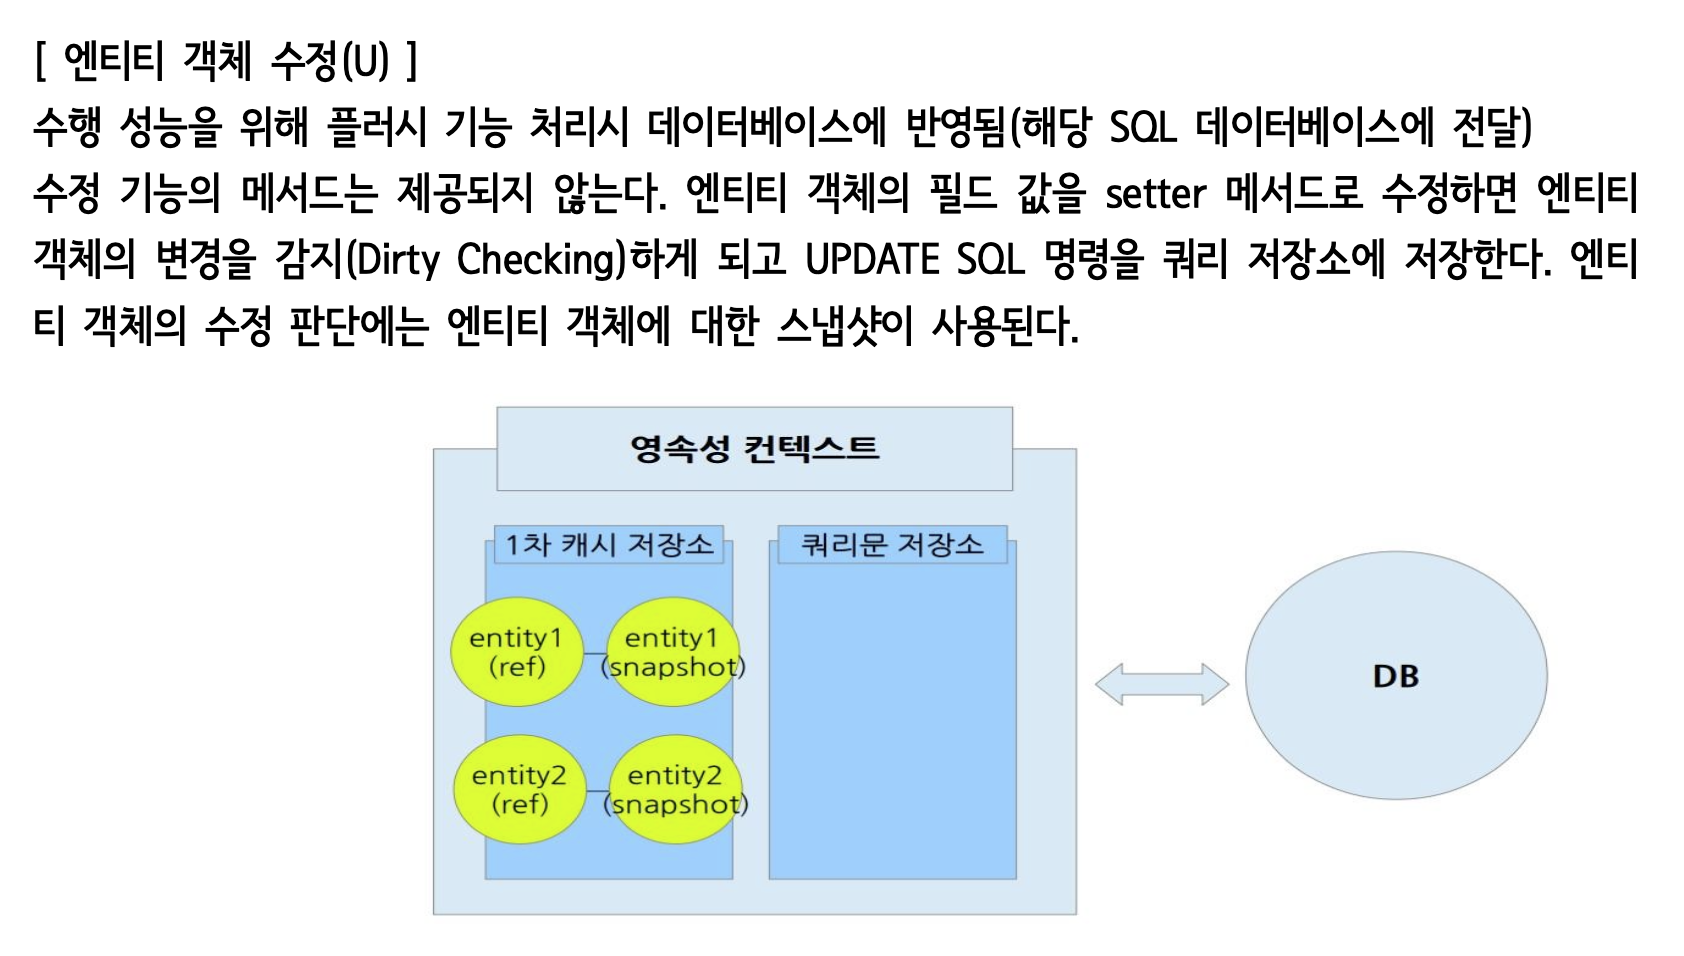
JPA는Entity를 영속성 컨텍스트에 저장할 때, 그 당시의 상태를 스냅샷으로 함께 보관한다.
이후flush가 일어나면JPA는 현재Entity값과 스냅샷을 비교한다.
값이 다르면 변경된 것으로 판단한다.
이것이Dirty Checking의 기본 원리이다.
1차 캐시에는 엔티티와 스냅샷이 함께 보관될 수 있다.
flush()가 실행되면 현재 엔티티 값과 스냅샷을 비교한다.
변경된 부분이 있으면 수정용SQL이 만들어지고 데이터베이스로 전달된다.
즉,JPA가 수정 여부를 알 수 있는 이유는 단순히 값을 바꿨기 때문이 아니다.
변경 전 상태를 스냅샷으로 기억하고 있기 때문에 현재 값과 비교할 수 있는 것이다.
흐름을 코드 느낌으로 보면 아래와 같다.
flush()는 변경 내용을 데이터베이스로 보내는 과정이므로Transaction안에서 확인하는 흐름으로 본다.// SnapshotDirtyCheckingFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 8L); // 조회 시점의 상태가 스냅샷으로 저장됨 member.changeName("스냅샷비교"); // 현재 Entity 값 변경 entityManager.flush(); // 스냅샷과 현재 값을 비교한 뒤 UPDATE SQL 생성 가능 transaction.commit(); // Transaction 확정스냅샷은 개발자가 직접 꺼내 쓰는 값이 아니다.
JPA가 내부적으로 변경 감지를 위해 사용하는 기준값이다.
변경 감지는 현재Entity값과 스냅샷을 비교해서 변경 여부를 판단하는 방식이다.
7-10. 영속성 컨텍스트 흐름 한 번에 연결하기
지금까지 본 내용을 하나로 연결하면 영속성 컨텍스트의 기본 흐름이 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라,persist()→1차 캐시→ 쓰기 지연SQL저장소 →flush→commit흐름을 한 번에 확인하는 마무리이다.
persist()로 등록된 엔티티는 영속성 컨텍스트에서 관리된다.
저장에 필요한INSERT SQL은 쓰기 지연SQL저장소에 모일 수 있다.
이후commit()과정에서flush()가 일어나면 변경SQL이 데이터베이스로 전달되고,Transaction이 확정된다.
아래 코드는persist()이후commit()시점에 저장 흐름이 확정되는 과정을 확인하는 예제이다.// PersistenceContextLifecycleFlow.java package jpaexam1.app; import jakarta.persistence.EntityManager; import jakarta.persistence.EntityManagerFactory; import jakarta.persistence.EntityTransaction; import jakarta.persistence.Persistence; import jpaexam1.entity.MemberEntityComplete; public class PersistenceContextLifecycleFlow { public static void main(String[] args) { EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // EntityManagerFactory 생성 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 EntityTransaction transaction = entityManager.getTransaction(); // Transaction 가져오기 try { transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(13L, "영속성흐름"); // 비영속 Entity 생성 System.out.println("persist 호출 전"); // 흐름 확인 entityManager.persist(member); // 영속성 컨텍스트에 등록 System.out.println("persist 호출 후"); // 흐름 확인 transaction.commit(); // flush 후 Transaction 확정 System.out.println("commit 완료"); // 흐름 확인 } catch (Exception e) { if (transaction.isActive()) { // Transaction 진행 여부 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } e.printStackTrace(); // 오류 출력 } finally { entityManager.close(); // EntityManager 닫기 factory.close(); // EntityManagerFactory 닫기 } } }// 출력결과 // persist 호출 전 // persist 호출 후 // commit 완료이 예제에서
persist()는Entity를 영속성 컨텍스트에 등록한다.
그리고commit()과정에서flush가 일어나면서 저장을 위한SQL이 데이터베이스로 전달될 수 있다.
직접 할당 기본키를 사용하는 예제이므로 같은 코드를 여러 번 실행하면 기본키 중복 오류가 발생할 수 있다.
다시 실행하려면 기본키 값을 바꾸거나 기존 데이터를 삭제해야 한다.
마지막으로 같은EntityManager안에서 같은 기본키를 두 번 조회하면 동일성 보장을 확인할 수 있다.
위 예제에서 기본키13L인 엔티티가 저장되었다고 가정하고 보면 된다.// PersistenceContextIdentityFlow.java MemberEntityComplete member1 = entityManager.find(MemberEntityComplete.class, 13L); // 첫 번째 조회 MemberEntityComplete member2 = entityManager.find(MemberEntityComplete.class, 13L); // 같은 기본키로 두 번째 조회 System.out.println("같은 객체 여부 : " + (member1 == member2)); // 동일성 비교// 출력결과 // 같은 객체 여부 : true이 예제의 핵심은 데이터베이스에서 같은 값을 읽었다는 수준이 아니다.
member1과member2가 실제로 같은 객체라는 점이다.
이것이 영속성 컨텍스트의 동일성 보장이다.
영속성 컨텍스트는Entity를 관리하면서1차 캐시, 동일성 보장, 쓰기 지연,flush, 변경 감지를 제공한다.
이 흐름을 이해하면 다음 단계에서Entity생명주기와 주요 메서드를 훨씬 쉽게 볼 수 있다.
8. Entity 생명주기와 주요 메서드 이해하기
Entity는JPA와 어떤 관계에 있는지에 따라 상태가 달라진다.
이 상태 변화를 엔티티 생명주기라고 한다.
생명주기는 객체가 만들어지고, 관리되고, 분리되고, 삭제되는 흐름을 의미한다.
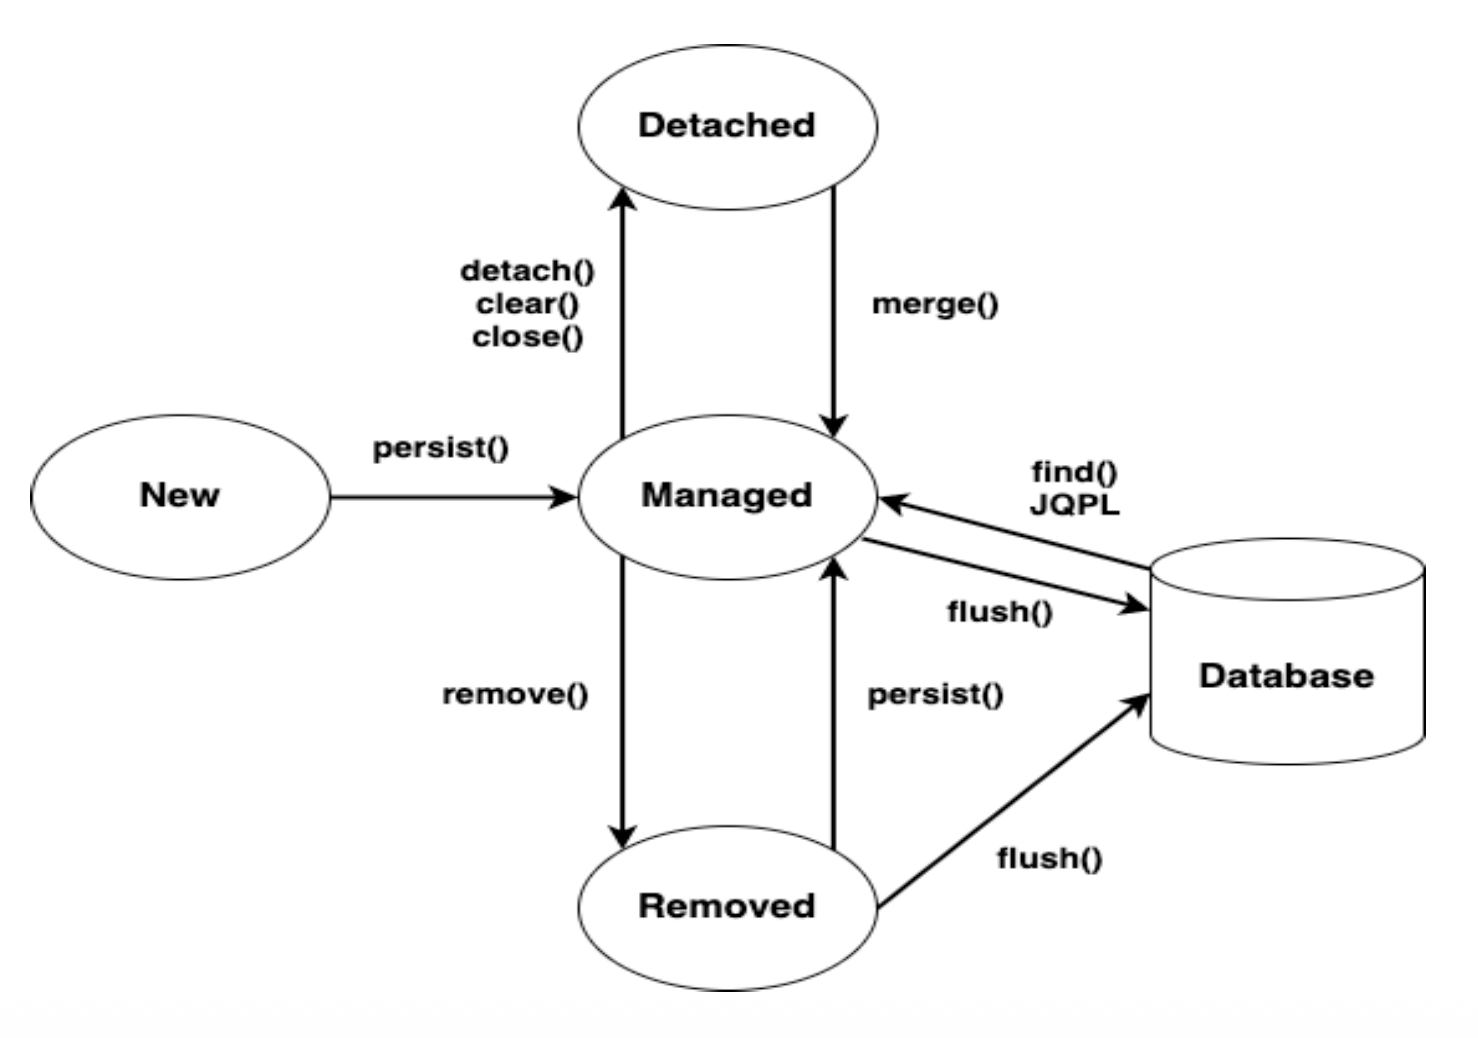
JPA에서 중요한Entity상태는 비영속 상태, 영속 상태, 준영속 상태, 삭제 상태이다.
각 상태를 이해해야persist(),find(),detach(),clear(),close(),merge(),remove()같은 메서드가 어떤 의미인지 정확히 보인다.
Entity는 처음 만들어졌을 때 바로JPA의 관리 대상이 아니다.
persist()를 통해 영속 상태가 될 수 있고,detach(),clear(),close()를 통해 준영속 상태가 될 수 있다.
또remove()를 통해 삭제 상태가 될 수 있다.
JPA메서드는 단순한 기능 이름이 아니라,Entity의 상태를 바꾸거나 영속성 컨텍스트와 데이터베이스의 흐름을 조절하는 역할을 한다.
8-1. 비영속 상태는 아직 JPA가 관리하지 않는 상태이다
비영속 상태는 아직 영속성 컨텍스트와 관계가 없는 상태이다.
new로 객체를 만들기만 하면 비영속 상태이다.
Java메모리에는 객체가 존재하지만,JPA가 아직 관리하지 않는다.
// NewEntityStateFlow.java
MemberEntityComplete member = new MemberEntityComplete(14L, "비영속회원"); // JPA가 아직 관리하지 않는 Entity 객체
이 객체는
Java객체로는 존재한다.
하지만EntityManager에게 전달되지 않았기 때문에 영속성 컨텍스트 안에 들어가 있지 않다.
따라서 비영속 상태의 객체는 값을 바꿔도JPA가 변경을 감지하지 않는다.
영속성 컨텍스트 안에 없으므로1차 캐시에도 없고, 스냅샷도 없다.
즉, 비영속 상태는JPA입장에서 아직 모르는 객체라고 이해하면 된다.
객체를 만들었다는 사실과JPA가 관리한다는 사실은 서로 다르다.
8-2. 영속 상태는 영속성 컨텍스트가 관리하는 상태이다
영속 상태는
Entity가 영속성 컨텍스트에 들어가EntityManager의 관리 대상이 된 상태이다.
비영속 객체에persist()를 호출하면 영속 상태가 된다.
저장 요청은 데이터베이스 상태를 바꾸는 작업과 연결되므로 실제 흐름에서는Transaction안에서 처리해야 한다.// PersistManagedStateFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(14L, "영속회원"); // 비영속 상태 Entity 생성 entityManager.persist(member); // 영속성 컨텍스트에 등록되어 영속 상태가 됨 transaction.commit(); // flush 후 저장 확정
persist()는 비영속 상태의Entity를 영속성 컨텍스트의 관리 대상으로 등록한다.
이제member는JPA가 관리하는 영속 상태가 된다.
직접 할당 기본키를 사용하는 흐름이므로 같은 코드를 여러 번 실행하면 기본키 중복 오류가 발생할 수 있다.
다시 실행하려면 기본키 값을 바꾸거나 기존 데이터를 삭제해야 한다.
또는find()로 조회한Entity도 영속 상태가 된다.
아래 예제는 기본키14L인 데이터가 이미 저장되어 있다고 가정한다.// FindManagedStateFlow.java MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 14L); // 조회된 Entity는 영속 상태
find()는 기본키로Entity를 조회한다.
조회 결과가 있으면 그 객체는 영속성 컨텍스트에 저장되고,JPA의 관리 대상이 된다.
영속 상태가 되면 중요한 변화가 생긴다.
JPA는 이 객체를1차 캐시에 보관할 수 있고, 변경 감지 대상으로 관리할 수 있다.
그래서 영속 상태의Entity값을 바꾸면 나중에flush시점에 변경 여부를 확인할 수 있다.
영속 상태는Entity가 영속성 컨텍스트 안에서JPA의 관리 대상이 된 상태이다.
8-3. find는 기본키로 Entity를 조회하고 1차 캐시를 먼저 확인한다
find()는 기본키를 기준으로Entity를 조회하는 메서드이다.
조회 결과가 있으면Entity객체를 반환하고, 없으면null을 반환할 수 있다.
null은 값이 없다는 뜻이다.
// FindEntityByPrimaryKeyFlow.java
MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 14L); // 기본키 14L로 Entity 조회
첫 번째 값인
MemberEntityComplete.class는 어떤Entity를 조회할지 알려 준다.
두 번째 값인14L은 조회할 기본키 값이다.
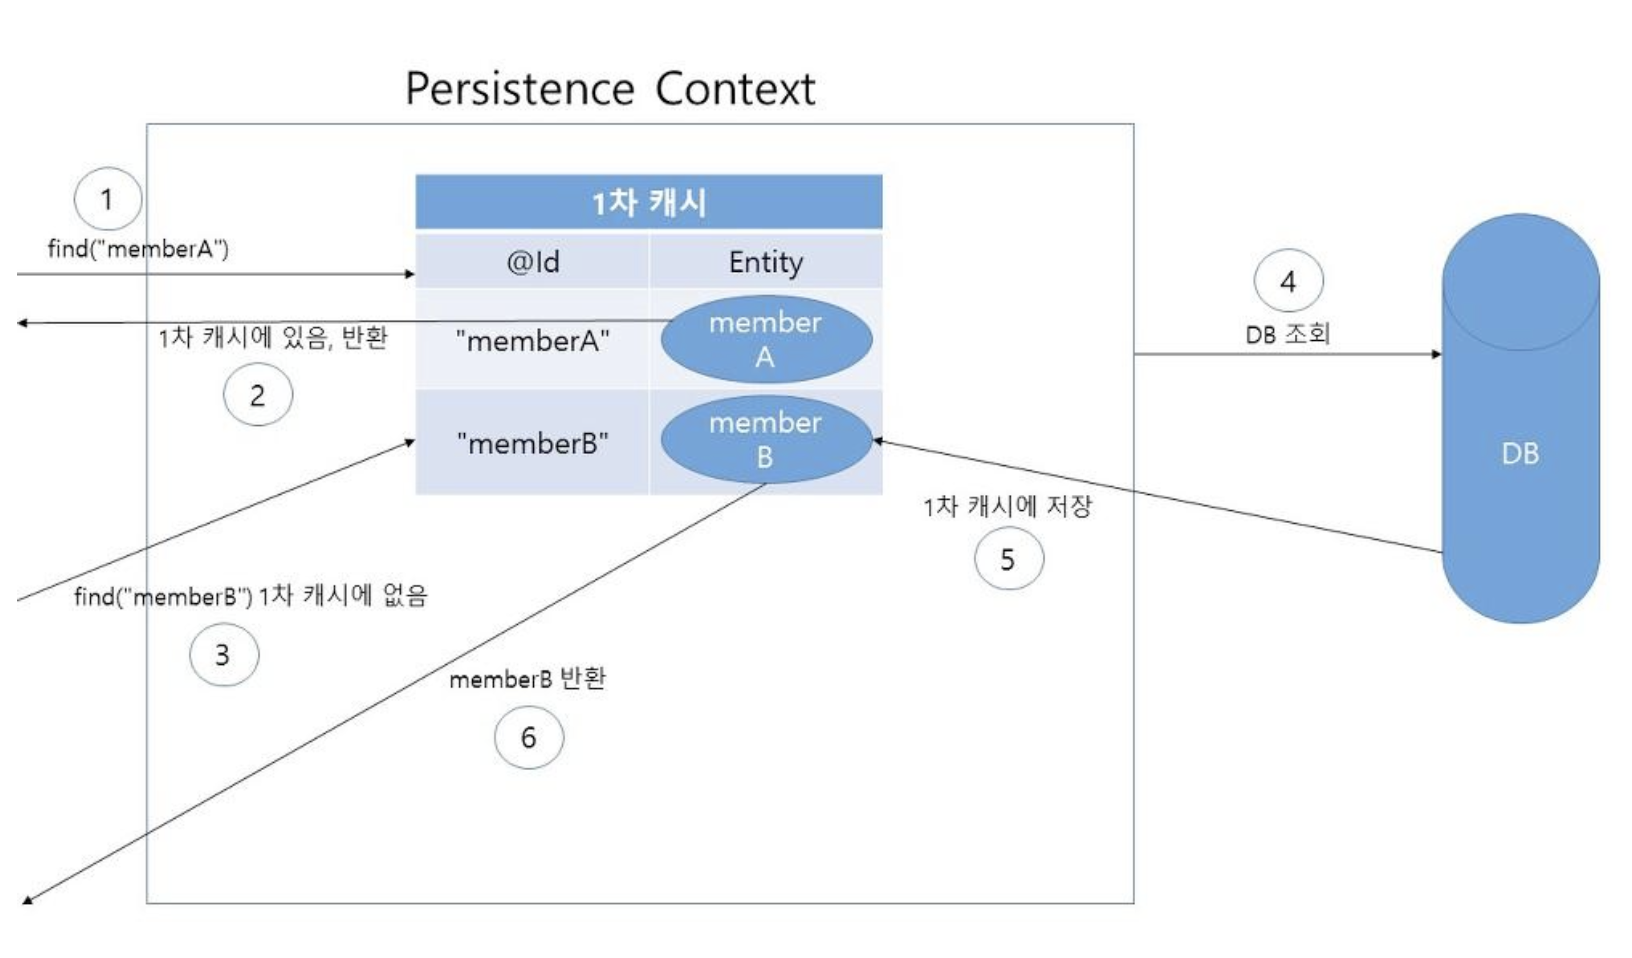
find()는 바로 데이터베이스로 가지 않는다.
먼저 영속성 컨텍스트의1차 캐시를 확인한다.
이미 같은 식별자의Entity가 있으면 그 객체를 반환한다.
없으면 데이터베이스에서 조회한 뒤, 조회 결과를Entity객체로 만들어 영속성 컨텍스트에 저장하고 반환한다.
find()는 먼저1차 캐시를 확인한다.
1차 캐시에 엔티티가 있으면 데이터베이스를 다시 조회하지 않고 그 객체를 반환한다.
1차 캐시에 없으면 데이터베이스에서 조회한 뒤, 조회한 엔티티를1차 캐시에 저장하고 반환한다.
이 흐름 때문에 같은EntityManager안에서 같은 기본키로 두 번 조회하면 같은 객체가 반환될 수 있다.
이것이 앞에서 본 동일성 보장과 연결된다.
8-4. 준영속 상태는 관리되던 Entity가 분리된 상태이다
준영속 상태는 한 번 영속 상태였던
Entity가 영속성 컨텍스트에서 분리된 상태이다.
즉, 이전에는JPA가 관리했지만 지금은 더 이상 관리하지 않는 상태이다.
준영속 상태가 되면 변경 감지 대상에서 벗어난다.
따라서 준영속 상태의 객체 값을 바꿔도 자동으로 데이터베이스에 반영되지 않는다.
준영속 상태로 만드는 대표 방법은detach(),clear(),close()이다.
먼저detach()는 특정Entity하나만 영속성 컨텍스트에서 분리한다.
아래 예제는 기본키14L인 데이터가 이미 저장되어 있다고 가정한다.// DetachEntityStateFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 14L); // 영속 상태 Entity 조회 if (member != null) { // 조회 결과가 있을 때만 분리 entityManager.detach(member); // 특정 Entity를 준영속 상태로 분리 member.changeName("준영속변경"); // JPA 관리 대상이 아니므로 변경 감지 안 됨 } transaction.commit(); // 변경 감지로 UPDATE 되지 않음위 흐름은
MemberEntityComplete안에changeName()메서드가 있다고 가정한다.
detach(member)이후의member는 더 이상 영속성 컨텍스트가 관리하지 않는다.
그래서member.changeName("준영속변경")으로 값을 바꿔도 변경 감지 대상이 아니다.
이 예제에서commit()을 호출해도member의 변경 내용은 자동으로UPDATE SQL로 만들어지지 않는다.
JPA가 관리하지 않는 객체가 되었기 때문이다.
조회 결과가 없으면 분리할 대상도 없다.
그래서member != null조건으로 조회 결과가 있을 때만detach()를 호출하는 흐름이 안전하다.
준영속 상태는 한 번 관리되던Entity가 영속성 컨텍스트에서 분리되어 더 이상 변경 감지 대상이 아닌 상태이다.
8-5. clear는 영속성 컨텍스트 전체를 비운다
clear()는 영속성 컨텍스트를 비우는 메서드이다.
특정Entity하나만 분리하는detach()와 다르게, 현재 영속성 컨텍스트 안의 모든Entity를 분리한다.
아래 예제는 기본키14L인 데이터가 이미 저장되어 있다고 가정한다.// ClearPersistenceContextFlow.java MemberEntityComplete member1 = entityManager.find(MemberEntityComplete.class, 14L); // 첫 번째 조회, 영속 상태 entityManager.clear(); // 영속성 컨텍스트 전체 초기화 MemberEntityComplete member2 = entityManager.find(MemberEntityComplete.class, 14L); // 다시 조회, DB 조회 가능 System.out.println(member1 == member2); // 같은 객체인지 비교// 출력결과 // false
clear()를 호출하면 영속성 컨텍스트 안의 엔티티들이 모두 준영속 상태가 된다.
1차 캐시도 비워진다.
그래서 같은 기본키로 다시 조회하면 기존 객체를 반환하는 것이 아니라, 데이터베이스에서 다시 조회할 수 있다.
그 결과member1과member2는 같은 기본키를 가진 데이터를 표현하더라도 서로 다른 객체일 수 있다.
detach()는 특정 객체 하나를 분리하고,clear()는 영속성 컨텍스트 전체를 비운다는 차이가 있다.
8-6. close는 EntityManager와 영속성 컨텍스트를 종료한다
close()는EntityManager를 닫는 메서드이다.
EntityManager가 닫히면 그 안에서 사용하던 영속성 컨텍스트도 종료된다.
// CloseEntityManagerFlow.java
entityManager.close(); // EntityManager 종료
close()이후에는 해당EntityManager를 더 이상 사용하면 안 된다.
영속성 컨텍스트도 종료되었기 때문이다.
닫힌EntityManager로 다시 조회나 저장을 시도하는 흐름은 잘못된 흐름이다.// ClosedEntityManagerBadFlow.java entityManager.close(); // EntityManager 종료 entityManager.find(MemberEntityComplete.class, 14L); // 닫힌 EntityManager를 다시 사용하면 안 됨이 코드는 실제로 따라 작성하라는 예제가 아니라, 닫힌
EntityManager를 다시 사용하면 안 된다는 점을 보여 주는 흐름이다.
차이를 정리하면 아래와 같다.
detach()는 특정Entity하나를 준영속 상태로 만든다.clear()는 영속성 컨텍스트를 비워 모든Entity를 준영속 상태로 만든다.close()는EntityManager자체를 종료하고 영속성 컨텍스트도 끝낸다.이 차이를 알아야 준영속 상태가 왜 생기는지 이해할 수 있다.
8-7. 삭제 상태는 삭제 대상으로 등록된 상태이다
삭제 상태는
Entity가 삭제 대상으로 등록된 상태이다.
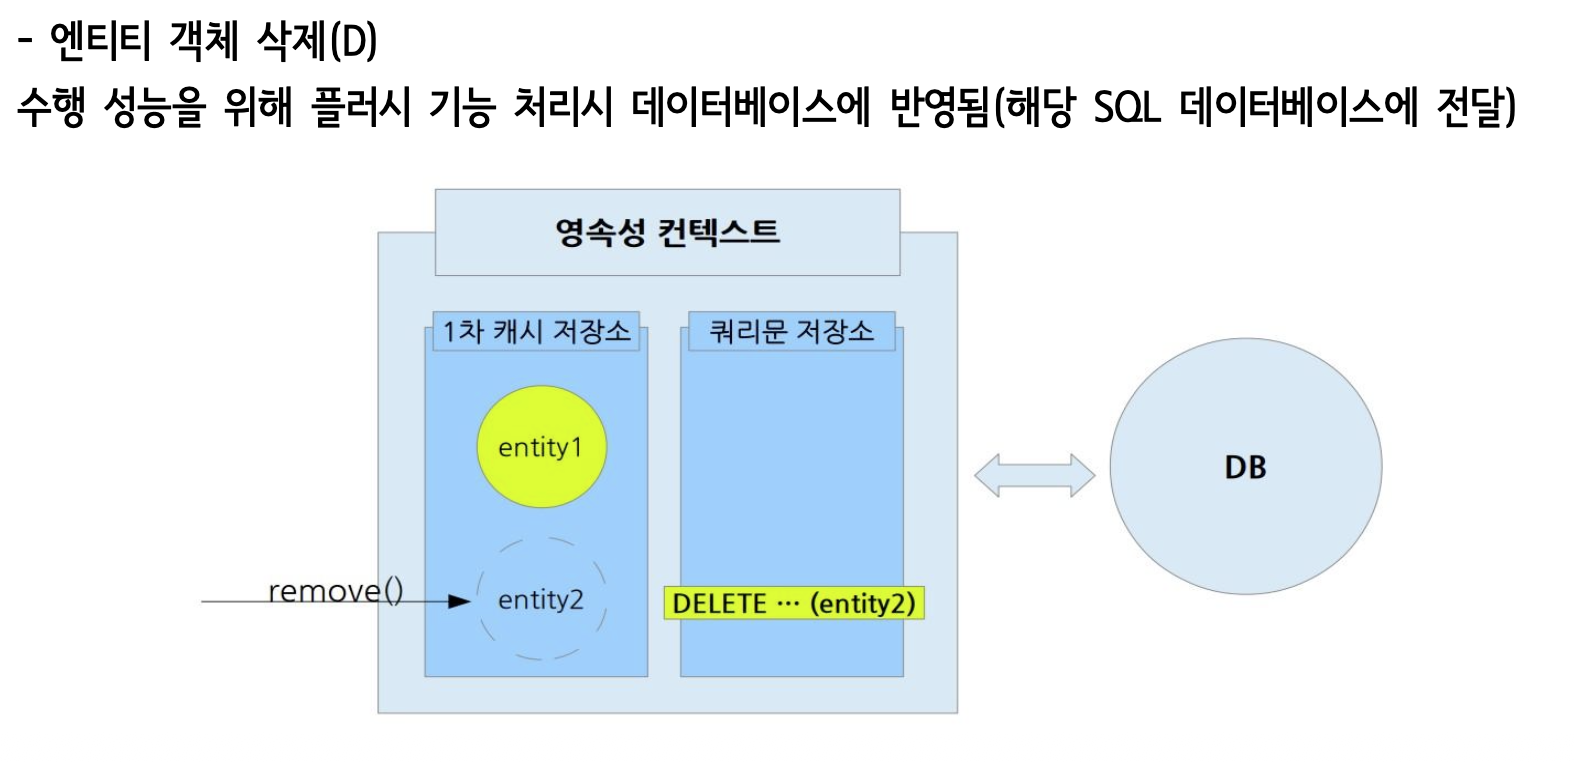
remove()를 호출하면 영속 상태의Entity가 삭제 상태가 된다.
삭제는 데이터베이스 상태를 바꾸는 작업이므로Transaction안에서 처리해야 한다.
삭제할 때는 보통 먼저find()로 삭제 대상Entity를 조회하고, 조회 결과가 있을 때만remove()를 호출한다.// RemoveEntityStateFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 14L); // 삭제 대상 Entity 조회 if (member != null) { // 조회 결과가 있을 때만 삭제 요청 entityManager.remove(member); // 삭제 상태로 등록 } transaction.commit(); // flush 후 삭제 확정
remove()를 호출했다고 해서 그 순간 무조건 데이터베이스에서 바로 삭제된다고 단정하면 안 된다.
삭제 작업도 쓰기 지연SQL저장소에 등록될 수 있다.
이후flush시점에DELETE SQL이 데이터베이스로 전달되고,commit()으로 작업이 확정된다.
remove()를 호출하면 영속 상태의 엔티티가 삭제 대상으로 등록된다.
삭제에 필요한DELETE SQL은 쓰기 지연SQL저장소에 저장될 수 있고, 이후flush시점에 데이터베이스로 전달된다.
삭제도 데이터 변경 작업이므로remove()는Transaction안에서 처리하고commit()으로 확정해야 한다.
8-8. merge는 준영속 Entity의 값을 병합한 영속 Entity를 반환한다
merge()는 준영속 상태의Entity값을 영속성 컨텍스트의 영속Entity에 병합하고, 그 결과로 영속 상태의Entity를 반환하는 메서드이다.
병합은 서로 떨어져 있던 값을 다시 합친다는 뜻이다.
여기서 가장 중요한 점은merge()에 넘긴 객체 자체가 다시 영속 상태가 되는 것이 아니라는 점이다.
merge()가 반환한 객체가 영속 상태이다.
아래 예제는 기본키15L인 데이터가 이미 저장되어 있다고 가정한다.
또MemberEntityComplete안에changeName()메서드가 있다고 가정한다.// MergeDetachedEntityFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete detachedMember = entityManager.find(MemberEntityComplete.class, 15L); // 영속 상태 Entity 조회 if (detachedMember != null) { // 조회 결과가 있을 때만 병합 흐름 진행 entityManager.detach(detachedMember); // 준영속 상태로 분리 detachedMember.changeName("merge변경"); // 준영속 Entity 값 변경 MemberEntityComplete managedMember = entityManager.merge(detachedMember); // 병합 후 영속 Entity 반환 System.out.println(detachedMember == managedMember); // 전달 객체와 반환 객체 비교 } transaction.commit(); // 변경 확정// 출력결과 // false
detachedMember는merge()에 전달한 준영속 객체이다.
managedMember는merge()가 반환한 영속 객체이다.
두 객체는 같은 객체가 아닐 수 있다.
초보자가 가장 많이 헷갈리는 부분이 여기이다.
merge()를 호출했다고 해서detachedMember자체를 계속 사용하면 안 된다.
병합 이후에는 반환된managedMember를 기준으로 작업해야 한다.
조회 결과가 없으면 분리하거나 병합할 대상도 없다.
그래서detachedMember != null조건으로 조회 결과가 있을 때만 병합 흐름을 진행하는 것이 안전하다.
merge()는 전달받은 준영속Entity자체를 다시 관리하는 것이 아니라, 그 값을 병합한 영속Entity를 반환한다.
8-9. Entity 상태와 주요 메서드 흐름 한 번에 연결하기
지금까지 본 내용을 하나로 연결하면
Entity생명주기와 주요 메서드의 흐름이 정리된다.
이 구간은 새로운 문법을 추가하는 부분이 아니라, 비영속 → 영속 → 준영속 → 삭제 상태와 각 메서드의 역할을 한 번에 연결해 보는 마무리이다.
먼저 상태 흐름은 아래처럼 볼 수 있다.
- 비영속 상태:
new로 만든 뒤 아직JPA가 관리하지 않는 상태이다.- 영속 상태:
persist()또는find()를 통해 영속성 컨텍스트가 관리하는 상태이다.- 준영속 상태:
detach(),clear(),close()로 영속성 컨텍스트에서 분리된 상태이다.- 삭제 상태:
remove()로 삭제 대상으로 등록된 상태이다.주요 메서드는 아래처럼 연결된다.
persist()는 비영속Entity를 영속 상태로 만든다.find()는 기본키로Entity를 조회하고, 조회된 객체를 영속 상태로 관리한다.detach()는 특정Entity를 준영속 상태로 만든다.clear()는 영속성 컨텍스트 전체를 비워 모든Entity를 준영속 상태로 만든다.close()는EntityManager를 종료하고 영속성 컨텍스트도 끝낸다.remove()는 영속 상태의Entity를 삭제 상태로 만든다.merge()는 준영속Entity의 값을 병합한 영속Entity를 반환한다.저장, 삭제, 병합처럼 데이터베이스 상태가 바뀔 수 있는 작업은
Transaction안에서 처리해야 한다.
조회는 기본키 기준이면find()를 사용할 수 있고, 조회 결과가 영속 상태가 된다는 점을 함께 기억해야 한다.
마지막으로 전체 흐름을 짧게 정리하면 이렇다.
Entity생명주기는 객체가JPA의 관리 대상인지, 분리되었는지, 삭제 대상으로 등록되었는지를 이해하는 기준이다.
이 기준을 잡으면 저장, 조회, 수정, 삭제 코드가 어떤 상태 변화를 만드는지 훨씬 쉽게 읽을 수 있다.
9. 저장, 조회, 수정, 삭제 흐름 이해하기
JPA의 기본 데이터 작업은 저장, 조회, 수정, 삭제로 나눌 수 있다.
데이터베이스 기준으로는insert,select,update,delete에 해당한다.
이 네 가지 작업을 묶어서CRUD라고 부른다.
CRUD는Create,Read,Update,Delete의 줄임말이다.
하지만JPA에서는 이 작업을 처음부터SQL중심으로 작성하지 않는다.
저장할 때는Entity객체를 만들고persist()로 저장 요청을 한다.
조회할 때는find()로 기본키 기준 조회를 한다.
수정할 때는 영속 상태의Entity값을 변경한다.
삭제할 때는remove()로 삭제 요청을 한다.
JPA의 기본CRUD흐름은 객체를 다루는 코드가 영속성 컨텍스트를 거쳐 실제SQL실행으로 이어지는 구조이다.
9-1. JPA의 CRUD는 EntityManager를 중심으로 진행된다
JPA에서 저장, 조회, 수정, 삭제는EntityManager를 통해 처리한다.
EntityManager는Entity를 실제로 관리하는 객체이고, 내부적으로 영속성 컨텍스트를 사용한다.
같은 작업이라도SQL중심 방식과JPA방식은 출발점이 다르다.
SQL중심 방식은 테이블과 쿼리를 먼저 생각한다.
JPA방식은Entity객체와 그 상태를 먼저 생각한다.
예를 들어 저장 작업을 비교하면 아래처럼 볼 수 있다.// SqlCrudThinking.java String sql = "insert into member(id, name) values(1, '홍길동')"; // 저장 SQL 직접 작성 executeUpdate(sql); // SQL 실행 요청이라고 가정이 방식에서는 개발자가 테이블 이름, 컬럼 이름, 값의 순서를 직접 맞춰야 한다.
즉, 저장 작업의 중심이SQL이다.
JPA에서는 저장할 객체를 먼저 만든다.
아래 코드는 실제 전체 실행 코드가 아니라,JPA방식의 사고 흐름을 보여 주는 예시이다.// JpaCrudThinking.java MemberEntityComplete member = new MemberEntityComplete(16L, "홍길동"); // 저장할 Entity 생성 entityManager.persist(member); // Entity 저장 요청이 방식에서는
Entity객체가 중심이다.
MemberEntityComplete이 어떤 테이블과 연결되는지는 매핑 정보가 알려 준다.
실제insert SQL은JPA구현체가 만들어 실행할 수 있다.
다만 저장, 수정, 삭제는 데이터베이스 상태를 바꾸는 작업이다.
따라서 실제 실행 흐름에서는 반드시Transaction안에서 처리해야 한다.
9-2. 저장은 persist로 요청한다
저장은 새
Entity객체를 만들고persist()로 영속성 컨텍스트에 등록하는 흐름이다.
persist()는 비영속 상태의Entity를 영속 상태로 만든다.
저장 흐름은 아래처럼 이해하면 된다.
new로Entity객체를 만든다.Transaction을 시작한다.persist()로 영속성 컨텍스트에 등록한다.- 저장에 필요한
insert SQL이 쓰기 지연SQL저장소에 모일 수 있다.commit()과정에서flush가 일어나고 저장 작업이 확정된다.아래 코드는 저장 흐름을 보여 준다.
// PersistCrudFlow.java
EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기

try {
    transaction.begin(); // Transaction 시작

    MemberEntityComplete member = new MemberEntityComplete(16L, "저장회원"); // 저장할 Entity 생성

    entityManager.persist(member); // 영속성 컨텍스트에 저장 대상으로 등록

    transaction.commit(); // flush 후 저장 확정
} catch (Exception e) {
    if (transaction.isActive()) { // Transaction 진행 중인지 확인
        transaction.rollback(); // 오류 발생 시 되돌리기
    }
}
persist()만 보고 바로 데이터베이스에 저장됐다고 단정하면 안 된다.
일반적인 흐름에서는 영속성 컨텍스트에 먼저 등록되고,flush시점에 데이터베이스로insert SQL이 전달될 수 있다.
다만IDENTITY전략처럼 데이터베이스가 기본키를 만들어 주는 경우에는 기본키 값을 알기 위해persist()시점에insert SQL이 먼저 실행될 수 있다.
그래서 저장 흐름을 볼 때는 기본키 생성 전략도 함께 생각해야 한다.
직접 할당 기본키를 사용하는 예제이므로 같은 코드를 여러 번 실행하면 기본키 중복 오류가 발생할 수 있다.
다시 실행하려면 기본키 값을 바꾸거나 기존 데이터를 삭제해야 한다.
저장은Entity객체를 만들고,persist()로 영속성 컨텍스트에 등록한 뒤,commit()으로 확정하는 흐름이다.
9-3. 조회는 find로 기본키 기준 조회한다
조회는 데이터베이스에 있는 데이터를
Entity객체로 가져오는 작업이다.
기본키를 기준으로 한 건을 조회할 때는find()를 사용한다.
find()는 두 가지 값을 받는다.
첫 번째는 조회할Entity클래스이고, 두 번째는 조회할 기본키 값이다.// FindCrudFlow.java MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 16L); // 기본키 16L로 Entity 조회
MemberEntityComplete.class는 어떤Entity를 조회할지 알려 준다.
16L은 조회할 기본키 값이다.
find()는 먼저 영속성 컨텍스트의1차 캐시를 확인한다.
이미 같은 기본키의Entity가 관리 중이면 데이터베이스에 다시 가지 않고 그 객체를 반환할 수 있다.
없으면 데이터베이스에서 조회한 뒤 영속성 컨텍스트에 저장하고 반환한다.
조회 결과가 없으면null이 반환될 수 있다.
그래서 조회 결과를 사용할 때는null여부를 확인하는 흐름이 안전하다.// FindNullCheckFlow.java MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 16L); // 기본키로 Entity 조회 if (member != null) { // 조회 결과가 있을 때 System.out.println(member.getName()); // 회원 이름 사용 } else { System.out.println("조회 결과가 없습니다."); // 조회 결과 없음 처리 }
find()로 조회된Entity는 영속 상태가 된다.
영속 상태라는 말은 영속성 컨텍스트가 이 객체를 관리한다는 뜻이다.
따라서 같은EntityManager안에서 다시 같은 기본키로 조회하면 같은 객체가 반환될 수 있다.
9-4. 수정은 update가 아니라 변경 감지로 처리한다
JPA에서 수정은 별도의update()메서드를 호출하는 방식이 아니다.
영속 상태의Entity값을 변경하면,JPA가 변경 감지를 통해 수정 여부를 판단한다.
먼저 엔티티 안에 값을 바꾸는 메서드가 있다고 생각해 보자.
아래 흐름은MemberEntityComplete안에changeName()메서드가 추가되어 있다고 가정한다.// MemberChangeNameForCrud.java public void changeName(String name) { // 이름 변경 메서드 this.name = name; // 현재 Entity의 이름 값 변경 }이제 수정 흐름을 보면 아래와 같다.
수정은 데이터베이스 상태를 바꾸는 작업이므로Transaction안에서 처리한다.// UpdateCrudFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 try { transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 16L); // 수정할 Entity 조회 if (member != null) { // 조회 결과가 있을 때만 수정 member.changeName("수정회원"); // 영속 상태 Entity 값 변경 } transaction.commit(); // 변경 감지 후 수정 확정 } catch (Exception e) { if (transaction.isActive()) { // Transaction 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } }이 코드에는
entityManager.update(member)가 없다.
그래도member가 영속 상태라면JPA는commit()과정에서flush가 일어날 때 스냅샷과 현재 값을 비교할 수 있다.
값이 바뀌었다면UPDATE SQL이 만들어질 수 있다.
flush()가 실행되면JPA는1차 캐시에 있는 엔티티와 스냅샷을 비교한다.
현재 엔티티 값이 스냅샷과 다르면 변경된 엔티티로 판단한다.
그 결과 수정에 필요한UPDATE SQL이 쓰기 지연SQL저장소에 생성되고, 이후 데이터베이스로 전달된다.
수정 흐름은 아래처럼 정리할 수 있다.
find()로 수정할Entity를 조회한다.- 조회된
Entity는 영속 상태가 된다.- 영속 상태의
Entity값을 변경한다.flush시점에 스냅샷과 현재 값을 비교한다.- 변경이 있으면
UPDATE SQL이 만들어진다.commit()으로 작업이 확정된다.수정은
update()를 호출하는 방식이 아니라, 영속 상태Entity의 변경을 감지하는 방식으로 처리된다.
9-5. 수정 시 기본적으로 모든 필드가 UPDATE될 수 있다
변경 감지는 어떤
Entity가 변경되었는지 판단하는 기능이다.
그런데 실제UPDATE SQL을 만들 때는 변경된 필드만이 아니라 전체 필드를 기준으로UPDATE SQL을 만들 수 있다.
예를 들어 이름만 바꿨다고 생각해 보자.
개발자 입장에서는name만 바뀌었다고 느낀다.
하지만JPA구현체는 해당 엔티티의 여러 필드를 함께 포함한UPDATE SQL을 만들 수 있다.
이 방식은 처음에는 비효율적으로 보일 수 있다.
하지만 장점도 있다.
전체 필드를 기준으로UPDATE SQL을 만들면 쿼리 모양이 일정해진다.
쿼리 모양이 일정하면JPA나 데이터베이스가 같은 형태의 쿼리를 재사용하기 쉬워질 수 있다.
반대로 필드가 매우 많고 실제로 바뀌는 필드는 적다면 전체 필드UPDATE가 부담될 수 있다.
이런 경우에는 변경된 필드만UPDATE하는 설정을 고려할 수 있다.
그때 사용하는 것이Hibernate의@DynamicUpdate이다.
변경 감지는 변경 여부를 찾는 기능이고, 실제UPDATE SQL에 어떤 필드가 포함되는지는 설정과 구현 방식에 따라 달라질 수 있다.
9-6. @DynamicUpdate는 변경된 필드만 UPDATE할 때 사용한다
@DynamicUpdate는 변경된 필드만UPDATE SQL에 포함하도록 도와주는Hibernate어노테이션이다.
동적이라는 말은 상황에 따라 달라진다는 뜻이다.
즉, 어떤 필드가 바뀌었는지에 따라 만들어지는UPDATE SQL의 내용이 달라질 수 있다.
예를 들어 아래처럼 엔티티에@DynamicUpdate를 붙일 수 있다.// MemberDynamicUpdate.java import jakarta.persistence.Entity; import jakarta.persistence.Id; import org.hibernate.annotations.DynamicUpdate; @DynamicUpdate // 변경된 필드만 UPDATE SQL에 포함하도록 설정 @Entity // JPA 관리 대상 Entity public class MemberDynamicUpdate { @Id // 기본키 필드 private Long id; private String name; // 이름 private int age; // 나이 protected MemberDynamicUpdate() { // JPA가 사용할 기본 생성자 } }
@DynamicUpdate를 사용하면name만 바뀐 경우name컬럼만 수정하는UPDATE SQL이 만들어질 수 있다.
하지만 항상 사용하는 것이 정답은 아니다.
필드가 적은 엔티티에서는 기본 방식으로도 충분할 수 있다.
오히려 매번 어떤 필드가 바뀌었는지에 따라 다른SQL이 만들어지면 쿼리 재사용 측면에서 불리할 수 있다.
교안 기준으로는 컬럼 개수가 아주 많은 경우, 예를 들어30개 이상이라면 고려해볼 만하다고 이해하면 된다.
@DynamicUpdate는 모든 엔티티에 무조건 붙이는 어노테이션이 아니라, 필드 수가 많고 변경 필드만 갱신하는 것이 유리할 때 고려하는 설정이다.
9-7. 삭제는 remove로 요청한다
삭제는 영속 상태의
Entity를 삭제 대상으로 등록하는 흐름이다.
삭제할 때는 보통 먼저find()로 삭제할Entity를 조회한다.
그다음 조회 결과가 있을 때만remove()를 호출한다.
삭제는 데이터베이스 상태를 바꾸는 작업이므로Transaction안에서 처리한다.// RemoveCrudFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 try { transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 16L); // 삭제할 Entity 조회 if (member != null) { // 조회 결과가 있을 때만 삭제 요청 entityManager.remove(member); // 삭제 대상으로 등록 } transaction.commit(); // 삭제 확정 } catch (Exception e) { if (transaction.isActive()) { // Transaction 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } }
remove()를 호출했다고 해서 그 순간 데이터베이스에서 바로 삭제된다고 단정하면 안 된다.
삭제 작업도 영속성 컨텍스트의 쓰기 지연SQL저장소에 등록될 수 있다.
이후flush시점에DELETE SQL이 데이터베이스로 전달되고,commit()으로 확정된다.
조회 결과가 없으면 삭제할 대상도 없다.
그래서member != null조건으로 조회 결과가 있을 때만remove()를 호출하는 것이 안전하다.
삭제는find()로 대상Entity를 조회하고, 영속 상태의 객체를remove()로 삭제 대상으로 등록한 뒤,commit()으로 확정하는 흐름이다.
9-8. CRUD 흐름 한 번에 정리하기
지금까지 본 내용을 하나로 연결하면
JPA의 기본CRUD흐름이 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라, 저장, 조회, 수정, 삭제가EntityManager와 영속성 컨텍스트를 통해 어떻게 이어지는지 정리하는 마무리이다.
정리하면 아래와 같다.
- 저장:
new로 객체 생성 →persist()→ 영속성 컨텍스트 등록 →flush→insert SQL→commit- 조회:
find()→1차 캐시확인 → 없으면select SQL→Entity반환- 수정:
find()→ 영속 상태Entity값 변경 → 스냅샷 비교 →update SQL→commit- 삭제:
find()→remove()→ 삭제 상태 등록 →delete SQL→commit저장, 수정, 삭제는 모두 데이터베이스 상태를 바꾸는 작업이다.
그래서 학습 단계에서는 흐름을 섞기보다 저장, 수정, 삭제를 분리해서 확인하는 것이 좋다.
저장 직후 같은 영속 상태 객체의 값을 바꾸면 별도의UPDATE SQL이 아니라, 최종 상태가INSERT SQL에 반영될 수 있다.
그래서 저장과 수정은 서로 다른 흐름으로 나누어 보는 편이 더 정확하다.
먼저 아래 코드는 저장 흐름을 확인하는 예제이다.// JpaPersistSummaryFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 try { transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(17L, "CRUD회원"); // 저장할 Entity 생성 entityManager.persist(member); // 저장 요청 transaction.commit(); // 저장 확정 } catch (Exception e) { if (transaction.isActive()) { // Transaction 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } }이 예제는
new로 비영속 상태의Entity를 만들고,persist()로 영속성 컨텍스트에 등록한 뒤,commit()으로 저장을 확정하는 흐름이다.
직접 할당 기본키를 사용하는 예제이므로 같은 코드를 여러 번 실행하면 기본키 중복 오류가 발생할 수 있다.
다시 실행하려면 기본키 값을 바꾸거나 기존 데이터를 삭제해야 한다.
수정은 이미 저장된 데이터가 있다고 가정하고 따로 확인한다.
아래 코드는 기본키17L인 데이터가 이미 저장되어 있다고 가정한다.// JpaUpdateSummaryFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 try { transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 17L); // 수정할 Entity 조회 if (member != null) { // 조회 결과가 있을 때 member.changeName("CRUD수정회원"); // 영속 상태 Entity 값 변경 } transaction.commit(); // 변경 감지 후 수정 확정 } catch (Exception e) { if (transaction.isActive()) { // Transaction 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } }이 예제는
find()로 영속 상태의Entity를 조회한 뒤, 값을 변경하는 흐름이다.
commit()과정에서flush가 일어나면 스냅샷과 현재 값을 비교하고, 변경이 있으면UPDATE SQL이 만들어질 수 있다.
삭제도 이미 저장된 데이터가 있다고 가정하고 따로 확인한다.
아래 코드는 기본키17L인 데이터를 삭제하는 흐름이다.// JpaRemoveSummaryFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 try { transaction.begin(); // Transaction 시작 MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 17L); // 삭제할 Entity 조회 if (member != null) { // 조회 결과가 있을 때만 삭제 entityManager.remove(member); // 삭제 요청 } transaction.commit(); // 삭제 확정 } catch (Exception e) { if (transaction.isActive()) { // Transaction 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } }삭제는 저장, 수정 흐름과 함께 한 번에 섞기보다 따로 확인하는 편이 이해하기 쉽다.
저장한 직후 바로 삭제까지 해 버리면 최종 데이터가 남지 않기 때문에, 조회나 수정 결과를 확인하기 어려워질 수 있기 때문이다.
JPA의CRUD는 메서드 이름을 외우는 것보다,Entity상태가 영속성 컨텍스트 안에서 어떻게 바뀌고 언제SQL로 이어지는지 보는 것이 중요하다.
다음 단계에서는 기본키 조회만으로 부족할 때 사용하는JPA쿼리 방식을 확인한다.
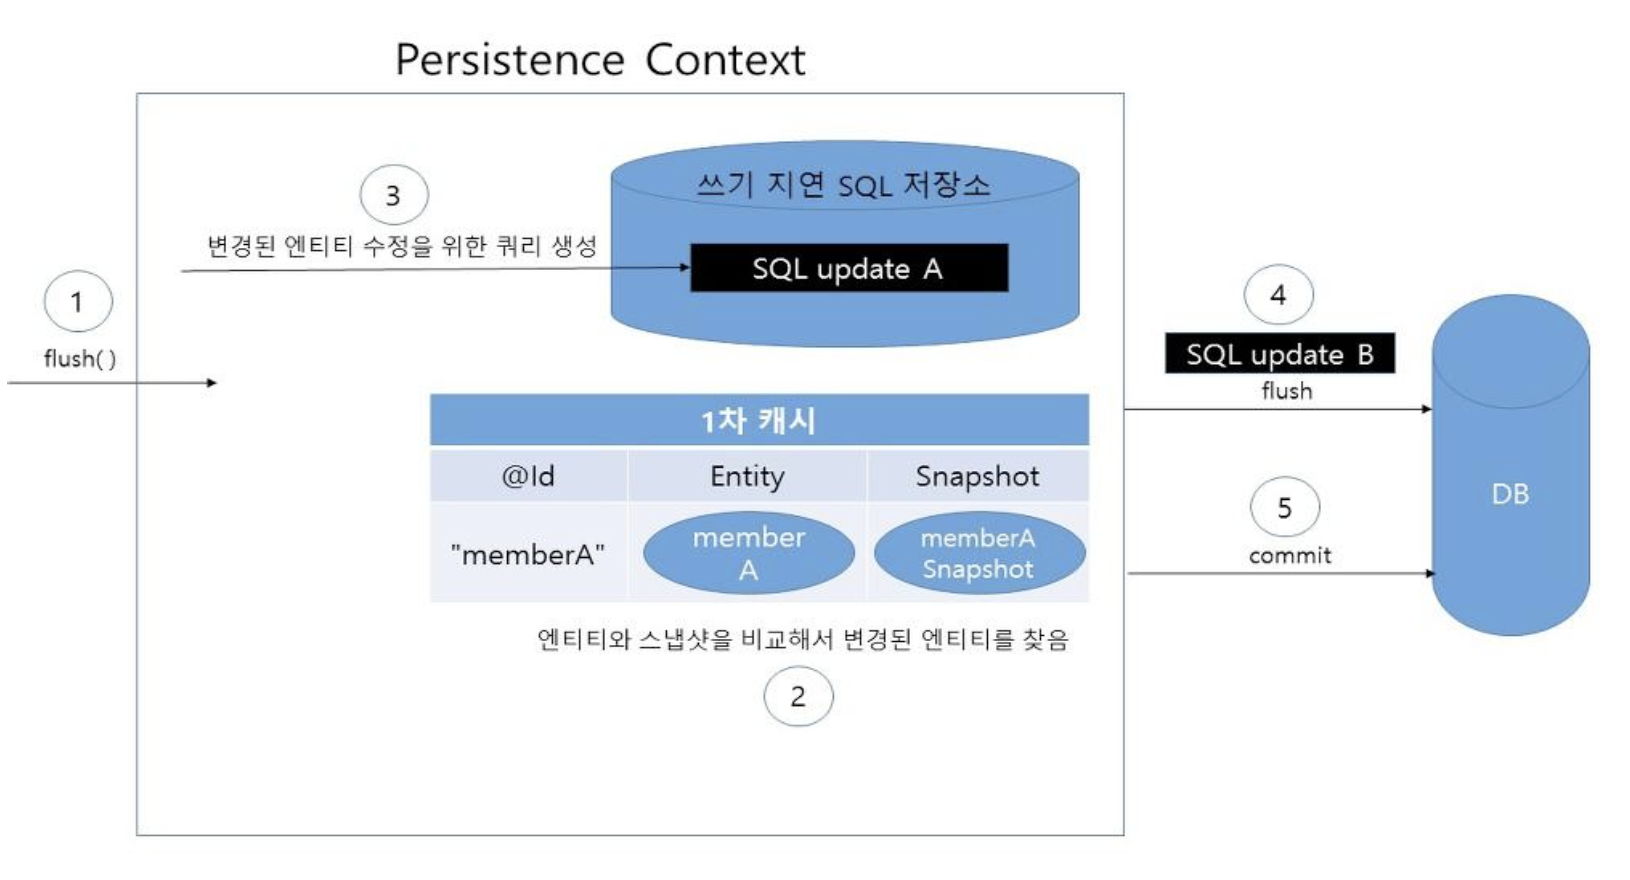
10. JPA 쿼리 방식 전체 보기
JPA에서는 기본키를 기준으로 한 건을 조회할 때find()를 사용할 수 있다.
하지만 실제 데이터 처리에서는 기본키 하나로만 조회하는 경우보다 조건을 걸거나, 여러 데이터를 목록으로 가져오거나, 원하는 필드만 조회하는 경우가 많다.
이때 필요한 것이 쿼리 방식이다.
쿼리는 데이터베이스에서 원하는 데이터를 조회하거나 처리하기 위해 작성하는 명령이다.
JPA에서는 여러 쿼리 방식을 사용할 수 있다.
그중 기본이 되는 방식은JPQL이다.
JPA의 쿼리 방식은 기본키 조회만으로 부족할 때, 원하는 조건과 형태로Entity데이터를 조회하기 위해 사용한다.
10-1. find만으로는 모든 조회를 처리하기 어렵다
find()는 기본키를 기준으로Entity하나를 조회할 때 사용한다.
기본키 값이 정확히 있을 때는 간단하고 명확하다.// FindByIdQueryLimit.java MemberEntityComplete member = entityManager.find(MemberEntityComplete.class, 1L); // 기본키 1L로 Entity 조회이 코드는 기본키가
1L인MemberEntityComplete를 찾는다.
조회 기준이 기본키 하나이므로find()로 충분하다.
하지만 아래와 같은 상황은find()만으로 처리하기 어렵다.
- 이름이 특정 값인 회원을 조회하고 싶을 때
- 회원 목록을 이름순으로 정렬하고 싶을 때
- 전체 회원 수를 구하고 싶을 때
- 특정 필드만 골라서 조회하고 싶을 때
- 한 페이지에 보여 줄 데이터만 잘라서 조회하고 싶을 때
이런 경우에는 기본키 하나가 아니라 조건, 정렬, 집계, 페이징 같은 조회 기준이 필요하다.
그래서JPA에서는JPQL,Criteria,Native SQL같은 쿼리 방식을 사용한다.
10-2. JPA 쿼리 방식과 함께 사용할 수 있는 DB 접근 기술
JPA에서 직접 사용하는 쿼리 방식에는JPQL,JPA Criteria,Native SQL이 있다.
Querydsl은JPA와 함께 자주 사용하는 외부 쿼리 작성 도구이다.
JDBC API,MyBatis,SpringJdbcTemplate은JPA자체의 쿼리 방식이라기보다, 필요할 때 함께 사용할 수 있는 다른 데이터 접근 기술이다.
구분해서 보면 아래와 같다.
JPQL:Entity객체를 대상으로 작성하는JPA의 기본 객체 지향 쿼리이다.JPA Criteria: 문자열이 아니라Java코드로 쿼리를 조립하는JPA표준 방식이다.Native SQL: 실제 데이터베이스 테이블과 컬럼을 대상으로 직접 작성하는SQL이다.Querydsl:JPQL을 더 편하게 코드 기반으로 작성하도록 돕는 외부 도구이다.JDBC API,MyBatis,SpringJdbcTemplate:JPA와 함께 사용할 수 있는 다른 데이터 접근 기술이다.처음부터 모든 방식을 같은 깊이로 이해하려고 하면 복잡하다.
이번 흐름에서는JPQL을 중심으로 잡고, 나머지는 각각 어떤 상황에서 쓰이는지 큰 차이만 이해하면 된다.
MyBatis나JDBC API는JPA가 제공하는 쿼리 방식이 아니라,JPA와 함께 사용할 수 있는 별도의 데이터 접근 기술이다.
10-3. JPQL은 Entity 객체를 대상으로 조회한다
JPQL은Java Persistence Query Language의 줄임말이다.
JPA에서 사용하는 객체 지향 쿼리 언어이다.
객체 지향 쿼리 언어라는 말은 데이터베이스 테이블이 아니라Entity객체를 기준으로 조회한다는 뜻이다.
일반SQL은 테이블과 컬럼을 대상으로 작성한다.
반면JPQL은Entity이름과Entity의 필드 이름을 대상으로 작성한다.
예를 들어 실제 테이블을 조회하는SQL은 아래처럼 쓸 수 있다.// SqlTableQuery.java String sql = "select * from member_direct"; // 테이블을 대상으로 조회하는 SQL이 코드는
member_direct라는 실제 테이블을 대상으로 한다.
SQL에서는 테이블 이름과 컬럼 이름이 기준이다.
반면JPQL은 아래처럼Entity이름을 기준으로 작성한다.// JpqlEntityQuery.java String jpql = "select m from MemberDirect m"; // Entity를 대상으로 조회하는 JPQL여기서
MemberDirect는 테이블 이름이 아니라Entity클래스 이름이다.
m은 별칭이다.
별칭은 쿼리 안에서 대상을 짧게 부르기 위해 붙이는 이름이다.
조건을 걸 때도 차이가 난다.// JpqlFieldCondition.java String jpql = "select m from MemberDirect m where m.name = :name"; // Entity 필드 기준 조건
m.name에서name은 테이블 컬럼 이름이 아니라MemberDirect엔티티의 필드 이름이다.
JPQL은 테이블이 아니라Entity를 대상으로 작성한다는 점이 가장 중요하다.
10-4. JPQL은 결국 SQL로 변환되어 실행된다
JPQL은Entity를 대상으로 작성하지만, 데이터베이스가JPQL을 직접 이해하는 것은 아니다.
데이터베이스는 여전히SQL을 이해한다.
그래서JPA구현체인Hibernate는JPQL을 분석한 뒤, 실제 데이터베이스가 실행할 수 있는SQL로 변환한다.
흐름은 아래처럼 볼 수 있다.
- 개발자는
JPQL을 작성한다.JPQL은Entity와 필드를 기준으로 작성된다.Hibernate가 매핑 정보를 확인한다.- 실제 테이블과 컬럼에 맞는
SQL로 변환한다.- 데이터베이스에
SQL을 실행한다.아래 예시는
JPQL이Entity기준으로 작성된다는 점을 보여 준다.// JpqlExecutionFlow.java List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m", MemberDirect.class ).getResultList(); // JPQL 실행 후 Entity 목록 조회이 코드에서 개발자가 직접
select * from member_direct를 작성하지 않는다.
대신MemberDirect라는Entity를 기준으로 조회한다.
하지만 내부적으로는Hibernate가MemberDirect의 매핑 정보를 보고 실제 테이블 조회SQL을 만들어 실행할 수 있다.
즉,JPQL을 사용해도SQL자체가 사라지는 것은 아니다.
JPQL은 객체 중심으로 작성하고, 실제 실행은JPA구현체가SQL로 바꾸어 처리한다.
10-5. JPA Criteria는 Java 코드로 쿼리를 작성하는 방식이다
JPA Criteria는 문자열로 쿼리를 작성하지 않고,Java코드로 쿼리를 조립하는 방식이다.
문자열 쿼리는 오타가 있어도 실행하기 전까지 발견하기 어려울 수 있다.
Criteria는Java코드 형태로 작성하기 때문에 컴파일 단계에서 일부 오류를 확인할 수 있다는 장점이 있다.
하지만 코드가 길고 복잡해지기 쉽다.
단순한 조회도 여러 객체를 사용해서 작성해야 하므로 초보자가 처음 보기에는 어렵다.
형태만 간단히 보면 아래와 같다.// CriteriaQueryShape.java CriteriaBuilder cb = entityManager.getCriteriaBuilder(); // Criteria 쿼리 작성을 위한 도구 CriteriaQuery<MemberDirect> query = cb.createQuery(MemberDirect.class); // 반환 타입 지정 Root<MemberDirect> member = query.from(MemberDirect.class); // 조회 대상 Entity 지정 query.select(member); // 조회할 대상 지정이 예제는 전체 실행 코드가 아니라
Criteria가 어떤 식으로Java코드로 쿼리를 조립하는지 보여 주는 흐름이다.
Criteria는 조건에 따라 쿼리 내용이 달라지는 동적 쿼리를 만들 때 사용할 수 있다.
동적 쿼리는 사용자의 검색 조건에 따라where조건이 붙기도 하고 빠지기도 하는 쿼리이다.
다만 코드가 복잡해질 수 있기 때문에 실무에서는Querydsl을 더 선호하는 경우도 많다.
이번 단계에서는Criteria를 “문자열이 아니라Java코드로JPQL을 조립하는 표준 방식” 정도로 이해하면 된다.
10-6. Querydsl은 Java 코드로 JPQL을 더 편하게 작성하는 방식이다
Querydsl은Java코드로 쿼리를 작성할 수 있게 도와주는 기술이다.
JPQL을 문자열로 직접 쓰는 대신, 코드 자동완성과 타입 검사를 활용할 수 있다.
타입 검사는 값의 종류가 맞는지 확인하는 과정이다.
Querydsl은JPA Criteria보다 문법이 읽기 쉽고, 동적 쿼리를 작성하기 편하다는 장점이 있다.
그래서 조건이 많은 검색 기능을 만들 때 유용하다.
형태를 아주 단순하게 보면 아래처럼 이해할 수 있다.// QuerydslConceptShape.java // 실제 Querydsl 사용에는 별도 설정과 Q클래스가 필요하다 // 여기서는 문자열 JPQL보다 코드 기반 쿼리를 더 편하게 작성할 수 있다는 흐름만 이해한다
Querydsl은 별도 설정과 추가 학습이 필요하다.
따라서 이번 기본 흐름에서는 깊게 다루지 않는다.
JPQL을 더 편하게 작성하기 위한 도구 정도로 이해하면 된다.
정리하면 아래와 같다.
JPQL은 문자열로 작성하는 기본 객체 지향 쿼리이다.JPA Criteria는Java코드로 쿼리를 조립하는 표준 방식이다.Querydsl은Java코드로 쿼리를 더 읽기 좋게 작성할 수 있도록 돕는 방식이다.이번 글에서는
JPQL을 중심으로 기본 문법을 확인한다.
10-7. Native SQL은 DB 전용 SQL을 직접 사용하는 방식이다
Native SQL은 데이터베이스가 사용하는 실제SQL을 직접 작성하는 방식이다.
여기서Native는 원래의, 고유한이라는 의미에 가깝다.
즉,JPA의 객체 지향 쿼리가 아니라 데이터베이스가 직접 이해하는SQL을 사용하는 것이다.
JPQL은Entity를 대상으로 조회한다.
반면Native SQL은 테이블과 컬럼을 대상으로 조회한다.
비교하면 아래와 같다.// JpqlAndNativeSqlCompare.java String jpql = "select m from MemberDirect m"; // Entity 이름을 사용하는 JPQL String sql = "select * from member_direct"; // 실제 테이블 이름을 사용하는 Native SQL
JPQL의MemberDirect는Entity이름이다.
Native SQL의member_direct는 실제 데이터베이스 테이블 이름이다.
Native SQL은 데이터베이스 전용 기능을 사용해야 할 때 필요할 수 있다.
예를 들어 특정 데이터베이스에서만 제공하는 함수나 문법을 사용해야 하는 경우이다.
하지만 특정 데이터베이스 문법에 의존하기 때문에 데이터베이스 독립성은 떨어질 수 있다.
데이터베이스 독립성은 데이터베이스 종류가 바뀌어도 코드를 많이 바꾸지 않고 사용할 수 있는 성질이다.
Native SQL은 실제 테이블과 컬럼을 직접 다룰 수 있지만, 특정 데이터베이스 문법에 묶일 수 있다.
10-8. JPQL과 Native SQL 조회 대상 비교하기
JPQL과Native SQL은 둘 다 조회에 사용할 수 있다.
하지만 조회 기준이 다르다.
JPQL은Entity이름을 사용하고,Native SQL은 실제 테이블 이름을 사용한다.
아래 예제는 두 방식의 조회 대상 차이를 비교한다.// QueryTypeCompareFlow.java package jpaexam1.app; import jakarta.persistence.EntityManager; import jakarta.persistence.EntityManagerFactory; import jakarta.persistence.Persistence; import jpaexam1.entity.MemberDirect; import java.util.List; public class QueryTypeCompareFlow { public static void main(String[] args) { EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // EntityManagerFactory 생성 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 try { List<MemberDirect> jpqlResult = entityManager.createQuery( "select m from MemberDirect m", MemberDirect.class ).getResultList(); // JPQL은 Entity 이름으로 조회 List<MemberDirect> nativeResult = entityManager.createNativeQuery( "select * from member_direct", MemberDirect.class ).getResultList(); // Native SQL은 테이블 이름으로 조회 System.out.println("JPQL 조회 개수 : " + jpqlResult.size()); // JPQL 결과 개수 출력 System.out.println("Native SQL 조회 개수 : " + nativeResult.size()); // Native SQL 결과 개수 출력 } finally { entityManager.close(); // EntityManager 닫기 factory.close(); // EntityManagerFactory 닫기 } } }// 출력결과 // JPQL 조회 개수 : 데이터베이스에 저장된 데이터 수에 따라 달라짐 // Native SQL 조회 개수 : 데이터베이스에 저장된 데이터 수에 따라 달라짐이 예제의 핵심은 조회 개수가 아니라 조회 기준이다.
"select m from MemberDirect m"은MemberDirect엔티티를 대상으로 조회한다.
"select * from member_direct"는 실제 데이터베이스 테이블을 대상으로 조회한다.
이 차이를 이해하면 다음 단계에서JPQL문법을 볼 때SQL과 헷갈리지 않는다.
10-9. JDBC API, MyBatis, SpringJdbcTemplate도 함께 사용할 수 있다
JPA를 사용한다고 해서 다른 데이터 접근 기술을 절대 사용할 수 없는 것은 아니다.
필요하면JDBC API,MyBatis,SpringJdbcTemplate같은 기술을 함께 사용할 수 있다.
예를 들어 복잡한 통계 쿼리는 직접SQL을 작성하는 편이 더 명확할 수 있다.
또 기존 프로젝트에 이미MyBatis쿼리가 많이 작성되어 있다면,JPA와 함께 사용하는 구조도 가능하다.
다만 함께 사용할 때는 주의할 점이 있다.
JPA는 영속성 컨텍스트라는 중간 관리 공간을 사용한다.
그래서 아직 데이터베이스에 반영되지 않은 변경 내용이 영속성 컨텍스트 안에만 남아 있을 수 있다.
이 상태에서JDBC API나MyBatis로 바로 데이터베이스를 조회하면, 아직 반영되지 않은 변경 내용을 못 볼 수 있다.
JDBC API나MyBatis는 영속성 컨텍스트를 보는 것이 아니라 데이터베이스를 직접 보기 때문이다.
그래서 필요한 시점에는flush()를 호출해서 영속성 컨텍스트의 변경 내용을 데이터베이스에 먼저 반영해야 할 수 있다.
10-10. JPA와 다른 DB 접근 기술을 함께 사용할 때 flush가 필요한 이유
flush는 영속성 컨텍스트의 변경 내용을 데이터베이스에 반영하는 과정이다.
JPA안에서만 작업할 때는commit()이나JPQL실행 시점에 자동으로flush가 일어날 수 있다.
하지만JPA밖의 기술로 데이터베이스에 직접 접근하면 이야기가 달라진다.
JDBC API,MyBatis,SpringJdbcTemplate은 영속성 컨텍스트를 모른다.
이 기술들은 데이터베이스 상태를 직접 본다.
예를 들어JPA로 엔티티를 저장했지만 아직flush되지 않았다고 생각해 보자.
이 상태에서MyBatis로 같은 테이블을 조회하면 방금 저장한 데이터가 조회되지 않을 수 있다.
아직 데이터베이스에 반영되지 않았기 때문이다.
흐름은 이렇게 볼 수 있다.
JPA로Entity를 저장한다.- 저장 내용이 영속성 컨텍스트에만 있다.
- 아직 데이터베이스에는 반영되지 않았다.
MyBatis나JDBC API는 데이터베이스를 직접 조회한다.- 따라서 최신 변경 내용이 보이지 않을 수 있다.
이럴 때는
entityManager.flush()를 호출해서 변경 내용을 데이터베이스에 먼저 반영할 수 있다.
변경 작업과 연결되는flush()는 일반적으로Transaction안에서 사용한다.// FlushBeforeOtherDbAccessFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 transaction.begin(); // Transaction 시작 MemberEntityComplete member = new MemberEntityComplete(18L, "다른기술조회전저장"); // 저장할 Entity 생성 entityManager.persist(member); // JPA 영속성 컨텍스트에 저장 요청 entityManager.flush(); // 같은 Transaction 흐름에서 다른 DB 접근 기술을 사용하기 전에 SQL을 DB로 보냄 // 같은 Transaction 흐름에서 MyBatis나 JDBC API가 조회해야 한다면 flush 시점을 맞춰야 한다 // flush는 DB에 SQL을 보내는 과정이고, 최종 확정은 commit에서 이루어진다 transaction.commit(); // Transaction 확정
flush()는commit()과 같은 말이 아니다.
flush()는 변경 내용을 데이터베이스로 보내는 과정이고,commit()은Transaction을 최종 확정하는 과정이다.
다만flush()는commit()이 아니므로, 별도Transaction이나 별도 데이터베이스 연결에서 조회하면 아직 확정되지 않은 변경 내용이 보이지 않을 수 있다.
즉,flush()는 영속성 컨텍스트와 데이터베이스 사이의 반영 시점을 맞추는 역할이고, 최종 확정은commit()에서 이루어진다.
JPA와 다른 데이터 접근 기술을 함께 사용할 때는 영속성 컨텍스트와 데이터베이스 상태가 어긋나지 않도록flush시점을 의식해야 한다.
여기까지 이해하면JPA쿼리 방식의 큰 그림이 잡힌다.
다음 단계에서는 여러 방식 중 가장 기본이 되는JPQL문법을 자세히 확인한다.
11. JPQL 기본 문법 이해하기
JPQL은JPA에서 사용하는 객체 지향 쿼리 언어이다.
객체 지향 쿼리 언어라는 말은 데이터베이스 테이블이 아니라Entity객체를 기준으로 쿼리를 작성한다는 뜻이다.
문법 모양은SQL과 비슷하다.
하지만 조회 대상이 다르다.
SQL은 테이블과 컬럼을 대상으로 작성하고,JPQL은Entity이름과 필드 이름을 대상으로 작성한다.
JPQL기본 문법에서 가장 중요한 기준은 테이블 이름이 아니라Entity이름을 쓰고, 컬럼 이름이 아니라 필드 이름을 쓴다는 점이다.
11-1. JPQL은 Entity 이름과 필드 이름을 사용한다
JPQL을 처음 볼 때 가장 많이 헷갈리는 부분은 조회 대상이다.
SQL에서는 실제 데이터베이스 테이블 이름을 쓴다.
하지만JPQL에서는Entity이름을 쓴다.
예를 들어MemberDirect라는Entity가 있다고 생각해 보자.
이Entity가 실제로는member_direct테이블과 매핑되어 있더라도,JPQL에서는 테이블 이름이 아니라Entity이름을 사용한다.// JpqlEntityNameFlow.java String jpql = "select m from MemberDirect m"; // MemberDirect는 테이블명이 아니라 Entity 이름
MemberDirect는 조회할Entity이름이다.
뒤의m은 별칭이다.
별칭은 쿼리 안에서MemberDirect를 짧게 부르기 위해 붙인 이름이다.
조건을 걸 때도 컬럼 이름이 아니라 필드 이름을 사용한다.// JpqlFieldNameFlow.java String jpql = "select m from MemberDirect m where m.name = :name"; // name은 Entity의 필드 이름
m.name은MemberDirect엔티티의name필드를 의미한다.
데이터베이스 컬럼 이름이member_name처럼 다르더라도,JPQL에서는 엔티티 필드 이름을 기준으로 작성한다.
비교하면 아래와 같다.// SqlAndJpqlNameCompare.java String sql = "select * from member_direct where member_name = ?"; // SQL은 테이블명과 컬럼명 사용 String jpql = "select m from MemberDirect m where m.name = :name"; // JPQL은 Entity명과 필드명 사용이 차이를 모르면
JPQL에서 테이블 이름을 쓰거나 컬럼 이름을 써서 오류가 날 수 있다.
JPQL에서는@Table에 적은 테이블 이름이 아니라@Entity로 관리되는 엔티티 이름을 사용한다.
11-2. select와 from은 조회 대상을 정한다
JPQL의 기본 구조는select와from으로 시작한다.
select는 무엇을 조회할지 정한다.
from은 어떤Entity에서 조회할지 정한다.
JPQL의 기본 조회문은select절과from절을 중심으로 작성한다.
필요에 따라where,group by,having,order by절을 뒤에 붙여 조건, 그룹화, 정렬을 처리할 수 있다.
가장 기본 형태는 아래와 같다.// JpqlSelectFromBasic.java String jpql = "select m from MemberDirect m"; // MemberDirect Entity 전체 조회
select m은 별칭m이 가리키는Entity전체를 조회한다는 뜻이다.
from MemberDirect m은MemberDirect엔티티를 조회 대상으로 두고, 그 엔티티를m이라는 이름으로 부르겠다는 뜻이다.
별칭을 사용하는 이유는 쿼리 안에서 필드를 지정하기 위해서이다.
예를 들어 이름 조건을 걸려면m.name처럼 별칭을 통해 필드에 접근한다.// JpqlAliasFieldAccess.java String jpql = "select m from MemberDirect m where m.name = :name"; // 별칭 m으로 name 필드 접근여기서
m.name은MemberDirect엔티티의name필드이다.
별칭을 붙이면 쿼리가 길어져도 어떤 엔티티의 필드인지 분명하게 표현할 수 있다.
select절에서 엔티티 전체를 조회하면 결과 타입은 엔티티 타입이 된다.
따라서MemberDirect전체를 조회한다면 결과는MemberDirect객체 목록으로 받을 수 있다.
11-3. where는 조회 조건을 지정한다
where는 조회 조건을 지정할 때 사용한다.
조건은 어떤 데이터를 가져올지 걸러 내는 기준이다.
예를 들어 이름이 특정 값인 회원만 조회하고 싶다면 아래처럼 작성한다.// JpqlWhereCondition.java String jpql = "select m from MemberDirect m where m.name = :name"; // name 값이 같은 Entity만 조회
where m.name = :name은name필드 값이 전달한 값과 같은 데이터만 조회하겠다는 뜻이다.
:name은 파라미터이다.
파라미터는 쿼리 안에 나중에 값을 넣기 위해 비워 둔 자리라고 이해하면 된다.
조건에는 숫자 비교도 사용할 수 있다.// JpqlWhereNumberCondition.java String jpql = "select m from MemberDirect m where m.id >= :id"; // id가 기준값 이상인 Entity 조회
m.id >= :id는id필드가 전달한 기준값 이상인 엔티티만 조회한다는 뜻이다.
조건을 여러 개 연결할 수도 있다.// JpqlWhereAndCondition.java String jpql = "select m from MemberDirect m where m.id >= :id and m.name = :name"; // 두 조건 모두 만족
and는 두 조건을 모두 만족해야 한다는 뜻이다.
조건이 많아질수록 쿼리가 복잡해지므로, 처음에는 한 조건씩 정확히 읽는 연습이 중요하다.
11-4. 파라미터 바인딩은 값 자리에 안전하게 값을 넣는 방식이다
파라미터 바인딩은 쿼리의 값 자리에 실제 값을 연결하는 방식이다.
바인딩은 묶는다는 뜻이다.
즉, 쿼리 안의 파라미터와 실제 값을 연결한다는 의미이다.
JPQL에서는 이름 기준 파라미터를 자주 사용한다.
이름 기준 파라미터는:name처럼 콜론 뒤에 이름을 붙여 사용한다.// NamedParameterBindingFlow.java String jpql = "select m from MemberDirect m where m.name = :name"; // :name 파라미터 사용 List<MemberDirect> members = entityManager.createQuery(jpql, MemberDirect.class) .setParameter("name", "홍길동") // name 파라미터에 실제 값 연결 .getResultList(); // 결과 목록 조회
:name은 쿼리 안의 빈자리이다.
setParameter("name", "홍길동")은 그 빈자리에"홍길동"값을 넣겠다는 뜻이다.
파라미터 바인딩을 사용하면 문자열을 직접 이어 붙이는 방식보다 안전하고 읽기 쉽다.
아래처럼 값을 문자열로 직접 이어 붙이는 방식은 좋지 않다.// StringConcatQueryBadFlow.java String name = "홍길동"; // 검색할 이름 String jpql = "select m from MemberDirect m where m.name = '" + name + "'"; // 문자열을 직접 이어 붙이는 방식이 방식은 값에 특수 문자가 들어가면 쿼리 모양이 깨질 수 있다.
또 쿼리와 값이 뒤섞여 가독성이 떨어진다.
따라서 값은setParameter()로 연결하는 방식이 좋다.// ParameterBindingGoodFlow.java String jpql = "select m from MemberDirect m where m.name = :name"; // 파라미터 자리 지정 List<MemberDirect> members = entityManager.createQuery(jpql, MemberDirect.class) .setParameter("name", "홍길동") // 안전하게 값 바인딩 .getResultList(); // 결과 목록 조회
JPQL에서 조건 값을 넣을 때는 문자열을 직접 이어 붙이기보다 파라미터 바인딩을 사용하는 것이 좋다.
11-5. createQuery는 JPQL을 실행할 Query 객체를 만든다
createQuery()는JPQL문자열을 실행할 수 있는 쿼리 객체로 만드는 메서드이다.
쿼리 객체는 아직 결과를 가져온 것이 아니라, 실행 준비가 된 상태라고 이해하면 된다.
아래 코드는JPQL문자열을TypedQuery로 만드는 흐름이다.// CreateTypedQueryFlow.java String jpql = "select m from MemberDirect m"; // 실행할 JPQL TypedQuery<MemberDirect> query = entityManager.createQuery(jpql, MemberDirect.class); // 결과 타입을 지정한 Query 생성
TypedQuery<MemberDirect>는 결과 타입이MemberDirect라는 뜻이다.
즉, 이 쿼리를 실행하면MemberDirect객체가 결과로 나온다고 컴파일 단계에서 알 수 있다.
반환 타입을 지정하지 않으면 일반Query를 사용할 수도 있다.// CreateRawQueryFlow.java Query query = entityManager.createQuery("select m from MemberDirect m"); // 타입을 명시하지 않은 Query하지만 일반
Query는 결과 타입이 명확하지 않아 나중에 형변환이 필요할 수 있다.
형변환은 어떤 값을 다른 타입으로 바꾸는 작업이다.
초보자 입장에서는 실수 가능성이 커질 수 있다.
그래서 결과 타입을 알고 있다면TypedQuery를 사용하는 편이 좋다.// TypedQueryPreferredFlow.java TypedQuery<MemberDirect> query = entityManager.createQuery( "select m from MemberDirect m", MemberDirect.class ); // Entity 결과 타입을 명확하게 지정조회 결과 타입을 알 수 있다면 일반
Query보다TypedQuery를 사용하는 것이 안전하다.
11-6. getResultList는 결과 목록을 가져온다
getResultList()는 쿼리 실행 결과를 목록으로 가져오는 메서드이다.
결과가 여러 개일 수 있는 조회에서 사용한다.
// GetResultListFlow.java
List<MemberDirect> members = entityManager.createQuery(
        "select m from MemberDirect m", MemberDirect.class
).getResultList(); // 결과 목록 조회
이 코드는
MemberDirect엔티티 목록을 조회한다.
결과가 여러 건이면 여러 객체가List에 담긴다.
List는 여러 값을 순서대로 담는 자료구조이다.
중요한 점은 결과가 없어도 보통null이 아니라 빈 목록이 반환된다는 것이다.
빈 목록은 결과가 하나도 없지만, 목록 객체 자체는 존재하는 상태이다.
// EmptyResultListFlow.java
List<MemberDirect> members = entityManager.createQuery(
        "select m from MemberDirect m where m.name = :name", MemberDirect.class
)
.setParameter("name", "없는이름") // 존재하지 않는 이름이라고 가정
.getResultList(); // 결과가 없으면 빈 List 반환

System.out.println(members.size()); // 목록 크기 출력
// 출력결과 // 0결과가 없을 때 빈 목록이 반환되면 반복문을 돌릴 때도 안전하다.
조회 결과가 여러 개일 수 있다면getResultList()를 사용한다고 이해하면 된다.
11-7. getSingleResult는 결과 하나를 가져온다
getSingleResult()는 결과가 정확히 하나라고 기대할 때 사용하는 메서드이다.
예를 들어 기본키처럼 결과가 하나로 정해지는 조건이거나,count()처럼 결과가 하나인 집계 조회에서 사용할 수 있다.
// GetSingleResultFlow.java
MemberDirect member = entityManager.createQuery(
        "select m from MemberDirect m where m.id = :id", MemberDirect.class
)
.setParameter("id", 1L) // 기본키 값 바인딩
.getSingleResult(); // 결과 하나 조회
이 코드는 기본키
1L인MemberDirect를 하나 조회한다고 기대한다.
하지만getSingleResult()는 주의해서 사용해야 한다.
결과가 없으면 예외가 발생할 수 있다.
결과가 둘 이상이어도 예외가 발생할 수 있다.
예외는 프로그램 실행 중 문제가 발생했음을 나타내는 상황이다.
결과가 없을 수 있거나 여러 개일 수 있다면getResultList()를 먼저 사용하는 편이 더 안전할 수 있다.// GetResultListForOptionalOneFlow.java List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m where m.name = :name", MemberDirect.class ) .setParameter("name", "홍길동") // 이름 조건 .getResultList(); // 결과가 0개 이상일 수 있으므로 목록으로 조회 if (!members.isEmpty()) { // 결과가 있으면 MemberDirect firstMember = members.get(0); // 첫 번째 결과 사용 }
getSingleResult()는 “하나만 나올 것이다”가 확실할 때 사용해야 한다.
그렇지 않으면 예외 상황을 처리해야 한다.
결과가 여러 개일 수 있으면getResultList(), 결과가 정확히 하나라고 확신할 수 있으면getSingleResult()를 사용한다.
11-8. JPQL 키워드와 Entity 이름의 대소문자 구분
JPQL에서는 대소문자 구분 기준을 알아야 한다.
대소문자는 영어의 큰 글자와 작은 글자를 의미한다.
select,from,where같은JPQL키워드는 대소문자를 크게 구분하지 않는다.
아래 두 쿼리는 키워드만 보면 같은 의미로 볼 수 있다.// JpqlKeywordCaseFlow.java String jpql1 = "select m from MemberDirect m"; // 소문자 키워드 String jpql2 = "SELECT m FROM MemberDirect m"; // 대문자 키워드하지만
Entity이름과 필드 이름은 대소문자를 구분한다.
MemberDirect라는 엔티티를memberdirect처럼 쓰면 다른 이름으로 인식될 수 있다.
name필드를Name처럼 쓰는 것도 문제가 될 수 있다.
// JpqlEntityCaseBadFlow.java
String jpql = "select m from memberdirect m where m.Name = :name"; // Entity 이름과 필드 이름 대소문자 오류 가능
이 코드는
memberdirect와Name이 실제 엔티티 이름과 필드 이름과 다르다면 오류가 날 수 있다.
정리하면 아래와 같다.
JPQL키워드: 대소문자 구분이 크지 않다.Entity이름: 대소문자를 구분한다.- 필드 이름: 대소문자를 구분한다.
초보자 입장에서는 키워드는 소문자로 통일하고,
Entity이름과 필드 이름은 코드에 있는 이름 그대로 쓰는 습관이 좋다.
11-9. JPQL 기본 조회 흐름 한 번에 보기
지금까지 본 내용을 하나로 연결하면
JPQL기본 조회 흐름이 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라,JPQL작성 →createQuery()→ 파라미터 바인딩 →getResultList()실행 흐름을 한 번에 확인하는 마무리이다.
아래 예제는 이름 조건으로MemberDirect목록을 조회한다.
조회 작업만 수행하므로 데이터베이스 상태를 바꾸지 않는다.// JpqlBasicSelectFlow.java package jpaexam1.app; import jakarta.persistence.EntityManager; import jakarta.persistence.EntityManagerFactory; import jakarta.persistence.Persistence; import jakarta.persistence.TypedQuery; import jpaexam1.entity.MemberDirect; import java.util.List; public class JpqlBasicSelectFlow { public static void main(String[] args) { EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // EntityManagerFactory 생성 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 try { String jpql = "select m from MemberDirect m where m.name = :name"; // Entity와 필드 기준 JPQL 작성 TypedQuery<MemberDirect> query = entityManager.createQuery(jpql, MemberDirect.class); // TypedQuery 생성 query.setParameter("name", "홍길동"); // name 파라미터에 값 바인딩 List<MemberDirect> members = query.getResultList(); // 결과 목록 조회 System.out.println("조회 개수 : " + members.size()); // 조회 결과 개수 출력 } finally { entityManager.close(); // EntityManager 닫기 factory.close(); // EntityManagerFactory 닫기 } } }// 출력결과 // 조회 개수 : 데이터베이스에 저장된 데이터에 따라 달라짐이 예제에서
MemberDirect는 테이블 이름이 아니라Entity이름이다.
m.name은 컬럼 이름이 아니라 엔티티의 필드 이름이다.
:name은 나중에 실제 값을 넣을 파라미터 자리이고,setParameter()가 그 값을 연결한다.
createQuery()는JPQL을 실행할 쿼리 객체로 만든다.
getResultList()는 쿼리를 실행하고 결과 목록을 가져온다.
JPQL기본 흐름은Entity기준 쿼리를 작성하고, 파라미터를 바인딩한 뒤, 결과 조회 메서드로 실행하는 것이다.
이 흐름을 이해하면 다음 단계에서 조건, 정렬, 여러 결과 형태를 더 쉽게 볼 수 있다.
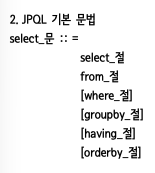
12. JPQL 조건식과 연산자 이해하기
JPQL에서 원하는 데이터를 조회하려면 조건식을 이해해야 한다.
조건식은 어떤 데이터를 가져올지 판단하는 기준이다.
예를 들어 이름이 같은 회원만 조회하거나, 특정 번호 이상인 데이터만 조회하거나, 이름에 특정 글자가 들어간 데이터를 조회할 수 있다.
조건식은 보통where절에서 사용한다.
where절은 전체 데이터 중에서 조건에 맞는 데이터만 걸러 내는 구간이다.
JPQL조건식의 핵심은Entity의 필드 값을 기준으로 필요한 데이터만 골라 조회하는 것이다.
12-1. 조건식은 where 절에서 데이터를 걸러내는 기준이다
where절은 조회 조건을 작성하는 위치이다.
조건이 없으면 조회 대상Entity의 모든 데이터가 조회될 수 있다.
조건이 있으면 그 조건을 만족하는 데이터만 조회된다.
예를 들어 전체 회원을 조회하는JPQL은 아래처럼 작성할 수 있다.// JpqlSelectAllFlow.java String jpql = "select m from MemberDirect m"; // 전체 MemberDirect Entity 조회이 쿼리에는
where절이 없다.
그래서MemberDirect엔티티 전체를 조회하는 흐름이다.
이름이 특정 값인 회원만 조회하려면where절을 붙인다.// JpqlWhereBasicFlow.java String jpql = "select m from MemberDirect m where m.name = :name"; // 이름이 같은 Entity만 조회
where m.name = :name은name필드 값이 파라미터로 전달한 값과 같은 데이터만 조회하겠다는 뜻이다.
여기서m.name은 테이블 컬럼명이 아니라MemberDirect엔티티의 필드 이름이다.
조건식은 단순히 문법을 외우는 부분이 아니다.
조건식을 이해하면 많은 데이터 중에서 필요한 데이터만 가져올 수 있다.
그래서 목록 조회, 검색 기능, 필터 기능을 만들 때 반드시 필요하다.
12-2. 비교 연산자는 값을 비교할 때 사용한다
비교 연산자는 두 값을 비교할 때 사용하는 기호이다.
예를 들어 같은지, 다른지, 큰지, 작은지 판단할 수 있다.
대표적인 비교 연산자는 아래와 같다.
=: 같다.<>: 같지 않다.>: 크다.>=: 크거나 같다.<: 작다.<=: 작거나 같다.이름이 같은 데이터를 조회할 때는
=를 사용한다.// JpqlEqualConditionFlow.java String jpql = "select m from MemberDirect m where m.name = :name"; // name 값이 같은 Entity 조회
m.name = :name은 엔티티의name필드 값이 전달받은 값과 같은지 비교한다.
기본키 값이 특정 값 이상인 데이터를 조회할 때는>=를 사용할 수 있다.// JpqlGreaterEqualConditionFlow.java String jpql = "select m from MemberDirect m where m.id >= :id"; // id가 기준값 이상인 Entity 조회
m.id >= :id는 엔티티의id필드 값이 전달받은 기준값보다 크거나 같은지 비교한다.
같지 않은 값을 찾고 싶다면<>를 사용할 수 있다.// JpqlNotEqualConditionFlow.java String jpql = "select m from MemberDirect m where m.name <> :name"; // name 값이 다른 Entity 조회
<>는 같지 않다는 뜻이다.
SQL과 비슷하게 사용할 수 있지만, 비교 대상은 테이블 컬럼이 아니라 엔티티 필드라는 점을 계속 기억해야 한다.
12-3. and, or, not은 조건을 연결하거나 뒤집는다
조건이 하나만 있으면 비교 연산자만으로 충분할 수 있다.
하지만 실제 조회에서는 조건이 여러 개 필요한 경우가 많다.
이때and,or,not을 사용한다.
and는 두 조건을 모두 만족해야 한다.// JpqlAndConditionFlow.java String jpql = "select m from MemberDirect m where m.id >= :id and m.name = :name"; // 두 조건 모두 만족이 쿼리는
id가 기준값 이상이고, 동시에name도 전달한 값과 같은 데이터를 조회한다.
둘 중 하나만 만족하면 결과에 포함되지 않는다.
or는 두 조건 중 하나라도 만족하면 된다.// JpqlOrConditionFlow.java String jpql = "select m from MemberDirect m where m.name = :name1 or m.name = :name2"; // 둘 중 하나라도 만족이 쿼리는
name1값과 같거나,name2값과 같은 데이터를 조회한다.
둘 중 하나만 맞아도 결과에 포함될 수 있다.
not은 조건의 결과를 반대로 뒤집는다.// JpqlNotConditionFlow.java String jpql = "select m from MemberDirect m where not (m.name = :name)"; // name이 같지 않은 Entity 조회
not (m.name = :name)은 이름이 전달한 값과 같지 않은 데이터를 찾는 조건이다.
m.name <> :name과 비슷한 의미로 볼 수 있다.
조건이 여러 개 연결되면 읽기 어려워질 수 있다.
처음에는 괄호를 사용해서 조건의 범위를 분명하게 잡는 것이 좋다.
12-4. between은 범위 조건을 지정한다
between은 어떤 값이 시작값과 끝값 사이에 있는지 확인할 때 사용한다.
숫자, 날짜처럼 범위를 판단할 수 있는 값에 사용할 수 있다.
예를 들어 기본키 값이1이상10이하인 데이터를 조회하고 싶다면 아래처럼 작성할 수 있다.// JpqlBetweenConditionFlow.java String jpql = "select m from MemberDirect m where m.id between :startId and :endId"; // id 범위 조건
m.id between :startId and :endId는id가startId이상이고endId이하인 데이터를 조회한다는 뜻이다.
같은 조건을 비교 연산자로 쓰면 아래와 비슷하다.// JpqlBetweenCompareFlow.java String jpql = "select m from MemberDirect m where m.id >= :startId and m.id <= :endId"; // between과 비슷한 범위 조건두 쿼리는 범위를 조회한다는 점에서 비슷하다.
between은 범위 조건을 더 짧고 명확하게 표현할 때 사용할 수 있다.
between은 시작값과 끝값을 포함하는 범위 조건으로 이해하면 된다.
12-5. in은 여러 값 중 하나에 포함되는지 확인한다
in은 어떤 값이 여러 값 중 하나에 포함되는지 확인할 때 사용한다.
여러 개의 값을or로 계속 연결하는 대신 더 간단하게 표현할 수 있다.
예를 들어 이름이"홍길동"또는"이순신"인 데이터를 조회하고 싶다면 아래처럼 작성할 수 있다.// JpqlInConditionFlow.java String jpql = "select m from MemberDirect m where m.name in (:names)"; // names 목록에 포함되는 이름 조회
:names에는 여러 이름이 담긴 목록을 전달할 수 있다.// JpqlInParameterFlow.java List<String> names = List.of("홍길동", "이순신"); // 조회할 이름 목록 List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m where m.name in (:names)", MemberDirect.class ) .setParameter("names", names) // names 파라미터에 목록 연결 .getResultList(); // 결과 목록 조회
in (:names)는name값이names목록 안에 들어 있으면 조회하겠다는 뜻이다.
or로 쓰면 아래처럼 길어질 수 있다.// JpqlOrInsteadOfInFlow.java String jpql = "select m from MemberDirect m where m.name = :name1 or m.name = :name2"; // or로 여러 값 비교조회할 값이 많아질수록
or조건은 길어지고 읽기 어려워진다.
이럴 때in을 사용하면 여러 값 조건을 더 간단하게 표현할 수 있다.
12-6. like는 문자열 패턴을 비교한다
like는 문자열이 특정 패턴과 맞는지 확인할 때 사용한다.
패턴은 어떤 글자 형태를 의미한다.
정확히 같은 값이 아니라, 특정 글자로 시작하거나 특정 글자를 포함하는 데이터를 찾을 때 사용한다.
like에서는%와_를 함께 사용할 수 있다.
%는 글자가 없거나 여러 글자가 올 수 있다는 뜻이다.
_는 글자 하나가 올 수 있다는 뜻이다.
이름에"길"이 포함된 데이터를 찾고 싶다면 아래처럼 작성할 수 있다.// JpqlLikeContainsFlow.java String jpql = "select m from MemberDirect m where m.name like :keyword"; // 문자열 패턴 조건실제 값은 파라미터로 연결한다.
// JpqlLikeContainsParameterFlow.java
List<MemberDirect> members = entityManager.createQuery(
        "select m from MemberDirect m where m.name like :keyword", MemberDirect.class
)
.setParameter("keyword", "%길%") // 앞뒤에 어떤 글자가 와도 되고, 길이 포함되면 조회
.getResultList(); // 결과 목록 조회
"%길%"은 앞뒤에 어떤 글자가 와도 되고, 중간에"길"이 포함되면 된다는 뜻이다.
특정 글자로 시작하는 값을 찾으려면 뒤에%를 붙인다.// JpqlLikeStartsWithFlow.java String jpql = "select m from MemberDirect m where m.name like :keyword"; // 시작 글자 조건 String keyword = "홍%"; // 홍으로 시작하는 이름특정 글자로 끝나는 값을 찾으려면 앞에
%를 붙인다.// JpqlLikeEndsWithFlow.java String jpql = "select m from MemberDirect m where m.name like :keyword"; // 끝 글자 조건 String keyword = "%동"; // 동으로 끝나는 이름
like는 검색 기능에서 자주 사용된다.
정확히 같은 값만 찾는=와 달리, 문자열 일부를 기준으로 찾을 수 있기 때문이다.
12-7. is null과 is not null은 값이 없는지 확인한다
null은 값이 없다는 뜻이다.
문자열이 빈 문자열인 것과는 다르다.
빈 문자열은 길이가0인 문자열 값이고,null은 값 자체가 없는 상태이다.
JPQL에서 값이 없는 데이터를 찾을 때는is null을 사용한다.// JpqlIsNullConditionFlow.java String jpql = "select m from MemberDirect m where m.name is null"; // name 값이 없는 Entity 조회
m.name is null은name필드 값이 없는 데이터를 조회한다는 뜻이다.
반대로 값이 있는 데이터를 찾을 때는is not null을 사용한다.// JpqlIsNotNullConditionFlow.java String jpql = "select m from MemberDirect m where m.name is not null"; // name 값이 있는 Entity 조회
null은=로 비교하지 않는다.
아래처럼 쓰는 방식은 피해야 한다.// JpqlNullCompareBadFlow.java String jpql = "select m from MemberDirect m where m.name = null"; // null 비교로 적절하지 않은 흐름
null여부를 판단할 때는is null또는is not null을 사용한다고 기억하면 된다.
null은 값이 없는 상태이므로=비교가 아니라is null,is not null로 판단한다.
12-8. 조건식에서도 파라미터 바인딩을 함께 사용한다
조건식에는 실제 값을 직접 쓰기보다 파라미터 바인딩을 사용하는 것이 좋다.
파라미터 바인딩은 쿼리 안의 빈자리와 실제 값을 연결하는 방식이다.
예를 들어id범위와 이름 패턴을 함께 조건으로 걸어 보자.// JpqlConditionParameterBindingFlow.java String jpql = "select m from MemberDirect m where m.id between :startId and :endId and m.name like :keyword"; // 범위와 패턴 조건 List<MemberDirect> members = entityManager.createQuery(jpql, MemberDirect.class) .setParameter("startId", 1L) // 시작 id 값 연결 .setParameter("endId", 10L) // 끝 id 값 연결 .setParameter("keyword", "%길%") // 이름 패턴 값 연결 .getResultList(); // 결과 목록 조회이 쿼리는
id가1이상10이하이고, 이름에"길"이 포함된 데이터를 조회한다.
파라미터 이름은 쿼리 안의 이름과 정확히 맞아야 한다.
쿼리에:startId라고 썼다면setParameter("startId", 값)으로 연결해야 한다.
이름이 다르면JPA가 어떤 값이 어느 자리에 들어가야 하는지 알 수 없다.
조건식이 복잡해질수록 파라미터 바인딩이 더 중요하다.
값을 직접 이어 붙이면 쿼리 모양이 깨질 수 있고, 조건이 많아졌을 때 읽기도 어려워진다.
12-9. JPQL 조건 조회 흐름 한 번에 보기
지금까지 본 내용을 하나로 연결하면
JPQL조건 조회 흐름이 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라,where조건식 → 파라미터 바인딩 → 결과 목록 조회 흐름을 한 번에 확인하는 마무리이다.
아래 예제는id범위, 이름 목록, 이름 패턴 조건을 함께 사용한다.
조회 작업만 수행하므로 데이터베이스 상태를 바꾸지 않는다.// JpqlConditionSelectFlow.java package jpaexam1.app; import jakarta.persistence.EntityManager; import jakarta.persistence.EntityManagerFactory; import jakarta.persistence.Persistence; import jpaexam1.entity.MemberDirect; import java.util.List; public class JpqlConditionSelectFlow { public static void main(String[] args) { EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // EntityManagerFactory 생성 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 try { String jpql = "select m from MemberDirect m " + "where m.id between :startId and :endId " + "and m.name in (:names) " + "and m.name like :keyword"; // 여러 조건을 함께 사용 List<String> names = List.of("홍길동", "이순신", "강감찬"); // 이름 조건 목록 List<MemberDirect> members = entityManager.createQuery(jpql, MemberDirect.class) .setParameter("startId", 1L) // 시작 id .setParameter("endId", 20L) // 끝 id .setParameter("names", names) // 이름 목록 .setParameter("keyword", "%길%") // 이름 패턴 .getResultList(); // 조건에 맞는 결과 목록 조회 System.out.println("조건 조회 개수 : " + members.size()); // 조회 개수 출력 } finally { entityManager.close(); // EntityManager 닫기 factory.close(); // EntityManagerFactory 닫기 } } }// 출력결과 // 조건 조회 개수 : 데이터베이스에 저장된 데이터와 조건에 따라 달라짐이 예제의 핵심은 조건식을 하나씩 읽는 것이다.
m.id between :startId and :endId는id범위 조건이다.
m.name in (:names)는 이름이 목록 안에 포함되는지 확인한다.
m.name like :keyword는 이름이 패턴과 맞는지 확인한다.
세 조건은and로 연결되어 있다.
따라서 세 조건을 모두 만족하는 데이터만 조회된다.
JPQL조건식은 필요한 데이터를 정확히 골라내기 위한 기준이며, 조건 값은 파라미터 바인딩으로 안전하게 연결하는 것이 좋다.
다음 단계에서는 조회 결과를 어떤 형태로 받을 수 있는지 확인한다.
13. JPQL 조회 결과 형태 이해하기
JPQL은 조회 대상에 따라 결과 형태가 달라진다.
엔티티 전체를 조회하면Entity객체가 결과로 나오고, 특정 필드만 조회하면 그 필드 타입의 값이 결과로 나온다.
여러 필드를 함께 조회하면 결과를 배열이나 별도 객체로 받아야 한다.
처음에는select m from MemberDirect m처럼 엔티티 전체를 조회하는 형태가 가장 이해하기 쉽다.
하지만 실제 조회에서는 이름만 필요하거나, 번호와 이름만 필요하거나, 화면에 보여 줄 값만 따로 묶어 가져와야 하는 경우가 많다.
JPQL조회 결과는select절에 무엇을 적었는지에 따라Entity, 단일 값, 배열,DTO형태로 달라진다.
13-1. Entity 전체를 조회하면 Entity 객체가 반환된다
JPQL에서 엔티티 전체를 조회하려면 별칭 자체를select에 적는다.
예를 들어MemberDirect엔티티를m이라는 별칭으로 두었다면select m은 엔티티 전체를 조회한다는 뜻이다.
// EntityResultSelectFlow.java
List<MemberDirect> members = entityManager.createQuery(
        "select m from MemberDirect m", MemberDirect.class
).getResultList(); // MemberDirect Entity 목록 조회
이 조회 결과는
MemberDirect객체 목록이다.
즉, 결과 타입은List<MemberDirect>가 된다.
엔티티 전체를 조회하면JPA가 조회한 엔티티를 영속성 컨텍스트에서 관리할 수 있다.
조회된 엔티티는 영속 상태가 될 수 있으므로, 같은EntityManager안에서 변경 감지 대상이 될 수 있다.
예를 들어 조회한 엔티티의 이름을 출력할 수 있다.// EntityResultPrintFlow.java for (MemberDirect member : members) { // 조회된 Entity 목록 반복 System.out.println(member.getName()); // Entity의 name 값 출력 }엔티티 전체가 필요할 때는 이 방식이 가장 자연스럽다.
다만 화면에 이름 하나만 필요한데 엔티티 전체를 조회하면 필요보다 많은 데이터를 가져올 수 있다.
이럴 때는 특정 필드만 조회하는 방식을 사용할 수 있다.
13-2. 단일 필드를 조회하면 해당 필드 타입으로 받을 수 있다
select절에 엔티티 전체가 아니라 특정 필드 하나만 적으면, 그 필드 값만 조회된다.
예를 들어 회원 이름만 필요하다면m.name만 조회할 수 있다.
// SingleFieldSelectFlow.java
List<String> names = entityManager.createQuery(
        "select m.name from MemberDirect m", String.class
).getResultList(); // name 필드만 조회
m.name은MemberDirect엔티티의name필드이다.
이 필드 타입이String이라면 결과도String목록으로 받을 수 있다.
조회 결과를 출력하면 아래처럼 사용할 수 있다.// SingleFieldPrintFlow.java for (String name : names) { // 이름 목록 반복 System.out.println(name); // 이름 출력 }단일 필드 조회는 필요한 값만 가져오고 싶을 때 사용한다.
엔티티 전체가 필요하지 않고, 특정 컬럼에 해당하는 필드 값만 필요할 때 더 가볍게 조회할 수 있다.
다만 이 경우 결과는Entity객체가 아니다.
String같은 값 자체가 결과이다.
따라서 조회된 값을 변경해도JPA의 변경 감지와는 관계가 없다.
단일 필드 조회 결과는Entity가 아니라 해당 필드 타입의 값이다.
13-3. 여러 필드를 조회하면 Object 배열로 받을 수 있다
select절에 여러 필드를 적으면 결과 한 줄에 여러 값이 들어간다.
예를 들어 회원 번호와 이름을 함께 조회하면 한 결과 행에id와name이 같이 들어간다.
이때는 결과를Object[]배열로 받을 수 있다.
Object는 모든 객체 타입의 상위 타입이라고 이해하면 된다.
여러 타입의 값이 한 줄에 섞여 있을 수 있으므로Object[]로 받는 것이다.
// MultipleFieldObjectArrayFlow.java
List<Object[]> results = entityManager.createQuery(
        "select m.id, m.name from MemberDirect m", Object[].class
).getResultList(); // id와 name을 함께 조회
select m.id, m.name은 엔티티 전체가 아니라id필드와name필드만 조회한다는 뜻이다.
결과 한 줄은Object[]하나로 들어온다.
배열에서 값을 꺼낼 때는 순서를 기준으로 꺼낸다.// MultipleFieldObjectArrayPrintFlow.java for (Object[] row : results) { // 결과 행 반복 Long id = (Long) row[0]; // 첫 번째 값은 id String name = (String) row[1]; // 두 번째 값은 name System.out.println(id + " / " + name); // id와 name 출력 }
row[0]은 첫 번째 조회 값인m.id이다.
row[1]은 두 번째 조회 값인m.name이다.
이 방식은 동작은 하지만 초보자가 헷갈리기 쉽다.
조회 순서가 바뀌면 배열에서 꺼내는 순서도 함께 맞춰야 한다.
또 형변환을 직접 해야 하므로 실수할 가능성이 있다.
그래서 여러 필드를 조회해 화면에 보여 줄 목적이라면DTO로 바로 받는 방식이 더 읽기 쉽다.
13-4. DTO는 조회 결과를 담기 위한 전용 객체이다
DTO는Data Transfer Object의 줄임말이다.
데이터를 옮기기 위해 사용하는 객체라는 뜻이다.
여기서는JPQL조회 결과 중 필요한 값만 담기 위한 전용 객체로 이해하면 된다.
엔티티는 데이터베이스 테이블과 매핑되는 객체이다.
반면DTO는 테이블과 직접 매핑되는 객체가 아니라, 필요한 데이터를 담아서 전달하기 위한 객체이다.
예를 들어 회원 번호와 이름만 화면에 보여 주고 싶다면 아래처럼DTO를 만들 수 있다.// MemberNameDto.java package jpaexam1.dto; public class MemberNameDto { private Long id; // 회원 번호 private String name; // 회원 이름 public MemberNameDto(Long id, String name) { // JPQL에서 호출할 생성자 this.id = id; this.name = name; } public Long getId() { // id 반환 return id; } public String getName() { // name 반환 return name; } }이
DTO는id와name만 담는다.
엔티티 전체가 아니라 화면이나 출력에 필요한 값만 담는 용도이다.
DTO는Entity와 목적이 다르다.
Entity는JPA가 관리하는 테이블 매핑 객체이고,DTO는 필요한 값을 옮기기 위한 객체이다.
Entity는 데이터베이스와 매핑되는 객체이고,DTO는 조회 결과나 전달 데이터를 담기 위한 객체이다.
13-5. JPQL new 문법으로 DTO를 바로 생성할 수 있다
JPQL에서는new문법을 사용해서 조회 결과를DTO객체로 바로 만들 수 있다.
이 방식을 생성자 표현식이라고 한다.
생성자 표현식은 조회 결과를DTO생성자에 바로 전달해서 객체를 만드는 방식이다.
// DtoProjectionSelectFlow.java
List<MemberNameDto> results = entityManager.createQuery(
        "select new jpaexam1.dto.MemberNameDto(m.id, m.name) from MemberDirect m",
        MemberNameDto.class
).getResultList(); // DTO 형태로 조회
select new jpaexam1.dto.MemberNameDto(m.id, m.name)은 조회 결과로MemberNameDto객체를 만들겠다는 뜻이다.
이때 패키지명을 포함한 전체 클래스 이름을 적어야 한다.
m.id값은MemberNameDto생성자의 첫 번째 매개변수로 들어간다.
m.name값은 두 번째 매개변수로 들어간다.
그래서MemberNameDto(Long id, String name)생성자가 필요하다.
조회 결과는 아래처럼 사용할 수 있다.// DtoProjectionPrintFlow.java for (MemberNameDto dto : results) { // DTO 목록 반복 System.out.println(dto.getId() + " / " + dto.getName()); // DTO 값 출력 }
DTO조회는 화면에 필요한 값만 가져올 때 유용하다.
엔티티 전체를 가져오지 않아도 되고,Object[]처럼 순서와 형변환을 직접 관리하지 않아도 된다.
다만DTO는Entity가 아니다.
따라서DTO값을 바꿔도JPA변경 감지가 일어나지 않는다.
변경 감지는 영속성 컨텍스트가 관리하는Entity에 대해서 동작한다.
13-6. Entity 조회와 DTO 조회는 목적이 다르다
엔티티 조회와
DTO조회는 둘 다 데이터를 가져오는 방식이다.
하지만 목적이 다르다.
엔티티 조회는JPA가 관리할 수 있는 객체를 가져오는 방식이다.
조회된 엔티티는 영속성 컨텍스트에서 관리될 수 있고, 영속 상태라면 변경 감지 대상이 될 수 있다.
// EntityProjectionPurposeFlow.java
MemberDirect member = entityManager.find(MemberDirect.class, 1L); // Entity 조회
이 방식은 조회한 객체를 수정하거나, 연관관계를 따라가거나,
JPA관리 흐름 안에서 다룰 때 적합하다.
반면DTO조회는 필요한 값만 담아 가져오는 방식이다.// DtoProjectionPurposeFlow.java List<MemberNameDto> results = entityManager.createQuery( "select new jpaexam1.dto.MemberNameDto(m.id, m.name) from MemberDirect m", MemberNameDto.class ).getResultList(); // 필요한 값만 DTO로 조회이 방식은 화면 출력, 목록 표시, 응답 데이터 구성처럼 필요한 값만 읽어 오면 되는 경우에 적합하다.
비교하면 아래와 같다.
Entity조회:JPA가 관리할 수 있는 엔티티 객체를 조회한다.DTO조회: 필요한 값만 담은 전용 객체를 조회한다.Entity조회 결과는 영속성 컨텍스트에서 관리될 수 있다.DTO조회 결과는 영속성 컨텍스트가 관리하는 엔티티가 아니다.둘 중 하나가 무조건 좋은 것이 아니다.
수정이나 관리가 필요하면 엔티티 조회가 적합하고, 단순 화면 출력이나 목록 응답이면DTO조회가 적합할 수 있다.
13-7. 집계 함수는 계산 결과를 조회한다
집계 함수는 여러 데이터를 기준으로 하나의 계산 결과를 만드는 함수이다.
예를 들어 전체 개수, 합계, 평균, 최댓값, 최솟값을 구할 수 있다.
JPQL에서 자주 쓰는 집계 함수는 아래와 같다.
count: 개수를 구한다.sum: 합계를 구한다.avg: 평균을 구한다.max: 최댓값을 구한다.min: 최솟값을 구한다.전체 회원 수를 구하려면
count를 사용할 수 있다.// CountQueryFlow.java Long count = entityManager.createQuery( "select count(m) from MemberDirect m", Long.class ).getSingleResult(); // 전체 개수 조회
count(m)은MemberDirect엔티티의 개수를 구한다는 뜻이다.
결과는 하나의 숫자이므로getSingleResult()로 받을 수 있다.
집계 함수의 결과는 엔티티가 아니다.
계산된 숫자 값이다.
따라서count결과는Long처럼 숫자 타입으로 받는다.
// CountQueryPrintFlow.java
System.out.println("회원 수 : " + count); // count 결과 출력
집계 함수는 목록 전체를 가져와서
Java코드로 직접 세는 것보다 효율적으로 사용할 수 있다.
필요한 계산을 데이터베이스 쪽에서 처리하고 결과만 가져올 수 있기 때문이다.
13-8. 조회 결과 형태에 따라 메서드 선택도 달라진다
조회 결과 형태를 이해하면
getResultList()와getSingleResult()를 언제 사용할지도 더 쉽게 판단할 수 있다.
여러 건이 나올 수 있는 조회는getResultList()를 사용한다.
예를 들어 엔티티 목록 조회, 이름 목록 조회,DTO목록 조회는 결과가 여러 개일 수 있다.
// ListResultMethodFlow.java
List<MemberDirect> members = entityManager.createQuery(
        "select m from MemberDirect m", MemberDirect.class
).getResultList(); // 여러 Entity 결과
결과가 하나로 정해지는 조회는
getSingleResult()를 사용할 수 있다.
예를 들어 전체 개수를 구하는count조회는 결과가 하나이다.
// SingleResultMethodFlow.java
Long count = entityManager.createQuery(
        "select count(m) from MemberDirect m", Long.class
).getSingleResult(); // 하나의 count 결과
하지만 결과가 없거나 여러 개일 수 있는 조건 조회에
getSingleResult()를 사용하면 예외가 발생할 수 있다.
그래서 “정확히 하나”라는 확신이 없으면getResultList()로 받는 것이 더 안전하다.
정리하면 아래와 같다.
- 결과가 여러 건일 수 있다면
getResultList()- 결과가 정확히 하나라고 확신한다면
getSingleResult()- 집계 함수처럼 결과가 하나인 조회는
getSingleResult()사용 가능조회 결과 형태를 먼저 생각하면 어떤 메서드로 결과를 받을지도 자연스럽게 정해진다.
13-9. JPQL 조회 결과 형태 한 번에 보기
지금까지 본 내용을 하나로 연결하면
JPQL조회 결과 형태가 정리된다.
이 구간은 새로운 문법을 추가하는 부분이 아니라,select절에 무엇을 적는지에 따라 결과가 어떻게 달라지는지 한 번에 확인하는 마무리이다.
아래 예제는 엔티티 전체 조회, 단일 필드 조회, 여러 필드 조회,DTO조회, 집계 조회를 한 번에 비교한다.
조회 작업만 수행하므로 데이터베이스 상태를 바꾸지 않는다.// JpqlResultTypeSummaryFlow.java package jpaexam1.app; import jakarta.persistence.EntityManager; import jakarta.persistence.EntityManagerFactory; import jakarta.persistence.Persistence; import jpaexam1.dto.MemberNameDto; import jpaexam1.entity.MemberDirect; import java.util.List; public class JpqlResultTypeSummaryFlow { public static void main(String[] args) { EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // EntityManagerFactory 생성 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 try { List<MemberDirect> entityResults = entityManager.createQuery( "select m from MemberDirect m", MemberDirect.class ).getResultList(); // Entity 전체 조회 List<String> nameResults = entityManager.createQuery( "select m.name from MemberDirect m", String.class ).getResultList(); // 단일 필드 조회 List<Object[]> objectArrayResults = entityManager.createQuery( "select m.id, m.name from MemberDirect m", Object[].class ).getResultList(); // 여러 필드 조회 List<MemberNameDto> dtoResults = entityManager.createQuery( "select new jpaexam1.dto.MemberNameDto(m.id, m.name) from MemberDirect m", MemberNameDto.class ).getResultList(); // DTO 조회 Long countResult = entityManager.createQuery( "select count(m) from MemberDirect m", Long.class ).getSingleResult(); // 집계 결과 조회 System.out.println("Entity 조회 개수 : " + entityResults.size()); // Entity 결과 개수 System.out.println("이름 조회 개수 : " + nameResults.size()); // 이름 결과 개수 System.out.println("배열 조회 개수 : " + objectArrayResults.size()); // Object[] 결과 개수 System.out.println("DTO 조회 개수 : " + dtoResults.size()); // DTO 결과 개수 System.out.println("전체 개수 : " + countResult); // count 결과 } finally { entityManager.close(); // EntityManager 닫기 factory.close(); // EntityManagerFactory 닫기 } } }// 출력결과 // Entity 조회 개수 : 데이터베이스에 저장된 데이터 수에 따라 달라짐 // 이름 조회 개수 : 데이터베이스에 저장된 데이터 수에 따라 달라짐 // 배열 조회 개수 : 데이터베이스에 저장된 데이터 수에 따라 달라짐 // DTO 조회 개수 : 데이터베이스에 저장된 데이터 수에 따라 달라짐 // 전체 개수 : 데이터베이스에 저장된 데이터 수에 따라 달라짐이 예제에서
select m은 엔티티 전체를 조회한다.
select m.name은 단일 필드 값을 조회한다.
select m.id, m.name은 여러 값을 한 줄로 조회하므로Object[]로 받을 수 있다.
select new ...는DTO객체를 바로 생성해서 조회한다.
count(m)은 전체 개수를 계산한 결과를 가져온다.
JPQL조회 결과는select절에 적은 대상에 따라 달라지므로, 먼저 어떤 형태의 결과가 필요한지 정하고 쿼리를 작성해야 한다.
다음 단계에서는 조회 결과를 정렬하거나 원하는 개수만 잘라서 가져오는 방법을 확인한다.
14. JPQL 정렬과 페이징 이해하기
JPQL로 데이터를 조회할 때는 조건만큼 정렬과 페이징도 중요하다.
정렬은 조회 결과를 원하는 순서로 나열하는 것이다.
페이징은 전체 결과 중에서 필요한 구간만 잘라서 가져오는 것이다.
예를 들어 회원 목록을 이름순으로 보여 주거나, 게시글 목록을 최신순으로 보여 주는 것이 정렬이다.
전체 회원이100명인데 화면에는10명씩만 보여 주는 것이 페이징이다.
정렬과 페이징은 목록 화면에서 데이터를 보기 좋은 순서와 적당한 개수로 가져오기 위해 사용한다.
14-1. order by는 조회 결과의 순서를 정한다
order by는 조회 결과를 어떤 기준으로 정렬할지 지정하는 문법이다.
조건이 데이터를 걸러 내는 기준이라면, 정렬은 걸러낸 데이터를 어떤 순서로 보여 줄지 정하는 기준이다.
기본 형태는 아래와 같다.// JpqlOrderByBasicFlow.java String jpql = "select m from MemberDirect m order by m.name asc"; // name 필드 기준 오름차순 정렬
order by m.name asc는MemberDirect엔티티의name필드를 기준으로 오름차순 정렬한다는 뜻이다.
여기서m.name은 테이블 컬럼명이 아니라 엔티티 필드 이름이다.
정렬 기준도JPQL에서는 테이블 컬럼이 아니라 엔티티 필드를 사용한다.
그래서 실제 컬럼명이member_name이어도, 엔티티 필드가name이면m.name으로 작성한다.
정렬이 없으면 데이터베이스가 결과를 어떤 순서로 돌려줄지 항상 분명하지 않을 수 있다.
목록 화면에서 순서가 중요하다면order by를 명확하게 작성하는 것이 좋다.
14-2. asc는 오름차순, desc는 내림차순이다
asc는 오름차순 정렬이다.
오름차순은 작은 값에서 큰 값으로 정렬하는 방식이다.
숫자는 작은 숫자부터 큰 숫자로 정렬되고, 문자열은 사전순에 가까운 순서로 정렬된다.
// JpqlOrderByAscFlow.java
String jpql = "select m from MemberDirect m order by m.id asc"; // id가 작은 값부터 정렬
m.id asc는id값이 작은 엔티티부터 조회 결과에 나오도록 정렬한다는 뜻이다.
desc는 내림차순 정렬이다.
내림차순은 큰 값에서 작은 값으로 정렬하는 방식이다.
숫자는 큰 숫자부터 작은 숫자로 정렬된다.
// JpqlOrderByDescFlow.java
String jpql = "select m from MemberDirect m order by m.id desc"; // id가 큰 값부터 정렬
m.id desc는id값이 큰 엔티티부터 조회 결과에 나오도록 정렬한다는 뜻이다.
정리하면 아래와 같다.
asc: 오름차순이다.desc: 내림차순이다.- 정렬 기준은
Entity의 필드 이름으로 작성한다.
JPQL정렬에서는order by뒤에 엔티티 필드를 적고,asc또는desc로 정렬 방향을 정한다.
14-3. 여러 기준으로 정렬할 수 있다
정렬 기준은 하나만 사용할 수도 있고, 여러 개를 함께 사용할 수도 있다.
여러 기준을 사용할 때는 쉼표로 구분한다.
예를 들어 이름을 오름차순으로 정렬하고, 이름이 같은 경우에는id를 내림차순으로 정렬할 수 있다.// JpqlOrderByMultipleFlow.java String jpql = "select m from MemberDirect m order by m.name asc, m.id desc"; // name 오름차순 후 id 내림차순이 쿼리는 먼저
name을 기준으로 정렬한다.
이름이 같은 데이터가 여러 개 있으면 그 안에서 다시id를 기준으로 내림차순 정렬한다.
여러 기준 정렬은 목록의 순서를 더 안정적으로 만들 때 유용하다.
예를 들어 이름이 같은 회원이 여러 명이면 이름만으로는 순서가 애매할 수 있다.
이때id같은 추가 기준을 넣으면 결과 순서를 더 분명하게 만들 수 있다.
14-4. 페이징은 전체 결과 중 일부만 가져오는 방식이다
페이징은 전체 조회 결과 중 필요한 구간만 가져오는 방식이다.
데이터가 많을 때 한 번에 전부 가져오면 화면도 무거워지고, 데이터베이스 작업도 부담이 커질 수 있다.
예를 들어 회원이1000명 있는데 화면에는 한 번에10명만 보여 주면 충분할 수 있다.
이때 전체1000명을 모두 가져온 뒤 화면에서10명만 보여 주는 것은 비효율적이다.
처음부터 필요한10명만 가져오는 것이 좋다.
JPA에서는setFirstResult()와setMaxResults()를 사용해서 페이징을 처리한다.// JpqlPagingBasicFlow.java List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m order by m.id asc", MemberDirect.class ) .setFirstResult(0) // 가져오기 시작할 위치 .setMaxResults(10) // 최대 10개만 조회 .getResultList(); // 페이징 결과 조회
setFirstResult(0)은 결과의 시작 위치를 의미한다.
위치는0부터 시작한다.
setMaxResults(10)은 최대10개만 가져오겠다는 뜻이다.
페이징은JPQL문자열에 직접limit을 쓰는 방식이 아니라,setFirstResult()와setMaxResults()로 조회 범위를 지정한다.
14-5. setFirstResult는 시작 위치를 정한다
setFirstResult()는 조회 결과에서 몇 번째 위치부터 가져올지 정한다.
이 위치는0부터 시작한다.
예를 들어 정렬된 결과가 아래처럼 있다고 생각해 보자.// PagingPositionConcept.java // 전체 결과 위치 // 0번째: 첫 번째 데이터 // 1번째: 두 번째 데이터 // 2번째: 세 번째 데이터 // 3번째: 네 번째 데이터
setFirstResult(0)이면 첫 번째 데이터부터 가져온다.
setFirstResult(10)이면 앞의10개를 건너뛰고,11번째 데이터부터 가져온다.
아래 예제는 앞의10개를 건너뛰고 그다음 결과를 가져오는 흐름이다.// JpqlSetFirstResultFlow.java List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m order by m.id asc", MemberDirect.class ) .setFirstResult(10) // 앞의 10개를 건너뛰고 시작 .setMaxResults(10) // 최대 10개 조회 .getResultList(); // 결과 목록 조회이 코드는 두 번째 페이지처럼 동작할 수 있다.
첫 번째 페이지가0부터9까지라면, 두 번째 페이지는10부터 시작한다.
14-6. setMaxResults는 가져올 최대 개수를 정한다
setMaxResults()는 조회 결과를 최대 몇 개까지 가져올지 정한다.
페이지 크기를 정할 때 사용한다.
예를 들어 한 페이지에5개씩 보여 주고 싶다면 아래처럼 작성한다.// JpqlSetMaxResultsFlow.java List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m order by m.id asc", MemberDirect.class ) .setFirstResult(0) // 처음부터 시작 .setMaxResults(5) // 최대 5개 조회 .getResultList(); // 결과 목록 조회이 쿼리는 정렬된 결과 중 처음
5개만 가져온다.
결과가5개보다 적으면 가능한 만큼만 반환된다.
setMaxResults()는 많은 데이터를 한 번에 가져오지 않도록 도와준다.
그래서 목록 화면, 검색 결과 화면, 게시판 화면 같은 곳에서 자주 사용된다.
14-7. 페이지 번호로 시작 위치 계산하기
실제 화면에서는 보통 “몇 번째 페이지”를 기준으로 요청한다.
예를 들어 사용자가1페이지,2페이지,3페이지를 누른다.
이때setFirstResult()에 들어갈 시작 위치를 계산해야 한다.
페이지 번호를1부터 시작한다고 보면 계산식은 아래와 같다.// PagingOffsetFormula.java int pageNumber = 2; // 사용자가 요청한 페이지 번호, 1부터 시작한다고 가정 int pageSize = 10; // 한 페이지에 보여 줄 데이터 개수 int firstResult = (pageNumber - 1) * pageSize; // 시작 위치 계산
pageNumber가1이면(1 - 1) * 10이므로 시작 위치는0이다.
pageNumber가2이면(2 - 1) * 10이므로 시작 위치는10이다.
계산한 값을 페이징 조회에 사용할 수 있다.// JpqlPagingWithPageNumberFlow.java int pageNumber = 2; // 2페이지 조회 int pageSize = 10; // 한 페이지당 10개 int firstResult = (pageNumber - 1) * pageSize; // 시작 위치 계산 List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m order by m.id asc", MemberDirect.class ) .setFirstResult(firstResult) // 계산한 시작 위치 적용 .setMaxResults(pageSize) // 페이지 크기 적용 .getResultList(); // 페이징 결과 조회이 예제는
2페이지에 해당하는 데이터를 조회한다.
앞의10개를 건너뛰고, 그다음10개를 가져오는 흐름이다.
페이지 번호가1부터 시작한다면 시작 위치는(페이지 번호 - 1) * 페이지 크기로 계산한다.
14-8. 페이징에서는 정렬 기준을 함께 쓰는 것이 좋다
페이징을 사용할 때는 정렬 기준을 함께 쓰는 것이 좋다.
정렬 기준이 없으면 데이터베이스가 결과를 어떤 순서로 돌려줄지 항상 명확하지 않을 수 있다.
예를 들어 첫 번째 페이지에서 어떤 데이터10개가 나왔는데, 다음 조회에서 순서가 달라지면 두 번째 페이지와 겹치거나 빠지는 데이터가 생길 수 있다.
그래서 페이징은 보통order by와 함께 사용한다.
좋은 흐름은 아래처럼 정렬 기준을 명확히 넣는 것이다.// PagingWithOrderByGoodFlow.java List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m order by m.id asc", MemberDirect.class ) .setFirstResult(0) // 첫 페이지 시작 위치 .setMaxResults(10) // 한 페이지 크기 .getResultList(); // 정렬된 페이징 결과 조회정렬 기준은 가능하면 결과 순서를 안정적으로 만들 수 있는 필드를 사용한다.
예를 들어 기본키인id를 정렬 기준으로 사용하면 결과 순서가 비교적 분명해진다.
반대로 아래처럼 정렬 없이 페이징만 적용하면 결과 순서가 애매해질 수 있다.// PagingWithoutOrderByBadFlow.java List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m", MemberDirect.class ) .setFirstResult(0) // 시작 위치 .setMaxResults(10) // 최대 개수 .getResultList(); // 정렬 기준 없는 페이징이 코드가 항상 틀렸다는 뜻은 아니다.
하지만 목록 화면에서 일관된 페이지 결과가 필요하다면 정렬 기준을 명확히 주는 것이 좋다.
페이징 결과를 안정적으로 만들려면order by로 정렬 기준을 먼저 정하고, 그다음setFirstResult()와setMaxResults()를 적용하는 것이 좋다.
14-9. 전체 개수를 구하면 페이지 수를 계산할 수 있다
페이징 화면에서는 현재 페이지 데이터뿐 아니라 전체 데이터 개수도 필요할 수 있다.
전체 개수를 알아야 총 몇 페이지가 있는지 계산할 수 있기 때문이다.
전체 개수는count()로 조회할 수 있다.// PagingCountQueryFlow.java Long totalCount = entityManager.createQuery( "select count(m) from MemberDirect m", Long.class ).getSingleResult(); // 전체 데이터 개수 조회
count(m)은MemberDirect엔티티의 전체 개수를 구한다.
결과는 하나의 숫자이므로getSingleResult()로 받을 수 있다.
전체 개수와 페이지 크기가 있으면 전체 페이지 수를 계산할 수 있다.// TotalPageCalculationFlow.java long totalCount = 25; // 전체 데이터 개수라고 가정 int pageSize = 10; // 한 페이지 크기 long totalPage = (totalCount + pageSize - 1) / pageSize; // 올림 계산 System.out.println(totalPage); // 전체 페이지 수 출력// 출력결과 // 3
25개를10개씩 보여 주면1페이지에10개,2페이지에10개,3페이지에5개가 들어간다.
그래서 전체 페이지 수는3이다.
(totalCount + pageSize - 1) / pageSize는 나누어떨어지지 않는 경우에도 페이지 수를 올려서 계산하기 위한 방식이다.
예를 들어25 / 10은 정수 계산에서2가 될 수 있지만, 실제 페이지는3개가 필요하다.
조건이 있는 페이징에서는 현재 페이지 데이터를 조회하는 쿼리와 전체 개수를 조회하는 쿼리에 같은where조건을 적용해야 한다.
목록 조회는 조건에 맞는 일부 데이터를 가져오고,count()조회는 같은 조건에 맞는 전체 개수를 구해야 페이지 수가 정확해진다.
예를 들어 이름에 특정 글자가 포함된 회원만 페이징한다면, 목록 조회와 전체 개수 조회에 같은 조건이 들어가야 한다.// PagingCountWithConditionFlow.java String dataJpql = "select m from MemberDirect m where m.name like :keyword order by m.id asc"; // 조건이 있는 목록 조회 String countJpql = "select count(m) from MemberDirect m where m.name like :keyword"; // 같은 조건의 전체 개수 조회현재 페이지 데이터는
where m.name like :keyword조건에 맞는 일부 데이터이다.
전체 개수도 같은 조건에 맞는 전체 데이터 개수여야 한다.
그래야 검색 결과 기준으로 전체 페이지 수를 정확히 계산할 수 있다.
조건 검색 페이징에서는 목록 조회 쿼리와 개수 조회 쿼리의 조건이 서로 맞아야 한다.
14-10. JPQL 정렬과 페이징 흐름 한 번에 보기
지금까지 본 내용을 하나로 연결하면
JPQL정렬과 페이징 흐름이 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라,order by정렬 → 페이지 시작 위치 계산 → 페이징 조회 → 전체 개수 조회 흐름을 한 번에 확인하는 마무리이다.
아래 예제는2페이지 데이터를10개씩 가져오고, 전체 데이터 개수도 함께 조회한다.
조회 작업만 수행하므로 데이터베이스 상태를 바꾸지 않는다.// JpqlOrderPagingSummaryFlow.java package jpaexam1.app; import jakarta.persistence.EntityManager; import jakarta.persistence.EntityManagerFactory; import jakarta.persistence.Persistence; import jpaexam1.entity.MemberDirect; import java.util.List; public class JpqlOrderPagingSummaryFlow { public static void main(String[] args) { EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // EntityManagerFactory 생성 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 try { int pageNumber = 2; // 조회할 페이지 번호, 1부터 시작 int pageSize = 10; // 한 페이지에 보여 줄 데이터 개수 int firstResult = (pageNumber - 1) * pageSize; // 시작 위치 계산 List<MemberDirect> members = entityManager.createQuery( "select m from MemberDirect m order by m.id asc", MemberDirect.class ) .setFirstResult(firstResult) // 시작 위치 지정 .setMaxResults(pageSize) // 조회할 최대 개수 지정 .getResultList(); // 현재 페이지 데이터 조회 Long totalCount = entityManager.createQuery( "select count(m) from MemberDirect m", Long.class ).getSingleResult(); // 전체 데이터 개수 조회 long totalPage = (totalCount + pageSize - 1) / pageSize; // 전체 페이지 수 계산 System.out.println("현재 페이지 : " + pageNumber); // 현재 페이지 출력 System.out.println("현재 페이지 조회 개수 : " + members.size()); // 현재 페이지 데이터 개수 System.out.println("전체 데이터 개수 : " + totalCount); // 전체 개수 System.out.println("전체 페이지 수 : " + totalPage); // 전체 페이지 수 } finally { entityManager.close(); // EntityManager 닫기 factory.close(); // EntityManagerFactory 닫기 } } }// 출력결과 // 현재 페이지 : 2 // 현재 페이지 조회 개수 : 데이터베이스에 저장된 데이터와 페이지 조건에 따라 달라짐 // 전체 데이터 개수 : 데이터베이스에 저장된 데이터 수에 따라 달라짐 // 전체 페이지 수 : 전체 데이터 개수와 페이지 크기에 따라 달라짐이 예제에서
order by m.id asc는 결과를id오름차순으로 정렬한다.
setFirstResult(firstResult)는 가져오기 시작할 위치를 지정한다.
setMaxResults(pageSize)는 한 번에 가져올 최대 개수를 지정한다.
전체 페이지 수를 계산하려면 현재 페이지 데이터만으로는 부족하다.
그래서count()쿼리로 전체 데이터 개수를 따로 조회한다.
그다음 전체 개수와 페이지 크기를 이용해 전체 페이지 수를 계산한다.
이 예제는 조건이 없는 전체 목록 페이징이다.
조건 검색 페이징이라면 현재 페이지 데이터 조회 쿼리와count()쿼리에 같은where조건을 넣어야 한다.
그래야 화면에 보이는 검색 결과와 전체 페이지 수가 서로 맞는다.
정렬은 결과 순서를 정하고, 페이징은 필요한 구간만 가져오며, 전체 개수 조회는 페이지 수 계산에 사용된다.
다음 단계에서는 엔티티 사이의 관계를 객체 참조와 외래키 기준으로 연결하는 방법을 확인한다.
15. 연관관계 매핑 기본 이해하기
JPA에서 엔티티 하나만 다룰 때는 기본키, 필드, 저장, 조회 흐름만 이해해도 된다.
하지만 실제 데이터는 보통 여러 테이블이 서로 연결되어 있다.
예를 들어 회원은 팀에 속할 수 있고, 주문은 회원과 연결될 수 있다.
관계형 데이터베이스에서는 이런 연결을 외래키로 표현한다.
외래키는 다른 테이블의 기본키를 참조해서 두 테이블을 연결하는 컬럼이다.
반면Java객체는 다른 객체를 필드로 가지고 있으면서 참조로 연결한다.
연관관계 매핑은 데이터베이스의 외래키 관계와Java객체의 참조 관계를JPA가 이해할 수 있도록 연결하는 설정이다.
15-1. 객체는 참조로 연결하고 테이블은 외래키로 연결한다
Java객체는 다른 객체를 필드로 가질 수 있다.
예를 들어 회원이 팀에 속한다면 회원 객체 안에 팀 객체를 필드로 둘 수 있다.
이것을 객체 참조라고 한다.
객체 참조는 한 객체가 다른 객체를 직접 가리키는 구조이다.
회원 객체에서 팀 객체를 바로 꺼내 쓸 수 있다.// ObjectReferenceConcept.java public class Member { private Long id; // 회원 번호 private String name; // 회원 이름 private Team team; // 회원이 속한 Team 객체 참조 }이 구조에서는
member.getTeam()처럼 회원에서 팀 객체로 이동할 수 있다.
객체 입장에서는 외래키 값 자체보다 연결된 객체를 직접 다루는 편이 자연스럽다.
반면 데이터베이스 테이블은 객체를 직접 저장하지 않는다.
테이블은 다른 테이블과 연결할 때 외래키 컬럼을 사용한다.// TableForeignKeyConcept.sql member - id - name - team_id team - id - name
member테이블의team_id컬럼은team테이블의id를 참조한다.
즉, 회원 행이 어떤 팀 행과 연결되는지 외래키 값으로 표현한다.
이 차이가 연관관계 매핑이 필요한 이유이다.
객체는 객체 참조로 연결하고, 테이블은 외래키 값으로 연결한다.
JPA는 이 둘 사이를 맞춰야 한다.
객체의 참조와 테이블의 외래키는 같은 관계를 표현하지만, 표현 방식이 다르다.
15-2. 연관관계 매핑은 참조와 외래키를 이어 주는 설정이다
연관관계 매핑은
Entity사이의 관계를JPA에게 알려 주는 설정이다.
JPA는Entity클래스의 필드와 어노테이션을 보고 어떤 객체가 어떤 테이블과 연결되는지 판단한다.
회원과 팀의 관계를 예로 들어 보자.
회원은 하나의 팀에 속할 수 있다.
그리고 하나의 팀에는 여러 회원이 속할 수 있다.
데이터베이스에서는member테이블에team_id외래키 컬럼을 두면 이 관계를 표현할 수 있다.
객체에서는 회원이 팀을 참조하도록 만든다.// MemberTeamReference.java private Team team; // 회원이 속한 팀을 객체로 참조그런데 이 필드만 있으면
JPA는 이 참조가 어떤 외래키와 연결되는지 정확히 알 수 없다.
그래서 관계를 나타내는 어노테이션과 외래키 컬럼을 지정하는 어노테이션을 함께 사용한다.
대표적으로 아래 두 어노테이션을 사용한다.
@ManyToOne: 여러 회원이 하나의 팀에 속한다는 관계를 나타낸다.@JoinColumn: 외래키 컬럼 이름을 지정한다.이 두 가지가 합쳐지면 객체의
team참조가 데이터베이스의team_id외래키와 연결된다.
15-3. ManyToOne은 다대일 관계를 표현한다
@ManyToOne은 다대일 관계를 표현한다.
다대일은 여러 개의 대상이 하나의 대상과 연결되는 관계이다.
회원과 팀을 예로 들면 회원은 여러 명이고, 팀은 하나일 수 있다.
여러 회원이 같은 팀에 속할 수 있기 때문에 회원 입장에서는 팀과 다대일 관계가 된다.
아래는 팀 엔티티이다.// TeamEntity.java import jakarta.persistence.Entity; import jakarta.persistence.Id; import jakarta.persistence.Table; @Entity // JPA 관리 대상 Entity @Table(name = "team") // team 테이블과 매핑 public class TeamEntity { @Id // 기본키 필드 private Long id; private String name; // 팀 이름 protected TeamEntity() { // JPA가 사용할 기본 생성자 } public TeamEntity(Long id, String name) { // 값을 넣어 객체 생성 this.id = id; this.name = name; } public Long getId() { // id 반환 return id; } public String getName() { // name 반환 return name; } }
TeamEntity는team테이블과 연결되는 엔티티이다.
id는 팀을 구분하는 기본키이고,name은 팀 이름이다.
이제 회원 엔티티에서 팀을 참조하도록 만든다.// MemberManyToOne.java import jakarta.persistence.Entity; import jakarta.persistence.Id; import jakarta.persistence.JoinColumn; import jakarta.persistence.ManyToOne; import jakarta.persistence.Table; @Entity // JPA 관리 대상 Entity @Table(name = "member") // member 테이블과 매핑 public class MemberManyToOne { @Id // 기본키 필드 private Long id; private String name; // 회원 이름 @ManyToOne // 여러 회원이 하나의 팀과 연결되는 관계 @JoinColumn(name = "team_id") // member 테이블의 team_id 외래키 컬럼과 연결 private TeamEntity team; protected MemberManyToOne() { // JPA가 사용할 기본 생성자 } public MemberManyToOne(Long id, String name, TeamEntity team) { // 회원 생성 시 팀도 함께 연결 this.id = id; this.name = name; this.team = team; } public TeamEntity getTeam() { // 연결된 팀 반환 return team; } }
@ManyToOne은 이 회원이 팀과 다대일 관계라는 뜻이다.
@JoinColumn(name = "team_id")는 이 관계를 저장할 외래키 컬럼이team_id라는 뜻이다.
즉, 객체에서는team필드로 팀 객체를 참조한다.
데이터베이스에서는member.team_id컬럼으로team.id를 참조한다.
@ManyToOne은 객체 참조를 만들고,@JoinColumn은 그 참조가 어떤 외래키 컬럼과 연결되는지 알려 준다.
15-4. JoinColumn은 외래키 컬럼을 지정한다
@JoinColumn은 연관관계에서 사용할 외래키 컬럼을 지정한다.
컬럼이라는 말이 들어가지만, 단순 필드 매핑용@Column과 역할이 다르다.
@Column은 일반 필드와 테이블 컬럼을 연결한다.
예를 들어name필드를member_name컬럼과 연결할 때 사용한다.
@JoinColumn은 다른 엔티티와의 관계를 저장하는 외래키 컬럼을 지정한다.
예를 들어 회원이 팀을 참조할 때, 그 관계를team_id외래키 컬럼에 저장한다고 알려 준다.
비교하면 아래처럼 볼 수 있다.// ColumnAndJoinColumnCompare.java @Column(name = "member_name") // 일반 값 필드와 컬럼 연결 private String name; @ManyToOne // 다른 Entity와의 관계 @JoinColumn(name = "team_id") // 외래키 컬럼 지정 private TeamEntity team;
name은 단순 문자열 값이다.
그래서@Column으로 컬럼과 연결한다.
team은 단순 값이 아니라TeamEntity객체 참조이다.
그래서 관계 어노테이션인@ManyToOne과 외래키 컬럼을 지정하는@JoinColumn을 함께 사용한다.
초보자가 헷갈리기 쉬운 부분은team_id필드를 따로 만들어야 하는지이다.
객체 중심으로 설계할 때는 보통 외래키 값 자체보다 참조할 객체를 필드로 둔다.// ObjectReferenceBetterFlow.java @ManyToOne // Team 객체와 연결 @JoinColumn(name = "team_id") // 실제 외래키 컬럼은 team_id private TeamEntity team;이렇게 작성하면
JPA가team참조와team_id외래키 컬럼을 연결한다.
따라서 객체 코드에서는TeamEntity를 참조하고, 데이터베이스에는 외래키 값이 저장되는 흐름으로 이어진다.
15-5. 연관관계 저장은 연결할 Entity를 먼저 준비한다
연관관계가 있는
Entity를 저장할 때는 연결할 대상 객체를 먼저 준비해야 한다.
예를 들어 회원을 저장하면서 팀과 연결하려면, 먼저 팀 객체가 있어야 한다.
저장 작업은 데이터베이스 상태를 바꾸는 작업이므로Transaction안에서 처리한다.// ManyToOnePersistFlow.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 객체 가져오기 try { transaction.begin(); // Transaction 시작 TeamEntity team = new TeamEntity(1L, "개발팀"); // 저장할 팀 Entity 생성 entityManager.persist(team); // 팀 저장 요청 MemberManyToOne member = new MemberManyToOne(1L, "홍길동", team); // 팀과 연결된 회원 Entity 생성 entityManager.persist(member); // 회원 저장 요청 transaction.commit(); // flush 후 저장 확정 } catch (Exception e) { if (transaction.isActive()) { // Transaction 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } }이 예제에서는 먼저
TeamEntity를 만들고 저장 요청한다.
그다음MemberManyToOne을 만들 때team객체를 전달한다.
이렇게 하면 회원 객체는 팀 객체를 참조하게 된다.
commit()과정에서flush가 일어나면team저장SQL과member저장SQL이 데이터베이스로 전달될 수 있다.
이때member테이블에는 팀과의 관계를 표현하기 위해team_id외래키 값이 저장된다.
직접 할당 기본키를 사용하는 예제이므로 같은 코드를 여러 번 실행하면 기본키 중복 오류가 발생할 수 있다.
다시 실행하려면 기본키 값을 바꾸거나 기존 데이터를 삭제해야 한다.
연관관계 저장에서는 객체끼리 참조로 연결하고, 데이터베이스에는 외래키 값으로 관계가 저장된다.
15-6. 연관관계 조회는 객체 참조로 이어진다
연관관계가 매핑되어 있으면 조회한 엔티티에서 연결된 엔티티로 이동할 수 있다.
회원을 조회한 뒤 회원이 속한 팀을 확인하는 흐름을 생각해 보자.
아래 예제는 기본키1L인 회원과 팀 데이터가 이미 저장되어 있다고 가정한다.// ManyToOneFindFlow.java MemberManyToOne member = entityManager.find(MemberManyToOne.class, 1L); // 회원 조회 if (member != null) { // 조회 결과가 있을 때 TeamEntity team = member.getTeam(); // 회원이 참조하는 팀 조회 System.out.println(team.getName()); // 팀 이름 출력 }
member.getTeam()은 회원 객체가 참조하는 팀 객체를 가져오는 코드이다.
객체 코드에서는 외래키 값인team_id를 직접 꺼내는 흐름이 아니다.
연결된TeamEntity객체로 이동하는 흐름이다.
이것이 객체 참조 방식의 장점이다.
데이터베이스에서는 외래키로 연결되어 있지만, 객체 코드에서는 연관된 객체를 직접 다룰 수 있다.
다만 실제로 팀 데이터를 언제 조회하는지는 즉시 로딩과 지연 로딩 설정에 따라 달라질 수 있다.
이 내용은 뒤에서 더 자세히 다룬다.
여기서는@ManyToOne과@JoinColumn으로 회원과 팀 관계를 연결할 수 있다는 흐름을 먼저 잡으면 된다.
15-7. 단방향 연관관계는 한쪽 객체에서만 참조하는 구조이다
단방향 연관관계는 한쪽 객체에서만 다른 객체를 참조하는 구조이다.
예를 들어 회원 객체가 팀 객체를 참조하지만, 팀 객체는 회원 목록을 모르는 구조이다.
현재 예제의MemberManyToOne이 단방향 연관관계이다.// OneWayRelationConcept.java @ManyToOne // 회원에서 팀으로만 이동 가능 @JoinColumn(name = "team_id") // 외래키 컬럼 지정 private TeamEntity team;이 구조에서는 회원에서 팀으로 이동할 수 있다.
// OneWayRelationUseFlow.java TeamEntity team = member.getTeam(); // 회원에서 팀으로 이동하지만 팀에서 회원 목록으로 바로 이동하는 필드는 없다.
즉, 객체 그래프 탐색 방향이 회원 → 팀 한 방향으로만 열린다.
객체 그래프 탐색은 객체 참조를 따라 다른 객체로 이동하는 것을 의미한다.
member.getTeam()처럼 회원 객체에서 팀 객체로 이동하는 것이 객체 그래프 탐색이다.
단방향 매핑은 구조가 단순하다.
처음 연관관계를 배울 때는 단방향부터 정확히 이해하는 것이 좋다.
15-8. 양방향 연관관계는 양쪽 객체가 서로 참조하는 구조이다
양방향 연관관계는 두 객체가 서로를 참조할 수 있는 구조이다.
회원은 팀을 참조하고, 팀은 회원 목록을 참조한다.
회원 쪽은 팀 하나를 참조한다.// MemberBidirectionalSide.java @ManyToOne // 여러 회원이 하나의 팀과 연결 @JoinColumn(name = "team_id") // 외래키 컬럼 지정 private TeamEntity team;팀에서도 회원 목록으로 이동하고 싶다면
TeamEntity에 회원 목록 필드를 추가할 수 있다.
이때 팀 쪽은 외래키를 직접 관리하지 않으므로mappedBy를 사용한다.// TeamEntityBidirectionalField.java @OneToMany(mappedBy = "team") // MemberManyToOne의 team 필드가 관계의 기준 private List<MemberManyToOne> members = new ArrayList<>(); // 팀에 속한 회원 목록
@OneToMany는 일대다 관계를 의미한다.
팀 하나에 여러 회원이 연결될 수 있으므로 팀 입장에서는 일대다 관계가 된다.
mappedBy = "team"은 이 관계의 기준이 회원 쪽의team필드에 있다는 뜻이다.
즉, 외래키를 실제로 관리하는 쪽은 회원 쪽이다.
TeamEntity에 이 필드를 추가하면 팀 객체에서 회원 목록으로 이동할 수 있다.
다만 외래키 값은 팀 쪽 목록 필드가 아니라 회원 쪽team필드와team_id외래키를 기준으로 관리된다.
양방향이라고 해서 데이터베이스에 외래키가 두 개 생기는 것은 아니다.
데이터베이스에서는 여전히member테이블의team_id외래키 하나로 관계를 표현한다.
객체에서 양쪽 방향으로 탐색할 수 있게 필드를 양쪽에 둔 것이다.
양방향 연관관계는 객체에서 양쪽으로 이동할 수 있게 만든 구조이고, 실제 외래키는 보통 한쪽 테이블에만 존재한다.
15-9. 연관관계의 주인은 외래키를 관리하는 쪽이다
양방향 연관관계에서는 연관관계의 주인을 정해야 한다.
연관관계의 주인은 외래키 값을 실제로 관리하는 쪽이다.
회원과 팀 관계에서는 외래키team_id가member테이블에 있다.
따라서 외래키를 관리하는 쪽은 회원 쪽이다.
객체로 보면MemberManyToOne의team필드가 연관관계의 주인이 된다.
주인 쪽은@JoinColumn을 사용한다.// OwningSideFlow.java @ManyToOne // 다대일 관계 @JoinColumn(name = "team_id") // 외래키 컬럼을 관리하는 주인 쪽 private TeamEntity team;반대쪽은
mappedBy를 사용한다.// InverseSideFlow.java @OneToMany(mappedBy = "team") // 관계의 주인이 아님, Member의 team 필드를 기준으로 연결 private List<MemberManyToOne> members = new ArrayList<>();
mappedBy가 붙은 쪽은 외래키를 직접 관리하지 않는다.
읽기 관점에서 반대 방향으로 탐색하기 위한 필드라고 이해하면 된다.
초보자가 가장 많이 헷갈리는 부분은 “주인”이라는 말이다.
여기서 주인은 더 중요한 객체라는 뜻이 아니다.
연관관계의 주인은 외래키 값을 변경할 수 있는 쪽이라는 뜻이다.
15-10. 연관관계 매핑 흐름 한 번에 보기
지금까지 본 내용을 하나로 연결하면 연관관계 매핑의 기본 흐름이 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라, 객체 참조와 외래키의 차이 →@ManyToOne→@JoinColumn→ 단방향과 양방향 → 연관관계의 주인 흐름을 한 번에 정리하는 마무리이다.
가장 기본으로 먼저 이해해야 할 구조는 다대일 단방향이다.
회원은 팀을 참조하고, 데이터베이스에서는 회원 테이블이 팀 외래키를 가진다.// MemberManyToOneSummary.java @Entity // 회원 Entity @Table(name = "member") // member 테이블과 매핑 public class MemberManyToOne { @Id // 회원 기본키 private Long id; @ManyToOne // 여러 회원이 하나의 팀과 연결 @JoinColumn(name = "team_id") // member 테이블의 team_id 외래키와 연결 private TeamEntity team; }이 코드는 객체에서는
MemberManyToOne이TeamEntity를 참조하도록 만든다.
데이터베이스에서는member.team_id외래키가team.id를 참조하는 구조로 이어진다.
정리하면 아래와 같다.
- 객체는 참조로 관계를 표현한다.
- 테이블은 외래키로 관계를 표현한다.
@ManyToOne은 여러 엔티티가 하나의 엔티티와 연결되는 관계를 나타낸다.@JoinColumn은 관계를 저장할 외래키 컬럼을 지정한다.- 단방향은 한쪽 객체에서만 참조하는 구조이다.
- 양방향은 양쪽 객체가 서로 참조할 수 있는 구조이다.
- 연관관계의 주인은 외래키를 관리하는 쪽이다.
연관관계 매핑에서 가장 먼저 잡아야 할 기준은 객체 참조와 테이블 외래키를 어떻게 연결할 것인지이다.
이 기준이 잡히면 다음 단계에서 다대일, 일대다, 일대일 관계와 로딩 전략을 더 쉽게 이해할 수 있다.
16. 다양한 연관관계 이해하기
JPA연관관계는 엔티티 사이의 연결 구조를 표현하는 방법이다.
앞에서는 회원과 팀처럼 여러 회원이 하나의 팀에 속하는 다대일 관계를 먼저 봤다.
하지만 실제 데이터 구조에는 다대일만 있는 것이 아니다.
하나의 팀이 여러 회원을 가질 수도 있고, 하나의 회원이 하나의 프로필을 가질 수도 있다.
또 학생과 과목처럼 서로 여러 개가 연결되는 관계도 있을 수 있다.
이런 관계를JPA에서는@ManyToOne,@OneToMany,@OneToOne,@ManyToMany같은 어노테이션으로 표현한다.
연관관계 매핑의 핵심은 객체 참조와 테이블 외래키를 어떻게 연결할지 정하는 것이다.
이 기준을 잡아야 단방향, 양방향, 연관관계의 주인,mappedBy,@JoinColumn을 헷갈리지 않는다.
16-1. 연관관계는 객체 참조와 테이블 외래키를 연결한다
객체는 참조로 관계를 표현한다.
예를 들어 회원 객체가 팀 객체를 필드로 가지고 있으면, 회원에서 팀으로 이동할 수 있다.
이때 객체 코드에서는member.getTeam()처럼 참조를 따라간다.
반면 테이블은 외래키로 관계를 표현한다.
회원 테이블에team_id컬럼이 있고, 이 값이 팀 테이블의 기본키를 가리키면 회원과 팀이 연결된다.
객체에서는
Member가Team객체를 참조하고, 테이블에서는MEMBER의TEAM_ID외래키가TEAM의 기본키와 연결된다.
JPA연관관계 매핑은 이 객체 참조와 테이블 외래키를 서로 맞춰 주는 설정이다.
JPA연관관계 매핑은 이 두 구조를 연결한다.
객체에서는 참조를 사용하고, 데이터베이스에서는 외래키를 사용하기 때문에 둘 사이를 맞춰 주는 설정이 필요하다.
가장 기본으로 먼저 이해해야 할 구조는 다대일 단방향이다.
회원은 팀을 참조하고, 데이터베이스에서는 회원 테이블이 팀 외래키를 가진다.// MemberManyToOneSummary.java @Entity // 회원 Entity @Table(name = "member") // member 테이블과 매핑 public class MemberManyToOne { @Id // 회원 기본키 private Long id; @ManyToOne // 여러 회원이 하나의 팀과 연결 @JoinColumn(name = "team_id") // member 테이블의 team_id 외래키와 연결 private TeamEntity team; // 팀 객체 참조 }이 코드는 객체에서는
MemberManyToOne이TeamEntity를 참조하도록 만든다.
데이터베이스에서는member.team_id외래키가team.id를 참조하는 구조로 이어진다.
정리하면 아래와 같다.
- 객체는 참조로 관계를 표현한다.
- 테이블은 외래키로 관계를 표현한다.
@ManyToOne은 여러 엔티티가 하나의 엔티티와 연결되는 관계를 나타낸다.@JoinColumn은 관계를 저장할 외래키 컬럼을 지정한다.연관관계 매핑에서 가장 먼저 봐야 할 것은 어느 객체가 참조를 가지고 있고, 어느 테이블이 외래키를 가지고 있는지이다.
16-2. 다대일 관계는 여러 Entity가 하나의 Entity와 연결되는 구조이다
다대일 관계는 여러 엔티티가 하나의 엔티티와 연결되는 관계이다.
회원과 팀을 예로 들면 여러 회원이 하나의 팀에 속할 수 있다.
그래서 회원 입장에서는 팀과 다대일 관계가 된다.
다대일 관계에서는 보통 다 쪽에 외래키가 있다.
회원과 팀 관계에서는 회원 테이블에team_id외래키가 있다.
따라서 회원 엔티티가 팀 엔티티를 참조하고, 회원 쪽에서@ManyToOne과@JoinColumn을 사용한다.// MemberManyToOne.java @Entity // 회원 Entity @Table(name = "member") // member 테이블과 매핑 public class MemberManyToOne { @Id // 회원 기본키 private Long id; private String username; // 회원 이름 @ManyToOne // 여러 회원이 하나의 팀에 속함 @JoinColumn(name = "team_id") // member 테이블의 team_id 외래키와 연결 private TeamEntity team; // 회원이 속한 팀 참조 }
@ManyToOne은 현재 엔티티 여러 개가 대상 엔티티 하나와 연결된다는 뜻이다.
회원 여러 명이 같은 팀 하나를 참조할 수 있으므로 회원 쪽에@ManyToOne이 붙는다.
@ManyToOne은 다대일 관계를 설정하는 어노테이션이다.
optional은 연결 대상이 반드시 있어야 하는지 정하고,fetch는 연관 엔티티를 언제 조회할지 정한다.
cascade는 영속성 전이 기능을 설정하고,targetEntity는 연결할 엔티티 타입을 직접 지정할 때 사용한다.
앞에서 본@JoinColumn을 실제 다대일 관계에 적용하면, 객체의 참조 필드와 테이블의 외래키 컬럼을 연결하는 역할을 한다.
@JoinColumn(name = "team_id")은 이 관계를 저장할 외래키 컬럼 이름을 지정한다.
즉, 객체에서는team필드를 통해 팀 객체를 참조하고, 테이블에서는team_id컬럼을 통해 팀 행을 참조한다.
@JoinColumn은 연관관계에서 사용할 외래키 컬럼을 지정한다.
name은 외래키 컬럼 이름을 정하고,referencedColumnName은 외래키가 참조할 대상 테이블의 컬럼을 정한다.
foreignKey는 외래키 제약 조건 이름을 지정할 때 사용하고,unique,nullable,insertable,updatable,columnDefinition,table은 컬럼 세부 설정과 연결된다.
다대일 관계에서는 외래키가 있는 다 쪽 엔티티가 관계를 관리하는 기준이 되는 경우가 많다.
16-3. 일대다 관계는 하나의 Entity가 여러 Entity를 가지는 구조이다
일대다 관계는 하나의 엔티티가 여러 엔티티와 연결되는 관계이다.
팀과 회원을 팀 입장에서 보면 하나의 팀에 여러 회원이 속할 수 있다.
그래서 팀 입장에서는 회원과 일대다 관계가 된다.
객체에서는 팀 엔티티가 회원 목록을 가질 수 있다.
여러 회원을 담아야 하므로List같은 컬렉션을 사용한다.
컬렉션은 여러 객체를 담는 자료구조이다.// TeamOneToMany.java @Entity // 팀 Entity @Table(name = "team") // team 테이블과 매핑 public class TeamEntity { @Id // 팀 기본키 private Long id; private String name; // 팀 이름 @OneToMany(mappedBy = "team") // MemberManyToOne의 team 필드가 관계의 주인 private List<MemberManyToOne> members = new ArrayList<>(); // 팀에 속한 회원 목록 }
@OneToMany는 현재 엔티티 하나가 대상 엔티티 여러 개와 연결된다는 뜻이다.
팀 하나가 여러 회원을 가질 수 있으므로 팀 쪽에는@OneToMany를 사용할 수 있다.
여기서 중요한 속성이mappedBy이다.
mappedBy = "team"은 이 관계의 주인이 현재TeamEntity가 아니라MemberManyToOne의team필드라는 뜻이다.
즉, 외래키를 실제로 관리하는 쪽은 회원 엔티티의team필드이다.
초보자가 헷갈리기 쉬운 부분은members목록이 있다고 해서 팀 테이블에 회원 목록이 컬럼으로 저장되는 것은 아니라는 점이다.
테이블에서는 여전히 회원 테이블의team_id외래키가 관계를 표현한다.
일대다 관계의 컬렉션은 객체 탐색을 편하게 하기 위한 구조이고, 실제 외래키 관리는 보통 다 쪽에서 이루어진다.
16-4. 단방향과 양방향은 객체 참조 방향의 차이이다
단방향은 한쪽 객체에서만 다른 객체를 참조하는 구조이다.
예를 들어 회원이 팀을 참조하지만, 팀은 회원 목록을 모른다면 단방향 관계이다.
아래는 회원에서 팀으로만 이동할 수 있는 단방향 구조이다.// OneWayRelation.java @Entity // 회원 Entity public class MemberManyToOne { @Id // 회원 기본키 private Long id; @ManyToOne // 회원에서 팀으로 이동 가능 @JoinColumn(name = "team_id") // 외래키 컬럼 지정 private TeamEntity team; // 팀 참조 }이 구조에서는
member.getTeam()처럼 회원에서 팀으로 이동할 수 있다.
하지만 팀 객체 안에 회원 목록이 없다면team.getMembers()처럼 팀에서 회원 목록으로 이동할 수 없다.
양방향은 양쪽 객체가 서로 참조할 수 있는 구조이다.
회원은 팀을 참조하고, 팀은 회원 목록을 참조한다.// TwoWayRelation.java @Entity // 팀 Entity public class TeamEntity { @Id // 팀 기본키 private Long id; @OneToMany(mappedBy = "team") // 반대쪽 MemberManyToOne의 team 필드와 연결 private List<MemberManyToOne> members = new ArrayList<>(); // 회원 목록 }양방향이라고 해서 데이터베이스 외래키가 두 개 생기는 것은 아니다.
테이블에서는 보통 외래키 하나로 관계를 표현한다.
객체에서 양쪽으로 이동할 수 있게 참조를 두 개 만든 것뿐이다.
단방향과 양방향은 데이터베이스 외래키 개수의 차이가 아니라, 객체에서 참조를 어느 방향으로 둘 것인지의 차이이다.
16-5. 연관관계의 주인은 외래키를 관리하는 쪽이다
양방향 관계에서는 연관관계의 주인을 정해야 한다.
주인이라는 말 때문에 더 중요한 객체라고 오해하기 쉽다.
하지만JPA에서 연관관계의 주인은 더 중요한 객체가 아니라 외래키 값을 실제로 관리하는 쪽이다.
회원과 팀 관계에서는 회원 테이블에team_id외래키가 있다.
따라서 회원 엔티티의team필드가 관계의 주인이 되는 구조가 자연스럽다.// RelationOwnerMember.java @Entity // 회원 Entity public class MemberManyToOne { @Id // 회원 기본키 private Long id; @ManyToOne // 다대일 관계 @JoinColumn(name = "team_id") // 외래키를 관리하는 주인 쪽 private TeamEntity team; }반대쪽인 팀 엔티티는
mappedBy를 사용한다.// RelationOwnerTeam.java @Entity // 팀 Entity public class TeamEntity { @Id // 팀 기본키 private Long id; @OneToMany(mappedBy = "team") // 주인이 아님, MemberManyToOne의 team 필드가 주인 private List<MemberManyToOne> members = new ArrayList<>(); }
mappedBy = "team"은 “나는 외래키를 직접 관리하지 않고, 반대쪽team필드가 이 관계를 관리한다”는 뜻이다.
따라서mappedBy가 있는 쪽은 연관관계의 주인이 아니다.
관계를 실제로 바꿀 때는 주인 쪽 값을 바꾸는 것이 중요하다.
회원이 어떤 팀에 속하는지 바꾸려면 회원 엔티티의team필드를 변경해야 외래키 변경으로 이어질 수 있다.
연관관계의 주인은 외래키를 실제로 관리하는 쪽이고,mappedBy가 있는 쪽은 주인이 아니다.
16-6. 일대일 관계는 하나의 Entity가 하나의 Entity와 연결되는 구조이다
일대일 관계는 하나의 엔티티가 하나의 엔티티와 연결되는 관계이다.
예를 들어 회원 한 명이 사물함 하나를 가진다고 생각할 수 있다.
회원과 사물함이 서로 하나씩만 연결된다면 일대일 관계이다.
일대일 관계에서도 객체는 참조로 연결하고, 테이블은 외래키로 연결한다.
예시처럼Member가Locker를 참조하면 객체에서는locker필드로 이동하고, 테이블에서는MEMBER의LOCKER_ID외래키가LOCKER의 기본키와 연결된다.
일대일 관계는@OneToOne으로 표현한다.
외래키를 어느 테이블에 둘지는 설계에 따라 달라질 수 있다.
여기서는 이미지 흐름에 맞춰 회원 테이블이 사물함을 참조한다고 가정한다.// MemberOneToOne.java @Entity // 회원 Entity @Table(name = "member") // member 테이블과 매핑 public class MemberOneToOne { @Id // 회원 기본키 private Long id; private String username; // 회원 이름 @OneToOne // 회원 하나가 사물함 하나와 연결 @JoinColumn(name = "locker_id") // member 테이블의 locker_id 외래키와 연결 private LockerEntity locker; // 연결된 사물함 }
@OneToOne은 현재 엔티티 하나가 대상 엔티티 하나와 연결된다는 뜻이다.
@JoinColumn(name = "locker_id")은 회원 테이블의locker_id외래키로 사물함과 연결한다는 뜻이다.
일대일 관계도 연관관계의 주인을 생각해야 한다.
외래키가 있는 쪽이 보통 주인이 된다.
위 예제에서는 회원 쪽에locker_id외래키가 있다고 가정했으므로MemberOneToOne이 관계를 관리하는 쪽이다.
일대일 관계도 결국 객체 참조와 외래키를 연결하는 구조이며, 외래키가 있는 쪽이 관계를 관리하는 기준이 된다.
16-7. 다대다 관계는 중간 테이블이 필요한 구조이다
다대다 관계는 여러 엔티티가 서로 여러 개씩 연결되는 구조이다.
예를 들어 학생과 과목 관계를 생각해 보자.
학생 한 명은 여러 과목을 수강할 수 있고, 과목 하나에도 여러 학생이 수강할 수 있다.
이것이 다대다 관계이다.
객체에서는 컬렉션을 서로 가질 수 있기 때문에 다대다처럼 보이는 구조를 만들 수 있다.
JPA에서는@ManyToMany를 사용할 수 있다.// StudentManyToMany.java @Entity // 학생 Entity public class StudentEntity { @Id // 학생 기본키 private Long id; @ManyToMany // 여러 학생이 여러 과목과 연결 private List<CourseEntity> courses = new ArrayList<>(); // 수강 과목 목록 }하지만 다대다 관계를 그대로 사용하는 것은 조심해야 한다.
관계형 데이터베이스에서는 다대다 관계를 직접 표현하기 어렵다.
보통 중간 테이블을 만들어 학생과 과목을 연결한다.
@ManyToMany를 사용해도 데이터베이스에서는 중간 테이블이 필요하다.
다만@ManyToMany만 사용하면 그 중간 테이블을 하나의Entity로 직접 다루기 어렵고, 추가 정보를 넣는 구조도 불편해진다.
학생과 과목 사이에는 수강 신청이라는 중간 개념이 들어갈 수 있다.
이 중간 테이블에는 학생 번호와 과목 번호뿐 아니라 신청일, 수강 상태 같은 추가 정보도 들어갈 수 있다.
그래서 다대다 관계는 중간 엔티티로 풀어내는 방식이 더 명확하다.
다대다 관계는 단순히@ManyToMany로 끝내기보다, 중간 테이블과 중간 엔티티로 풀어내는 흐름을 이해하는 것이 중요하다.
16-8. 다대다 관계는 중간 Entity로 풀어내는 것이 좋다
다대다 관계를 중간 엔티티로 풀면 구조가 더 명확해진다.
학생과 과목 사이에 수강 엔티티를 둔다고 생각해 보자.
수강 엔티티는 학생 하나와 과목 하나를 연결한다.
이렇게 하면 학생과 수강은 일대다 관계가 되고, 과목과 수강도 일대다 관계가 된다.
반대로 수강 입장에서는 학생과 다대일, 과목과 다대일 관계가 된다.// EnrollmentEntity.java @Entity // 수강 Entity @Table(name = "enrollment") // enrollment 테이블과 매핑 public class EnrollmentEntity { @Id // 수강 기본키 private Long id; @ManyToOne // 여러 수강 정보가 하나의 학생과 연결 @JoinColumn(name = "student_id") // student_id 외래키와 연결 private StudentEntity student; // 학생 참조 @ManyToOne // 여러 수강 정보가 하나의 과목과 연결 @JoinColumn(name = "course_id") // course_id 외래키와 연결 private CourseEntity course; // 과목 참조 private String status; // 수강 상태 }이 구조에서는 수강 엔티티가 중간 테이블 역할을 한다.
학생과 과목을 직접 다대다로 연결하지 않고, 수강이라는 엔티티를 통해 연결한다.
이 방식의 장점은 중간 관계에 대한 정보를 추가할 수 있다는 점이다.
예를 들어 수강 신청일, 수강 상태, 점수 같은 값을EnrollmentEntity에 넣을 수 있다.
또 연관관계의 주인도 더 명확해진다.
EnrollmentEntity가student_id,course_id외래키를 가지고 있으므로 수강 엔티티가 두 관계를 관리하는 쪽이 된다.
다대다 관계는 중간 엔티티를 두면 관계 자체도 데이터로 관리할 수 있고, 추가 정보도 자연스럽게 저장할 수 있다.
16-9. 다양한 연관관계 흐름 한 번에 정리하기
지금까지 본 내용을 하나로 연결하면 연관관계 종류와 매핑 기준이 정리된다.
이 구간은 새로운 문법을 추가하는 부분이 아니라, 다대일, 일대다, 일대일, 다대다, 연관관계의 주인, 중간 엔티티 흐름을 한 번에 정리하는 마무리이다.
연관관계 종류는 아래처럼 정리할 수 있다.
@ManyToOne: 여러 엔티티가 하나의 엔티티와 연결된다.@OneToMany: 하나의 엔티티가 여러 엔티티와 연결된다.@OneToOne: 하나의 엔티티가 하나의 엔티티와 연결된다.@ManyToMany: 여러 엔티티가 서로 여러 개씩 연결된다.연관관계 매핑 기준은 아래처럼 볼 수 있다.
- 객체는 참조로 관계를 표현한다.
- 테이블은 외래키로 관계를 표현한다.
@JoinColumn은 외래키 컬럼을 지정한다.- 외래키가 있는 쪽이 보통 연관관계의 주인이다.
mappedBy가 있는 쪽은 주인이 아니다.- 단방향은 한쪽 객체에서만 참조하는 구조이다.
- 양방향은 양쪽 객체가 서로 참조할 수 있는 구조이다.
- 다대다 관계는 중간 엔티티로 풀어내는 방식이 더 명확하다.
마지막으로 전체 기준을 짧게 정리하면 이렇다.
연관관계 매핑은 엔티티 사이의 관계를 객체 참조와 테이블 외래키로 함께 이해하는 과정이다.
이 기준이 잡히면 다음 단계에서 연관된 엔티티를 언제 조회할지 정하는 지연 로딩과 즉시 로딩을 더 쉽게 이해할 수 있다.
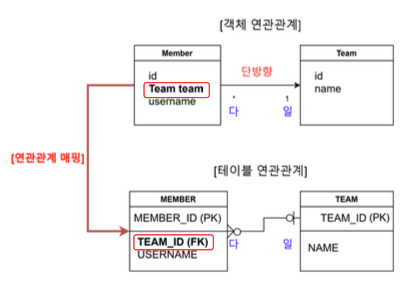
17. 지연 로딩과 즉시 로딩 이해하기
JPA에서 연관관계를 매핑하면 한 엔티티에서 다른 엔티티로 객체 참조를 따라 이동할 수 있다.
예를 들어 회원을 조회한 뒤member.getTeam()으로 팀 정보를 확인할 수 있다.
그런데 연관관계가 있다고 해서 연결된 엔티티를 항상 바로 조회해야 하는 것은 아니다.
회원을 조회할 때 팀까지 바로 함께 조회할 수도 있고, 팀 정보가 실제로 필요할 때 나중에 조회할 수도 있다.
이 기준을 로딩 전략이라고 한다.
로딩은 데이터를 가져오는 시점을 의미한다.
지연 로딩과 즉시 로딩은 연관된Entity를 언제 데이터베이스에서 조회할지 정하는 방식이다.
17-1. 로딩 전략은 연관된 엔티티를 언제 가져올지 정한다
로딩 전략은 연관된 엔티티를 처음부터 함께 가져올지, 필요할 때 나중에 가져올지 정하는 설정이다.
연관관계가 있다고 해서 연결된 데이터를 항상 한 번에 모두 가져와야 하는 것은 아니다.
예를 들어 회원과 팀이 연결되어 있다고 생각해 보자.
회원 목록 화면에서는 회원 이름만 필요할 수 있다.
이때 팀 정보까지 매번 함께 조회하면 필요 없는 데이터 조회가 늘어날 수 있다.
반대로 회원 상세 화면에서는 회원 정보와 팀 정보가 항상 같이 필요할 수 있다.
이런 경우에는 회원을 조회할 때 팀을 함께 가져오는 방식이 더 단순할 수 있다.
JPA의 대표 로딩 전략은 두 가지이다.
FetchType.LAZY: 지연 로딩이다.FetchType.EAGER: 즉시 로딩이다.지연 로딩은 연관된 엔티티를 실제로 사용할 때 조회한다.
즉시 로딩은 주 엔티티를 조회할 때 연관된 엔티티도 바로 함께 조회하려고 한다.
로딩 전략은 연관된 엔티티의 조회 시점을 정하고, 이 조회 시점은 성능과 실행 흐름에 직접 영향을 준다.
17-2. 지연 로딩은 실제 사용할 때 연관된 엔티티를 조회한다
지연 로딩은 처음 엔티티를 조회할 때 연관된 엔티티를 바로 가져오지 않는 방식이다.
대신 연관된 엔티티가 실제로 필요해지는 순간에 데이터베이스에서 조회할 수 있다.
지연 로딩은fetch = FetchType.LAZY로 설정한다.// LazyLoadingMapping.java @ManyToOne(fetch = FetchType.LAZY) // 팀은 실제 사용할 때 조회 @JoinColumn(name = "team_id") // member 테이블의 team_id 외래키와 연결 private TeamEntity team; // 회원이 속한 팀 참조이 설정에서는 회원을 조회할 때 팀 전체 데이터를 바로 가져오지 않을 수 있다.
회원 객체 안에는 실제 팀 객체 대신, 나중에 팀을 가져올 수 있는 대리 객체가 들어올 수 있다.
이 대리 객체를 프록시라고 한다.
프록시는 실제 객체를 대신해서 서 있는 객체이다.
처음에는 진짜 데이터가 모두 채워져 있지 않을 수 있다.
그러다가 실제 값이 필요해지는 순간 데이터베이스를 조회해서 값을 채울 수 있다.
아래 예제는 기본키1L인 회원 데이터가 이미 저장되어 있다고 가정한다.// LazyLoadingUseFlow.java MemberManyToOne member = entityManager.find(MemberManyToOne.class, 1L); // 회원 조회 if (member != null) { // 조회 결과가 있을 때 TeamEntity team = member.getTeam(); // 지연 로딩 프록시를 받을 수 있음 System.out.println(team.getName()); // 팀 값을 실제 사용할 때 조회가 발생할 수 있음 }
member.getTeam()을 호출했다고 해서 무조건 그 순간 팀의 모든 데이터가 조회된다고 단정하면 안 된다.
지연 로딩에서는 프록시가 반환될 수 있다.
실제 팀 이름처럼 값을 사용하는team.getName()시점에 조회가 발생할 수 있다.
지연 로딩의 핵심은 연관된 데이터를 처음부터 가져오지 않고, 실제 사용할 때 가져올 수 있다는 점이다.
17-3. 프록시는 실제 엔티티 조회를 미루기 위한 대리 객체이다
프록시는 실제 엔티티를 대신하는 객체이다.
지연 로딩에서는 연관된 엔티티를 바로 조회하지 않기 때문에, 그 자리에 실제 객체처럼 행동할 수 있는 대리 객체가 필요하다.
예를 들어 회원을 조회했지만 팀 정보는 아직 필요하지 않다고 생각해 보자.
이때JPA는 팀 정보를 바로 조회하지 않고, 팀 자리에 프록시를 넣어 둘 수 있다.
그리고 팀 이름처럼 실제 값이 필요해지는 순간 팀 데이터를 조회한다.
흐름을 단순하게 보면 아래와 같다.
- 회원을 조회한다.
- 팀은 지연 로딩 대상이다.
- 팀 자리에 프록시가 들어올 수 있다.
team.getName()처럼 실제 값을 사용할 때 팀 조회가 발생할 수 있다.프록시는 지연 로딩을 가능하게 해 주는 장치이다.
그래서 지연 로딩을 이해할 때는 프록시를 함께 이해해야 한다.
프록시는 실제 객체처럼 보이지만, 처음부터 모든 값을 가지고 있는 실제 엔티티와는 다를 수 있다.
따라서 지연 로딩에서는 “참조를 얻는 시점”과 “실제 값을 사용하는 시점”을 나누어 봐야 한다.
프록시는 연관 엔티티 조회를 실제 사용 시점까지 미루기 위해 사용되는 대리 객체이다.
17-4. 즉시 로딩은 연관된 엔티티를 바로 함께 조회한다
즉시 로딩은 주 엔티티를 조회할 때 연관된 엔티티도 함께 조회하려는 방식이다.
회원을 조회하면 회원이 속한 팀도 같이 조회될 수 있다.
즉시 로딩은fetch = FetchType.EAGER로 설정한다.// EagerLoadingMapping.java @ManyToOne(fetch = FetchType.EAGER) // 회원 조회 시 팀도 즉시 조회 @JoinColumn(name = "team_id") // member 테이블의 team_id 외래키와 연결 private TeamEntity team; // 회원이 속한 팀 참조이 설정에서는 회원을 조회할 때 팀 정보까지 함께 준비될 수 있다.
그래서member.getTeam()을 호출했을 때 이미 팀 객체가 조회되어 있을 수 있다.
아래 예제는 기본키1L인 회원 데이터가 이미 저장되어 있다고 가정한다.// EagerLoadingUseFlow.java MemberManyToOne member = entityManager.find(MemberManyToOne.class, 1L); // 회원 조회 if (member != null) { // 조회 결과가 있을 때 TeamEntity team = member.getTeam(); // 이미 함께 조회된 팀을 사용할 수 있음 System.out.println(team.getName()); // 팀 이름 출력 }즉시 로딩은 연관된 데이터를 항상 같이 사용할 때는 편할 수 있다.
하지만 필요하지 않은 데이터까지 함께 가져올 수 있다는 단점이 있다.
예를 들어 회원 이름만 필요한 화면인데 팀 정보까지 매번 함께 조회하면 불필요한 조회가 늘어난다.
연관관계가 많아질수록 예상보다 많은 데이터가 한 번에 조회될 수 있다.
즉시 로딩은 편해 보이지만, 필요하지 않은 연관 데이터까지 함께 가져올 수 있으므로 신중하게 사용해야 한다.
17-5. 기본 로딩 전략과 명시적 설정을 구분해야 한다
JPA의 연관관계 어노테이션에는 기본 로딩 전략이 있다.
기본값은fetch속성을 따로 지정하지 않았을 때 자동으로 적용되는 값이다.
대표적인 기본값은 아래와 같다.
@ManyToOne: 기본값은EAGER이다.@OneToOne: 기본값은EAGER이다.@OneToMany: 기본값은LAZY이다.@ManyToMany: 기본값은LAZY이다.예를 들어
@ManyToOne에서fetch를 생략하면 기본적으로 즉시 로딩이 적용될 수 있다.// ManyToOneDefaultFetchFlow.java @ManyToOne // 기본값은 EAGER @JoinColumn(name = "team_id") // 외래키 컬럼 지정 private TeamEntity team; // 팀 참조하지만 기본값이 그렇다고 해서 항상 그대로 사용하는 것이 좋은 것은 아니다.
@ManyToOne은 자주 사용하는 관계이기 때문에, 기본값인 즉시 로딩을 그대로 두면 예상하지 못한 조회가 늘어날 수 있다.
그래서 필요한 경우 아래처럼 지연 로딩을 명시한다.// ManyToOneLazyFetchFlow.java @ManyToOne(fetch = FetchType.LAZY) // 필요할 때 팀 조회 @JoinColumn(name = "team_id") // 외래키 컬럼 지정 private TeamEntity team; // 팀 참조이렇게 명시하면 회원을 조회할 때 팀을 항상 바로 가져오지 않고, 실제로 팀 정보가 필요할 때 조회하도록 할 수 있다.
기본 로딩 전략은 자동 적용값이고, 실제 코드에서는 조회 흐름에 맞게LAZY나EAGER를 명시적으로 선택해야 한다.
17-6. 지연 로딩은 영속성 컨텍스트가 살아 있을 때 동작한다
지연 로딩은 실제 값이 필요할 때 데이터베이스를 다시 조회할 수 있다.
그러려면EntityManager와 영속성 컨텍스트가 아직 살아 있어야 한다.
영속성 컨텍스트는 엔티티를 관리하는 공간이다.
지연 로딩 프록시는 이 관리 흐름 안에서 필요한 데이터를 가져올 수 있다.
그런데EntityManager가 닫힌 뒤라면 더 이상 데이터베이스 조회를 진행하기 어렵다.
아래 예제는 기본키1L인 회원 데이터가 이미 저장되어 있고, 팀 정보가 아직 실제로 조회되지 않은 상황을 가정한다.// LazyLoadingAfterCloseBadFlow.java MemberManyToOne member = entityManager.find(MemberManyToOne.class, 1L); // 회원 조회 if (member != null) { // 조회 결과가 있을 때 entityManager.close(); // EntityManager 닫기 TeamEntity team = member.getTeam(); // 지연 로딩 대상 접근 System.out.println(team.getName()); // 이 시점에 지연 로딩 문제가 발생할 수 있음 }이 코드는 닫힌
EntityManager밖에서 지연 로딩을 시도할 수 있다.
팀 정보가 아직 실제로 조회되지 않은 상태라면,team.getName()시점에 추가 조회가 필요하다.
하지만 영속성 컨텍스트가 닫혀 있으면 추가 조회를 처리할 수 없다.
그래서 지연 로딩을 사용할 때는 연관 데이터를 언제 사용할지 생각해야 한다.
필요한 데이터는 영속성 컨텍스트가 열려 있는 동안 조회해야 한다.
지연 로딩은 필요한 데이터를 늦게 가져오는 장점이 있지만, 영속성 컨텍스트가 닫힌 뒤에는 추가 조회가 불가능할 수 있다.
17-7. 지연 로딩과 즉시 로딩은 조회 시점의 차이이다
지연 로딩과 즉시 로딩의 가장 큰 차이는 연관 엔티티를 가져오는 시점이다.
지연 로딩은 연관 엔티티를 실제 사용할 때 가져오고, 즉시 로딩은 주 엔티티를 조회할 때 함께 가져오려고 한다.
비교하면 아래와 같다.
LAZY: 연관 엔티티를 실제 사용할 때 조회한다.EAGER: 주 엔티티를 조회할 때 연관 엔티티도 바로 함께 조회하려고 한다.LAZY에서는 프록시가 사용될 수 있다.LAZY는 영속성 컨텍스트가 닫힌 뒤에 접근하면 문제가 생길 수 있다.EAGER는 필요하지 않은 데이터까지 함께 조회할 수 있다.처음 배울 때는 즉시 로딩이 더 편해 보일 수 있다.
하지만 연관관계가 많아질수록 불필요한 데이터 조회가 늘어날 수 있다.
그래서 연관관계는 기본적으로 지연 로딩을 고려하고, 실제로 함께 필요한 데이터는 조회 쿼리에서 명확히 가져오는 흐름이 안전하다.
여기서 다음 개념으로 자연스럽게 이어진다.
연관 엔티티를 언제 조회하느냐는 실제SQL실행 횟수와 연결된다.
목록 조회에서 연관 엔티티를 반복해서 사용하면 조회가 예상보다 많이 발생할 수 있다.
이 문제가 바로 다음에 볼N+1문제이다.
마지막으로 기준을 정리하면 이렇다.
지연 로딩과 즉시 로딩은 연관 엔티티의 조회 시점을 정하는 설정이고, 이 조회 시점은 다음 단계의N+1문제와Fetch Join이해로 이어진다.
18. N+1 문제와 Fetch Join 이해하기
앞에서 지연 로딩과 즉시 로딩은 연관된
Entity를 언제 가져올지 정하는 방식이라고 정리했다.
이제 그 로딩 전략이 실제 조회 성능과 어떻게 연결되는지 봐야 한다.
가장 대표적으로 만나는 문제가N+1문제이다.
앞에서는 지연 로딩과 즉시 로딩의 개념을 중심으로 봤다.
이번에는 그 로딩 전략이 실제SQL실행 횟수에 어떤 영향을 주는지, 그리고Fetch Join으로 어떻게 줄일 수 있는지 중심으로 정리한다.
N+1문제는 처음 목록을 조회하는 쿼리1번이 실행된 뒤, 조회된 데이터 개수만큼 연관 엔티티 조회 쿼리가 추가로 실행되는 상황이다.
예를 들어 회원 목록을1번 조회했는데, 각 회원의 팀을 사용할 때 팀 조회가 회원 수만큼 추가로 발생할 수 있다.
N+1문제는 연관 데이터를 반복해서 조회하면서SQL실행 횟수가 예상보다 크게 늘어나는 성능 문제이다.
18-1. N+1은 목록 조회 1번 뒤에 N번의 추가 조회가 붙는 문제이다
N+1에서N은 처음 조회된 데이터 개수를 의미한다.
처음 회원 목록을 조회해서 회원이10명 나왔다면N은10이다.
여기에 처음 목록 조회1번이 더해져서1 + 10개의 조회가 발생할 수 있다.
흐름을 단순하게 보면 아래와 같다.
- 회원 목록을 조회한다.
- 회원이
N명 조회된다.- 반복문에서 각 회원의 팀 정보를 사용한다.
- 팀 정보를 가져오기 위한 조회가 최대
N번 추가될 수 있다.즉, 처음에는 목록 조회만 한 것처럼 보이지만, 실제로는 연관 엔티티를 사용할 때 추가
SQL이 계속 실행될 수 있다.
아래 코드는N+1문제가 생길 수 있는 기본 흐름이다.// NPlusOneBasicFlow.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m", MemberManyToOne.class ).getResultList(); // 회원 목록 조회 1번 for (MemberManyToOne member : members) { // 조회된 회원 수만큼 반복 System.out.println(member.getTeam().getName()); // 팀 조회가 추가로 발생할 수 있음 }이 코드에서 첫 번째
JPQL은 회원 목록을 조회한다.
이것이1번 쿼리이다.
그다음 반복문에서member.getTeam().getName()을 호출한다.
이때 각 회원이 참조하는 팀 정보가 아직 준비되어 있지 않다면 팀 조회SQL이 추가로 실행될 수 있다.
회원이 많을수록 추가 조회도 늘어날 수 있다.
N+1은 코드 한 줄이 틀려서 생기는 문제가 아니라, 연관 데이터를 사용하는 시점과 조회 방식이 맞지 않을 때 생기는 문제이다.
18-2. 지연 로딩에서도 N+1 문제가 발생할 수 있다
지연 로딩은 연관된 엔티티를 처음부터 가져오지 않고 실제 사용할 때 가져오는 방식이다.
그래서 처음 목록 조회만 보면 실행되는SQL이 적어 보일 수 있다.
하지만 반복문 안에서 연관 엔티티를 계속 사용하면 이야기가 달라진다.
각 회원의 팀 이름을 출력하는 순간마다 팀 정보가 필요해진다.
이때 팀 조회가 반복해서 발생할 수 있다.
// LazyNPlusOneFlow.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m", MemberManyToOne.class ).getResultList(); // 회원 목록만 먼저 조회 for (MemberManyToOne member : members) { // 회원을 하나씩 확인 TeamEntity team = member.getTeam(); // 지연 로딩 대상 접근 System.out.println(team.getName()); // 팀 값을 실제 사용할 때 추가 조회 가능 }지연 로딩 자체가 나쁜 것은 아니다.
필요하지 않은 연관 데이터를 처음부터 가져오지 않는 장점이 있다.
문제는 목록을 조회한 뒤 반복문에서 연관 데이터를 계속 사용할 때이다.
이 경우 지연 로딩은 조회를 미룬 것일 뿐이고, 실제 사용하는 순간 추가 조회가 발생할 수 있다.
지연 로딩은 조회 비용을 없애는 기능이 아니라, 조회 시점을 실제 사용 시점으로 미루는 기능이다.
18-3. 즉시 로딩도 N+1 문제에서 자유롭지 않다
즉시 로딩은 연관된 엔티티를 바로 함께 조회하려는 전략이다.
그래서 초보자는 즉시 로딩을 쓰면N+1문제가 없어질 것처럼 생각하기 쉽다.
하지만 그렇게 단순하게 보면 안 된다.
JPQL로 목록을 조회할 때는 먼저 조회 대상 엔티티 목록을 가져온 뒤, 즉시 로딩 설정에 맞춰 연관 엔티티를 추가로 조회하는 흐름이 생길 수 있다.
즉시 로딩은 “항상 하나의SQL로 모든 연관 데이터를 가져온다”는 뜻이 아니다.
// EagerNPlusOneFlow.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m", MemberManyToOne.class ).getResultList(); // 회원 목록 조회 for (MemberManyToOne member : members) { // 회원 목록 사용 System.out.println(member.getTeam().getName()); // 이미 준비된 팀을 사용할 수 있지만, 조회 과정에서 추가 SQL이 발생했을 수 있음 }즉시 로딩은 연관 데이터를 바로 준비하려고 한다.
하지만 목록 조회에서는 그 준비 과정이 추가 조회로 이어질 수 있다.
따라서 즉시 로딩을N+1문제의 해결책처럼 사용하면 위험하다.
연관 데이터를 함께 써야 한다면 로딩 전략에만 기대지 말고, 조회 쿼리에서 함께 가져오도록 명확히 작성하는 것이 더 안전하다.
즉시 로딩은 연관 데이터를 바로 가져오려는 전략이지만, 목록 조회에서 항상 효율적인 방식은 아니다.
18-4. N+1 문제는 데이터가 많아질수록 크게 드러난다
N+1문제는 데이터가 적을 때는 크게 느껴지지 않을 수 있다.
회원이2명뿐이면 회원 조회1번과 팀 조회2번 정도라서 문제가 작아 보인다.
하지만 회원이100명이라면 회원 조회1번에 팀 조회가 최대100번 추가될 수 있다.
회원이1000명이라면 추가 조회도 훨씬 커질 수 있다.
문제는 코드만 보면 반복문 하나처럼 보인다는 점이다.// NPlusOneHiddenCostFlow.java for (MemberManyToOne member : members) { // 코드상으로는 단순 반복문 System.out.println(member.getTeam().getName()); // 내부적으로 추가 SQL이 반복될 수 있음 }코드는 짧지만, 내부에서는 연관 엔티티 조회가 반복될 수 있다.
그래서JPA를 사용할 때는 코드만 보지 말고 실제로 실행되는SQL로그도 함께 봐야 한다.
Hibernate로그를 보면 목록 조회 뒤에 비슷한select문이 여러 번 반복되는 상황을 확인할 수 있다.
이런 반복 조회가 보이면N+1문제가 아닌지 의심해야 한다.
N+1문제는 코드 길이보다 실제 실행되는SQL횟수로 확인해야 한다.
18-5. Fetch Join은 연관 Entity를 함께 조회하는 JPQL 문법이다
Fetch Join은JPQL에서 연관된 엔티티를 함께 조회하라고 지정하는 문법이다.
일반적인join은 조건이나 연결을 위해 사용한다.
반면fetch join은 연관된 엔티티를 실제 조회 결과와 함께 가져오는 데 목적이 있다.
회원 목록을 조회하면서 팀 정보도 함께 사용할 예정이라면 아래처럼 작성할 수 있다.// FetchJoinBasicFlow.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m join fetch m.team", MemberManyToOne.class ).getResultList(); // 회원과 팀을 함께 조회
join fetch m.team은 회원을 조회하면서 각 회원이 참조하는 팀도 함께 가져오겠다는 뜻이다.
이렇게 조회하면 반복문에서 팀 이름을 사용할 때 팀 조회가 계속 추가로 발생하는 상황을 줄일 수 있다.
// FetchJoinUseFlow.java for (MemberManyToOne member : members) { // 회원 목록 반복 System.out.println(member.getTeam().getName()); // 함께 조회된 팀 정보 사용 }이 흐름에서는 회원을 조회할 때 팀도 함께 준비된다.
따라서 반복문 안에서 팀을 사용할 때마다 추가 조회가 반복되는 문제를 줄일 수 있다.
Fetch Join은 연관 데이터를 실제로 함께 사용할 것이 확실할 때, 처음 조회 쿼리에서 함께 가져오는 방법이다.
18-6. 일반 Join과 Fetch Join은 목적이 다르다
join과fetch join은 모양이 비슷해서 헷갈리기 쉽다.
하지만 목적이 다르다.
일반join은 주로 조건을 걸거나 테이블 관계를 이용해 조회 범위를 정할 때 사용한다.
연관 엔티티를 영속성 컨텍스트에 함께 채워 두는 목적이 항상 있는 것은 아니다.
// NormalJoinFlow.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m join m.team t where t.name = :teamName", MemberManyToOne.class ) .setParameter("teamName", "개발팀") // 팀 이름 조건 .getResultList(); // 조건에 맞는 회원 조회이 쿼리는 팀 이름이
"개발팀"인 회원을 찾기 위해join을 사용한다.
핵심 목적은 조건 조회이다.
반면fetch join은 연관 엔티티를 함께 가져오는 목적이 강하다.// FetchJoinCompareFlow.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m join fetch m.team", MemberManyToOne.class ).getResultList(); // 회원과 팀을 함께 조회이 쿼리는 회원 목록을 조회하면서 팀 엔티티도 함께 가져온다.
그래서 이후member.getTeam()을 사용해도 추가 조회를 줄일 수 있다.
정리하면 아래와 같다.
- 일반
join: 조건이나 연결을 위해 사용한다.fetch join: 연관 엔티티를 함께 조회하기 위해 사용한다.
N+1문제를 줄이려면 단순join이 아니라 연관 엔티티를 함께 가져오는fetch join이 필요하다.
18-7. Fetch Join은 필요한 곳에만 사용해야 한다
Fetch Join은N+1문제를 줄이는 데 효과적이다.
하지만 모든 조회에 무조건 붙이면 좋은 것은 아니다.
연관 데이터를 함께 가져온다는 말은 한 번에 가져오는 데이터 양이 늘어날 수 있다는 뜻이다.
회원 이름만 필요한 화면인데 팀 정보까지 항상 함께 가져오면 오히려 불필요한 조회가 된다.
그래서fetch join은 연관 데이터가 실제로 필요한 조회에서 사용해야 한다.
예를 들어 회원 목록 화면에서 팀 이름도 함께 보여 준다면fetch join을 사용할 수 있다.
하지만 회원 번호와 이름만 보여 주는 화면이라면 팀까지 가져올 필요가 없을 수 있다.
좋은 기준은 아래와 같다.
- 연관 데이터가 화면이나 로직에서 바로 필요하면
fetch join을 고려한다.- 연관 데이터가 필요하지 않으면 기본 조회를 가볍게 유지한다.
- 목록 조회 후 반복문에서 연관 데이터를 계속 사용한다면
N+1여부를 확인한다.
Fetch Join은 성능 문제를 줄이는 도구이지만, 필요한 연관 데이터가 명확할 때 사용하는 것이 좋다.
18-8. LAZY를 기본으로 두고 필요한 조회에서 Fetch Join을 사용한다
연관관계는 기본적으로 지연 로딩을 고려하는 흐름이 안전하다.
지연 로딩은 연관 데이터를 처음부터 무조건 가져오지 않기 때문에 기본 조회를 가볍게 유지할 수 있다.
하지만 지연 로딩만으로 모든 문제가 해결되는 것은 아니다.
연관 데이터를 실제로 많이 사용할 조회에서는 추가 조회가 반복될 수 있다.
이때 필요한 조회에서fetch join을 사용한다.
예를 들어 회원 엔티티의 팀 관계는 지연 로딩으로 둔다.// LazyRelationBaseFlow.java @ManyToOne(fetch = FetchType.LAZY) // 팀은 기본적으로 실제 사용할 때 조회 @JoinColumn(name = "team_id") // 외래키 컬럼 지정 private TeamEntity team;그리고 팀 정보가 필요한 조회에서는
fetch join을 사용한다.// LazyAndFetchJoinFlow.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m join fetch m.team", MemberManyToOne.class ).getResultList(); // 필요한 조회에서 팀까지 함께 조회이렇게 하면 평소에는 연관 데이터를 불필요하게 가져오지 않는다.
하지만 특정 화면이나 기능에서 팀 정보가 필요하면 쿼리에서 함께 가져올 수 있다.
권장 흐름은 연관관계를 지연 로딩으로 두고, 연관 데이터가 필요한 조회에서Fetch Join으로 함께 가져오는 방식이다.
18-9. N+1과 Fetch Join 흐름을 코드로 한 번에 보기
지금까지 본 내용을 하나로 연결하면
N+1문제와Fetch Join의 차이가 보인다.
이 구간은 새로운 문법을 추가하는 부분이 아니라, 같은 회원 목록 조회라도 연관 데이터를 어떻게 가져오느냐에 따라SQL흐름이 달라질 수 있다는 점을 확인하는 마무리이다.
먼저N+1이 발생할 수 있는 흐름이다.// NPlusOneSummaryFlow.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m", MemberManyToOne.class ).getResultList(); // 회원 목록 조회 for (MemberManyToOne member : members) { // 회원 수만큼 반복 System.out.println(member.getTeam().getName()); // 팀 조회가 추가로 반복될 수 있음 }이 코드는 회원 목록을 먼저 조회한다.
그다음 반복문에서 각 회원의 팀 이름을 사용한다.
로딩 전략과 조회 상태에 따라 팀 조회가 회원 수만큼 추가될 수 있다.
이제 같은 상황을Fetch Join으로 바꾸면 아래와 같다.// FetchJoinSummaryFlow.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m join fetch m.team", MemberManyToOne.class ).getResultList(); // 회원과 팀을 함께 조회 for (MemberManyToOne member : members) { // 회원 목록 반복 System.out.println(member.getTeam().getName()); // 함께 조회된 팀 정보 사용 }두 코드 모두 반복문에서
member.getTeam().getName()을 사용한다.
하지만 두 번째 코드는 회원 목록을 조회할 때 팀도 함께 가져오도록 명시했다.
그래서 반복문 안에서 팀 조회가 계속 추가되는 상황을 줄일 수 있다.
같은 객체 탐색 코드라도, 처음 조회 쿼리를 어떻게 작성했는지에 따라 실제SQL실행 횟수가 달라질 수 있다.
18-10. N+1 문제와 Fetch Join 핵심 정리
N+1문제와Fetch Join은 로딩 전략을 실제 성능과 연결해서 이해하는 핵심 개념이다.
지연 로딩과 즉시 로딩을 단순히 “늦게 가져온다”, “빨리 가져온다”로만 외우면 부족하다.
목록 조회에서 연관 데이터를 어떻게 사용하는지까지 함께 봐야 한다.
정리하면 아래와 같다.
N+1은 목록 조회1번 뒤에 연관 엔티티 조회가N번 추가될 수 있는 문제이다.- 지연 로딩은 연관 데이터 조회 시점을 미루지만, 반복 사용하면 추가 조회가 발생할 수 있다.
- 즉시 로딩도 목록 조회에서 항상 한 번의
SQL로 해결되는 것은 아니다.Fetch Join은 필요한 연관 엔티티를 처음 조회 쿼리에서 함께 가져오는 방법이다.- 모든 조회에
Fetch Join을 붙이는 것이 아니라, 연관 데이터가 실제로 필요한 조회에 사용해야 한다.- 기본은 지연 로딩으로 두고, 필요한 조회에서
Fetch Join을 사용하는 흐름이 안전하다.마지막으로 전체 기준을 짧게 정리하면 이렇다.
N+1문제는 연관 엔티티를 반복 조회하면서 발생하고,Fetch Join은 필요한 연관 엔티티를 한 번에 함께 조회해서 이 문제를 줄이는 방법이다.
이 흐름을 이해하면 연관관계가 있는 목록 조회를 작성할 때 실제SQL실행 횟수를 더 쉽게 예측할 수 있다.
19. 응용예제로 넘어가기 전 JPA 전체 흐름 정리하기
JPA기본 개념은 각각 따로 외우는 내용이 아니다.
ORM,Entity,EntityManager, 영속성 컨텍스트,Transaction,JPQL, 연관관계, 로딩 전략은 모두 하나의 실행 흐름 안에서 연결된다.
응용예제를 볼 때는 코드가 어떤 문법을 썼는지만 보면 부족하다.
이 코드가 객체를 만드는 단계인지, 영속성 컨텍스트에 등록하는 단계인지,SQL실행으로 이어지는 단계인지 같이 봐야 한다.
응용예제를 이해하려면JPA가 객체를 중심으로 코드를 작성하게 하고, 내부에서는 매핑 정보와 영속성 컨텍스트를 바탕으로SQL을 실행한다는 흐름을 먼저 잡아야 한다.
19-1. JPA는 객체와 테이블을 연결해서 데이터베이스 작업을 처리한다
JPA는Java객체와 데이터베이스 테이블을 연결해서 다루는 기술이다.
Java에서는 데이터를 객체로 다루고, 데이터베이스에서는 데이터를 테이블과 행으로 저장한다.
두 구조가 다르기 때문에 서로 맞춰 주는 과정이 필요하다.
이 연결 방식을ORM이라고 한다.
ORM은Object Relational Mapping의 줄임말이고, 객체와 관계형 데이터베이스를 매핑하는 방식이다.
JPA는Java에서ORM을 사용하기 위한 표준 규칙이다.
Hibernate는 그 표준을 실제로 실행하는 구현체이다.
아래 흐름은JPA가 객체 중심 코드에서 데이터베이스 작업으로 이어지는 기본 구조를 보여 준다.
아래 코드는 실제 전체 실행 코드가 아니라, 객체를 만들고JPA에게 저장을 요청한다는 사고 흐름을 보여 주는 예시이다.
실제 저장 작업은Transaction안에서 처리해야 한다.// JpaObjectToTableFlow.java MemberDirect member = new MemberDirect(1L, "홍길동"); // 저장할 Entity 객체 생성 entityManager.persist(member); // JPA에게 저장 요청이 코드는
insert SQL을 직접 작성하지 않는다.
대신 저장할Entity객체를 만들고,persist()로 저장을 요청한다.
그렇다고SQL이 사라지는 것은 아니다.
Hibernate가Entity의 매핑 정보를 확인하고, 필요한insert SQL을 만들어 데이터베이스에 전달할 수 있다.
JPA는SQL을 없애는 기술이 아니라, 객체와 매핑 정보를 바탕으로 필요한SQL을 대신 만들어 주는 기술이다.
19-2. Entity는 JPA가 관리하는 테이블 매핑 클래스이다
Entity는 데이터베이스 테이블과 연결되는Java클래스이다.
Entity클래스의 필드는 테이블의 컬럼과 연결될 수 있고,Entity객체 하나는 테이블의 한 행과 대응될 수 있다.
JPA가 클래스를Entity로 인식하려면@Entity가 필요하다.
또 어떤 필드가 기본키인지 알려 주기 위해@Id도 필요하다.
기본키는 테이블에서 각 행을 구분하는 값이다.
// EntityBasicMappingSummary.java import jakarta.persistence.Entity; import jakarta.persistence.Id; import jakarta.persistence.Table; @Entity // JPA가 관리할 Entity 클래스 @Table(name = "member_direct") // 연결할 테이블 이름 지정 public class MemberDirect { @Id // 기본키 필드 private Long id; private String name; // 회원 이름 }
@Entity는 이 클래스가JPA의 관리 대상이라는 표시이다.
@Table(name = "member_direct")는 이Entity가member_direct테이블과 연결된다는 뜻이다.
@Id는JPA가 객체를 구분할 때 사용할 기본키 필드를 알려 준다.
응용예제에서 새로운 클래스가 나오면 가장 먼저 봐야 할 것은 이 클래스가Entity인지이다.
그다음 어떤 테이블과 연결되는지, 기본키가 무엇인지, 필드가 어떤 컬럼과 연결되는지 확인해야 한다.
Entity를 읽을 때는 클래스 이름, 테이블 이름, 기본키 필드, 일반 필드 매핑을 먼저 확인해야 한다.
19-3. EntityManager는 영속성 컨텍스트를 통해 Entity를 관리한다
EntityManager는Entity를 실제로 저장, 조회, 수정, 삭제하는 객체이다.
하지만EntityManager가 직접 데이터베이스만 바라보는 것은 아니다.
중간에 영속성 컨텍스트라는 관리 공간을 사용한다.
영속성 컨텍스트는EntityManager가Entity객체를 보관하고 관리하는 공간이다.
이 공간이 있기 때문에1차 캐시, 동일성 보장, 쓰기 지연, 변경 감지 같은 기능이 가능하다.
아래 흐름은EntityManager가Entity를 관리하는 기본 구조이다.// EntityManagerPersistenceContextSummary.java EntityManagerFactory factory = Persistence.createEntityManagerFactory("entitytest"); // 설정 묶음으로 Factory 생성 EntityManager entityManager = factory.createEntityManager(); // EntityManager 생성 MemberDirect member = entityManager.find(MemberDirect.class, 1L); // 기본키로 Entity 조회
EntityManagerFactory는EntityManager를 만드는 공장 역할이다.
EntityManager는 실제 작업 객체이다.
find()를 호출하면JPA는 먼저 영속성 컨텍스트의1차 캐시를 확인한다.
거기에 없으면 데이터베이스에서 조회하고, 조회한 결과를Entity객체로 만들어 영속성 컨텍스트에 저장할 수 있다.
같은EntityManager안에서 같은 기본키로 다시 조회하면 같은 객체가 반환될 수 있다.
이것을 동일성 보장이라고 한다.
EntityManager를 이해할 때는 항상 영속성 컨텍스트를 함께 떠올려야 한다.
19-4. 저장, 수정, 삭제는 Transaction 안에서 처리한다
Transaction은 데이터베이스 변경 작업을 하나의 작업 단위로 묶는 기능이다.
저장, 수정, 삭제는 데이터베이스 상태를 바꾸는 작업이다.
그래서Transaction안에서 처리해야 한다.
정상적으로 끝나면commit()으로 확정한다.
중간에 오류가 나면rollback()으로 되돌린다.
아래 코드는 저장 작업의 기본 흐름이다.// TransactionCrudSummary.java EntityTransaction transaction = entityManager.getTransaction(); // Transaction 가져오기 try { transaction.begin(); // Transaction 시작 MemberDirect member = new MemberDirect(2L, "저장회원"); // 저장할 Entity 생성 entityManager.persist(member); // 영속성 컨텍스트에 저장 대상으로 등록 transaction.commit(); // flush 후 저장 확정 } catch (Exception e) { if (transaction.isActive()) { // Transaction이 진행 중인지 확인 transaction.rollback(); // 오류 발생 시 되돌리기 } }
persist()는 비영속 상태의Entity를 영속성 컨텍스트에 등록한다.
그 후commit()과정에서flush가 일어나면 저장에 필요한insert SQL이 데이터베이스로 전달될 수 있다.
수정은 별도의update()메서드를 호출하는 방식이 아니다.
영속 상태의Entity값을 변경하면,JPA가 변경 감지를 통해UPDATE SQL을 만들 수 있다.
아래 흐름은MemberDirect안에 이름을 바꾸는changeName()메서드가 추가되어 있다고 가정한다.// DirtyCheckingSummary.java transaction.begin(); // Transaction 시작 MemberDirect member = entityManager.find(MemberDirect.class, 2L); // 영속 상태 Entity 조회 if (member != null) { // 조회 결과가 있을 때 member.changeName("수정회원"); // 영속 상태 Entity 값 변경 } transaction.commit(); // 변경 감지 후 수정 확정이 코드에는
entityManager.update(member)가 없다.
member가 영속성 컨텍스트의 관리 대상이기 때문에 값 변경을 감지할 수 있다.
삭제는remove()로 삭제 대상으로 등록한다.
조회 결과가 있을 때만 삭제 요청을 하는 흐름이 안전하다.// RemoveSummary.java transaction.begin(); // Transaction 시작 MemberDirect member = entityManager.find(MemberDirect.class, 2L); // 삭제 대상 조회 if (member != null) { // 조회 결과가 있을 때 entityManager.remove(member); // 삭제 대상으로 등록 } transaction.commit(); // flush 후 삭제 확정저장, 수정, 삭제는 모두 영속성 컨텍스트와
Transaction흐름 안에서 이해해야 한다.
19-5. 기본키 조회는 find, 조건 조회는 JPQL을 사용한다
기본키로 한 건을 조회할 때는
find()를 사용한다.
find()는 조회할Entity클래스와 기본키 값을 전달한다.
// FindAndJpqlDecisionFlow.java MemberDirect member = entityManager.find(MemberDirect.class, 1L); // 기본키 1L로 Entity 조회이 코드는 기본키를 정확히 알고 있을 때 적합하다.
하지만 이름으로 검색하거나, 목록을 정렬하거나, 특정 필드만 조회하거나, 페이징을 처리하려면find()만으로는 부족하다.
이때JPQL을 사용한다.
JPQL은 테이블이 아니라Entity를 대상으로 작성하는 객체 지향 쿼리 언어이다.
// JpqlConditionSummary.java String jpql = "select m from MemberDirect m where m.name = :name"; // Entity와 필드 기준 JPQL List<MemberDirect> members = entityManager.createQuery(jpql, MemberDirect.class) .setParameter("name", "홍길동") // name 파라미터에 값 연결 .getResultList(); // 결과 목록 조회
MemberDirect는 테이블 이름이 아니라Entity이름이다.
m.name은 컬럼 이름이 아니라Entity의 필드 이름이다.
:name은 나중에 값을 넣을 파라미터 자리이다.
JPQL결과는select절에 무엇을 적는지에 따라 달라진다.
select m은Entity전체를 조회한다.
select m.name은 단일 필드 값을 조회한다.
select new ...는DTO객체로 조회할 수 있다.
기본키 하나로 찾으면find(), 조건이나 목록 조회가 필요하면JPQL을 사용한다고 흐름을 잡으면 된다.
19-6. 연관관계는 객체 참조와 외래키를 연결한다
객체는 참조로 관계를 맺는다.
테이블은 외래키로 관계를 맺는다.
JPA의 연관관계 매핑은 이 둘을 연결한다.
예를 들어 회원과 팀 관계를 생각해 보자.
객체에서는 회원이 팀 객체를 참조한다.
데이터베이스에서는 회원 테이블의team_id외래키가 팀 테이블의 기본키를 참조한다.
// RelationMappingSummary.java @ManyToOne(fetch = FetchType.LAZY) // 여러 회원이 하나의 팀과 연결 @JoinColumn(name = "team_id") // member 테이블의 team_id 외래키와 연결 private TeamEntity team; // 팀 객체 참조
@ManyToOne은 여러 회원이 하나의 팀과 연결된다는 뜻이다.
@JoinColumn(name = "team_id")은 이 관계를 저장할 외래키 컬럼이team_id라는 뜻이다.
객체 코드에서는member.getTeam()처럼 연결된 객체로 이동한다.
데이터베이스 코드처럼team_id값을 직접 꺼내서 팀을 찾는 흐름이 아니다.
양방향 관계에서는 연관관계의 주인을 구분해야 한다.
주인은 더 중요한 객체라는 뜻이 아니다.
외래키 값을 실제로 관리하는 쪽을 의미한다.
연관관계 매핑의 핵심은 객체 참조와 테이블 외래키를 어떻게 연결할지 정하는 것이다.
19-7. 로딩 전략은 연관 Entity 조회 시점을 정한다
연관관계를 매핑하면 다음으로 생각해야 할 것이 로딩 전략이다.
로딩 전략은 연관된Entity를 언제 조회할지 정하는 기준이다.
대표적인 로딩 전략은 두 가지이다.
FetchType.LAZY: 지연 로딩이다.FetchType.EAGER: 즉시 로딩이다.지연 로딩은 연관된 데이터를 실제 사용할 때 조회한다.
즉시 로딩은 주 엔티티를 조회할 때 연관된 엔티티도 바로 함께 조회하려고 한다.
// LoadingStrategySummary.java @ManyToOne(fetch = FetchType.LAZY) // 팀은 실제 사용할 때 조회 @JoinColumn(name = "team_id") // 외래키 컬럼 지정 private TeamEntity team;지연 로딩에서는 연관 객체 자리에 프록시가 들어올 수 있다.
프록시는 실제 객체를 대신해서 서 있다가, 실제 값이 필요할 때 조회를 진행하는 대리 객체이다.
로딩 전략은 성능과 연결된다.
목록을 조회한 뒤 반복문에서 연관 엔티티를 계속 사용하면 추가 조회가 여러 번 발생할 수 있다.
이것이N+1문제로 이어질 수 있다.
필요한 연관 데이터를 처음 조회에서 함께 가져오고 싶다면Fetch Join을 사용할 수 있다.// FetchJoinSummary.java List<MemberManyToOne> members = entityManager.createQuery( "select m from MemberManyToOne m join fetch m.team", MemberManyToOne.class ).getResultList(); // 회원과 팀을 함께 조회
join fetch m.team은 회원을 조회하면서 팀도 함께 가져오겠다는 뜻이다.
회원 목록에서 팀 이름을 바로 사용할 것이 확실하다면 추가 조회를 줄이는 데 도움이 된다.
연관관계는 기본적으로 지연 로딩을 고려하고, 실제로 함께 필요한 데이터는Fetch Join으로 명확히 조회하는 흐름이 안전하다.
19-8. 응용예제를 볼 때 확인해야 할 순서
응용예제를 볼 때는 코드를 위에서 아래로만 읽으면 헷갈릴 수 있다.
먼저 어떤JPA개념을 확인하는 예제인지 잡고, 그다음 실행 흐름을 따라가야 한다.
확인 순서는 아래처럼 잡으면 좋다.
- 이 클래스가
Entity인지 먼저 확인한다.- 어떤 테이블과 매핑되는지 확인한다.
- 기본키 필드가 무엇인지 확인한다.
EntityManagerFactory와EntityManager가 어떻게 만들어지는지 확인한다.- 저장, 수정, 삭제라면
Transaction안에 있는지 확인한다.persist(),find(),remove(),flush(),commit()중 어떤 메서드가 핵심인지 확인한다.JPQL이라면 테이블 이름이 아니라Entity이름을 쓰는지 확인한다.- 연관관계가 있다면 객체 참조와 외래키가 어떻게 연결되는지 확인한다.
- 목록 조회에서 연관 데이터를 반복 사용한다면
N+1문제가 생길 수 있는지 확인한다.이 순서로 보면 응용예제의 코드가 단순히 길어 보이지 않는다.
각 줄이 어떤 개념과 연결되는지 보이기 시작한다.
예를 들어 아래 코드는 짧지만 여러 개념이 함께 들어 있다.// ApplicationExampleReadingFlow.java transaction.begin(); // Transaction 시작 MemberManyToOne member = entityManager.find(MemberManyToOne.class, 1L); // 기본키로 회원 조회 if (member != null) { // 조회 결과가 있을 때 System.out.println(member.getTeam().getName()); // 연관된 팀 정보 사용 } transaction.commit(); // Transaction 확정이 코드는
find()로 회원을 조회한다.
그리고member.getTeam()으로 연관된 팀 객체에 접근한다.
만약 팀 관계가 지연 로딩이라면 팀 이름을 실제 사용할 때 추가 조회가 발생할 수 있다.
따라서 이 예제를 볼 때는 단순히 출력 코드라고 보면 부족하다.
기본키 조회, 영속 상태, 연관관계, 로딩 전략을 함께 봐야 한다.
19-9. 응용예제를 보기 전에 반드시 잡아야 할 핵심 정리
응용예제로 넘어가기 전에 반드시 잡아야 할 핵심은 아래와 같다.
첫째,JPA는 객체와 테이블을 매핑한다.
Entity는 테이블과 연결되는 클래스이고,Entity객체는 테이블의 한 행과 대응될 수 있다.
둘째,JPA는SQL을 없애는 기술이 아니다.
개발자가 객체 중심으로 코드를 작성하면,Hibernate가 매핑 정보를 바탕으로 필요한SQL을 만들어 실행한다.
셋째,EntityManager는 영속성 컨텍스트를 통해Entity를 관리한다.
영속성 컨텍스트는1차 캐시, 동일성 보장, 쓰기 지연, 변경 감지 기능을 제공한다.
넷째, 저장, 수정, 삭제는Transaction안에서 처리해야 한다.
성공하면commit()으로 확정하고, 실패하면rollback()으로 되돌린다.
다섯째, 수정은 별도의update()메서드를 호출하는 방식이 아니다.
영속 상태의Entity값을 변경하면Dirty Checking으로 변경을 감지할 수 있다.
여섯째, 기본키 조회는find()를 사용하고, 조건 조회나 목록 조회는JPQL을 사용한다.
JPQL은 테이블이 아니라Entity를 대상으로 작성한다.
일곱째, 연관관계 매핑은 객체 참조와 테이블 외래키를 연결한다.
다대일 관계에서는 보통 외래키를 가진 다 쪽 엔티티가 연관관계의 주인이 된다.
여덟째, 로딩 전략은 성능과 연결된다.
지연 로딩과 즉시 로딩의 차이를 알아야N+1문제를 이해할 수 있고, 필요한 경우Fetch Join으로 연관 엔티티를 함께 조회할 수 있다.
마지막으로 전체 흐름을 한 줄로 정리하면 이렇다.
JPA는Entity를 중심으로 객체 상태를 관리하고, 영속성 컨텍스트와 매핑 정보를 바탕으로 데이터베이스 작업을 실행하는 기술이다.
이 흐름을 잡은 상태에서 응용예제를 보면, 제공 코드가 단순히 실행되는 코드가 아니라 어떤JPA개념을 확인하는 예제인지 분명하게 보인다.