스프링과 스프링 부트의 큰 그림
Spring을 처음 볼 때 가장 먼저 잡아야 하는 것은 복잡한 문법이 아니다.
왜 이런 프레임워크가 필요한지, 그리고 왜Spring Boot가 따로 나왔는지를 먼저 이해해야 한다.
그래야 뒤에서 배우는IoC,DI,AOP,MVC도 각각 따로 떨어진 개념이 아니라 하나의 흐름으로 이어서 볼 수 있다.
자바만으로도 프로그램은 만들 수 있다.
하지만 프로그램이 커지면 필요한 객체를 직접 만들고 연결하는 코드가 많아지고, 웹 요청을 처리하는 흐름도 복잡해지고,로깅, 보안, 트랜잭션처럼 여러 곳에서 반복되는 기능도 코드 곳곳에 섞이기 쉽다.
이렇게 되면 한 곳을 고칠 때 다른 곳도 같이 건드려야 하는 일이 많아지고, 코드끼리 강하게 묶여서 관리가 어려워진다.
Spring은 이런 복잡함을 정해진 구조 안에서 정리하게 해 주는 프레임워크라고 이해하면 된다.
먼저 잡아야 할 질문은 세 가지이다.
객체를 누가 만들고 관리하는가, 웹 요청을 어떤 흐름으로 처리하는가, 반복되는 공통 기능을 어떻게 분리하는가이다.
뒤에서 배우는 핵심 개념들은 결국 이 세 가지 질문에 대한 답이다.
스프링이 해결하려는 문제
왜 일반 자바 코드만으로는 점점 복잡해지는가
프로그램이 아주 작을 때는 필요한 객체를
new로 직접 만들고 메서드를 호출해도 큰 문제가 없다.
하지만 기능이 많아지면 어떤 객체가 어떤 객체를 필요로 하는지 관계가 점점 복잡해진다.
한 클래스를 고치면 그 클래스를 사용하던 다른 클래스도 함께 수정해야 하는 일이 자주 생긴다.
웹 프로그램에서는 더 복잡해진다.
브라우저에서 요청이 들어오고, 서버가 그것을 처리하고, 결과를 다시 응답으로 보내는 흐름이 일정한 규칙 없이 흩어지기 쉽다.
여기에로깅, 보안, 트랜잭션 같은 공통 기능까지 섞이면 핵심 기능과 부가 기능의 경계도 흐려진다.
즉, 문제는 단순히 코드가 길어진다는 것이 아니라 역할이 섞이고, 연결이 복잡해지고, 중복이 늘어난다는 데 있다.
Spring은 무엇을 정리해 주는가
- 객체를 누가 만들고 관리할지 정리해 준다.
- 웹 요청이 어디로 들어가고 어떻게 처리될지 구조를 잡아 준다.
- 여러 곳에서 반복되는 공통 기능을 따로 분리하게 도와준다.
이 세 가지가 뒤에서 배우는
IoC,DI,AOP,MVC로 이어진다.
즉, 각각의 개념이 따로 존재하는 것이 아니라 모두 복잡한 프로그램을 역할별로 나누어 정리하려는 흐름 안에 들어 있다.
그래서 이 큰 그림을 먼저 이해하면 뒤의 세부 개념도 훨씬 덜 낯설다.
Spring,Spring Framework,Spring Boot는 같은 말이 아니다처음 배우는 단계에서는 이 세 단어가 자주 섞여 보여서 헷갈리기 쉽다.
하지만 완전히 같은 뜻으로 보면 안 된다.
먼저Spring은 큰 생태계 이름에 가깝다.
즉,Spring Framework,Spring Boot,Spring Data,Spring Security처럼 여러 프로젝트를 아우르는 넓은 이름으로 볼 수 있다.
그중Spring Framework는 핵심 구조를 제공하는 중심 도구이다.
객체를 관리하고, 웹 요청을 처리하고, 공통 기능을 분리하는 기본 뼈대가 여기에 들어 있다.
즉, 우리가IoC,DI,AOP,MVC를 배울 때 실제로 중심이 되는 것은Spring Framework이다.
그리고Spring Boot는 그Spring Framework를 더 쉽게 시작하고 실행하게 해 주는 도구이다.
즉,Spring Boot는Spring을 대신하는 완전히 다른 프레임워크가 아니라, 기존Spring구조를 더 편하게 쓰게 해 주는 도구이다.
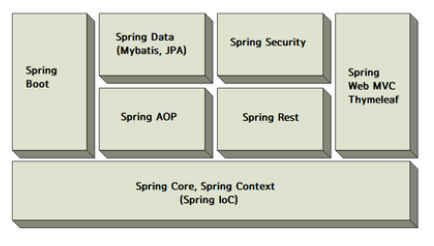
스프링 프레임워크의 모듈 구성
스프링은 하나의 기능이 아니라 역할별 모듈 구조이다
Spring은 하나의 단일 기능이 아니라 여러 모듈이 역할별로 나뉜 구조이다.
그래서 처음에는 모듈 이름을 모두 외우려 하기보다, 어떤 역할을 맡는 묶음들이 있는지만 보는 편이 훨씬 좋다.
이 단계에서 중요한 것은 이름 암기가 아니라,Spring이 한 덩어리 도구가 아니라는 점을 이해하는 것이다.
Spring Core,Spring Context를 바닥으로 두고, 그 위에 웹 처리, 보안,AOP, 데이터 접근 같은 기능이 역할별로 나뉘어 올라가는 구조를 보여 준다.
즉,Spring은 하나의 거대한 기능이 아니라 필요한 역할을 층층이 나누어 둔 구조이다.
초보자 기준에서 각 모듈은 이렇게 이해하면 된다
Spring Core,Spring Context는 객체 관리의 중심 바닥이다.Spring Web MVC는 웹 요청과 응답 흐름을 처리하는 구조이다.Spring AOP는 공통 기능을 분리하는 구조와 연결된다.- 데이터 접근 관련 기술은 데이터베이스를 더 편하게 다루는 데 연결된다.
Spring Security는 인증과 권한 같은 보안 처리와 연결된다.여기서는 세부 구현을 다 아는 것이 목적이 아니다.
처음에는 이름을 외우려 하지 말고, 객체 관리, 웹 처리, 보안, 데이터 접근, 공통 기능 분리처럼 역할만 잡아도 충분하다.
즉, 스프링은 역할별 기능이 나뉜 구조이고, 그 중심에는 객체 관리와 웹 처리 구조가 있다.
이렇게 보면 스프링이 왜 기능이 많아 보이는지도 자연스럽게 이해된다.
스프링 부트가 필요한 이유
Spring이 좋은데도Spring Boot가 따로 필요한 이유
Spring Framework는 이미 객체 관리, 웹 처리,AOP같은 강력한 구조를 제공한다.
하지만 기능이 많은 만큼 프로젝트를 처음 시작할 때 준비해야 할 설정도 많아진다.
라이브러리 버전을 맞추고, 실행 환경을 잡고, 서버와 관련된 설정을 준비하는 과정이 초보자에게는 꽤 부담이 된다.
처음 배우는 입장에서는 여기서 막히기 쉽다.
분명 구조는 좋은데, 막상 프로젝트를 시작하려고 하면 설정 파일이 많고 준비할 것이 많아서 진입 장벽이 높게 느껴진다.
즉, 문제는Spring이 나빠서가 아니라 좋은 구조를 쓰기까지의 준비 과정이 꽤 무겁다는 데 있다.
기존
Spring에 무엇이 더해지는가
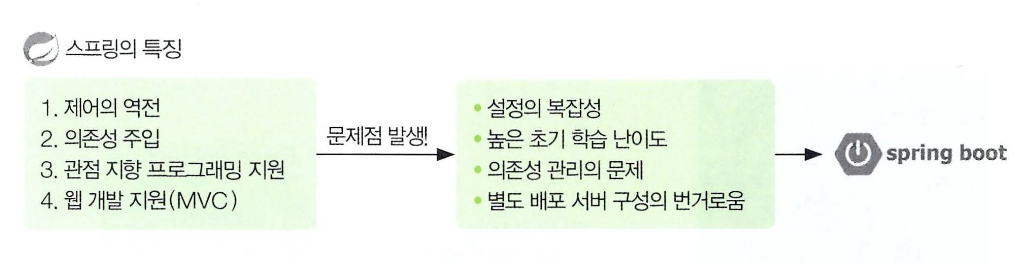
Spring은IoC,DI,AOP,MVC같은 강력한 구조를 제공했지만, 설정 복잡성, 높은 초기 학습 난이도, 의존성 관리, 별도 배포 서버 구성 같은 불편도 함께 있었다.
즉,Spring Boot는Spring의 핵심 구조를 버린 것이 아니라, 이런 불편을 줄여 더 쉽게 시작하고 실행하게 만든 도구이다.
처음Spring만 볼 때는 기능이 많고 강력하다는 점이 먼저 보인다.
하지만 실제 프로젝트를 시작하려고 하면 설정할 것이 많고, 라이브러리 버전을 맞추는 일도 쉽지 않다.
여기에 실행을 위한 서버 환경까지 따로 준비해야 하면 초보자 입장에서는 진입 장벽이 더 높아진다.
Spring Boot는 바로 이 시작 단계의 부담을 줄여 주기 위해 나온 것이다.
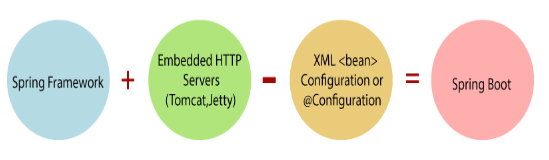
Spring Framework에Tomcat,Jetty같은 실행 환경이 더해지고, 기존XML설정이나@Configuration부담이 줄어들어Spring Boot로 이어지는 흐름을 보여 준다.
즉, 복잡한 준비 과정을 줄이고 애플리케이션을 더 빨리 실행할 수 있게 해 주는 방향으로 이해하면 된다.
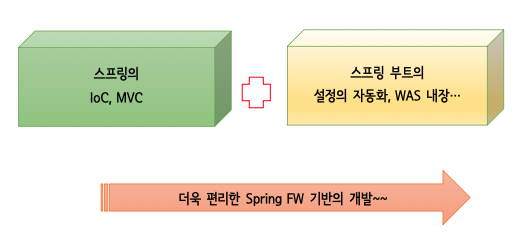
Spring의IoC,MVC구조에Spring Boot의 설정 자동화와 내장WAS가 더해져 더 편리한 개발 환경이 되는 흐름을 보여 준다.
즉,Spring Boot는 기존 구조를 버리는 것이 아니라, 기존 구조를 더 쉽게 쓰게 만드는 도구이다.
준비를 쉽게 해 주는 기능
starter를 통해 필요한 라이브러리 묶음을 한 번에 가져오기 쉽다.- 자동 설정을 통해 기본 실행 환경을 빠르게 준비할 수 있다.
여기서
starter는 중요하다.
처음에는 이 말도 낯설 수 있다.
쉽게 말하면 자주 같이 쓰는 라이브러리들을 미리 묶어 둔 꾸러미에 가깝다.
예를 들어 웹 개발에 필요한 것들을 하나하나 직접 고르지 않고, 필요한 묶음을 한 번에 가져올 수 있게 도와준다.
그래서 준비 단계에서 실수할 수 있는 부분을 줄여 준다.
자동 설정도 같은 맥락이다.
처음부터 모든 설정을 개발자가 일일이 적는 대신, 많이 쓰는 기본값을 먼저 준비해 주기 때문에 시작이 훨씬 가벼워진다.
즉, 초보자는 처음부터 복잡한 설정과 싸우기보다 기본 흐름을 먼저 익히는 데 더 집중할 수 있다.
실행과 배포를 쉽게 해 주는 기능
- 내장
WAS가 있어서 서버를 따로 크게 준비하지 않아도 바로 실행해 보기 쉽다.- 독립 실행 가능한
Jar형태로 빌드하기 쉬워 배포가 편하다.여기서
WAS는 웹 애플리케이션 서버, 즉 웹 요청을 받아 자바 웹 프로그램을 실행해 주는 서버 프로그램이다.
기존에는 이런 서버 환경을 따로 준비해야 하는 경우가 많았다.
하지만Spring Boot는 실행에 필요한 서버 환경을 프로젝트 안에 함께 두는 방식이라서, 초보자도 비교적 쉽게 실행해 볼 수 있다.
이 부분은 준비 단계와 다르다.
준비 단계가 프로젝트 시작을 쉽게 해 주는 쪽이라면, 이 부분은 실행과 배포를 더 간단하게 만드는 쪽이다.
그래서Spring Boot를 배우면 처음 만드는 것도 편하고, 실행해 보는 것도 훨씬 쉬워진다.
여기서 먼저 정리해야 할 핵심
Spring과Spring Boot를 어떻게 구분해서 이해하면 되는가
Spring은 여러 프로젝트를 아우르는 큰 생태계 이름으로 볼 수 있다.Spring Framework는 객체 관리와 웹 처리 구조를 잡아 주는 중심 프레임워크이다.Spring Boot는 그 구조를 더 쉽게 시작하고 실행하게 해 주는 도구이다.이 구분이 선명해야 뒤에서
IoC,DI,AOP,MVC를 볼 때 헷갈리지 않는다.
Spring Boot를 별개의 완전히 다른 기술로 보면 흐름이 끊기고, 반대로 둘을 완전히 같은 것으로 보면 왜Boot가 필요한지도 흐려진다.
그래서 이 단계에서는 구조의 중심은Spring Framework, 시작과 실행의 편의는Spring Boot라고 이해하면 가장 안정적이다.
이제 큰 그림은 잡혔다.
다음부터는 이 구조가 실제로 코드 안에서 어떻게 동작하는지를IoC,DI,AOP로 나누어 보면 된다.
스프링의 핵심 동작 원리
Spring을 제대로 이해하려면 컨트롤러 문법보다 먼저 내부 동작 원리를 잡아야 한다.
여기서 가장 중요한 질문은 세 가지이다.
필요한 객체를 어떻게 연결하는가, 그 연결을 누가 관리하는가, 여러 곳에서 반복되는 공통 기능을 어떻게 분리하는가이다.
이 질문이 각각DI,IoC,AOP로 이어진다.
초보자 입장에서는 이 부분이 가장 어렵게 느껴질 수 있다.
하지만 반대로 이 부분만 이해하면 뒤의 어노테이션,MVC, 실습 코드가 훨씬 자연스럽게 읽힌다.
즉, 지금 보는 내용은 외워야 하는 이론이 아니라, 왜Spring코드가 그런 모양으로 작성되는지 설명해 주는 핵심 구조이다.
의존성 주입
의존성이란 무엇인가
의존성은 어떤 객체가 다른 객체를 필요로 하는 관계를 말한다.
즉, 혼자서 일을 다 하지 못하고 다른 객체의 도움을 받아야 하는 상태이다.
예를 들어 커피를 만드는 객체가 커피 머신 없이 동작할 수 없다면, 커피를 만드는 객체는 커피 머신에 의존한다고 말한다.
이 개념을 먼저 이해해야 하는 이유는Spring이 결국 객체와 객체의 연결을 다루는 프레임워크이기 때문이다.
즉, 어떤 객체가 무엇을 필요로 하는지 알아야 그다음에 왜 외부에서 넣어 주는 방식이 필요한지도 이해할 수 있다.
직접 만들면 왜 불편한가
처음에는 필요한 객체를 직접
new로 만들면 단순해 보인다.
하지만 이렇게 만들면 사용하는 쪽이 특정 구현 클래스에 강하게 묶이게 된다.
그러면 나중에 부품을 바꾸고 싶을 때 사용하는 코드도 함께 수정해야 한다.
쉽게 말하면 전구를 갈아 끼우는 수준이 아니라, 전구를 바꾸려는데 스위치 배선까지 다시 손봐야 하는 상태가 되는 것이다.
프로그램이 커질수록 이런 수정은 더 자주 일어나고, 수정 범위도 커진다.
그래서 객체를 직접 만드는 방식은 처음에는 쉬워 보여도 규모가 커지면 불편해진다.
커피 머신 예제로 보는 의존성
먼저 에스프레소를 추출하는 객체가 있다고 보자.
그리고 커피 메이커는 이 커피 머신을 사용해서 커피를 만든다고 가정한다.
아래 코드는 커피 메이커가 에스프레소 머신을 직접 만들어 쓰는 가장 단순한 형태이다.// EspressoMachine.java public class EspressoMachine { public String brew() { return "Brewing coffee with Espresso Machine"; // 에스프레소 추출 } }// CoffeeMaker.java public class CoffeeMaker { private EspressoMachine espressoMachine; // 필요한 객체 보관 public CoffeeMaker() { this.espressoMachine = new EspressoMachine(); // 직접 객체 생성 } public void makeCoffee() { System.out.println(espressoMachine.brew()); // 커피 머신 사용 } }// Main.java public class Main { public static void main(String[] args) { CoffeeMaker coffeeMaker = new CoffeeMaker(); // 커피 메이커 생성 coffeeMaker.makeCoffee(); // 커피 만들기 } }// 출력결과 // Brewing coffee with Espresso Machine이 구조에서는 커피 메이커가 에스프레소 머신을 직접 만들고 있다.
즉, 커피 메이커는 에스프레소 머신이라는 특정 구현에 강하게 묶여 있다.
처음에는 별문제 없어 보이지만, 나중에 다른 커피 머신으로 바꾸고 싶으면 커피 메이커 코드도 같이 수정해야 한다.
느슨한 결합이 왜 중요한가
이번에는 드립 커피 머신으로 바꾸고 싶다고 해 보자.
직접 생성 구조라면CoffeeMaker안에 들어 있는EspressoMachine관련 코드를 모두DripCoffeeMachine으로 바꿔야 한다.
말로만 보면 감이 잘 안 오기 때문에 코드로 비교해 보는 것이 좋다.
먼저 드립 커피 머신 클래스를 새로 만든다.// DripCoffeeMachine.java public class DripCoffeeMachine { public String brew() { return "Brewing coffee with Drip Coffee Machine"; // 드립 커피 추출 } }이제
CoffeeMaker가 드립 커피 머신을 사용하려면 아래처럼 바뀐다.// CoffeeMaker.java public class CoffeeMaker { private DripCoffeeMachine dripCoffeeMachine; // 드립 커피 머신으로 변경 public CoffeeMaker() { this.dripCoffeeMachine = new DripCoffeeMachine(); // 드립 커피 머신 직접 생성 } public void makeCoffee() { System.out.println(dripCoffeeMachine.brew()); // 드립 커피 머신 사용 } }겉으로 보면
EspressoMachine을DripCoffeeMachine으로 바꾼 것뿐이다.
하지만 중요한 점은 커피 머신을 바꾸기 위해CoffeeMaker코드도 같이 수정했다는 것이다.
CoffeeMaker는 원래 커피를 만드는 역할만 하면 된다.
그런데 지금은 어떤 커피 머신을 직접 만들지도 알고 있다.
그래서 커피 머신이라는 부품이 바뀌면, 그 부품을 사용하는CoffeeMaker코드도 함께 흔들린다.
이 상태를 강한 결합이라고 한다.
강한 결합은 한 클래스가 특정 구현 클래스에 직접 묶여 있어서, 구현 클래스가 바뀔 때 사용하는 쪽 코드도 함께 수정되는 상태이다.
반대로 사용하는 쪽은 역할만 알고, 실제 구현은 바깥에서 바꿔 끼울 수 있게 만들면 훨씬 유연해진다.
이 상태를 느슨한 결합이라고 한다.
강한 결합은 부품이 바뀌면 사용하는 쪽도 함께 흔들리는 상태이고, 느슨한 결합은 부품이 바뀌어도 사용하는 쪽의 수정이 적은 상태이다.
그래서Spring은 객체를 아예 없애는 것이 아니라, 객체 사이의 연결을 더 유연하게 만들려는 방향으로 움직인다.
외부에서 넣어 주는 것이 왜 DI인가
느슨한 결합을 만들려면 공통 역할을 먼저 잡아야 한다.
커피 머신이 무엇이든 결국 커피를 추출하는 기능은 같으므로interface로 역할을 먼저 정의할 수 있다.
그리고 커피 메이커는 특정 구현을 직접 만들지 않고, 바깥에서 전달받은 커피 머신을 사용하게 만들면 된다.
이렇게 필요한 객체를 직접 만들지 않고 외부에서 넣어 주는 방식이DI이다.// CoffeeMachine.java public interface CoffeeMachine { String brew(); // 커피 추출 기능 }// EspressoMachine.java public class EspressoMachine implements CoffeeMachine { @Override public String brew() { return "Brewing coffee with Espresso Machine"; // 에스프레소 추출 } }// DripCoffeeMachine.java public class DripCoffeeMachine implements CoffeeMachine { @Override public String brew() { return "Brewing coffee with Drip Coffee Machine"; // 드립 커피 추출 } }// CoffeeMaker.java public class CoffeeMaker { private CoffeeMachine coffeeMachine; // 역할 타입으로 보관 public void setCoffeeMachine(CoffeeMachine coffeeMachine) { this.coffeeMachine = coffeeMachine; // 외부에서 주입 } public void makeCoffee() { System.out.println(coffeeMachine.brew()); // 주입받은 객체 사용 } }// Main.java public class Main { public static void main(String[] args) { CoffeeMaker coffeeMaker = new CoffeeMaker(); // 커피 메이커 생성 coffeeMaker.setCoffeeMachine(new DripCoffeeMachine()); // 필요한 구현 주입 coffeeMaker.makeCoffee(); // 커피 만들기 } }// 출력결과 // Brewing coffee with Drip Coffee Machine이제 커피 메이커는 어떤 커피 머신을 직접 만들지 모른다.
그 대신 커피 머신 역할만 알고, 실제 구현은 바깥에서 전달받는다.
그래서 에스프레소 머신을 쓰든 드립 커피 머신을 쓰든 커피 메이커 코드를 크게 고칠 필요가 없어진다.
이 점이DI의 핵심이다.
즉,DI는 단순히 밖에서 넣어 준다는 문법 이야기가 아니다.
구현 변경이 생겨도 사용하는 쪽의 수정 범위를 줄이고, 객체 사이의 결합을 느슨하게 만드는 구조이다.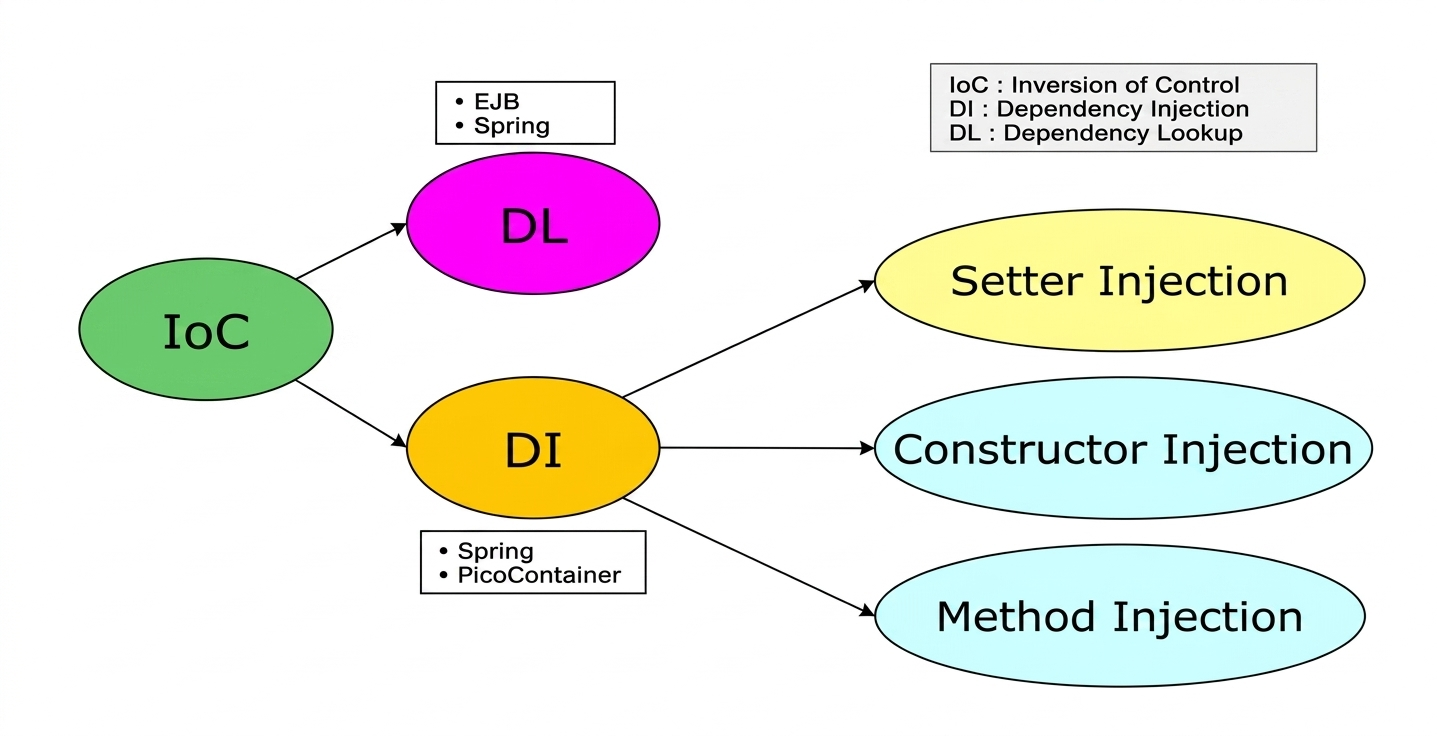
IoC,DI,DL관계와 여러 주입 방식을 함께 보여 준다.
여기서 가장 중요한 점은 실제 코드 작성에서 가장 자주 체감하는 방식이DI라는 것이다.
즉, 필요한 객체를 직접 만들지 않고 외부에서 받아 쓰는 흐름이 핵심이다.
생성자 주입, 필드 주입, 세터 주입
DI를 실제 코드에 적용하는 방식은 여러 가지가 있다.
가장 자주 보는 것은 생성자 주입, 필드 주입, 세터 주입이다.
- 생성자 주입은 객체가 만들어질 때 필요한 의존성을 함께 받는 방식이다.
- 필드 주입은 필드에 바로 의존성을 넣는 방식이다.
- 세터 주입은 메서드를 통해 나중에 의존성을 넣는 방식이다.
초보자 기준에서는 생성자 주입을 가장 기본으로 이해하면 된다.
객체가 만들어질 때 어떤 의존성이 꼭 필요한지가 가장 분명하게 드러나기 때문이다.
필드 주입은 코드가 짧아 보이지만 의존성이 겉으로 잘 드러나지 않을 수 있다.
세터 주입은 선택적으로 바꿔 넣을 수 있다는 장점이 있다.
즉, 이 세 방식은 문법 차이만 있는 것이 아니라 객체를 언제 어떤 방식으로 연결할지의 차이이다.
제어의 역전과 스프링 컨테이너
IoC란 무엇인가
IoC는Inversion of Control의 줄임말이다.
한국어로는 제어의 역전이라고 부른다.
이름은 어렵지만 뜻은 단순하다.
원래는 개발자가 직접 객체를 만들고 연결하고 호출하는 흐름을 다 쥐고 있었다.
그런데Spring에서는 그 제어권의 큰 부분을 프레임워크가 맡는다.
그래서 제어의 방향이 바뀌었다고 해서 제어의 역전이라고 부른다.
일반 자바 코드에서는 개발자가 직접 객체를 만들고 연결한다.// Main.java public class Main { public static void main(String[] args) { CoffeeMachine coffeeMachine = new DripCoffeeMachine(); // 개발자가 직접 생성 CoffeeMaker coffeeMaker = new CoffeeMaker(); // 개발자가 직접 생성 coffeeMaker.setCoffeeMachine(coffeeMachine); // 개발자가 직접 연결 coffeeMaker.makeCoffee(); // 커피 만들기 } }// 출력결과 // Brewing coffee with Drip Coffee Machine이 구조에서는 객체를 만들고 연결하는 코드가 전부 개발자 코드 안에 있다.
반면Spring에서는 스프링 컨테이너가 객체를 만들고, 필요한 객체끼리 연결해 준다.
DI가 필요한 객체를 외부에서 넣어 주는 방식이라면,IoC는 그 객체 생성과 연결 흐름을 스프링이 더 중심적으로 관리하는 큰 구조라고 보면 된다.
즉, 초보자 기준에서는DI는 연결 방식이고,IoC는 그 연결을 포함해 객체 관리의 제어권이 스프링 쪽으로 넘어간 구조라고 이해하면 된다.
Bean과 스프링 컨테이너
Bean은 스프링이 관리하는 자바 객체이다.
완전히 특별한 다른 객체라고 보면 오해하기 쉽다.
그냥 자바 객체인데, 그중에서 스프링 컨테이너가 생성하고 관리하는 객체를Bean이라고 부른다.
스프링 컨테이너는 이Bean들을 담아 두고 관리하는 공간이다.
어떤 객체를 먼저 만들지, 어디에 연결할지, 필요한 곳에 무엇을 넣어 줄지 같은 일을 여기서 처리한다.
그래서IoC를 이해할 때는Bean과 컨테이너를 따로 떼어 보지 말고 함께 봐야 한다.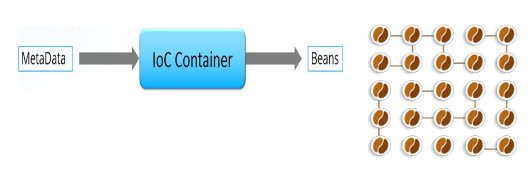
메타데이터를 바탕으로
IoC Container가Bean을 생성하고 관리하는 구조를 보여 준다.
초보자 기준에서는 컨테이너가 객체 창고이자 객체 관리자 역할을 한다고 이해하면 된다.
애노테이션 기반 IoC는 어떻게 동작하는가
Spring Boot에서는 보통 애노테이션으로IoC를 구현한다.
즉, 어떤 클래스를 스프링이 관리할지 표시하고, 필요한 의존성을 자동으로 연결하게 만드는 방식이다.
이 흐름을 이해하면Spring코드가 왜 저런 모양으로 쓰이는지 훨씬 분명해진다.
먼저 커피 머신 역할을interface로 둔다.// CoffeeMachine.java public interface CoffeeMachine { String brew(); // 커피 추출 기능 }그리고 실제 커피 머신 구현 클래스에
@Component를 붙인다.// EspressoMachine.java import org.springframework.stereotype.Component; @Component public class EspressoMachine implements CoffeeMachine { @Override public String brew() { return "Brewing coffee with Espresso Machine"; // 에스프레소 추출 } }// DripCoffeeMachine.java import org.springframework.context.annotation.Primary; import org.springframework.stereotype.Component; @Component @Primary public class DripCoffeeMachine implements CoffeeMachine { @Override public String brew() { return "Brewing coffee with Drip Coffee Machine"; // 드립 커피 추출 } }
@Component는 이 클래스를 스프링이 관리하는 대상으로 등록하겠다는 뜻이다.
더 정확히 말하면, 스프링이 컴포넌트 스캔 범위 안에서 이 클래스를 발견하면 이 클래스로 객체를 만들고 컨테이너 안에Bean으로 등록한다는 의미이다.
여기서는EspressoMachine과DripCoffeeMachine이 둘 다CoffeeMachine타입이다.
이렇게 같은 타입의Bean후보가 여러 개 있으면 스프링은 무엇을 넣어야 할지 결정하기 어렵다.
그래서DripCoffeeMachine에@Primary를 붙여 기본으로 선택할 대상을 정했다.
이제CoffeeMaker도 스프링이 관리하는 대상으로 등록한다.// CoffeeMaker.java import org.springframework.stereotype.Component; @Component public class CoffeeMaker { private final CoffeeMachine coffeeMachine; // 필요한 Bean 보관 public CoffeeMaker(CoffeeMachine coffeeMachine) { this.coffeeMachine = coffeeMachine; // 스프링이 Bean을 넣어 줌 } public void makeCoffee() { System.out.println(coffeeMachine.brew()); // 주입받은 Bean 사용 } }여기서
CoffeeMaker는CoffeeMachine이 필요하다.
그러면 스프링은 컨테이너 안에서CoffeeMachine타입의Bean을 찾고, 선택된 객체를CoffeeMaker생성자에 넣어 준다.
생성자가 하나뿐이면 보통@Autowired를 생략할 수 있다.
즉, 위 코드에서는 개발자가 직접new DripCoffeeMachine()을 작성하지 않아도 된다.
스프링 컨테이너가DripCoffeeMachine객체를 만들고,CoffeeMaker에 연결해 준다.
이 흐름을 실행해서 확인하고 싶다면CommandLineRunner를 사용할 수 있다.// CoffeeRunner.java import org.springframework.boot.CommandLineRunner; import org.springframework.stereotype.Component; @Component public class CoffeeRunner implements CommandLineRunner { private final CoffeeMaker coffeeMaker; // CoffeeMaker Bean 보관 public CoffeeRunner(CoffeeMaker coffeeMaker) { this.coffeeMaker = coffeeMaker; // 스프링이 CoffeeMaker Bean 주입 } @Override public void run(String... args) { coffeeMaker.makeCoffee(); // 애플리케이션 실행 후 호출 } }// 출력결과 // Brewing coffee with Drip Coffee Machine이 흐름을 풀어 보면 다음과 같다.
- 스프링이 컴포넌트 스캔 범위 안에서
@Component가 붙은 클래스를 찾는다.EspressoMachine,DripCoffeeMachine,CoffeeMaker,CoffeeRunner객체를 만든다.- 만들어진 객체들을 스프링 컨테이너 안에
Bean으로 보관한다.CoffeeMaker를 만들 때 필요한CoffeeMachineBean을 찾아 넣어 준다.CoffeeRunner를 만들 때 필요한CoffeeMakerBean을 찾아 넣어 준다.
Bean으로 관리한다는 것은 스프링 컨테이너가 객체의 생성, 보관, 연결을 맡는 흐름에 들어간다는 뜻이다.
그래서Spring코드에서는 직접new로 객체를 만드는 코드가 줄어들고, 필요한 객체는 생성자를 통해 주입받는 구조가 많아진다.
@Component와 @Autowired를 따로 보면
@Component는 등록이다.
즉, 스프링이 이 객체를 관리 대상으로 삼게 만든다.
@Autowired는 연결이다.
즉, 이미 등록되어 있는Bean중에서 필요한 것을 찾아 넣어 달라는 뜻이다.
이 둘은 함께 움직인다.
스프링 컨테이너에Bean으로 등록되어 있지 않은 객체는 자동 주입 대상이 되지 않는다.
그래서 주입을 이해할 때는 항상 먼저 스프링이 이 객체를 관리하고 있는가를 같이 봐야 한다.
다만 생성자가 하나뿐인 경우에는 생성자 주입에서@Autowired를 생략할 수 있다.
그래서 요즘 예제에서는 필드에@Autowired를 붙이는 방식보다, 생성자를 통해 의존성을 받는 코드가 더 자주 보인다.
같은 타입 Bean이 여러 개면 어떻게 되는가
CoffeeMachine구현체가 하나뿐이면 스프링은 그 객체를 바로 넣으면 된다.
하지만EspressoMachine과DripCoffeeMachine처럼 같은CoffeeMachine타입의Bean이 여러 개 등록되어 있으면 상황이 달라진다.
스프링은CoffeeMachine타입을 보고 주입하려고 한다.
그런데 같은 타입의 후보가 여러 개 있고, 어떤 것을 선택해야 하는지 기준이 없으면 스프링은 무엇을 넣어야 할지 결정하지 못한다.
앞의 예제에서는DripCoffeeMachine에@Primary를 붙였기 때문에 기본 선택 대상이 정해져 있었다.
그래서 그 예제는 정상적으로 동작할 수 있다.
하지만@Primary나@Qualifier같은 선택 기준이 없다면 같은 타입 후보가 여러 개일 때 오류가 발생할 수 있다.
즉, 자동 연결이 항상 되는 것은 아니다.
같은 타입의Bean이 여러 개일 때는 스프링이 어떤Bean을 선택해야 하는지 알 수 있도록 기준을 정해 주어야 한다.
@Primary, @Qualifier, 여러 개 주입
이럴 때 대표적으로 쓰는 방법이
@Primary와@Qualifier이다.// DripCoffeeMachine.java import org.springframework.context.annotation.Primary; import org.springframework.stereotype.Component; @Component @Primary public class DripCoffeeMachine implements CoffeeMachine { @Override public String brew() { return "Brewing coffee with Drip Coffee Machine"; // 드립 커피 추출 } }
@Primary는 같은 타입의 후보가 여러 개 있을 때 우선순위를 높여 주는 표시이다.
즉, 특별한 지시가 없으면 이Bean을 먼저 선택하라는 뜻이다.
더 정확하게 지정하고 싶다면 이름으로 고를 수도 있다.// DripCoffeeMachine.java import org.springframework.stereotype.Component; @Component("dripCoffeeMachine") public class DripCoffeeMachine implements CoffeeMachine { @Override public String brew() { return "Brewing coffee with Drip Coffee Machine"; // 드립 커피 추출 } }// CoffeeMaker.java import org.springframework.beans.factory.annotation.Qualifier; import org.springframework.stereotype.Component; @Component public class CoffeeMaker { private final CoffeeMachine coffeeMachine; // 선택된 Bean 보관 public CoffeeMaker(@Qualifier("dripCoffeeMachine") CoffeeMachine coffeeMachine) { this.coffeeMachine = coffeeMachine; // 이름으로 정확히 선택 } public void makeCoffee() { System.out.println(coffeeMachine.brew()); // 선택된 Bean 사용 } }
@Qualifier는 후보가 여러 개일 때 이름으로 정확히 집어서 선택하는 방식이다.
즉,@Primary가 기본 우선순위라면,@Qualifier는 더 직접적인 지정이라고 보면 된다.
그리고 경우에 따라서는 하나만 고르는 것이 아니라, 같은 타입의Bean을 여러 개 모두 받을 수도 있다.// CoffeeMaker.java import org.springframework.stereotype.Component; import java.util.List; @Component public class CoffeeMaker { private final List<CoffeeMachine> coffeeMachines; // 같은 타입 Bean 모두 받기 public CoffeeMaker(List<CoffeeMachine> coffeeMachines) { this.coffeeMachines = coffeeMachines; // 모든 CoffeeMachine Bean 주입 } public void makeCoffee() { for (CoffeeMachine coffeeMachine : coffeeMachines) { System.out.println(coffeeMachine.brew()); // 모든 Bean 사용 } } }즉, 같은 타입
Bean이 여러 개일 때는 하나를 고를 수도 있고, 여러 개를 한 번에 받을 수도 있다.
결국@Primary,@Qualifier, 리스트 주입은 후보가 여러 개일 때 어떤 기준으로 선택하거나 모아 쓸지를 정하는 도구들이다.
이 부분은 실제 프로젝트에서도 자주 헷갈리는 지점이라서 꼭 같이 알아 두는 것이 좋다.
공통 기능을 따로 빼는 방식
AOP란 무엇인가
AOP는Aspect Oriented Programming의 줄임말이다.
한국어로는 관점 지향 프로그래밍이라고 부른다.
처음에는 이름이 어려워 보이지만 핵심은 단순하다.
하나의 기능 안에 핵심 기능과 공통 부가 기능이 섞여 있을 때, 부가 기능을 따로 분리해서 관리하는 방식이다.
핵심 기능은 실제 목적 기능이다.
예를 들어 회원 처리, 게시글 처리, 상품 처리처럼 비즈니스 로직이 여기에 들어간다.
반대로 부가 기능은 여러 곳에서 반복되는 기능이다.
예를 들어로깅, 보안, 트랜잭션 처리가 여기에 들어간다.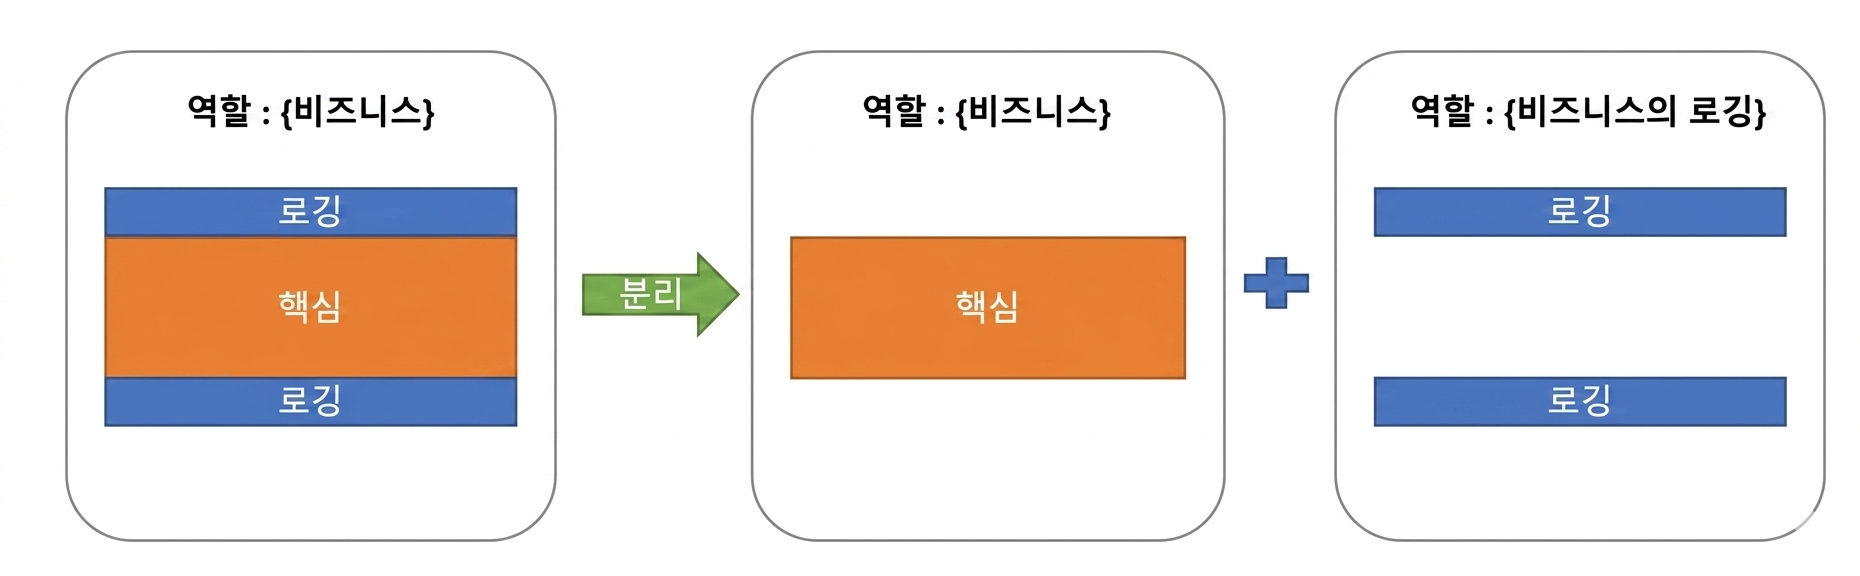
하나의 비즈니스 로직 안에 섞여 있던
로깅을 핵심 기능과 분리하는 흐름을 보여 준다.
즉, 핵심 일과 공통 보조 일을 분리하는 것이AOP의 출발점이다.
AOP는 파일을 나누는 것과 다르다
AOP는 단순히 파일을 여러 개로 나누는 것이 아니다.
Controller,Service,Repository로 파일을 나누는 것은 보통 레이어 분리라고 본다.
레이어 분리는 요청 처리, 핵심 로직, 데이터 접근처럼 역할을 나누는 구조이다.
예를 들어 아래 구조는AOP가 아니라 레이어드 구조이다.// MemberController.java import org.springframework.stereotype.Controller; @Controller public class MemberController { private final MemberService memberService; // 서비스 의존 public MemberController(MemberService memberService) { this.memberService = memberService; // 생성자 주입 } }// MemberService.java import org.springframework.stereotype.Service; @Service public class MemberService { private final MemberRepository memberRepository; // 저장소 의존 public MemberService(MemberRepository memberRepository) { this.memberRepository = memberRepository; // 생성자 주입 } }// MemberRepository.java import org.springframework.stereotype.Repository; @Repository public class MemberRepository { }이 구조는 요청을 받는 코드, 실제 처리하는 코드, 데이터베이스에 접근하는 코드를 나눈 것이다.
즉, 기능의 역할을 세로로 나눈 구조라고 보면 된다.
반면AOP는 여러 기능에 반복해서 들어가는 공통 기능을 따로 빼는 것이다.
회원 기능, 상품 기능, 게시글 기능처럼 서로 다른 기능을 가로질러 반복되는 부가 기능을 따로 관리하는 방식이다.
레이어 분리는 역할별로 코드를 나누는 구조이고,AOP는 여러 역할을 가로질러 반복되는 공통 기능을 분리하는 구조이다.
그래서Service와Repository를 나누는 것 자체가AOP는 아니다.
왜 AOP가 필요한가
예를 들어 회원 등록, 상품 조회, 게시글 작성 메서드마다 실행 시작 로그와 종료 로그를 매번 직접 적는다고 해 보자.
처음에는 가능해 보인다.
하지만 이런 코드가 서비스마다 반복되기 시작하면 핵심 기능보다 공통 기능이 더 눈에 띄게 된다.
코드를 읽기도 불편하고, 로그 형식을 바꿀 때도 여러 곳을 함께 수정해야 한다.
아래 코드는AOP를 적용하지 않았을 때의 예이다.// MemberService.java import org.springframework.stereotype.Service; @Service public class MemberService { public void join() { System.out.println("메서드 실행 시작"); // 반복되는 로그 System.out.println("회원가입 처리"); // 핵심 기능 System.out.println("메서드 실행 종료"); // 반복되는 로그 } }// ProductService.java import org.springframework.stereotype.Service; @Service public class ProductService { public void findProduct() { System.out.println("메서드 실행 시작"); // 반복되는 로그 System.out.println("상품 조회 처리"); // 핵심 기능 System.out.println("메서드 실행 종료"); // 반복되는 로그 } }여기서 핵심 기능은 회원가입 처리와 상품 조회 처리이다.
그런데 로그 코드가 여러 메서드에 반복해서 섞여 있다.
이렇게 되면 코드를 읽을 때 핵심 기능이 한눈에 들어오지 않는다.
또 로그 문구를 바꾸고 싶을 때도 문제가 생긴다.
회원 서비스, 상품 서비스, 게시글 서비스에 흩어진 로그 코드를 모두 찾아 수정해야 한다.
즉, 공통 기능이 여러 곳에 복사되어 있으면 수정 지점이 늘어난다.
이때 공통 기능을 따로 빼면 핵심 기능이 더 또렷해진다.
또 공통 기능 수정도 한곳에서 처리하기 쉬워진다.
즉,AOP는 단순히 코드를 예쁘게 정리하는 기술이 아니라, 중복을 줄이고 수정 지점을 한곳으로 모으는 방식이다.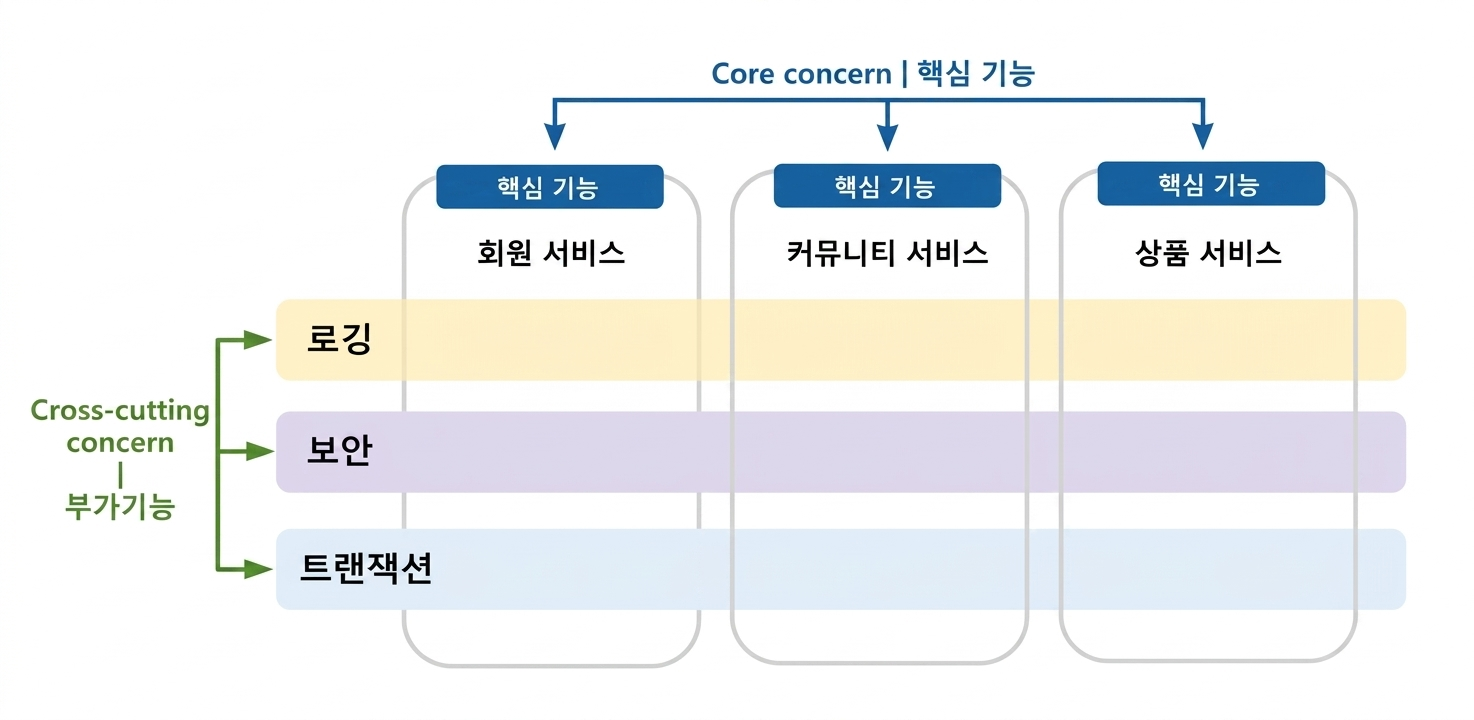
회원 서비스,커뮤니티 서비스,상품 서비스같은 핵심 기능에로깅, 보안, 트랜잭션이 공통으로 가로질러 적용되는 구조를 보여 준다.
즉, 공통 기능이 여러 서비스에 반복될수록 따로 분리하는 편이 훨씬 자연스럽다.
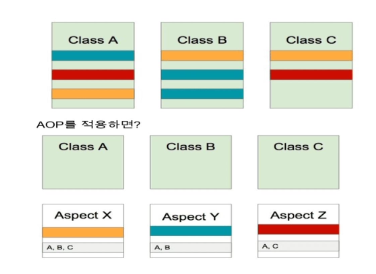
AOP적용 전에는 공통 기능이 여러 클래스에 흩어져 있고, 적용 후에는Aspect로 따로 분리되는 구조를 보여 준다.
즉, 공통 기능을 서비스마다 복사해 넣는 대신, 한곳으로 모아서 관리하는 방식으로 이해하면 된다.
스프링에서 AOP가 동작하는 방식
스프링은
AOP를 적용할 때 프록시 방식을 사용한다.
프록시는 대신 서 주는 객체라고 생각하면 된다.
원본 객체 앞에 대리 객체를 하나 두고, 그 대리 객체가 공통 기능을 먼저 처리한 뒤 원래 메서드로 넘기는 구조이다.
즉, 원본 메서드 안을 직접 뒤섞어 고치는 것이 아니라, 원본 앞단에서 공통 기능을 끼워 넣는 방식이다.
그래서 핵심 기능 코드를 크게 건드리지 않고도로깅, 보안, 트랜잭션 같은 기능을 추가할 수 있다.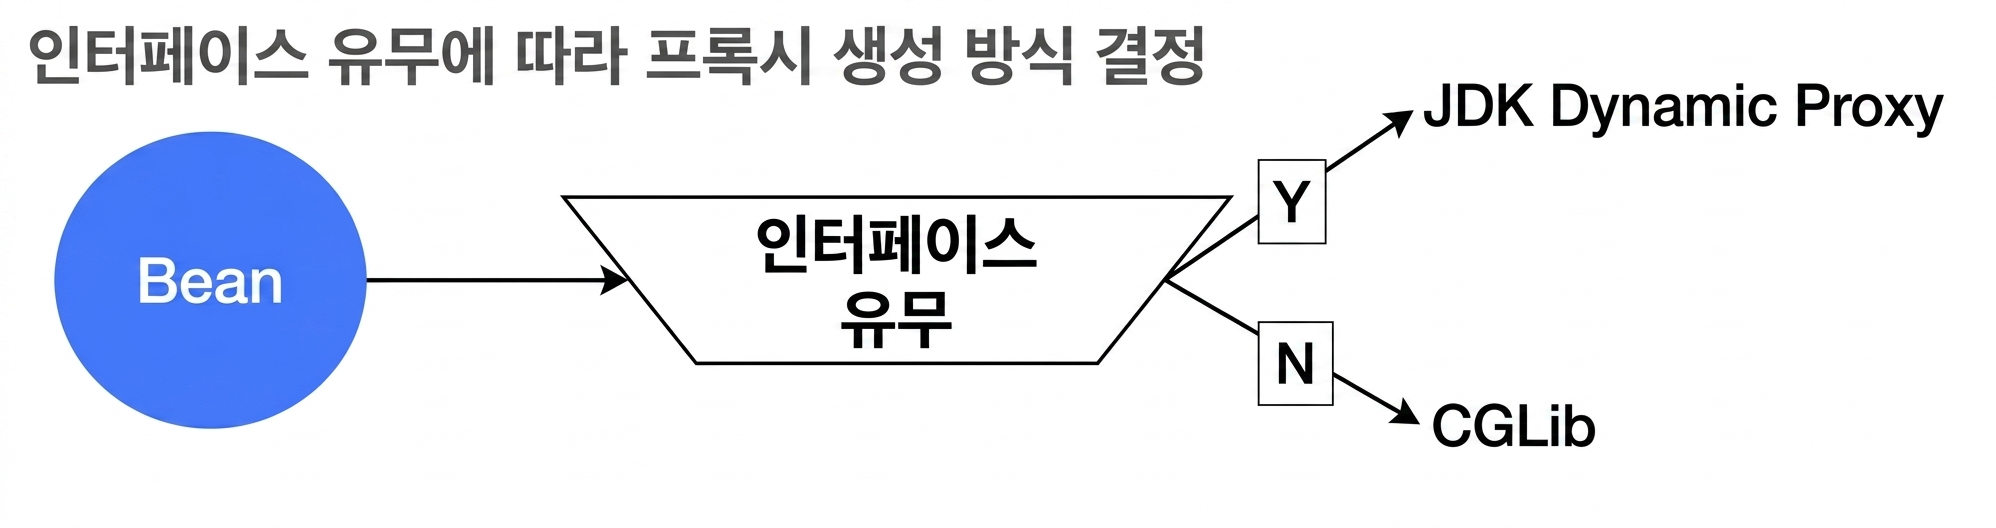
스프링
AOP는 프록시 객체를 만들어 원본 객체 앞에서 공통 기능을 처리한다.
프록시 생성 방식에는 대표적으로JDK Dynamic Proxy와CGLIB이 있다.
다만 실제 선택 방식은 인터페이스 유무와 설정에 따라 달라질 수 있다.
초보자 단계에서는 구현 이름보다 먼저 대리 객체가 앞에서 공통 기능을 처리한 뒤 원본으로 넘긴다는 동작 원리를 이해하는 것이 더 중요하다.
실행 시간 측정 예제로 보는 AOP
AOP는 개념만 보면 추상적으로 느껴질 수 있다.
그래서 애노테이션 하나를 붙였을 때 공통 기능이 실제로 끼어드는 예제를 보는 것이 좋다.
아래 예제는 메서드 실행 시간을 재는@PrintExecutionTime애노테이션을 만드는 흐름이다.
실제 프로젝트에서 스프링AOP를 사용하려면 관련 의존성이 필요할 수 있다.
Spring Boot에서는 보통spring-boot-starter-aop같은 의존성을 추가한 뒤 사용한다.// PrintExecutionTime.java package com.example.demo; import java.lang.annotation.ElementType; import java.lang.annotation.Retention; import java.lang.annotation.RetentionPolicy; import java.lang.annotation.Target; @Target(ElementType.METHOD) @Retention(RetentionPolicy.RUNTIME) public @interface PrintExecutionTime { }이 애노테이션은 메서드에 붙여서 사용한다.
즉, 실행 시간을 측정하고 싶은 메서드에 표시를 남기는 역할이다.
이제 실제로 그 표시를 보고 동작하는Aspect를 만든다.// PrintExecutionTimeAspect.java package com.example.demo; import org.aspectj.lang.ProceedingJoinPoint; import org.aspectj.lang.annotation.Around; import org.aspectj.lang.annotation.Aspect; import org.springframework.stereotype.Component; @Component @Aspect public class PrintExecutionTimeAspect { @Around("@annotation(com.example.demo.PrintExecutionTime)") public Object printExecutionTime(ProceedingJoinPoint joinPoint) throws Throwable { long start = System.currentTimeMillis(); // 시작 시각 저장 Object object = joinPoint.proceed(); // 원래 메서드 실행 long executionTime = System.currentTimeMillis() - start; // 실행 시간 계산 System.out.println("executed in " + executionTime + "ms."); // 결과 출력 return object; // 원래 반환값 전달 } }여기서
@Aspect는 이 클래스가 공통 기능을 다루는AOP구현체라는 뜻이다.
@Around는 대상 메서드의 실행 전과 후를 모두 감쌀 수 있다는 뜻이다.
즉, 원래 메서드를 실행하기 전에도 작업할 수 있고, 실행한 뒤에도 작업할 수 있다.
@Around("@annotation(com.example.demo.PrintExecutionTime)")는com.example.demo.PrintExecutionTime애노테이션이 붙은 메서드에 이 공통 기능을 적용하겠다는 뜻이다.
여기서com.example.demo는 예시 패키지명이다.
실제 프로젝트에서는 자신의 프로젝트 패키지 경로에 맞게 적어야 한다.
초보자 단계에서는 특정 애노테이션이 붙은 메서드를 찾아 실행 전후에 공통 기능을 끼워 넣는 구조라고 이해하면 된다.
이제 실행 시간을 재고 싶은 메서드에 애노테이션을 붙이면 된다.// Pi.java package com.example.demo; import org.springframework.stereotype.Component; @Component public class Pi { @PrintExecutionTime public double calculate(int points) { int circle = 0; // 원 안의 점 개수 for (long i = 0; i < points; i++) { double x = Math.random() * 2 - 1; // x 좌표 double y = Math.random() * 2 - 1; // y 좌표 if (x * x + y * y <= 1) { circle++; // 원 안이면 증가 } } return 4.0 * circle / points; // 원주율 근삿값 반환 } }실행 흐름을 보려면
Pi의calculate()를 실제로 호출해야 한다.// PiRunner.java package com.example.demo; import org.springframework.boot.CommandLineRunner; import org.springframework.stereotype.Component; @Component public class PiRunner implements CommandLineRunner { private final Pi pi; // Pi Bean 보관 public PiRunner(Pi pi) { this.pi = pi; // 스프링이 Pi Bean 주입 } @Override public void run(String... args) { pi.calculate(1000); // 실행 시간 측정 대상 pi.calculate(10000); // 실행 시간 측정 대상 pi.calculate(100000); // 실행 시간 측정 대상 } }// 출력결과 // executed in 18ms. // executed in 169ms. // executed in 1724ms.출력 시간은 실행 환경마다 달라질 수 있다.
중요한 것은 숫자 자체가 아니라,calculate()안에 실행 시간 측정 코드가 없는데도 시간이 출력된다는 점이다.
즉,calculate()안에는 실행 시간 측정 코드가 직접 들어 있지 않다.
그런데도@PrintExecutionTime하나만 붙이면 실행 시간 출력이 끼어든다.
초보자 기준에서는 이 지점이 가장 중요하다.
핵심 메서드는 원래 자기 일만 하고 있는데, 공통 기능이 바깥에서 추가된다는 것이AOP의 핵심이기 때문이다.
@Around, @Before, @After 차이
스프링
AOP에서는 공통 기능을 끼워 넣는 시점을 다르게 잡을 수 있다.
대표적으로 자주 보는 것이@Around,@Before,@After,@AfterReturning,@AfterThrowing이다.
@Around는 실행 전과 후를 모두 감싼다.@Before는 대상 메서드가 실행되기 전에 동작한다.@After는 정상 종료든 예외 발생이든 대상 메서드 실행이 끝난 뒤 동작한다.@AfterReturning은 정상적으로 값을 반환한 뒤 동작한다.@AfterThrowing은 예외가 발생했을 때 동작한다.즉, 공통 기능을 넣는다는 점은 같지만 언제 끼어들 것인가가 다르다.
같은AOP라도 실행 전을 다룰지, 실행 후를 다룰지, 정상 반환 뒤를 다룰지, 예외 상황을 다룰지에 따라 역할이 달라진다.
이 차이를 알고 있으면AOP를 단순히 로깅 기술 정도로만 보지 않고, 실행 흐름을 제어하는 구조로 이해할 수 있다.
여기서 먼저 정리해야 할 핵심
DI, IoC, AOP를 한 번에 묶어 보면
DI는 필요한 객체를 밖에서 연결받는 방식이다.IoC는 그 객체 생성과 연결을 스프링이 더 중심적으로 관리하는 큰 구조이다.Bean은 스프링이 관리하는 객체이고, 스프링 컨테이너는 그Bean을 생성하고 연결하고 관리하는 공간이다.AOP는 여러 곳에서 반복되는 공통 기능을 핵심 기능과 분리해서 적용하는 방식이다.이 세 개가 합쳐져서
Spring코드가 더 구조적으로 보이게 된다.
객체는 스프링이 관리하고, 필요한 객체는 주입으로 연결하고, 반복되는 공통 기능은 따로 빼서 적용한다.
즉,Spring의 핵심은 기능을 무작정 많이 제공하는 것이 아니라, 복잡한 프로그램을 역할별로 나누어 정리하게 해 주는 구조에 있다.
이제 객체 연결과 객체 관리, 공통 기능 분리 구조는 잡혔다.
다음부터는 이 구조가 웹 요청 처리 흐름 안에서 어떻게 이어지는지MVC구조로 넘어가서 보면 된다.
웹 애플리케이션과 요청 처리 구조
앞에서
Spring이 객체를 어떻게 만들고 연결하는지 봤다면, 이제는 웹 요청이 실제로 어떻게 들어오고 나가는지를 이해해야 한다.
초보자가 스프링을 어렵게 느끼는 이유 중 하나는 브라우저에서 보낸 요청이 서버 안에서 어떤 순서로 처리되는지 한 번에 보이지 않기 때문이다.
이 파트에서는 웹 애플리케이션의 전체 구조,Tier와Layer의 차이,WAS와Servlet의 역할, 스프링MVC요청 처리 흐름을 차례대로 연결해서 본다.
여기서 중요한 것은 요청 처리 순서만 외우는 것이 아니다.
브라우저 요청이 서버에 들어온 뒤, 그 요청이DispatcherServlet을 거쳐Controller,Service,Repository로 이어지는 흐름을 함께 이해해야 한다.
그래야 실제 프로젝트에서controller,service,repository,domain,core,config패키지가 왜 나뉘어 있는지도 자연스럽게 보인다.
즉, 지금부터 보는 내용은 단순히 용어를 외우는 구간이 아니다.
나중에@Controller,@RequestMapping,Model,@RestController,DTO,Entity,Repository가 왜 필요한지 이해하기 위한 흐름을 먼저 잡는 구간이다.
웹 애플리케이션의 전체 구조
웹 애플리케이션은 어떤 구조로 동작하는가
웹 애플리케이션은 브라우저 같은 클라이언트와 서버가
HTTP로 데이터를 주고받으며 동작하는 프로그램이다.
사용자가 주소창에/members같은 주소를 입력하거나 버튼을 누르면, 브라우저는 서버로HTTP Request를 보낸다.
여기서Request는 요청이라는 뜻이고, 사용자가 무엇을 원하는지 서버에 전달하는 메시지라고 보면 된다.
서버는 요청을 받은 뒤 필요한 처리를 하고 다시HTTP Response를 돌려준다.
여기서Response는 응답이라는 뜻이고, 서버가 처리 결과를 클라이언트에게 돌려주는 메시지이다.
응답은HTML화면일 수도 있고,JSON데이터일 수도 있고, 이미지나 파일일 수도 있다.
예를 들어 사용자가 회원 목록 화면을 요청하면 서버는 회원 목록을 보여 주는HTML을 응답할 수 있다.
반대로 화면이 아니라 데이터만 필요한 요청이라면 서버는 회원 목록 데이터를JSON형식으로 응답할 수도 있다.
즉, 웹 애플리케이션에서 서버 응답은 항상 화면만 의미하지 않는다.
여기서 정적 응답과 동적 응답도 구분해야 한다.
정적 응답은 이미 만들어져 있는HTML,CSS, 이미지 파일처럼 서버가 거의 그대로 보내 주는 응답이다.
동적 응답은 요청에 따라 자바 코드가 실행되고, 필요하면DB에서 데이터를 조회한 뒤 새로 만들어지는 응답이다.
브라우저는 보통DB에 직접 접근하지 않는다.
브라우저는 서버에 요청을 보내고, 서버가 필요할 때DB에 접근한다.
그리고 서버가 조회 결과를 화면이나 데이터 형태로 만들어 브라우저에 돌려준다.
스프링 웹 개발에서는 이 요청이 서버 안에서 바로Controller로 들어가는 것이 아니다.
먼저 스프링MVC의 공통 입구 역할을 하는DispatcherServlet이 요청을 받는다.
그다음 알맞은Controller를 찾아 요청을 넘기고,Controller는 필요한Service를 호출하면서 내부 처리 흐름을 이어 간다.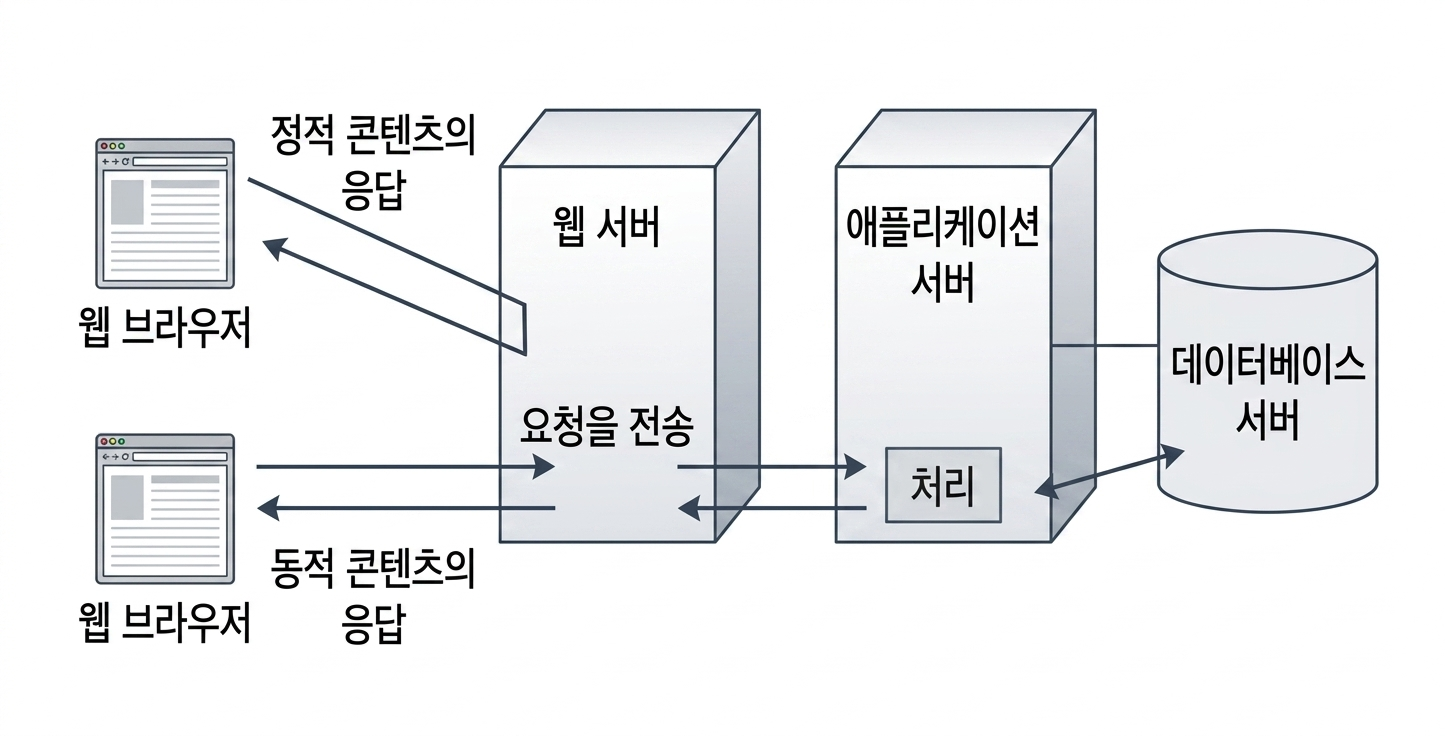
웹 브라우저,웹 서버,애플리케이션 서버,데이터베이스 서버가 연결되어 정적 콘텐츠와 동적 콘텐츠를 처리하는 전체 구조를 보여 준다.
즉, 브라우저가 직접 데이터베이스와 통신하는 것이 아니라, 중간에 서버가 요청을 받아 처리하고 필요할 때 데이터베이스에 접근한다.
사용자는 보통 브라우저 화면만 본다.
하지만 실제로는 브라우저가 요청을 보내고, 서버가 그 요청을 해석하고, 필요한 데이터를 가져오고, 다시 결과를 응답으로 보내는 과정이 뒤에서 계속 일어난다.
그래서 스프링 웹 개발을 이해하려면 화면만 보는 것이 아니라, 요청이 서버 안에서 어떤 객체를 거쳐 이동하는지를 같이 봐야 한다.
먼저 Tier와 Layer를 구분해야 한다
앞에서 본 웹 서버 구조는 실제 위치와 장비를 기준으로 보는 물리 구조에 가깝다.
이제부터 보는 스프링 프로젝트 구조는 누가 어떤 역할을 맡는지를 기준으로 보는 논리 구조에 가깝다.
그래서 여기서는Tier와Layer를 먼저 구분해서 보는 것이 중요하다.
Tier와Layer는 둘 다 구조를 나눈다는 점에서는 비슷해 보인다.
하지만 나누는 기준이 다르다.
Tier는 물리적인 기준으로 나눈 구조이다.
예를 들어 클라이언트 층, 중간 서버 층, 데이터베이스 층처럼 실제 위치나 배포 서버 기준으로 나눈다.
반면Layer는 논리적인 기준으로 나눈 구조이다.
예를 들어 요청 처리, 기능 처리, 데이터 접근처럼 코드가 맡는 역할 기준으로 나눈다.
즉,Tier는 어디에 배치되어 있는가를 보는 것이고,Layer는 무슨 역할을 하는가를 보는 것이다.
이 차이를 실제 프로젝트에 연결하면 더 쉽게 이해된다.
controller,service,repository,domain패키지는 보통 같은 스프링 애플리케이션 안에 있다.
물리적으로 다른 서버에 나뉘어 있는 것이 아니다.
하지만 각각 맡는 역할이 다르기 때문에 논리적으로 다른Layer로 나누어 생각할 수 있다.
따라서3-Tier와3-Layer를 완전히 같은 말처럼 보면 안 된다.
3-Tier는 클라이언트, 애플리케이션 서버, 데이터베이스 서버처럼 실제 배치 구조를 보는 말에 가깝다.
3-Layer는 프레젠테이션 계층, 비즈니스 계층, 데이터 접근 계층처럼 코드 역할을 보는 말에 가깝다.
스프링 프로젝트에서controller,service,repository,domain을 나누는 것은 서버를 나누는 것이 아니라 코드의 책임을 나누는Layer구조이다.
이 구분을 먼저 잡아야 뒤에서 레이어드 아키텍처를 볼 때 헷갈리지 않는다.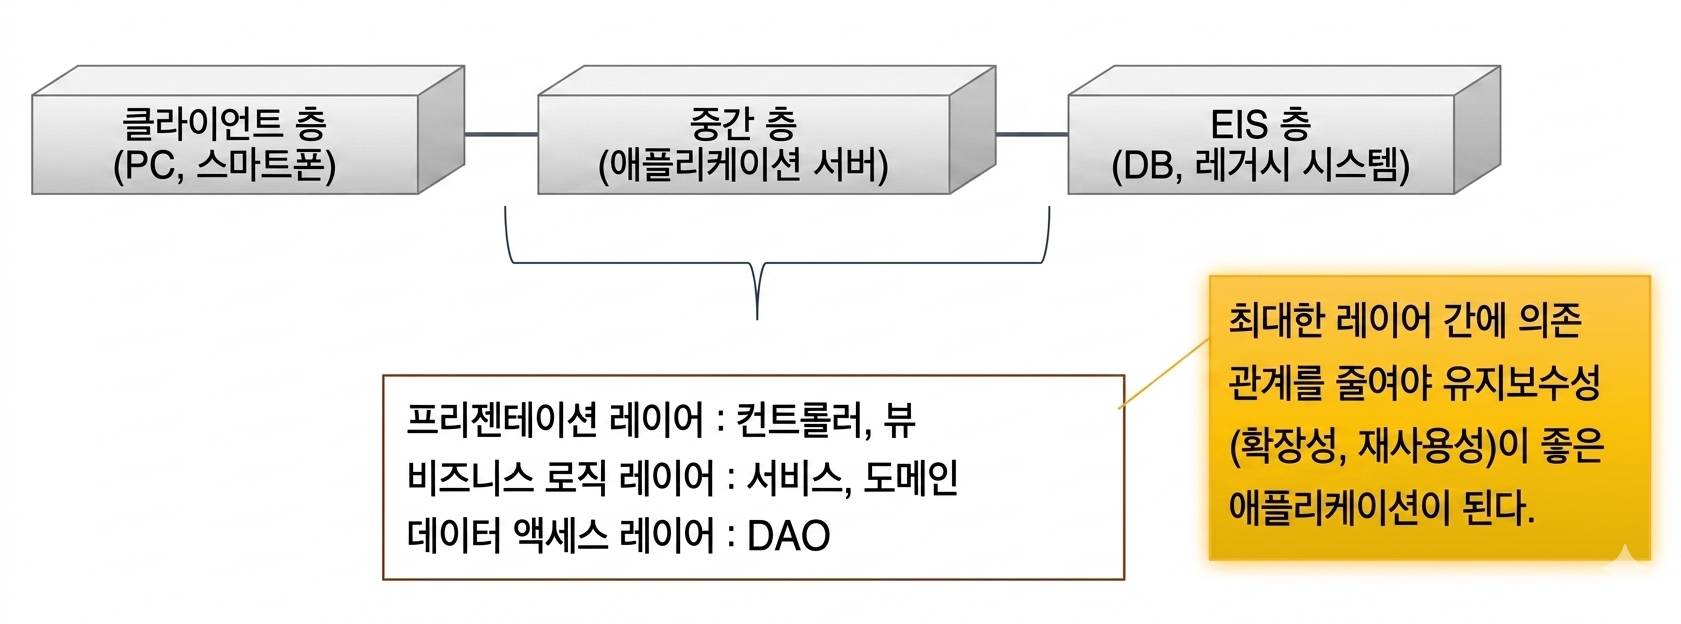
클라이언트 층,중간 층,EIS층으로 나눈Tier구조와, 내부의 프레젠테이션 레이어, 비즈니스 로직 레이어, 데이터 액세스 레이어를 함께 보여 준다.
즉,Tier는 물리 구조,Layer는 역할 구조라고 구분하면 된다.
웹 서버와 WAS는 무엇이 다른가
웹 서버와
WAS는 비슷해 보이지만, 처음 이해할 때는 역할을 나누어 보는 편이 쉽다.
개념적으로 웹 서버는HTML,CSS, 이미지 같은 정적인 자원을 전달하는 쪽에 가깝다.
반면WAS는 요청에 따라 자바 코드가 실행되어야 하는 동적인 처리를 맡는 쪽에 가깝다.
WAS는Web Application Server의 줄임말이다.
쉽게 말하면 웹 애플리케이션을 실행해 주는 서버이다.
단순히 파일을 보내는 것이 아니라, 요청에 따라 자바 코드를 실행하고, 필요하면DB와 통신한 뒤 응답 결과를 만들어 낸다.
자바 웹 애플리케이션에서는WAS안에서Servlet Container가 중요한 역할을 한다.
Servlet Container는Servlet을 생성하고 관리하며, 요청이 들어왔을 때 알맞은Servlet을 실행한다.
스프링MVC에서 모든 요청의 공통 입구 역할을 하는DispatcherServlet도 결국Servlet Container안에서 관리되는Servlet이다.
처음 스프링 부트를 실행하면 별도로Tomcat을 설치하지 않았는데도 서버가 실행되는 것처럼 보일 수 있다.
그 이유는Spring Boot가 보통 내장Tomcat을 함께 실행하기 때문이다.
여기서Tomcat은 자바 웹 애플리케이션을 실행하고Servlet을 관리하는 대표적인 서버 환경으로 이해하면 된다.
즉, 초보자 기준에서는 웹 서버와WAS를 완벽하게 딱 잘라 외우기보다, 정적인 자원 전달 쪽과 자바 웹 애플리케이션 실행 쪽을 나누어 본다는 감각을 먼저 잡으면 된다.
이 감각이 있어야 뒤에서Servlet,Servlet Container,DispatcherServlet의 관계도 덜 헷갈린다.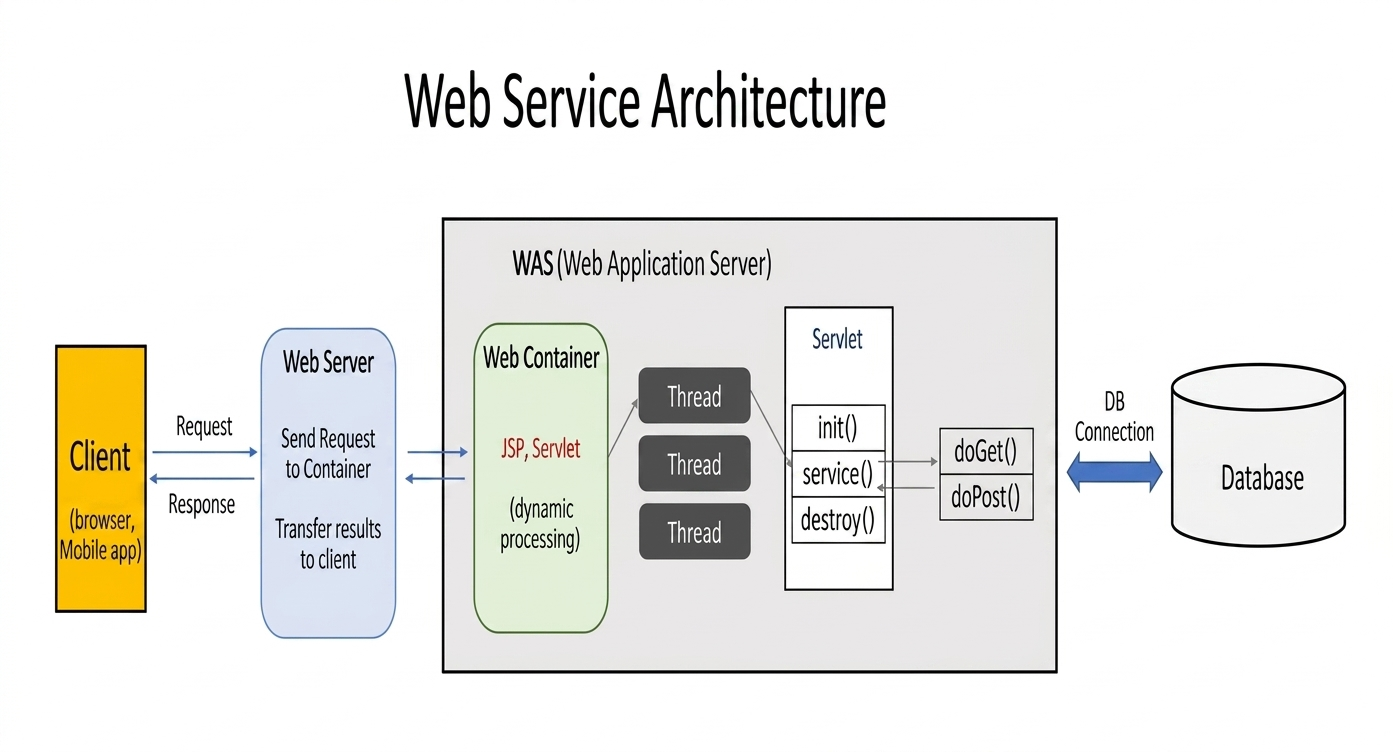
클라이언트,웹 서버,WAS,Web Container,Servlet,Database로 이어지는Web Service Architecture를 보여 준다.
즉, 브라우저 요청이 서버 안으로 들어오면WAS와Web Container가 동적인 처리를 담당하고, 그 안에서Servlet이 요청 처리를 맡게 된다.
서블릿, 서블릿 컨테이너, 디스패처 서블릿
Servlet은 무엇인가
Servlet은 자바에서 웹 요청을 처리하기 위한 객체이다.
쉽게 말하면 브라우저가 보낸 요청을 받아서 자바 코드로 처리하고, 응답을 만들어 돌려주는 역할을 한다.
즉, 자바 웹 애플리케이션에서 요청 처리의 기본 단위라고 보면 된다.
일반Servlet방식에서는 요청을 처리하기 위해doGet(),doPost()같은 메서드를 작성한다.
doGet()은 주로GET요청을 처리할 때 사용하고,doPost()는 주로POST요청을 처리할 때 사용한다.
요청 정보는HttpServletRequest로 들어오고, 응답은HttpServletResponse를 통해 만든다.
이 방식은 자바 웹 요청 처리의 기본 구조를 이해하는 데 중요하다.
하지만 요청이 많아질수록 개발자가 여러Servlet을 만들고, 각 요청을 직접 연결하고, 요청값을 꺼내고, 응답을 만드는 코드가 많아진다.
그러면 반복 코드가 늘어나고 요청 처리 구조도 복잡해진다.
스프링MVC는 이런 흐름을 더 편하게 정리한다.
개발자가 일반Servlet을 여러 개 직접 만들어 요청을 처리하기보다, 스프링이 제공하는DispatcherServlet을 공통 입구로 두고, 개발자는 보통Controller메서드 중심으로 요청을 처리한다.
Servlet은 자바 웹 요청 처리의 기본 단위이고, 스프링MVC에서는DispatcherServlet이 대표적인Servlet로서 모든 요청의 공통 입구 역할을 한다.
Servlet Container는 무엇인가
Servlet Container는Servlet을 대신 관리해 주는 실행 환경이다.
개발자가Servlet객체를 직접new로 만들고 실행하는 것이 아니다.
Servlet Container가Servlet객체를 생성하고, 초기화하고, 요청이 들어오면 호출하고, 애플리케이션이 종료될 때 정리한다.
즉,Servlet은 혼자서 움직이는 객체가 아니다.
항상Servlet Container안에서 관리되고 실행된다.
대표적으로Tomcat은 자바 웹 애플리케이션에서 많이 사용하는Servlet Container역할을 한다.
여기서 헷갈리기 쉬운 점은Servlet Container와 스프링 컨테이너가 다르다는 것이다.
둘 다 컨테이너라는 이름이 붙지만 관리 대상이 다르다.
Servlet Container는 웹 요청을 처리하는Servlet을 관리한다.
반면 스프링 컨테이너는Controller,Service,Repository같은 스프링Bean을 관리한다.
즉,Servlet Container는 웹 실행 환경에 가깝고, 스프링 컨테이너는 애플리케이션 객체 관리 공간에 가깝다.
정리하면 아래와 같다.
Servlet Container는Servlet을 생성하고 실행하고 관리한다.- 스프링 컨테이너는 스프링
Bean을 생성하고 연결하고 관리한다.DispatcherServlet은Servlet Container안에서 관리되는Servlet이다.Controller,Service,Repository는 스프링 컨테이너 안에서 관리되는Bean이다.이 구분을 잡아야
Servlet Container,IoC Container, 스프링 컨테이너라는 말이 나와도 덜 헷갈린다.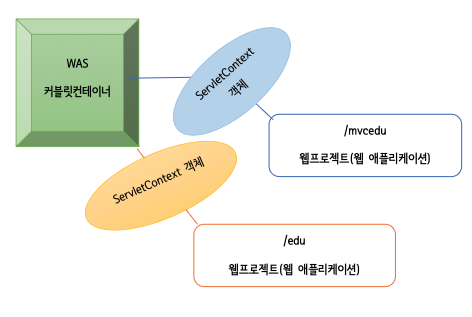
WAS안에서 웹 애플리케이션마다 별도의ServletContext객체가 생성되고,/mvcedu,/edu처럼 각각 독립된 웹 프로젝트로 구분되는 구조를 보여 준다.
즉, 웹 애플리케이션마다 자기만의 실행 공간이 따로 잡힌다고 이해하면 된다.
DispatcherServlet은 왜 중요한가
스프링
MVC에서는 브라우저에서 들어오는 모든 요청을 먼저DispatcherServlet이 받는다.
DispatcherServlet은 스프링MVC의 공통 입구이다.
요청을 먼저 받고, 어떤 컨트롤러가 처리할지 찾고, 실행 결과를 다음 단계로 넘기는 전체 흐름을 관리한다.
그래서 스프링 웹 요청 처리의 시작점은 보통Controller가 아니라DispatcherServlet이다.
하지만DispatcherServlet이 모든 일을 혼자 직접 처리하는 것은 아니다.
DispatcherServlet은 요청 처리의 총괄자에 가깝다.
실제로는 여러 구성요소와 함께 움직인다.
예를 들어 요청이 들어오면DispatcherServlet은 먼저HandlerMapping을 통해 어떤 컨트롤러 메서드가 이 요청을 처리할지 찾는다.
그다음HandlerAdapter를 통해 찾은 컨트롤러 메서드를 실행한다.
컨트롤러 실행 결과가 뷰 이름이면ViewResolver를 통해 실제 화면 파일을 찾고, 응답 데이터이면MessageConverter를 통해 응답 본문을 만든다.
정리하면 아래와 같다.
DispatcherServlet은 모든 요청의 공통 입구이다.HandlerMapping은 요청을 처리할 컨트롤러 메서드를 찾는다.HandlerAdapter는 찾은 메서드를 실행할 수 있게 연결한다.ViewResolver는 뷰 이름을 실제 화면 파일과 연결한다.MessageConverter는 자바 객체를 응답 데이터 형식으로 바꾼다.즉,
DispatcherServlet은 요청 처리의 중심이지만, 혼자 모든 일을 직접 하는 객체는 아니다.
여러 구성요소에게 일을 나누어 맡기면서 스프링MVC요청 흐름을 통일한다.
코드로 먼저 보면
아래 예제는 브라우저에서
/hello요청이 들어왔을 때 스프링이 어떤 식으로 처리하는지 가장 단순하게 보여 주는 예제이다.// HelloController.java @Controller public class HelloController { @GetMapping("/hello") // /hello 요청 연결 public String hello() { return "hello"; // 뷰 이름 반환 } }// hello.html <!DOCTYPE html> <html xmlns:th="http://www.thymeleaf.org"> <head> <meta charset="UTF-8"> <title>hello</title> </head> <body> <h1>Hello Spring MVC</h1> </body> </html>브라우저가
/hello를 요청했다고 해서 바로HelloController로 가는 것이 아니다.
먼저DispatcherServlet이 요청을 받고,HandlerMapping이HelloController의hello()메서드를 찾고,HandlerAdapter가 그 메서드를 실행한다.
여기서 중요한 점은return "hello"의 의미이다.
일반Controller에서 반환하는"hello"는 브라우저에 그대로 출력할 문자열이 아니다.
스프링은"hello"를 뷰 이름으로 해석한다.
그리고ViewResolver가 이 이름을 바탕으로 실제 화면 파일을 찾는다.
Thymeleaf를 사용하는 경우라면 보통templates/hello.html같은 파일과 연결된다.
즉,"hello"라는 뷰 이름이 실제hello.html화면으로 이어지는 것이다.
같은String을 반환하더라도@RestController에서는 의미가 달라진다.
@RestController에서는 반환 문자열이 뷰 이름이 아니라 응답 본문으로 나간다.
이 차이는 뒤에서 일반Controller와RestController를 비교하면서 다시 정리한다.
스프링의 레이어드 아키텍처
역할별로 나누면 왜 좋은가
스프링에서는 애플리케이션 코드를 역할에 따라 나누어 관리한다.
이 구조를 레이어드 아키텍처라고 한다.
여기서Layer는 물리적인 서버 위치가 아니라, 코드가 맡는 역할을 기준으로 나눈 논리적인 구분이다.
현재 프로젝트 구조를 보면controller,service,repository,domain,core,config패키지가 분리되어 있다.
이 구조는 파일을 보기 좋게 나누기 위한 장식이 아니다.
각 패키지가 맡는 책임을 분리하기 위한 구조이다.
예를 들어 회원 목록 조회 기능을 만든다고 해 보자.
사용자의 요청을 받는 일, 회원 목록 조회 조건을 판단하는 일, 회원 데이터를 조회하는 일, 응답에 필요한 데이터를 담는 일, 회원 상태 같은 정해진 값을 관리하는 일은 모두 성격이 다르다.
이 모든 일을 한 클래스에 넣으면 처음에는 코드가 짧아 보일 수 있다.
하지만 기능이 커질수록 수정할 위치를 찾기 어려워지고, 한 곳을 고쳤는데 다른 기능까지 영향을 받을 수 있다.
레이어드 아키텍처는 코드를 무조건 많이 나누는 방식이 아니라, 변경 이유가 비슷한 코드끼리 모으고 다른 역할의 코드는 분리하는 방식이다.
그래서 중요한 기준은 “파일이 몇 개냐”가 아니라 “각 코드가 자기 역할만 맡고 있느냐”이다.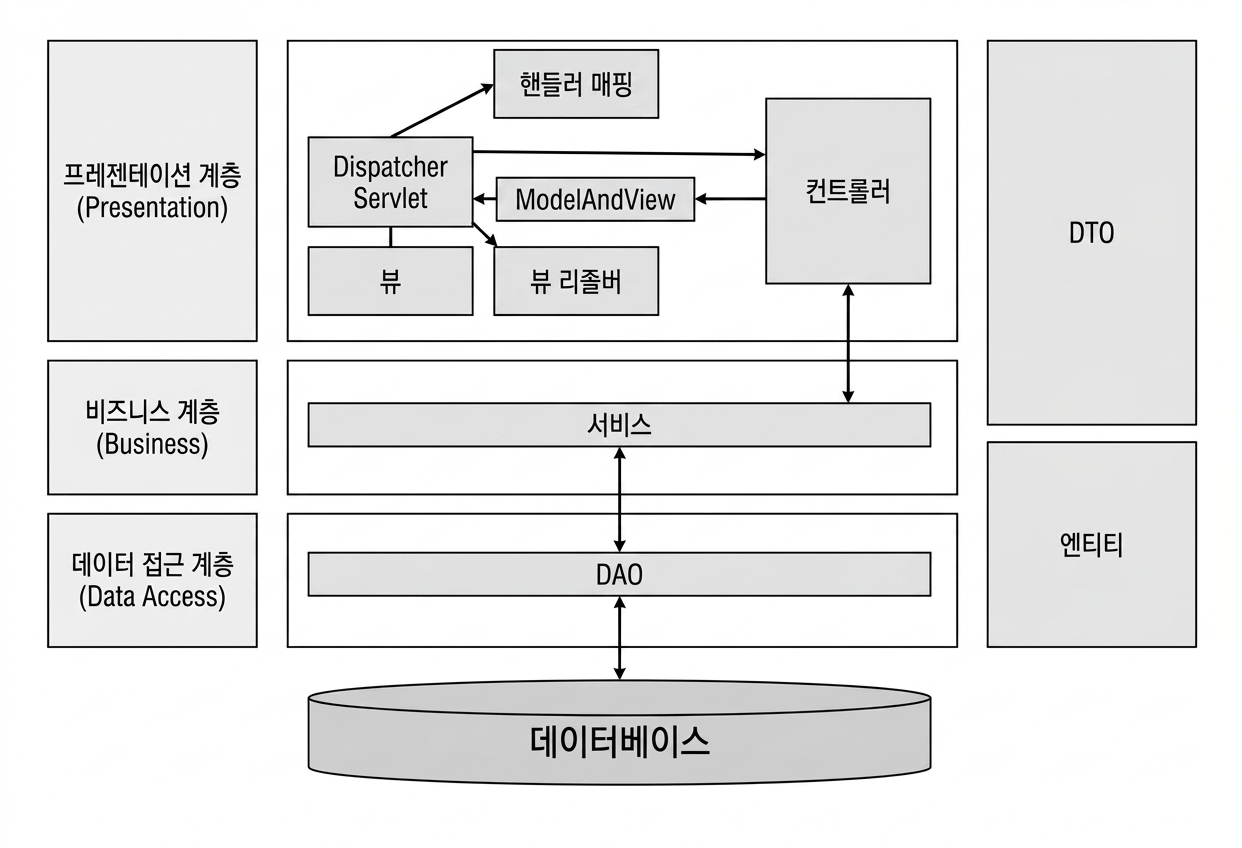
프레젠테이션 계층, 비즈니스 계층, 데이터 접근 계층으로 나눈 스프링 레이어드 아키텍처 구조를 보여 준다.
현재 프로젝트에서는 여기에domain,core,config같은 패키지까지 함께 보면서 역할을 구분하면 된다.
현재 프로젝트 구조 기준으로 먼저 보기
현재 프로젝트는 기능별로
member패키지 안에controller,service,repository를 모두 넣은 구조가 아니다.
사진 기준으로 보면 큰 역할별 패키지를 먼저 나눈 구조에 가깝다.
현재 구조는 아래처럼 볼 수 있다.// ProjectStructure.txt com.example.groupbuyingweb ├── config ├── controller ├── core ├── domain │ ├── dto │ ├── entity │ └── enums ├── repository ├── service └── GroupbuyingwebApplication각 패키지의 큰 역할은 아래와 같다.
config는 프로젝트 설정 코드를 담는다.controller는 요청과 응답을 처리하는 입구 코드를 담는다.core는 여러 기능에서 함께 쓰는 공통 기반 코드를 담는다.domain은 요청, 응답, 저장 데이터, 정해진 값처럼 핵심 데이터 타입을 담는다.repository는DB접근 코드를 담는다.service는 실제 기능 처리 흐름을 담는다.이 구조에서 특히
domain을 조심해서 봐야 한다.
domain안에는dto,entity,enums가 함께 들어간다.
하지만dto가domain안에 있다고 해서DTO가Entity와 같은 역할을 한다는 뜻은 아니다.
폴더 위치와 객체의 역할은 구분해서 봐야 한다.
현재 프로젝트에서domain패키지는 기능 처리 과정에서 사용되는 데이터 타입들을 모아 두는 영역이다.
그 안에서도dto,entity,enums는 각각 역할이 다르다.
controller 패키지는 요청과 응답의 입구이다
controller패키지는 사용자의 요청을 받는 클래스를 담는다.
브라우저나 클라이언트가 특정URL로 요청을 보내면, 스프링은 그 요청을 처리할Controller메서드를 찾는다.
Controller는 요청URL, 요청 방식, 요청값을 받는다.
그리고 직접 모든 일을 처리하지 않고, 필요한Service를 호출한다.
처리가 끝나면 화면 이름을 반환하거나, 응답 데이터를 클라이언트에게 돌려준다.
예를 들어/members요청이 들어왔다고 해 보자.
MemberController는 이 요청을 받고, 회원 목록을 가져오기 위해MemberService를 호출한다.
회원 목록을 어떤 기준으로 가져올지, 어떤 검증이 필요한지, 어떤 데이터로 응답할지는Controller가 혼자 다 처리하지 않는다.
Controller를 접수 창구로 생각하면 쉽다.
사용자가 요청을 접수하면,Controller는 그 요청을 실제 처리 부서인Service에 넘긴다.
그리고 처리 결과를 다시 사용자에게 돌려준다.
정리하면Controller의 역할은 아래와 같다.
- 요청
URL을 받는다.- 요청 방식을 구분한다.
- 요청값을 받는다.
- 필요한
Service를 호출한다.- 처리 결과를 화면이나 응답 본문으로 돌려준다.
- 실제 핵심 처리 규칙이나
DB접근은 직접 맡지 않는다.
Controller가 너무 많은 일을 직접 처리하면 코드가 무거워진다.
요청 처리 코드, 검증 코드, 조회 조건, 저장 코드가 한곳에 섞이면 나중에 수정하기 어렵다.
그래서Controller는 요청과 응답의 입구 역할에 집중하는 것이 좋다.
service 패키지는 실제 기능 처리 흐름을 담당한다
service패키지는 실제 기능 처리 흐름을 담당하는 클래스를 담는다.
여기서 기능 처리 흐름이란 프로그램이 실제로 해야 하는 일을 어떤 순서로 처리할지 정하는 흐름이다.
예를 들어 회원 목록 조회 기능이라면Service는 회원 목록을 어떤 기준으로 가져올지 판단하고, 필요하면Repository를 호출한다.
회원가입 기능이라면 아이디 중복 확인, 비밀번호 암호화, 회원Entity생성, 저장 요청 같은 흐름이Service에 들어갈 수 있다.
초보자는 처음에Service를 단순한 중간 통로로 오해하기 쉽다.
예제 코드에서는Service가Repository를 한 번 호출하고 끝나는 것처럼 보일 수 있기 때문이다.
하지만 실제 프로젝트에서는 검증, 조건 판단, 여러Repository호출, 도메인 객체 생성, 트랜잭션 처리 같은 흐름이Service에 모인다.
정리하면Service의 역할은 아래와 같다.
- 실제 기능 처리 흐름을 담당한다.
- 필요한 검증과 조건 판단을 수행한다.
- 필요한
Entity나DTO를 사용한다.- 필요한
Repository를 호출한다.- 여러 작업을 하나의 흐름으로 묶는다.
- 트랜잭션 처리가 필요한 경우 중심 위치가 될 수 있다.
Service는 단순 전달자가 아니라, 기능이 어떤 순서로 처리되어야 하는지 조정하는 중심 계층이다.
그래서 프로젝트가 커질수록Service의 역할이 중요해진다.
repository 패키지는 DB 접근을 담당한다
repository패키지는DB에 접근하는 클래스를 담는다.
Service가 데이터를 저장하거나 조회해야 할 때Repository를 호출한다.
Repository는domain/entity에 있는Entity를 기준으로 데이터를 저장하거나 조회한다.
예를 들어 회원 목록 조회 기능에서Service가 회원 데이터가 필요하다고 판단하면MemberRepository를 호출한다.
그러면MemberRepository는 실제 저장소에서 회원 데이터를 가져온다.
여기서 저장소는 실제DB일 수도 있고, 예제에서는 임시 데이터일 수도 있다.
Repository는 데이터 접근을 담당하지만, 비즈니스 판단을 하는 곳은 아니다.
예를 들어 회원을 저장할 수 있는지, 어떤 조건에서 조회해야 하는지, 어떤 예외를 처리해야 하는지는 보통Service에서 판단한다.
Repository는 그 판단에 따라 실제 데이터를 저장하거나 조회하는 역할에 집중한다.
정리하면Repository의 역할은 아래와 같다.
DB에서 데이터를 조회한다.DB에 데이터를 저장한다.DB데이터를 수정하거나 삭제한다.Service가DB접근 방식을 직접 알지 않아도 되게 한다.Entity를 기준으로 저장소와 데이터를 주고받는다.
Repository와DAO는 둘 다 데이터 접근을 담당한다는 점에서 비슷하다.
DAO는Data Access Object의 줄임말로, 전통적인SQL중심 구조나MyBatis같은 방식에서 자주 볼 수 있다.
JPA를 사용하는 스프링 프로젝트에서는 보통Repository라는 이름을 많이 사용한다.
초보자 기준에서는 먼저 이렇게 이해하면 된다.
Service는 무엇을 해야 할지 판단하고,Repository나DAO는 데이터를 어디서 가져오고 어디에 저장할지 담당한다.
domain 패키지는 핵심 데이터 타입을 모아 둔다
domain패키지는 현재 프로젝트에서 핵심 데이터 타입을 모아 둔 영역이다.
여기에는dto,entity,enums가 함께 들어간다.
이 구조를 볼 때 가장 중요한 것은domain을 하나의 호출 계층처럼 오해하지 않는 것이다.
요청 흐름은 보통Controller→Service→Repository중심으로 움직인다.
그 과정에서domain안에 있는DTO,Entity,enum이 사용된다.
즉,domain은Controller다음에 호출되고Repository전에 호출되는 중간 단계가 아니다.
기능 처리 과정에서 필요한 핵심 데이터 타입을 모아 둔 영역이다.
현재 프로젝트 기준으로 보면 아래처럼 이해하면 된다.
domain/entity는DB에 저장되는 핵심 데이터 객체를 담는다.domain/dto는 요청과 응답 데이터를 전달하는 객체를 담는다.domain/enums는 상태나 역할처럼 정해진 값 목록을 담는다.
domain은 하나의 호출 계층이라기보다, 요청 처리 과정에서 사용되는Entity,DTO,enum같은 핵심 데이터 타입을 모아 둔 영역이다.
그래서domain안에 같이 있더라도entity,dto,enums의 역할은 반드시 구분해서 봐야 한다.
domain/entity는 저장되는 데이터 객체를 담는다
domain/entity는DB테이블과 연결되는 객체를 담는 패키지이다.
JPA를 사용한다면 보통@Entity가 붙은 클래스가 이 위치에 들어간다.
Entity는 실제 저장 대상이 되는 핵심 데이터 객체이다.
예를 들어 회원 정보를 저장한다면Member클래스가Entity가 될 수 있다.
Member는 회원 아이디, 로그인 아이디, 닉네임 같은 회원 데이터를 가진다.
이 객체는 단순히 화면에 보여 주기 위한 데이터가 아니라, 실제 저장소에 저장되는 데이터 구조와 연결된다.
초보자 기준에서는Entity를DB에 저장되는 객체라고 이해하면 된다.
화면에 보여 주기 위한 값만 담는 객체가 아니라, 실제 데이터베이스 테이블과 연결되는 핵심 저장 객체이다.
예시는 아래와 같다.// Member.java public class Member { private Long id; // 회원 식별자 private String loginId; // 로그인 아이디 private String nickname; // 닉네임 public Member(Long id, String loginId, String nickname) { this.id = id; // 식별자 저장 this.loginId = loginId; // 로그인 아이디 저장 this.nickname = nickname; // 닉네임 저장 } public Long getId() { return id; // 식별자 반환 } public String getLoginId() { return loginId; // 로그인 아이디 반환 } public String getNickname() { return nickname; // 닉네임 반환 } }이 예제에서는 설명을 단순하게 하기 위해
@Entity같은 세부 설정은 생략했다.
중요한 점은Member가 회원이라는 저장 대상 데이터를 표현하는 객체라는 것이다.
실제JPA프로젝트에서는 이 클래스에@Entity,@Id,@Column같은 매핑 정보가 추가될 수 있다.
domain/dto는 요청과 응답 데이터를 전달한다
domain/dto는 요청과 응답에 필요한 데이터 전달 객체를 담는 패키지이다.
DTO는Data Transfer Object의 줄임말이다.
뜻 그대로 데이터를 전달하기 위한 객체이다.
여기서 꼭 구분해야 할 점이 있다.
DTO가domain패키지 안에 있다고 해서DTO가Entity와 같은 역할을 하는 것은 아니다.
Entity는 저장되는 데이터 객체이고,DTO는 데이터를 전달하기 위한 객체이다.
예를 들어 회원 목록 화면에 회원의 모든 정보가 필요하지 않을 수 있다.
화면에는 회원 식별자와 닉네임만 필요할 수 있다.
이때MemberEntity전체를 그대로 넘기지 않고, 응답에 필요한 값만 담은MemberResponseDTO를 만들 수 있다.// MemberResponse.java public class MemberResponse { private Long id; // 응답에 필요한 회원 식별자 private String nickname; // 응답에 필요한 닉네임 public MemberResponse(Long id, String nickname) { this.id = id; // 식별자 저장 this.nickname = nickname; // 닉네임 저장 } public Long getId() { return id; // 식별자 반환 } public String getNickname() { return nickname; // 닉네임 반환 } }
DTO는 요청 데이터를 받을 때도 사용하고, 응답 데이터를 보낼 때도 사용할 수 있다.
요청 데이터를 받을 때 쓰는 객체를Request DTO라고 부를 수 있고, 응답 데이터를 보낼 때 쓰는 객체를Response DTO라고 부를 수 있다.
정리하면DTO의 역할은 아래와 같다.
- 요청 데이터를 받는다.
- 응답 데이터를 담는다.
- 화면이나
API에 필요한 값만 전달한다.Entity전체를 외부에 그대로 노출하지 않도록 도와준다.
DTO가domain패키지 안에 있어도DTO의 역할은 도메인 규칙을 담는 것이 아니라 요청과 응답 데이터를 전달하는 것이다.
그래서Entity와DTO는 위치가 가까워 보여도 목적이 다르다.
domain/enums는 정해진 값 목록을 담는다
domain/enums는 정해진 값 목록을 표현하는 타입을 담는 패키지이다.
여기서enum은 선택지가 정해져 있는 값을 코드로 안전하게 표현할 때 사용한다.
예를 들어 회원 역할이 일반 회원과 관리자처럼 정해져 있다고 해 보자.
이 값을 문자열로 직접"USER","ADMIN"처럼 여기저기 쓰면 오타가 날 수 있다.
"ADMN"처럼 잘못 입력해도 단순 문자열이면 컴파일 단계에서 잡기 어렵다.
이럴 때enum으로 정해진 값 목록을 만들면 사용할 수 있는 값을 제한할 수 있다.// MemberRole.java public enum MemberRole { USER, // 일반 회원 ADMIN // 관리자 }회원 상태도 정해진 값으로 관리할 수 있다.
// MemberStatus.java
public enum MemberStatus {
    ACTIVE, // 활성 회원
    WITHDRAWN // 탈퇴 회원
}
enum을 사용하면 아무 문자열이나 넣는 실수를 줄일 수 있다.
또 코드만 봐도 어떤 값들이 가능한지 알 수 있다.
정리하면domain/enums의 역할은 아래와 같다.
- 정해진 값 목록을 관리한다.
- 상태값, 역할값, 타입값을 표현한다.
- 문자열 오타로 인한 실수를 줄인다.
- 사용할 수 있는 값을 코드 수준에서 제한한다.
즉,
domain/enums는 회원 역할, 회원 상태처럼 선택지가 정해진 값을 안전하게 관리하기 위한 영역이다.
core 패키지는 공통 기반 코드를 담는다
core패키지는 여러 기능에서 공통으로 사용하는 기반 코드를 담는 영역으로 볼 수 있다.
특정 기능 하나에만 묶이는 코드가 아니라, 프로젝트 전체에서 함께 쓰이는 코드가 들어갈 수 있다.
예를 들어 공통 응답 형식, 공통 예외 처리, 에러 코드, 공통 상수, 공통 유틸 코드가core에 들어갈 수 있다.
회원 기능에서도 쓰고, 게시글 기능에서도 쓰고, 다른 기능에서도 함께 쓰는 코드라면core에 둘 수 있다.
다만core에 무엇을 넣을지는 프로젝트 규칙에 따라 달라질 수 있다.
중요한 점은core가 실제 비즈니스 기능 하나를 직접 담당하는 패키지가 아니라는 것이다.
공통 기반을 정리하기 위한 패키지에 가깝다.
정리하면core의 역할은 아래와 같다.
- 여러 기능에서 함께 쓰는 공통 코드를 담는다.
- 공통 응답 형식을 담을 수 있다.
- 공통 예외와 에러 코드를 담을 수 있다.
- 공통 유틸이나 상수를 담을 수 있다.
- 특정 기능 하나의 처리 흐름보다는 프로젝트 기반 코드를 담는다.
즉,
core는 기능별 로직보다 공통 기반을 정리하는 영역으로 이해하면 된다.
config 패키지는 설정 코드를 담는다
config패키지는 프로젝트 설정 코드를 담는 영역이다.
기능을 직접 처리하는 코드라기보다, 프로젝트가 어떤 방식으로 동작할지 환경을 잡아 주는 코드가 들어간다.
예를 들어 웹 설정, 보안 설정, 외부API설정,CORS설정, 직접 등록해야 하는Bean설정 등이 들어갈 수 있다.
이 설정들은 회원 목록을 조회한다거나 회원을 저장한다거나 하는 기능 자체를 직접 처리하는 코드는 아니다.
하지만 애플리케이션이 올바르게 동작하려면 필요한 환경 설정이다.
정리하면config의 역할은 아래와 같다.
- 프로젝트 설정 코드를 담는다.
- 웹 관련 설정을 담을 수 있다.
- 보안 관련 설정을 담을 수 있다.
- 외부
API연동 설정을 담을 수 있다.CORS나Bean등록 설정을 담을 수 있다.즉,
config는 기능을 직접 수행하는 계층이 아니라, 프로젝트가 어떤 방식으로 동작할지 정해 주는 설정 영역이다.
요청 흐름으로 보면 더 쉽게 이해된다
레이어드 구조는 요청이 들어왔을 때의 이동 흐름으로 보면 더 쉽게 이해된다.
예를 들어 브라우저가/members라는 주소로 회원 목록을 요청한다고 해 보자.
이 요청은 먼저DispatcherServlet을 거쳐 알맞은Controller로 전달된다.
그다음 흐름은 보통 아래처럼 이어진다.
Controller가/members요청을 받는다.Controller는 직접DB를 조회하지 않고Service를 호출한다.Service는 회원 목록 조회에 필요한 처리 흐름을 담당한다.Service는 실제 데이터 조회가 필요할 때Repository를 호출한다.Repository는DB에서MemberEntity를 조회한다.- 조회된 데이터는 다시
Repository→Service→Controller순서로 돌아온다.Service는 필요한 경우Entity를DTO로 바꾼다.Controller는 결과를 화면에 담거나 응답 본문으로 돌려준다.이 흐름을 한 줄로 보면 아래와 같다.
브라우저 요청 →DispatcherServlet→Controller→Service→Repository→DB→Repository→Service→Controller→ 응답
여기서domain은 독립적으로 호출되는 중간 계층이 아니다.
domain/entity,domain/dto,domain/enums는 이 요청 흐름 안에서 사용되는 데이터 타입이다.
예를 들어 요청값은domain/dto의Request DTO로 받을 수 있다.
저장 대상은domain/entity의Entity로 만들 수 있다.
회원 역할이나 회원 상태 같은 값은domain/enums의enum으로 표현할 수 있다.
응답값은 다시domain/dto의Response DTO로 보낼 수 있다.
요청 흐름은Controller→Service→Repository중심으로 움직이고, 그 과정에서domain내부 객체들이 사용된다.
이렇게 이해해야domain을 호출 계층처럼 오해하지 않는다.
Controller가 Repository를 바로 호출하면 왜 좋지 않은가
초보자 입장에서는
Controller에서 바로Repository를 호출하면 더 간단해 보일 수 있다.
요청을 받자마자 데이터를 조회하면 코드가 짧아 보이기 때문이다.
실제로 아주 단순한 조회라면 동작 자체는 할 수 있다.
하지만 이 방식은 기능이 커질수록 문제가 생긴다.
회원 조회 전에 권한 검사, 검색 조건 처리, 정렬 기준 적용, 예외 처리 같은 로직이 들어가기 시작하면Controller가 점점 무거워진다.
아래 코드는Controller가Repository를 바로 호출하는 예이다.// BadMemberController.java @Controller public class BadMemberController { private final MemberRepository memberRepository; // 저장소에 직접 의존 public BadMemberController(MemberRepository memberRepository) { this.memberRepository = memberRepository; // Repository 직접 주입 } @GetMapping("/members") public String members(Model model) { model.addAttribute("members", memberRepository.findAll()); // Controller가 직접 조회 return "member/list"; // 뷰 이름 반환 } }이 예제는 단순 조회만 보면 문제없어 보일 수 있다.
하지만 회원 조회 조건이 복잡해지거나, 응답 데이터 변환이 필요하거나, 예외 처리가 추가되면Controller안에 여러 역할이 섞이게 된다.
Controller가 무거워지면 요청 처리 코드와 실제 처리 규칙이 섞인다.
그러면 화면 응답 방식을 바꾸고 싶을 때도, 조회 규칙을 바꾸고 싶을 때도 같은Controller를 계속 수정하게 된다.
즉, 수정 이유가 서로 다른 코드가 한곳에 모이게 된다.
그래서 보통은Controller가Repository를 바로 호출하지 않고, 중간에Service를 둔다.// MemberController.java @Controller public class MemberController { private final MemberService memberService; // 서비스 의존 public MemberController(MemberService memberService) { this.memberService = memberService; // 생성자 주입 } @GetMapping("/members") public String members(Model model) { model.addAttribute("members", memberService.findAll()); // 서비스 호출 return "member/list"; // 뷰 이름 반환 } }이 구조에서는
Controller가 요청과 응답 흐름에 집중할 수 있다.
회원 목록을 어떤 기준으로 가져올지, 어떤 데이터로 바꿔서 보낼지에 대한 판단은Service로 넘긴다.
그래서 기능이 커져도 각 계층의 역할이 덜 섞인다.
레이어드 구조를 코드로 보면
아래 예제는 요청이 들어왔을 때
Controller→Service→Repository순서로 역할이 나뉘는 가장 기본적인 흐름이다.
현재 프로젝트 구조 기준으로 파일 위치를 함께 보면 더 이해하기 쉽다.
예제 파일 위치는 아래처럼 볼 수 있다.
Member.java는domain/entity에 들어간다.MemberResponse.java는domain/dto에 들어간다.MemberRepository.java는repository에 들어간다.MemberService.java는service에 들어간다.MemberController.java는controller에 들어간다.먼저 저장 대상이 되는
Member객체를 본다.// Member.java public class Member { private Long id; // 회원 식별자 private String loginId; // 로그인 아이디 private String nickname; // 닉네임 public Member(Long id, String loginId, String nickname) { this.id = id; // 식별자 저장 this.loginId = loginId; // 로그인 아이디 저장 this.nickname = nickname; // 닉네임 저장 } public Long getId() { return id; // 식별자 반환 } public String getNickname() { return nickname; // 닉네임 반환 } }
Member는 회원이라는 저장 대상 데이터를 표현하는Entity예시이다.
실제 프로젝트에서JPA를 사용하면@Entity가 붙고,DB테이블과 매핑될 수 있다.
다음은 화면이나 응답에 필요한 데이터만 담는DTO이다.// MemberResponse.java public class MemberResponse { private Long id; // 응답에 필요한 회원 식별자 private String nickname; // 응답에 필요한 닉네임 public MemberResponse(Long id, String nickname) { this.id = id; // 식별자 저장 this.nickname = nickname; // 닉네임 저장 } public Long getId() { return id; // 식별자 반환 } public String getNickname() { return nickname; // 닉네임 반환 } }
MemberResponse는 응답에 필요한 값만 담는DTO이다.
여기서는loginId를 응답에 포함하지 않았다.
이처럼DTO를 사용하면 화면이나API에 필요한 값만 골라서 전달할 수 있다.
다음은 데이터를 가져오는Repository이다.// MemberRepository.java @Repository public class MemberRepository { public List<Member> findAll() { return List.of( new Member(1L, "member1", "이언덕"), new Member(2L, "member2", "김스프링") ); // 예시 회원 데이터 반환 } }이 예제의
Repository는 실제DB를 조회하지 않고 예시 데이터를 반환한다.
레이어드 구조의 흐름을 보기 위한 단순 예제이다.
실제 프로젝트에서는JPA,MyBatis,DAO등을 사용해서DB와 연결될 수 있다.
다음은 실제 처리 흐름을 담당하는Service이다.// MemberService.java @Service public class MemberService { private final MemberRepository memberRepository; // 저장소 의존 public MemberService(MemberRepository memberRepository) { this.memberRepository = memberRepository; // 생성자 주입 } public List<MemberResponse> findAll() { return memberRepository.findAll() .stream() .map(member -> new MemberResponse(member.getId(), member.getNickname())) .toList(); // Entity를 응답 DTO로 변환 } }
MemberService는Repository에서Member목록을 가져온다.
그리고 화면에 필요한 형태인MemberResponse로 바꾼다.
이 예제에서는 변환 정도만 하지만, 실제 프로젝트에서는 검증, 조건 판단, 여러 저장소 호출, 트랜잭션 처리 같은 흐름이 더 들어갈 수 있다.
마지막은 요청을 받는Controller이다.// MemberController.java @Controller public class MemberController { private final MemberService memberService; // 서비스 의존 public MemberController(MemberService memberService) { this.memberService = memberService; // 생성자 주입 } @GetMapping("/members") public String members(Model model) { model.addAttribute("members", memberService.findAll()); // 뷰에 전달할 데이터 저장 return "member/list"; // 뷰 이름 반환 } }이 구조에서
Controller는 요청을 받고,Service는 실제 처리 흐름을 조정하고,Repository는 데이터를 꺼낸다.
Member는 저장 대상인Entity이고,MemberResponse는 응답 데이터 전달용DTO이다.
즉, 같은 회원 기능 안에서도 객체마다 역할이 다르다.
Member는 저장되는 데이터이고,MemberResponse는 응답에 필요한 데이터만 담는다.
이 차이를 이해해야 나중에Entity와DTO를 섞어 쓰는 실수를 줄일 수 있다.
계층별 어노테이션은 역할을 드러낸다
스프링에서는 계층별 역할을 드러내기 위해
@Controller,@Service,@Repository같은 어노테이션을 자주 사용한다.
이 어노테이션들은 모두 스프링이 객체를 관리하게 만든다는 점에서는@Component계열로 볼 수 있다.
즉, 스프링 컨테이너에Bean으로 등록되는 대상이 된다.
하지만 이름을 다르게 쓰는 이유가 있다.
각 클래스가 어떤 역할을 맡는지 코드만 봐도 알 수 있게 하기 위해서이다.
@Controller가 붙으면 요청을 받는 계층이라는 뜻이 강하게 드러난다.
@Service가 붙으면 실제 기능 처리 흐름을 담당하는 계층이라는 뜻이 드러난다.
@Repository가 붙으면 데이터 접근 계층이라는 뜻이 드러난다.
정리하면 아래와 같다.
@Controller는 웹 요청을 받는 클래스에 붙인다.@Service는 비즈니스 로직과 처리 흐름을 담당하는 클래스에 붙인다.@Repository는 데이터 접근을 담당하는 클래스에 붙인다.
@Repository는 데이터 접근 계층에서 발생하는 예외를 스프링 예외 체계로 바꾸는 기능과도 연결될 수 있다.
다만 초보자 단계에서는 먼저 데이터 접근 역할을 드러내는 표시라고 이해하면 충분하다.
계층별 어노테이션은 단순히 스프링에 등록하기 위한 표시만이 아니라, 이 클래스가 어떤 역할을 맡는지 드러내는 표시이다.
그래서 같은Bean등록이라도 역할에 맞는 어노테이션을 붙이면 코드 구조를 훨씬 쉽게 읽을 수 있다.
레이어드 구조에서 헷갈리기 쉬운 점
레이어드 구조를 처음 배울 때는 파일이 나뉘어 있다는 사실만 보고 이해했다고 착각하기 쉽다.
하지만 중요한 것은 파일 개수가 아니라 책임 분리이다.
파일을 많이 나눈다고 무조건 좋은 구조가 되는 것은 아니다.
Controller안에 요청 처리, 비밀번호 검증, 회원 저장 규칙,DB조회 코드가 모두 들어 있다면 파일은 하나라서 단순해 보일 수 있다.
하지만 역할은 전부 섞여 있다.
반대로 파일이 여러 개로 나뉘어 있어도 각 파일의 역할이 불분명하면 좋은 구조라고 보기 어렵다.
Service가 아무 이유 없이 모든 일을 떠넘기기만 하거나,Repository가 비즈니스 판단을 하거나,DTO와Entity를 구분 없이 사용하면 구조가 다시 복잡해진다.
초보자 기준에서는 아래 기준으로 보면 된다.
- 화면 요청과 응답 흐름은
Controller에서 처리한다.- 실제 처리 규칙과 판단은
Service에서 처리한다.- 데이터 저장과 조회는
Repository또는DAO에서 처리한다.- 저장되는 핵심 데이터 객체는
domain/entity에 둔다.- 요청과 응답에 필요한 데이터 전달 객체는
domain/dto에 둔다.- 상태나 역할처럼 정해진 값 목록은
domain/enums에 둔다.- 공통 기반 코드는
core에 둘 수 있다.- 설정 코드는
config에 둔다.이 기준이 모든 프로젝트에서 완벽한 정답이라는 뜻은 아니다.
프로젝트마다 패키지 구조는 달라질 수 있다.
하지만 현재 프로젝트 구조를 읽을 때는 이 기준이 있어야 코드가 덜 헷갈린다.
레이어드 아키텍처의 핵심은 코드를 많이 나누는 것이 아니라, 역할이 다른 코드를 섞지 않는 것이다.
스프링 MVC와 Front Controller
모든 요청을 먼저 하나의 입구에서 받는다
스프링
MVC는Front Controller패턴을 사용한다.
Front Controller는 모든 요청을 각각의 컨트롤러가 바로 받는 것이 아니라, 먼저 하나의 공통 입구에서 받는 구조를 말한다.
스프링MVC에서는DispatcherServlet이 이 공통 입구 역할을 한다.
여기서Front Controller는 설계 패턴이고,DispatcherServlet은 그 패턴을 실제로 구현한 스프링의 객체라고 보면 된다.
즉, 둘은 완전히 같은 단어가 아니다.
Front Controller는 구조를 설명하는 말이고,DispatcherServlet은 그 구조에서 앞문 역할을 하는 실제 객체이다.
이 구조가 중요한 이유는 요청 흐름을 통일할 수 있기 때문이다.
모든 요청이 같은 입구를 지나면 공통 처리 규칙을 적용하기 쉽고, 요청 분배도 일정한 방식으로 정리할 수 있다.
그래서 스프링MVC는 요청 처리 구조가 비교적 일관되게 유지된다.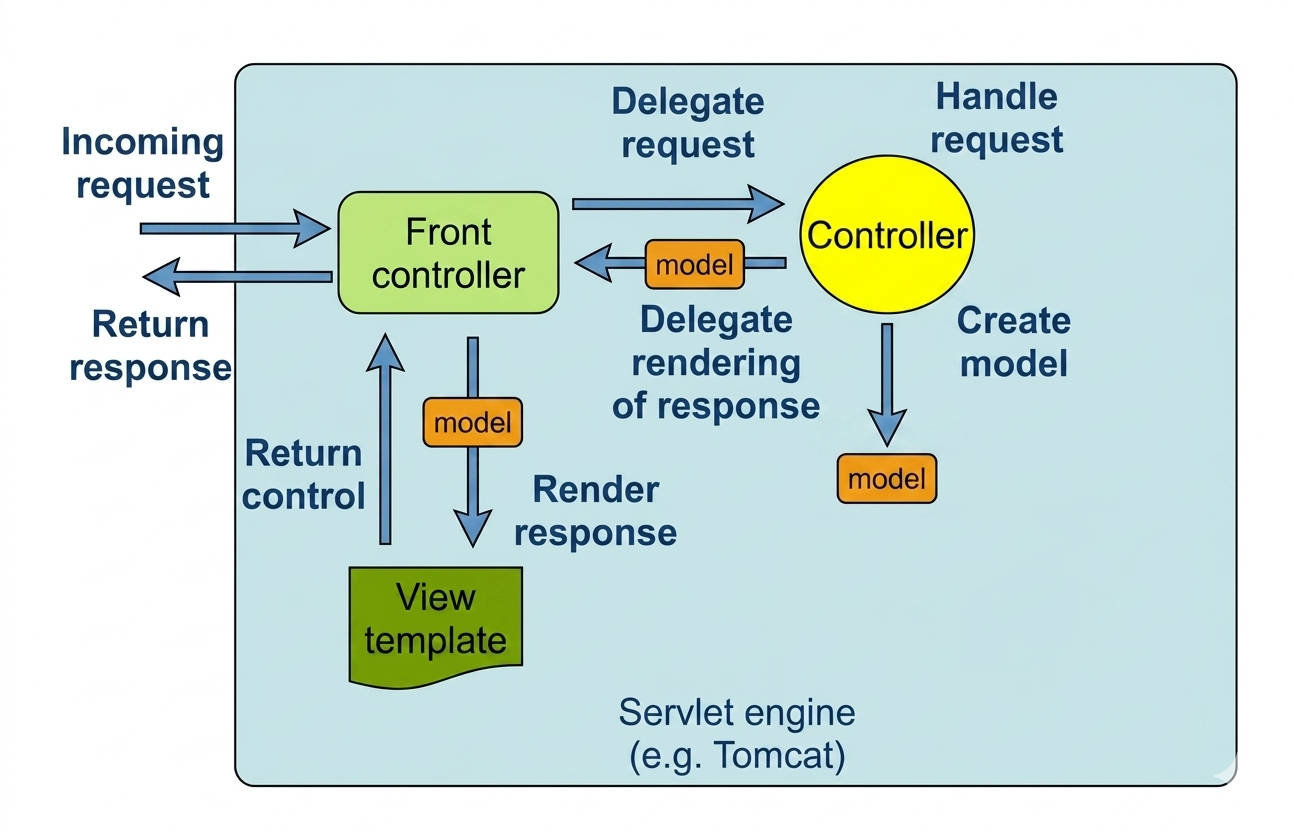
그림에서
Front Controller라고 표시된 부분이 바로 스프링MVC의DispatcherServlet역할이다.
즉, 여러 컨트롤러 앞에서 모든 요청을 먼저 받는 하나의 공통 입구 역할을 한다.
DispatcherServlet 안에서는 어떤 일이 일어나는가
DispatcherServlet은 스프링MVC에서 모든 웹 요청 처리 흐름을 총괄하는 중심 객체이다.
요청을 먼저 받고, 어떤 컨트롤러가 처리해야 할지 찾고, 실행 결과를 다음 단계로 넘긴다.
조금 더 자세히 보면 흐름은 아래처럼 움직인다.
DispatcherServlet이 요청을 받는다.HandlerMapping이 요청을 처리할 컨트롤러 메서드를 찾는다.HandlerAdapter가 찾은 컨트롤러 메서드를 실행한다.- 컨트롤러가 결과를 반환한다.
- 결과가 뷰 이름이면
ViewResolver를 통해 화면 파일을 찾는다.- 결과가 응답 데이터이면
MessageConverter를 통해 응답 본문을 만든다.즉,
DispatcherServlet은 요청을 받은 뒤 흐름을 총괄한다.
하지만 실제로는HandlerMapping,HandlerAdapter,ViewResolver,MessageConverter같은 구성요소와 함께 움직인다.
초보자는 이름을 외우는 것보다 먼저 순서를 잡는 것이 중요하다.
입구가 요청을 받는다 → 담당자를 찾는다 → 실행한다 → 결과를 화면이나 데이터 형태로 정리한다 → 응답한다는 흐름만 먼저 잡아도 이후 코드가 훨씬 쉽게 읽힌다.
일반 Controller의 요청 처리 흐름
내부에서는 이런 순서로 움직인다
일반
Controller는 보통 화면 응답을 만들 때 사용한다.
여기서 화면 응답이란 최종적으로 사용자가 볼HTML화면을 응답하는 흐름이다.
일반Controller가 최종HTML전체를 직접 문자열로 만들어 내는 것은 아니다.
보통은 어떤 화면을 보여 줄지에 대한 뷰 이름을 반환하고, 화면에 필요한 데이터는Model에 담는다.
그다음ViewResolver가 뷰 이름을 실제 화면 파일과 연결한다.
여기서Model은 컨트롤러가 뷰로 데이터를 넘기기 위해 사용하는 그릇이다.
예를 들어 회원 목록을 화면에 보여 주고 싶으면Controller는Model에 회원 목록 데이터를 담고,"member/list"같은 뷰 이름을 반환한다.
Thymeleaf를 사용하는 경우라면"member/list"라는 뷰 이름은 보통templates/member/list.html같은 파일과 연결될 수 있다.
즉, 컨트롤러가 반환하는 문자열은 최종 응답 문자열이 아니라 화면 파일을 찾기 위한 이름이다.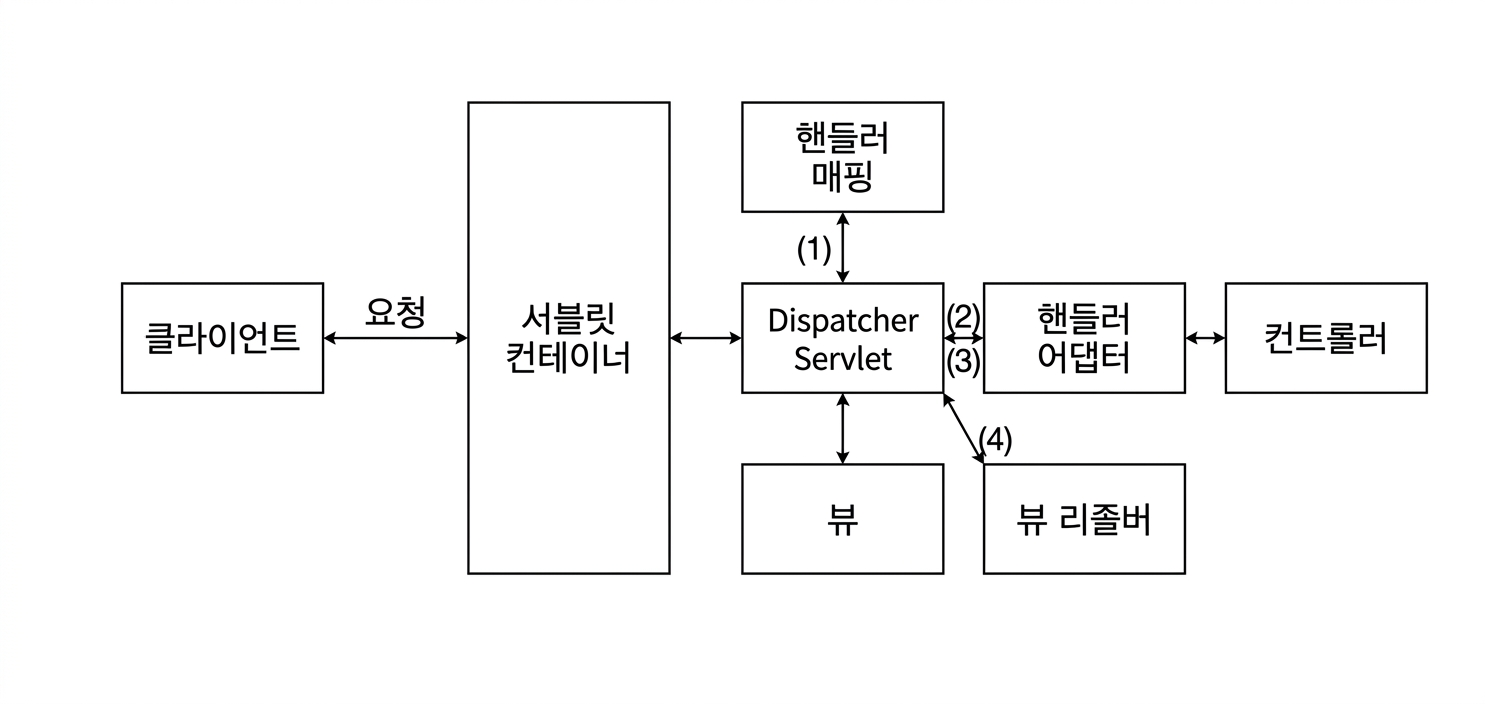
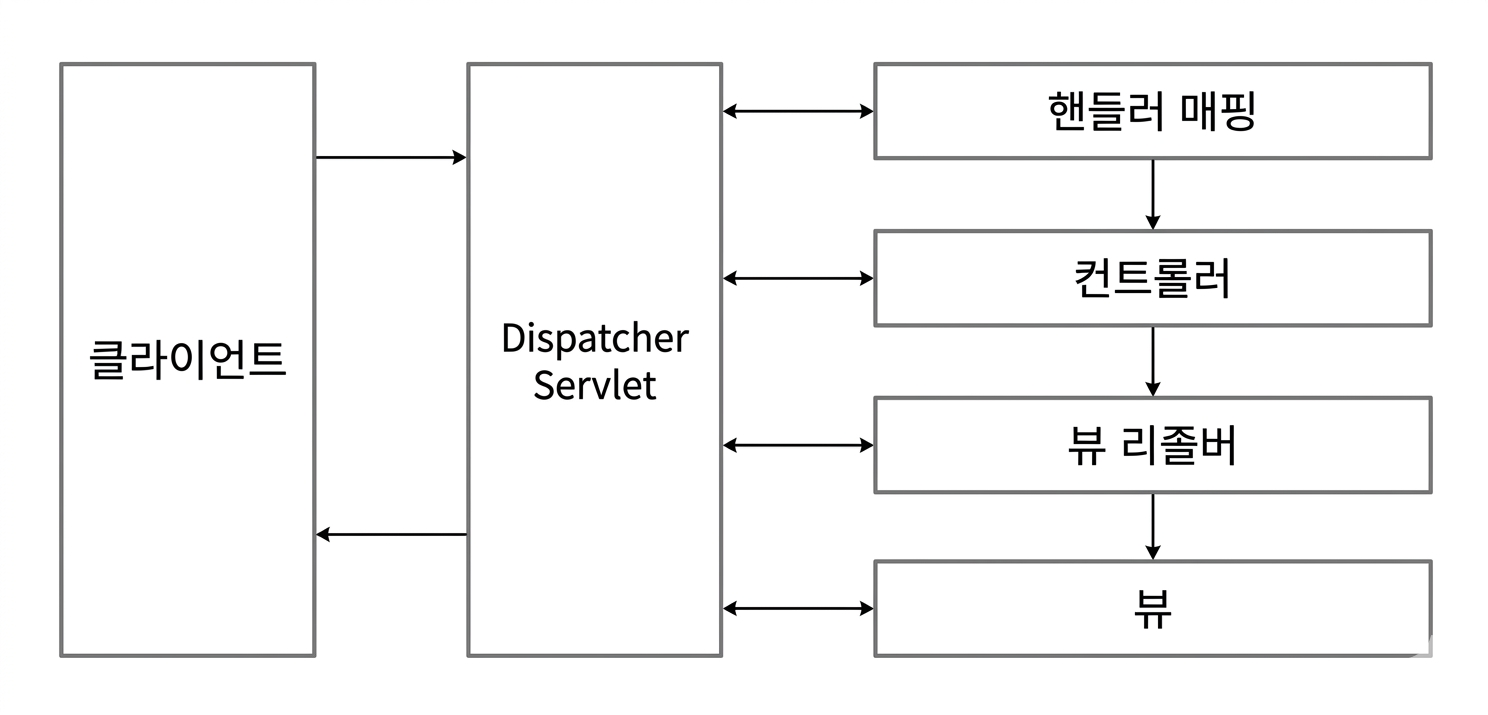
DispatcherServlet,HandlerMapping,HandlerAdapter,Controller,ViewResolver,View로 이어지는 스프링MVC의 상세 처리 순서를 보여 준다.
즉, 요청이 들어오면 누가 처리할지 찾고, 실행하고, 화면을 찾아 응답하는 흐름으로 이해하면 된다.
각 구성요소를 아주 쉽게 풀면
일반
Controller의 화면 응답 흐름은 여러 구성요소가 함께 움직인다.
이름이 어렵게 느껴질 수 있지만, 각 역할을 요청 흐름에 맞춰 보면 훨씬 쉽다.
HandlerMapping은 누가 처리할지 찾는다.HandlerAdapter는 찾은 컨트롤러 메서드를 실제로 실행할 수 있게 연결한다.Controller는 요청을 처리하고 뷰 이름과 데이터를 준비한다.Model은 뷰에 전달할 데이터를 담는다.ViewResolver는 화면 이름을 실제 화면 파일과 연결한다.View는 최종적으로 사용자에게 보여 줄HTML화면을 만든다.예를 들어
/members요청이 들어오면HandlerMapping은 이 요청을 처리할MemberController.members()메서드를 찾는다.
HandlerAdapter는 그 메서드를 실행할 수 있게 도와준다.
MemberController는Model에 회원 목록을 담고"member/list"라는 뷰 이름을 반환한다.
그다음ViewResolver가"member/list"를 실제 화면 파일과 연결한다.
여기서 특히ViewResolver가 중요하다.
컨트롤러는 보통 화면 이름만 넘기고, 실제 어떤 화면 파일을 연결할지는ViewResolver가 결정한다.
즉, 컨트롤러와 실제 화면 파일 사이를 이어 주는 중간 연결자라고 보면 된다.
앞에서 본/hello예제를 다시 떠올려 보면, 브라우저가/hello를 요청했을 때DispatcherServlet이 먼저 받고,HandlerMapping이HelloController의hello()를 찾고,HandlerAdapter가 그것을 실행한다.
그리고"hello"라는 반환값을ViewResolver가 실제hello.html과 연결한다.
즉, 짧은 컨트롤러 코드 안에서도 스프링MVC내부 흐름이 이미 움직이고 있다.
일반
Controller에서DispatcherServlet,HandlerMapping,Controller,ViewResolver,View로 이어지는 처리 구조를 보여 준다.
즉, 일반Controller는 데이터를Model에 담아 뷰로 넘기고, 그다음 화면을 찾아 응답하는 흐름으로 이해하면 된다.
RestController의 처리 흐름
뷰를 찾지 않고 데이터를 바로 응답한다
RestController는 일반Controller와 다르게 움직인다.
일반Controller가 주로 뷰 이름을 반환해 화면을 찾는 흐름이라면,RestController는 반환값을 응답 본문에 바로 담는 흐름이다.
@RestController는@Controller와@ResponseBody가 합쳐진 형태로 이해할 수 있다.
@ResponseBody는 반환값을 뷰 이름으로 해석하지 않고 응답 본문에 넣겠다는 뜻이다.
그래서RestController에서는 메서드가 반환한 값이 화면 이름이 아니라 클라이언트에게 보낼 데이터가 된다.
예를 들어 문자열을 반환하면 그 문자열이 응답 본문으로 나간다.
자바 객체를 반환하면 보통JSON같은 형식으로 바뀌어 응답 본문에 담긴다.
이 변환을 담당하는 것이HttpMessageConverter이다.
MessageConverter는 자바 객체를 브라우저나 클라이언트가 읽을 수 있는 응답 데이터 형식으로 바꿔 주는 도구이다.
쉽게 말하면 응답용 번역기 같은 역할이다.
예를 들어 자바 객체를JSON형태로 바꿔서 응답 본문에 담아 주는 일이 여기서 일어난다.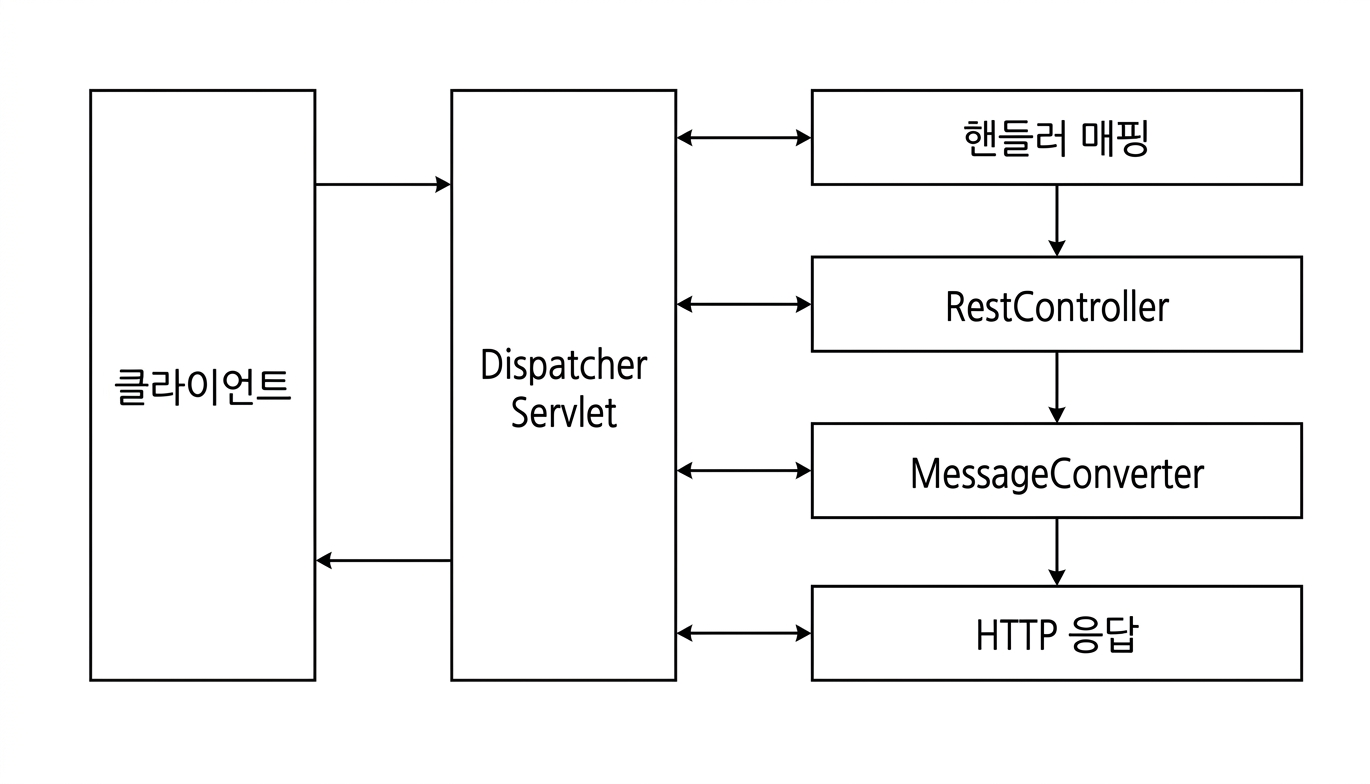
DispatcherServlet부터HandlerMapping,RestController,MessageConverter,HTTP응답까지 이어지는 처리 흐름을 보여 준다.
즉,RestController는 뷰를 찾지 않고 데이터를 바로 응답 본문으로 보내는 구조이다.
일반 Controller와 RestController를 코드로 비교하면
일반
Controller와RestController는 둘 다 메서드에서String을 반환할 수 있다.
하지만 같은String이라도 의미가 다르다.
일반Controller에서 반환하는String은 보통 뷰 이름이고,RestController에서 반환하는String은 응답 본문이다.
먼저 일반Controller에서 화면을 반환하는 예를 보자.// PageController.java @Controller public class PageController { @GetMapping("/page-hello") // 화면 요청 public String hello(Model model) { model.addAttribute("msg", "안녕하세요"); // 뷰에 전달할 데이터 저장 return "hello"; // 뷰 이름 반환 } }// hello.html <!DOCTYPE html> <html xmlns:th="http://www.thymeleaf.org"> <head> <meta charset="UTF-8"> <title>hello</title> </head> <body> <h1 th:text="${msg}"></h1> </body> </html>이 예제에서
"hello"는 응답 본문이 아니다.
스프링은"hello"를 뷰 이름으로 보고, 실제hello.html화면 파일을 찾아 응답한다.
이번에는 일반Controller에서@ResponseBody를 붙여 데이터를 바로 응답하는 예를 보자.// BodyController.java @Controller public class BodyController { @ResponseBody @GetMapping("/body-hello") // 데이터 요청 public String hello() { return "안녕하세요"; // 응답 본문으로 반환 } }// 출력결과 // 안녕하세요일반
Controller라도@ResponseBody가 붙으면 반환값을 뷰 이름으로 보지 않는다.
반환값을 그대로 응답 본문에 담는다.
마지막으로RestController를 보자.// ApiController.java @RestController public class ApiController { @GetMapping("/api-hello") // 데이터 요청 public String hello() { return "안녕하세요"; // 응답 본문으로 바로 반환 } }// 출력결과 // 안녕하세요
RestController는 모든 메서드에@ResponseBody가 붙은 것처럼 동작한다고 이해하면 된다.
그래서 반환값을 뷰 이름으로 해석하지 않고 응답 본문으로 보낸다.
객체를 반환하는 예도 볼 수 있다.// MemberApiController.java @RestController public class MemberApiController { @GetMapping("/api/members/1") // 회원 데이터 요청 public MemberResponse member() { return new MemberResponse(1L, "이언덕"); // 객체를 응답 데이터로 반환 } }// 출력결과 // { // "id": 1, // "nickname": "이언덕" // }이 예제에서
MemberResponse객체는MessageConverter를 통해JSON형식으로 바뀌어 응답 본문에 담긴다.
즉,RestController는 화면을 찾는 흐름이 아니라 데이터를 응답하는 흐름이다.
같은String반환이라도 일반Controller에서는 뷰 이름이 될 수 있고,RestController에서는 응답 본문이 된다.
이 차이를 반드시 잡아야 스프링MVC요청 흐름을 헷갈리지 않는다.
스프링 MVC 요청 흐름을 한 번 더 정리하기
단계별로 다시 보면
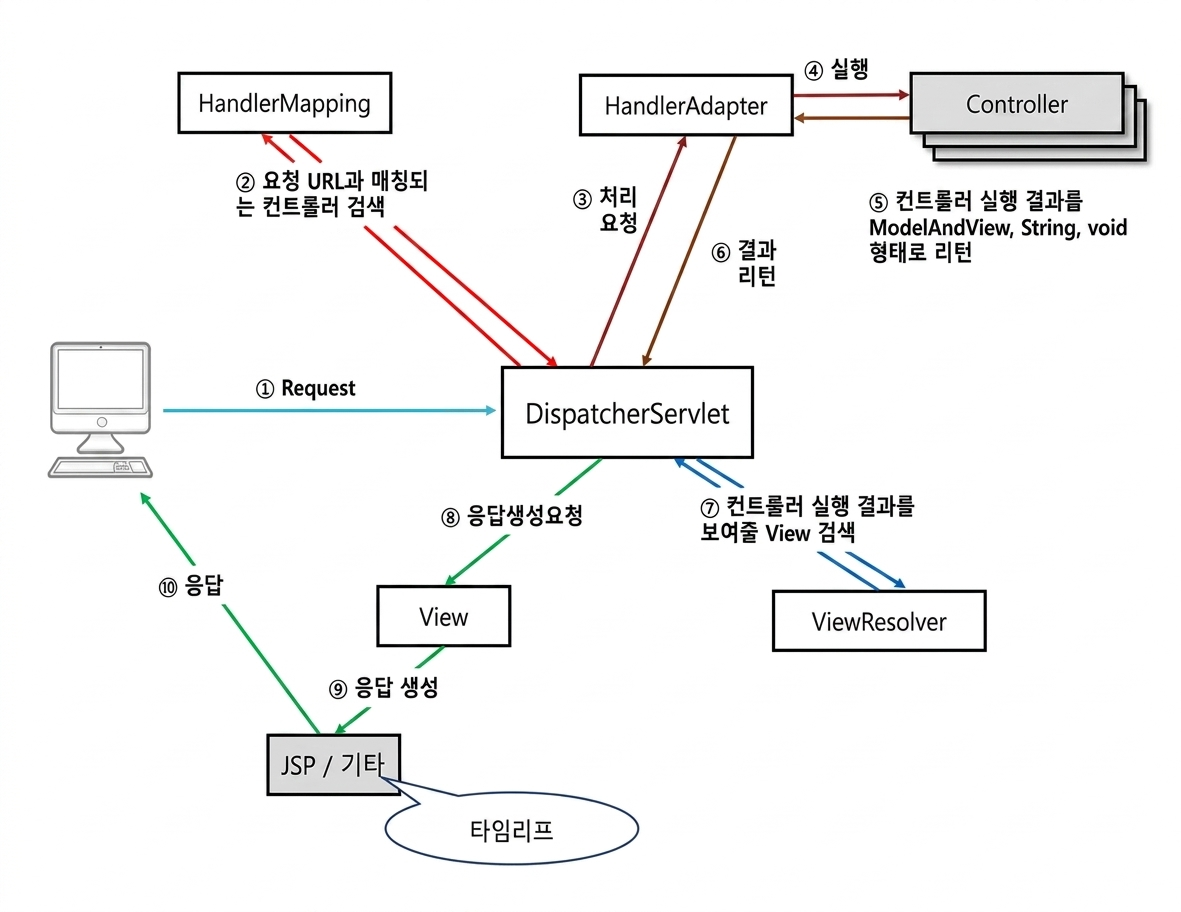
DispatcherServlet이 요청을 받아HandlerMapping,HandlerAdapter,Controller,ViewResolver,View와 연결되는 스프링MVC동작 순서를 단계별로 보여 준다.
즉, 요청이 들어오면 누가 처리할지 찾고, 실행하고, 결과를 화면이나 데이터로 응답하는 흐름이 정해진 구조 안에서 반복된다.
지금까지 본 내용을 합치면 스프링MVC요청 흐름은 크게 두 가지로 나누어 볼 수 있다.
하나는 화면을 응답하는 일반Controller흐름이고, 다른 하나는 데이터를 응답하는RestController흐름이다.
먼저 일반 화면 응답 흐름은 아래처럼 볼 수 있다.
브라우저 요청 →DispatcherServlet→HandlerMapping→HandlerAdapter→Controller→Service→Repository→DB→Repository→Service→Controller→Model→ViewResolver→View→HTML응답
이 흐름에서Controller는 요청을 받고Service를 호출한다.
Service는 필요한 처리 흐름을 담당하고,Repository는DB에 접근한다.
처리 결과는 다시Controller로 돌아오고,Controller는Model에 데이터를 담은 뒤 뷰 이름을 반환한다.
그다음ViewResolver가 실제 화면 파일을 찾고, 최종HTML응답이 만들어진다.
데이터 응답 흐름은 아래처럼 볼 수 있다.
브라우저 요청 →DispatcherServlet→HandlerMapping→HandlerAdapter→RestController→Service→Repository→DB→Repository→Service→RestController→MessageConverter→ 응답 본문
이 흐름에서는 뷰를 찾지 않는다.
RestController가 반환한 값은MessageConverter를 거쳐 응답 본문으로 나간다.
객체를 반환하면 보통JSON형식으로 바뀌어 응답된다.
여기서도domain내부 객체들이 함께 사용된다.
요청값은domain/dto의Request DTO로 받을 수 있고, 저장 대상은domain/entity의Entity로 표현할 수 있다.
회원 상태나 역할은domain/enums의enum으로 표현할 수 있고, 응답값은Response DTO로 바꿔 보낼 수 있다.
다만domain은 흐름 중간에서 독립적으로 호출되는 단계가 아니다.
Controller,Service,Repository흐름 안에서 사용되는 데이터 타입 영역이다.
이 차이를 알아야 프로젝트 구조를 정확히 읽을 수 있다.
여기서 초보자가 꼭 기억해야 할 것은 이름이 아니라 순서이다.
요청을 받는다 → 처리할 대상을 찾는다 → 실행한다 → 계층별로 역할을 나누어 처리한다 → 결과를 화면이나 데이터로 응답한다는 흐름만 잡아도 이후 코드가 훨씬 쉽게 읽힌다.
여기서 먼저 정리해야 할 핵심
웹 요청 처리 구조를 한 번에 묶어 보면
- 웹 애플리케이션은
HTTP Request와HTTP Response로 동작한다.- 브라우저는 보통
DB에 직접 접근하지 않고, 서버가 필요할 때DB에 접근한다.Tier는 물리 구조이고,Layer는 역할 구조이다.- 스프링 프로젝트의
controller,service,repository,domain분리는 서버 분리가 아니라 코드 역할 분리이다.- 개념적으로 웹 서버는 정적인 자원 전달 쪽,
WAS는 자바 웹 애플리케이션 실행 쪽으로 이해하면 된다.Servlet Container는Servlet을 관리하고, 스프링 컨테이너는 스프링Bean을 관리한다.- 스프링
MVC에서는 모든 요청을 먼저DispatcherServlet이 받는다.DispatcherServlet은HandlerMapping,HandlerAdapter,ViewResolver,MessageConverter와 함께 요청을 처리한다.controller는 요청과 응답의 입구이다.service는 실제 기능 처리 흐름을 담당한다.repository는DB접근을 담당한다.domain/entity는DB테이블과 매핑되어 저장되는 핵심 데이터 객체를 담는다.domain/dto는 요청과 응답 데이터를 전달하는 객체를 담는다.domain/enums는 상태나 역할처럼 정해진 값 목록을 담는다.core는 공통 기반 코드를 담는다.config는 프로젝트 설정 코드를 담는다.- 일반
Controller는 보통 뷰 이름을 반환하고,Model로 화면에 필요한 데이터를 넘긴다.RestController는 뷰를 찾지 않고 응답 본문을 반환한다.MessageConverter는 자바 객체를JSON같은 응답 형식으로 바꿔 준다.이 흐름이 잡히면 나중에
@Controller,@RequestMapping,Model,@RestController,DTO,Entity,Repository가 왜 필요한지 훨씬 쉽게 이해된다.
즉, 지금 이 파트는 단순히 요청 처리 순서를 외우는 구간이 아니라, 스프링 웹 코드가 왜 그런 구조로 짜이는지 이해하는 구간이다.
스프링 웹 요청 흐름과 레이어드 구조는 따로 외우는 것이 아니라, 하나의 요청 처리 흐름 안에서 함께 봐야 한다.
브라우저 요청은DispatcherServlet을 거쳐Controller로 들어오고, 실제 기능 처리는Service, 데이터 접근은Repository, 데이터 표현은domain내부 객체들이 맡는다.
이 전체 흐름이 보이면 스프링 프로젝트 구조가 훨씬 덜 복잡하게 느껴진다.