1. 생성된 스프링 부트 프로젝트 기동
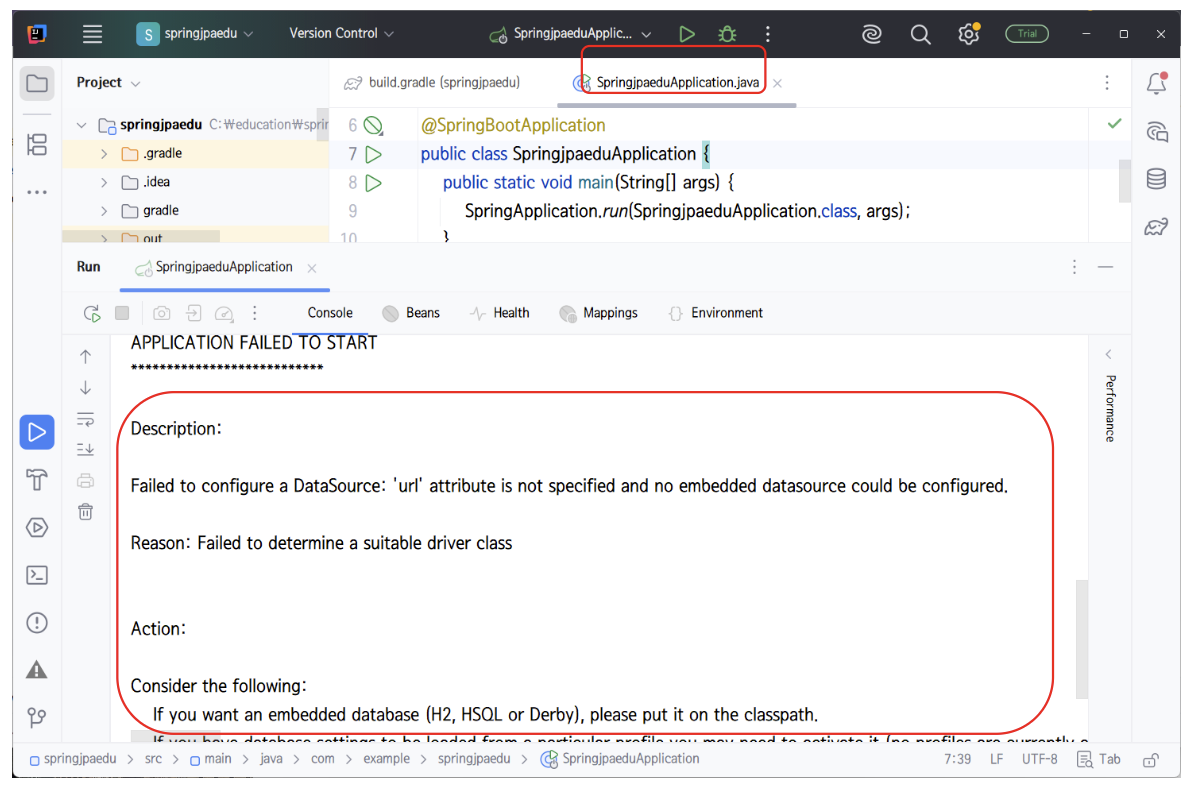
Spring Data JPA의존성이 들어간Spring Boot프로젝트는 처음 실행할 때 데이터베이스 연결 설정을 함께 확인한다.
JPA는 엔티티 객체를 데이터베이스 테이블과 연결해서 사용하는 기술이다.
그래서Spring Boot는 이 프로젝트가 데이터베이스를 사용할 가능성이 있다고 판단하고, 실행 과정에서 데이터베이스 연결에 필요한DataSource를 자동으로 만들려고 한다.
여기서DataSource는 데이터베이스 연결 정보를 바탕으로 실제 데이터베이스 연결을 제공하는 객체이다.
애플리케이션은DataSource를 통해 필요한 순간 데이터베이스와 연결된다.
따라서Spring Data JPA를 사용하려면DataSource가 필요하고,DataSource를 만들려면 데이터베이스 주소, 계정, 비밀번호, 드라이버 정보가 필요하다.
아직 데이터베이스 접속 정보가 준비되지 않았다면Spring Boot는 어떤 데이터베이스에 연결해야 하는지 알 수 없다.
그래서 애플리케이션 실행 도중DataSource설정 오류가 발생한다.
이 흐름을 먼저 이해해야 이후의 임시 설정과 실제DB연결 설정이 자연스럽게 이어진다.
DataSource 설정 오류가 나는 이유
Spring Data JPA의존성이 있으면Spring Boot는 데이터베이스 연결을 위한DataSource를 자동 설정하려고 한다.
자동 설정은 개발자가 모든 설정을 직접 작성하지 않아도Spring Boot가 필요한 설정을 미리 구성해 주는 기능이다.
하지만 자동 설정도 아무 정보 없이 동작할 수는 없다.
application.properties에 데이터베이스 주소, 계정, 비밀번호, 드라이버 정보가 없으면Spring Boot는 어떤 데이터베이스를 사용해야 하는지 알 수 없다.
그래서DataSource를 만들지 못하고 프로젝트 실행을 중단한다.
이 오류는 프로젝트 생성이 잘못됐다는 뜻이 아니다.
Spring Data JPA를 사용하기 위한 데이터베이스 연결 정보가 아직 없다는 뜻이다.
즉, 오류의 핵심은 코드 문제가 아니라DB연결 설정이 비어 있다는 점이다.
DataSource정보가 없으면Spring Boot는 어떤 데이터베이스에 연결해야 하는지 알 수 없다.
그래서url속성이나 드라이버 클래스를 찾지 못하고 애플리케이션 실행을 멈춘다.
이 단계에서 중요한 점은 오류 메시지를 무조건 실패로만 보는 것이 아니다.
Spring Data JPA프로젝트는 데이터베이스 연결 설정이 필요하다는 흐름을 먼저 확인하는 단계로 보면 된다.
DataSourceAutoConfiguration을 임시로 제외하는 이유
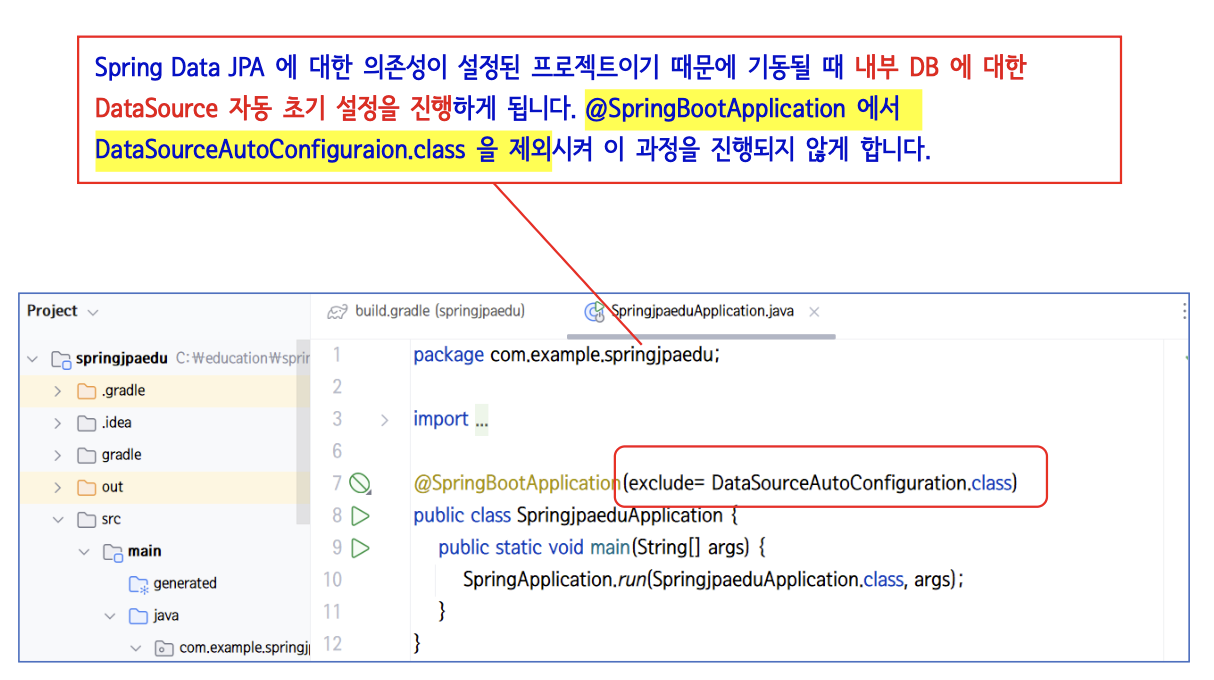
아직 데이터베이스 연결 설정을 작성하지 않은 상태에서도 프로젝트 뼈대가 정상적으로 실행되는지는 확인할 수 있다.
이때 사용하는 임시 설정이DataSourceAutoConfiguration제외이다.
DataSourceAutoConfiguration은Spring Boot가DataSource를 자동으로 구성하도록 도와주는 자동 설정이다.
하지만 지금은 데이터베이스 연결 정보가 없기 때문에 이 자동 설정이 실행 과정에서 오류를 만든다.
그래서@SpringBootApplication(exclude = DataSourceAutoConfiguration.class)처럼 작성해DataSource자동 설정을 잠시 제외한다.
이 설정은 최종 설정이 아니라 임시 설정이다.
데이터베이스 기능을 사용하지 않겠다는 뜻이 아니다.
실제JPA기능을 사용하려면 다시DB연결 정보를 작성하고, 제외 설정도 제거해야 한다.
DataSourceAutoConfiguration을 제외하면Spring Boot가 데이터베이스 연결 객체를 자동으로 만들려는 과정을 잠시 멈춘다.
그래서 데이터베이스 설정이 없어도 프로젝트 실행 여부를 먼저 확인할 수 있다.
이 흐름을 알면 자동 설정 제외가 왜 필요한지 이해하기 쉽다.
데이터베이스 기능을 포기하는 것이 아니라, 설정 전 단계에서 프로젝트 실행 상태만 먼저 확인하는 것이다.
자동 설정 제외 후 실행 확인
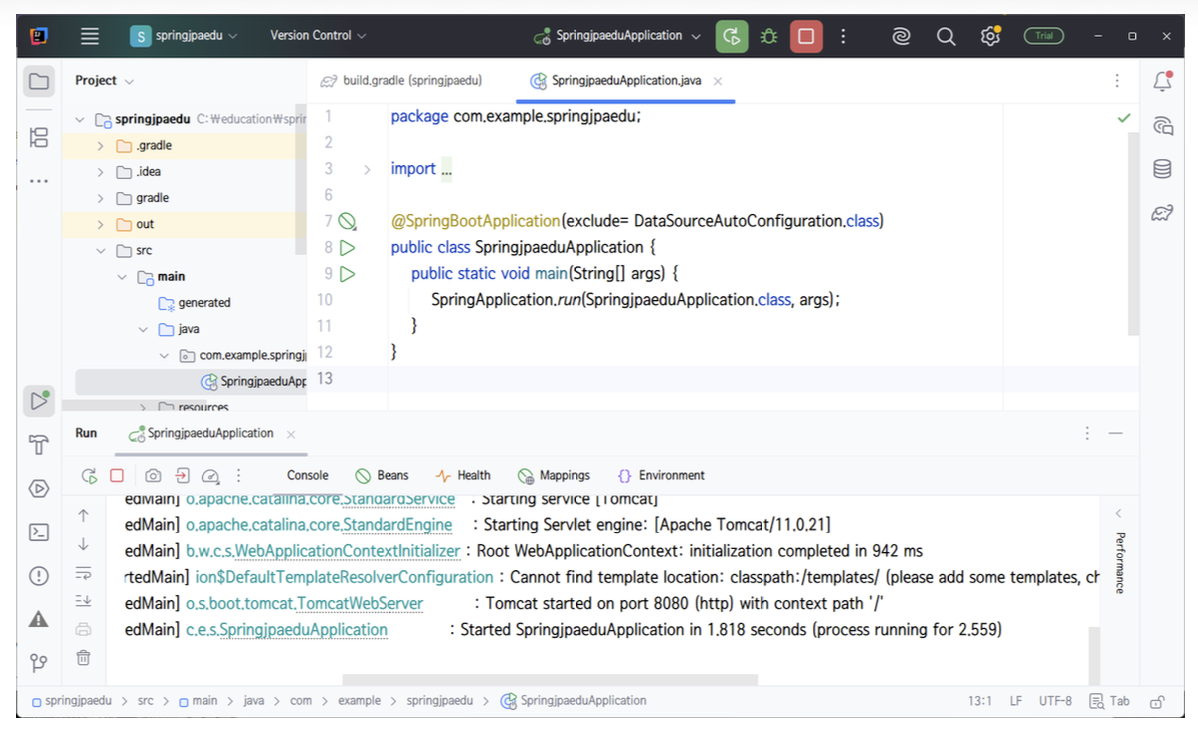
DataSourceAutoConfiguration을 제외한 뒤 프로젝트를 다시 실행하면 데이터베이스 연결 설정이 없어도 애플리케이션이 시작될 수 있다.
이때 확인할 핵심은 콘솔 로그이다.
콘솔에Tomcat started on port 8080이 보이면 내장Tomcat서버가 정상적으로 시작된 것이다.
Started SpringjpaeduApplication이 보이면Spring Boot애플리케이션도 실행된 것이다.
여기서 말하는 실행 성공은 데이터베이스 기능까지 성공했다는 뜻이 아니다.
데이터베이스 자동 설정을 잠시 제외했기 때문에, 이 단계에서는 프로젝트 뼈대와 서버가 정상적으로 올라오는지만 확인한다.
templates폴더가 없다는 안내 메시지가 함께 나올 수 있다.
이 메시지는 지금 단계에서 치명적인 오류가 아니다.
아직 화면 템플릿을 만들지 않았기 때문에 나오는 안내로 이해하면 된다.
Tomcat시작 로그와 애플리케이션 시작 로그가 보이면 프로젝트 뼈대는 정상적으로 실행된 상태이다.
아직 데이터베이스 기능을 확인한 것은 아니고,Spring Boot애플리케이션 자체가 실행 가능한지만 확인한 것이다.
이 단계에서는 서버 실행 성공과 데이터베이스 기능 성공을 구분해야 한다.
서버가 실행됐다고 해서 데이터베이스 연결까지 완성된 것은 아니다.
실행 성공과 화면 표시 성공은 다르다
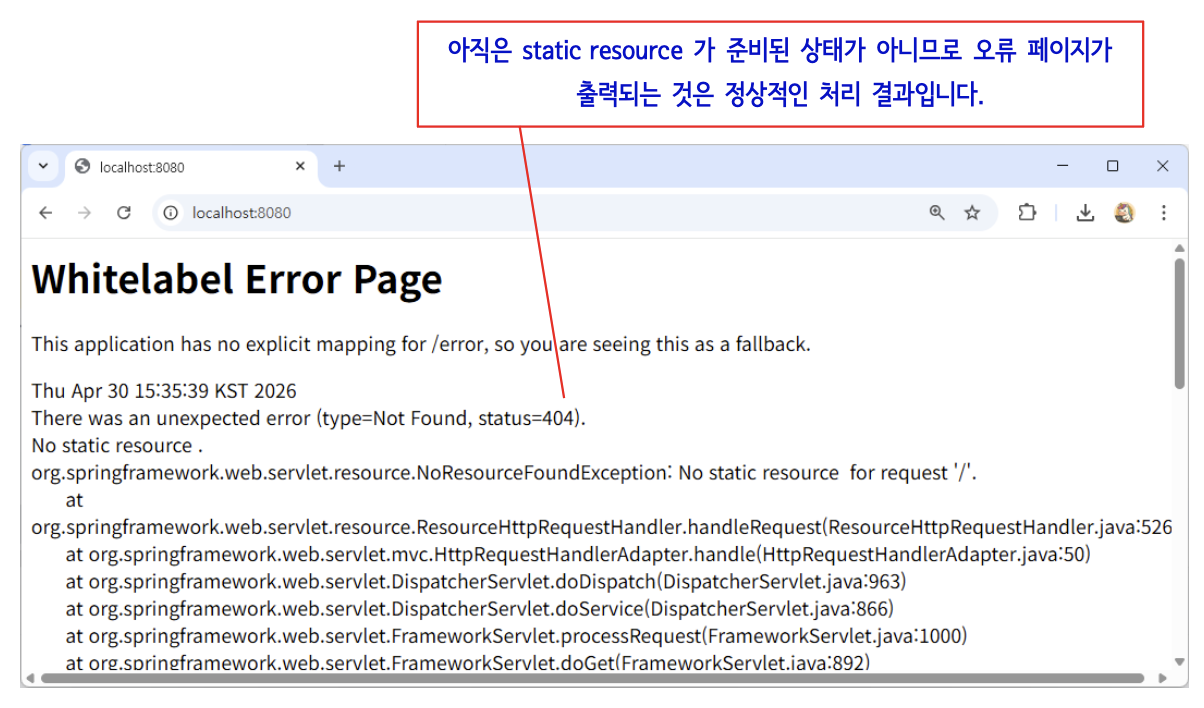
프로젝트가 정상 실행됐다고 해서 브라우저에 보여 줄 화면이 자동으로 생기는 것은 아니다.
브라우저에서localhost:8080에 접속하면 기본적으로/경로로 요청이 들어간다.
그런데 아직/요청을 처리할Controller가 없고, 기본 정적 리소스도 없다면Spring Boot는 보여 줄 대상을 찾지 못한다.
이때Whitelabel Error Page가 출력될 수 있다.
여기서 보이는404는 애플리케이션이 꺼졌다는 뜻이 아니다.
요청을 처리할 경로나 파일이 없다는 뜻이다.
콘솔 실행 성공과 브라우저 화면 출력 성공은 서로 다른 문제이다.
애플리케이션은 실행 중이지만
/경로를 처리할Controller나 정적 리소스가 없으면 기본 오류 페이지가 출력된다.
따라서Whitelabel Error Page가 보인다고 해서 항상 서버 실행 실패로 판단하면 안 된다.
이 흐름을 알고 있어야 이후에 화면이 안 보일 때 원인을 나누어 생각할 수 있다.
서버 실행 문제인지, 요청 경로 문제인지, 화면 파일 문제인지 구분해야 한다.
실제 데이터베이스와 JPA 연결 설정
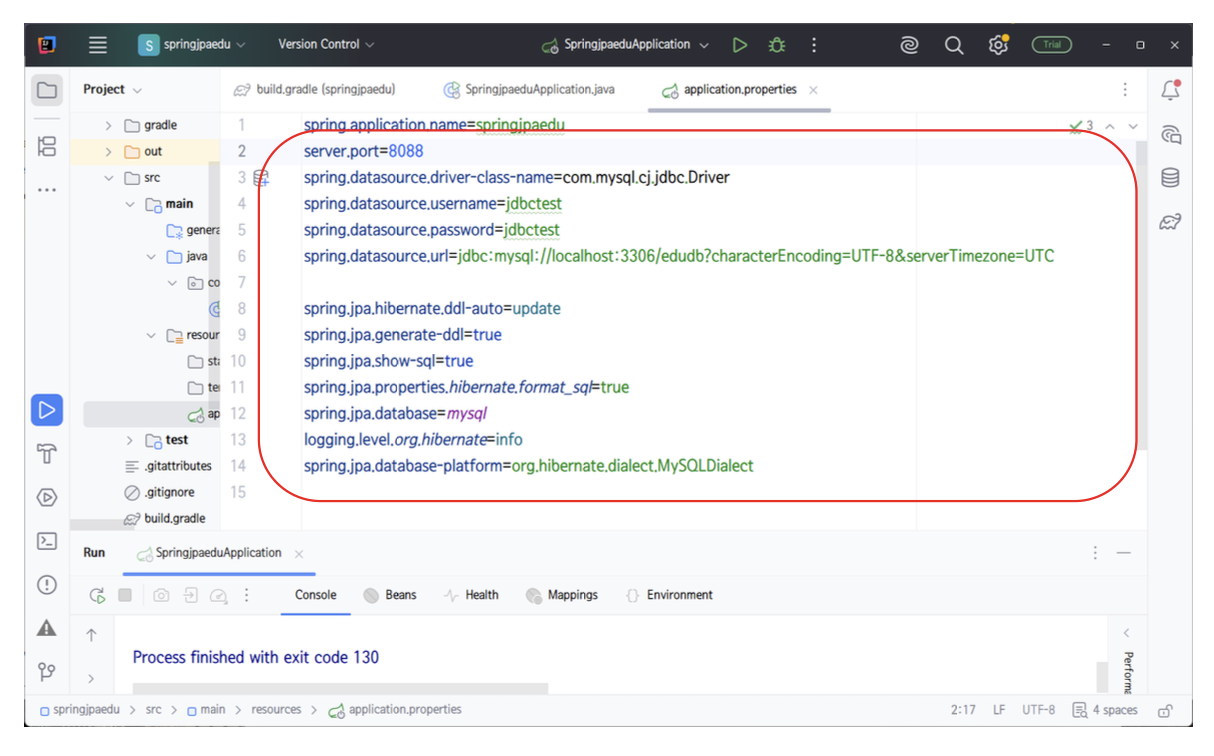
프로젝트 뼈대 실행을 확인한 뒤에는 서버를 종료하고 실제 데이터베이스 연결 설정을 진행한다.
앞에서 임시로 추가했던DataSourceAutoConfiguration제외 설정은 제거해야 한다.
이제는Spring Boot가 정상적으로DataSource를 만들 수 있도록 데이터베이스 정보를 직접 작성해야 한다.
application.properties에는 서버 포트, 데이터베이스 연결 정보,JPA와Hibernate설정을 작성한다.
server.port는 애플리케이션이 사용할 포트 번호를 정한다.
driver-class-name은 사용할 데이터베이스 드라이버를 지정한다.
username과password는 데이터베이스 접속 계정 정보이다.
url은 접속할 데이터베이스 주소와 데이터베이스 이름을 의미한다.
spring.jpa.hibernate.ddl-auto=update는 엔티티 구조를 기준으로 테이블 구조를 갱신할 때 사용한다.
실습 단계에서는 엔티티 변경 사항을 테이블에 반영하기 위해 자주 사용하지만, 실제 운영 환경에서는 조심해서 사용해야 한다.
spring.jpa.show-sql=true는 실행되는SQL을 콘솔에 출력하게 한다.
spring.jpa.database-platform은 사용할 데이터베이스 종류에 맞는Hibernate방언을 지정한다.
여기서 방언은 데이터베이스마다 조금씩 다른SQL문법을Hibernate가 맞춰서 사용하게 해주는 설정이다.
application.properties에 데이터베이스 연결 정보가 있어야Spring Boot가DataSource를 만들 수 있다.
JPA와Hibernate설정까지 함께 작성하면 엔티티와 테이블을 연결하고, 실행되는SQL도 콘솔에서 확인할 수 있다.
이 설정을 기준으로Spring Data JPA는 실제 데이터베이스와 연결된다.
앞에서 임시로 자동 설정을 제외했던 단계와 달리, 이제는 데이터베이스를 사용하는 정상 실행 흐름으로 넘어간다.
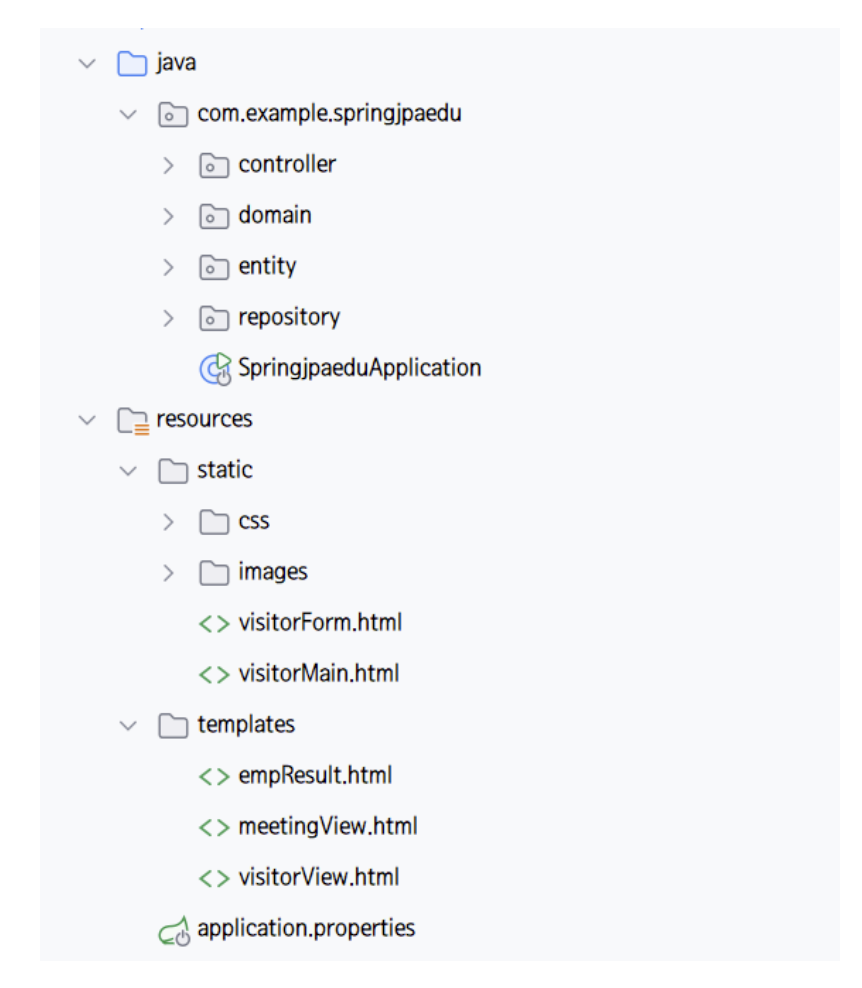
프로젝트 구조 확인
데이터베이스 설정을 마친 뒤에는 프로젝트 구조를 확인해야 한다.
Spring Data JPA프로젝트는 파일을 아무 곳에나 만들면 나중에 흐름을 이해하기 어렵다.
그래서 역할별로 패키지를 나누어 둔다.
패키지는 비슷한 역할을 하는 파일을 모아 두는 폴더라고 생각하면 된다.
예를 들어 요청을 받는 코드는controller에 두고, 실제 기능을 처리하는 코드는service에 둔다.
데이터베이스와 연결되는 객체는entity에 두고, 데이터베이스에 접근하는 코드는repository에 둔다.
프로젝트 구조를 나누는 이유는 각 코드가 맡는 일을 분명하게 나누기 위해서이다.
모든 코드를 한 클래스에 넣으면 처음에는 편해 보일 수 있다.
하지만 기능이 늘어나면 요청 처리 코드, 기능 처리 코드, 데이터 저장 코드가 한곳에 섞인다.
그러면 어디를 고쳐야 하는지 찾기 어려워진다.
그래서Spring Boot프로젝트에서는 보통controller,domain,service,entity,repository,resources처럼 역할별로 나누어 관리한다.
이제 각 패키지가 어떤 역할을 하는지 하나씩 확인한다.
controller 패키지
controller는 사용자의 요청을 가장 먼저 받는 곳이다.
사용자가 브라우저에서 주소를 입력하거나 버튼을 누르면 서버로 요청이 들어온다.
그 요청을 받아서 어떤 기능을 실행할지 연결하는 역할을controller가 한다.
예를 들어 회원가입 버튼을 누르면 회원가입 요청이 서버로 들어온다.
이때controller는 요청 값을 받고, 회원가입 기능을 실행하기 위해service를 호출한다.
여기서 중요한 점은controller가 모든 일을 직접 하지 않는다는 것이다.
controller는 요청을 받는 입구 역할을 한다.
아이디 중복 확인, 비밀번호 처리, 회원 저장 같은 실제 기능 흐름은service에 맡긴다.
정리하면controller는 아래 역할을 맡는다.
- 사용자의 요청을 받는다.
- 요청 주소와 실행할 메서드를 연결한다.
- 요청으로 들어온 값을 받는다.
- 필요한 기능을 처리하기 위해
service를 호출한다.- 처리 결과를 화면이나 응답 데이터로 돌려준다.
쉽게 말하면
controller는 “어떤 요청이 들어왔는지 확인하고, 그 요청을 처리할 곳으로 넘겨주는 입구”이다.
service 패키지
service는 실제 기능 처리 흐름을 담당하는 곳이다.
controller가 요청을 받는 입구라면,service는 그 요청을 실제 기능으로 처리하는 중심부이다.
예를 들어 회원가입 요청을 생각해 보면 된다.
controller는 사용자가 입력한 아이디, 비밀번호, 이름 같은 값을 받는다.
하지만 그 값을 어떻게 검사하고, 어떤 순서로 저장할지는service가 처리한다.
회원가입 기능에서는 다음과 같은 흐름이 필요할 수 있다.
- 아이디가 이미 존재하는지 확인한다.
- 비밀번호를 저장 가능한 형태로 처리한다.
- 회원 정보를 담은
entity객체를 만든다.- 데이터베이스에 저장하기 위해
repository를 호출한다.이런 흐름은 단순히 요청을 받는 일이 아니다.
하나의 기능이 실제로 실행되는 과정이다.
그래서controller가 아니라service에 두는 것이 자연스럽다.
service는 직접 데이터베이스에 접근하지 않는다.
데이터베이스에 저장하거나 조회해야 할 때는repository를 호출한다.
즉,service는 기능의 순서를 담당하고,repository는 데이터베이스 작업을 담당한다.
service는 기능의 전체 흐름과 규칙을 담당하는 계층이다.
프로젝트를 진행할 때는controller에서 바로repository를 호출하기보다, 중간에service를 두면 구조가 더 깔끔해진다.
domain 패키지
domain은 프로젝트에서 사용하는 데이터 표현 객체를 정리하는 영역이다.
현재 구조에서는service가domain안에 들어가는 것이 아니다.
service는 별도 패키지이고,domain은 주로 요청, 응답, 값 표현에 필요한 객체를 관리하는 영역으로 보면 된다.
여기서 자주 나오는 것이DTO와VO이다.
처음에는 둘을 너무 어렵게 생각하지 않아도 된다.
이 단계에서는 “데이터를 담아서 이동시키는 객체”와 “하나의 값 의미를 표현하는 객체” 정도로 구분하면 된다.
DTO는Data Transfer Object의 줄임말이다.
데이터를 옮기기 위한 객체이다.
예를 들어 회원가입 요청에서 아이디, 비밀번호, 이름을 한 번에 받기 위해SignupRequestDto를 만들 수 있다.
VO는Value Object의 줄임말이다.
값 자체를 하나의 의미로 묶은 객체이다.
예를 들어 주소, 좌표, 기간처럼 여러 값을 하나의 의미 있는 값으로 표현하고 싶을 때 사용할 수 있다.
여기서DTO와entity를 구분해야 한다.
DTO는 요청이나 응답에 필요한 값을 담는다.
entity는 데이터베이스에 저장될 값을 담는다.
예를 들어 회원가입 화면에는 비밀번호 확인 값이 있을 수 있다.
비밀번호 확인 값은 사용자가 비밀번호를 제대로 입력했는지 검사할 때 필요하다.
하지만 데이터베이스에 저장할 값은 아닐 수 있다.
이런 값은DTO에는 들어갈 수 있지만,entity에는 들어가지 않을 수 있다.
domain은 요청, 응답, 값 표현에 필요한 데이터 객체를 정리하는 영역이고,entity는 데이터베이스와 직접 연결되는 객체이다.
이 둘을 구분하면 화면에서 받는 값과 실제 저장되는 값을 헷갈리지 않을 수 있다.
entity 패키지
entity는 데이터베이스 테이블과 연결되는 자바 클래스를 두는 곳이다.
JPA는 자바 객체와 데이터베이스 테이블을 연결해서 사용한다.
이때 데이터베이스 테이블과 직접 연결되는 객체가entity이다.
예를 들어 회원 정보를 데이터베이스에 저장하려면 회원 테이블이 필요하다.
그리고 자바 코드에서는 그 회원 테이블과 연결될Member엔티티가 필요하다.
Member엔티티 안에는 데이터베이스에 저장할 값들이 들어간다.
예를 들어 회원 아이디, 비밀번호, 이름, 생성일 같은 값이 필드로 들어갈 수 있다.
이 필드들은 데이터베이스의 컬럼과 연결된다.
엔티티 클래스에는 보통@Entity가 붙는다.
@Entity는 이 클래스가JPA가 관리하는 클래스라는 뜻이다.
JPA는 이 클래스를 보고 어떤 테이블과 연결할지, 어떤 필드를 컬럼으로 볼지 판단한다.
쉽게 말하면entity는 “데이터베이스에 저장될 데이터의 모양”을 자바 코드로 표현한 것이다.
entity는 데이터베이스 테이블과 직접 연결되는 객체이다.
그래서 화면에서 잠깐 필요한 값이 아니라, 실제 데이터베이스에 저장해야 하는 값을 기준으로 작성해야 한다.
repository 패키지
repository는 데이터베이스에 접근하는 통로 역할을 하는 곳이다.
entity가 데이터베이스에 저장될 데이터의 모양을 정한다면,repository는 그entity를 실제로 저장하고 조회하는 역할을 한다.
예를 들어Member엔티티를 만들었다고 해서 바로 회원 데이터를 저장할 수 있는 것은 아니다.
Member라는 데이터 모양은 준비된 것이다.
하지만 그 데이터를 데이터베이스에 넣거나 꺼내려면MemberRepository가 필요하다.
Spring Data JPA에서는repository를 보통 인터페이스로 만든다.
그리고JpaRepository를 상속한다.
그러면 기본적인 저장, 조회, 삭제 기능을 직접 만들지 않아도 사용할 수 있다.
예를 들어Member엔티티의 기본키 타입이Long이면 아래처럼 작성한다.// MemberRepository.java import org.springframework.data.jpa.repository.JpaRepository; // JpaRepository 사용 public interface MemberRepository extends JpaRepository<Member, Long> { // 기본 저장, 조회, 삭제 기능은 JpaRepository가 제공한다 }이 코드에서
Member는 이 저장소가 다룰 엔티티이다.
Long은Member엔티티의 기본키 타입이다.
JpaRepository<Member, Long>이라고 적으면Spring Data JPA는 이렇게 이해한다.
“이 저장소는Member엔티티를 다루고, 기본키 타입은Long이다.”
그러면Spring Data JPA가 실행 시점에 필요한 구현 객체를 자동으로 만들어 준다.
그래서 개발자는save(),findById(),findAll(),delete()같은 기본 메서드를 바로 사용할 수 있다.
즉,repository가 있어야service에서 엔티티를 저장하거나 조회할 수 있다.
엔티티만 만들면 데이터 구조만 준비된 것이고,repository까지 만들어야 실제 데이터베이스 작업으로 이어질 수 있다.
resources 폴더
resources는 자바 코드가 아니라, 실행에 필요한 설정 파일이나 화면 파일을 두는 곳이다.
자바 클래스는 보통src/main/java아래에 두고, 설정 파일과 화면 관련 파일은src/main/resources아래에 둔다.
static은 이미지,CSS,JavaScript같은 정적 파일을 두는 곳이다.
정적 파일은 서버가 별도로 처리하지 않고 그대로 브라우저에 보내 줄 수 있는 파일이다.
templates는Thymeleaf같은 화면 템플릿을 두는 곳이다.
controller에서 화면 이름을 반환하면Spring Boot는templates폴더에서 해당 화면 파일을 찾는다.
application.properties는 프로젝트 실행 설정을 작성하는 파일이다.
여기에는 서버 포트, 데이터베이스 주소, 계정, 비밀번호,JPA설정,SQL출력 여부 같은 값이 들어간다.
정리하면resources는 화면 파일과 설정 파일을 관리하는 영역이다.
Java코드가 아니지만, 프로젝트가 실행될 때 반드시 필요한 파일들이 들어간다.
springjpaedu프로젝트는 요청을 받는controller, 기능을 처리하는service, 데이터를 표현하는domain, 테이블과 연결되는entity, 데이터베이스에 접근하는repository, 설정과 화면 파일을 담는resources로 나누어 볼 수 있다.
이 구조를 알면 어떤 파일을 어느 위치에 만들어야 하는지 기준이 생긴다.
프로젝트 구조의 전체 연결 흐름
각 패키지 설명을 따로 보면 아직 헷갈릴 수 있다.
그래서 실제 요청이 들어왔을 때의 흐름으로 다시 정리해야 한다.
기본 흐름은 아래와 같다.
- 사용자가 브라우저에서 요청을 보낸다.
controller가 요청을 받는다.- 요청 값은 필요하면
DTO에 담긴다.controller는 기능 처리를 위해service를 호출한다.service는 기능의 순서와 규칙을 처리한다.- 데이터베이스 작업이 필요하면
repository를 호출한다.repository는entity를 기준으로 저장하거나 조회한다.- 실제 데이터는
DB에 저장되거나DB에서 조회된다.- 처리 결과는 다시
service를 거쳐controller로 돌아간다.controller는 화면 이름이나 응답 데이터를 반환한다.이 흐름을 아주 짧게 쓰면 아래와 같다.
// ProjectFlow.java
// Controller -> Service -> Repository -> Entity -> DB
여기에
DTO를 포함해서 보면 아래처럼 이해할 수 있다.// ProjectFlowWithDto.java // 요청값 -> DTO -> Service -> Entity -> Repository -> DB
DTO는 요청 값을 담아서 이동시키는 객체이다.
Service는 기능 흐름을 처리한다.
Entity는 데이터베이스에 저장될 객체이다.
Repository는 데이터베이스에 접근하는 통로이다.
DB는 실제 데이터가 저장되는 공간이다.
예를 들어 회원가입 흐름으로 보면 더 쉽다.
사용자가 회원가입 정보를 입력한다.
controller가 그 값을 받는다.
요청 값은SignupRequestDto같은DTO에 담길 수 있다.
service는 아이디 중복 확인, 비밀번호 처리, 회원 생성 같은 흐름을 처리한다.
그다음Member엔티티를 만들고,MemberRepository를 통해 데이터베이스에 저장한다.
프로젝트를 진행할 때는 요청 값을DTO로 받고,service에서 기능 흐름을 처리하고,entity를 만들어repository로 저장하거나 조회한다고 이해하면 된다.
이 구조를 먼저 잡아 두면 뒤에서Repository, 쿼리 메서드, 연관관계 조회를 배울 때 훨씬 덜 헷갈린다.
프로젝트를 진행할 때도 어떤 파일을 어느 패키지에 만들어야 하는지 기준이 생긴다.
테스트 클래스 구성
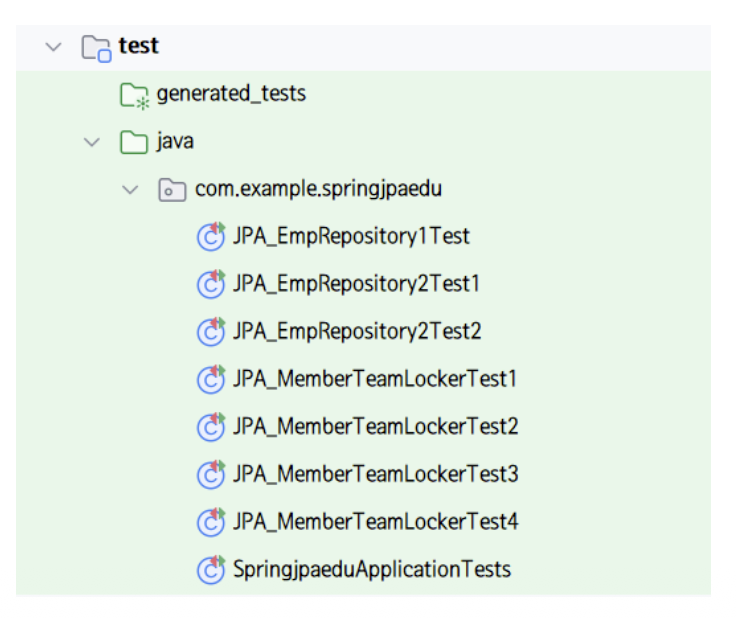
src/test/java아래에는 실습 동작을 확인하기 위한 테스트 클래스가 들어간다.
이 프로젝트에서는 단순히 서버만 실행하는 것이 아니라,Repository와 엔티티 연관관계가 제대로 동작하는지 테스트 코드로 확인한다.
다만 이 글에서는 프로젝트에 들어간 실제 테스트 코드를 자세히 분석하지 않는다.
테스트 폴더에는 이후 응용예제에서 사용할Repository테스트와 연관관계 테스트 클래스들이 준비되어 있다.
지금 단계에서는 실습이 기능별 테스트 클래스로 나뉘어 있다는 점만 확인하면 된다.
테스트 클래스는
Repository조회, 조건 검색, 엔티티 연관관계 확인처럼 실습 목적별로 나뉘어 있다.
이후 개념을 배운 뒤 실제 프로젝트 소스를 응용예제로 볼 때, 각 테스트 클래스가 실행 흐름을 확인하는 기준이 된다.
정리하면, 첫 기동 단계에서는 오류를 없애는 것만 보는 것이 아니다.
Spring Data JPA프로젝트가 데이터베이스 설정을 왜 필요로 하는지, 자동 설정이 어떻게 동작하는지, 프로젝트 구조가 어떤 역할로 나뉘는지를 함께 확인해야 한다.
2. 스프링 데이터와 스프링 데이터 JPA
Spring Data JPA를 이해하려면 먼저Spring Data가 무엇인지 알아야 한다.
이름이 비슷해서Spring Data와Spring Data JPA를 같은 것으로 생각하기 쉽지만, 둘은 같은 개념이 아니다.
Spring Data는 여러 데이터 저장 기술을 더 일관된 방식으로 사용하게 도와주는 큰 프로젝트이다.
여기서 데이터 저장 기술은 데이터를 저장하고 조회하는 기술이나 저장소를 의미한다.
예를 들어 관계형 데이터베이스,MongoDB,Redis같은 기술이 모두 데이터 저장소에 해당한다.
저장소 종류가 달라질 때마다 완전히 다른 방식으로 코드를 작성해야 한다면 개발이 복잡해진다.
Spring Data는 이런 불편함을 줄이기 위해 공통적인 데이터 접근 방식을 제공한다.
즉, 저장소 종류가 달라도 비슷한 구조로 데이터를 저장하고 조회할 수 있게 도와준다.
Spring Data는 큰 묶음이고,Spring Data JPA는 그 안에서JPA사용을 도와주는 하위 프로젝트이다.
Spring Data가 필요한 이유
데이터를 저장하고 조회하는 작업은 대부분의 애플리케이션에서 반복된다.
저장, 조회, 수정, 삭제 같은 기본 작업은 저장소가 달라도 자주 등장한다.
이런 반복 작업을 매번 직접 구현하면 코드가 많아지고, 구조도 쉽게 복잡해진다.
Spring Data는 여러 저장소 기술에서 공통으로 필요한 기능을 모아 제공한다.
공통 영역은 여러 하위 프로젝트에서 함께 사용하는 기반 기능을 담당한다.
그 아래에는Spring Data JPA,Spring Data JDBC,Spring Data MongoDB,Spring Data Redis같은 하위 프로젝트가 있다.
이 구조를 보면Spring Data JPA의 위치가 분명해진다.
Spring Data JPA는Spring Data전체가 아니다.
Spring Data안에서 관계형 데이터베이스와JPA기반 데이터 접근을 편하게 만들기 위한 프로젝트이다.
Spring Data는 여러 저장소 기술을 하나의 공통 흐름으로 다루기 위한 큰 프로젝트이다.
그중Spring Data JPA는JPA기반 데이터 접근 코드를 더 단순하게 만들어 주는 하위 프로젝트이다.
이 구조에서 중요한 점은 포함 관계이다.
Spring Data JPA가Spring Data전체를 의미하는 것이 아니라,Spring Data안에 포함된 여러 하위 프로젝트 중 하나이다.
Spring Data JPA가 하는 일
Spring Data JPA는Spring Framework에서JPA를 더 편하게 사용할 수 있도록 도와주는 프로젝트이다.
JPA는 객체와 관계형 데이터베이스 테이블을 매핑하는Java표준 기술이다.
여기서 매핑은 서로 다른 구조를 연결한다는 뜻이다.
즉,Java객체와 데이터베이스 테이블을 서로 대응시키는 작업이다.
JPA만 사용하면 엔티티를 저장하고 조회하기 위해EntityManager를 직접 다루는 코드가 자주 필요하다.
EntityManager는JPA에서 엔티티를 저장, 조회, 수정, 삭제할 때 사용하는 핵심 객체이다.
직접 사용하면 세밀하게 제어할 수 있지만, 기본 저장, 조회, 삭제 코드가 반복되기 쉽다.
Spring Data JPA는 이 반복을 줄이기 위해Repository인터페이스 중심의 개발 방식을 제공한다.
Repository는 저장소라는 뜻이지만, 여기서는 데이터베이스에 접근하는 계층을 의미한다.
엔티티를 저장하거나 조회하거나 삭제하는 역할을 맡는다.
예전 방식에서는DAO구현 클래스를 만들고, 메서드마다 데이터베이스 접근 코드를 작성해야 했다.
DAO는 데이터 접근 객체라는 뜻으로, 데이터베이스 작업을 담당하는 객체이다.
Spring Data JPA를 사용하면Repository인터페이스만 작성해도 기본 구현체가 자동으로 만들어진다.
Spring Data JPA의 핵심은JPA를 더 쉽게 쓰게 해 주고, 반복되는 데이터 접근 코드를 줄여 준다는 점이다.
Spring Data JPA가JPA를 대체하는 것이 아니라,JPA위에서 더 편한 사용 방식을 제공한다고 이해하면 된다.
Spring Data JPA의 내부 흐름
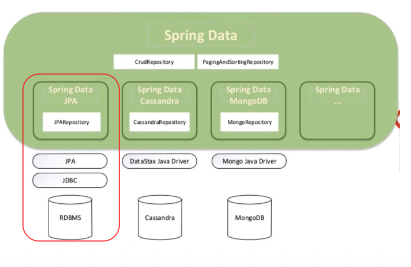
Spring Data JPA는 데이터베이스와 직접 통신하는 기술처럼 보일 수 있다.
하지만 실제로는 여러 단계를 거쳐 데이터베이스와 연결된다.
개발자는 보통Repository인터페이스를 작성하고 그 메서드를 호출한다.
그 뒤 내부적으로Spring Data JPA가JPA를 사용한다.
JPA는 객체와 관계형 데이터베이스를 연결하는 표준 기술이다.
그리고 실제 실행 과정에서는Hibernate같은JPA구현체가 동작한다.
구현체는 표준으로 정해진 기능을 실제로 동작하게 만든 라이브러리라고 이해하면 된다.
JPA구현체는 다시JDBC를 통해 관계형 데이터베이스와 통신한다.
JDBC는Java에서 데이터베이스에 접속하고SQL을 실행하기 위한 기본 기술이다.
RDBMS는 관계형 데이터베이스 관리 시스템을 의미한다.
대표적으로MySQL,Oracle,PostgreSQL같은 데이터베이스가 여기에 속한다.
정리하면 실제 흐름은Repository→Spring Data JPA→JPA→JPA구현체 →JDBC→RDBMS순서로 이해할 수 있다.
이 흐름은Spring Data JPA가JPA를 대체한다는 뜻이 아니다.
오히려Spring Data JPA는JPA위에서 동작하면서JPA사용을 더 편하게 만들어 준다.
개발자는
Repository인터페이스를 사용하지만, 내부적으로는Spring Data JPA가JPA를 사용하고, 실제 실행 과정에서는Hibernate같은JPA구현체가JDBC를 통해 관계형 데이터베이스와 연결된다.
따라서Spring Data JPA는JPA를 없애는 기술이 아니라,JPA를 더 편하게 사용하게 해주는 기술이다.
이 차이를 정확히 잡아야 한다.
JPA는 객체와 관계형 데이터베이스를 매핑하는 표준 기술이고,Spring Data JPA는 그JPA를Spring환경에서 더 편하게 사용하도록 도와주는 프로젝트이다.
정리하면,Spring Data는 여러 저장소 기술을 공통 방식으로 다루는 큰 프로젝트이다.
Spring Data JPA는 그중JPA기반의 데이터 접근을 더 쉽게 만들어 주는 하위 프로젝트이다.
그리고 실제 데이터베이스 통신은 내부적으로JPA,JPA구현체,JDBC를 거쳐 이루어진다.
3. 저장소와 JPA 저장소
Spring Data JPA를 실제로 사용할 때 가장 많이 만나는 구조가Repository이다.
Repository는 데이터를 저장하고 조회하는 역할을 담당하는 데이터 접근 계층이다.
여기서 데이터 접근 계층은 애플리케이션 코드와 데이터베이스 사이에서 저장, 조회, 삭제 같은 작업을 맡는 영역을 의미한다.
Spring Data JPA에서는 이 데이터 접근 계층을 보통 인터페이스로 만든다.
즉, 개발자는 엔티티마다Repository인터페이스를 만들고, 그 인터페이스가JpaRepository를 상속하도록 작성한다.
그러면Spring Data JPA가 기본 저장, 조회, 삭제 기능을 사용할 수 있게 해 준다.
이렇게 역할을 나누면 코드의 책임이 분명해진다.
Controller는 요청을 받고,Service는 처리 흐름을 담당하고,Repository는 데이터베이스 접근을 담당한다.
데이터베이스 접근 코드를 한곳에 모을 수 있기 때문에 유지보수도 쉬워진다.
Repository가 필요한 이유
JPA만 직접 사용하면EntityManager를 통해 엔티티를 저장하고 조회하는 코드를 직접 작성해야 한다.
EntityManager는JPA에서 엔티티를 저장, 조회, 수정, 삭제할 때 사용하는 핵심 객체이다.
직접 사용할 수는 있지만, 엔티티마다 비슷한 저장 코드와 조회 코드가 반복될 수 있다.
예를 들어 회원 엔티티를 저장하는 코드, 게시글 엔티티를 저장하는 코드, 댓글 엔티티를 저장하는 코드는 다루는 대상만 다를 뿐 구조가 비슷해질 수 있다.
이런 반복이 많아지면 데이터 접근 코드가 길어지고, 수정할 곳도 많아진다.
Spring Data JPA는 이 반복을 줄이기 위해Repository인터페이스 중심의 개발 방식을 제공한다.
개발자는 엔티티별Repository인터페이스를 만들고, 그 인터페이스가JpaRepository를 상속하도록 작성한다.
그러면 기본적인 저장, 조회, 삭제 기능을 직접 구현하지 않고 바로 사용할 수 있다.
여기서JpaRepository<T, ID>의T는 다룰 엔티티 타입이다.
ID는 해당 엔티티의 기본키 타입이다.
예를 들어Member엔티티의 기본키 타입이Long이면JpaRepository<Member, Long>형태로 작성한다.
엔티티마다 전용
Repository인터페이스를 만들고, 그 인터페이스가JpaRepository를 상속하도록 작성한다.
JpaRepository<Member, Long>에서Member는 저장소가 다룰 엔티티이고,Long은 그 엔티티의 기본키 타입이다.
이 구조를 이해하면Repository인터페이스 선언이 왜 필요한지 알 수 있다.
단순히 이름만 만드는 것이 아니라, 어떤 엔티티를 어떤 기본키 타입으로 다룰지Spring Data JPA에 알려 주는 선언이다.
Repository 인터페이스 계층 구조
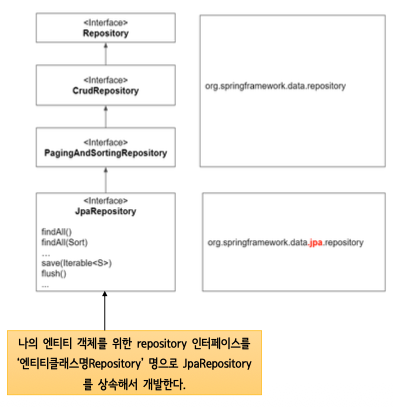
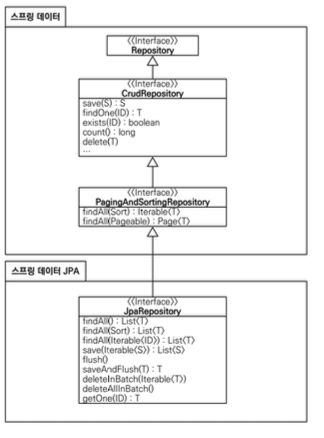
Spring Data의Repository계층은 여러 인터페이스로 나뉜다.
가장 위에는Repository가 있다.
이 인터페이스는 저장소 계층의 가장 기본이 되는 출발점 역할을 한다.
그 아래에CrudRepository가 있고, 저장, 조회, 삭제 같은 기본 작업을 제공한다.
CRUD는 데이터를 생성, 조회, 수정, 삭제하는 기본 작업을 의미한다.
Create,Read,Update,Delete의 앞 글자를 모은 말이다.
대부분의 데이터 중심 애플리케이션에서 반복해서 사용하는 기본 기능이다.
PagingAndSortingRepository는 페이징과 정렬 기능을 제공한다.
페이징은 많은 데이터를 페이지 단위로 나누어 조회하는 방식이다.
정렬은 특정 기준으로 데이터를 순서대로 조회하는 방식이다.
JpaRepository는 이 구조 위에JPA에서 자주 사용하는 기능을 추가로 제공한다.
그래서Spring Data JPA를 사용할 때는 보통JpaRepository를 상속해서 사용한다.
이렇게 하면 기본CRUD, 페이징, 정렬,JPA관련 기능을 한 번에 사용할 수 있다.
JpaRepository는 기본CRUD, 페이징, 정렬 기능에 더해JPA에서 자주 사용하는 기능까지 제공한다.
그래서Spring Data JPA를 사용할 때는 직접 하위 인터페이스를 조합하기보다JpaRepository하나를 상속하는 방식이 많이 사용된다.
이 흐름을 간단히 정리하면 다음과 같다.
Repository는 저장소 계층의 가장 기본이 되는 출발점이다.CrudRepository는 기본CRUD기능을 제공한다.PagingAndSortingRepository는 페이징과 정렬 기능을 제공한다.JpaRepository는JPA전용 기능을 추가로 제공한다.
기본예제로 구조 확인하기
Repository구조는 코드로 한 번 보면 더 쉽게 이해된다.
아래 예제는 실제 프로젝트 소스가 아니라,JpaRepository<T, ID>구조를 이해하기 위한 최소 예제이다.
복잡한 비즈니스 로직은 빼고, 엔티티 하나와 저장소 인터페이스 하나만 확인한다.// exam03_Member.java import jakarta.persistence.Entity; import jakarta.persistence.GeneratedValue; import jakarta.persistence.GenerationType; import jakarta.persistence.Id; @Entity // 데이터베이스 테이블과 매핑될 클래스 public class Member { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.IDENTITY) // 기본키 자동 증가 private Long id; // 기본키 타입은 Long private String name; // 회원 이름 protected Member() { // JPA가 사용할 기본 생성자 } public Member(String name) { // 회원 이름을 저장하는 생성자 this.name = name; } public Long getId() { // 기본키 값 반환 return id; } public String getName() { // 회원 이름 반환 return name; } public void setName(String name) { // 회원 이름 변경 this.name = name; } }
Member클래스는JPA가 관리할 엔티티이다.
@Entity가 붙으면 이 클래스는 데이터베이스 테이블과 매핑될 수 있다.
@Id가 붙은id는 기본키 역할을 한다.
@GeneratedValue는 기본키 값을 자동으로 생성할 때 사용한다.
protected Member()는JPA가 엔티티 객체를 만들 때 사용할 기본 생성자이다.
직접 값을 넣어 객체를 만들 때는Member(String name)생성자를 사용할 수 있다.
getId(),getName(),setName()은 뒤에서 저장, 조회, 테스트 흐름을 확인할 때 필요한 기본 메서드이다.// exam03_MemberRepository.java import org.springframework.data.jpa.repository.JpaRepository; public interface MemberRepository extends JpaRepository<Member, Long> { // 기본 CRUD 메서드는 JpaRepository가 제공한다 }
MemberRepository는Member엔티티를 다루는 저장소 인터페이스이다.
JpaRepository<Member, Long>이라고 작성했기 때문에 이 저장소는Member를 다루고, 기본키 타입은Long이라고 선언한 것이다.
여기서 핵심은 구현 클래스를 만들지 않았다는 점이다.
인터페이스만 작성했지만Spring Data JPA가 실행 시점에 구현 객체를 자동으로 만들어 준다.
그래서 개발자는 기본 저장, 조회, 삭제 기능을 직접 구현하지 않고도 사용할 수 있다.
정리하면,Repository는 데이터 접근 계층의 입구이다.
JpaRepository<T, ID>는 어떤 엔티티를 어떤 기본키 타입으로 다룰지 정하는 선언이다.
이 구조를 이해해야 다음에 나오는 자동 구현체 생성과 주요 메서드 흐름을 자연스럽게 이어서 볼 수 있다.
4. 저장소 구현체 자동 생성과 주요 메서드
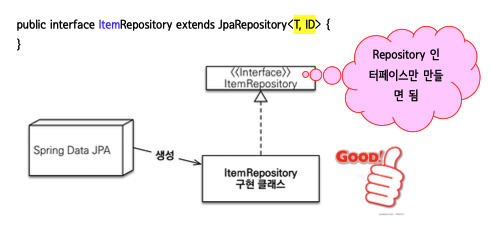
Spring Data JPA의 핵심은Repository인터페이스만 작성해도 실제 동작하는 구현 객체가 자동으로 만들어진다는 점이다.
일반적으로 인터페이스는 메서드 이름만 가지고 있고, 실제 실행 코드는 구현 클래스가 담당한다.
그런데Spring Data JPA에서는 개발자가 구현 클래스를 직접 만들지 않아도 된다.
이 구조 덕분에 데이터 접근 계층의 반복 코드가 크게 줄어든다.
예전처럼DAO클래스를 만들고, 메서드마다SQL실행 코드를 작성하는 방식보다 훨씬 단순하게 저장소를 만들 수 있다.
개발자는 필요한Repository인터페이스를 선언하고, 실제 구현은Spring Data JPA가 맡는다.
인터페이스만 작성해도 동작하는 이유
Spring Data JPA는 애플리케이션이 실행될 때Repository인터페이스를 찾는다.
그리고 그 인터페이스가 어떤 엔티티를 다루는지, 기본키 타입이 무엇인지 분석한다.
그 다음 실행 시점에 해당 인터페이스의 구현 객체를 자동으로 만들어Spring빈으로 등록한다.
Spring빈은Spring컨테이너가 생성하고 관리하는 객체를 의미한다.
이렇게 등록된 객체는 필요한 곳에서 주입받아 사용할 수 있다.
그래서Repository구현 클래스를 직접 만들지 않아도save(),findAll()같은 메서드를 호출할 수 있다.
개발자는
ItemRepository extends JpaRepository<T, ID>처럼 인터페이스만 작성한다.
그러면Spring Data JPA가 실행 시점에 구현 객체를 자동으로 생성한다.
이 흐름에서 중요한 점은Repository가 단순한 이름표가 아니라는 것이다.
Spring Data JPA는 이 인터페이스 선언을 보고 어떤 엔티티 저장소를 만들어야 하는지 판단한다.
JpaRepository 주요 메서드
JpaRepository를 상속하면 기본 데이터 접근 메서드를 바로 사용할 수 있다.
이 메서드들은 대부분의 엔티티에서 공통으로 필요한 기능이다.
그래서 엔티티마다 직접 반복해서 만들 필요가 없다.
메서드 역할 한 번에 보기
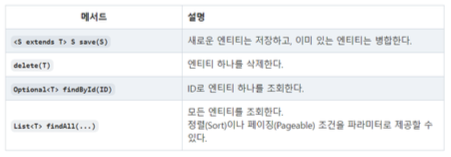
save()는 엔티티를 저장할 때 사용한다.delete()는 엔티티를 삭제할 때 사용한다.deleteById()는 기본키 값을 기준으로 엔티티를 삭제할 때 사용한다.findById()는 기본키 값을 기준으로 엔티티 하나를 조회할 때 사용한다.findAll()은 해당 엔티티의 모든 데이터를 조회할 때 사용한다.count()는 해당 엔티티의 전체 데이터 개수를 조회할 때 사용한다.findAll(Sort)는 전체 데이터를 정렬해서 조회할 때 사용한다.findAll(Pageable)은 전체 데이터를 페이지 단위로 나누어 조회할 때 사용한다.- 이때
PageRequest를 인자로 넘겨 몇 번째 페이지를 몇 개씩 가져올지 지정할 수 있다.
save()는 가장 기본적으로 엔티티를 저장하는 메서드로 이해하면 된다.
새 엔티티를 넘기면 데이터베이스에 저장하는 흐름으로 이어진다.
이미 식별자를 가진 엔티티를 넘기면 기존 데이터로 판단해 처리될 수 있으므로, 이 단계에서는 “저장 계열 메서드”라고 먼저 이해하면 된다.
findById()는 기본키 하나를 기준으로 엔티티 하나를 찾을 때 사용한다.
반면findAll()은 조건 없이 해당 엔티티의 전체 데이터를 가져온다.
두 메서드는 모두 조회이지만, 조회 기준이 기본키 하나인지 전체 데이터인지가 다르다.
count()는 전체 데이터 개수를 숫자로 돌려준다.
데이터 목록이 아니라 개수만 필요할 때 사용한다.
예를 들어 사원 목록 전체를 화면에 출력하는 것이 아니라 “사원 데이터가 몇 개인지”만 보여 주고 싶다면count()가 적합하다.
deleteById()는 삭제할 엔티티 객체를 직접 넘기지 않고, 기본키 값만 넘겨 삭제할 수 있는 메서드이다.
삭제 대상의 기본키를 알고 있다면deleteById(id)처럼 간단하게 삭제 요청을 보낼 수 있다.
JpaRepository를 상속하면 저장, 조회, 삭제 같은 기본 데이터 접근 기능을 직접 구현하지 않아도 사용할 수 있다.
반복되는 기본 기능은JpaRepository가 제공하고, 개발자는 엔티티별로 필요한 추가 조회 조건에 집중하면 된다.
PageRequest, Page, Sort 기본 개념
JpaRepository는 전체 조회만 제공하는 것이 아니다.
많은 데이터를 한 번에 모두 가져오면 화면도 복잡해지고 성능에도 부담이 생길 수 있다.
그래서 실제 개발에서는 데이터를 페이지 단위로 나누거나, 특정 기준으로 정렬해서 조회하는 경우가 많다.
Pageable은 페이지 조회 조건을 표현하는 인터페이스이다.
여기서 인터페이스는 어떤 기능을 사용할 수 있는지 정해 둔 약속으로 이해하면 된다.
findAll(Pageable)은 이 약속에 맞는 페이지 조건을 받아서 데이터를 페이지 단위로 조회한다.
PageRequest는Pageable을 실제로 사용할 수 있게 만든 객체이다.
몇 번째 페이지를 몇 개씩 가져올지 담는다.
예를 들어PageRequest.of(0, 5)는 첫 번째 페이지에서 5개를 가져오겠다는 뜻이다.
여기서 페이지 번호는 보통1이 아니라0부터 시작한다.
Page는 페이지 조회 결과를 담는 객체이다.
단순히 현재 페이지의 데이터만 담는 것이 아니라, 전체 페이지 정보나 현재 페이지 정보 같은 페이지 관련 정보도 함께 다룰 수 있다.
필요하면toList()를 사용해 현재 페이지에 들어 있는 데이터 목록만 꺼낼 수 있다.
Sort는 어떤 필드를 기준으로 정렬할지 정하는 객체이다.
Sort.by("name")은name필드를 기준으로 정렬한다는 뜻이다.
기본 정렬 방향은 오름차순이고, 큰 값에서 작은 값 순서로 보고 싶으면descending()을 붙일 수 있다.
페이징은 데이터를 나누어 조회하는 기능이고, 정렬은 데이터를 원하는 순서로 조회하는 기능이다.
두 기능은 따로 사용할 수도 있고,PageRequest.of(0, 5, Sort.by("name"))처럼 함께 사용할 수도 있다.
기본예제로 저장과 전체 조회 확인하기
기본 메서드는 실제로 호출하는 흐름을 보면 더 쉽게 이해된다.
아래 예제는 앞에서 만든Member엔티티와MemberRepository를 기준으로,save()와findAll()만 확인하는 최소 예제이다.
테스트 관련 자세한 내용은 뒤에서 따로 정리하므로, 여기서는 저장소 메서드가 어떻게 호출되는지만 보면 된다.// exam04_MemberRepositoryBasicTest.java import org.junit.jupiter.api.Test; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.boot.data.jpa.test.autoconfigure.DataJpaTest; import java.util.List; @DataJpaTest // JPA Repository 테스트 환경 준비 class MemberRepositoryBasicTest { @Autowired // 자동 생성된 Repository 구현체 주입 MemberRepository memberRepository; @Test // 저장 후 전체 조회 흐름 확인 void saveAndFindAll() { Member member = new Member("kim"); // 저장할 엔티티 생성 memberRepository.save(member); // 엔티티 저장 List<Member> members = memberRepository.findAll(); // 전체 조회 System.out.println(members.size()); // 조회 개수 확인 } }// 출력결과 // 1위 출력 결과는 테스트 안에서 새로 저장한
Member데이터만 있다고 가정했을 때의 결과이다.
memberRepository.save(member)는Member엔티티를 저장한다.
그 다음memberRepository.findAll()을 호출하면 저장된Member목록을 조회한다.
여기서 눈여겨볼 부분은memberRepository의 실제 구현 클래스를 만든 적이 없다는 점이다.
인터페이스만 작성했지만Spring Data JPA가 자동으로 구현 객체를 만들었기 때문에 메서드를 호출할 수 있다.
기본예제로 페이징과 정렬 모양 확인하기
이번에는
Sort,PageRequest,Page가 어떤 모양으로 사용되는지 확인한다.
아래 예제는Member데이터를 몇 개 저장한 뒤, 이름 기준 정렬과 페이지 조회를 실행하는 구조이다.// exam04_MemberRepositoryPagingTest.java import org.junit.jupiter.api.Test; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.boot.data.jpa.test.autoconfigure.DataJpaTest; import org.springframework.data.domain.Page; import org.springframework.data.domain.PageRequest; import org.springframework.data.domain.Sort; import java.util.List; @DataJpaTest // JPA Repository 테스트 환경 준비 class MemberRepositoryPagingTest { @Autowired // 자동 생성된 Repository 구현체 주입 MemberRepository memberRepository; @Test // 정렬과 페이징 조회 확인 void sortAndPaging() { memberRepository.save(new Member("kim")); // 첫 번째 데이터 저장 memberRepository.save(new Member("lee")); // 두 번째 데이터 저장 memberRepository.save(new Member("park")); // 세 번째 데이터 저장 List<Member> sortedMembers = memberRepository.findAll(Sort.by("name").ascending()); // name 오름차순 정렬 Page<Member> page = memberRepository.findAll(PageRequest.of(0, 2)); // 첫 페이지에서 2개 조회 List<Member> currentPageMembers = page.toList(); // 현재 페이지 데이터만 목록으로 변환 System.out.println(sortedMembers.size()); // 정렬 조회 결과 개수 확인 System.out.println(currentPageMembers.size()); // 현재 페이지 데이터 개수 확인 } }// 출력결과 // 3 // 2위 출력 결과는 테스트 안에서 새로 저장한
Member데이터만 있다고 가정했을 때의 결과이다.
세 개의Member를 저장했기 때문에 정렬 조회 결과 개수는3이다.
PageRequest.of(0, 2)는 첫 번째 페이지에서 2개를 가져오라는 뜻이므로 현재 페이지 목록의 개수는2이다.
이 예제에서 중요한 점은findAll()이 여러 형태로 사용된다는 것이다.
findAll()은 전체 조회이고,findAll(Sort)는 정렬된 전체 조회이다.
findAll(Pageable)은 페이지 단위 조회이고, 이 예제에서는PageRequest를 넘겨 페이지 번호와 크기를 지정한다.
즉, 같은findAll계열 메서드라도 전달하는 값에 따라 조회 방식이 달라질 수 있다.
정리하면,JpaRepository는 기본 데이터 접근 기능을 제공한다.
Spring Data JPA는Repository인터페이스를 보고 구현 객체를 자동으로 만든다.
그래서 개발자는 반복적인 저장소 구현 코드보다 필요한 엔티티 구조와 조회 조건, 페이징과 정렬 조건에 집중할 수 있다.
5. 쿼리 메서드 기본 개념
JpaRepository가 제공하는 기본 메서드만으로는 모든 조회 조건을 처리할 수 없다.
findAll()은 전체 조회이고,findById()는 기본키 조회이다.
하지만 실제 개발에서는 이름으로 조회하거나, 특정 값이 포함된 데이터를 찾거나, 조건에 맞는 데이터 개수를 세야 하는 경우가 많다.
이런 조건은 엔티티마다 다르다.
예를 들어 회원 엔티티는 이름으로 조회해야 할 수 있고, 상품 엔티티는 가격으로 조회해야 할 수 있다.
게시글 엔티티는 제목에 특정 단어가 포함된 데이터를 찾아야 할 수 있다.
이런 조건을 모든 엔티티에 공통 메서드로 미리 제공하는 것은 어렵다.
이때 사용하는 기능이 쿼리 메서드이다.
쿼리 메서드는Spring Data JPA가 메서드 이름을 해석해서 쿼리를 자동으로 만들어 주는 기능이다.
메서드 이름이 조회 조건을 표현하고,Spring Data JPA가 그 이름을 분석해서 필요한 쿼리를 만든다.
메서드 이름이 쿼리가 되는 방식
쿼리 메서드는 정해진 이름 규칙을 따른다.
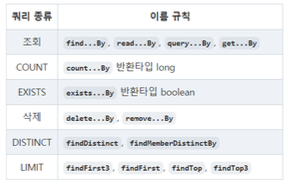
조회할 때는find...By,read...By,query...By,get...By같은 형태를 사용할 수 있다.
실습에서는 가장 익숙한findBy형태를 먼저 기준으로 보면 된다.
findByName()이라고 작성하면name필드 값으로 데이터를 찾는 조회 메서드로 해석된다.
여기서find는 조회한다는 뜻이고,By뒤의Name은 조회 조건이 되는 엔티티 필드를 의미한다.
즉,findByName()은 “name값으로 찾겠다”는 뜻이다.
개수를 구할 때는countBy를 사용할 수 있다.
존재 여부를 확인할 때는existsBy를 사용할 수 있다.
삭제할 때는deleteBy나removeBy를 사용할 수 있다.
중복을 제거하고 싶으면Distinct를 사용할 수 있다.
조회 개수를 제한하고 싶으면First나Top을 사용할 수 있다.
이처럼 간단한 조건은JPQL을 직접 작성하지 않고도 메서드 이름만으로 표현할 수 있다.
조회, 개수 확인, 존재 여부 확인, 삭제 같은 목적을 메서드 이름 앞부분에 표현할 수 있다.
그 뒤에By를 붙이고 엔티티 필드 이름을 이어 쓰면,Spring Data JPA가 그 이름을 기준으로 쿼리를 만든다.
예를 들어findByName()은name값으로 조회하는 메서드이다.
countByName()은name값이 같은 데이터 개수를 구하는 메서드이다.
existsByName()은 해당name값이 존재하는지 확인하는 메서드이다.
필드 이름이 정확해야 하는 이유
쿼리 메서드에서
By뒤에 붙는 이름은 아무 단어나 붙이는 것이 아니다.
엔티티 안에 실제로 존재하는 필드 이름과 연결된다.
예를 들어Member엔티티에name필드가 있으면findByName()이라고 작성할 수 있다.
하지만 필드명이username이라면findByName()이 아니라findByUsername()처럼 작성해야 한다.
쿼리 메서드는 메서드 이름을 기준으로 엔티티 필드를 찾기 때문에, 필드 이름이 맞지 않으면 정상적으로 쿼리를 만들 수 없다.
그래서 쿼리 메서드를 작성할 때는 엔티티의 필드명을 먼저 확인해야 한다.
기본예제로 findByName 이해하기
쿼리 메서드는 처음에는 가장 단순한 조건 조회부터 보는 것이 좋다.
아래 예제는Member엔티티에name필드가 있다고 가정하고, 이름으로 회원을 조회하는 구조이다.
name값이 같은 회원이 여러 명일 수 있으므로 반환 타입은List<Member>로 작성한다.// exam05_MemberRepository.java import org.springframework.data.jpa.repository.JpaRepository; import java.util.List; public interface MemberRepository extends JpaRepository<Member, Long> { List<Member> findByName(String name); // name 값으로 회원 목록 조회 }
findByName()은 직접 구현하지 않는다.
메서드 이름에findBy와Name이 들어 있기 때문에Spring Data JPA는Member엔티티의name필드를 기준으로 조회하는 쿼리를 만든다.
여기서 중요한 점은Name이Member엔티티 안의name필드와 연결된다는 것이다.
쿼리 메서드는 메서드 이름과 엔티티 필드 이름의 관계를 바탕으로 동작한다.
아래 테스트 코드는kim이라는 이름을 가진 회원을 저장한 뒤,findByName("kim")으로 다시 조회하는 흐름만 확인한다.
테스트 관련 자세한 내용은 뒤에서 따로 정리하므로, 여기서는 쿼리 메서드 호출 흐름만 보면 된다.// exam05_MemberQueryMethodTest.java import org.junit.jupiter.api.Test; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.boot.data.jpa.test.autoconfigure.DataJpaTest; import java.util.List; @DataJpaTest // JPA Repository 테스트 환경 준비 class MemberQueryMethodTest { @Autowired // Repository 구현체 주입 MemberRepository memberRepository; @Test // 이름 조건 조회 확인 void findByNameTest() { Member member = new Member("kim"); // 조회 조건이 될 이름 저장 memberRepository.save(member); // 엔티티 저장 List<Member> result = memberRepository.findByName("kim"); // 이름으로 조회 System.out.println(result.size()); // 조회 결과 개수 확인 } }// 출력결과 // 1위 출력 결과는 테스트 안에서 새로 저장한
Member데이터만 있다고 가정했을 때의 결과이다.
save()로name값이kim인 회원을 저장했다.
그 다음findByName("kim")을 호출하면name값이kim인 회원을 조회한다.
이 예제에서 직접SQL이나JPQL을 작성하지 않았다.
그런데도 이름 조건 조회가 가능하다.
이유는Spring Data JPA가findByName()이라는 메서드 이름을 분석해서 쿼리를 생성하기 때문이다.
정리하면, 쿼리 메서드는 메서드 이름으로 조회 조건을 표현하는 방식이다.
간단한 조건 조회에서는 코드가 짧고 의도가 분명해진다.
다만 조건이 많아지면 메서드 이름이 길어질 수 있으므로, 다음 단계에서는 조건 키워드를 어떻게 조합하는지 확인해야 한다.
6. 쿼리 메서드 조건 키워드
쿼리 메서드는 단순히
findByName()처럼 같은 값만 찾는 데서 끝나지 않는다.
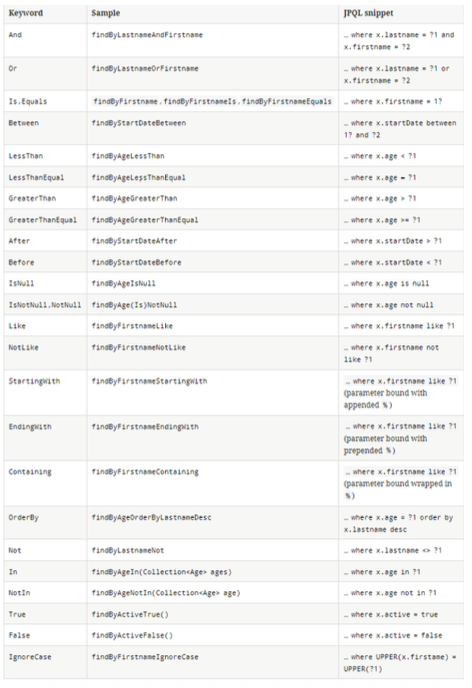
정해진 키워드를 조합하면 여러 조건을 메서드 이름으로 표현할 수 있다.
예를 들어 두 조건을 함께 검사하거나, 특정 값보다 큰 데이터를 찾거나, 문자열에 특정 글자가 포함된 데이터를 조회할 수 있다.
다만 모든 키워드를 한 번에 코드로 외우려고 하면 오히려 헷갈린다.
먼저 자주 쓰는 키워드를 역할별로 나누어 이해하는 것이 좋다.
이 주제에서는 대표 조건만 기본예제로 확인하고, 더 많은 실제 조건 조회는 뒤의 응용예제에서 프로젝트 코드로 다시 확인한다.
조건 키워드를 역할별로 보기
쿼리 메서드 키워드는 크게 조건 연결, 비교 조건, 문자열 조건, 정렬 조건으로 나눠서 보면 이해하기 쉽다.
조건 연결은 여러 조건을 함께 사용할 때 필요하다.
비교 조건은 숫자나 날짜처럼 크고 작음을 비교할 때 사용한다.
문자열 조건은 이름이나 제목처럼 글자 검색이 필요할 때 사용한다.
정렬 조건은 조회 결과의 순서를 정할 때 사용한다.
자주 쓰는 조건 키워드
And는 두 조건을 모두 만족해야 할 때 사용한다.Or는 두 조건 중 하나만 만족해도 될 때 사용한다.GreaterThan은 기준값보다 큰 데이터를 찾을 때 사용한다.GreaterThanEqual은 기준값보다 크거나 같은 데이터를 찾을 때 사용한다.LessThan은 기준값보다 작은 데이터를 찾을 때 사용한다.LessThanEqual은 기준값보다 작거나 같은 데이터를 찾을 때 사용한다.Between은 두 값 사이 범위를 조회할 때 사용한다.IsNull은 값이null인 데이터를 찾을 때 사용한다.IsNotNull은 값이null이 아닌 데이터를 찾을 때 사용한다.StartingWith는 특정 문자열로 시작하는 데이터를 찾을 때 사용한다.EndingWith는 특정 문자열로 끝나는 데이터를 찾을 때 사용한다.Containing은 특정 문자열을 포함하는 데이터를 찾을 때 사용한다.OrderBy는 조회 결과를 정렬할 때 사용한다.Top은 조회 결과 중 일부 개수만 가져올 때 사용한다.IgnoreCase는 대소문자를 구분하지 않고 비교할 때 사용한다.
간단한 조건 조회는
JPQL을 직접 작성하지 않아도 쿼리 메서드 키워드만으로 처리할 수 있다.
하지만 조건이 많아질수록 메서드 이름이 길어진다.
그래서 쿼리 메서드는 간단하고 읽기 쉬운 조건에 사용하는 것이 좋다.
기본예제로 대표 조건 확인하기
아래 예제는
Member엔티티에name과age필드가 있다고 가정한다.
앞에서 사용한Member구조에 조건 조회 연습을 위해age필드가 하나 더 추가된 상황으로 보면 된다.
모든 조건 키워드를 코드로 만들지 않고, 자주 쓰는 대표 조건만 확인한다.// exam06_MemberRepository.java import org.springframework.data.jpa.repository.JpaRepository; import java.util.List; public interface MemberRepository extends JpaRepository<Member, Long> { List<Member> findByAgeGreaterThan(int age); // age보다 큰 회원 조회 List<Member> findByNameContaining(String keyword); // name에 keyword가 포함된 회원 조회 List<Member> findByNameIgnoreCase(String name); // 대소문자 구분 없이 name 조회 List<Member> findTop3ByOrderByAgeDesc(); // age 내림차순 정렬 후 앞의 3명 조회 List<Member> findByNameContainingAndAgeGreaterThan(String keyword, int age); // 이름 포함 + 나이 조건 조회 }
findByAgeGreaterThan(20)은age값이20보다 큰 회원을 조회한다.
GreaterThan은 초과 조건이다.
따라서20은 포함하지 않고,21이상에 해당하는 데이터가 조회 대상이 된다.
findByNameContaining("kim")은name값 안에kim이 포함된 회원을 조회한다.
정확히 같은 이름만 찾는 것이 아니라, 문자열 안에 해당 값이 들어 있는지를 확인한다.
findByNameIgnoreCase("kim")은 대소문자를 구분하지 않고name값을 비교한다.
예를 들어kim,KIM,Kim처럼 대소문자가 달라도 같은 값으로 비교할 수 있다.
findTop3ByOrderByAgeDesc()는age를 기준으로 내림차순 정렬한 뒤 앞에서 3개만 조회한다.
Desc는 내림차순을 의미한다.
반대로 오름차순은Asc를 사용한다.
여기서Top3는 “3개만 가져온다”는 뜻이고,OrderByAgeDesc가 “나이가 많은 순서”라는 기준을 만든다.
findByNameContainingAndAgeGreaterThan("kim", 20)은 이름에kim이 포함되고, 나이가20보다 큰 회원을 조회한다.
And가 들어갔기 때문에 두 조건을 모두 만족해야 한다.
긴 쿼리 메서드 이름 읽는 방법
쿼리 메서드 이름이 길어지면 앞에서부터 의미 단위로 끊어서 읽어야 한다.
예를 들어findByNameContainingAndAgeGreaterThan은 다음처럼 나눌 수 있다.
findByNameContainingAndAgeGreaterThan 읽기
findBy는 조건으로 조회한다는 뜻이다.Name은Member엔티티의name필드를 의미한다.Containing은 문자열 안에 특정 값이 포함되는지 확인한다.And는 앞 조건과 뒤 조건을 모두 만족해야 한다는 뜻이다.Age는Member엔티티의age필드를 의미한다.GreaterThan은 기준값보다 큰지 비교한다.따라서
findByNameContainingAndAgeGreaterThan("kim", 20)은name에kim이 포함되고,age가20보다 큰 회원을 조회한다는 뜻이다.
메서드 이름이 길어져도 이렇게 역할 단위로 끊어 읽으면 조건 구조를 이해할 수 있다.
쿼리 메서드의 장점과 한계
쿼리 메서드의 장점은 코드가 짧고 의도가 바로 보인다는 점이다.
findByName()은 이름으로 조회한다는 뜻이 바로 드러난다.
findByAgeGreaterThan()도 나이가 특정 값보다 큰 데이터를 조회한다는 뜻을 쉽게 알 수 있다.
하지만 조건이 많아지면 문제가 생긴다.
예를 들어 이름 포함, 나이 범위, 정렬, 상위 개수 제한을 모두 메서드 이름에 넣으면 이름이 너무 길어진다.
메서드 이름이 길어지면 오히려 읽기 어려워지고 실수하기 쉽다.
쿼리 메서드는 간단한 조건 조회에 적합하다.
복잡한 조인이나fetch join처럼 조회 구조를 직접 제어해야 하는 경우에는@Query로JPQL을 직접 작성하는 방식이 더 적합할 수 있다.
정리하면, 쿼리 메서드 조건 키워드는 간단한 조회를 빠르게 만들기 위한 도구이다.
키워드의 뜻을 이해하면 직접SQL을 쓰지 않아도 여러 조건 조회를 만들 수 있다.
다만 복잡한 조회까지 모두 메서드 이름으로 해결하려고 하면 코드가 지저분해질 수 있다.
그래서 더 다양한 실제 조건 조회는 응용예제에서 프로젝트Repository코드로 다시 확인한다.
7. 연관관계가 있는 엔티티와 저장소 조회
JPA에서는 엔티티가 다른 엔티티를 필드로 가질 수 있다.
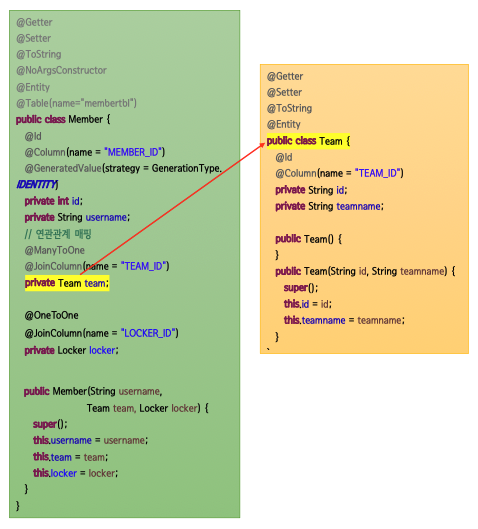
예를 들어 회원을 나타내는Member엔티티가 팀을 나타내는Team엔티티를 필드로 가질 수 있다.
이런 구조를 연관관계라고 한다.
객체 입장에서는Member객체가Team객체를 참조하는 구조이다.
참조는 한 객체가 다른 객체를 필드로 가지고, 그 객체에 접근할 수 있는 상태를 의미한다.
데이터베이스 입장에서는Member테이블이TEAM_ID같은 외래키 컬럼으로Team테이블과 연결되는 구조이다.
외래키는 다른 테이블의 데이터를 가리키는 컬럼이다.
즉, 객체에서는 객체를 참조하고, 테이블에서는 외래키로 연결한다.
JPA연관관계는 객체 참조와 테이블 외래키를 서로 연결해서 사용할 수 있게 해 주는 구조이다.
객체 참조와 외래키 연결
@ManyToOne은 여러 개의 엔티티가 하나의 엔티티를 참조할 수 있다는 뜻이다.
예를 들어 여러 회원이 하나의 팀에 속할 수 있다면Member와Team관계는ManyToOne으로 볼 수 있다.
회원은 여러 명이고, 팀은 하나일 수 있기 때문이다.
@JoinColumn은 두 테이블을 연결할 외래키 컬럼을 지정할 때 사용한다.
@JoinColumn(name = "TEAM_ID")라고 작성하면Member테이블의TEAM_ID컬럼을 사용해서Team테이블과 연결한다는 뜻이다.
이때TEAM_ID는Member가 어떤Team에 속하는지 가리키는 외래키 역할을 한다.
이 구조에서 헷갈리기 쉬운 부분은 객체와 테이블의 연결 방식이 다르다는 점이다.
객체는member.getTeam()처럼 객체를 따라간다.
데이터베이스는TEAM_ID외래키 값을 기준으로 테이블을 연결한다.
JPA는 객체 참조와 테이블 외래키 사이를 매핑해 주는 역할을 한다.
객체에서는
Member가Team객체를 필드로 가지고 있다.
데이터베이스에서는Member테이블의TEAM_ID외래키 컬럼이Team테이블과 연결된다.
이 차이를 이해해야 연관관계 조회가 자연스럽게 이어진다.
Spring Data JPA는 객체의 필드를 따라가면서 연결된 엔티티의 값까지 조회 조건으로 사용할 수 있다.
기본예제로 Member와 Team 관계 확인하기
연관관계는 처음부터 여러 엔티티를 많이 넣으면 복잡해진다.
기본예제에서는Member와Team만 사용해서ManyToOne관계를 확인한다.
Locker같은 추가 관계는 응용예제에서 실제 프로젝트 코드로 보는 편이 좋다.
아래 예제에서는 하나의Team에 여러Member가 속할 수 있다고 가정한다.
그래서Member엔티티 안에Team타입 필드를 두고, 그 필드에@ManyToOne을 붙인다.// exam07_Team.java import jakarta.persistence.Entity; import jakarta.persistence.GeneratedValue; import jakarta.persistence.GenerationType; import jakarta.persistence.Id; @Entity // 데이터베이스 테이블과 매핑될 클래스 public class Team { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.IDENTITY) // 기본키 자동 증가 private Long id; // 팀 기본키 private String name; // 팀 이름 protected Team() { // JPA 기본 생성자 } public Team(String name) { // 팀 이름을 받는 생성자 this.name = name; } public Long getId() { // 팀 기본키 반환 return id; } public String getName() { // 팀 이름 반환 return name; } }// exam07_Member.java import jakarta.persistence.Entity; import jakarta.persistence.GeneratedValue; import jakarta.persistence.GenerationType; import jakarta.persistence.Id; import jakarta.persistence.JoinColumn; import jakarta.persistence.ManyToOne; @Entity // 데이터베이스 테이블과 매핑될 클래스 public class Member { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.IDENTITY) // 기본키 자동 증가 private Long id; // 회원 기본키 private String name; // 회원 이름 @ManyToOne // 여러 회원이 하나의 팀을 참조 @JoinColumn(name = "TEAM_ID") // 외래키 컬럼명 지정 private Team team; // 회원이 속한 팀 protected Member() { // JPA 기본 생성자 } public Member(String name, Team team) { // 회원 이름과 팀 저장 this.name = name; this.team = team; } public Long getId() { // 회원 기본키 반환 return id; } public String getName() { // 회원 이름 반환 return name; } public Team getTeam() { // 회원이 속한 팀 반환 return team; } }
Team은 팀 정보를 나타내는 엔티티이다.
Member는 회원 정보를 나타내는 엔티티이다.
Member안에는Team타입 필드가 있다.
이 필드가 객체 참조를 만든다.
@ManyToOne은 여러Member가 하나의Team을 참조할 수 있다는 뜻이다.
@JoinColumn(name = "TEAM_ID")는 데이터베이스에서 사용할 외래키 컬럼명을 지정한다.
즉, 객체에서는Member가Team객체를 가지고 있고, 테이블에서는Member쪽에TEAM_ID외래키 컬럼이 생긴다고 이해하면 된다.
연결된 엔티티의 필드로 조회하기
연관관계가 설정되면 연결된 엔티티의 필드도 조회 조건으로 사용할 수 있다.
예를 들어Member가Team을 가지고 있고,Team에name필드가 있다면 팀 이름으로 회원을 조회할 수 있다.
이때 쿼리 메서드는 단순히Member의 필드만 보는 것이 아니다.
Member안의team필드로 들어가고, 다시Team안의name필드를 조회 조건으로 사용할 수 있다.// exam07_MemberRepository.java import org.springframework.data.jpa.repository.JpaRepository; import java.util.List; public interface MemberRepository extends JpaRepository<Member, Long> { List<Member> findByTeamName(String teamName); // team.name 값으로 회원 조회 }
findByTeamName()은Member안의team필드로 들어간 뒤, 그 안의name값을 기준으로 조회한다.
즉,Member자체의 단순 필드만 보는 것이 아니라, 연결된Team객체의 필드까지 조건으로 사용할 수 있다.
이 방식은 단순한 컬럼 조회보다 한 단계 더 나아간 조회이다.
객체 관점에서는Member→Team→name흐름으로 조건을 따라간다고 이해하면 된다.
연관 필드 이름을 정확히 맞춰야 하는 이유
연관관계 조회에서도 필드 이름은 정확해야 한다.
findByTeamName()은Member의team필드와Team의name필드가 연결된 이름으로 해석될 수 있다.
즉,team.name경로를 따라가는 조회라고 볼 수 있다.
하지만Team엔티티 안의 필드명이name이 아니라teamName이라면 이야기가 달라진다.
이 경우에는findByTeamName()이라고만 쓰면team.name처럼 읽힐 수 있어 정확하지 않다.
Team안의teamName필드를 기준으로 조회하려면findByTeamTeamName()처럼 작성하거나, 더 분명하게findByTeam_TeamName()처럼 언더스코어로 경로를 나눌 수 있다.
쿼리 메서드는 메서드 이름을 보고 필드 경로를 찾기 때문에, 엔티티 필드명과 경로를 정확히 맞춰야 한다.
필드명이 조금만 달라도Spring Data JPA가 원하는 조회 조건을 만들지 못할 수 있다.
정리하면, 연관관계 조회는 객체가 다른 객체를 참조하는 구조를 바탕으로 한다.
JPA는 객체 참조와 테이블 외래키를 연결하고,Spring Data JPA는 그 연결 구조를 메서드 이름으로 조회할 수 있게 도와준다.
8. @Query와 JPQL
@Query는 쿼리 메서드만으로 표현하기 어려운 조회를 직접 작성할 때 사용하는 어노테이션이다.
쿼리 메서드는 간단한 조건 조회에는 매우 편리하다.
하지만 조건이 많아지거나, 조회 구조를 더 분명하게 직접 작성해야 하는 경우에는 메서드 이름이 지나치게 길어질 수 있다.
이때@Query를 사용하면JPQL을 직접 작성할 수 있다.
JPQL은Java Persistence Query Language의 줄임말이다.
데이터베이스 테이블이 아니라 엔티티 객체를 기준으로 작성하는 쿼리이다.
쿼리 메서드는 메서드 이름으로 조건을 표현하고,@Query는JPQL문자열로 조건을 직접 표현한다.
두 방식은 서로 경쟁하는 것이 아니라, 조회가 단순한지 복잡한지에 따라 나누어 사용하는 방식이다.
쿼리 메서드의 한계
쿼리 메서드는 메서드 이름만 보고 조회 조건을 알 수 있다는 장점이 있다.
예를 들어findByName()은 이름으로 조회한다는 뜻이 바로 보인다.
findByAgeGreaterThan()도 나이가 특정 값보다 큰 데이터를 조회한다는 의미가 분명하다.
하지만 조건이 많아지면 이름이 길어진다.
findByNameContainingAndAgeGreaterThanOrderByAgeDesc()처럼 조건과 정렬이 모두 들어가면 한눈에 읽기 어렵다.
조건이 더 늘어나면 메서드 이름만으로 조회 의도를 표현하는 것이 부담스러워진다.
또한 연관 객체의 필드 조건은 쿼리 메서드로 일부 표현할 수 있지만, 복잡한 조인이나fetch join처럼 조회 구조를 직접 제어해야 하는 경우에는 메서드 이름만으로 표현하기 어렵다.
이럴 때@Query를 사용하면 조회 조건을JPQL로 직접 작성할 수 있다.
쿼리 메서드는 간단한 조건 조회에 적합하고, 복잡한 조회는@Query로 분리하는 것이 더 읽기 좋다.
JPQL은 엔티티 기준으로 작성한다
JPQL은 일반SQL과 비슷해 보이지만 기준이 다르다.
SQL은 데이터베이스 테이블과 컬럼을 기준으로 작성한다.
반면JPQL은 엔티티 클래스와 엔티티 필드를 기준으로 작성한다.
예를 들어Member엔티티의name필드로 조회한다면select m from Member m where m.name = :name처럼 작성한다.
여기서Member는 테이블 이름이 아니라 엔티티 클래스 이름이다.
m.name은 컬럼명이 아니라 엔티티의 필드명이다.
즉,JPQL을 작성할 때는 데이터베이스 테이블 이름을 먼저 떠올리는 것이 아니라,JPA가 관리하는 엔티티 클래스와 그 안의 필드 이름을 기준으로 생각해야 한다.
엔티티 클래스명이 바뀌거나 필드명이 바뀌면JPQL도 그 이름에 맞춰 작성해야 한다.
@Param은JPQL안에 있는 이름과 메서드 매개변수를 연결할 때 사용한다.
:name이라고 작성한 부분은@Param("name")이 붙은 매개변수와 연결된다.
이렇게 하면 매개변수 순서가 아니라 이름을 기준으로 값을 넣을 수 있다.
기본예제로 쿼리 메서드와 @Query 비교하기
같은 조회를 쿼리 메서드와
@Query방식으로 나란히 보면 차이가 분명해진다.
아래 예제는Member의name필드로 회원을 조회하는 가장 단순한 비교이다.// exam08_MemberRepository.java import org.springframework.data.jpa.repository.JpaRepository; import org.springframework.data.jpa.repository.Query; import org.springframework.data.repository.query.Param; import java.util.List; public interface MemberRepository extends JpaRepository<Member, Long> { List<Member> findByName(String name); // 메서드 이름으로 name 조회 @Query("select m from Member m where m.name = :name") // JPQL 직접 작성 List<Member> findMembersByName(@Param("name") String name); // name 값 연결 }
findByName()은 메서드 이름을 보고Spring Data JPA가 쿼리를 자동으로 만든다.
짧고 단순한 조건 조회라면 이 방식이 충분히 좋다.
findMembersByName()은@Query안에JPQL을 직접 작성한다.
select m from Member m where m.name = :name은Member엔티티 중에서name필드가 매개변수 값과 같은 데이터를 조회한다는 뜻이다.
두 방식은 같은 결과를 만들 수 있다.
차이는 쿼리를 어디에 표현하느냐이다.
쿼리 메서드는 메서드 이름에 조건을 표현하고,@Query는JPQL문자열 안에 조건을 표현한다.
이 예제처럼 조건이 단순하면 쿼리 메서드가 더 짧고 편하다.
하지만 조건이 길어지거나 조회 구조를 직접 보여 주고 싶다면@Query가 더 읽기 쉬울 수 있다.
Param과 join fetch 이해하기
@Param은JPQL의 이름과 메서드 매개변수를 연결한다.
예를 들어:name은@Param("name") String name과 연결된다.
이렇게 작성하면 매개변수가 여러 개 있어도 어떤 값이 어디에 들어가는지 분명해진다.
join fetch는 연관된 엔티티를 함께 조회할 때 사용한다.
예를 들어Member를 조회하면서Team도 함께 가져오고 싶을 때 사용할 수 있다.
다만join fetch는 연관관계와 로딩 전략까지 함께 생각해야 하므로 기본예제에서는 개념만 잡고, 실제 프로젝트 소스 기반 응용예제에서 자세히 보는 편이 좋다.
복잡한 동적 쿼리는 쿼리 메서드와@Query만으로 부족할 수 있다.
동적 쿼리는 조건이 실행 시점에 달라지는 쿼리를 의미한다.
이런 경우에는QueryDSL같은 별도 기술을 사용하는 것이 더 적합할 수 있다.
정리하면, 간단한 조건은 쿼리 메서드로 충분하다.
조건이 복잡하거나 직접 쿼리 흐름을 명확히 쓰고 싶다면@Query와JPQL을 사용한다.
두 방식은 경쟁 관계가 아니라 상황에 따라 나누어 쓰는 방식이다.
9. 스프링 부트 애플리케이션에 설정된 어노테이션
Spring Boot애플리케이션은 시작 클래스의 어노테이션을 기준으로 필요한 객체와 설정을 찾는다.
시작 클래스는main()메서드를 가지고 애플리케이션을 실행하는 클래스이다.
보통 프로젝트를 만들면프로젝트명Application같은 이름으로 자동 생성된다.
Spring Boot는 시작 클래스가 있는 패키지를 기준으로 그 아래 하위 패키지를 훑으면서 필요한 클래스를 찾는다.
프로젝트 구조가 단순하고 시작 클래스 아래쪽 패키지에 코드가 모여 있으면 대부분 자동으로 인식된다.
하지만 엔티티나 저장소가 기본 스캔 범위 밖에 있으면 직접 위치를 지정해야 한다.
이 주제에서는@SpringBootApplication,@ComponentScan,@EnableAutoConfiguration,@EnableJpaRepositories,@EntityScan이 각각 어떤 역할을 하는지 정리한다.
코드 예제는 새 기능을 배우기 위한 예제가 아니라, 어노테이션이 어디에 붙고 어떤 범위를 지정하는지 확인하는 용도로 보면 된다.
SpringBootApplication
@SpringBootApplication은Spring Boot애플리케이션의 가장 기본이 되는 어노테이션이다.
이 어노테이션은 애플리케이션 시작 클래스에 붙는다.
@SpringBootApplication안에는 여러 설정이 포함되어 있다.
대표적으로@ComponentScan과@EnableAutoConfiguration이 포함된다.
그래서 시작 클래스에@SpringBootApplication을 붙이면 컴포넌트 탐색과 자동 설정이 함께 동작한다.
@ComponentScan은Spring이 관리할 일반 컴포넌트를 어디에서 찾을지 정한다.
컴포넌트는Spring이 객체로 만들어 관리할 대상을 의미한다.
예를 들어@Controller,@Service,@Component, 일반@Repository가 붙은 클래스들이 스캔 대상이 될 수 있다.
다만JpaRepository를 상속한Spring Data JPA Repository인터페이스는 일반 컴포넌트 클래스와 구분해서 이해해야 한다.
이 저장소 인터페이스들은 뒤에서 설명하는@EnableJpaRepositories가 담당한다.
@EnableAutoConfiguration은 현재 프로젝트의 의존성과 설정을 보고 필요한 설정을 자동으로 구성한다.
예를 들어 앞에서 본 것처럼Spring Data JPA의존성이 있으면DataSource자동 설정도 시도된다.
@SpringBootApplication은 단순 실행 표시가 아니라, 컴포넌트 탐색과 자동 설정의 출발점이다.
그래서 시작 클래스가 어디에 있는지가 중요하다.
Repository와 Entity 스캔 범위
Spring Data JPA를 사용하려면JPA Repository인터페이스와 엔티티 클래스를Spring Boot가 찾을 수 있어야 한다.
시작 클래스의 하위 패키지에repository와entity가 있다면 보통 자동으로 인식된다.
하지만 패키지 위치가 기본 스캔 범위 밖에 있으면 직접 위치를 지정해야 한다.
이때@EnableJpaRepositories와@EntityScan을 사용할 수 있다.
@EnableJpaRepositories는JPA Repository인터페이스를 활성화하고, 어디에서 찾을지 지정한다.
즉,JpaRepository를 상속한 저장소 인터페이스들이 어느 패키지에 있는지 알려 주는 설정이다.
@EntityScan은 엔티티 클래스를 어디에서 찾을지 지정한다.
즉,@Entity가 붙은 클래스들이 어느 패키지에 있는지 알려 주는 설정이다.
여기서@ComponentScan,@EnableJpaRepositories,@EntityScan의 역할을 구분해야 한다.
@ComponentScan은 일반적인Spring컴포넌트를 찾는다.
@EnableJpaRepositories는JPA Repository인터페이스를 찾는다.
@EntityScan은JPA엔티티 클래스를 찾는다.
JPA Repository와Entity가 자동으로 인식되지 않는 문제는 코드 내용보다 패키지 위치 때문에 발생할 수 있다.
그래서Spring Boot프로젝트에서는 시작 클래스 위치와 패키지 구조가 중요하다.
어노테이션 위치 확인하기
아래 코드는 애플리케이션 시작 클래스에 어노테이션을 설정하는 형태이다.
패키지 구조가 기본 스캔 범위 안에 있다면@EnableJpaRepositories와@EntityScan은 생략될 수 있다.
하지만JPA Repository나Entity가 기본 스캔 범위 밖에 있거나, 위치를 명확히 지정해야 하는 경우에는 다음처럼 작성할 수 있다.// exam09_SpringjpaeduApplication.java import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; import org.springframework.data.jpa.repository.config.EnableJpaRepositories; import org.springframework.boot.autoconfigure.domain.EntityScan; @SpringBootApplication // 스프링 부트 기본 설정 @EnableJpaRepositories(basePackages = {"com.example.springjpaedu.repository"}) // JPA Repository 위치 지정 @EntityScan(basePackages = {"com.example.springjpaedu.entity"}) // Entity 위치 지정 public class SpringjpaeduApplication { public static void main(String[] args) { SpringApplication.run(SpringjpaeduApplication.class, args); // 애플리케이션 실행 } }
@SpringBootApplication은 애플리케이션 실행의 기준이 되는 설정이다.
@EnableJpaRepositories는JPA Repository인터페이스를 찾을 위치를 지정한다.
@EntityScan은 엔티티 클래스를 찾을 위치를 지정한다.
이 설정이 필요한 상황은 패키지 구조가 기본 스캔 범위와 맞지 않을 때이다.
반대로 시작 클래스 하위 패키지에controller,service,repository,entity가 모두 있다면 별도 설정 없이도 인식될 수 있다.
정리하면,Spring Boot는 자동으로 많은 설정을 처리하지만 아무 위치에서나 클래스를 찾는 것은 아니다.
자동 설정과 자동 스캔은 정해진 기준 안에서 동작한다.
따라서 프로젝트 구조와 패키지 위치를 이해해야JPA Repository나 엔티티가 인식되지 않는 문제를 줄일 수 있다.
10. 학습한 스프링 부트 구조
앞에서
Spring Data JPA,Repository, 쿼리 메서드,@Query를 각각 따로 봤다.
이제 이 개념들이Spring Boot웹 애플리케이션 전체 구조 안에서 어디에 들어가는지 정리해야 한다.
개념을 따로 알더라도 전체 흐름을 모르면 실제 프로젝트에서 어떤 코드가 어디에 있어야 하는지 헷갈릴 수 있다.
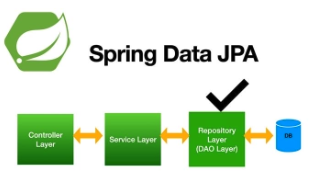
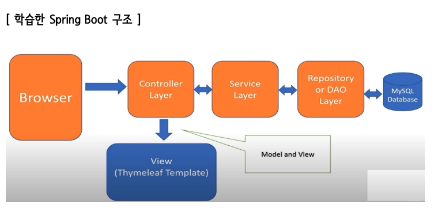
Spring Boot웹 애플리케이션은 보통 요청을 받는 계층, 처리 흐름을 담당하는 계층, 데이터베이스에 접근하는 계층, 화면을 만드는 계층으로 나뉜다.
각 계층이 자기 역할만 맡으면 코드 구조가 분명해진다.
여기서 말하는Repository는 데이터베이스 접근을 담당하는 계층이고,Spring Data JPA Repository인터페이스도 이 계층에 포함된다.
Spring Data JPA는 전체 구조에서 데이터베이스 접근을 담당하는Repository Layer를 편하게 만들어 주는 기술이다.
요청 처리 흐름을 계층으로 나누어 보기
브라우저에서 요청이 들어오면 가장 먼저
Controller Layer가 요청을 받는다.
Controller는 요청 주소와 요청 데이터를 확인하고, 필요한 처리를 다음 계층으로 넘긴다.
여기서 요청 주소는 사용자가 접근한URL이고, 요청 데이터는 폼 입력값이나 파라미터처럼 서버로 전달된 값을 의미한다.
실제 업무 규칙이나 처리 흐름은Service Layer에서 담당한다.
예를 들어 저장하기 전에 값을 검사하거나, 여러 데이터 접근 작업을 하나의 흐름으로 묶는 처리가 여기에 들어갈 수 있다.
Service는 단순히 데이터를 가져오는 곳이 아니라, 애플리케이션의 처리 순서를 정리하는 계층이다.
다만 단순 실습 예제에서는Service계층을 생략하고Controller가Repository를 직접 호출하기도 한다.
이 경우에도 역할 개념은 같다.
실제 데이터베이스 접근은 여전히Repository가 담당한다.
데이터베이스 접근이 필요하면Service는Repository Layer를 사용한다.
Service계층을 생략한 실습에서는Controller가 바로Repository를 사용한다.
Repository는 엔티티를 기준으로 데이터베이스에 접근한다.
Entity는 데이터베이스 테이블과 매핑되는 객체이다.
이때Spring Data JPA가Repository인터페이스의 구현체를 자동으로 만들어 주기 때문에 데이터 접근 코드가 단순해진다.
Controller는 요청을 받고,Service는 처리 흐름을 담당하며,Repository는 데이터베이스 접근을 맡는다.
Spring Data JPA는 이 중에서Repository Layer를 지원하므로,Controller나Service가 직접 데이터베이스 세부 처리 코드를 작성하지 않게 해 준다.
이 구조를 잡아 두면 역할이 섞이지 않는다.
화면 요청 처리는Controller, 비즈니스 흐름은Service, 데이터 접근은Repository가 담당한다고 나누어 생각하면 된다.
실습처럼Service가 생략된 구조를 보더라도, 데이터베이스 접근 역할은Repository가 맡는다는 기준은 그대로 유지된다.
데이터가 화면으로 돌아오는 흐름
데이터베이스에서 조회한 결과는 다시
Repository에서Service로 전달된다.
Service가 있다면 필요한 처리를 마친 뒤Controller로 결과를 넘긴다.
Service가 생략된 실습 구조에서는Repository의 조회 결과가Controller에서 바로 화면 응답 준비에 사용될 수 있다.
Controller는 이 데이터를 화면에서 사용할 수 있도록Model에 담는다.
Model은Controller가View에 데이터를 전달할 때 사용하는 저장 공간으로 이해하면 된다.
예를 들어 회원 목록을 화면에 보여 주고 싶다면,Controller는 조회한 회원 목록을Model에 담고 화면 이름을 반환한다.
그러면View는Model에 담긴 데이터를 사용해서 화면을 만든다.
화면을 만드는 역할은View가 담당한다.
Spring Boot에서Thymeleaf를 사용한다면templates폴더에 있는Thymeleaf Template이 화면을 만든다.
최종적으로 만들어진HTML이 브라우저에 응답된다.
즉, 전체 흐름은 요청이 들어오는 방향과 응답이 나가는 방향을 함께 봐야 한다.
기본 흐름은Browser→Controller→Service→Repository→Database방향으로 이동한다.
실습처럼Service가 없다면Browser→Controller→Repository→Database방향으로 이해하면 된다.
응답은 다시 데이터베이스 조회 결과가Controller로 돌아오고,Model이나ModelAndView를 거쳐View에서 화면으로 만들어진다.
Spring Boot웹 애플리케이션은 요청을 받는 계층과 데이터를 처리하는 계층, 데이터베이스에 접근하는 계층, 화면을 만드는 계층이 연결되어 동작한다.
Repository가 조회한 데이터는 다시Service와Controller를 거쳐Model에 담기고,View는 그 데이터를 사용해 최종 화면을 만든다.
이 흐름에서Entity는 데이터베이스 테이블과 매핑되는 객체이다.
Repository는 이Entity를 기준으로 저장, 조회, 삭제 작업을 수행한다.
따라서Spring Data JPA를 이해할 때는Repository만 따로 보는 것이 아니라,Entity,Service,Controller,Model,View와 이어지는 흐름까지 함께 봐야 한다.
화면으로 보낼지, 다른 주소로 보낼지, 데이터로 보낼지
Controller는 항상 같은 방식으로 응답하지 않는다.
어떤 요청은 화면을 보여 줘야 하고, 어떤 요청은 저장 후 목록 화면으로 다시 이동해야 한다.
또 어떤 요청은 화면 전체가 아니라 데이터만 응답해야 한다.
ModelAndView는 화면 이름과 화면에 전달할 데이터를 함께 담는 객체이다.
Model은 화면에 전달할 데이터만 담는 객체이다.
둘 다View에 데이터를 넘긴다는 점은 비슷하지만,ModelAndView는 화면 이름까지 함께 가진다는 차이가 있다.
redirect:는 응답 후 다른 요청 주소로 다시 이동시키는 방식이다.
예를 들어 저장을 마친 뒤redirect:/list를 반환하면, 브라우저는 다시/list주소로 요청을 보낸다.
이 방식은 저장 후 목록 화면을 새로 조회해서 보여 줄 때 자주 사용된다.
@ResponseBody는 화면 이름을 반환하는 것이 아니라 응답 본문 자체를 반환하게 만든다.
일반적인Controller메서드가 문자열을 반환하면 그 문자열을 화면 이름으로 해석할 수 있다.
하지만@ResponseBody가 붙으면 반환값이 화면 이름이 아니라 실제 응답 데이터가 된다.
JSON은 객체 데이터를 화면에서 다루기 쉬운 문자열 형태로 표현한 것이다.
예를 들어 객체의id,name,memo같은 값을 화면의JavaScript에서 사용해야 할 때JSON응답이 자주 사용된다.
화면을 보여 줄 때는View, 저장 후 다시 이동할 때는redirect, 데이터만 보낼 때는@ResponseBody와JSON흐름을 생각하면 된다.// exam10_ResponseController.java import org.springframework.stereotype.Controller; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.ResponseBody; import org.springframework.web.servlet.ModelAndView; import java.util.Map; @Controller // 웹 요청을 처리하는 클래스 public class ResponseController { @GetMapping("/sample-view") // 화면 응답 요청 public ModelAndView sampleView() { ModelAndView mav = new ModelAndView(); // 데이터와 화면 이름을 담는 객체 생성 mav.addObject("msg", "목록 화면"); // 화면에 전달할 데이터 저장 mav.setViewName("sampleView"); // 보여 줄 화면 이름 지정 return mav; // 화면 응답 } @GetMapping("/sample-redirect") // 다시 이동할 요청 public String sampleRedirect() { return "redirect:/sample-view"; // 다른 주소로 다시 요청 } @GetMapping("/sample-json") // 데이터 응답 요청 @ResponseBody // 반환값을 응답 본문으로 전달 public Map<String, Object> sampleJson() { return Map.of("result", true); // JSON 형태로 변환될 데이터 반환 } }이 예제는
Controller가 응답을 만드는 대표 흐름을 보여 준다.
sampleView()는ModelAndView에 데이터와 화면 이름을 담아 화면을 보여 준다.
sampleRedirect()는 화면 이름을 직접 반환하는 것이 아니라/sample-view주소로 다시 이동시킨다.
sampleJson()은@ResponseBody가 붙어 있으므로 화면 이름이 아니라 데이터 자체를 응답한다.
이 흐름을 알면 응용예제에서ModelAndView,redirect:/vlist,@ResponseBody,JSON응답이 나와도 덜 헷갈린다.
전체 구조에서 헷갈리기 쉬운 부분
초보자가 가장 많이 헷갈리는 부분은
Repository와Service의 차이이다.
Repository는 데이터베이스 접근을 담당한다.
반면Service는 애플리케이션의 처리 흐름과 비즈니스 로직을 담당한다.
예를 들어 회원 목록을 조회한다고 할 때, 실제 데이터베이스에서 회원을 가져오는 작업은Repository가 담당한다.
그 회원 목록을 어떤 조건으로 가공하거나, 다른 처리와 묶는 흐름은Service가 담당한다.
즉,Repository는 데이터 접근에 집중하고,Service는 처리 흐름에 집중한다.
Controller와Service도 다르다.
Controller는 웹 요청과 응답에 가까운 계층이다.
요청 주소를 받고, 요청 데이터를 읽고, 화면에 전달할 데이터를 준비한다.
Service는 요청 방식과 상관없이 실제 처리 흐름을 담당하는 계층이다.
다만 현재 실습처럼 예제가 단순하면Service없이Controller에서 바로Repository를 호출할 수 있다.
이 구조가 보인다고 해서Repository와Service의 역할 구분이 사라지는 것은 아니다.
실습에서는 흐름을 단순하게 보기 위해 중간 계층을 생략한 것으로 이해하면 된다.
Entity와View도 역할이 다르다.
Entity는 데이터베이스 테이블과 연결되는 객체이다.
View는 사용자에게 보여 줄 화면을 만드는 영역이다.
따라서Entity를 화면 출력용 객체처럼 막 사용하거나,View에서 데이터베이스 접근을 직접 처리하는 식으로 역할을 섞으면 구조가 복잡해진다.
정리하면,Spring Boot구조는 역할 분리를 위한 구조이다.
Controller는 요청과 응답을 담당한다.
Service는 처리 흐름을 담당한다.
Repository는 데이터베이스 접근을 담당한다.
Entity는 데이터베이스 테이블과 매핑된다.
View는 최종 화면을 만든다.
Spring Data JPA는 이 중 데이터 접근 계층을 단순하게 만들어 준다.
이 전체 흐름을 알고 있으면 뒤에서 프로젝트 실제 소스를 응용예제로 볼 때 코드 위치와 역할을 더 쉽게 이해할 수 있다.
11. 스프링 부트 테스트
Spring Boot는 애플리케이션을 실행해서 직접 확인하는 방법뿐 아니라, 테스트 코드로 기능을 확인하는 방법도 제공한다.
테스트 코드는 특정 기능이 의도대로 동작하는지 확인하기 위해 작성하는 코드이다.
특히Repository는 데이터가 제대로 저장되고 조회되는지 확인해야 하므로 테스트 코드와 잘 어울린다.
Spring Boot에서는spring-boot-starter-test의존성을 사용하면 테스트에 필요한 여러 도구를 함께 사용할 수 있다.
이 안에는JUnit 5,Spring Test,Spring Boot Test,AssertJ,Hamcrest,Mockito,JSONassert,JsonPath같은 라이브러리가 포함된다.
이 도구들은 테스트를 실행하고, 결과를 검증하고, 필요한 경우 가짜 객체나JSON응답을 확인하는 데 사용된다.
테스트 라이브러리와 테스트 어노테이션
JUnit 5는Java애플리케이션에서 테스트 코드를 작성하고 실행하는 대표적인 도구이다.
테스트 메서드에@Test를 붙이면 해당 메서드를 테스트로 실행할 수 있다.
Spring Test와Spring Boot Test는Spring Boot애플리케이션을 테스트할 수 있도록 도와준다.
일반Java코드만 테스트하는 것이 아니라,Spring이 관리하는 빈과 설정까지 함께 테스트할 수 있게 해 준다.
AssertJ는 테스트 결과를 읽기 쉬운 문장처럼 검증할 수 있게 해주는 라이브러리이다.
예를 들어 조회 결과가 존재하는지, 저장된 값이 예상한 값과 같은지 확인할 때 사용할 수 있다.
Mockito는 실제 객체 대신 가짜 객체를 만들어 특정 상황을 테스트할 때 사용한다.
JSONassert와JsonPath는JSON응답 값을 확인할 때 사용할 수 있다.
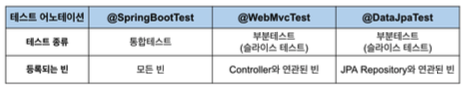
Spring Boot는 테스트 목적에 따라 여러 어노테이션을 제공한다.
@SpringBootTest는 애플리케이션 전체를 대상으로 테스트할 때 사용한다.
전체 설정과 빈을 많이 로딩하기 때문에 통합 테스트에 가깝다.
@WebMvcTest는 웹 계층을 중심으로 테스트할 때 사용한다.
주로Controller가 요청을 잘 받는지, 응답을 잘 만드는지 확인할 때 사용한다.
@DataJpaTest는JPA Repository를 중심으로 테스트할 때 사용한다.
전체 애플리케이션을 모두 로딩하지 않고,JPA와Repository테스트에 필요한 부분을 중심으로 준비한다.
테스트 어노테이션은 목적에 따라 로딩하는 범위가 다르다.
전체 흐름을 확인할 때는@SpringBootTest, 웹 계층만 확인할 때는@WebMvcTest, 데이터 접근 계층만 확인할 때는@DataJpaTest를 사용한다.
테스트 범위를 적절히 줄이면 확인하려는 대상이 분명해진다.
Repository동작만 확인하고 싶은데 전체 애플리케이션을 모두 실행할 필요는 없다.
DataJpaTest의 기본 동작
@DataJpaTest는JPA Repository테스트에 집중하는 어노테이션이다.
이 어노테이션을 사용하면 엔티티 클래스와JPA Repository관련 설정을 중심으로 테스트 환경이 구성된다.
즉, 화면이나 전체 웹 요청 흐름이 아니라 데이터 접근 계층을 확인하는 데 집중한다.
@DataJpaTest에는@Transactional이 포함되어 있다.
@Transactional은 하나의 작업 단위를 트랜잭션으로 묶는 설정이다.
트랜잭션은 데이터베이스 작업을 하나의 단위로 처리하는 개념이다.
테스트에@Transactional이 적용되어 있으면 테스트가 끝난 뒤 기본적으로 롤백된다.
롤백은 테스트 중 변경한 데이터를 원래 상태로 되돌리는 동작이다.
그래서@DataJpaTest로 저장 테스트를 하더라도 기본적으로 실제 데이터베이스에 테스트 결과가 남지 않는다.
이 말은 테스트 중에 저장이 안 된다는 뜻이 아니다.
테스트가 실행되는 동안에는 저장과 조회가 정상적으로 동작한다.
다만 테스트가 끝난 뒤에는 변경 내용이 되돌아가기 때문에, 실제DB에는 테스트 데이터가 남지 않는다.
테스트 결과를 실제 데이터베이스에 남기고 싶다면@Rollback(false)를 추가한다.
하지만 일반적인 테스트에서는 데이터가 계속 남으면 다음 테스트에 영향을 줄 수 있으므로 기본 롤백이 안전하다.
테스트 데이터베이스 설정
@DataJpaTest를 사용할 때 클래스패스에H2같은 내장 데이터베이스가 있으면 테스트용 내장 데이터베이스가 자동으로 설정될 수 있다.
내장 데이터베이스는 테스트를 빠르게 실행하기 위해 메모리 기반으로 사용하는 데이터베이스이다.
하지만 실제 프로젝트에서 설정한MySQL같은 외부 데이터베이스로 테스트하고 싶을 수도 있다.
이때는@AutoConfigureTestDatabase(replace = Replace.NONE)을 사용한다.
replace = Replace.NONE은 테스트가 임의로 내장 데이터베이스로 바꾸지 말고, 현재 프로젝트에 설정된 데이터베이스 연결 정보를 사용하라는 뜻이다.
즉,application.properties에 설정한 실제 데이터베이스 연결 정보를 기준으로 테스트하게 된다.
@DataJpaTest는 테스트 범위를Repository중심으로 줄이고, 테스트 후 데이터를 롤백하며, 필요에 따라 테스트 데이터베이스를 조정할 수 있다.
기본예제로 Repository 테스트 흐름 확인하기
Repository테스트는 저장소가 실제로 엔티티를 저장하고 다시 조회할 수 있는지 확인하는 데 사용한다.
아래 예제는MemberRepository를 기준으로save()후findById()로 다시 조회하는 흐름만 확인한다.
예제에서는@DataJpaTest를 사용해Repository테스트 환경을 준비한다.
실제 프로젝트의MySQL설정을 그대로 사용해야 하는 상황이라면@AutoConfigureTestDatabase(replace = Replace.NONE)설정을 추가해서 내장 데이터베이스로 바뀌지 않게 할 수 있다.// exam11_MemberRepositoryTest.java import org.junit.jupiter.api.Test; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.boot.data.jpa.test.autoconfigure.DataJpaTest; import java.util.Optional; import static org.assertj.core.api.Assertions.assertThat; @DataJpaTest // JPA Repository 테스트 환경 준비 class MemberRepositoryTest { @Autowired // 자동 생성된 Repository 구현체 주입 MemberRepository memberRepository; @Test // 저장 후 기본키로 다시 조회 void saveAndFindById() { Member member = new Member("kim"); // 저장할 엔티티 생성 Member savedMember = memberRepository.save(member); // 엔티티 저장 Optional<Member> result = memberRepository.findById(savedMember.getId()); // 기본키로 조회 assertThat(result).isPresent(); // 조회 결과가 있는지 검증 assertThat(result.get().getName()).isEqualTo("kim"); // 이름 값 검증 } }이 테스트는 먼저
Member엔티티를 생성한다.
그 다음memberRepository.save(member)로 데이터베이스에 저장한다.
저장된 엔티티의 기본키를 사용해findById()로 다시 조회한다.
assertThat(result).isPresent()는 조회 결과가 존재하는지 확인한다.
assertThat(result.get().getName()).isEqualTo("kim")은 조회된 엔티티의 이름이 저장한 값과 같은지 확인한다.
여기서 중요한 점은 테스트가 단순히 코드가 실행되는지만 보는 것이 아니라는 점이다.
저장한 데이터가 다시 조회되는지, 조회된 값이 예상과 같은지까지 확인한다.
또 하나 중요한 점은@DataJpaTest의 기본 롤백 동작이다.
테스트 안에서는 저장과 조회가 정상적으로 확인되지만, 테스트가 끝나면 기본적으로 변경 내용이 되돌아간다.
그래서 테스트가 끝난 뒤 실제 데이터베이스에서kim데이터가 보이지 않아도, 그것만으로 저장 테스트가 실패했다고 판단하면 안 된다.
정리하면, 테스트는 기능을 눈으로만 확인하는 대신 코드로 검증하는 방법이다.
@DataJpaTest는Repository테스트에 필요한 환경을 준비하고, 기본적으로 테스트 후 데이터를 롤백한다.
그래서Spring Data JPA실습에서는 저장소 메서드가 제대로 동작하는지 확인하는 데 자주 사용된다.
응용예제 1. Emp 엔티티와 기본 Repository 조회 흐름 (Emp.java, EmpRepository1.java, EmpController.java, empResult.html)
앞 개념에서
Entity는 데이터베이스 테이블과 매핑되는 객체라고 정리했다.
또Repository는 엔티티를 기준으로 데이터베이스에 접근하는 계층이라고 정리했다.
이번 예제에서는 이 두 개념이Emp엔티티와EmpRepository1코드에서 실제로 어떻게 사용되는지 확인한다.
이 예제의 흐름은 어렵게 볼 필요가 없다.
먼저Emp클래스가 사원 테이블과 연결되는 엔티티 역할을 한다.
그 다음EmpRepository1이Emp엔티티를 조회하는 저장소 역할을 한다.
마지막으로EmpController가 브라우저 요청을 받아 저장소 메서드를 호출하고, 조회 결과를 화면으로 전달한다.
전체 흐름은브라우저 요청→EmpController→EmpRepository1→Emp엔티티 기준 조회 →empResult.html화면 출력 순서로 이어진다.
이 예제는 앞에서 정리한Entity,Repository,JpaRepository,Controller,ModelAndView흐름을 실제 코드로 확인하는 첫 번째 응용예제이다.
앞 개념과 연결해서 보기
앞에서
JpaRepository<T, ID>를 정리할 때,T는 저장소가 다룰 엔티티 타입이고ID는 기본키 타입이라고 했다.
이번 예제에서는 이 개념이EmpRepository1코드에 그대로 나타난다.// EmpRepository1.java package com.example.springjpaedu.repository; import com.example.springjpaedu.entity.Emp; import org.springframework.data.jpa.repository.JpaRepository; public interface EmpRepository1 extends JpaRepository<Emp, Integer> { // 기본 메서드는 JpaRepository가 제공한다 }
EmpRepository1은Emp데이터를 다루는 저장소 인터페이스이다.
여기서 중요한 부분은JpaRepository<Emp, Integer>이다.
Emp는 이 저장소가 다룰 엔티티 타입이다.
즉, 이 저장소는 아무 테이블이나 다루는 저장소가 아니라,Emp엔티티에 매핑된 데이터만 다루는 저장소이다.
Integer는Emp엔티티의 기본키 타입이다.
Emp클래스에서 기본키 역할을 하는 필드는empno이고, 이 필드는int타입이다.
JpaRepository의 기본키 타입 자리에는 객체 타입을 적기 때문에Integer를 사용한다.
따라서EmpRepository1 extends JpaRepository<Emp, Integer>는 “Emp엔티티를Integer기본키로 다루는 저장소를 만들겠다”는 선언이다.
이 선언만 해도Spring Data JPA가 실행 시점에 구현 객체를 자동으로 만들어 준다.
개발자는 저장소 구현 클래스를 직접 만들지 않아도count(),findAll()같은 기본 메서드를 사용할 수 있다.
이 점이Spring Data JPA를 사용하는 가장 큰 이유 중 하나이다.
Emp 엔티티 구조 확인하기
Emp클래스는 데이터베이스의 사원 정보를Java객체로 다루기 위한 엔티티이다.
엔티티는 데이터베이스 테이블과 연결되는 클래스이다.
사원 한 명의 데이터가 데이터베이스에서는 한 행으로 저장되고,Java코드에서는Emp객체 하나로 다뤄진다고 이해하면 된다.// Emp.java package com.example.springjpaedu.entity; import jakarta.persistence.Column; import jakarta.persistence.Entity; import jakarta.persistence.Id; import lombok.Getter; import lombok.Setter; import lombok.ToString; @Entity // 데이터베이스 테이블과 매핑될 클래스 @Setter // setter 메서드 자동 생성 @Getter // getter 메서드 자동 생성 @ToString // 객체 정보를 문자열로 출력 public class Emp { @Id // 기본키 필드 private int empno; // 사원 번호 @Column(length = 14) // 컬럼 길이 지정 private String ename; // 사원 이름 @Column(length = 30) // 컬럼 길이 지정 private String job; // 직무 private Integer mgr; // 관리자 번호 private java.sql.Date hiredate; // 입사일 private int sal; // 급여 private Integer comm; // 커미션 private Integer deptno; // 부서 번호 }
@Entity가 붙었기 때문에Emp클래스는JPA가 관리하는 엔티티가 된다.
이 말은Emp객체가 데이터베이스 테이블의 한 행과 연결될 수 있다는 뜻이다.
@Id가 붙은empno는 기본키이다.
기본키는 각 데이터를 구분하는 고유한 값이다.
사원 테이블에서는 사원 번호가 각 사원을 구분하는 기준이 되므로empno가 기본키 역할을 한다.
ename,job,mgr,hiredate,sal,comm,deptno는 사원 정보에 해당하는 필드이다.
ename은 사원 이름이고,job은 직무이다.
hiredate는 입사일이고,sal은 급여이다.
이런 필드들이 데이터베이스 컬럼과 연결된다.
@Column(length = 14)처럼 작성하면 컬럼의 세부 정보를 지정할 수 있다.
여기서는ename컬럼의 길이를14로 지정하고,job컬럼의 길이를30으로 지정한다.
따로 지정하지 않은 필드는 기본 매핑 규칙에 따라 컬럼과 연결된다.
여기서mgr,comm,deptno는Integer타입이다.
int는 값이 반드시 있어야 하는 기본형 타입이다.
반면Integer는 값이 없을 수 있는 객체 타입이다.
데이터베이스에서null이 들어올 수 있는 컬럼이라면Integer처럼 객체 타입을 사용하는 것이 더 안전하다.
예를 들어 커미션이 없는 사원은comm값이null일 수 있다.
이런 값을int로 받으면null을 표현하기 어렵다.
그래서 값이 없을 가능성이 있는 컬럼은Integer로 두는 흐름이 자연스럽다.
이 예제에서 중요한 점은Emp가 단순한Java클래스가 아니라는 점이다.
@Entity와@Id를 통해JPA가 데이터베이스 테이블과 연결해서 사용할 수 있는 클래스가 된다.
Controller에서 Repository를 사용하는 흐름
앞 개념에서는 일반적인 구조를
Controller→Service→Repository→Database흐름으로 정리했다.
다만 단순 실습 예제에서는Service계층을 생략하고Controller가Repository를 직접 호출하기도 한다고 했다.
이번 예제의EmpController가 바로 그런 구조이다.
EmpController는EmpRepository1을 직접 주입받고, 요청이 들어오면dao.count()나dao.findAll()을 호출한다.
여기서dao라는 이름은 데이터베이스 접근 객체처럼 쓰이는 저장소를 가리킨다.// EmpController.java package com.example.springjpaedu.controller; import com.example.springjpaedu.entity.Emp; import com.example.springjpaedu.repository.EmpRepository1; import lombok.RequiredArgsConstructor; import org.springframework.stereotype.Controller; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.servlet.ModelAndView; import java.util.List; @Controller // 웹 요청을 처리하는 클래스 @RequiredArgsConstructor // final 필드를 받는 생성자 자동 생성 public class EmpController { private final EmpRepository1 dao; // Emp 데이터 접근 저장소 @GetMapping("/countnum") // /countnum 요청 처리 public ModelAndView count() { ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 long num = dao.count(); // Emp 데이터 개수 조회 mav.addObject("num", num); // 조회한 개수를 화면에 전달 mav.setViewName("empResult"); // empResult.html 화면으로 이동 return mav; // 화면 응답 } @GetMapping("/list") // /list 요청 처리 public ModelAndView list() { ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 List<Emp> list = dao.findAll(); // Emp 전체 데이터 조회 list.parallelStream().forEach(System.out::println); // 콘솔에 조회 결과 출력 mav.addObject("list", list); // 조회 목록을 화면에 전달 mav.setViewName("empResult"); // empResult.html 화면으로 이동 return mav; // 화면 응답 } }
@Controller는 이 클래스가 웹 요청을 처리하는 클래스라는 뜻이다.
브라우저에서/countnum이나/list로 요청을 보내면EmpController안의 메서드가 실행된다.
@GetMapping("/countnum")은GET방식으로 들어온/countnum요청을count()메서드와 연결한다.
@GetMapping("/list")는/list요청을list()메서드와 연결한다.
즉, 요청 주소에 따라 실행되는 메서드가 달라진다.
@RequiredArgsConstructor는final필드를 초기화하는 생성자를 자동으로 만들어 준다.
여기서는private final EmpRepository1 dao를 생성자를 통해 주입받을 수 있게 해 준다.
즉,EmpController는EmpRepository1을 직접 만들어 쓰는 것이 아니라,Spring이 만들어 둔 저장소 객체를 주입받아 사용한다.
이 흐름은 앞 개념에서 정리한Spring빈과 연결된다.
Spring Data JPA가EmpRepository1의 구현 객체를 자동으로 만들고,Spring이 그 객체를EmpController에 넣어 준다.
그래서EmpController는dao.count()와dao.findAll()을 바로 호출할 수 있다.
과거 방식에서는DAO구현 클래스를 직접 만들고 데이터베이스 접근 코드를 작성해야 했다.
하지만 여기서는Spring Data JPA가 만든Repository구현 객체를 사용한다.
실습에서는Controller가Repository를 바로 호출하지만, 데이터베이스 접근 역할은 여전히Repository가 담당한다.
count 요청 흐름 확인하기
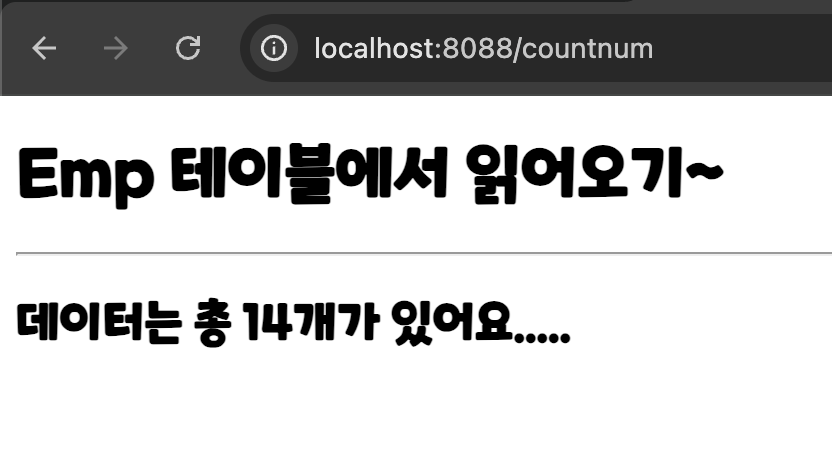
/countnum요청은 사원 데이터가 몇 개인지 조회하는 예제이다.
앞 개념에서count()는 전체 데이터 개수를 조회하는 기본 메서드라고 정리했다.
이번 예제에서는 그 메서드가dao.count()로 사용된다.// EmpController.java @GetMapping("/countnum") // /countnum 요청 처리 public ModelAndView count() { ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 long num = dao.count(); // Emp 전체 데이터 개수 조회 mav.addObject("num", num); // num이라는 이름으로 화면에 전달 mav.setViewName("empResult"); // empResult.html 화면 사용 return mav; // 화면 응답 }
dao.count()는Emp엔티티에 해당하는 데이터 개수를 조회한다.
개수를 조회하는 기능은JpaRepository가 기본으로 제공하기 때문에EmpRepository1안에 따로 메서드를 작성하지 않아도 된다.
조회한 개수는num이라는 이름으로ModelAndView에 담긴다.
ModelAndView는 화면 이름과 화면에 전달할 데이터를 함께 담는 객체이다.
여기서는 화면 이름으로empResult를 지정했기 때문에 최종적으로empResult.html화면이 사용된다.
mav.addObject("num", num)에서 첫 번째num은 화면에서 사용할 이름이다.
두 번째num은dao.count()로 조회한 실제 데이터 개수이다.
즉,Controller는 조회 결과를num이라는 이름표를 붙여 화면으로 넘긴다.
화면에서는 이num값을 꺼내 “데이터는 총 14개가 있어요”처럼 출력한다.
따라서 화면에 보이는14개는 단순히 직접 적어 둔 숫자가 아니다.
EmpRepository1의count()메서드가 데이터베이스에서 조회한 결과이다.
/countnum요청을 실행하면count()가 호출되고,Emp테이블에 저장된 데이터 개수가 화면에 출력된다.
화면에 보이는14개는dao.count()로 조회한 결과가num이라는 이름으로 전달된 값이다.
list 요청 흐름 확인하기
/list요청은 사원 전체 목록을 조회하는 예제이다.
앞 개념에서findAll()은 해당 엔티티의 전체 데이터를 조회하는 기본 메서드라고 정리했다.
이번 예제에서는 그 메서드가dao.findAll()로 사용된다.// EmpController.java @GetMapping("/list") // /list 요청 처리 public ModelAndView list() { ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 List<Emp> list = dao.findAll(); // Emp 전체 데이터 조회 list.parallelStream().forEach(System.out::println); // 콘솔에 조회 결과 출력 mav.addObject("list", list); // list라는 이름으로 화면에 전달 mav.setViewName("empResult"); // empResult.html 화면 사용 return mav; // 화면 응답 }
dao.findAll()은Emp엔티티에 매핑된 전체 데이터를 조회한다.
반환 타입은List<Emp>이다.
List는 여러 개의 데이터를 순서대로 담을 수 있는 자료구조이다.
따라서 여러 사원 정보를 한 번에 담기에 적합하다.
mav.addObject("list", list)에서 첫 번째list는 화면에서 사용할 이름이다.
두 번째list는dao.findAll()로 조회한 실제 사원 목록이다.
즉,Controller는 사원 목록에list라는 이름표를 붙여 화면으로 넘긴다.
화면에서는 이list를 반복해서 출력한다.
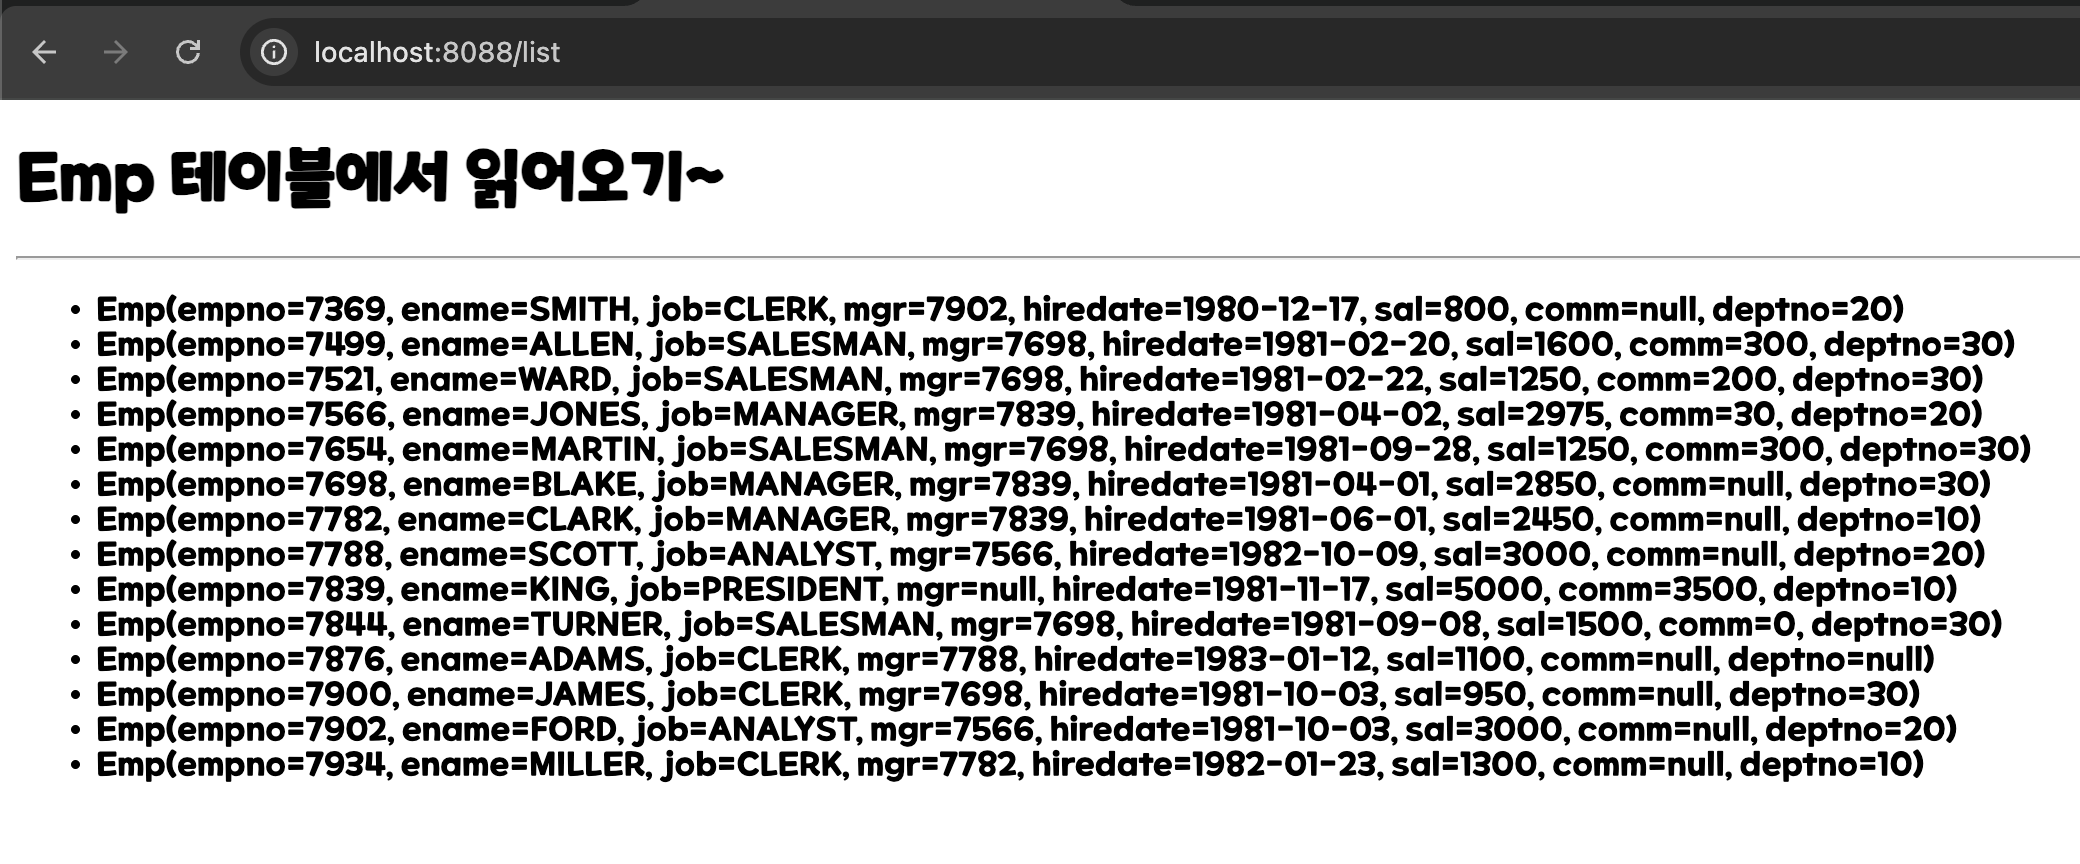
그래서 브라우저에는 사원 한 명이 한 줄씩 표시된다.
각 줄에 보이는empno,ename,job,mgr,hiredate,sal,comm,deptno는Emp엔티티의 필드 값이다.
list.parallelStream().forEach(System.out::println)은 조회 결과를 콘솔에 출력하는 코드이다.
화면 출력과 직접 관련된 핵심 코드는 아니다.
화면에 목록이 나오는 이유는mav.addObject("list", list)로 데이터를 전달했기 때문이다.
parallelStream()은 여러 데이터를 병렬 흐름으로 처리할 수 있게 해 주는 기능이다.
이 예제에서는 복잡한 병렬 처리보다 “조회된Emp목록을 콘솔에 찍어 본다” 정도로 이해하면 충분하다.
초보자 단계에서는forEach(System.out::println)이 각Emp객체를 출력한다는 점만 잡으면 된다.
/list요청을 실행하면findAll()로 조회한Emp전체 목록이 화면에 출력된다.
각 줄은Emp객체 하나를 의미하고,empno,ename,job,mgr,hiredate,sal,comm,deptno값이 함께 출력된다.
값이 없는 컬럼은null로 표시될 수 있다.
이 예제에서 확인해야 하는 핵심
이 예제는 코드가 복잡하지 않지만
Spring Data JPA의 핵심 흐름이 들어 있다.
먼저Emp는@Entity를 통해 데이터베이스 테이블과 연결된다.
empno는@Id를 통해 기본키로 지정된다.
다음으로EmpRepository1은JpaRepository<Emp, Integer>를 상속한다.
이 선언 때문에EmpRepository1은Emp엔티티를 다루는 저장소가 된다.
개발자는 구현 클래스를 직접 만들지 않았지만count()와findAll()을 사용할 수 있다.
마지막으로EmpController는 브라우저 요청을 받는다.
/countnum요청에서는count()로 데이터 개수를 조회한다.
/list요청에서는findAll()로 전체 사원 목록을 조회한다.
조회 결과는ModelAndView에 담겨empResult.html화면으로 전달된다.
정리하면, 응용예제 1은 앞에서 정리한Entity,Repository,JpaRepository,ModelAndView,Controller흐름을 실제 코드에서 확인하는 예제이다.
핵심은Repository인터페이스만 작성해도 기본 조회 메서드를 사용할 수 있고,Controller는 그 결과를 화면으로 전달한다는 점이다.
응용예제 2. Emp 페이징과 정렬 조회 (Emp.java, EmpRepository1.java, EmpController.java, JPA_EmpRepository1Test.java, empResult.html)
앞 개념에서
JpaRepository는 전체 조회뿐 아니라 페이징과 정렬 기능도 사용할 수 있다고 정리했다.
페이징은 많은 데이터를 한 번에 모두 가져오지 않고, 페이지 단위로 나누어 조회하는 방식이다.
정렬은 특정 필드를 기준으로 데이터를 원하는 순서로 조회하는 방식이다.
이번 예제에서는Emp데이터를 한 번에 전부 조회하지 않고, 필요한 개수만 잘라서 가져오는 흐름을 확인한다.
또 급여나 입사일 같은 필드를 기준으로 정렬해서 조회하는 흐름도 함께 확인한다.
전체 흐름은브라우저 요청→EmpController→PageRequest생성 →EmpRepository1.findAll()호출 →Page<Emp>결과 추출 →empResult.html화면 출력 순서로 이어진다.
이 예제의 핵심은PageRequest,Page,Sort를 사용해Emp데이터를 페이지 단위로 나누고, 원하는 기준으로 정렬해서 조회하는 것이다.
앞 개념과 연결해서 보기
앞에서
findAll()은 전체 데이터를 조회하는 기본 메서드라고 정리했다.
그런데 실제 데이터가 많아지면 전체 데이터를 한 번에 화면에 출력하는 방식은 부담이 될 수 있다.
예를 들어 사원 데이터가 수천 개라면 모든 데이터를 한 화면에 보여 주는 것은 보기에도 불편하고 처리에도 비효율적이다.
그래서 필요한 개수만 나누어 가져오는 페이징이 필요하다.
Spring Data JPA에서는PageRequest를 사용해서 몇 번째 페이지를 몇 개씩 가져올지 지정할 수 있다.
그리고findAll(Pageable)형태의 메서드에PageRequest를 넘기면 페이지 단위 조회가 가능하다.
정렬이 필요할 때는Sort를 사용한다.
Sort.by("sal").descending()처럼 작성하면sal필드를 기준으로 내림차순 정렬한다.
여기서 내림차순은 큰 값에서 작은 값 순서로 정렬하는 방식이다.
이번 예제에서 중심이 되는 개념
PageRequest는 페이징 조건을 만드는 객체이다.Page는 페이징 조회 결과를 담는 객체이다.Sort는 정렬 조건을 만드는 객체이다.findAll(Pageable)은PageRequest같은 페이징 조건을 받아 페이지 단위로 조회한다.
PageRequest는 페이징 조건을 만들고,Sort는 정렬 조건을 만들며,Page는 페이징 조회 결과를 담는다.
이 세 개념이 이번 예제의 중심이다.
part 요청 흐름 확인하기
/part요청은 페이지 번호와 페이지 크기를 받아서 해당 페이지의 사원 데이터만 조회하는 예제이다.
여기서는 정렬 조건 없이, 전달받은page와size값만 사용한다.
요청 주소에서 전달하는 값
page는 몇 번째 페이지를 조회할지 정하는 값이다.size는 한 페이지에 몇 개의 데이터를 가져올지 정하는 값이다.page=0은 첫 번째 페이지를 의미한다.size=5는 한 페이지에 5개 데이터를 가져오겠다는 뜻이다.// EmpController.java @GetMapping("/part") // /part 요청 처리 public ModelAndView part(@RequestParam("page") int page, @RequestParam("size") int size) { ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 PageRequest pageRequest = PageRequest.of(page, size); // 페이지 번호와 크기 지정 Page<Emp> pageObj = dao.findAll(pageRequest); // 페이지 단위로 Emp 조회 List<Emp> list = pageObj.toList(); // 현재 페이지 데이터만 List로 변환 mav.setViewName("empResult"); // empResult.html 화면 사용 mav.addObject("list", list); // 조회 결과를 list 이름으로 전달 return mav; // 화면 응답 }코드 흐름
@RequestParam("page")는 요청 주소의page값을 받는다.@RequestParam("size")는 요청 주소의size값을 받는다.PageRequest.of(page, size)는 페이지 조회 조건을 만든다.dao.findAll(pageRequest)는 해당 페이지에 맞는Emp데이터를 조회한다.pageObj.toList()는 현재 페이지의 데이터만 목록으로 꺼낸다.mav.addObject("list", list)는 조회 결과를 화면에 전달한다.
@RequestParam("page")는 요청 파라미터 중page값을 받는다.
요청 파라미터는 주소 뒤에 붙어서 서버로 전달되는 값이다.
예를 들어/part?page=0&size=5라고 요청하면page에는0,size에는5가 들어간다.
PageRequest.of(page, size)는 페이지 조회 조건을 만든다.
첫 번째 값인page는 몇 번째 페이지를 가져올지 의미한다.
두 번째 값인size는 한 페이지에 몇 개의 데이터를 가져올지 의미한다.
여기서 중요한 점은 페이지 번호가1부터 시작하지 않는다는 점이다.
Spring Data JPA의 페이지 번호는 보통0부터 시작한다.
따라서page=0은 첫 번째 페이지를 의미한다.
dao.findAll(pageRequest)는Emp전체 데이터 중에서pageRequest조건에 맞는 일부 데이터만 조회한다.
반환 타입은Page<Emp>이다.
Page<Emp>는 단순한 목록이 아니라 페이지 정보까지 포함한 조회 결과이다.
pageObj.toList()는 현재 페이지에 들어 있는Emp데이터만List<Emp>형태로 꺼낸다.
화면에서는 페이지 정보 전체가 아니라 사원 목록만 출력하면 되므로,List로 바꿔서list라는 이름으로 전달한다.
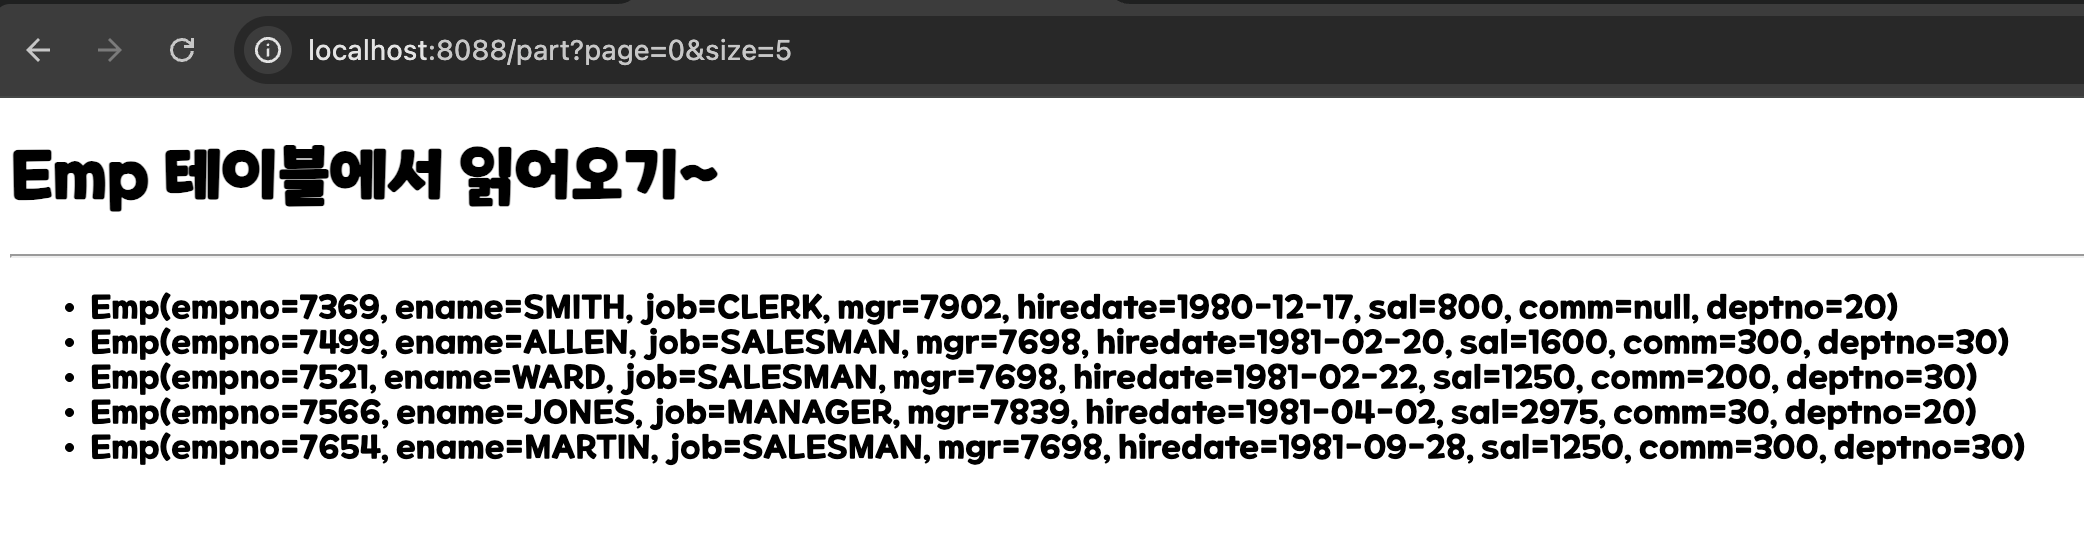
/part?page=0&size=5요청을 실행하면 첫 번째 페이지에 해당하는Emp데이터 5개만 화면에 출력된다.
전체 데이터를 모두 가져오는 것이 아니라,PageRequest.of(page, size)로 지정한 페이지 번호와 크기에 맞는 데이터만 조회된다.
partsal 요청 흐름 확인하기
/partsal요청은 페이지 조회에 급여 정렬 조건을 함께 추가한 예제이다.
앞의/part는 페이지 번호와 크기만 지정했다.
이번에는Sort.by("sal").descending()을 추가해서 급여가 높은 사원부터 조회한다.
part와 partsal의 차이
/part는 페이지 번호와 페이지 크기만 사용한다./partsal은 페이지 조건에 정렬 조건까지 함께 사용한다.- 정렬 기준은
sal필드이다.- 정렬 방향은
descending()이므로 내림차순이다.// EmpController.java @GetMapping("/partsal") // /partsal 요청 처리 public ModelAndView partsal(@RequestParam("page") int page, @RequestParam("size") int size) { ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 PageRequest pageRequest = PageRequest.of(page, size, Sort.by("sal").descending()); // sal 내림차순 정렬 추가 Page<Emp> pageObj = dao.findAll(pageRequest); // 정렬 조건이 포함된 페이지 조회 List<Emp> list = pageObj.toList(); // 현재 페이지 데이터만 List로 변환 mav.setViewName("empResult"); // empResult.html 화면 사용 mav.addObject("list", list); // 조회 결과를 list 이름으로 전달 return mav; // 화면 응답 }코드 흐름
PageRequest.of(page, size, Sort.by("sal").descending())는 페이지 조건과 정렬 조건을 함께 만든다.Sort.by("sal")은sal필드를 기준으로 정렬한다는 뜻이다.descending()은 큰 값에서 작은 값 순서로 정렬한다는 뜻이다.dao.findAll(pageRequest)는 정렬이 포함된 페이지 조건으로 데이터를 조회한다.
PageRequest.of(page, size, Sort.by("sal").descending())은 페이지 조건과 정렬 조건을 함께 만든다.
page는 페이지 번호이고,size는 한 페이지에 가져올 데이터 개수이다.
마지막의Sort.by("sal").descending()은 급여인sal필드를 기준으로 내림차순 정렬하겠다는 뜻이다.
descending()은 내림차순을 의미한다.
급여처럼 숫자 값에 내림차순을 적용하면 큰 값이 먼저 나온다.
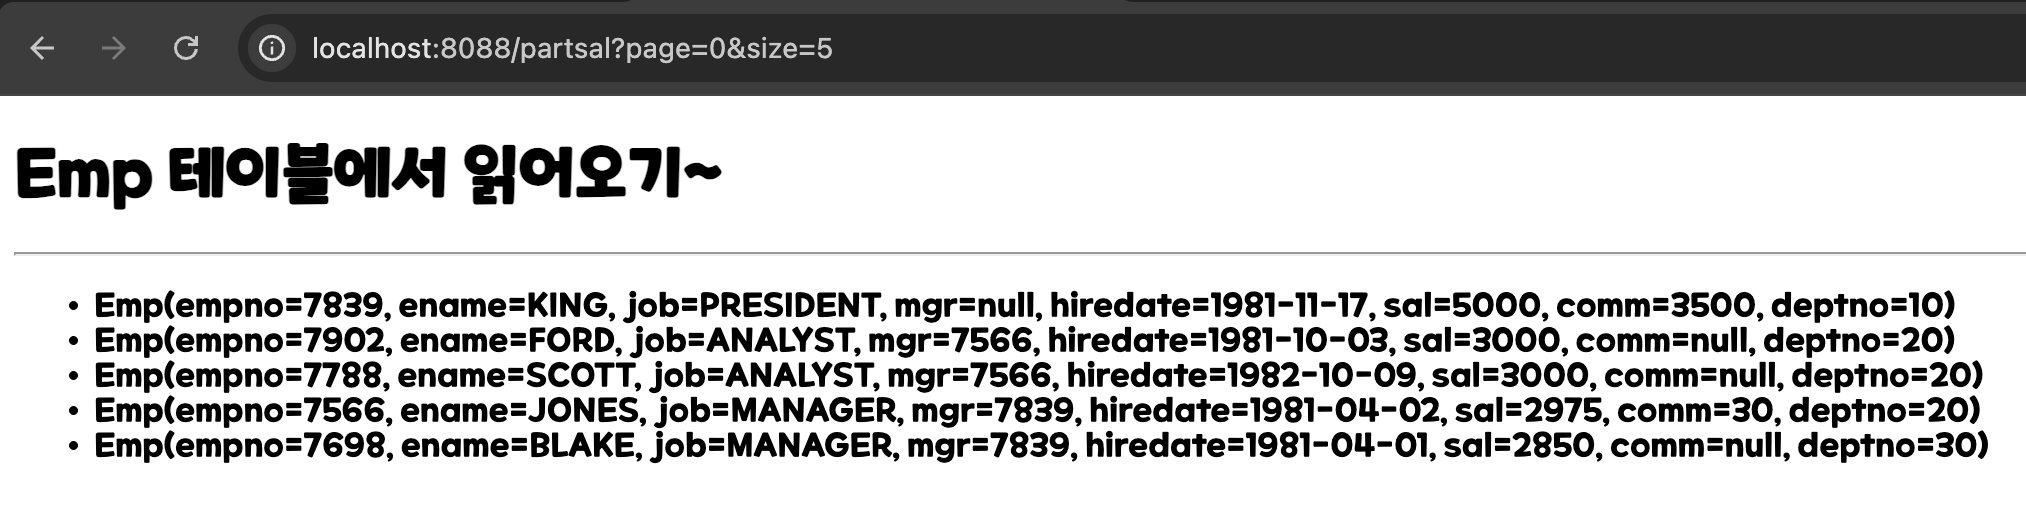
따라서/partsal?page=0&size=5를 실행하면 급여가 높은 사원 5명이 첫 페이지에 출력된다.
여기서 중요한 점은 정렬이 먼저 적용된 뒤 페이지가 나뉜다는 점이다.
전체Emp데이터를 급여 기준으로 정렬하고, 그 정렬된 결과 중에서 요청한 페이지에 해당하는 데이터만 가져온다.
즉,/partsal?page=0&size=5는 단순히 아무 데이터 5개를 가져오는 요청이 아니다.
급여가 높은 순서로 정렬한 뒤, 첫 번째 페이지의 5개를 가져오는 요청이다.
/partsal?page=0&size=5요청을 실행하면sal값이 높은 순서로 정렬된Emp데이터 5개가 출력된다.
화면에서KING의 급여5000이 가장 먼저 나오고, 그 뒤로 급여가 큰 데이터가 이어지는 것을 확인할 수 있다.
parthiredate 요청 흐름 확인하기
/parthiredate요청은 입사일을 기준으로 정렬한 뒤 페이지 단위로 조회하는 예제이다.
이번에는Sort.by("hiredate")를 사용한다.
partsal과 parthiredate의 차이
/partsal은sal필드를 기준으로 정렬한다./parthiredate는hiredate필드를 기준으로 정렬한다./partsal은descending()을 사용해서 내림차순으로 정렬한다./parthiredate는descending()이 없으므로 기본값인 오름차순으로 정렬한다.// EmpController.java @GetMapping("/parthiredate") // /parthiredate 요청 처리 public ModelAndView parthiredate(@RequestParam("page") int page, @RequestParam("size") int size) { ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 PageRequest pageRequest = PageRequest.of(page, size, Sort.by("hiredate")); // hiredate 기준 정렬 Page<Emp> pageObj = dao.findAll(pageRequest); // 정렬 조건이 포함된 페이지 조회 List<Emp> list = pageObj.toList(); // 현재 페이지 데이터만 List로 변환 mav.setViewName("empResult"); // empResult.html 화면 사용 mav.addObject("list", list); // 조회 결과를 list 이름으로 전달 return mav; // 화면 응답 }코드 흐름
Sort.by("hiredate")는hiredate필드를 기준으로 정렬한다는 뜻이다.descending()이 없으므로 기본 정렬 방향인 오름차순이 적용된다.- 날짜 오름차순은 오래된 날짜가 먼저 나오고, 최근 날짜가 나중에 나온다.
- 정렬된 결과 중에서 첫 번째 페이지의 5개 데이터가 화면에 출력된다.
Sort.by("hiredate")는hiredate필드를 기준으로 정렬한다는 뜻이다.
여기서는descending()을 붙이지 않았다.
따라서 기본 정렬 방향인 오름차순으로 정렬된다.
오름차순은 작은 값에서 큰 값 순서로 정렬하는 방식이다.
날짜에서는 오래된 날짜가 먼저 나오고, 최근 날짜가 나중에 나온다고 이해하면 된다.
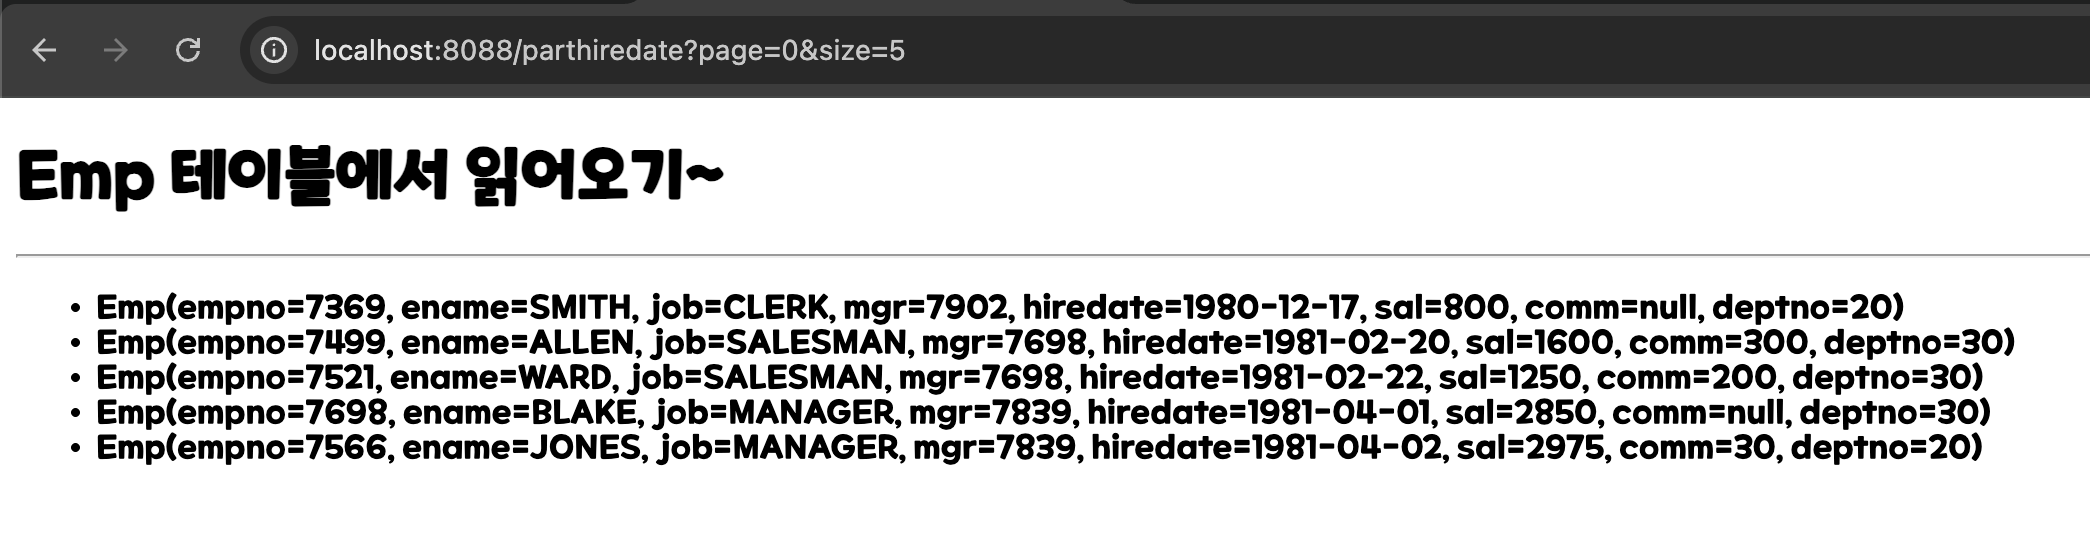
따라서/parthiredate?page=0&size=5를 실행하면 입사일이 빠른 사원부터 첫 페이지에 출력된다.
이 예제는/partsal과 구조가 거의 같다.
차이는 정렬 기준 필드가sal에서hiredate로 바뀌었다는 점이다.
정렬 기준이 바뀌면 같은 페이지 번호와 크기를 사용하더라도 화면에 출력되는 데이터 순서가 달라질 수 있다.
/parthiredate?page=0&size=5요청을 실행하면hiredate기준 오름차순으로 정렬된Emp데이터 5개가 출력된다.
descending()을 붙이지 않았기 때문에 오래된 입사일이 먼저 나오며, 화면에서도1980-12-17부터 순서대로 이어지는 흐름을 확인할 수 있다.
테스트 코드에서 페이징과 정렬 확인하기
브라우저 요청으로 결과를 확인할 수도 있지만, 테스트 코드로
Repository메서드만 직접 실행할 수도 있다.
JPA_EmpRepository1Test는 화면을 거치지 않고EmpRepository1의 메서드를 직접 호출해서 정렬과 페이징 결과를 확인한다.
테스트 코드는Controller나View를 확인하는 것이 아니다.
저장소가 실제로 정렬과 페이징 조회를 잘 수행하는지 확인하는 데 집중한다.// JPA_EmpRepository1Test.java @Test void list1() { List<Emp> list = empR.findAll(); // 조건 없이 전체 Emp 조회 list.stream().forEach(System.out::println); // 조회 결과 콘솔 출력 } @Test void list2() { List<Emp> list = empR.findAll(Sort.by("sal").descending()); // sal 내림차순 정렬 조회 list.stream().forEach(System.out::println); // 조회 결과 콘솔 출력 } @Test void list3() { List<Emp> list = empR.findAll(Sort.by("sal")); // sal 오름차순 정렬 조회 list.stream().forEach(System.out::println); // 조회 결과 콘솔 출력 } @Test void list4() { Page<Emp> list = empR.findAll(PageRequest.of(0, 2)); // 첫 페이지에서 2개 조회 list.stream().forEach(System.out::println); // 현재 페이지 결과 콘솔 출력 } @Test void list5() { Page<Emp> list = empR.findAll(PageRequest.of(3, 4)); // 네 번째 페이지에서 4개 조회 list.stream().forEach(System.out::println); // 현재 페이지 결과 콘솔 출력 } @Test void list6() { List<Emp> list = empR.findAll(Sort.by("ename")); // ename 오름차순 정렬 조회 list.stream().forEach(System.out::println); // 조회 결과 콘솔 출력 } @Test void list7() { Page<Emp> list = empR.findAll(PageRequest.of(0, 3, Sort.by("ename"))); // ename 정렬 + 페이지 조회 list.stream().forEach(System.out::println); // 조회 결과 콘솔 출력 }테스트 메서드별 의미
list1()은 조건 없는 전체 조회를 확인한다.list2()는sal기준 내림차순 정렬을 확인한다.list3()은sal기준 오름차순 정렬을 확인한다.list4()는 첫 번째 페이지에서 2개 데이터만 조회되는지 확인한다.list5()는 네 번째 페이지에서 4개 데이터가 조회되는지 확인한다.list6()은ename기준 오름차순 정렬을 확인한다.list7()은 페이징과 정렬을 함께 적용했을 때의 결과를 확인한다.
list1()은findAll()을 호출한다.
조건 없이 전체Emp데이터를 조회하므로, 기본 전체 조회 흐름을 확인하는 테스트이다.
list2()는findAll(Sort.by("sal").descending())을 호출한다.
이 코드는 전체Emp데이터를 급여가 높은 순서로 정렬해서 조회한다.
list3()은findAll(Sort.by("sal"))을 호출한다.
descending()이 없으므로 기본 정렬 방향인 오름차순이 적용된다.
따라서 급여가 낮은 데이터부터 높은 데이터 순서로 조회된다.
list4()는findAll(PageRequest.of(0, 2))를 호출한다.
첫 번째 페이지에서 2개의 데이터만 가져오는 테스트이다.
여기서도 페이지 번호는0부터 시작한다.
list5()는findAll(PageRequest.of(3, 4))를 호출한다.
페이지 번호가3이므로 네 번째 페이지를 의미하고, 한 페이지 크기가4이므로 해당 페이지에서 최대 4개 데이터를 가져온다.
데이터 개수에 따라 마지막 페이지에는 4개보다 적은 결과가 나올 수 있다.
list6()은findAll(Sort.by("ename"))을 호출한다.
사원 이름인ename을 기준으로 오름차순 정렬해서 전체 목록을 조회한다.
list7()은 페이징과 정렬을 함께 사용한다.
PageRequest.of(0, 3, Sort.by("ename"))은 첫 번째 페이지에서 3개를 가져오되,ename을 기준으로 오름차순 정렬하겠다는 뜻이다.
테스트 코드는 화면 출력이 아니라Repository메서드 자체의 동작을 확인하는 용도이다.
따라서 콘솔에 출력되는 결과를 보면서 정렬 기준과 페이지 크기가 제대로 적용됐는지 확인하면 된다.
이 예제에서 확인해야 하는 핵심
응용예제 2는 앞에서 배운
PageRequest,Page,Sort가 실제EmpController와 테스트 코드에서 어떻게 쓰이는지 확인하는 예제이다.
요청별 핵심 차이
/part는 페이지 번호와 크기만 사용한다./partsal은 페이지 조건에 급여 내림차순 정렬을 추가한다./parthiredate는 페이지 조건에 입사일 기준 오름차순 정렬을 추가한다.객체별 역할 정리
PageRequest는 페이지 번호와 페이지 크기를 담는다.PageRequest는 필요하면Sort까지 함께 담을 수 있다.Page<Emp>는 페이지 조회 결과를 담는다.toList()는 현재 페이지의 실제Emp목록만 꺼낸다.테스트 코드 핵심 정리
findAll()은 조건 없는 전체 조회이다.findAll(Sort)는 정렬 조건이 적용된 전체 조회이다.findAll(PageRequest)는 페이지 단위 조회이다.PageRequest.of(page, size, Sort)는 페이징과 정렬을 함께 적용한다.정리하면, 페이징은 데이터를 나누어 가져오는 기능이고, 정렬은 데이터를 원하는 순서로 가져오는 기능이다.
Spring Data JPA에서는PageRequest와Sort를 조합해 페이지 조회와 정렬 조회를 간단하게 처리할 수 있다.
응용예제 3. EmpRepository2 쿼리 메서드 조건 조회 (Emp.java, EmpRepository2.java, JPA_EmpRepository2Test1.java, JPA_EmpRepository2Test2.java)
앞 개념에서 쿼리 메서드는 메서드 이름을 분석해서 조회 조건을 자동으로 만드는 기능이라고 정리했다.
기본 메서드인findAll()이나findById()만으로는 이름, 직무, 급여, 날짜, 문자열 포함 여부 같은 다양한 조건 조회를 처리하기 어렵다.
이번 예제에서는EmpRepository2에 작성된 여러 쿼리 메서드를 보면서, 메서드 이름 안에 조건이 어떻게 표현되는지 확인한다.
직접SQL이나JPQL을 작성하지 않아도 메서드 이름만으로 조건 조회가 만들어지는 흐름을 보는 예제이다.
전체 흐름은 테스트 코드 실행 →EmpRepository2메서드 호출 →Spring Data JPA가 메서드 이름 분석 → 조건 쿼리 생성 →Emp데이터 조회 → 콘솔 출력 순서로 이어진다.
이 예제의 핵심은findBy,And,Or,GreaterThan,Between,Null,StartsWith,Contains,OrderBy,Top3같은 키워드가 실제 메서드 이름 안에서 어떻게 쓰이는지 이해하는 것이다.
앞 개념과 연결해서 보기
앞에서 쿼리 메서드는
By뒤에 오는 이름을 엔티티 필드와 연결한다고 정리했다.
예를 들어findByEname()은Emp엔티티의ename필드를 기준으로 조회한다.
findByJob()은job필드를 기준으로 조회한다.
이번 예제의EmpRepository2는Emp엔티티를 대상으로 다양한 조건 조회 메서드를 선언한다.
EmpRepository2도JpaRepository<Emp, Integer>를 상속한다.
그래서 기본 조회 메서드도 사용할 수 있고, 직접 선언한 쿼리 메서드도 사용할 수 있다.// EmpRepository2.java package com.example.springjpaedu.repository; import com.example.springjpaedu.entity.Emp; import org.springframework.data.jpa.repository.JpaRepository; import java.util.List; public interface EmpRepository2 extends JpaRepository<Emp, Integer> { List<Emp> findByEname(String name); // 이름이 정확히 같은 사원 조회 List<Emp> findByEnameIgnoreCase(String name); // 대소문자 구분 없이 이름 조회 List<Emp> findByJob(String job); // 직무 기준 조회 List<Emp> findByJobOrDeptno(String job, int dno); // 직무 또는 부서 번호 조건 조회 List<Emp> findByJobAndDeptno(String job, int dno); // 직무와 부서 번호 모두 만족 조회 List<Emp> findDistinctByJob(String job); // 중복 제거를 포함한 직무 조회 List<Emp> findByDeptno(int dno); // 부서 번호 기준 조회 List<Emp> findBySalGreaterThan(int inputsal); // 급여 초과 조건 조회 List<Emp> findBySalGreaterThanEqual(int inputsal); // 급여 이상 조건 조회 List<Emp> findBySalLessThan(int inputsal); // 급여 미만 조건 조회 List<Emp> findBySalLessThanEqual(int inputsal); // 급여 이하 조건 조회 List<Emp> findBySalBetween(int minsal, int maxsal); // 급여 범위 조건 조회 List<Emp> findByCommNull(); // 커미션이 null인 사원 조회 List<Emp> findByCommNotNull(); // 커미션이 null이 아닌 사원 조회 List<Emp> findByHiredateAfter(java.sql.Date d); // 특정 날짜 이후 입사자 조회 List<Emp> findByHiredateBefore(java.sql.Date d); // 특정 날짜 이전 입사자 조회 List<Emp> findByEnameStartsWith(String partname); // 특정 문자열로 시작하는 이름 조회 List<Emp> findByEnameContains(String partname); // 특정 문자열을 포함하는 이름 조회 List<Emp> findByDeptnoOrderBySalDesc(int dno); // 부서 번호 조건 + 급여 내림차순 List<Emp> findTop3ByDeptnoOrderBySalDesc(int dno); // 부서 번호 조건 + 급여 내림차순 상위 3개 }이 코드에서 중요한 점은 메서드의 내부 구현이 없다는 것이다.
findByEname(),findByJobAndDeptno(),findBySalBetween()같은 메서드는 이름만 선언되어 있다.
그런데도 테스트 코드에서 이 메서드들을 호출하면 조회가 실행된다.
이유는Spring Data JPA가 메서드 이름을 분석해서 필요한 쿼리를 자동으로 만들기 때문이다.
메서드 이름을 읽는 기본 순서
find는 조회한다는 뜻이다.By뒤에는 조회 조건이 온다.Ename,Job,Deptno,Sal,Comm,Hiredate는Emp엔티티의 필드 이름과 연결된다.And,Or,GreaterThan,Between,Null,OrderBy같은 단어는 조건 키워드이다.쿼리 메서드는 메서드 이름 자체가 조회 조건을 설명하는 문장처럼 동작한다.
그래서 메서드 이름을 의미 단위로 끊어 읽는 것이 중요하다.
테스트 코드 구조 먼저 확인하기
EmpRepository2의 쿼리 메서드는 테스트 코드에서 실행된다.
JPA_EmpRepository2Test1과JPA_EmpRepository2Test2는 화면을 거치지 않고Repository메서드를 직접 호출한다.
즉, 이 예제는 브라우저 결과를 보는 예제가 아니라 콘솔 출력으로 조건 조회 결과를 확인하는 예제이다.
앞 응용예제 1, 2에서는Controller요청과 화면 출력이 중심이었다.
이번에는Repository자체의 조건 조회 기능이 중심이다.// JPA_EmpRepository2Test1.java @AutoConfigureTestDatabase(replace = AutoConfigureTestDatabase.Replace.NONE) // 실제 DB 설정 사용 @TestMethodOrder(OrderAnnotation.class) // @Order 순서대로 테스트 실행 @DataJpaTest // JPA Repository 테스트 환경 준비 public class JPA_EmpRepository2Test1 { @Autowired // Repository 구현체 주입 private EmpRepository2 empR; @BeforeEach // 각 테스트 실행 전 출력 void pr() { System.out.println("=========================================================="); } }
@DataJpaTest는JPA Repository를 테스트하기 위한 환경을 준비한다.
@AutoConfigureTestDatabase(replace = AutoConfigureTestDatabase.Replace.NONE)은 테스트할 때 내장 데이터베이스로 바꾸지 않고, 현재 프로젝트에 설정된 실제 데이터베이스를 사용하겠다는 뜻이다.
@TestMethodOrder(OrderAnnotation.class)는 테스트 실행 순서를@Order기준으로 맞추는 설정이다.
테스트 메서드마다@Order(1),@Order(2)처럼 번호가 붙어 있으면 그 순서대로 실행된다.
@BeforeEach는 각 테스트가 실행되기 전에 먼저 실행되는 메서드에 붙인다.
여기서는 구분선을 출력해서 콘솔에서 테스트 결과를 나눠 보기 쉽게 만든다.
기본 저장, 전체 조회, 기본키 조회 확인하기
JPA_EmpRepository2Test1의 앞부분에는 쿼리 메서드만 있는 것이 아니다.
save(),findAll(),findById()같은 기본 메서드도 함께 사용된다.
이 부분은 앞에서 배운JpaRepository기본 메서드가 실제 테스트에서 어떻게 호출되는지 다시 확인하는 구간이다.// JPA_EmpRepository2Test1.java @Test @Order(1) @Transactional // 하나의 트랜잭션 안에서 실행 void save() { Emp entity = new Emp(); // 저장할 Emp 객체 생성 entity.setEmpno(1234); // 사원 번호 설정 entity.setEname("유니코1"); // 사원 이름 설정 entity.setJob("강의"); // 직무 설정 entity.setMgr(7566); // 관리자 번호 설정 entity.setHiredate(new java.sql.Date(System.currentTimeMillis())); // 현재 날짜 설정 entity.setSal(3000); // 급여 설정 entity.setComm(300); // 커미션 설정 entity.setDeptno(30); // 부서 번호 설정 empR.save(entity); // Emp 엔티티 저장 List<Emp> list = empR.findAll(); // 전체 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
save()테스트는 새로운Emp객체를 만들고 값을 채운 뒤 저장한다.
Emp는 기본키인empno가 직접 들어가는 구조이다.
그래서 저장 전에entity.setEmpno(1234)처럼 사원 번호를 직접 설정한다.
empR.save(entity)는Emp엔티티를 저장하는 메서드이다.
저장 후empR.findAll()로 전체 데이터를 조회해서 콘솔에 출력한다.
여기서@Transactional이 붙어 있다.
앞 개념에서 테스트는 기본적으로 롤백될 수 있다고 정리했다.
따라서 이 저장 테스트는 실행 중에는 저장과 조회가 되지만, 테스트가 끝난 뒤 실제 데이터가 남지 않을 수 있다.// JPA_EmpRepository2Test1.java @Test @Order(2) void list() { List<Emp> list = empR.findAll(); // 현재 Emp 전체 목록 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
@Order(2)의list()는 저장 없이 현재Emp전체 목록만 조회하는 테스트이다.
앞의save()테스트가 새Emp객체를 저장한 뒤 전체 조회까지 확인하는 흐름이라면,list()는 기존 데이터 전체 조회만 단독으로 확인한다.
이 테스트를 함께 보면JPA_EmpRepository2Test1의 기본 메서드 흐름이save()→findAll()→findById()순서로 더 분명해진다.// JPA_EmpRepository2Test1.java @Test @Order(3) void byId() { Emp entity = empR.findById(7788).get(); // 기본키 7788로 Emp 조회 System.out.println(entity); // 조회 결과 출력 }
findById(7788)은 기본키가7788인Emp데이터를 조회한다.
반환값은 바로Emp가 아니라Optional<Emp>이다.
Optional은 조회 결과가 있을 수도 있고 없을 수도 있는 상황을 감싸는 객체이다.
여기서는.get()을 사용해 안에 들어 있는Emp객체를 꺼낸다.
다만 실제 개발에서는 값이 없을 수도 있으므로, 무조건.get()을 쓰기보다 존재 여부를 먼저 확인하는 방식이 더 안전하다.
이 예제에서는 기본키7788데이터가 있다고 보고 결과를 확인하는 흐름으로 보면 된다.
기본 메서드 흐름
save()는 엔티티를 저장한다.findAll()은 전체 엔티티 목록을 조회한다.findById()는 기본키 값으로 엔티티 하나를 조회한다.- 테스트에서는 조회 결과를 화면이 아니라 콘솔에 출력한다.
이름과 직무 조건 조회
이제 본격적으로 쿼리 메서드를 확인한다.
가장 단순한 조건은 특정 필드 값이 정확히 같은 데이터를 조회하는 것이다.
findByEname()은 사원 이름이 특정 값과 같은 데이터를 조회한다.
findByJob()은 직무가 특정 값과 같은 데이터를 조회한다.// JPA_EmpRepository2Test1.java @Test @Order(4) void byName() { List<Emp> list = empR.findByEname("SMITH"); // ename이 SMITH인 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(5) void byNameIgnoreCase() { List<Emp> list = empR.findByEnameIgnoreCase("smith"); // 대소문자 구분 없이 이름 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(6) void byJob() { List<Emp> list = empR.findByJob("SALESMAN"); // job이 SALESMAN인 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
findByEname("SMITH")는ename값이 정확히SMITH인 사원을 조회한다.
메서드 이름에서Ename은Emp엔티티의ename필드와 연결된다.
findByEnameIgnoreCase("smith")는 대소문자를 구분하지 않고 이름을 비교한다.
그래서 데이터베이스에SMITH처럼 대문자로 저장되어 있어도, 테스트 코드에서smith처럼 소문자로 전달해 조회할 수 있다.
findByJob("SALESMAN")은job값이SALESMAN인 사원을 조회한다.
직무가 같은 사원이 여러 명일 수 있으므로 반환 타입은List<Emp>이다.
이름과 직무 조회에서 봐야 할 점
findByEname()은 정확히 같은 이름을 조회한다.IgnoreCase는 대소문자 차이를 무시한다.findByJob()은 특정 직무에 해당하는 사원들을 조회한다.- 결과가 여러 명일 수 있으므로
List<Emp>로 받는다.
byName()은findByEname("SMITH")를 실행한 결과이다.
콘솔에 출력된SQL의where e1_0.ename=?조건을 보면ename필드 값으로 조회한다는 점을 확인할 수 있다.
byNameIgnoreCase()는 대소문자를 구분하지 않는 이름 조회 결과이다.
콘솔의upper(e1_0.ename)=upper(?)조건은 양쪽 값을 같은 대문자 기준으로 바꿔 비교한다는 흐름을 보여준다.
byJob()은job값이SALESMAN인 사원 목록을 조회한 결과이다.
같은 직무를 가진 사원이 여러 명이므로List<Emp>로 여러 결과가 출력된다.
Or와 And 조건 조회
조건이 하나만 있는 조회도 있지만, 실제로는 조건을 여러 개 연결해야 할 때도 많다.
쿼리 메서드에서는Or와And를 사용해 조건을 연결할 수 있다.
Or는 둘 중 하나라도 만족하면 조회 대상이 된다.
And는 두 조건을 모두 만족해야 조회 대상이 된다.// JPA_EmpRepository2Test1.java @Test @Order(7) void byJobOrDeptno() { List<Emp> list = empR.findByJobOrDeptno("MANAGER", 20); // job이 MANAGER이거나 deptno가 20인 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(8) void byJobAndDeptno() { List<Emp> list = empR.findByJobAndDeptno("MANAGER", 20); // job이 MANAGER이고 deptno가 20인 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
findByJobOrDeptno("MANAGER", 20)은job이MANAGER이거나deptno가20인 사원을 조회한다.
둘 중 하나만 만족해도 결과에 포함될 수 있다.
반면findByJobAndDeptno("MANAGER", 20)은job이MANAGER이고 동시에deptno가20인 사원만 조회한다.
두 조건을 모두 만족해야 하므로Or보다 결과 범위가 좁아질 수 있다.
Or와 And 차이
Or는 조건 중 하나만 맞아도 결과에 포함된다.And는 모든 조건이 맞아야 결과에 포함된다.- 같은 값으로 조회해도
Or와And는 결과 개수가 달라질 수 있다.
byJobOrDeptno()는job이MANAGER이거나deptno가20인 데이터를 조회한다.
콘솔의where e1_0.job=? or e1_0.deptno=?조건처럼 둘 중 하나만 만족해도 결과에 포함된다.
byJobAndDeptno()는job이MANAGER이고deptno가20인 데이터를 조회한다.
And조건은 두 조건을 모두 만족해야 하므로,Or보다 결과가 더 좁게 나온다.
조건 연결에서는Or와And의 차이를 반드시 구분해야 한다.
같은 필드와 같은 값을 사용해도 조건 연결 방식이 달라지면 조회 결과가 달라진다.
중복 제거와 부서 번호 조회
findDistinctByJob()은 이름에Distinct가 들어간다.
Distinct는 중복 제거를 의미한다.
다만 이 예제에서는Emp엔티티 전체를 조회하므로, 단순히 직무 이름만 중복 제거해서 가져오는 구조로 이해하면 안 된다.
findByDeptno()는 부서 번호가 특정 값과 같은 사원을 조회한다.
부서별 사원 목록을 볼 때 사용할 수 있는 가장 단순한 조건 조회이다.// JPA_EmpRepository2Test1.java @Test @Order(9) void byDistinctByJob() { List<Emp> list = empR.findDistinctByJob("SALESMAN"); // job이 SALESMAN인 사원 조회에 distinct 적용 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(10) void byDeptno() { List<Emp> list = empR.findByDeptno(30); // deptno가 30인 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
findDistinctByJob("SALESMAN")은job값이SALESMAN인 데이터를 조회하면서distinct를 적용한다.
초보자가 여기서 오해하기 쉬운 부분이 있다.
이 메서드는 직무 이름 목록만 뽑는 메서드가 아니다.
반환 타입이List<Emp>이므로 조회 결과는 여전히Emp객체 목록이다.
findByDeptno(30)은deptno값이30인 사원을 조회한다.
Deptno는Emp엔티티의deptno필드와 연결된다.
Distinct를 볼 때 주의할 점
Distinct는 중복 제거 키워드이다.- 반환 타입이
List<Emp>이면 결과는Emp객체 목록이다.- 특정 필드 값만 뽑는 것이 아니라 엔티티 조회 결과에 중복 제거가 적용되는 흐름으로 이해해야 한다.
이 구간에서는
Distinct자체를 깊게 파고들기보다, 메서드 이름에 중복 제거 키워드를 붙일 수 있다는 정도로 이해하면 충분하다.
급여 비교 조건 조회
급여처럼 숫자 값은 크고 작음을 기준으로 조회할 수 있다.
EmpRepository2에는 급여를 기준으로 초과, 이상, 미만, 이하, 범위 조건을 확인하는 메서드가 들어 있다.
먼저GreaterThan과GreaterThanEqual을 확인한다.
두 키워드는 비슷해 보이지만 기준값을 포함하는지 여부가 다르다.// JPA_EmpRepository2Test1.java @Test @Order(11) void bySalGreaterThan() { List<Emp> list = empR.findBySalGreaterThan(3000); // sal이 3000보다 큰 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(12) void bySalGreaterThanEqual() { List<Emp> list = empR.findBySalGreaterThanEqual(3000); // sal이 3000 이상인 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
findBySalGreaterThan(3000)은 급여가3000보다 큰 사원을 조회한다.
여기서3000은 포함되지 않는다.
즉,3000초과 조건이다.
findBySalGreaterThanEqual(3000)은 급여가3000이상인 사원을 조회한다.
여기서는3000도 포함된다.
이 차이를 모르면 결과가 왜 다른지 헷갈릴 수 있다.
GreaterThan과 GreaterThanEqual 차이
GreaterThan은 기준값보다 큰 값만 조회한다.GreaterThanEqual은 기준값보다 크거나 같은 값을 조회한다.3000을 기준으로 보면GreaterThan은3000을 제외하고,GreaterThanEqual은3000을 포함한다.
bySalGreaterThan()은sal이3000보다 큰 데이터를 조회한다.
결과에는sal=5000인KING만 출력되고,sal=3000인 데이터는 포함되지 않는다.
bySalGreaterThanEqual()은sal이3000이상인 데이터를 조회한다.
GreaterThanEqual은 기준값을 포함하므로sal=3000인SCOTT,FORD도 함께 출력된다.
이번에는 반대 방향인LessThan,LessThanEqual, 그리고 범위 조건인Between을 확인한다.// JPA_EmpRepository2Test2.java @Test @Order(1) void bySalLessThan() { List<Emp> list = empR.findBySalLessThan(3000); // sal이 3000보다 작은 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(2) void bySalLessThanEqual() { List<Emp> list = empR.findBySalLessThanEqual(3000); // sal이 3000 이하인 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(3) void bySalBetween() { List<Emp> list = empR.findBySalBetween(2000, 3000); // sal이 2000과 3000 사이인 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
findBySalLessThan(3000)은 급여가3000보다 작은 사원을 조회한다.
여기서도 기준값3000은 포함되지 않는다.
findBySalLessThanEqual(3000)은 급여가3000이하인 사원을 조회한다.
따라서 급여가 정확히3000인 사원도 결과에 포함될 수 있다.
findBySalBetween(2000, 3000)은 급여가2000부터3000사이인 사원을 조회한다.
Between은 범위 조건을 표현할 때 사용하며, 이 예제에서는 시작값과 끝값이 모두 포함된다.
따라서sal=3000인 데이터도 결과에 포함된다.
급여 조건 정리
GreaterThan은 초과 조건이다.GreaterThanEqual은 이상 조건이다.LessThan은 미만 조건이다.LessThanEqual은 이하 조건이다.Between은 두 값 사이의 범위 조건이며, 이 예제에서는 양끝값이 포함된다.
bySalLessThan()은sal이3000보다 작은 데이터를 조회한다.
LessThan은 기준값을 포함하지 않기 때문에sal=3000인 데이터는 제외된다.
bySalLessThanEqual()은sal이3000이하인 데이터를 조회한다.
LessThanEqual은 기준값을 포함하므로sal=3000인 데이터도 결과에 포함된다.
bySalBetween()은sal이2000부터3000사이인 데이터를 조회한다.
콘솔의between ? and ?조건을 통해 범위 조건이 적용된 것을 확인할 수 있고, 양끝값도 결과에 포함된다.
null 조건 조회
데이터베이스에서는 값이 없는 상태를
null로 표현할 수 있다.
Emp엔티티의comm은 커미션을 의미한다.
모든 사원이 커미션을 받는 것은 아니기 때문에comm값은null일 수 있다.
앞에서Emp엔티티를 볼 때comm타입이Integer인 이유를 설명했다.
Integer는 객체 타입이므로null을 표현할 수 있다.
이번 예제에서는 이comm값이null인지 아닌지 기준으로 조회한다.// JPA_EmpRepository2Test2.java @Test @Order(4) void byCommNull() { List<Emp> list = empR.findByCommNull(); // comm이 null인 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(5) void byCommNotNull() { List<Emp> list = empR.findByCommNotNull(); // comm이 null이 아닌 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
findByCommNull()은comm값이null인 사원을 조회한다.
즉, 커미션 값이 없는 데이터를 찾는다.
findByCommNotNull()은comm값이null이 아닌 사원을 조회한다.
즉, 커미션 값이 존재하는 데이터를 찾는다.
Null과 NotNull 차이
Null은 값이 없는 데이터를 찾는다.NotNull은 값이 있는 데이터를 찾는다.comm=null은 커미션 값이 없다는 뜻이다.
byCommNull()은comm값이null인 데이터를 조회한다.
콘솔의e1_0.comm is null조건을 통해 값이 없는 데이터를 찾는 조회임을 확인할 수 있다.
byCommNotNull()은comm값이null이 아닌 데이터를 조회한다.
콘솔의e1_0.comm is not null조건처럼 커미션 값이 존재하는 데이터만 결과에 포함된다.
null은 숫자0과 다르다.
0은 값이 있는 상태이고,null은 값 자체가 없는 상태이다.
따라서comm=0인 데이터와comm=null인 데이터는 서로 다르게 봐야 한다.
날짜 조건 조회
날짜도 조건으로 조회할 수 있다.
Emp엔티티의hiredate는 입사일을 의미한다.
특정 날짜 이후에 입사한 사원이나, 특정 날짜 이전에 입사한 사원을 조회할 수 있다.// JPA_EmpRepository2Test2.java @Test @Order(6) void byHiredateAfter() { List<Emp> list = empR.findByHiredateAfter(java.sql.Date.valueOf("1981-12-31")); // 1981-12-31 이후 입사자 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(7) void byHiredateBefore() { List<Emp> list = empR.findByHiredateBefore(java.sql.Date.valueOf("1981-12-31")); // 1981-12-31 이전 입사자 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
java.sql.Date.valueOf("1981-12-31")은 문자열로 적은 날짜를java.sql.Date타입으로 바꾼다.
쿼리 메서드의 매개변수 타입이java.sql.Date이기 때문에 날짜 값을 이 타입으로 전달한다.
findByHiredateAfter()는 기준 날짜 이후의 데이터를 조회한다.
즉,1981-12-31보다 나중에 입사한 사원이 조회 대상이다.
이 조건에서는 기준 날짜인1981-12-31자체는 포함되지 않는다.
findByHiredateBefore()는 기준 날짜 이전의 데이터를 조회한다.
즉,1981-12-31보다 먼저 입사한 사원이 조회 대상이다.
이 조건에서도 기준 날짜인1981-12-31자체는 포함되지 않는다.
After와 Before 차이
After는 기준 날짜보다 이후인 데이터를 조회한다.Before는 기준 날짜보다 이전인 데이터를 조회한다.After와Before는 기준 날짜 자체를 포함하지 않는다.- 날짜 조건에서는 기준 날짜를 어떤 타입으로 전달하는지도 함께 확인해야 한다.
날짜 조건은 숫자 비교와 비슷하게 생각할 수 있다.
다만 비교 대상이 숫자가 아니라 날짜라는 점이 다르다.
이 구간은 결과 이미지를 따로 넣지 않아도 된다.
핵심은After와Before가 날짜 값을 기준으로 이후와 이전 조건을 만든다는 점이다.
문자열 조건 조회
문자열 필드는 정확히 같은 값만 찾는 것이 아니라, 특정 글자로 시작하거나 특정 글자를 포함하는 데이터도 조회할 수 있다.
Emp엔티티에서는 사원 이름인ename을 기준으로 문자열 조건을 확인한다.// JPA_EmpRepository2Test2.java @Test @Order(8) void byEnameStartsWith() { List<Emp> list = empR.findByEnameStartsWith("M"); // 이름이 M으로 시작하는 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(9) void byEnameContains() { List<Emp> list = empR.findByEnameContains("LA"); // 이름에 LA가 포함된 사원 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
findByEnameStartsWith("M")은ename값이M으로 시작하는 사원을 조회한다.
예를 들어 이름이MARTIN이나MILLER처럼M으로 시작하면 조건에 맞는다.
findByEnameContains("LA")는ename값 안에LA가 포함된 사원을 조회한다.
앞이나 뒤에 다른 글자가 있어도, 중간에LA가 들어 있으면 조회 대상이 될 수 있다.
StartsWith와 Contains 차이
StartsWith는 특정 문자열로 시작하는지 확인한다.Contains는 특정 문자열이 포함되어 있는지 확인한다.Contains는 문자열의 앞, 중간, 뒤 어디에 있어도 포함 여부를 기준으로 조회한다.
byEnameStartsWith()는 이름이M으로 시작하는 데이터를 조회한다.
콘솔 결과에서MARTIN,MILLER처럼M으로 시작하는 이름이 출력된다.
byEnameContains()는 이름에LA가 포함된 데이터를 조회한다.
콘솔 결과에서BLAKE,CLARK처럼 이름 안에LA가 들어 있는 데이터가 출력된다.
정렬과 상위 개수 제한 조회
쿼리 메서드 이름에는 정렬 조건도 넣을 수 있다.
OrderBySalDesc는sal필드를 기준으로 내림차순 정렬하겠다는 뜻이다.
여기에Top3를 붙이면 정렬된 결과 중 상위 3개만 가져올 수 있다.// JPA_EmpRepository2Test2.java @Test @Order(10) void byDeptnoOrderBySalDesc() { List<Emp> list = empR.findByDeptnoOrderBySalDesc(20); // deptno 20 사원을 sal 내림차순 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test @Order(11) void byTop3DeptnoOrderBySalDesc() { List<Emp> list = empR.findTop3ByDeptnoOrderBySalDesc(20); // deptno 20 사원을 sal 내림차순 상위 3개 조회 list.stream().forEach(System.out::println); // 콘솔 출력 }
findByDeptnoOrderBySalDesc(20)은deptno가20인 사원을 조회하되,sal기준 내림차순으로 정렬한다.
메서드 이름을 끊어 읽으면findBy→Deptno→OrderBy→Sal→Desc이다.
findTop3ByDeptnoOrderBySalDesc(20)은 같은 조건에Top3가 추가된 형태이다.
deptno가20인 사원을 급여 내림차순으로 정렬한 뒤, 앞에서 3명만 가져온다.
여기서 중요한 점은Top3를 단독으로 보면 안 된다는 것이다.
Top3는 “3개만 가져온다”는 뜻이고, 어떤 3개를 가져올지는 뒤의 정렬 기준과 함께 봐야 한다.
이 예제에서는OrderBySalDesc가 붙어 있으므로 급여가 높은 순서에서 상위 3개를 가져온다.
긴 메서드 이름 끊어 읽기
findTop3는 상위 3개를 조회한다는 뜻이다.ByDeptno는deptno조건을 사용한다는 뜻이다.OrderBySalDesc는sal기준 내림차순 정렬을 의미한다.- 전체 의미는
deptno가 특정 값인 사원을 급여 내림차순으로 정렬하고 상위 3명만 조회한다는 뜻이다.
byDeptnoOrderBySalDesc()는deptno가20인 사원을 조회한 뒤sal기준 내림차순으로 정렬한다.
콘솔의order by e1_0.sal desc조건을 보면 정렬 조건이 적용된 것을 확인할 수 있다.
byTop3DeptnoOrderBySalDesc()는deptno가20인 사원을 급여 내림차순으로 정렬한 뒤 상위 3개만 조회한다.
콘솔에limit이 함께 보이므로 조회 개수가 제한된 것을 확인할 수 있다.
긴 쿼리 메서드는 외우는 것이 아니라 의미 단위로 끊어 읽어야 한다.
메서드 이름이 길어져도find,Top3,By,Deptno,OrderBy,Sal,Desc처럼 나누면 조건 구조를 이해할 수 있다.
이 예제에서 확인해야 하는 핵심
응용예제 3은 쿼리 메서드 조건 키워드를 실제
EmpRepository2코드로 확인하는 예제이다.
기본 메서드만으로는 다양한 조건 조회를 처리하기 어렵기 때문에,Spring Data JPA는 메서드 이름으로 쿼리를 만드는 기능을 제공한다.
기본 메서드 정리
save()는 새Emp엔티티를 저장한다.list()는 현재Emp전체 목록을 단독으로 조회한다.findById()는 기본키 값으로Emp하나를 조회한다.조건 키워드 정리
findByEname은 이름이 정확히 같은 데이터를 조회한다.IgnoreCase는 대소문자를 구분하지 않는다.And는 두 조건을 모두 만족해야 한다.Or는 두 조건 중 하나만 만족해도 된다.GreaterThan,LessThan은 기준값을 포함하지 않는 비교 조건이다.GreaterThanEqual,LessThanEqual은 기준값을 포함하는 비교 조건이다.Between은 범위 조건이며, 이 예제에서는 양끝값이 포함된다.Null,NotNull은 값이 없는지 있는지 검사한다.After,Before는 날짜 조건에 사용되며, 기준 날짜 자체는 포함하지 않는다.StartsWith,Contains는 문자열 검색 조건에 사용된다.OrderBy는 정렬 조건이다.Top3는 조회 개수 제한이다.응용예제 3의 핵심 흐름
EmpRepository2에 쿼리 메서드를 선언한다.- 테스트 코드에서 해당 메서드를 호출한다.
Spring Data JPA가 메서드 이름을 분석한다.- 분석된 이름을 기준으로 조건 쿼리가 실행된다.
- 조회 결과는
List<Emp>로 반환되고 콘솔에 출력된다.정리하면, 쿼리 메서드는 간단한 조건 조회를 빠르게 만들기 위한 기능이다.
메서드 이름을 잘 지으면SQL이나JPQL을 직접 작성하지 않고도 조건 조회를 처리할 수 있다.
다만 조건이 너무 길어지면 메서드 이름도 길어지므로, 복잡한 조회는@Query나 다른 쿼리 작성 방식으로 분리하는 것이 더 적합할 수 있다.
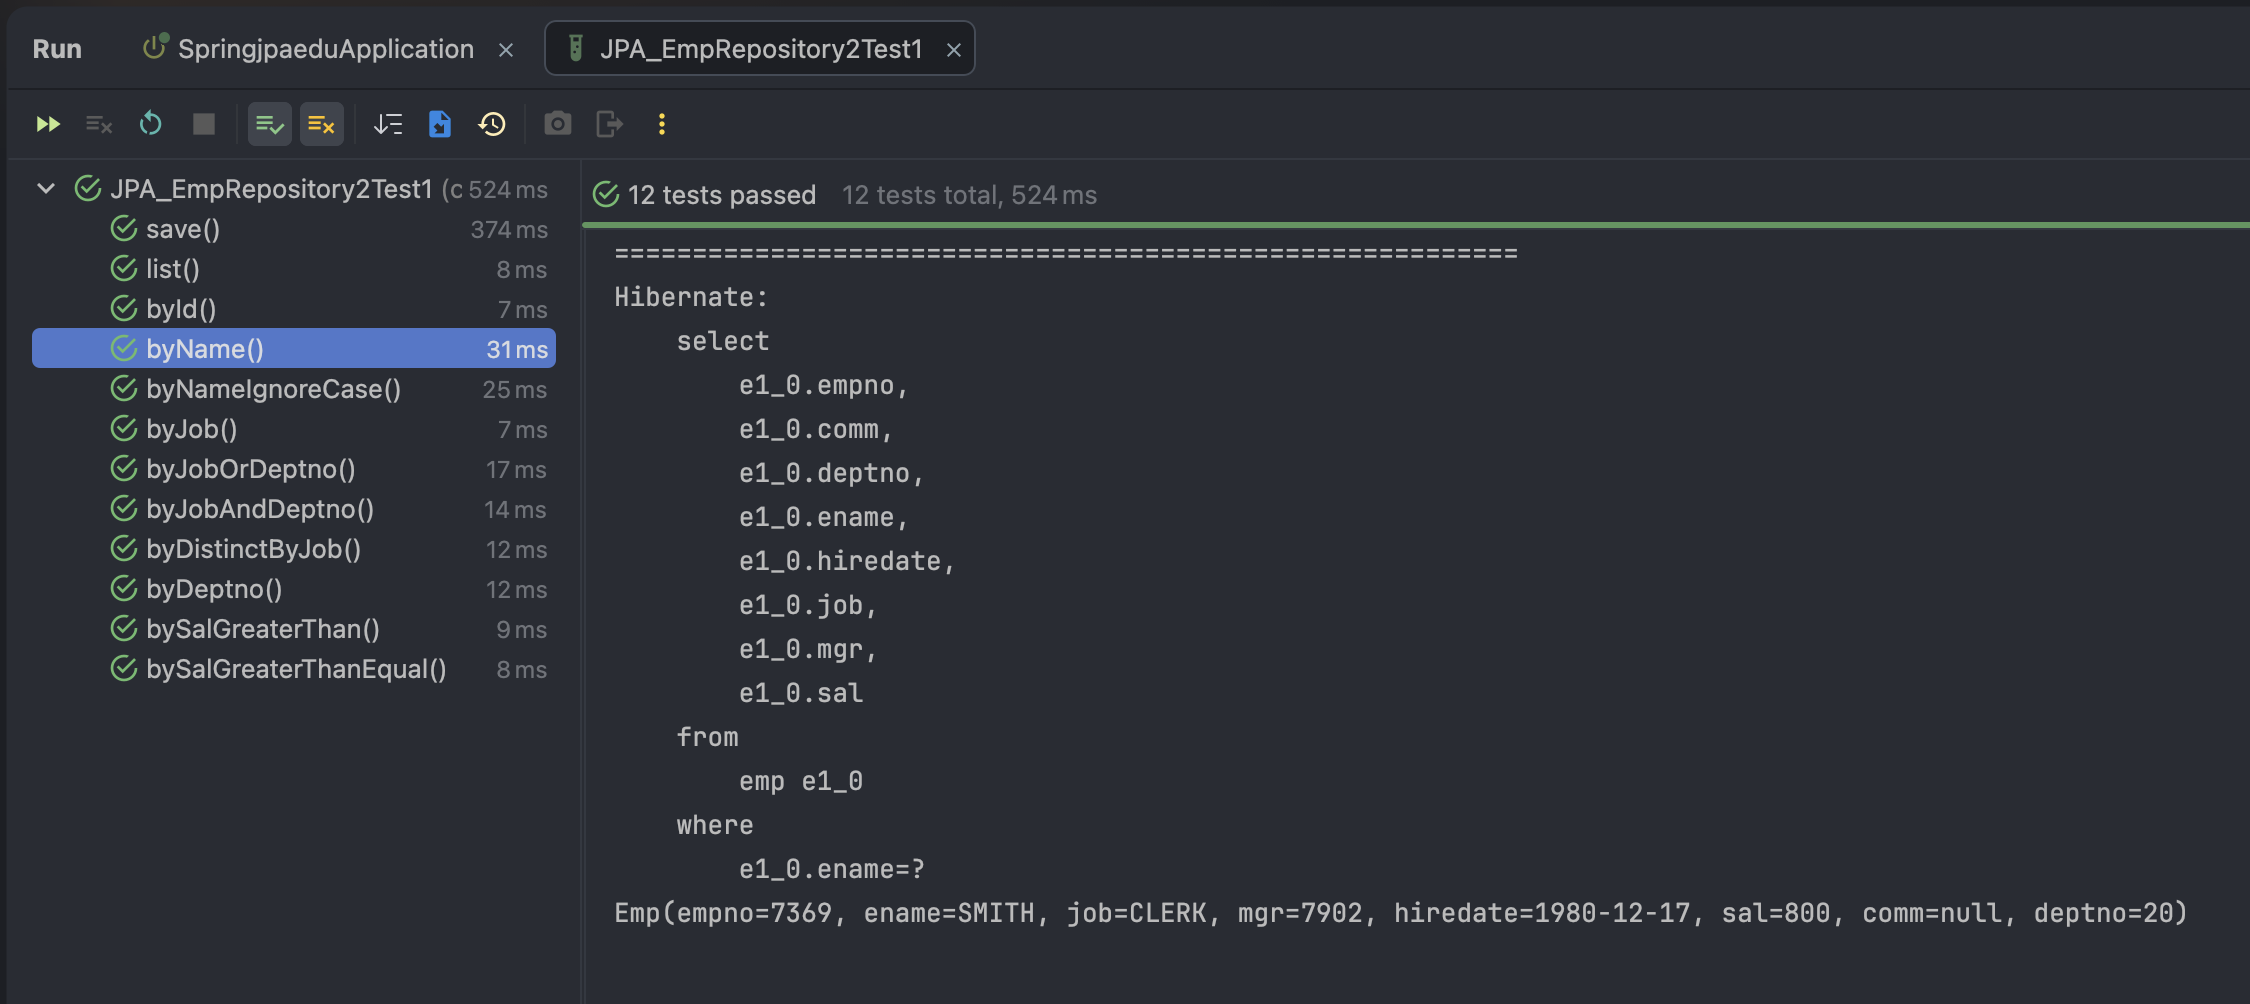
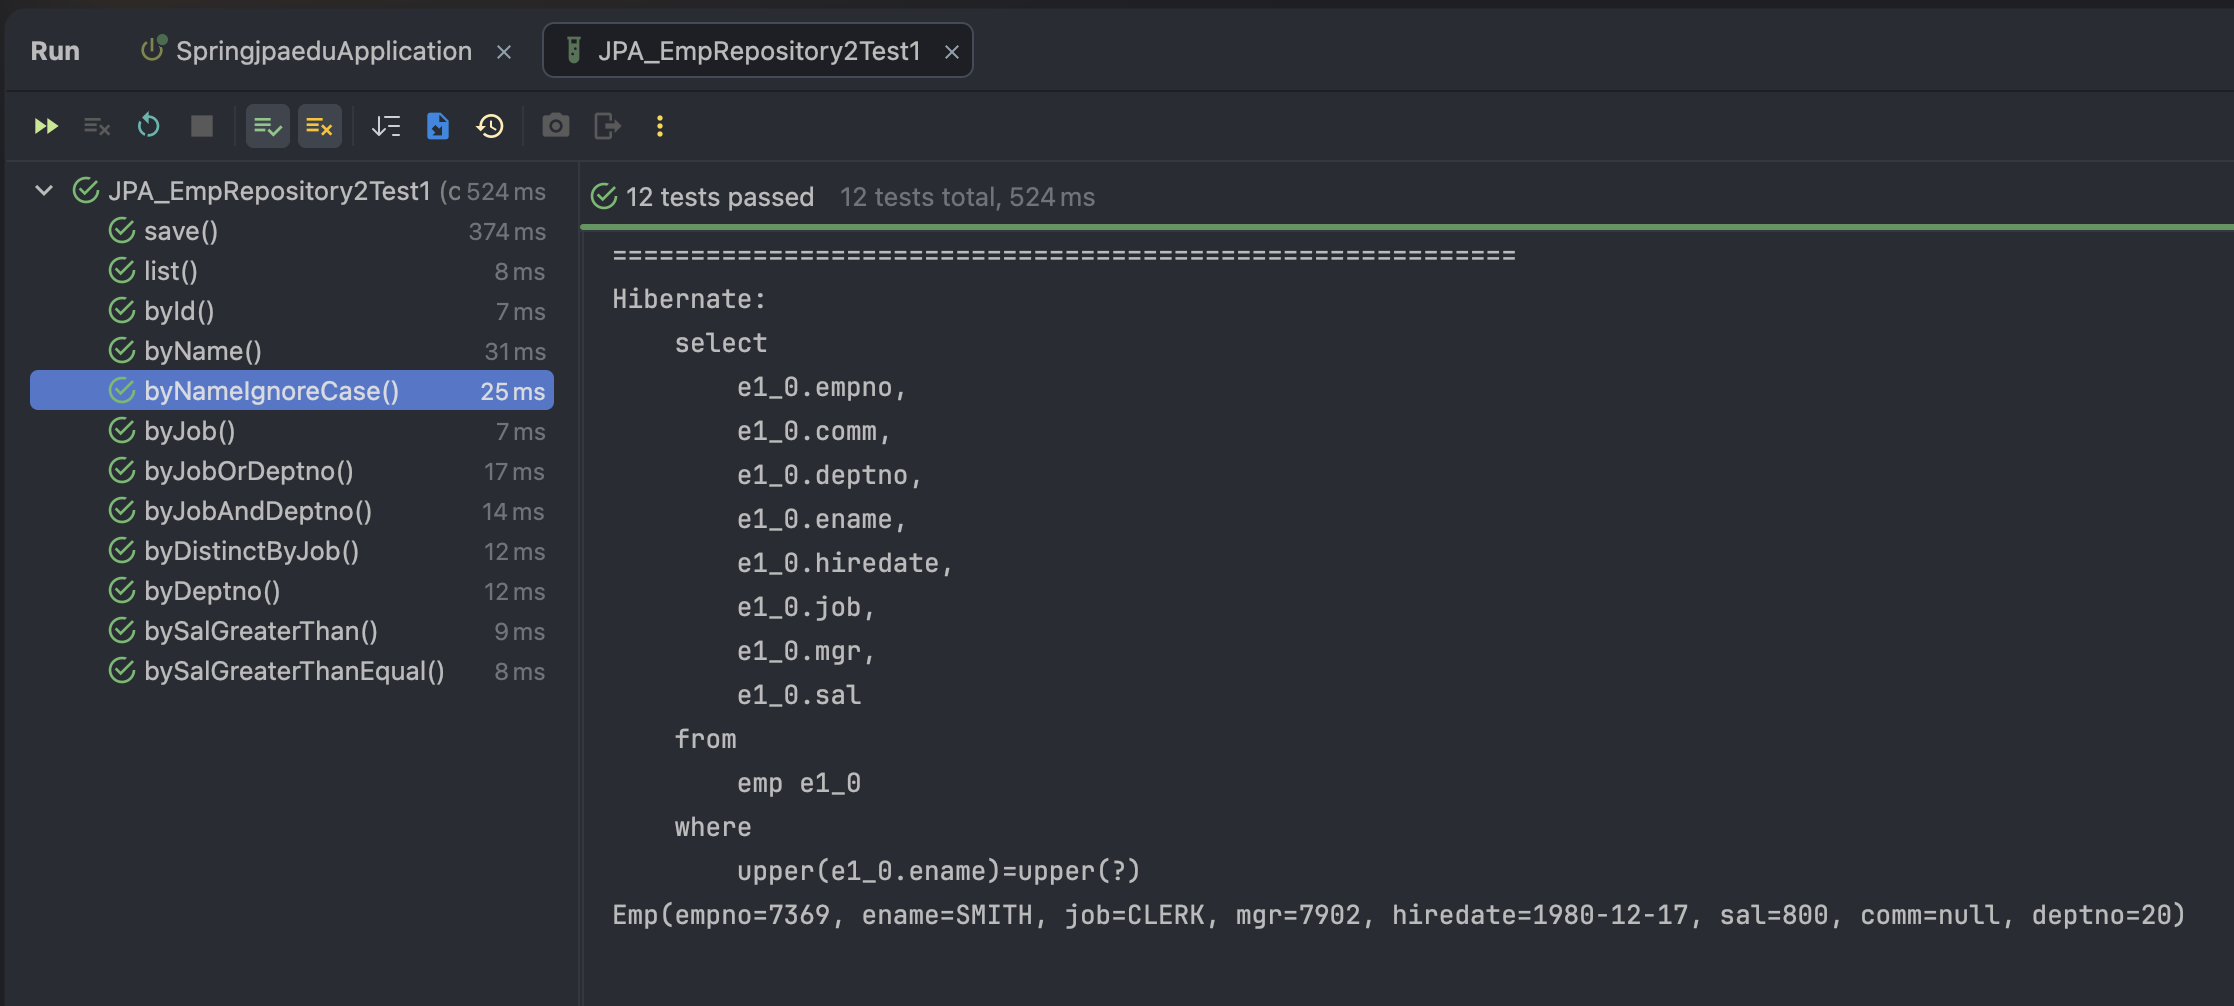
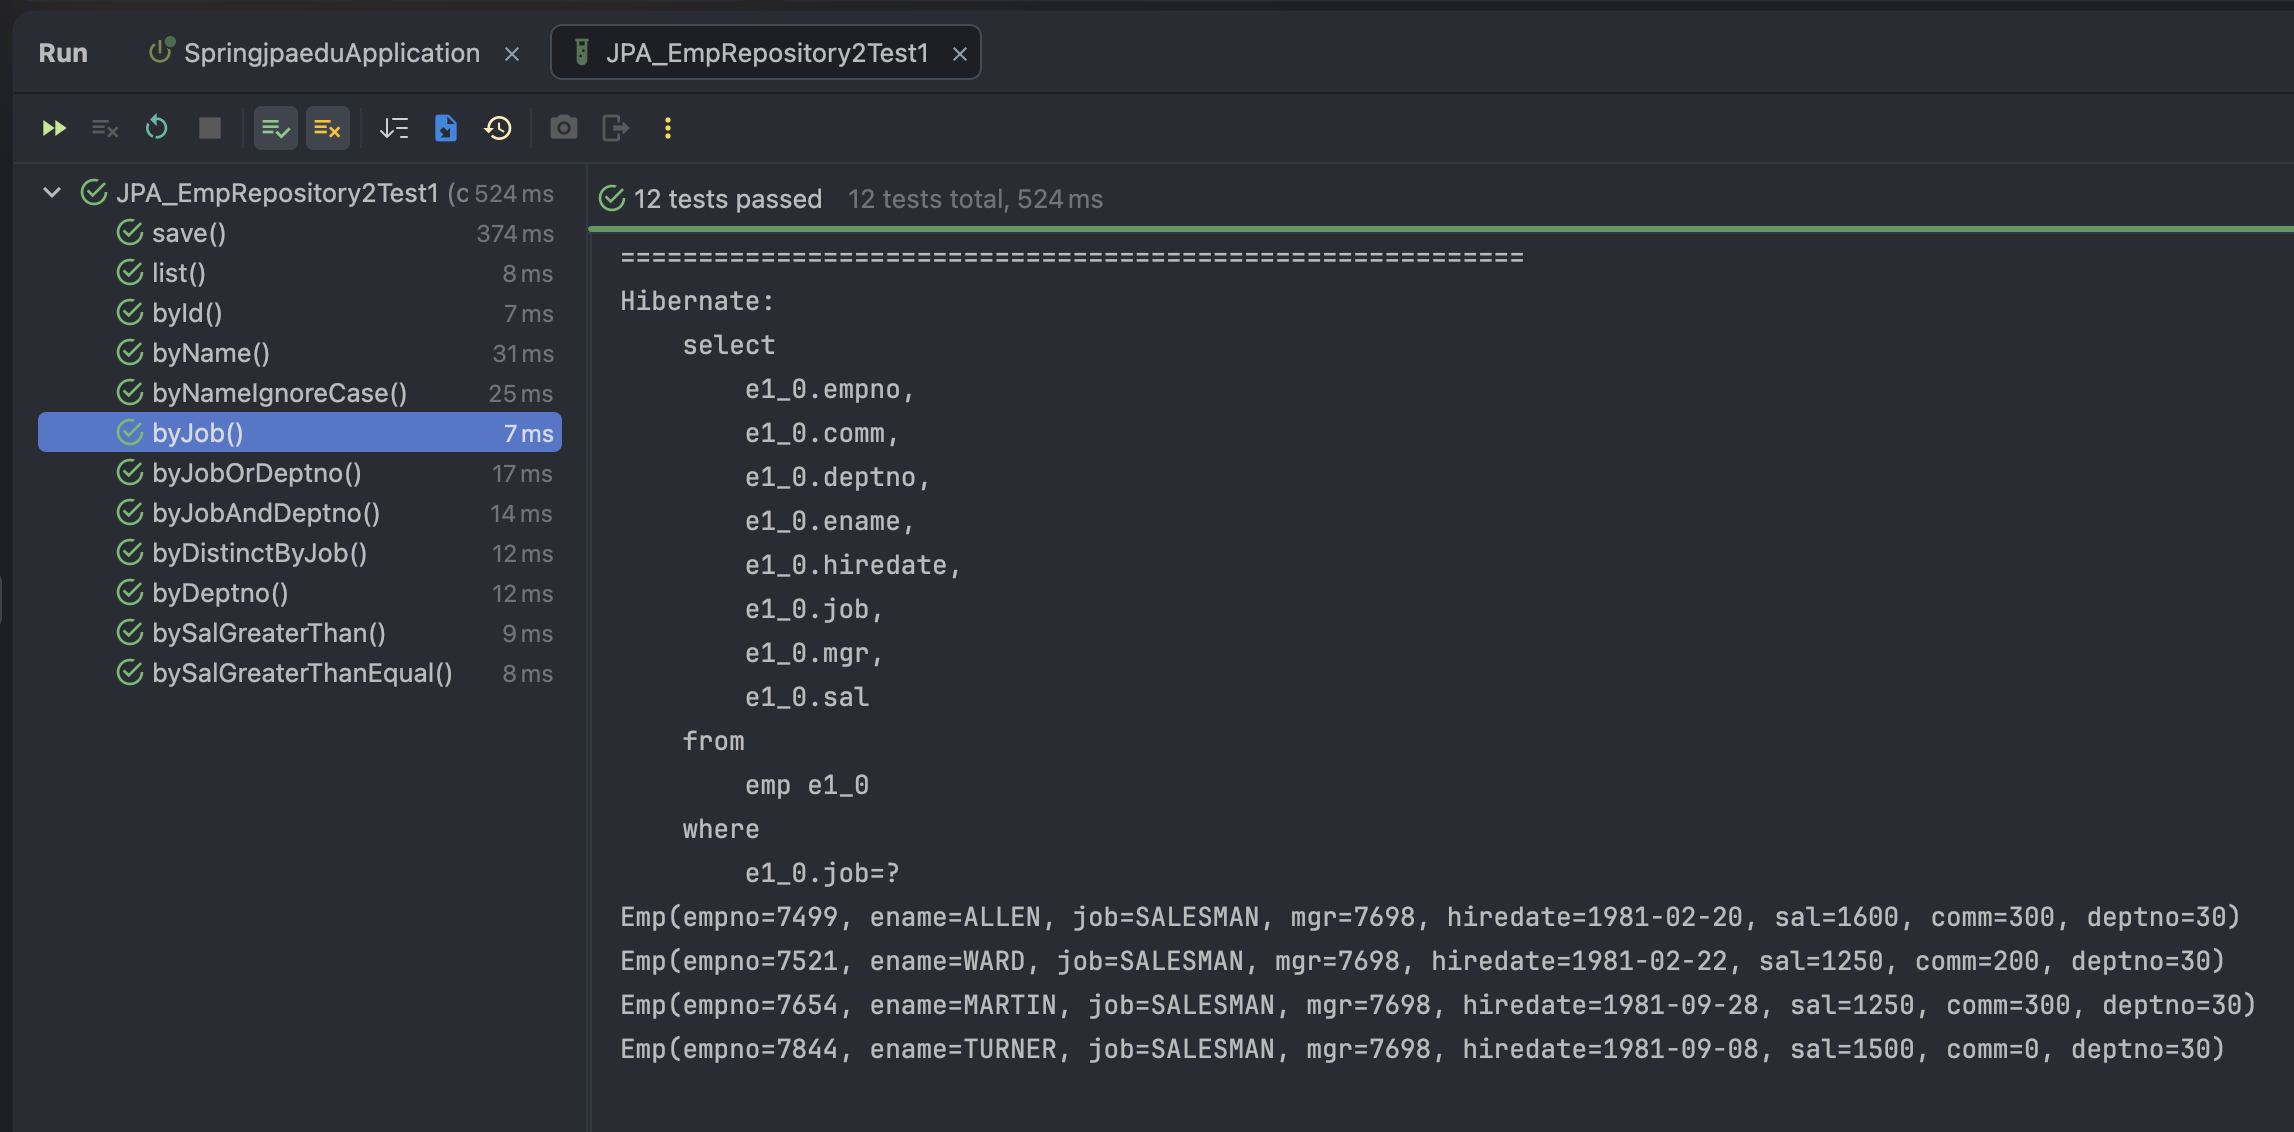
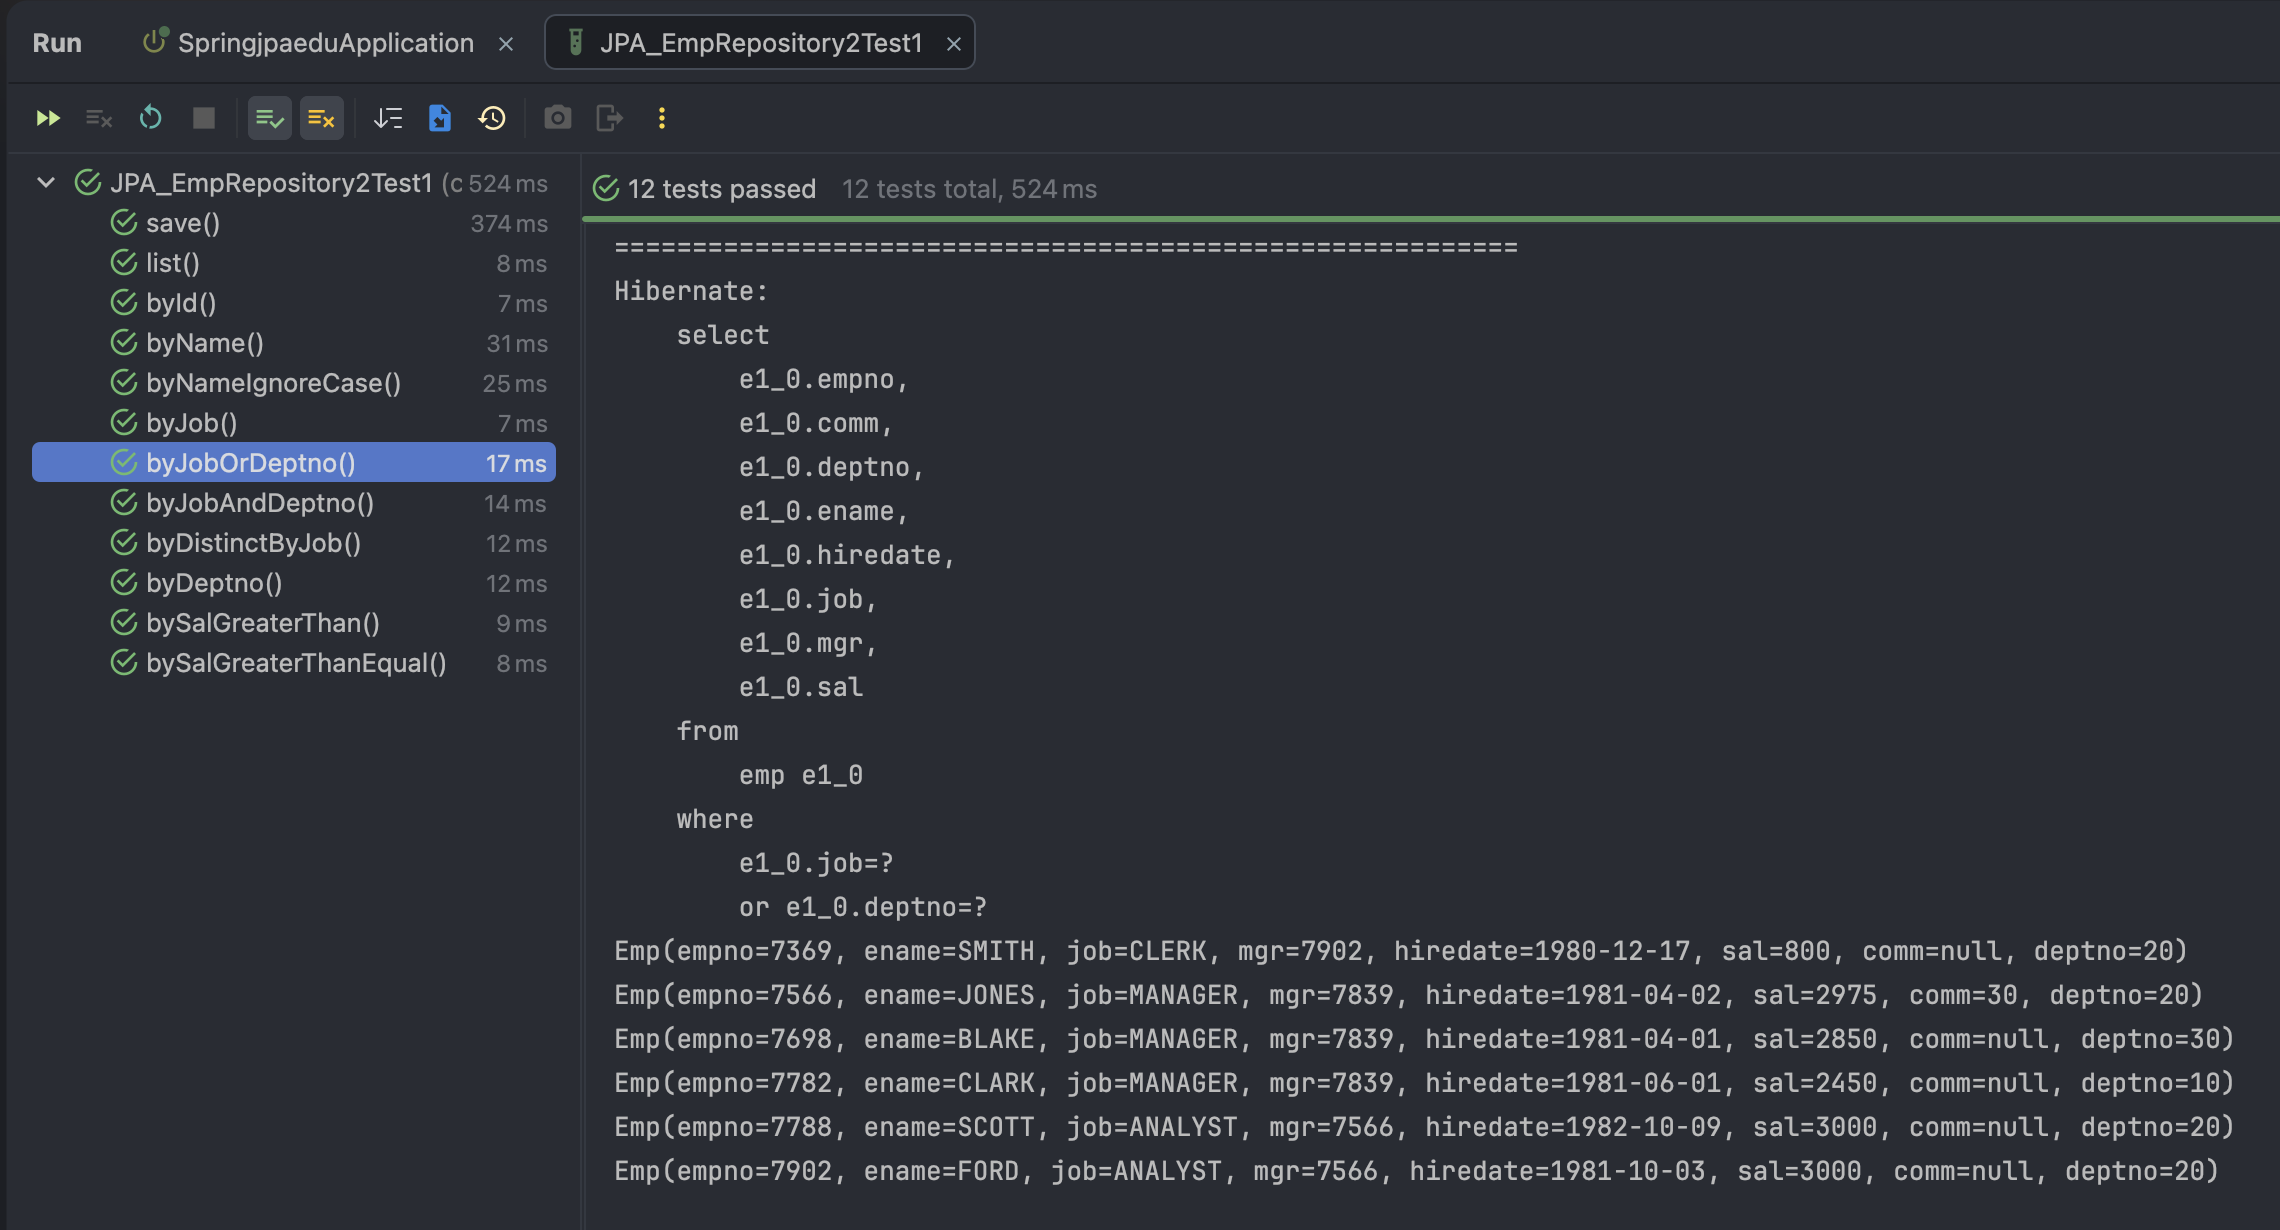
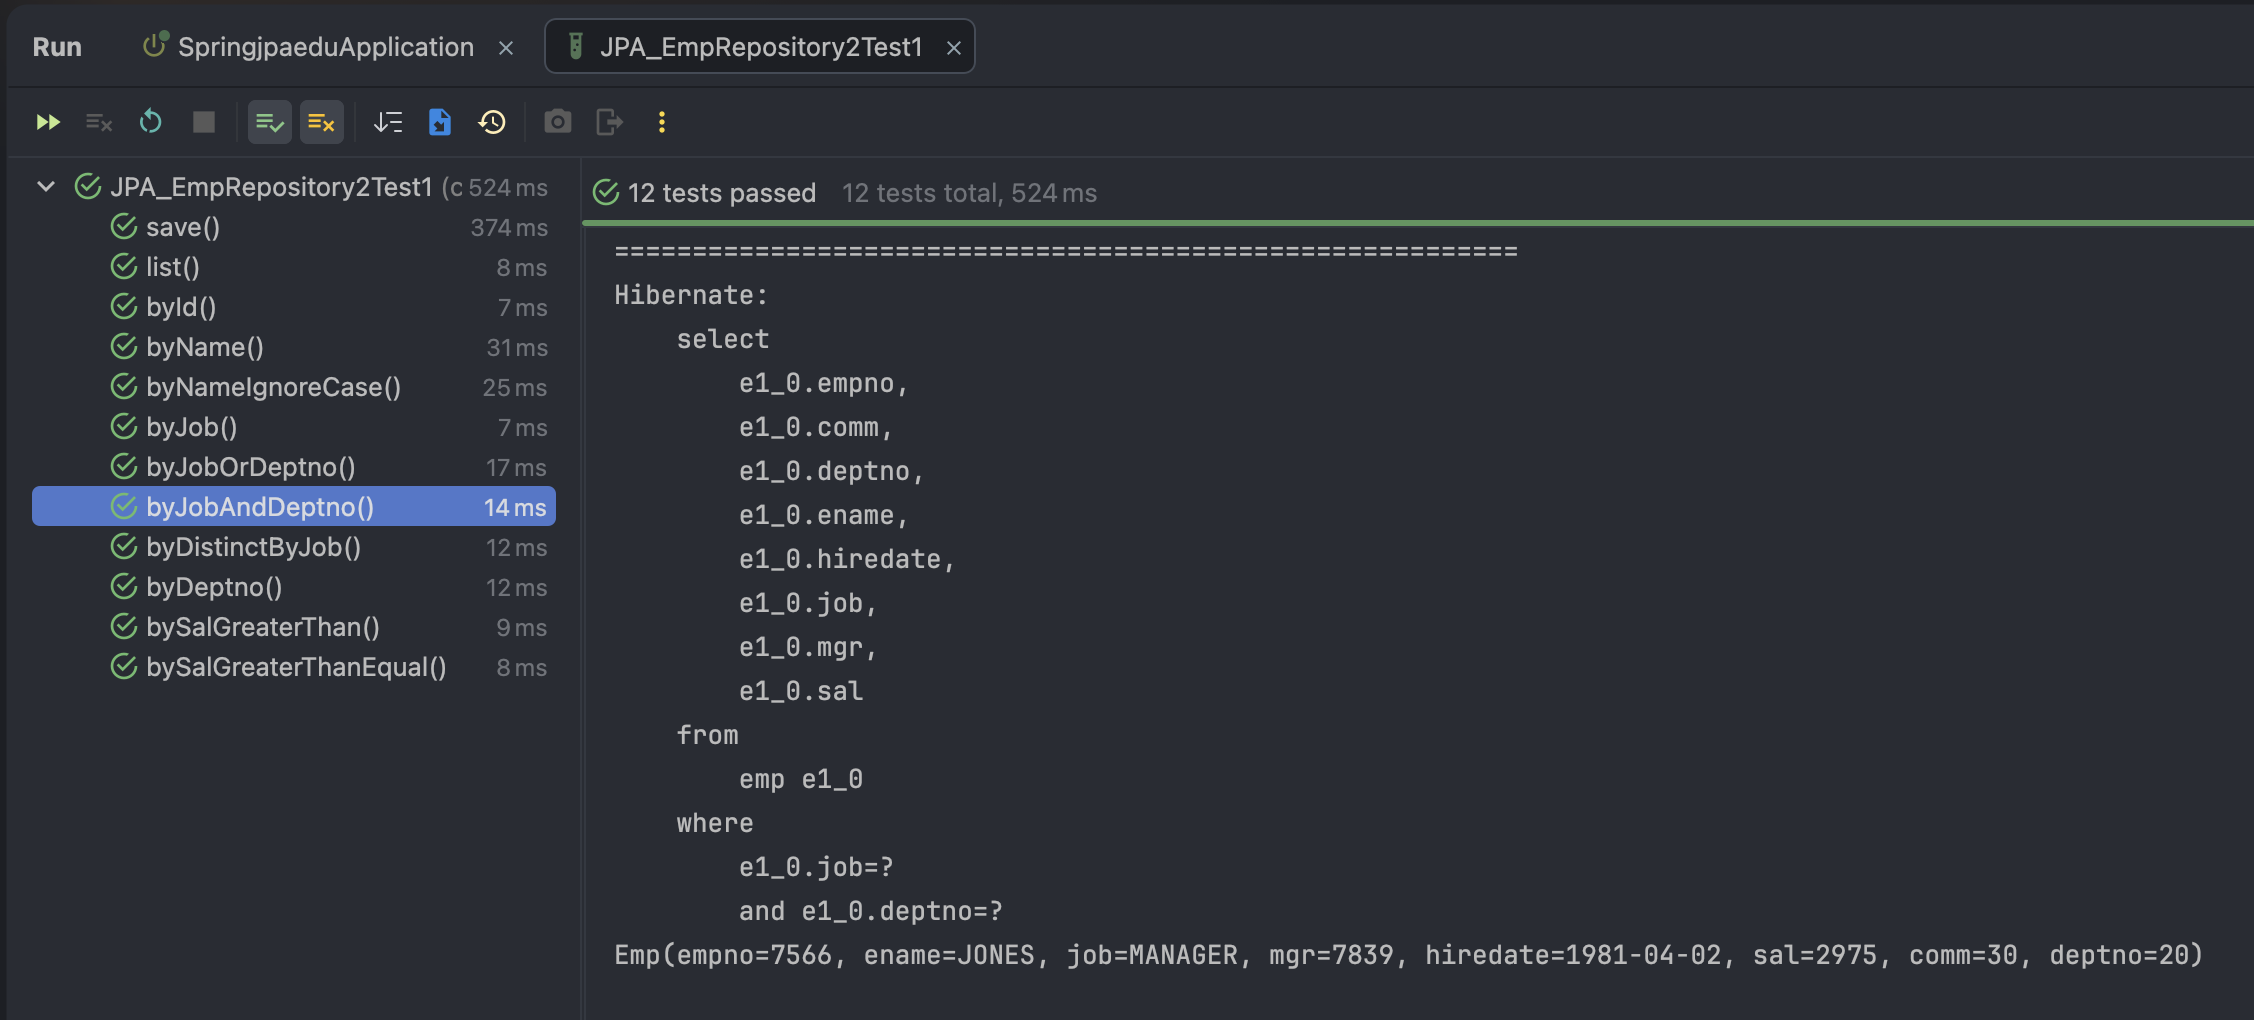
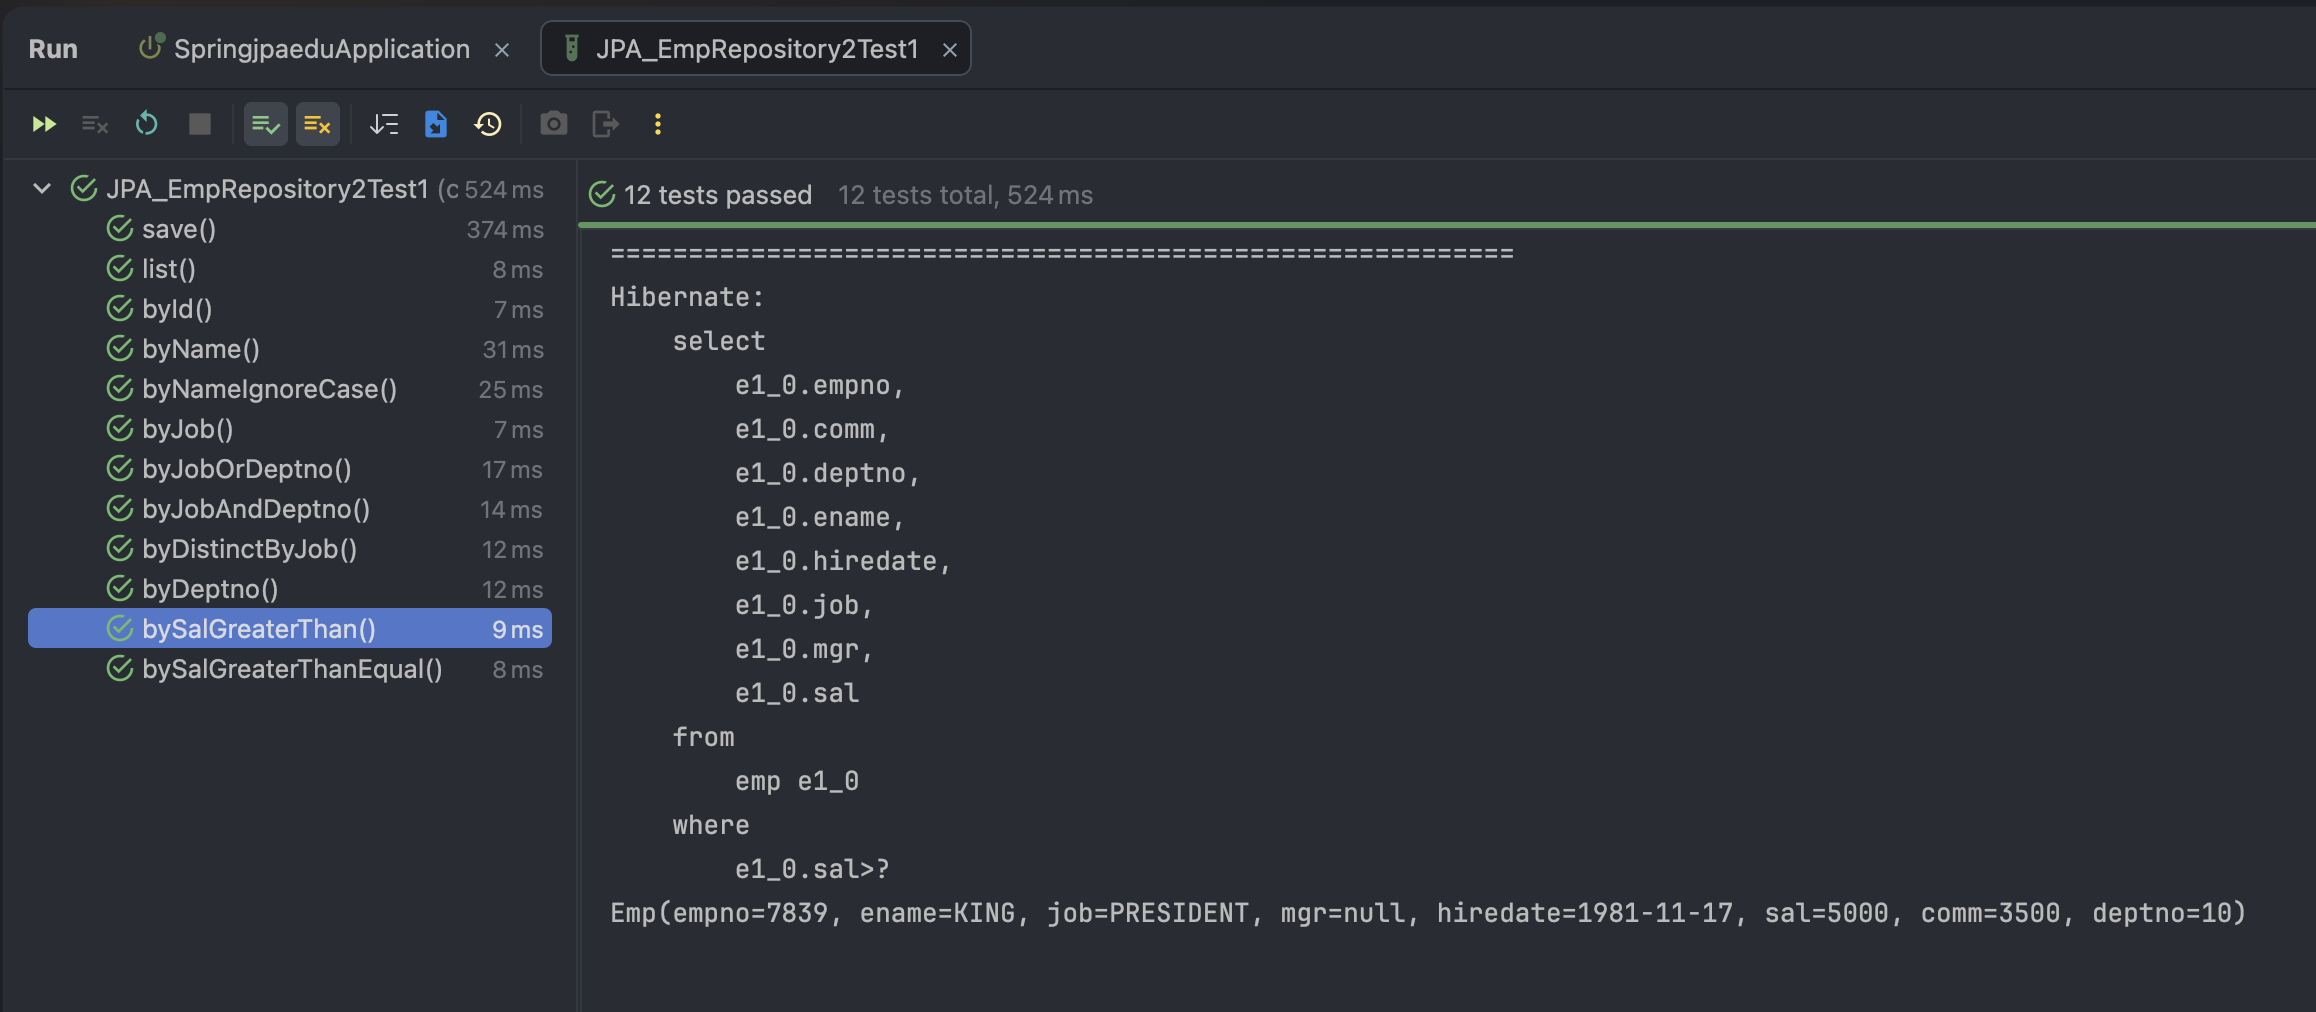
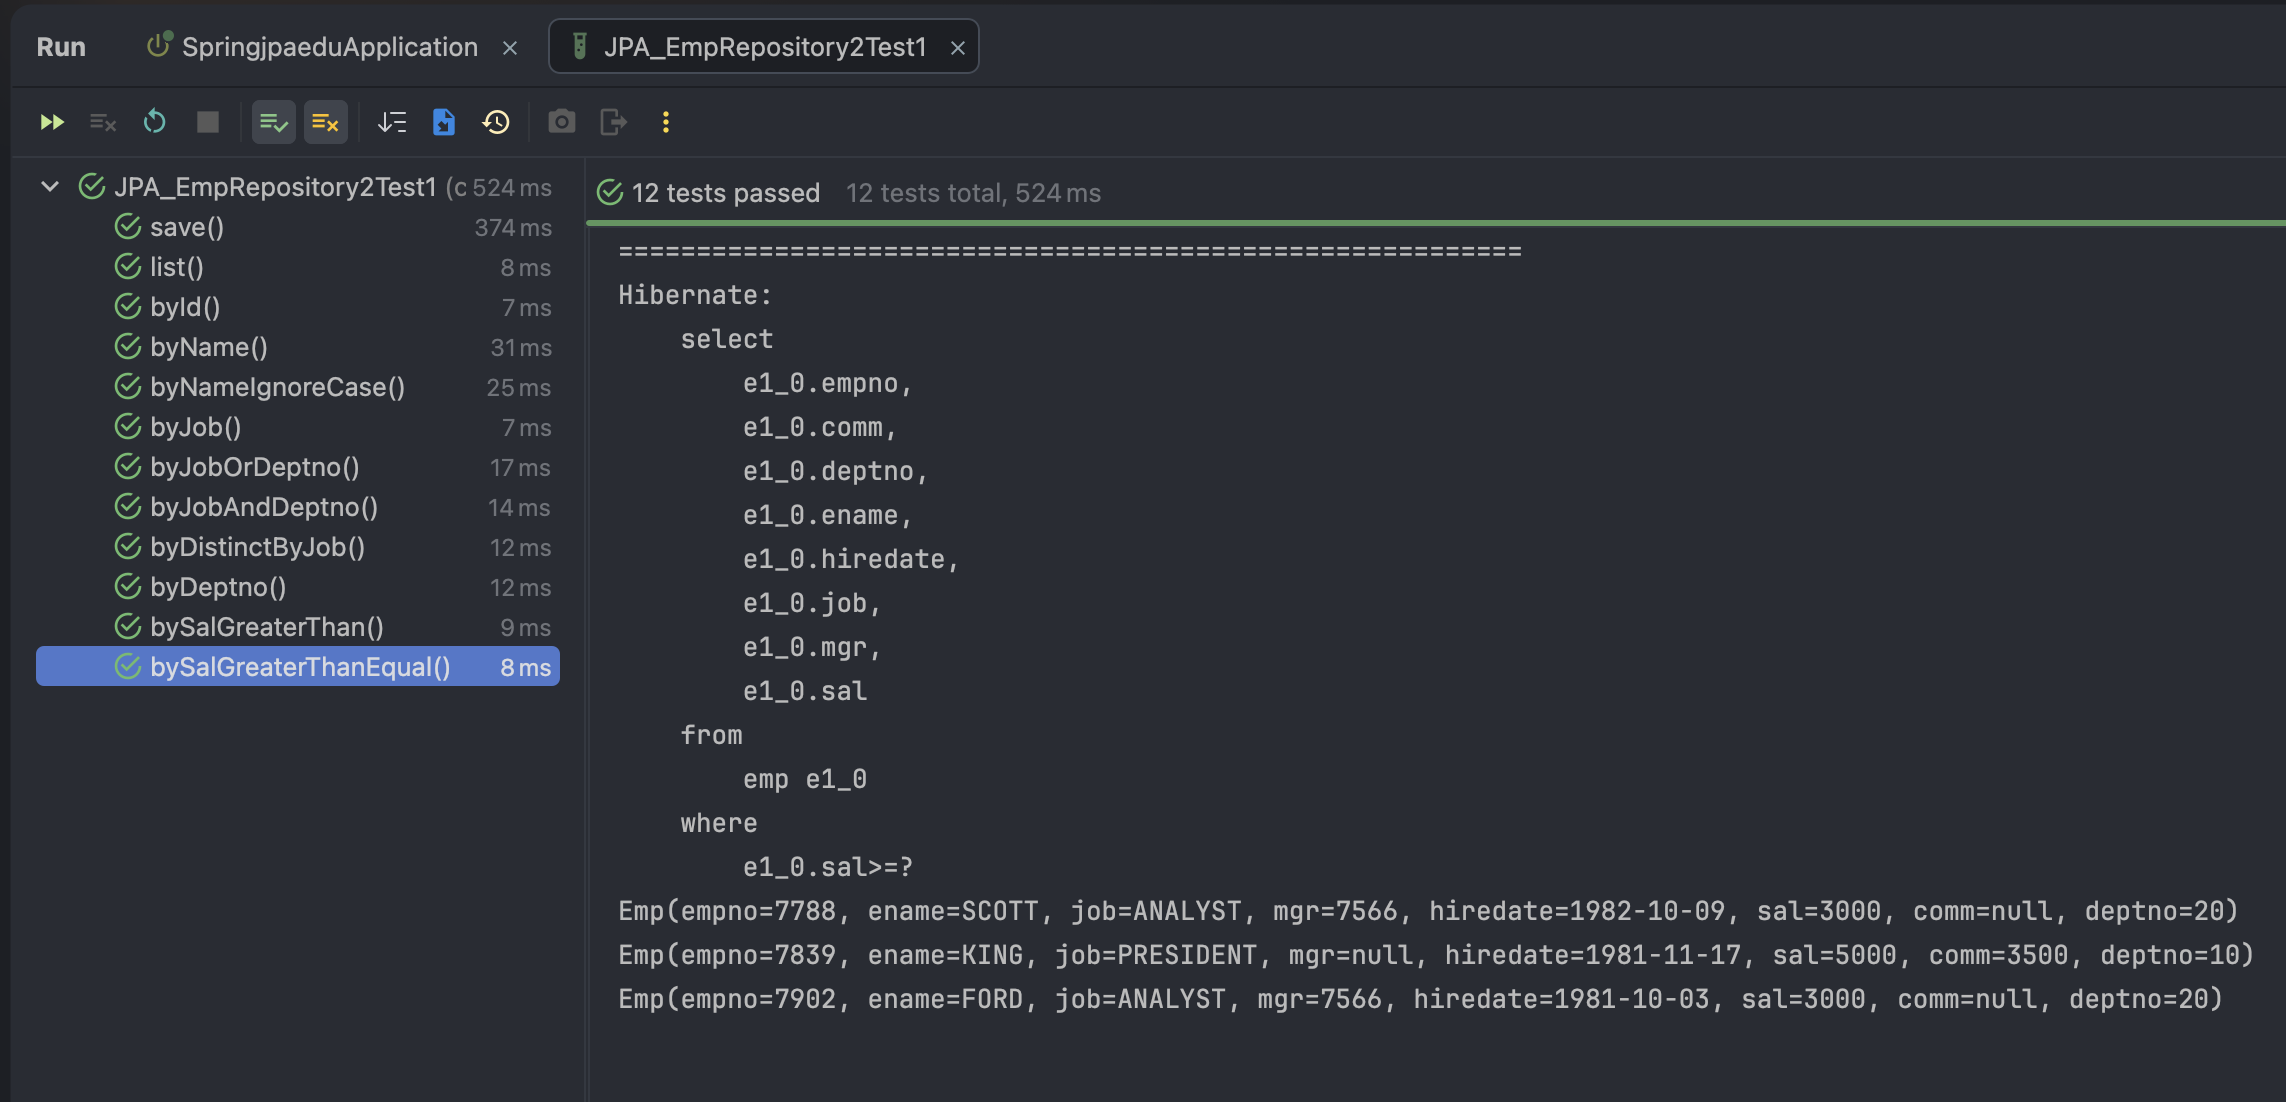
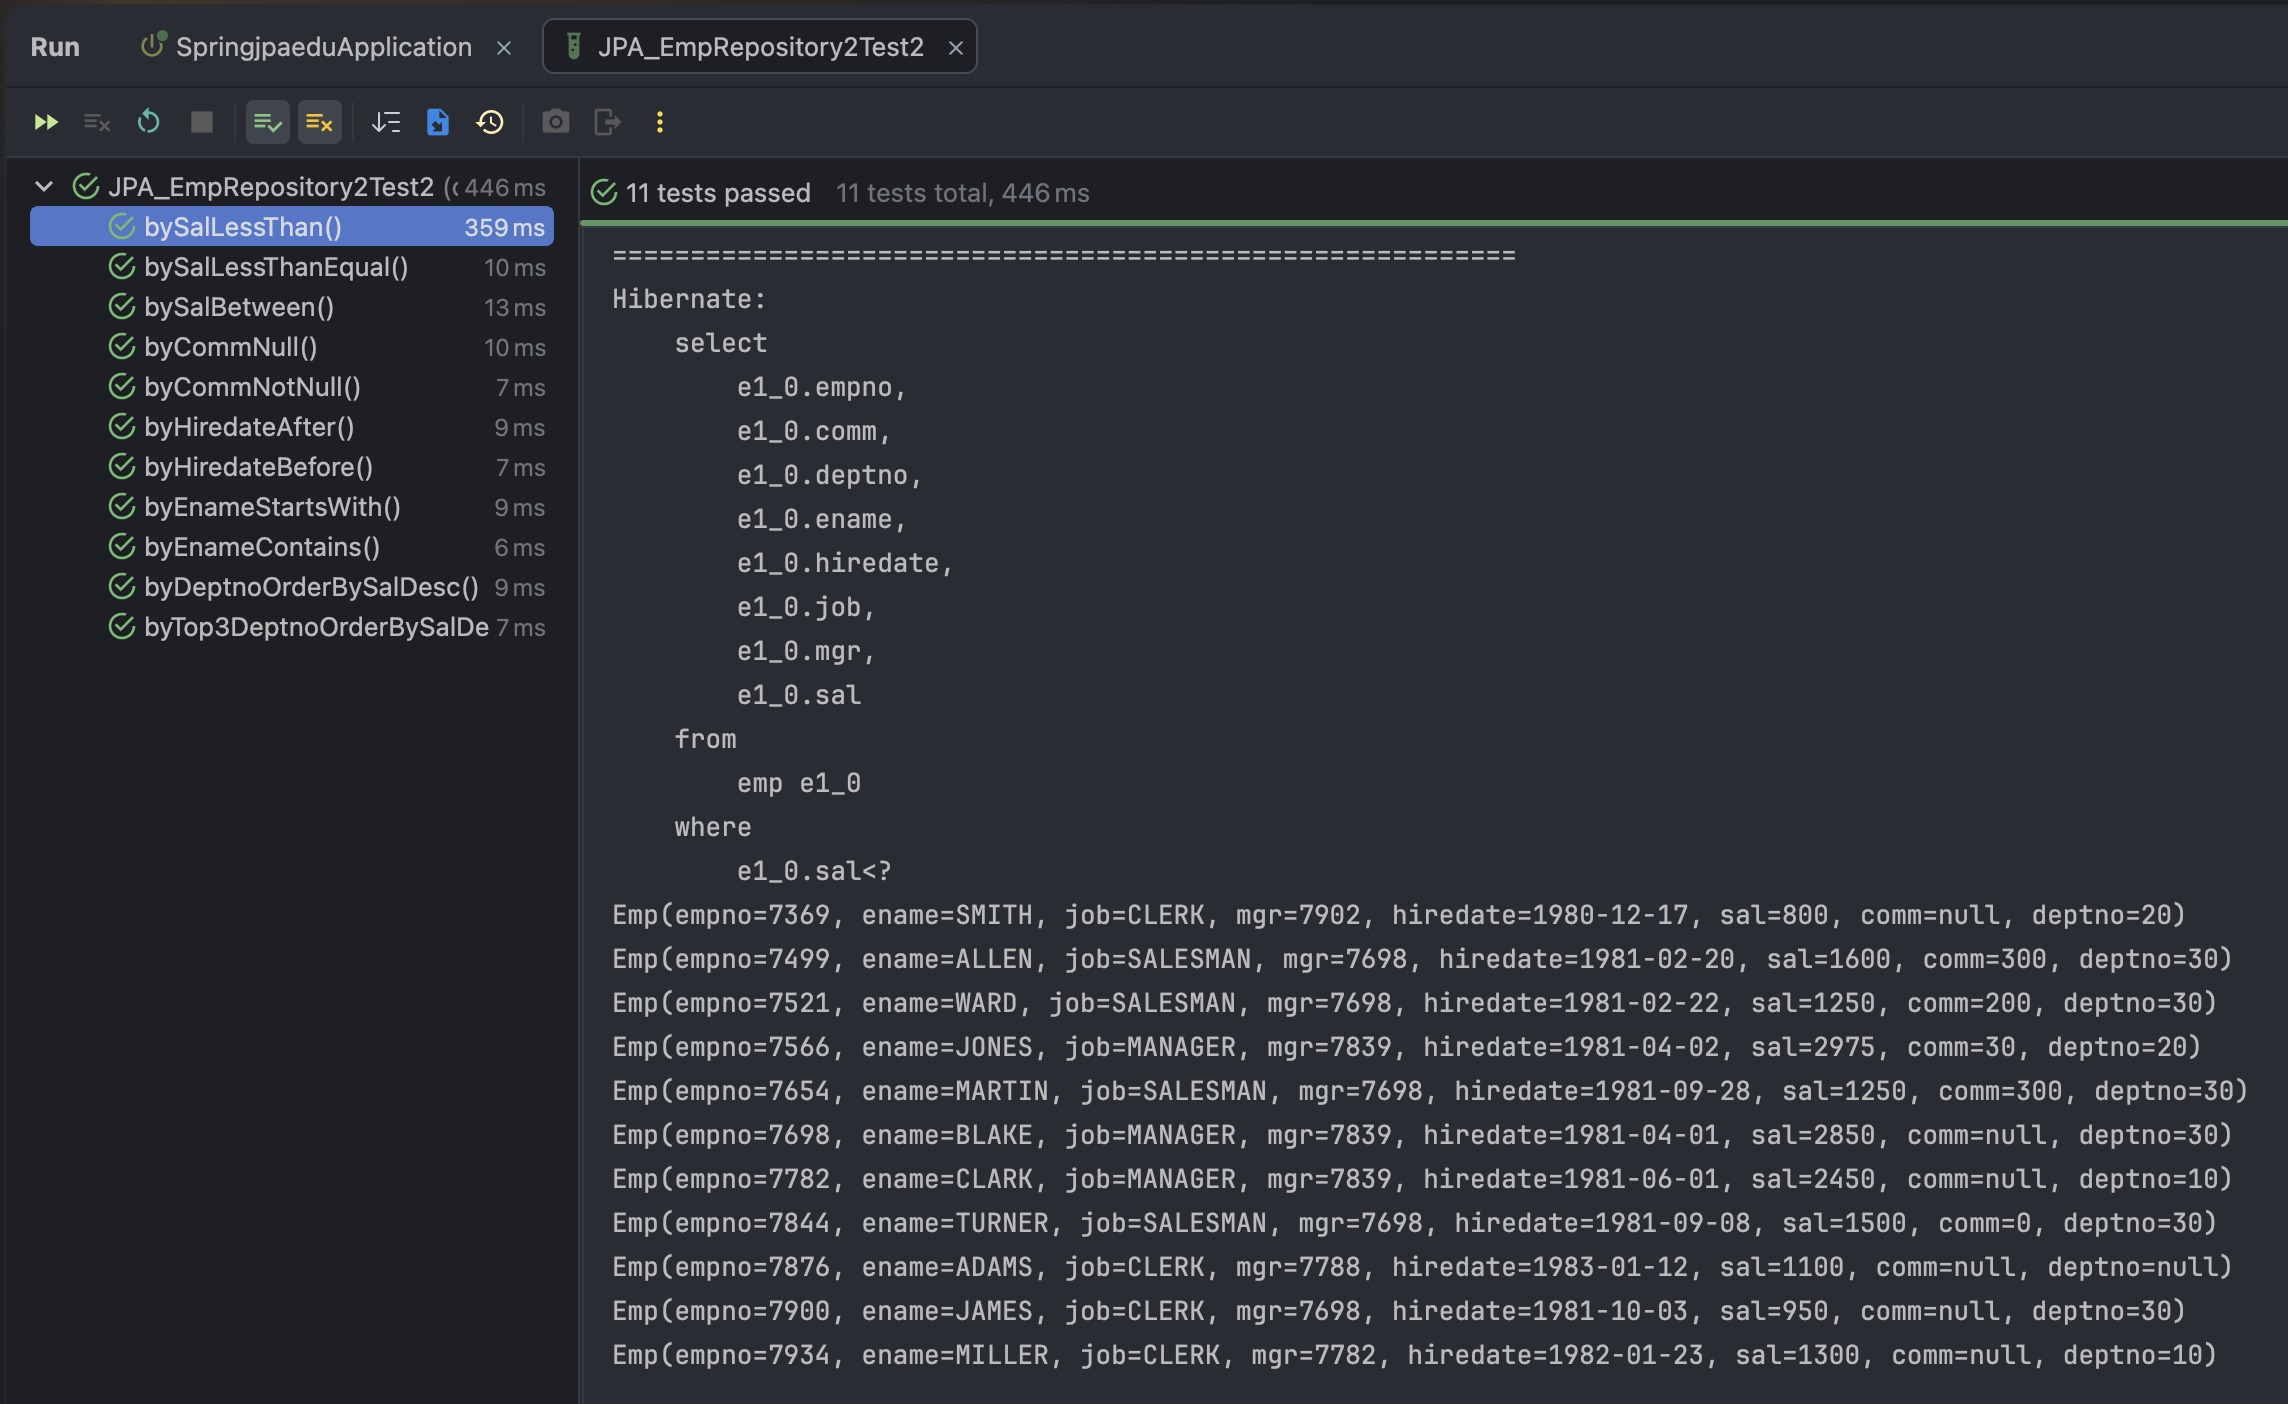
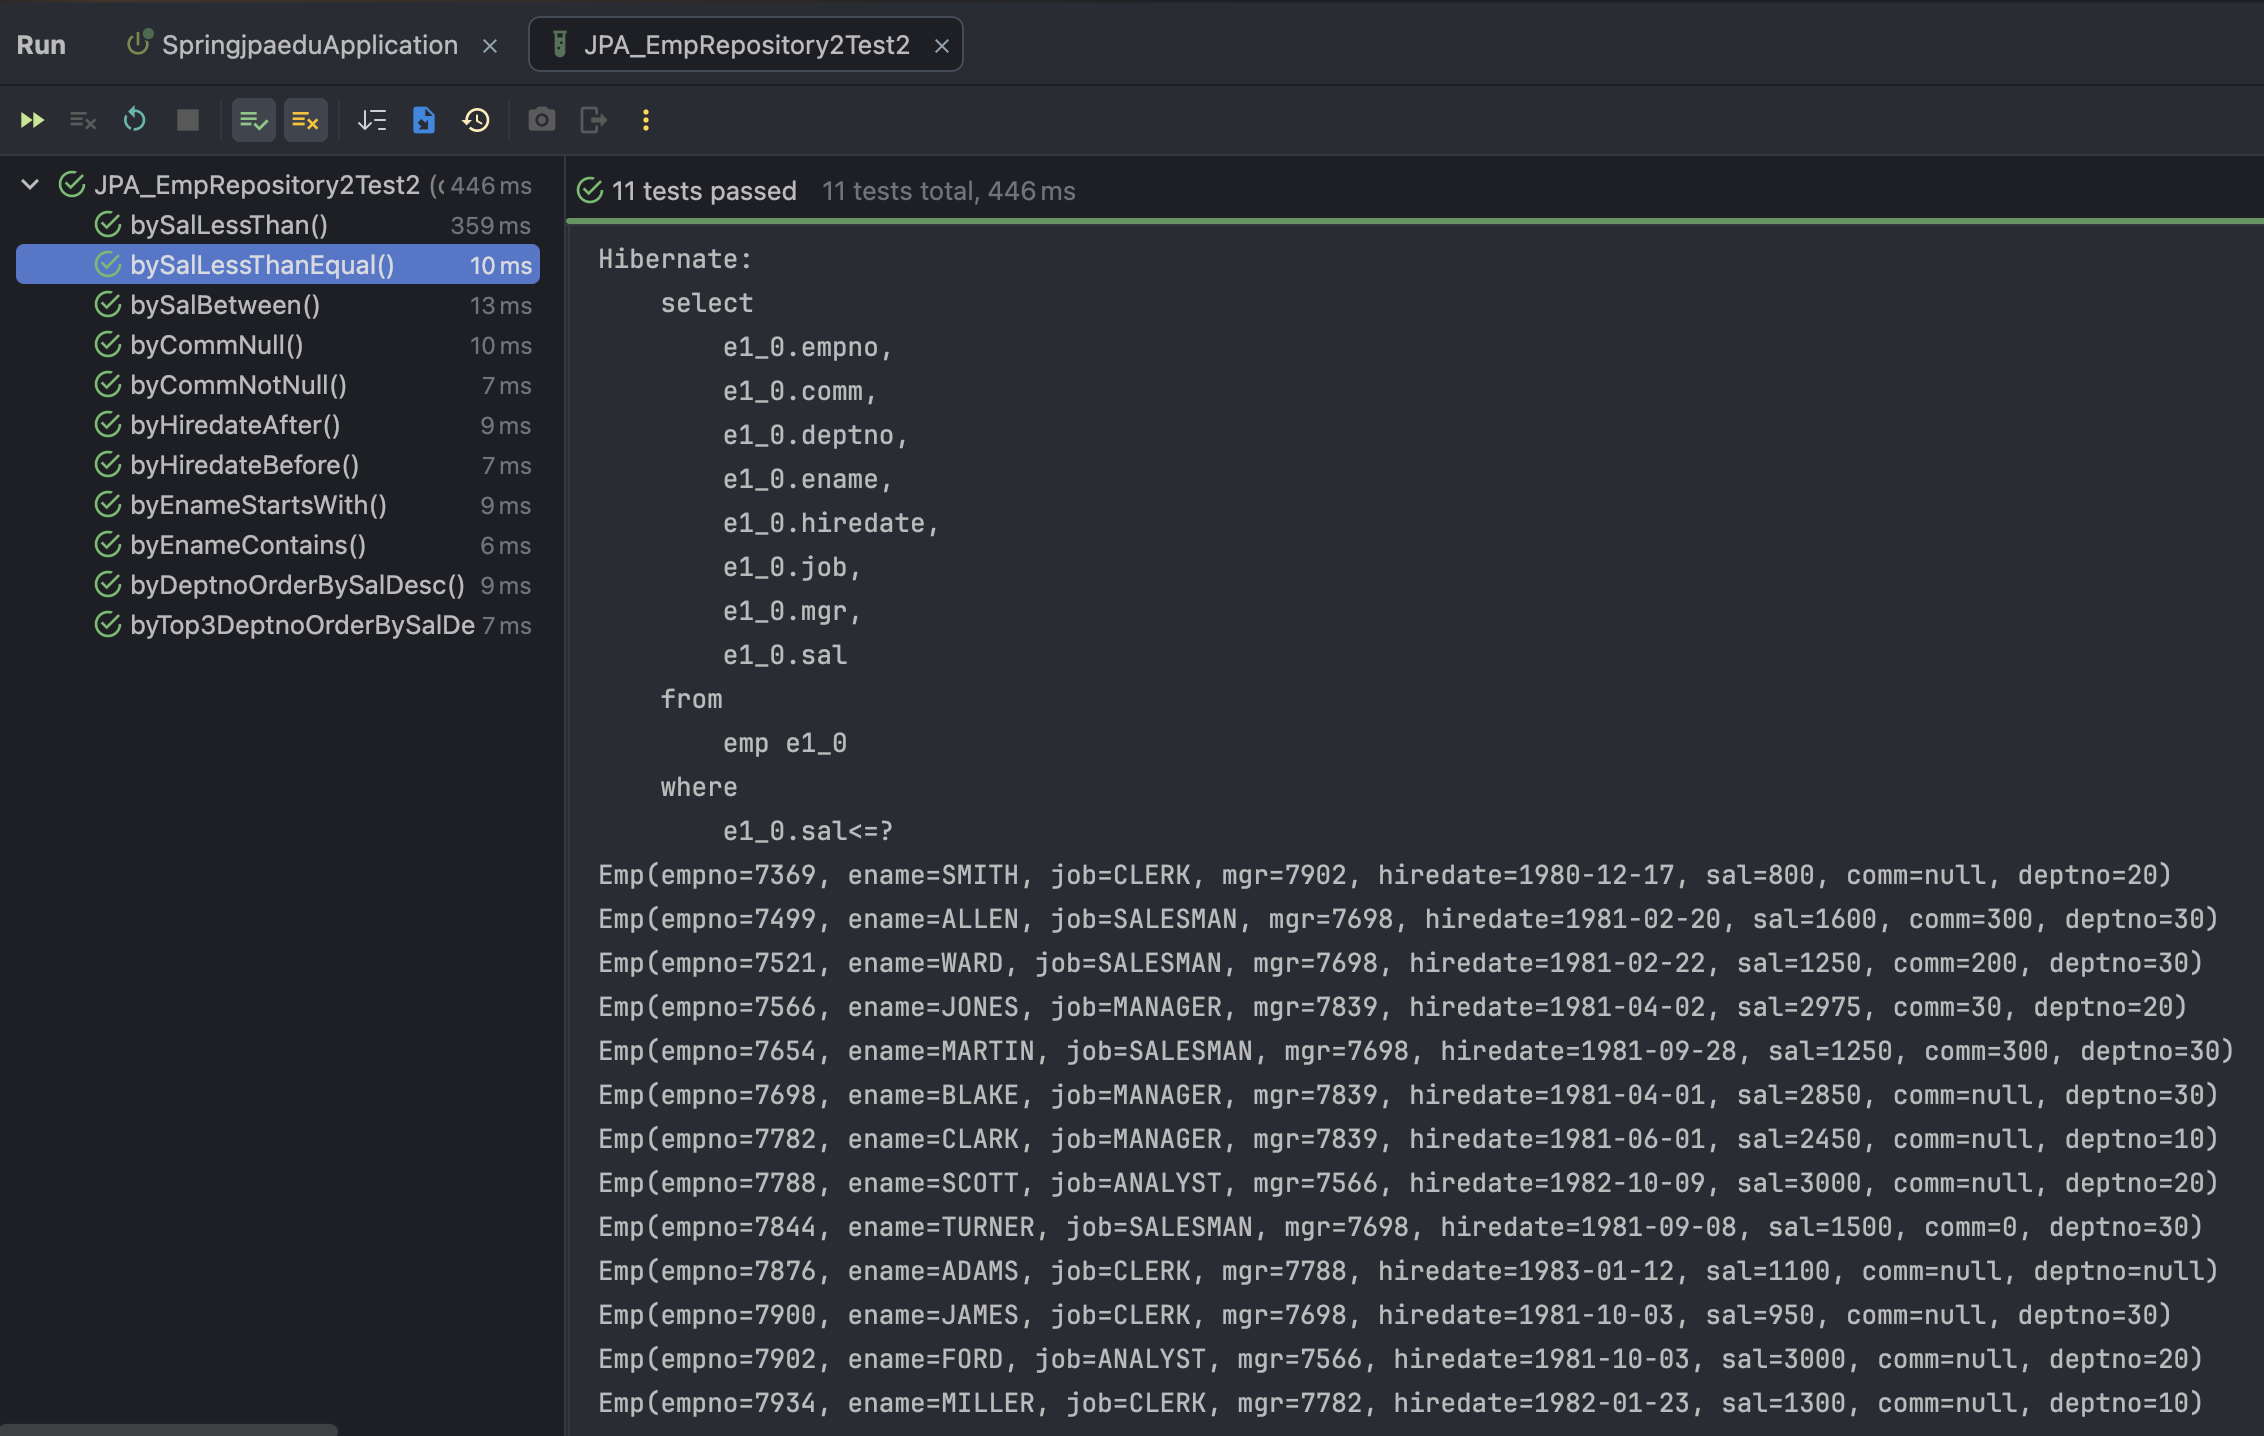
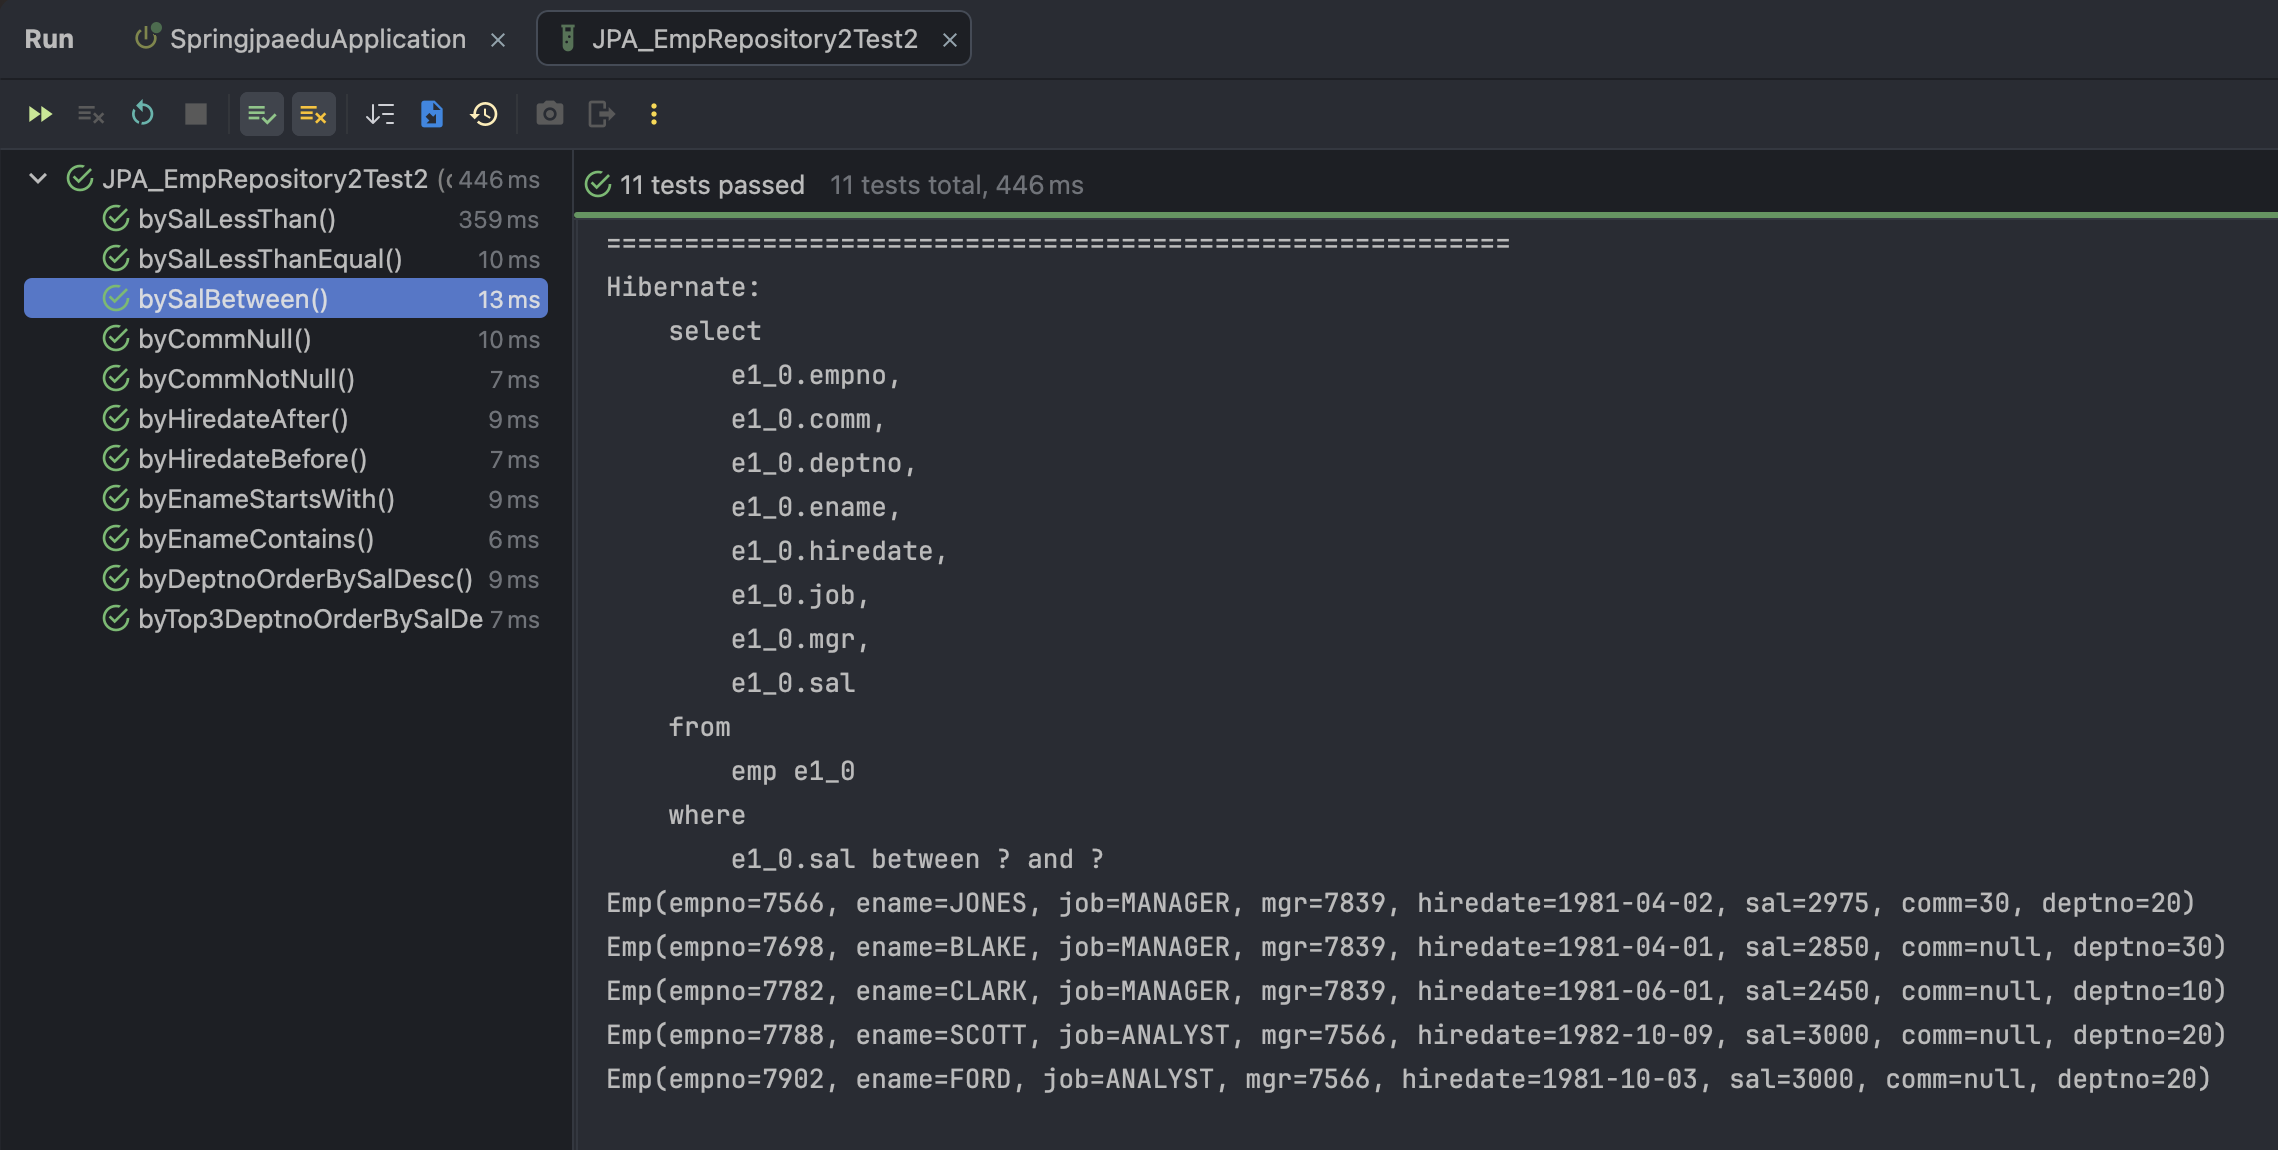
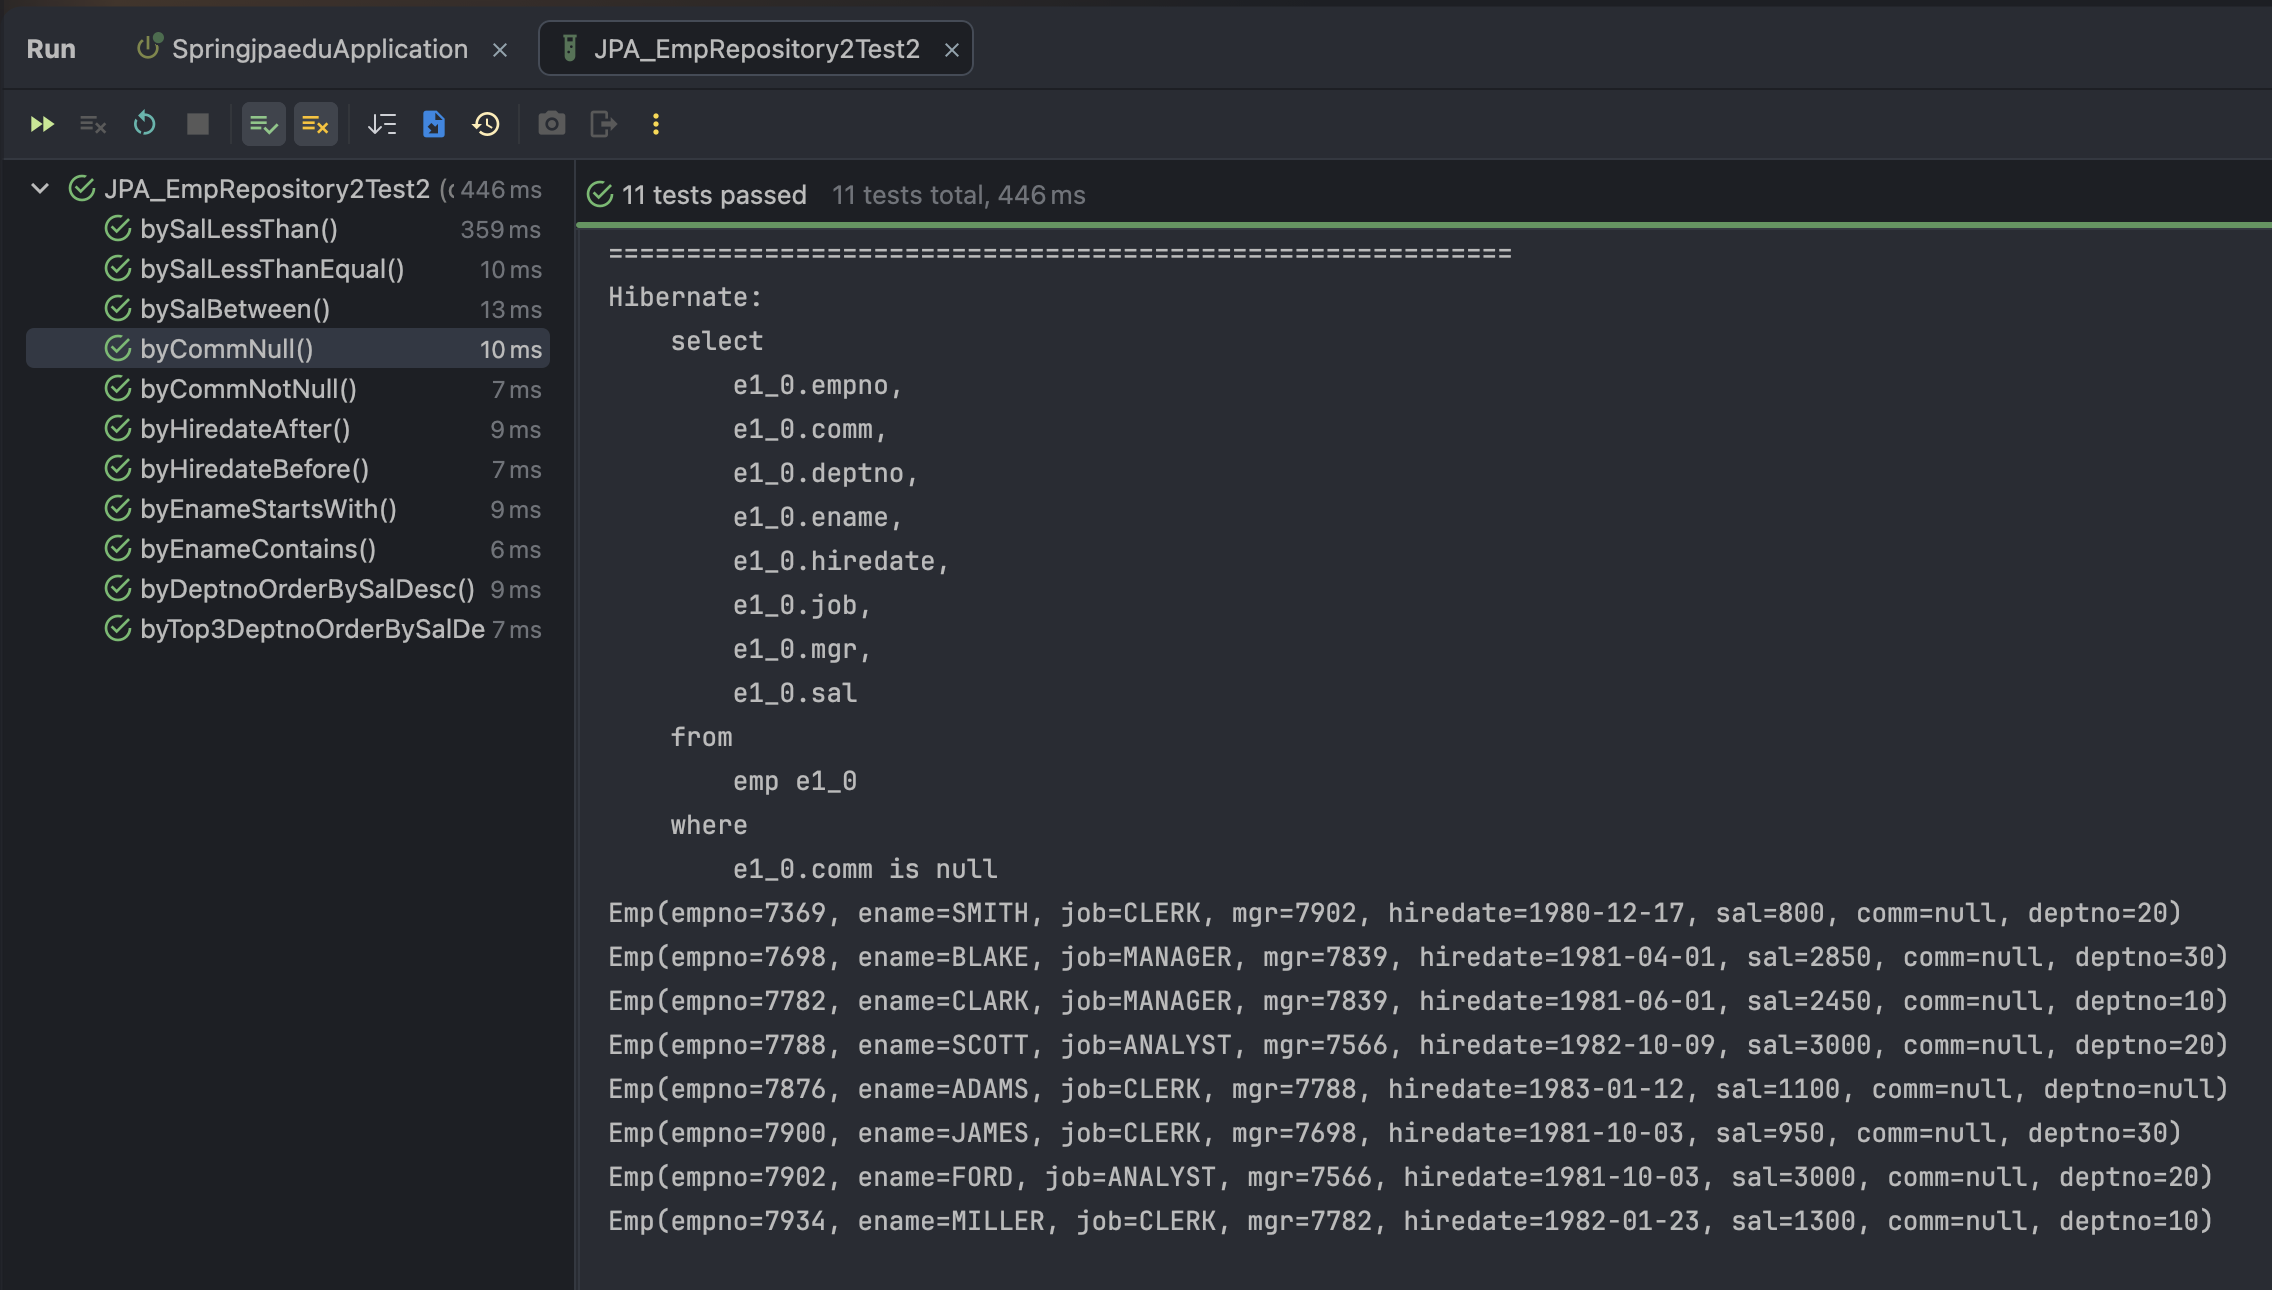
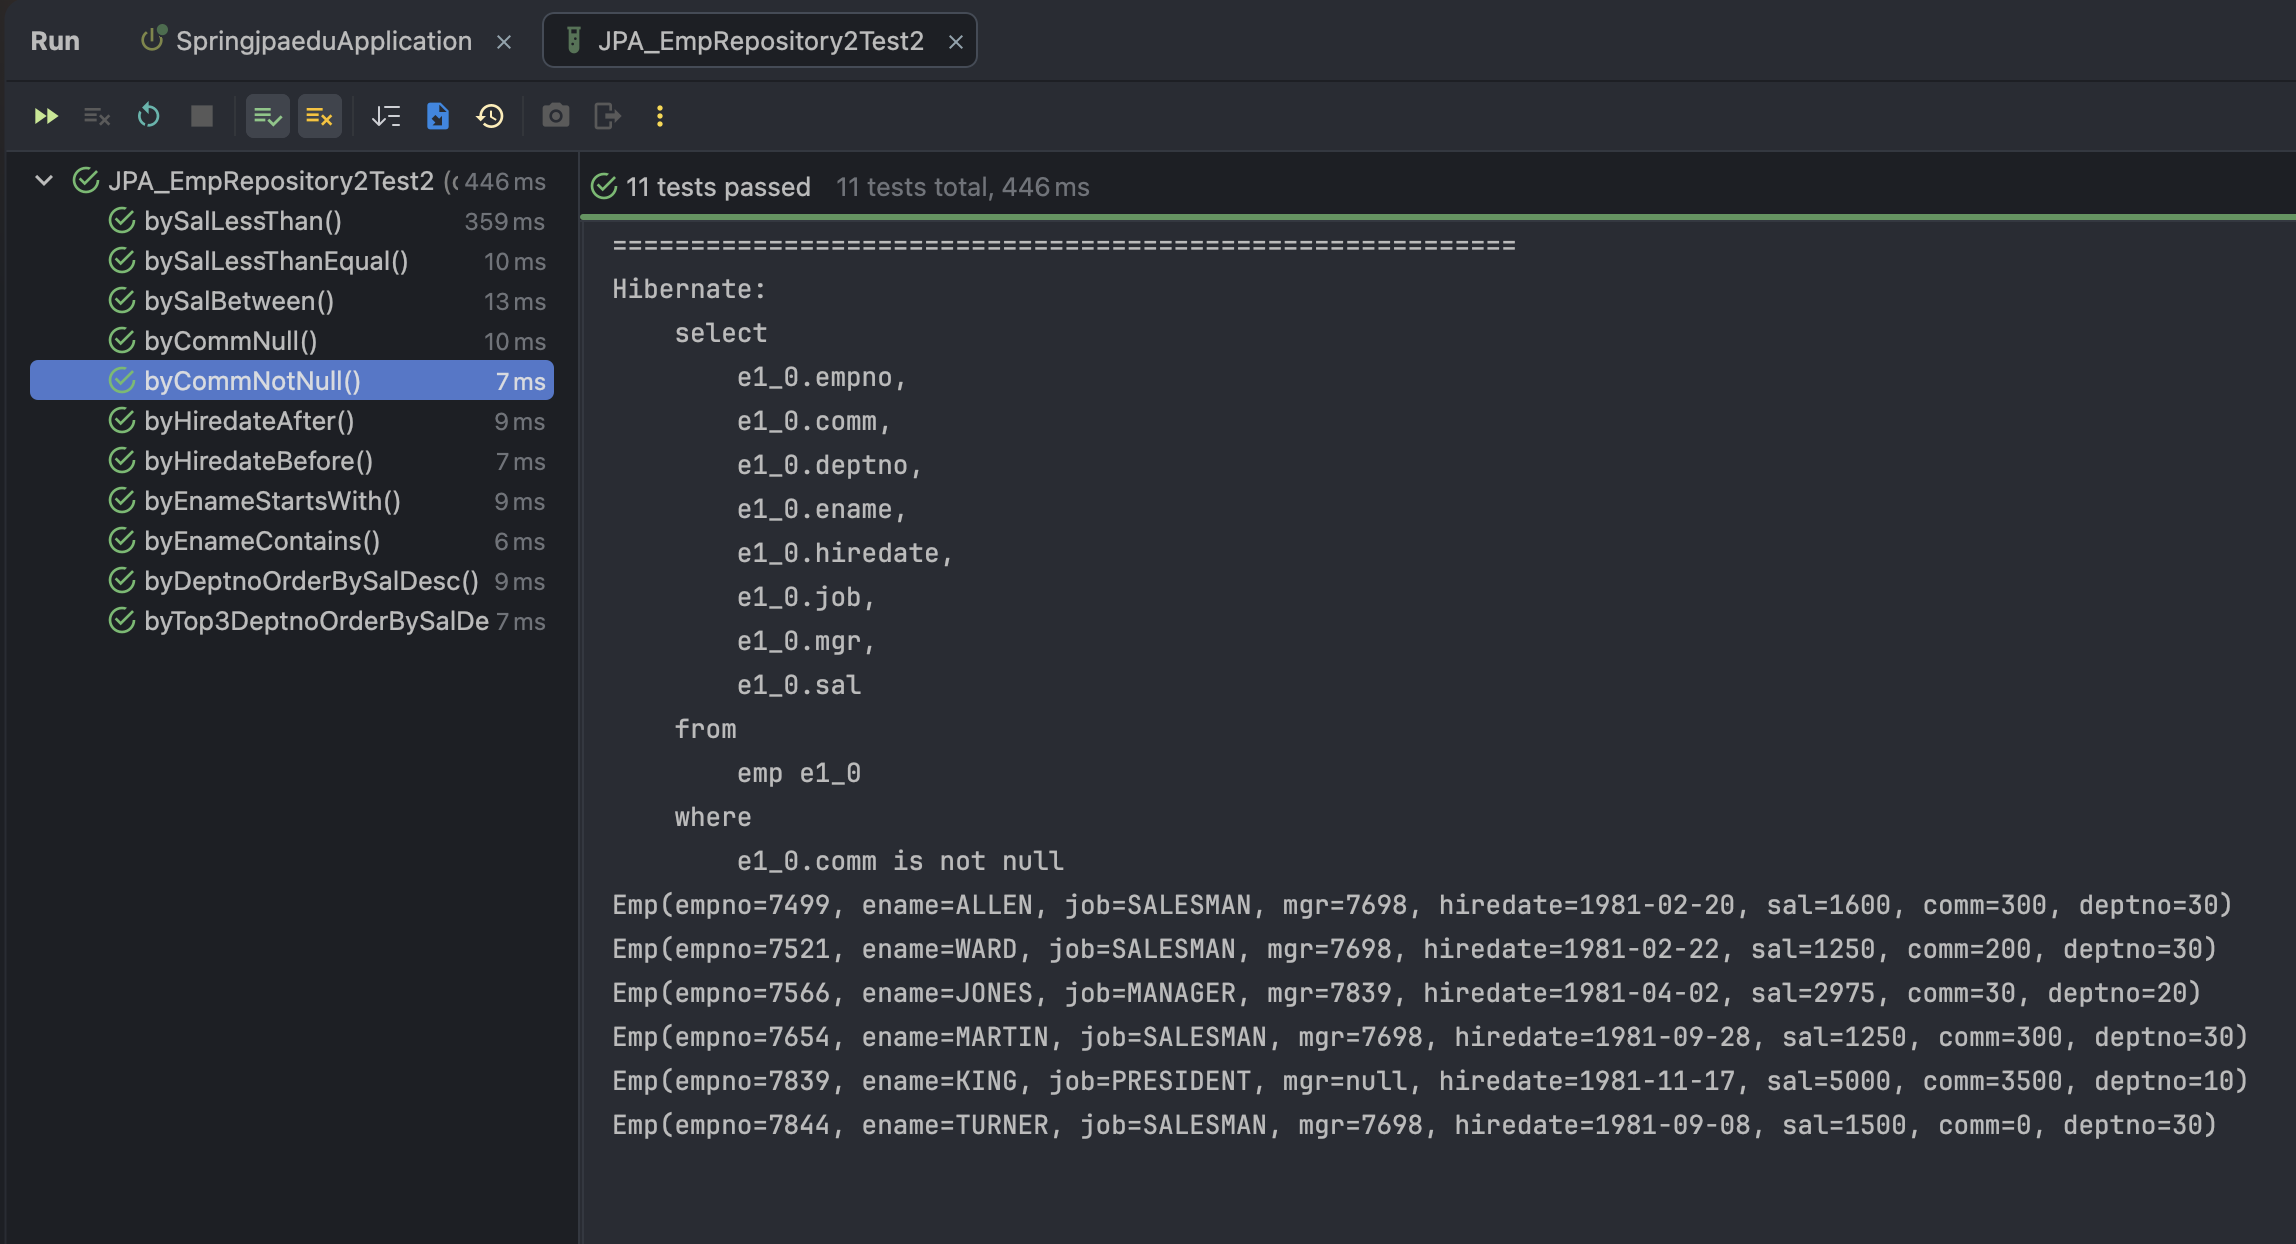
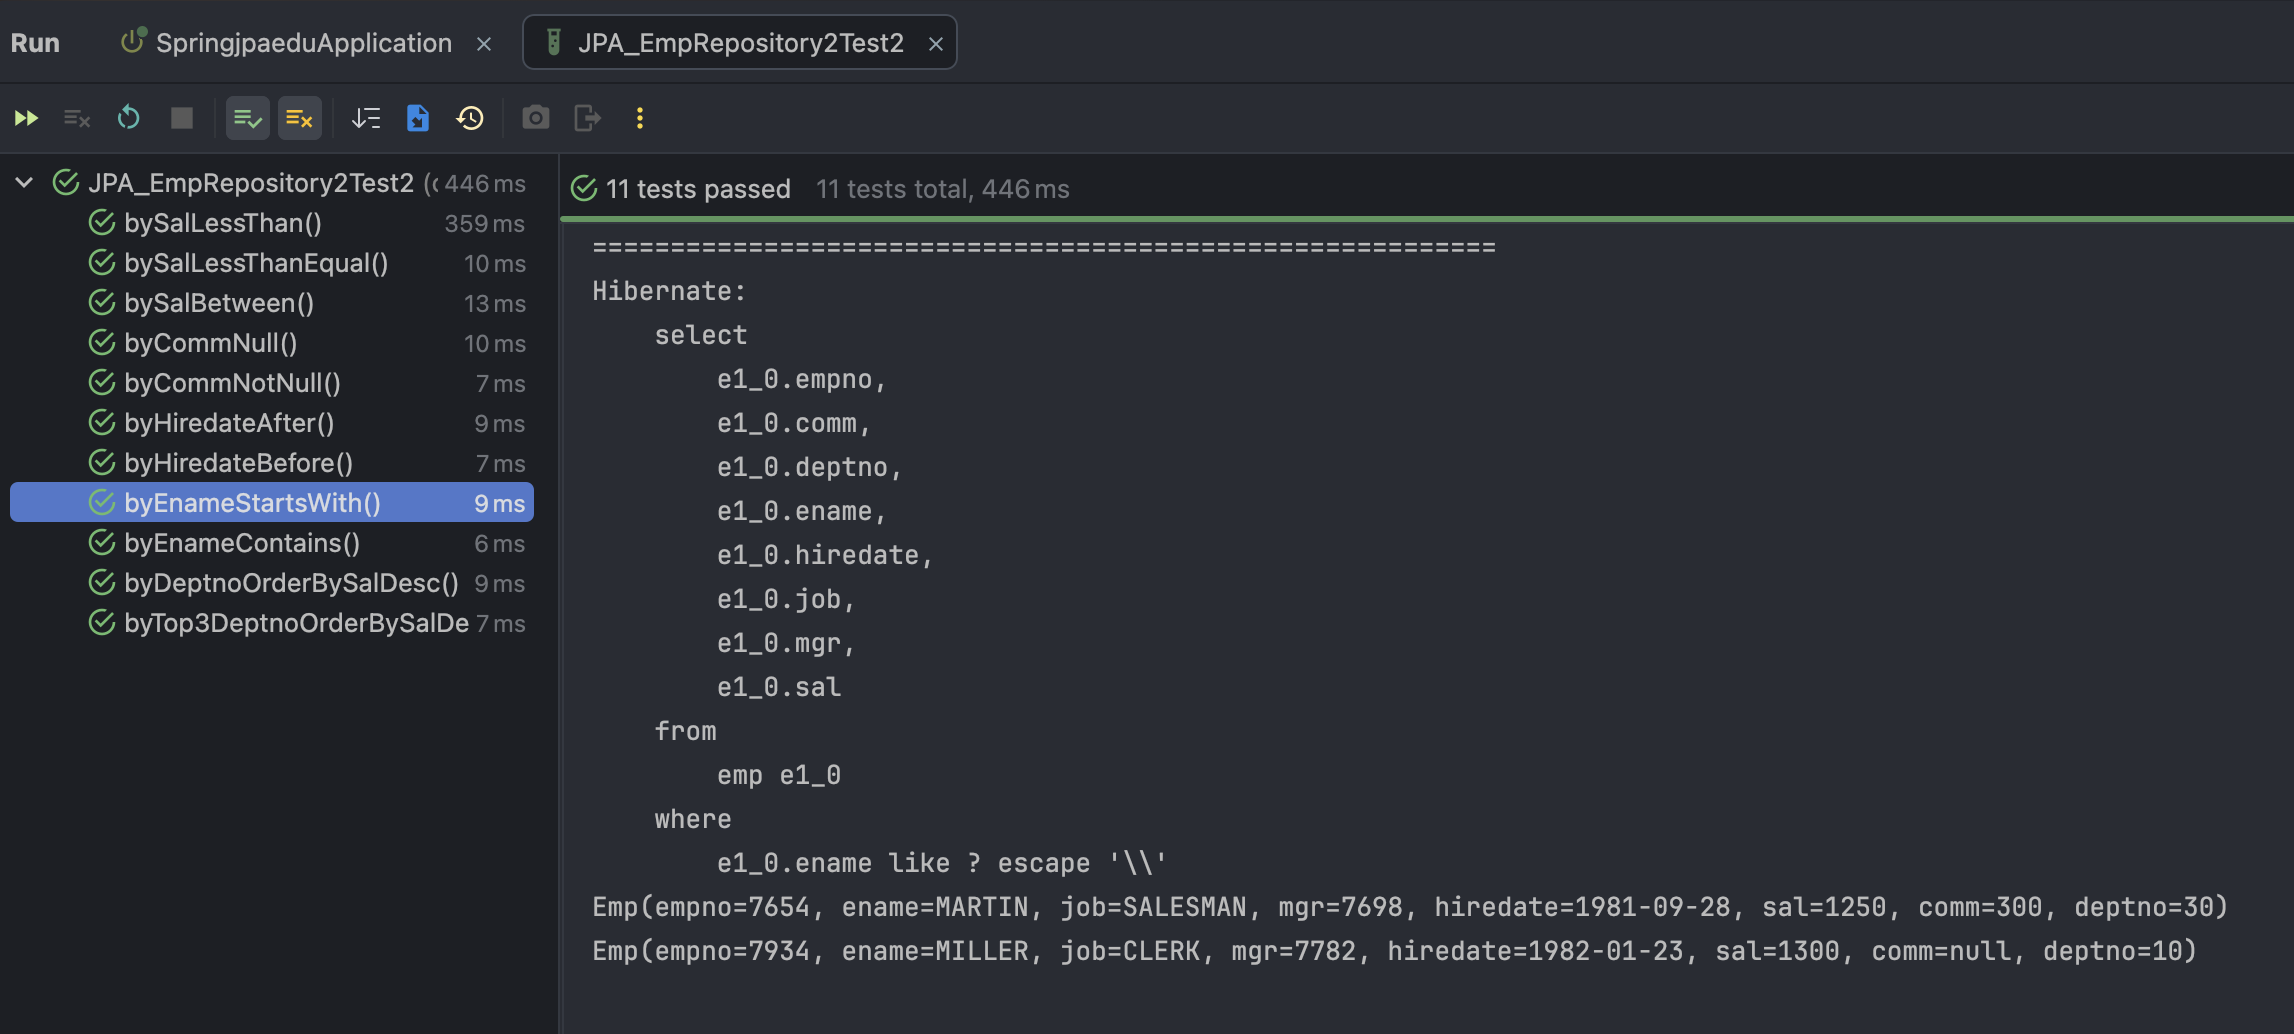
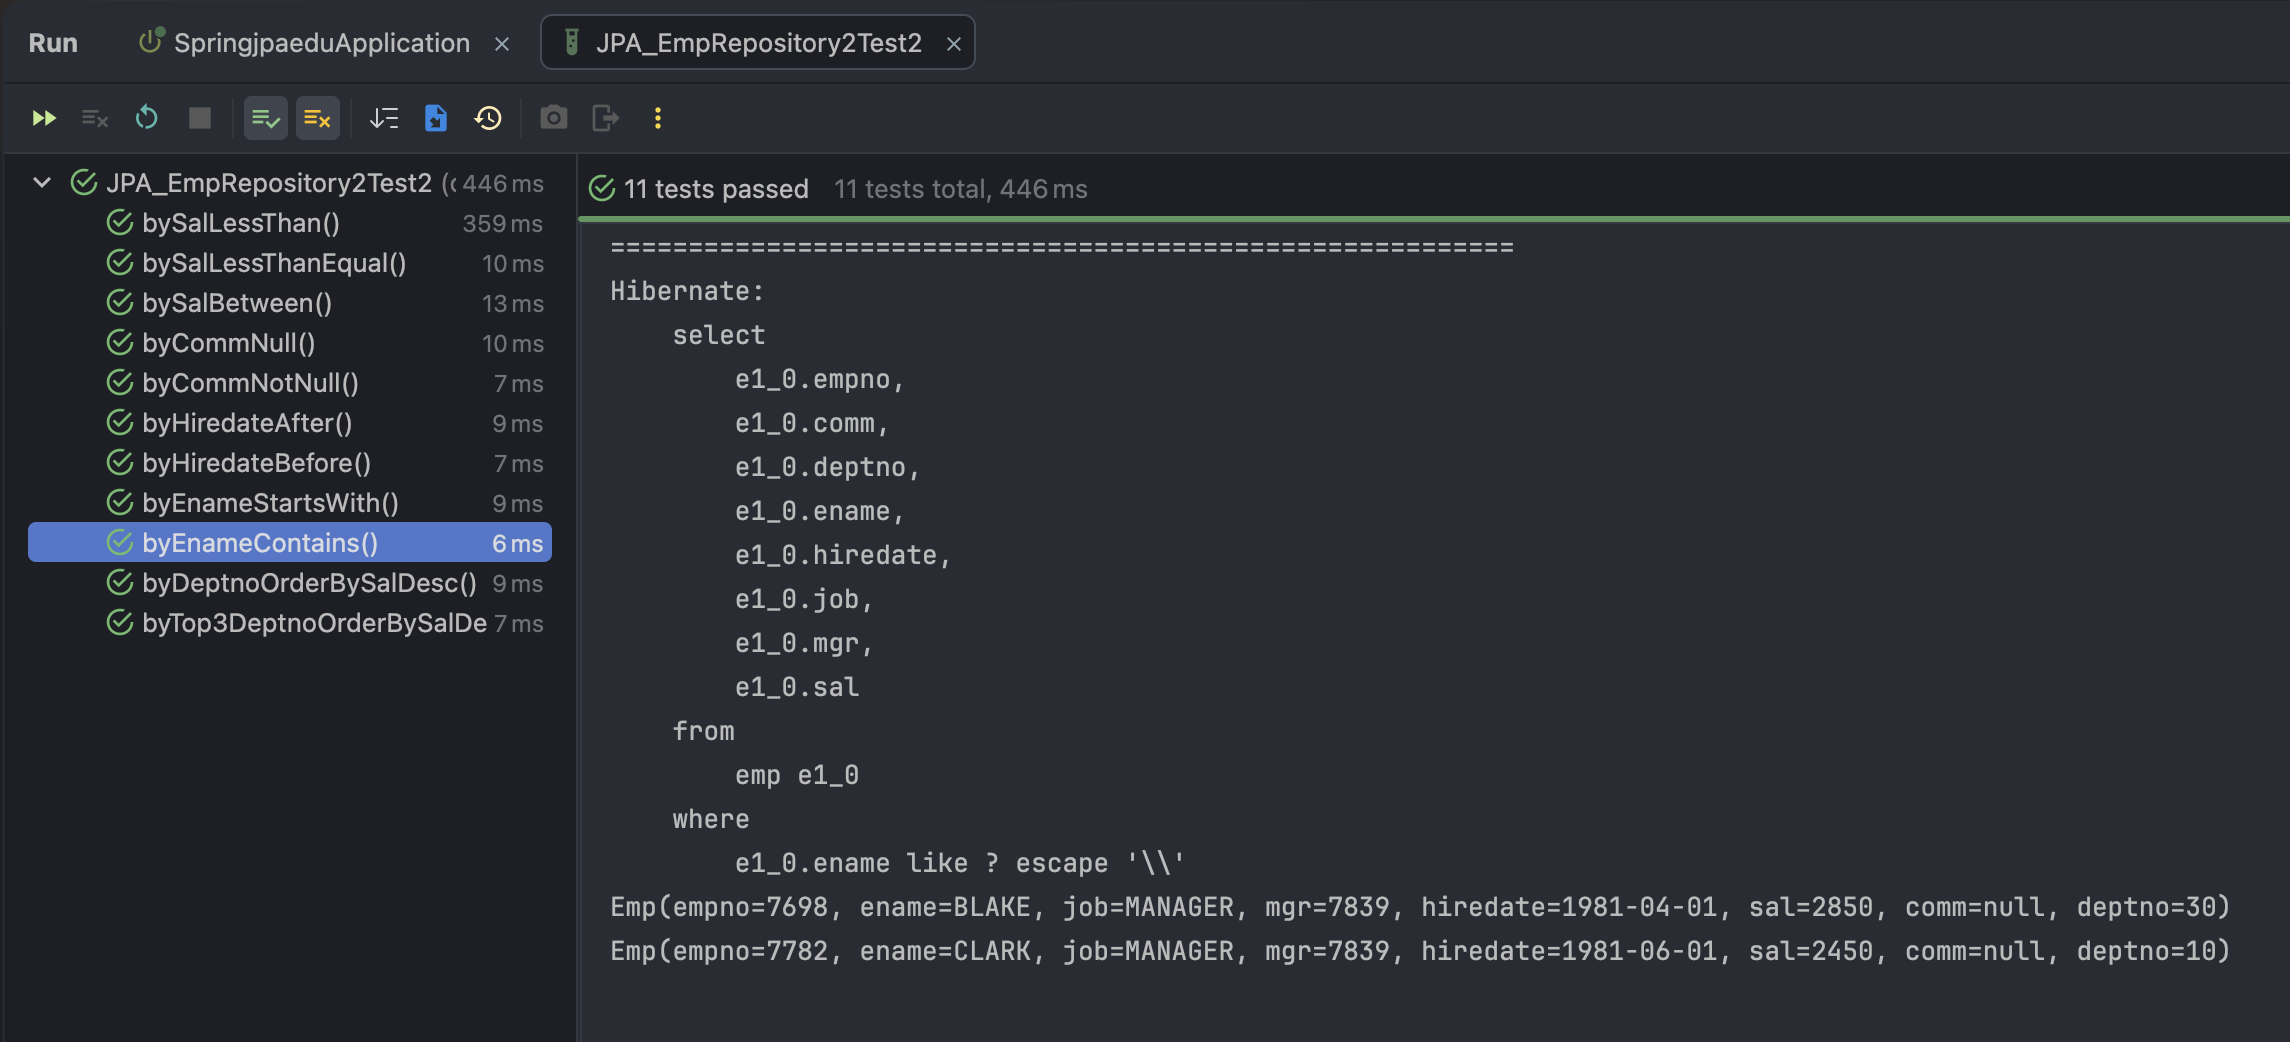
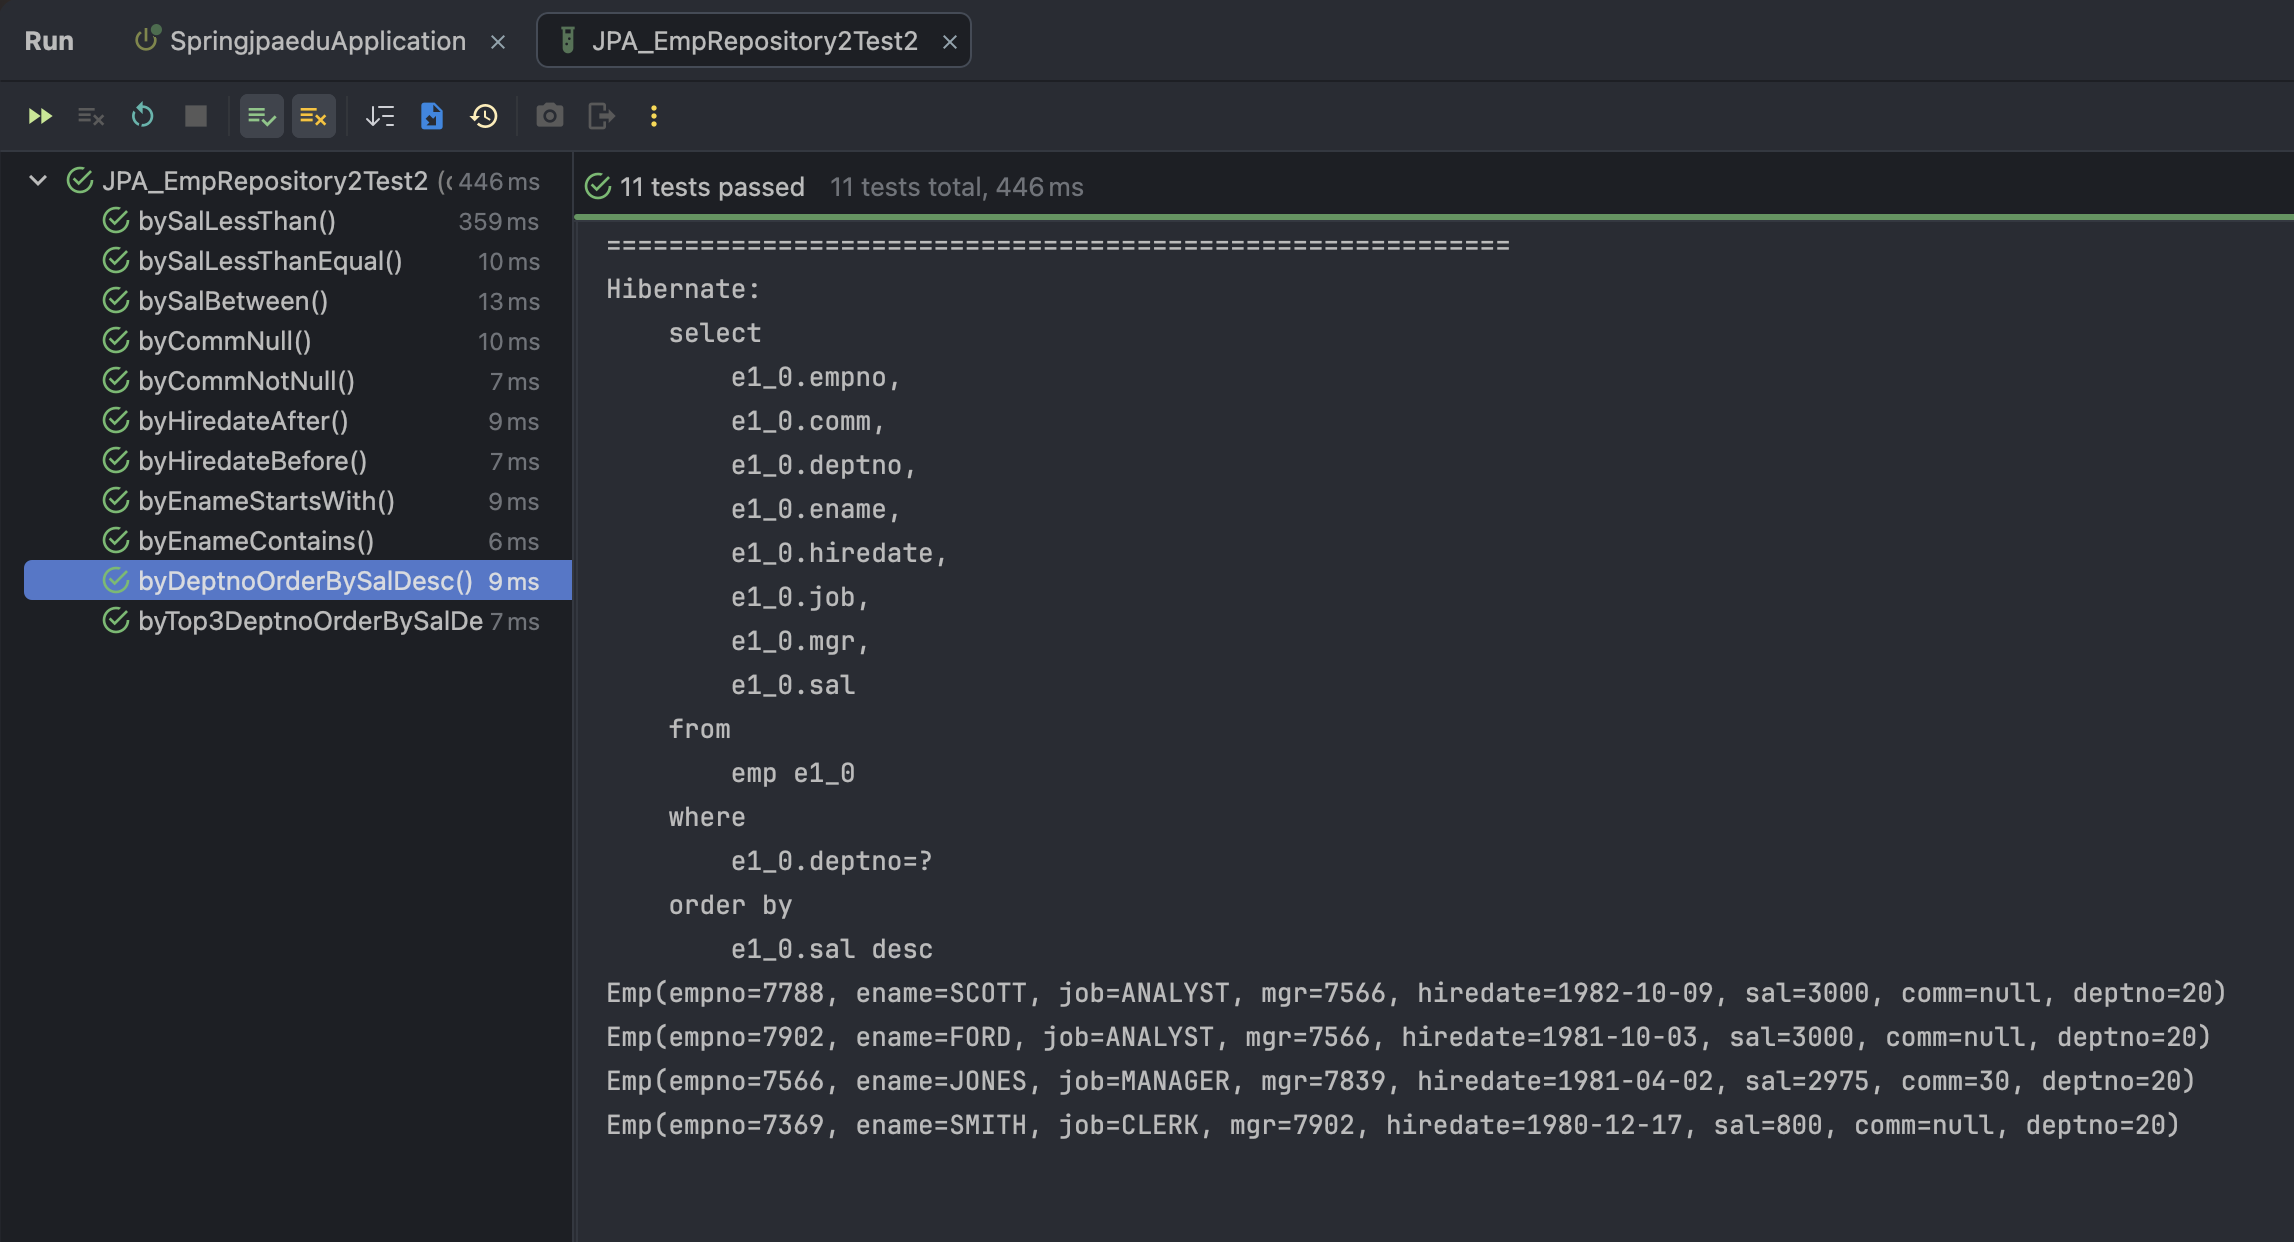
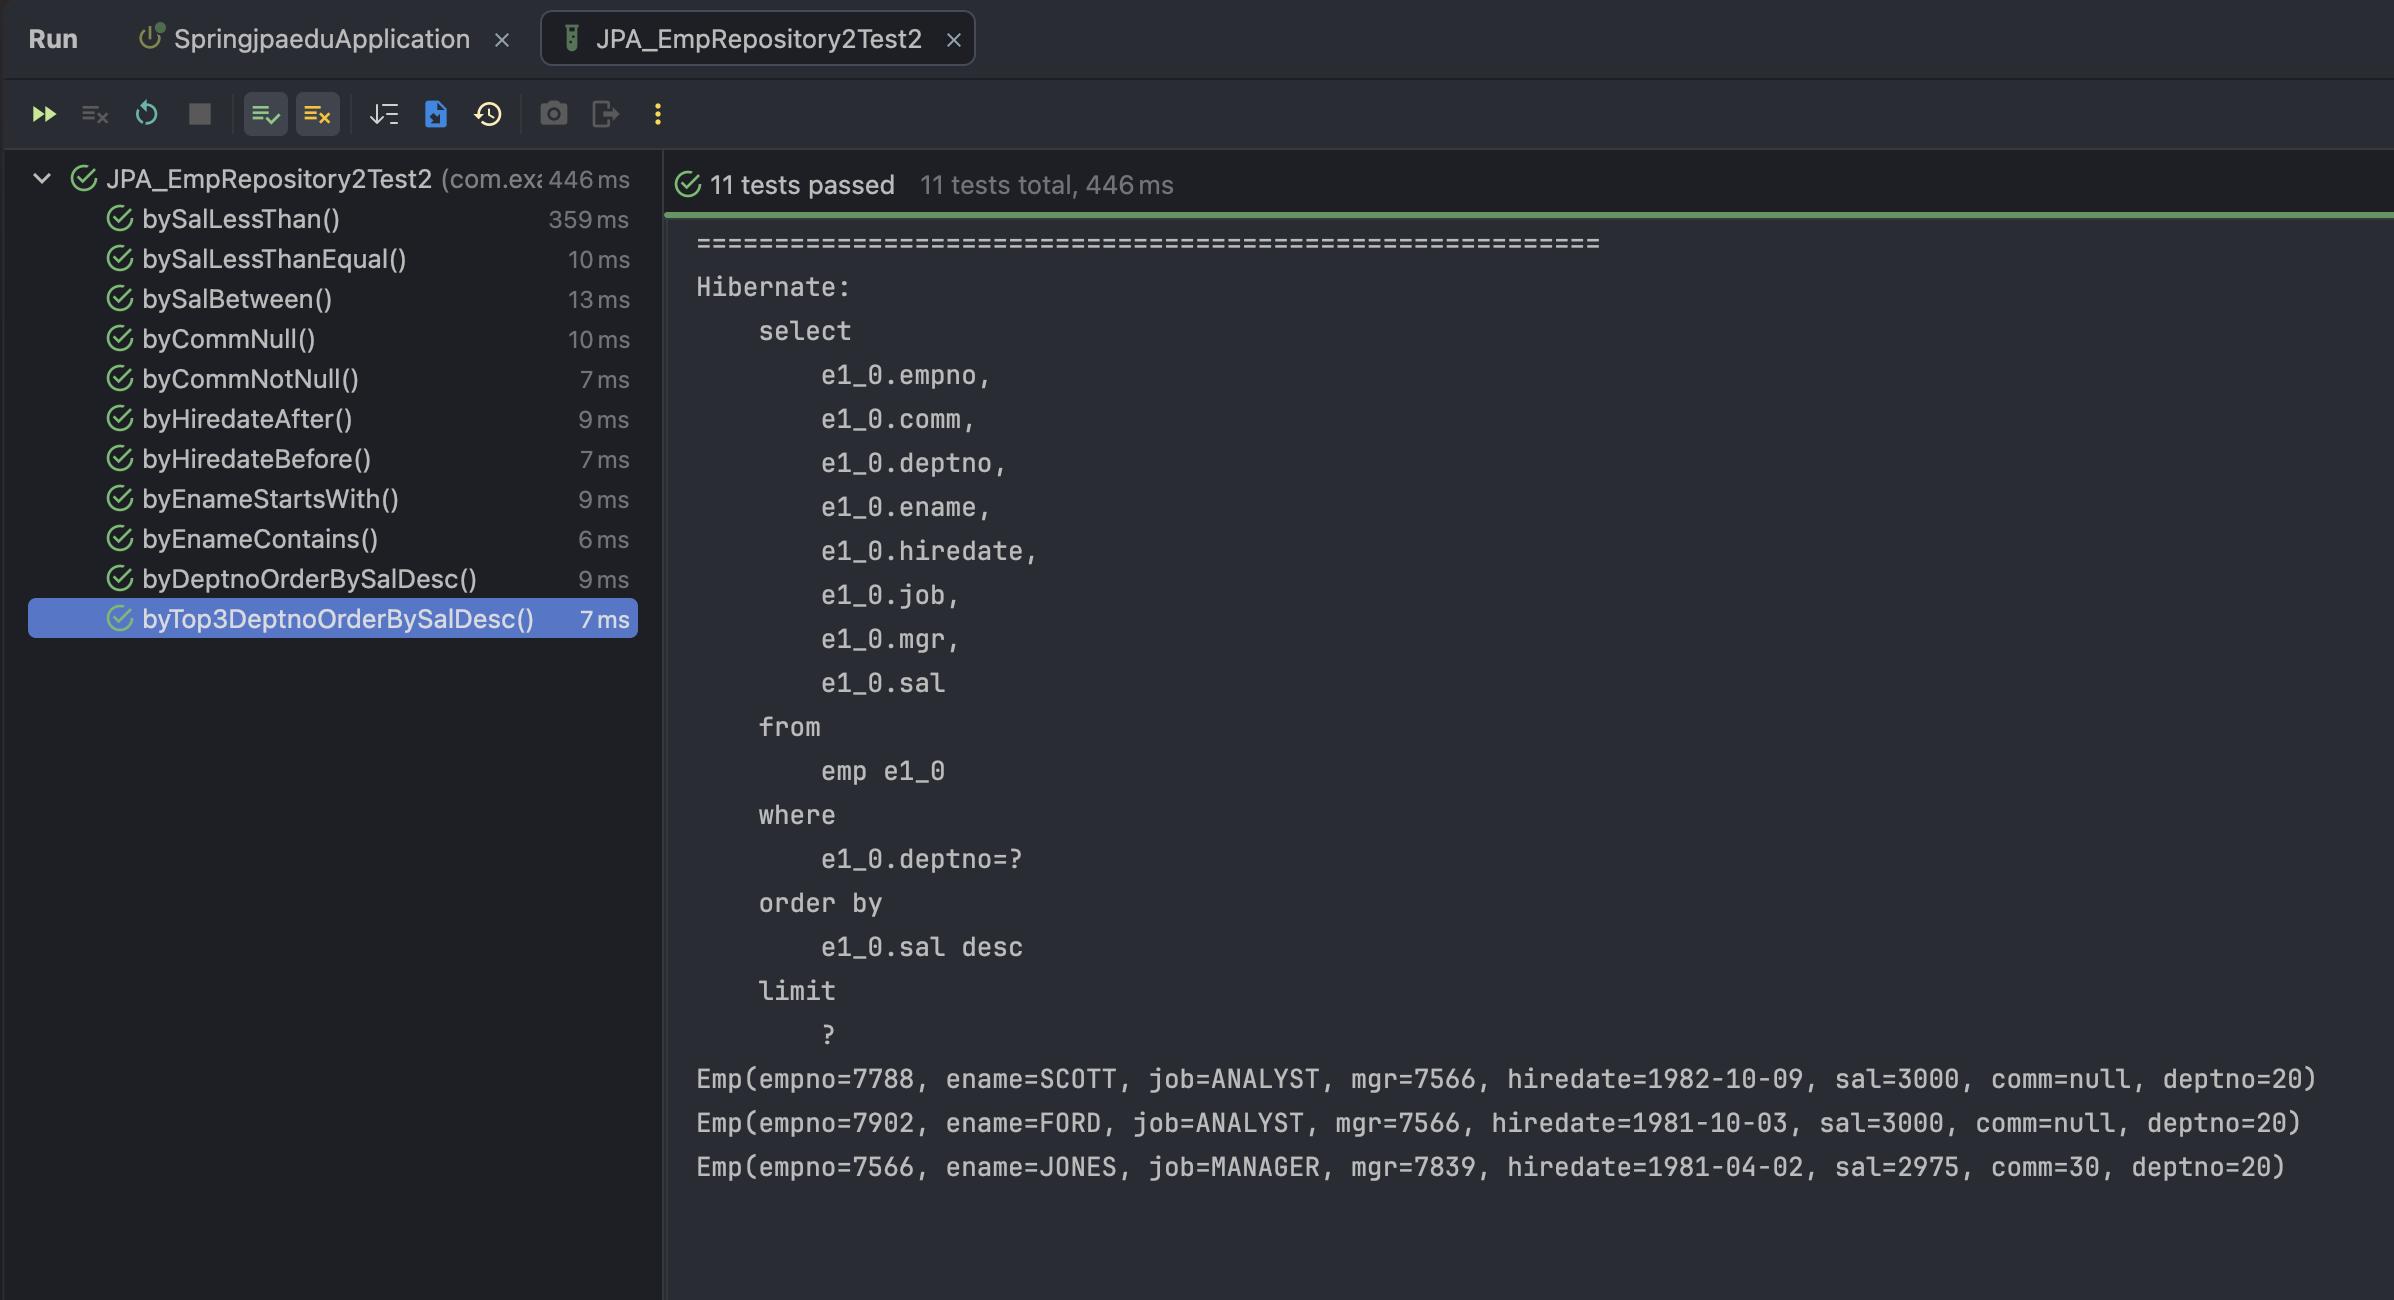
응용예제 4. Visitor 방명록 CRUD와 Ajax 수정 흐름 (Visitor.java, VisitorRepository.java, VisitorController.java, visitorMain.html, visitorForm.html, visitorView.html)
앞 개념에서
Repository는 데이터베이스 접근을 담당하고,Controller는 웹 요청을 받아 필요한 처리로 연결한다고 정리했다.
이번 예제에서는 이 흐름이 방명록 기능 전체에서 어떻게 사용되는지 확인한다.
앞의Emp예제는 주로 조회 기능을 확인했다.
이번Visitor예제는 조회뿐만 아니라 등록, 검색, 삭제, 수정까지 함께 다룬다.
즉, 데이터를 다루는 기본 기능인CRUD흐름을 한 번에 확인하는 예제이다.
CRUD는 데이터를 생성, 조회, 수정, 삭제하는 기본 기능을 뜻한다.
Create는 등록,Read는 조회,Update는 수정,Delete는 삭제이다.
이 예제의 핵심은Visitor엔티티를 기준으로Repository가 데이터를 처리하고,Controller가 요청별로 그 기능을 연결한다는 점이다.
앞 개념과 연결해서 보기
앞에서
Spring Data JPA는Repository인터페이스만 작성해도 기본 구현 객체를 자동으로 만들어 준다고 정리했다.
이번 예제에서도 같은 흐름이 반복된다.
VisitorRepository는 구현 클래스를 직접 만들지 않고JpaRepository<Visitor, Integer>를 상속한다.
Visitor는 방명록 글 한 개를 나타내는 엔티티이다.
Integer는Visitor엔티티의 기본키 타입이다.
즉,VisitorRepository extends JpaRepository<Visitor, Integer>는 “Visitor엔티티를Integer기본키로 다루는 저장소를 만들겠다”는 선언이다.// VisitorRepository.java package com.example.springjpaedu.repository; import com.example.springjpaedu.entity.Visitor; import org.springframework.data.jpa.repository.JpaRepository; import java.util.List; public interface VisitorRepository extends JpaRepository<Visitor, Integer>{ public List<Visitor> findByMemoContains(String keyword); // memo에 keyword가 포함된 글 조회 }
JpaRepository를 상속했기 때문에findAll(),findById(),save(),deleteById()같은 기본 메서드를 사용할 수 있다.
그리고findByMemoContains()는 직접 선언한 쿼리 메서드이다.
Contains는 특정 문자열이 포함되어 있는지 검사하는 조건이다.
따라서findByMemoContains(keyword)는 방명록 내용인memo안에keyword가 들어 있는 글을 조회한다.
이 예제에서 다시 확인할 개념
Visitor는 방명록 글 한 개를 표현하는 엔티티이다.VisitorRepository는Visitor엔티티를 다루는 저장소이다.JpaRepository가 기본CRUD메서드를 제공한다.findByMemoContains()는 방명록 내용 검색을 위한 쿼리 메서드이다.VisitorController는 요청 주소별로 저장소 메서드를 호출한다.이번 예제는
Repository기본 메서드와 쿼리 메서드가 실제 화면 기능과 연결되는 흐름을 보여 준다.
Visitor 엔티티 구조 확인하기
Visitor클래스는 방명록 글 한 개를 데이터베이스와 연결하기 위한 엔티티이다.
방명록 글에는 글 번호, 작성자 이름, 작성일, 글 내용이 필요하다.
이 정보가Visitor클래스의 필드로 표현된다.// Visitor.java package com.example.springjpaedu.entity; import jakarta.persistence.*; import lombok.Getter; import lombok.Setter; import lombok.ToString; import org.hibernate.annotations.CreationTimestamp; @Entity // 데이터베이스 테이블과 매핑될 클래스 @Setter // setter 메서드 자동 생성 @Getter // getter 메서드 자동 생성 @ToString // 객체 정보를 문자열로 출력 public class Visitor { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.IDENTITY) // DB가 기본키 자동 생성 private int id; // 글 번호 private String name; // 작성자 이름 @CreationTimestamp // 저장 시점의 날짜 자동 입력 @Column(name = "writedate") // 컬럼명 지정 private java.sql.Date writeDate; // 작성일 private String memo; // 방명록 내용 }
@Entity가 붙었기 때문에Visitor클래스는JPA가 관리하는 엔티티가 된다.
즉,Visitor객체는 데이터베이스 테이블의 한 행과 연결될 수 있다.
id는 방명록 글을 구분하는 기본키이다.
@Id가 붙어 있으므로JPA는 이 필드를 기본키로 인식한다.
@GeneratedValue(strategy = GenerationType.IDENTITY)는 기본키 값을 데이터베이스가 자동으로 생성한다는 뜻이다.
그래서 새 글을 등록할 때 사용자가id를 직접 입력하지 않아도 된다.
name은 작성자 이름이고,memo는 방명록 글 내용이다.
폼에서 입력한 이름과 내용은 이 필드에 담긴다.
writeDate는 작성일이다.
@CreationTimestamp가 붙어 있으므로 엔티티가 처음 저장될 때 생성 시점의 날짜가 자동으로 들어간다.
사용자가 작성일을 직접 입력하지 않아도 저장 시점의 날짜가 들어가는 흐름이다.
Visitor 필드 역할 정리
id는 방명록 글 번호이며 기본키이다.name은 작성자 이름이다.writeDate는 작성일이며 저장 시점에 자동으로 들어간다.memo는 방명록 글 내용이다.이 구조를 보면 방명록 글 한 개가 어떻게 객체로 표현되는지 알 수 있다.
방명록 한 줄은 데이터베이스에서는 한 행이고,Java코드에서는Visitor객체 하나이다.
메인 화면에서 요청 시작하기
visitorMain.html은 방명록 기능을 시작하는 메인 화면이다.
여기서는 목록 보기, 글 작성 화면 이동, 검색 요청을 시작할 수 있다.// visitorMain.html <!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title>Insert title here</title> <link rel="stylesheet" href="css/visitor.css"> </head> <body> <h1>방명록</h1> <hr> <a href="/vlist"><button>방명록 리스트 보기</button></a> <hr> <a href="/visitorForm.html"><button>방명록 작성</button></a> <hr> <form method="GET" action="/vsearch"> <input type="text" name="key"> <input type="submit" value="방명록 검색"> </form> </body> </html>
방명록 리스트 보기버튼을 누르면/vlist요청이 실행된다.
이 요청은 전체 방명록 목록을 조회하는 흐름으로 이어진다.
방명록 작성버튼을 누르면visitorForm.html로 이동한다.
이 화면에서 새 방명록 글을 입력할 수 있다.
검색 폼은GET방식으로/vsearch에 요청을 보낸다.
입력칸의name이key이므로, 사용자가 입력한 검색어는key라는 이름의 요청 파라미터로 전달된다.
예를 들어 검색어를호이호이라고 입력하면/vsearch?key=호이호이같은 흐름으로 요청이 만들어진다.
메인 화면 요청 정리
/vlist는 전체 방명록 목록을 조회한다.visitorForm.html은 새 글 작성 화면이다./vsearch는 검색어를 기준으로 방명록 내용을 검색한다.- 검색어는
key라는 이름으로Controller에 전달된다.메인 화면은 직접 데이터를 처리하지 않는다.
사용자가 어떤 기능을 실행할지 선택하게 하고, 선택한 기능에 맞는 요청 주소로 이동시키는 역할을 한다.
목록 조회 흐름 확인하기
/vlist요청은 전체 방명록 글을 조회하는 기능이다.
이 요청은VisitorController의list()메서드와 연결된다.// VisitorController.java @RequestMapping("/vlist") // 전체 목록 조회 요청 public ModelAndView list() { List<Visitor> list = null; // 조회 결과를 담을 변수 list = repository.findAll(); // 전체 방명록 조회 ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 if (list.size() != 0) { mav.addObject("list", list); // 조회 결과가 있으면 list 전달 } else { mav.addObject("msg", "추출된 결과가 없어요"); // 조회 결과가 없으면 msg 전달 } mav.setViewName("visitorView"); // visitorView.html 화면 사용 return mav; // 화면 응답 }
repository.findAll()은Visitor엔티티에 해당하는 전체 데이터를 조회한다.
이 메서드는JpaRepository가 기본으로 제공하는 메서드이다.
따라서VisitorRepository에 따로 선언하지 않아도 사용할 수 있다.
조회 결과는List<Visitor>로 받는다.
방명록 글은 여러 개일 수 있으므로 목록 형태로 받는 것이 자연스럽다.
조회 결과가 있으면mav.addObject("list", list)로 화면에 전달한다.
첫 번째list는 화면에서 사용할 이름이고, 두 번째list는 실제 조회된 방명록 목록이다.
조회 결과가 없으면msg를 전달한다.
화면에서는list가 있으면 목록을 보여 주고,msg가 있으면 안내 문구를 보여 줄 수 있다.
/vlist요청을 실행하면findAll()로 조회한 방명록 목록이 화면에 출력된다.
조회된 각 글에는 작성자 이름, 작성일, 내용이 표시되고, 오른쪽에는 삭제와 수정 기능으로 이어지는 아이콘이 함께 보인다.
목록 화면에서 데이터 출력하기
visitorView.html은 방명록 목록을 출력하는 화면이다.
Controller에서 전달한list를 반복해서 출력하고, 각 글 옆에 삭제 버튼과 수정 버튼을 함께 보여 준다.// visitorView.html <table th:if="${list}"> <tr th:each="vo : ${list}"> <td>[[${vo.name}]]</td> <td>[[${vo.writeDate}]]</td> <td>[[${vo.memo}]]</td> <td><a th:href="@{/vdelete(id=${vo.id})}"> <img src="/images/delete.png" width="38"> </a></td> <td><img src="/images/edit.png" width="38" th:onclick="|displayUpdateForm(${vo.id})|"></td> </tr> </table> <h3 th:if="${msg}" th:text="${msg}"></h3>
th:if="${list}"는list가 있을 때만 테이블을 출력한다.
즉, 조회 결과가 있을 때만 방명록 목록이 보인다.
th:each="vo : ${list}"는list안에 들어 있는Visitor객체를 하나씩 꺼내 반복한다.
반복 중인 객체는vo라는 이름으로 사용할 수 있다.
[[${vo.name}]],[[${vo.writeDate}]],[[${vo.memo}]]는 각각 작성자 이름, 작성일, 글 내용을 출력한다.
이 값들은Visitor엔티티의 필드와 연결된다.
삭제 아이콘은/vdelete?id=글번호형태의 요청으로 연결된다.
수정 아이콘은 화면 이동을 바로 하지 않고displayUpdateForm(id)함수를 실행한다.
이 함수는 뒤에서/one요청과JSON응답을 사용해 수정 폼을 채우는 데 사용된다.
목록 화면에서 봐야 할 부분
th:if는 조건에 따라 화면 출력 여부를 결정한다.th:each는 목록 데이터를 반복 출력한다.- 삭제 아이콘은
/vdelete요청으로 연결된다.- 수정 아이콘은
JavaScript함수를 실행해 기존 글 데이터를 가져온다.목록 화면은 단순히 데이터를 보여 주는 것에서 끝나지 않는다.
삭제와 수정 기능으로 이어지는 출발점 역할도 함께 한다.
검색 흐름 확인하기
/vsearch요청은 방명록 내용에서 검색어가 포함된 글을 찾는 기능이다.
메인 화면 검색 폼에서 입력한 값이key라는 이름으로 전달되고,Controller는 이 값을 받아 검색에 사용한다.// VisitorController.java @RequestMapping("/vsearch") // 검색 요청 public ModelAndView search(@RequestParam("key") String key) { List<Visitor> list = null; // 검색 결과를 담을 변수 list = repository.findByMemoContains(key); // memo에 key가 포함된 글 조회 ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 if (list.size() != 0) { System.out.println(list); // 검색 결과 콘솔 출력 mav.addObject("list", list); // 검색 결과가 있으면 list 전달 } else { mav.addObject("msg", "추출된 결과가 없어요"); // 결과가 없으면 msg 전달 } mav.setViewName("visitorView"); // visitorView.html 화면 사용 return mav; // 화면 응답 }
@RequestParam("key")는 요청 파라미터 중key값을 받는다.
검색 폼의 입력칸 이름이key이기 때문에 이 값이Controller의key매개변수로 들어온다.
repository.findByMemoContains(key)는memo필드에 검색어가 포함된 글을 조회한다.
이 메서드는VisitorRepository에 직접 선언한 쿼리 메서드이다.
Contains는 특정 문자열을 포함하는지 검사한다.
따라서 검색어가 방명록 내용 중간에 들어 있어도 조회 대상이 될 수 있다.
검색 흐름 정리
- 사용자가 검색어를 입력한다.
- 검색어는
key라는 이름으로/vsearch에 전달된다.Controller는@RequestParam("key")로 검색어를 받는다.Repository는findByMemoContains(key)로 내용 포함 검색을 수행한다.- 검색 결과는 다시
visitorView.html화면으로 전달된다.
/vsearch?key=호이호이요청을 실행하면 방명록 내용인memo에호이호이가 포함된 글만 조회된다.
검색 결과도 전체 목록과 같은visitorView.html에서 출력되지만, 화면에는 조건에 맞는 글만 남는다.
등록 화면과 등록 요청 흐름
새 글을 등록할 때는 먼저
visitorForm.html화면에서 이름과 내용을 입력한다.
이 화면의 폼은POST방식으로/vinsert에 요청을 보낸다.// visitorForm.html <form method="post" action="/vinsert"> <input type="text" name="name" placeholder="이름을 입력하세요" required><br> <textarea cols="35" rows="10" name="memo" placeholder="내용을 입력하세요" required></textarea><br> <input type="submit" value="등록"> <input type="reset" value="재작성"> <input type="button" value="취소" onclick="location.href = 'visitorMain.html'"> </form>
name="name"인 입력값은Visitor객체의name필드로 들어간다.
name="memo"인 입력값은Visitor객체의memo필드로 들어간다.
required는 필수 입력을 의미한다.
이름이나 내용을 비워 두면 폼이 제출되지 않는다.
등록 버튼을 누르면/vinsert요청이 실행된다.
method="post"이므로POST방식으로 전달된다.
POST방식은 데이터를 새로 등록하거나 변경할 때 자주 사용한다.
방명록 작성 화면에서는 작성자 이름과 내용을 입력한다.
이 화면에서 등록 버튼을 누르면 입력값이POST방식으로/vinsert요청에 전달된다.// VisitorController.java @RequestMapping(value = "/vinsert", method = RequestMethod.POST) // 글 등록 요청 @Transactional // 저장 작업을 트랜잭션으로 처리 public String insert(Visitor vo, Model model) { try { repository.save(vo); // 방명록 글 저장 return "redirect:/vlist"; // 저장 후 목록 요청으로 다시 이동 } catch(Exception e) { model.addAttribute("msg", "글 작성에 실패했습니다."); // 실패 메시지 전달 } return "visitorView"; // 실패 시 visitorView 화면 사용 }
insert(Visitor vo, Model model)에서Visitor vo는 폼 데이터를 받는 객체이다.
폼의name,memo입력값이Visitor객체의 같은 이름 필드에 자동으로 담긴다.
이런 방식을 객체 바인딩이라고 이해하면 된다.
repository.save(vo)는 새 방명록 글을 저장한다.
id는 직접 입력하지 않아도 된다.
Visitor엔티티의id에@GeneratedValue(strategy = GenerationType.IDENTITY)가 있기 때문에 데이터베이스가 자동으로 생성한다.
writeDate도 폼에서 입력하지 않는다.
@CreationTimestamp가 붙어 있으므로 저장 시점에 자동으로 들어간다.
저장에 성공하면redirect:/vlist를 반환한다.
redirect는 다른 요청 주소로 다시 이동시키는 방식이다.
여기서는 저장 후 전체 목록을 다시 조회해서 최신 방명록 목록을 보여 주기 위해/vlist로 이동한다.
등록 흐름 정리
- 사용자가
visitorForm.html에서 이름과 내용을 입력한다.- 폼은
POST방식으로/vinsert에 데이터를 보낸다.Controller는 폼 데이터를Visitor객체로 받는다.save()가 새 방명록 글을 저장한다.- 저장 후
redirect:/vlist로 이동해 최신 목록을 다시 보여 준다.
등록 버튼을 누르면 입력한 이름과 내용이
Visitor객체에 담긴 뒤save()로 저장된다.
등록 후에는/vlist로 다시 이동하고, 방금 입력한 글이 목록에 새로 추가된 것을 확인할 수 있다.
삭제 요청 흐름
삭제 기능은 목록 화면의 삭제 아이콘에서 시작된다.
삭제 아이콘은 글 번호인id를/vdelete요청에 함께 전달한다.// visitorView.html <a th:href="@{/vdelete(id=${vo.id})}"> <img src="/images/delete.png" width="38"> </a>
th:href="@{/vdelete(id=${vo.id})}"는 삭제 요청 주소를 만든다.
예를 들어 글 번호가3이면/vdelete?id=3같은 주소가 만들어진다.
id는 삭제할 글을 찾기 위한 기본키이다.
삭제는 특정 글 하나를 대상으로 해야 하므로, 어떤 글을 삭제할지 알려 주는id가 반드시 필요하다.// VisitorController.java @RequestMapping(value = "/vdelete") // 글 삭제 요청 @Transactional // 삭제 작업을 트랜잭션으로 처리 public ModelAndView delete(@RequestParam("id") int id) { ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 try { repository.deleteById(id); // id 기준으로 글 삭제 mav.addObject("list", repository.findAll()); // 삭제 후 최신 목록 조회 } catch(Exception e) { mav.addObject("msg", "글 삭제에 실패했습니다."); // 실패 메시지 전달 } mav.setViewName("visitorView"); // visitorView.html 화면 사용 return mav; // 화면 응답 }
@RequestParam("id")는 요청 주소에 들어온id값을 받는다.
삭제 아이콘에서 만든/vdelete?id=글번호의 값이 이 매개변수로 들어온다.
repository.deleteById(id)는 기본키 값을 기준으로 데이터를 삭제한다.
이 메서드는JpaRepository가 제공하는 기본 삭제 메서드이다.
삭제 후에는repository.findAll()을 다시 호출한다.
삭제된 상태를 반영한 최신 목록을 화면에 보여 주기 위해서이다.
삭제 흐름 정리
- 목록 화면에서 삭제 아이콘을 누른다.
/vdelete?id=글번호요청이 만들어진다.Controller는id값을 받는다.deleteById(id)가 해당 글을 삭제한다.- 삭제 후
findAll()로 최신 목록을 다시 조회한다.
삭제 아이콘을 누르면 글 번호가
/vdelete요청으로 전달된다.
삭제 후에는 같은 목록 화면이 다시 출력되지만, 삭제한 글은 목록에서 사라진다.
수정 전 단건 조회와 JSON 응답
수정 기능은 삭제보다 한 단계 더 복잡하다.
수정하려면 먼저 기존 글의 이름과 내용을 수정 폼에 채워야 한다.
그래서 수정 아이콘을 눌렀을 때/one?id=글번호요청으로 글 한 개를 조회한다.
여기서는 화면 전체를 이동하지 않는다.
JavaScript가XMLHttpRequest로 서버에 요청을 보내고, 서버는 글 하나를JSON데이터로 응답한다.
JSON은 객체 데이터를 화면에서 사용하기 쉬운 문자열 형태로 표현한 데이터 형식이다.// VisitorController.java @RequestMapping(value = "/one", produces = "application/json; charset=utf-8") // 글 하나 조회 @ResponseBody // 반환값을 응답 본문으로 전달 public Visitor one(@RequestParam("id") int id) { Optional<Visitor> result = repository.findById(id); // id 기준으로 글 하나 조회 return result.get(); // 조회된 Visitor 객체 반환 }
repository.findById(id)는 기본키 값으로 글 하나를 조회한다.
반환 타입은Optional<Visitor>이다.
Optional은 조회 결과가 있을 수도 있고 없을 수도 있는 상황을 감싸는 객체이다.
result.get()은Optional안에 들어 있는Visitor객체를 꺼낸다.
이 예제에서는 해당id의 글이 있다고 보고 꺼내는 흐름이다.
@ResponseBody가 중요하다.
일반적인Controller메서드가 객체나 문자열을 반환하면 화면 이름으로 해석될 수 있다.
하지만@ResponseBody가 붙으면 반환값을 화면 이름으로 보지 않고 응답 본문 데이터로 보낸다.
produces = "application/json; charset=utf-8"는 응답 데이터가JSON형식이며 문자 인코딩은UTF-8이라는 뜻이다.
따라서 화면의JavaScript는 이 응답을 받아 객체처럼 사용할 수 있다.
/one?id=1요청은 화면 이름을 반환하지 않고 글 하나의 데이터를JSON형태로 응답한다.
응답 안에는id,memo,name,writeDate값이 들어 있으며, 이 데이터는 수정 폼을 채우는 데 사용된다.
단건 조회 흐름 정리
- 수정 아이콘을 누르면 글 번호가 전달된다.
/one?id=글번호요청이 실행된다.findById(id)로 글 하나를 조회한다.@ResponseBody가Visitor객체를 응답 데이터로 보낸다.- 화면은
JSON응답을 받아 수정 폼에 기존 값을 채운다.
/one은 화면을 보여 주는 요청이 아니라, 수정 폼에 필요한 기존 글 데이터를 가져오는 요청이다.
Ajax로 수정 폼 채우기
visitorView.html의 수정 아이콘은displayUpdateForm(id)함수를 실행한다.
이 함수는XMLHttpRequest를 사용해/one?id=글번호요청을 보내고, 응답으로 받은 데이터를 수정 폼에 넣는다.// visitorView.html <img src="/images/edit.png" width="38" th:onclick="|displayUpdateForm(${vo.id})|">수정 아이콘을 누르면 현재 글의
id가displayUpdateForm()함수에 전달된다.
이id를 사용해 서버에서 해당 글 하나를 가져온다.// visitorView.html let jsonobj = null; // 기존 글 데이터를 담을 변수 let namedom = null; // 이름 입력칸을 담을 변수 let memodom = null; // 내용 입력칸을 담을 변수 function displayUpdateForm(id) { let xhr = new XMLHttpRequest(); // 비동기 요청 객체 생성 xhr.onload = function() { // 응답이 도착했을 때 실행 if (xhr.status == 200) { // 정상 응답 확인 document.getElementById('updateform').style.display='block'; // 수정 폼 표시 let iddom = document.querySelector("#updateform input[name=id]"); // hidden id 입력칸 namedom = document.querySelector("#updateform input[name=name]"); // 이름 입력칸 memodom = document.querySelector("#updateform textarea"); // 내용 입력칸 jsonobj = JSON.parse(xhr.responseText); // JSON 문자열을 객체로 변환 iddom.value = jsonobj.id; // 기존 글 번호 채우기 namedom.value = jsonobj.name; // 기존 이름 채우기 memodom.value = jsonobj.memo; // 기존 내용 채우기 } }; xhr.open('GET', '/one?id='+id, true); // 글 하나 조회 요청 xhr.send(); // 요청 전송 }
XMLHttpRequest는 화면 전체를 새로 이동하지 않고 서버에 요청을 보낼 수 있게 해 주는 객체이다.
이런 방식의 비동기 요청을 보통Ajax라고 부른다.
비동기 요청은 요청을 보내는 동안 화면 전체가 멈추거나 새로고침되지 않는 방식이다.
xhr.open('GET', '/one?id='+id, true)는/one요청을 준비한다.
id값을 주소 뒤에 붙여서 어떤 글을 조회할지 서버에 전달한다.
서버가Visitor객체를JSON으로 응답하면xhr.responseText에 응답 문자열이 들어온다.
JSON.parse(xhr.responseText)는 이 문자열을JavaScript객체로 바꾼다.
그 다음jsonobj.id,jsonobj.name,jsonobj.memo값을 수정 폼에 넣는다.
이렇게 해서 사용자는 기존 글 내용을 보고 수정할 수 있다.
Ajax 수정 폼 흐름
- 수정 아이콘을 누른다.
displayUpdateForm(id)가 실행된다./one?id=글번호요청을 보낸다.- 서버는 글 하나를
JSON으로 응답한다.JavaScript는JSON을 객체로 바꾼다.- 수정 폼에 기존
id,name,memo값을 채운다.이 단계는 수정 요청을 보내기 전 준비 과정이다.
수정 폼에 기존 값이 자동으로 채워지는 이유는/one요청으로 받은JSON데이터를JavaScript가 입력칸에 넣기 때문이다.
수정 요청 흐름
수정 폼에 기존 값이 채워지면 사용자는 이름이나 내용을 바꾼 뒤 수정 버튼을 누를 수 있다.
수정 폼은POST방식으로/vupdate요청을 보낸다.// visitorView.html <form method="post" action="/vupdate"> <input type="hidden" name="id" value=""> <input type="text" name="name" value="" required><br> <textarea cols="35" rows="10" name="memo" required></textarea> <br> <input type="submit" value="수정"> <input type="reset" value="재작성" onclick="resetForm();return false;"> <input type="button" value="취소" onclick="document.getElementById('updateform').style.display='none'"> </form>
hidden타입의id입력칸은 화면에는 보이지 않지만 서버로 함께 전달된다.
수정할 때는 어떤 글을 수정할지 알아야 하므로id가 필요하다.
name과memo는 사용자가 수정한 값이다.
이 값들은/vupdate요청에서Visitor vo객체에 담긴다.// VisitorController.java @RequestMapping(value = "/vupdate", method = RequestMethod.POST) // 글 수정 요청 @Transactional // 수정 작업을 트랜잭션으로 처리 public String update(Visitor vo, Model model) { try { Visitor entity = repository.findById(vo.getId()).get(); // 기존 글 조회 entity.setName(vo.getName()); // 이름 수정 entity.setMemo(vo.getMemo()); // 내용 수정 return "redirect:/vlist"; // 수정 후 목록으로 이동 } catch(Exception e) { model.addAttribute("msg", "글 수정에 실패했습니다."); // 실패 메시지 전달 } return "visitorView"; // 실패 시 visitorView 화면 사용 }
Visitor vo에는 폼에서 전달된id,name,memo값이 담긴다.
하지만 이 객체를 바로 저장하는 방식이 아니라, 먼저 기존 엔티티를 조회한다.
repository.findById(vo.getId()).get()은 수정할 기존 글을 데이터베이스에서 조회한다.
그 다음 조회된 엔티티의name과memo값을 바꾼다.
이 메서드에는@Transactional이 붙어 있다.
@Transactional안에서findById()로 조회한entity는JPA가 관리하는 상태가 된다.
이 상태에서entity.setName(vo.getName()),entity.setMemo(vo.getMemo())처럼 값을 바꾸면JPA가 변경된 내용을 감지한다.
그래서 별도로save()를 다시 호출하지 않아도 수정 내용이 데이터베이스에 반영될 수 있다.
이 흐름을 변경 감지라고 이해하면 된다.
수정에 성공하면redirect:/vlist로 이동한다.
그래서 수정 후 최신 목록을 다시 조회해서 화면에 보여 준다.
수정 흐름 정리
- 수정 아이콘을 누르면
/one요청으로 기존 글 데이터를 가져온다.Ajax응답으로 받은 값이 수정 폼에 자동으로 채워진다.- 사용자가 이름이나 내용을 수정한다.
- 수정 폼에서
id,name,memo가/vupdate로 전달된다.id로 기존 글을 다시 조회한다.- 조회된 엔티티의
name,memo값을 변경한다.JPA가 변경 감지를 통해 수정 내용을 반영한다.- 수정 후
/vlist로 이동해 최신 목록을 보여 준다.
수정 기능은 수정 아이콘 클릭,
/one을 통한 기존 데이터 조회, 수정 폼 자동 입력,/vupdate요청, 목록 반영까지 이어진다.
수정 후에는/vlist로 다시 이동하고, 수정한 이름이나 내용이 목록에 반영된 것을 확인할 수 있다.
이 예제에서 확인해야 하는 핵심
응용예제 4는
Visitor방명록 기능을 통해Spring Data JPA의 기본CRUD흐름을 확인하는 예제이다.
앞의 예제들이 주로 조회 조건을 확인했다면, 이번 예제는 실제 화면 기능과 데이터 변경 흐름까지 함께 확인한다.
요청별 역할 정리
/vlist는 전체 방명록 목록을 조회한다./vsearch는memo에 검색어가 포함된 글을 조회한다./vinsert는 새 방명록 글을 저장한다./vdelete는 글 번호를 기준으로 방명록 글을 삭제한다./one은 수정 폼에 채울 글 하나를JSON으로 반환한다./vupdate는 기존 방명록 글의 이름과 내용을 수정한다.Repository 메서드 연결 정리
findAll()은 전체 목록 조회에 사용된다.findByMemoContains()는 내용 검색에 사용된다.save()는 새 글 저장에 사용된다.deleteById()는 글 삭제에 사용된다.findById()는 글 하나 조회와 수정 대상 조회에 사용된다.정리하면,
Visitor예제는 방명록 화면에서 발생하는 요청을Controller가 받고,Repository가 실제 데이터 작업을 처리하는 구조이다.
핵심은Spring Data JPA의 기본 메서드와 쿼리 메서드가 실제 웹 화면의 등록, 조회, 검색, 삭제, 수정 기능으로 연결된다는 점이다.
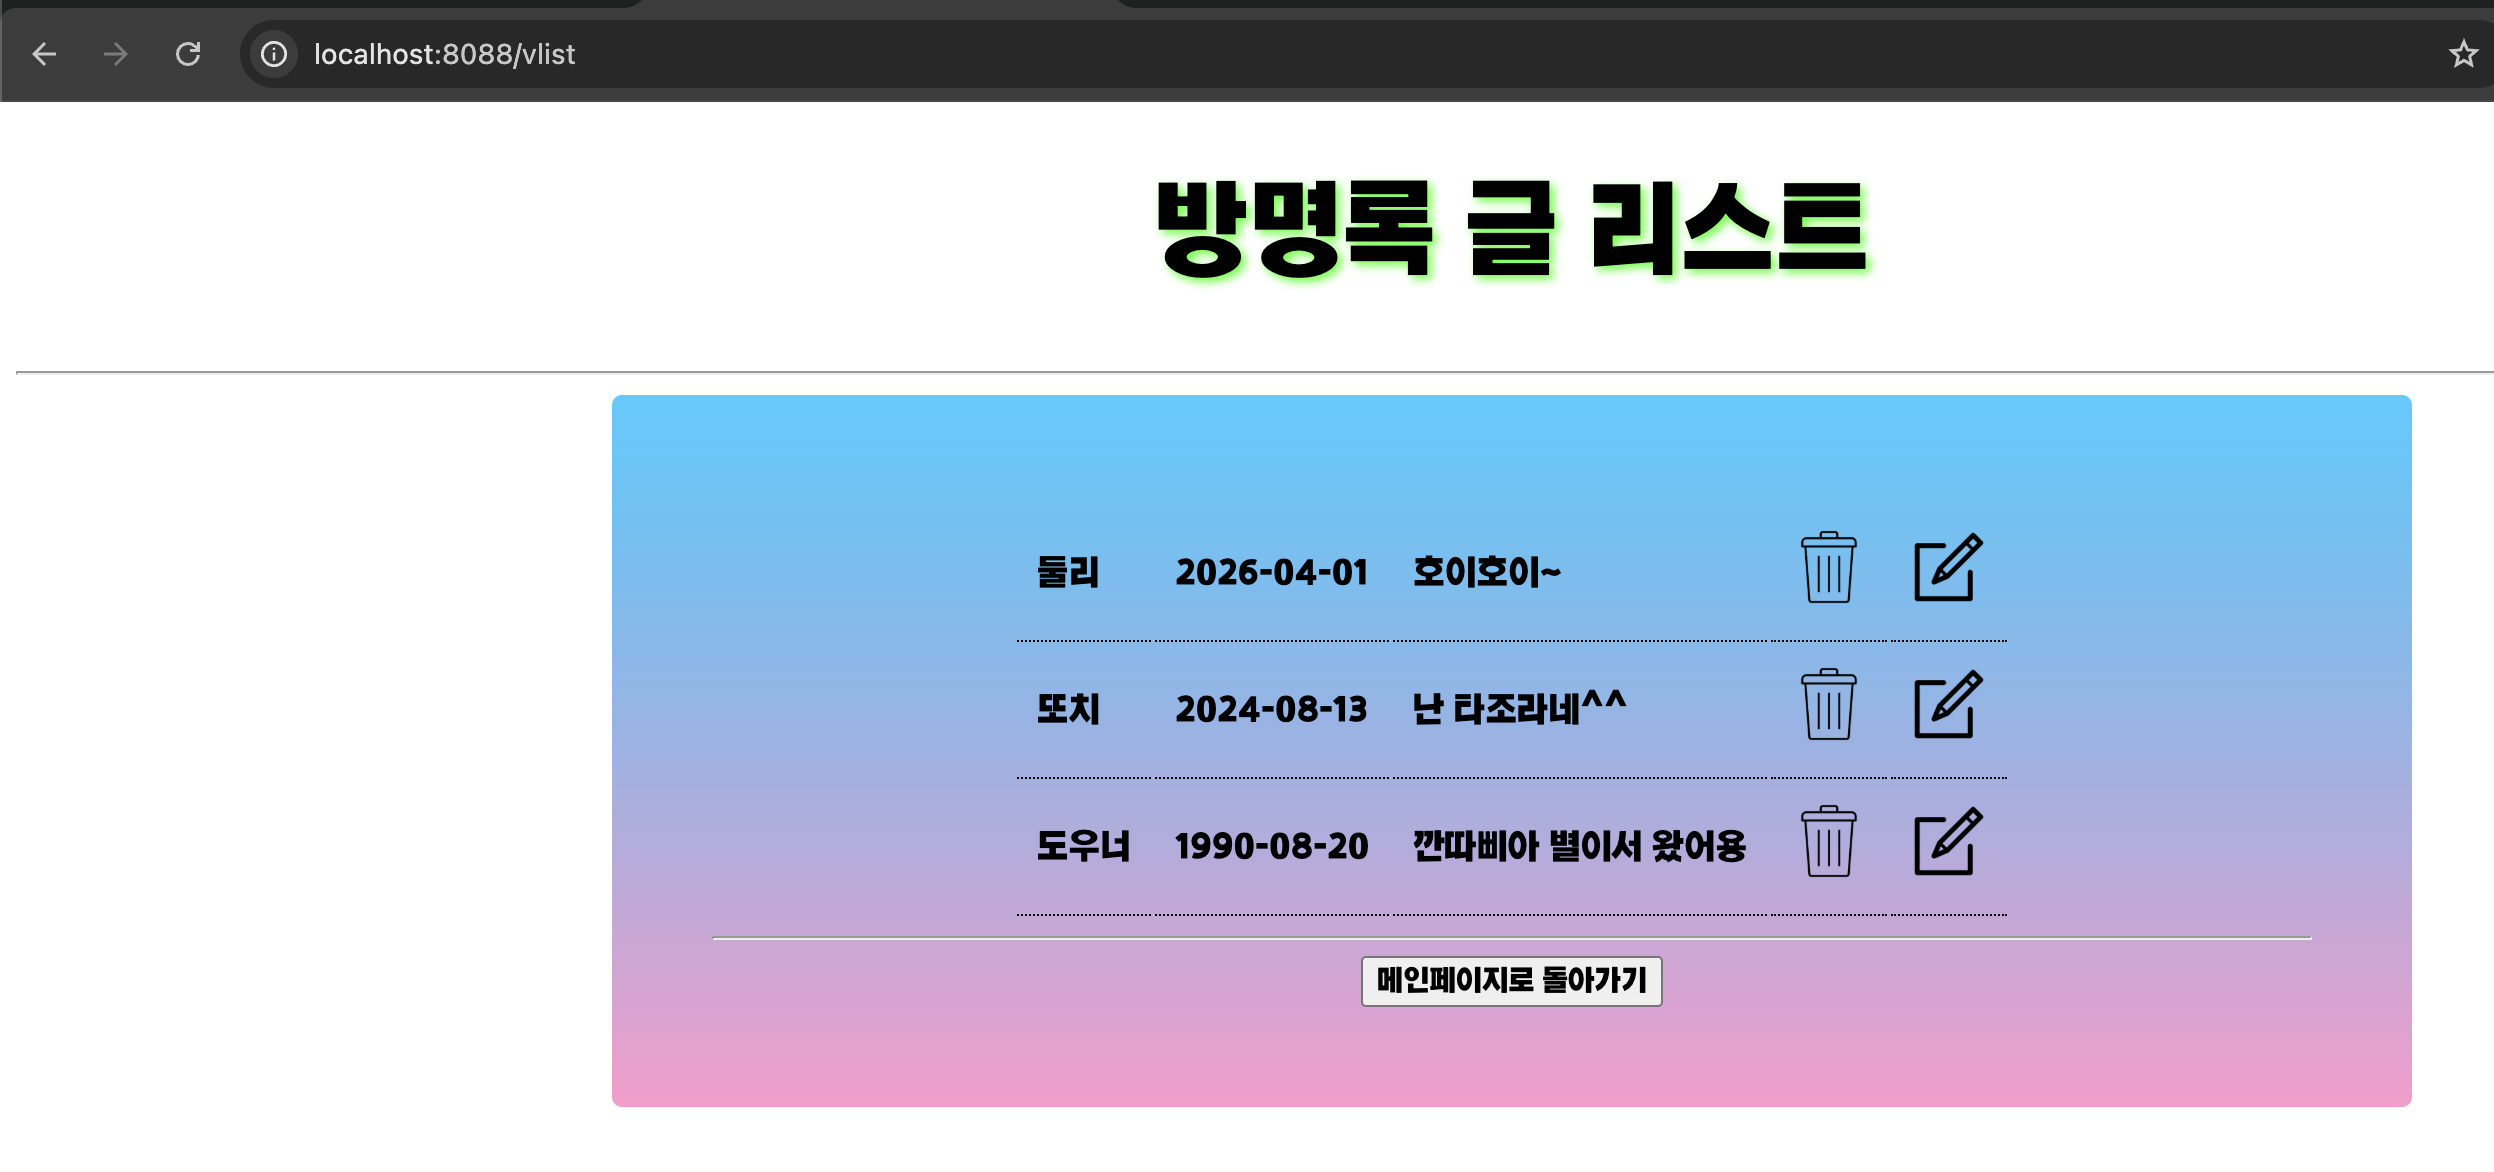
응용예제 5. Member, Team, Locker 연관관계와 Fetch Join 조회 (Member.java, Team.java, Locker.java, MemberTeamLockerRepository.java, JPA_MemberTeamLockerTest1.java)
앞 개념에서
JPA연관관계는 객체 참조와 데이터베이스 외래키를 연결하는 구조라고 정리했다.
이번 예제에서는Member가Team과Locker를 필드로 가지고 있는 구조를 확인한다.
앞의 예제들은 주로 하나의 엔티티를 기준으로 조회했다.
이번 예제는 하나의 엔티티 안에서 다른 엔티티를 참조하는 구조를 다룬다.
즉,Member한 명이 어떤Team에 속해 있고, 어떤Locker를 사용하는지 함께 조회하는 흐름이다.
전체 흐름은 테스트 코드 실행 →MemberTeamLockerRepository메서드 호출 →Member조회 → 연결된Team,Locker확인 → 콘솔 출력 순서로 이어진다.
이 예제의 핵심은Member가Team,Locker와 어떻게 연결되는지 보고, 일반 조회와fetch join조회의 차이를 이해하는 것이다.
앞 개념과 연결해서 보기
앞에서 객체는 다른 객체를 필드로 가질 수 있다고 정리했다.
이런 구조를 객체 참조라고 한다.
예를 들어Member객체 안에Team객체가 들어 있으면,Member에서Team으로 이동할 수 있다.
데이터베이스에서는 객체를 직접 넣을 수 없다.
대신 외래키 컬럼을 사용해 다른 테이블의 데이터를 가리킨다.
예를 들어membertbl테이블에TEAM_ID컬럼이 있으면, 이 컬럼은 어떤 팀에 속한 회원인지 알려 주는 값이 된다.
JPA는 이 두 구조를 연결해 준다.
객체에서는Member가Team객체를 필드로 가지고, 데이터베이스에서는TEAM_ID외래키로 연결한다.
연관관계 매핑은 객체 참조와 테이블 외래키를 서로 이어 주는 작업이다.
이번 예제에서 확인할 관계
Member는 회원 한 명을 표현하는 엔티티이다.Team은 팀 정보를 표현하는 엔티티이다.Locker는 사물함 정보를 표현하는 엔티티이다.Member는Team을 참조한다.Member는Locker를 참조한다.Member테이블은TEAM_ID,LOCKER_ID외래키로 다른 테이블과 연결된다.이제 이 관계가 실제 코드에서 어떻게 표현되는지 확인한다.
Team 엔티티 구조 확인하기
Team클래스는 팀 정보를 표현하는 엔티티이다.
회원은 팀에 소속될 수 있으므로,Member가 참조할 대상이 된다.// Team.java package com.example.springjpaedu.entity; import jakarta.persistence.Column; import jakarta.persistence.Entity; import jakarta.persistence.Id; import lombok.Getter; import lombok.Setter; import lombok.ToString; @Getter // getter 메서드 자동 생성 @Setter // setter 메서드 자동 생성 @ToString // 객체 정보를 문자열로 출력 @Entity // 데이터베이스 테이블과 매핑될 클래스 public class Team { @Id // 기본키 필드 @Column(name = "TEAM_ID") // TEAM_ID 컬럼과 연결 private String id; // 팀 아이디 private String name; // 팀 이름 public Team() { } public Team(String id, String name) { super(); this.id = id; // 팀 아이디 저장 this.name = name; // 팀 이름 저장 } }
Team은@Entity가 붙어 있으므로JPA가 관리하는 엔티티이다.
id는@Id가 붙은 기본키 필드이다.
기본키는 각 팀을 구분하는 고유한 값이다.
@Column(name = "TEAM_ID")는id필드를 데이터베이스의TEAM_ID컬럼과 연결한다.
즉, 코드에서는id라고 쓰지만 데이터베이스 컬럼명은TEAM_ID로 사용할 수 있다.
name은 팀 이름이다.
이번 예제에서는Member를 조회하면서m.getTeam().getName()처럼 팀 이름을 함께 확인할 수 있다.
Team에서 봐야 할 부분
@Entity로 엔티티가 된다.id는 팀의 기본키이다.TEAM_ID는 다른 테이블에서 팀을 가리킬 때 사용할 수 있는 기준 값이다.name은 팀 이름이다.
Team은 단독으로도 엔티티이지만, 이번 예제에서는Member가 참조하는 대상이라는 점이 더 중요하다.
Locker 엔티티 구조 확인하기
Locker클래스는 사물함 정보를 표현하는 엔티티이다.
회원 한 명이 사물함 하나를 사용할 수 있는 구조로 볼 수 있다.// Locker.java package com.example.springjpaedu.entity; import jakarta.persistence.*; import lombok.Getter; import lombok.NoArgsConstructor; import lombok.Setter; import lombok.ToString; @Entity // 데이터베이스 테이블과 매핑될 클래스 @Getter // getter 메서드 자동 생성 @Setter // setter 메서드 자동 생성 @ToString // 객체 정보를 문자열로 출력 @NoArgsConstructor // 기본 생성자 자동 생성 public class Locker { @Id // 기본키 필드 @Column(name = "LOCKER_ID") // LOCKER_ID 컬럼과 연결 @GeneratedValue(strategy = GenerationType.IDENTITY) // DB가 기본키 자동 생성 private Long id; // 사물함 번호 private String name; // 사물함 이름 public Locker(String name) { this.name = name; // 사물함 이름 저장 } }
Locker도@Entity가 붙어 있으므로JPA가 관리하는 엔티티이다.
id는 기본키이고, 데이터베이스에서는LOCKER_ID컬럼과 연결된다.
@GeneratedValue(strategy = GenerationType.IDENTITY)는 기본키 값을 데이터베이스가 자동으로 생성한다는 뜻이다.
따라서 새 사물함 데이터를 저장할 때id를 직접 넣지 않아도 데이터베이스가 값을 만들 수 있다.
name은 사물함 이름이다.
예를 들어B101같은 값이 들어갈 수 있다.
뒤에서getByLockerName("B101")처럼 사물함 이름을 기준으로 회원을 찾는 흐름도 나온다.
Locker에서 봐야 할 부분
Locker는 사물함 정보를 담는 엔티티이다.id는 사물함의 기본키이다.LOCKER_ID는Member와 연결될 수 있는 외래키 기준이다.name은 사물함 이름이다.
Locker도Team처럼Member가 참조하는 대상이다.
다만Team과의 관계는 여러 회원이 하나의 팀에 속할 수 있는 구조이고,Locker와의 관계는 회원과 사물함이 하나씩 연결되는 구조로 볼 수 있다.
Member 엔티티에서 연관관계 확인하기
Member클래스는 회원 정보를 표현하는 엔티티이다.
이번 예제에서 가장 중요한 클래스이다.
왜냐하면Member안에Team과Locker가 필드로 들어 있기 때문이다.// Member.java package com.example.springjpaedu.entity; import jakarta.persistence.*; import lombok.Getter; import lombok.NoArgsConstructor; import lombok.Setter; import lombok.ToString; @Getter // getter 메서드 자동 생성 @Setter // setter 메서드 자동 생성 @ToString // 객체 정보를 문자열로 출력 @NoArgsConstructor // 기본 생성자 자동 생성 @Entity // 데이터베이스 테이블과 매핑될 클래스 @Table(name="membertbl") // membertbl 테이블과 연결 public class Member { @Id // 기본키 필드 @Column(name = "MEMBER_ID") // MEMBER_ID 컬럼과 연결 @GeneratedValue(strategy = GenerationType.IDENTITY) // DB가 기본키 자동 생성 private int id; // 회원 번호 private String username; // 회원 이름 // 연관관계 매핑 @ManyToOne // 여러 Member가 하나의 Team을 참조할 수 있음 @JoinColumn(name = "TEAM_ID") // TEAM_ID 외래키 컬럼으로 Team 연결 private Team team; // 소속 팀 @OneToOne // Member 하나가 Locker 하나를 참조 @JoinColumn(name = "LOCKER_ID") // LOCKER_ID 외래키 컬럼으로 Locker 연결 private Locker locker; // 사용하는 사물함 public Member(String username, Team team, Locker locker) { super(); this.username = username; // 회원 이름 저장 this.team = team; // 팀 객체 연결 this.locker = locker; // 사물함 객체 연결 } }
@Table(name="membertbl")은Member엔티티가membertbl테이블과 연결된다는 뜻이다.
클래스 이름은Member이지만, 실제 테이블 이름은membertbl로 지정되어 있다.
id는 회원의 기본키이다.
데이터베이스에서는MEMBER_ID컬럼과 연결된다.
@GeneratedValue(strategy = GenerationType.IDENTITY)가 있으므로 회원 번호는 데이터베이스가 자동으로 만들 수 있다.
username은 회원 이름이다.
이 필드는 단순한 문자열 값이다.
반면team과locker는 단순 문자열이 아니라 다른 엔티티 객체이다.
이 부분이 연관관계의 핵심이다.
ManyToOne 관계
@ManyToOne은 여러 개의Member가 하나의Team을 참조할 수 있다는 뜻이다.
예를 들어 여러 회원이 같은 팀에 속할 수 있다.
회원은 여러 명이고 팀은 하나이므로Member입장에서는ManyToOne관계가 된다.
@JoinColumn(name = "TEAM_ID")는membertbl테이블의TEAM_ID컬럼을 사용해Team과 연결한다는 뜻이다.
객체에서는private Team team으로 연결하고, 데이터베이스에서는TEAM_ID외래키로 연결한다.
OneToOne 관계
@OneToOne은Member하나가Locker하나와 연결된다는 뜻이다.
회원 한 명이 사물함 하나를 사용하는 구조로 이해하면 된다.
@JoinColumn(name = "LOCKER_ID")는membertbl테이블의LOCKER_ID컬럼을 사용해Locker와 연결한다는 뜻이다.
객체에서는private Locker locker로 연결하고, 데이터베이스에서는LOCKER_ID외래키로 연결한다.
Member 연관관계 정리
Member는membertbl테이블과 연결된다.Member.id는MEMBER_ID컬럼과 연결된다.Member.team은TEAM_ID외래키로Team과 연결된다.Member.locker는LOCKER_ID외래키로Locker와 연결된다.- 객체에서는
Team,Locker객체를 직접 참조한다.- 테이블에서는 외래키 컬럼으로 연결한다.
Member엔티티는 단순한 회원 정보뿐 아니라, 소속 팀과 사물함까지 객체 참조로 연결하고 있다.
이 구조를 알아야 뒤에서 조회 결과를 해석할 수 있다.
Repository에서 일반 조회와 Fetch Join 조회 준비하기
MemberTeamLockerRepository는Member엔티티를 기준으로 조회하는 저장소이다.
기본 조회뿐만 아니라@Query를 사용한JPQL조회도 함께 들어 있다.// MemberTeamLockerRepository.java package com.example.springjpaedu.repository; import com.example.springjpaedu.entity.Member; import org.springframework.data.jpa.repository.JpaRepository; import org.springframework.data.jpa.repository.Query; import org.springframework.data.repository.query.Param; import java.util.List; public interface MemberTeamLockerRepository extends JpaRepository<Member, Integer>{ @Query("select m from Member m ") public List<Member> getAllData(); // Member 전체 조회 @Query("select m from Member m join fetch m.team join fetch m.locker") public List<Member> getAllDataFetchJoin(); // Team, Locker까지 함께 조회 @Query("select m from Member m where m.team.name = :tn") public List<Member> getWithJPQL1(@Param("tn") String tname); // 팀 이름 조건 조회 public List<Member> findByTeamName(String name); // 팀 이름 쿼리 메서드 조회 @Query("select m.team.name from Member m where m.username = :un") public String getWithJPQL2(@Param("un") String username); // 회원 이름으로 팀 이름 조회 public TeamName getByUsername(String username); // 회원 이름으로 팀 이름 프로젝션 조회 public Member getByLockerName(String lname); // 사물함 이름으로 회원 조회 public List<Member> findByUsername(String username); // 회원 이름 기준 목록 조회 public Long countByUsername(String username); // 회원 이름 기준 개수 조회 }이번 응용예제에서는 먼저
getAllData()와getAllDataFetchJoin()을 중심으로 본다.
나머지 메서드는 다음 예제에서 조건 조회와 프로젝션 흐름으로 다시 확인한다.
getAllData()는select m from Member m을 실행한다.
이 쿼리는Member전체를 조회한다.
Team이나Locker를 쿼리에 직접 함께 가져오라고 쓰지는 않는다.
getAllDataFetchJoin()은join fetch m.team join fetch m.locker를 사용한다.
fetch join은 연관된 엔티티를 함께 가져오라고 명시하는 방식이다.
여기서는Member를 조회할 때Team과Locker도 함께 가져오도록 작성되어 있다.
일반 조회와 Fetch Join 차이
getAllData()는Member를 기준으로 조회한다.getAllDataFetchJoin()은Member와 연결된Team,Locker까지 함께 조회한다.fetch join은 연관된 엔티티를 한 번에 가져오고 싶을 때 사용한다.- 연관관계가 있는 엔티티를 출력할 때 추가 조회가 줄어들 수 있다.
일반 조회는 중심 엔티티를 조회하는 흐름이고,
fetch join은 연관 엔티티까지 함께 가져오는 흐름이다.
테스트 코드에서 일반 조회와 Fetch Join 확인하기
JPA_MemberTeamLockerTest1은 화면이 아니라 테스트 콘솔로 결과를 확인하는 예제이다.
MemberTeamLockerRepository의 메서드를 직접 호출하고, 조회 결과를 콘솔에 출력한다.// JPA_MemberTeamLockerTest1.java package com.example.springjpaedu; import com.example.springjpaedu.entity.Member; import com.example.springjpaedu.repository.MemberTeamLockerRepository; import org.junit.jupiter.api.AfterAll; import org.junit.jupiter.api.BeforeEach; import org.junit.jupiter.api.Test; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.boot.jdbc.test.autoconfigure.AutoConfigureTestDatabase; import org.springframework.boot.data.jpa.test.autoconfigure.DataJpaTest; import java.util.List; @AutoConfigureTestDatabase(replace = AutoConfigureTestDatabase.Replace.NONE) // 실제 DB 설정 사용 @DataJpaTest // JPA Repository 테스트 환경 준비 public class JPA_MemberTeamLockerTest1 { @Autowired // Repository 구현체 주입 private MemberTeamLockerRepository repo; @BeforeEach // 각 테스트 실행 전 구분선 출력 void pr() { System.out.println("=".repeat(80)); } @Test void test1() { List<Member> list = repo.findAll(); // JpaRepository 기본 전체 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test void test2() { List<Member> list = repo.getAllData(); // JPQL로 Member 전체 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @Test void test3() { List<Member> list = repo.getAllDataFetchJoin(); // fetch join으로 연관 엔티티 함께 조회 list.stream().forEach(System.out::println); // 콘솔 출력 } @AfterAll // 모든 테스트 종료 후 실행 static void end() { System.out.println("=".repeat(80)); System.out.println("[[[[[[ 테스트 종료 ]]]]]]"); } }
test1()은repo.findAll()을 호출한다.
이 메서드는JpaRepository가 제공하는 기본 전체 조회 메서드이다.
따로Repository에 선언하지 않아도 사용할 수 있다.
test2()는repo.getAllData()를 호출한다.
이 메서드는@Query("select m from Member m ")로 작성된JPQL을 실행한다.
결과적으로Member전체를 조회한다는 점에서는findAll()과 비슷하다.
test3()은repo.getAllDataFetchJoin()을 호출한다.
이 메서드는fetch join을 사용한다.
Member를 조회하면서m.team과m.locker도 함께 가져온다.
테스트 메서드별 의미
test1()은 기본 메서드인findAll()로 전체 조회한다.test2()는 직접 작성한JPQL로 전체 조회한다.test3()은fetch join으로Team,Locker까지 함께 조회한다.이 세 테스트는 모두
Member목록을 조회한다.
하지만 조회를 만드는 방식이 다르다.
findAll()은 기본 메서드이고,getAllData()는 직접 작성한JPQL이며,getAllDataFetchJoin()은 연관 엔티티를 함께 가져오는fetch join이다.
일반 조회 결과 해석하기
일반 조회는
Member를 기준으로 조회하고,fetch join처럼Team,Locker를 함께 가져오라고 쿼리에 직접 지정하지 않는다.
현재Member의@ManyToOne,@OneToOne에는 별도의fetch설정이 없기 때문에 기본 조회 방식으로 연관 객체가 함께 준비될 수 있다.
이때fetch join처럼 하나의join쿼리로 가져오는 것이 아니라,Team,Locker를 가져오기 위한 별도select가 추가로 보일 수 있다.
test1()은findAll()을 사용한 기본 전체 조회이다.
콘솔 결과를 보면Member목록이 출력되고, 각Member안에 연결된Team,Locker정보도 함께 보인다.// JPA_MemberTeamLockerTest1.java @Test void test1() { List<Member> list = repo.findAll(); // JpaRepository 기본 전체 조회 list.stream().forEach(System.out::println); // Member, Team, Locker 정보 출력 }
test1()은findAll()로Member전체를 조회한 결과이다.
위쪽에team,locker를 조회하는select가 추가로 보이는 이유는 일반 조회가fetch join으로 작성된 조회가 아니기 때문이다.
연관 객체는 결과에 함께 보이지만, 조회 방식은join이 아니라 별도select로 처리될 수 있다.
test2()는@Query로 작성한JPQL일반 조회이다.
select m from Member m은Member자체를 조회하는 쿼리이다.
fetch join을 사용하지 않았기 때문에 연관된Team,Locker를 처음부터 함께 가져오라고 명시하지는 않는다.// JPA_MemberTeamLockerTest1.java @Test void test2() { List<Member> list = repo.getAllData(); // JPQL로 Member 전체 조회 list.stream().forEach(System.out::println); // Member, Team, Locker 정보 출력 }
test2()는getAllData()로JPQL일반 조회를 실행한 결과이다.
조회 결과는findAll()과 비슷하게Member목록으로 보인다.
하지만 이 메서드는 기본 메서드가 아니라@Query에 작성한select m from Member m이 실행된다는 점이 다르다.
일반 조회에서 봐야 할 점
- 결과 화면에는
Member,Team,Locker정보가 함께 보일 수 있다.- 하지만 일반 조회는 처음부터 연관 엔티티를
join으로 함께 가져오라고 명시한 조회가 아니다.- 현재 연관관계의 기본 조회 방식 때문에 별도
select가 추가로 보일 수 있다.findAll()과 일반JPQL조회는 결과가 비슷해 보여도 호출 방식이 다르다.일반 조회 결과가 겉으로는 연관 객체까지 다 나온 것처럼 보여도, 실제 조회 방식은
fetch join과 다를 수 있다.
Fetch Join 조회 결과 해석하기
test3()은fetch join을 사용한 조회이다.
fetch join은Member를 조회할 때 연결된Team,Locker도 함께 가져오라고 쿼리에 직접 지정하는 방식이다.// JPA_MemberTeamLockerTest1.java @Test void test3() { List<Member> list = repo.getAllDataFetchJoin(); // fetch join으로 연관 엔티티 함께 조회 list.stream().forEach(System.out::println); // Member, Team, Locker 정보 출력 }
Repository의 쿼리는 아래와 같다.// MemberTeamLockerRepository.java @Query("select m from Member m join fetch m.team join fetch m.locker") public List<Member> getAllDataFetchJoin(); // Team, Locker까지 함께 조회
join fetch m.team은Member와 연결된Team을 함께 가져오라는 뜻이다.
join fetch m.locker는Member와 연결된Locker를 함께 가져오라는 뜻이다.
즉,Member만 먼저 조회한 뒤 나중에Team,Locker를 따로 가져오는 흐름이 아니라, 처음 조회할 때부터 필요한 연관 엔티티를 함께 가져오도록 지정한다.
test3()은getAllDataFetchJoin()으로fetch join조회를 실행한 결과이다.
콘솔의SQL을 보면membertbl,team,locker가join으로 함께 조회된다.
그래서Member를 출력할 때 연결된Team,Locker정보를 함께 확인할 수 있다.
Fetch Join에서 봐야 할 점
fetch join은 연관 엔티티를 함께 조회하도록 지정한다.membertbl,team,locker가 하나의 조회 흐름에서join된다.- 결과에는
Member객체가 나오지만, 그 안의Team,Locker도 함께 준비되어 있다.- 연관 객체를 출력할 때 추가 조회가 줄어드는 구조로 이해할 수 있다.
fetch join은 결과 모양만 보는 것이 아니라, 콘솔에 찍힌SQL에서join이 실제로 발생했는지를 함께 확인해야 한다.
일반 조회와 Fetch Join 차이 정리하기
test1,test2,test3은 모두Member목록을 출력한다.
그래서 출력된 객체 모양만 보면 결과가 비슷해 보일 수 있다.
하지만 콘솔의SQL을 보면 차이가 있다.
일반 조회는Member를 조회하고, 연관 객체는 별도select로 조회될 수 있다.
반면fetch join은 처음부터membertbl,team,locker를join해서 가져온다.
조회 방식 비교
findAll()은JpaRepository가 제공하는 기본 전체 조회이다.getAllData()는 직접 작성한JPQL로Member전체를 조회한다.getAllDataFetchJoin()은fetch join으로Team,Locker까지 함께 조회한다.SQL 흐름 비교
- 일반 조회는 중심 엔티티인
Member조회가 기준이다.- 일반 조회에서는
Team,Locker조회가 별도select로 추가될 수 있다.fetch join은Member,Team,Locker를 한 번의join조회 흐름으로 가져온다.결과 객체가 비슷해 보여도, 일반 조회와
fetch join은 데이터를 가져오는 방식이 다르다.
이 차이를 이해해야 연관관계 조회에서 왜fetch join을 사용하는지 알 수 있다.
이 예제에서 확인해야 하는 핵심
응용예제 5는
Member,Team,Locker엔티티의 연관관계와fetch join조회 흐름을 확인하는 예제이다.
앞에서 배운 엔티티 매핑, 외래키, 연관관계,JPQL,@Query가 함께 사용된다.
엔티티 관계 정리
Member는 회원 정보를 표현한다.Team은 팀 정보를 표현한다.Locker는 사물함 정보를 표현한다.Member는@ManyToOne으로Team을 참조한다.Member는@OneToOne으로Locker를 참조한다.TEAM_ID는Member와Team을 연결한다.LOCKER_ID는Member와Locker를 연결한다.조회 방식 정리
findAll()은JpaRepository가 제공하는 기본 전체 조회이다.getAllData()는@Query로 직접 작성한JPQL전체 조회이다.getAllDataFetchJoin()은fetch join으로 연관 엔티티까지 함께 조회한다.정리하면,
Member예제는 단순 조회에서 한 단계 더 나아가 연관된 엔티티를 함께 다루는 흐름을 보여 준다.
핵심은 객체에서는Member가Team,Locker를 참조하고, 데이터베이스에서는TEAM_ID,LOCKER_ID외래키로 연결된다는 점이다.
그리고 연관관계 조회에서는 결과만 보는 것이 아니라, 실제SQL이 일반 조회인지join조회인지 함께 확인해야 한다.
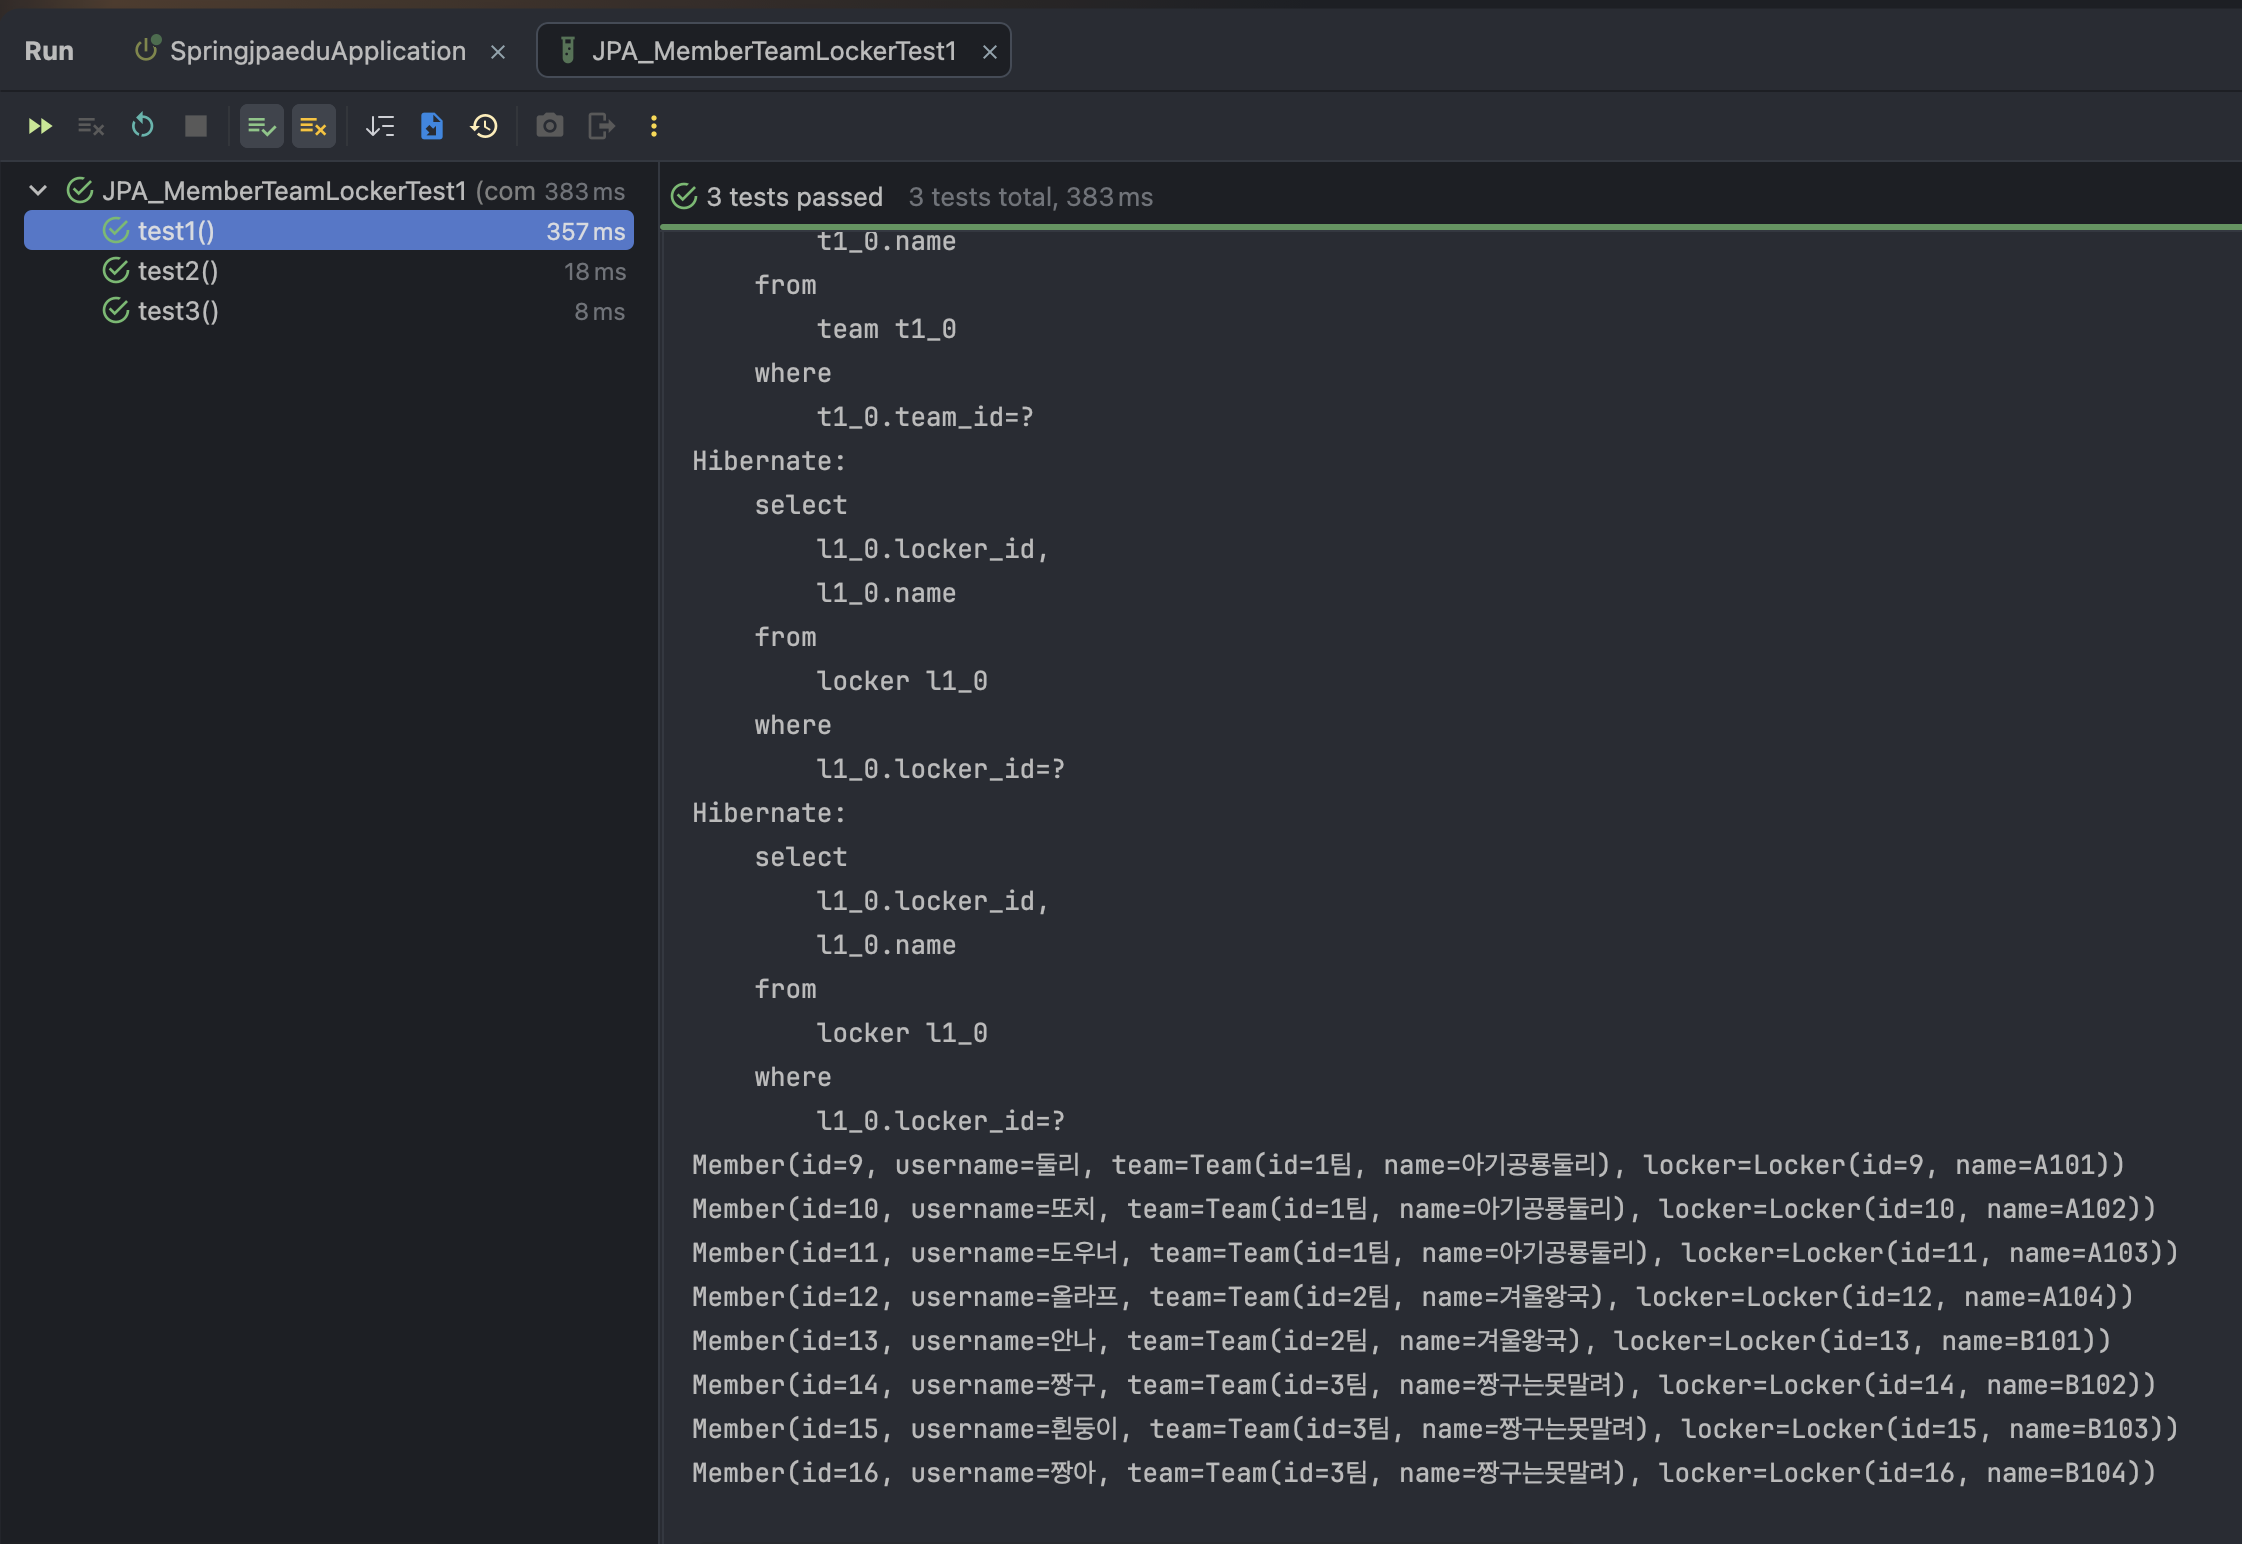
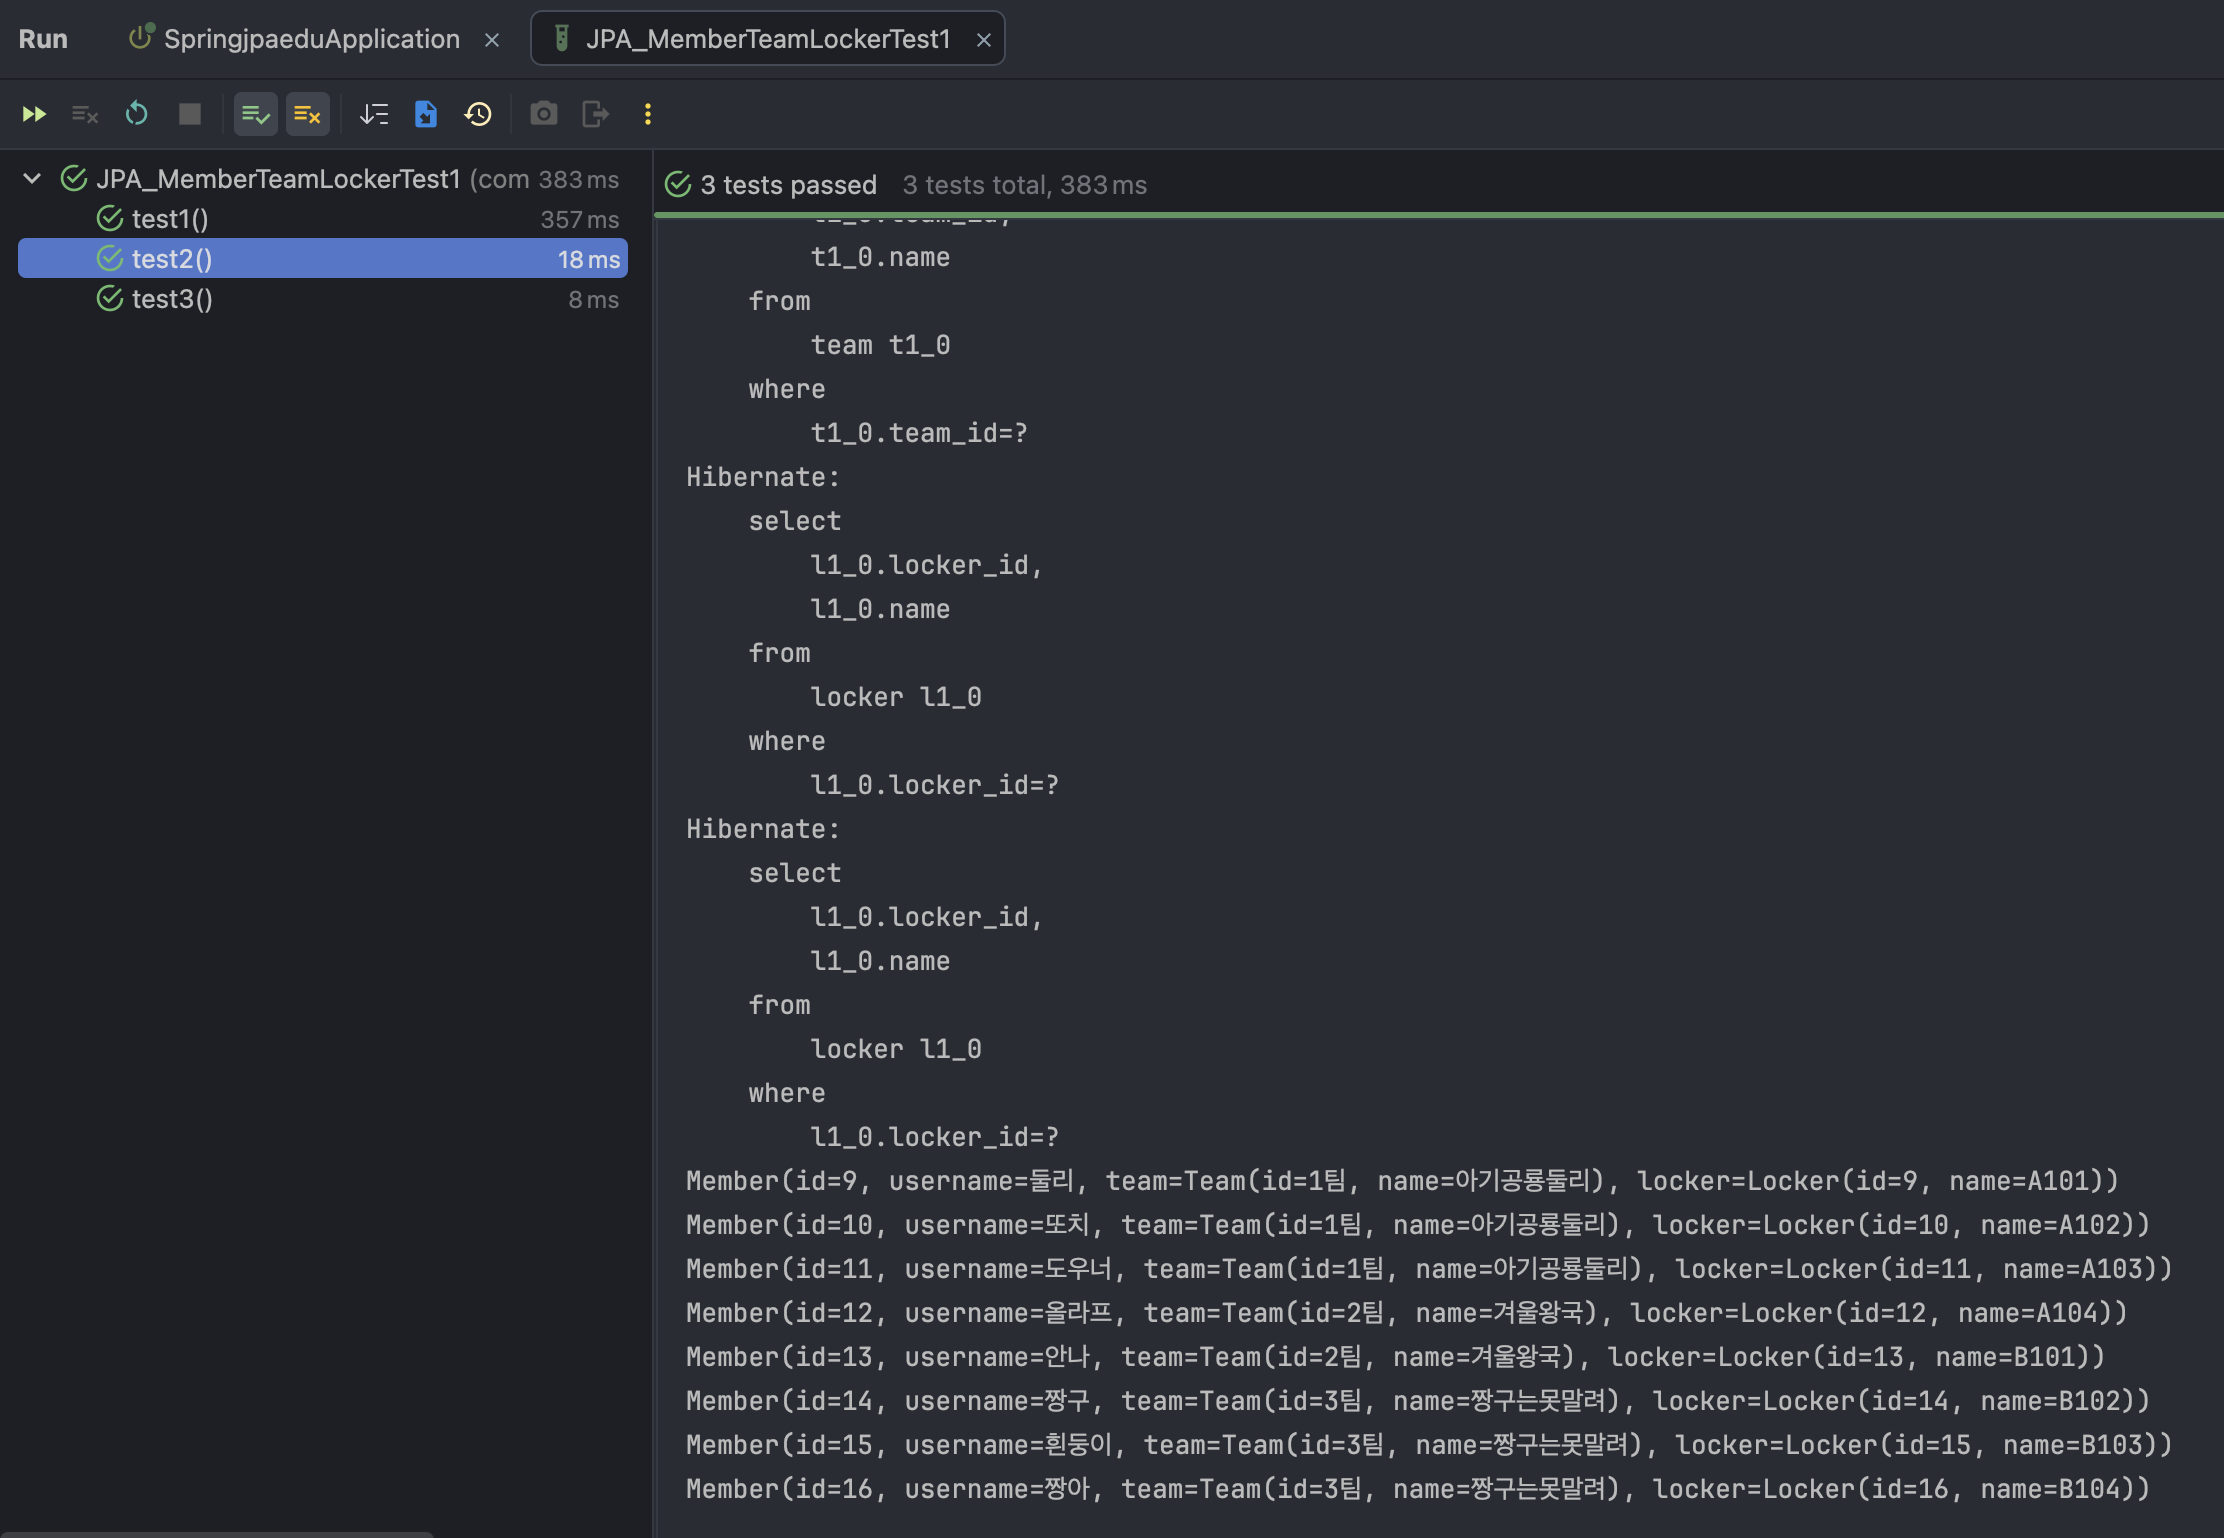
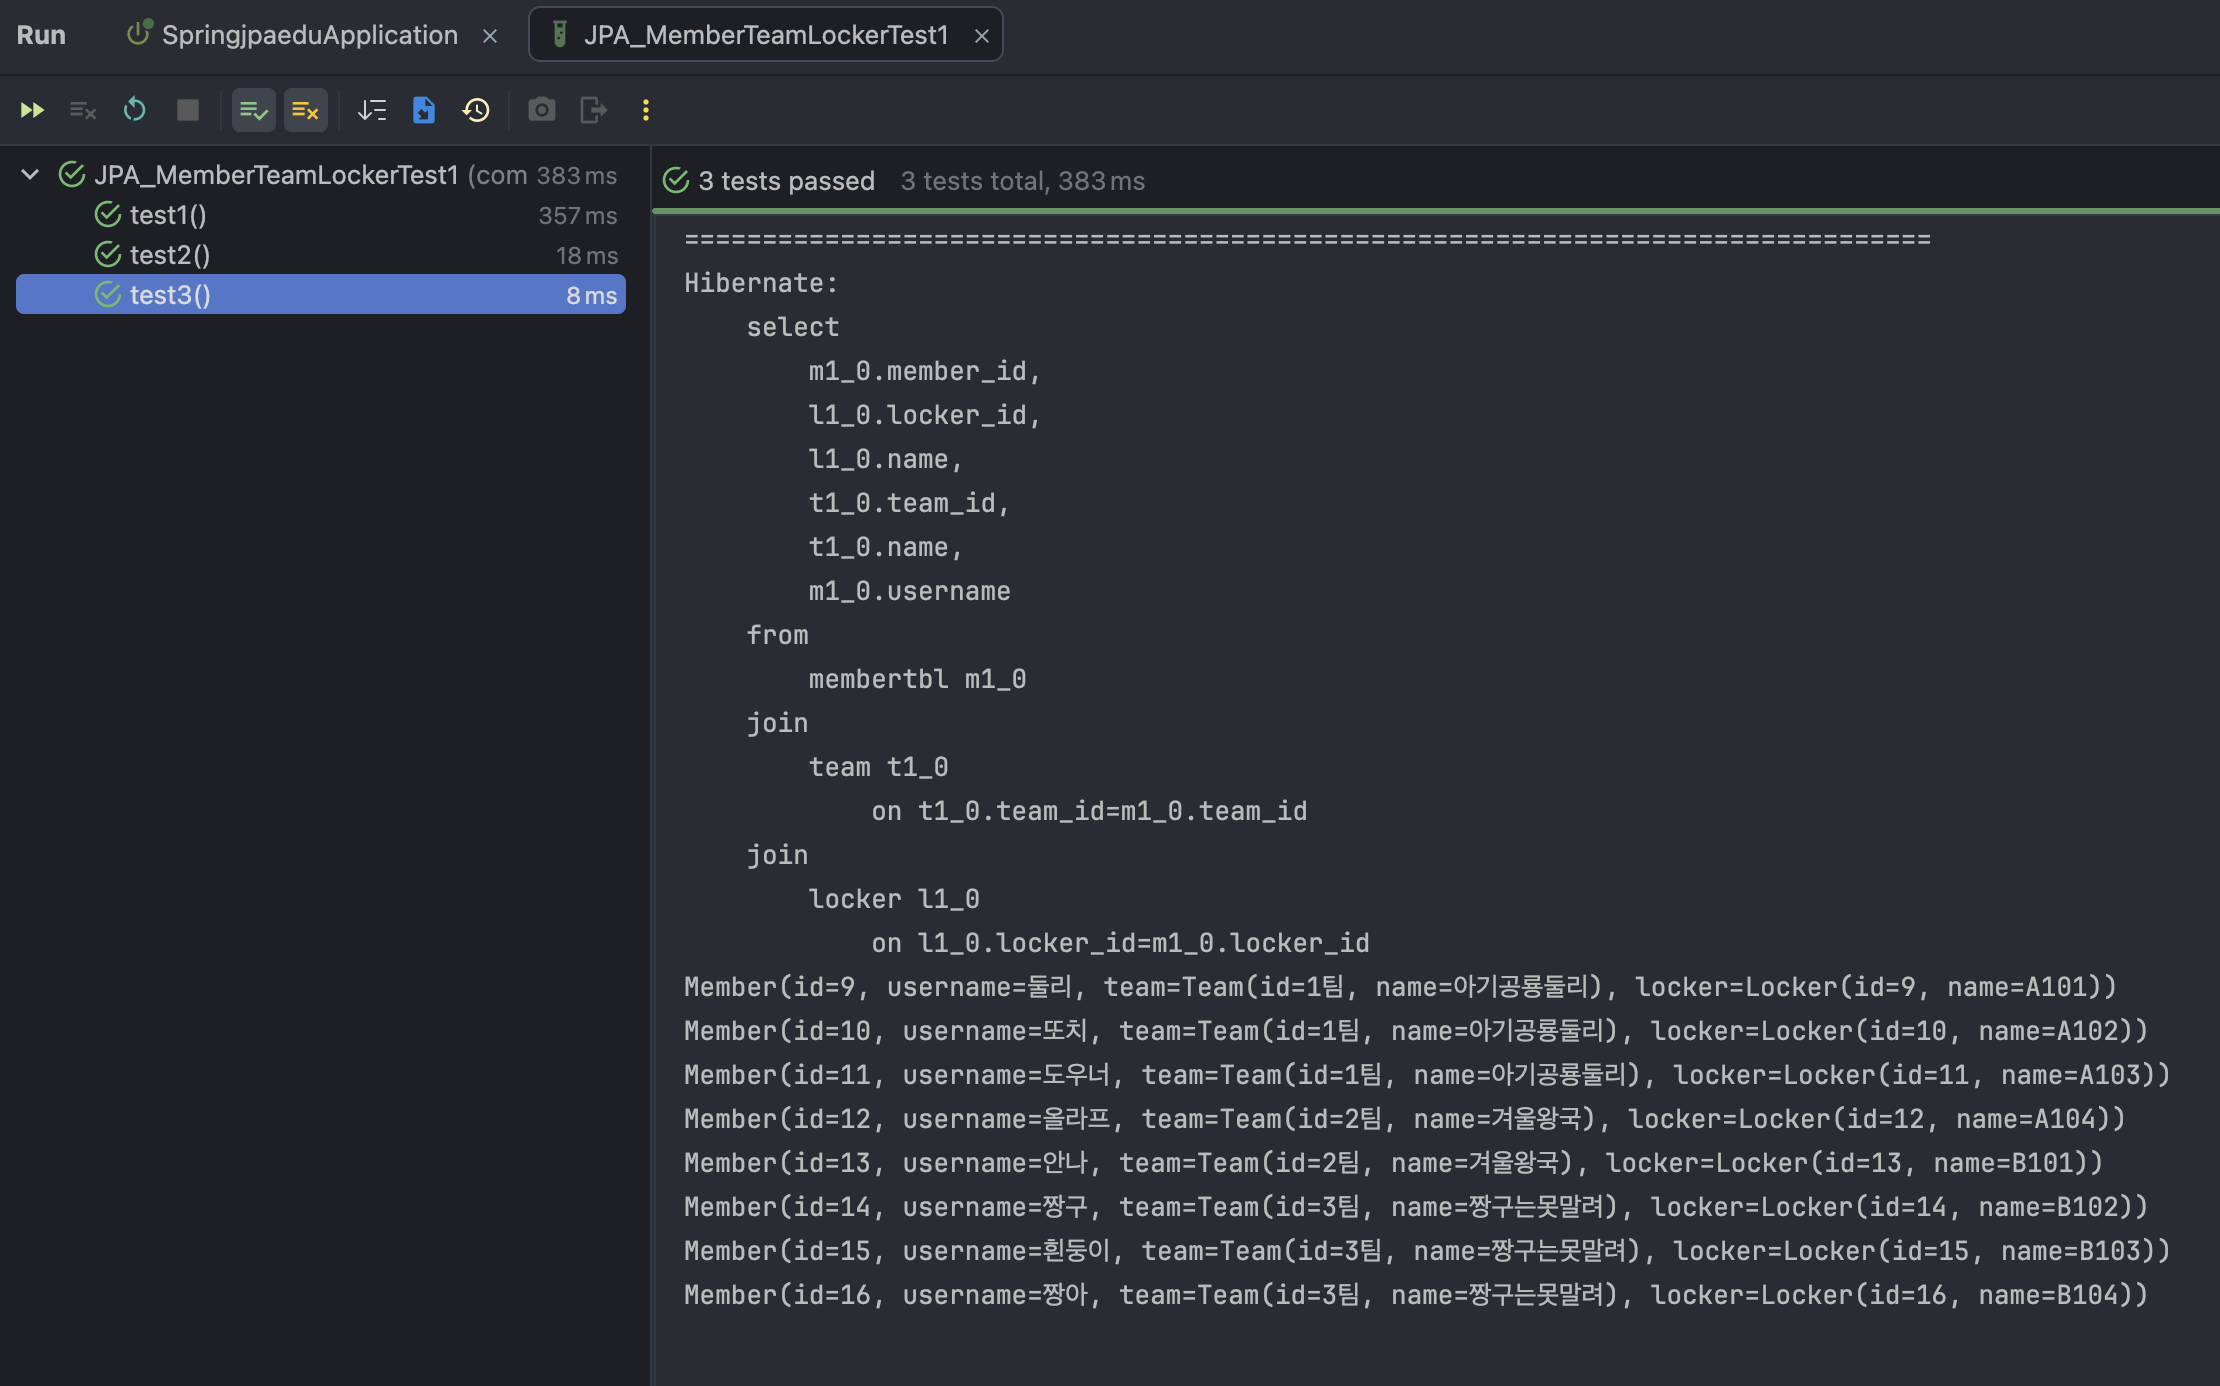
응용예제 6. Member와 Team 연관관계 조건 조회와 프로젝션 조회 (Member.java, Team.java, MemberTeamLockerRepository.java, TeamName.java, JPA_MemberTeamLockerTest2.java)
앞 예제에서는
Member를 조회하면서 연결된Team,Locker를 함께 확인했다.
이번 예제에서는 그 연관관계를 조회 조건과 조회 결과에 사용하는 흐름을 확인한다.
Member는Team을 직접 필드로 가지고 있다.
그래서Member자신의 필드뿐만 아니라,Member가 참조하는Team의name값도 조회 조건으로 사용할 수 있다.
이번 예제의 핵심은 두 가지이다.
첫 번째는 팀 이름이 특정 값인 회원 목록을 조회하는 것이다.
두 번째는 회원 이름을 기준으로 전체Member가 아니라 팀 이름만 조회하는 것이다.
즉, 이번 예제는 연관 객체의 필드를 조건으로 쓰는 방법과 필요한 값만 가져오는 프로젝션 흐름을 확인하는 예제이다.
앞 개념과 연결해서 보기
앞에서
Member는Team을 참조한다고 정리했다.
코드에서는Member클래스 안에private Team team필드가 있다.
데이터베이스에서는membertbl테이블의TEAM_ID외래키가Team테이블과 연결된다.
이 관계가 있으면Member에서Team으로 이동할 수 있다.
객체 기준으로 보면member.getTeam().getName()처럼 회원이 속한 팀 이름을 꺼낼 수 있다.
JPQL이나 쿼리 메서드에서도 이 구조를 따라가서 팀 이름을 조건으로 사용할 수 있다.
예를 들어m.team.name은Member가 참조하는Team의name필드를 의미한다.
findByTeamName()도 같은 흐름이다.
메서드 이름만 보면Member안에teamName이라는 필드가 있는 것처럼 보일 수 있지만, 실제 의미는team.name을 따라가는 조건 조회이다.
이번 예제에서 확인할 개념
Member는Team을 참조한다.Team에는 팀 이름인name필드가 있다.m.team.name은Member에서Team으로 이동한 뒤name값을 사용한다는 뜻이다.findByTeamName()은 연결된Team의name값을 조건으로 조회한다.@Query를 사용하면 같은 조건을JPQL로 직접 작성할 수 있다.- 프로젝션은 전체 엔티티가 아니라 필요한 값만 가져오는 조회 방식이다.
연관관계 조회에서는 내 엔티티의 필드만 보는 것이 아니라, 내가 참조하는 엔티티의 필드까지 조건이나 결과로 사용할 수 있다.
Repository 메서드 구조 확인하기
이번 예제에서 사용하는 메서드는
MemberTeamLockerRepository에 들어 있다.
여기서는 팀 이름 조건 조회와 팀 이름만 조회하는 메서드를 중심으로 본다.// MemberTeamLockerRepository.java package com.example.springjpaedu.repository; import com.example.springjpaedu.entity.Member; import org.springframework.data.jpa.repository.JpaRepository; import org.springframework.data.jpa.repository.Query; import org.springframework.data.repository.query.Param; import java.util.List; public interface MemberTeamLockerRepository extends JpaRepository<Member, Integer>{ @Query("select m from Member m where m.team.name = :tn") public List<Member> getWithJPQL1(@Param("tn") String tname); // 팀 이름 조건 JPQL 조회 public List<Member> findByTeamName(String name); // 팀 이름 조건 쿼리 메서드 조회 @Query("select m.team.name from Member m where m.username = :un") public String getWithJPQL2(@Param("un") String username); // 회원 이름으로 팀 이름만 조회 public TeamName getByUsername(String username); // 회원 이름으로 팀 이름 프로젝션 조회 }
findByTeamName(String name)은 쿼리 메서드이다.
메서드 이름을 분석해서 조회 조건을 자동으로 만든다.
여기서TeamName은Member의 직접 필드명이 아니라,team.name경로를 의미한다.
getWithJPQL1()은 같은 조건을@Query로 직접 작성한 메서드이다.
select m from Member m where m.team.name = :tn은Member를 조회하되, 그Member가 속한Team의 이름이tn값과 같은 데이터만 가져오겠다는 뜻이다.
getWithJPQL2()는Member전체를 조회하지 않는다.
select m.team.name처럼 팀 이름 값 하나만 선택한다.
그래서 반환 타입도Member가 아니라String이다.
getByUsername()은 프로젝션 조회이다.
프로젝션은 필요한 필드만 뽑아서 가져오는 방식이다.
이 메서드는 회원 이름을 기준으로 조회하되, 결과를TeamName인터페이스 형태로 받는다.
메서드별 역할 정리
findByTeamName()은 쿼리 메서드로 팀 이름 조건 조회를 한다.getWithJPQL1()은@Query로 직접 작성한 팀 이름 조건 조회를 한다.getWithJPQL2()는JPQL로 팀 이름 문자열 하나만 조회한다.getByUsername()은 프로젝션 인터페이스를 사용해 필요한 값만 조회한다.같은 팀 이름을 기준으로 조회하더라도 쿼리 메서드로 만들 수도 있고,
@Query로 직접 작성할 수도 있다.
또 결과를 전체Member로 받을 수도 있고, 팀 이름 하나만 받을 수도 있다.
TeamName 프로젝션 인터페이스 확인하기
TeamName은 엔티티가 아니다.
데이터베이스 테이블과 직접 매핑되는 클래스도 아니다.
조회 결과 중 필요한 값만 꺼내기 위한 프로젝션 인터페이스이다.// TeamName.java package com.example.springjpaedu.repository; public interface TeamName { String getTeamName(); // 조회 결과에서 팀 이름만 꺼내는 메서드 }
TeamName은interface이다.
interface는 구현할 메서드의 모양만 정해 두는 타입이다.
여기서는getTeamName()메서드만 가지고 있다.
getByUsername("둘리")를 실행하면 전체Member객체를 직접 받지 않고,TeamName타입으로 결과를 받는다.
그리고result.getTeamName()을 호출해서 팀 이름만 출력한다.
이 방식은 화면이나 출력에서 특정 값 하나만 필요할 때 유용하다.
전체 엔티티를 다 가져와서 필요한 값을 꺼내는 방식보다, 처음부터 필요한 값만 조회하는 흐름에 가깝다.
프로젝션에서 봐야 할 점
- 프로젝션은 전체 엔티티가 아니라 필요한 값만 가져오는 방식이다.
TeamName은 엔티티가 아니라 조회 결과를 받기 위한 인터페이스이다.getTeamName()은 조회 결과에서 팀 이름만 꺼내는 메서드이다.- 필요한 값이 적을 때는 프로젝션이 더 목적에 맞을 수 있다.
프로젝션은 데이터를 수정하기 위한 엔티티 조회가 아니라, 필요한 값을 읽기 위한 조회 방식이다.
테스트 코드 구조 확인하기
JPA_MemberTeamLockerTest2는 팀 이름 조건 조회와 팀 이름만 조회하는 흐름을 테스트한다.
화면이 아니라 콘솔 결과로 확인하는 예제이다.// JPA_MemberTeamLockerTest2.java package com.example.springjpaedu; import com.example.springjpaedu.entity.Member; import com.example.springjpaedu.repository.MemberTeamLockerRepository; import com.example.springjpaedu.repository.TeamName; import org.junit.jupiter.api.AfterAll; import org.junit.jupiter.api.BeforeEach; import org.junit.jupiter.api.Test; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.boot.jdbc.test.autoconfigure.AutoConfigureTestDatabase; import org.springframework.boot.data.jpa.test.autoconfigure.DataJpaTest; import java.util.List; @AutoConfigureTestDatabase(replace = AutoConfigureTestDatabase.Replace.NONE) // 실제 DB 설정 사용 @DataJpaTest // JPA Repository 테스트 환경 준비 public class JPA_MemberTeamLockerTest2 { @Autowired // Repository 구현체 주입 private MemberTeamLockerRepository repo; @BeforeEach // 각 테스트 실행 전 구분선 출력 void pr() { System.out.println("=".repeat(80)); } @Test void test1() { List<Member> list = repo.findByTeamName("겨울왕국"); // 팀 이름 조건 쿼리 메서드 조회 list.stream().forEach(System.out::println); // 조회 결과 출력 } @Test void test2() { List<Member> list = repo.getWithJPQL1("겨울왕국"); // 팀 이름 조건 JPQL 조회 list.stream().forEach(System.out::println); // 조회 결과 출력 } @Test void test3() { TeamName result = repo.getByUsername("둘리"); // 회원 이름으로 팀 이름 프로젝션 조회 System.out.println(result.getTeamName()); // 팀 이름만 출력 } @Test void test4() { String teamName = repo.getWithJPQL2("둘리"); // 회원 이름으로 팀 이름 문자열 조회 System.out.println(teamName); // 팀 이름 출력 } @AfterAll // 모든 테스트 종료 후 실행 static void end() { System.out.println("=".repeat(80)); System.out.println("[[[[[[ 테스트 종료 ]]]]]]"); } }
test1()과test2()는 모두 팀 이름이겨울왕국인 회원 목록을 조회한다.
차이는 조회 조건을 만드는 방식이다.
test1()은 쿼리 메서드를 사용하고,test2()는@Query로 작성한JPQL을 사용한다.
test3()과test4()는 모두 회원 이름이둘리인 데이터에서 팀 이름을 조회한다.
차이는 결과를 받는 방식이다.
test3()은TeamName프로젝션 인터페이스로 받고,test4()는String으로 팀 이름 하나를 바로 받는다.
테스트 메서드별 의미
test1()은findByTeamName()으로 팀 이름 조건 조회를 확인한다.test2()는getWithJPQL1()로 같은 조건을 직접 작성한JPQL로 확인한다.test3()은getByUsername()으로 프로젝션 결과를 확인한다.test4()는getWithJPQL2()로 팀 이름 문자열만 조회한다.이 테스트들은 모두
Member와Team의 연관관계를 사용한다.
하지만 조건으로 쓰는지, 결과로 가져오는지, 전체 엔티티를 받는지, 값 하나만 받는지에 따라 코드 구조가 달라진다.
팀 이름 조건 조회 비교하기
먼저
test1()과test2()를 비교한다.
두 테스트는 모두 팀 이름이겨울왕국인 회원을 조회한다.
즉, 결과로는겨울왕국팀에 속한Member목록이 출력된다.// JPA_MemberTeamLockerTest2.java @Test void test1() { List<Member> list = repo.findByTeamName("겨울왕국"); // 팀 이름 조건 쿼리 메서드 조회 list.stream().forEach(System.out::println); // 조회 결과 출력 }
findByTeamName("겨울왕국")은 메서드 이름으로 조건을 만든다.
Member가 참조하는Team의name값이겨울왕국인 데이터를 조회한다.
콘솔의SQL을 보면membertbl과team이 연결되고,where t1_0.name=?조건이 사용된다.
즉, 회원 테이블의 단순 필드가 아니라 연결된 팀의 이름을 조건으로 사용한 것이다.
test1()은findByTeamName("겨울왕국")을 실행한 결과이다.
Team의name값이겨울왕국인 회원만 조회되며, 결과에는올라프,안나가 출력된다.
이 방식은 메서드 이름만으로 연관 객체의 필드를 조건으로 사용한다.
// JPA_MemberTeamLockerTest2.java
@Test
void test2() {
    List<Member> list = repo.getWithJPQL1("겨울왕국"); // 팀 이름 조건 JPQL 조회
    list.stream().forEach(System.out::println); // 조회 결과 출력
}
getWithJPQL1("겨울왕국")은 직접 작성한JPQL로 같은 조건을 만든다.
where m.team.name = :tn에서:tn은 이름이 붙은 매개변수이다.
@Param("tn")이 메서드 매개변수tname과:tn을 연결한다.
결과는findByTeamName()과 비슷하게 나온다.
하지만 이 방식은 메서드 이름이 아니라@Query안에 조건을 직접 작성한다는 점이 다르다.
test2()는getWithJPQL1("겨울왕국")을 실행한 결과이다.
@Query에 작성한m.team.name = :tn조건을 사용해겨울왕국팀에 속한Member목록을 조회한다.
결과는test1()과 같지만, 조회 조건을 직접 작성한JPQL로 만든다는 차이가 있다.
쿼리 메서드와 JPQL 조건 조회 차이
- 쿼리 메서드는 메서드 이름으로 조건을 만든다.
JPQL은@Query안에 조회문을 직접 작성한다.findByTeamName()은team.name경로를 메서드 이름으로 표현한다.getWithJPQL1()은m.team.name = :tn조건을 직접 작성한다.- 결과는 비슷해도 쿼리를 만드는 방식이 다르다.
같은 결과를 얻더라도 쿼리 메서드는 이름으로 조건을 만들고,
JPQL은 조건을 직접 작성한다.
프로젝션과 문자열 조회 비교하기
이번에는
test3()과test4()를 비교한다.
두 테스트는 모두 회원 이름이둘리인 데이터를 기준으로 팀 이름을 조회한다.
하지만 결과를 받는 방식이 다르다.// JPA_MemberTeamLockerTest2.java @Test void test3() { TeamName result = repo.getByUsername("둘리"); // 회원 이름으로 팀 이름 프로젝션 조회 System.out.println(result.getTeamName()); // 팀 이름만 출력 }
getByUsername("둘리")는 회원 이름을 기준으로 데이터를 조회한다.
반환 타입은TeamName이다.
즉, 전체Member를 받는 것이 아니라, 팀 이름을 꺼낼 수 있는 프로젝션 결과를 받는다.
result.getTeamName()을 호출하면 팀 이름이 출력된다.
여기서 중요한 점은Member전체를 출력하지 않는다는 것이다.
필요한 값인 팀 이름만 출력한다.
콘솔을 보면membertbl과team이left join으로 연결되고, 선택되는 값은t1_0.name이다.
즉,Member전체가 아니라 팀 이름 컬럼을 중심으로 조회한다.
test3()은getByUsername("둘리")를 실행한 결과이다.
회원 이름이둘리인 데이터를 기준으로 팀 이름만 조회하고,TeamName프로젝션의getTeamName()을 통해아기공룡둘리가 출력된다.
// JPA_MemberTeamLockerTest2.java
@Test
void test4() {
    String teamName = repo.getWithJPQL2("둘리"); // 회원 이름으로 팀 이름 문자열 조회
    System.out.println(teamName); // 팀 이름 출력
}
getWithJPQL2("둘리")는@Query를 사용한다.
select m.team.name from Member m where m.username = :un은 회원 이름이둘리인Member를 찾고, 그 회원이 속한Team의name값만 선택한다.
그래서 반환 타입이String이다.
엔티티가 아니라 팀 이름 문자열 하나만 가져오기 때문이다.
test4()는getWithJPQL2("둘리")를 실행한 결과이다.
JPQL에서m.team.name값만 직접 선택하므로, 전체Member가 아니라 팀 이름 문자열인아기공룡둘리만 출력된다.
프로젝션과 문자열 조회 차이
getByUsername()은 프로젝션 인터페이스인TeamName으로 결과를 받는다.getWithJPQL2()는JPQL에서 팀 이름 값 하나만 선택하고String으로 받는다.- 두 방식 모두 전체
Member객체를 출력하지 않는다.- 필요한 값이 팀 이름 하나라면 전체 엔티티 조회보다 값 조회가 더 목적에 맞다.
프로젝션과 값 조회는 전체 엔티티를 다루는 것이 아니라, 필요한 결과만 읽어오는 데 초점이 있다.
전체 엔티티 조회와 값 조회를 구분하기
이 예제에서 꼭 구분해야 하는 것은 전체 엔티티 조회와 값 조회이다.
test1()과test2()는 조건에 맞는Member목록을 조회한다.
반환 타입이List<Member>이므로 결과는 회원 객체 목록이다.
반면test3()과test4()는 팀 이름만 확인한다.
test3()은TeamName프로젝션을 사용하고,test4()는String으로 값을 받는다.
둘 다 결과의 목적은 전체 회원 객체가 아니라 팀 이름 값이다.
조회 목적에 따른 반환 타입
- 회원 목록이 필요하면
List<Member>를 사용한다.- 필요한 값만 뽑고 싶으면 프로젝션 인터페이스를 사용할 수 있다.
- 값 하나만 직접 선택하면
String같은 단순 타입으로 받을 수 있다.- 반환 타입은 조회 목적과 맞아야 한다.
예를 들어 회원 목록 화면을 만들려면
Member목록이 필요할 수 있다.
하지만 회원 이름을 입력했을 때 팀 이름만 보여 주는 기능이라면Member전체를 가져올 필요가 없다.
이런 경우에는 프로젝션이나 값 조회가 더 자연스럽다.
조회할 때는 “무엇을 조건으로 찾는가”뿐만 아니라 “무엇을 결과로 받을 것인가”도 함께 정해야 한다.
이 예제에서 확인해야 하는 핵심
응용예제 6은
Member와Team의 연관관계를 조건 조회와 결과 조회에 사용하는 예제이다.
앞 예제에서는 연관 엔티티를 함께 가져오는fetch join을 확인했다.
이번에는 연관 엔티티의 필드인team.name을 조건과 결과로 사용하는 흐름을 확인했다.
조건 조회 핵심
findByTeamName()은 쿼리 메서드로 팀 이름 조건 조회를 한다.getWithJPQL1()은JPQL로 팀 이름 조건 조회를 한다.- 두 메서드는 모두
Member가 참조하는Team의name값을 조건으로 사용한다.결과 조회 핵심
getByUsername()은 회원 이름으로 조회하고TeamName프로젝션 결과를 받는다.getWithJPQL2()는 회원 이름으로 조회하고 팀 이름 문자열만 직접 받는다.- 전체
Member가 필요하지 않으면 필요한 값만 조회하는 방식도 사용할 수 있다.정리하면, 연관관계는 단순히 객체를 연결하는 데서 끝나지 않는다.
Member에서Team으로 이어지는 경로를 조건으로 사용할 수도 있고, 그 경로의 값만 결과로 받을 수도 있다.
핵심은Member.team.name처럼 연관 객체의 필드를 따라가며 조건 조회와 값 조회를 할 수 있다는 점이다.
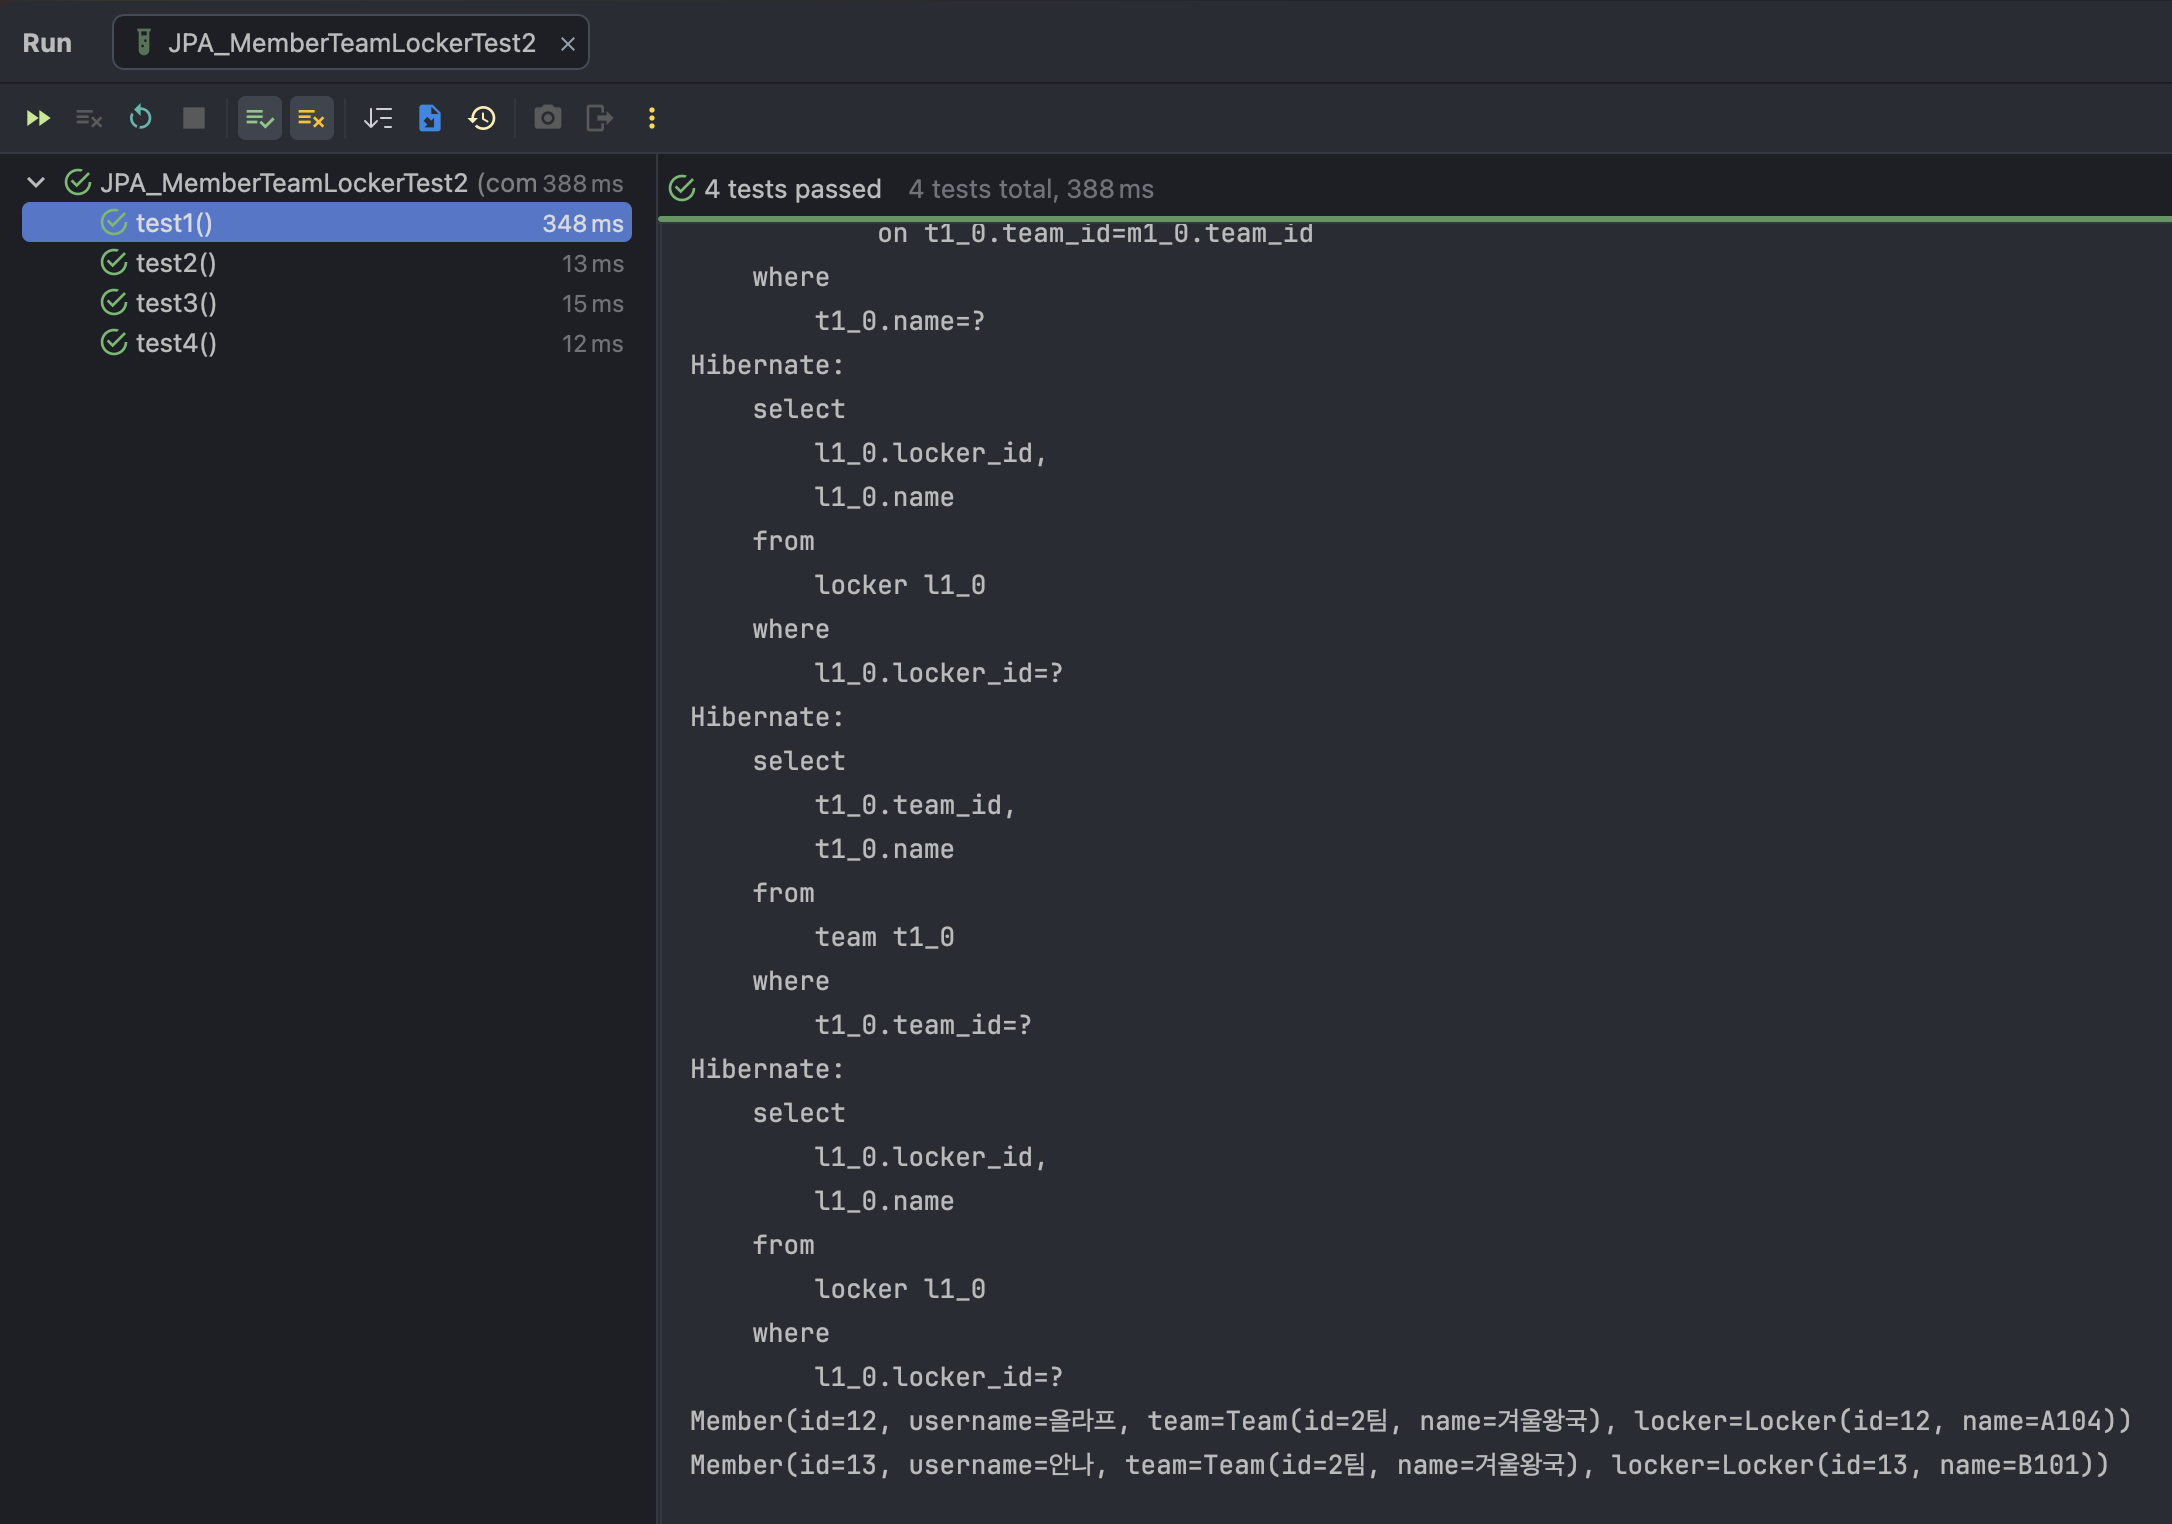
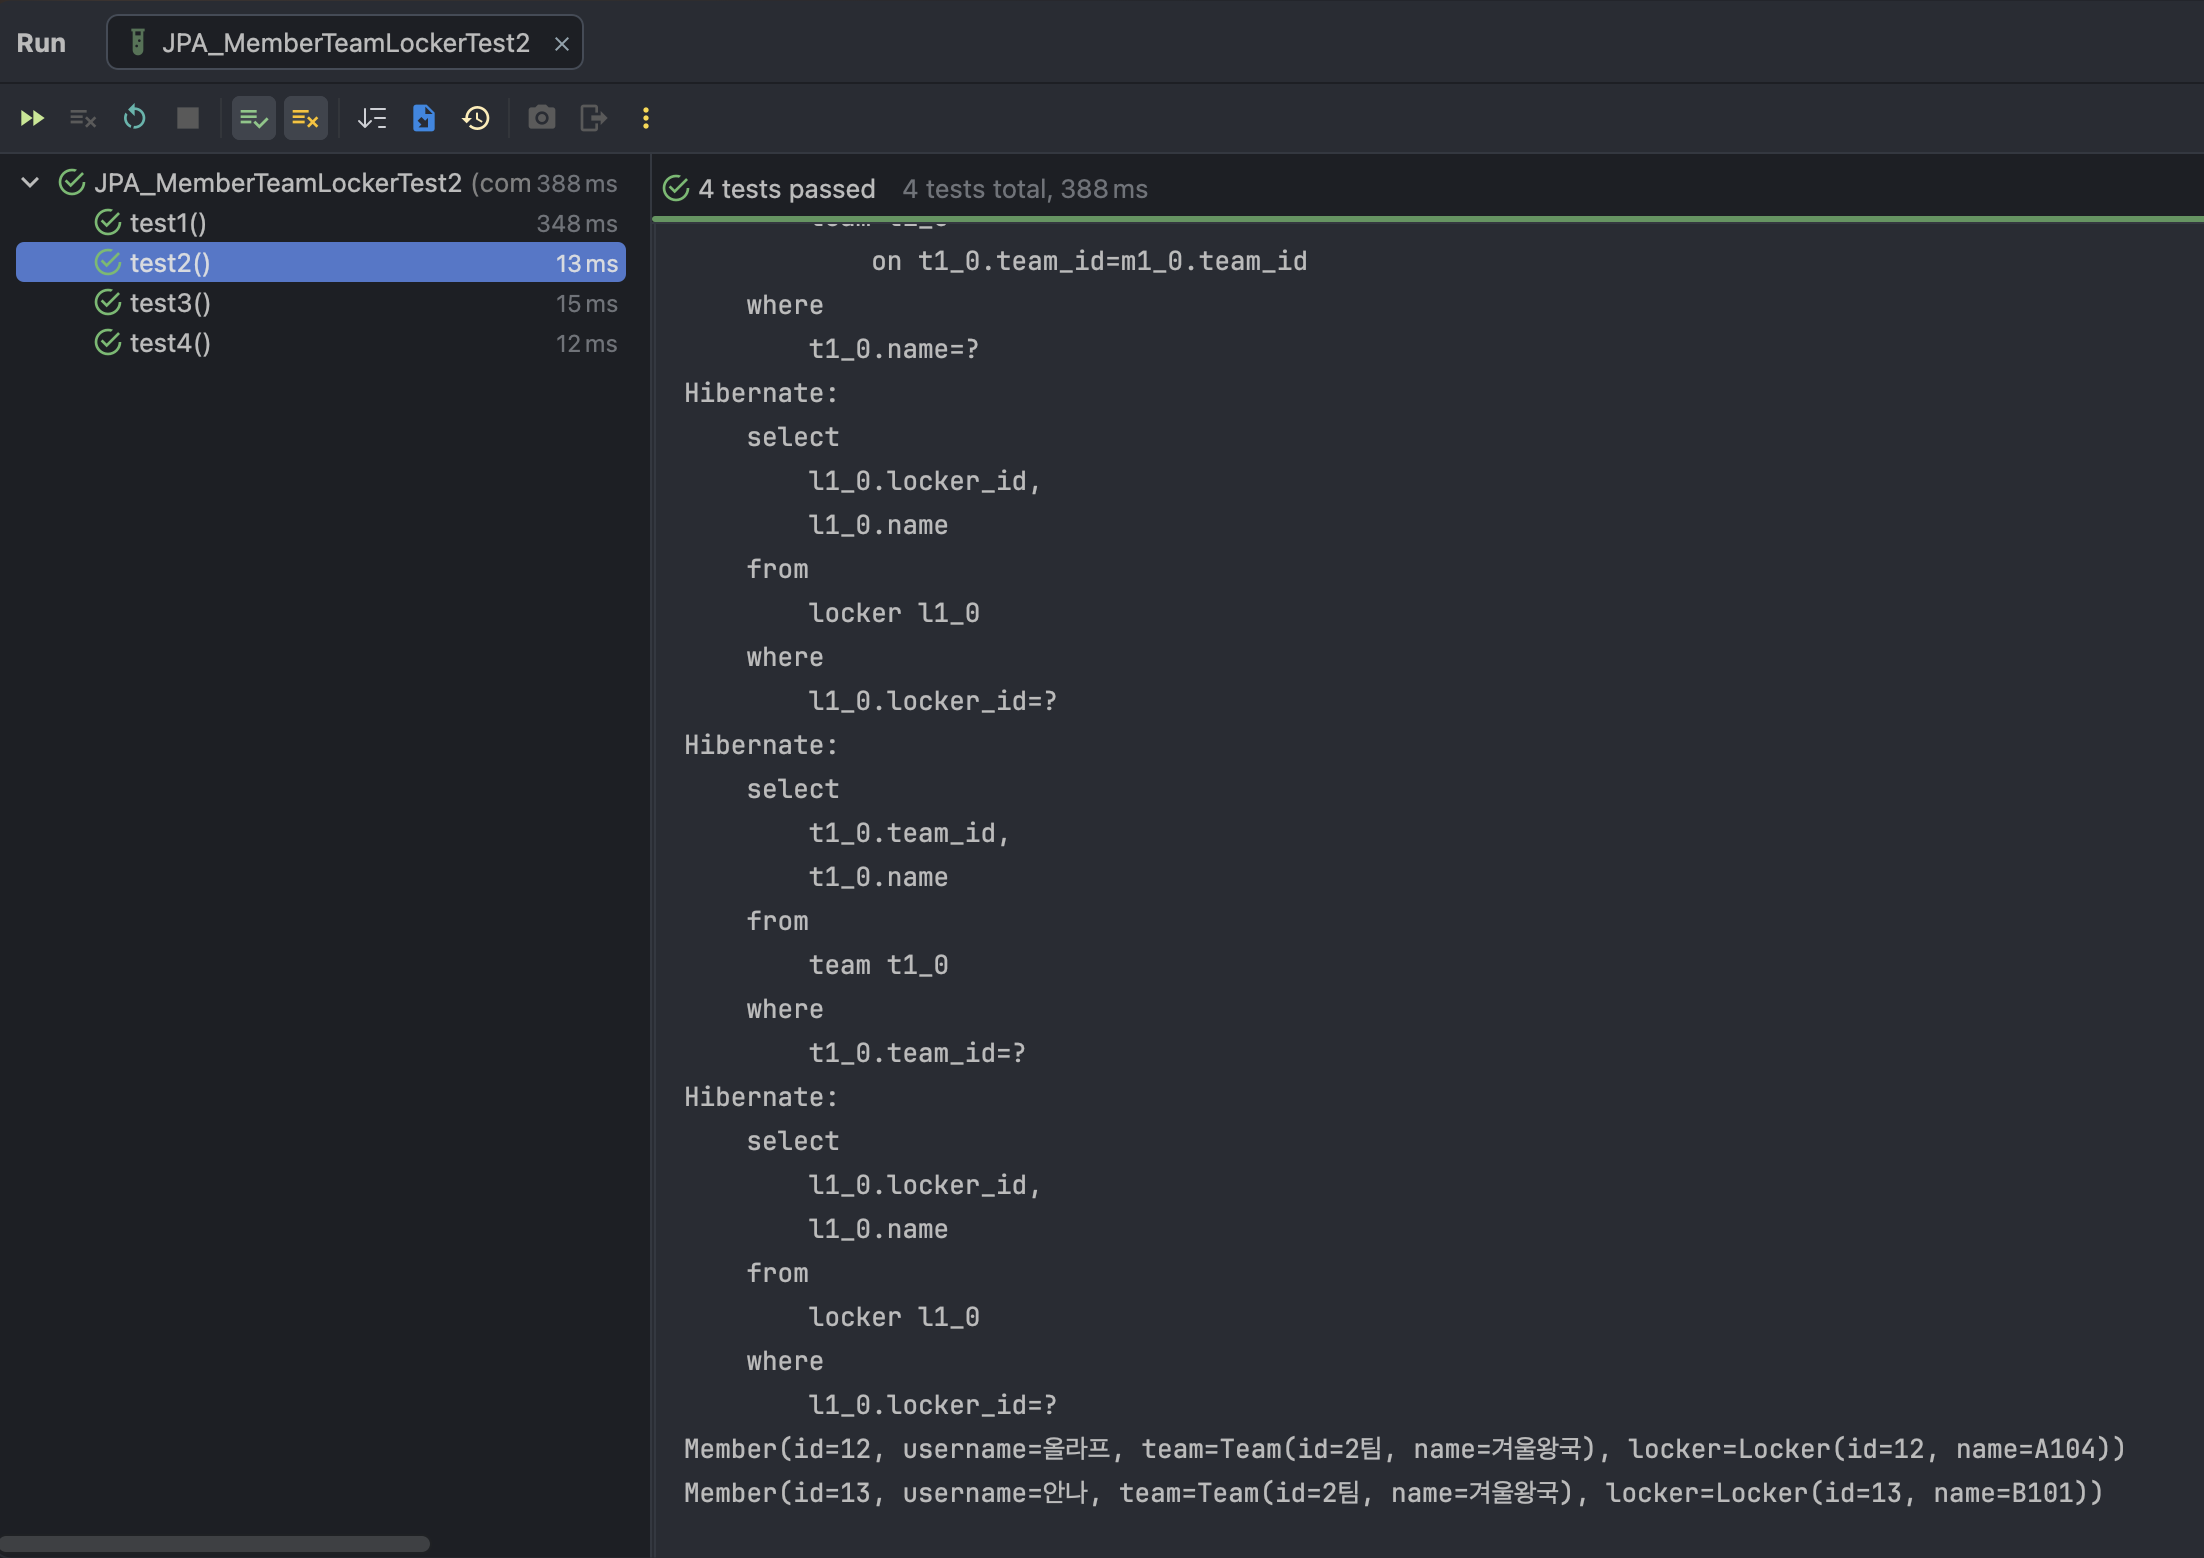
응용예제 7. 전체 회원 출력 방식과 사물함 이름 조건 조회 (Member.java, Team.java, Locker.java, MemberTeamLockerRepository.java, JPA_MemberTeamLockerTest3.java)
앞 예제에서는
Member와Team의 연관관계를 조건 조회와 프로젝션 조회에 사용했다.
이번 예제에서는 같은Member목록을 출력하더라도 출력 방식에 따라 결과를 보는 관점이 어떻게 달라지는지 확인한다.
또한Member가 직접 가진 필드가 아니라,Member가 참조하는Locker의name값을 조건으로 회원을 찾는 흐름도 확인한다.
앞에서는Team의name을 조건으로 사용했다.
이번에는Locker의name을 조건으로 사용한다.
전체 흐름은 테스트 코드 실행 →MemberTeamLockerRepository메서드 호출 →Member조회 → 연결된Team,Locker정보 확인 → 콘솔 출력 순서로 이어진다.
이 예제의 핵심은 연관 객체를 출력하는 방식과, 연관 객체의 필드를 조건으로 조회하는 방식을 구분해서 이해하는 것이다.
앞 개념과 연결해서 보기
Member는Team과Locker를 필드로 가진다.
객체 기준으로 보면Member안에Team객체와Locker객체가 연결되어 있는 구조이다.
앞 예제에서는Team의name값을 기준으로 회원을 조회했다.
이번 예제에서는Locker의name값을 기준으로 회원을 조회한다.
즉,Member자신의 필드가 아니라Member가 참조하는 다른 엔티티의 필드를 따라가서 조건을 만든다.
예를 들어getByLockerName("B101")은Member안에lockerName이라는 필드가 있다는 뜻이 아니다.
실제로는Member가 가진locker객체로 이동한 뒤, 그Locker의name값이B101인지 확인하는 조건이다.
이번 예제에서 확인할 개념
Member는Team과Locker를 참조한다.findAll()은 전체Member목록을 조회한다.- 같은
findAll()결과라도 객체 전체를 출력할 수도 있고, 필요한 필드만 골라 출력할 수도 있다.getByLockerName()은 연결된Locker의name값을 조건으로 사용한다.getTeam().getName(),getLocker().getName()처럼 연관 객체의 값을 꺼낼 수 있다.연관관계가 있으면 조회 조건뿐만 아니라 출력 방식에서도 연결된 객체의 값을 사용할 수 있다.
Repository 메서드 구조 확인하기
이번 예제에서 직접 사용하는 새 메서드는
getByLockerName()이다.
이 메서드는MemberTeamLockerRepository에 선언되어 있다.// MemberTeamLockerRepository.java package com.example.springjpaedu.repository; import com.example.springjpaedu.entity.Member; import org.springframework.data.jpa.repository.JpaRepository; import org.springframework.data.jpa.repository.Query; import org.springframework.data.repository.query.Param; import java.util.List; public interface MemberTeamLockerRepository extends JpaRepository<Member, Integer>{ @Query("select m from Member m ") public List<Member> getAllData(); // Member 전체 조회 @Query("select m from Member m join fetch m.team join fetch m.locker") public List<Member> getAllDataFetchJoin(); // Team, Locker까지 함께 조회 @Query("select m from Member m where m.team.name = :tn") public List<Member> getWithJPQL1(@Param("tn") String tname); // 팀 이름 조건 조회 public List<Member> findByTeamName(String name); // 팀 이름 조건 쿼리 메서드 조회 @Query("select m.team.name from Member m where m.username = :un") public String getWithJPQL2(@Param("un") String username); // 회원 이름으로 팀 이름 조회 public TeamName getByUsername(String username); // 회원 이름으로 팀 이름 프로젝션 조회 public Member getByLockerName(String lname); // 사물함 이름으로 회원 조회 public List<Member> findByUsername(String username); // 회원 이름 기준 목록 조회 public Long countByUsername(String username); // 회원 이름 기준 개수 조회 }
getByLockerName(String lname)은 쿼리 메서드이다.
메서드 이름을 분석해서 조건 조회를 만든다.
여기서LockerName은Member의 직접 필드명이 아니다.
Member의locker필드로 이동한 뒤,Locker의name필드를 조건으로 사용한다는 의미이다.
반환 타입은Member이다.
사물함 이름 하나에 해당하는 회원 한 명을 조회하는 구조로 사용한다.
여러 명이 나올 수 있는 조건이라면List<Member>가 더 자연스럽지만, 이 예제에서는B101사물함을 사용하는 회원 하나를 찾는 흐름이다.
getByLockerName 읽는 방법
get은 조회한다는 의미이다.By뒤에는 조회 조건이 온다.LockerName은locker.name경로를 의미한다.- 결과는 조건에 맞는
Member객체이다.쿼리 메서드에서 연관 객체의 필드를 조건으로 사용할 때는 메서드 이름을 객체 경로처럼 끊어 읽어야 한다.
테스트 코드 구조 확인하기
JPA_MemberTeamLockerTest3은 세 가지 테스트를 가진다.
첫 번째와 두 번째는 전체 회원 목록을 출력하는 방식의 차이를 보여 준다.
세 번째는 사물함 이름으로 회원을 조회한다.// JPA_MemberTeamLockerTest3.java package com.example.springjpaedu; import com.example.springjpaedu.entity.Member; import com.example.springjpaedu.repository.MemberTeamLockerRepository; import org.junit.jupiter.api.AfterAll; import org.junit.jupiter.api.BeforeEach; import org.junit.jupiter.api.Test; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.boot.jdbc.test.autoconfigure.AutoConfigureTestDatabase; import org.springframework.boot.data.jpa.test.autoconfigure.DataJpaTest; import java.util.List; @AutoConfigureTestDatabase(replace = AutoConfigureTestDatabase.Replace.NONE) // 실제 DB 설정 사용 @DataJpaTest // JPA Repository 테스트 환경 준비 public class JPA_MemberTeamLockerTest3 { @Autowired // Repository 구현체 주입 private MemberTeamLockerRepository repo; @BeforeEach // 각 테스트 실행 전 구분선 출력 void pr() { System.out.println("=".repeat(80)); } @Test void test_findAll1() { List<Member> list = repo.findAll(); // 전체 회원 조회 list.stream().forEach(System.out::println); // Member 객체 전체 출력 } @Test void test_findAll2() { List<Member> list = repo.findAll(); // 전체 회원 조회 for(Member m : list) { // 회원을 하나씩 꺼냄 System.out.print(m.getUsername()+", "); // 회원 이름 출력 System.out.print(m.getTeam() != null ? m.getTeam().getName()+", ": "없음, "); // 팀 이름 또는 없음 출력 System.out.println(m.getLocker() != null ? m.getLocker().getName() : "없음"); // 사물함 이름 또는 없음 출력 } } @Test void test_findByLockerName() { Member member = repo.getByLockerName("B101"); // B101 사물함을 사용하는 회원 조회 System.out.printf("B101 락커를 사용하는 회원은 %s팀 소속의 %s입니다\n", member.getTeam().getName(), member.getUsername()); // 조회 결과 출력 } @AfterAll // 모든 테스트 종료 후 실행 static void end() { System.out.println("=".repeat(80)); System.out.println("[[[[[[ 테스트 종료 ]]]]]]"); } }
test_findAll1()과test_findAll2()는 둘 다repo.findAll()을 사용한다.
조회하는 데이터는 같다.
하지만 출력하는 방식이 다르다.
test_findAll1()은Member객체 전체를 그대로 출력한다.
@ToString에 의해id,username,team,locker정보가 한 번에 문자열로 보인다.
test_findAll2()는Member객체 전체를 그대로 출력하지 않는다.
반복문 안에서username,team.name,locker.name처럼 필요한 값만 직접 꺼내 출력한다.
test_findByLockerName()은 사물함 이름이B101인 회원을 찾는다.
조회 결과로 받은Member에서 다시Team과username을 꺼내 문장 형태로 출력한다.
테스트 메서드별 의미
test_findAll1()은 전체Member객체를 그대로 출력한다.test_findAll2()는 전체 회원을 조회한 뒤 필요한 필드만 골라 출력한다.test_findByLockerName()은Locker의name값으로 회원을 조회한다.같은 데이터를 조회해도 출력 방식에 따라 결과를 읽는 느낌이 달라진다.
객체 전체 출력은 구조 확인에 좋고, 필요한 값만 출력하는 방식은 사용자에게 보여 줄 문장을 만들 때 더 적합하다.
전체 객체 그대로 출력하기
먼저
test_findAll1()을 확인한다.
이 테스트는findAll()로 전체 회원을 조회하고,Member객체를 그대로 출력한다.// JPA_MemberTeamLockerTest3.java @Test void test_findAll1() { List<Member> list = repo.findAll(); // 전체 회원 조회 list.stream().forEach(System.out::println); // Member 객체 전체 출력 }
repo.findAll()은JpaRepository가 제공하는 기본 전체 조회 메서드이다.
결과는List<Member>로 반환된다.
list.stream().forEach(System.out::println)은 목록 안의Member객체를 하나씩 출력한다.
이때 출력되는 모양은Member클래스의@ToString결과에 가깝다.
그래서 회원 번호, 회원 이름, 연결된 팀, 연결된 사물함 정보가 한 줄에 함께 보일 수 있다.
이 방식은 객체 구조를 한눈에 확인하기 좋다.
다만 실제 화면이나 사용자 안내 문구로 쓰기에는 정보가 많고 딱딱해 보일 수 있다.
test_findAll1()은findAll()로 전체Member를 조회한 뒤 객체 전체를 그대로 출력한다.
출력 결과에는 회원 이름뿐만 아니라 연결된Team,Locker객체 정보가 함께 보인다.
필요한 값만 골라 출력하기
이번에는
test_findAll2()를 확인한다.
이 테스트도findAll()로 전체 회원을 조회한다.
하지만 출력할 때는 객체 전체를 그대로 출력하지 않고, 필요한 값만 꺼내서 출력한다.// JPA_MemberTeamLockerTest3.java @Test void test_findAll2() { List<Member> list = repo.findAll(); // 전체 회원 조회 for(Member m : list) { // 회원을 하나씩 꺼냄 System.out.print(m.getUsername()+", "); // 회원 이름 출력 System.out.print(m.getTeam() != null ? m.getTeam().getName()+", ": "없음, "); // 팀 이름 또는 없음 출력 System.out.println(m.getLocker() != null ? m.getLocker().getName() : "없음"); // 사물함 이름 또는 없음 출력 } }
for(Member m : list)는list안에 있는Member객체를 하나씩 꺼내는 반복문이다.
꺼낸 회원은m이라는 이름으로 사용한다.
m.getUsername()은 회원 이름을 꺼낸다.
m.getTeam().getName()은 회원이 속한 팀 객체로 이동한 뒤 팀 이름을 꺼낸다.
m.getLocker().getName()은 회원이 사용하는 사물함 객체로 이동한 뒤 사물함 이름을 꺼낸다.
여기서 삼항 연산자가 사용된다.
삼항 연산자는 조건에 따라 두 값 중 하나를 선택하는 문법이다.
조건 ? 참일 때 값 : 거짓일 때 값형태로 읽는다.
m.getTeam() != null ? m.getTeam().getName()+", " : "없음, "은 팀 정보가 있으면 팀 이름을 출력하고, 팀 정보가 없으면없음을 출력한다.
m.getLocker() != null ? m.getLocker().getName() : "없음"도 같은 방식이다.
null 검사가 필요한 이유
- 모든 회원에게 팀이 있을 수도 있지만, 없을 수도 있다.
- 모든 회원에게 사물함이 있을 수도 있지만, 없을 수도 있다.
null인 객체에서.getName()을 호출하면 오류가 날 수 있다.- 그래서 먼저
null인지 확인한 뒤 값을 꺼낸다.이 출력 방식은 객체 전체를 보여 주는 것이 아니라, 사람이 읽기 쉬운 형태로 필요한 값만 보여 준다.
조회 결과를 어떻게 출력할지는 조회 목적에 따라 달라진다.
test_findAll2()는 전체Member를 조회한 뒤 회원 이름, 팀 이름, 사물함 이름만 골라 출력한다.
객체 전체를 그대로 보여 주는 것이 아니라,getter를 사용해 필요한 값만 꺼내는 방식이다.
사물함 이름으로 회원 조회하기
이번에는
test_findByLockerName()을 확인한다.
이 테스트는 전체 목록을 조회하는 것이 아니라, 특정 사물함 이름을 사용하는 회원 한 명을 조회한다.// JPA_MemberTeamLockerTest3.java @Test void test_findByLockerName() { Member member = repo.getByLockerName("B101"); // B101 사물함을 사용하는 회원 조회 System.out.printf("B101 락커를 사용하는 회원은 %s팀 소속의 %s입니다\n", member.getTeam().getName(), member.getUsername()); // 조회 결과 출력 }
repo.getByLockerName("B101")은 사물함 이름이B101인 회원을 조회한다.
조건은Member의 직접 필드가 아니라 연결된Locker의name필드이다.
조회 결과는Member객체 하나로 받는다.
그 다음member.getTeam().getName()으로 팀 이름을 꺼내고,member.getUsername()으로 회원 이름을 꺼낸다.
출력 문장은printf()로 만든다.
printf()는 문자열 안에 값을 끼워 넣어 출력할 수 있는 메서드이다.
%s는 문자열 값이 들어갈 자리이다.
첫 번째%s자리에는 팀 이름이 들어가고, 두 번째%s자리에는 회원 이름이 들어간다.
getByLockerName 흐름
B101이라는 사물함 이름을 조건으로 전달한다.Member가 참조하는Locker의name값과 비교한다.- 조건에 맞는
Member를 조회한다.- 조회된
Member에서 팀 이름과 회원 이름을 꺼낸다.- 문장 형태로 콘솔에 출력한다.
getByLockerName("B101")은Locker의name값이B101인 회원을 조회한다.
조회된Member에서 팀 이름과 회원 이름을 꺼내면겨울왕국팀 소속의안나라는 결과를 확인할 수 있다.
객체 전체 출력과 필요한 값 출력 구분하기
이번 예제에서 가장 먼저 구분해야 할 것은 조회와 출력이다.
test_findAll1()과test_findAll2()는 모두findAll()을 사용한다.
즉, 데이터베이스에서 가져오는 대상은 전체Member목록으로 같다.
하지만 출력 방식은 다르다.
test_findAll1()은 객체 전체를 출력한다.
그래서 구조를 확인하기 좋다.
반면test_findAll2()는 필요한 값만 직접 꺼내 출력한다.
그래서 결과가 더 읽기 쉬운 형태가 된다.
두 출력 방식의 차이
- 객체 전체 출력은 엔티티 구조를 확인하기 좋다.
- 필요한 값 출력은 사용자에게 보여 줄 문장을 만들기 좋다.
- 객체 전체 출력은
@ToString결과에 의존한다.- 필요한 값 출력은
getter를 사용해 원하는 값만 꺼낸다.- 연관 객체가 없을 수 있으면
null검사가 필요하다.같은 조회 결과라도 어떻게 출력하느냐에 따라 복습 포인트가 달라진다.
객체 구조를 확인할 때는 전체 출력이 좋고, 원하는 정보만 확인할 때는 필드 값을 직접 꺼내는 방식이 좋다.
이 예제에서 확인해야 하는 핵심
응용예제 7은
Member,Team,Locker연관관계에서 전체 출력, 필요한 값 출력, 사물함 이름 조건 조회를 확인하는 예제이다.
앞 예제에서 팀 이름을 조건과 결과로 사용했다면, 이번 예제에서는 사물함 이름을 조건으로 사용한다.
출력 방식 핵심
test_findAll1()은Member객체 전체를 출력한다.test_findAll2()는username,team.name,locker.name만 골라 출력한다.- 연관 객체가
null일 수 있으면 먼저null검사를 해야 한다.조건 조회 핵심
getByLockerName()은Locker의name값을 조건으로 사용한다.B101사물함을 사용하는 회원을 조회한다.- 조회된
Member에서 다시Team과username값을 꺼내 출력한다.정리하면, 연관관계는 조회 조건을 만들 때도 쓰이고, 조회 결과를 출력할 때도 쓰인다.
핵심은Member에서Team,Locker로 이어지는 객체 경로를 이해하고, 필요한 값만 정확히 꺼내는 것이다.
응용예제 8. 회원 이름 조회와 개수 조회 (Member.java, MemberTeamLockerRepository.java, JPA_MemberTeamLockerTest4.java)
앞 예제에서는
Member가 참조하는Team,Locker의 필드를 조건으로 조회했다.
이번 예제에서는 다시Member자신의 필드인username을 기준으로 조회하고, 조건에 맞는 데이터 개수를 구하는 흐름을 확인한다.
이전 예제들이 연관 객체의 필드를 따라가는 조회였다면, 이번 예제는 더 기본적인 조회 방식으로 돌아온다.
Member의username값이 특정 이름과 같은 데이터를 찾고, 그 이름을 가진 회원이 몇 명인지 확인한다.
전체 흐름은 테스트 코드 실행 →MemberTeamLockerRepository메서드 호출 → 이름 조건 조회 또는 개수 조회 → 콘솔 출력 순서로 이어진다.
이 예제의 핵심은findByUsername(),countByUsername(),count()의 차이를 구분하는 것이다.
앞 개념과 연결해서 보기
앞에서 쿼리 메서드는 메서드 이름을 보고 조회 조건을 만든다고 정리했다.
예를 들어findByTeamName()은Team의name값을 조건으로 사용했다.
getByLockerName()은Locker의name값을 조건으로 사용했다.
이번에는findByUsername()을 사용한다.
username은Member엔티티가 직접 가지고 있는 필드이다.
따라서 연관 객체를 따라갈 필요 없이Member.username값을 기준으로 조회한다.
또 이번 예제에서는count계열 메서드도 사용한다.
count는 데이터를 가져오는 것이 아니라 개수를 구하는 기능이다.
즉, 회원 목록 자체가 필요한 상황과 회원 수만 필요한 상황을 구분해야 한다.
이번 예제에서 확인할 개념
findByUsername()은 회원 이름 조건으로Member목록을 조회한다.countByUsername()은 특정 회원 이름을 가진 데이터 개수를 구한다.count()는 전체Member데이터 개수를 구한다.- 조회 결과가 필요하면
findBy...를 사용한다.- 개수만 필요하면
count...를 사용한다.같은 조건을 사용하더라도 결과 목록이 필요한지, 개수만 필요한지에 따라 사용하는 메서드가 달라진다.
Repository 메서드 구조 확인하기
이번 예제에서 사용하는 메서드는
MemberTeamLockerRepository에 선언된findByUsername(),countByUsername()이다.
그리고count()는JpaRepository가 기본으로 제공하는 메서드이므로 따로 선언하지 않아도 사용할 수 있다.// MemberTeamLockerRepository.java package com.example.springjpaedu.repository; import com.example.springjpaedu.entity.Member; import org.springframework.data.jpa.repository.JpaRepository; import java.util.List; public interface MemberTeamLockerRepository extends JpaRepository<Member, Integer>{ public List<Member> findByUsername(String username); // 회원 이름 기준 목록 조회 public Long countByUsername(String username); // 회원 이름 기준 개수 조회 }
findByUsername(String username)은username값이 매개변수와 같은Member목록을 조회한다.
반환 타입은List<Member>이다.
이름이 같은 회원이 여러 명 있을 수 있으므로 목록으로 받는다.
countByUsername(String username)은username값이 매개변수와 같은 데이터의 개수를 구한다.
반환 타입은Long이다.
조회된 회원 객체 목록이 아니라 개수 숫자만 필요하기 때문이다.
count()는JpaRepository에 이미 들어 있는 기본 메서드이다.
전체 데이터 개수를 구할 때 사용한다.
따라서MemberTeamLockerRepository에 직접 선언하지 않아도repo.count()처럼 호출할 수 있다.
메서드별 역할 정리
findByUsername()은 조건에 맞는Member목록을 가져온다.countByUsername()은 조건에 맞는Member개수만 가져온다.count()는 전체Member개수를 가져온다.
find는 데이터 자체를 가져오는 흐름이고,count는 데이터의 개수만 가져오는 흐름이다.
테스트 코드 구조 확인하기
JPA_MemberTeamLockerTest4는 회원 이름 조회와 개수 조회를 확인하는 테스트 클래스이다.
화면이 아니라 콘솔에서 결과를 확인한다.// JPA_MemberTeamLockerTest4.java package com.example.springjpaedu; import com.example.springjpaedu.entity.Member; import com.example.springjpaedu.repository.MemberTeamLockerRepository; import org.junit.jupiter.api.AfterAll; import org.junit.jupiter.api.BeforeEach; import org.junit.jupiter.api.Test; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.boot.jdbc.test.autoconfigure.AutoConfigureTestDatabase; import org.springframework.boot.data.jpa.test.autoconfigure.DataJpaTest; import java.util.List; @AutoConfigureTestDatabase(replace = AutoConfigureTestDatabase.Replace.NONE) // 실제 DB 설정 사용 @DataJpaTest // JPA Repository 테스트 환경 준비 public class JPA_MemberTeamLockerTest4 { @Autowired // Repository 구현체 주입 private MemberTeamLockerRepository repo; @BeforeEach // 각 테스트 실행 전 구분선 출력 void pr() { System.out.println("=".repeat(80)); } @Test void test_byUsername() { List<Member> list = repo.findByUsername("짱아"); // username이 짱아인 회원 조회 list.stream().forEach(m -> { // 조회된 회원을 하나씩 꺼냄 System.out.println(m.getId()); // 회원 번호 출력 System.out.println(m.getUsername()); // 회원 이름 출력 System.out.println(m.getTeam()); // 연결된 팀 출력 }); } @Test void test_countByUsername() { Long count = repo.countByUsername("짱아"); // username이 짱아인 회원 수 조회 System.out.println("짱아는 " + count + "명"); // 조건에 맞는 개수 출력 } @Test void test_countBy() { Long count = repo.count(); // 전체 회원 수 조회 System.out.println("전체 회원은 " + count + "명"); // 전체 개수 출력 } @AfterAll // 모든 테스트 종료 후 실행 static void end() { System.out.println("=".repeat(80)); System.out.println("[[[[[[ 테스트 종료 ]]]]]]"); } }
test_byUsername()은findByUsername("짱아")를 호출한다.
회원 이름이짱아인Member데이터를 목록으로 가져온다.
조회 결과는List<Member>로 받지만, 출력할 때는Member객체 전체를 그대로 출력하지 않는다.
id,username,team값을 각각 꺼내 출력한다.
test_countByUsername()은countByUsername("짱아")를 호출한다.
회원 이름이짱아인 데이터가 몇 개인지만 구한다.
결과는 회원 목록이 아니라 숫자이다.
test_countBy()는repo.count()를 호출한다.
조건 없이 전체Member데이터 개수를 구한다.
테스트 메서드별 의미
test_byUsername()은 이름이짱아인 회원 목록을 조회한 뒤 필요한 값을 각각 출력한다.test_countByUsername()은 이름이짱아인 회원 수를 조회한다.test_countBy()는 전체 회원 수를 조회한다.이 세 테스트는 모두
Member데이터를 대상으로 한다.
하지만 하나는 목록 조회이고, 나머지 두 개는 개수 조회이다.
회원 이름으로 목록 조회하기
먼저
test_byUsername()을 확인한다.
이 테스트는username값이짱아인 회원을 조회한다.// JPA_MemberTeamLockerTest4.java @Test void test_byUsername() { List<Member> list = repo.findByUsername("짱아"); // username이 짱아인 회원 조회 list.stream().forEach(m -> { // 조회된 회원을 하나씩 꺼냄 System.out.println(m.getId()); // 회원 번호 출력 System.out.println(m.getUsername()); // 회원 이름 출력 System.out.println(m.getTeam()); // 연결된 팀 출력 }); }
findByUsername("짱아")는 메서드 이름으로 조건을 만든다.
findBy뒤의Username은Member엔티티의username필드를 의미한다.
즉,where username = '짱아'와 같은 조건으로 이해할 수 있다.
반환 타입은List<Member>이다.
회원 이름이 같은 데이터가 여러 개 있을 수도 있기 때문이다.
그래서 결과를 하나의Member가 아니라 목록으로 받는다.
조회된 결과는Member목록으로 받는다.
다만 출력할 때는Member객체 전체를 그대로 출력하지 않고,id,username,team값을 각각 꺼내 출력한다.
이렇게 하면 객체 전체 문자열보다 현재 확인하려는 값이 더 분명하게 보인다.
findByUsername("짱아")는Member의username값이짱아인 회원 목록을 조회한다.
출력 결과에서는 조회된 회원의id,username, 연결된Team정보가 각각 출력된다.
회원 이름으로 개수 조회하기
이번에는
test_countByUsername()을 확인한다.
이 테스트는 이름이짱아인 회원 데이터를 가져오는 것이 아니라, 몇 개인지만 구한다.// JPA_MemberTeamLockerTest4.java @Test void test_countByUsername() { Long count = repo.countByUsername("짱아"); // username이 짱아인 회원 수 조회 System.out.println("짱아는 " + count + "명"); // 조건에 맞는 개수 출력 }
countByUsername("짱아")는username값이짱아인 데이터의 개수를 구한다.
countBy뒤에 조건 필드가 붙어 있으므로, 조건에 맞는 행의 개수를 계산한다.
반환 타입은Long이다.
회원 객체를 가져오는 것이 아니라 숫자 결과를 가져오기 때문이다.
이 메서드는 목록을 보여 줄 필요가 없고 개수만 필요할 때 사용한다.
예를 들어 특정 이름을 가진 회원이 몇 명인지 확인하고 싶을 때 적합하다.
findByUsername과 countByUsername 차이
findByUsername()은 조건에 맞는Member목록을 반환한다.countByUsername()은 조건에 맞는 데이터 개수만 반환한다.- 결과를 출력하면
findByUsername()은 조회된 회원의 값을 확인할 수 있다.- 결과를 출력하면
countByUsername()은 숫자만 보인다.
countByUsername("짱아")는username값이짱아인 회원이 몇 명인지 개수만 조회한다.
결과는 회원 객체가 아니라1명이라는 숫자이다.
전체 회원 수 조회하기
마지막으로
test_countBy()를 확인한다.
이 테스트는 조건 없이 전체Member데이터 개수를 구한다.// JPA_MemberTeamLockerTest4.java @Test void test_countBy() { Long count = repo.count(); // 전체 회원 수 조회 System.out.println("전체 회원은 " + count + "명"); // 전체 개수 출력 }
repo.count()는JpaRepository가 제공하는 기본 메서드이다.
조건 없이 현재Member테이블에 있는 전체 데이터 개수를 구한다.
countByUsername()은 이름 조건이 있는 개수 조회이다.
반면count()는 조건이 없는 전체 개수 조회이다.
이 차이를 구분해야 한다.
반환 타입은 마찬가지로Long이다.
데이터 목록이 아니라 개수 숫자만 반환하기 때문이다.
countByUsername과 count 차이
countByUsername("짱아")는 이름이짱아인 회원 수만 구한다.count()는 전체 회원 수를 구한다.- 둘 다 결과는 숫자이다.
- 차이는 조건이 있는지 없는지이다.
count()는 조건 없이 전체Member데이터 개수를 조회한다.
결과로 전체 회원 수가8명임을 확인할 수 있다.
목록 조회와 개수 조회 구분하기
이번 예제에서 가장 중요한 구분은 목록 조회와 개수 조회이다.
목록 조회는 조건에 맞는 데이터 자체가 필요할 때 사용한다.
개수 조회는 데이터 내용이 아니라 몇 개인지만 필요할 때 사용한다.
findByUsername("짱아")는짱아라는 이름을 가진 회원 데이터를 가져온다.
그래서 결과를 출력하면 조회된 회원의id,username,Team정보를 확인할 수 있다.
countByUsername("짱아")는 같은 조건을 사용하지만, 결과는 개수이다.
그래서 출력하면 숫자만 보인다.
count()는 조건조차 없다.
전체Member데이터가 몇 개인지만 확인한다.
조회 목적에 따른 메서드 선택
- 데이터 목록이 필요하면
findBy...를 사용한다.- 조건에 맞는 개수만 필요하면
countBy...를 사용한다.- 전체 개수만 필요하면
count()를 사용한다.조회 메서드를 고를 때는 조건뿐만 아니라 결과로 목록이 필요한지, 숫자만 필요한지도 함께 생각해야 한다.
이 예제에서 확인해야 하는 핵심
응용예제 8은
Member의username필드를 기준으로 목록 조회와 개수 조회를 구분하는 예제이다.
앞 예제에서는 연관 객체의 필드를 조건으로 사용했다.
이번 예제에서는Member자신의 필드를 기준으로 조건 조회와 개수 조회를 확인한다.
이름 조건 조회 핵심
findByUsername("짱아")는 이름이짱아인Member목록을 조회한다.- 반환 타입은
List<Member>이다.- 결과에서는 조회된 회원의
id,username,Team정보를 확인한다.개수 조회 핵심
countByUsername("짱아")는 이름이짱아인 회원 수를 조회한다.count()는 전체 회원 수를 조회한다.- 두 메서드 모두 결과는 숫자이다.
정리하면,
findByUsername(),countByUsername(),count()는 모두Member데이터를 대상으로 하지만 목적이 다르다.
핵심은find는 목록 조회,count는 개수 조회라는 점이다.
응용예제 9. Meeting 게시글 CRUD와 Reply 댓글 Ajax 흐름 (Meeting.java, Reply.java, MeetingRepository.java, ReplyRepository.java, MeetingController.java, meetingView.html)
앞 예제에서는
Visitor방명록을 기준으로 기본CRUD흐름과Ajax수정 흐름을 확인했다.
이번 예제에서는 비슷한 구조를Meeting게시글과Reply댓글 기능으로 확장해서 확인한다.
Meeting은 미팅 일정 글 한 개를 표현하는 엔티티이다.
Reply는 특정 미팅 글에 달린 댓글 한 개를 표현하는 엔티티이다.
미팅 글 하나에는 댓글이 여러 개 달릴 수 있고, 댓글 하나는 반드시 하나의 미팅 글에 속한다.
전체 흐름은MeetingController가 미팅 목록, 검색, 등록, 수정, 삭제 요청을 처리하고, 댓글 등록과 댓글 목록 조회는Ajax방식으로 처리하는 구조이다.
이 예제의 핵심은Meeting게시글의CRUD흐름과Reply댓글의 다대일 연관관계, 그리고 댓글 등록·조회JSON응답 흐름을 함께 이해하는 것이다.
앞 개념과 연결해서 보기
앞에서
Repository는 엔티티를 기준으로 데이터베이스 작업을 처리한다고 정리했다.
이번 예제에서는MeetingRepository가Meeting엔티티를 처리하고,ReplyRepository가Reply엔티티를 처리한다.
Meeting은 미팅 대상 이름, 미팅 목적, 미팅 날짜와 시간을 가진다.
Reply는 댓글 작성자, 댓글 내용, 그리고 어떤 미팅 글에 달린 댓글인지를 나타내는refid를 가진다.
여기서refid라는 이름만 보면 숫자처럼 보일 수 있다.
하지만Reply클래스에서refid의 타입은Meeting이다.
즉,Reply.refid는 댓글이 속한 미팅 글 객체를 참조하는 필드이다.
이번 예제에서 확인할 개념
Meeting은 미팅 일정 글 한 개를 표현한다.Reply는 미팅 글에 달린 댓글 한 개를 표현한다.Reply는@ManyToOne으로Meeting을 참조한다.MeetingRepository는 미팅 글 조회, 검색, 저장, 삭제를 처리한다.ReplyRepository는 특정 미팅 글에 달린 댓글 목록을 조회한다.- 댓글 등록과 댓글 목록 조회는
Ajax와JSON응답으로 처리된다.댓글은 혼자 존재하는 데이터가 아니라, 어떤 미팅 글에 속하는지까지 함께 봐야 한다.
Meeting 엔티티 구조 확인하기
Meeting클래스는 미팅 일정 글 한 개를 표현하는 엔티티이다.
미팅 글에는 글 번호, 이름, 제목, 날짜와 시간이 필요하다.// Meeting.java package com.example.springjpaedu.entity; import jakarta.persistence.*; import lombok.Getter; import lombok.Setter; import lombok.ToString; import org.springframework.format.annotation.DateTimeFormat; import java.time.LocalDateTime; @Entity // 데이터베이스 테이블과 매핑될 클래스 @Getter // getter 메서드 자동 생성 @Setter // setter 메서드 자동 생성 @ToString // 객체 정보를 문자열로 출력 public class Meeting { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.IDENTITY) // DB가 기본키 자동 생성 private int id; // 미팅 글 번호 private String name; // 미팅 대상 이름 private String title; // 미팅 목적 @DateTimeFormat(pattern = "yyyy-MM-dd'T'HH:mm") // 폼 날짜 문자열 변환 형식 @Column(name="meetingdate") // meetingdate 컬럼과 연결 private LocalDateTime meetingDate; // 미팅 날짜와 시간 }
@Entity가 붙었기 때문에Meeting은JPA가 관리하는 엔티티이다.
id는@Id가 붙은 기본키이며,@GeneratedValue(strategy = GenerationType.IDENTITY)때문에 데이터베이스가 값을 자동으로 생성한다.
name은 미팅 대상 이름이다.
title은 미팅 목적이나 내용을 나타낸다.
meetingDate는 미팅 날짜와 시간을 저장하는 필드이다.
@DateTimeFormat(pattern = "yyyy-MM-dd'T'HH:mm")은 화면 폼에서 전달되는 날짜와 시간 문자열을LocalDateTime으로 바꿀 때 사용하는 형식이다.
datetime-local입력값은2026-05-01T14:30처럼 날짜와 시간 사이에T가 들어가는 형태이므로, 이 형식에 맞춰 변환한다.
Meeting 필드 역할 정리
id는 미팅 글 번호이며 기본키이다.name은 미팅 대상 이름이다.title은 미팅 목적이다.meetingDate는 미팅 날짜와 시간이다.
Meeting은 댓글이 달릴 수 있는 부모 글 역할을 한다.
뒤에서Reply는 이Meeting객체를 참조한다.
Reply 엔티티와 다대일 관계 확인하기
Reply클래스는 댓글 한 개를 표현하는 엔티티이다.
댓글에는 댓글 번호, 작성자 이름, 댓글 내용, 그리고 댓글이 달린 미팅 글 정보가 필요하다.// Reply.java package com.example.springjpaedu.entity; import jakarta.persistence.*; import lombok.Getter; import lombok.Setter; import lombok.ToString; @Entity // 데이터베이스 테이블과 매핑될 클래스 @Setter // setter 메서드 자동 생성 @Getter // getter 메서드 자동 생성 @ToString // 객체 정보를 문자열로 출력 public class Reply { @Id // 기본키 필드 @GeneratedValue(strategy = GenerationType.IDENTITY) // DB가 기본키 자동 생성 private int id; // 댓글 번호 private String name; // 댓글 작성자 private String content; // 댓글 내용 @ManyToOne(optional = false) // 여러 Reply가 하나의 Meeting을 참조 @JoinColumn(name="refid") // refid 외래키 컬럼 사용 private Meeting refid; // 댓글이 속한 미팅 글 }
Reply도@Entity가 붙어 있으므로 데이터베이스 테이블과 매핑된다.
id는 댓글을 구분하는 기본키이다.
name은 댓글 작성자이고,content는 댓글 내용이다.
가장 중요한 필드는refid이다.
이 필드는 이름만 보면 숫자처럼 보이지만 실제 타입은Meeting이다.
즉,Reply객체 안에는 댓글이 속한Meeting객체가 들어 있다.
@ManyToOne(optional = false)는 여러 댓글이 하나의 미팅 글에 연결될 수 있다는 뜻이다.
optional = false는 댓글이 미팅 글 없이 존재할 수 없다는 의미이다.
@JoinColumn(name="refid")는 데이터베이스에서refid컬럼을 외래키로 사용해Meeting과 연결한다는 뜻이다.
객체에서는Reply.refid가Meeting객체를 참조하고, 테이블에서는refid외래키가Meeting의 기본키를 가리킨다.
Reply와 Meeting 관계 정리
- 미팅 글 하나에는 댓글 여러 개가 달릴 수 있다.
- 댓글 하나는 하나의 미팅 글에 속한다.
- 객체에서는
Reply.refid가Meeting객체를 참조한다.- 데이터베이스에서는
refid외래키로Meeting과 연결된다.
Reply.refid는 댓글 자신의 번호가 아니라, 댓글이 연결된Meeting글을 가리키는 객체 참조이다.
Repository 구조 확인하기
미팅 글과 댓글은 서로 다른 엔티티이므로 저장소도 각각 따로 둔다.
MeetingRepository는Meeting글을 다루고,ReplyRepository는Reply댓글을 다룬다.// MeetingRepository.java package com.example.springjpaedu.repository; import com.example.springjpaedu.entity.Meeting; import org.springframework.data.jpa.repository.JpaRepository; import java.util.List; public interface MeetingRepository extends JpaRepository<Meeting, Integer>{ public List<Meeting> findByTitleContains(String keyword); // 제목에 keyword가 포함된 글 조회 public List<Meeting> findByName(String name); // 이름이 같은 글 조회 }
MeetingRepository는JpaRepository<Meeting, Integer>를 상속한다.
따라서findAll(),findById(),save(),deleteById()같은 기본 메서드를 사용할 수 있다.
findByTitleContains()는 미팅 목적 또는 제목에 특정 검색어가 포함된 글을 조회한다.
findByName()은 이름이 정확히 같은 미팅 글을 조회한다.// ReplyRepository.java package com.example.springjpaedu.repository; import com.example.springjpaedu.entity.Reply; import org.springframework.data.jpa.repository.JpaRepository; import org.springframework.data.jpa.repository.Query; import java.util.List; public interface ReplyRepository extends JpaRepository<Reply, Integer>{ public List<Reply> findByRefidId(int id); // Meeting id 기준으로 댓글 조회 @Query("select t from Reply t join fetch t.refid") public List<Reply> findAllJoinFetch(); // Reply와 Meeting을 함께 조회 }
ReplyRepository는JpaRepository<Reply, Integer>를 상속한다.
findByRefidId(int id)는 특정 미팅 글에 달린 댓글을 조회하는 쿼리 메서드이다.
RefidId는Reply의refid객체로 이동한 뒤, 그Meeting의id값을 조건으로 사용한다는 뜻이다.
즉, 댓글 자신의id를 비교하는 것이 아니라, 댓글이 참조하는 미팅 글의id를 비교한다.
findAllJoinFetch()는Reply를 조회하면서 연결된Meeting까지 함께 가져오는fetch join예제이다.
이 글의 화면 흐름에서는 댓글 목록 조회에findByRefidId()가 사용되지만,findAllJoinFetch()도Reply와Meeting연관관계를 한 번에 조회할 수 있음을 보여 주는 메서드이다.
Repository 메서드 역할 정리
findAll()은 전체 미팅 글 조회에 사용된다.findByTitleContains()는 제목 포함 검색에 사용된다.findByName()은 이름 검색에 사용된다.save()는 미팅 글 등록과 댓글 등록에 사용된다.deleteById()는 미팅 글 삭제에 사용된다.findById()는 수정 대상 조회와 댓글이 달릴 미팅 글 조회에 사용된다.findByRefidId()는 특정 미팅 글의 댓글 목록 조회에 사용된다.
findByRefidId()는Reply에서Meeting으로 객체 경로를 따라가서 부모 글 번호를 조건으로 사용하는 메서드이다.
MeetingController 전체 요청 흐름 보기
MeetingController는MeetingRepository와ReplyRepository를 함께 사용한다.
미팅 글 관련 요청은repositoryM으로 처리하고, 댓글 관련 요청은repositoryR로 처리한다.// MeetingController.java package com.example.springjpaedu.controller; import com.example.springjpaedu.entity.Meeting; import com.example.springjpaedu.entity.Reply; import com.example.springjpaedu.repository.MeetingRepository; import com.example.springjpaedu.repository.ReplyRepository; import org.springframework.stereotype.Controller; import org.springframework.transaction.annotation.Transactional; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.PostMapping; import org.springframework.web.bind.annotation.RequestParam; import org.springframework.web.bind.annotation.ResponseBody; import org.springframework.web.servlet.ModelAndView; import java.util.List; @Controller // 웹 요청을 처리하는 클래스 public class MeetingController { private MeetingRepository repositoryM; // Meeting 저장소 private ReplyRepository repositoryR; // Reply 저장소 public MeetingController(MeetingRepository p1, ReplyRepository p2) { repositoryM = p1; // Meeting 저장소 주입 repositoryR = p2; // Reply 저장소 주입 } }생성자에서
MeetingRepository와ReplyRepository를 받는다.
Spring은 자동으로 두 저장소 구현 객체를 만들어 두고,MeetingController를 만들 때 생성자에 넣어 준다.
이 구조는VisitorController보다 한 단계 더 확장된 형태이다.
VisitorController는 하나의 저장소만 사용했지만,MeetingController는 글 저장소와 댓글 저장소를 함께 사용한다.
요청 주소별 역할
/meeting은 전체 미팅 글 목록을 조회한다./meeting/search는 제목에 검색어가 포함된 글을 조회한다./meeting/searchname은 이름이 같은 글을 조회한다./meeting/delete는 미팅 글을 삭제한다./meeting/one은 글 하나를JSON으로 응답한다./meeting/insert는 새 미팅 글을 등록한다./meeting/update는 기존 미팅 글을 수정한다./meeting/ireply는 댓글을 등록하고JSON문자열을 응답한다./meeting/lreply는 특정 글의 댓글 목록을JSON으로 응답한다.이 요청들은 모두 하나의 화면인
meetingView.html과 연결되어 동작한다.
목록 화면에서 글 작성, 검색, 수정, 삭제, 댓글 등록, 댓글 조회 기능이 함께 이어진다.
미팅 글 목록 조회와 검색 흐름
/meeting요청은 전체 미팅 글을 조회한다.
조회 결과가 있으면list라는 이름으로meetingView.html에 전달한다.// MeetingController.java @GetMapping("/meeting") // 전체 미팅 글 목록 조회 public ModelAndView list() { List<Meeting> list = repositoryM.findAll(); // 전체 Meeting 조회 ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 if (list.size() != 0) { mav.addObject("list", list); // 조회 결과 전달 } else { mav.addObject("msg", "추출된 결과가 없어요"); // 결과 없음 메시지 전달 } mav.setViewName("meetingView"); // meetingView.html 사용 return mav; // 화면 응답 }
repositoryM.findAll()은 전체 미팅 글을 조회한다.
이 메서드는JpaRepository가 기본으로 제공한다.
화면에는 미팅 대상 이름, 미팅 목적, 날짜와 시간이 출력된다.
각 글 옆에는 삭제, 수정, 댓글 아이콘이 함께 표시된다.
/meeting요청은 전체 미팅 글 목록을 조회한다.
화면에는 미팅 대상 이름, 미팅 목적, 미팅 날짜와 시간이 출력되고, 각 글 옆에는 삭제, 수정, 댓글 아이콘이 함께 표시된다.
검색은 두 가지가 있다.
/meeting/search는 제목에 검색어가 포함된 글을 찾고,/meeting/searchname은 이름이 정확히 같은 글을 찾는다.// MeetingController.java @GetMapping("/meeting/search") // 제목 포함 검색 public ModelAndView search(@RequestParam("keyword") String keyword) { List<Meeting> list = repositoryM.findByTitleContains(keyword); // title 포함 검색 ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 if (list.size() != 0) { mav.addObject("list", list); // 검색 결과 전달 mav.addObject("button", "메인화면으로"); // 목록 이동 버튼 문구 전달 } else { mav.addObject("msg", "추출된 결과가 없어요"); // 결과 없음 메시지 전달 } mav.setViewName("meetingView"); // meetingView.html 사용 return mav; // 화면 응답 } @GetMapping("/meeting/searchname") // 이름 검색 public ModelAndView searchName(@RequestParam("name") String name) { List<Meeting> list = repositoryM.findByName(name); // name 정확히 일치 검색 ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 if (list.size() != 0) { mav.addObject("list", list); // 검색 결과 전달 mav.addObject("button", "메인화면으로"); // 목록 이동 버튼 문구 전달 } else { mav.addObject("msg", "추출된 결과가 없어요"); // 결과 없음 메시지 전달 } mav.setViewName("meetingView"); // meetingView.html 사용 return mav; // 화면 응답 }
findByTitleContains(keyword)는title안에keyword가 포함된 미팅 글을 조회한다.
Contains가 들어 있으므로 검색어가 제목 중간에 있어도 조회 대상이 될 수 있다.
findByName(name)은 이름이 정확히 같은 미팅 글을 조회한다.
이름 전체가 일치하는 데이터를 찾는 흐름이다.
검색 결과가 있을 때button을 함께 전달하는 이유는 검색 결과 화면에서 다시/meeting메인 목록으로 돌아가는 버튼을 보여 주기 위해서이다.
미팅 정보 검색버튼을 누르면 검색 폼이 표시된다.
검색어를 입력하면 제목 포함 검색 또는 이름 검색 요청이 실행되고, 조건에 맞는 미팅 글만 목록에 출력된다.
meetingView.html에서 목록과 버튼 출력하기
meetingView.html은Controller에서 전달한list를 반복 출력한다.
각 미팅 글 옆에는 삭제, 수정, 댓글 등록 아이콘이 있다.// meetingView.html <table> <tr th:each="vo : ${list}"> <td th:class="${vo.id}">[[${vo.name}]]</td> <td th:class="${vo.id}" th:onclick="|displayReply(${vo.id})|">[[${vo.title}]]</td> <td th:class="${vo.id}">[[${vo.meetingDate}]]</td> <td><a th:href="@{/meeting/delete(id=${vo.id})}"><img src="/images/delete.png" width="20"></a></td> <td><img th:onclick="|displayUpdateForm(${vo.id})|" src="/images/edit.png" width="20"></td> <td><img th:onclick="|insertReply(${vo.id})|" src="/images/comment.png" width="25"></td> </tr> </table>
th:each="vo : ${list}"는 미팅 글 목록을 하나씩 꺼내 출력한다.
vo.name,vo.title,vo.meetingDate는 각각 미팅 대상 이름, 미팅 목적, 미팅 날짜와 시간이다.
제목 칸에는displayReply(vo.id)가 연결되어 있다.
제목을 누르면 해당 미팅 글의 댓글 목록을 조회한다.
삭제 아이콘은/meeting/delete?id=글번호요청으로 연결된다.
수정 아이콘은displayUpdateForm(id)함수를 실행해 글 작성 폼을 수정 폼으로 바꾼다.
댓글 아이콘은insertReply(id)함수를 실행해 댓글 작성 흐름을 시작한다.
화면 아이콘 역할
- 제목 클릭은 댓글 목록 조회이다.
- 삭제 아이콘은 미팅 글 삭제 요청이다.
- 수정 아이콘은 기존 값을 폼에 채우고 수정 모드로 전환한다.
- 댓글 아이콘은 댓글 등록 요청을 시작한다.
화면은 단순히 목록만 보여 주지 않는다.
각 글에서 수정, 삭제, 댓글 조회, 댓글 등록 기능으로 이어지는 출발점 역할을 한다.
미팅 글 등록 흐름
미팅 정보 작성 버튼을 누르면 작성 폼이 보인다.
작성 폼은 이름, 미팅 목적, 날짜와 시간을 입력받고/meeting/insert로POST요청을 보낸다.// meetingView.html <form method="post" action="/meeting/insert"> <input type="hidden" name="id" value="0"> 미팅 대상 이름 : <input id="m_name" type="text" name="name"> <br> 미팅 목적 : <br> <textarea id="m_title" rows="3" cols="60" name="title"></textarea> <br> 날짜와 시간 : <input id="m_dt" type="datetime-local" name="meetingDate"> <br><br> <input type="submit" value="등록"> </form>폼의
name,title,meetingDate는Meeting엔티티의 같은 이름 필드로 바인딩된다.
meetingDate는 날짜와 시간을 함께 받기 때문에Meeting엔티티에서LocalDateTime타입으로 선언되어 있다.
/meeting/insert요청은 전달된Meeting객체를 저장한다.
저장 후 다시 전체 목록을 조회하고meetingView로 돌아온다.// MeetingController.java @PostMapping("/meeting/insert") // 미팅 글 등록 public ModelAndView insert(Meeting meeting) { repositoryM.save(meeting); // Meeting 저장 List<Meeting> list = repositoryM.findAll(); // 저장 후 전체 목록 다시 조회 ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 mav.addObject("list", list); // 목록 전달 mav.setViewName("meetingView"); // meetingView.html 사용 return mav; // 화면 응답 }
insert(Meeting meeting)에서 매개변수meeting은 폼에서 전달된 값을 담은 객체이다.
입력 폼의name속성과Meeting필드명이 같기 때문에 값이 자동으로 들어간다.
repositoryM.save(meeting)은 새 미팅 글을 저장한다.
저장 후findAll()로 목록을 다시 조회하는 이유는 등록된 글까지 포함한 최신 목록을 화면에 보여 주기 위해서이다.
미팅 정보 작성버튼을 누르면 작성 폼이 표시되고, 입력한 값은/meeting/insert요청으로 전달된다.
등록이 끝나면 다시 목록 화면으로 돌아오며 새 미팅 글이 목록에 반영된다.
미팅 글 수정 흐름
수정 아이콘을 누르면 기존 미팅 글의 값이 작성 폼에 채워지고 수정 모드로 바뀐다.
이 흐름은 화면의JavaScript함수가 담당한다.// meetingView.html function displayUpdateForm(id) { document.querySelector("form").action = "/meeting/update"; // 수정 요청 주소로 변경 document.querySelector("[type=submit]").value = "수정"; // 버튼 문구 변경 document.querySelector("h2").innerHTML = "미팅정보 수정"; // 제목 변경 document.querySelector("[name=id]").value = id; // 수정할 글 번호 저장 document.getElementById("m_name").value = document.getElementsByClassName(id)[0].innerText; // 기존 이름 입력 document.getElementById("m_title").value = document.getElementsByClassName(id)[1].innerText; // 기존 제목 입력 document.getElementById("m_dt").value = document.getElementsByClassName(id)[2].innerText; // 기존 날짜 입력 document.getElementById("input_area").style.display = "block"; // 입력 영역 표시 document.getElementById("search_area").style.display = "none"; // 검색 영역 숨김 }
displayUpdateForm(id)는 수정할 글 번호를 받아서 폼을 수정용으로 바꾼다.
폼의action은/meeting/update로 변경되고, 제출 버튼의 문구도수정으로 바뀐다.
그리고 목록에 이미 출력된 이름, 제목, 날짜 값을 가져와 입력 폼에 채운다.
이렇게 하면 사용자는 기존 내용을 보면서 필요한 부분만 수정할 수 있다.
수정 요청은/meeting/update에서 처리된다.
기존 글을 먼저 조회한 뒤, 입력받은 값으로 필드를 바꾸고 다시 저장한다.// MeetingController.java @PostMapping("/meeting/update") // 미팅 글 수정 public ModelAndView update(Meeting meeting) { Meeting oldMeeting = repositoryM.findById(meeting.getId()).get(); // 기존 글 조회 oldMeeting.setName(meeting.getName()); // 이름 수정 oldMeeting.setTitle(meeting.getTitle()); // 제목 수정 oldMeeting.setMeetingDate(meeting.getMeetingDate()); // 날짜와 시간 수정 repositoryM.save(oldMeeting); // 수정된 내용 저장 List<Meeting> list = repositoryM.findAll(); // 수정 후 전체 목록 다시 조회 ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 mav.addObject("list", list); // 목록 전달 mav.setViewName("meetingView"); // meetingView.html 사용 return mav; // 화면 응답 }
findById(meeting.getId()).get()은 수정할 기존 글을 찾는다.
그 다음setName(),setTitle(),setMeetingDate()로 값을 바꾼다.
마지막에save(oldMeeting)을 호출하면 변경된 내용이 저장된다.
이 흐름은 새 글 등록처럼 보일 수 있지만, 이미 존재하는id를 가진 엔티티를 저장하므로 수정 흐름으로 동작한다.
수정 아이콘을 누르면 기존 미팅 글의 값이 작성 폼에 채워지고 수정 모드로 전환된다.
수정 후 제출하면/meeting/update요청이 실행되고, 변경된 내용이 목록에 다시 반영된다.
미팅 글 삭제 흐름
삭제 아이콘을 누르면
/meeting/delete?id=글번호요청이 실행된다.
컨트롤러는 전달받은id로 해당 미팅 글을 삭제한다.// MeetingController.java @GetMapping("/meeting/delete") // 미팅 글 삭제 public ModelAndView delete(@RequestParam("id") int id) { repositoryM.deleteById(id); // id 기준으로 Meeting 삭제 List<Meeting> list = repositoryM.findAll(); // 삭제 후 전체 목록 다시 조회 ModelAndView mav = new ModelAndView(); // 화면 이름과 데이터를 담는 객체 mav.addObject("list", list); // 목록 전달 mav.setViewName("meetingView"); // meetingView.html 사용 return mav; // 화면 응답 }
@RequestParam("id")는 요청 주소에 붙은id값을 받는다.
예를 들어/meeting/delete?id=3이면id값으로3이 들어온다.
repositoryM.deleteById(id)는 해당 기본키 값을 가진 미팅 글을 삭제한다.
삭제 후에는 다시findAll()로 목록을 조회한다.
그래야 삭제된 글이 빠진 최신 목록이 화면에 출력된다.
단, 댓글이 이미 달린 미팅 글을 삭제할 때는 데이터베이스 외래키 제약 때문에 삭제가 실패할 수 있다.
이 예제에서는 삭제 흐름 자체를 확인하는 데 집중하고, 댓글까지 함께 삭제하는 처리는 별도로 다루지 않는다.
삭제 아이콘을 누르면
/meeting/delete요청이 실행된다.
삭제 후 전체 목록을 다시 조회하므로, 삭제한 미팅 글이 화면에서 사라진 것을 확인할 수 있다.
미팅 글 단건 조회 JSON 흐름
/meeting/one요청은 글 번호를 받아 미팅 글 하나를JSON문자열로 응답한다.
다만 현재 화면의 수정 흐름은/meeting/one을 호출하지 않는다.
현재 수정 기능은 목록에 이미 출력된 값을JavaScript로 읽어 폼에 채우는 방식이다.
따라서/meeting/one은 글 하나를JSON형태로 응답하는 별도 단건 조회 예제로 보면 된다.
화면에서 특정 글의 데이터를Ajax로 다시 가져와야 하는 구조라면 이런 단건 조회 요청을 사용할 수 있다.// MeetingController.java @GetMapping(value="/meeting/one", produces = "application/json; charset=utf-8") // 글 하나 JSON 조회 @ResponseBody // 문자열을 화면 이름이 아니라 응답 본문으로 반환 public String one(@RequestParam("id") int id) { Meeting meeting = repositoryM.findById(id).get(); // id 기준으로 Meeting 조회 String json = "{ \"id\" : " + meeting.getId() + ", \"name\" : \"" + meeting.getName() + "\", \"title\" : \"" + meeting.getTitle() + "\", \"meetingDate\" : \"" + meeting.getMeetingDate() + "\" }"; // JSON 문자열 생성 return json; // JSON 응답 }
@ResponseBody가 붙으면 반환 문자열을 화면 이름으로 해석하지 않는다.
대신 브라우저 응답 본문에 그대로 보낸다.
produces = "application/json; charset=utf-8"은 응답 형식이JSON이고, 문자 인코딩은utf-8이라는 뜻이다.
한글이 포함될 수 있으므로charset=utf-8을 함께 지정한다.
이 메서드는Meeting객체를 그대로 반환하지 않고 문자열로JSON형태를 직접 만든다.
간단한 예제에서는 이렇게 직접 만들 수 있지만, 실제 개발에서는 객체를 반환해 자동으로JSON변환을 맡기는 방식도 자주 사용한다.
Reply 댓글 등록 흐름
댓글 등록은 화면 전체를 새로고침하는 방식이 아니라
Ajax요청으로 처리된다.
댓글 아이콘을 누르면 작성자 이름과 댓글 내용을 입력받고/meeting/ireply요청을 보낸다.// meetingView.html function insertReply(id) { let name = window.prompt("댓글 작성자의 성명을 입력하세요.."); // 댓글 작성자 입력 let content = window.prompt("댓글 내용을 입력하세요.."); // 댓글 내용 입력 let query = "name="+name+"&content="+content+"&refid="+id; // 요청 파라미터 생성 var xhr = new XMLHttpRequest(); // Ajax 요청 객체 생성 xhr.onload = function () { if(xhr.status == 200) { let jsondom = JSON.parse(xhr.responseText); // JSON 문자열을 객체로 변환 if (jsondom.result == true) window.alert("댓글 작성이 완료되었습니다."); // 성공 알림 else window.alert("댓글 작성에 실패했습니다."); // 실패 알림 } }; xhr.open("GET", "/meeting/ireply?"+query, true); // 댓글 등록 요청 준비 xhr.send(); // 요청 전송 }
insertReply(id)에서id는 댓글이 달릴 미팅 글 번호이다.
작성자 이름과 댓글 내용을prompt로 입력받고,refid에는 미팅 글 번호를 담아 서버로 보낸다.
여기서 중요한 점은 요청 파라미터 이름이다.
화면에서는 미팅 글 번호를refid라는 이름으로 보낸다.
따라서 컨트롤러도@RequestParam("refid")로 받아야 한다.
댓글 등록 컨트롤러는 아래처럼 작성한다.// MeetingController.java @GetMapping(value="/meeting/ireply", produces = "application/json; charset=utf-8") // 댓글 등록 JSON 응답 @ResponseBody // 문자열을 응답 본문으로 반환 @Transactional // 댓글 저장 작업을 트랜잭션으로 처리 public String insert_reply(@RequestParam("name") String name, @RequestParam("content") String content, @RequestParam("refid") int refid) { Meeting mainWriting = repositoryM.findById(refid).get(); // 댓글이 달릴 미팅 글 조회 Reply vo = new Reply(); // 댓글 객체 생성 vo.setName(name); // 댓글 작성자 저장 vo.setContent(content); // 댓글 내용 저장 vo.setRefid(mainWriting); // 댓글과 미팅 글 연결 try { repositoryR.save(vo); // 댓글 저장 return "{ \"result\": true }"; // 성공 JSON 응답 } catch(Exception e) { return "{ \"result\": false }"; // 실패 JSON 응답 } }
@RequestParam("name")은 댓글 작성자 이름을 받는다.
@RequestParam("content")는 댓글 내용을 받는다.
@RequestParam("refid")는 댓글이 달릴 미팅 글 번호를 받는다.
이전 코드가@RequestParam("int") int refid처럼 되어 있으면 화면에서 보내는refid와 맞지 않아 댓글 등록이 실패할 수 있다.
@RequestParam("...")안의 이름은 실제 요청 파라미터 이름과 반드시 같아야 한다.
따라서 이 예제에서는@RequestParam("refid") int refid로 맞춰야 한다.
repositoryM.findById(refid).get()은 댓글이 달릴 미팅 글을 조회한다.
그 다음Reply객체를 만들고 작성자, 내용, 미팅 글 객체를 저장한다.
repositoryR.save(vo)가 성공하면{ "result": true }를 응답한다.
화면의JavaScript는 이 응답을 받아댓글 작성이 완료되었습니다.알림을 띄운다.
Reply 댓글 목록 조회 흐름
댓글 목록 조회도
Ajax로 처리된다.
미팅 제목을 클릭하면displayReply(id)함수가 실행되고, 해당 글의 댓글 목록을 서버에 요청한다.// meetingView.html function displayReply(id) { var xhr = new XMLHttpRequest(); // Ajax 요청 객체 생성 xhr.onload = function () { if(xhr.status == 200) { let jsonObj = JSON.parse(xhr.responseText); // JSON 문자열을 객체로 변환 let result = jsonObj.replies; // 댓글 배열 꺼내기 if(result.length == 0) { window.alert("아직 댓글이 없네요!!"); // 댓글 없음 알림 } else { let output = ""; // 댓글 출력 문자열 for(let i=0; i<result.length; i++) { output += result[i].name + " : " + result[i].content + "\n"; // 댓글 한 줄 추가 } window.alert(output); // 댓글 목록 알림 } } }; xhr.open("GET", "/meeting/lreply?refid="+id, true); // 댓글 목록 요청 준비 xhr.send(); // 요청 전송 }
displayReply(id)의id는 미팅 글 번호이다.
/meeting/lreply?refid=글번호요청을 보내면, 서버는 해당 글에 달린 댓글 목록을 찾아JSON으로 응답한다.
응답을 받은 뒤JSON.parse()로 문자열을 객체로 바꾼다.
댓글 목록은jsonObj.replies에 들어 있다.
댓글이 없으면아직 댓글이 없네요!!를 출력한다.
댓글이 있으면 작성자 이름과 댓글 내용을 한 줄씩 이어 붙여 알림창으로 보여 준다.// MeetingController.java @GetMapping(value="/meeting/lreply", produces = "application/json; charset=utf-8") // 댓글 목록 JSON 조회 @ResponseBody // 문자열을 응답 본문으로 반환 @Transactional // 댓글 조회 중 연관 객체 접근을 안정적으로 처리 public String list_reply(@RequestParam("refid") int refid) { List<Reply> list = repositoryR.findByRefidId(refid); // 특정 Meeting id에 달린 댓글 조회 String json = "{ \"replies\" : ["; // JSON 배열 시작 for(int i=0; i<list.size(); i++) { Reply reply = list.get(i); // 댓글 하나 꺼내기 json += "{ \"id\" : " + reply.getId() + ", \"name\" : \"" + reply.getName() + "\", \"content\" : \"" + reply.getContent() + "\" }"; // 댓글 JSON 생성 if(i < list.size() - 1) { json += ","; // 마지막이 아니면 쉼표 추가 } } json += "] }"; // JSON 배열 종료 return json; // JSON 응답 }
findByRefidId(refid)는Reply가 참조하는Meeting의id가 전달받은refid와 같은 댓글을 조회한다.
즉, 특정 미팅 글에 달린 댓글만 가져오는 흐름이다.
응답은{ "replies" : [...] }형태의JSON문자열이다.
화면에서는 이replies배열을 반복하면서 작성자와 댓글 내용을 알림창에 출력한다.
미팅 제목을 클릭하면 해당 글의 댓글 목록을 조회한다.
댓글 아이콘을 누르면 작성자와 댓글 내용을 입력받고,/meeting/ireply요청으로 댓글을 등록한다.
Ajax 댓글 흐름에서 주의할 점
댓글 등록과 댓글 목록 조회는 모두 화면 전체를 다시 그리지 않는다.
XMLHttpRequest로 서버에 요청을 보내고, 서버가 돌려준JSON문자열을 화면에서 해석한다.
댓글 등록은/meeting/ireply요청을 사용한다.
댓글 목록 조회는/meeting/lreply요청을 사용한다.
두 요청 모두 미팅 글 번호를refid라는 이름으로 사용한다.
댓글 등록과 목록 조회 비교
- 댓글 등록은 작성자, 내용, 미팅 글 번호를 서버에 보낸다.
- 댓글 등록 성공 여부는
{ "result": true }또는{ "result": false }로 받는다.- 댓글 목록 조회는 미팅 글 번호만 서버에 보낸다.
- 댓글 목록 조회 결과는
{ "replies": [...] }형태로 받는다.- 화면에서는 응답 문자열을
JSON.parse()로 객체로 바꿔 사용한다.
Ajax요청에서는 서버가 보내는 응답 형식과 화면에서 해석하는 방식이 서로 맞아야 한다.
서버가JSON문자열을 보내면 화면에서는JSON.parse()로 객체로 바꾼 뒤 사용한다.
이 예제에서 확인해야 하는 핵심
응용예제 9는
Meeting게시글과Reply댓글을 함께 다루는 예제이다.
Meeting은 부모 글이고,Reply는 특정Meeting에 속하는 댓글이다.
Meeting CRUD 핵심
/meeting은 전체 미팅 글을 조회한다./meeting/search는 제목 포함 검색을 처리한다./meeting/searchname은 이름 일치 검색을 처리한다./meeting/insert는 새 미팅 글을 등록한다./meeting/update는 기존 미팅 글을 수정한다./meeting/delete는 미팅 글을 삭제한다./meeting/one은 글 하나를JSON으로 응답한다.Reply 댓글 핵심
Reply는@ManyToOne으로Meeting을 참조한다.Reply.refid는 댓글이 속한Meeting객체이다./meeting/ireply는 댓글을 등록하고 성공 여부를JSON으로 응답한다./meeting/lreply는 특정 글의 댓글 목록을JSON으로 응답한다.findByRefidId()는 댓글이 참조하는Meeting의id를 조건으로 댓글 목록을 조회한다.정리하면, 이 예제는 단순 게시글 기능에서 한 단계 더 나아가 댓글까지 연결한 구조이다.
핵심은Meeting과Reply의 관계를 이해하고, 게시글CRUD는 화면 이동으로, 댓글 처리는Ajax와JSON으로 처리한다는 점이다.