Builder Pattern
Builder Pattern은 복잡한 객체 생성 과정을 단계별로 나누고, 어떤 값을 넣었는지 코드에서 잘 보이게 만드는 생성 방식이다.
객체를 만들 때 필요한 값이 많아지면 생성자만으로는 코드가 복잡해진다.
Builder Pattern은 이 문제를 줄이기 위해 사용한다.
여기서 객체는 클래스를 바탕으로 실제로 만들어진 사용 대상이다.
예를 들어 학생 한 명을 표현하려면 번호, 이름, 학년, 전화번호 같은 값이 필요하다.
이 값들을Student클래스 구조에 맞게 넣어서 만든 실제 결과가 학생 객체다.
즉,Student클래스는 학생 객체를 만들기 위한 설계도이고,new Student(...)또는Builder를 통해 만들어진 결과물이 실제 학생 객체다.
이 차이를 먼저 알아야Builder Pattern이 왜 객체 생성 방식인지 이해할 수 있다.
Builder Pattern이란
객체 생성을 단계별로 나누는 방식이다
Builder Pattern은 객체를 만드는 과정을 한 번에 처리하지 않고, 여러 단계로 나누는 방식이다.
객체를 만들 때 필요한 값을 메서드로 하나씩 받은 뒤, 마지막에build()를 호출해서 최종 객체를 만든다.
여기서pattern은 자주 반복되는 문제를 해결하기 위해 정리된 설계 방식이라고 이해하면 된다.
Builder Pattern은 여러 설계 방식 중에서도 객체를 만드는 문제를 다루는 생성 패턴에 속한다.
생성 패턴은 객체를 어떤 방식으로 만들지에 집중하는 설계 방식이다.
Builder Pattern의 핵심은 값을 모으는 준비 단계와 실제 객체가 만들어지는 단계를 나누는 것이다.
값을 모으는 과정은Builder가 맡는다.
실제로 사용할 객체는 마지막build()가 호출될 때 만들어진다.
이 말은Builder자체가 최종 결과물이 아니라는 뜻이다.
Builder는 객체를 만들기 전에 필요한 값을 잠시 담아 두는 준비 도구다.
최종 객체는build()를 호출해야 만들어진다.
수제 햄버거 주문처럼 값을 선택해서 조립한다
Builder Pattern은 수제 햄버거를 주문하는 상황으로 이해하면 쉽다.
햄버거를 만들 때 빵, 패티, 치즈, 토마토, 소스 같은 재료가 있을 수 있다.
하지만 모든 사람이 같은 재료를 넣는 것은 아니다.
어떤 사람은 치즈를 빼고 싶을 수 있다.
어떤 사람은 토마토를 빼고 싶을 수 있다.
또 어떤 사람은 소스를 추가하고 싶을 수도 있다.
객체 생성도 이와 비슷하다.
어떤 객체는 반드시 들어가야 하는 값이 있고, 상황에 따라 넣어도 되고 안 넣어도 되는 값이 있다.
이런 선택값이 많아지면 생성자만으로 객체를 만들기 어렵고 읽기도 불편해진다.
Builder Pattern은 이런 선택값들을 메서드로 하나씩 받아서 객체를 조립한다.
그래서 어떤 값을 넣었는지 코드에서 바로 확인할 수 있다.
생성자에 값을 한 번에 넣는 방식과 다르다
일반적으로 객체를 만들 때는 생성자를 많이 사용한다.
생성자는 객체가 처음 만들어질 때 필요한 값을 받아서 객체 내부에 저장하는 역할을 한다.
예를 들어 학생 객체를 만들 때 생성자를 사용하면 아래처럼 값을 한 번에 넣는다.// ConstructorStudentExample.java Student student = new Student(123456789, "둘리", "Senior", "010-5555-5555"); // 생성자에 값을 순서대로 전달이 방식은 간단하지만, 값이 많아지면 각 값이 어떤 의미인지 바로 보기 어렵다.
123456789가 학생 번호인지,"Senior"가 학년인지 코드를 읽는 사람이 직접 추측해야 한다.
특히 같은 타입의 값이 여러 개 있으면 더 위험하다.
예를 들어name,grade,phoneNumber가 모두 문자열이면 순서를 바꿔 넣어도 문법 오류가 나지 않을 수 있다.
하지만 객체 안에는 잘못된 값이 저장된다.// WrongConstructorOrderExample.java Student student = new Student(123456789, "Senior", "둘리", "010-5555-5555"); // 이름과 학년 순서가 바뀐 잘못된 예위 코드는 문법만 보면 실행될 수 있다.
하지만"Senior"가name에 들어가고,"둘리"가grade에 들어갈 수 있다.
이런 문제는 코드가 길어질수록 찾기 어렵다.
반면Builder Pattern은 아래처럼 값의 이름에 해당하는 메서드를 호출하면서 객체를 만든다.// StudentBuilderUsageExample.java Student student = new StudentBuilder() // 값을 담을 Builder 객체 생성 .id(123456789) // 학생 번호 저장 .name("둘리") // 이름 저장 .grade("Senior") // 학년 저장 .phoneNumber("010-5555-5555") // 전화번호 저장 .build(); // Student 객체 최종 생성이 코드는 어떤 값이 어디에 들어가는지 메서드 이름으로 바로 보인다.
값의 순서를 외우는 방식이 아니라, 값의 이름을 보면서 객체를 만드는 방식이다.
기본예제 직접 만든 StudentBuilder로 객체 생성하기
예제에서 만들 객체 구조 먼저 보기
이번 예제의 목표는 학생 한 명을 표현하는
Student객체를 만드는 것이다.
학생 한 명을 표현하려면 학생 번호, 이름, 학년, 전화번호가 필요하다.
이 예제에서 사용할 값은 다음과 같다.
id는 학생 번호를 저장한다.name은 학생 이름을 저장한다.grade는 학생 학년을 저장한다.phoneNumber는 학생 전화번호를 저장한다.이 값들을 한 번에 생성자에 넣을 수도 있다.
하지만 이번 예제에서는 값을 바로Student생성자에 넣지 않고,StudentBuilder에 먼저 하나씩 저장한 뒤 마지막에Student객체를 만든다.
전체 코드로 흐름 확인하기
먼저 전체 코드를 보면
Builder Pattern의 구조가 한눈에 보인다.
코드는 크게 세 부분으로 나뉜다.
Student클래스는 최종으로 만들어질 객체의 설계도다.StudentBuilder클래스는Student객체를 만들기 전에 값을 모아 두는 준비 객체다.StudentBuilderExample클래스는 실제로Builder를 사용해서 객체를 만들고 출력한다.// StudentBuilderExample.java class Student { private int id; // 학생 번호 private String name = "아무개"; // 기본 이름 private String grade = "freshman"; // 기본 학년 private String phoneNumber = "010-0000-0000"; // 기본 전화번호 public Student(int id, String name, String grade, String phoneNumber) { this.id = id; // 전달받은 학생 번호 저장 this.name = name; // 전달받은 이름 저장 this.grade = grade; // 전달받은 학년 저장 this.phoneNumber = phoneNumber; // 전달받은 전화번호 저장 } @Override public String toString() { return "Student { " + "id='" + id + '\'' + ", name=" + name + ", grade=" + grade + ", phoneNumber=" + phoneNumber + " }"; // 객체 정보를 문자열로 반환 } } class StudentBuilder { private int id; // Student에 넣을 학생 번호를 임시 저장 private String name; // Student에 넣을 이름을 임시 저장 private String grade; // Student에 넣을 학년을 임시 저장 private String phoneNumber; // Student에 넣을 전화번호를 임시 저장 public StudentBuilder id(int id) { this.id = id; // Builder에 학생 번호 저장 return this; // 다음 메서드를 이어서 호출하기 위해 자기 자신 반환 } public StudentBuilder name(String name) { this.name = name; // Builder에 이름 저장 return this; // 다음 메서드를 이어서 호출하기 위해 자기 자신 반환 } public StudentBuilder grade(String grade) { this.grade = grade; // Builder에 학년 저장 return this; // 다음 메서드를 이어서 호출하기 위해 자기 자신 반환 } public StudentBuilder phoneNumber(String phoneNumber) { this.phoneNumber = phoneNumber; // Builder에 전화번호 저장 return this; // 다음 메서드를 이어서 호출하기 위해 자기 자신 반환 } public Student build() { return new Student(id, name, grade, phoneNumber); // 모아 둔 값으로 Student 객체 생성 } } public class StudentBuilderExample { public static void main(String[] args) { Student student = new StudentBuilder() // Builder 객체 생성 .id(123456789) // 학생 번호 설정 .name("둘리") // 이름 설정 .grade("Senior") // 학년 설정 .phoneNumber("010-5555-5555") // 전화번호 설정 .build(); // Student 객체 최종 생성 System.out.println(student); // 생성된 Student 객체 출력 } }// 출력결과 // Student { id='123456789', name=둘리, grade=Senior, phoneNumber=010-5555-5555 }이 코드는
StudentBuilder에 값을 하나씩 저장한 다음, 마지막에build()를 호출해서Student객체를 생성한다.
출력 결과는 최종적으로 만들어진Student객체의 필드 값이 제대로 들어갔다는 것을 보여준다.
Student 클래스는 최종 객체의 설계도다
Student클래스는 최종적으로 만들어질 학생 객체의 구조를 정의한다.
즉, 학생 객체가 어떤 값을 가질 수 있는지 정해 두는 클래스다.
Student클래스 안에는id,name,grade,phoneNumber필드가 있다.
필드는 객체 안에 저장되는 값이라고 이해하면 된다.
name,grade,phoneNumber에는 기본값이 들어가 있다.
하지만 이 예제에서는 생성자로"둘리","Senior","010-5555-5555"값이 전달된다.
그래서 기본값은 그대로 사용되지 않고, 생성자로 전달된 값으로 덮어써진다.
다만 이 예제의StudentBuilder에는name,grade,phoneNumber의 기본값이 따로 들어가 있지 않다.
그래서 값을 생략한 채build()를 호출하면Student의 기본값이 유지되는 것이 아니라null이 전달될 수 있다.
이번 예제는 모든 값을 직접 설정하는 흐름을 보여주는 예제다.
선택값을 생략해도 기본값을 유지하고 싶다면StudentBuilder쪽에도 기본값을 두거나,build()안에서 기본값을 처리해야 한다.
이 점을 구분해야Builder Pattern이 선택값을 다룰 수 있다는 말과 이 예제 코드의 실제 동작을 헷갈리지 않는다.
여기서 중요한 점은Student클래스가 직접 값을 단계별로 받는 것이 아니라는 점이다.
Student클래스는 생성자를 통해 한 번에 값을 받는다.
실제로 값을 하나씩 받는 역할은StudentBuilder가 담당한다.
Student생성자는 아래 역할을 한다.
id값을 받아 학생 번호 필드에 저장한다.name값을 받아 이름 필드에 저장한다.grade값을 받아 학년 필드에 저장한다.phoneNumber값을 받아 전화번호 필드에 저장한다.생성자 안에서 사용한
this.id = id는 현재 객체의id필드에 매개변수id값을 저장한다는 뜻이다.
여기서 매개변수는 메서드나 생성자가 외부에서 전달받는 값을 의미한다.
StudentBuilder 클래스는 값을 임시로 모아 둔다
StudentBuilder클래스는 최종 객체가 아니다.
Student객체를 만들기 전에 필요한 값을 임시로 저장하는 준비 객체다.
StudentBuilder안에도id,name,grade,phoneNumber필드가 있다.
이 필드들은 최종Student객체의 필드가 아니라,Student를 만들기 전에 잠시 값을 담아 두는 공간이다.
예를 들어.name("둘리")를 호출하면 바로Student객체의name에"둘리"가 들어가는 것이 아니다.
먼저StudentBuilder안의name필드에"둘리"가 저장된다.
그 뒤 마지막에build()가 호출되면,StudentBuilder에 모아 둔 값들을Student생성자에 전달한다.
Builder는 최종 객체를 바로 만드는 것이 아니라, 최종 객체를 만들기 위한 값을 먼저 모아 두는 역할을 한다.
이 차이를 알아야build()가 왜 마지막에 필요한지 이해할 수 있다.
return this가 있어야 메서드를 계속 이어 쓸 수 있다
StudentBuilder의id(),name(),grade(),phoneNumber()메서드는 모두 마지막에return this를 한다.
여기서this는 현재 사용 중인StudentBuilder객체 자기 자신을 의미한다.
예를 들어 아래 흐름을 생각하면 된다.
new StudentBuilder()로StudentBuilder객체를 만든다..id(123456789)를 호출하면id값이 저장된다.id()메서드는return this로 같은StudentBuilder객체를 다시 돌려준다.- 그래서 바로 뒤에
.name("둘리")를 이어서 호출할 수 있다.즉,
return this가 있기 때문에 아래처럼 메서드를 줄줄이 이어 쓸 수 있다.// MethodChainingFlowExample.java Student student = new StudentBuilder() // Builder 객체 생성 .id(123456789) // id 저장 후 같은 Builder 반환 .name("둘리") // name 저장 후 같은 Builder 반환 .grade("Senior") // grade 저장 후 같은 Builder 반환 .phoneNumber("010-5555-5555") // phoneNumber 저장 후 같은 Builder 반환 .build(); // 모아 둔 값으로 Student 생성이런 방식을
method chaining이라고 한다.
method chaining은 메서드 호출 결과로 자기 자신을 반환해서, 다음 메서드를 계속 이어서 호출하는 방식이다.
return this가 없으면.id().name().grade()처럼 이어 쓰는 구조를 만들 수 없다.
그래서 직접Builder클래스를 만들 때는 값을 저장한 뒤return this를 반환하는 구조가 중요하다.
build는 최종 객체를 만드는 마지막 단계다
build()는Builder Pattern에서 가장 마지막에 호출되는 메서드다.
이 메서드가 호출되기 전까지는StudentBuilder안에 값만 모여 있을 뿐, 최종Student객체는 만들어지지 않는다.
build()안에서는 아래 코드가 실행된다.// StudentBuildMethodExample.java public Student build() { return new Student(id, name, grade, phoneNumber); // Builder에 저장된 값으로 Student 객체 생성 }이 코드는
StudentBuilder안에 저장된id,name,grade,phoneNumber값을 꺼내서Student생성자에 전달한다.
그 결과 실제로 사용할 수 있는Student객체가 만들어진다.
정리하면build()의 역할은 다음과 같다.
Builder에 임시 저장된 값을 꺼낸다.- 그 값을
Student생성자에 전달한다.- 완성된
Student객체를 만들어 반환한다.
build()가 반환하는 것은StudentBuilder가 아니라Student객체다.
그래서Student student = new StudentBuilder()...build();처럼 최종 결과를Student타입 변수에 저장할 수 있다.
실행 흐름을 순서대로 정리하기
이 예제의 실행 흐름은 아래 순서로 진행된다.
new StudentBuilder()가 실행되어 값을 담을 준비 객체가 만들어진다..id(123456789)가 실행되어Builder안에 학생 번호가 저장된다..name("둘리")가 실행되어Builder안에 이름이 저장된다..grade("Senior")가 실행되어Builder안에 학년이 저장된다..phoneNumber("010-5555-5555")가 실행되어Builder안에 전화번호가 저장된다..build()가 실행되어Student객체가 만들어진다.System.out.println(student)가 실행되어toString()결과가 출력된다.흐름을 한 줄로 정리하면 다음과 같다.
Builder생성 → 값 하나씩 저장 →build()호출 →Student객체 생성 → 출력 확인
이 예제를 통해 알 수 있는 핵심은 분명하다.
Builder Pattern은 값을 단계별로 모은 뒤, 마지막에 완성된 객체를 만들어 반환하는 객체 생성 방식이다.
생성자처럼 값을 한 번에 넣는 방식보다 코드가 길어질 수는 있지만, 어떤 값이 어디에 들어가는지 훨씬 분명하게 보인다.
Builder Pattern이 필요한 이유
객체를 만들 때 값이 많아지면 코드가 헷갈린다
기본예제에서 확인한 것처럼 객체를 만들 때 값이 많아지면 생성자 방식은 읽기 어려워진다.
생성자는 값을 정해진 순서대로 전달하기 때문이다.
특히String처럼 같은 타입의 값이 여러 개 있을 때는 더 조심해야 한다.
순서가 바뀌어도 문법 오류가 나지 않을 수 있고, 실행 후에 잘못된 데이터가 들어간 것을 뒤늦게 발견할 수 있다.
Builder Pattern은 값의 순서가 아니라 값의 이름을 보면서 객체를 만들 수 있게 해준다.
그래서 객체 생성 코드가 길어져도 어떤 값이 어디에 들어가는지 확인하기 쉽다.
선택값이 많아지면 생성자가 지저분해진다
객체를 만들 때 모든 값이 항상 필요한 것은 아니다.
어떤 값은 반드시 있어야 하고, 어떤 값은 상황에 따라 없어도 된다.
예를 들어 학생 객체에서id와name은 꼭 필요할 수 있다.
하지만phoneNumber는 나중에 입력할 수도 있다.
또 어떤 화면에서는grade만 필요하고, 다른 화면에서는phoneNumber까지 필요할 수도 있다.
이런 상황을 생성자로만 처리하려고 하면 생성자를 여러 개 만들어야 할 수 있다.
이를constructor overloading, 즉 같은 이름의 생성자를 매개변수 구성이 다르게 여러 개 만드는 방식이라고 한다.
생성자가 많아지면 아래 문제가 생긴다.
- 어떤 생성자를 써야 하는지 헷갈린다.
- 생성자마다 값의 순서를 다시 확인해야 한다.
- 필드가 추가될 때 생성자도 같이 수정해야 한다.
- 코드가 길어지고 유지보수가 어려워진다.
여기서 유지보수는 코드를 나중에 고치거나 기능을 추가하는 작업을 의미한다.
객체 생성 코드가 복잡하면 작은 필드 하나를 추가할 때도 여러 생성자와 호출 코드를 함께 확인해야 한다.
생성자 방식과 Builder 방식은 목적이 다르다
생성자 방식이 항상 나쁜 것은 아니다.
값이 적고 구조가 단순하면 생성자 방식이 더 간단할 수 있다.
하지만 값이 많거나 선택값이 많은 객체라면Builder Pattern이 더 읽기 쉽다.
특히 객체를 만들 때 어떤 값이 들어가는지 코드에서 바로 드러나야 한다면Builder Pattern이 유리하다.
정리하면 다음과 같다.
- 생성자 방식은 값을 정해진 순서대로 한 번에 넣는다.
Builder Pattern은 값을 이름이 있는 메서드로 하나씩 넣는다.- 생성자 방식은 값이 적을 때 간단하다.
Builder Pattern은 값이 많거나 선택값이 많을 때 읽기 쉽다.
Builder Pattern은 생성자를 무조건 대체하는 방식이 아니다.
값이 많거나 선택값이 많아 객체 생성 코드가 복잡해질 때, 객체 생성 흐름을 더 읽기 쉽게 만들기 위해 사용하는 방식이다.
다음 구간에서는 직접Builder클래스를 만들지 않고,Lombok의@Builder를 사용해서 같은 흐름을 더 짧게 작성하는 방법을 확인한다.
Lombok Builder
Lombok Builder는 직접 작성해야 하는Builder코드를Lombok이 대신 만들어 주는 방식이다.
앞에서 직접 만든StudentBuilder는 구조를 이해하기에는 좋지만, 실제로 매번 직접 작성하기에는 반복 코드가 많다.
Lombok은 반복되는Java코드를 애노테이션으로 줄여 주는 라이브러리다.
여기서 애노테이션은 코드 위에 붙여서 특정 기능을 적용하라고 알려 주는 표시라고 이해하면 된다.
Lombok의@Builder를 사용하면builder()메서드, 필드 값을 받는 메서드, 마지막에 객체를 완성하는build()메서드가 자동으로 만들어진다.
Lombok Builder는Builder Pattern의 동작 원리를 없애는 것이 아니라, 반복되는Builder작성 코드를 자동으로 줄여 주는 방식이다.
그래서Lombok Builder를 이해하려면 먼저 직접 만든Builder의 흐름을 알고 있어야 한다.
Lombok Builder란
직접 Builder 클래스를 만들 때 반복 코드가 많다
직접
Builder클래스를 만들면 객체 생성 흐름이 눈에 잘 보인다.
하지만 필드가 많아질수록 작성해야 하는 코드도 많아진다.
앞에서 만든StudentBuilder를 떠올려 보면,id,name,grade,phoneNumber필드마다 값을 받는 메서드를 직접 작성해야 했다.
각 메서드 안에서는 값을 저장하고, 다음 메서드를 이어서 호출할 수 있도록return this를 반복해서 작성했다.
마지막에는 모아 둔 값으로 실제 객체를 만드는build()메서드도 직접 작성했다.
즉, 직접 만든Builder는 아래 작업을 개발자가 모두 작성해야 한다.
- 값을 임시로 저장할
Builder필드를 만든다.- 필드마다 값을 받는 메서드를 만든다.
- 각 메서드에서 값을 저장한다.
- 각 메서드에서
return this를 반환한다.- 마지막에
build()메서드로 최종 객체를 생성한다.이 구조는 이해에는 좋지만, 실무 코드에서 객체마다 매번 직접 작성하면 코드가 길어진다.
필드가 하나 추가되면Builder필드와 메서드도 같이 추가해야 한다.
그래서 반복되는 작성 부담이 생긴다.
@Builder가 자동으로 만들어주는 것
Lombok의@Builder는 이런 반복 코드를 자동으로 만들어 준다.
개발자는 클래스 위에@Builder를 붙이고, 객체에 필요한 필드만 작성하면 된다.
그러면 컴파일 과정에서Lombok이 내부적으로Builder구조를 만들어 준다.
여기서 컴파일은 사람이 작성한 코드를 컴퓨터가 실행할 수 있는 형태로 바꾸는 과정이라고 이해하면 된다.
@Builder가 만들어 주는 대표적인 코드는 다음과 같다.
builder()메서드- 필드명과 같은 설정 메서드
- 값을 임시로 저장하는 내부
Builder클래스- 마지막에 객체를 만드는
build()메서드예를 들어
Person클래스에name,age,gender필드가 있다면Person.builder()로 시작할 수 있다.
그리고.name("둘리"),.age("10"),.gender("man")처럼 필드명과 같은 메서드로 값을 넣을 수 있다.
마지막에는.build()를 호출해서Person객체를 만든다.
@Builder를 사용해도 객체 생성 흐름은 직접 만든Builder와 같다.
달라지는 것은 개발자가Builder클래스를 직접 작성하지 않는다는 점이다.
직접 만든 Builder와 Lombok Builder는 같은 흐름을 가진다
직접 만든
Builder와Lombok Builder는 코드 작성 방식이 다를 뿐, 객체가 만들어지는 흐름은 같다.
둘 다 값을 하나씩 설정하고, 마지막에build()를 호출해서 최종 객체를 만든다.
직접 만든Builder는 아래처럼 사용했다.// ManualStudentBuilderUsageExample.java Student student = new StudentBuilder() // 직접 만든 Builder 객체 생성 .id(123456789) // 학생 번호 설정 .name("둘리") // 이름 설정 .grade("Senior") // 학년 설정 .phoneNumber("010-5555-5555") // 전화번호 설정 .build(); // Student 객체 생성
Lombok Builder도 모양은 거의 같다.
차이점은new StudentBuilder()처럼 직접 만든Builder클래스를 호출하지 않고, 클래스에서 자동으로 제공되는builder()메서드로 시작한다는 점이다.// LombokPersonBuilderUsageExample.java Person person = Person.builder() // Lombok이 만들어 준 Builder 시작 .name("둘리") // 이름 설정 .age("10") // 나이 설정 .gender("man") // 성별 설정 .job("가정부") // 직업 설정 .birthday("1983.04.22") // 생일 설정 .address("쌍문동") // 주소 설정 .build(); // Person 객체 생성이 두 코드는 모두
Builder Pattern의 흐름을 따른다.
값을 한 번에 생성자에 넣는 것이 아니라, 이름이 있는 메서드로 하나씩 넣는다.
그리고 마지막에build()로 실제 객체를 만든다.
정리하면 직접 만든Builder와Lombok Builder의 차이는 다음과 같다.
- 직접 만든
Builder는Builder클래스를 개발자가 직접 작성한다.Lombok Builder는@Builder가Builder클래스를 자동으로 만들어 준다.- 직접 만든
Builder와Lombok Builder모두 값을 하나씩 설정하고build()로 객체를 만든다.이제 실제
Person예제로@Builder가 어떤 코드를 줄여 주는지 확인한다.
기본예제 Lombok @Builder로 Person 객체 생성하기
Person 클래스 구조 먼저 보기
이번 예제의 목표는
Lombok의@Builder를 사용해서Person객체를 만드는 것이다.
Person은 사람 한 명의 정보를 담는 객체라고 보면 된다.
이 예제에서 사용할 값은 다음과 같다.
name은 이름을 저장한다.age는 나이를 저장한다.gender는 성별을 저장한다.job은 직업을 저장한다.birthday는 생일을 저장한다.address는 주소를 저장한다.이 예제에서는
age도String타입으로 작성한다.
나이로 계산을 하는 예제가 아니라,Builder로 값이 전달되는 흐름을 확인하는 예제이기 때문이다.
실제 프로젝트에서 나이를 숫자 계산에 사용해야 한다면int같은 숫자 타입을 사용할 수 있다.
직접Builder를 만들었다면 이 필드마다 값을 받는 메서드를 직접 작성해야 한다.
하지만 이 예제에서는@Builder를 사용하기 때문에 별도의PersonBuilder클래스를 직접 작성하지 않는다.
전체 코드로 흐름 확인하기
먼저 전체 코드를 보면
Lombok Builder의 사용 흐름이 보인다.
코드는 크게 두 부분으로 나뉜다.
Person클래스는 최종으로 만들어질 객체의 설계도다.LombokPersonBuilderExample클래스는Person.builder()로 객체를 만들고 출력한다.// LombokPersonBuilderExample.java import lombok.AccessLevel; // 접근 제어 수준을 지정할 때 사용 import lombok.AllArgsConstructor; // 모든 필드를 받는 생성자를 자동 생성 import lombok.Builder; // Builder 코드를 자동 생성 import lombok.ToString; // 객체 정보를 문자열로 출력할 수 있게 생성 @Builder // PersonBuilder와 builder(), build() 흐름 자동 생성 @AllArgsConstructor(access = AccessLevel.PRIVATE) // 모든 필드를 받는 생성자를 private으로 생성 @ToString // 출력할 때 필드 값을 확인할 수 있게 toString 자동 생성 class Person { private final String name; // 이름 private final String age; // 나이 private final String gender; // 성별 private final String job; // 직업 private final String birthday; // 생일 private final String address; // 주소 } public class LombokPersonBuilderExample { public static void main(String[] args) { Person person = Person.builder() // Lombok이 만들어 준 Builder 시작 .name("둘리") // 이름 설정 .age("10") // 나이 설정 .gender("man") // 성별 설정 .job("가정부") // 직업 설정 .birthday("1983.04.22") // 생일 설정 .address("쌍문동") // 주소 설정 .build(); // Person 객체 최종 생성 System.out.println(person); // 생성된 Person 객체 출력 } }// 출력결과 // Person(name=둘리, age=10, gender=man, job=가정부, birthday=1983.04.22, address=쌍문동)이 코드는
Person.builder()로Builder흐름을 시작한다.
그 다음 필드명과 같은 메서드로 값을 하나씩 넣고, 마지막에build()를 호출해서Person객체를 만든다.
출력 결과를 보면Person객체에 값이 제대로 들어간 것을 확인할 수 있다.
@Builder는 Builder 코드를 자동 생성한다
@Builder는Builder Pattern에 필요한 반복 코드를 자동으로 만들어 주는 애노테이션이다.
@Builder를 붙이면 개발자가 직접PersonBuilder클래스를 만들지 않아도 된다.
Lombok이 내부적으로PersonBuilder와 비슷한 구조를 만들어 준다.
그래서 아래 코드가 가능해진다.// PersonBuilderCallExample.java Person person = Person.builder() // Builder 객체를 얻는다 .name("둘리") // name 값을 Builder에 저장한다 .age("10") // age 값을 Builder에 저장한다 .build(); // 저장된 값으로 Person 객체를 만든다이 코드에서
Person.builder()는Builder객체를 가져오는 시작점이다.
.name("둘리")와.age("10")은Builder안에 값을 저장한다.
마지막.build()는 모아 둔 값으로Person객체를 만든다.
@Builder는 객체 생성 흐름을 바꾸는 것이 아니라, 직접 작성해야 할Builder코드를 자동으로 만들어 주는 역할을 한다.
그래서@Builder를 사용할 때도Builder가 값을 모으고,build()가 최종 객체를 만든다는 흐름은 그대로 유지된다.
@AllArgsConstructor는 전체 필드를 받는 생성자를 만든다
@AllArgsConstructor는 모든 필드를 매개변수로 받는 생성자를 자동으로 만들어 주는 애노테이션이다.
여기서AllArgs는 모든 인자를 뜻한다.
인자는 메서드나 생성자에 전달되는 값이라고 이해하면 된다.
Person클래스에는name,age,gender,job,birthday,address필드가 있다.
@AllArgsConstructor를 사용하면 이 모든 값을 받는 생성자가 자동으로 만들어진다.
@Builder는 마지막에 객체를 만들 때 이 전체 필드 생성자를 이용할 수 있다.
예제에서는 아래처럼 작성했다.// PersonAllArgsConstructorExample.java @AllArgsConstructor(access = AccessLevel.PRIVATE) // 모든 필드를 받는 생성자를 private으로 생성 class Person { private final String name; // 이름 private final String age; // 나이 private final String gender; // 성별 private final String job; // 직업 private final String birthday; // 생일 private final String address; // 주소 }
access = AccessLevel.PRIVATE는 생성자의 접근 범위를private으로 제한한다는 뜻이다.
private은 클래스 바깥에서 직접 사용할 수 없게 막는 접근 제한자다.
이렇게 하면 외부에서new Person(...)처럼 생성자를 직접 호출하기보다,Person.builder()를 통해 객체를 만들도록 유도할 수 있다.
즉, 객체 생성 방식을Builder흐름으로 통일하기 쉬워진다.
@Builder도 결국 생성자를 통해 객체를 만든다
@Builder를 사용하면new Person(...)코드를 직접 쓰지 않아도 된다.
그래서 초보자는@Builder가 생성자 없이 객체를 만드는 것처럼 오해할 수 있다.
하지만 실제 흐름은 그렇지 않다.
Builder가 값을 모은 뒤, 마지막build()단계에서 그 값들을 가지고Person객체를 만든다.
이때 전체 필드를 받는 생성자가 사용될 수 있다.
정리하면 흐름은 다음과 같다.
Person.builder()로Builder를 가져온다..name(),.age()같은 메서드로 값을 저장한다..build()를 호출한다.build()가 모아 둔 값으로Person객체를 만든다.즉,
@Builder는 생성자를 없애는 기능이 아니다.
객체 생성 코드를 직접 생성자 호출 방식으로 쓰지 않게 도와주는 기능이다.
@ToString은 출력 확인을 쉽게 해준다
@ToString은 객체 정보를 문자열로 확인할 수 있게toString()메서드를 자동으로 만들어 주는 애노테이션이다.
객체를 출력할 때 내부 값이 제대로 들어갔는지 확인하려면toString()이 필요하다.
@ToString이 없으면 객체를 출력했을 때 사람이 읽기 어려운 형태가 나올 수 있다.
하지만@ToString을 사용하면 아래처럼 필드 값이 보이는 형태로 출력된다.// PersonToStringOutputExample.java System.out.println(person); // Person 객체의 필드 값을 문자열로 출력// 출력결과 // Person(name=둘리, age=10, gender=man, job=가정부, birthday=1983.04.22, address=쌍문동)이 출력 결과를 보면
name,age,gender,job,birthday,address값이 모두 들어간 것을 확인할 수 있다.
그래서 예제에서는Builder로 만든 객체가 의도한 값으로 생성되었는지 쉽게 확인할 수 있다.
Lombok Builder가 필요한 이유
반복되는 Builder 코드를 줄일 수 있다
직접
Builder클래스를 만들면 객체 생성 흐름은 잘 보인다.
하지만 필드가 많아질수록 반복 코드도 많아진다.
예를 들어Person에 필드가 6개 있으면, 직접Builder를 만들 때도 6개의 필드를 임시 저장해야 한다.
그리고 각 필드마다 값을 받는 메서드도 만들어야 한다.
각 메서드에서는 값을 저장하고return this를 반환해야 한다.
Lombok Builder를 사용하면 이런 반복 코드를 직접 작성하지 않아도 된다.
개발자는 클래스에@Builder를 붙이고, 실제 객체를 만들 때Person.builder()를 사용하면 된다.
정리하면Lombok Builder가 줄여 주는 코드는 다음과 같다.
- 내부
Builder클래스 작성- 필드별 설정 메서드 작성
return this반복 작성build()메서드 작성코드가 짧아지면 핵심 필드와 객체 생성 흐름이 더 잘 보인다.
그래서 반복적인Builder코드가 많은 상황에서는Lombok Builder가 편리하다.
코드가 짧아져도 동작 원리는 같다
Lombok Builder를 사용하면 직접 만든Builder코드가 눈에 보이지 않는다.
하지만 코드가 사라진 것이 아니라,Lombok이 컴파일 과정에서 대신 만들어 주는 것이다.
따라서 동작 원리는 직접 만든Builder와 같다.
builder()로Builder객체를 가져온다..name(),.age()같은 메서드로 값을 저장한다.build()로 최종 객체를 만든다.
Lombok Builder는 코드를 짧게 만들어 주지만,Builder Pattern의 기본 흐름은 그대로 유지한다.
그래서Lombok Builder를 사용할 때도Builder가 값을 모으고build()가 객체를 만든다는 구조를 기억해야 한다.
Lombok Builder를 사용할 때 주의할 점
Lombok Builder는 반복 코드를 줄여 주지만, 모든 문제를 자동으로 해결해 주는 것은 아니다.
특히 필수값 검증은 조심해야 한다.
예를 들어Person객체를 만들 때name과age가 꼭 필요하다고 생각해 보자.
하지만 일반적인@Builder사용만으로는 개발자가name이나age를 빼고build()를 호출하는 것을 강하게 막기 어렵다.
값을 넣지 않으면 해당 필드는null이 될 수 있다.
그래서 필수값이 있는 객체라면 아래 내용을 따로 고민해야 한다.
- 어떤 값이 반드시 필요한지 정한다.
- 필수값이 빠졌을 때 예외를 발생시킬지 정한다.
- 객체가 만들어지기 전에 검증할 방법을 준비한다.
@Builder는 객체 생성 코드를 편하게 만들어 주는 도구다.
하지만 어떤 값이 필수인지, 잘못된 값이 들어오면 어떻게 막을지는 개발자가 직접 설계해야 한다.
다음 구간에서는 이 문제를 해결하기 위해 필수 파라미터를 먼저 받는Builder방식을 확인한다.
필수 파라미터 Builder
필수 파라미터 Builder는 객체를 만들 때 반드시 필요한 값을 먼저 받도록 제한하는 방식이다.
일반적인Lombok Builder는 값을 선택적으로 넣을 수 있어서 편리하지만, 꼭 필요한 값까지 빠뜨릴 수 있다는 문제가 있다.
예를 들어 사람 정보를 담는Person객체를 만들 때 이름과 나이는 반드시 필요하다고 생각해 보자.
그런데 일반@Builder만 사용하면name이나age를 넣지 않고도build()를 호출할 수 있다.
이렇게 되면 객체는 만들어지지만, 중요한 값이null인 상태가 될 수 있다.
필수 파라미터Builder의 핵심은 객체 생성 흐름을 시작할 때 반드시 필요한 값을 먼저 받게 만드는 것이다.
필수값을 먼저 받은 뒤, 나머지 선택값은 기존Builder방식처럼 메서드 체이닝으로 이어서 설정한다.
필수 파라미터 Builder란
반드시 필요한 값과 선택값을 구분하는 방식이다
객체를 만들 때 모든 값의 중요도가 같은 것은 아니다.
어떤 값은 객체가 의미를 가지려면 반드시 있어야 하고, 어떤 값은 상황에 따라 없어도 된다.
예를 들어Person객체에서name과age가 필수값이라고 생각해 보자.
이름이 없는 사람 정보나 나이가 없는 사람 정보는 현재 예제에서 완성된 객체로 보기 어렵다.
반면gender,job,birthday,address는 상황에 따라 나중에 넣거나 생략할 수도 있다.
이처럼 필수값과 선택값을 나누면 객체 생성 흐름이 더 안전해진다.
반드시 필요한 값은 객체 생성 시작 단계에서 먼저 받고, 선택값은 필요할 때만 이어서 설정할 수 있기 때문이다.
정리하면 값의 역할은 아래처럼 나눌 수 있다.
name은 반드시 필요한 이름 값이다.age는 반드시 필요한 나이 값이다.gender는 선택적으로 넣을 수 있는 성별 값이다.job은 선택적으로 넣을 수 있는 직업 값이다.birthday는 선택적으로 넣을 수 있는 생일 값이다.address는 선택적으로 넣을 수 있는 주소 값이다.이렇게 구분해 두면 어떤 값이 없으면 객체를 만들면 안 되는지 더 분명해진다.
일반 @Builder의 한계
일반
@Builder는 객체 생성 코드를 짧고 읽기 쉽게 만들어 준다.
하지만 기본적으로 모든 필드를 선택값처럼 다룰 수 있다.
예를 들어 일반@Builder만 사용하는 구조라면 아래처럼name과age를 빼고도build()를 호출할 수 있다.// GeneralBuilderMissingRequiredValueExample.java Person person = Person.builder() // 일반 Builder 시작 .gender("woman") // 선택값만 설정 .job("가정부친구") // 선택값만 설정 .build(); // name과 age 없이 객체 생성 시도이 코드는 일반
@Builder만 사용할 때 생길 수 있는 문제를 보여주는 예시다.
문법적으로는 작성될 수 있지만,name과age가 꼭 필요한 값이라면 문제가 된다.
객체는 만들어졌지만 중요한 값이 빠진 상태가 되기 때문이다.
일반@Builder는 객체 생성 코드를 편하게 만들어 주지만, 필수값 누락을 자동으로 완벽하게 막아 주지는 않는다.
그래서 필수값이 있는 객체라면 객체를 만들기 전에 검증하는 흐름이 필요하다.
필수값을 먼저 받는 builder 메서드가 필요하다
필수값 누락을 줄이려면 객체 생성 흐름을 시작하는 지점에서 필수값을 먼저 받게 만들면 된다.
이때 사용하는 방식이builder(String name, String age)처럼 필수값을 매개변수로 받는builder메서드다.
여기서 매개변수는 메서드가 외부에서 전달받는 값을 의미한다.
즉,builder(String name, String age)는builder를 시작하려면name과age를 반드시 전달하라는 뜻이다.
기본builder()는 아무 값 없이 시작할 수 있다.
반면 필수 파라미터를 받는builder(String name, String age)는 시작할 때부터 필수값을 넣어야 한다.
이번 예제에서는 객체 생성 시작점을 필수값을 먼저 받는 방식으로 바꾸기 위해builder(String name, String age)를 직접 작성한다.
흐름은 아래와 같다.
Person.builder("또치", "10")으로 필수값을 먼저 전달한다.builder메서드 안에서name과age가null인지 확인한다.- 값이 없으면 예외를 발생시켜 객체 생성 흐름을 막는다.
- 값이 있으면
name과age가 미리 저장된Builder객체를 반환한다.- 이후
gender,job,birthday,address같은 선택값을 이어서 설정한다.이 구조를 사용하면 필수값과 선택값의 역할이 코드에서 더 분명하게 드러난다.
기본예제 필수 파라미터를 받는 builder 메서드 만들기
Person 클래스 구조 먼저 보기
이번 예제의 목표는
name과age를 먼저 받은 뒤, 나머지 값을 선택적으로 이어서 설정하는Person객체를 만드는 것이다.
Person은 사람 한 명의 정보를 담는 객체다.
이 예제에서 사용할 필드는 다음과 같다.
name은 이름을 저장한다.age는 나이를 저장한다.gender는 성별을 저장한다.job은 직업을 저장한다.birthday는 생일을 저장한다.address는 주소를 저장한다.이 예제에서도
age는String타입으로 작성한다.
나이를 계산하는 예제가 아니라, 필수값이Builder로 먼저 전달되는 흐름을 확인하는 예제이기 때문이다.
실제 프로젝트에서 나이를 계산해야 한다면int같은 숫자 타입을 사용할 수 있다.
전체 코드로 흐름 확인하기
먼저 전체 코드를 보면 필수 파라미터
Builder의 구조가 보인다.
코드는 크게 세 부분으로 나뉜다.
Person클래스는 최종으로 만들어질 객체의 설계도다.builder(String name, String age)는 필수값을 먼저 받는 메서드다.RequiredPersonBuilderExample클래스는 필수값과 선택값을 설정한 뒤 객체를 출력한다.// RequiredPersonBuilderExample.java import lombok.AccessLevel; // 접근 제어 수준을 지정할 때 사용 import lombok.AllArgsConstructor; // 모든 필드를 받는 생성자를 자동 생성 import lombok.Builder; // Builder 코드를 자동 생성 import lombok.ToString; // 객체 정보를 문자열로 출력할 수 있게 생성 @Builder // PersonBuilder와 builder(), build() 흐름 자동 생성 @AllArgsConstructor(access = AccessLevel.PRIVATE) // 모든 필드를 받는 생성자를 private으로 생성 @ToString // 출력할 때 필드 값을 확인할 수 있게 toString 자동 생성 class Person { private final String name; // 필수값: 이름 private final String age; // 필수값: 나이 private final String gender; // 선택값: 성별 private final String job; // 선택값: 직업 private final String birthday; // 선택값: 생일 private final String address; // 선택값: 주소 public static PersonBuilder builder(String name, String age) { if (name == null || age == null) { // 필수값 누락 검사 throw new IllegalArgumentException("필수 파라미터 누락"); // 잘못된 생성 흐름 중단 } return new PersonBuilder().name(name).age(age); // 필수값이 미리 들어간 Builder 반환 } } public class RequiredPersonBuilderExample { public static void main(String[] args) { Person person = Person.builder("또치", "10") // 필수값 먼저 전달 .gender("woman") // 선택값 설정 .job("가정부친구") // 선택값 설정 .birthday("1983.xx.xx") // 선택값 설정 .address("아프리카") // 선택값 설정 .build(); // Person 객체 최종 생성 System.out.println(person); // 생성된 Person 객체 출력 } }// 출력결과 // Person(name=또치, age=10, gender=woman, job=가정부친구, birthday=1983.xx.xx, address=아프리카)이 코드는
Person.builder("또치", "10")으로 필수값을 먼저 전달한다.
그 다음gender,job,birthday,address를 선택적으로 설정한다.
마지막에build()를 호출하면 필수값과 선택값이 함께 들어간Person객체가 만들어진다.
builder(String name, String age)는 필수값을 먼저 받는다
일반
Lombok Builder는 보통Person.builder()처럼 아무 값 없이 시작한다.
하지만 이 예제에서는Person.builder("또치", "10")처럼name과age를 먼저 전달한다.
이렇게 하면 객체 생성 흐름을 시작하는 순간 필수값이 들어왔는지 확인할 수 있다.
name과age가 없으면Builder를 계속 진행하지 못하게 막을 수 있다.
중요한 코드는 아래 부분이다.// RequiredBuilderMethodExample.java public static PersonBuilder builder(String name, String age) { if (name == null || age == null) { // name 또는 age가 없으면 throw new IllegalArgumentException("필수 파라미터 누락"); // 예외 발생 } return new PersonBuilder().name(name).age(age); // 필수값 저장 후 Builder 반환 }이 메서드의 반환 타입은
PersonBuilder다.
PersonBuilder는@Builder가 만들어 주는Builder클래스라고 이해하면 된다.
개발자가 직접 전체PersonBuilder클래스를 작성하지 않아도,@Builder덕분에 사용할 수 있다.
이 메서드는Person객체를 바로 반환하지 않는다.
대신name과age가 먼저 들어간PersonBuilder를 반환한다.
그래야 뒤에서.gender(),.job(),.birthday(),.address()같은 선택값 설정을 이어서 할 수 있다.
null 검사를 하는 이유
null은 값이 없다는 뜻이다.
객체를 만들 때 필수값이null이면 객체는 만들어져도 정상적인 데이터라고 보기 어렵다.
예를 들어name이null이면 이름이 없는 사람 객체가 만들어진다.
현재 예제에서는 이름과 나이가 반드시 있어야 한다고 정했기 때문에, 이런 객체가 만들어지기 전에 막아야 한다.
그래서builder(String name, String age)안에서 아래 검사를 한다.// RequiredValueNullCheckExample.java if (name == null || age == null) { // 둘 중 하나라도 값이 없으면 throw new IllegalArgumentException("필수 파라미터 누락"); // 객체 생성 흐름 중단 }여기서
||는 또는이라는 뜻이다.
즉,name이null이거나age가null이면 조건이 참이 된다.
IllegalArgumentException은 잘못된 인자가 들어왔을 때 발생시키는 예외다.
여기서 인자는 메서드에 전달된 값을 의미한다.
즉, 필수로 넣어야 할name또는age가 잘못 들어왔으니 예외를 발생시키는 것이다.
현재 예제는null여부만 검사한다.
만약 빈 문자열인""도 막고 싶다면name.isBlank()같은 조건을 추가로 검사해야 한다.
이 부분은 필수값을 어디까지 엄격하게 볼지에 따라 달라진다.
필수값 검사는 잘못된 객체가 만들어진 뒤에 문제를 찾는 것이 아니라, 객체가 만들어지기 전에 흐름을 막기 위한 장치다.
이렇게 하면 값이 빠진 객체가 프로그램 안에서 돌아다니는 상황을 줄일 수 있다.
미리 값이 들어간 Builder 객체를 반환한다
필수값 검사가 끝나면 아래 코드가 실행된다.
// RequiredBuilderReturnExample.java
return new PersonBuilder().name(name).age(age); // 필수값을 저장한 Builder 반환
이 코드는 새
PersonBuilder객체를 만든 뒤,name(name)과age(age)를 먼저 호출한다.
즉, 반환되는Builder에는 이미name과age가 저장된 상태다.
그렇기 때문에 아래처럼 이어서 선택값을 설정할 수 있다.// RequiredBuilderChainingExample.java Person person = Person.builder("또치", "10") // name과 age가 저장된 Builder 반환 .gender("woman") // 선택값 추가 .job("가정부친구") // 선택값 추가 .birthday("1983.xx.xx") // 선택값 추가 .address("아프리카") // 선택값 추가 .build(); // 최종 Person 객체 생성여기서 중요한 점은
Person.builder("또치", "10")의 결과가 최종Person객체가 아니라는 점이다.
이 호출의 결과는 필수값이 저장된PersonBuilder다.
그래서 뒤에.gender(),.job()같은 메서드를 계속 이어서 호출할 수 있다.
마지막에build()를 호출해야 최종Person객체가 만들어진다.
이 흐름은 일반Builder와 같지만, 시작할 때 필수값을 먼저 검사한다는 점이 다르다.
실행 흐름을 순서대로 정리하기
이 예제의 실행 흐름은 아래 순서로 진행된다.
Person.builder("또치", "10")가 호출된다.builder(String name, String age)가name과age를 먼저 받는다.name또는age가null인지 검사한다.- 값이 정상이라면
new PersonBuilder().name(name).age(age)를 반환한다.- 반환된
Builder에gender,job,birthday,address를 이어서 저장한다.build()가 호출되어 최종Person객체가 만들어진다.System.out.println(person)가 실행되어toString()결과가 출력된다.흐름을 한 줄로 정리하면 다음과 같다.
필수값 전달 → 필수값 검사 → 필수값이 들어간Builder반환 → 선택값 추가 →build()호출 →Person객체 생성
이 예제를 통해 알 수 있는 핵심은 분명하다.
필수 파라미터Builder는 반드시 필요한 값을 먼저 받고, 선택값은 뒤에서 유연하게 이어서 설정하는 방식이다.
필수 파라미터 Builder가 필요한 이유
필수값 누락을 빠르게 막을 수 있다
객체를 만들 때 필수값이 빠진 상태로 객체가 생성되면 나중에 더 큰 문제가 생길 수 있다.
예를 들어 이름이 없는 사람 객체가 만들어지고, 그 객체가 여러 메서드에 전달되면 어디에서 문제가 시작됐는지 찾기 어려워진다.
필수 파라미터Builder는 객체 생성 시작 단계에서 필수값을 먼저 확인한다.
그래서 값이 잘못 들어오면 바로 예외를 발생시켜 흐름을 멈춘다.
이 방식은 잘못된 객체가 만들어진 뒤에 문제를 찾는 것보다 안전하다.
문제가 생기는 위치가builder(String name, String age)안으로 좁혀지기 때문이다.
선택값은 유연하게 받을 수 있다
필수값을 먼저 받는다고 해서 모든 값을 한 번에 넣어야 하는 것은 아니다.
필수값만 먼저 받고, 나머지 선택값은 기존Builder방식처럼 이어서 넣을 수 있다.
예를 들어name과age는 먼저 넣고,gender,job,birthday,address는 필요한 경우에만 추가한다.
이렇게 하면 필수값의 안전성과 선택값의 유연성을 함께 가져갈 수 있다.
정리하면 다음과 같다.
- 필수값은
builder(String name, String age)에서 먼저 받는다.- 필수값이 없으면 예외를 발생시킨다.
- 선택값은 메서드 체이닝으로 이어서 설정한다.
- 마지막에
build()로 최종 객체를 만든다.필수 파라미터
Builder는Builder Pattern의 장점인 읽기 쉬운 객체 생성 흐름을 유지하면서, 필수값 누락 문제를 줄이기 위한 방식이다.
다음 구간에서는 객체 생성 방식에서 벗어나, 요청 흐름 앞단에서 공통 작업을 처리하는Filter를 확인한다.
Filter
Filter는 요청이Spring MVC의 핵심 흐름으로 들어가기 전후에 공통 작업을 처리하는 기능이다.
여기서 공통 작업은 여러 요청에서 반복해서 필요한 작업을 의미한다.
예를 들어 요청 로그 출력, 인코딩 처리, 보안 관련 검사처럼 여러Controller에 반복해서 들어갈 수 있는 작업이 여기에 해당한다.
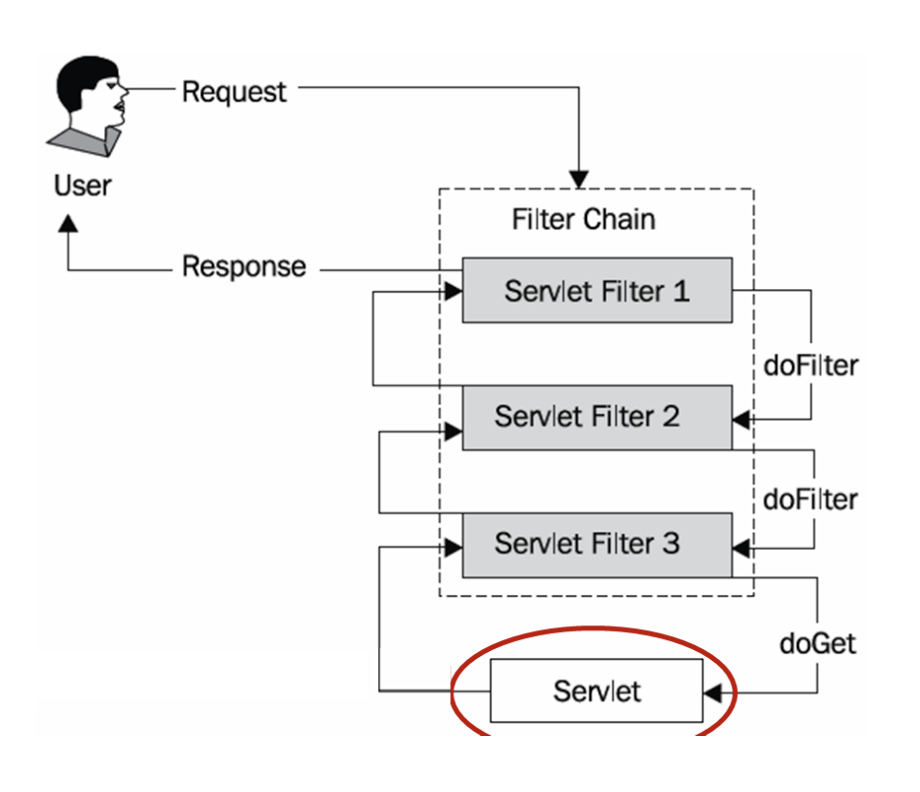
Filter를 이해할 때 가장 중요한 점은 위치다.
Filter는DispatcherServlet에 요청이 도착하기 전과 응답이 나간 뒤에 동작한다.
그래서Spring MVC내부의Controller보다 앞단에서 요청을 먼저 확인할 수 있다.
Filter란
DispatcherServlet에 도착하기 전후로 동작한다
Filter는Client의 요청이DispatcherServlet에 전달되기 전후에 실행된다.
DispatcherServlet은Spring MVC에서 요청을 가장 먼저 받아 어떤Controller로 보낼지 결정하는 핵심 객체다.
그런데Filter는 이DispatcherServlet보다 먼저 요청을 만난다.
그래서 요청이Controller로 가기 전에 공통 작업을 처리할 수 있다.
응답이 다시Client에게 돌아갈 때도Filter를 다시 지나갈 수 있다.
요청 흐름을 단순하게 보면 다음과 같다.
Client가 요청을 보낸다.- 요청이
Servlet Container에 들어온다.Filter가 요청을 먼저 처리한다.DispatcherServlet으로 요청이 전달된다.- 이후
Controller흐름으로 이어진다.- 응답이 돌아올 때도
Filter를 거쳐 나간다.
Filter는Tomcat같은Servlet Container영역에서 먼저 동작하고,DispatcherServlet으로 요청이 들어가기 전후에 공통 작업을 처리한다.
Filter는 Spring MVC 흐름보다 앞에서 동작한다
Filter는Spring MVC의Controller흐름보다 앞에서 동작한다.
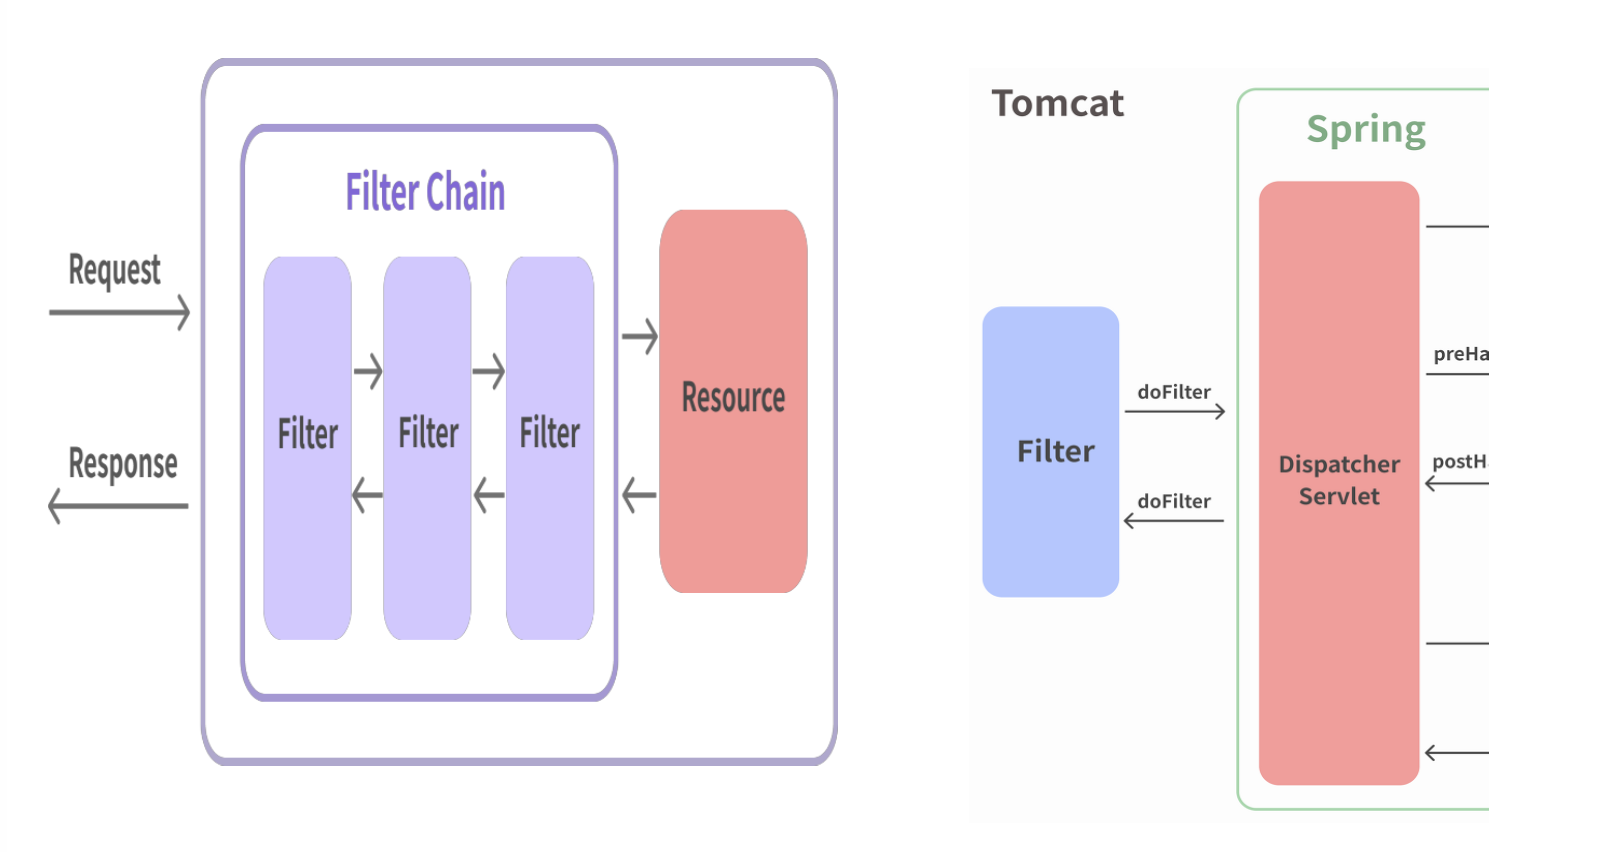
정확히 말하면 요청이DispatcherServlet에 들어가기 전에Servlet Container의Filter Chain을 먼저 지난다.
여기서Servlet Container는Tomcat처럼Servlet요청과 응답을 실행하고 관리하는 환경이라고 이해하면 된다.
반대로Spring Container는Controller,Service,Repository같은Spring객체를 생성하고 관리하는 영역이다.
이 예제에서는@Component를 사용하기 때문에Filter객체가Spring Bean으로 등록된다.
하지만 실행 위치는 여전히DispatcherServlet보다 앞단이다.
즉,Spring이 객체 등록을 도와줄 수는 있지만, 요청 처리 흐름에서Filter가 실행되는 위치는Spring MVC내부Controller앞이라고 이해해야 한다.
이 차이를 알아야Filter와 뒤에서 배울Interceptor를 구분할 수 있다.
Filter는DispatcherServlet앞에서 동작한다.
Interceptor는DispatcherServlet을 지난 뒤,Controller실행 전후에 동작한다.
Filter는Spring Bean으로 등록될 수 있지만, 요청 처리 위치는DispatcherServlet앞단이다.
이 부분이Filter와Interceptor를 구분할 때 중요하다.
Filter가 처리하기 좋은 작업
Filter는 요청이Controller에 도착하기 전에 먼저 실행된다.
그래서 여러 요청에 공통으로 필요한 작업을 한 곳에서 처리할 수 있다.
Filter에 어울리는 작업은 다음과 같다.
- 모든 요청에 대한 로그를 남기는 작업
- 문자 인코딩을 맞추는 작업
- 공통 보안 검사
- 요청이나 응답을 공통으로 가공하는 작업
Spring MVC의Controller흐름에 들어가기 전에 먼저 처리해야 하는 작업이런 작업을 모든
Controller에 직접 넣으면 코드가 반복된다.
반복 코드가 많아지면 수정할 때 여러 파일을 고쳐야 한다.
Filter를 사용하면 이런 공통 작업을 한 곳으로 분리할 수 있다.
기본예제 TestFilter1 등록하기
TestFilter1 코드 구조 먼저 보기
이번 예제의 목표는 요청이 들어올 때와 요청 처리가 끝난 뒤에 로그를 출력하는
Filter를 만드는 것이다.
이 예제에서 중요한 코드는doFilter()메서드다.
doFilter()는 실제 요청과 응답이 지나가는 핵심 메서드다.
그리고 그 안에 있는chain.doFilter(request, response)가 다음 단계로 요청을 넘기는 기준점이다.
예제에서 확인할 요소는 다음과 같다.
@Component는Filter객체를Spring Bean으로 등록하는 역할을 한다.@Slf4j는 로그를 출력할 수 있게 해준다.@Order는Filter실행 순서를 정한다.doFilter()는 요청과 응답이 지나가는 메서드다.chain.doFilter()는 다음Filter또는 최종 요청 대상으로 요청을 넘긴다.
Filter는 요청 전 작업과 요청 후 작업을 한 메서드 안에서 나눠 작성할 수 있다.
이때 나누는 기준이 바로chain.doFilter()다.
전체 코드로 흐름 확인하기
먼저 전체 코드를 보면
Filter가 어떤 구조로 작성되는지 확인할 수 있다.
이 예제는 요청이 들어오면Filter에서 요청 전 로그를 출력하고,chain.doFilter()로 다음 요청 흐름을 진행한 뒤, 요청 처리가 끝나면 다시Filter에서 요청 후 로그를 출력한다.
출력 결과까지 흐름이 맞으려면 테스트용Controller에서도 로그를 하나 출력해야 한다.
그래야chain.doFilter()전후로 어떤 일이 일어나는지 정확히 확인할 수 있다.// TestFilterExample.java import jakarta.servlet.Filter; // Filter 기능을 구현하기 위한 인터페이스 import jakarta.servlet.FilterChain; // 다음 단계로 요청을 넘기기 위한 객체 import jakarta.servlet.ServletException; // Servlet 처리 중 예외 표현 import jakarta.servlet.ServletRequest; // 요청 정보를 담는 객체 import jakarta.servlet.ServletResponse; // 응답 정보를 담는 객체 import lombok.extern.slf4j.Slf4j; // 로그 출력을 위한 Lombok 애노테이션 import org.springframework.core.annotation.Order; // Filter 실행 순서를 지정 import org.springframework.stereotype.Component; // Spring Bean으로 등록 import java.io.IOException; // 입출력 예외 표현 @Component // Filter를 Spring이 관리하는 객체로 등록 @Slf4j // log.info()를 사용할 수 있게 설정 @Order(2) // Filter가 여러 개일 때 실행 순서 지정 public class TestFilterExample implements Filter { @Override public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException { log.info("[필터1] 요청 자원 수행 전"); // 다음 단계로 가기 전 실행 chain.doFilter(request, response); // 다음 Filter 또는 DispatcherServlet 흐름으로 이동 log.info("[필터1] 요청 자원 수행 후"); // 요청 처리가 끝난 뒤 실행 } }// TestFilterController.java import lombok.extern.slf4j.Slf4j; // 로그 출력을 위한 Lombok 애노테이션 import org.springframework.web.bind.annotation.GetMapping; // GET 요청 매핑 import org.springframework.web.bind.annotation.RestController; // REST Controller 등록 @RestController // 문자열 응답을 바로 반환하는 Controller @Slf4j // Controller에서도 로그 출력 public class TestFilterController { @GetMapping("/filter-test") // 테스트용 요청 주소 public String filterTest() { log.info("[컨트롤러] 요청 처리"); // Controller 실행 확인 return "filter test"; // 응답 본문 반환 } }// 출력결과 // [필터1] 요청 자원 수행 전 // [컨트롤러] 요청 처리 // [필터1] 요청 자원 수행 후이 코드에서 가장 중요한 부분은
chain.doFilter(request, response)다.
chain.doFilter()가 실행되기 전에는 요청이 다음 단계로 넘어가기 전이다.
chain.doFilter()가 실행되면 다음Filter또는DispatcherServlet쪽으로 요청이 넘어간다.
그 이후DispatcherServlet이 요청을 처리할Controller를 찾고,TestFilterController의filterTest()가 실행된다.
Controller처리가 끝나면 다시chain.doFilter()다음 줄로 돌아와 요청 후 로그가 출력된다.
@Component로 Filter를 Bean으로 등록한다
@Component는 이 클래스를Spring이 관리하는 객체로 등록하겠다는 뜻이다.
Spring이 관리하는 객체를Bean이라고 한다.
여기서Bean은 개발자가 직접 매번new로 만들지 않아도,Spring이 대신 생성하고 관리하는 객체라고 이해하면 된다.
Filter클래스에@Component를 붙이면Spring이 이 객체를 등록하고 요청 흐름에서 사용할 수 있게 한다.
다만Filter의 실행 위치 자체는Spring MVC내부Controller쪽이 아니라Servlet Container의Filter Chain쪽이다.
그래서Filter는Spring Bean으로 등록될 수 있지만, 동작 위치는DispatcherServlet보다 앞이라고 이해해야 한다.
Filter는Bean으로 등록될 수 있지만, 요청 처리 위치는DispatcherServlet앞단이다.
이 부분이Filter와Interceptor를 구분할 때 중요하다.
@Order로 Filter 실행 순서를 정한다
@Order는 여러Filter가 있을 때 실행 순서를 정하는 애노테이션이다.
요청은 여러Filter를 순서대로 지나갈 수 있다.
이런 구조를Filter Chain이라고 한다.
Filter Chain은 말 그대로Filter들이 사슬처럼 연결되어 있는 구조다.
요청이 들어오면 첫 번째Filter를 지나고, 그 다음Filter를 지나고, 마지막으로 실제 요청 대상까지 이동한다.
응답이 돌아올 때는 반대 흐름으로 다시 지나간다.
Filter Chain에서는 요청이 여러Filter를 순서대로 통과하고, 응답은 다시 반대 방향으로 돌아온다.
예를 들어 보안 검사Filter, 인코딩 처리Filter, 로그 출력Filter가 함께 있다면 어떤Filter가 먼저 실행될지 정해야 한다.
이때@Order를 사용해 순서를 지정할 수 있다.
@Order는 숫자가 작을수록 먼저 실행된다.
예를 들어@Order(1)이 붙은Filter는@Order(2)가 붙은Filter보다 먼저 요청을 처리한다.
응답이 돌아올 때는 요청이 들어간 순서와 반대로 빠져나온다.
doFilter가 실제 요청과 응답을 처리한다
doFilter()는Filter에서 가장 중요한 메서드다.
요청이Filter를 지나갈 때 실제로 실행되는 메서드이기 때문이다.
doFilter()는 크게 세 부분으로 나눠서 이해하면 된다.
chain.doFilter()전에 작성한 코드는 요청이 다음 단계로 가기 전에 실행된다.chain.doFilter()는 다음Filter또는 최종 요청 대상으로 요청을 넘긴다.chain.doFilter()뒤에 작성한 코드는 요청 처리가 끝나고 응답이 돌아올 때 실행된다.예제 코드에서 이 흐름은 아래처럼 볼 수 있다.
// FilterDoFilterFlowExample.java
log.info("[필터1] 요청 자원 수행 전"); // 요청 전 작업
chain.doFilter(request, response); // 다음 단계로 요청 전달
log.info("[필터1] 요청 자원 수행 후"); // 응답이 돌아온 뒤 작업
이 구조 때문에
Filter는 요청 전 작업과 응답 후 작업을 모두 처리할 수 있다.
요청이 들어갈 때 한 번만 실행되는 것이 아니라,chain.doFilter()를 기준으로 앞뒤 흐름을 나눠서 볼 수 있다.
chain.doFilter가 요청 흐름의 기준점이다
chain.doFilter(request, response)는 현재Filter에서 다음 단계로 요청을 넘기는 코드다.
다음 단계는 다른Filter일 수도 있고, 마지막 요청 대상인DispatcherServlet일 수도 있다.
만약chain.doFilter()를 호출하지 않으면 요청은 다음 단계로 넘어가지 않는다.
즉,Controller까지 도착하지 못할 수 있다.
그래서 일반적인Filter에서는 특별히 요청을 막아야 하는 상황이 아니라면chain.doFilter()를 호출해야 한다.
정리하면chain.doFilter()의 역할은 다음과 같다.
- 현재
Filter다음 단계로 요청을 넘긴다.- 다음
Filter가 있으면 다음Filter를 실행한다.- 더 이상
Filter가 없으면DispatcherServlet으로 요청을 보낸다.- 이후 응답이 돌아오면
chain.doFilter()다음 줄부터 다시 실행된다.
chain.doFilter()는 요청을 계속 진행시킬지 결정하는 핵심 코드다.
요청 전후 작업을 나누는 기준이기 때문에Filter를 이해할 때 반드시 잡아야 한다.
Filter가 필요한 이유
공통 작업을 Controller마다 반복하지 않기 위해 사용한다
웹 애플리케이션에서는 여러 요청에 반복해서 필요한 작업이 많다.
예를 들어 모든 요청에 로그를 남기거나, 요청 문자 인코딩을 맞추거나, 공통 보안 검사를 해야 할 수 있다.
이런 코드를 모든Controller메서드에 직접 넣으면 문제가 생긴다.
같은 코드가 여러 곳에 반복되고, 수정할 때도 여러 파일을 고쳐야 한다.
그리고Controller는 원래 처리해야 할 핵심 기능보다 부가 작업 코드로 복잡해진다.
Filter를 사용하면 이런 공통 작업을Controller바깥으로 분리할 수 있다.
그래서Controller는 실제 요청 처리에 집중하고, 공통 전처리와 후처리는Filter가 맡게 된다.
Spring MVC의 Controller 흐름에 들어가기 전에 처리해야 하는 작업에 적합하다
Filter는DispatcherServlet보다 먼저 동작한다.
따라서 요청이Spring MVC의Controller로 들어가기 전에 처리해야 하는 작업과 잘 맞는다.
예를 들어 다음과 같은 작업은Filter에 두기 좋다.
- 모든 요청에 대한 공통 로그
- 문자 인코딩 처리
- 공통 보안 검사
- 요청 또는 응답의 공통 가공
Spring MVC로 들어오기 전 먼저 걸러야 하는 작업
Filter는 요청 흐름의 가장 앞쪽에서 동작한다.
그래서 전체 요청에 넓게 적용할 공통 작업을 처리하는 데 적합하다.
다음 구간에서는Spring MVC내부에서Controller실행 전후에 동작하는Interceptor를 확인한다.
Interceptor
Interceptor는DispatcherServlet을 지난 요청이Controller에 도착하기 전후에 공통 작업을 처리하는 기능이다.
여기서Interceptor는 중간에서 가로채는 역할을 한다고 이해하면 된다.
요청이 바로Controller로 가기 전에 먼저 확인하거나,Controller실행 후에 공통 처리를 추가할 수 있다.
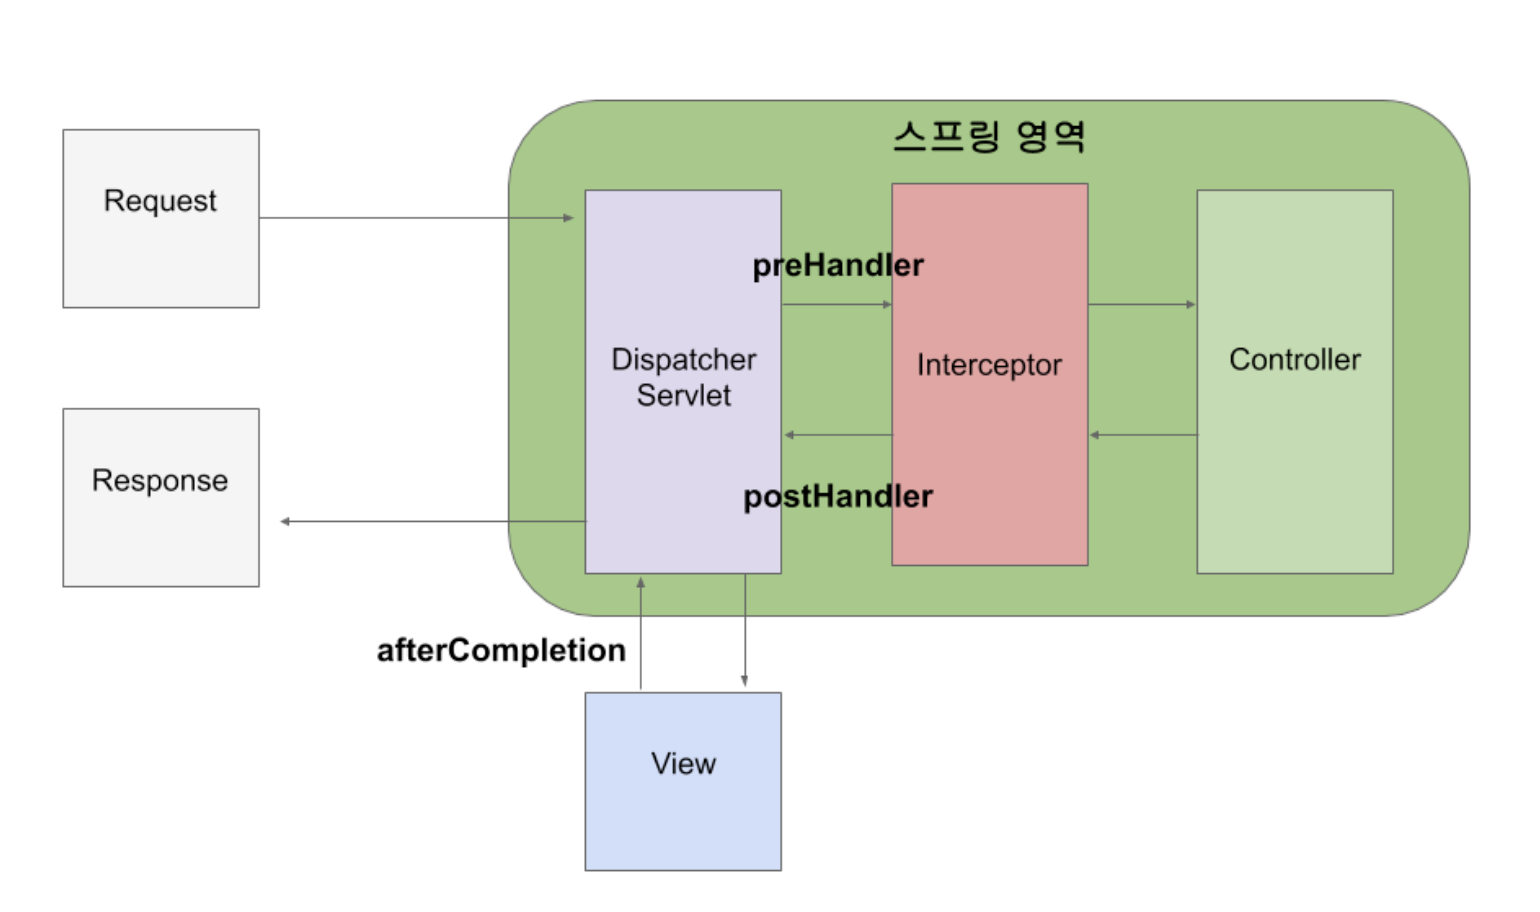
앞에서 본Filter가DispatcherServlet앞단에서 동작했다면,Interceptor는DispatcherServlet이후의Spring MVC흐름 안에서 동작한다.
Interceptor는Controller실행 전후를 기준으로 공통 작업을 넣고 싶을 때 사용한다.
그래서 로그인 여부 확인, 권한 확인, 특정URL요청 검사 같은 작업과 잘 어울린다.
Interceptor란
Controller 호출 전후로 동작한다
Interceptor는 요청이Controller에 도착하기 전과Controller가 실행된 후에 동작할 수 있다.
Controller는 실제 요청을 처리하는 메서드를 가진 클래스다.
예를 들어/interceptor-test요청이 들어오면 그 요청을 처리할Controller메서드가 실행된다.
그런데Interceptor를 등록해 두면 요청이Controller로 바로 가지 않는다.
먼저Interceptor의preHandle()이 실행되고, 그다음Controller가 실행된다.
Controller실행이 끝난 뒤에는postHandle()과afterCompletion()같은 후처리 메서드가 실행될 수 있다.
요청 흐름을 단순하게 보면 다음과 같다.
Client가 요청을 보낸다.- 요청이
DispatcherServlet에 도착한다.HandlerMapping이 실행할Controller를 찾는다.- 등록된
Interceptor가 먼저 실행된다.Controller가 요청을 처리한다.Controller실행 후Interceptor가 다시 후처리한다.- 응답이
Client에게 돌아간다.
Interceptor는DispatcherServlet이후의Spring MVC흐름 안에서 동작하고,Controller호출 전후와 요청 완료 후에 각각 다른 메서드로 공통 작업을 처리한다.
Interceptor는 Spring 내부에서 동작한다
Interceptor는Spring MVC내부 흐름에서 동작한다.
정확히 말하면 요청이DispatcherServlet에 들어온 뒤,HandlerMapping이 실행할Controller를 찾은 다음에Interceptor가 개입한다.
여기서HandlerMapping은 요청 주소와 실행할Controller메서드를 연결해 주는 역할을 한다.
예를 들어/interceptor-test요청이 들어오면 이 요청을 어떤Controller메서드가 처리해야 하는지 찾아준다.
Filter는Servlet Container의Filter Chain에서 먼저 동작했다.
반면Interceptor는Spring MVC가 어떤Controller를 실행할지 찾은 뒤에 동작한다.
그래서Interceptor는Spring MVC흐름에 더 가까운 공통 처리에 적합하다.
Filter는DispatcherServlet앞에서 동작하고,Interceptor는DispatcherServlet뒤에서Controller전후로 동작한다.
이 위치 차이를 알아야 두 기능을 헷갈리지 않는다.
Interceptor가 처리하기 좋은 작업
Interceptor는Controller실행 전후에 동작한다.
그래서 특정 요청이Controller로 들어가기 전에 검사해야 하는 작업과 잘 맞는다.
Interceptor에 어울리는 작업은 다음과 같다.
- 로그인 여부 확인
- 권한 확인
- 특정
URL요청 검사Controller실행 전 요청 정보 확인Controller실행 후 공통 후처리예를 들어 마이페이지 요청은 로그인한 사용자만 접근해야 한다.
이때 모든 마이페이지Controller메서드마다 로그인 확인 코드를 넣으면 코드가 반복된다.
Interceptor를 사용하면 특정URL패턴에 대해 로그인 확인을 공통으로 처리할 수 있다.
기본예제 HandlerInterceptor 구조 확인하기
HandlerInterceptor 코드 구조 먼저 보기
Interceptor를 만들려면HandlerInterceptor를 구현하면 된다.
여기서 구현은 이미 정해진 규칙에 맞춰 필요한 메서드를 작성한다는 뜻이다.
HandlerInterceptor에서 중요한 메서드는 세 가지다.
preHandle()은Controller실행 전에 동작한다.postHandle()은Controller실행 후에 동작한다.afterCompletion()은 요청 처리가 끝난 뒤 동작한다.이 세 메서드는 실행 시점이 다르다.
그래서 같은Interceptor안에서도 요청 전 처리, 요청 후 처리, 최종 마무리 처리를 나눠서 작성할 수 있다.
전체 코드로 구조 확인하기
먼저
Interceptor클래스 구조를 코드로 확인한다.
이 코드는Interceptor의 각 메서드가 언제 실행되는지 로그로 확인하기 위한 기본 구조다.
다만 이 클래스만 작성한다고 바로 실행되는 것은 아니다.
Interceptor는 다음 구간에서WebMvcConfig에 등록해야 실제 요청 흐름에 적용된다.// TestInterceptorExample.java import jakarta.servlet.http.HttpServletRequest; // HTTP 요청 정보를 담는 객체 import jakarta.servlet.http.HttpServletResponse; // HTTP 응답 정보를 담는 객체 import lombok.extern.slf4j.Slf4j; // 로그 출력을 위한 Lombok 애노테이션 import org.springframework.lang.Nullable; // null이 들어올 수 있음을 표시 import org.springframework.web.method.HandlerMethod; // Controller 메서드 정보를 담는 객체 import org.springframework.web.servlet.HandlerInterceptor; // Interceptor 기능을 구현하기 위한 인터페이스 import org.springframework.web.servlet.ModelAndView; // View와 Model 정보를 담는 객체 @Slf4j // log.info()를 사용할 수 있게 설정 public class TestInterceptorExample implements HandlerInterceptor { @Override public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception { log.info("[인터셉터] preHandle - Controller 실행 전"); // Controller 실행 전 로그 if (handler instanceof HandlerMethod handlerMethod) { // Controller 메서드인지 확인 log.info("[인터셉터] 실행할 메서드: {}", handlerMethod.getMethod().getName()); // 실행 메서드 이름 확인 } return true; // true이면 다음 단계로 진행 } @Override public void postHandle(HttpServletRequest request, HttpServletResponse response, Object handler, @Nullable ModelAndView modelAndView) throws Exception { log.info("[인터셉터] postHandle - Controller 실행 후"); // Controller 실행 후 로그 } @Override public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, @Nullable Exception ex) throws Exception { log.info("[인터셉터] afterCompletion - 요청 완료 후"); // 요청 완료 후 로그 } }이 코드는
preHandle(),postHandle(),afterCompletion()의 구조를 보여준다.
실제 실행 순서는Interceptor를 등록한 뒤 요청을 보내야 확인할 수 있다.
preHandle은 Controller 실행 전에 동작한다
preHandle()은Controller가 호출되기 전에 실행된다.
그래서 요청을 계속 진행할지, 중간에서 막을지를 결정할 수 있다.
preHandle()의 반환 타입은boolean이다.
boolean은 참 또는 거짓을 표현하는 타입이다.
여기서는true를 반환하면 다음 단계로 진행하고,false를 반환하면 요청 흐름을 중단한다.
정리하면preHandle()의 반환값은 아래처럼 이해하면 된다.
true를 반환하면Controller로 요청이 계속 진행된다.false를 반환하면Controller가 실행되지 않는다.예를 들어 로그인하지 않은 사용자가 마이페이지에 접근했다면
preHandle()에서 로그인 여부를 확인한 뒤false를 반환할 수 있다.
그러면Controller까지 요청이 가지 않게 막을 수 있다.
preHandle()의 세 번째 매개변수인handler는 실행될 요청 처리 대상을 의미한다.
보통Controller의 메서드 정보가 들어올 수 있다.
그래서 필요하면 어떤Controller메서드가 실행될 예정인지 확인할 수도 있다.
postHandle은 Controller 실행 후에 동작한다
postHandle()은Controller가 실행된 뒤에 호출된다.
즉, 요청을 처리할Controller메서드가 실행된 후에 추가로 처리할 작업이 있을 때 사용할 수 있다.
postHandle()에는ModelAndView라는 값이 전달될 수 있다.
ModelAndView는 화면에 보여 줄 데이터와 이동할 화면 정보를 함께 담는 객체다.
다만 최근에는Rest API처럼JSON데이터를 바로 반환하는@RestController를 많이 사용한다.
이 경우에는 화면을 만들기 위한ModelAndView를 직접 다루는 일이 적다.
그래서Rest API중심의Controller에서는postHandle()을 자주 사용하지 않을 수도 있다.
또한Controller나 그 아래 로직에서 예외가 발생하면postHandle()은 호출되지 않을 수 있다.
그래서 반드시 실행되어야 하는 마무리 작업은postHandle()보다afterCompletion()에 두는 것이 더 적합하다.
중요한 점은postHandle()이Controller실행 후 작업이라는 점이다.
요청 전 검사는preHandle()이 맡고,Controller실행 후 후처리는postHandle()이 맡는다고 구분하면 된다.
afterCompletion은 요청이 끝난 뒤 동작한다
afterCompletion()은 요청 처리가 끝난 뒤 실행된다.
이름 그대로 요청 처리의 마지막 단계에 가깝다.
afterCompletion()은 요청 중 사용한 자원을 정리하거나, 최종 로그를 남길 때 사용할 수 있다.
예를 들어 요청 처리 시간이 얼마나 걸렸는지 기록하거나, 예외가 발생했는지 확인하는 작업을 넣을 수 있다.
afterCompletion()의 마지막 매개변수인Exception ex는 요청 처리 중 발생한 예외 정보를 받을 수 있다.
예외가 없으면null일 수 있다.
그래서 예외가 발생했을 때만 별도 로그를 남기고 싶다면ex를 확인하면 된다.
afterCompletion()은 요청 처리의 마지막 정리 작업을 넣기 좋은 메서드다.
preHandle()은 시작 전 검사,postHandle()은Controller실행 후 작업,afterCompletion()은 최종 마무리 작업으로 구분하면 된다.
기본예제 WebMvcConfig에서 Interceptor 등록하기
WebMvcConfig 코드 구조 먼저 보기
Interceptor클래스만 만들어서는 요청 흐름에 자동으로 적용되지 않는다.
어떤 요청에 이Interceptor를 적용할지 등록해야 한다.
Spring MVC에서는WebMvcConfigurer를 구현한 설정 클래스에서addInterceptors()메서드를 사용해Interceptor를 등록할 수 있다.
여기서 설정 클래스는 애플리케이션의 동작 방식을 정하는 클래스라고 이해하면 된다.
이번 예제에서는 아래 흐름을 확인한다.
- 앞에서 만든
TestInterceptorExample을 사용한다.WebMvcConfig에서Interceptor를 등록한다.- 전체 요청에
Interceptor를 적용한다./interceptor-exclude요청은Interceptor적용 대상에서 제외한다.- 테스트용
Controller에서 요청 처리 로그를 출력한다.- 로그 순서로 실행 흐름을 확인한다.
전체 코드로 흐름 확인하기
이번에는 실제로
Interceptor가 실행되도록 설정 클래스와 테스트용Controller를 함께 작성한다.
코드는 파일별로 나누어 보는 것이 좋다.// WebMvcConfig.java import org.springframework.context.annotation.Configuration; // 설정 클래스 등록 import org.springframework.web.servlet.config.annotation.InterceptorRegistry; // Interceptor 등록 객체 import org.springframework.web.servlet.config.annotation.WebMvcConfigurer; // Spring MVC 설정 확장 @Configuration // Spring 설정 클래스로 등록 public class WebMvcConfig implements WebMvcConfigurer { @Override public void addInterceptors(InterceptorRegistry registry) { registry.addInterceptor(new TestInterceptorExample()) // 등록할 Interceptor 지정 .addPathPatterns("/**") // 전체 URL에 Interceptor 적용 .excludePathPatterns("/interceptor-exclude"); // 제외할 URL 지정 } }// InterceptorTestController.java import lombok.extern.slf4j.Slf4j; // 로그 출력을 위한 Lombok 애노테이션 import org.springframework.web.bind.annotation.GetMapping; // GET 요청 매핑 import org.springframework.web.bind.annotation.RestController; // REST Controller 등록 @RestController // 문자열 응답을 바로 반환하는 Controller @Slf4j // Controller에서도 로그 출력 public class InterceptorTestController { @GetMapping("/interceptor-test") // Interceptor가 적용되는 요청 주소 public String interceptorTest() { log.info("[컨트롤러] 요청 처리"); // Controller 실행 확인 return "interceptor test"; // 응답 본문 반환 } @GetMapping("/interceptor-exclude") // Interceptor가 제외되는 요청 주소 public String interceptorExclude() { log.info("[컨트롤러] 제외 요청 처리"); // 제외 요청 실행 확인 return "interceptor exclude"; // 응답 본문 반환 } }// 출력결과 // [인터셉터] preHandle - Controller 실행 전 // [인터셉터] 실행할 메서드: interceptorTest // [컨트롤러] 요청 처리 // [인터셉터] postHandle - Controller 실행 후 // [인터셉터] afterCompletion - 요청 완료 후// 제외 URL 요청 출력결과 // [컨트롤러] 제외 요청 처리첫 번째 출력 결과는
/interceptor-test요청을 보냈을 때의 흐름이다.
/interceptor-test는/interceptor-exclude가 아니므로addPathPatterns("/**")에 의해Interceptor가 적용된다.
먼저preHandle()이 실행되고, 그 다음Controller가 실행된다.
Controller처리가 끝난 뒤postHandle()이 실행되고, 마지막으로afterCompletion()이 실행된다.
두 번째 출력 결과는/interceptor-exclude요청을 보냈을 때의 흐름이다.
이 요청은excludePathPatterns("/interceptor-exclude")에 등록되어 있으므로Interceptor로그가 출력되지 않는다.
Controller의 제외 요청 로그만 출력된다.
addInterceptor로 Interceptor 객체를 등록한다
addInterceptor()는 어떤Interceptor를 요청 흐름에 넣을지 정하는 메서드다.
예제에서는 아래처럼TestInterceptorExample객체를 등록했다.// AddInterceptorExample.java registry.addInterceptor(new TestInterceptorExample()) // 등록할 Interceptor 지정 .addPathPatterns("/**"); // 전체 URL에 Interceptor 적용이 코드는
TestInterceptorExample을Spring MVC요청 흐름에 넣겠다는 뜻이다.
이렇게 등록해야preHandle(),postHandle(),afterCompletion()이 실제 요청에서 실행된다.
Interceptor를 등록하지 않으면TestInterceptorExample클래스를 만들어도 요청 흐름에 적용되지 않는다.
즉, 클래스 작성과 등록은 서로 다른 단계다.
addPathPatterns로 적용할 URL을 정한다
addPathPatterns()는Interceptor를 적용할 요청 주소를 정하는 메서드다.
예제에서는/**를 사용해서 전체 요청에Interceptor를 적용했다.
/**는 모든 하위 경로를 포함한다는 뜻이다.
즉,/interceptor-test,/mypage/profile,/admin/users같은 요청이 모두 적용 대상이 될 수 있다.
이 기능은 특정 영역이나 전체 요청에 공통 작업을 적용할 때 유용하다.
예를 들어/mypage/**요청에만 로그인 검사를 적용하거나,/admin/**요청에만 관리자 권한 검사를 적용할 수 있다.
excludePathPatterns로 제외할 URL을 정한다
excludePathPatterns()는Interceptor적용 대상에서 제외할 요청 주소를 정하는 메서드다.
전체 요청에Interceptor를 적용하되, 일부 요청은 제외하고 싶을 때 사용한다.
예를 들어 로그인 검사를 하는Interceptor가 있다고 생각해 보자.
이때 로그인 페이지 자체까지 로그인 검사를 적용하면 문제가 생긴다.
로그인하려고 들어갔는데 로그인하지 않았다는 이유로 계속 막힐 수 있기 때문이다.
그래서 로그인 페이지, 회원가입 페이지, 정적 자원 같은 요청은 제외 경로로 등록하는 경우가 많다.
예제에서는/interceptor-exclude를 제외 경로로 등록했다.
정리하면 경로 설정은 아래처럼 이해하면 된다.
addPathPatterns()는Interceptor를 적용할 주소를 정한다.excludePathPatterns()는 적용 대상 중에서 제외할 주소를 정한다.이 두 메서드를 함께 사용하면 필요한 요청에만
Interceptor를 적용할 수 있다.
Interceptor가 필요한 이유
Controller에 들어가기 전 요청을 검사할 수 있다
Interceptor의 가장 큰 장점은Controller실행 전에 요청을 검사할 수 있다는 점이다.
특히preHandle()은Controller가 실행되기 전에 동작하므로, 요청을 계속 진행할지 중단할지 결정하기 좋다.
예를 들어 로그인 확인이 필요한 요청이 있다고 생각해 보자.
로그인하지 않은 사용자가 접근했다면preHandle()에서 로그인 여부를 확인한 뒤false를 반환할 수 있다.
그러면Controller까지 요청이 가지 않게 막을 수 있다.
로그인한 사용자라면true를 반환해서Controller로 요청을 계속 진행시킬 수 있다.
이런 코드를 모든Controller에 직접 작성하지 않아도 된다.
Interceptor를 등록해 두면 특정URL패턴에 대해 공통으로 요청 검사를 처리할 수 있다.
URL 단위로 공통 작업을 적용하기 쉽다
Interceptor는addPathPatterns()와excludePathPatterns()로 적용할 경로를 정할 수 있다.
그래서 요청 주소 단위로 공통 작업을 적용하거나 제외하기 쉽다.
예를 들어 다음처럼 나눌 수 있다.
/mypage/**에는 로그인 확인을 적용한다./admin/**에는 관리자 권한 확인을 적용한다./login,/signup,/css/**는 검사 대상에서 제외한다.이렇게 하면
Controller는 실제 기능 처리에 집중할 수 있다.
로그인 확인, 권한 확인, 공통 로그 같은 부가 작업은Interceptor에서 관리할 수 있다.
Interceptor는Spring MVC흐름 안에서 동작하기 때문에Controller와 가까운 요청 검사에 적합하다.
다음 구간에서는 앞에서 배운Filter와Interceptor를 함께 비교해서, 어떤 작업을 어디에 두는 것이 좋은지 정리한다.
Filter와 Interceptor 차이
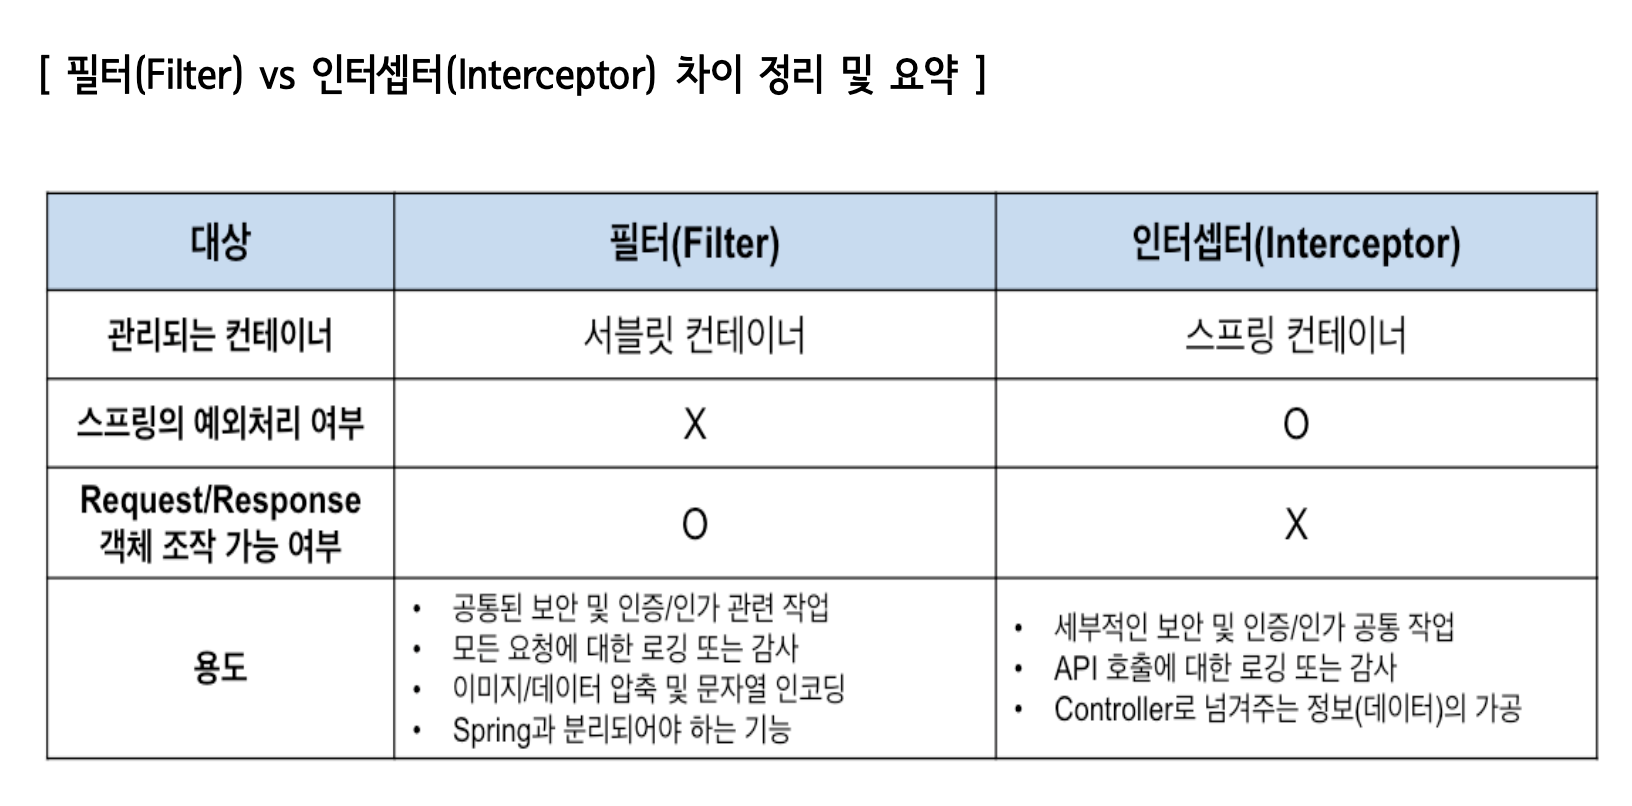
Filter와Interceptor는 둘 다 여러 요청에서 반복되는 공통 작업을 처리할 때 사용한다.
하지만 두 기능은 같은 위치에서 동작하지 않는다.
Filter와Interceptor의 가장 큰 차이는 요청을 가로채는 위치다.
Filter는DispatcherServlet에 요청이 들어가기 전에 먼저 동작한다.
Interceptor는DispatcherServlet을 지난 뒤,Controller가 실행되기 전후에 동작한다.
그래서 둘 다 공통 작업을 처리할 수 있지만, 어떤 작업을 어디에 둘지는 요청 흐름에서의 위치를 기준으로 판단해야 한다.
Filter와 Interceptor 차이 정리
관리되는 컨테이너가 다르다
Filter는Servlet Container영역에서 동작한다.
여기서Servlet Container는Tomcat처럼Servlet요청과 응답을 실행하고 관리하는 환경이다.
Interceptor는Spring Container영역에서 동작한다.
Spring Container는Controller,Service,Repository같은Spring객체를 생성하고 관리하는 영역이다.
즉,Filter는Spring MVC의 핵심 요청 처리 흐름보다 앞에서 동작하고,Interceptor는Spring MVC내부 흐름에서 동작한다.
차이를 표로 보면 다음과 같다.
Filter는Servlet Container영역에서 동작하고,Interceptor는Spring Container영역에서 동작한다.
둘 다 공통 작업을 처리하지만, 요청을 가로채는 위치와 적합한 작업이 다르다.
Spring 예외 처리 적용 여부가 다르다
Filter는DispatcherServlet보다 앞에서 동작한다.
그래서Spring MVC내부의 예외 처리 흐름과는 거리가 있다.
여기서Spring MVC의 예외 처리 흐름은Controller나Service에서 발생한 예외를Spring이 정해진 방식으로 처리하는 구조를 의미한다.
예를 들어@ControllerAdvice나 예외 처리 설정은 보통Spring MVC요청 처리 흐름 안에서 동작한다.
반면Interceptor는DispatcherServlet이후의Spring MVC흐름 안에서 동작한다.
그래서Controller실행 전후 흐름과 더 가깝고,afterCompletion()에서는 요청 처리 중 발생한 예외 정보도 확인할 수 있다.
정리하면 다음과 같다.
Filter는Spring MVC예외 처리 흐름 바깥쪽에 가깝다.Interceptor는Spring MVC흐름 안에서 동작한다.Interceptor의afterCompletion()은 예외 정보를 확인하는 마무리 작업에 사용할 수 있다.이 차이 때문에
Filter는 요청이Spring MVC내부로 들어가기 전의 넓은 공통 처리에 적합하고,Interceptor는Controller와 가까운 요청 검사와 후처리에 적합하다.
Request와 Response 객체를 다루는 범위가 다르다
Filter는ServletRequest와ServletResponse를 직접 받아 처리한다.
그래서 요청이나 응답 객체를 앞단에서 공통으로 다루는 작업에 적합하다.
예를 들어 요청 문자 인코딩을 맞추거나, 요청과 응답을 감싸서 공통 처리를 하는 작업은Filter쪽에서 다루기 좋다.
Filter는 요청이DispatcherServlet에 들어가기 전부터 요청과 응답을 만지기 때문이다.
Interceptor도HttpServletRequest와HttpServletResponse를 매개변수로 받을 수 있다.
하지만 역할의 중심은 요청과 응답 객체 자체를 감싸거나 바꾸는 것보다,Controller실행 전후에 요청을 검사하고 공통 작업을 넣는 데 있다.
이 단계에서는 아래처럼 이해하면 된다.
Filter는 요청과 응답 객체를 더 앞단에서 공통으로 다루는 데 적합하다.Interceptor는Controller실행 전후에 요청을 검사하고 흐름을 제어하는 데 적합하다.그래서 요청 자체를 넓게 가공해야 하면
Filter를 먼저 떠올리고, 특정Controller요청을 검사해야 하면Interceptor를 먼저 떠올리면 된다.
실행 위치가 다르다
요청이 들어오는 순서를 기준으로 보면
Filter가 먼저 실행된다.
요청은 먼저Servlet Container의Filter Chain을 지나고, 그다음DispatcherServlet으로 들어간다.
Interceptor는DispatcherServlet이 요청을 받은 뒤에 실행된다.
정확히는HandlerMapping이 어떤Controller를 실행할지 찾은 뒤,Controller실행 전후에Interceptor가 동작한다.
흐름을 단순하게 정리하면 다음과 같다.
Client가 요청을 보낸다.Filter가 먼저 요청을 처리한다.DispatcherServlet이 요청을 받는다.HandlerMapping이 실행할Controller를 찾는다.Interceptor의preHandle()이 실행된다.Controller가 실행된다.Interceptor의postHandle()과afterCompletion()이 실행된다.- 응답이 다시
Filter를 거쳐 나간다.요청이 들어갈 때는
Filter가Interceptor보다 먼저 실행되고, 응답이 돌아올 때는Filter의 후처리가 마지막에 실행된다.
이 흐름을 알아야 로그 출력 순서를 보고 어디에서 실행된 코드인지 이해할 수 있다.
사용할 작업이 다르다
Filter는Spring MVC의Controller흐름에 들어가기 전에 처리해야 하는 작업과 잘 맞는다.
모든 요청을 넓게 대상으로 잡고, 요청 자체를 먼저 검사하거나 가공할 때 사용하기 좋다.
Filter에 어울리는 작업은 다음과 같다.
- 모든 요청에 대한 공통 로그
- 문자 인코딩 처리
- 공통 보안 검사
- 요청 또는 응답 객체의 공통 가공
Spring MVC의Controller흐름에 들어가기 전에 먼저 걸러야 하는 작업
Interceptor는Controller와 가까운 위치에서 요청을 검사할 때 사용하기 좋다.
특정URL패턴에 대해 로그인 여부나 권한을 검사하고,Controller실행 전후에 공통 작업을 넣을 수 있다.
Interceptor에 어울리는 작업은 다음과 같다.
- 로그인 여부 확인
- 권한 확인
- 특정
URL요청 검사Controller실행 전 요청 정보 확인Controller실행 후 공통 후처리정리하면
Filter는 더 앞단의 넓은 공통 처리에 적합하다.
Interceptor는Spring MVC내부에서Controller와 가까운 요청 검사에 적합하다.
기본예제 Filter와 Interceptor 실행 순서 확인하기
예제에서 확인할 흐름 먼저 보기
이번 예제의 목표는
Filter,Interceptor,Controller가 함께 있을 때 어떤 순서로 실행되는지 확인하는 것이다.
이전 구간에서Filter는DispatcherServlet앞에서 동작한다고 정리했다.
그리고Interceptor는DispatcherServlet이후,Controller실행 전후에 동작한다고 정리했다.
이번 예제에서는 로그를 통해 이 순서를 직접 확인한다.
확인할 흐름은 다음과 같다.
Filter요청 전 로그가 먼저 출력된다.Interceptor의preHandle()로그가 출력된다.Controller로그가 출력된다.Interceptor의postHandle()로그가 출력된다.Interceptor의afterCompletion()로그가 출력된다.Filter요청 후 로그가 마지막에 출력된다.이 순서를 보면 요청이 들어갈 때와 응답이 돌아올 때의 흐름을 함께 이해할 수 있다.
전체 코드로 흐름 확인하기
이번 예제는
Filter,Interceptor,WebMvcConfig,Controller를 함께 사용한다.
코드는 파일별로 나누어 보는 것이 좋다.
그래야 어떤 클래스가 어떤 역할을 하는지 헷갈리지 않는다.// RequestOrderFilter.java import jakarta.servlet.Filter; // Filter 기능을 구현하기 위한 인터페이스 import jakarta.servlet.FilterChain; // 다음 단계로 요청을 넘기기 위한 객체 import jakarta.servlet.ServletException; // Servlet 처리 중 예외 표현 import jakarta.servlet.ServletRequest; // 요청 정보를 담는 객체 import jakarta.servlet.ServletResponse; // 응답 정보를 담는 객체 import lombok.extern.slf4j.Slf4j; // 로그 출력을 위한 Lombok 애노테이션 import org.springframework.core.annotation.Order; // Filter 실행 순서 지정 import org.springframework.stereotype.Component; // Spring Bean으로 등록 import java.io.IOException; // 입출력 예외 표현 @Component // Filter 객체 등록 @Slf4j // log.info() 사용 @Order(1) // 숫자가 작을수록 먼저 실행 public class RequestOrderFilter implements Filter { @Override public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException { log.info("[필터] 요청 전"); // DispatcherServlet으로 가기 전 실행 chain.doFilter(request, response); // 다음 Filter 또는 DispatcherServlet 흐름으로 이동 log.info("[필터] 요청 후"); // 응답이 돌아올 때 실행 } }// RequestOrderInterceptor.java import jakarta.servlet.http.HttpServletRequest; // HTTP 요청 정보를 담는 객체 import jakarta.servlet.http.HttpServletResponse; // HTTP 응답 정보를 담는 객체 import lombok.extern.slf4j.Slf4j; // 로그 출력을 위한 Lombok 애노테이션 import org.springframework.lang.Nullable; // null 가능 표시 import org.springframework.web.servlet.HandlerInterceptor; // Interceptor 기능 구현 import org.springframework.web.servlet.ModelAndView; // View와 Model 정보 @Slf4j // log.info() 사용 public class RequestOrderInterceptor implements HandlerInterceptor { @Override public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception { log.info("[인터셉터] preHandle"); // Controller 실행 전 return true; // Controller로 요청 진행 } @Override public void postHandle(HttpServletRequest request, HttpServletResponse response, Object handler, @Nullable ModelAndView modelAndView) throws Exception { log.info("[인터셉터] postHandle"); // Controller 실행 후 } @Override public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, @Nullable Exception ex) throws Exception { log.info("[인터셉터] afterCompletion"); // 요청 완료 후 } }// RequestOrderWebMvcConfig.java import org.springframework.context.annotation.Configuration; // 설정 클래스 등록 import org.springframework.web.servlet.config.annotation.InterceptorRegistry; // Interceptor 등록 객체 import org.springframework.web.servlet.config.annotation.WebMvcConfigurer; // Spring MVC 설정 확장 @Configuration // Spring MVC 설정 클래스 public class RequestOrderWebMvcConfig implements WebMvcConfigurer { @Override public void addInterceptors(InterceptorRegistry registry) { registry.addInterceptor(new RequestOrderInterceptor()) // Interceptor 등록 .addPathPatterns("/order-test"); // 테스트 URL에만 적용 } }// RequestOrderController.java import lombok.extern.slf4j.Slf4j; // 로그 출력을 위한 Lombok 애노테이션 import org.springframework.web.bind.annotation.GetMapping; // GET 요청 매핑 import org.springframework.web.bind.annotation.RestController; // REST Controller 등록 @RestController // 문자열 응답을 바로 반환하는 Controller @Slf4j // Controller에서도 로그 출력 public class RequestOrderController { @GetMapping("/order-test") // 실행 순서 확인용 요청 주소 public String orderTest() { log.info("[컨트롤러] 요청 처리"); // Controller 실행 확인 return "order test"; // 응답 본문 반환 } }// 출력결과 // [필터] 요청 전 // [인터셉터] preHandle // [컨트롤러] 요청 처리 // [인터셉터] postHandle // [인터셉터] afterCompletion // [필터] 요청 후출력 결과를 보면
Filter의 요청 전 로그가 가장 먼저 출력된다.
그 다음Interceptor의preHandle()이 실행되고, 이후Controller가 요청을 처리한다.
Controller처리가 끝나면postHandle()과afterCompletion()이 실행된다.
마지막으로 응답이 돌아오면서Filter의 요청 후 로그가 출력된다.
Filter가 먼저 실행되는 이유
Filter가 먼저 실행되는 이유는 요청이DispatcherServlet에 도착하기 전에Servlet Container의Filter Chain을 먼저 지나기 때문이다.
즉,Filter는Spring MVC가 어떤Controller를 실행할지 찾기 전 단계에서 동작한다.
그래서 모든 요청에 대해 넓게 공통 처리를 적용하기 좋다.
예제 출력 결과에서도 이 흐름이 보인다.// FilterFirstOutputExample.java // [필터] 요청 전 // [인터셉터] preHandle
[필터] 요청 전이[인터셉터] preHandle보다 먼저 출력된다.
이것은Filter가Interceptor보다 앞단에서 실행된다는 뜻이다.
Interceptor가 Controller 전에 실행되는 이유
Interceptor는DispatcherServlet이후의Spring MVC흐름에서 동작한다.
요청이 들어오면HandlerMapping이 실행할Controller를 찾고, 그 뒤에Interceptor의preHandle()이 실행된다.
preHandle()이true를 반환하면 요청은Controller로 계속 진행된다.
false를 반환하면Controller는 실행되지 않는다.
예제 출력 결과에서는 아래 순서를 볼 수 있다.// InterceptorBeforeControllerOutputExample.java // [인터셉터] preHandle // [컨트롤러] 요청 처리
[인터셉터] preHandle이 먼저 출력되고, 그 다음[컨트롤러] 요청 처리가 출력된다.
이것은Interceptor가Controller실행 전에 요청을 검사할 수 있다는 뜻이다.
응답이 돌아올 때 실행 순서가 반대로 보이는 이유
요청이 들어갈 때는
Filter→Interceptor→Controller순서로 진행된다.
하지만 응답이 돌아올 때는 안쪽에서 바깥쪽으로 빠져나온다.
그래서Controller실행 후에는 먼저Interceptor의 후처리 메서드가 실행된다.
그다음 가장 바깥쪽에 있던Filter의chain.doFilter()다음 줄로 돌아와 요청 후 로그가 출력된다.
예제 출력 결과에서는 아래 순서를 볼 수 있다.// ResponseReturnOrderExample.java // [컨트롤러] 요청 처리 // [인터셉터] postHandle // [인터셉터] afterCompletion // [필터] 요청 후
Filter의 요청 후 로그가 가장 마지막에 출력되는 이유는Filter가 요청 흐름의 바깥쪽에 있기 때문이다.
요청이 들어갈 때는 가장 먼저 실행되지만, 응답이 돌아올 때는 가장 마지막에 후처리를 한다.
Filter는 요청 흐름의 바깥쪽에 있고,Interceptor는Controller에 더 가까운 안쪽에 있다.
그래서 요청이 들어갈 때와 응답이 돌아올 때의 실행 순서가 다르게 보인다.
어떤 작업을 Filter에 두고 어떤 작업을 Interceptor에 둘지 판단하기
Filter에 두기 좋은 작업
Filter는DispatcherServlet앞에서 동작한다.
따라서Spring MVC의Controller흐름에 들어가기 전에 처리해야 하는 작업과 잘 맞는다.
Filter에 두기 좋은 작업은 다음과 같다.
- 모든 요청에 대한 공통 로그
- 문자 인코딩 처리
- 공통 보안 검사
- 요청 또는 응답 객체의 공통 가공
Spring MVC의Controller흐름에 들어가기 전 먼저 걸러야 하는 작업예를 들어 요청 문자 인코딩을 맞추는 작업은 특정
Controller에만 필요한 작업이 아니다.
전체 요청에 공통으로 적용되는 작업이다.
이런 경우에는Filter가 더 적합하다.
Interceptor에 두기 좋은 작업
Interceptor는DispatcherServlet이후,Controller실행 전후에 동작한다.
그래서 특정Controller요청과 가까운 공통 검사에 적합하다.
Interceptor에 두기 좋은 작업은 다음과 같다.
- 로그인 확인
- 권한 확인
- 특정
URL요청 검사Controller실행 전 요청 정보 확인Controller실행 후 공통 후처리예를 들어 마이페이지 요청에 로그인 검사를 적용해야 한다면
Interceptor가 적합하다.
/mypage/**같은URL패턴에만 적용하고,/login이나/signup같은 요청은 제외할 수 있기 때문이다.
선택 기준은 요청 흐름에서의 위치다
Filter와Interceptor중 무엇을 사용할지는 “어느 위치에서 처리해야 하는 작업인가”를 기준으로 판단하면 된다.
정리하면 다음과 같다.
- 요청이
Spring MVC의Controller흐름에 들어가기 전에 처리해야 하면Filter가 적합하다.Controller실행 전후에 처리해야 하면Interceptor가 적합하다.- 전체 요청에 넓게 적용할 작업이면
Filter가 적합하다.- 특정
URL패턴 중심의 검사라면Interceptor가 적합하다.
Filter와Interceptor는 경쟁 관계가 아니다.
둘 다 공통 작업을 처리하기 위한 기능이지만, 동작 위치와 사용 목적이 다르다.
이 차이를 이해하면 공통 로직을 더 알맞은 위치에 배치할 수 있다.
다음 구간에서는 이 흐름을 더 넓게 확장해서Spring MVC전체 처리 흐름 안에서Filter,Interceptor,Controller,Service,Repository가 어떻게 이어지는지 정리한다.
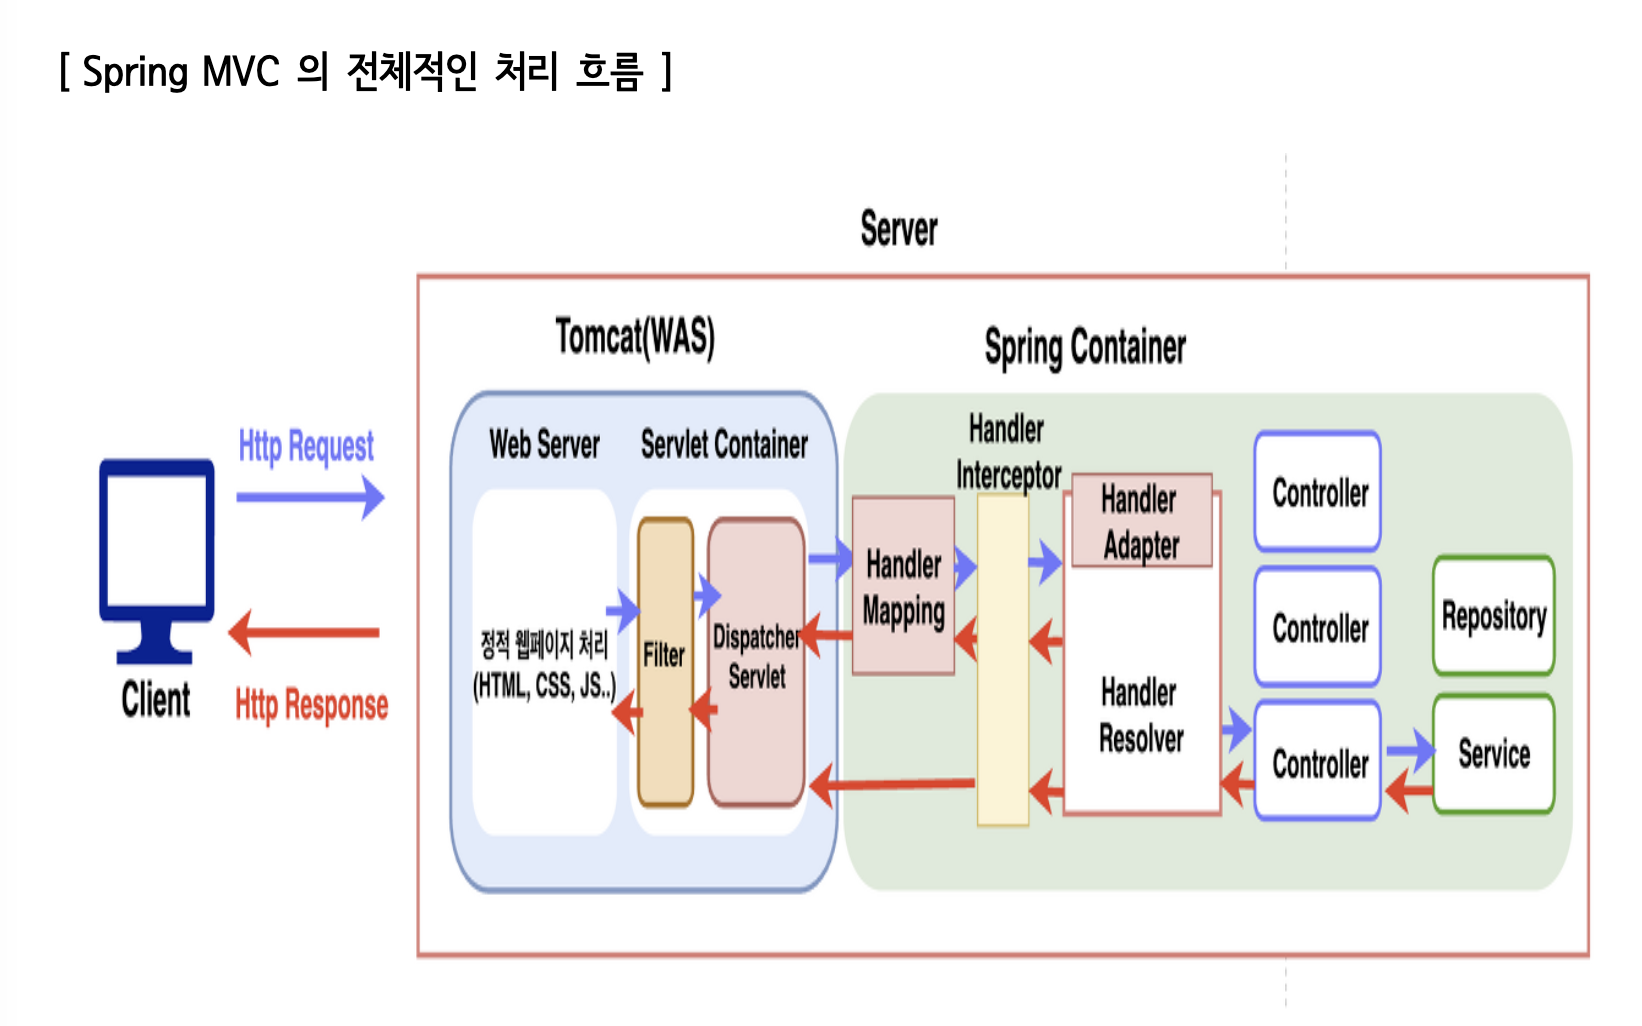
Spring MVC 전체 처리 흐름
Spring MVC전체 처리 흐름은Client가 보낸 요청이 서버 안에서 어떤 순서로 이동하는지 정리하는 구간이다.
앞에서Filter와Interceptor를 따로 봤다면, 이번에는 이 둘을Controller,Service,Repository흐름까지 이어서 한 번에 연결한다.
Spring MVC요청 흐름을 이해하면 내가 작성한 코드가 요청 처리 과정의 어느 위치에서 실행되는지 알 수 있다.
그래서Filter,Interceptor,Controller,Service,Repository의 역할을 따로 외우는 것이 아니라 하나의 흐름으로 이해할 수 있다.
Spring MVC 전체 처리 흐름이란
요청이 들어오는 전체 순서
Spring MVC에서 요청은 바로Controller로 들어가지 않는다.
Client가 요청을 보내면 서버 안의 여러 단계를 거쳐서Controller까지 도착한다.
전체 흐름을 크게 보면 다음과 같다.
Client가HTTP Request를 보낸다.Tomcat같은WAS가 요청을 받는다.- 요청은 설정에 따라
Filter를 먼저 지날 수 있다.- 정적 자원 요청이면
HTML,CSS,JS같은 파일이DispatcherServlet까지 가지 않고 처리될 수 있다.Spring MVC가 처리해야 하는 요청이면DispatcherServlet이 요청을 받는다.HandlerMapping이 실행할Controller를 찾는다.Interceptor가Controller실행 전후에 동작한다.HandlerAdapter가 실제Controller메서드를 실행한다.Controller는 필요한 경우Service를 호출한다.Service는 비즈니스 로직을 처리한다.Repository는 데이터 저장소와 연결되는 역할을 한다.- 처리 결과가 다시 응답으로 돌아간다.
요청은
Filter를 거쳐DispatcherServlet으로 들어가고, 이후HandlerMapping,Interceptor,HandlerAdapter,Controller,Service,Repository흐름으로 이어진다.
각 단계의 역할을 나눠서 이해한다
전체 흐름을 처음 보면 복잡해 보일 수 있다.
하지만 각 단계가 맡은 역할을 하나씩 나누면 이해하기 쉽다.
Client는 요청을 보내는 쪽이다.
브라우저, 모바일 앱, 다른 서버 프로그램이Client가 될 수 있다.
Tomcat은 서버에서 요청을 받는 실행 환경이다.
Spring Boot를 실행하면 내부적으로Tomcat이 함께 실행되어 웹 요청을 받을 수 있다.
Filter는DispatcherServlet에 요청이 들어가기 전후에 공통 작업을 처리한다.
요청 로그, 인코딩, 보안 관련 검사처럼 전체 요청에 넓게 적용할 작업에 적합하다.
DispatcherServlet은Spring MVC요청 처리의 중심이다.
요청을 직접 처리하는 것이 아니라, 어떤Controller가 처리해야 하는지 찾고 실행 흐름을 연결한다.
HandlerMapping은 요청 주소와Controller메서드를 연결해 준다.
예를 들어/mvc-flow-test요청이 들어오면 이 요청을 처리할 메서드를 찾는다.
Interceptor는Controller실행 전후에 공통 작업을 처리한다.
로그인 확인, 권한 확인, 특정URL검사처럼Controller와 가까운 요청 검사에 적합하다.
HandlerAdapter는 찾은Controller메서드를 실제로 실행해 주는 역할을 한다.
개발자가 예제 코드에서 직접 작성하는 클래스는 아니지만,DispatcherServlet이 찾은Controller메서드를 실행할 때 내부적으로 사용된다.
DispatcherServlet이 요청 처리 전체를 조율하고,HandlerAdapter가 실제 실행을 도와준다고 보면 된다.
Controller는 요청을 받아 필요한 처리를 시작하는 진입점이다.
하지만 복잡한 비즈니스 로직을 전부Controller에 넣지는 않는다.
필요한 처리는Service에게 넘긴다.
Service는 핵심 비즈니스 로직을 처리한다.
예를 들어 회원 가입, 주문 처리, 게시글 등록 같은 실제 기능 흐름이 여기에 들어간다.
Repository는 데이터 저장소와 연결되는 역할을 한다.
DB에서 데이터를 조회하거나 저장하는 작업을 담당한다.
정리하면Controller는 요청을 받고,Service는 핵심 로직을 처리하고,Repository는 데이터 저장소와 연결된다.
이 흐름을 알면 각 코드를 어느 위치에 작성해야 하는지도 더 쉽게 판단할 수 있다.
Filter와 Interceptor 위치를 다시 확인한다
Filter와Interceptor는 둘 다 공통 작업을 처리하지만 위치가 다르다.
이 차이는 전체 흐름 안에서 보면 더 분명해진다.
Filter는DispatcherServlet앞에 있다.
그래서 요청이Spring MVC의Controller흐름에 들어가기 전 공통 처리를 맡기 좋다.
Interceptor는DispatcherServlet뒤에 있다.
정확히는HandlerMapping이 실행할Controller를 찾은 뒤,Controller실행 전후에 동작한다.
흐름을 짧게 정리하면 다음과 같다.
Filter는DispatcherServlet앞에서 동작한다.Interceptor는DispatcherServlet뒤에서 동작한다.Controller는 실제 요청을 처리하는 진입점이다.Service는 핵심 기능 로직을 처리한다.Repository는 데이터 저장소와 연결된다.
Filter와Interceptor를 구분할 때는 “어느 위치에서 요청을 가로채는가”를 기준으로 보면 된다.
위치를 기준으로 보면 어떤 공통 작업을 어디에 둬야 하는지도 자연스럽게 정리된다.
기본예제 요청 흐름을 로그로 확인하기
예제 목표
이번 예제의 목표는 요청 하나가 들어왔을 때
Filter,Interceptor,Controller,Service,Repository가 어떤 순서로 실행되는지 로그로 확인하는 것이다.
실제 프로젝트에서는 요청 하나가 들어오면 여러 계층을 거쳐 처리된다.
이 예제에서는 복잡한DB연결까지 하지 않고, 각 계층에서 로그를 출력해서 흐름만 확인한다.
확인할 흐름은 다음과 같다.
Filter요청 전 로그가 출력된다.Interceptor의preHandle()로그가 출력된다.Controller로그가 출력된다.Service로그가 출력된다.Repository로그가 출력된다.Interceptor의postHandle()로그가 출력된다.Interceptor의afterCompletion()로그가 출력된다.Filter요청 후 로그가 출력된다.이 순서를 보면 요청이 들어갈 때의 흐름과 응답이 돌아올 때의 흐름을 함께 이해할 수 있다.
전체 코드로 흐름 확인하기
이번 예제는 파일을 나누어 보는 것이 좋다.
각 파일이 요청 처리 흐름에서 맡는 위치가 다르기 때문이다.
먼저Filter는 요청이DispatcherServlet으로 들어가기 전후에 실행된다.// MvcFlowFilter.java import jakarta.servlet.Filter; // Filter 기능을 구현하기 위한 인터페이스 import jakarta.servlet.FilterChain; // 다음 단계로 요청을 넘기는 객체 import jakarta.servlet.ServletException; // Servlet 처리 예외 import jakarta.servlet.ServletRequest; // 요청 정보 객체 import jakarta.servlet.ServletResponse; // 응답 정보 객체 import lombok.extern.slf4j.Slf4j; // 로그 출력용 Lombok 애노테이션 import org.springframework.core.annotation.Order; // Filter 실행 순서 지정 import org.springframework.stereotype.Component; // Spring Bean 등록 import java.io.IOException; // 입출력 예외 @Component // Filter를 Bean으로 등록 @Slf4j // log.info() 사용 @Order(1) // 숫자가 작을수록 먼저 실행 public class MvcFlowFilter implements Filter { @Override public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException { log.info("[Filter] 요청 전"); // DispatcherServlet으로 가기 전 실행 chain.doFilter(request, response); // 다음 단계로 요청 전달 log.info("[Filter] 요청 후"); // 응답이 돌아올 때 실행 } }다음은
Interceptor다.
Interceptor는Controller실행 전후에 동작한다.// MvcFlowInterceptor.java import jakarta.servlet.http.HttpServletRequest; // HTTP 요청 정보 import jakarta.servlet.http.HttpServletResponse; // HTTP 응답 정보 import lombok.extern.slf4j.Slf4j; // 로그 출력용 Lombok 애노테이션 import org.springframework.lang.Nullable; // null 가능 표시 import org.springframework.web.servlet.HandlerInterceptor; // Interceptor 구현 인터페이스 import org.springframework.web.servlet.ModelAndView; // Model과 View 정보 @Slf4j // log.info() 사용 public class MvcFlowInterceptor implements HandlerInterceptor { @Override public boolean preHandle(HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception { log.info("[Interceptor] preHandle"); // Controller 실행 전 return true; // Controller로 요청 진행 } @Override public void postHandle(HttpServletRequest request, HttpServletResponse response, Object handler, @Nullable ModelAndView modelAndView) throws Exception { log.info("[Interceptor] postHandle"); // Controller 실행 후 } @Override public void afterCompletion(HttpServletRequest request, HttpServletResponse response, Object handler, @Nullable Exception ex) throws Exception { log.info("[Interceptor] afterCompletion"); // 요청 완료 후 } }
Interceptor는 클래스만 만든다고 자동으로 적용되지 않는다.
WebMvcConfig에서 어떤 요청에 적용할지 등록해야 한다.// MvcFlowWebMvcConfig.java import org.springframework.context.annotation.Configuration; // 설정 클래스 등록 import org.springframework.web.servlet.config.annotation.InterceptorRegistry; // Interceptor 등록 객체 import org.springframework.web.servlet.config.annotation.WebMvcConfigurer; // Spring MVC 설정 확장 @Configuration // Spring 설정 클래스 public class MvcFlowWebMvcConfig implements WebMvcConfigurer { @Override public void addInterceptors(InterceptorRegistry registry) { registry.addInterceptor(new MvcFlowInterceptor()) // Interceptor 등록 .addPathPatterns("/mvc-flow-test"); // 테스트 URL에만 적용 } }이제 실제 요청을 받는
Controller를 작성한다.
Controller는 요청을 받고, 필요한 처리를Service에 맡긴다.// MvcFlowController.java import lombok.RequiredArgsConstructor; // final 필드 생성자 자동 생성 import lombok.extern.slf4j.Slf4j; // 로그 출력용 Lombok 애노테이션 import org.springframework.web.bind.annotation.GetMapping; // GET 요청 매핑 import org.springframework.web.bind.annotation.RestController; // REST Controller 등록 @RestController // 문자열 응답을 바로 반환 @RequiredArgsConstructor // final 필드 생성자 자동 생성 @Slf4j // log.info() 사용 public class MvcFlowController { private final MvcFlowService mvcFlowService; // Service 의존성 @GetMapping("/mvc-flow-test") // 요청 주소 매핑 public String mvcFlowTest() { log.info("[Controller] 요청 처리"); // Controller 실행 확인 return mvcFlowService.process(); // Service 호출 후 결과 반환 } }
Service는 핵심 처리 흐름을 담당한다.
여기서는Repository를 호출해서 데이터를 가져오는 흐름만 확인한다.// MvcFlowService.java import lombok.RequiredArgsConstructor; // final 필드 생성자 자동 생성 import lombok.extern.slf4j.Slf4j; // 로그 출력용 Lombok 애노테이션 import org.springframework.stereotype.Service; // Service Bean 등록 @Service // Service 계층 Bean 등록 @RequiredArgsConstructor // final 필드 생성자 자동 생성 @Slf4j // log.info() 사용 public class MvcFlowService { private final MvcFlowRepository mvcFlowRepository; // Repository 의존성 public String process() { log.info("[Service] 비즈니스 로직 처리"); // Service 실행 확인 return mvcFlowRepository.findMessage(); // Repository 호출 } }
Repository는 데이터 저장소와 연결되는 계층이다.
이 예제에서는 실제DB대신 문자열을 반환해서 흐름만 확인한다.// MvcFlowRepository.java import lombok.extern.slf4j.Slf4j; // 로그 출력용 Lombok 애노테이션 import org.springframework.stereotype.Repository; // Repository Bean 등록 @Repository // Repository 계층 Bean 등록 @Slf4j // log.info() 사용 public class MvcFlowRepository { public String findMessage() { log.info("[Repository] 데이터 조회"); // Repository 실행 확인 return "mvc flow test"; // 테스트 응답 데이터 반환 } }// 출력결과 // [Filter] 요청 전 // [Interceptor] preHandle // [Controller] 요청 처리 // [Service] 비즈니스 로직 처리 // [Repository] 데이터 조회 // [Interceptor] postHandle // [Interceptor] afterCompletion // [Filter] 요청 후출력 결과를 보면 요청이 어떤 순서로 이동했는지 한눈에 볼 수 있다.
요청이 들어갈 때는Filter가 먼저 실행되고, 그다음Interceptor,Controller,Service,Repository순서로 이어진다.
응답이 돌아올 때는Interceptor의 후처리 메서드가 실행되고, 마지막에Filter의 요청 후 로그가 출력된다.
요청이 들어갈 때의 흐름
요청이 들어갈 때는 바깥쪽에서 안쪽으로 들어간다.
가장 먼저Filter가 실행되고, 그 다음Spring MVC내부 흐름으로 들어간다.
예제 출력 결과에서 요청이 들어가는 흐름은 다음과 같다.// RequestFlowOutputExample.java // [Filter] 요청 전 // [Interceptor] preHandle // [Controller] 요청 처리 // [Service] 비즈니스 로직 처리 // [Repository] 데이터 조회
Filter는DispatcherServlet앞에서 실행된다.
Interceptor의preHandle()은Controller실행 전에 실행된다.
그 뒤Controller가Service를 호출하고,Service가Repository를 호출한다.
이 흐름을 한 줄로 정리하면 다음과 같다.
Filter→DispatcherServlet→Interceptor→Controller→Service→Repository
응답이 돌아올 때의 흐름
응답이 돌아올 때는 안쪽에서 바깥쪽으로 나온다.
Repository에서 조회한 결과가Service로 돌아가고,Service결과가Controller로 돌아간다.
그 다음Controller처리가 끝났으므로Interceptor의 후처리 메서드가 실행된다.
마지막으로Filter의chain.doFilter()다음 줄로 돌아와 요청 후 로그가 출력된다.
예제 출력 결과에서 응답이 돌아오는 흐름은 다음과 같다.// ResponseFlowOutputExample.java // [Interceptor] postHandle // [Interceptor] afterCompletion // [Filter] 요청 후여기서
Filter의 요청 후 로그가 마지막에 찍히는 이유는Filter가 요청 흐름의 가장 바깥쪽에 있기 때문이다.
들어갈 때는 가장 먼저 실행되지만, 나올 때는 가장 마지막에 실행된다.
전체 흐름 정리
Spring MVC전체 요청 흐름은 단순히Controller하나만 보는 것이 아니다.
요청은 여러 단계를 지나고, 각 단계는 맡은 역할이 다르다.
전체 흐름을 다시 정리하면 다음과 같다.
Filter는DispatcherServlet앞에서 공통 작업을 처리한다.DispatcherServlet은 요청 처리 흐름을 조율한다.HandlerMapping은 실행할Controller를 찾는다.Interceptor는Controller실행 전후에 공통 작업을 처리한다.HandlerAdapter는 찾은Controller메서드를 실행한다.Controller는 요청을 받고Service를 호출한다.Service는 핵심 비즈니스 로직을 처리한다.Repository는 데이터 저장소와 연결된다.요청 처리 흐름을 이해하면 공통 로직은
Filter나Interceptor에 두고, 실제 기능 흐름은Controller,Service,Repository로 나눠 작성할 수 있다.
이렇게 역할을 나누면 코드가 덜 복잡해지고, 수정할 위치도 더 분명해진다.