1Gbps & 280RPS 트래픽 폭증 대응기: SSD 캐시 서버 도입
시작
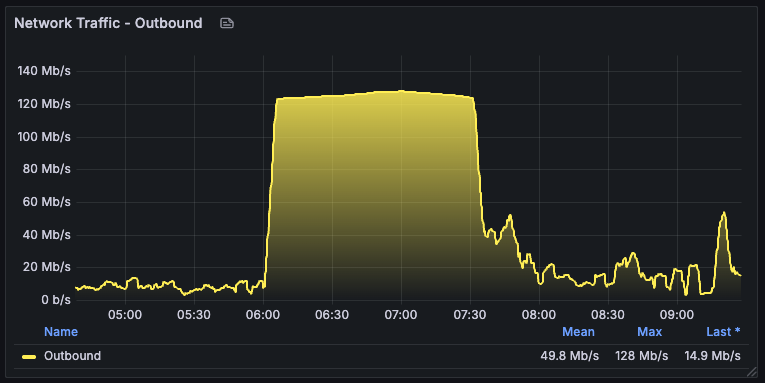
2025년 11월 7일 오전 6시, 모니터링 대시보드에서 이상 징후가 포착되었다. 아웃바운드 네트워크 트래픽이 급격히 상승하며 불과 5분 만에 계약한 회선의 최대 용량인 1Gbps에 도달했고, 이 상태가 약 1시간 30분 동안 지속되었다.
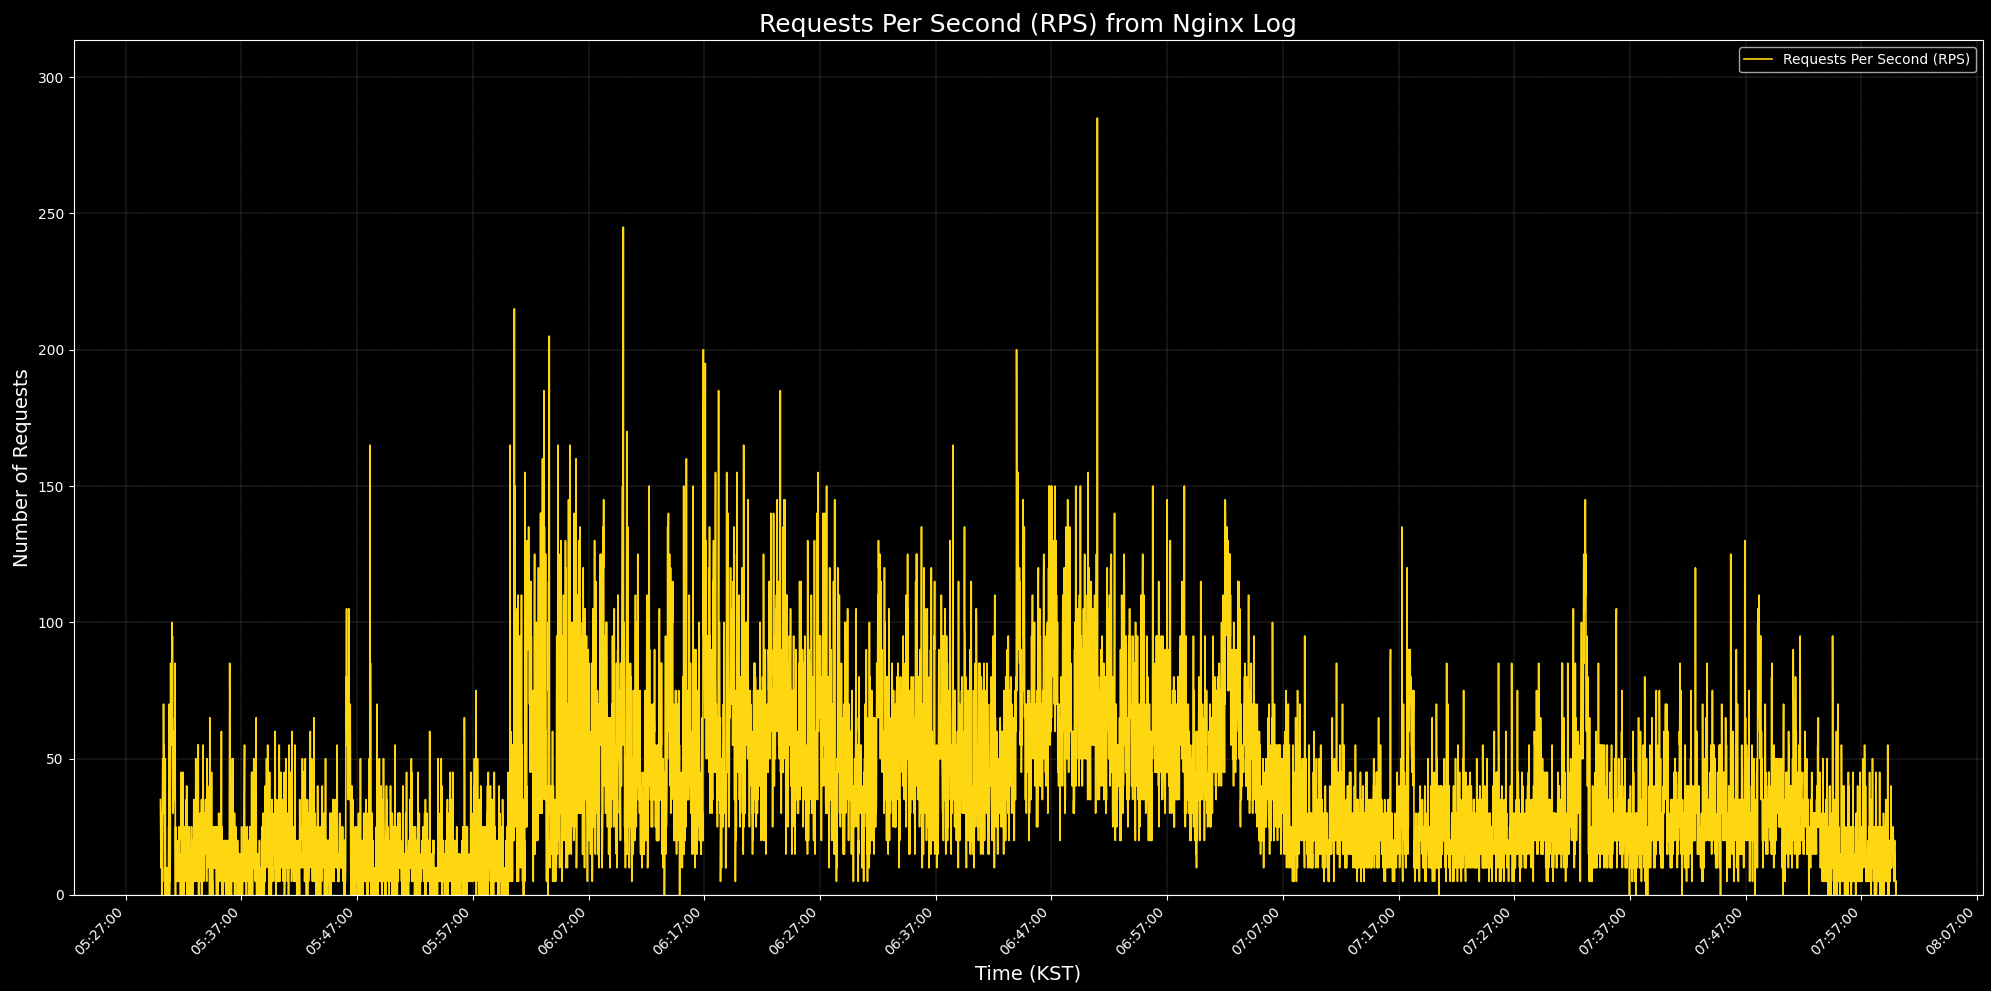
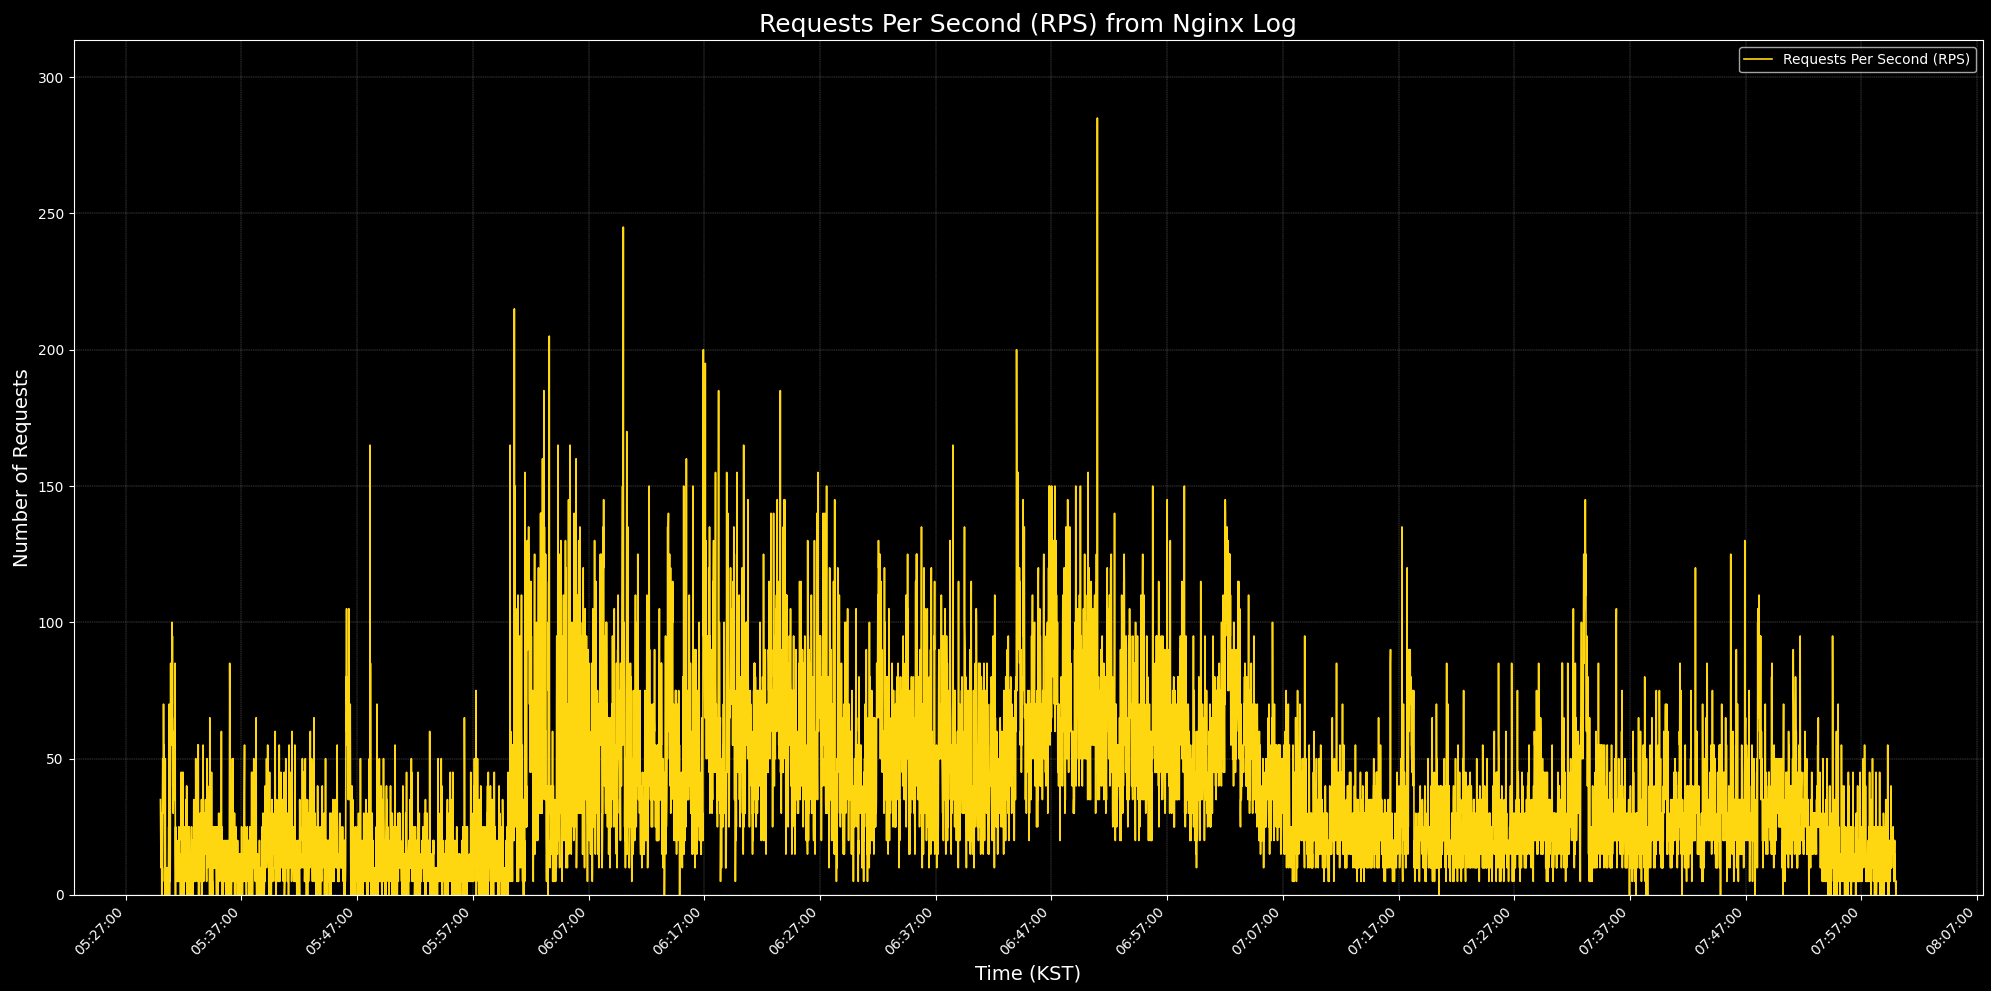
초당 요청 수(RPS)는 평소 50~100건 수준에서 최대 280건까지 치솟았다. 초기에는 DDoS 공격 가능성을 의심했으나, 로그 분석 결과 이는 Rocky Linux를 포함한 리눅스 패키지의 대규모 업데이트로 인한 정상적인 사용자 요청 폭증이었다.
사건의 시작은 약 한 달 전부터 시작되었다. Kali Linux 미러 관리 담당자로부터 "간헐적으로 504 Gateway Timeout 오류가 발생한다"는 피드백을 받았다.
504 오류의 원인을 분석한 결과, 다수의 동시 요청으로 인해 원본 서버의 HDD에서 I/O 지연이 발생하여 타임아웃이 발생 한 것 이었다. 리눅스 미러 서버는 수많은 작은 메타데이터 파일에 대한 동시 접근을 처리해야 하는데, HDD는 이러한 랜덤 액세스 상황에서 성능이 급격히 저하된다. 또한 이렇게 작은 메타데이터 파일들을 처리하느라 하드디스크의 헤드가 끊임없이 이동하면 대용량 패키지 파일의 다운로드도 지연되고, 반대로 대용량 패키지 파일을 전송하는 중에는 메타데이터 요청이 대기 상태에 빠진다. 즉, 서로 다른 I/O 패턴의 요청이 HDD에서 서로 간섭하며 전체 I/O 성능을 저하시킨다.
해결 전략: SSD 캐시 도입
문제의 원인을 파악한 후, 저장 장치의 특성에 따라 I/O 부하를 분리하는 캐시 아키텍처를 설계하였다.
즉, HDD에는 쥐약인 랜덤 I/O는 SSD에 캐시하여 처리, 순차 I/O는 HDD가 처리하도록 역할을 구분했다.
이를 구현하기 위해 Nginx 프록시 캐시 서버를 도입하고, SSD를 캐시 스토리지로 사용했다.
파일 특성에 따라 다음과 같은 유연한 캐시 전략을 적용했다.
-
요청이 폭주하는 메타데이터 파일(
InRelease,repomd.xml등)은 5분의 짧은 TTL로 캐시했다.
이 파일들은 저장소의 최상위 인덱스로, 현재 패키지 버전과 업데이트 시점을 나타내는 핵심 데이터이다.
Debian/Ubuntu 계열의InRelease,Release, RHEL/Rocky 계열의repomd.xml에는 하위 메타데이터의 해시값이 포함되어 있으며, 클라이언트는 이를 통해 패키지 무결성을 검증한다.
따라서 60분의 긴 TTL도 가능했지만, 저장소 업데이트 시 해시 불일치 오류 방지와 클라이언트가 최신 메타데이터를 신속히 받을 수 있도록 5분의 TTL을 설정해 원본 서버의 부하를 차단했다. -
반면 내용이 거의 변하지 않는 패키지 파일(
.deb,.rpm)은 60분의 긴 TTL을 적용하여 대부분의 트래픽을 SSD 캐시에서 직접 처리하도록 설계했다. -
/dists경로의 핵심 메타데이터 파일은 데이터 무결성 유지를 위해 캐시 대상에서 제외했다.
캐시된 구버전 메타데이터와 최신 원본이 혼재되면 해시 검증 실패나 잘못된 패키지 다운로드가 발생할 수 있으므로, 이 파일들은 항상 원본 서버에서 직접 제공되도록 설정했다.
실전 검증: 메트릭이 증명하는 캐시의 효과
11월 7일의 대규모 트래픽 발생은 SSD 캐시 아키텍처가 대규모 트래픽 환경에서 얼마나 효과적으로 작동하는지를 명확히 보여주었다.
 |  |
|---|
(네트워크 그래프 설정이 잘못되어 Y축 값이 잘못된 값으로 나와있습니다.)
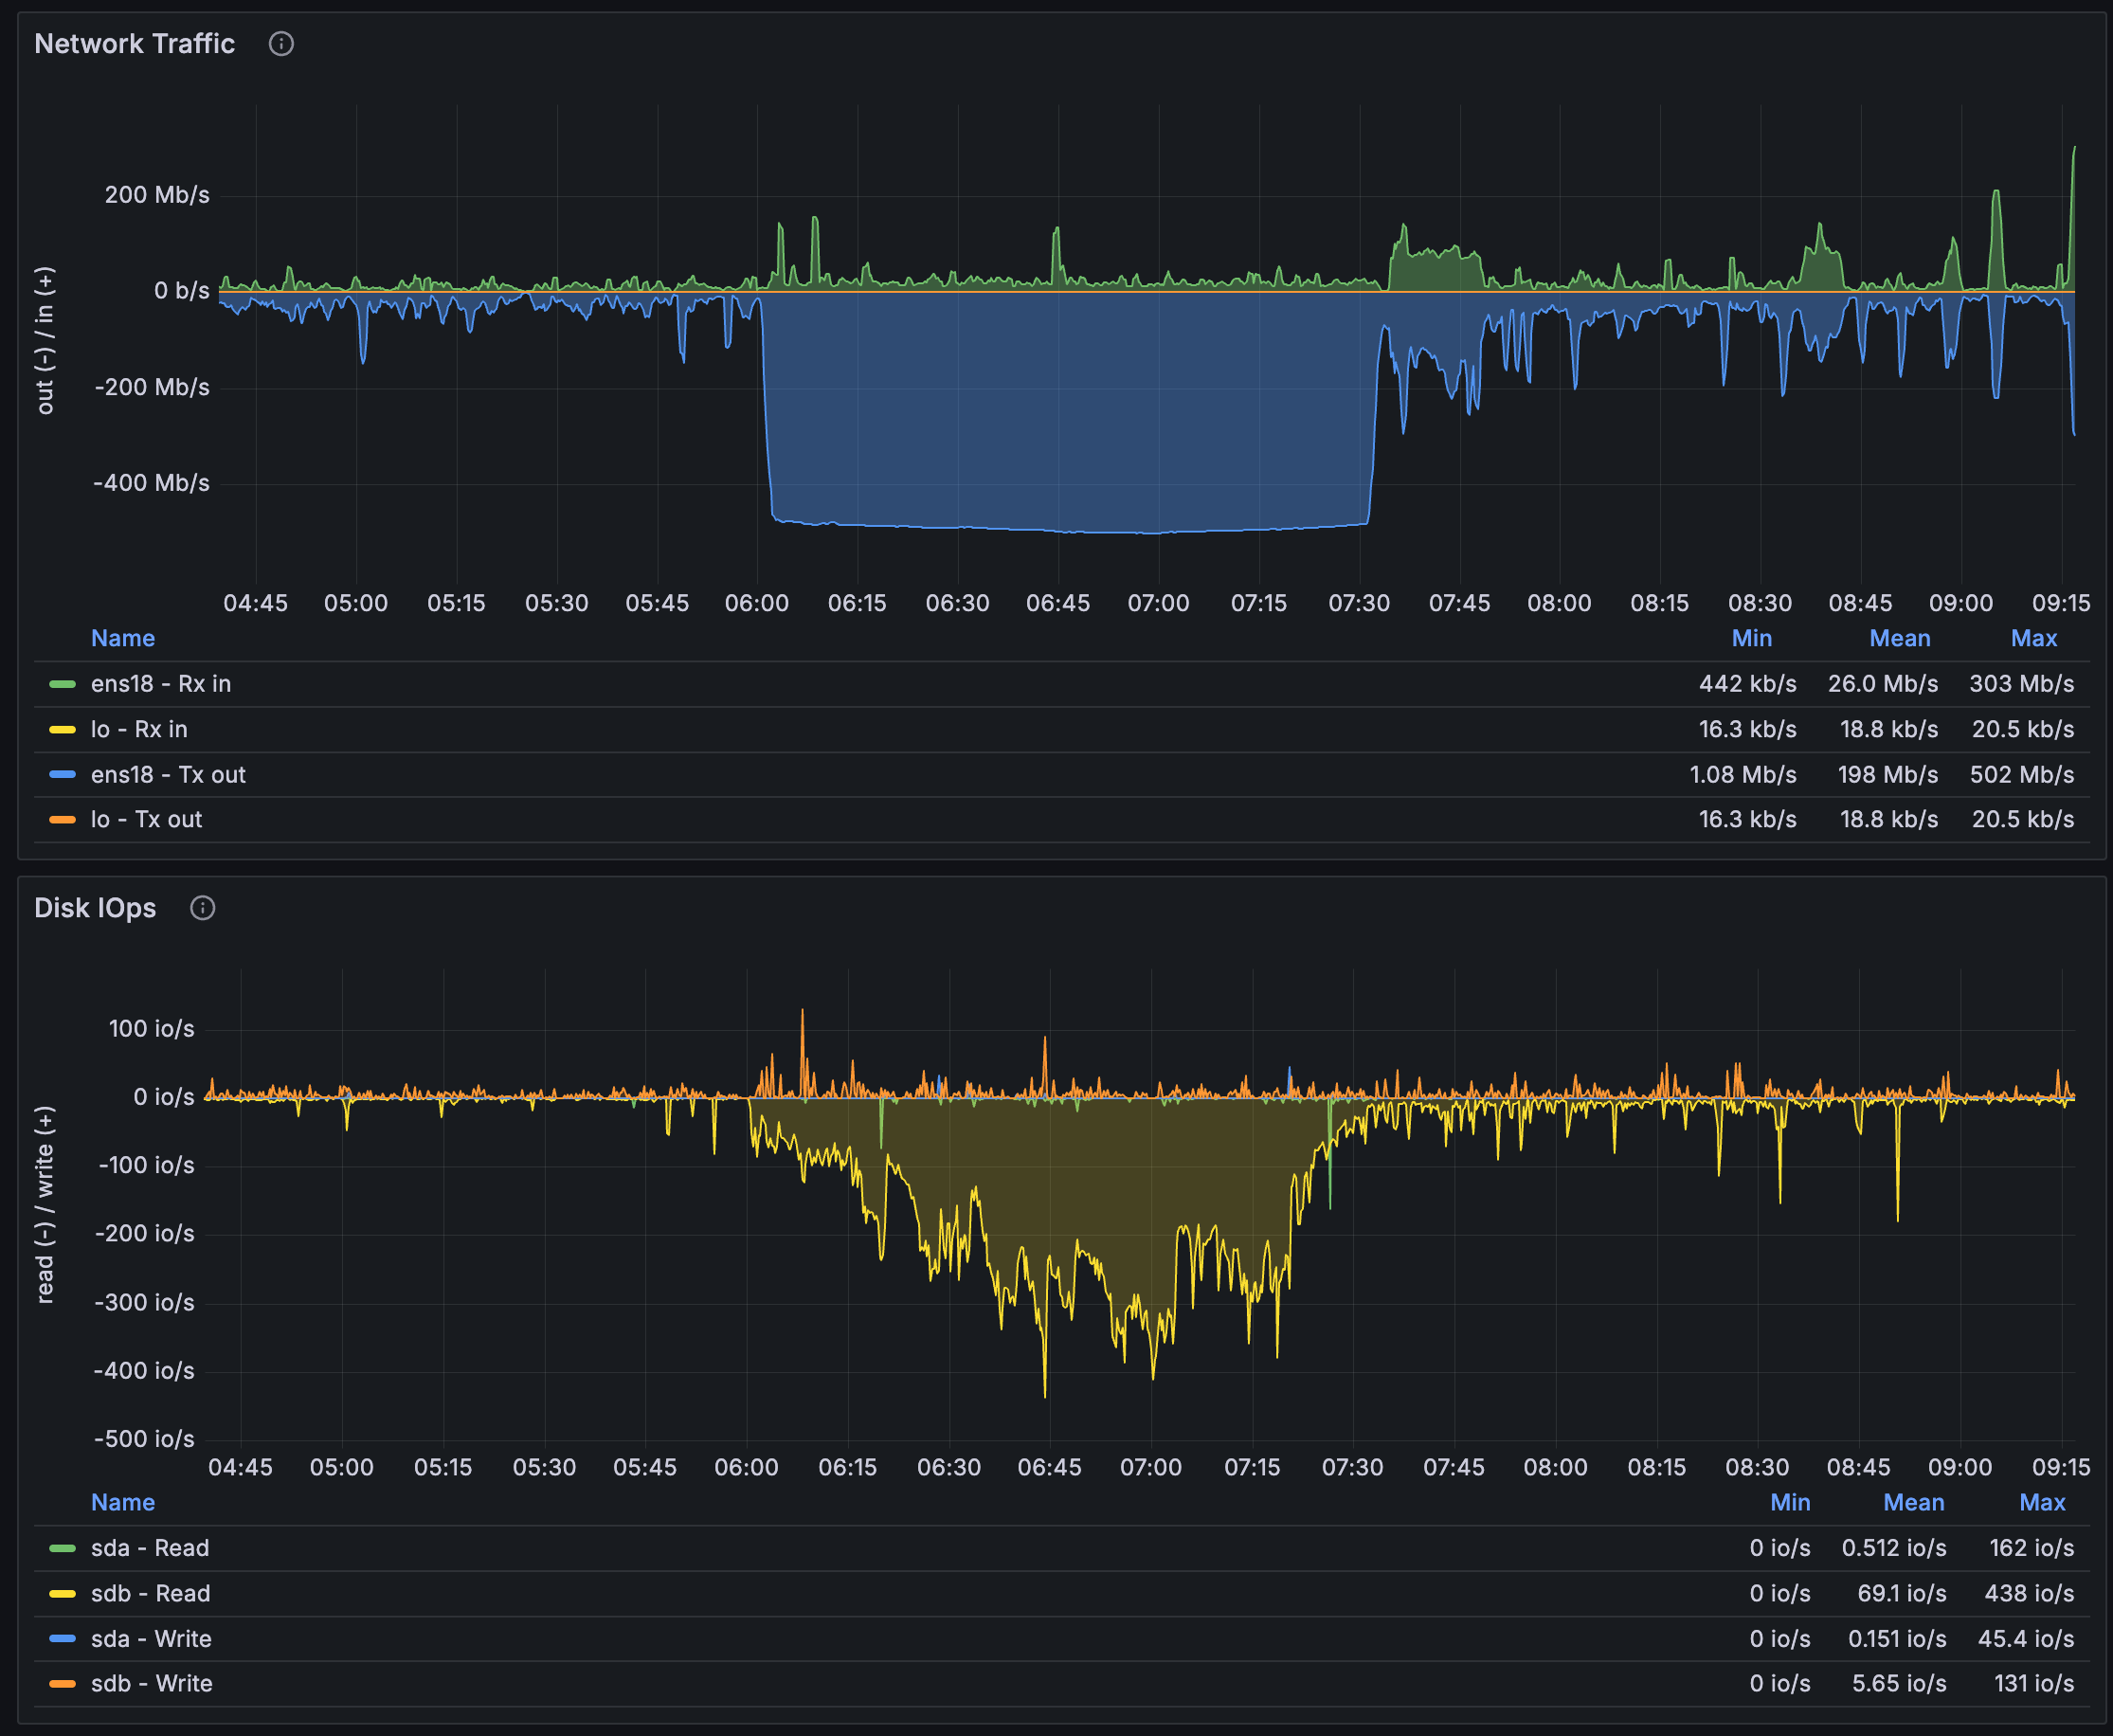
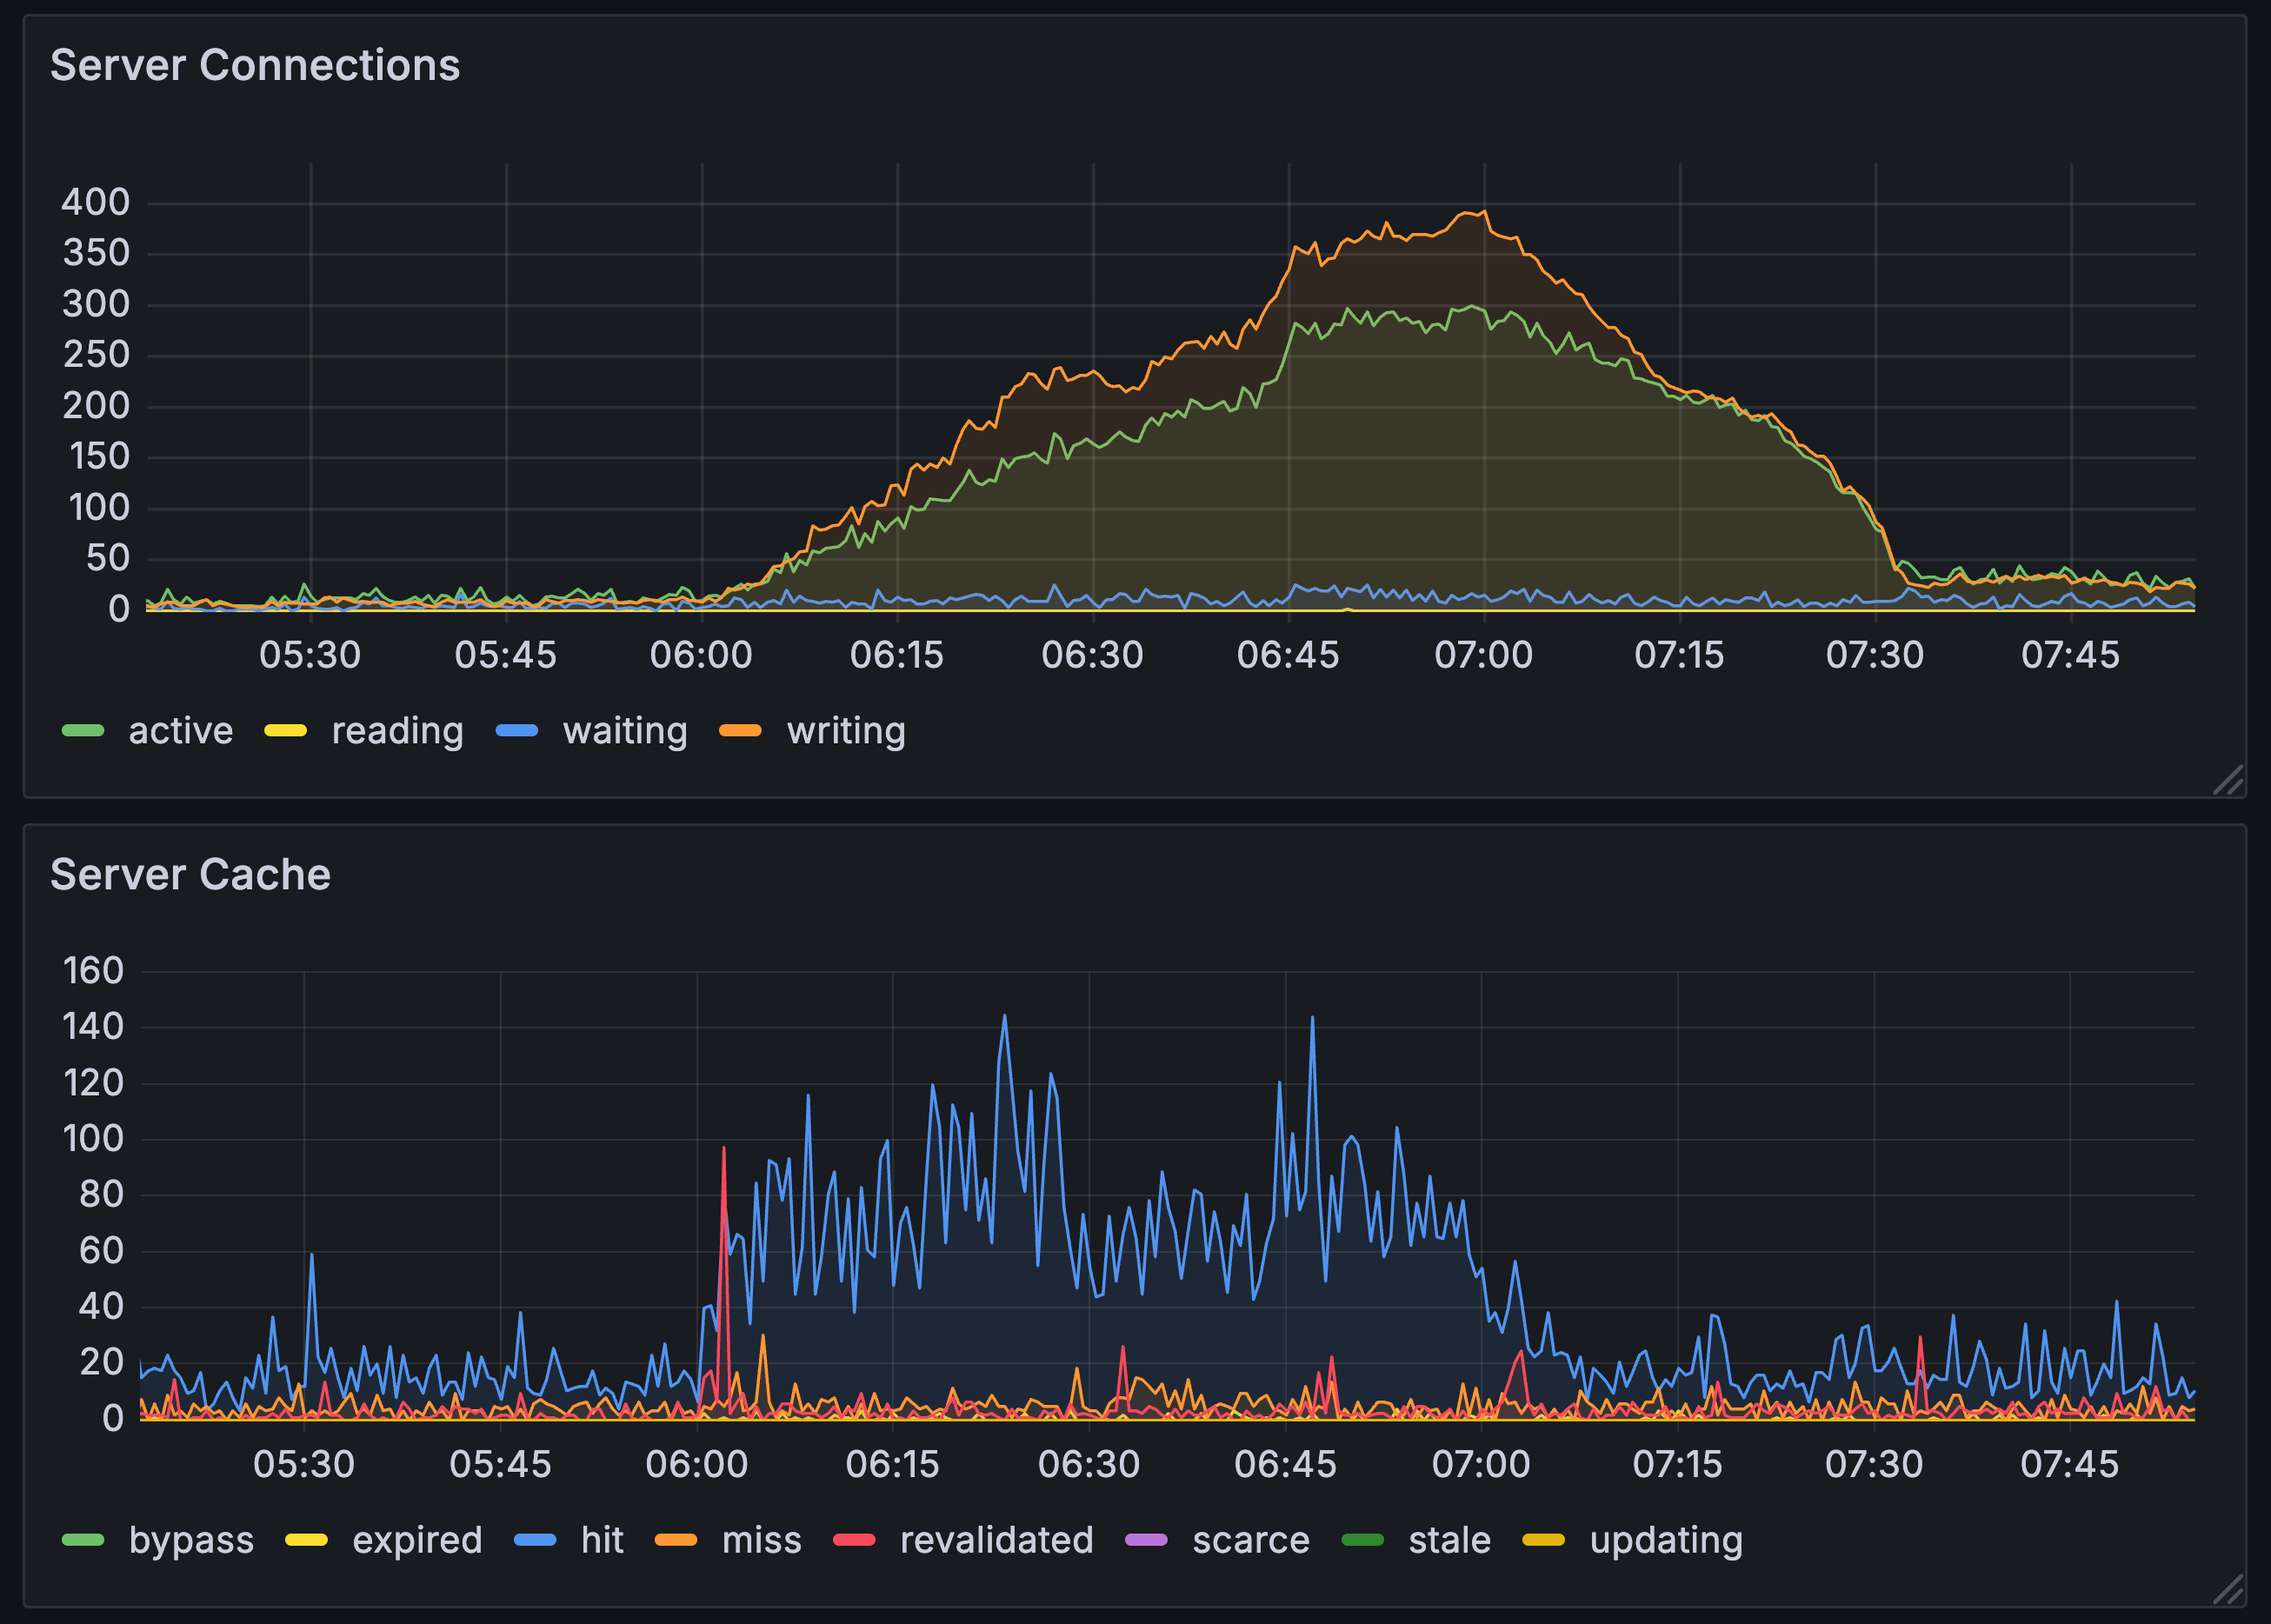
프록시 서버의 네트워크 트래픽 그래프를 보면, 오전 6시부터 7시 30분까지 아웃바운드 트래픽 대역폭이 1Gbps로 유지되며 높은 부하를 유지했다.
이와 동시에 프록시 서버의 SSD(sdb)는 읽기 IOPS가 초당 400~500까지 치솟으며 대량의 요청을 안정적으로 처리했다. 최대 438 IOps의 읽기 작업이 발생했으며, SSD가 캐시 히트를 통해 대부분의 요청을 직접 처리했음을 명확히 보여준다.
 |  |
|---|
(네트워크 그래프 설정이 잘못되어 Y축 값이 잘못된 값으로 나와있습니다.)
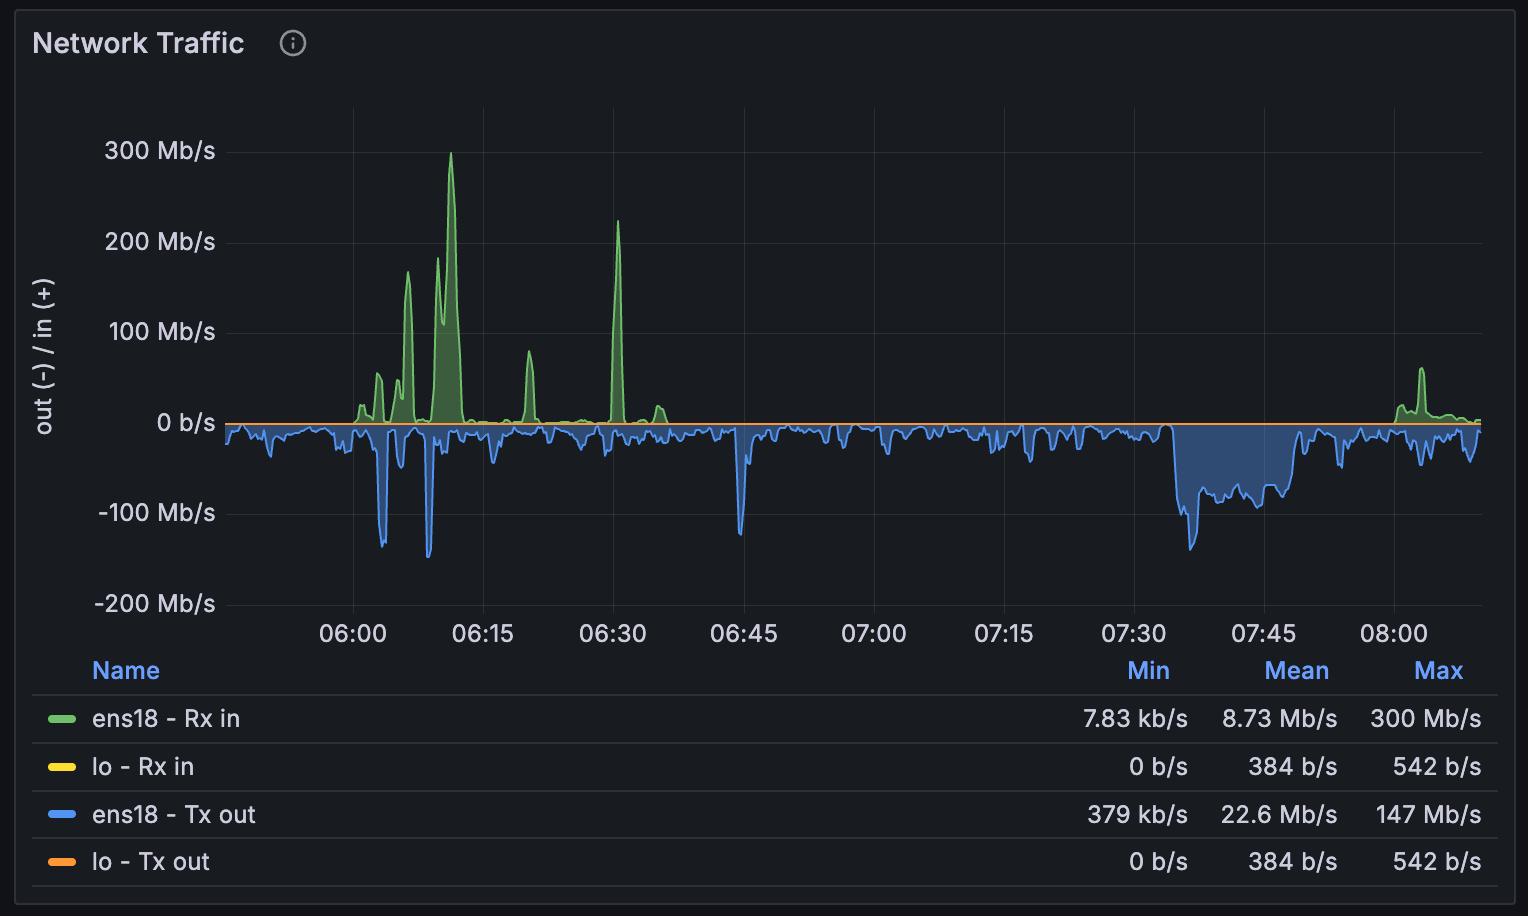
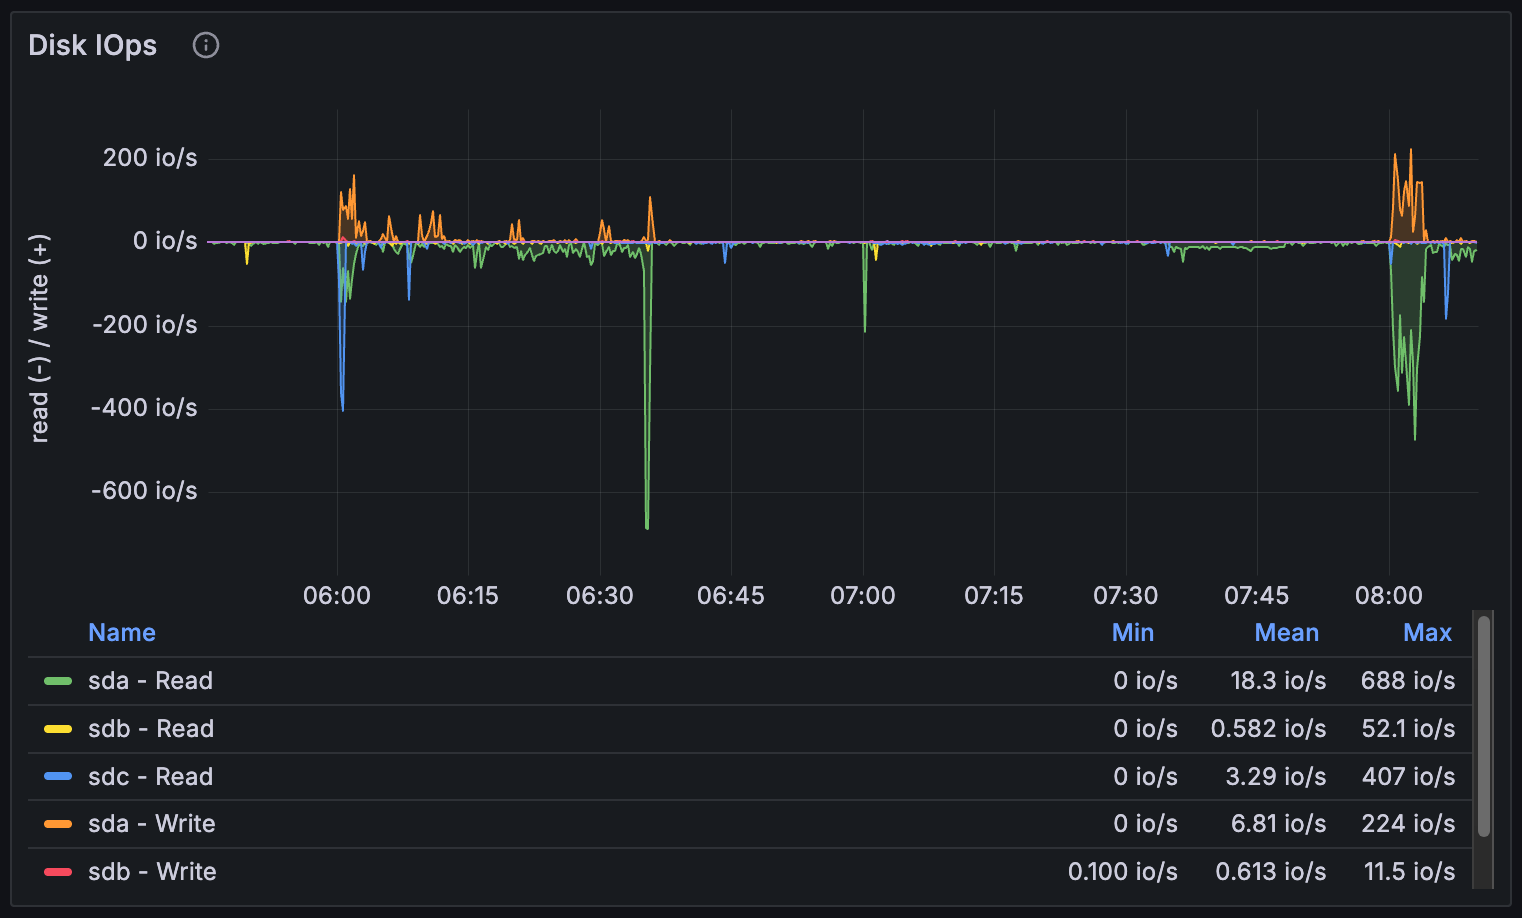
반면 원본 서버의 상황은 반대였다. 네트워크 트래픽은 평균 최대 606Mbps로 프록시 서버 대비 현저히 낮은 수준을 유지했다. 특히 트래픽 폭증 구간(6:00~7:30)에서도 원본 서버의 송신 트래픽은 거의 변동이 없었다.
원본 서버의 HDD 또한 안정적인 상태를 유지했다. 디스크 읽기 IOps는 평균 0.512 IOps, 최대 162 IOps로 매우 낮은 수준이었다. I/O 부하가 완전히 프록시 서버의 SSD로 이전되었음을 수치로 확인할 수 있다.
 | |
|---|
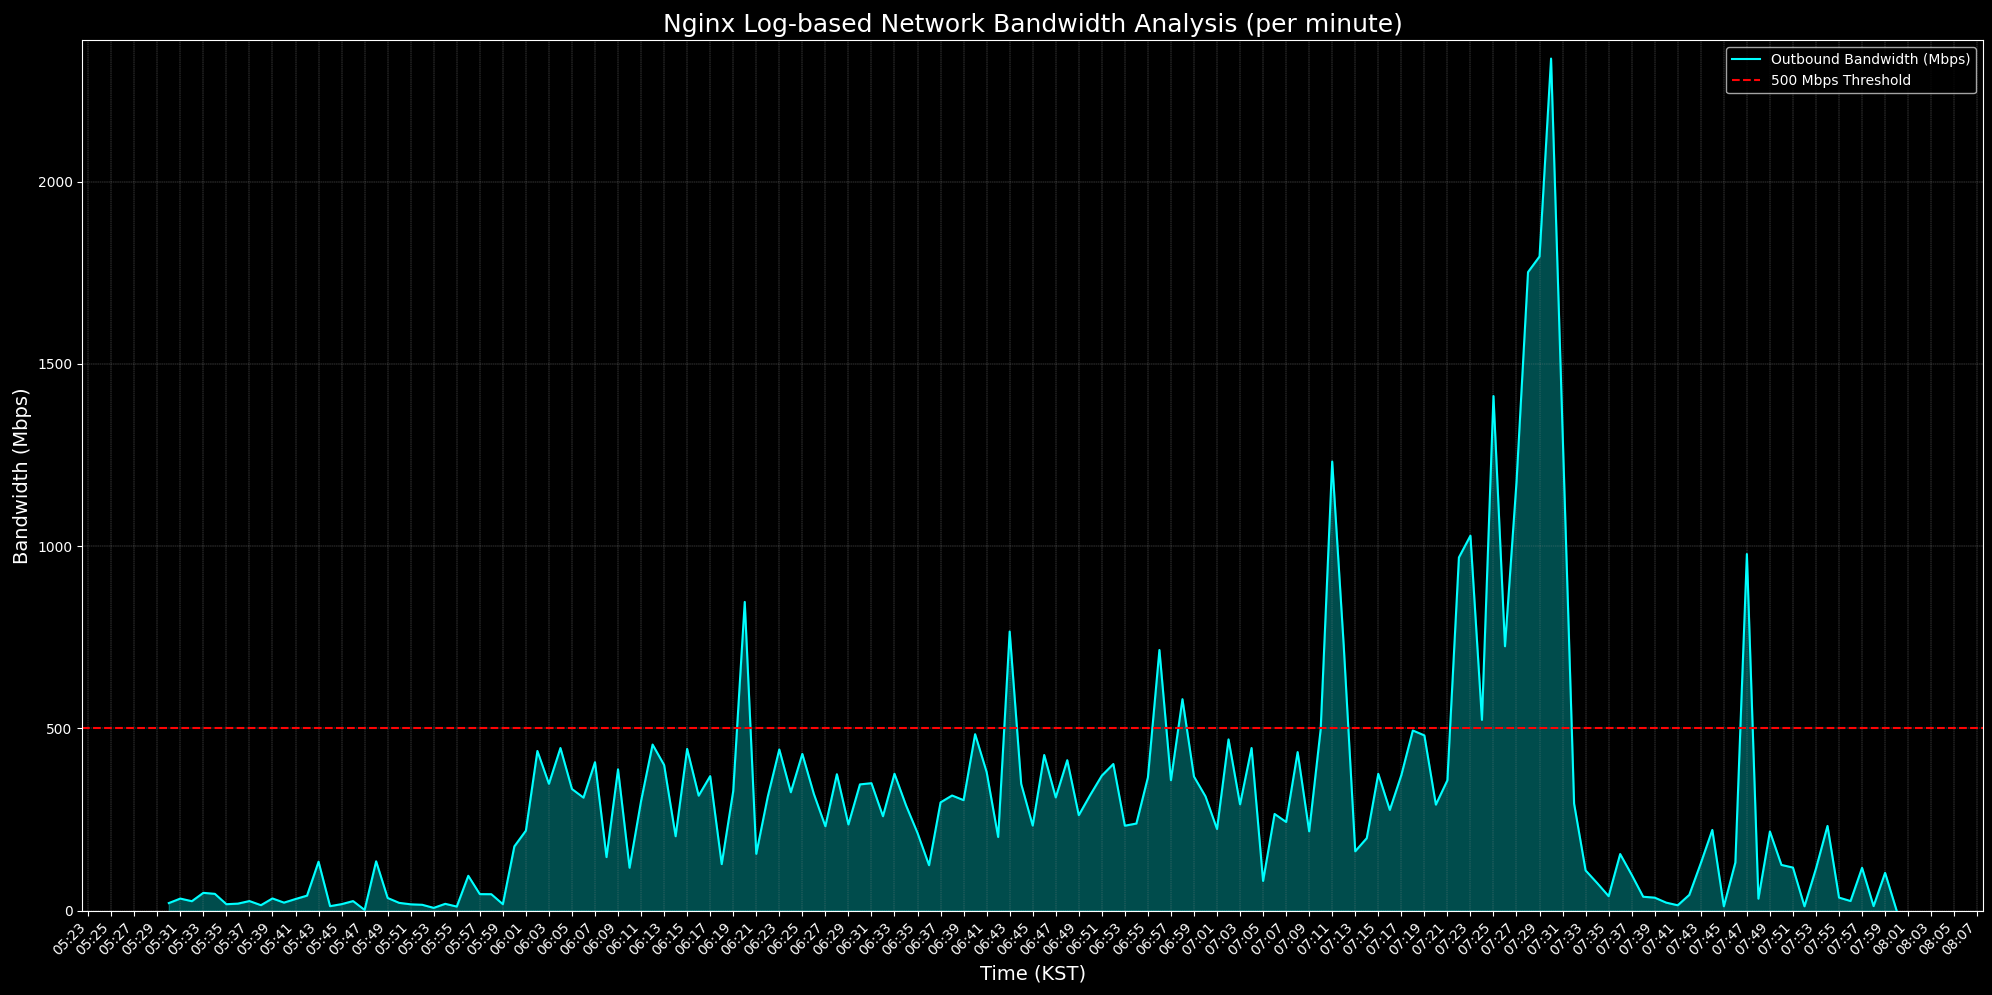
더 흥미로운 사실은 Nginx 로그 기반 대역폭 분석에서 드러났다. 서버는 순간적으로 최대 2.5Gbps의 트래픽을 하도록 요청을 받았으나, 외부 회선이 1Gbps로 제한되어 실제로는 그 이상을 처리하지 못했다.
실제 병목 지점은 서버의 I/O 성능이 아니라 1Gbps로 제한된 네트워크 회선이었다.
만약 SSD 캐시가 없었다면
이번 대규모 트래픽 대응을 통해 한 달 전의 SSD 도입 결정이 얼마나 중요했는지 명확해졌다. 만약 SSD 캐시 아키텍처를 구축하지 않았다면, 280 RPS와 최대 2.5Gbps에 달하는 요청 부하가 전부 원본 서버의 HDD로 향했을 것이다.
HDD의 I/O 대기 시간(iowait)이 급증하며 Nginx의 연결 수가 폭증하고, 원본 서버의 CPU와 메모리 자원이 고갈되면서 다른 서비스의 응답 속도가 심각하게 지연되었을 것이다. 프록시 서버의 SSD가 초당 400~500 IOps를 처리한 것과 달리, 원본 서버의 HDD는 이러한 랜덤 I/O 패턴에서 수십 IOps 수준으로 성능이 급락했을 것이다.
문제는 여기서 끝나지 않는다. 동일 인프라에서 운영 중인 매우 중요한 교내 서비스와 Upcoin 암호화폐 모의투자 거래소 서비스까지 모든 서비스가 영향을 받았을 가능성이 높다. 하나의 서비스에서 발생한 I/O 병목이 시스템 전체의 리소스 경합을 야기하며 연쇄 장애로 확대되는 최악의 시나리오로 이어질 수 있었다.
SSD 캐시는 단순히 미러 서비스의 성능을 개선한 것이 아니라, 전체 인프라의 안정성을 보호했다.
결론
이번 경험은 데이터 기반의 문제 분석과 선제적인 캐시 아키텍처 도입이 어떻게 대규모 트래픽으로부터 서비스를 보호하는지 명확하게 증명했다.
504 Gateway Timeout이라는 작은 오류를 그냥 넘길 수도 있었지만, 원인을 분석하고 저장 장치의 특성을 파악한 뒤 해결함으로써, 실제 위기 상황에서도 전체 인프라를 안정적으로 유지할 수 있었다. 프록시 서버의 SSD는 초당 400~500 IOps를 처리하며 HDD 부하를 흡수했고, 원본 서버의 HDD는 부하 변화 없이 안정적으로 동작했다.
향후 계획은, 가능하다면 네트워크 회선 대역폭을 증설하여 병목 지점을 해소해야겠다.