AI데이터엔지니어 부트캠프 <핀테커스> TIL 챌린지
1.AI데이터엔지니어 부트캠프 <핀테커스> 1주차 (1)

오늘 내가 배운 것 > ## 데이터 리터러시 데이터를 수집, 이해, 분석하고 그 정보를 활용 할 수 있는 능력 이를 응용해 수많은 의사결정에 도움이 될 수 있으며, 많은 기업에서 실제 적극 사용중이다. 데이터 리터러시의 하위 내용으로는 기획 수집 이해 및 관리
2.AI데이터엔지니어 부트캠프 <핀테커스> 1주차 (2)
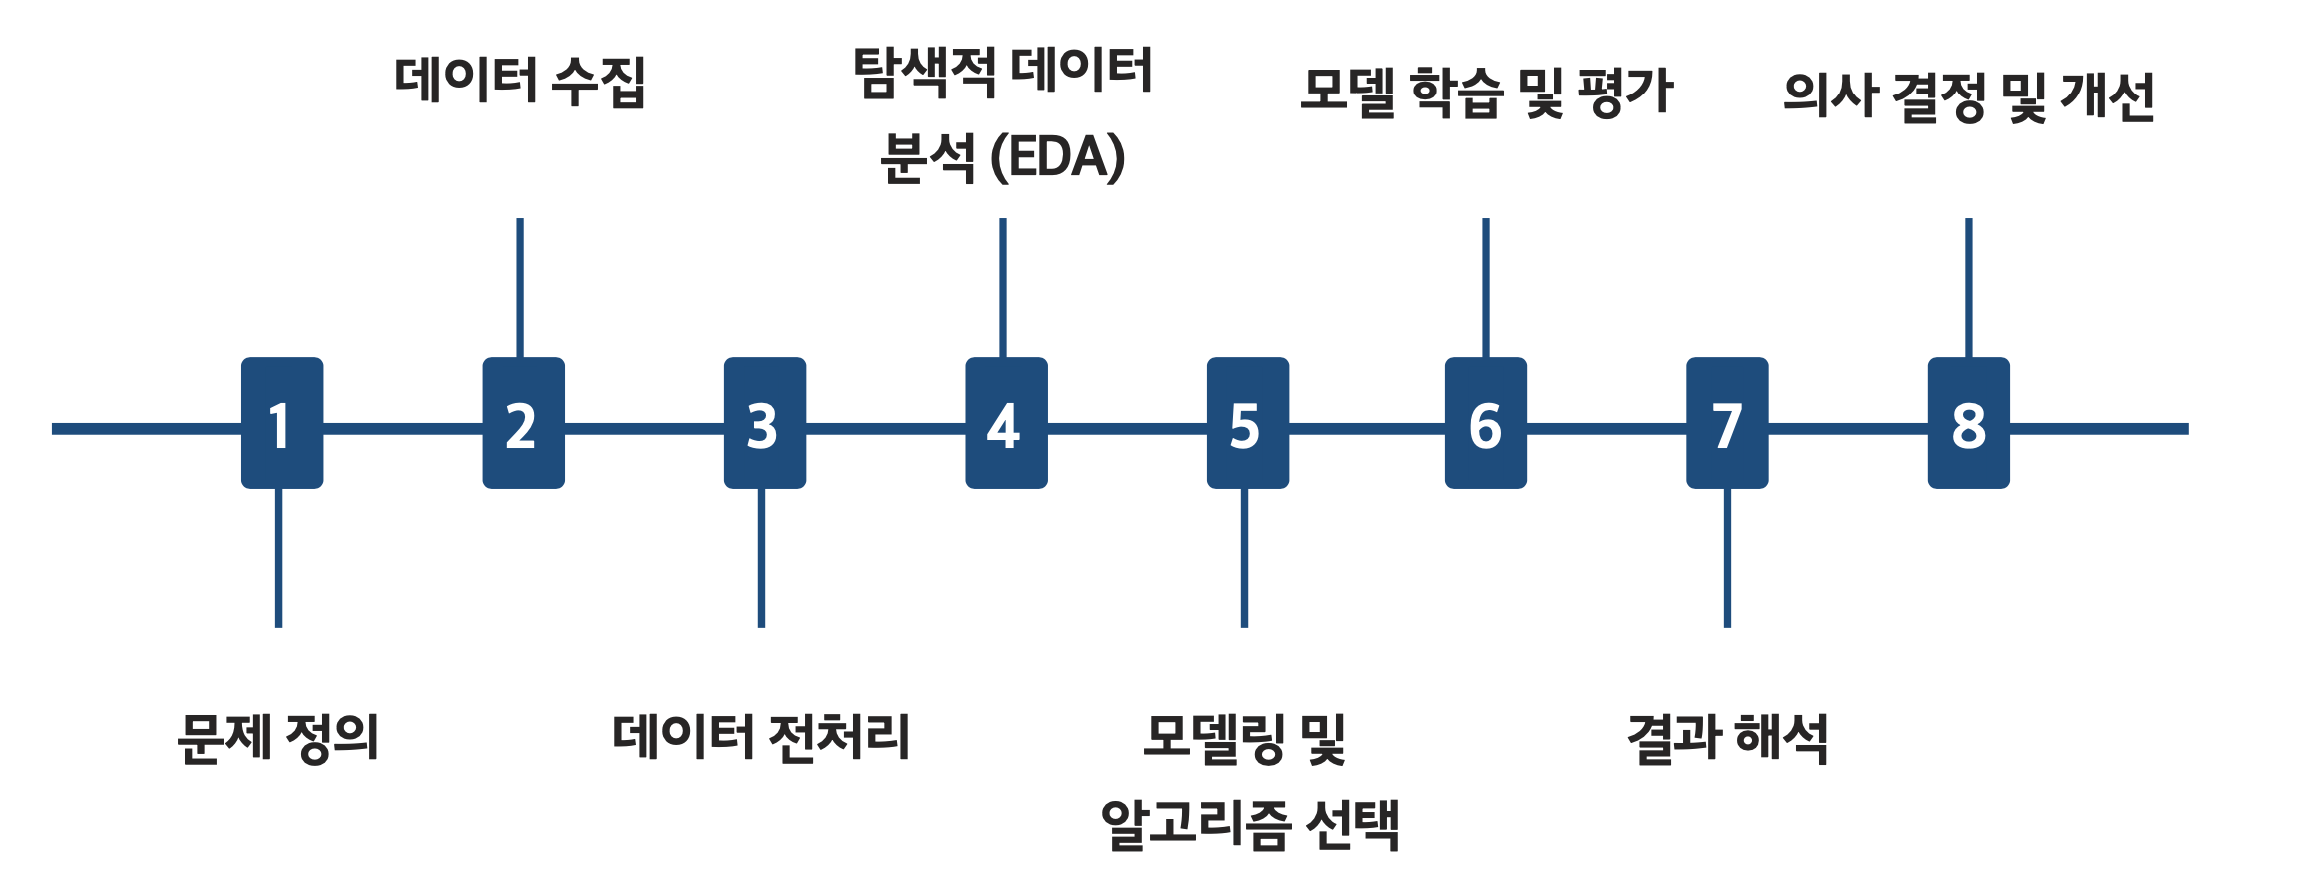
아래와 같이, 엑셀 내 여러 시트의 데이터를 통합해야 할 경우가 있다.물론 엑셀내의 함수를 이용할 수 있겠지만, 데이터의 양이 커질 경우 성능에 저하가 생길 수 있다.이때 파워쿼리를 이용한다면 상당히 편리하게 데이터 통합이 가능하다.데이터 - 데이터 가져오기 - 파일에
3.AI데이터엔지니어 부트캠프 <핀테커스> 1주차 (3)
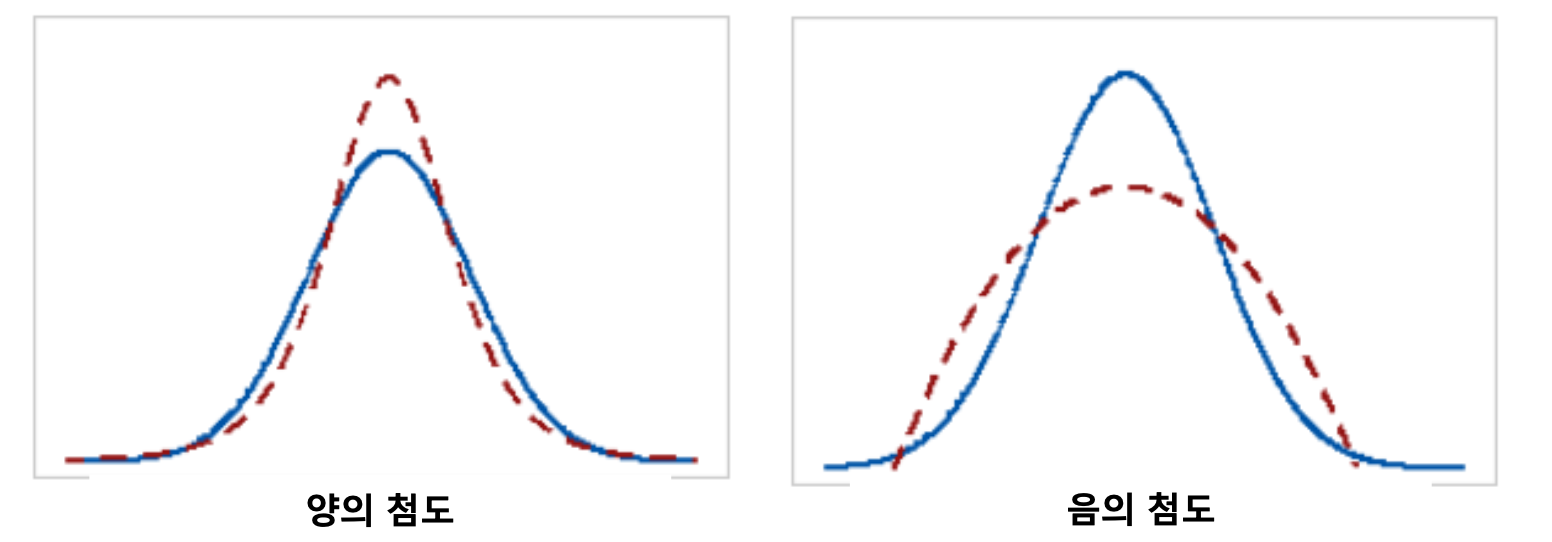
기술통계의 이해 > ## 통계 '현상'을 나타내고 있는 data로부터 유용한 정보를 도출하여 적절한 의사결정을 하게 해주는것 모집단/전수조사 -> 표본집단/표본조사 유의수준(오차한계), 신뢰수준 표본으로 전체를 설명하는 것을 '검정 통계학' 이라한다 P-Valu
4.AI데이터엔지니어 부트캠프 <핀테커스> 2주차 - (1) 파이썬 개발환경 설정과 파이썬 기초
mac 환경을 기준으로 작성되었습니다. 파이썬 > ## 특징 간결하다 다른 언어보다 적은 코드 양으로도 같은 결과물을 만들 수 있음 풀이가 쉽다 문법이 쉽고 직관적이어서 처음 배우는 사람도 쉽게 익힐 수 있음 다양한 라이브러리 아무리 복잡한 작업도 다양한 라이브러리를 사용하면 쉽게 처리할 수 있음 높은 생산성 다양한 자동화 도구를 제공해 개발자의 생산성...
5.AI데이터엔지니어 부트캠프 <핀테커스> 2주차 - (2) 파이썬 기초 [제어문, 파일입출력]
기본적으로 if와 else를 이용해 간단한 비교 구문 제작에 사용여러 가지 조건을 동시에 판별할 땐, elif 구문을 이용비교 연산자를 응용해 사용한다특정 수식이나 기능을 반복 수행할 때 사용특정 조건이 맞을 때, 계속 반복되는 구조들여쓰기를 이용해, 반복 조건에 대한
6.AI데이터엔지니어 부트캠프 <핀테커스> 2주차 - (3) 파이썬 기초 [함수, 클래스]
입력 X 값에 대한 결과 Y값을 반환(Return)하는 기능을 하나의 묶음으로 선언반복적으로 사용되는 특별한 기능을 함수로 선언해 사용코드에서 함수를 호출해 사용클래스(class): 객체를 만들기 위한 설계 도면인스턴스(Instance): 클래스의 실체화된 객체클래스로
7.AI데이터엔지니어 부트캠프 <핀테커스> 2주차 - (4) 데이터베이스, SQL
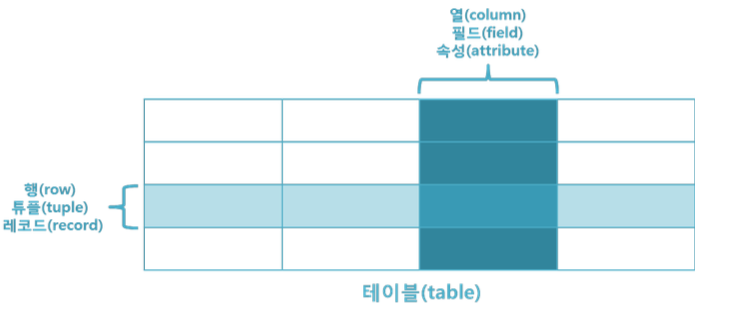
데이터를 체계적으로 저장, 관리 및 검색하기 위한 시스템데이터를 구조화하여 효율적인 접근, 조작 및 관리를 가능하게 함데이터베이스 시스템은 쿼리(Query) 언어를 제공SQL(Structured Query Language)은 가장 널리 사용되는 쿼리 언어데이터베이스에
8.AI데이터엔지니어 부트캠프 <핀테커스> 2주차 - (5) SQL [서브쿼리, 트랜잭션], DB API
서브쿼리 SQL 문장 안에 포함된 또 다른 SQL 문장 주로 SELECT, INSERT, UPDATE, DELETE 문에서 사용 서브쿼리는 외부 쿼리의 결과에 영향을 주거나 의존 외부 쿼리 안에서 값을 도출하거나, 조건을 만족하는지 확인하기 위해 사용 서브 쿼리의 활용
9.AI데이터엔지니어 부트캠프 <핀테커스> 3주차 - (1) 데이터, Pandas
정형 데이터 (Structured Data)데이터베이스에 저장된 데이터테이블 형태로 구성반정형 데이터 (Semi-Structured Data)정형 데이터와 비정형 데이터의 중간 형태데이터를 테이블과 같은 형태로 정리하지만, 스키마와 같은 구조화 요소가 없음비정형 데이터
10.AI데이터엔지니어 부트캠프 <핀테커스> 3주차 - (2) Pandas를 활용한 데이터 처리
iloc(): 데이터 순서로 데이터를 가져온다loc(): index, column으로 데이터를 가져온다concat()merge()sort_index()inplace= True/Falsesort_values(by='칼럼명')ascending= True/False .dro
11.AI데이터엔지니어 부트캠프 <핀테커스> 3주차 - (3) Pandas의 시계열 처리, matplotlib 맛보기
파이썬 내장모듈 datetimepandas dataframe의 시간 관련 메서드들matplotlib은 다양한 데이터를 많은 방법으로 도식화 할 수 있도록 하는 파이썬 라이브러리여러개의 그래프 그리기
12.AI데이터엔지니어 부트캠프 <핀테커스> 3주차 - (4) 데이터 시각화
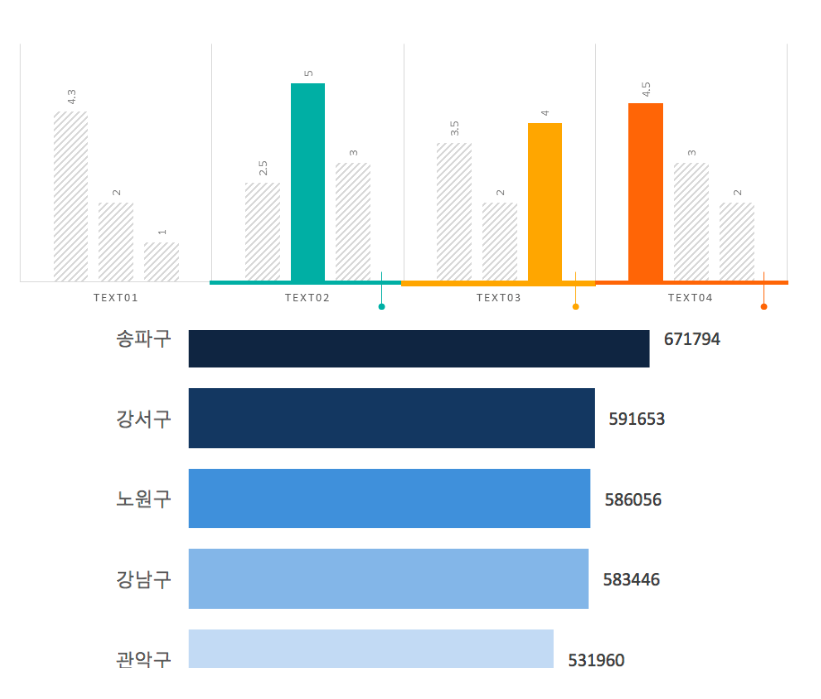
차트, 그래프 또는 맵과 같은 시각적 요소를 사용해 데이터를 표시하는 프로세스원시 데이터는 이해하고 사용하기 어려울 수 있음의사결정을 위한 스토리텔링분석은 기술적으로 하더라도, 자료에는 누구나 이해할 수 있는 언어를 활용결과 자료의 종류의사결정 지원 : 필수적이고 간결
13.AI데이터엔지니어 부트캠프 <핀테커스> 4주차 - (1) Python 기초 더 다지기
가장 흔하게 사용되는 데이터 전처리 기법데이터의 모든 feature의 각각에 대해서 평균값 만큼 차감하는 방법기하학 관점에서 보자면 데이터 군집을 모든 차원에 대해서 원점으로 이동시키는 것으로 해석할 수 있음
14.AI데이터엔지니어 부트캠프 <핀테커스> 4주차 - (2) Python with Math
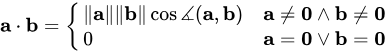
1개 이상의 수나 식을 직사각형의 배열로 나열한 것N x 1차원의 행렬(Matrix)벡터 내부 데이터의 수가 곧 벡터의 차원(Dimension)벡터와 벡터간의 연산스칼라와 벡터의 연산선형대수학에서 벡터의 크기(magnitude) 또는 길이(length)를 측정하는 방법
15.AI데이터엔지니어 부트캠프 <핀테커스> 4주차 - (3) min-Max Normalization

데이터 정규화 방법 중 하나각각의 최소값이 0, 최대값이 1로, 그리고 다른 값들은 0과 1 사이의 값으로 변환
16.AI데이터엔지니어 부트캠프 <핀테커스> 4주차 - (4) Confusion Vector , Manhattan Distance
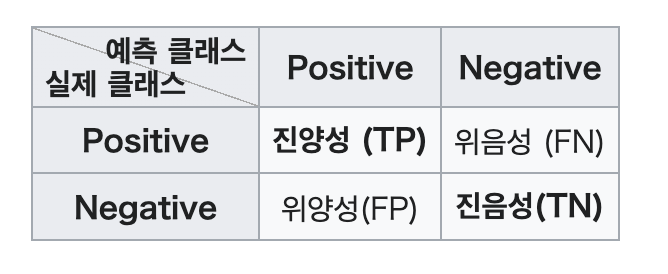
Confusion Vector (Confusion Matrix) 모델의 성능평가 지표로 활용된다 정밀도 정확도
17.AI데이터엔지니어 부트캠프 <핀테커스> 4주차 - (5) Basic operations of Matrix , Categorical Encoding
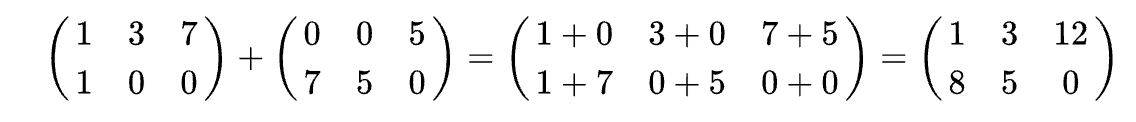
Matrix Addition Matrix-Vector Multiplication Matrix-Matrix Multiplication Categorical Encoding One-hot Encoding
18.AI데이터엔지니어 부트캠프 <핀테커스> 6주차 - (1) Data Visualization with matplotlib
3주차에 공부했던 matplotlib의 사용법 대해 좀더 자세히 알아보자figure 생성시 지정해 줄수있는 속성은 아래와 같다numfigsizefacecolor추가내용은 matplotlib의 공식문서 참조 .suptitle('지정할 타이틀 텍스트')fontsizefon
19.AI데이터엔지니어 부트캠프 <핀테커스> 6주차 - (2) matplotlib - iris flower data set 을 활용한 실습
각 종별 feature 분포를 시각화 한 코드각 feature를 축으로 가지는 그래프의 시각화 코드를 아래와 같이 작성해 보았다. 허나 아직 개선의 여지가 보여서 좀 더 고민해 보아야 할 거 같다.
20.AI데이터엔지니어 부트캠프 <핀테커스> 6주차 - (3) matplotlib의 boxplot, numpy
예시코드실행결과numpy.ones(), numpy.zeros() numpy.arange(), numpy.linspace()ndarray는 Element-wise Operations 를 가능하게 해준다.실행 결과numpy.reshape()실행 결과numpy.reshape
21.AI데이터엔지니어 부트캠프 <핀테커스> 7주차 - (1) KNN Classification
1일차test data 생성, test data와 data사이의 euclidean distance를 통한 KNN 분류해 시각화 까지 완료
22.AI데이터엔지니어 부트캠프 <핀테커스> 7주차 - (2) KNN Classification 완성하기
1일차 참조class 숫자만큼 임의의 데이터 생성 및 분류, 테스트 데이터 생성 및 분류, decision boundary 시각화 포함해 완성된 코드실행결과
23.AI데이터엔지니어 부트캠프 <핀테커스> 7주차 - (3) Decision tree model [1]
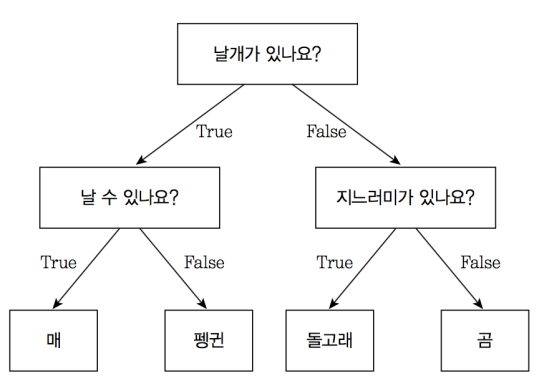
특정 기준(descriptive feature)에 따라 데이터를 구분하는 지도학습 모델classification tree, regression tree로 나누어지며, 분류와 회귀 모두 가능하다분기점각각의 분기점마다 변수 영역을 분화무질서도impurity(불순도), he
24.AI데이터엔지니어 부트캠프 <핀테커스> 7주차 - (4) Decision tree model [2]
Information Gain Ratio Feature를 선택할 때 가지(branch)의 수와 크기를 고려하여 feature의 여러 value에 대한 편향을 줄이기 위해 사용 > $$Information\;Gain\;Ratio = IG/IV = GR$$ $$GR(d
25.AI데이터엔지니어 부트캠프 <핀테커스> 8주차 - (1) Regression Tree
target feature가 continuous함value output by the leaf nodeleaf node안 instance들의 meanleaf node 안 target feature 값들의 variance가 감소하는 방향으로 진행됨best feature를
26.AI데이터엔지니어 부트캠프 <핀테커스> 8주차 - (2) Bayes' Theorem
두 확률 변수의 사전 확률 과 사후 확률 사이의 관계를 나타내는 정리$$P(B∣A)= \\frac{P(A∣B)\\times P(B)}{P(A)}$$어떤 사건이 일어날 확률에 대한 임의의 가정 $$P(A)$$에 실제로 발견된 자료나 증거 $$B$$를 반영해서, 자료로 미
27.AI데이터엔지니어 부트캠프 <핀테커스> 9주차 - (1) 최신 AI 기술 개요 및 용어 정리
데이터의 유형정성적(qualitative)정량적(quantitative)빅데이터의 정의3V : 양(Volume), 다양성(Variety), 속도(Velocity)4V: 3V + 가치(Value)1950년대 등장한 개념으로, 인공적으로 만들어진 지능컴퓨터 과학에서는 인공