실전 FortiShop 프로젝트에서 Kafka + Redisson 환경에서 발생한 race condition을 해결하며 얻은 인사이트와 코드/아키텍처 개선 과정을 담는다. 보여주기식 결과가 아닌, 내가 실제로 겪고 고민한 문제들을 정리해두고 싶어 작성한다.
문제 배경 : 고트래픽 상황에서의 재고 차감 실패
FortiShop 프로젝트의 product-inventory-service는 Kafka 기반의 이벤트를 수신하여 상품의 재고를 차감하는 구조이다. 이 구조가 고트래픽 상황에서도 안정적으로 동작할 수 있는지 검증해보고 싶었다.
Kafka 구조를 설계할 때도 꽤나 고민이 많았다. 단순히 메시지를 발행하고 소비하는 구조를 넘어서, 병렬 처리가 가능한 구조를 갖추는 것이 중요하다고 생각했다. 그래서 다음과 같은 방식으로 구성하였다.
- Kafka 토픽 파티션: 5개
- Consumer 컨테이너 concurrency: 5개
이렇게 구성함으로써, order.created 이벤트가 동시에 여러 파티션으로 분산되어 처리될 수 있도록 하였고 product-inventory-service에서도 5개의 스레드가 동시에 메시지를 소비할 수 있게 하였다.
Kafka의 파티셔닝, 키 기반 메시지 라우팅, Consumer Group 내부 병렬 소비 구조 등을 충분히 이해한 뒤 설계하였기 때문에 이번 테스트는 그 구조가 실제 고트래픽 상황에서도 잘 작동하는지 확인하는 계기가 되었다.
그래서 JMeter를 통해 TPS 300 수준으로 Kafka 메시지를 1000건 발행하는 테스트를 진행하였다.
그런데, 결과는 예상과 달랐다.
- Kafka 메시지는 1000건 정확히 발행되었고 consumer 로그 상으로도 모두 수신되었다.
- 로그에는
✅ 재고 차감 성공메시지가 1000건 모두 출력되었다. - 하지만 실제 DB를 조회해보니 재고는 500 ~ 600건 정도만 줄어들어 있었다.
처음에는 단순한 로깅 오류일 수도 있다고 생각했지만, DB에서 정확히 확인했기 때문에 로직 상 어딘가에서 정합성이 깨지고 있다는 확신이 들었다.
1차 시도 : 락 없이 동시 처리
Kafka 메시지를 수신한 후 재고를 차감하는 로직은 다음과 같았다.
Inventory inventory = inventoryRepository.findByProductId(productId);
inventory.decrease(quantity);
inventoryRepository.save(inventory);
락 없이 처리했을 때는 예측한 대로 재고가 음수로 떨어지는 현상이 발생했다. 동시 요청이 몰리면서 동일한 재고를 중복 차감한 것이다.
이 테스트를 통해 "동시성 제어가 없다면 데이터 정합성이 완전히 깨진다"는 점을 몸소 확인할 수 있었다. 이후 해결책은 락이라고 판단했다.
2차 시도 : Redisson 락 도입
분산 환경이므로 Redis 기반의 Redisson 분산락을 적용했다. 구현은 간단했다.
RLock lock = redissonClient.getLock("lock:product:" + productId);
if (lock.tryLock(5, TimeUnit.SECONDS)) {
    Inventory inventory = inventoryRepository.findByProductId(productId);
    inventory.decrease(quantity);
    inventoryRepository.save(inventory);
    lock.unlock();
}
락을 적용하면 당연히 문제가 해결될 것이라 생각했다. 하지만 결과는 또 달랐다.
- 로그에는 여전히 1000건 성공 메시지가 찍혔다.
- 그러나 실제 DB에서는 재고가 정확히 1000개 차감되지 않았다. 약 489건만 반영되었다.
당황스러웠다. 락을 걸었고 모든 처리가 순차적으로 이루어졌다고 생각했는데 왜 DB는 일부만 반영된 걸까?
이후 로그를 정밀하게 추적해보면서 문제의 원인을 파악할 수 있었다.
문제의 핵심 : 락 해제와 트랜잭션 커밋 타이밍의 불일치
락은 tryLock()으로 잘 걸렸고 순차적으로 실행되었다. 하지만 lock.unlock()은 트랜잭션 커밋 전에 호출되고 있었다. 즉, 락이 먼저 풀렸지만 트랜잭션은 아직 반영되지 않은 상태였다.
이 상태에서 다음 스레드가 락을 잡고 진입하면, DB에서는 여전히 예전 수량을 보여준다. 그래서 서로 다른 스레드가 동일한 수량을 읽고 동일한 값을 저장하는 일이 발생한 것이다.
이 실험을 통해 "Redisson 락은 메서드 진입 순서는 보장하지만 트랜잭션 커밋 시점까지 보장하지 않는다"는 점을 알 수 있었다.
3차 시도 : Redisson + DB 비관적 락 병행 적용
문제 해결을 위해 다음으로 떠올린 방법은 DB 수준의 비관적 락을 병행하는 것이었다.
비관적 락은 해당 row를 SELECT FOR UPDATE로 조회하면서 다른 트랜잭션이 접근하지 못하도록 제어할 수 있다. Redisson이 분산 환경의 진입 제어를 담당한다면, DB 락은 실제 데이터 접근 타이밍을 보장해준다.
이 방식이라면 Redisson 락이 선점 제어, DB 비관적 락이 정합성 보장의 역할을 분리해서 수행할 수 있을 것이라 판단했다.
@Lock(LockModeType.PESSIMISTIC_WRITE)
@Query("SELECT i FROM Inventory i WHERE i.productId = :productId")
Inventory findByProductIdForUpdate(@Param("productId") Long productId);
이후 다음과 같이 병행 적용하였다.
RLock lock = redissonClient.getLock("lock:product:" + productId);
if (lock.tryLock(5, TimeUnit.SECONDS)) {
    Inventory inventory = inventoryRepository.findByProductIdForUpdate(productId);
    inventory.decrease(quantity);
    inventoryRepository.save(inventory);
    lock.unlock();
}
결과는 만족스러웠다.
- 동시성 완벽 제어
- 재고 1000건 정확히 차감
그러나 이 방식은 또 다른 한계를 드러냈다. 바로 성능 저하였다. TPS가 높은 환경에서 DB 락 대기 시간이 길어지고 소비 처리 속도가 떨어지면서 Kafka consumer에 backpressure 현상이 발생할 수 있음을 확인했다. 락 대기 시간이 길어져서 재고 부족으로 인한 실패가 이루어지지 않고 락 획득 시간 초과에 대한 로직 실패가 발생하였다.
"이 방식은 정확하지만 무겁다. 더 가볍고 효율적인 방법이 없을까?"
이러한 고민 끝에 최종 해결 방식에 도달하게 되었다.
최종 해결 : Redisson + 트랜잭션 커밋 이후 락 해제
핵심 아이디어는 단순했다.
"락을 트랜잭션 커밋 이후에 해제한다면, race condition을 원천 차단할 수 있지 않을까?"
이 발상을 처음 떠올렸을 때, 나는 Spring의 트랜잭션 흐름이 어디까지 개입할 수 있는지 구체적으로 알고 싶었다. 트랜잭션이 커밋되기 전과 후의 타이밍 사이에 내가 원하는 동작을 지연시킬 수 있는 방법이 있는지 검색과 문서 탐색을 통해 찾아보기 시작했다.
처음에는 @Transactional 내부에서 어떻게 락을 늦게 해제할 수 있을지 고민했지만, 메서드의 반환 시점과 커밋이 실제로 적용되는 시점 사이에 Hook을 걸 수 있다는 것이 핵심이었다. 그러다 TransactionSynchronizationManager와 TransactionSynchronization 인터페이스를 발견하게 되었고 바로 afterCommit()이라는 메서드가 눈에 띄었다. "이거다" 싶었다. 이 콜백을 활용하면 커밋 이후 시점에서만 Redisson 락을 해제할 수 있었다.
이것은 나에게 있어 단순한 해결책 이상의 의미였다. 트랜잭션의 라이프사이클을 이해하고 그 흐름의 마지막 순간까지 제어할 수 있다는 사실은 굉장히 실무적인 깨달음으로 다가왔다.
@Transactional
public void adjustInventory(...) {
    RLock lock = redissonClient.getLock("lock:product:" + productId);
    if (lock.tryLock(5, 10, TimeUnit.SECONDS)) {
        try {
            Inventory inventory = inventoryRepository.findByProductId(productId);
            inventory.decrease(quantity);
            inventoryRepository.save(inventory);

            TransactionSynchronizationManager.registerSynchronization(new TransactionSynchronization() {
                @Override
                public void afterCommit() {
                    if (lock.isHeldByCurrentThread()) {
                        lock.unlock();
                        log.info("🔓 커밋 이후 Redisson 락 해제 완료");
                    }
                }
            });
        } catch (Exception e) {
            if (lock.isHeldByCurrentThread()) lock.unlock();
            throw e;
        }
    }
}
결과
- Kafka 메시지 1000건 발행 → 정확히 1000건 처리
- 로그와 DB 모두 일치
- TPS 저하 없음, backpressure 없음
- 비관적 락 없이도 완전한 정합성 확보
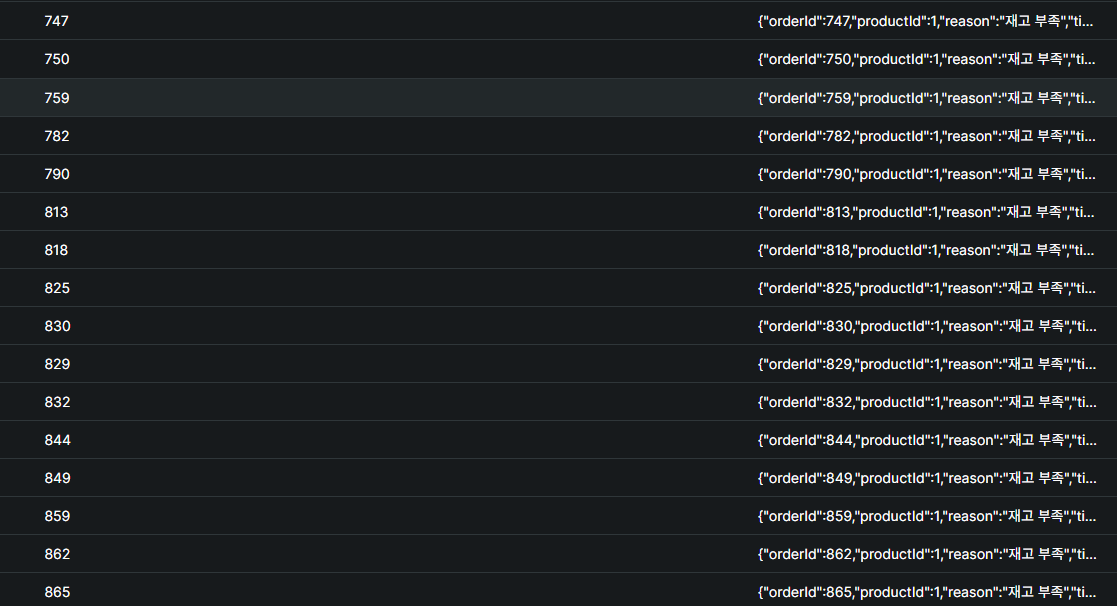
아래와 같이 정학이 inventory.failed 토픽에 100개의 메시지가 쌓였고 메세지들을 모두 재고 부족으로 저장되었다.

흐름 비교 요약
Redisson만 사용 시 (❌)
Thread A: 락 → DB 조회 (500) → -1 → 저장 (499) → 락 해제 (커밋 전)
Thread B: 락 → DB 조회 (500) → -1 → 저장 (499) → 커밋 덮어쓰기
Redisson + 비관적 락 (✅)
Thread A: 락 + FOR UPDATE → 처리 → 커밋
Thread B: 대기 → 최신값 조회 → 처리
Redisson + 커밋 이후 해제 (✅ 최종)
Thread A: 락 → 처리 → 커밋 → 락 해제
Thread B: 락 → 최신값 조회 → 처리 → 커밋
실험 지표 정리
| 항목 | Redisson만 | 비관적 락 | 커밋 이후 해제 |
|---|---|---|---|
| 처리 성공률 | 50~60% | 100% | 100% |
| TPS | 빠름 | 느림 | 빠름 |
| DB 부하 | 낮음 | 높음 | 낮음 |
| 구현 난이도 | 쉬움 | 중간 | 중간 |
| 운영 적합성 | ❌ | ❌ | ✅ |
이번 경험을 통해 뼈저리게 느꼈다. "락은 언제 해제되는가"가 진짜 핵심이었다. 락을 무작정 건다고 해도 락을 놓는 시점에 이전 트랜잭션에 대한 로직이 모두 완료되어야 진정한 락인 것이다.
Redisson 자체는 메서드 단위의 선점 제어만 해줄 뿐이고 트랜잭션의 경계와는 무관하다. 그리고 이 미묘한 시차 때문에 수많은 장애가 발생할 수 있다는 걸 직접 겪고 나서야 깊이 이해할 수 있었다.
처음에는 단순히 락만 걸면 끝날 줄 알았고 비관적 락을 썼을 땐 이게 정답이라고 생각했지만, 결국 실무에서는 "가볍고 안전한 방법"이 가장 좋은 방법이었다.
Kafka처럼 빠른 처리가 중요한 환경에서는 더더욱 그 균형이 중요하다.
이 트러블 슈팅 경험은 단지 버그를 해결한 경험보다는 어떤 시점에서 어떤 일이 일어나는지를 깊이 생각하게 만든 경험이었다.
다음 포스팅에서는 Kafka를 사용하면서 재처리와 DLQ를 도입한 경험에 대해 작성할 예정이다.