CS:APP 3.8.4장에서는 16x16이라는 고정된 크기의 배열 2개를 놓고, 두 배열을 곱했을 때 (내적했을 때) i행 k열에 있는 값을 구하는 함수를 예시로 든다.
책에서는 -O1 옵션으로 어떻게 최적화되는지 예시를 보여주는데, 이걸 평소 하던대로 -Og 옵션을 쓰면 어떻게 되는지, C-어셈블리 1:1 대응 차원에서 한번 실험해보았다.
사용한 웹사이트는 Compiler Explorer이다.
기본 전제
C 코드에도 적혀있겠지만 fix_matrix는 이렇게 선언되어 있다.
#define N 16
typedef int fix_matrix[N][N];
이 배열의 한 칸의 크기는 4바이트, 한 줄의 크기는 64바이트이며, 배열 전체 크기는 64*16인 1024바이트이다.
-Og 옵션 (C-어셈블리 1:1 대응)
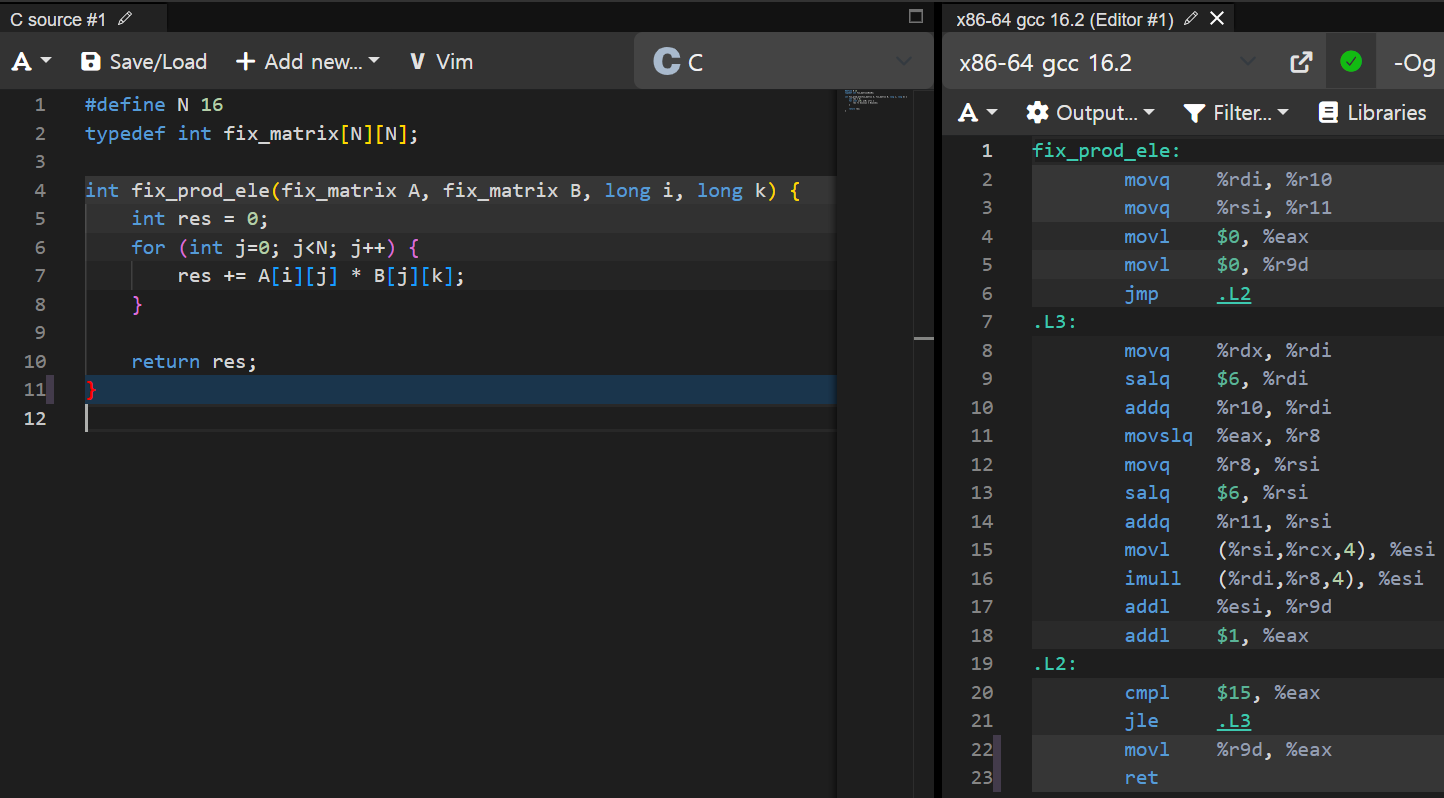
두 코드 화면을 보면 줄마다 밝기가 살짝 다른데, 양쪽을 확인했을 때 같은 밝기면 이 C언어 코드 한 줄이 어셈블리에서 이렇게 대응된다고 확인할 수 있다.
두 배열의 주소값 자체를 나중에 쓸 생각인지 %r10, %r11이 동원되었다. 그리고 조건형-do 기법을 써서 j가 15까지일 때만 .L3으로 점프하는 모습이다.
fix_matrix의 한 줄의 크기는 int형 16칸인 64바이트이므로, 두 배열에 대해 이렇게 주소를 계산한다.
- 인덱스에 64를 곱하는 행위는 그 행으로 가겠다는 의미로 해석할 수 있다.
- A:
i에다가 64를 곱하고(salq $6, %rdi),j를%r8에 저장해서(%rdi, %r8, 4)로 참조- 이렇게
A[i][j]의 주소를 구하고, 역참조한다.
- 이렇게
- B:
j에다가 64를 곱하고(salq $6, %rsi),(%rsi, %rcx, 4)로 참조- 이렇게
B[j][k]의 주소를 구하고, 역참조한다. %rcx에 저장된k값은 어디에도 복사하지 않았다.
- 이렇게
레지스터 %esi를 배열 요소를 한번 곱한 값을 저장하려고 잠시 재사용한다. 그리고 누적 값을 %r9d에 더한 다음, j가 16이 되는 순간 .L3을 빠져나와 진짜 반환 레지스터인 %eax에 최종 결과를 복사하고 함수가 반환된다.
-O1 옵션 (gcc의 진심 최적화, 1:1 대응 힘듦)
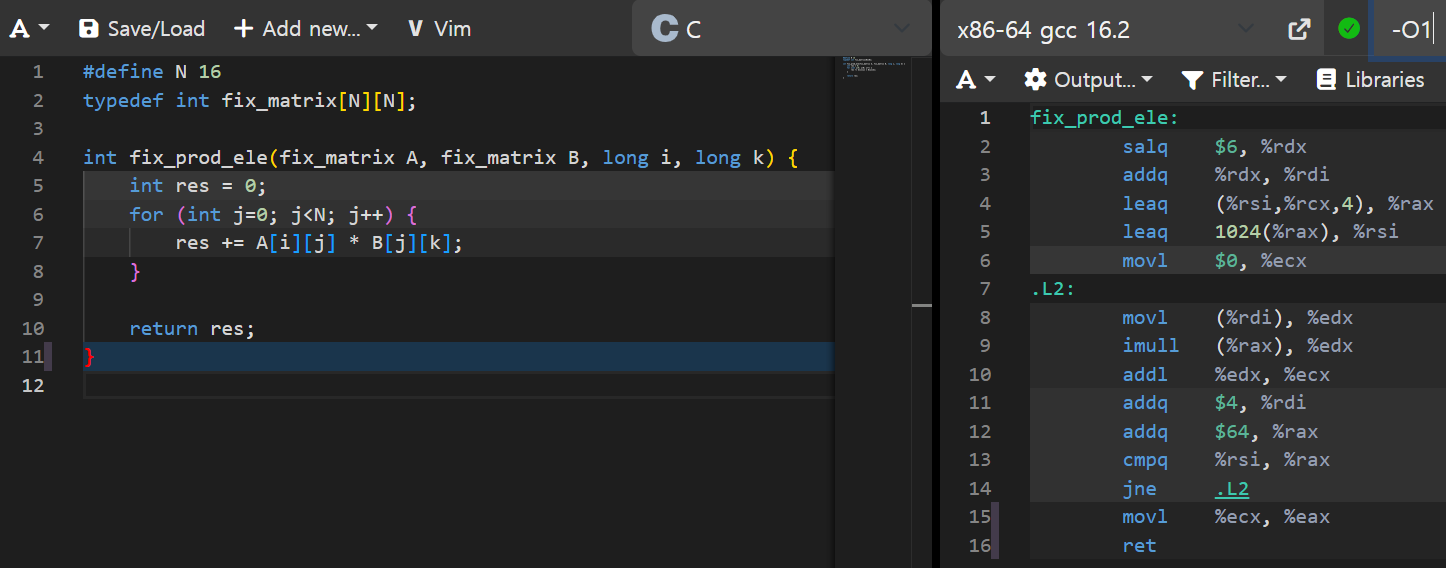
이 화면에서는 어셈블리 코드에 아무리 마우스를 호버링해봐도 왼쪽 C 코드를 다 설명하지 못한다. 이게 바로 gcc의 "진짜" 최적화라는 것이다.
- 냅다 i에다가 64를 곱하고 시작한다. 그리고 A의 주소에
i*64를 더하므로,%rdi에는 이제A[i][0]의 주소가 저장되었다. leaq (%rsi, %rcx, 4), %rax에서B[0][j]의 주소를%rax에 임시로 저장한다. 그리고는B[16][j]의 주소를%rsi에 저장한다. (%rax + 1024,1024 = 64*16)- 이제부터는 한번 더한 값을 %edx, 누적 값을 %ecx에 저장하려고 한다.
- 8행과 9행에서 주소들을 역참조하여 값을 구해오고, 곱한다. 그리고 10행에서 값을 누적한다.
addq $4, %rdi로 A에서는 오른쪽으로 한 칸 간다. 비슷하게addq $64, %rax로 B에서는 밑으로 한 칸 간다. (중간에서 64바이트 진행시키면 같은 열의 바로 아래 행으로 이동하는거나 마찬가지기 때문에)- %rax를 밑으로 한 칸 보낸 값이
B[16][j]의 주소와 같으면 루프를 빠져나오고, 아니면 3번으로 되돌아간다. - 진짜 반환 레지스터인 %eax에 누적 값을 복사하고, 함수가 반환된다.
인덱스 사용을 일절 하지 않고, 오로지 주소만 일정하게 이동시켜서 역참조하는 모습이다. -O2 옵션을 사용해도 같은 결과를 볼 수 있다.
-O3 옵션
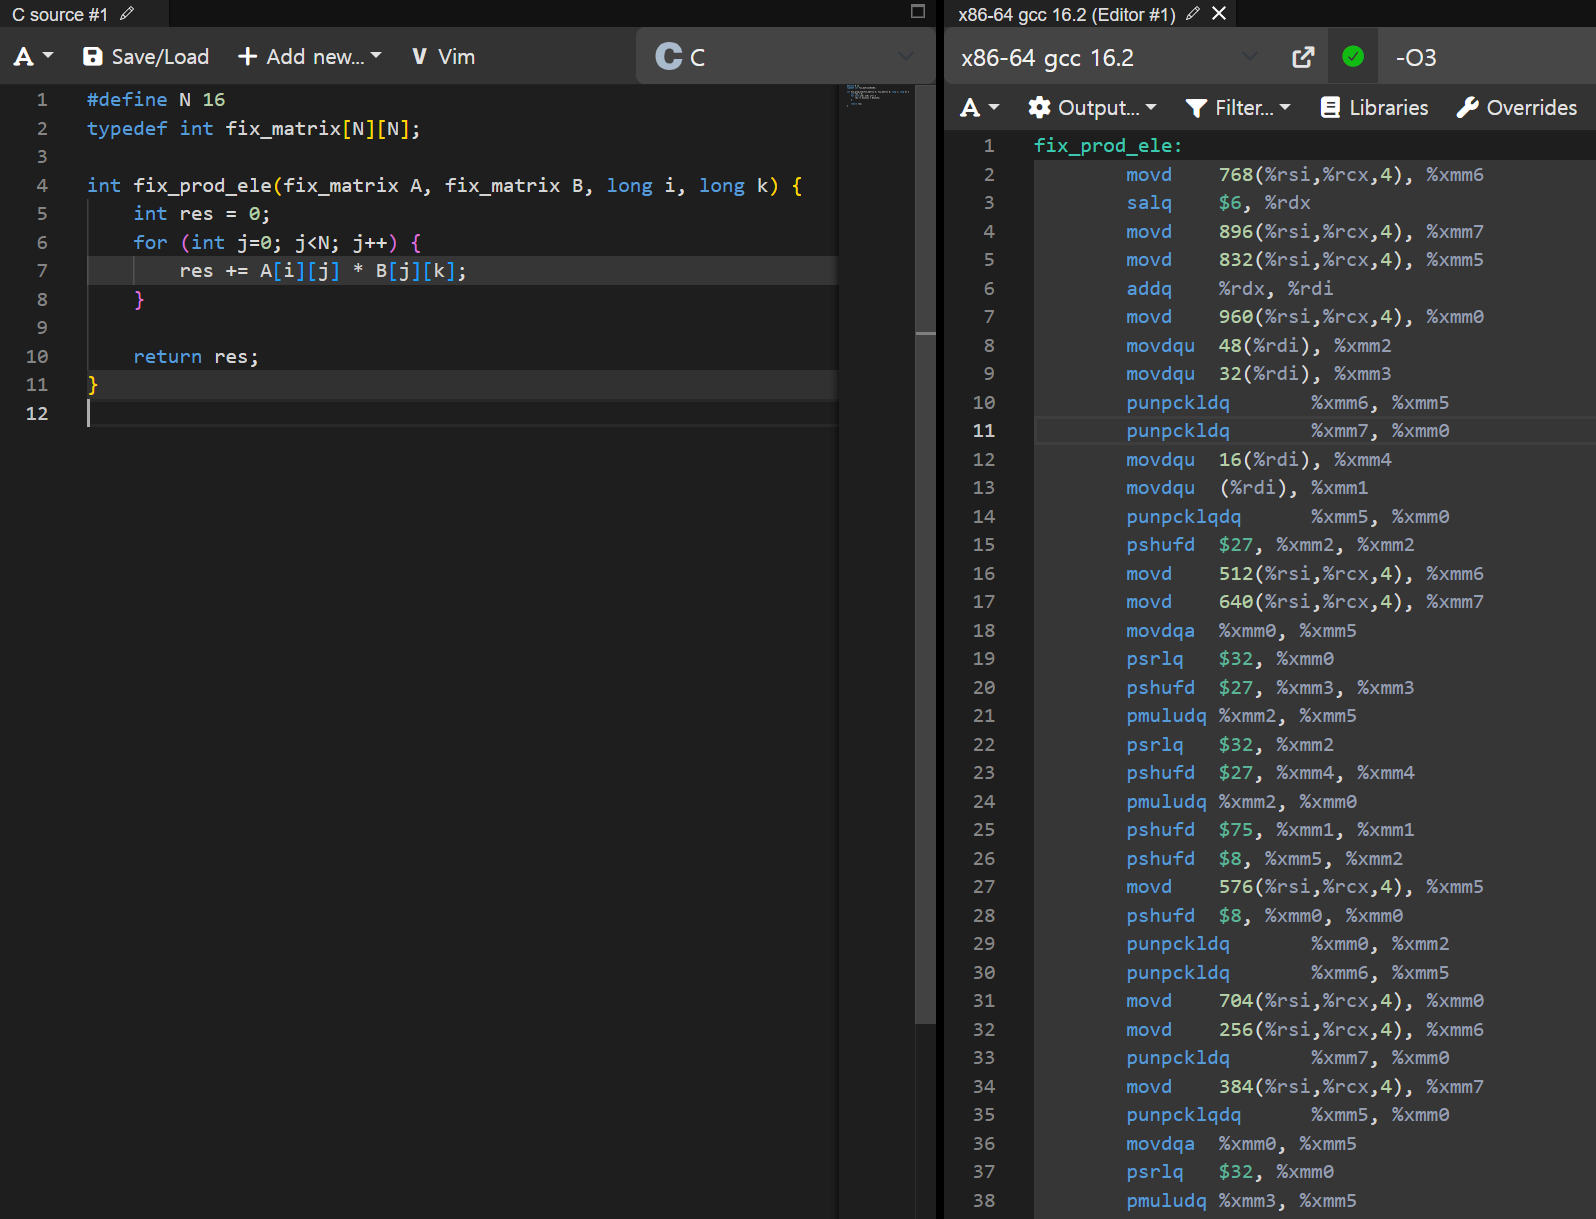
진짜 그냥 단순히 궁금해서 이 옵션을 써봤는데, 결과가 충격적이다.
점프고 인덱스 계산이고 뭐고.. 아무것도 없다. 심지어 부동소수점 처리를 위한 xmm 레지스터까지 끌고와서 어떻게든 점프를 쓰지 않으려는 모습이다. (오른쪽 화면의 어셈블리 코드가 전부가 아니다)
책에서 다루지 않는 인스트럭션도 있어서, 굳이 분석하지는 않는다.
요약
- 평소 쓰던대로
-Og옵션을 쓰면, 디버깅 경험이 최소화되는 선이기 때문에 어셈블리 분석이 쉽다. - 이 장에서 나온 것처럼
-O1옵션을 쓰면, 고정 배열의 인덱스를 순차 탐색하는 경우 단순히 주소값에서 더하는 작업으로 효율을 늘린다. -O3옵션은 진짜 성능 하나만을 위한 최적화라는 것을 다시한번 알아간다. 어셈블리 코드의 가독성은 0에 가깝다...
좋은 글이네요