안녕하세요, 미니지식공간입니다.
Beam-501B-A23B는 Reflection AI가 2026년 10월 5일 공개한 501B 오픈웨이트 모델 Beam의 API 모델 ID다. 공식 문서를 먼저 열어 보면 발표 블로그와 숫자가 한 군데 어긋나 있는데, 그 차이가 실제로 코드를 쓸 때 영향을 준다. 이 글은 발표 서사보다 공식 API 문서와 아키텍처 수치를 먼저 읽는 순서로 정리한다.
세 줄 정리
1. 모델 ID는 Beam-501B-A23B. OpenAI 호환 엔드포인트가 제공되고, base URL만 바꾸면 기존 OpenAI SDK 코드가 거의 그대로 돈다.
2. 공식 API 문서상 컨텍스트는 256K(262,144), 최대 출력 128K(131,072)다. 발표 블로그의 "유효 100만 토큰"과는 다른 숫자다.
3. 가중치는 아직 없다. Apache 2.0 라이선스로 "이달 중" 공개 예고 상태이고, 현재는 베타 대기명단 기반 API만 열려 있다. 가격 미공개.
먼저 API 문서부터
공식 문서(developers.reflection.ai)는 두 개의 base URL을 제시한다.
| 종류 | Base URL |
|---|---|
| Reflection 네이티브 클라이언트 | https://api.reflection.ai/v1 |
| OpenAI 호환 | https://api.reflection.ai/openai/v1 |
문서의 모든 코드 예시는 OpenAI 호환 쪽을 쓴다. /models에 등재된 모델은 현재 하나뿐이다.
| 필드 | 값 |
|---|---|
id | Beam-501B-A23B |
owned_by | reflection |
| 생성일 | 2026년 10월 5일 |
| 지식 컷오프 | 2026년 6월 30일 |
context_length | 262144 (256K) |
max_output_tokens | 131072 (128K) |
| 지원 기능 | reasoning, tool calling, structured outputs |
공식 퀵스타트의 코드는 다음과 같다. 아래 스니펫은 모두 developers.reflection.ai/quickstart에 게시된 예제를 그대로 가져온 것이다.
export REFLECTION_API_KEY="<your API key>"curl https://api.reflection.ai/openai/v1/chat/completions \
-H "Authorization: Bearer $REFLECTION_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "Beam-501B-A23B",
"messages": [
{"role": "user", "content": "Why is the sky blue?"}
]
}'import os
from openai import OpenAI
client = OpenAI(
base_url="https://api.reflection.ai/openai/v1",
api_key=os.environ["REFLECTION_API_KEY"],
)
completion = client.chat.completions.create(
model="Beam-501B-A23B",
messages=[{"role": "user", "content": "Why is the sky blue?"}],
)
print(completion.choices[0].message.content)기존 OpenAI SDK 기반 도구에 꽂을 때는 환경변수만 바꿔도 된다. 아래는 developers.reflection.ai/openai-compatibility 문서의 설정 블록이다.
export OPENAI_BASE_URL="https://api.reflection.ai/openai/v1"
export OPENAI_API_KEY="$REFLECTION_API_KEY"
호환되는 범위와 막힌 범위
"OpenAI 호환"이라는 표현이 전부 호환을 뜻하지는 않는다. 문서가 명시한 범위는 좁다.
| 구분 | 내용 |
|---|---|
| 지원 엔드포인트 | POST /chat/completions, GET /models, GET /models/{model} |
| 미지원 | Responses, Embeddings, Images, Audio, Files, Batch, Assistants 전부 |
| 입력 | 텍스트 전용 (이미지·오디오·파일 입력 불가) |
| 쓸 수 있는 파라미터 | temperature, top_p, frequency_penalty, presence_penalty, max_completion_tokens, seed, reasoning_effort, tool_choice, parallel_tool_calls |
| 고정값만 허용 | n=1, logprobs=false, logit_bias={}, store=false, modalities=["text"], verbosity=medium |
| 무시됨 | stop (문자열 또는 최대 4개 배열을 받지만 효과 없음으로 문서화) |
| 문서에 없는 파라미터 | top_logprobs, audio, prediction, user, metadata → 400 unsupported_parameter |
고정값 위반은 400 unsupported_value로 떨어진다. 즉 n=3으로 여러 후보를 뽑는 패턴, logprobs로 토큰 확률을 받는 패턴, store=true로 응답을 서버에 남기는 패턴은 코드를 고쳐야 한다. 구조화 출력은 json_object와 json_schema 둘 다 지원하고, 스트리밍은 stream_options.include_usage까지 받는다.
reasoning은 끌 수 없다
Beam은 추론(reasoning) 모델이고, 문서는 이를 mandatory: true로 표기한다. OpenAI 쪽에 있는 reasoning_effort: "none" 같은 선택지가 없다는 뜻이다.
{
  "reasoning": {
    "supported_efforts": ["max", "xhigh", "high", "medium", "low"],
    "default_effort": "medium",
    "mandatory": true
  }
}
응답 형태도 표준 Chat Completions에서 두 군데 늘어난다. message 안에 reasoning_content가 들어오고, usage.completion_tokens_details.reasoning_tokens로 추론 토큰 수가 따로 집계된다. reasoning_content는 요청 쪽 assistant 메시지에도 넣을 수 있다고 문서에 적혀 있어, 멀티턴에서 추론 이력을 돌려주는 패턴이 가능하다. 응답 헤더로는 x-server-request-id와 x-ratelimit-*-day가 온다. 가격이 미공개라 추론 토큰이 과금에 어떻게 반영되는지는 아직 알 수 없다(확인 필요).
256K와 1M, 어느 쪽을 믿나
이 지점이 이번 발표에서 가장 혼동이 큰 부분이다. 2026년 10월 5일 공식 블로그는 미드트레이닝으로 "유효 컨텍스트 길이를 100만 토큰까지 확장했다"고 적었고, TechCrunch는 같은 날 이를 "100만 토큰 컨텍스트 윈도"로 단정해 보도했다. 반면 공식 API 문서는 context_length를 262144로 명시하고, 베타 기간 중 변경될 수 있다는 각주를 달았다.
정리하면 세 숫자가 각각 다른 것을 가리킨다. 100만은 미드트레이닝에서 확보한 유효 컨텍스트, 256K는 지금 API가 받는 실제 상한, 그리고 블로그가 밝힌 RL 최대 롤아웃 컨텍스트는 256K다. 긴 컨텍스트를 전제로 설계하고 있다면 현재 기준은 256K로 잡는 편이 안전하다.
모델 구조와 학습 인프라
공식 블로그가 공개한 수치는 모델 스펙보다 학습 운영 쪽이 훨씬 상세하다.
| 항목 | 값 |
|---|---|
| 총 / 활성 파라미터 | 501B / 23B |
| 레이어 | 52 |
| 사전학습 토큰 | 23.8조 |
| 사전학습 하드웨어 | NVIDIA GB300 NVL72 6,144장, 4주 미만 |
| 사전학습 굿풋 | 막판 92.3% |
| 되감기 횟수 | 9회 (그라디언트 노름 급증 또는 SDC 의심) |
| RL 하드웨어 | GB300 10,500장, 4주 |
| RL 롤아웃 | 1억 건 이상 (그중 8천만 건이 reasoning 전문가 학습) |
| RL 샌드박스 | 약 13억 개 (학습·채점 합산), 동시 최대 17만 개 |
| 가중치 전파 | 신규 가중치가 추론 플릿에 도달하는 중위 시간 약 12초 |
아키텍처 구성 요소로는 로컬·글로벌 어텐션 인터리빙, 세분화된 라우팅 전문가, SandwichNorm, 원소별 어텐션 게이팅, FP32 잔차 누적, 깊이 기반 잔차 스케일링이 열거됐다. 로드 밸런싱은 보조 손실 없는 방식(DeepSeek-AI et al., 2024, arXiv:2412.19437)을 기반으로 전문가 바이어스 업데이트에 코사인 감쇠를 더했고, 사전학습 완료 시점에 MoE 레이어 평균으로 가장 바쁜 전문가의 부하가 1.04배에 머물렀다고 밝혔다. 다만 전문가 개수와 토큰당 활성 전문가 수는 블로그에 명시되지 않았다.
벤치마크를 어떻게 읽어야 하나
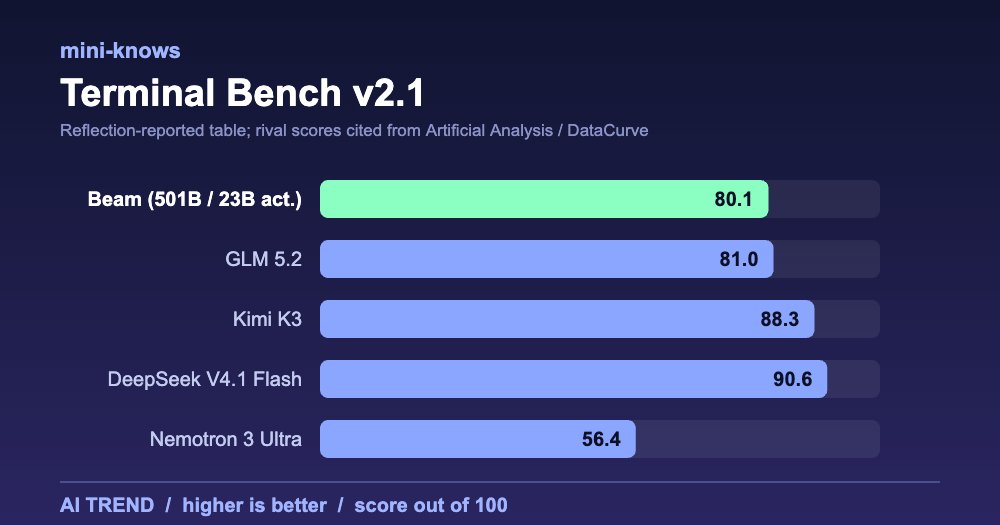
아래 표의 모든 점수는 Reflection의 자사 발표다. 경쟁 모델 점수는 회사가 Artificial Analysis와 DataCurve를 출처로 인용한 값이며, 회사가 동일 조건에서 재측정한 값이 아니다. "NR"은 미보고다.
| 벤치마크 | Beam | Inkling | Nemotron 3 Ultra | GLM 5.2 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|---|---|
| SWE-bench Verified | 80.9 | 77.6 | 70.7 | NR | NR | NR | NR |
| SWE-bench Pro v1 | 65.5 | 54.3 | 46.4 | 62.1 | NR | 67.7 | NR |
| SWE-bench Pro v2-Hard | 77.2 | 56.9 | NR | NR | 88.2 | NR | NR |
| SWE-bench Multilingual | 78.0 | NR | 67.7 | NR | NR | NR | NR |
| Terminal Bench v2.1 | 80.1 | 63.8 | 56.4 | 81.0 | 88.3 | 86.6 | 90.6 |
| DeepSWE v1.1 | 44.4 | NR | NR | 44.0 | 68.0 | 51.0 | 74.2 |
| SWE Atlas Codebase QnA | 34.6 | NR | NR | NR | 68.0 | NR | NR |
열별로 비교 대상 수가 다르므로 종합 순위를 매기기 어렵다. 분명한 건 Beam이 전 항목 1위가 아니라는 점이다. Terminal Bench, DeepSWE, SWE Atlas에서는 Kimi K3와 DeepSeek V4.1 Flash가 앞서고, 회사도 블로그에서 Kimi K3 같은 프런티어 오픈 모델이 "순수 성능에서는 앞서 있다"고 직접 적었다. Reflection이 내세우는 축은 동일 성능 대비 추론 컴퓨트다.
TechCrunch는 Reflection의 성능 주장이 독립적으로 검증되지 않았다고 명시했고, Beam이 Inkling(미라 무라티의 Thinking Machines Lab이 7월 공개)보다 네 개 코딩 테스트에서 앞서지만 Inkling은 멀티모달이고 Beam은 텍스트 전용이라는 차이를 지적했다.
효율 주장의 계산식
"3~4배 적은 추론 컴퓨트"라는 문구는 회사가 계산식을 함께 공개했기 때문에 검증 가능한 형태다. 블로그가 밝힌 식은 다음과 같다.
FLOPs ≈ 2 × (활성 파라미터 수) × (시도당 평균 생성 토큰)
# 곱셈-누산 1회를 2연산으로 계산
# MoE 모델은 총 파라미터가 아니라 토큰당 활성 파라미터를 사용
이 식에는 프롬프트 프리필, 컨텍스트 길이에 따라 달라지는 어텐션 연산, 서빙 오버헤드가 전부 빠져 있다. 회사도 이를 인정하며 "측정된 추론 비용이 아니라 근사적인 컴퓨트 비교"라고 썼다. 활성 파라미터 23B는 비교군 중 가장 작으므로 이 식에서는 구조적으로 유리하게 나온다. 실제 서빙 단가는 배치 효율, KV 캐시, 전문가 라우팅 오버헤드에 좌우되므로 별개 문제다.
가중치 공개 전까지의 체크리스트
가중치는 2026년 10월 5일 시점에 공개되지 않았다. 회사는 최종 레드팀과 평가를 진행 중이며 "이달 중" Apache 2.0 라이선스로 가중치·기술 리포트·모델 카드·실행/평가/파인튜닝 전체 스택을 공개한다고 예고했다. 공식 Hugging Face 조직 페이지(huggingface.co/reflection)는 존재하지만 Beam 가중치는 아직 올라와 있지 않다. 구체적 공개일은 없다(확인 필요).
그 사이 준비할 수 있는 것은 세 가지다. 첫째, OpenAI 호환 레이어 뒤에 모델을 바꿔 끼울 수 있는 추상화가 코드에 있는지 점검. 둘째, n·logprobs·store 같은 고정값 파라미터에 의존하는 호출부 식별. 셋째, 추론 토큰이 따로 집계되는 만큼 reasoning_tokens를 로깅에 넣어 두는 것이다. 가격이 공개되면 바로 비용 산정이 가능해진다.
오픈웨이트 MoE 모델의 계보를 함께 보고 싶다면, 같은 비교표에 등장하는 Kimi K3를 API 관점에서 정리한 Kimi K3 API 뜯어보기 — KDA 아키텍처부터 캐시 기반 요금 구조까지 글도 참고할 만하다.
자주 묻는 질문
Beam 가중치는 어디서 다운로드하나?
현재 다운로드할 수 없다. Reflection은 2026년 10월 5일 발표에서 최종 레드팀 중이라고 밝히고 "이달 중" Apache 2.0으로 가중치를 공개한다고 예고했다. 공식 Hugging Face 조직 페이지는 있지만 Beam 모델 카드는 아직 없다.
기존 OpenAI API 코드를 수정해야 하나?
base URL과 모델명만 바꾸면 기본 호출은 동작한다. 다만 지원 엔드포인트가 chat/completions와 모델 조회 두 종류뿐이고, n·logprobs·logit_bias·store·modalities는 고정값만 허용되므로 해당 파라미터를 쓰는 호출부는 수정이 필요하다. Responses API나 임베딩을 쓰고 있다면 그 경로는 대체해야 한다.
컨텍스트는 100만 토큰인가, 256K인가?
문서 기준으로는 256K다. 100만은 공식 블로그가 미드트레이닝 결과로 언급한 유효 컨텍스트 길이이고, 현재 API가 받는 context_length는 262144(256K)로 명시돼 있다. 이 값은 베타 기간 중 변경될 수 있다고 문서가 각주로 밝혔다.
Beam API 가격은?
공개되지 않았다. 접근 자체가 베타 대기명단 기반이며, 공식 문서와 발표 블로그 모두 토큰 단가를 제시하지 않았다(확인 필요).
마무리
이번 발표에서 당장 손에 잡히는 것은 모델이 아니라 API 문서다. 숫자가 상세하고 계산식까지 공개된 건 평가에 유리한 조건이지만, 가중치와 가격이 없는 상태에서는 독립 검증과 비용 비교가 모두 불가능하다. 이달 중 가중치가 실제로 풀리는지가 다음 확인 지점이다.
출처
- Reflection AI 공식 블로그, Introducing Beam: Reflection's 501B open-weight model (2026-10-05): https://reflection.ai/blog/introducing-beam
- Reflection AI 공식 API 문서: https://developers.reflection.ai/ , https://developers.reflection.ai/quickstart , https://developers.reflection.ai/models , https://developers.reflection.ai/openai-compatibility
- TechCrunch (2026-10-05): https://techcrunch.com/2026/10/05/reflection-debuts-beam-a-open-weight-ai-model-to-rival-chinese-models-at-lower-compute-cost/
- MarkTechPost (2026-10-05): https://www.marktechpost.com/2026/10/05/reflection-ai-introduces-beam-a-501b-open-weight-moe-model-with-23b-active-parameters-for-coding-and-agentic-workloads/
- SiliconANGLE (2026-10-05): https://siliconangle.com/2026/10/05/reflection-ai-debuts-open-source-beam-model-with-501b-parameters/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 벤치마크 점수와 효율 수치는 Reflection AI의 자사 발표이며 독립적으로 검증되지 않았습니다.