안녕하세요, 미니지식공간입니다. Kimi K3 API가 2026년 7월 16일 문샷AI(Moonshot AI) 공식 블로그를 통해 공개됐다. 2.8조 파라미터 MoE·100만 토큰 컨텍스트라는 스펙보다 개발자 입장에서 더 눈에 들어오는 것은, KDA(Kimi Delta Attention)라는 새 어텐션 구조와 캐시 적중 여부로 10배 갈리는 요금 체계다. 이 글에서는 아키텍처와 API 사용 규칙을 문서 기준으로 뜯어본다.
아키텍처: KDA와 AttnRes, 그리고 16/896 희소성
Kimi K3는 총 2.8조 파라미터의 희소 MoE(Mixture of Experts) 모델로, Stable LatentMoE 프레임워크에서 896개 전문가 중 16개를 활성화한다. 활성 비율이 약 1.8%에 불과한 극단적 희소 구조라, 문샷AI는 라우팅 안정화를 위해 라우터 점수 분위수로 전문가 할당을 정하는 Quantile Balancing, 어텐션 헤드를 독립적으로 최적화하는 Per-Head Muon 등을 함께 도입했다고 밝혔다(2026-07-16 공식 블로그).
시퀀스 축에서는 KDA(Kimi Delta Attention, 하이브리드 선형 어텐션)가 100만 토큰 컨텍스트에서 최대 6.3배 빠른 디코딩을 낸다고 문샷AI는 발표했다(자사 발표). 깊이 축에서는 AttnRes(Attention Residuals)가 층을 거치며 표현을 균일하게 누적하는 대신 선택적으로 가져와, 약 2% 미만의 추가 비용으로 학습 효율을 약 25% 높였다고 주장한다. 두 축의 개선과 데이터 레시피를 합쳐 K2 대비 전체 스케일링 효율 약 2.5배를 자사 수치로 제시했다. 모두 자사 발표이며 기술 보고서는 가중치와 함께 추후 공개 예정이다.
서빙 쪽 선택도 특이하다. SFT(지도 미세조정) 단계부터 양자화 인지 학습(QAT)을 적용해 MXFP4 가중치·MXFP8 활성값 포맷을 쓰고, 가속기 64장 이상의 슈퍼노드 구성을 권장한다. KDA가 기존 프리픽스 캐싱(prefix caching, 입력 앞부분 KV 캐시 재사용)과 호환되지 않는 문제가 있어, 문샷AI는 대응 구현을 vLLM 커뮤니티에 기여해 모델과 함께 공개한다고 밝혔다.
벤치마크: 자사 표에서도 이기고 지는 항목이 갈린다
아래는 문샷AI 공개 수치 중 일부다. 전 항목 reasoning effort는 max이고, 벤치마크별로 하니스(KimiCode/Claude Code/Codex)가 달라 절대 비교에는 한계가 있다. 문샷AI 스스로 "전반 성능은 Claude Fable 5·GPT 5.6 Sol에 미치지 못한다"고 명시했다.
| 벤치마크 | Kimi K3 | Fable 5 (fallback 포함) | GPT 5.6 Sol |
|---|---|---|---|
| DeepSWE | 67.5 | 70.0 | 73.0 |
| Program Bench | 77.8 | 76.8 | 77.6 |
| FrontierSWE | 81.2 | 86.6 | 71.3 |
| BrowseComp | 91.2* | 88.0 | 90.4 |
| HLE-Full | 43.5 | 53.3 | 44.5 |
| OmniDocBench | 91.1 | 89.8 | 85.8 |
* BrowseComp은 300K 토큰에서 컨텍스트 압축을 적용한 수치이며, 압축 없이 1M 컨텍스트로 돌리면 90.4다. "Fable 5 (fallback 포함)"는 Fable 5가 사용 정책상 거절한 요청을 Opus 4.8로 우회 처리한 결과라는 각주가 붙어 있다. 이런 각주까지 공개한 것은 평가 조건을 따져 읽으라는 뜻이기도 하다.
API 사용법: OpenAI SDK 호환, 단 규칙이 있다
Kimi K3는 OpenAI SDK 호환 엔드포인트로 제공된다. 아래는 MarkTechPost(2026-07-16)가 정리한 공식 최소 호출 예시다(출처: https://www.marktechpost.com/2026/07/16/moonshot-ai-releases-kimi-k3-a-2-8-trillion-parameter-open-moe-model-with-kimi-delta-attention-and-1m-context/ ).
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)

completion = client.chat.completions.create(
    model="kimi-k3",
    reasoning_effort="max",
    messages=[{"role": "user", "content": "Introduce Kimi K3 in one sentence."}],
)
print(completion.choices[0].message.content)
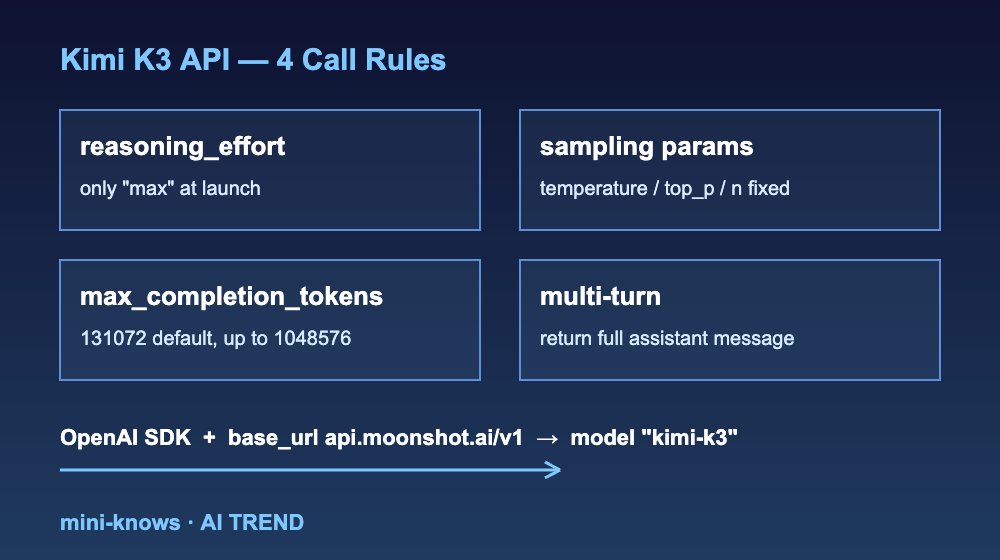
문서에 명시된 호출 규칙 네 가지를 요약하면 다음과 같다.
| 규칙 | 내용 |
|---|---|
| reasoning_effort | 출시 시점에는 max만 지원. K2.x의 thinking 파라미터 사용 금지 |
| 샘플링 파라미터 | temperature, top_p, n은 고정값 — 요청에서 생략 |
| max_completion_tokens | 기본 131072, 최대 1048576 |
| 멀티턴·툴콜 | assistant 메시지를 완전한 형태로 되돌려줄 것(thinking 이력 보존) |
특히 마지막 규칙이 중요하다. K3는 thinking 이력 보존 모드로 학습돼, 하니스가 이력을 온전히 넘기지 않거나 다른 모델로 진행하던 세션을 K3로 갈아타면 생성 품질이 크게 불안정해질 수 있다고 공식 Limitations에 명시돼 있다. 에이전트 프레임워크에 붙일 때 가장 먼저 확인할 지점이다.
요금: 캐시 적중률이 사실상 단가를 결정한다
가격은 100만 토큰당 입력 캐시 히트 $0.30, 캐시 미스 $3.00, 출력 $15.00이며 컨텍스트 길이에 따른 차등은 없다. 입력 단가가 캐시 적중 여부로 10배 갈리기 때문에, 시스템 프롬프트와 대화 이력이 반복되는 에이전트·코딩 워크로드일수록 유리하다. 문샷AI는 자사 API가 코딩 워크로드에서 캐시 적중률 90% 이상이라고 발표했는데(자사 발표), 실제 단가는 각자의 호출 패턴으로 검증해야 한다.
오픈웨이트는 2026년 7월 27일까지 공개 예고 상태다. 다만 MXFP4 포맷과 64장 이상 가속기 권장 사양을 감안하면, 가중치가 풀려도 개인·소규모 팀의 자체 서빙은 현실적으로 어렵고 서드파티 호스팅 API 경쟁이 먼저 벌어질 가능성이 크다. 오픈웨이트 대형 모델의 서빙 전략은 이전 글 GLM-5.2 오픈웨이트 분석과 MiniMax M3의 MSA 구조 분석에서 다룬 맥락과 이어진다.
자주 묻는 질문
Q. Kimi K3 가중치는 언제 어디서 받을 수 있나?
문샷AI는 2026년 7월 27일까지 전체 가중치를 공개하겠다고 발표했다. 배포 채널과 라이선스는 아직 공개 전이므로 확인이 필요하며, 기술 보고서도 함께 나올 예정이다.
Q. 기존 OpenAI 코드에서 바로 갈아탈 수 있나?
base_url과 model만 바꾸면 기본 호출은 동작한다. 다만 temperature·top_p·n이 고정이라 해당 파라미터를 지정하던 코드는 제거해야 하고, K2.x용 thinking 파라미터도 빼야 한다.
Q. vLLM에서 바로 돌릴 수 있나?
KDA 대응 프리픽스 캐싱 구현을 문샷AI가 vLLM에 기여해 모델과 함께 공개한다고 밝혔다. 가중치 공개 시점의 vLLM 지원 상태는 릴리스 노트 확인이 필요하다.
마무리
자사 벤치마크에서조차 최상위 클로즈드 모델에 못 미친다고 인정하면서, 대신 가중치를 열겠다는 접근입니다. 7월 27일 공개와 독립 평가 결과가 나오면 후속으로 다루겠습니다. 읽어주셔서 감사합니다.
출처: 문샷AI 공식 블로그(https://www.kimi.com/blog/kimi-k3, 2026-07-16), MarkTechPost(2026-07-16), Build Fast with AI(2026-07-17)
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다.