안녕하세요, 미니지식공간입니다. LLMD(ZML/LLMD)는 Docker 명령 한 줄로 NVIDIA CUDA·AMD ROCm·구글 TPU·인텔 oneAPI·애플 Metal에서 같은 LLM 추론 서버를 띄우는 신제품입니다. 프랑스 스타트업 ZML이 2026년 7월 8일(현지) 알파 버전을 무료로 공개했는데, vLLM·SGLang과 어디가 겹치고 어디가 다른지 개발자 관점에서 정리했다.
한 줄 요약
vLLM이 사실상 CUDA 중심 생태계에 서 있다면, LLMD는 "서버 하나로 5개 가속기"를 내세운 범용 추론 서버다. 오픈소스는 아니지만 무료이며(2026-07-08 기준, 유료화 시점 미정), LLaMa·Gemma·Qwen·Mistral 계열 모델을 지원한다.
배경: 누가 만들었나
ZML은 파리 기반 20인 팀으로, Zenly(2017년 스냅챗 인수) 엔지니어링 부사장 출신 스티브 모랭(Steeve Morin)이 창업해 2,000만 달러를 조달했다. 얀 르쿤(튜링상 수상자), 허깅페이스 공동창업자 클레망 들랑그·줄리앙 쇼몽, Docker 창업자 솔로몬 하익스가 투자자 명단에 올라 있다(2026-07-08 TechCrunch). 2024년 공개한 오픈소스 ML 프레임워크 ZML(GitHub 스타 3.5K, 2026년 3월 v2)이 기반 기술이고, LLMD는 그 위에 만든 첫 상용 지향 제품이다.
서빙 프리미티브: 스펙 시트
공식 사이트(zml.ai/llmd) 기준 LLMD가 기본 제공하는 기능은 다음과 같다.
| 기능 | 내용 |
|---|---|
| Continuous batching | 동시 요청을 스케줄러 직접 구현 없이 묶음 처리 |
| Paged attention | 긴 컨텍스트 워크로드의 메모리 관리 |
| Tensor parallel sharding | 멀티 디바이스 분산 실행, 통신은 서버가 처리 |
| Prefix caching | 공통 프롬프트 프리픽스 재사용 |
| Tool calling | 서빙 경로 안에서 툴 호출 지원 |
| Prometheus metrics | 내장 /metrics 엔드포인트 |
| DFlash speculative decoding | Gemma 4 계열 네이티브 지원, 지원 모델에서 10배 속도 향상(자사 발표), Qwen 지원 예정 |
투기적 디코딩(speculative decoding)은 작은 드래프트 모델이 토큰 후보를 먼저 내고 본 모델이 검증하는 가속 기법인데, 10배라는 수치는 ZML 자사 발표이므로 독립 벤치마크는 확인 필요다.
플랫폼별 실행: 공식 스니펫
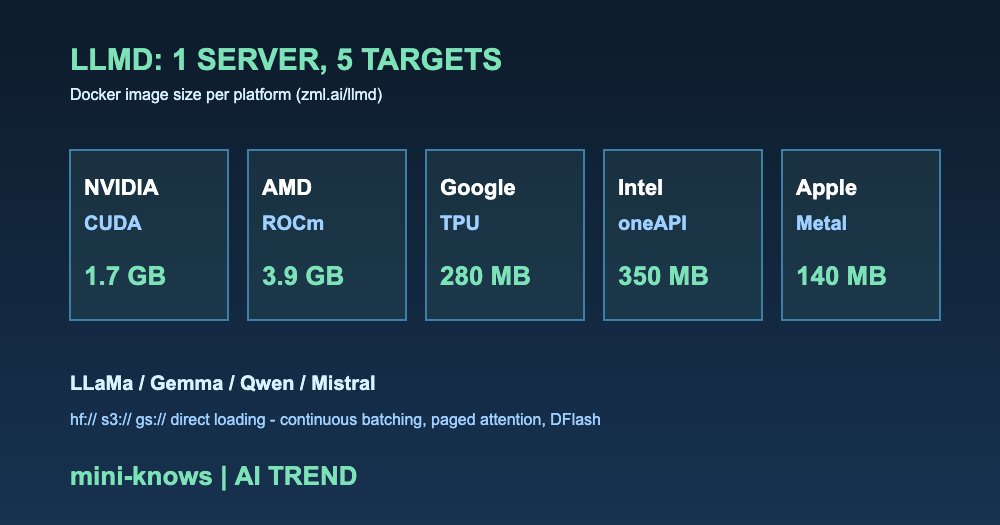
아래 명령은 모두 공식 사이트(https://zml.ai/llmd/)에 게시된 예제 그대로다. 이미지 크기는 CUDA 1.7GB, ROCm 3.9GB, TPU 280MB, oneAPI 350MB, Metal 140MB.
# NVIDIA (CUDA)
docker run -p 8000:8000 --shm-size=256GB --gpus=all -e HF_TOKEN -it zmlai/llmd:cuda \
  --model=hf://Qwen/Qwen3.6-27B

# AMD (ROCm)
docker run -p 8000:8000 --device=/dev/kfd --device=/dev/dri -e HF_TOKEN -it zmlai/llmd:rocm \
  --model=hf://Qwen/Qwen3.6-27B

# Intel (oneAPI)
docker run -p 8000:8000 --device=/dev/dri -e HF_TOKEN -it zmlai/llmd:oneapi \
  --model=hf://Qwen/Qwen3.6-27B

# Google TPU
docker run --net=host --privileged -e HF_TOKEN -it zmlai/llmd:tpu \
  --model=hf://Qwen/Qwen3.6-27B

# Apple Metal (Docker 없이 Homebrew)
brew install zml/zml/llmd
llmd --model=hf://Qwen/Qwen3.6-27B
눈여겨볼 부분은 모델 경로다. hf:// 외에 s3://, gs://를 그대로 받는 VFS(가상 파일시스템) 서브시스템을 써서, 모델을 로컬에 내려받는 별도 단계 없이 Hugging Face·S3·GCS에서 직접 로드한다. 서버는 8000 포트로 뜨고 기존 하네스(클라이언트)를 그쪽으로 향하게 하면 된다는 것이 공식 안내다.
vLLM·SGLang과의 구도
추론 서버 시장은 이미 자본이 몰린 격전지다. vLLM 팀이 세운 Inferact, SGLang을 상업화한 RadixArk, 기업가치 130억 달러의 Baseten이 버티고 있고, TechCrunch도 LLMD가 vLLM·SGLang과 부분적으로 경쟁한다고 짚었다(2026-07-08). LLMD의 차별점은 성능 수치보다 포지셔닝에 있다. CUDA 밖(ROCm·TPU·oneAPI·Metal)까지 단일 서버·단일 UX로 커버하겠다는 것, 그리고 "각 칩의 최대 속도, 경우에 따라 그 이상"이라는 창업자의 주장이다(자사 주장, 검증 전). 이 방향은 추론 비용 절감 흐름과 맞닿아 있는데, 관련 배경은 이전 글 토큰맥싱 시대의 종료와 OpenAI·Broadcom Jalapeño 추론칩에서 다뤘다.
한계와 주의점
알파 단계라는 점을 감안해야 한다. 지원 모델이 LLaMa·Gemma·Qwen·Mistral 계열로 제한되고, DFlash는 현재 Gemma 4 계열만 네이티브다. 소스가 공개되지 않아 내부 동작 검증이나 자체 패치는 불가능하며, 무료 정책이 언제까지 유지될지도 미정이다. 프로덕션에서 vLLM을 걷어내기보다는, 보유한 비 NVIDIA 하드웨어(AMD 서버, 맥 스튜디오 등)에서 오픈 모델 서빙을 검증하는 용도로 시작하는 것이 합리적이다.
자주 묻는 질문
Q. LLMD는 vLLM보다 빠른가?
아직 판단할 근거가 부족하다. "각 칩의 최대 속도"와 "DFlash 10배"는 ZML 자사 발표·주장이며, 독립 벤치마크는 확인 필요다(2026-07-09 기준).
Q. 기존 클라이언트 코드를 수정해야 하나?
서버가 8000 포트로 뜨고 기존 하네스를 그대로 연결하는 구조라, 엔드포인트 주소 변경 수준으로 시작할 수 있다는 것이 공식 안내다. 세부 API 호환 범위는 공식 문서(GitHub zml/zml docs) 확인을 권장한다.
Q. 상용 서비스에 무료로 써도 되나?
현재 무료 배포지만 오픈소스가 아니고 유료화 시점이 미정이므로(2026-07-08 창업자 인터뷰), 장기 운영 전제라면 라이선스 조건 변화를 추적해야 한다.
여기까지 ZML/LLMD 알파를 개발자 관점에서 살펴봤습니다. 독립 벤치마크가 나오면 후속으로 다루겠습니다. 감사합니다.
출처
- TechCrunch (2026-07-08): https://techcrunch.com/2026/07/08/hot-french-startup-zml-releases-free-product-to-speed-inference-across-lots-of-ai-chips/
- ZML/LLMD 공식: https://zml.ai/llmd/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다.