안녕하세요, 미니지식공간입니다. deepseek-flash라는 모델 이름을 그대로 쓰고 있다면 이미 DeepSeek-V4.1-Flash-1017이 응답하고 있고, 같은 시점에 공개된 Search·Fetch API는 토큰이 아니라 요청 건수로 과금됩니다. 호출부는 한 줄도 고칠 필요가 없지만 비용 모델은 달라지므로, 공식 문서 기준으로 엔드포인트와 과금 구조부터 정리한다.
TL;DR
1.deepseek-flash→ DeepSeek-V4.1-Flash-1017. 모델 ID·호출 방식 불변, 토큰 단가도 불변.
2. Search·Fetch가 독립 엔드포인트로 전체 공개. 성공 요청 1,000건당 $0.75, 계정당 5 QPS.
3. Harness·Claude Code·Codex 경유 서버사이드 호출은 2026-11-01 00:00(베이징)부터 요청당 과금 시작.
1. 바뀐 것은 모델 이름이 아니라 그 뒤의 체크포인트다
공식 가격 문서의 모델 표를 그대로 읽으면 이번 변경의 범위가 바로 드러난다.
| API 모델 이름 | 실제 버전 | 비전 입력 | 동시 요청 한도 |
|---|---|---|---|
deepseek-flash | DeepSeek-V4.1-Flash-1017 | 지원 | 2,500 |
deepseek-v4-pro | DeepSeek-V4-Pro-0813 | 미지원 | 500 |
deepseek-v4-flash (퇴역) | 1017이 처리, Flash 단가 과금 | — | — |
deepseek-v4-flash-vision-exp (퇴역) | 1017이 처리, Flash 단가 과금 | — | — |
문서 각주 원문은 레거시 두 이름에 대해 "문자열은 여전히 수용되지만 해당 모델들은 퇴역했고, 그 요청은 DeepSeek-V4.1-Flash-1017 모델이 처리하며 Flash 가격으로 과금된다"고 적었다. 모델 ID를 환경변수로 외부화해두지 않은 서비스라도 깨지지 않는다는 뜻이지만, 반대로 버전 교체를 코드 레벨에서 감지할 수 없다는 뜻이기도 하다. 사후 학습(post-training) 체크포인트가 바뀌면 같은 프롬프트에 대한 출력 분포가 달라질 수 있으므로, 프롬프트 의존도가 높은 파이프라인은 골든 셋 비교를 한 번 돌려두는 편이 낫다.
두 모델 모두 컨텍스트 1M 토큰, 최대 출력 384K 토큰이다. thinking 모드와 non-thinking 모드를 모두 지원하며 기본값은 thinking이다. FIM(Fill-In-the-Middle, 코드 중간을 채우는 보완 방식) 완성은 non-thinking 모드에서만 동작한다.
2. 호출부: 모델 문자열 하나로 끝난다
공식 API 개요 문서에 실린 Chat API 호출 예제는 다음과 같다.
# 출처: https://api-docs.deepseek.com/
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <DeepSeek API Key>" \
  -d '{
    "model": "deepseek-flash",
    "messages": [{"role": "user", "content": "Hello"}],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "high",
    "stream": false
  }'
문서는 이 예제에 대해 deepseek-flash가 "이제 DeepSeek-V4.1-Flash-1017이 서비스하며 호출 방식은 변하지 않았다"고 덧붙였다. 기준 주소는 두 가지로, OpenAI 형식은 https://api.deepseek.com, Anthropic 형식은 https://api.deepseek.com/anthropic이다. 두 모델 모두 JSON 출력, 툴 호출, Responses API, Anthropic API, 채팅 프리픽스 완성을 지원한다.
reasoning_effort 값에는 주의할 점이 있다. 위 공식 예제는 "high"라는 문자열을 쓰는데, 허깅페이스 모델 카드는 추론 노력 설정을 "연속적으로 조절 가능한 정수 1~100"으로 기술하고 최대치를 reasoning_effort=100으로 적는다. 문자열 단계와 정수 범위의 매핑은 어느 문서에도 설명이 없으므로 확인 필요로 둔다. API 경유로는 문서화된 문자열 값을, 자체 호스팅에서는 정수를 쓰는 것이 현재로서는 안전한 선택이다.
3. Search API: 요청 스펙과 응답 필드
Search와 Fetch는 모델 호출 안의 툴이 아니라 별도로 부르는 엔드포인트다. 공식 Search 가이드에 기재된 엔드포인트와 파라미터를 그대로 정리하면 다음과 같다.
# 공식 문서에 기재된 엔드포인트와 파라미터를 그대로 구성한 스니펫
# 출처: https://api-docs.deepseek.com/guides/search
curl -X POST https://api.deepseek.com/v1/tools/search \
  -H "Authorization: Bearer <DeepSeek API Key>" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "site:arxiv.org mixture of experts after:2026-09-01",
    "count": 10,
    "need_content": false
  }'
# Search 요청 파라미터 (공식 문서 기재값 전사)
query string 필수. 1~128 유니코드 문자. 연산자 site: / lang: / after: / before: 지원
count integer 선택. 기본 10, 범위 1~50
ori_question string 선택. 1~128 문자
localization string 선택. IP 주소
need_content boolean 선택. 기본 false
# Search 응답 results[] 필드
rerank_score, title, url, snippet, summary, content,
site_name, site_icon, date, authority
# Fetch 요청 / 응답
url string 필수. 최대 8192 문자, HTTP 또는 HTTPS만
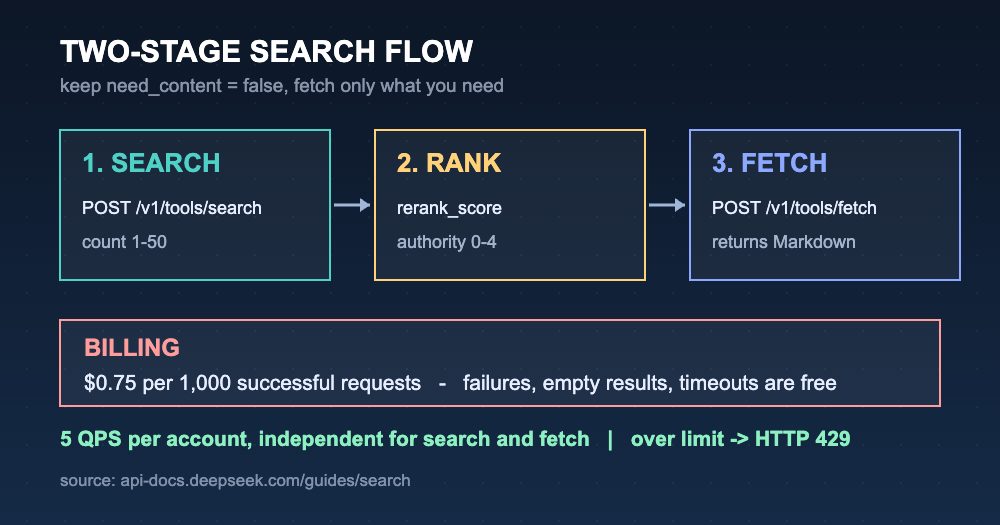
→ 응답: title, content (Markdown)need_content가 기본 false라는 점이 설계상 중요하다. 검색 결과 목록만 받아 재순위(rerank_score)와 신뢰도(authority)로 걸러낸 뒤, 실제로 본문이 필요한 URL만 Fetch로 따로 가져오는 2단 구조가 토큰 소비 측면에서 유리하다. Fetch 응답이 Markdown이므로 LLM 입력으로 바로 넣기도 수월하다.
4. 과금은 토큰이 아니라 성공 요청 건수다
여기가 기존 비용 모델과 가장 크게 어긋나는 지점이다. 공식 문서 기재 사항을 그대로 옮기면 다음과 같다.
# Search / Fetch 과금·제한 (공식 문서 기재값 전사)
단가        성공 요청 1,000건당 $0.75 (Search, Fetch 각각)
미과금      실패한 요청 / 빈 검색 결과 / 타임아웃
레이트 리밋  Search 5 QPS, Fetch 5 QPS. 계정 단위이며 상호 독립
            Fetch는 도메인별 QPS 제한이 추가로 적용
초과 응답    HTTP 429
에러 코드    400, 401, 402, 403, 404, 408, 413, 429, 500, 504
            402 = 잔액 부족
무료 기간    DeepSeek Harness / Claude Code / Codex 경유 서버사이드 툴 호출은
            현재 무료. 요청당 과금은 2026-11-01 00:00 베이징 시간부터 시작
실패·빈 결과·타임아웃이 모두 무과금이라는 조건은 재시도 설계를 단순하게 만든다. 429를 받고 백오프 후 재시도하는 루프가 비용을 증식시키지 않기 때문이다. 다만 5 QPS는 계정 단위이므로, 여러 워커가 같은 키를 공유하는 구조라면 애플리케이션 단에서 전역 레이트 리미터를 두지 않으면 서로 429를 유발한다.
11월 1일 경계는 별도로 계산해둘 필요가 있다. 지금 Claude Code나 Codex에서 DeepSeek의 웹 검색을 쓰는 중이라면 그 호출은 아직 무료지만, 11월 1일 이후에는 건당 과금 대상이 된다. 하루 검색 호출 수에 0.00075달러를 곱하면 증가분이 바로 나온다.
5. 단가표: 네 칸으로 갈린다
토큰 단가 자체는 이번 체크포인트 교체로 바뀌지 않았다. 100만 토큰당 기준이다.
| 항목 | deepseek-flash (오프피크/피크) | deepseek-v4-pro (오프피크/피크) |
|---|---|---|
| 캐시 히트 입력 | $0.003 / $0.006 | $0.022 / $0.044 |
| 캐시 미스 입력 | $0.15 / $0.3 | $0.66 / $1.32 |
| 출력 | $0.6 / $1.2 | $1.98 / $3.96 |
피크 구간 정의 원문은 "Peak hours are 01:00 - 04:00 and 06:00 - 10:00 UTC, Monday through Friday, excluding Chinese public holidays"이고, 오프피크는 피크의 절반이다. UTC+9를 적용하면 KST 월~금 10:00~13:00, 15:00~19:00이 피크다(환산값이며 공식 문서에는 UTC만 기재).
배율로 보면 캐시 히트 대비 미스가 50배, 오프피크 대비 피크가 2배이므로 최악과 최선의 입력 비용은 100배 차이가 난다. Search·Fetch의 건당 과금은 이 축과 무관하게 붙으므로, 검색형 에이전트의 단위 비용은 이제 토큰 × 시간대 × 캐시 와 요청 건수 두 항을 더해야 나온다.
6. 아키텍처: 890바이트 KV 캐시와 비대칭 활성
허깅페이스 모델 카드가 기재한 구조는 이 모델이 왜 이 단가에 1M 컨텍스트를 제공하는지 설명해준다.
- 멀티모달 MoE. 백본 552B 파라미터, 여기에 Engram 조건부 메모리 196B가 별도로 기재된다.
- Causal Encoder-Decoder(CED) 구조. 40층 트랜스포머를 인과 인코더 20층 + 디코더 20층으로 구성.
- 토큰당 활성 파라미터가 비대칭이다. prefill(입력 처리) 단계 8B, decode(출력 생성) 단계 16B.
- MoE 층마다 공유 전문가 1개와 라우팅 전문가 384개, 토큰당 라우팅 전문가 6개 활성.
- 전역 KV 캐시 용량이 토큰당 890바이트로, 모델 카드 표현으로는 DeepSeek-V4-Flash의 "약 1/4"이다.
- 사전학습 45T 토큰. 34T 토큰 시점에 컨텍스트를 1M으로 확장.
KV 캐시(Key-Value cache, 생성 중 이전 토큰의 중간 계산 결과를 들고 있는 메모리) 용량은 긴 컨텍스트 서비스의 원가를 사실상 결정하는 값이다. 토큰당 890바이트면 1M 토큰을 채워도 KV 캐시가 1GB 미만이라는 계산이 나오고, 이것이 1M 컨텍스트를 Flash 단가로 제공할 수 있는 근거가 된다.
한 가지 표기 불일치가 있다. 모델 카드 본문은 백본 552B로 적지만 같은 페이지의 safetensors 메타데이터는 763B로 표시되고, 페이지는 둘의 관계를 설명하지 않는다. 총 파라미터 수를 인용할 때는 기준을 밝히는 편이 안전하며, 공식 해설은 확인 필요다.
7. 자체 호스팅 커맨드
모델 카드에 실린 실행 커맨드는 다음과 같다. 서빙 후에는 OpenAI 호환 엔드포인트로 받는다.
# 출처: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
# vLLM
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash"
# → POST http://localhost:8000/v1/chat/completions (OpenAI 호환)

# SGLang
python3 -m sglang.launch_server \
  --model-path "deepseek-ai/DeepSeek-V4.1-Flash" \
  --port 30000
권장 샘플링 설정도 문서에 명시돼 있다. temperature 1.0, top_p 0.95 또는 1.0, 컨텍스트 윈도 1M 토큰, max_tokens는 256K 이상이다. max_tokens 권장치가 이례적으로 큰 것은 thinking 모드가 기본값이라 추론 토큰을 담을 여유가 필요하기 때문으로 읽힌다.
라이선스는 해당 저장소와 모델 가중치에 대해 MIT로 명시돼 있다. 단 그 저장소는 9월 V4.1-Flash 기준이고, 마크테크포스트는 1017 체크포인트 가중치에 대해 "공개되지 않음"이라고 적었다. 1017을 그대로 자체 호스팅할 수 있는지는 확인 필요다.
8. 벤치마크: 전부 자사 측정치
아래 수치는 모두 DeepSeek가 직접 측정해 발표한 값이고 독립 검증 결과가 아니다. 마크테크포스트 기사도 이 점을 명시한다.
| 벤치마크 | 1017 | 이전 V4.1-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 77.0 | 74.2 | 74.0 | 73.0 |
| Terminal-Bench 4.0 | 42.3 | 31.2 | 51.8 | — |
| NL2Repo-Bench | 68.2 | 64.0 | 75.3 | — |
| ProgramBench | 29.1 | 20.3 | 37.0 | — |
| HLE(도구 없음) | 42.6 | 36.8 | 56.3 | — |
| BabyVision(도구 사용) | 92.5 | 89.6 | 94.1 | — |
스캐폴드가 명시돼 있다는 점은 평가할 만하다. Terminal-Bench 4.0은 Claude Code에서, DeepSWE는 Mini-SWE-V2에서 실행했다. 9월 V4.1-Flash 때 공개된 스캐폴드별 분산을 보면 DeepSWE v1.1 점수가 mini-SWE 74.2, DeepSeek 자체 하네스 72.6, Claude Code 69.8, Codex 65.6으로 8.6점까지 벌어졌다. 같은 모델도 실행 틀에 따라 이만큼 흔들린다는 뜻이므로, 단일 숫자 비교는 신뢰 구간을 넓게 잡아야 한다.
기사 본문과 표가 어긋나는 부분도 있다. 본문은 "DeepSeek가 보고한 11개 벤치마크 전부에서 2.0~11.1점 앞섰다"고 쓰는데 표에는 9개 행만 있다. 개수가 맞지 않으므로 확인 필요로 표기한다.
9. 도입 전 체크리스트
- 모델 ID를 하드코딩했다면 그대로 둬도 동작한다. 단 골든 셋 회귀 테스트를 한 번 돌린다.
reasoning_effort를 쓰고 있다면 API는 문자열, 자체 호스팅은 정수 1~100 기준으로 분리해둔다.- 긴 시스템 프롬프트를 앞쪽에 고정해 캐시 히트를 유도한다. 입력 비용 50배 축이다.
- 지연에 둔감한 배치는 KST 19시 이후나 주말로 옮긴다. 추가 2배 축이다.
- Search·Fetch를 쓰면 하루 호출 수 × $0.00075로 11월 1일 이후 증가분을 미리 산출한다.
- 같은 API 키를 여러 워커가 공유하면 전역 5 QPS 리미터와 429 백오프를 먼저 넣는다.
need_content=false로 목록만 받고 필요한 URL만 Fetch하는 2단 구조로 토큰을 줄인다.
자주 묻는 질문
deepseek-flash를 쓰고 있었는데 모델 버전을 고정할 수 있나?
공식 가격 문서는 deepseek-flash와 deepseek-v4-pro 두 이름만 제시하고, 특정 체크포인트를 고정하는 별칭은 기재하지 않는다. 즉 문서 범위에서는 버전 핀 고정 방법이 확인되지 않는다. 버전 고정이 필요한 워크로드라면 자체 호스팅을 검토하는 편이 현실적이다.
Search API에 레이트 리밋 5 QPS를 올릴 방법이 있나?
공식 문서는 Search와 Fetch 각각 계정당 5 QPS, Fetch에 도메인별 추가 제한을 기재하고 상향 절차는 적지 않았다. 초과 시 HTTP 429가 반환된다. 상향 가능 여부는 확인 필요다.
기존 V4-Flash로 측정해둔 비용 추정을 그대로 써도 되나?
토큰 단가는 동일하므로 토큰 기준 추정치는 유효하다. 다만 1017은 thinking 모드가 기본이고 출력 토큰 권장치가 커서 실제 출력 토큰 수가 늘어날 수 있다. 출력 단가가 입력(캐시 미스)의 4배이므로 출력 토큰 실측치를 다시 재어보는 편이 안전하다.
마무리
deepseek-flash는 이름을 유지한 채 내용물이 교체됐고, 토큰 단가는 그대로지만 요청 건수로 과금되는 축이 새로 생겼습니다. 코드 변경은 없지만 비용 모델은 둘로 늘어났으니, 11월 1일 전에 검색 호출량을 한 번 세어보시길 권합니다. 같은 모델의 피크·오프피크 단가 구조는 DeepSeek API 가격 인상 이후 단가 계산법을 정리한 글에서 더 자세히 다뤘고, 벤더별 과금 축을 비교하려면 Claude Opus 5.5 fast mode의 speed 파라미터 글도 함께 보시면 좋습니다.
출처
- DeepSeek API 공식 가격 문서 — https://api-docs.deepseek.com/quick_start/pricing
- DeepSeek 공식 Search 가이드 — https://api-docs.deepseek.com/guides/search
- DeepSeek API 공식 개요(기준 주소·cURL 예제) — https://api-docs.deepseek.com/
- DeepSeek-V4.1-Flash 모델 카드 — https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- 마크테크포스트 2026-10-17 — https://www.marktechpost.com/2026/10/17/deepseek-just-released-v4-1-flash-1017-scores-77-0-on-deepswe-opens-search-api/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 벤치마크 수치는 전부 DeepSeek 자사 발표·측정값이며 독립 검증 결과가 아닙니다.