안녕하세요, 미니지식공간입니다.
구글이 2026년 7월 21일 Gemini 3.6 Flash와 3.5 Flash-Lite를 공개했다. 이번 Flash 계열 업데이트의 핵심은 새로운 최고 성능이 아니라 토큰 효율과 가격이며, 에이전트 워크로드의 단위 비용 구조가 직접적으로 바뀐다. 아래에서는 벤치마크 수치와 API 관점의 변경점을 개발자 시선으로 정리한다.
세 줄 정리
gemini-3.6-flash: 입력 $1.50 / 출력 $7.50 (1M 토큰당). 3.5 Flash의 출력 $9.00에서 인하.- 구글 발표 기준 출력 토큰 사용량 17% 감소(Artificial Analysis Index). DeepSWE에서는 최대 65% 감소 관측.
gemini-3.5-flash-lite: 입력 $0.30 / 출력 $2.50, 초당 350 출력 토큰. thinking level을 minimal/low/higher로 조절 가능.
라인업 구조
이번 발표는 세 모델을 한 번에 묶었고, 셋 다 Flash 계열이다. Flash 계열은 구글이 최대 추론 깊이가 아니라 속도·비용·대량 처리에 맞춰 조정하는 등급이다. 역할 분담이 이전보다 명확하게 나뉜다.
| 모델 | 입력 (1M) | 출력 (1M) | 포지션 |
|---|---|---|---|
| Gemini 3.6 Flash | $1.50 | $7.50 | 주력 워크호스, 코딩·지식 업무 |
| Gemini 3.5 Flash (이전) | - | $9.00 | 직전 세대 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 고처리량·저지연 |
| Gemini 3.5 Flash Cyber | 미공개 | 미공개 | CodeMender 전용, 제한 파일럿 |
가격은 모두 구글 공식 블로그(2026-07-21) 표기 값이며 미국 달러 기준이다.
벤치마크: 무엇이 얼마나 올랐나
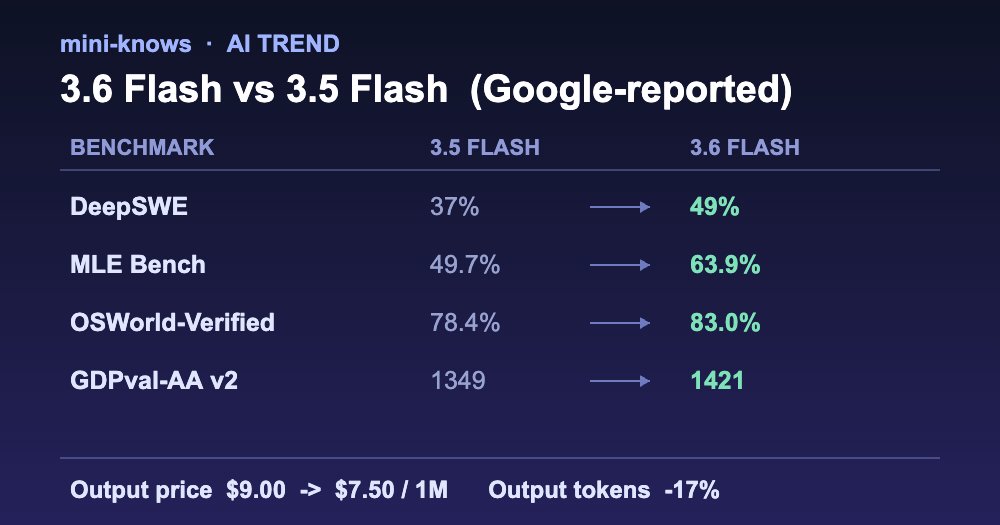
아래 수치는 전부 구글 자사 발표 기준이며 제3자 독립 검증 결과가 아니다. 그 전제 위에서 보면 3.6 Flash의 개선폭은 코딩과 ML 연구 쪽에서 두드러진다.
| 벤치마크 | 3.6 Flash | 3.5 Flash | 측정 대상 |
|---|---|---|---|
| DeepSWE | 49% | 37% | 실전형 코드 수정 |
| MLE Bench | 63.9% | 49.7% | ML 연구 과제 |
| OSWorld-Verified | 83.0% | 78.4% | 컴퓨터 조작(computer use) |
| GDPval-AA v2 | 1421 | 1349 | 지식 업무 |
3.5 Flash-Lite는 이전 3.1 Flash-Lite 대비 Terminal-Bench 2.1에서 54%(31%), GDM-MRCR v2에서 72.2%(60.1%), GDPval-AA v2에서 1140점(642점)을 기록했다. 구글은 이 모델이 구세대 3 Flash도 일부 항목에서 앞선다고 밝혔는데, SWE-Bench Pro 54.2%(49.6%), OSWorld-Verified 74.0%(65.1%)가 그 예다.
비용 구조에서 실제로 달라지는 것
출력 단가만 보면 $9.00에서 $7.50으로 약 16.7% 인하다. 여기에 같은 작업을 출력 토큰 17% 적게 쓴다는 구글 주장이 겹치면, 출력이 지배적인 워크로드의 작업당 비용은 단순 가격 인하폭보다 더 크게 내려갈 여지가 있다. 다만 두 효과는 워크로드 성격에 따라 달라지므로 자체 측정이 전제다.
구글은 추론 단계와 도구 호출 횟수 자체가 줄어든다고 설명했다. 에이전트 루프에서는 호출 1회당 비용뿐 아니라 루프 횟수도 비용에 곱해지므로, 이 부분이 사실이라면 체감폭이 더 커진다. 반대로 말하면 단발성 짧은 응답 위주 서비스에서는 개선이 거의 안 보일 수 있다.
API 관점: 무엇을 바꾸면 되나
모델 ID는 gemini-3.6-flash다. 구글 공식 블로그의 AI Studio 링크 파라미터에서 확인되며, 기존 제미나이 API 경로를 그대로 쓴다. 아래 스니펫은 구글 공식 문서 Text generation의 예제 구조를 그대로 따르고 모델 ID만 3.6 Flash로 지정한 것이다.
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.6-flash",
    input="How does AI work?"
)
print(interaction.output_text)
thinking level을 낮춰 지연과 비용을 줄이는 설정도 같은 문서에 정의돼 있다. 대량 처리 구간에서 Flash-Lite와 조합할 때 유용한 파라미터다.
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.6-flash",
    input="How does AI work?",
    generation_config={
        "thinking_level": "low"
    }
)
print(interaction.output_text)
REST로 직접 호출할 경우 엔드포인트와 헤더는 아래와 같다. 역시 공식 문서 예제의 구조이며 모델 ID만 교체했다.
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-3.6-flash",
    "input": "How does AI work?"
  }'
출처 문서: https://ai.google.dev/gemini-api/docs/text-generation (2026-07-08 최종 수정 표기)
툴 통합에서 눈여겨볼 지점
컴퓨터 사용(computer use)이 제미나이 API와 Gemini Enterprise에서 클라이언트 측 내장 도구로 제공된다. 3.6 Flash와 3.5 Flash-Lite 양쪽에 들어간다. 화면 조작 에이전트를 별도 프레임워크로 감싸던 구성이라면 의존성을 줄일 여지가 생긴다.
배포 채널은 Google AI Studio, Android Studio, Google Antigravity(3.6 Flash), Gemini Enterprise Agent Platform, 제미나이 앱이다. 3.5 Flash-Lite는 구글 검색에 순차 적용 중이다. MarkTechPost는 3.6 Flash가 GitHub Copilot에도 순차 적용된다고 전했다.
3.5 Flash Cyber: 열리지 않은 문
3.5 Flash Cyber는 3.5 Flash 위에 보안 취약점 탐지·검증·패치를 위해 파인튜닝한 모델이다. 설계 전제가 흥미로운데, 단일 거대 모델 1회 호출이 병목이 되므로 저렴한 모델을 여러 번 호출하는 쪽을 택했다. MarkTechPost에 따르면 CodeMender는 이 모델을 최대 5회 호출한 뒤 서브에이전트 결과를 하나의 보고서로 병합한다.
같은 매체는 구글 내부 평가에서 V8 자바스크립트 엔진 대상 고정 호출 횟수 기준 55건의 고유 확인 이슈를 찾았고, 이는 3.5 Flash 47건, Claude Opus 4.6 36건과 비교된다고 전했다. 다만 이 모델은 일반 공개가 아니다. 이중 용도(dual-use) 위험을 이유로 정부와 신뢰 파트너 대상 제한 접근 파일럿으로만 제공된다.
상위 모델 상황
구글은 같은 글에서 Gemini 3.5 Pro가 여전히 파트너와 테스트 중이며 준비되는 대로 공개하겠다고 밝혔다. 3.5 Pro 지연 배경은 이전 글에서 개발자 관점으로 정리한 바 있다. 함께 언급된 것은 Gemini 4로, 가장 야심찬 사전학습(pre-training) 실행을 이미 시작했다고 밝혔다.
지식 컷오프와 관련해 9to5Google은 3.6 Flash에서 2025년 1월에서 2026년 3월로 앞당겨졌다고 보도했다. 구글 공식 블로그 본문에는 명시되지 않아 확인 필요 항목으로 둔다.
반응은 갈렸다. MarkTechPost는 개발자들이 가격과 효율은 환영했으나 지연 중인 상위 모델에 비판이 집중됐다고 전하며 해커뉴스 토론을 인용했다. 벤치마크가 전부 자사 발표라는 점을 감안하면, 실제 판단은 자체 워크로드 측정 이후로 미루는 편이 합리적이다.
자주 묻는 질문
Gemini 3.6 Flash 가격은 얼마인가?
구글 공식 블로그(2026-07-21) 기준 입력 100만 토큰당 $1.50, 출력 100만 토큰당 $7.50이다. 이전 3.5 Flash의 출력 $9.00보다 낮다. 실제 청구액은 캐싱·배치 여부에 따라 달라지므로 공식 가격 문서를 함께 확인하는 편이 좋다.
기존 API 코드를 수정해야 하나?
구글은 기존 제미나이 API를 통해 제공한다고 밝혔으며, 일반적으로는 요청의 model 필드를 gemini-3.6-flash로 바꾸는 수준에서 시작할 수 있다. 다만 사용 중인 SDK 버전과 API 계열(Interactions API 여부)에 따라 차이가 있어 공식 문서 확인이 필요하다.
3.5 Flash Cyber는 일반 개발자도 쓸 수 있나?
쓸 수 없다. 구글은 이중 용도 위험을 이유로 정부와 신뢰 파트너 대상 제한 접근 파일럿으로만, CodeMender를 통해 제공한다고 밝혔다.
마무리
요약하면 성능 도약보다 단위 비용을 손본 릴리스다. 출력 단가와 출력 토큰 사용량을 동시에 건드렸기 때문에, 에이전트처럼 출력이 반복 누적되는 파이프라인에서 효과가 가장 크게 나타날 구조다. 수치가 모두 자사 발표인 만큼 자체 워크로드로 A/B를 돌려보는 과정이 필요하다.
출처
- 구글 공식 블로그, Introducing Gemini 3.6 Flash, 3.5 Flash-Lite, and 3.5 Flash Cyber (2026-07-21): https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-6-flash-3-5-flash-lite-3-5-flash-cyber/
- 9to5Google (2026-07-21): https://9to5google.com/2026/07/21/gemini-3-6-flash-launch/
- MarkTechPost (2026-07-21): https://www.marktechpost.com/2026/07/21/google-releases-gemini-3-6-flash-3-5-flash-lite-and-3-5-flash-cyber-a-cheaper-more-token-efficient-flash-tier-built-for-agentic-workloads/
- Gemini API 공식 문서, Text generation: https://ai.google.dev/gemini-api/docs/text-generation
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다.