gemini-3.8-live-extended-thinking 적용하기 — thinking_level, NON_BLOCKING 툴, interaction_status
AI 트렌드·이슈
안녕하세요, 미니지식공간입니다.
구글이 2026년 9월 15일 gemini-3.8-live와 gemini-3.8-live-extended-thinking 두 모델을 공개했다. Gemini Live API에서 바로 붙일 수 있고, 두 모델 모두 오디오 입력 분당 0.005달러·오디오 출력 분당 0.018달러로 같은 요금표를 쓴다. 이 글은 공식 문서를 기준으로 세션 설정, 툴 선언 방식, 프로토콜 차이를 코드로 정리한다.
1. 이번 릴리스가 건드린 지점
기존 음성 스택은 STT(음성 인식) → LLM → TTS(음성 합성)를 체인으로 묶는 방식이었다. 두 모델은 네이티브 speech-to-speech라 이 체인을 하나로 대체한다. 다만 진짜 변화는 여기가 아니라 도구가 도는 동안의 처리다.
공식 문서(Thinking in the Live API)는 문제를 이렇게 정의한다. 요청이 계획·분석·외부 도구를 요구하면 표준 음성 모델은 두 가지 선택지밖에 없다. 추론 없이 바로 답하거나, 도구가 끝날 때까지 침묵하거나. gemini-3.8-live-extended-thinking은 백그라운드로 추론·도구 호출을 돌리면서 대화용 추임새(conversational filler)를 발화해 세션을 살려 둔다.
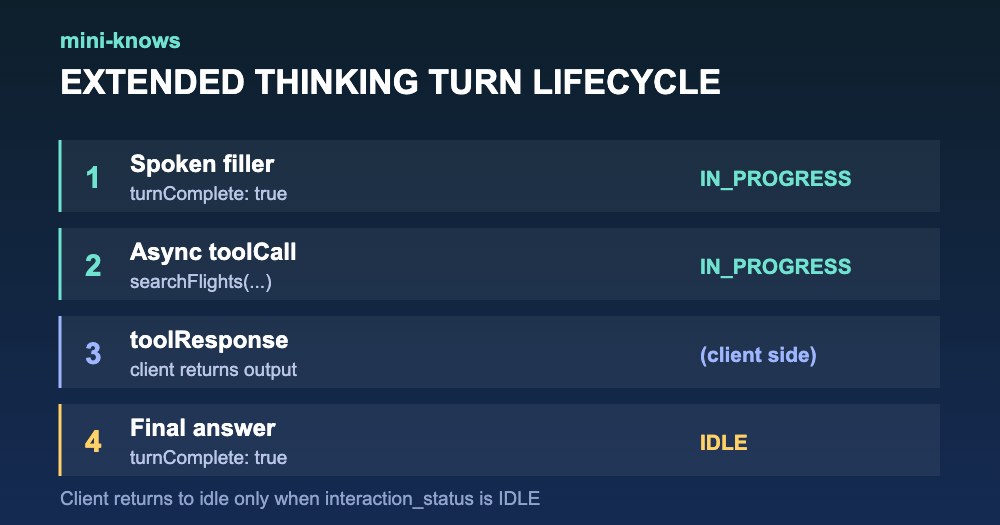
이 구조 때문에 대화 수명주기가 두 군데 바뀐다. 하나는 중간 발화, 다른 하나는 interaction_status 필드다. 모델이 한 요청 안에서 여러 번 말할 수 있으므로 서버가 백그라운드 처리 중에는 IN_PROGRESS, 전체 작업이 끝나면 IDLE을 내보낸다.
2. 어느 모델을 고를 것인가
문서가 제시하는 판단 기준은 응답 지연, 과제 복잡도, 클라이언트 상태 처리 세 가지다.
| 항목 | gemini-3.8-live | gemini-3.8-live-extended-thinking |
|---|---|---|
| 주 용도 | 저지연 음성 에이전트, 직접 명령, 빠른 도구 | 다단계 문제 해결, 복잡한 계획, 다중 도구 워크플로우 |
| 추론 아키텍처 | 고정 지연 프로파일의 인터리브 추론(thinking_level 미지원) | 백그라운드 추론 설정 가능(thinking_level: low, medium, high / MINIMAL 미지원) |
| 턴 경계 | turnComplete: true가 턴을 닫고 idle로 복귀 | turnComplete: true는 발화 하나를 끝낼 뿐, 세션 수명주기는 interaction_status가 제어 |
| 추임새 | 도구 실행이 끝날 때까지 대기 후 발화 | 처리 중 중간 추임새를 스트리밍 |
| 도구 실행 | 동기(BLOCKING)·비동기(NON_BLOCKING) 모두 지원 | 비동기(NON_BLOCKING) 선언 필수 |
도구가 밀리초 안에 끝나면(센서값 읽기, 스마트기기 제어) 전자, 몇 초씩 걸리면(항공권 병렬 조회, 로그 다중 점검) 후자다.
3. 세션 연결 — GenAI SDK
가장 기본 형태다. 출처: Get started with Gemini Live API using the Google GenAI SDK
import asyncio
from google import genai

client = genai.Client(api_key="YOUR_API_KEY")

model = "gemini-3.8-live"
config = {"response_modalities": ["AUDIO"]}

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session started")
        # Send content...

if __name__ == "__main__":
    asyncio.run(main())
오디오는 raw PCM으로 넣는다. 입력은 16-bit PCM 16kHz little-endian, 출력은 24kHz다. 프로토콜은 스테이트풀 WebSocket(WSS)이고 이미지 입력은 JPEG 기준 초당 1프레임 이하로 제한된다.
# Assuming 'chunk' is your raw PCM audio bytes
await session.send_realtime_input(
    audio=types.Blob(
        data=chunk,
        mime_type="audio/pcm;rate=16000"
    )
)
4. Extended Thinking으로 올릴 때 고쳐야 하는 3곳
문서는 통합 지점 세 곳을 명시한다. 출처: Thinking in the Live API
4-1. turnComplete 대신 interaction_status 추적
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
중간 추임새가 나올 수 있으므로 IDLE일 때만 idle 상태로 되돌려야 한다.
4-2. 함수 선언을 NON_BLOCKING으로
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
동기 블로킹 툴을 그대로 두면 에러가 난다고 문서에 적혀 있다.
4-3. 추론 깊이 설정
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)low, medium, high만 유효하고 MINIMAL은 지원되지 않는다.
5. 프로토콜 레벨에서 뭐가 다른가
WebSocket 엔드포인트와 인증은 두 모델이 동일하다. 달라지는 건 setup의 모델 문자열, thinkingConfig 유무, 함수 선언의 behavior다.
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": { "voiceName": "Puck" }
        }
      },
      "thinkingConfig": { "thinkingLevel": "LOW" }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": { "destination": { "type": "STRING" } },
          "required": ["destination"]
        }
      }]
    }]
  }
}
응답 흐름은 네 단계다. ① 중간 추임새를 turnComplete: true + interactionStatus: "IN_PROGRESS"로 내보내고 ② 같은 상태로 툴 콜을 발행하고 ③ 클라이언트가 결과를 돌려주고 ④ 최종 답변을 interactionStatus: "IDLE"로 마무리한다. 2번 단계에서 IN_PROGRESS가 유지된다는 점이 클라이언트 상태 머신 설계의 핵심이다.
6. 요금 계산
공식 가격 페이지 기준이며, gemini-3.1-flash-live-preview까지 같은 표를 공유한다. 분 단위 표기는 구글이 토큰 단가를 환산해 병기한 값이다.
| 구분 | 무료 티어 | 유료 티어(100만 토큰당, USD) |
|---|---|---|
| 입력 — 텍스트 | 무료 | $0.75 |
| 입력 — 오디오 | 무료 | $3.00 또는 $0.005/분 |
| 입력 — 이미지·비디오 | 무료 | $1.00 또는 $0.002/분 |
| 출력 — 텍스트(사고 토큰 포함) | 무료 | $4.50 |
| 출력 — 오디오(사고 토큰 포함) | 무료 | $12.00 또는 $0.018/분 |
| Google 검색 그라운딩 | 지원 | 월 5,000회 무료(Gemini 3.x 공통), 이후 1,000회당 $14 |
주의할 지점은 출력 단가에 사고 토큰이 포함된다는 문구다. thinking_level을 high로 올리면 같은 통화라도 출력 토큰이 늘어나 청구액이 커진다. 무료 티어는 데이터가 제품 개선에 사용되고 유료 티어는 사용되지 않는다는 구분도 같은 표에 있다.
7. 벤치마크 수치를 읽는 법
구글이 인용한 수치는 외부 평가 기관 지표지만, 측정 조건은 구글 발표문 기준이다. Extended Thinking이 Artificial Analysis Speech to Speech Quality Index에서 82.6으로 전체 1위, τ-Voice 68.6%, Sierra τ-Voice-banking 35.1%, Big Bench Audio 97.7%다. gemini-3.8-live는 사람 선호도 평가인 Speech Agent Arena에서 2위다. ServiceNow EVA-Bench 결과에는 Gemini Enterprise Agent Platform의 Live API에서 측정했다는 각주가 붙어 있다. 밀리초 단위 지연 수치는 발표문·문서 어디에도 없다(확인 필요).
언어 지원 수치는 문서 간 차이가 있다. 발표문은 97개 언어를 자동 감지·전환한다고 적었는데, Live API 개요 문서의 일반 기능 설명란은 70개 언어로 되어 있다. 신규 모델 기준인지 API 전체 기준인지 구분되지 않으므로 대상 언어를 직접 확인하는 편이 안전하다.
8. 마이그레이션 체크리스트
gemini-3.1-flash-live-preview→gemini-3.8-live: 모델 문자열만 교체하고thinking_level(또는thinking_config)을 제거한다. 턴 수명주기와turnComplete신호는 동일하다.- →
gemini-3.8-live-extended-thinking: 모든 함수 선언에behavior: "NON_BLOCKING"을 붙인다. - 클라이언트 상태 머신을
turnComplete기반에서interaction_status기반으로 옮긴다. thinking_level을 낮은 값부터 올리며 출력 토큰 증가분을 측정한다.- 생성 오디오에 SynthID 워터마크가 들어간다는 점을 컴플라이언스 문서에 반영한다.
- 실시간 미디어 인프라는 Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel, Vision Agents 연동을 먼저 검토한다.
같은 시기 공개된 다른 진영의 음성 API와 비교하려면 gpt-live-1 API 뜯어보기 글의 요금·세션 구조 부분을 같이 보면 된다.
자주 묻는 질문
Q. gemini-3.8-live에서도 thinking을 켤 수 있나?
아니다. 공식 문서 비교표에 thinking_level 미지원으로 명시돼 있고, 인터리브 추론을 고정 지연 프로파일로 수행한다. 설정 가능한 백그라운드 추론이 필요하면 gemini-3.8-live-extended-thinking을 써야 한다.
Q. 기존 코드에서 API 키를 그대로 써도 되나?
WebSocket 엔드포인트와 API 키 인증 방식은 두 모델이 동일하다. 다만 클라이언트가 직접 Live API에 붙는 구성이라면, 프로덕션에서는 일반 API 키 대신 ephemeral token을 쓰라고 문서가 권고한다.
Q. 두 모델 요금이 다른가?
공식 가격 페이지 기준으로 같은 표를 쓴다. 단가는 같지만 Extended Thinking은 사고 토큰이 출력 요금에 포함되므로 실제 청구액은 더 나올 수 있다.
마무리
코드 관점에서 보면 이번 릴리스의 핵심은 모델 교체가 아니라 클라이언트 상태 머신 교체입니다. turnComplete를 세션 종료 신호로 쓰던 코드가 있다면 그 부분부터 손대시면 됩니다. 읽어주셔서 감사합니다.
출처
- Google, "Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking", 2026-09-15 — https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/
- Google AI for Developers, Thinking in the Live API — https://ai.google.dev/gemini-api/docs/live-api/thinking
- Google AI for Developers, Get started with Gemini Live API using the Google GenAI SDK — https://ai.google.dev/gemini-api/docs/live-api/get-started-sdk
- Google AI for Developers, Gemini API Pricing — https://ai.google.dev/gemini-api/docs/pricing
- MarkTechPost, 2026-09-15 — https://www.marktechpost.com/2026/09/15/google-releases-gemini-3-8-live-and-3-8-live-extended-thinking-for-production-grade-voice-agents/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다.