안녕하세요, 미니지식공간입니다.
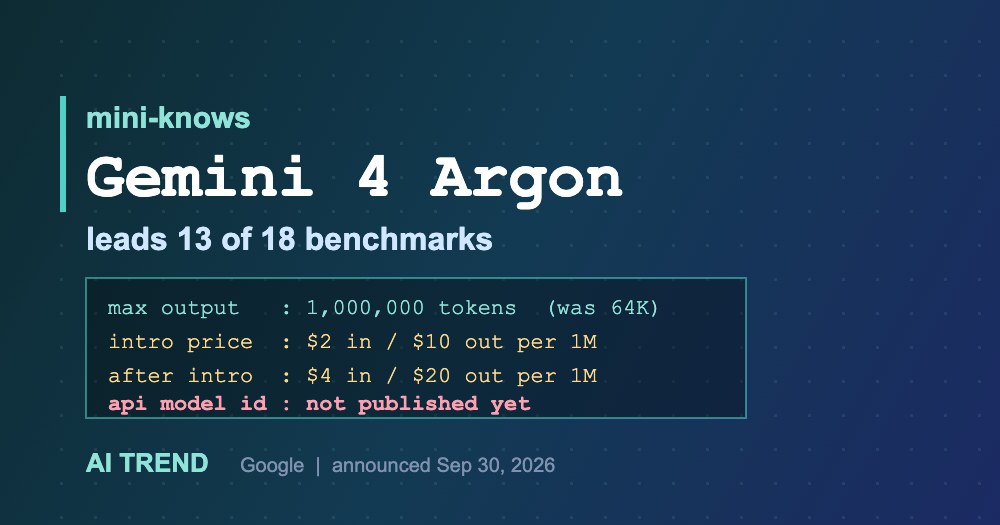
구글이 2026년 9월 30일 Gemini 4 Argon을 공개했다. 벤치마크 18개 중 13개에서 선두를 가져갔다는 발표인데, 정작 API로 호출할 모델 ID는 공식 문서에 아직 올라와 있지 않다. 이 글은 지금 코드에서 무엇을 할 수 있고 무엇을 할 수 없는가를 기준으로 정리한다.
TL;DR
- 출력 토큰 한도가 64K → 1,000,000으로 확대됐다. 공식 블로그 명시 사항이다.
- 도입가 입력 $2 / 출력 $10 (100만 토큰당), 캐시 입력은 입력가의 95% 할인. 도입가 종료 후 $4 / $20.
- Gemini API 공식 모델·가격 문서에 Gemini 4 항목이 없다(2026-10-01 확인). 지금은 전환 작업을 시작할 수 없다.
1. 공식 발표에 적힌 것만
구글 공식 블로그(2026-09-30) 기준으로 확정된 항목은 아래가 전부다.
# 출처: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
#       https://deepmind.google/fairwind-program/
# 아래는 공식 발표문에 기재된 값만 전사한 것이며, 설정 파일이 아니다.

model name           : Gemini 4 Argon
announced            : 2026-09-30
max output tokens    : 1,000,000   (이전 Gemini 계열 64,000)
input context window : 공식 발표문 미기재 (확인 필요)
price (intro)        : input $2 / output $10  per 1M tokens
price (post-intro)   : input $4 / output $20  per 1M tokens
cached input         : input 단가의 95% off -> intro 기준 $0.10 / 1M
intro period end     : 미공개 (확인 필요)
api model id         : 공식 API 문서 미기재 (확인 필요)
access order         : Fairwind Program -> 유료 API 고객 + Google AI Ultra -> 개발자/기업/소비자
입력 컨텍스트 윈도를 100만 토큰으로 적은 기사가 몇 곳 있는데, 공식 문구가 100만이라고 말하는 대상은 출력 한도다. 원문은 출력 토큰 한도를 업계 최고 수준인 100만 토큰으로 기존 64K에서 확대한다는 표현을 쓴다. 입력 쪽 수치는 발표문에 없으므로 확인 필요로 둔다.
2. 단가 구조
| 구분 | 입력 / 1M | 출력 / 1M | 캐시 입력 / 1M |
|---|---|---|---|
| Gemini 4 Argon (도입가) | $2 | $10 | $0.10 (95% off) |
| Gemini 4 Argon (도입가 종료 후) | $4 | $20 | 확인 필요 |
| GPT-6 Astra | $10 | $50 | — |
| Claude Opus 5.5 | $4 | $20 | — |
Argon 단가 출처: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
비교 단가 출처: https://venturebeat.com/technology/google-unveils-gemini-4-argon-retaking-benchmark-lead-over-openai-and-anthropic-but-in-limited-release
여기서 설계상 중요한 지점은 출력 단가와 출력 한도가 같이 커졌다는 것이다. 출력 100만 토큰을 실제로 소진하면 도입가 기준 호출 한 번에 $10, 정가 기준 $20이 청구된다. 출력 한도 확대는 처리량 이득이면서 동시에 단일 호출 비용 상한의 확대이기도 하다. max_output_tokens 류의 상한을 기본값에 맡기지 않고 명시하는 쪽이 안전하다.
도입가 종료 후 캐시 입력 단가는 공식 발표에 없다. 입력가의 95% 할인 규칙이 정가에도 그대로 적용되면 $0.20이 되지만, 그 규칙이 유지된다는 명시가 없어 확인 필요다.
3. 지금 API로 호출할 수 있나
결론부터: 모델 문자열이 없어서 불가능하다. 2026년 10월 1일 기준으로 Gemini API 공식 모델 목록과 가격 문서를 확인했으나 Gemini 4 계열 항목이 없다. 문서에 올라와 있는 최신 계열은 Gemini 3.8 Flash다.
그래서 아래 코드는 현행 공식 문서의 예제를 그대로 옮긴 것이고, 모델 문자열은 문서에 기재된 gemini-3.8-flash를 유지했다. Argon의 모델 ID가 공개되면 이 자리만 바뀌는 구조라서, 호출 형태를 미리 확인해 두는 용도로는 쓸 수 있다.
# 출처: https://ai.google.dev/gemini-api/docs/text-generation
# 공식 문서 예제 원문. model 문자열은 문서 기재값 그대로 둠.
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="How does AI work?"
)
print(interaction.output_text)
// 출처: https://ai.google.dev/gemini-api/docs/text-generation
import { GoogleGenAI } from "@google/genai";
const ai = new GoogleGenAI({});
const interaction = await ai.interactions.create({
model: "gemini-3.8-flash",
input: "How does AI work?",
});
console.log(interaction.output_text);# 출처: https://ai.google.dev/gemini-api/docs/text-generation
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-d "{\"model\": \"gemini-3.8-flash\", \"input\": \"How does AI work?\"}"추론 강도는 공식 문서에서 generation_config 안의 thinking_level로 설명되며, 문서에 기재된 값은 low / medium / high다. Argon에서 이 파라미터 체계가 그대로 유지되는지는 모델 문서가 나오기 전까지 알 수 없다.
4. 벤치마크 18개 중 13개 — 이기는 쪽과 지는 쪽
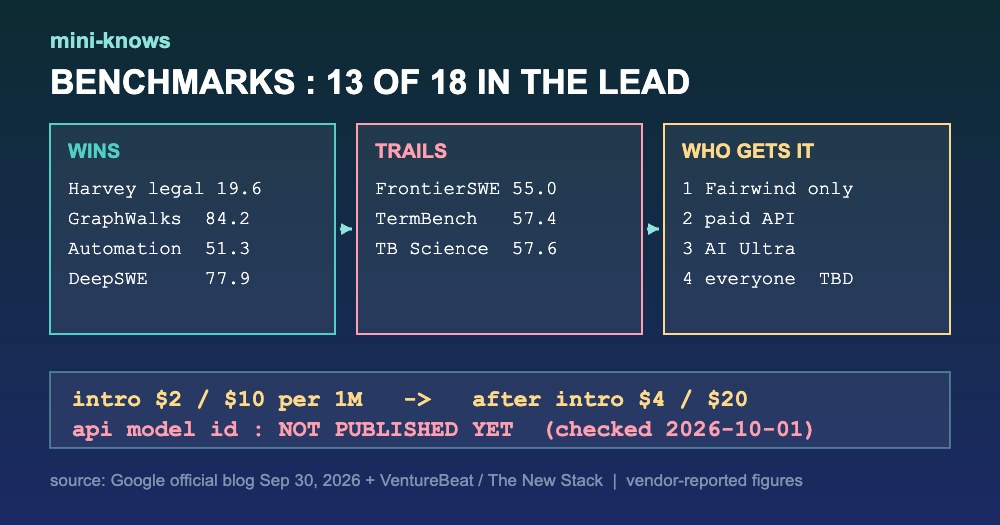
아래 수치는 전부 구글 자사 발표이며 제3자 독립 검증 결과가 아니다. 벤처비트와 더뉴스택이 같은 수치로 정리했다.
| 벤치마크 | Gemini 4 Argon | 비교 모델 | 차이 |
|---|---|---|---|
| Harvey 법무 에이전트 | 19.6% | GPT-6 Astra 5.4% | +14.2%p |
| GraphWalks (256K~1M) | 84.2% | GPT-6 Astra 71.8% | +12.4%p |
| AutomationBench | 51.3% | Claude Opus 5.5 42.5% | +8.8%p |
| Vals Finance Agent v2 | 65.4% | Claude Opus 5.5 58.6% | +6.8%p |
| LVBench | 91.7% | GPT-6 Astra 87.5% | +4.2%p |
| DeepSWE v1.1 | 77.9% | Claude Opus 5.5 74.2% | +3.7%p |
| CWE-bench v1 | 68% | GPT-6 Astra 68% | 공동 1위 |
| FrontierSWE v2 | 55.0% | GPT-6 Astra 65.5% | -10.5%p |
| Terminal-Bench Science 0.1 | 57.6% | GPT-6 Astra 68.1% | -10.5%p |
| Terminal-Bench 4.0 | 57.4% | Claude Opus 5.5 66.4% | -9.0%p |
패턴이 읽힌다. 롱 컨텍스트 탐색, 기업 지식 업무(법무·재무), 업무 자동화, 영상 이해에서는 두 자릿수 격차까지 벌리는데, 터미널·셸을 직접 다루는 에이전트형 코딩 벤치마크에서는 오히려 뒤처진다. DeepSWE v1.1만 보고 코딩 전반에서 1위라고 읽으면 과대 해석이다.
간접 프롬프트 인젝션 내성은 Gray Swan 지표에서 공격 성공률 0.7%로 보고됐다. Claude Opus 5.5 1.0%, GPT-6 Astra 8.5%와 비교된다. 단 이 구체 수치는 벤처비트 단일 출처에서만 확인됐다. Vals Finance Agent v2 수치도 같다.
5. 출력 100만 토큰이 바꾸는 설계 지점
출력 한도가 64K일 때는 긴 산출물을 만드는 작업이 거의 전부 분할 호출이었다. 문서 전체 번역, 대규모 리팩터링 패치, 코드베이스 단위 테스트 생성 같은 일은 청크를 나누고 각 청크의 결과를 이어 붙이는 오케스트레이션 코드를 따로 두게 된다. 이 코드가 전체 파이프라인에서 버그가 가장 자주 나는 부분이기도 하다.
출력 한도가 100만이면 그 오케스트레이션을 걷어낼 여지가 생긴다. 대신 세 가지가 새로 문제가 된다. 첫째, 단일 호출의 타임아웃과 스트리밍 처리. 둘째, 실패 시 재시도 비용 — 90만 토큰을 뽑다가 끊기면 그 전부가 매몰 비용이다. 셋째, 출력 상한 미설정 상태의 비용 폭발. 긴 출력이 가능해지는 것과 긴 출력을 안전하게 운영하는 것은 별개 문제다.
구글은 사내 적용 사례로 양자 최적화 과제에서 공개 기준선 대비 40% 개선, 데이터센터 메모리 300TiB 이상 확보(총 500TiB~1PiB 절감), libgav1 디코더 재작성으로 기존 러스트 이식본 대비 2.7배 속도를 제시했다. 모두 자사 발표다.
6. 도입 전 점검 5가지
- 모델 ID 공개 여부. 공식 모델 문서와 가격 문서에 Gemini 4 항목이 올라왔는지 확인한다. 2026-10-01 기준으로는 없다.
- 도입가 종료 조건. $2/$10이 언제까지인지 공개되지 않았다. 정가 $4/$20 기준으로 비용을 추산해 두는 쪽이 안전하다.
- 출력 상한 명시. 출력 한도 100만은 단일 호출 비용 상한이 $10~$20까지 열린다는 뜻이다. 상한을 코드에서 걸어 둔다.
- 코딩 과제 유형 구분. 터미널·셸 에이전트 워크로드는 발표 수치상 Argon이 뒤처진다. 벤치마크 평균이 아니라 자사 과제 유형으로 재측정한다.
- 접근 경로. 사이버 방어 목적이면 Fairwind Program 신청 요건을 먼저 확인한다. 그 외에는 유료 API 고객·Google AI Ultra 순서를 기다리는 것 외에 경로가 없다.
자주 묻는 질문
Q. gemini-4-argon 같은 모델 ID로 지금 호출되나?
아니다. 2026년 10월 1일 기준 Gemini API 공식 모델 목록과 가격 문서에 Gemini 4 계열 항목이 없다. 공식 문서에 모델 문자열이 올라오기 전에는 호출 경로가 없다.
Q. 기존 Gemini API 코드를 수정해야 하나?
지금 시점에는 수정할 것이 없다. 현행 문서의 호출 형태는 client.interactions.create(model=..., input=...)이며, Argon이 추가되더라도 모델 문자열 교체로 시작하는 것이 자연스럽다. 다만 파라미터 체계 변경 여부는 모델 문서 공개 전까지 알 수 없다.
Q. 도입가 $2/$10이면 Claude Opus 5.5보다 싼가?
도입가 기준으로는 입력·출력 모두 절반이다. 다만 도입가가 끝나면 $4/$20으로 Opus 5.5와 같아진다. 도입 기간 길이가 공개되지 않았으므로 장기 비용 비교의 근거로는 약하다.
마무리
Gemini 4 Argon은 발표 내용과 사용 가능 시점 사이의 간격이 유독 큰 공개다. 출력 100만 토큰과 도입가 $2/$10은 확정 사실이지만, 모델 ID가 없고 접근 순서가 사이버 방어 파트너부터라 지금은 코드에 손댈 단계가 아니다. 같은 $2/$10 구간을 도입가 없이 표시 단가로 쓰는 쪽과의 비교는 gpt-6.1-sol 도입 점검 글에 정리해 두었다.
출처
- Google 공식 블로그, Gemini 4 Argon (2026-09-30) — https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
- Google DeepMind, Fairwind Program — https://deepmind.google/fairwind-program/
- Gemini API 공식 모델 문서 — https://ai.google.dev/gemini-api/docs/models
- Gemini API 공식 가격 문서 — https://ai.google.dev/gemini-api/docs/pricing
- Gemini API Text generation 문서 (코드 예제 원본) — https://ai.google.dev/gemini-api/docs/text-generation
- VentureBeat (2026-09-30) — https://venturebeat.com/technology/google-unveils-gemini-4-argon-retaking-benchmark-lead-over-openai-and-anthropic-but-in-limited-release
- The New Stack (2026-09-30) — https://thenewstack.io/google-gemini-4-argon/
- 지디넷코리아 (2026-10-01) — https://zdnet.co.kr/view/?no=20261001090835
본 글의 성능·비용 비교 수치는 모두 구글 자사 발표이며 제3자 독립 검증 결과가 아닙니다. 본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다.