안녕하세요, 미니지식공간입니다.
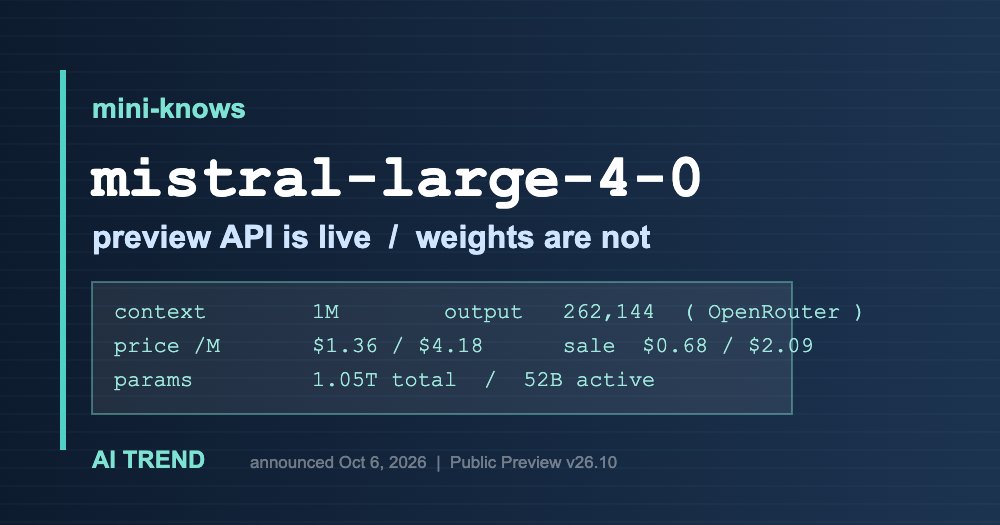
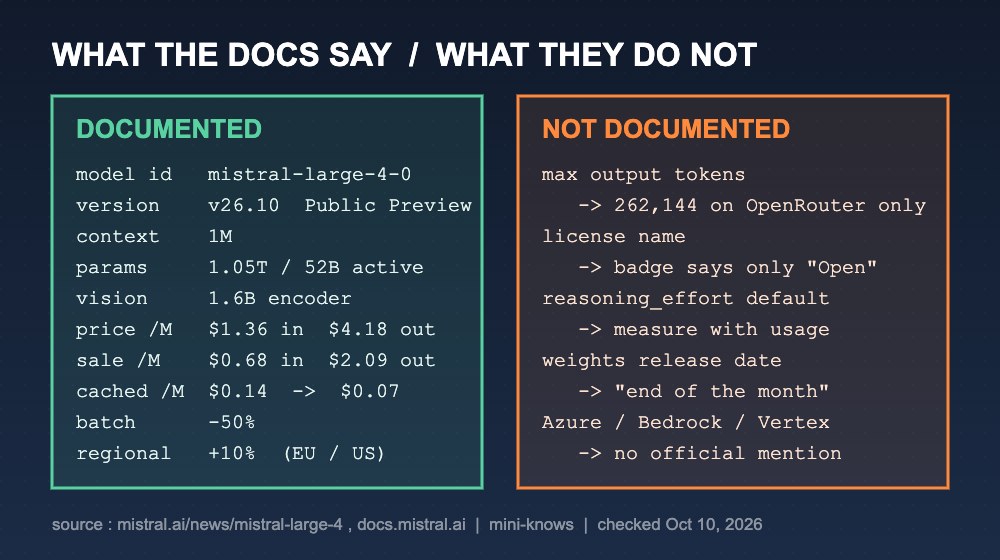
Mistral Large 4 API를 붙이기 전에 공식 문서에서 확인되는 것과 확인되지 않는 것을 갈라 정리했다. 모델 ID는 mistral-large-4-0이고, 1M 컨텍스트와 50% 할인 단가는 문서에 있지만 최대 출력 토큰과 라이선스 이름은 문서에 없다.
TL;DR
1.mistral-large-4-0(v26.10)은 2026년 10월 6일 공개된 퍼블릭 프리뷰다. 총 1.05조 / 활성 520억 파라미터 MoE에 16억 파라미터 비전 인코더가 붙는다.
2. 단가는 정가 $1.36 / $4.18, 공식 가격 문서에 50% 할인가 $0.68 / $2.09가 함께 걸려 있다. 캐시 입력은 $0.14 → $0.07.
3. 가중치는 아직 없다. 공식 표현은 "이달 말 공개"이고 라이선스 이름은 미지정이다. 자체 호스팅 전제 설계는 지금 못 한다.
1. 모델 표면부터
공식 모델 카드에서 확인되는 값만 추렸다.
| 항목 | 값 |
|---|---|
| 모델 ID | mistral-large-4-0 |
| 버전 | v26.10 |
| 상태 | Public Preview / Open |
| 공개일 | 2026-10-06 |
| 구조 | granular MoE(세분화된 전문가 혼합) |
| 파라미터 | 총 1.05T / 활성 52B |
| 비전 인코더 | 1.6B |
| 컨텍스트 | 1M |
| 입력 모달리티 | 텍스트 + 이미지 |
| 출력 모달리티 | 텍스트 |
| 엔드포인트 | /v1/chat/completions, /v1/batch, /v1/agents, /v1/conversations |
| 기능 | Structured Outputs, Function Calling, Document QnA, Prefix, Built-In Tools |
카드에는 모델 ID 칩이 mistral-large-4 하나에 접힌 +1 표시가 붙어 있다. 두 번째 식별자(별칭으로 보이는 값)는 서버가 내려주는 HTML에 들어 있지 않아 문자열을 확인하지 못했다. mistral-large-latest 같은 값을 임의로 가정하지 말고 GET /v1/models로 직접 확인하는 편이 안전하다 — 공식 라이프사이클 문서도 "별칭을 쓰면 모델 동작과 가격이 조용히 바뀌는 상황에 노출될 수 있다"고 경고한다.
프리뷰 단계라는 점이 운영 설계에 직접 영향을 준다. 라이프사이클 문서 기준으로 퍼블릭 프리뷰는 정식 출시와 같은 가격을 받으면서 사전 공지 없는 갱신이 허용되고, "정식 출시(GA)로 가는 경로가 보장되지 않는다". 폐기 공지 기간도 프리뷰는 1개월(정식은 6개월)이고, 폐기 이후 해당 식별자는 404를 반환한다.
2. 단가 구조와 깎을 수 있는 지점
공식 가격 문서의 플래그십 표에서 Large 4 행은 "Sale price"로 표시돼 정가에 취소선이 그어진 상태다. OpenRouter의 Mistral 엔드포인트에서도 같은 숫자가 "50% off" 배지와 함께 확인된다.
| 구분 | 입력 /M | 캐시 입력 /M | 출력 /M |
|---|---|---|---|
| Large 4 정가 | $1.36 | $0.14 | $4.18 |
| Large 4 할인가 | $0.68 | $0.07 | $2.09 |
| Large 3 | $0.50 | $0.05 | $1.50 |
| Medium 3.5 | $1.50 | $0.15 | $7.50 |
| Small 4 | $0.15 | $0.015 | $0.60 |
여기서 계산해 둘 숫자가 하나 있다. 세대 교체인데 단가가 올라간다. 정가 기준 Large 3 대비 입력 2.72배, 출력 2.79배이고, 할인가 기준으로도 입력 1.36배, 출력 1.39배다. Large 3는 폐기 목록에 없고 Apache 2.0으로 현역 유지 중이니, 전환은 "긴 컨텍스트나 이미지 입력이 실제로 필요한 경로"에만 선택적으로 적용하는 게 비용 면에서 맞다.
반대로 깎는 장치는 문서에 세 가지가 적혀 있다.
- 배치: "가격을 50% 낮춘다". 실시간성이 필요 없는 대량 처리는
/v1/batch로 보내는 쪽이 유리하다. - 프롬프트 캐싱: 입력 비용을 "최대 90%까지" 낮춘다. API 레퍼런스에는
prompt_cache_key필드가 있고, 캐시된 토큰은 표준 입력가의 10%로 과금된다고 적혀 있다. - 리전 엔드포인트는 반대 방향:
api.eu.mistral.ai/api.us.mistral.ai같은 리전 전용 엔드포인트는 표준 정가의 1.1배(10% 가산)로 과금되고, Agents·Batch·Files를 지원하지 않으며 도구 중에서는 함수 호출만 쓸 수 있다. EU 내 처리 요건이 있으면 기능 제약과 가산 요금을 같이 계산해야 한다.
리전별로 어느 모델이 올라가 있는지는 문서에 표로 정리돼 있지 않다. 리전별 models.list를 직접 호출해 확인하라고 안내한다.
3. 공식 문서 기준 최소 호출
아래 두 스니펫은 Mistral 공식 문서에 실린 예제를 그대로 가져온 것이고, 모델 문자열만 mistral-large-4-0으로 교체했다. 문서에 없는 조합은 쓰지 않았다.
cURL (출처: https://docs.mistral.ai/api/ — Chat Completion, cURL 탭)
curl https://api.mistral.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -d '{
    "model": "mistral-large-4-0",
    "messages": [
      {
        "role": "user",
        "content": "Who is the best French painter? Answer in one short sentence."
      }
    ]
  }'
문서의 cURL 예제는 -X POST를 명시하지 않는다. -d 본문이 있으면 POST로 전송되기 때문이다.
Python SDK (출처: https://docs.mistral.ai/getting-started/quickstarts/developer/first-api-request)
import os
from mistralai.client import Mistral

client = Mistral(api_key=os.environ["MISTRAL_API_KEY"])

response = client.chat.complete(
    model="mistral-large-4-0",
    messages=[
        {"role": "user", "content": "What is Mistral AI?"}
    ],
)

print(response.choices[0].message.content)
패키지는 pip install mistralai, 클라이언트 클래스는 Mistral, 호출은 client.chat.complete(...)다. 한 가지 짚어 둘 점은 import 경로다. 공식 퀵스타트·기능 문서·API 레퍼런스 세 곳 모두 from mistralai.client import Mistral로 적고 있는데, 이 SDK 형태에서는 흔치 않은 경로다. 문서 표기를 그대로 옮긴 것이므로, 실제 설치한 패키지 버전에서 import가 통하는지는 한 번 확인하고 쓰는 게 좋다.
TypeScript 쪽은 패키지 @mistralai/mistralai, new Mistral({ apiKey }), client.chat.complete({...}) 형태로 문서에 실려 있다.
4. 요청 파라미터, 문서에 적힌 그대로
Chat Completion 요청 본문에서 기본값이나 허용값이 명시된 항목만 정리했다. 전체 목록은 API 레퍼런스에 있다.
| 필드 | 타입 | 문서 기재 기본값 / 허용값 |
|---|---|---|
model | string | 필수 |
messages | array | 필수. role은 system / user / assistant / tool |
temperature | number | null | 고정 기본값 없음. "대상 모델에 따라 다르다"며 /models 호출로 확인하라고 안내. 권장 범위 0.0~0.7 |
top_p | number | null | temperature와 둘 중 하나만 조정하라고 안내 |
max_tokens | integer | null | 기본값 미기재. 프롬프트 + max_tokens가 컨텍스트 길이를 넘을 수 없음 |
stream | boolean | false. 스트림 종료는 data: [DONE] |
response_format | object | null | 기본 {"type": "text"}. json_object, json_schema 지원 |
tool_choice | string | object | none / auto / any / required, 또는 함수 지정 |
parallel_tool_calls | boolean | true |
safe_prompt | boolean | false. 대화 앞에 안전 프롬프트 주입 |
prompt_cache_key | string | null | 캐시 키. 캐시된 토큰은 표준 입력가의 10% |
prompt_mode | string | 문서에 "reasoning" 한 값만 기재 |
reasoning_effort | string | none / minimal / low / medium / high / xhigh. 기본값 미기재 |
service_tier | string | auto / standard_only |
random_seed | integer | null | 결정적 샘플링용 시드 |
reasoning_effort에 Large 4의 기본값이 무엇인지는 문서에 없다. 블로그는 Large 4를 "하이브리드 instruct + reasoning MoE"로 소개했으니 추론 단계가 출력 토큰 과금에 포함될 가능성이 있는데, 기본 노력 수준이 명시되지 않은 상태라 비용 추정은 usage 실측으로 잡는 게 맞다. 이 항목도 확인 필요다.
메시지 레벨 필드로 prefix(마지막 assistant 메시지에 "prefix": True를 주면 그 내용이 응답 앞에 붙는다)가 기능 문서에 있고, Large 4 모델 카드의 기능 목록에도 Prefix가 포함돼 있다.
5. 공식 문서가 비워 둔 칸 두 개
최대 출력 토큰. Mistral 모델 카드는 컨텍스트를 "1M"으로만 적고 최대 출력은 어디에도 쓰지 않았다. 숫자가 있는 곳은 OpenRouter뿐으로, 컨텍스트 1,048,576 토큰 / 최대 출력 262,144 토큰(약 256K)이라고 기재한다. 1차 출처가 아니므로 긴 출력이 필요한 작업이라면 실측으로 상한을 잡아야 한다. MarkTechPost의 자동 생성 사이드바에는 같은 모델에 "524K ctx"라는 값도 섞여 있어서, 2차 출처끼리도 일치하지 않는다.
라이선스 이름. 모델 목록 페이지의 라이선스 배지가 Large 4만 "Open"이다. 같은 목록에서 Mistral Large 3는 "Apache 2.0", Small 4는 "Apache 2.0", Medium 3.5는 "Modified MIT", Voxtral TTS는 "CC BY-NC 4.0"처럼 이름이 박혀 있다. 즉 Mistral이 Large 4의 라이선스를 아직 지정하지 않았다. 모델 카드에 WEIGHTS 탭이 있지만 내용이 서버 HTML에 없어서 확인할 수 없었다. 상업적 사용 조건을 법무 검토해야 하는 조직은 이 탭이 채워진 뒤에 판단하는 게 맞다.
레거시 가중치 문서(docs.mistral.ai/getting-started/models/weights/)는 아직 2507 세대까지만 반영돼 있어 Large 4 행이 없다. 여기를 기준으로 삼으면 안 된다. mistral.ai/pricing 쪽 FAQ도 "Mistral Large는 입력 $0.5 / 출력 $1.5"라고 적혀 있는데 이건 Large 3 단가다. 단가 확인은 docs.mistral.ai/inference/pricing을 봐야 한다.
6. 가중치는 왜 아직 없나
공식 블로그의 문장은 "이달 말까지 가중치를 공개하겠다"다. 10월 6일에 쓴 글이므로 2026년 10월 말을 뜻한다. 그때까지는 사이버보안 업계 관계자, 검증된 파트너, 국가 기관과 함께 실제 환경에서 레드팀을 돌리고 있으며, 이들에게는 모더레이션을 완화하고 사이버 기능을 확장한 버전을 제공한다고 밝혔다. 가중치가 공개되면 사설 클라우드와 온프레미스 구동이 가능해진다는 설명도 붙었다.
일부 매체는 공개일을 10월 27일로 특정해 보도했지만 Mistral 공식 자료에는 그 날짜가 없다. 단일 출처이므로 확인 필요로 둔다.
규모도 자체 구동 계획에 영향을 준다. 활성 파라미터가 520억이라도 추론을 위해 총 1.05조 파라미터를 메모리에 올려야 하는 구조다. 데스크톱·노트북 급에서는 선택지가 아니다.
7. 벤치마크를 읽을 때 걸리는 두 지점
블로그가 제시한 수치는 전부 Mistral 자사 발표다. 숫자로 본문에 적힌 것만 옮기면 다음과 같다.
| 항목 | Mistral 발표 |
|---|---|
| Cybench (40개 과제) | 93% |
| 취약점 재현·패치 테스트 | 82% |
| DeepSWE v1.1 | 61.7% |
| SWE-Atlas-QnA | 59.4% |
| Terminal-Bench 4 | 28.3% |
| 코딩 에이전트 종합 지수 | 49.8% |
| AutomationBench (워크플로 657종) | 59.9% |
| AA-Briefcase | 1,393 Elo |
| Dense 200 | 42% (GPT-6 Astra 41%) |
| Surge AI 블라인드 인간 평가 | 3.74 / 5 (5개 중 2위, Claude Opus 5는 4.22) |
| Lakera B3 | 공격 93.3% 방어 |
| KORA | 1.691 (최대 2) |
첫째, 82%의 성격. Mistral은 같은 테스트에서 "Claude Opus 5.5와 GPT-6 Astra가 작업 수행을 거부해 0점에 가깝다"고 썼다. 이건 능력 차이가 아니라 안전 정책 차이에서 나온 격차다. 사이버 공격성 작업을 수행하도록 설계된 모델과 거부하도록 설계된 모델을 같은 축에서 비교한 숫자이므로, 82%를 보안 성능 우위로 바로 환산하면 안 된다. 공격성 기능이 확장된 버전이 별도로 배포되고 있다는 블로그 서술과 묶어 읽어야 맥락이 맞는다.
둘째, 61.7%의 위치. 2026년 10월 6일 implicator.ai는 DeepSWE 공개 리더보드의 최적 구성 기준으로 GLM-5.3과 Kimi K3가 약 69%, 비공개 모델들이 약 74%라고 적으며 Large 4의 61.7%가 그보다 낮다고 지적했다. 같은 기사는 Large 4가 해당 리더보드와 Artificial Analysis 사이버 지수의 공개 평가 목록에 아직 등재되지 않았다는 점, 그리고 Harvey 법률 벤치마크에서 Mistral 차트는 15%인데 공개 보드의 Kimi K3는 12.92%라는 수치도 함께 제시했다. 측정 조건이 동일한지 확인되지 않았으므로 두 숫자를 직접 비교하기는 어렵다. MarkTechPost는 Mistral이 "평가 하네스가 공개되기 전에 비공개로 측정했다"고 전해, 재현 자체가 지금은 불가능하다는 점도 지적했다.
파라미터 수치도 2차 출처와 엇갈린다. 활성 파라미터를 Mistral 공식 블로그·모델 카드는 520억으로 적지만 MarkTechPost와 implicator.ai는 둘 다 490억으로 보도했다. 이 글은 1차 출처인 공식 문서 표기를 따랐고, 불일치가 있다는 사실을 남겨 둔다.
8. 지금 할 수 있는 것 / 미뤄야 할 것
지금 할 수 있는 것
mistral-large-4-0으로 프리뷰 API 평가. Mistral Studio(console.mistral.ai) 플레이그라운드와/v1/chat/completions모두 사용 가능.prompt_cache_key를 붙여 캐시 적중률과 실제 단가 측정. 캐시 입력가($0.07~$0.14) 전제로 반복 호출 비용 산출./v1/batch로 비실시간 경로 분리. 문서 기준 50% 절감.usage응답으로 추론 토큰 포함 여부와 실제 출력 상한 실측(reasoning_effort기본값·최대 출력이 문서에 없으므로).- 식별자는
mistral-large-4-0처럼 버전 고정형으로 핀. 별칭 사용 시 조용한 갱신 위험.
미뤄야 할 것
- 자체 호스팅·온프레미스 설계 — 가중치 미공개.
- 상업 사용 조건 확정 — 라이선스 이름 미지정.
- Large 3 → Large 4 일괄 전환 — 단가가 오르고 Large 3는 폐기 예정도 아니다.
- 타사 클라우드(Azure / Bedrock / Vertex) 전제 아키텍처 — 공식 언급 없음, 확인 필요.
자주 묻는 질문
Q. Mistral Large 4는 지금 다운로드해서 쓸 수 있나?
아직 아니다. 2026년 10월 10일 기준 가중치가 공개되지 않았다. 공식 블로그는 10월 6일 글에서 "이달 말까지 공개"라고만 밝혔고, Hugging Face에도 Large 4 체크포인트가 올라오지 않은 상태다. 지금 쓸 수 있는 건 프리뷰 API뿐이다.
Q. 기존 Mistral API 코드를 수정해야 하나?
엔드포인트와 요청 스키마는 그대로다. /v1/chat/completions에서 model 문자열만 mistral-large-4-0으로 바꾸면 호출은 된다. 다만 최대 출력 토큰이 공식 문서에 없고 reasoning_effort 기본값도 명시되지 않아, 출력 길이와 과금을 usage로 실측한 뒤 운영에 올리는 게 안전하다.
Q. Large 3보다 비싼데 왜 쓰나?
갈리는 지점은 두 가지다. 컨텍스트 1M과 이미지 입력이다. Large 3로 처리하려면 문서를 쪼개야 하는 작업이거나 이미지가 입력에 섞이는 작업이라면 Large 4 쪽이 설계가 단순해진다. 그 조건이 아니라면 입력 2.7배(정가 기준)를 정당화하기 어렵다.
마무리
요약하면 mistral-large-4-0은 "API로는 지금 평가 가능, 자체 호스팅은 10월 말 이후" 상태다. 문서에 있는 숫자(단가·1M 컨텍스트·기능 목록)와 문서에 없는 숫자(최대 출력·라이선스·추론 기본값)를 구분해 두면 도입 판단이 훨씬 빨라진다. 오픈웨이트 모델을 API부터 먼저 공개하고 가중치를 뒤에 붙이는 패턴은 이번이 처음이 아니어서, 지난주 다룬 Beam-501B-A23B API 뜯어보기와 비교해 보면 체크 항목이 거의 겹친다. 읽어주셔서 감사합니다.
출처
- Mistral AI 공식 블로그, Introducing Mistral Large 4 (2026-10-06) — https://mistral.ai/news/mistral-large-4
- 공식 모델 카드
mistral-large-4-0— https://docs.mistral.ai/models/mistral-large-4-0 - 공식 가격 문서 — https://docs.mistral.ai/inference/pricing
- 공식 API 레퍼런스 (Chat Completion 요청 필드·cURL 예제) — https://docs.mistral.ai/api/
- 공식 퀵스타트 (Python 예제) — https://docs.mistral.ai/getting-started/quickstarts/developer/first-api-request
- 공식 모델 라이프사이클 / 리전 추론 문서 — https://docs.mistral.ai/inference/model-lifecycle , https://docs.mistral.ai/inference/regional-inference
- OpenRouter 모델 페이지 (단가·컨텍스트·최대 출력 교차확인) — https://openrouter.ai/mistralai/mistral-large-4-0
- MarkTechPost (2026-10-06) — https://www.marktechpost.com/2026/10/06/mistral-ai-releases-mistral-large-4-le-chonk-a-1-05t-parameter-open-weight-multimodal-moe/
- implicator.ai (2026-10-06) — https://www.implicator.ai/mistral-large-4-open-weights-lock-in/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 벤치마크·보안 수치는 모두 Mistral AI 자사 발표이며 독립 검증된 값이 아닙니다. 최대 출력 토큰 수, 라이선스 이름, reasoning_effort 기본값, 가중치 공개 날짜, 타사 클라우드 지원 여부는 공식 자료에 없어 "확인 필요"로 표기했습니다.