[논문리뷰] FocusVTC: Efficient and High-Performance Visual Text Compression with Adaptive Resolution (적응형 해상도 시각 텍스트 압축)
논문리뷰
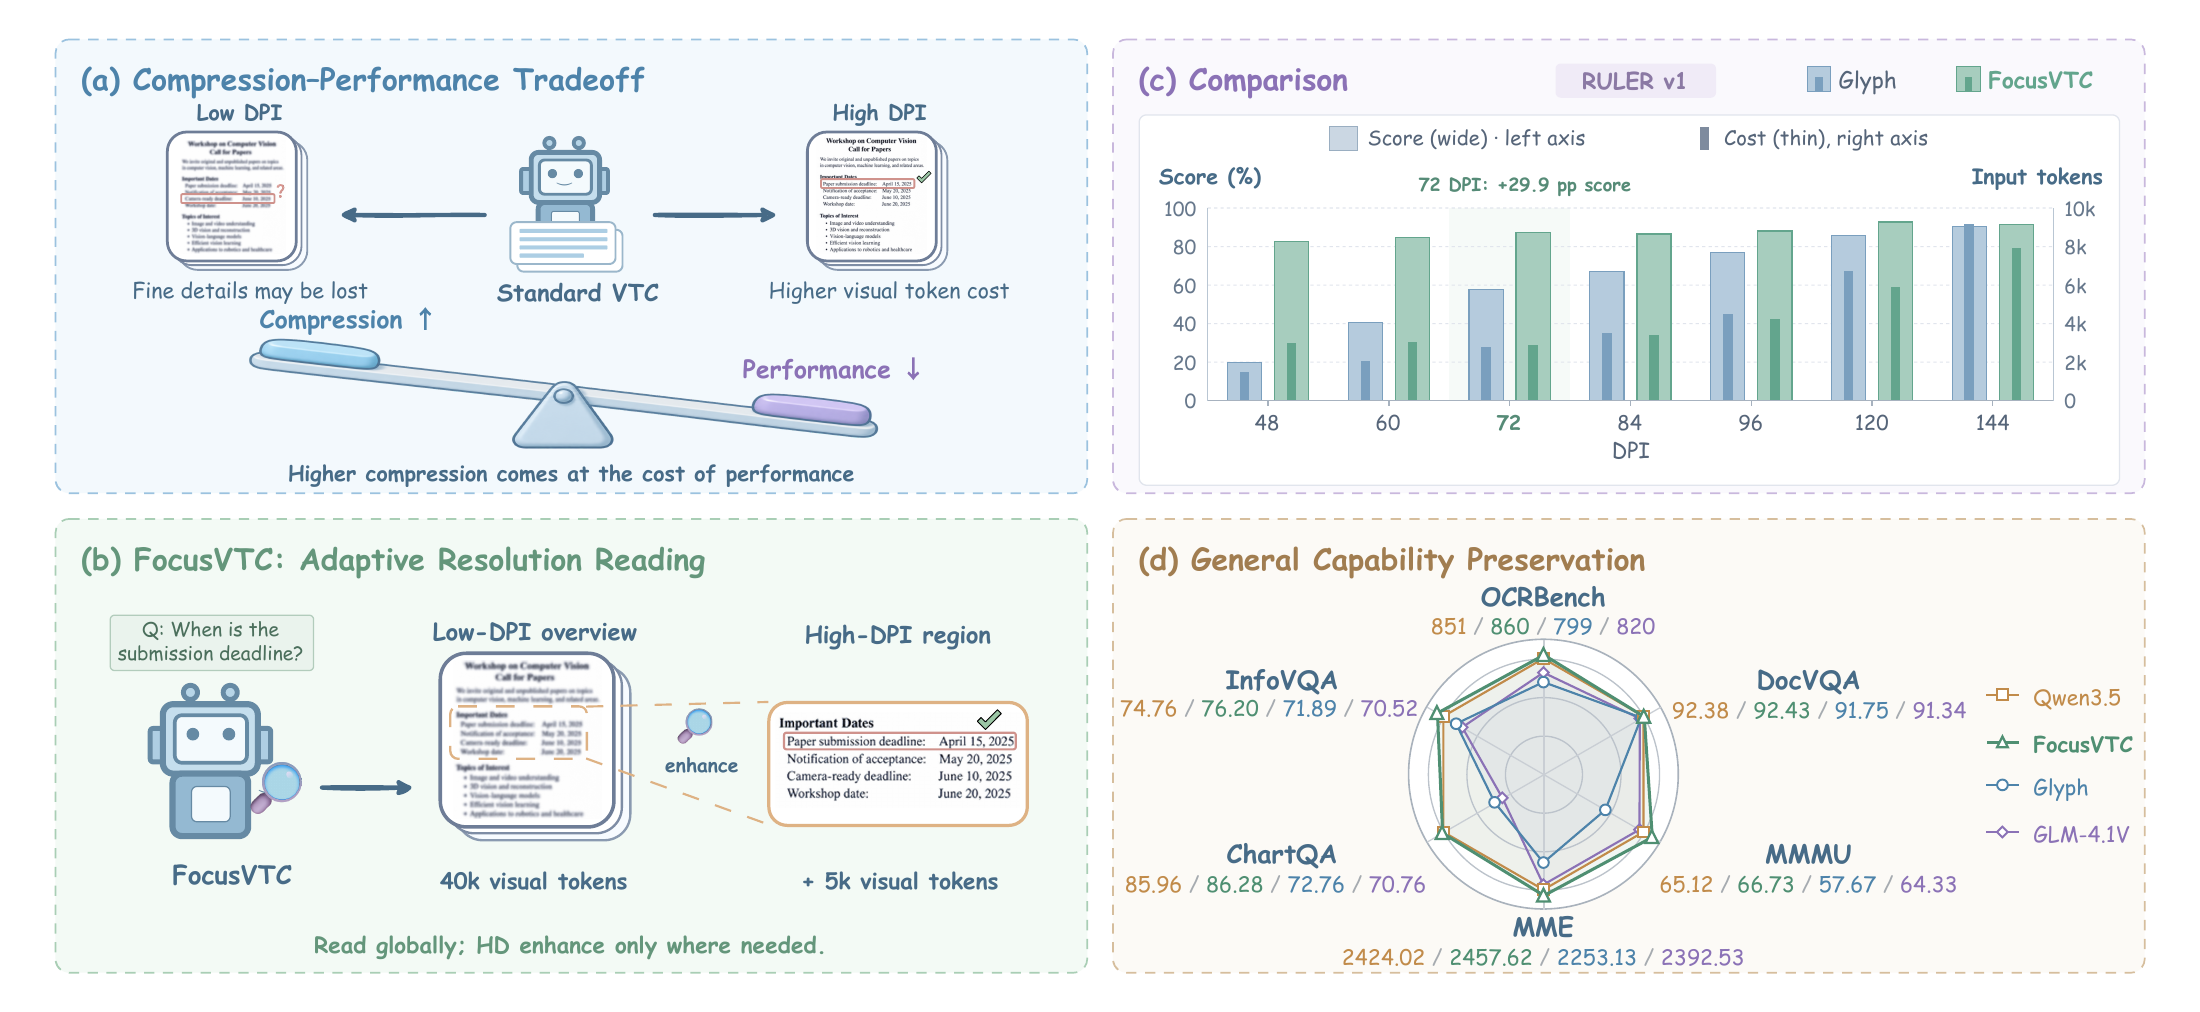
(출처: arXiv:2609.36651, Figure 1 — 저자 공개 리포지토리 docs/assets/focusvtc_introduction.png)
논문 제목: FocusVTC: Efficient and High-Performance Visual Text Compression with Adaptive Resolution
저자: FangZhi Zhong, Xuerui Qiu, Yuqi Pan, Ya Liu, Shaowei Gu, Bo Xu, Guoqi Li
(소속은 arXiv 초록 페이지·HF 페이퍼 카드·GitHub README 어디에도 표기되어 있지 않아 생략합니다.)
공개일: 2026년 9월 29일 (arXiv 제출), Hugging Face Papers 등재 9월 30일
arXiv: https://arxiv.org/abs/2609.36651 (cs.CV)
코드: https://github.com/fangzhi-zhong/FoucsVTC (리포지토리 이름의 Foucs 오타는 원본 그대로입니다)
모델: https://huggingface.co/zfz04/FocusVTC (9B, BF16, base: Qwen/Qwen3.5-9B)
데이터셋: REL-CoT — https://www.modelscope.cn/datasets/zhongfangzhi/REL-CoT
분류 태그: Visual Text Compression · Document Understanding · Long-Context · Vision-Language · Tool Use
🔖 TL;DR (한눈에)
- 롱컨텍스트를 이미지로 압축하는 VTC(Visual Text Compression)의 고질적 딜레마를 정면으로 다룹니다. 텍스트를 페이지 이미지로 렌더링하면 입력 토큰이 줄지만, 해상도를 고정해 두면 "저DPI = 토큰 절약 + 판독 불가" vs "고DPI = 판독 가능 + 무관 영역에 토큰 낭비"의 상충에서 벗어날 수 없습니다.
- FocusVTC의 답은 적응형 해상도(adaptive resolution)입니다. 문서 전체는 저DPI 축소 페이지로 훑고, 근거가 있을 것 같은 영역만
zoom_region도구로 고DPI 원본에서 잘라 와 추론 도중에 새로운 시각 관측으로 투입합니다. - 학습은 2단계입니다. ① 추론 과정을 페이지 번호·바운딩 박스에 묶은 REL-CoT 29.4K 데이터로 다해상도 REL-SFT, ② 도구 보조 GRPO로 "언제 확대할지"와 "확대 결과를 어떻게 쓸지"를 강화학습. 별도의 continual-pretraining 단계는 없습니다.
- 성능: RULER v1(72 DPI)에서 2.9× 입력 압축으로 87.4점 — 같은 압축률대(3.0×)의 Glyph 57.5점을 크게 앞섭니다. LongBench에서는 텍스트 입력 백본보다 더 높은 56.40(백본 55.86)을 기록했습니다.
- 압축 모델의 숙제인 일반 멀티모달 능력 퇴화도 일어나지 않았습니다(MMMU 65.12 → 66.73, MME 2424.02 → 2457.62). MRCR 지연 평가에서는 텍스트 입력 대비 2.79× 온라인 종단간 속도 향상.
한 줄 요약: "문서를 통째로 고해상도로 읽을 필요 없다 — 작게 훑고, 필요한 데만 확대해서 읽으면 압축률과 정확도를 동시에 가져갈 수 있다"는 것을 9B VLM 하나로 실증한 연구.
📄 초록(Abstract) 한국어 번역
대형 언어 모델의 롱컨텍스트 추론은 상당한 연산량과 메모리를 요구한다. 시각 텍스트 압축(Visual Text Compression, VTC)은 텍스트를 이미지로 렌더링해 입력 길이를 줄이지만, 고정된 해상도로 렌더링하는 방식은 압축률과 성능 사이의 상충을 강제한다. 낮은 DPI는 토큰을 절약하는 대신 가독성을 희생하고, 높은 DPI는 가독성을 확보하는 대신 정작 무관한 내용에까지 토큰을 소모한다. 본 논문은 FocusVTC를 제안한다. FocusVTC는 일반적인 멀티모달 능력을 보존하면서 적응형 해상도를 통해 이 상충을 깨뜨린다. 압축된 저DPI 전역 뷰를 선택적 영역 확대(selective region enhancement)와 결합하고, 확대된 뷰를 진행 중인 추론 과정에 통합한다. 이를 위해 29.4K 규모의 고품질 Reasoning-Evidence Localization(REL) chain-of-thought 예제(REL-CoT)를 구축하여 추론 흐름을 페이지 인덱스와 바운딩 박스에 연결한다. 다해상도 REL 지도 미세조정(REL-SFT)이 관련 영역을 지역화하도록 모델을 학습시키고, Group Relative Policy Optimization(GRPO)이 언제 해상도를 높일 것인지와 그 결과로 얻은 관측을 어떻게 활용할 것인지를 학습하되, 별도의 continual-pretraining 단계를 두지 않는다. RULER v1에서 72 DPI 기준, FocusVTC는 (도구 관측을 포함한) 2.9× 입력 압축에서 87.4점을 기록하며, 3.0× 입력 압축에서 57.5점인 Glyph를 능가한다. LongBench에서는 자신의 텍스트 입력 백본을 상회하고(56.40 대 55.86), MRCR 매크로 평균을 13.91점 향상시키며, VTCBench에서 51.19의 매크로 평균을 달성한다. MRCR 지연(latency) 평가에서는 텍스트 입력 대비 2.79× 온라인 종단간 속도 향상을 보인다. 또한 일반 멀티모달 능력이 보존되어 MMMU는 65.12에서 66.73으로, MME는 2424.02에서 2457.62로 상승한다.
요약 정리. VTC는 "긴 텍스트를 이미지로 바꿔서 토큰 수를 줄이자"는 접근인데, 지금까지는 렌더링 해상도를 한 번 정하면 그걸로 끝이었습니다. 이 논문은 그 고정 해상도 가정 자체를 버립니다. 저DPI로 전체를 보고, 근거가 있는 영역만 고DPI로 다시 들여다보는 능동적 읽기(active reading) 정책을 모델이 직접 학습합니다. 핵심 기여는 (1) 추론-근거-좌표를 하나의 CoT로 묶은 REL-CoT 데이터, (2) 다해상도 SFT + 도구 보조 GRPO의 2단계 레시피, (3) 압축률을 유지하면서 텍스트 백본과 일반 멀티모달 성능을 모두 지켜냈다는 실증입니다.
🧩 왜 이 문제가 중요한가 (배경)
롱컨텍스트 문제를 "픽셀로 푸는" 흐름은 지난 1년간 Document AI에서 가장 뜨거운 줄기였습니다. DeepSeek-OCR 계열이 "텍스트 토큰 대신 비전 토큰"이라는 아이디어를 대중화한 뒤로, 표 하나를 64토큰으로 압축하거나 레이아웃을 시각 토큰으로 접어 넣는 시도가 쏟아졌습니다. 발상은 단순하고 강력합니다. 텍스트 1,000토큰 분량의 한 페이지를 이미지 수백 토큰으로 넣을 수 있다면, 컨텍스트 윈도우와 KV 캐시를 그만큼 아낄 수 있다는 것입니다.
그런데 실전에 쓰려고 하면 바로 벽을 만납니다. 압축률을 결정하는 변수가 사실상 렌더링 DPI 하나인데, 이 값은 문서 전체에 일괄 적용됩니다.
- DPI를 낮추면: 토큰은 확실히 줄어듭니다. 하지만 작은 글자, 각주, 표 셀 안의 숫자, 도면 레이블이 뭉개집니다. 바로 QA 정확도가 꺾이는 구간입니다.
- DPI를 높이면: 글자는 읽힙니다. 그런데 100페이지 문서에서 정답과 관련된 부분이 두 문단뿐이라면, 나머지 98페이지를 또렷하게 렌더링하는 데 쓴 토큰은 전부 낭비입니다.
즉 압축률과 판독성이 전역적으로 묶여 있다는 게 문제의 본질입니다. 사람이 두꺼운 보고서를 읽을 때를 생각해 보면 이상한 제약입니다. 우리는 목차와 페이지 레이아웃을 흐릿하게 훑다가, 숫자를 확인해야 할 때만 눈을 가까이 가져갑니다. 해상도를 전역 상수가 아니라 추론 중에 내리는 국소적 결정으로 바꾸는 것 — FocusVTC가 겨냥하는 지점이 정확히 여기입니다.
이 변화는 단순한 효율 개선이 아닙니다. 모델이 "어디를 확대할지" 고르려면 근거의 위치를 알아야 하고, 근거 위치를 안다는 것은 곧 답의 출처를 좌표로 지목할 수 있다는 뜻입니다. 압축 연구가 자연스럽게 근거 귀속(evidence attribution) 연구와 만나는 셈이고, 이는 문서 QA를 실무에 올릴 때 가장 많이 요구받는 기능 중 하나입니다.
🔬 방법론
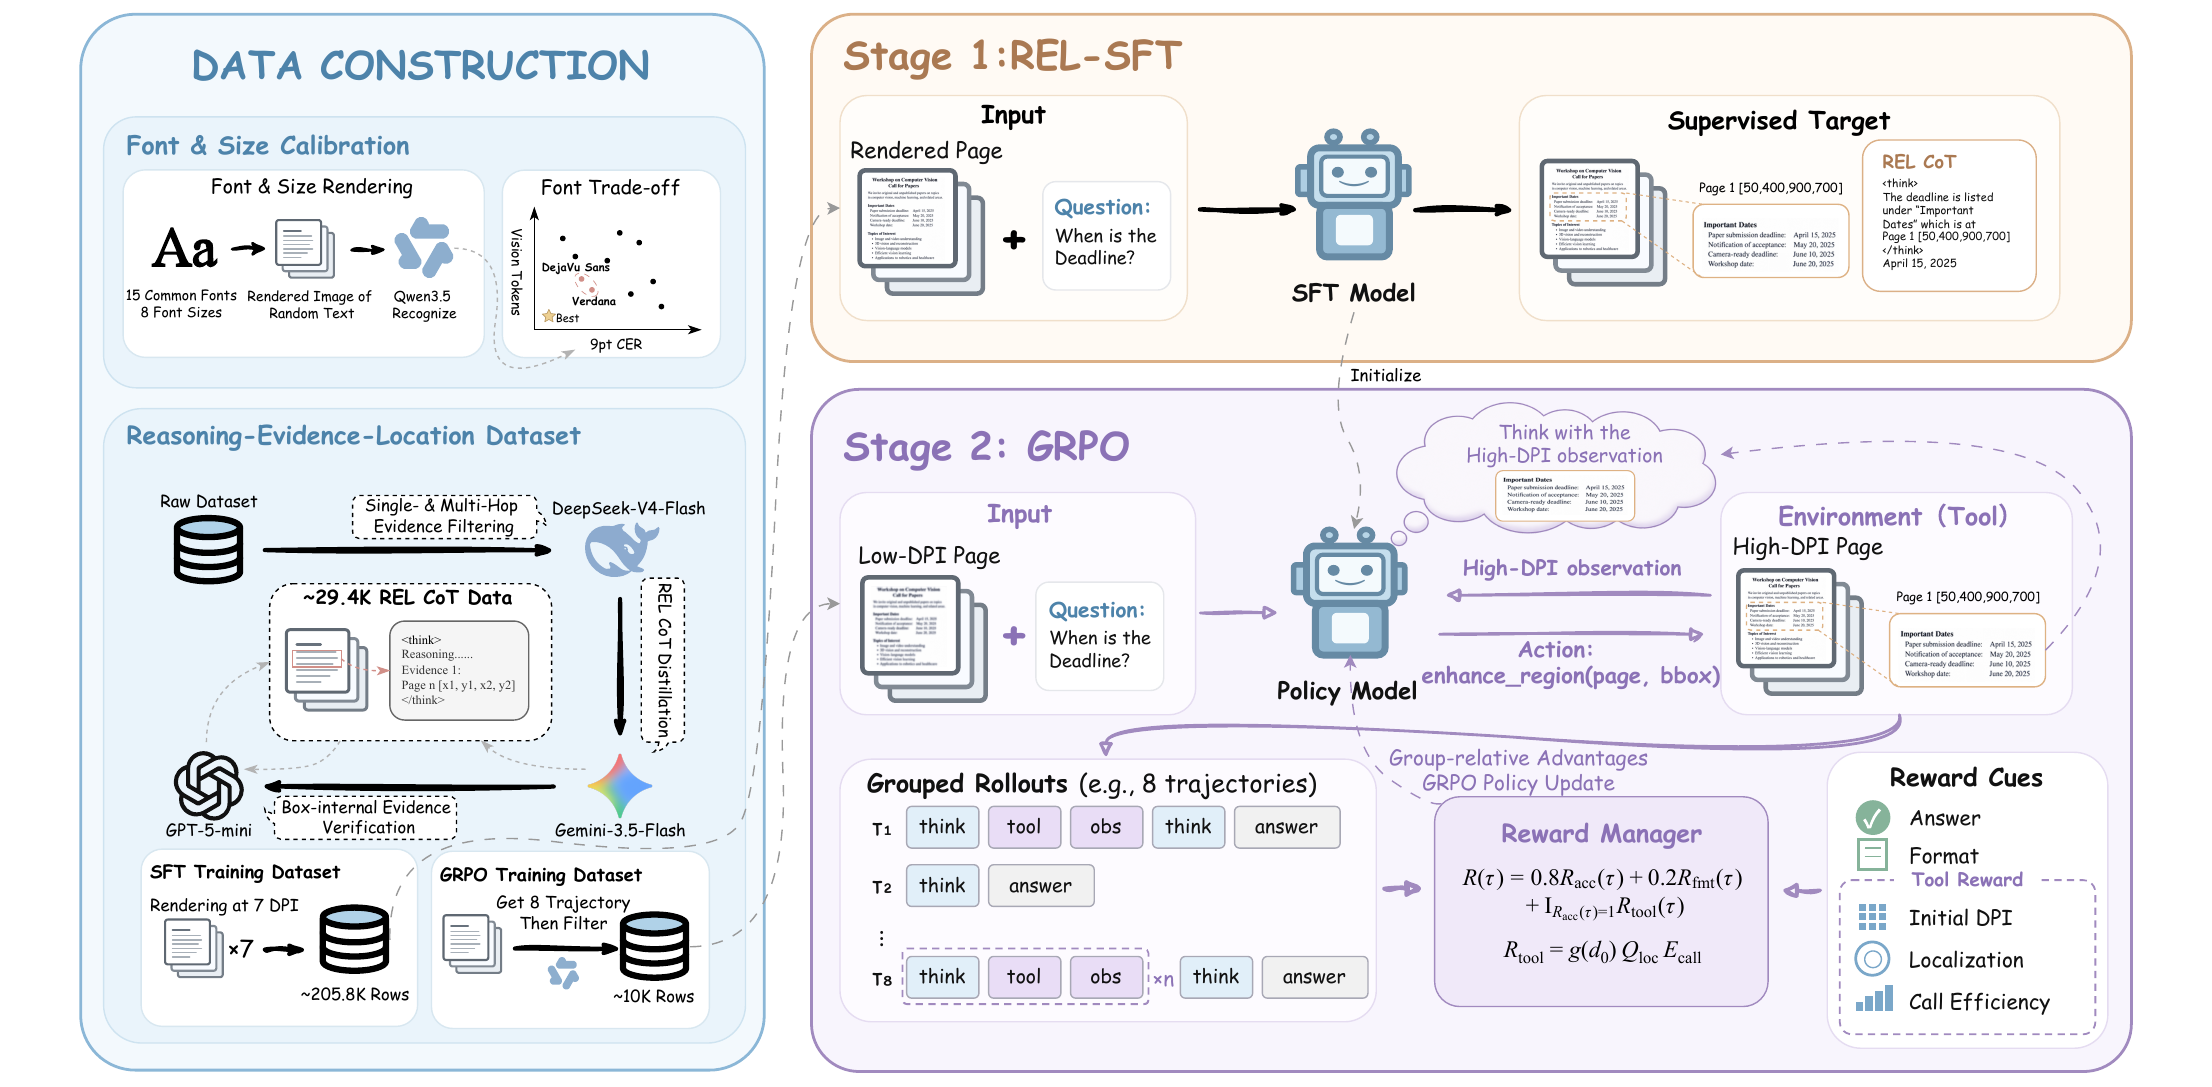
(출처: arXiv:2609.36651, 방법론 개요 그림 — 저자 공개 리포지토리 docs/assets/focusvtc_overview.png)
1) 기본 설정: 두 겹의 페이지
FocusVTC는 같은 문서를 두 가지 해상도로 동시에 준비합니다. 공개된 평가 파이프라인 기준으로 저해상도 72 DPI / 고해상도 144 DPI 쌍입니다. 디스크 상에서도 dpi_72/ 와 dpi_144/ 두 트리로 나란히 유지되고, 두 트리의 파일명과 페이지 레이아웃이 정확히 일치해야 합니다.
모델의 초기 프롬프트에 들어가는 것은 저해상도 페이지뿐입니다. 고해상도 페이지는 디스크에 있지만 컨텍스트에는 없습니다 — 모델이 요청할 때만 지연 로딩(lazy load)됩니다. 이 설계가 압축률을 지켜 주는 핵심입니다.
렌더링 폰트는 DejaVu Sans로 고정되어 있고, 학습 데이터 쪽은 더 넓게 48 / 60 / 72 / 84 / 96 / 120 / 144 — 7가지 DPI 뷰를 모두 렌더링합니다. 한 문서의 모든 DPI 변형이 train/val 중 한쪽에만 들어가도록 metadata.base_id 기준으로 분할하는데, 이는 같은 내용이 해상도만 바꿔 양쪽에 걸치는 누출을 막기 위한 장치입니다.
2) zoom_region: 추론 도중에 해상도를 올리는 도구
모델이 쓰는 도구는 딱 하나입니다.
{
  "name": "zoom_region",
  "description": "Crop a potentially unreadable region from a document page and return it as a new image.",
  "parameters": {
    "page":    { "type": "integer", "description": "1-based page number." },
    "bbox_2d": { "type": "array", "items": {"type": "number"},
                 "minItems": 4, "maxItems": 4,
                 "description": "[x1, y1, x2, y2] normalized to [0, 1000]." }
  }
}
인터페이스가 의도적으로 단순합니다. 1-based 페이지 번호와 [0, 1000]으로 정규화된 바운딩 박스 네 값만 내놓으면, 런타임이 해당 저DPI 페이지에 대응하는 고DPI 페이지(dpi_72/page_k → dpi_144/page_k)를 찾아 그 영역을 잘라 다음 턴의 시각 관측으로 되돌려 줍니다.
여기서 중요한 포인트 두 가지입니다.
- 좌표 정규화가 해상도 독립성을 만듭니다. [0, 1000] 스케일로 말하기 때문에, 모델은 저DPI 뷰에서 본 위치를 그대로 고DPI 좌표계로 옮길 수 있습니다. 모델이 두 해상도의 픽셀 치수를 알 필요가 없습니다.
- 크롭은 모델이 아니라 호스트 런타임이 수행합니다. 모델 카드가 명시적으로 경고하듯, 순수
transformers.generate()만으로는 도구가 실행되지 않습니다. 도구 호출을 파싱하고 박스를 검증하고 크롭을 수행해 다시 붙여 주는 외부 게이트웨이가 반드시 필요합니다. 짝이 되는 고해상도 페이지가 없으면 명시적으로 실패한 도구 관측이 되돌아옵니다(조용히 저해상도 이미지로 대체하지 않습니다).
평가 시 기본 정책은 최대 8회 줌 호출, 총 9턴, 턴당 생성 2,048토큰, 전체 트래젝토리 10,240토큰입니다. 이 트래젝토리 예산에는 생성 텍스트뿐 아니라 되돌아온 크롭 이미지의 토큰까지 포함해서 셉니다 — 즉 "확대해서 읽은 비용"이 압축률 계산에 정직하게 반영됩니다. 초록이 압축률을 보고할 때 "도구 관측을 포함한 2.9×"라고 단서를 붙인 이유입니다.
3) REL-CoT: 추론을 좌표에 묶는 데이터
적응형 읽기를 학습시키려면 "이 질문의 근거는 몇 페이지 어디에 있다"는 지도가 필요합니다. 저자들이 만든 것이 REL-CoT(Reasoning-Evidence Localization chain-of-thought), 규모는 29.4K 예제입니다.
구조적으로 각 예제는 추론 트레이스를 근거 페이지 인덱스 + 바운딩 박스에 연결합니다. 좌표 규약은 도구와 동일하게 1-based 페이지, [0, 1000] 정규화 박스로 통일되어 있습니다. 학습 타깃은 <think>...</think> 블록과 답변 텍스트를 포함하는 형태입니다.
데이터 구축 방식에서 눈여겨볼 점은, 공개된 렌더러가 새로운 지도 신호를 모델로 생성하지 않는다는 것입니다. 원문 텍스트를 7가지 DPI로 다시 렌더링하면서 기존의 추론과 정답은 보존하고, 근거 박스와 페이지 참조만 새 레이아웃에 맞게 재매핑합니다. 공개 범위 문서에서도 "자동 REL 주석 생성과 합성 학습 태스크 생성"은 릴리스에 포함되지 않는다고 분명히 적어 두었습니다. 즉 좌표 재매핑이 곧 해상도 증강인 구조입니다. 같은 근거가 48 DPI에서는 어떻게, 144 DPI에서는 어떻게 보이는지를 동일한 의미 라벨 아래에서 학습하게 됩니다.
4) 1단계 — REL-SFT (다해상도 지도 미세조정)
백본은 Qwen3.5-9B입니다. 이 단계의 목표는 "관련 영역을 지역화하는 능력"을 심는 것입니다. 공개 레시피에서 확인되는 설정들:
- 비전 인코더(
model.visual)는 동결(freeze)합니다. 시각 표현은 건드리지 않고 언어 측의 지역화·추론 능력을 올립니다. - 랜덤 그라운딩 프롬프트를 활성화해 좌표 지시 형식에 과적합되지 않게 합니다.
- 32K 토큰 패킹으로 샘플을 묶고, FSDP2로 분산 학습합니다. 패킹은 mRoPE 위치와 어텐션/DeltaNet/컨볼루션의 시퀀스 경계를 함께 공급합니다.
- Qwen3.5의 하이브리드 어텐션 구현 때문에
use_rmpad: false,sp_ulysses_degree: 1이 요구됩니다. - 기준 구성은 8 GPU 단일 노드입니다.
다해상도 데이터를 한 매니페스트에 섞어 학습하므로, 모델은 "저DPI에서 뭉개진 글자를 보고도 그게 어디쯤 무슨 내용인지 추정하는" 감각을 갖게 됩니다. 이 감각이 곧 "어디를 확대해야 하는지" 판단의 기반이 됩니다.
5) 2단계 — 도구 보조 GRPO (언제·어떻게 확대할지 학습)
SFT만으로는 부족합니다. 지역화를 배운다고 해서 호출 타이밍과 호출 효율이 좋아지지는 않습니다. 쓸데없이 8번 다 쓰거나, 정작 필요할 때 안 쓰거나, 페이지 전체를 박스로 잡아 압축 이득을 날려버릴 수 있습니다. 이를 GRPO(Group Relative Policy Optimization)로 교정합니다.
보상 설계가 이 논문에서 가장 음미할 부분입니다. 보상은 세 축으로 구성됩니다.
| 보상 구성 요소 | 역할 |
|---|---|
| 답변 정확도(answer accuracy) | 최종 정답의 정합성 |
| 구조적 포맷(structural format) | <think>/도구 호출 스키마 등 출력 형식 준수 |
| 도구 품질(tool quality) | 확대 행위 자체의 효율성 |
핵심 장치는 도구 보너스가 "완전히 정답일 때만" 열린다(gated on a fully correct answer)는 점입니다. 틀린 답을 내면서 도구를 예쁘게 쓰는 것으로는 보상을 얻을 수 없습니다. 도구 사용이 목적이 되는 리워드 해킹을 원천 차단하는 설계입니다.
그리고 열린 도구 보너스는 다음 네 가지에 의존합니다.
- 근거 IoU — 잡은 박스가 실제 근거와 얼마나 겹치는가
- 크롭 면적 — 필요한 만큼만 작게 잡았는가 (페이지 통째로 잡으면 압축 이득이 사라집니다)
- DPI — 해상도 상승폭. 네이티브 144→144 학습 케이스에서는 DPI 보너스가 0으로 정의됩니다(올릴 해상도가 없으므로 공짜 점수를 주지 않습니다)
- 중복 호출 — 같은 영역을 반복 호출하는 낭비에 대한 페널티
근거 주석이 비어 있거나 없는 샘플은 근거 중첩 보너스를 받을 수 없습니다. 즉 좌표 라벨이 있는 데이터에만 지역화 보상이 걸립니다.
학습 측 하이퍼파라미터(공개 기본값):
| 항목 | 값 |
|---|---|
| 프롬프트 배치 / PPO 미니배치 | 8 / 8 |
| 프롬프트당 롤아웃 수 | 4 |
| PPO 마이크로배치 (GPU당) | 1 |
| 초기 프롬프트 예산 | 8,192 토큰 |
| 응답 + 도구 관측 예산 | 10,240 토큰 |
| 총 에폭 | 1 |
| 저장·검증 주기 | 50 스텝 |
| 상호작용 예산 | 도구 호출 8회 + 최종 답변 1턴 |
| 학습률 | 문서상 예시 오버라이드로 5e-7 제시 (기본값으로 명시되진 않음) |
인프라는 Ray 워커 + FSDP + 수정된 vLLM SPMD 백엔드이고, 기준 레시피는 역시 대용량 메모리 8 GPU 단일 노드를 가정합니다. 참조 환경은 PyTorch 2.10.0 / Transformers 5.16.1 / vLLM 0.19.1 / FlashAttention 2.8.3입니다.
마지막으로 학습과 평가의 정합성을 챙긴 디테일이 하나 있습니다. 평가 게이트웨이가 GRPO 환경과 도구 파서, 박스 검증, 크롭 기하를 공유하고, 커스텀 Qwen3.5 챗 템플릿이 과거 도구 턴의 reasoning을 보존합니다. GRPO의 누적 토큰 트래젝토리와 추론 시 동작이 어긋나지 않게 맞춘 것입니다. 도구 사용 에이전트에서 train/serve skew는 흔한 함정인데, 이 부분을 명시적으로 처리했습니다.
📊 실험 결과
초록에서 보고된 수치를 정리하면 다음과 같습니다. (상세 표는 arXiv 본문에 있으며, 본 리뷰는 초록·모델 카드·공개 리포지토리에서 확인 가능한 수치만 사용했습니다.)
롱컨텍스트 벤치마크
| 벤치마크 | 조건 | FocusVTC | 비교 대상 |
|---|---|---|---|
| RULER v1 | 72 DPI, 2.9× 입력 압축(도구 관측 포함) | 87.4 | Glyph 57.5 (3.0× 입력 압축) |
| LongBench | — | 56.40 | 텍스트 입력 백본 55.86 |
| MRCR | 매크로 평균 | +13.91점 향상 | (기준 대비) |
| VTCBench | 매크로 평균 | 51.19 | — |
RULER v1이 가장 강한 결과입니다. 압축률은 사실상 동급(2.9× vs 3.0×)인데 점수가 87.4 대 57.5로 29.9점 벌어집니다. 고정 해상도 VTC가 72 DPI 구간에서 겪는 판독성 붕괴를, 선택적 확대가 거의 전부 복구한다고 읽을 수 있습니다. 여기서 압축률에 도구로 되돌아온 크롭 이미지 토큰까지 포함시켰다는 점이 중요합니다. "확대하느라 쓴 토큰을 빼고 계산한 압축률"이 아니라는 뜻이니, 비교가 공정한 쪽으로 기울어 있습니다.
LongBench 결과는 성격이 다릅니다. 56.40 대 55.86, 차이는 0.54점으로 작습니다. 하지만 비교 대상이 같은 모델의 텍스트 입력 버전이라는 게 핵심입니다. 압축 연구에서 보통 기대하는 최선은 "원본 텍스트 성능에 근접"인데, 여기서는 그 선을 넘었습니다. 전역 저해상도 뷰가 레이아웃 정보를 함께 주는 효과, 그리고 확대 과정이 일종의 명시적 근거 집중으로 작동하는 효과가 압축 손실을 상쇄했다고 해석할 수 있습니다. 다만 0.54점은 작은 마진이므로, 이를 "압축이 텍스트보다 낫다"로 일반화하기보다 "최소한 손해는 아니다"로 읽는 쪽이 안전합니다.
MRCR 매크로 평균 +13.91점은 다중 참조 해결(multi-round co-reference) 과제에서 적응형 확대의 이득이 크다는 신호입니다. 긴 대화·문서 속에서 특정 지점을 다시 찾아 확인해야 하는 과제 성격과 zoom_region의 작동 방식이 잘 맞습니다.
효율
| 지표 | 결과 |
|---|---|
| MRCR 온라인 종단간 속도 | 텍스트 입력 대비 2.79× |
| RULER v1 입력 압축률 | 2.9× (도구 관측 포함) |
속도 이득이 압축률(2.9×)과 거의 같은 배율(2.79×)로 나타난다는 게 깔끔합니다. 토큰을 줄인 만큼 실제 지연으로 돌려받았다는 뜻이고, 도구 호출로 인한 멀티턴 오버헤드가 압축 이득을 잡아먹지 않았다는 증거이기도 합니다.
일반 멀티모달 능력 보존
| 벤치마크 | 학습 전 | FocusVTC |
|---|---|---|
| MMMU | 65.12 | 66.73 (+1.61) |
| MME | 2424.02 | 2457.62 (+33.60) |
이 표가 생각보다 중요합니다. 문서 특화 미세조정을 세게 하면 일반 VQA·추론 능력이 깎이는 게 흔한 부작용인데(이른바 특화 세금), FocusVTC는 두 지표 모두 오히려 소폭 상승했습니다. 비전 인코더를 동결하고, 랜덤 그라운딩 프롬프트로 형식 과적합을 막고, 초록이 강조하듯 별도 continual-pretraining 단계를 두지 않은 설계 선택이 여기서 값을 하는 것으로 보입니다. 상승폭 자체는 크지 않으니 "향상됐다"보다 "퇴화하지 않았다"가 정확한 독법입니다.
🚧 한계
논문 초록·모델 카드·공개 문서에서 확인되는 제약들을 정리합니다. 저자들이 상당히 솔직하게 적어 둔 편입니다.
1. 외부 런타임 의존이 구조적입니다. zoom_region은 모델이 실행하는 도구가 아닙니다. 도구 호출을 파싱하고 박스를 검증하고 고해상도 페이지에서 크롭해 다시 주입하는 게이트웨이가 반드시 있어야 합니다. 모델 카드도 "신뢰할 수 있는 도구 사용에는 검증·실행을 담당하는 외부 런타임이 필요하다"고 명시합니다. 단순히 HF에서 체크포인트를 내려받아 generate()를 호출하면 이 논문의 능력은 작동하지 않습니다.
2. 두 해상도 트리를 항상 유지해야 합니다. 저DPI와 고DPI 페이지가 파일명·레이아웃까지 일치해야 하고, 짝이 없으면 실패한 도구 관측이 됩니다. 저장 공간이 더 들고, 파이프라인 운영 복잡도가 올라갑니다. 사진이나 짝이 없는 이미지에는 require_high_res: false 같은 별도 설정이 필요합니다.
3. 좌표와 답이 틀릴 수 있습니다. 모델 카드가 명시하듯 답변도 크롭 좌표도 오류 가능하고, 결과가 페이지 해상도·프롬프트 형식·생성 설정·시각 컨텍스트 분량에 크게 좌우될 수 있습니다. 고위험 용도에서는 독립 검증을 권고합니다.
4. 공개된 데이터로 GRPO 단계를 그대로 재현하기 어렵습니다. 릴리스된 REL-CoT 매니페스트에는 GRPO 변환기가 요구하는 gold 참조 답변 필드가 없습니다. 사용자가 독립적인 참조 답변을 직접 공급해야 하고, 변환기는 지도 학습용 어시스턴트 응답을 참조 답변으로 전용하지 않습니다. 자동 REL 주석 생성과 합성 태스크 생성도 릴리스에서 제외되어 있습니다.
5. 릴리스가 재현 로그는 아닙니다. 공개 문서가 스스로 "이 릴리스는 새로운 GPU 평가를 돌려 본 적이 없다", 설정들은 "이식 가능한 출발점"이며 "모든 레시피가 논문 실험을 정확히 재현한다고 주장하지 않는다"고 적고 있습니다. SFT 학습률·배치·에폭 같은 수치는 문서 본문에 없고 YAML에만 있습니다.
6. 스코어링 비교에 주의가 필요합니다. RULER v2 평가는 원 리포지토리 옵션을 유지해 일부 검색 과제에서 reasoning 안에 등장한 정답 문자열도 인정합니다. 최종 답변만 채점하는 방식과 다르므로, 업스트림 리더보드와 직접 비교하기 전에 스코어러를 확인해야 합니다. 문서도 점수를 보고할 때 프롬프트·샘플링·DPI·도구 예산·스코어러 정책을 함께 밝히라고 권고합니다. VTCBench 기본 어댑터 역시 원본 이미지를 크롭하며 짝 고해상도 페이지를 재구성하지 않습니다.
7. 평가의 폭. RULER / LongBench / MRCR / VTCBench는 모두 렌더링된 텍스트 문서 성격이 강합니다. 스캔 품질이 나쁜 실제 스캔본, 손글씨, 복잡한 다국어 조판, 사진 촬영 문서에서 이 전략이 어떻게 버티는지는 공개 자료만으로는 판단하기 어렵습니다. zoom_region이 전제하는 "고DPI 원본이 존재한다"는 가정 자체가, 애초에 저해상도로만 존재하는 실제 스캔본에는 적용되지 않습니다.
🎯 마무리
FocusVTC가 바꾼 것은 모델 구조가 아니라 질문의 틀입니다. 지금까지 VTC 연구는 "한 페이지를 몇 토큰까지 줄일 수 있나"를 물었습니다. 이 논문은 "어느 부분을 몇 토큰으로 읽을 것인가"를 묻습니다. 압축률을 전역 상수에서 추론 중의 국소적 결정으로 내려놓은 것이고, 그 결과가 RULER v1에서 동급 압축률 대비 29.9점 차이로 나타났습니다.
개인적으로 가장 설계가 좋다고 본 부분은 보상 게이팅입니다. 도구 보너스를 "정답을 맞혔을 때만" 열고, 그 안에서 IoU·크롭 면적·DPI·중복 호출로 효율을 채점합니다. 도구 사용 에이전트를 강화학습으로 다룰 때 가장 흔한 실패는 도구 호출 자체가 보상이 되어 버리는 것인데, 이 구조에서는 그 경로가 막혀 있습니다. 압축 연구가 아니라 도구 사용 RL 레시피로 읽어도 참고할 만합니다.
실무 관점에서 의미 있는 신호는 세 가지입니다. 첫째, 텍스트 백본을 넘어선 LongBench 56.40은 압축이 반드시 손실이 아님을 보여줍니다(마진은 작지만 방향이 중요합니다). 둘째, 2.79× 종단간 속도 향상은 압축 이득이 멀티턴 도구 오버헤드에 잡아먹히지 않는다는 실증입니다. 셋째, MMMU·MME 비퇴화는 문서 특화와 범용성이 양립 가능함을 보여줍니다 — 프로덕션에서 모델을 하나만 유지하고 싶을 때 중요한 조건입니다.
반면 도입 장벽은 과소평가하면 안 됩니다. 두 해상도 트리 유지, 외부 도구 게이트웨이 구축, 근거 좌표가 달린 데이터 확보는 모두 실제 비용입니다. 특히 좌표 라벨이 있는 REL 데이터가 이 접근의 진짜 관문입니다. 사내 문서로 같은 레시피를 돌리려면 "이 답의 근거는 몇 페이지 어디"를 붙여 둔 데이터를 만들어야 하고, 공개 릴리스가 자동 REL 주석 생성을 제외했다는 점은 그 작업이 쉽지 않다는 간접 증거로 보입니다.
그래도 방향 자체는 설득력 있습니다. 문서를 읽는 비용을 "페이지 수 × 고정 해상도"가 아니라 "필요한 영역 × 필요한 해상도"로 재정의하는 것 — 사람이 실제로 문서를 읽는 방식에 더 가까운 이 전환은, 롱컨텍스트 문서 AI에서 한동안 계속 확장될 줄기로 보입니다.
📚 출처 / 인용
- 논문: FocusVTC: Efficient and High-Performance Visual Text Compression with Adaptive Resolution — arXiv:2609.36651 (cs.CV) — https://arxiv.org/abs/2609.36651
- Hugging Face Papers: https://huggingface.co/papers/2609.36651
- 코드: https://github.com/fangzhi-zhong/FoucsVTC
- 모델: https://huggingface.co/zfz04/FocusVTC
- 데이터셋 (REL-CoT): https://www.modelscope.cn/datasets/zhongfangzhi/REL-CoT
본문에 사용된 이미지는 원논문의 그림을 인용한 것이며, 저작권은 원저자에게 있습니다.
본 글은 학습·공유 목적의 개인 리뷰이며, 수치와 해석에 오류가 있을 수 있으니 정확한 내용은 원문을 확인해 주세요.