이 시리즈는 Databricks 환경에서 구축했던 항공/운송/물류 분야의 RAG Agent 구축 프로젝트 관련 내용을 정리하는 시리즈입니다. 요구사항과 관련하여 Databricks의 어떤 기술을 사용해 이를 충족하였으며, 수행 중 발생한 문제 상황을 어떻게 해결했는지 정리합니다.
실제 고객사에서 수행한 프로젝트와는 별도의 내용으로, 기술적인 내용만을 정리합니다.
1. 프로젝트 개요
'RAG Agent 구축 프로젝트(이하 RAG 프로젝트)'는 일선 부서에서 사용하는 비정형 데이터(매뉴얼, 공지사항, 규정집 등)를 활용하여 RAG 시스템 및 챗봇 앱을 구축하는 것을 목표로 합니다.
단순히 RAG 챗봇을 구축하는 것을 넘어, Databricks 기반의 전사 표준 RAG 시스템 및 통합 관리 체계를 구축하고 패키징하여 제공함으로써 향후 전사에 표준화된 RAG 시스템을 전파시킬 수 있도록 하는 것을 목표로 합니다.
1.1 프로젝트 주요 범위
| 영역 | 주요 내용 |
|---|---|
| 데이터 파이프라인 | 데이터 수집 및 적재, ETL 및 인덱싱 파이프라인, 데이터 정합성 보장 |
| 검색 및 인덱스 최적화 | AI Search 구축 및 운영, 검색 품질 고도화 |
| 모델 서빙 및 LLM 운영 | Model Serving Endpoint 배포, 프롬프트 및 에이전트 튜닝 |
| 품질 평가 및 모니터링 | 로그 분석 및 관제, 평가 및 피드백 루프 구현 |
| 인프라, 보안, 거버넌스 | 보안 및 권한 제어(Unity Catalog), DevOps 및 인프라 운영 |
2. 아키텍처
2.1. 시스템 아키텍처
사용자가 직접 Databricks App의 Chat UI를 사용하거나, 혹은 Application의 BFF(Backend For Frontend)를 통해 Databricks App의 API를 호출하는 아키텍처입니다.
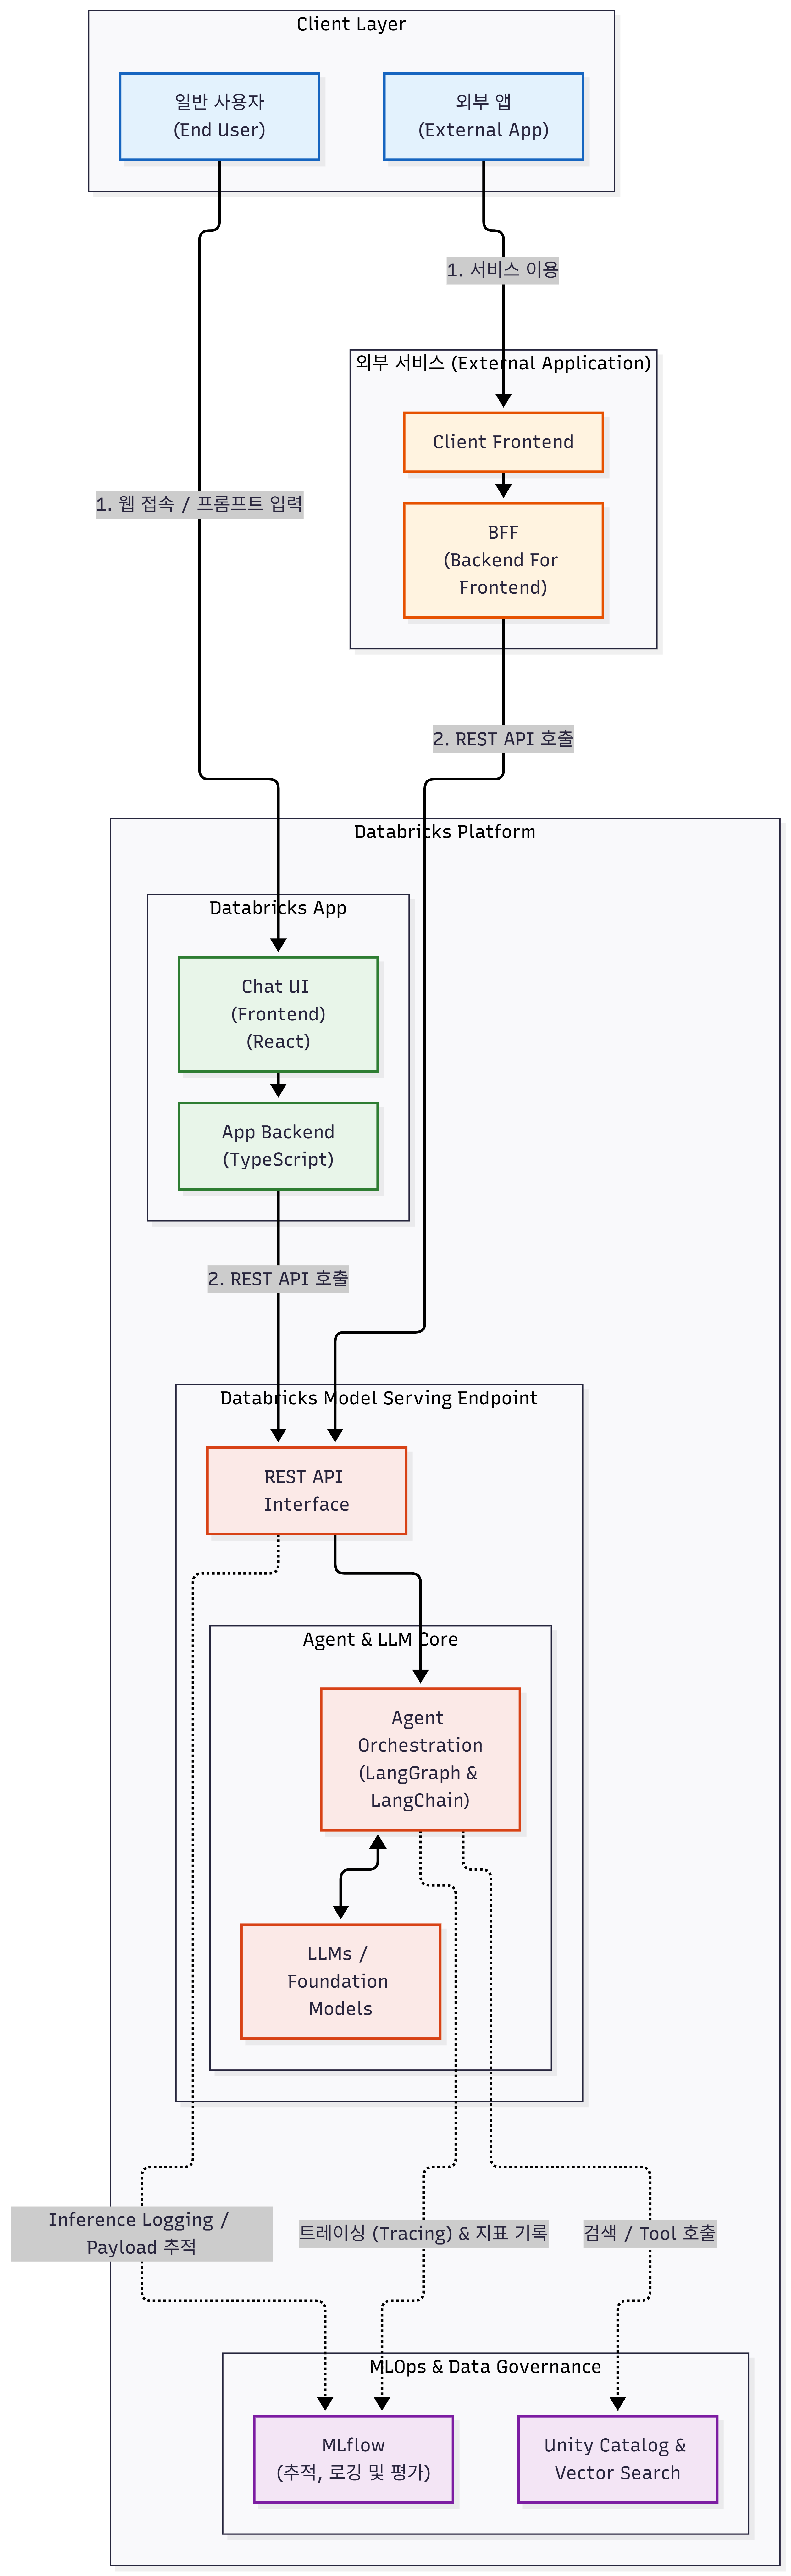
Databricks App 및 BFF 등은 본 프로젝트의 구현 범위에서 제외되며, App은 Databricks Apps의 템플릿을 일부 수정하여 활용하였습니다.
2.2. Databricks 아키텍처
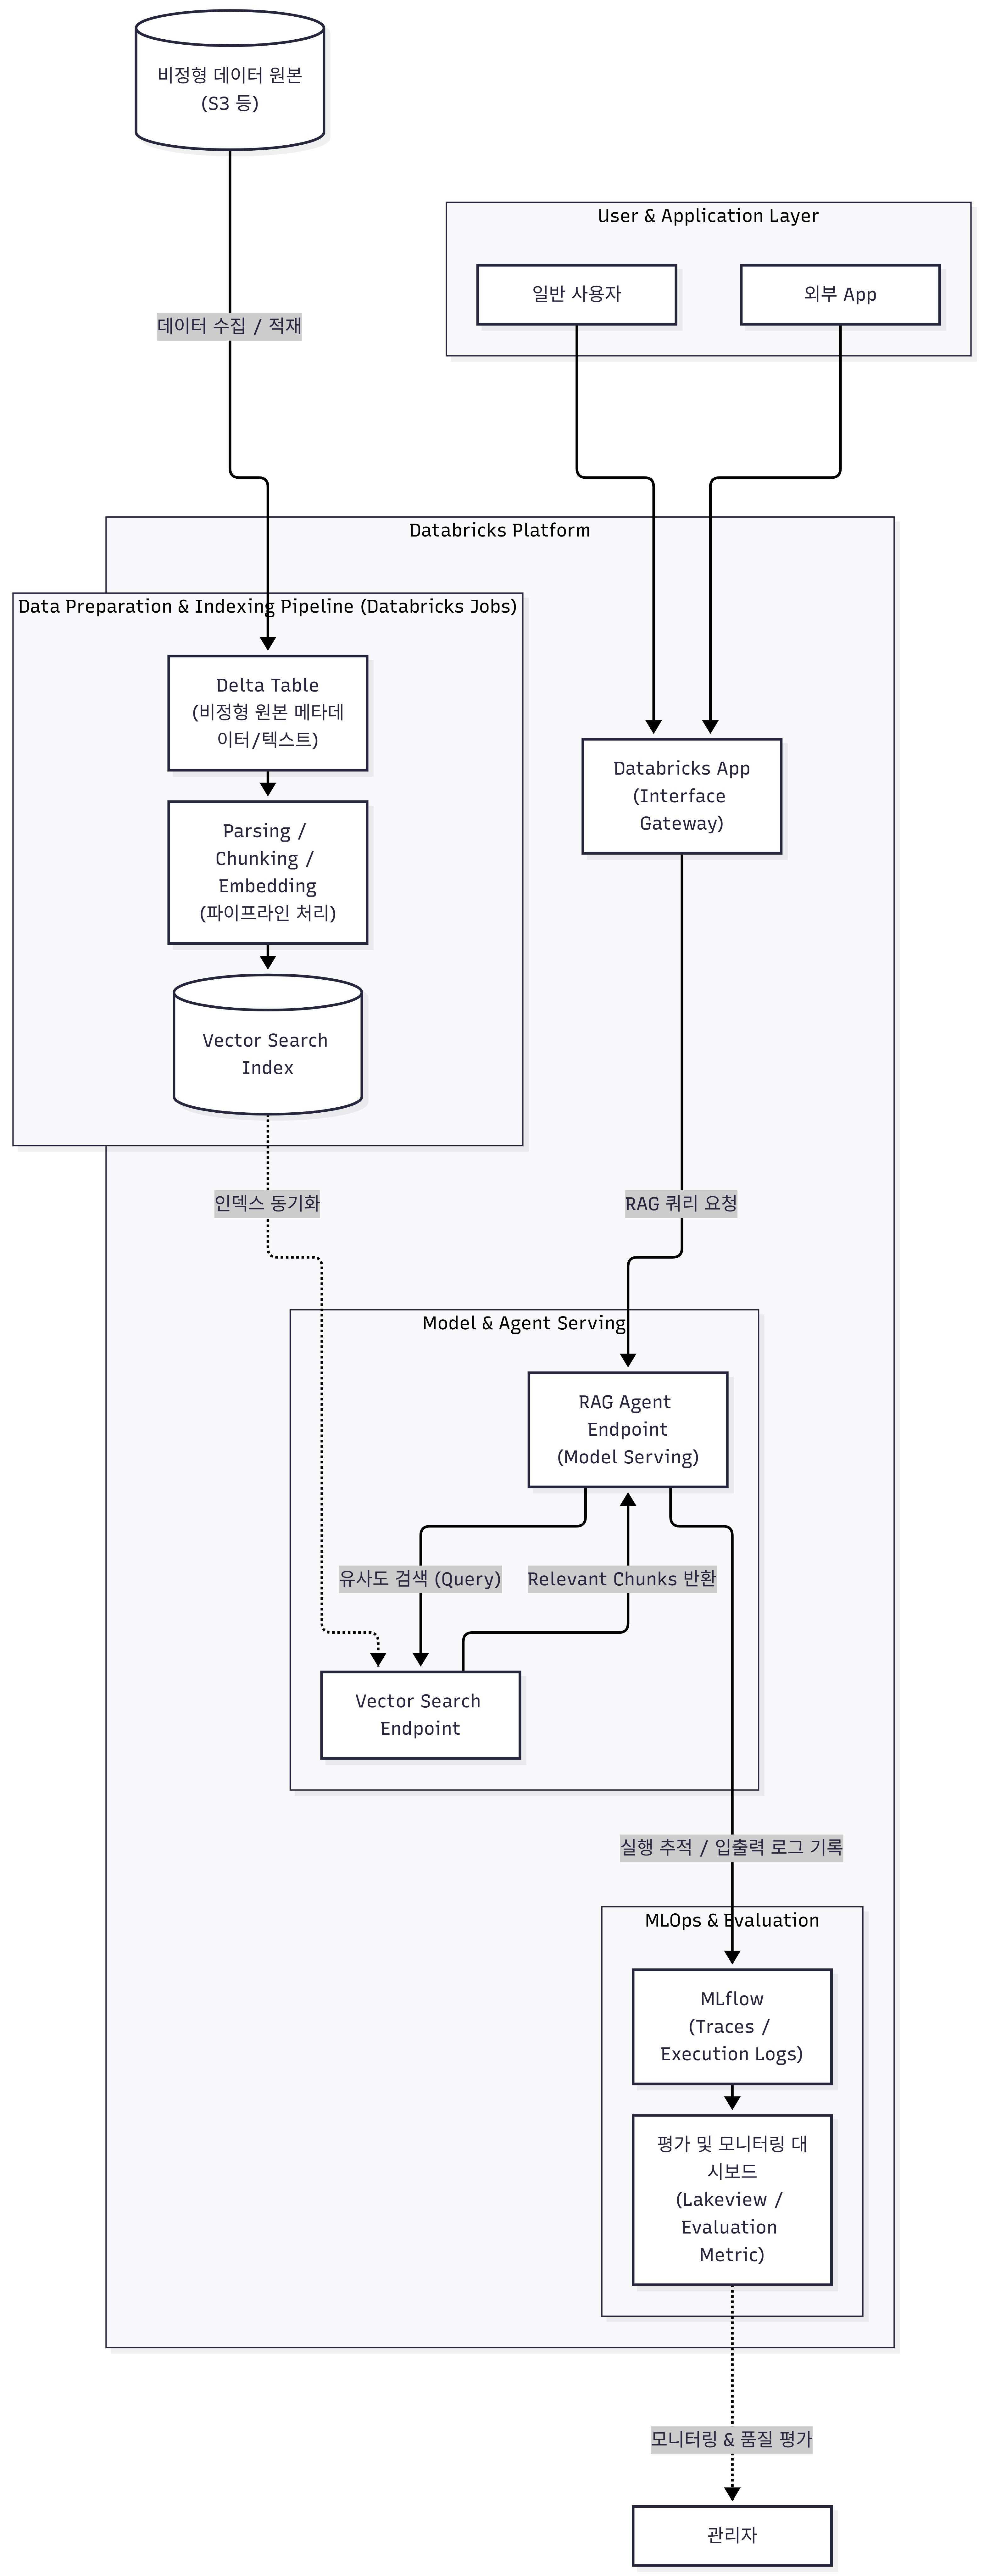
Generative AI 기반 RAG 서비스의 표준 아키텍처로, 데이터 수집부터 인덱싱, 검색, 생성, 모니터링까지 전 영역을 Databricks에서 커버합니다.
3. 주요 구현 사항
이 장에서는 본 프로젝트에서 중점적으로 구현한 사항을 명세합니다. 특히 일반적인 RAG 파이프라인 외에, 본 프로젝트를 위하여 커스터마이징된 요소를 중점적으로 다룹니다.
3.1. Self-Managed Index & Ensemble Retriever
3.1.1. 도입 배경 및 커스터마이징 필요성
- Databricks Managed Index의 한계: 프로젝트 수행 당시, Databricks Managed Vector Search의 기본 키워드 검색(BM25)은 특정 타깃 컬럼만 한정하여 검색을 수행할 수 없었습니다(2026년 8월 업데이트됨). 대신 검색 결과로 반환할 메타데이터 성격의 컬럼 목록인
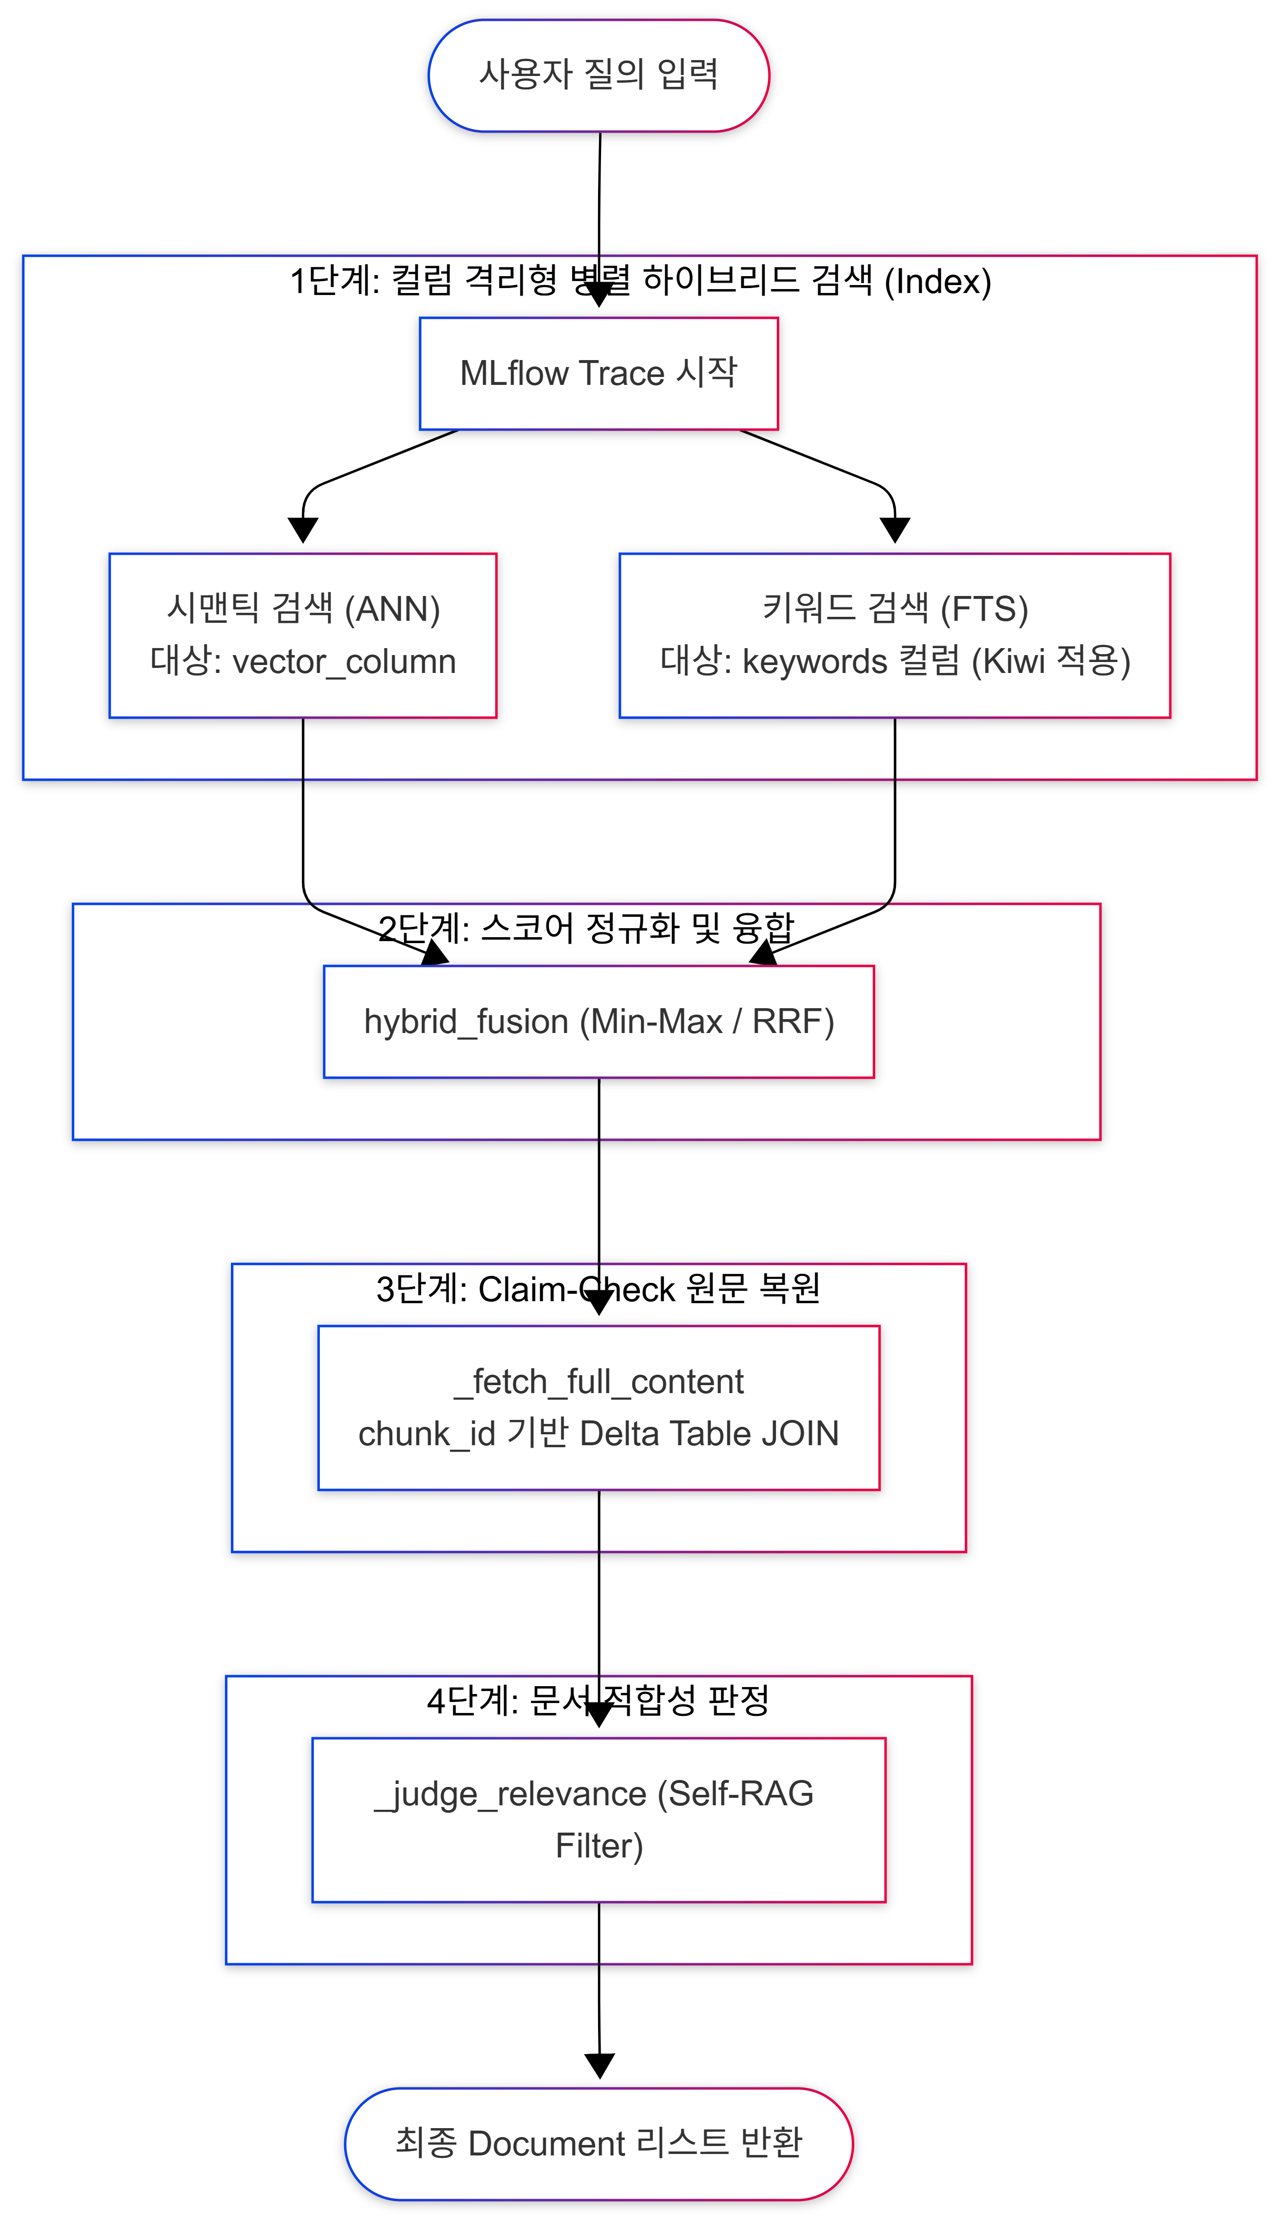
columns_to_sync에 정의된 모든 텍스트 필드를 전수 검색 대상으로 삼습니다. 이로 인해 본문 내용 외에 딥링크 URL이나 부가 메타데이터 필드에 키워드가 매칭될 경우, 검색 결과 순위가 왜곡되는 키워드 검색 왜곡(Keyword Search Pollution) 현상이 발생합니다. - 검색 채널의 분리: 이를 해소하기 위해 동기화할 컬럼과 검색 대상 컬럼을 직접 제어할 수 있는 Self-Managed Index 구조를 채택했습니다. 앙상블 리트리버(
ensemble_retriever.py)에서는 시맨틱 검색(ANN)과 키워드 검색(FTS)을 서로 다른 컬럼을 대상으로 병렬 수행하도록 차별화했습니다. 시맨틱 검색은 임베딩 벡터가 담긴vector_column을 대상으로 수행하고, 키워드 검색은 Kiwi 토크나이저로 정제된keywords컬럼만을 대상으로 수행하여 각각의 검색 정확도(특히 고유 코드 매칭 등 키워드 검색의 정확도)를 극대화합니다. - 자연스러운 Claim-Check 패턴 도출: 실제 반환되어야 할 원문 본문(
content)이나 상세 메타데이터 컬럼이 인덱스에 직접 포함되면 이 역시 키워드 검색 대상이 되어 스코어를 오염시키게 됩니다. 따라서 인덱스에는 최소한의 검색 매칭용 컬럼(chunk_id,keywords,vector_column)만 남겨두고, 검색 및 순위 융합(Fusion)이 끝난 상위 top-K 청크들의chunk_id를 활용해 원본 Delta Table에 조인하여 실제 본문 원문과 딥링크 URL 등 메타데이터 컬럼들을 다시 쿼리해 가져오는 Claim-Check 방식으로 파이프라인을 설계했습니다.
3.1.2. 구현 방식
- 인덱스 동기화 설정:
changes_vectorizing파이프라인에서 Qwen 3 Embedding 0.6B 모델을ai_query함수로 호출하여 1024차원의 임베딩 벡터(vector_column)를 계산하고, 동시 가동되는 Kiwi UDF를 통해 키워드 토큰 문자열(keywords)을 정제해 Delta Table에 병합합니다. 이후VectorSearchClient를 통해 이 테이블의 특정 컬럼만을 바라보는 Self-Managed Delta Sync 인덱스를 구축합니다. - 하이브리드 스코어 융합: 리트리버 단에서는 각 검색 채널의 점수를 Min-Max Scaling으로 정규화하여 가중합(
semantic_weight비중 제어)을 산출하거나, 혹은 상호 역순위 정렬 방식인 RRF(Reciprocal Rank Fusion)를 가동하여 병렬 검색 결과 순위를 보정합니다.
3.1.3. 핵심 코드 조각
# Self-Managed Delta Sync Index 생성
from databricks.vector_search.client import VectorSearchClient

def create_self_managed_sync_index(
	endpoint_name: str,
    index_name: str,
    source_table: str
):
    client = VectorSearchClient()
    client.create_delta_sync_index(
        endpoint_name=endpoint_name,
        index_name=index_name,
        source_table_name=source_table,
        pipeline_type="TRIGGERED",
        primary_key="chunk_id",
        embedding_dimension=1024,
        embedding_vector_column="vector_column"
    )

# RRF(Reciprocal Rank Fusion) 순위 융합 계산 예시
def calculate_rrf_score(ranks_list: list, k: int = 60) -> float:
    score = 0.0
    for rank in ranks_list:
        score += 1.0 / (k + rank)
    return score
3.2. Kiwi Tokenizer(Synonym Dictionary)
3.2.1. 도입 배경
한국어 교착어 특성상 단순 공백 토큰화로는 조사/접사 결합어(예: "화물의")를 정규화하지 못해 키워드 검색의 매칭율이 하락합니다. 또한 다중 어휘 동의어를 유연하게 매치하되, BM25의 IDF 왜곡(검색어 인플레이션)을 막기 위해 검색 시점에만 확장이 동작하도록 오케스트레이션해야 합니다.
3.2.2. 구현 방식
- 파생/전성명사 원형 복원: 용언 어간과 명사형 어미(ETN), 명사와 명사파생 접미사(XSN)의 결합을 감지하여 하나의 일반명사(
NNG)로 합성하고, 형태소 오프셋을 기반으로 원래 표면형을 슬라이싱 복원하는 알고리즘(_merge_derived_nouns)을 적용합니다. - Aho-Corasick 확장: 검색 시점에 C-Extension 기반 패키지인
pyahocorasick을KEY_SEQUENCE모드로 로드하여 단어 경계 일치를 확보하고 최장 비중첩 매치(Leftmost-Longest Match)로 쿼리 확장 중복을 필터링합니다.
3.2.3. 사전 설계 정책 요약
| 사전 유형 | 가중치 점수 정책 | 주요 목적 및 예시 |
|---|---|---|
| 사용자 사전 | +5.0 (고유명사 NNP)+3.0 (명사 승격 NNG)-3.0 (원형 정규화) | 공항 코드(ICN) 및 의존명사 승격(킬로그램), 변이형 수렴(수화물 수하물) 적용 |
| 동의어 사전 | 검색 시점에만 OR 확장 (IDF 왜곡 방지) | 동등 매핑 및 단방향 매핑(=>) 지원 |
| 불용어 사전 | 토큰화 최종 단계 필터링 | 분석 가치를 흐리는 무의미 반복 용어("사본", "참고사항") 드롭 |
3.3. Prompt Registry(Manual OAuth Injection)
3.3.1. 도입 배경 및 자격 증명 주입 설계
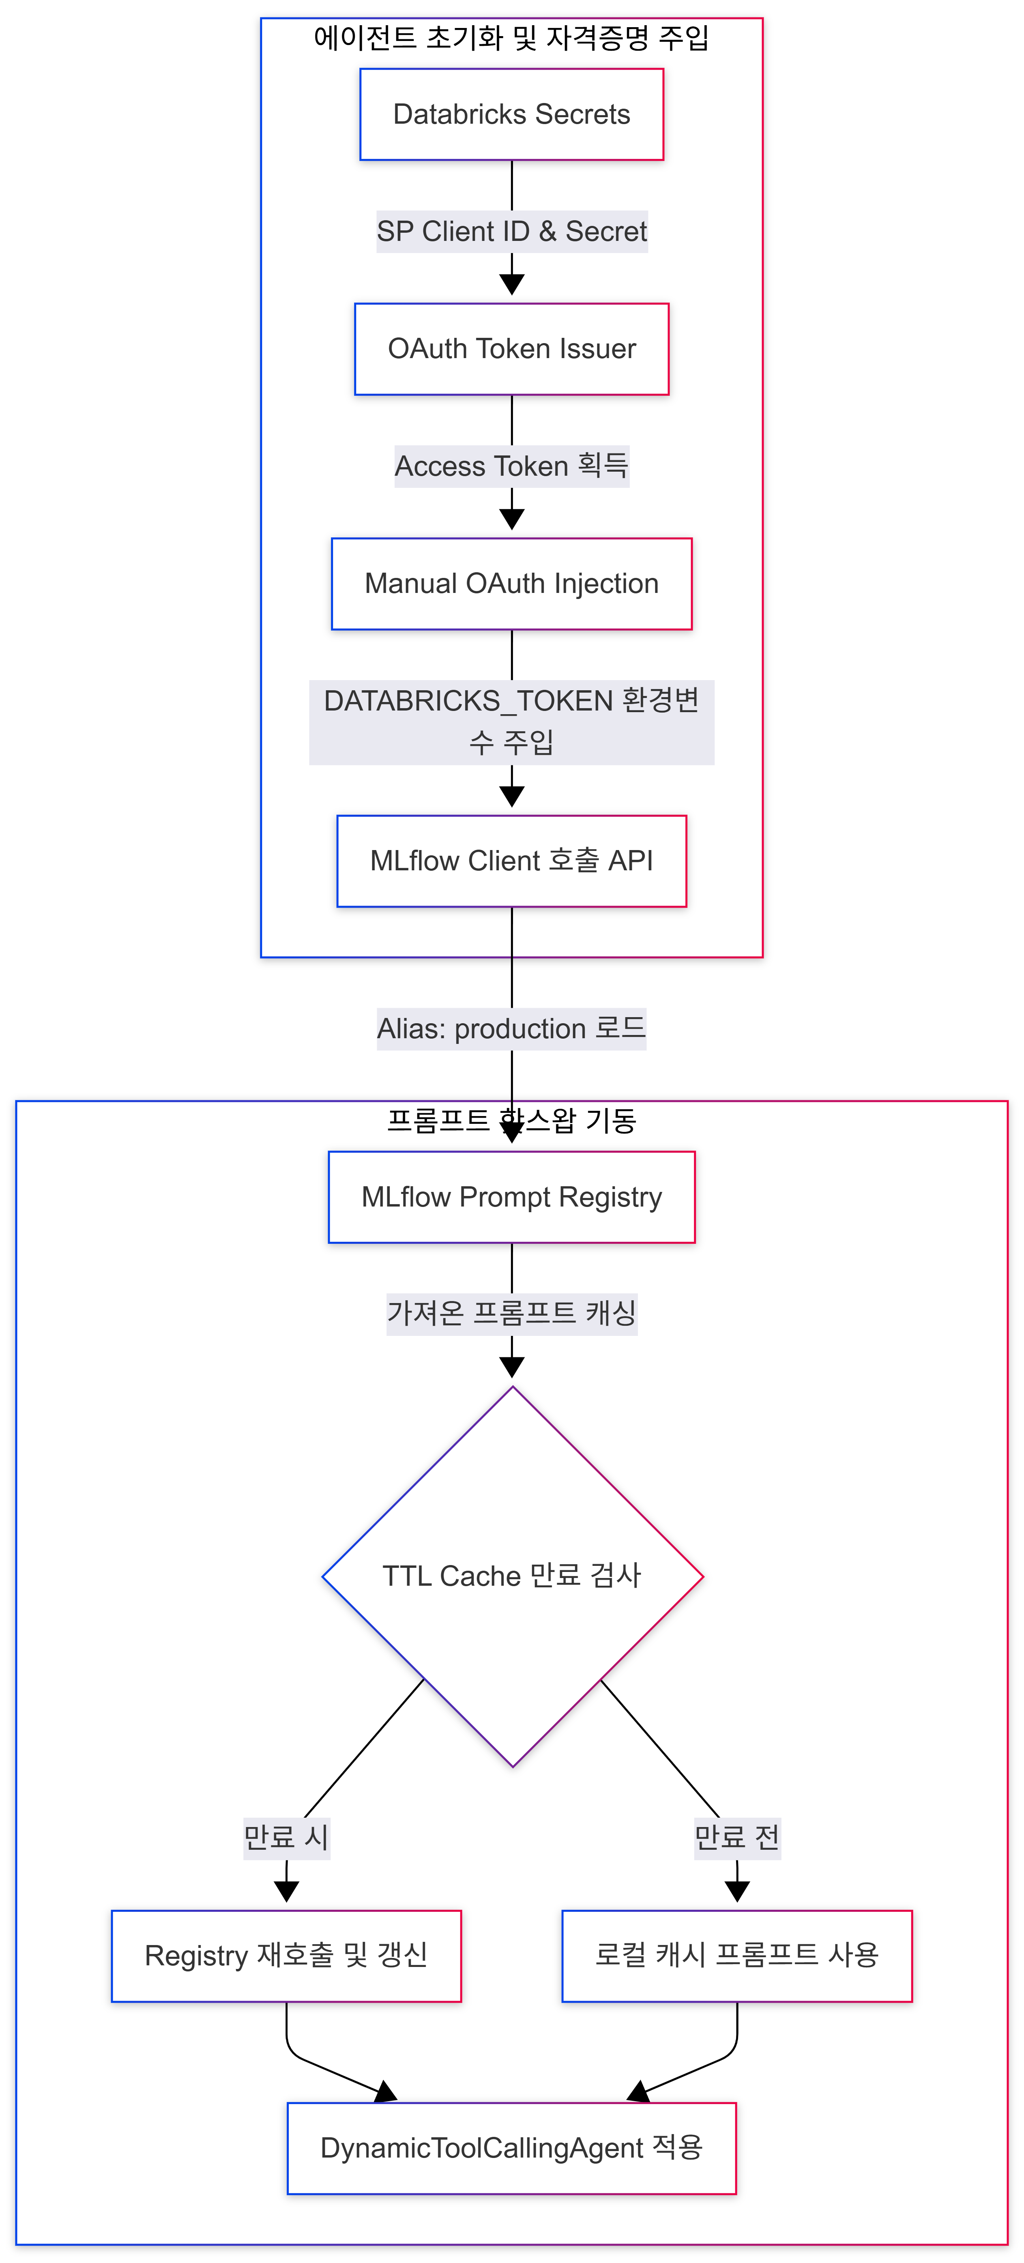
- 엔드포인트 재배포 없는 프롬프트 핫스왑: 프롬프트가 소스 코드에 하드코딩되어 있으면 프롬프트 수정 시마다 모델을 새로 빌드하고 서빙 엔드포인트를 매번 재배포해야 하는 배포 공백과 비효율이 생깁니다. 이를 방지하기 위해 프롬프트를 에이전트 코드와 격리하여 Unity Catalog 기반의 MLflow Prompt Registry에서 통합 관리합니다.
- 자격 증명 수동 주입 (Manual OAuth Injection): Model Serving 컨테이너 런타임 환경에서는 보안상의 이유로 외부 시스템 호출 자격 증명이 차단될 수 있으며, GenAI 및 Prompt Registry API 연결을 위한 Databricks 토큰 획득이 제한됩니다. 이 컴플라이언스 및 제약을 우회하기 위해, 에이전트 구동 및 서빙 기동 시점에 Databricks Secrets에서 Service Principal Credentials(Client ID 및 Client Secret)을 직접 호출하여 서버리스 API 통신용 OAuth Access Token을 획득하고, 이를 에이전트 런타임 환경 변수(
DATABRICKS_TOKEN)에 수동으로 직접 바인딩/주입했습니다.
3.3.2. 구현 방식
- TTL 캐시 기반 로딩:
PromptRegistryManager유틸리티를 구현하여 에이전트 내에서 설정된 Time-To-Live(TTL) 캐시 주기 단위로 MLflow Prompt Registry를 폴링하도록 오케스트레이션합니다. 시스템 프롬프트(System Prompt)와 판정 프롬프트(Self-RAG Judge Prompt)가 이에 연계되어 가동되므로, 운영자가 레지스트리 상에서productionAlias의 대상을 신규 프롬프트 버전으로 승격시키면 서빙 인프라의 중단 및 코드 재배포 없이 실시간으로 시스템에 핫스왑 적용됩니다.
3.3.3. 핵심 코드
# PromptRegistryManager를 활용한 dynamic prompt 지연 로드 및 TTL 갱신 예시
import time
import mlflow.genai

class LazyPrompt:
    def __init__(self, prompt_uri: str, ttl_seconds: int = 300):
        self.prompt_uri = prompt_uri
        self.ttl_seconds = ttl_seconds
        self.cached_prompt = None
        self.last_fetched = 0

    def get(self) -> str:
        # TTL 만료 시점에만 MLflow Registry에서 프롬프트를 핫 로드
        if time.time() - self.last_fetched > self.ttl_seconds:
            try:
                self.cached_prompt = mlflow.genai.load_prompt(self.prompt_uri)
                self.last_fetched = time.time()
            except Exception:
                if not self.cached_prompt:
                    raise
        return self.cached_prompt