이전 글에서는 브라우저가 HTML을 DOM으로 변환한다는 사실을 알아봤다.
<section>
  <h2>관심사</h2>
  <p>요즘 HTML과 CSS를 공부하고 있다.</p>
</section>
우리가 보기에는 태그 몇 개와 글자로 이루어진 코드다. 하지만 브라우저 안에서는 다음과 같은 DOM 트리가 만들어진다.
section
├── h2
│   └── "관심사"
└── p
    └── "요즘 HTML과 CSS를 공부하고 있다."
그런데 HTML 문자열이 어떻게 부모와 자식 관계를 가진 트리로 바뀌는 걸까?
이해, 분해, 재구축. 이번에는 HTML을 연성해보자.
HTML 파싱 과정도 연금술과 비슷하게 바라볼 수 있다.
- HTML 문법과 현재 상태를 기준으로 코드를 이해한다.
- 문자열을 태그와 글자 등의 토큰으로 분해한다.
- 분해한 토큰을 부모와 자식 관계를 가진 DOM으로 재구축한다.
물론 브라우저가 실제로 연금술을 사용하는 것은 아니다. HTML 파서와 정해진 파싱 규칙이 이 과정을 담당한다.
이번 글에서는 하나의 HTML 문서가 어떤 과정을 거쳐 DOM 트리가 되는지 알아보려고 한다.
1. HTML 파서: 연성을 담당하는 규칙
브라우저가 HTML 문서를 받았다고 해서 바로 DOM이 만들어지는 것은 아니다.
HTML은 처음에는 다음과 같은 문자열에 가깝다.
<h1 class="title">HTML 연성 시작</h1>브라우저는 이 문자열에서 어디까지가 태그인지, 어떤 부분이 속성인지, 어떤 내용이 글자인지 구분해야 한다.
이 작업을 담당하는 것이 HTML 파서(Parser)다.
HTML 파싱 과정은 크게 두 부분으로 나눌 수 있다.
HTML 문자열
    ↓
Tokenizer
    ↓
HTML Token
    ↓
Tree Builder
    ↓
DOM TreeTokenizer는 HTML 문자열을 의미 있는 토큰으로 분해한다.
Tree Builder는 만들어진 토큰을 이용해 부모와 자식 관계를 가진 DOM 트리를 구성한다.
연금술에 비유하면 Tokenizer는 재료를 분해하는 과정이고, Tree Builder는 분해한 재료를 새로운 구조로 재구축하는 과정이다.
HTML 파서는 두 작업을 정해진 HTML 파싱 규칙에 따라 진행한다. 따라서 같은 HTML 문서를 파싱하면 브라우저마다 제멋대로 다른 DOM을 만드는 것이 아니라, 기본적으로 같은 구조를 만들 수 있다.
2. Tokenizer: HTML을 토큰으로 분해한다
HTML 파서가 가장 먼저 하는 일은 HTML 문자열을 브라우저가 구분할 수 있는 단위로 나누는 것이다.
이 과정을 토큰화(Tokenization)라고 하고, 토큰화를 담당하는 부분을 Tokenizer라고 한다.
다음 HTML을 토큰화해보자.
<h1 class="title">HTML 연성 시작</h1>Tokenizer는 이 코드를 대략 다음과 같은 토큰으로 분해한다.
StartTag Token
├── tagName: h1
└── class: title

Character Token
└── "HTML 연성 시작"

EndTag Token
└── tagName: h1
<h1 class="title">은 요소의 시작과 속성 정보를 가진 StartTag Token이 된다.
태그 사이에 있는 HTML 연성 시작은 Character Token이 되고, </h1>은 요소의 끝을 알리는 EndTag Token이 된다.
HTML Token에는 다음과 같은 종류가 있다.
- DOCTYPE Token: 문서 형식을 나타낸다.
- StartTag Token: 요소의 시작 태그와 속성을 나타낸다.
- EndTag Token: 요소의 종료 태그를 나타낸다.
- Character Token: 태그 사이의 글자를 나타낸다.
- Comment Token: HTML 주석을 나타낸다.
- End-of-file Token: HTML 문서의 끝을 나타낸다.
설명의 편의를 위해 글자를 하나의 Character Token으로 묶어 표현했지만, 실제 파싱 과정에서는 각각의 문자가 Character Token으로 처리될 수 있다.
연금술에 비유하면 Tokenizer는 재구축에 사용할 재료를 먼저 분해하는 단계다. 아직 DOM 요소를 만드는 것이 아니라 HTML을 구성하는 재료만 구분한다.
재구축은 아직이다. 지금은 분해 단계다.
하지만 Tokenizer는 단순히 <와 >를 기준으로 문자열을 자르는 것이 아니다. 현재 어떤 내용을 읽고 있는지에 따라 같은 문자도 다르게 해석해야 한다.
이를 위해 Tokenizer는 상태 머신(State Machine)으로 동작한다.
3. State Machine: 현재 상태에 따라 문자를 해석한다
Tokenizer는 단순히 <와 >를 기준으로 HTML을 자르지 않는다.
문자를 하나씩 읽으면서 현재 어떤 상태인지 확인하고, 읽은 문자를 어떻게 처리할지 결정한다. 이런 동작 방식을 상태 머신(State Machine)이라고 한다.
다음 HTML을 읽는 과정을 살펴보자.
<p>안녕</p>Tokenizer는 처음에 Data State에서 문자를 읽기 시작한다.
시작 태그를 읽는 과정
| 현재 상태 | 읽은 문자 | 처리 결과 |
|---|---|---|
| Data State | < | Tag Open State로 이동 |
| Tag Open State | p | 시작 태그 이름을 읽기 시작 |
| Tag Name State | > | 태그 이름 읽기 종료 |
최종적으로 다음 토큰이 만들어진다.
StartTag Token(p)각 상태에서 하는 일은 다음과 같다.
-
Data State
- 일반적인 글자를 읽는 기본 상태다.
<를 만나면 태그가 시작되는지 확인하기 위해 상태를 변경한다.
-
Tag Open State
<다음에 어떤 문자가 오는지 확인한다.- 알파벳이 나오면 시작 태그로 판단한다.
/가 나오면 종료 태그를 확인하는 상태로 이동한다.
-
Tag Name State
- 태그 이름을 읽는다.
>를 만나면 태그 토큰을 완성하고 다시 Data State로 돌아간다.
따라서 <p>는 한 번에 처리되는 것이 아니다.
<  → 태그가 시작되는가?
p  → 태그 이름은 p인가?
> → 태그가 끝났는가?<p>의 처리가 끝나면 Tokenizer는 다시 Data State로 돌아간다. 이후 안녕이라는 글자를 읽고 Character Token을 만든다.
Character Token("안녕")종료 태그를 읽는 과정
이번에는 </p>를 처리하는 과정이다.
| 현재 상태 | 읽은 문자 | 처리 결과 |
|---|---|---|
| Data State | < | Tag Open State로 이동 |
| Tag Open State | / | End Tag Open State로 이동 |
| End Tag Open State | p | 종료 태그 이름을 읽기 시작 |
| Tag Name State | > | 태그 이름 읽기 종료 |
최종적으로 다음 토큰이 만들어진다.
EndTag Token(p)같은 문자라도 현재 상태에 따라 역할이 달라질 수 있다. Tokenizer는 현재 상태를 기억하면서 HTML을 순서대로 해석한다.
이렇게 만들어진 토큰은 바로 화면에 그려지는 것이 아니다. 다음 단계에서 Tree Builder가 토큰을 전달받아 DOM 노드로 재구축한다.
4. Tree Builder: 토큰을 DOM으로 재구축한다
Tokenizer가 만든 토큰은 Tree Builder로 전달된다.
Tree Builder는 전달받은 토큰의 종류를 확인하고, 필요한 DOM 노드를 생성해 부모와 자식 관계를 만든다.
다음 HTML을 다시 살펴보자.
<section>
  <p>안녕</p>
</section>
Tokenizer는 이 HTML을 다음과 같은 토큰으로 분해한다.
StartTag Token(section)
StartTag Token(p)
Character Token("안녕")
EndTag Token(p)
EndTag Token(section)
Tree Builder는 토큰을 순서대로 처리한다.
| 전달받은 토큰 | Tree Builder가 하는 일 |
|---|---|
StartTag Token(section) | section 요소 노드를 생성한다. |
StartTag Token(p) | p 요소 노드를 만들고 section의 자식으로 추가한다. |
Character Token("안녕") | 텍스트 노드를 만들고 p의 자식으로 추가한다. |
EndTag Token(p) | 현재 열려 있는 p 요소를 닫는다. |
EndTag Token(section) | 현재 열려 있는 section 요소를 닫는다. |
모든 토큰을 처리하면 다음과 같은 DOM 트리가 만들어진다.
section
└── p
    └── Text("안녕")
Tokenizer가 HTML을 재료 단위로 분해했다면, Tree Builder는 분해된 재료를 부모와 자식 관계를 가진 새로운 구조로 '재구축'한다.
에드워드… 오빠…(재구축된 니나와 알렉산더)
물론 Tree Builder가 서로 다른 대상을 합성하는 것은 아니다. 전달받은 토큰을 바탕으로 요소 노드와 텍스트 노드를 만들고, 각 노드의 부모와 자식 관계를 구성한다.
그렇다면 Tree Builder는 새로운 요소를 어느 노드의 자식으로 추가해야 하는지 어떻게 알 수 있을까?
이를 위해 브라우저는 현재 열려 있는 요소를 열린 요소의 스택(Stack of Open Elements)에 기록한다.
5. 열린 요소의 스택: 부모 요소를 기억한다
Tree Builder는 새로운 노드를 만들 때 어느 요소의 자식으로 추가해야 하는지 알아야 한다.
이를 위해 HTML 파서는 현재 열려 있는 요소들을 열린 요소의 스택(Stack of Open Elements)에 기록한다.
스택은 가장 나중에 들어온 데이터가 가장 먼저 나가는 LIFO(Last In, First Out) 구조다.
접시를 쌓을 때

가장 먼저 쌓은 접시
↓
[접시 1]
[접시 2]
[접시 3] ← 가장 나중에 쌓은 접시부터 꺼낸다
HTML 요소도 비슷한 방식으로 관리된다.
<section>
  <p>안녕</p>
</section>
설명을 단순하게 하기 위해 html과 body가 이미 스택에 들어 있다고 가정해보자.
| 전달받은 토큰 | 열린 요소의 스택 | 처리 내용 |
|---|---|---|
| 시작 | html → body | body가 현재 요소다. |
StartTag(section) | html → body → section | section을 스택에 추가한다. |
StartTag(p) | html → body → section → p | p를 스택에 추가한다. |
Character("안녕") | html → body → section → p | 현재 요소인 p에 텍스트를 추가한다. |
EndTag(p) | html → body → section | p를 스택에서 제거한다. |
EndTag(section) | html → body | section을 스택에서 제거한다. |
스택의 가장 마지막에 있는 요소가 현재 작업 중인 요소가 된다.
Character Token("안녕")을 처리할 때 스택의 마지막에는 p가 있다. 따라서 만들어진 텍스트 노드는 p의 자식으로 추가된다.
section
└── p
    └── Text("안녕")
시작 태그를 만나면 새로운 요소를 스택에 추가하고, 종료 태그를 만나면 해당 요소를 닫으며 스택에서 제거한다. 이를 통해 Tree Builder는 각 노드의 부모와 자식 관계를 결정할 수 있다.
다만 실제 HTML 파서는 모든 태그를 단순히 추가하고 제거하기만 하는 것은 아니다. 닫아야 할 태그가 없거나 요소가 잘못 중첩되어 있다면 HTML 파싱 규칙에 따라 구조를 복구한다.
6. 오류 복구: 잘못된 HTML도 파싱을 멈추지 않는다
HTML 파서는 문법에 맞지 않는 코드를 발견해도 문서 전체의 파싱을 바로 중단하지 않는다.
대신 HTML 표준에 정의된 오류 복구 규칙에 따라 DOM 구조를 조정한다.
다음 HTML을 살펴보자.
<table>
  <p>표 안에 작성한 문장</p>
  <tr>
    <td>표의 내용</td>
  </tr>
</table>
코드만 보면 p가 table의 자식처럼 보인다.
하지만 p는 table 바로 아래에 올 수 있는 요소가 아니다. 그렇다면 브라우저는 이 HTML을 어떻게 처리할까?
직접 확인해보기
아래 예제에서는 HTML을 브라우저가 실제 DOM으로 변환하는 과정을 확인할 수 있다.
먼저 DOM으로 변환 버튼을 누르기 전 화면이다.
실행 전
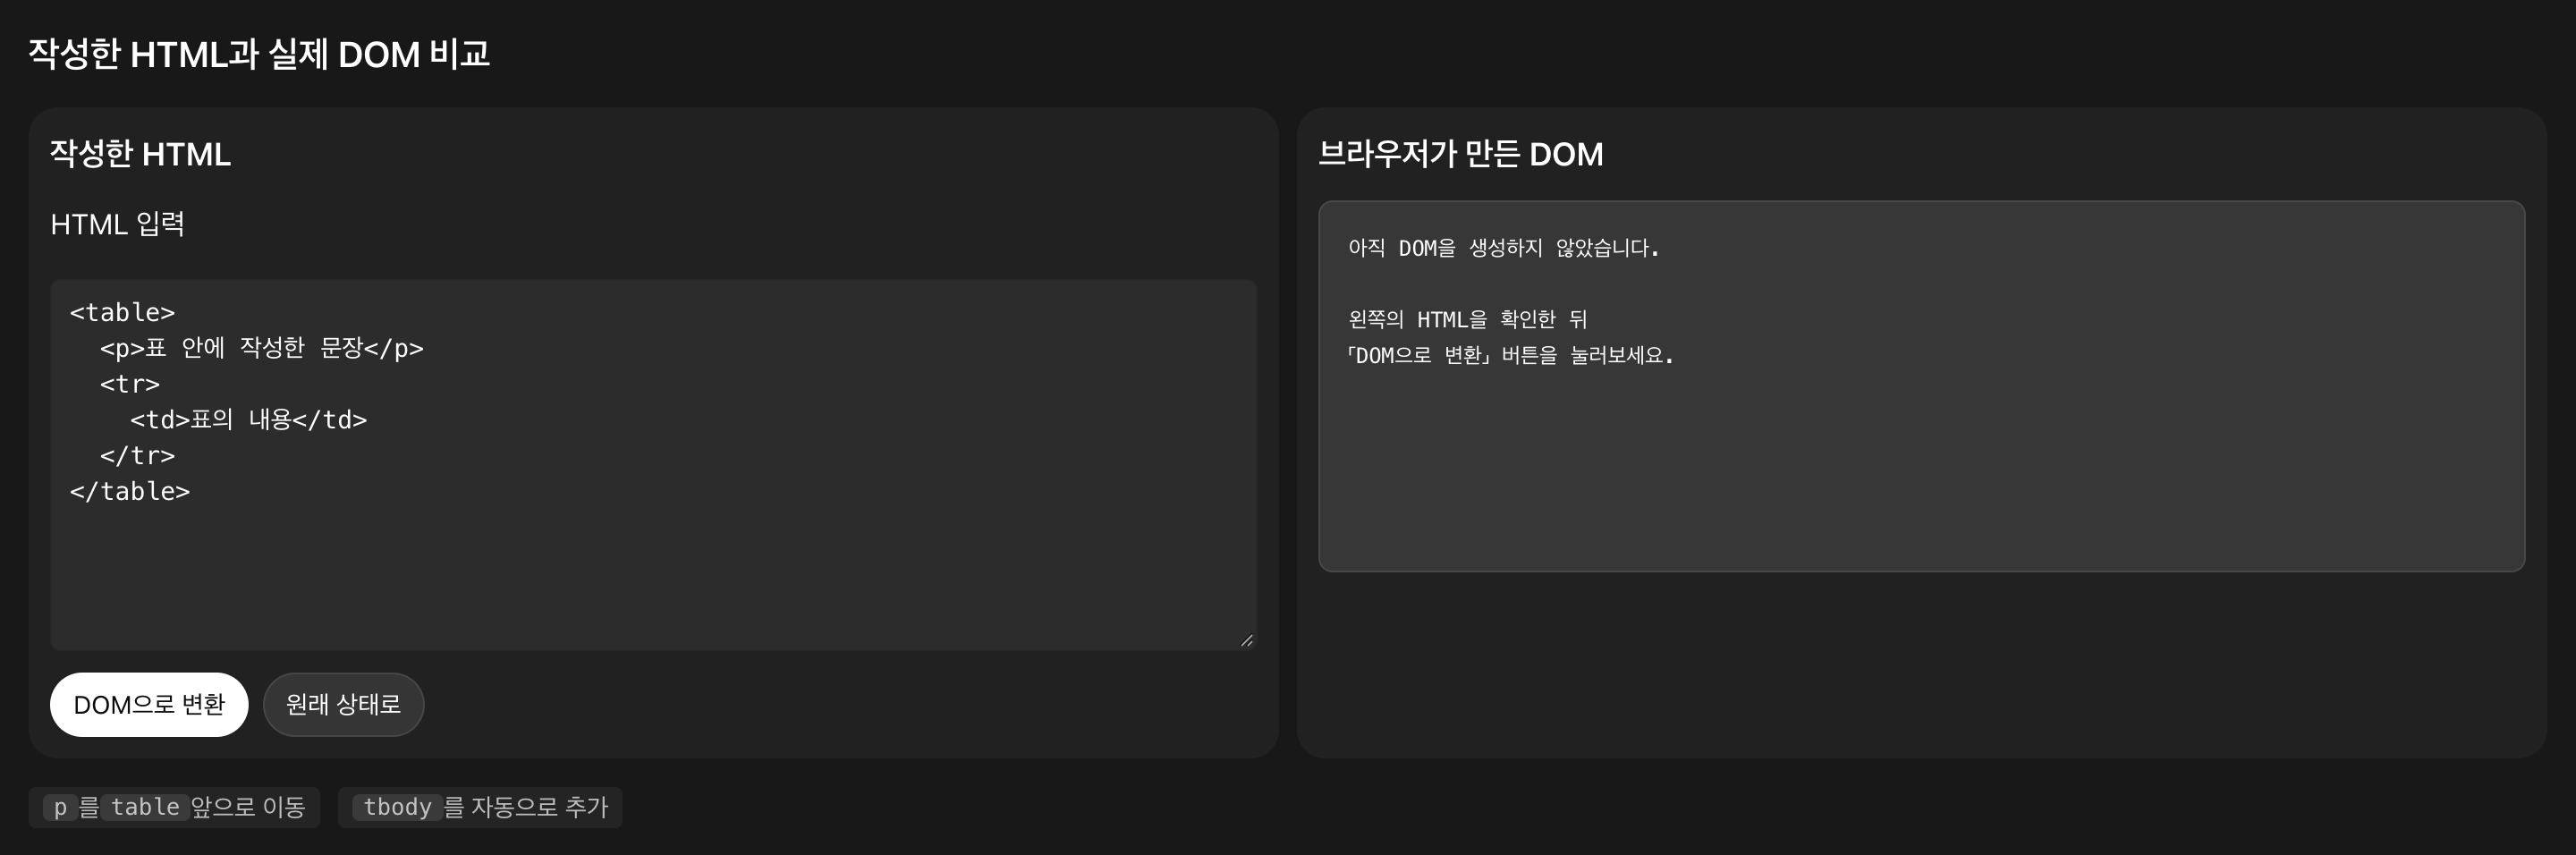
왼쪽에는 작성한 HTML이 있고, 오른쪽의 DOM 결과는 아직 비어 있다.
이제 DOM으로 변환 버튼을 눌러보자.
실행 후
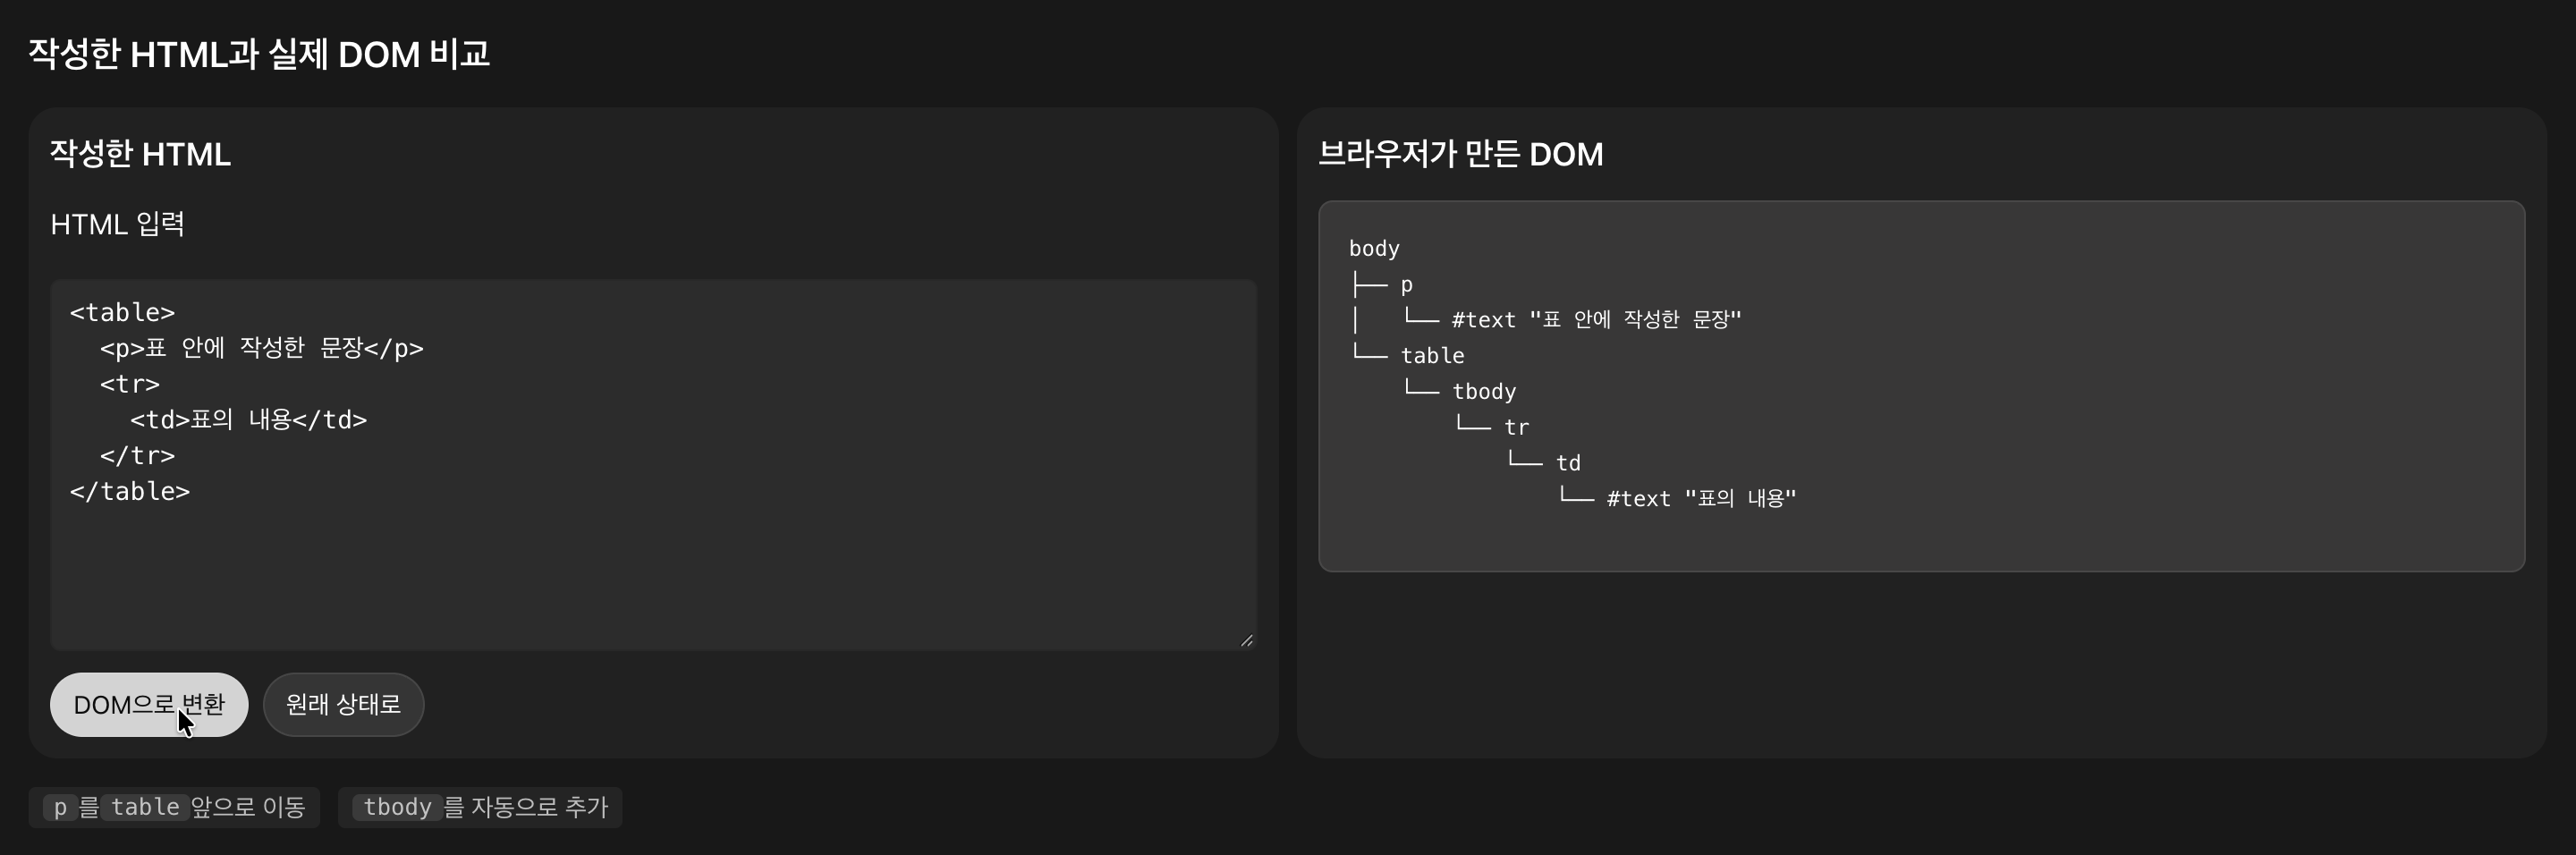
브라우저가 만든 DOM을 트리로 표현하면 다음과 같다.
body
├── p
│   └── Text("표 안에 작성한 문장")
└── table
    └── tbody
        └── tr
            └── td
                └── Text("표의 내용")
작성한 HTML과 실제 DOM을 비교하면 두 가지가 달라졌다.
p요소가table앞으로 이동했다.- 직접 작성하지 않은
tbody요소가 추가되었다.
p는 왜 앞으로 이동했을까?
HTML 파서는 table 안에 올 수 없는 콘텐츠를 발견하면 적절한 위치로 이동시킬 수 있다.
표 안에 잘못 들어간 콘텐츠를 table 밖으로 이동시키는 이 동작을 Foster Parenting이라고 한다.
따라서 table 안에 작성했던 p가 실제 DOM에서는 table의 앞쪽 형제 요소가 된다.
tbody는 왜 생겼을까?
tr은 표의 행을 나타내는 요소다. Tree Builder는 tr을 처리하는 과정에서 필요한 tbody 요소를 생성하고, tr을 그 안에 추가한다.
우리가 작성한 HTML에는 tbody가 없지만 실제 DOM에는 존재하는 이유다.
HTML 파서가 코드를 마음대로 수정하는 것은 아니다. 어떤 구조를 만나면 어떻게 처리할지 HTML 표준에 오류 복구 방법이 정해져 있다.
따라서 작성한 HTML과 실제 DOM은 항상 같지 않을 수 있다. 브라우저 개발자 도구에서 확인하는 DOM은 원본 HTML이 아니라, 파싱과 오류 복구를 거쳐 완성된 결과다.
이 결과를 예상했다면 HTML 파싱 과정을 제대로 이해한 것이다.
정답이다, 연금술사.
7. 정리: HTML 연성 완료
지금까지 HTML 문자열이 DOM 트리가 되는 과정을 살펴봤다.
HTML 문자열
    ↓
Tokenizer
    ↓
HTML Token
    ↓
Tree Builder
    ↓
DOM Tree
각 단계에서 일어난 일을 정리하면 다음과 같다.
-
HTML Parser
- 브라우저가 HTML 문서를 해석한다.
-
Tokenizer
- HTML 문자열을 시작 태그, 종료 태그, 글자 등의 토큰으로 분해한다.
-
State Machine
- 현재 상태에 따라 각각의 문자를 어떻게 해석할지 결정한다.
-
Tree Builder
- Tokenizer가 전달한 토큰으로 요소 노드와 텍스트 노드를 만든다.
-
열린 요소의 스택
- 현재 열려 있는 요소를 기록해 노드의 부모와 자식 관계를 결정한다.
-
오류 복구
- 잘못된 HTML을 만나도 파싱을 중단하지 않고 정해진 규칙에 따라 DOM을 구성한다.
연금술에 비유하면 HTML 파싱은 이해, 분해, 재구축의 과정과 닮아 있다.
| 연금술 | HTML 파싱 |
|---|---|
| 이해 | HTML 문법과 현재 상태를 확인한다. |
| 분해 | HTML 문자열을 토큰으로 나눈다. |
| 재구축 | 토큰으로 DOM 트리를 만든다. |
HTML 문자열은 브라우저가 바로 사용할 수 있는 구조가 아니다. 브라우저는 문자열을 토큰으로 분해하고, 각 토큰을 부모와 자식 관계를 가진 DOM으로 재구축한다.
물론 오류 복구 과정에서 요소가 추가되거나 위치가 바뀔 수 있으므로 HTML과 DOM이 항상 완전히 같은 것은 아니다.
그래도 HTML 문자열을 내어주고 브라우저가 사용할 수 있는 DOM 트리를 얻었다.
HTML 문자열을 내어주고 DOM 트리를 얻는다. 이것이 등가교환이다.
다음 글
다음 글에서는 하나의 요소에 여러 CSS가 동시에 적용될 때 브라우저가 어떤 스타일을 선택하는지 알아보려고 한다.
CSS의 Cascade, 상속, 명시도 그리고 선택자의 우선순위를 다룰 예정이다.
다음은 CSS의 권력 다툼이다. 기다려.
이거지. 이게 블로그지. That's what I want!
잘 봤습니다. 민...식...오...빠