상관관계
- 두 변수간의 관계를 보여주는 지표로, 두 변수 간의 관계를 수치적으로 나타내는 방법 중 하나
- 어떤 변수가 증가할때 다른 변수도 함께 증가하거나 감소하는 경우, 두 변수 간에는 어느 정도의 관련성이 있다고 할 수 있음
- 두 변수 x와 y가 있을 때, x가 증가함에 따라 y도 증가하는 경우, 두 변수 간에는 양의 상관관계
- 반대로, x가 증가함에 따라 y가 감소하는 경우, 두 변수 간에는 음의 상관관계
- 두 변수 간에 상관관계가 있다고 해서 두 변수 간에 인과관계가 있거나, 한 변수가 다른 변수를 일으킨 원인이 되는 것은 아니다.
r이 -1.0과 -0.7 사이 : 강한 음적 선형관계
r이 -0.7과 -0.3 사이 : 뚜렷한 음적 선형관계
r이 -0.3과 -0.1 사이 : 약한 음적 선형관계
r이 -0.1과 +0.1 사이 : 거의 무시될 수 있는 선형관계
r이 +0.1과 0.3 사이 : 약한 양적 선형관계
r이 +0.3과 +0.7 사이 : 뚜렷한 양적 선형관계
r이 +0.7과 +1.0 사이 : 강한 양적 선형관계
상관계수
- 두 변수 간의 관련성을 측정하는 방법
- 상관계수는 -1에서 1사이의 값을 가지며, 값이 0 에 가까울수록 두 변수 간의 관련성이 적다는 것을 의미한다.
- 상관계수는 두 변수 간의 공분산을 각 변수의 표준편차로 나눈 값으로 계산
- 공분산은 두 변수 간의 관련성을 나타내는 지표로, 값이 양수일 경우 두 변수가 함께 증가하거나 감소하고, 값이 음수일 경우두 변수가 반대 방향으로 움직임
- 상관계수는 주로 피어슨 상관계수를 사용한다.
공분산
- 두 변수가 함께 변화하는 정도를 나타내는 지표
부호
- 공분산이 +인 경우 : 두 변수가 같은 방향으로 변화 (하나가 증가하면 다른 하나도 증가)
- 공분산이 -인 경우 : 두 변수가 반대 방향으로 변화 (하나가 증가하면 다른 하나는 감소)
크기
- 공분산의 크기가 클수록 두 변수는 함께 많이 변화
- 단위에 따라 공분산의 크기가 달라지므로 절대적 크기로 판단이 어려움
- 공분산을 -1 ~ 1 범위로 표준화시킨 것이 상관계수
import maplotlib.pyplot as plt
import numpy as np

x = [7,3,6,8,8,3,2,6,7,8]
y = [4,4,5,6,7,2,1,8,4,5]

plt.plot(x,y,'o')

np.cov(x,y)[0,1]
당뇨데이터 상관관계 분석
import pandas as pd
import numpy as np
from sklearn import datasets

data = datasets.load_diabetes() #사이킷런의 당뇨데이터 로드

print(data)
# 딕셔너리 데이터 키값 확인
data.keys()
# 데이터 프레임으로 변환 컬럼명은 feature_names의 value
df = pd.DataFrame(data['data'],columns=data['feature_names'])
df
# 당뇨수치 데이터 target 컬럼으로 insert
df['target'] = data['target']
df
#pandas corr함수로 상관관계 분석
df.corr()
import seaborn as sns

sns.heatmap(df.corr())
plt.show()

import matplotlib.pyplot as plt

x = df.bmi
y = df.target

plt.scatter(x,y,alpha = 0.5)
plt.xlabel('BMI')
plt.ylabel('TARGET')
plt.show()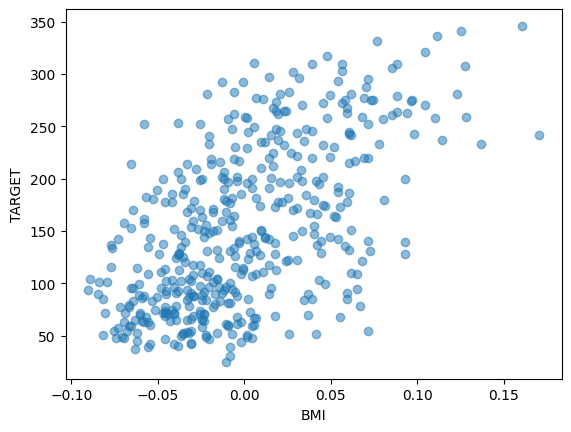
x = df.s3.values
y = df.target.values

plt.scatter(x,y,alpha=0.5)
plt.xlabel('S3')
plt.ylabel('TARGET')
plt.show()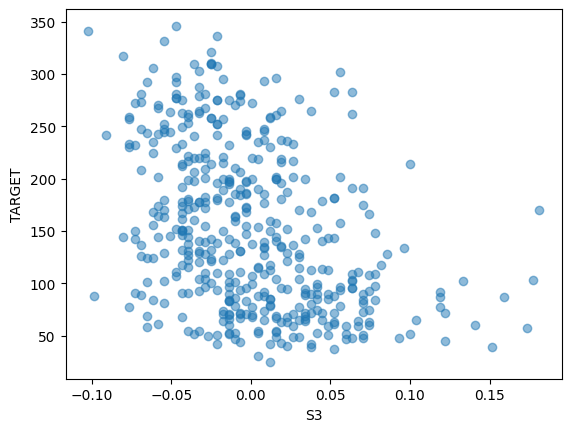
import scipy.stats as stats

x = df.s3.values
y = df.target.values

stats.pearsonr(x,y)

#p-value가 0에 가까움으로 귀무가설 '상관관계가 없다'를 기각
회귀
- 여러 개의 독립변수와 한 개의 종속변수 간의 상관고나계를 모델링하는 기법
- 지하철역까지의 거리, 주변 학군 등의 독립변수에 따라 아파트 가격이라는 종속변수가 어떤 관계인지 예측
머신러닝에서 독립변수는 feature, 종속변수는 결정값에 해당
feature의 결정 값 데이터에서 학습을 통해 최적의 회귀 계수를 찾아내는 것
데이터 전처리
표준화 : 피처들을 평균이 0이고 분산이 1인 가우시안 정규 분포를 가진 값으로 변환
정규화 : 피처들의 크기를 통일하기 위해 크기를 변환하는 것, 값을 최소 0 ~ 최대 1의 값으로 변환
StandardScaler
- 표준화를 지원해주는 함수로 피처들을 평균이 0이고 분산이 1인 값으로 변환
- ML 알고리즘들은 표준화를 적용하는 것이 예측 성능 향상에 중요한 요소로 작용
MinMaxScaler - 데이터의 값들을 0과 1 사이의 범위 값으로 변환
- 데이터들의 분포가 가우시안 분포가 아닐 경우에 적용
StandatdScaler
from sklearn.datasets import load_iris
import pandas as pd

iris = load_iris() # iris 데이터를 불러옴
iris_data = iris.data

iris_df=pd.DataFrame(data=iris_data,columns=iris.feature_names)
iris_df.head()
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(iris_df) #학습
iris_scaled = scaler.transform(iris_df) #적용
iris_scaledMinMaxSacler
from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler()
scaler.fit(iris_df)
iris_scaled=scaler.transform(iris_df)

df_scaled=pd.DataFrame(data=iris_scaled,columns=iris.feature_names)
df_scaled
train_test_split
머신러닝 모델을 학습하고 그 결과를 검증하기 위해서는 원래의 데이터를 Training,Validation,Testing의 용도로 나누어서 사용해야함
Training에서 사용한 데이터를 검증용으로 사용하면 과접합의 문제가 생겨 성능에 문제가 생김
trian_test_split : 사이킷런에서 데이터를 학습과 검증데이터로 분리하는데 사용하는 함수
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

dataset = load_iris()

data = dataset['data']
target = dataset['target']

#train_test_split
X_train, X_test, y_train, y_test = \
	train_test_split(data,target, test_size = 0.2,
    				 shuffle = True, stratify = target, random_state=34)
test_size : 테스트 셋 구성의 비율
test_size = 0.2는 전체 데이터 셋의 20%를 test셋으로 지정한다는 의미
shuffle : default = True
split을 하기 전 섞을 건지 여부
stratify : default = None
stratify 값을 target으로 지정해주면 각각의 class 비율을 train/ validation에 유지. 이 옵션을 지정해주지 않으면 성능의 차이가 많이 날 수 있음
random_state : 이 값ㅇ르 고정해두고 튜닝해야 매번 데이터셋이 변경되는 것을 방지
유방암 예측 Logisticregression
import pandas as pd
import matplotlib.pyplot as plt
%matplotlib inline
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LogisticRegression

data = load_breast_cancer()
data
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
#StandardScaler : 평균이 0, 분산 1로 데이터 분포도 변환
scaler = StandardScaler()
data_scaled = scaler.fit_transform(data.data)
X_train, X_test, y_train, y_test = train_test_split(data_scaled, data.target, test_size=0.3,random_state=0)from sklearn.metrics import accuracy_scaore, roc_auc_score
#로지스틱 회귀를 이용하여 학습 : 결과값이 1과 0으로
lr_clf = LogisticRegression()
lr_clf.fit(X_train,y_train)
lr_preds = lr_clf.predict(X_test)
#accuracy와 roc_auc 측정
print('acc : ',accuracy_score(y_test,lr_preds))
print('roc : ',roc_auc_score(y_test, lr_preds))colab
https://colab.research.google.com/drive/111Q9rEdMxkLQdCGeRIPDKc7Yb7X5rkmJ?usp=sharing