실전 RAG 구현 가이드: 던전톡 TRPG AI 시스템 분석 (시리즈 2/3)
첫 번째 시리즈에서 RAG의 기본 개념을 다뤘다면, 이번에는 실제 운영 중인 RAG 시스템을 분석해보겠습니다. 던전톡 TRPG AI 시스템의 실제 구현 사례를 통해 RAG 시스템의 실전 노하우를 살펴보겠습니다.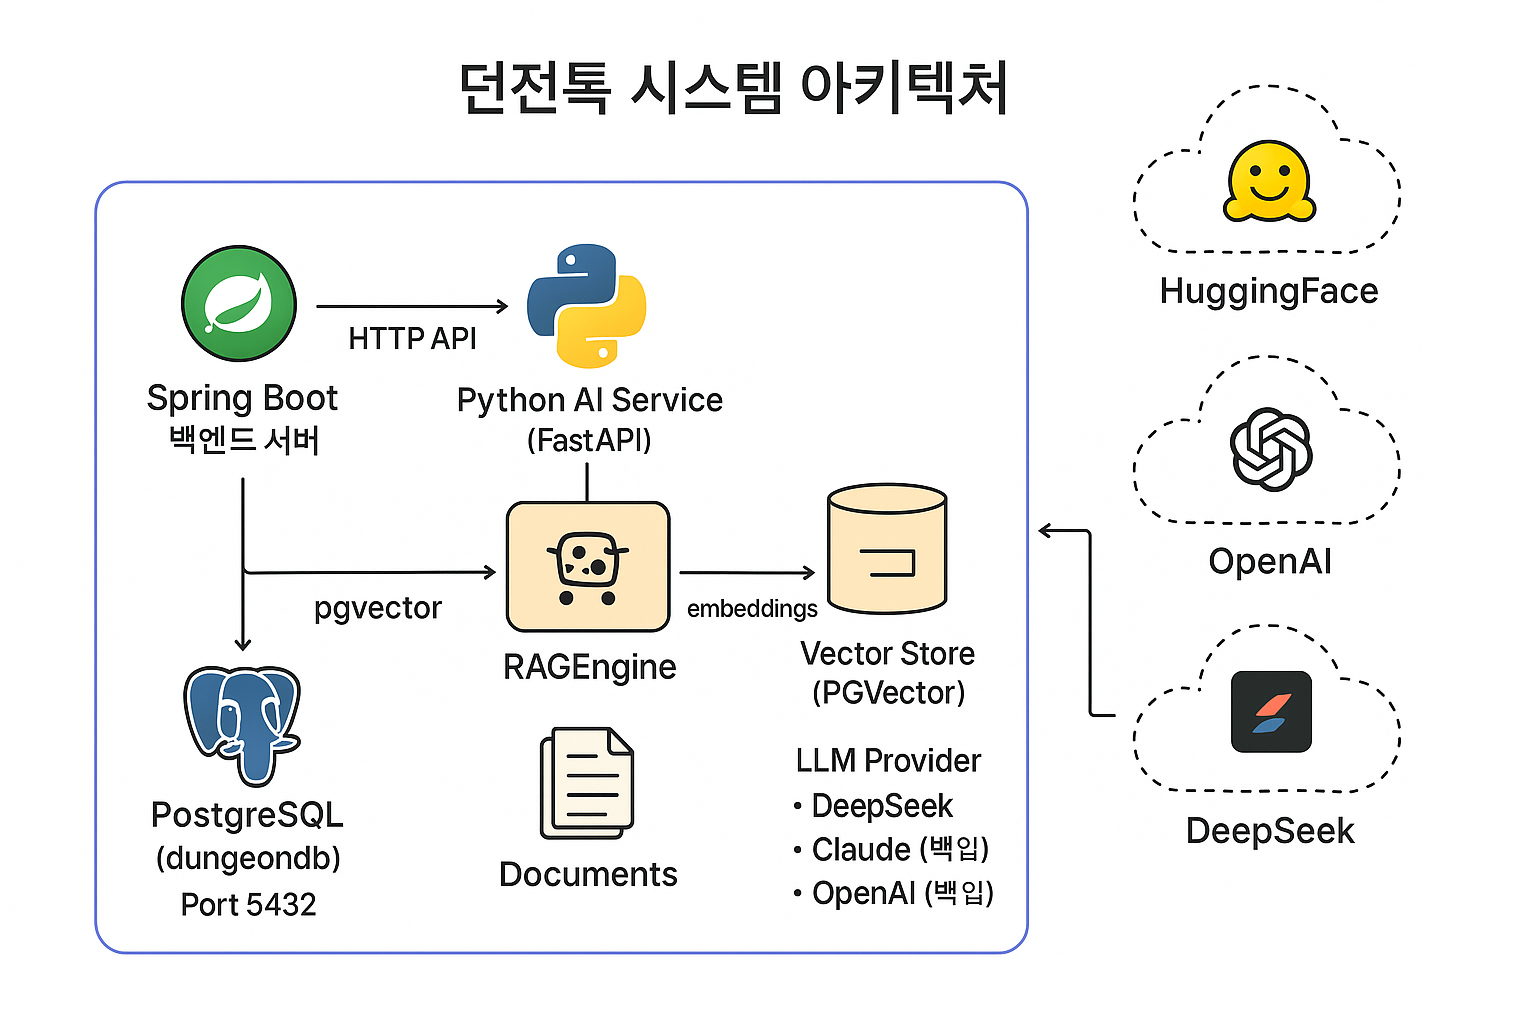
1. 프로젝트 개요: 던전톡 AI 시스템
던전톡은 Spring Boot 백엔드와 Python FastAPI 기반의 AI 마이크로서비스로 구성된 TRPG 게임 시스템입니다. RAG 기술을 활용하여 게임 마스터(GM) 역할을 하는 AI가 플레이어들의 행동에 맞춰 스토리를 전개합니다.
시스템 아키텍처
┌──────────────────┐    HTTP API     ┌─────────────────────────────┐
│   Spring Boot    │◄──────────────►│     Python AI Service      │
│   백엔드 서버     │   (Port 8001)   │      (FastAPI)             │
│   (Port 8080)    │                │                             │
└──────────────────┘                └─────────────────────────────┘
         │                                        │
         ▼                                        ▼
┌──────────────────┐                 ┌─────────────────────────────┐
│   PostgreSQL     │◄────────────────│       RAGEngine             │
│   (dungeondb)    │   pgvector      │                             │
│   Port 5432      │   embeddings    │                             │
└──────────────────┘                 └─────────────────────────────┘
2. 의존성 관리와 기술 스택
실제 프로젝트의 pyproject.toml을 살펴보면 현대적인 RAG 시스템에 필요한 핵심 라이브러리들을 확인할 수 있습니다:
[project]
name = "dungeontalk-mvp"
version = "0.1.0"
requires-python = ">=3.13"
dependencies = [
    "fastapi>=0.116.1",
    "langchain>=0.3.27",
    "langchain-anthropic>=0.3.18",
    "langchain-community>=0.3.27",
    "langchain-huggingface>=0.3.1",
    "langchain-ollama>=0.3.6",
    "langchain-openai>=0.3.28",
    "langchain-postgres>=0.0.15",  # PostgreSQL pgvector 지원
    "psycopg2-binary>=2.9.10",
    "psycopg[binary]>=3.2.9",      # 최신 PostgreSQL 드라이버
    "sentence-transformers>=5.1.0",
    "uvicorn[standard]>=0.35.0",
]
주목할 점들:
- 다중 LLM 지원: Anthropic Claude, OpenAI, Ollama 모두 지원
- PostgreSQL + pgvector: Chroma 대신 PostgreSQL의 pgvector 확장 사용
- 최신 LangChain: 0.3.x 버전으로 최신 기능 활용
3. 핵심 RAGEngine 클래스 분석
실제 구현된 RAGEngine 클래스의 핵심 구조를 살펴보겠습니다:
class RAGEngine:
    def __init__(self):
        # 임베딩 모델 선택 (원격/로컬)
        use_remote = os.getenv("USE_REMOTE_EMBEDDINGS", "false").lower() == "true"

        if use_remote:
            self.embeddings = OpenAIEmbeddings(
                model=os.getenv("OPENAI_EMBEDDING_MODEL", "text-embedding-3-small"),
                api_key=os.getenv("OPENAI_API_KEY")
            )
        else:
            self.embeddings = HuggingFaceEmbeddings(
                model_name=os.getenv("EMBEDDING_MODEL", "intfloat/multilingual-e5-large"),
                model_kwargs={'device': 'cpu'},
                encode_kwargs={'normalize_embeddings': True}
            )

        # PostgreSQL PGVector 벡터스토어
        connection_string = f"postgresql://{user}:{password}@{host}:{port}/{db}?options=-csearch_path%3Ddungeontalk_rag%2Cpublic"

        self.vectorstore = PGVector(
            embeddings=self.embeddings,
            connection=connection_string,
            collection_name="documents",
            distance_strategy="cosine"
        )

        # 다중 LLM 제공자 지원
        llm_provider = os.getenv("LLM_PROVIDER", "ollama").lower()

        if llm_provider == "claude":
            self.llm = ChatAnthropic(
                model=os.getenv("CLAUDE_MODEL", "claude-3-5-sonnet-20241022"),
                api_key=os.getenv("ANTHROPIC_API_KEY"),
                temperature=float(os.getenv("LLM_TEMPERATURE", "0.7"))
            )
        elif llm_provider == "deepseek":
            self.llm = ChatOpenAI(
                model=os.getenv("DEEPSEEK_MODEL", "deepseek-chat"),
                api_key=os.getenv("DEEPSEEK_API_KEY"),
                base_url="https://api.deepseek.com",
                temperature=float(os.getenv("LLM_TEMPERATURE", "0.7"))
            )
        else:
            self.llm = OllamaLLM(model="llama3.2", base_url="http://localhost:11434")
4. 스마트한 문서 처리 시스템
던전톡 시스템의 문서 처리 방식은 실제 운영 환경에서 마주치는 문제들을 해결하는 좋은 사례입니다:
4.1. 다중 인코딩 지원
def add_document(self, file_path: str):
    """문서를 벡터스토어에 추가 (다양한 인코딩 지원)"""
    try:
        # UTF-8 먼저 시도
        loader = TextLoader(file_path, encoding='utf-8')
        documents = loader.load()
    except UnicodeDecodeError:
        try:
            # CP949 (한국어 Windows 기본) 시도
            loader = TextLoader(file_path, encoding='cp949')
            documents = loader.load()
        except UnicodeDecodeError:
            try:
                # UTF-8 with BOM 시도
                loader = TextLoader(file_path, encoding='utf-8-sig')
                documents = loader.load()
            except Exception as e:
                print(f"[ERROR] 파일 인코딩을 감지할 수 없습니다: {e}")
                return
실전 팁: 한국어 문서를 다룰 때는 인코딩 문제가 자주 발생합니다. 순차적으로 여러 인코딩을 시도하는 것이 안전합니다.
4.2. 파일 변경 감지 시스템
def auto_embed_documents(self):
    """documents 폴더의 모든 파일을 자동으로 임베딩"""
    # 기존 해시 정보 로드
    existing_hashes = self.load_file_hashes()

    for file_path in glob.glob("./documents/**/*.txt", recursive=True):
        # 현재 파일 해시 계산
        current_hash = self.get_file_hash(file_path)

        # 이미 처리된 파일인지 확인
        if file_path in existing_hashes and existing_hashes[file_path] == current_hash:
            files_skipped += 1
            continue

        # 새로운 파일이거나 변경된 파일이면 임베딩
        print(f"[EMBED] 임베딩 중: {file_path}")
        self.add_document(file_path)
        files_processed += 1
실전 활용: MD5 해시를 이용한 변경 감지로 불필요한 재임베딩을 방지하여 성능을 크게 개선할 수 있습니다.
5. PostgreSQL + pgvector 활용
던전톡 시스템은 Chroma나 FAISS 대신 PostgreSQL의 pgvector 확장을 사용합니다. 이는 운영 환경에서 중요한 장점들을 제공합니다:
5.1. 왜 pgvector를 선택했나?
# PostgreSQL PGVector 벡터스토어 설정
base_connection = f"postgresql://{user}:{password}@{host}:{port}/{db}"
connection_string = f"{base_connection}?options=-csearch_path%3Ddungeontalk_rag%2Cpublic"

self.vectorstore = PGVector(
    embeddings=self.embeddings,
    connection=connection_string,
    collection_name="documents",
    distance_strategy="cosine"
)
pgvector의 장점:
- 영속성: 서버 재시작 후에도 데이터 유지
- 트랜잭션 지원: ACID 특성으로 데이터 무결성 보장
- 확장성: 기존 PostgreSQL 인프라와 통합
- 고성능: 인덱스를 통한 빠른 유사도 검색
5.2. 스키마 구조
-- dungeontalk_rag 스키마 내
CREATE TABLE langchain_pg_collection (
    uuid UUID PRIMARY KEY,
    name VARCHAR NOT NULL,
    cmetadata JSON
);

CREATE TABLE langchain_pg_embedding (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES langchain_pg_collection(uuid),
    embedding VECTOR(1536),  -- OpenAI embedding 차원
    document TEXT,
    cmetadata JSON
);
6. 컨텍스트 인식 AI 응답 생성
던전톡의 핵심 기능인 컨텍스트 기반 AI 응답 생성을 살펴보겠습니다:
def generate_ai_response(self, context_messages: List[dict], current_user: str, current_message: str):
    """Spring Boot에서 전달받은 컨텍스트로 AI 응답 생성"""

    # 컨텍스트 구성
    context = ""
    if context_messages:
        context = "\n이전 대화 기록:\n"
        for msg in context_messages:
            if msg.get('messageType') == 'USER':
                context += f"- {msg.get('senderNickname')}: {msg.get('content')}\n"
            elif msg.get('messageType') == 'AI':
                context += f"  GM: {msg.get('content')[:150]}...\n"

    trpg_question = f"""당신은 TRPG GM입니다. 다중 플레이어 게임을 진행해주세요.

{context}

현재 발언자: {current_user}
새로운 질문/행동: {current_message}

# 답변 형식 규칙:
1. 이전 대화 맥락을 고려하여 일관성 있게 답변해주세요
2. 현재 발언자({current_user})의 행동에 초점을 맞춰 답변해주세요
3. 다른 파티원들도 고려한 상황 묘사를 해주세요
4. 상황을 생생하게 묘사하고, 플레이어의 행동에 따라 스토리를 전개시킵니다
"""

    result = self.qa_chain.invoke({"query": trpg_question})

    return {
        "content": result["result"],
        "response_time": response_time,
        "sources": [doc.page_content[:100] + "..." for doc in result["source_documents"]]
    }
프롬프트 엔지니어링 포인트:
- 컨텍스트 요약: 긴 대화 기록을 압축하여 토큰 사용량 최적화
- 역할 명확화: TRPG GM 역할을 명확히 정의
- 출력 형식 지정: 일관된 응답 형식으로 사용자 경험 향상
7. 실제 게임 데이터 구조
던전톡 시스템에서 사용하는 실제 게임 데이터들을 살펴보면 RAG가 어떻게 활용되는지 알 수 있습니다:
documents/
├── NPC_닥터_리오.txt          # NPC 캐릭터 정보
├── NPC_스카웃_제시.txt
├── 세계관_개요_황혼의새벽.txt   # 게임 세계관
├── 시나리오_초반_폐허탐색.txt   # 시나리오 스크립트
├── 아이템_무기_총기류.txt      # 게임 아이템 정보
├── 장소_버려진고속도로.txt     # 게임 맵 정보
└── 퀘스트_유형_및_분기.txt     # 퀘스트 로직
이러한 구조화된 데이터를 통해 AI는 일관된 게임 세계관을 유지하면서 플레이어의 행동에 반응할 수 있습니다.
8. 마이크로서비스 아키텍처의 실전 적용
8.1. 서비스 분리의 장점
# FastAPI 앱 정의
app = FastAPI(title="던전톡 AI 응답 서비스")

# Spring Boot 연동용 데이터 모델
class AiResponseRequest(BaseModel):
    game_id: str
    ai_game_room_id: str
    current_user: str
    current_message: str
    context_messages: List[ContextMessage] = []
    turn_number: int

@app.post("/ai-response", response_model=AiResponseResult)
async def generate_ai_response(request: AiResponseRequest):
    """Spring Boot AiResponseController에서 호출하는 AI 응답 생성 API"""
마이크로서비스 분리 이점:
- 독립적 배포: AI 모델 업데이트 시 전체 시스템 중단 불필요
- 기술 스택 최적화: Python AI 생태계 활용
- 확장성: AI 서비스만 별도로 스케일링 가능
- 장애 격리: AI 서비스 장애가 전체 게임 시스템에 미치는 영향 최소화
8.2. 환경별 설정 관리
def validate_environment():
    """환경변수 검증"""
    llm_provider = os.getenv("LLM_PROVIDER", "ollama").lower()

    if llm_provider == "claude":
        api_key = os.getenv("ANTHROPIC_API_KEY")
        if not api_key or api_key.startswith("sk-ant-api03-여기에"):
            raise ValueError("ANTHROPIC_API_KEY가 설정되지 않았거나 예시 값입니다.")
9. 성능 최적화 및 모니터링
9.1. 응답 시간 추적
def generate_ai_response(self, context_messages, current_user, current_message):
    start_time = time.time()

    # AI 응답 생성 로직...

    end_time = time.time()
    response_time = int((end_time - start_time) * 1000)  # 밀리초

    return {
        "content": result["result"],
        "response_time": response_time,
        "sources": [doc.page_content[:100] + "..." for doc in result["source_documents"]]
    }
9.2. 청크 크기 최적화
chunk_size = int(os.getenv("CHUNK_SIZE", "1000"))
chunk_overlap = int(os.getenv("CHUNK_OVERLAP", "200"))

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=chunk_size,
    chunk_overlap=chunk_overlap
)
환경변수를 통한 동적 설정으로 운영 중에도 성능 튜닝이 가능합니다.
10. 실전 배포 고려사항
10.1. 다중 LLM 제공자 지원
# 환경변수에서 LLM 제공자 선택
llm_provider = os.getenv("LLM_PROVIDER", "ollama").lower()

if llm_provider == "claude":
    self.llm = ChatAnthropic(...)
elif llm_provider == "deepseek":
    self.llm = ChatOpenAI(base_url="https://api.deepseek.com", ...)
else:
    self.llm = OllamaLLM(...)  # 로컬 모델
비용 최적화 전략:
- DeepSeek: 기본 제공자 (저렴한 비용)
- Claude: 고품질 응답이 필요한 경우
- Ollama: 개발 환경 또는 비용 절약
10.2. 헬스체크 및 모니터링
@app.get("/health")
async def health():
    """서비스 상태 확인"""
    return {
        "status": "healthy",
        "service": "dungeontalk-ai-service",
        "llm_provider": os.getenv("LLM_PROVIDER", "ollama")
    }
11. 마무리
던전톡 시스템을 통해 살펴본 실전 RAG 구현의 핵심 포인트들:
- 다중 임베딩 지원: 비용과 성능의 균형
- PostgreSQL + pgvector: 안정적인 벡터 데이터베이스
- 파일 변경 감지: 효율적인 문서 관리
- 마이크로서비스 아키텍처: 확장성과 유지보수성
- 컨텍스트 인식: 게임 상황에 맞는 AI 응답
다음 시리즈(3편)에서는 RAG 시스템의 고급 최적화 기법과 실제 운영 환경에서의 성능 튜닝, 그리고 사용자 피드백을 통한 지속적인 개선 방법을 다룰 예정입니다.
참고 자료: