1. Jev란: TypeSafe AI의 System One Model
LLM에게 "JSON으로 답해줘"라고 부탁하는 대신, 처음부터 소프트웨어가 쓸 수 있는 판단을 받아오는 방법이다.
생성형 AI 중심의 시스템에서 벗어나 AI는 판단하고 코드는 통제하는 자동화 아키텍처이다.
판단 전용 모델
- 문장을 만들지 않는다. 대신 구조가 정해진 판단을 한다.
- 파싱할 것이 없다. 그리고 확률과 확신도가 함께 온다.
department   billing    confidence 1.00
             {billing: 1.00, technical: 0.00, sales: 0.00, other: 0.00}
refund       0.98
urgency      2.81       confidence 0.81
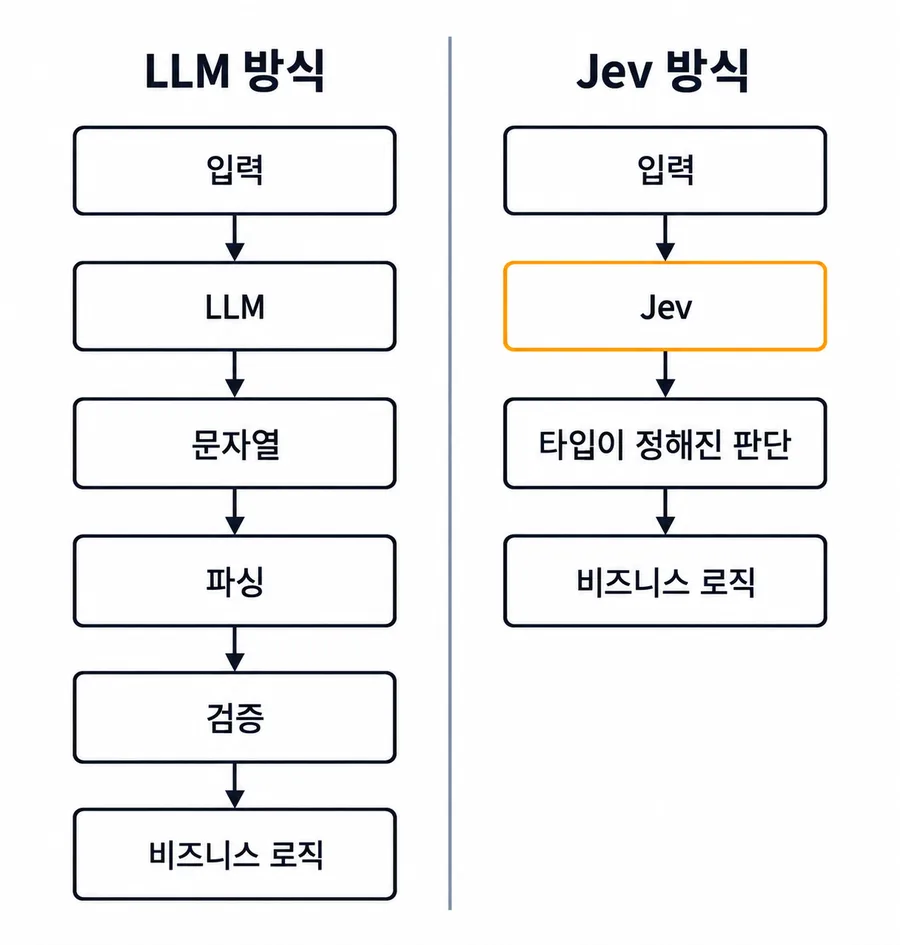
기존 LLM은 질문을 던지면 사람의 언어(줄글)로 대답하기 때문에, 프로그램에서 그 결괏값을 활용하려면 필요한 정보만 따로 떼어내는 '파싱(Parsing, 구문 분석)' 작업이 필요하다(예: 텍스트에서 JSON 형태만 추출). 반면, Jev는 문장을 생성하는 대신 처음부터 결괏값을 구조화된 데이터 형태로 반환하므로 번거로운 추출 과정이 필요 없다는 의미이다.
LLM은 보통 자신이 내놓은 답변에 대해 얼마나 확신하는지 수치로 알려주지 않는다. 하지만 Jev는 결괏값과 함께 그 판단이 맞을 확률과 확신도(Confidence)를 구체적인 숫자(예: 0.98, 1.00)로 함께 제공한다. 즉, AI가 낸 답을 '얼마나 믿고 써도 될지'를 개발자가 수치로 파악하고 제어할 수 있다는 뜻이다.
(출처: wikidocs)
기존 LLM은
- 느리다.
- 판단이 서로 다르다.
- 확신의 정도를 알 수 없다.
2. Jev의 장점 → 자신이 모르는 것을 안다
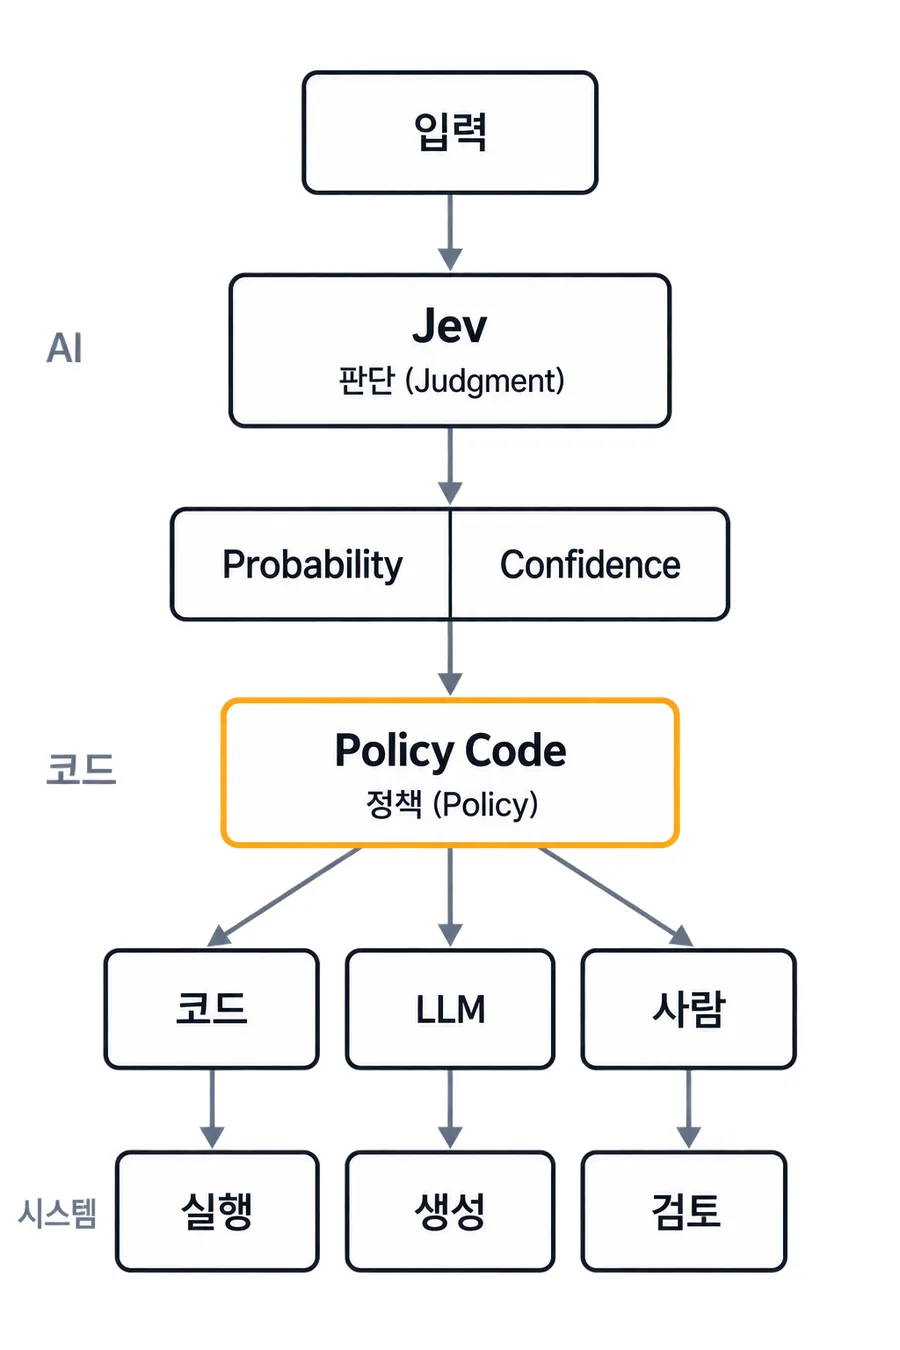
- 자신이 내놓은 판단이 얼마나 확실한지 (confidence) 수치로 알려준다.
- → 잘 모르는 것은 시스템에 정확히 신호를 보낸다
- → 확신하는 쉬운 문제는 저렴하게 처리한다
- → 모르는 문제는 비싼 LLM에게 넘겨서 처리할 수 있다
오해 : LLM을 대체하는 것이 아닌 LLM 앞에 판단 계층을 하나 두는 것이다.
(출처: wikidocs)
💡 중요하게 판단해야 하는 것은 : 이 방식이 이 task에 적합한가이다.
3. LLM은 어떻게 답을 만드는가
다음에 올 토큰을 하나씩 예측해서 이어 붙이는 방식이다.
ex) 배고프다 라는 입력을 받으면, 다음에 올 법한 조각을 고르고, 그 결과를 다시 입력에 붙여 그 다음 조각을 고른다 → 문장이 끝날 때까지 이 과정을 반복한다.
그로 인한 영향
1. 출력이 길어질수록 시간이 오래 걸린다.
2. 출력은 언제나 문자열이다 → 출력할 때 JSON 형태로 라는 걸 강제해야 한다.
3. 자유로움이 높아서, 실행할 때마다 답이 다르게 나온다.
특히, 속도와 비용 + 확신도가 가장 큰 문제다.
4. 생성과 결정은 다른 일이다
| 생성(Generation) | 결정(Decision) | |
|---|---|---|
| 답의 범위 | 정해져 있지 않음 | 미리 정해져 있음 |
| 좋은 답 | 여러 개일 수 있음 | 보통 하나 |
| 출력 형태 | 문자열 | 선택지, 숫자, 참/거짓 |
| 길이 | 길수록 좋을 때도 있음 | 길이가 의미 없음 |
| 사람이 하는 일 | 읽는다 | 그대로 실행한다 |
"이 문서를 요약해줘"는 생성이다. 정답이 하나가 아니고, 여러 요약문이 모두 괜찮을 수 있다. 반면 "이 문의를 billing/technical/sales/other 중 어디로 보낼까"는 결정이다. 답은 넷 중 하나이고, 코드는 그 답을 받아 바로 분기한다.
"이건 할랄/하람/마슈부 중에 뭐야?"라고 질문한다.
LLM에게 질문했을 때
halal판단 전용 모델 (Jev)
halal     0.90
haram     0.00
mashbooh 0.10| System One Model (Jev) | 일반 LLM | Reasoning LLM | |
|---|---|---|---|
| 하는 일 | 판단 | 생성 | 추론 |
| 출력 | 구조화된 값 + 확률 | 문자열 | 문자열 + 생각 과정 |
| 속도 | 빠름 | 보통 | 느림 |
| 어울리는 문제 | 후보가 정해진 반복 판단 | 글쓰기, 요약, 대화 | 수학, 코드, 다단계 문제 |
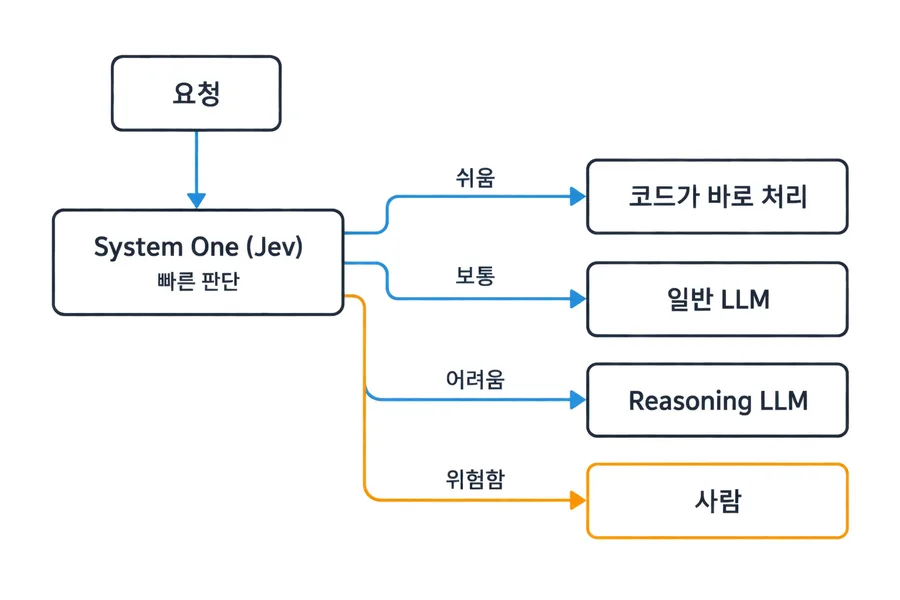
함께 쓴다면 다음과 같다.
(출처: wikidocs)
⇒ "작업의 성격과 도구의 성격을 맞추자"
5. Jev 사용법
Jev의 호출 부분
- state : 판단의 대상
- question : state에 대해 묻는 것 → 질문이 여러 개일 수 있다
result = client.system_one(
    state="결제가 두 번 됐습니다. 빨리 환불해주세요.",
    questions={
        "department": Choice(criteria={"billing": None, "technical": None,
                                       "sales": None, "other": None}),
        "urgency": Score(criteria=["급하지 않음", "보통", "급함", "매우 급함"]),
        "refund": Noul(instructions="고객이 환불을 요구하고 있는가?"),
    },
)
→ 이 구조를 기반으로 Jev는 여러 질문을 서로 간섭하지 않게 평가하도록 설계되어 있다.
질문 형태 3가지 / Primitive : 기초적이고 핵심적인 판단 블록들
| 질문 | 묻는 것 | 예 |
|---|---|---|
| Choice | 여러 후보 중 어느 것인가 | 어느 부서로 보낼까 |
| Noul | 그런가, 아닌가 | 환불을 요구하는가 |
| Score | 어느 정도인가 | 얼마나 급한가 |
Choice
from typesafe_sdk import TypeSafeClient, Choice

with TypeSafeClient() as client:
    result = client.system_one(
        state="앱이 로그인 화면에서 계속 멈춰요.",
        questions={
            "department": Choice(criteria={
                "billing": None, "technical": None,
                "sales": None, "other": None,
            })
        },
    )

answer = result.choices["department"]
print(answer.choice)         # technical
print(answer.confidence)     # 1.0
print(answer.probabilities) # {'technical': 1.0, 'billing': 0.0, ...}| 필드 | 내용 |
|---|---|
| choice | 확률이 가장 높은 후보의 이름 |
| confidence | 그 선택에 대한 확신도, 0에서 1 |
| probabilities | 후보 전체의 확률, 합은 1 |
후보를 잘 나누는 법
1. 후보는 서로 겹치지 않게 만든다. → 반반 상황이 생길 수도 있다.
2. 빠진 후보가 있는지 confidence로 확인한다.
3. Other은 넣되 기대하지 않는다.
4. 후보 개수는 늘려도 느려지지 않는다.
Noul : 예/아니오에 대한 확률
from typesafe_sdk import TypeSafeClient, Noul

with TypeSafeClient() as client:
    result = client.system_one(
        state="전액 환불해주세요",
        questions={"refund": Noul(instructions="고객이 환불이나 결제 취소를 요구하고 있는가?")},
    )

print(result.nouls["refund"].noul)   # 0.98
Score : 어느 정도인가를 묻는 질문
후보 대신 순서가 있는 단계 목록을 받는다.
from typesafe_sdk import TypeSafeClient, Score

with TypeSafeClient() as client:
    result = client.system_one(
        state="며칠째 답이 없네요. 확인 부탁드립니다",
        questions={"sentiment": Score(criteria=["차분함", "약간 불만", "화남", "매우 화남"])},
    )

answer = result.scores["sentiment"]
print(answer.score)          # 0.91
print(answer.confidence)     # 0.91
print(answer.legend)         # {0: '차분함', 1: '약간 불만', 2: '화남', 3: '매우 화남'}
print(answer.probabilities)  # {0: 0.09, 1: 0.91, 2: 0.0, 3: 0.0}
Jev가 하지 않는 것
- 문장 생성 (요약/번역/답변)
- 대화 → 챗봇이 아니다
- 코드 작성
- 후보에 없는 답 생성
6. 최신 동향 (2026년 10월 기준)
출시 배경
- Jev는 2026년 9월 15일 공개됐고, 같은 날 DCVC가 주도한 4천만 달러 규모의 시드 투자도 함께 발표됐다.
- TypeSafe AI는 전 OpenAI 연구자 Diogo Almeida가 창업한 스타트업이다.
- 이름은 비용이 떨어지면 소비가 오히려 늘어난다는 역설을 제시한 경제학자 William Stanley Jevons에서 왔고, System One은 Kahneman이 구분한 빠르고 직관적인 System 1 사고를 가리킨다.
- 새 아키텍처, 새 샘플러, 그리고 RLCD(Reinforcement Learning for Calibrated Decisions)라는 새 학습 알고리즘으로 만들었다고 밝혔다.
속도와 가격 (회사 발표 수치)
- 응답 시간은 70~500ms, 가격은 입력 토큰 100만 개당 0.042달러이며 출력은 무료다.
- 모든 필드를 토큰 하나씩이 아니라 한 번에 만들어내는 병렬 샘플링이 속도의 근거라고 설명한다. → 3장의 "출력이 길어질수록 시간이 오래 걸린다" 문제를 구조적으로 피한 것이다.
접근 경로
- 현재 공개 버전은 jev-1.13.0이다. TypeSafe API를 직접 쓰려면 대기자 명단을 거쳐야 하지만, Vercel AI Gateway와 Cloudflare Workers AI에서는 대기 없이 쓸 수 있다.
- OpenRouter에서도 typesafe/jev-1.13이라는 이름으로 호출할 수 있다.
한계: Jev 1.13 jaggedness
- TypeSafe는 현재 모델의 약점을 정리한 jaggedness 문서를 직접 공개했다.
- 정리된 실패 유형은 9가지다: 문자 그대로 읽기, 개수 세기, 숫자와 날짜, 간접 참조, 관련 없는 state, 적대적 콘텐츠, 서로 모순되는 기준, 구조적 불변식, 생성.
- 대표적인 예
- 개수를 안정적으로 세지 못한다. 그래서 조건에 맞는 항목 수를 셀 때는 코드에서 후보를 하나씩 돌며 각각 질문하고, 답을 직접 더하라고 권한다.
- 날짜를 순서가 있는 값이 아니라 텍스트로 읽는다.
- Choice의 선택지 순서가 답에 영향을 주는 경우가 있고, 앞쪽 선택지 쪽으로 기우는 경향이 관찰됐다.
- state에 관련 없는 내용이 섞이면 정확도가 떨어진다(context rot).
- 같은 입력에서 논리적으로 동일한 Noul 질문과 Choice 질문이 0.22와 0.01처럼 크게 다른 확률을 반환한 사례도 문서에 나와 있다.
- "환각이 없다"의 의미
- 정의한 스키마 밖의 값을 반환하지 않는다는 뜻이지, 틀리지 않는다는 뜻은 아니다. Hacker News에서도 이 점이 크게 지적됐다.
- 즉 LLM의 실패가 "없는 답을 지어내는 것"이라면, Jev의 실패는 "있는 후보 중 틀린 것을 고르는 것"이다.
- 입력과 운영 제약
- state와 질문 전체를 합친 입력 한도는 64k 토큰이다.
- Choice 선택지는 최대 255개이고, 데이터는 미국에서 처리되며 미세 조정(fine-tuning)은 불가능하다.
- 대응 방향
- 문서의 대응책 대부분은 같은 방향이다: 로직은 코드에 두고, Jev에게는 잘하는 좁은 판단만 맡긴다.
- 비용이 큰 행동일수록 더 높은 confidence를 요구하고, confidence가 낮은 경우는 사람에게 넘긴다. → 2장의 "모르는 문제는 다른 곳으로 넘긴다"와 같은 구조다.
경쟁 모델 등장: Liquid AI d1
- Liquid AI는 9월 29일 첫 결정 모델 d1을 공개했다.
- d1은 Jev의 세 가지 판단 방식인 Choice, Noul, Score와 호환된다.
- Hugging Face의 Decision Index 0.2.1에서 d1은 58.9점, Jev 1.13은 57.9점이다. 단, Liquid AI가 직접 돌린 결과다.
- Liquid AI는 다국어 평가, 프롬프트 인젝션에 대한 견고성, 긴 입력 처리에서 앞선다고 주장한다.
- 현재 무료 버전(d1:free)으로 쓸 수 있고, 가중치와 파라미터 크기는 아직 공개되지 않았다. 로컬 실행 가능 여부를 묻는 질문에는 가능하게 하겠다고 답했다.
- → "판단 전용 모델"이 하나의 모델이 아니라 하나의 카테고리로 자리 잡는 중이다.
7. 실습 코드
실습 환경
conda create -n jev python=3.12 -y
conda activate jev
pip install typesafe-sdk python-dotenv openai
예제 코드
참고 자료
- TypeSafe AI 공식 문서: https://docs.typesafe.ai
- Python SDK: https://github.com/typesafe-ai/typesafe-sdk-python
- System One Model 발표 글: https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Jev 1.13 jaggedness: https://docs.typesafe.ai/model-jaggedness/jev-1.13
- 출처 : https://wikidocs.net/book/21376
- Liquid AI, 문장 생성 대신 Jev 호환 API로 분류 / 라우팅 / 점수를 처리하는 결정 모델 d1 공개
- A decision-making model, 'd1,' has emerged that surpasses Jev in benchmarks - GIGAZINE
- What Is Jev AI? TypeSafe's System One Model, and Where It Fits in an Agent Harness - Width.ai
- Decision models experiments - Baobab Tech