키-값 저장소 설계
키-값 저장소는 고유 식별자인 키로만 값에 접근하는 비관계형 데이터베이스다. 키는 일반 텍스트일 수도 해시 값일 수도 있고, 성능상 짧을수록 좋다. 값은 문자열/리스트/객체 등 무엇이든 상관하지 않는다. 대표적으로 아마존 다이나모, memcached, 레디스가 있다.
이 글에서 설계할 저장소가 지원할 연산은 두 개다.
put(key, value)— 키-값 쌍을 저장get(key)— 키에 매달린 값을 조회
문제 이해 및 설계 범위 확정
완벽한 설계는 없다. 읽기·쓰기·메모리 사용량 사이의 균형과 일관성·가용성 사이의 타협을 어떻게 잡느냐의 문제다. 이번에 잡은 조건은 다음과 같다.
- 키-값 쌍의 크기는 10KB 이하
- 큰 데이터를 저장할 수 있어야 함
- 높은 가용성 — 장애가 있어도 빨리 응답
- 높은 규모 확장성 — 트래픽에 따라 서버 자동 증설/삭제
- 데이터 일관성 수준 조정 가능
- 짧은 응답 지연시간
단일 서버 키-값 저장소
가장 직관적인 방법은 키-값 쌍 전부를 메모리에 해시 테이블로 저장하는 것이다. 빠르지만 모든 데이터를 메모리에 두는 것이 불가능할 수 있다는 약점이 있다.
개선책:
- 데이터 압축(compression)
- 자주 쓰이는 데이터만 메모리에 두고 나머지는 디스크에 저장
그래도 한 대로 부족한 때가 오므로, 결국 분산 키-값 저장소가 필요하다.
분산 키-값 저장소
키-값 쌍을 여러 서버에 분산시키므로 분산 해시 테이블이라고도 부른다. 설계하려면 먼저 CAP 정리를 이해해야 한다.
CAP 정리
일관성(Consistency), 가용성(Availability), 파티션 감내(Partition tolerance) 세 가지를 동시에 만족하는 분산 시스템은 불가능하다는 정리다.
- 데이터 일관성: 어떤 노드에 접속하든 클라이언트는 언제나 같은 데이터를 본다
- 가용성: 일부 노드에 장애가 나도 클라이언트는 항상 응답을 받는다
- 파티션 감내: 노드 간 통신 장애가 생겨도 시스템은 계속 동작한다
셋 중 둘을 충족하려면 나머지 하나는 반드시 희생된다.
| 구분 | 지원 | 희생 |
|---|---|---|
| CP | 일관성 + 파티션 감내 | 가용성 |
| AP | 가용성 + 파티션 감내 | 일관성 |
| CA | 일관성 + 가용성 | 파티션 감내 |
네트워크 장애는 피할 수 없는 일로 여겨지므로 분산 시스템은 반드시 파티션을 감내하도록 설계해야 한다. 따라서 실세계에 CA 시스템은 존재하지 않는다.
이상적 상태
네트워크 파티션이 절대 일어나지 않는 환경이라면, n1에 기록된 데이터가 자동으로 n2·n3에 복제되어 일관성과 가용성이 모두 만족된다.
실세계의 분산 시스템
파티션은 피할 수 없고, 발생하면 일관성과 가용성 중 하나를 골라야 한다. n3이 n1·n2와 통신할 수 없게 된 상황을 예로 들면:
- CP 선택: 불일치를 막기 위해 n1, n2의 쓰기 연산을 중단 → 시스템을 쓸 수 없게 된다. 은행권 시스템처럼 일관성을 양보할 수 없는 경우, 상황이 해결될 때까지 오류를 반환해야 한다.
- AP 선택: 낡은 데이터를 반환할 위험을 감수하고 읽기를 계속 허용하고, n1·n2는 쓰기도 계속 받는다. 파티션이 해결되면 새 데이터를 n3에 전송한다.
요구사항에 맞게 CAP 정리를 적용해야 하며, 면접에서는 면접관과 상의해 결론을 내고 설계하는 것이 좋다.
시스템 컴포넌트
아래 내용은 널리 쓰이는 세 저장소 — 다이나모, 카산드라, 빅테이블 — 의 사례를 참고한 것이다.
데이터 파티션
데이터를 작은 파티션으로 나눠 여러 서버에 저장한다. 이때 따져야 할 두 가지:
- 데이터를 여러 서버에 고르게 분산할 수 있는가
- 노드가 추가·삭제될 때 데이터 이동을 최소화할 수 있는가
안정 해시(consistent hash) 가 이 문제에 적합하다. 서버를 해시 링에 배치하고, 키도 같은 링에 올린 뒤 시계 방향으로 순회하다 만나는 첫 번째 서버에 저장한다.
장점:
- 규모 확장 자동화: 부하에 따라 서버를 자동으로 추가·삭제
- 다양성(heterogeneity): 서버 용량에 맞춰 가상 노드 수를 조정. 고성능 서버는 더 많은 가상 노드를 갖게 설정
데이터 다중화
가용성과 안정성을 위해 데이터를 N개 서버에 비동기적으로 다중화한다(N은 튜닝 가능). 키를 해시 링에 올린 뒤 시계 방향으로 만나는 첫 N개 서버에 사본을 보관한다.
주의할 점:
- 가상 노드를 쓰면 선택된 N개 노드가 대응되는 실제 물리 서버 수가 N보다 작아질 수 있다 → 같은 물리 서버를 중복 선택하지 않도록 해야 한다.
- 같은 데이터 센터의 노드는 정전·네트워크 이슈·자연재해를 동시에 겪을 수 있다 → 사본은 다른 센터의 서버에 두고, 센터들은 고속 네트워크로 연결한다.
데이터 일관성
정족수 합의(Quorum Consensus) 프로토콜로 읽기/쓰기 일관성을 보장한다.
- N = 사본 개수
- W = 쓰기 정족수. 최소 W개 서버의 성공 응답을 받아야 쓰기 성공으로 간주
- R = 읽기 정족수. 최소 R개 서버의 응답을 받아야 읽기 성공으로 간주
W=1은 "한 대에만 기록된다"는 뜻이 아니라, 중재자(coordinator)가 한 대의 성공 응답만 받으면 된다는 뜻이다. 중재자는 클라이언트와 노드 사이의 프락시 역할을 한다.
W·R·N을 정하는 것은 응답 지연과 일관성 사이의 전형적인 타협이다. W나 R이 1보다 크면 일관성은 향상되지만, 중재자가 가장 느린 서버의 응답을 기다려야 하므로 느려진다.
| 설정 | 특성 |
|---|---|
R=1, W=N | 빠른 읽기 연산에 최적화 |
W=1, R=N | 빠른 쓰기 연산에 최적화 |
W+R > N | 강한 일관성 보장 (보통 N=3, W=R=2) |
W+R < N | 강한 일관성 보장되지 않음 |
W+R > N이면 최신 데이터를 가진 노드가 최소 하나는 겹치므로 강한 일관성이 보장된다.
일관성 모델
- 강한 일관성: 모든 읽기가 가장 최근 갱신 결과를 반환. 클라이언트는 절대 낡은 데이터를 보지 않는다
- 약한 일관성: 읽기가 최근 갱신 결과를 반환하지 못할 수 있다
- 결과적 일관성: 약한 일관성의 한 형태로, 갱신 결과가 결국에는 모든 사본에 반영된다
강한 일관성은 보통 모든 사본에 반영될 때까지 읽기/쓰기를 금지해 달성하는데, 새 요청 처리가 멈추므로 고가용성 시스템에는 부적합하다. 다이나모·카산드라는 결과적 일관성을 택하며, 이 설계도 그 모델을 따른다. 대신 병렬 쓰기로 깨진 일관성은 클라이언트가 해결해야 한다.
비 일관성 해소 기법: 데이터 버저닝
다중화하면 가용성은 높아지지만 사본 간 일관성이 깨질 가능성도 높아진다. 버저닝은 데이터를 변경할 때마다 새 버전을 만드는 것으로, 각 버전은 변경 불가능(immutable)하다.
예를 들어 서버 1이 name을 "johnSanFrancisco"로, 서버 2가 "johnNewYork"으로 동시에 바꾸면 충돌하는 두 버전 v1, v2가 생긴다. 원래 값은 무시할 수 있지만 v1과 v2 사이의 충돌은 해소하기 어렵다. 이를 위해 충돌을 발견하고 자동으로 해결할 버저닝 시스템이 필요하며, 보편적으로 벡터 시계(vector clock) 가 쓰인다.
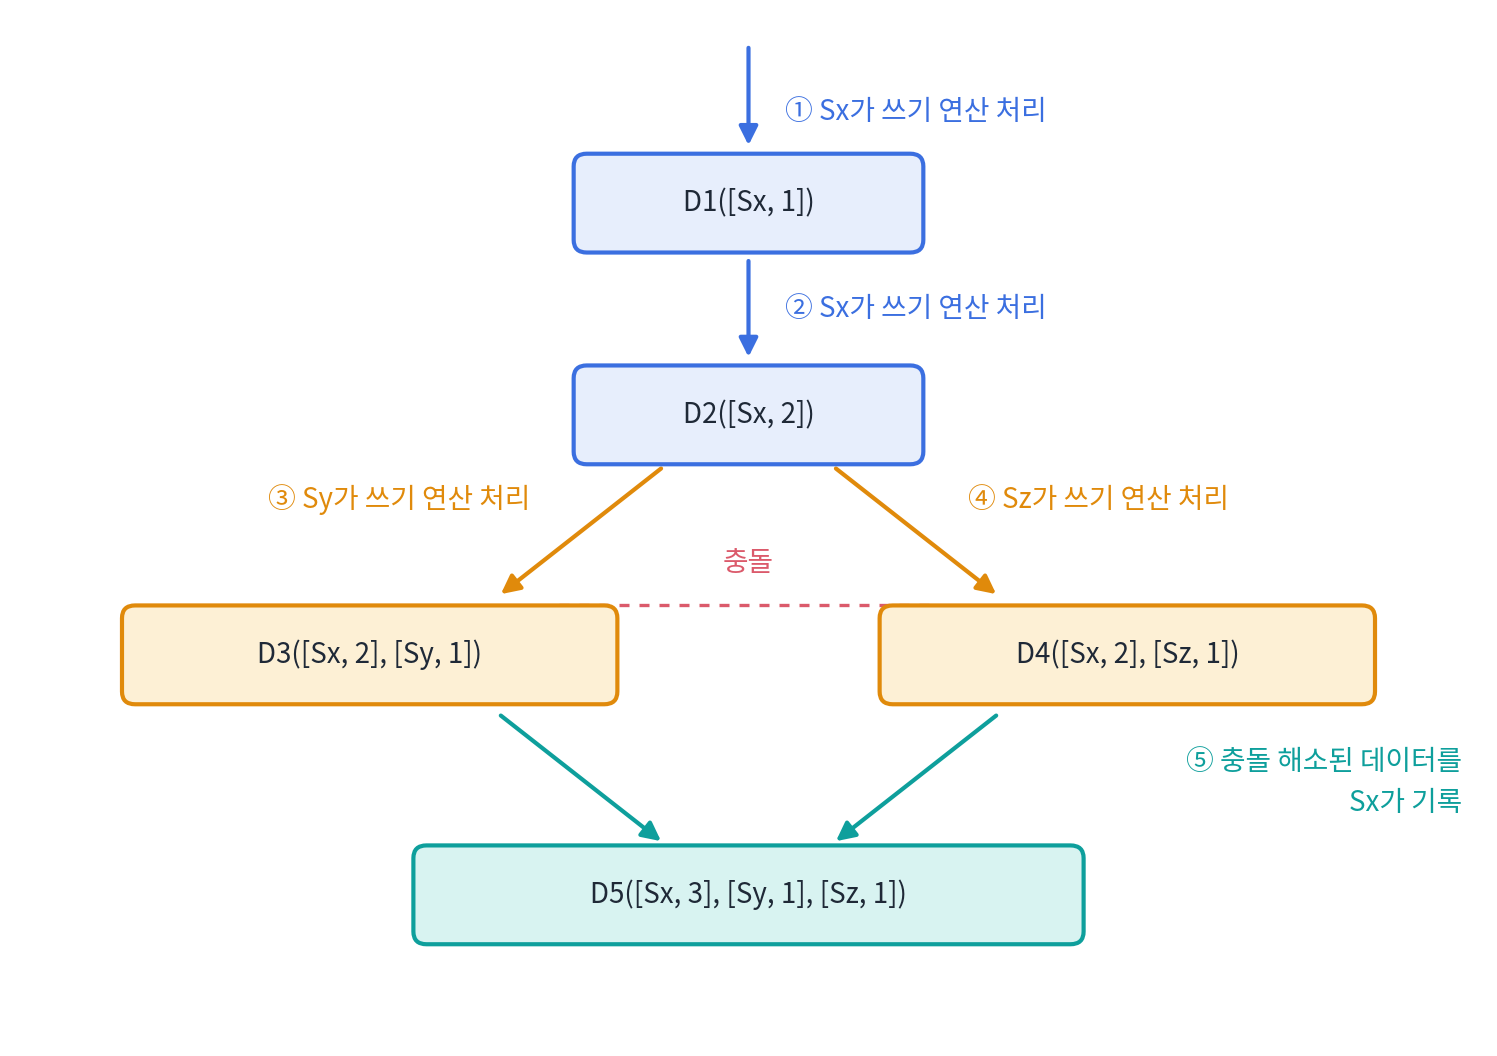
벡터 시계는 [서버, 버전] 순서쌍을 데이터에 매단 것으로, 어떤 버전이 선행인지 후행인지 충돌인지 판별한다. 표기는 D([S1, v1], [S2, v2], ...) 이고, 데이터 D를 서버 Si에 기록하면:
[Si, vi]가 있으면 vi를 증가시킨다- 없으면 새 항목
[Si, 1]을 만든다
동작 예시
- 클라이언트가 D1을 기록, Sx가 처리 →
D1([Sx, 1]) - D1을 읽어 D2로 갱신, 역시 Sx가 처리 →
D2([Sx, 2]) - D2를 읽어 D3로 갱신, Sy가 처리 →
D3([Sx, 2], [Sy, 1]) - D2를 읽어 D4로 갱신, Sz가 처리 →
D4([Sx, 2], [Sz, 1]) - D3과 D4를 함께 읽으면 충돌 감지. 클라이언트가 해소 후 Sx에 기록 →
D5([Sx, 3], [Sy, 1], [Sz, 1])
판별 방법
- Y의 모든 구성요소 값이 X의 동일 서버 구성요소보다 크거나 같으면 → X는 Y의 이전 버전, 충돌 없음
- 예:
D([s0,1],[s1,1])은D([s0,1],[s1,2])의 이전 버전
- 예:
- Y의 구성요소 중 X보다 작은 값이 섞여 있으면 → 충돌
- 예:
D([s0,1],[s1,2])와D([s0,2],[s1,1])는 서로 충돌
- 예:
단점 두 가지
1. 충돌 감지·해소 로직이 클라이언트에 들어가므로 클라이언트 구현이 복잡해진다.
2. [서버:버전] 순서쌍 개수가 굉장히 빨리 늘어난다. 임계치를 두고 오래된 순서쌍을 제거해야 하는데, 그러면 선후 관계 판단이 부정확해져 충돌 해소 효율이 떨어진다. 다만 다이나모 관련 문헌에 따르면 아마존은 실서비스에서 그런 문제를 발견한 적이 없다고 하므로, 대부분의 기업에는 적용할 만한 솔루션이다.
장애 처리
대규모 시스템에서 장애는 불가피할 뿐 아니라 아주 흔한 사건이다.
장애 감지
서버 한 대의 신고만으로 장애 처리하지 않고, 보통 두 대 이상이 같은 보고를 해야 실제 장애로 간주한다. 모든 노드 사이에 멀티캐스팅 채널을 구축하는 것이 가장 손쉽지만 서버가 많으면 비효율적이다.
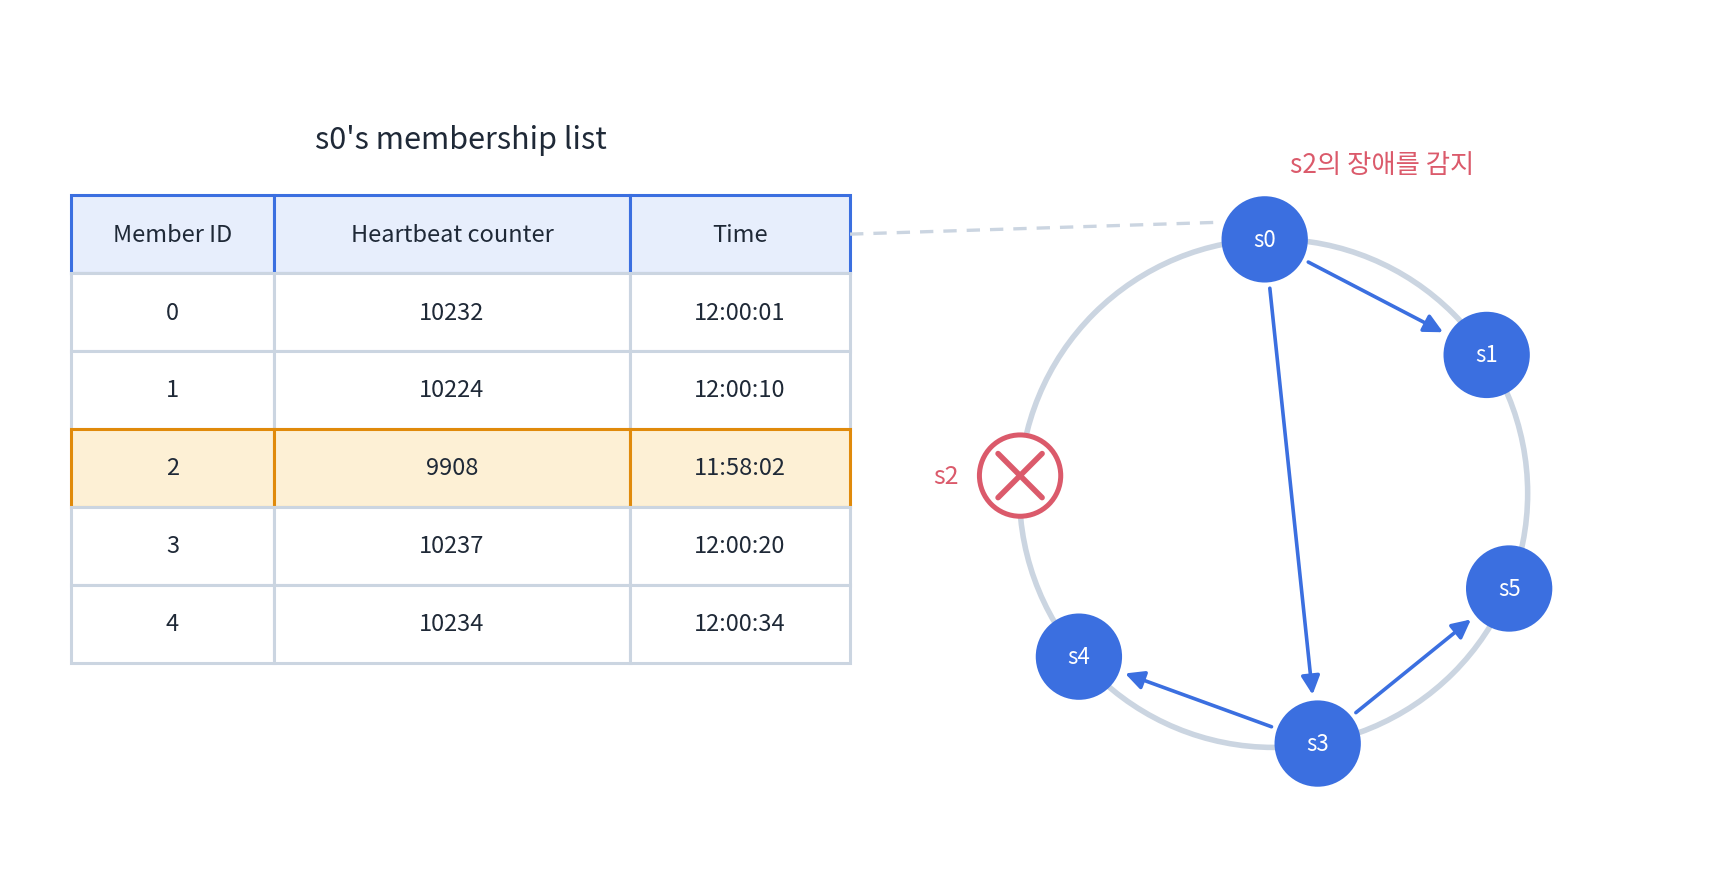
→ 가십 프로토콜(gossip protocol) 같은 분산형 장애 감지가 더 효율적이다.
- 각 노드는
[멤버 ID, 박동 카운터]쌍의 목록인 멤버십 목록을 유지한다 - 각 노드는 주기적으로 자신의 박동 카운터를 증가시킨다
- 각 노드는 무작위로 선정된 노드들에게 주기적으로 박동 카운터 목록을 보낸다
- 목록을 받은 노드는 멤버십 목록을 최신 값으로 갱신한다
- 어떤 멤버의 박동 카운터가 지정된 시간 동안 갱신되지 않으면 장애 상태로 간주한다
일시적 장애 처리
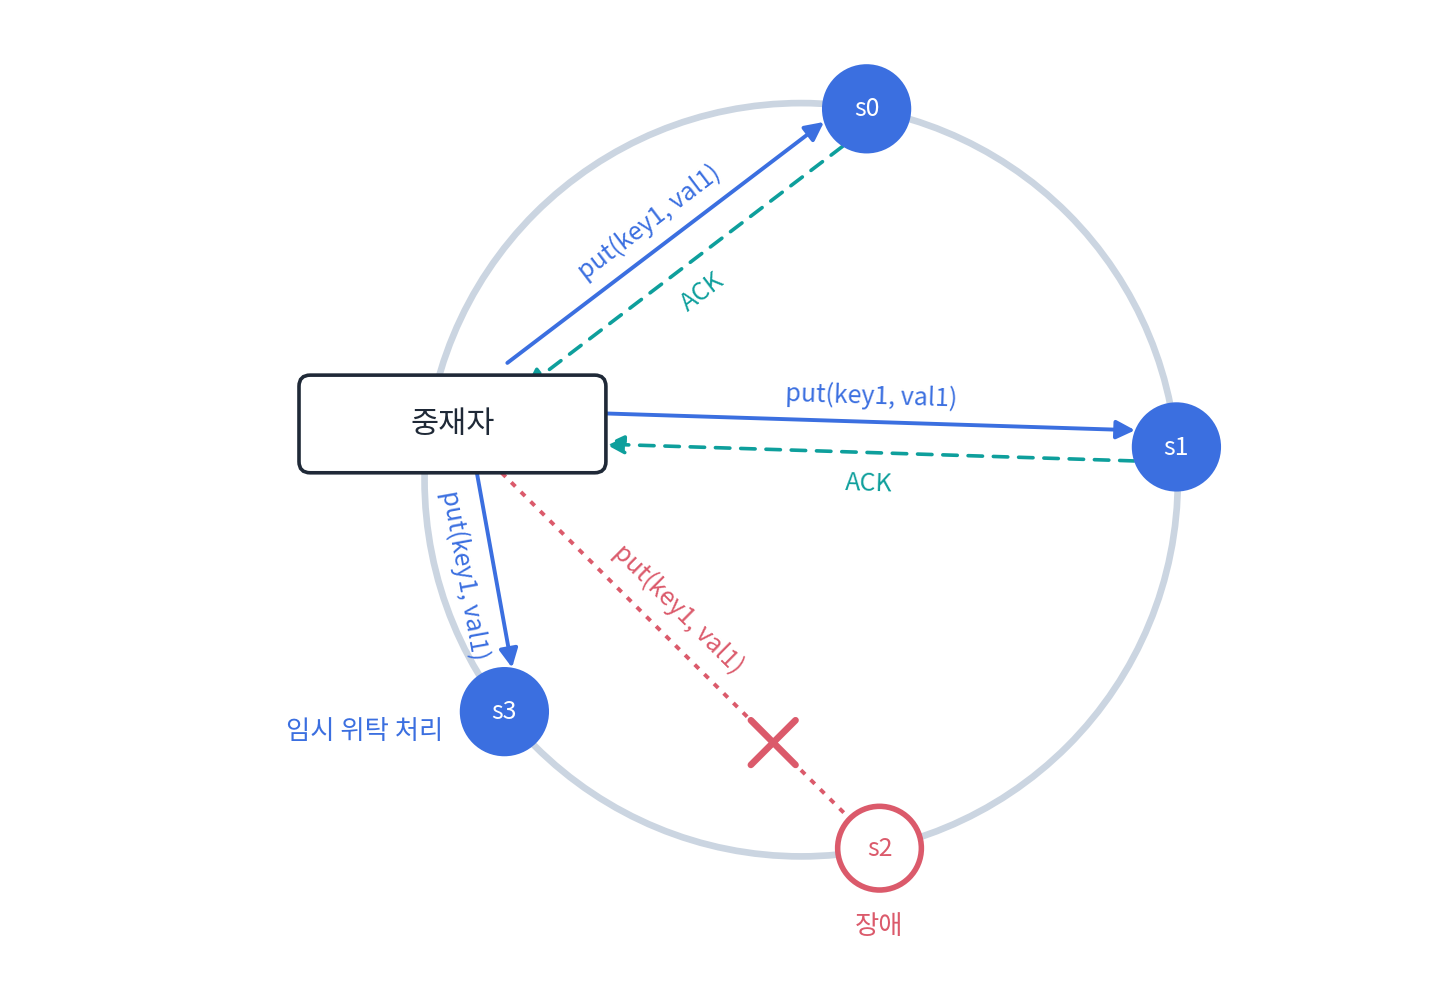
엄격한 정족수(strict quorum) 접근법을 쓰면 장애 시 읽기·쓰기를 금지해야 한다. 느슨한 정족수(sloppy quorum) 는 이 조건을 완화해 가용성을 높인다. 정족수를 강제하는 대신, 해시 링에서 쓰기용 건강한 서버 W개와 읽기용 건강한 서버 R개를 고르고 장애 서버는 무시한다.
장애 서버로 갈 요청은 다른 서버가 잠시 맡아 처리하고, 그동안의 변경사항에 단서(hint) 를 남겨뒀다가 복구 시 일괄 반영한다. 이를 단서 후 임시 위탁(hinted handoff) 이라 부른다. 예를 들어 장애 노드 s2의 연산을 s3가 대신 처리하다가, s2가 복구되면 갱신 데이터를 인계한다.
영구 장애 처리
영구적 장애에는 사본을 비교해 최신 버전으로 갱신하는 반-엔트로피(anti-entropy) 프로토콜을 구현한다. 불일치 탐지와 전송 데이터 양 감소를 위해 머클(Merkle) 트리를 사용한다.
해시 트리라고도 불리는 머클 트리는, 각 노드에 자식 노드 값의 해시(자식이 종단 노드인 경우) 또는 자식 노드 레이블로부터 계산된 해시 값을 레이블로 붙여둔 트리다.
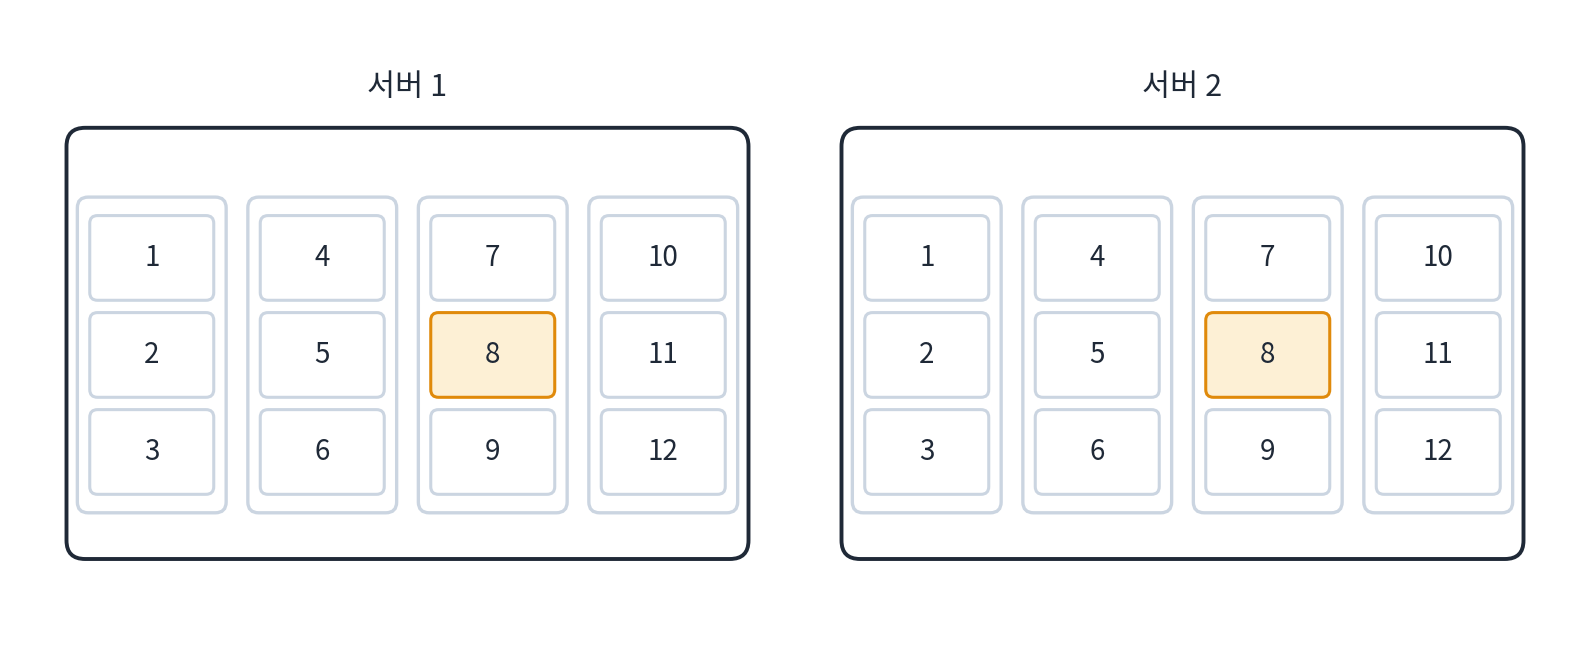
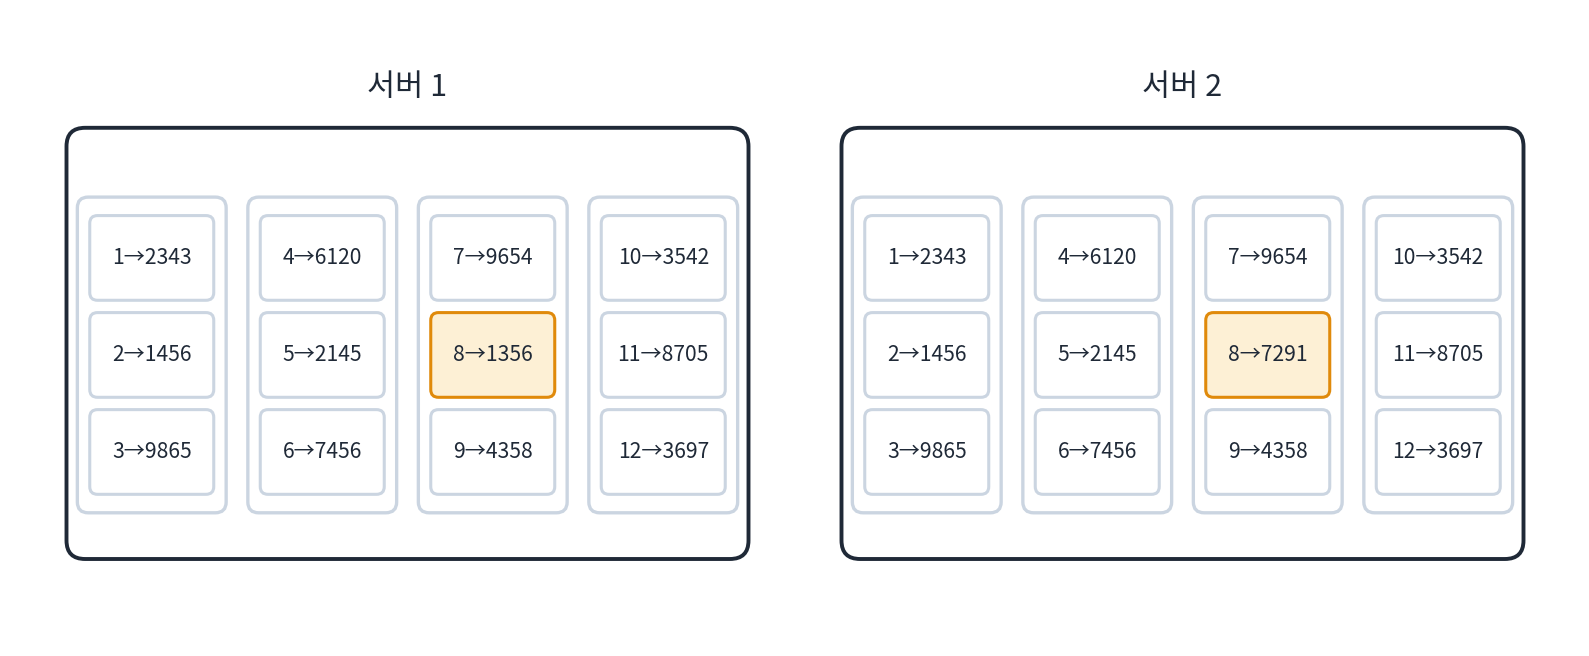
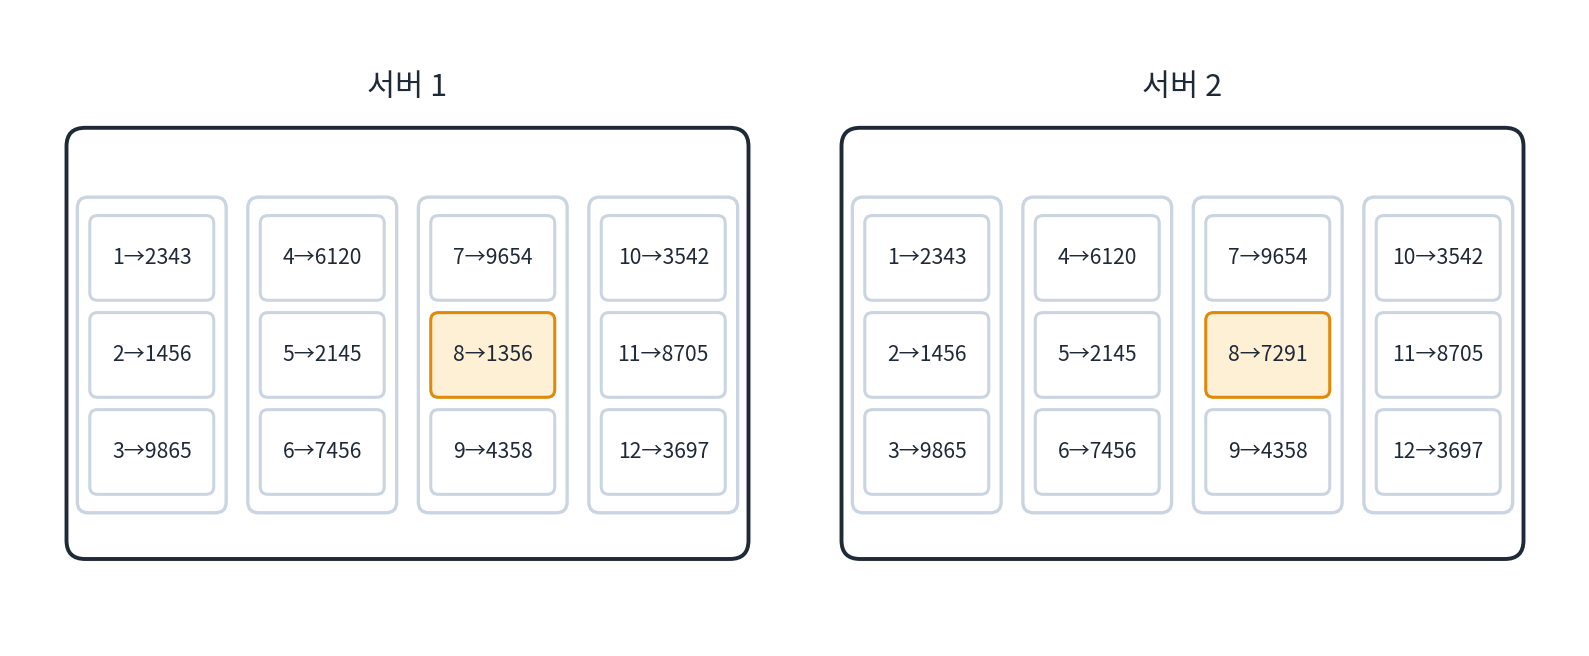
키 공간이 1~12일 때 만드는 과정:
1. 키 공간을 버킷(bucket)으로 나눈다 (이때 일관성이 망가진 데이터에 색깔 표시)
2. 버킷에 포함된 각 키에 균등 분포 해시 함수를 적용해 해시 값을 계산한다
3. 버킷별 해시 값을 계산해 그 값을 레이블로 갖는 노드를 만든다
4. 자식 노드 레이블로부터 새 해시 값을 계산하며 이진 트리를 상향식으로 구성한다
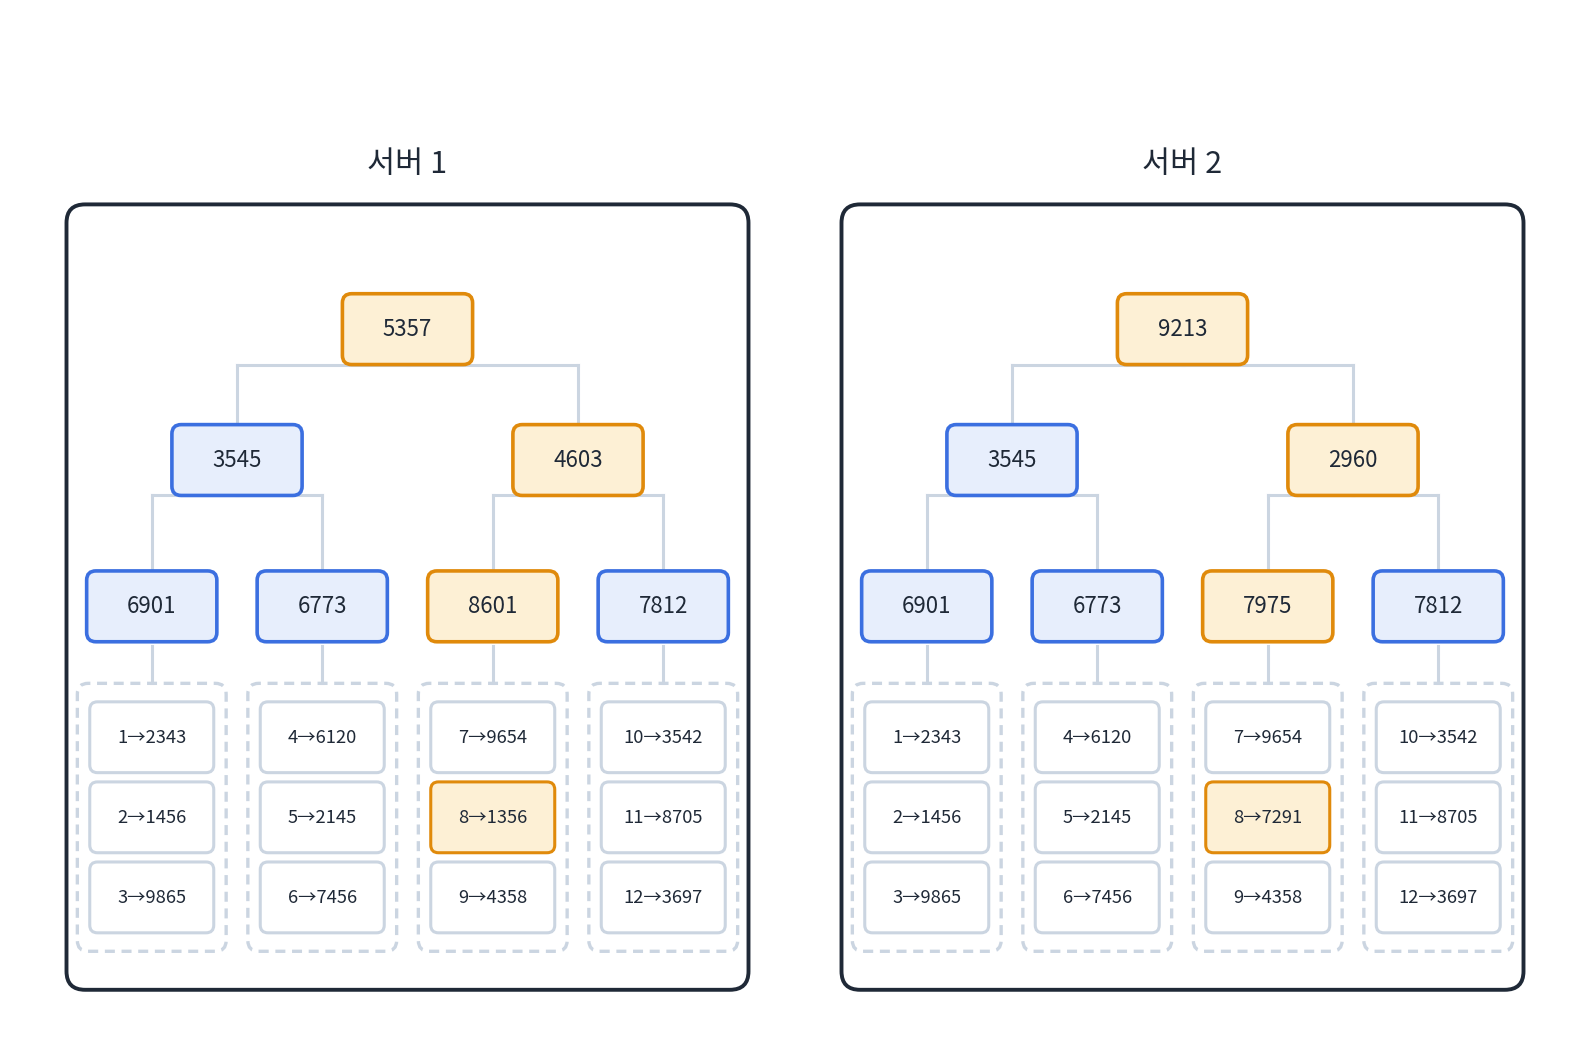
비교는 루트 노드의 해시 값부터 시작한다. 같으면 두 서버는 같은 데이터를 갖는 것이고, 다르면 왼쪽·오른쪽 자식으로 내려가며 탐색해 다른 데이터를 가진 버킷만 찾아 동기화한다.
1단계 — 루트 비교
5357 vs 9213 → 다름. 어딘가에 차이가 있다는 것만 알게 된다.
여기서 같았다면 비교는 끝이다. 키 12개를 하나도 보지 않고 "두 서버 동일" 판정이 난다.
2단계 — 루트의 두 자식 비교
- 왼쪽
3545vs3545→ 같음. 아래에 매달린 버킷 1·2(키 1~6)는 볼 필요조차 없다. 여기서 절반이 잘려나간다. - 오른쪽
4603vs2960→ 다름. 차이는 이쪽에 있다.
3단계 — 다른 쪽(오른쪽)의 자식만 비교
8601vs7975→ 다름 → 버킷 3(키 7, 8, 9)이 범인7812vs7812→ 같음 → 버킷 4(키 10~12)는 건너뜀
4단계 — 지목된 버킷만 실제로 주고받기
버킷 3의 키만 비교하면 8→1356 vs 8→7291. 이 키만 동기화하면 끝난다.
즉 다르면 내려가고, 같으면 그 가지 전체를 버린다를 반복해 차이가 있는 잎까지 좁혀 들어가는 것이다.
이 예제에서 실제로 비교한 노드는 루트 포함 5개뿐인데, 트리가 없었다면 키 12개를 전부 주고받아야 했다.
그래서 10억 개 키를 100만 개 버킷으로 관리할 때 키 하나만 어긋나 있다면, 10억 개를 다 보내는 게 아니라 해당 버킷의 1,000개 키만 보내면 된다. 전송량이 데이터 총량이 아니라 차이의 크기에 비례한다는 말이 이 뜻이다.
데이터 센터 장애 처리
데이터 센터 장애는 정전·네트워크 장애·자연재해 등으로 발생한다. 대응하려면 여러 데이터 센터에 데이터를 다중화하는 것이 중요하다. 한 센터가 완전히 망가져도 사용자는 다른 센터의 데이터를 이용할 수 있다.
시스템 아키텍처 다이어그램
주된 기능은 다음과 같다.
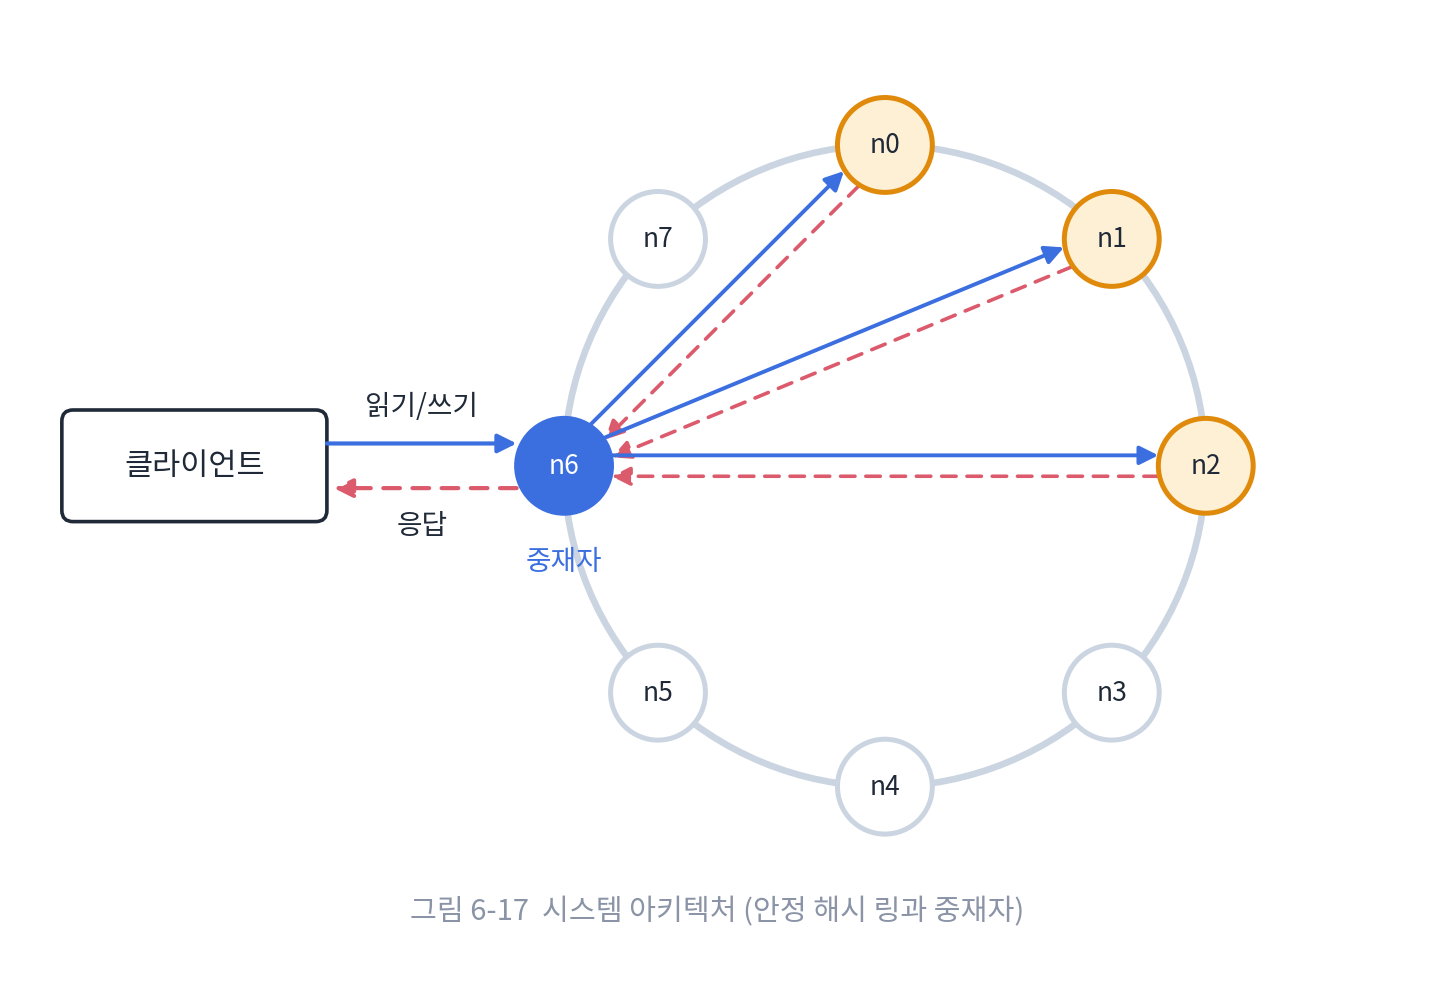
- 클라이언트는
get(key)와put(key, value)두 API로 통신한다 - 중재자는 클라이언트에게 저장소에 대한 프락시 역할을 하는 노드다
- 노드는 안정 해시의 해시 링 위에 분포한다
- 노드를 자동으로 추가·삭제할 수 있도록 시스템은 완전히 분산된다
- 데이터는 여러 노드에 다중화된다
- 모든 노드가 같은 책임을 지므로 SPOF(단일 장애점)가 존재하지 않는다
완전히 분산된 설계이므로 모든 노드가 클라이언트 API, 충돌 해소, 장애 감지·복구, 다중화, 저장소 엔진 기능을 전부 지원해야 한다.
쓰기 경로
아래 구조는 카산드라의 사례를 참고한 것이다.
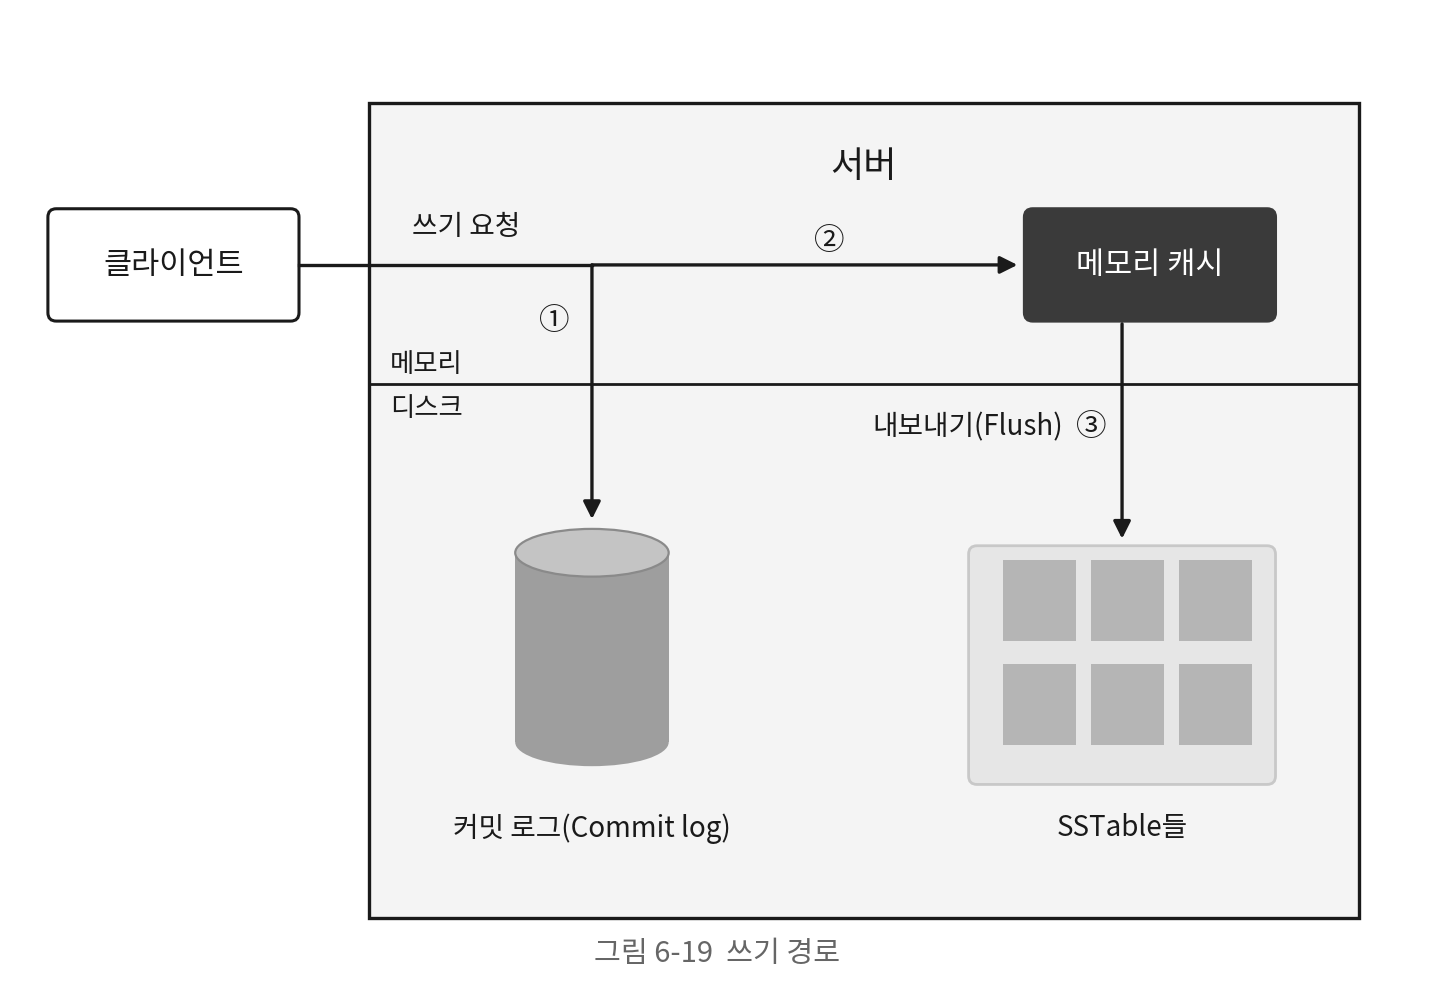
- 쓰기 요청이 커밋 로그(commit log) 파일에 기록된다
- 데이터가 메모리 캐시에 기록된다
- 메모리 캐시가 가득 차거나 임계치에 도달하면 디스크의 SSTable에 기록된다. SSTable(Sorted-String Table)은
<키, 값>순서쌍을 정렬된 리스트로 관리하는 테이블이다
읽기 경로
읽기 요청을 받은 노드는 먼저 메모리 캐시를 살피고, 있으면 바로 클라이언트에 반환한다. 없으면 디스크에서 가져와야 하는데, 어느 SSTable에 키가 있는지 알아내기 위해 블룸 필터(Bloom filter) 를 사용한다.
블룸 필터는 "이 키가 여기 있을 수도 있다 / 확실히 없다"만 알려주는 확률적 자료구조
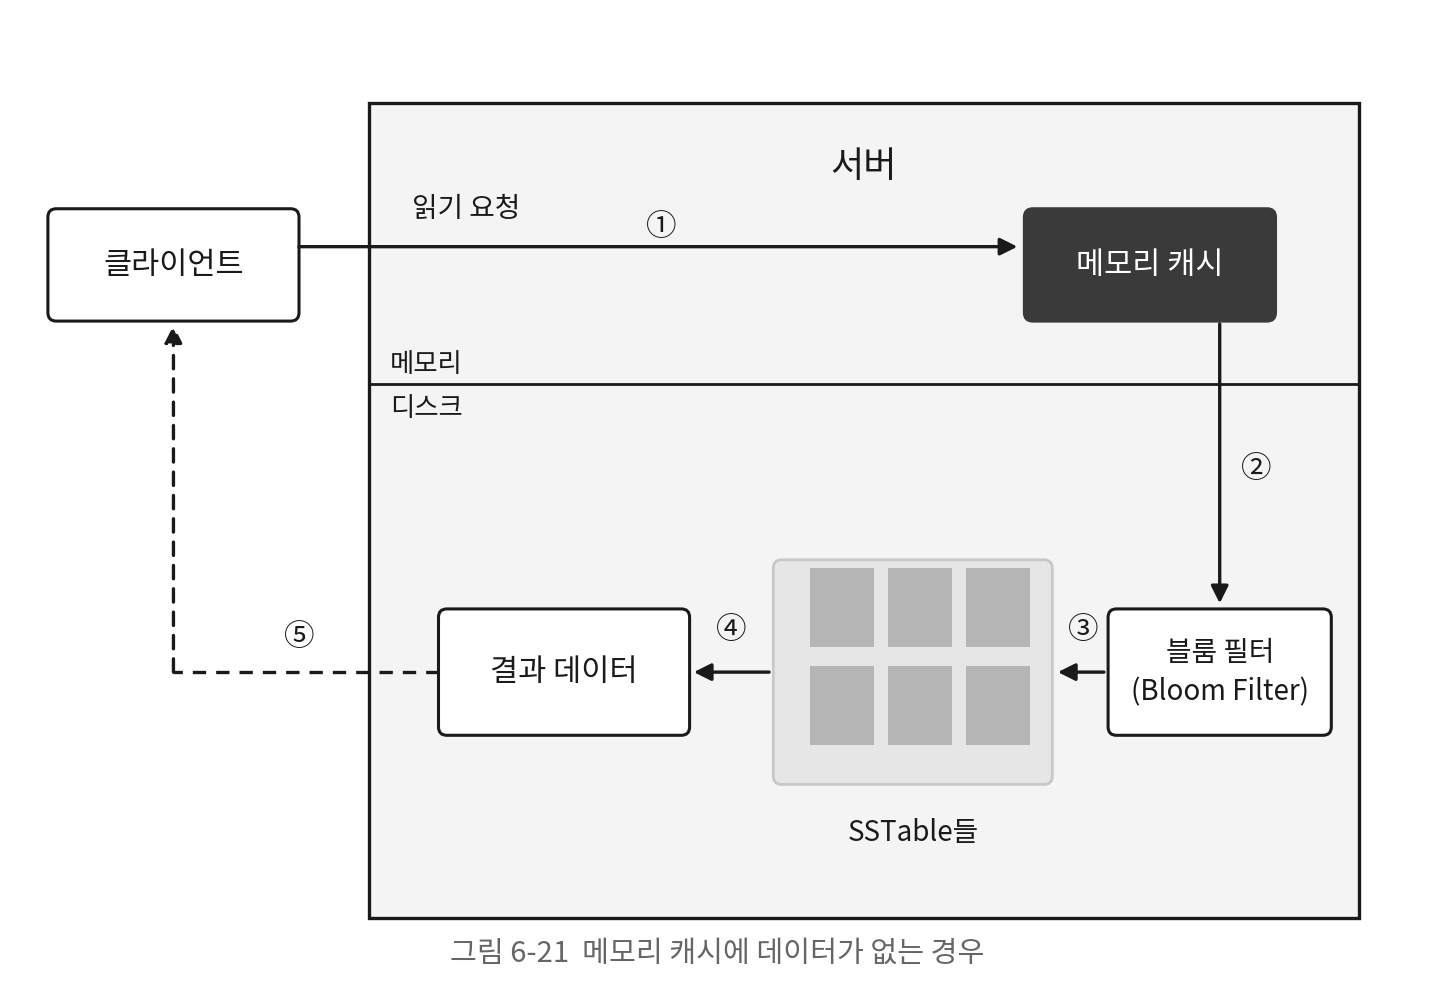
- 데이터가 메모리에 있는지 검사한다. 없으면 2로 간다
- 블룸 필터를 검사한다
- 블룸 필터를 통해 어떤 SSTable에 키가 보관되어 있는지 알아낸다
- SSTable에서 데이터를 가져온다
- 해당 데이터를 클라이언트에 반환한다
요약
분산 키-값 저장소가 가져야 하는 기능과 그 기능 구현에 이용되는 기술
| 목표 / 문제 | 기술 |
|---|---|
| 대규모 데이터 저장 | 안정 해시를 사용해 서버들에 부하 분산 |
| 읽기 연산에 대한 높은 가용성 보장 | 데이터를 여러 데이터센터에 다중화 |
| 쓰기 연산에 대한 높은 가용성 보장 | 버저닝 및 벡터 시계를 사용한 충돌 해소 |
| 데이터 파티션 | 안정 해시 |
| 점진적 규모 확장성 | 안정 해시 |
| 다양성(heterogeneity) | 안정 해시 |
| 조절 가능한 데이터 일관성 | 정족수 합의 |
| 일시적 장애 처리 | 느슨한 정족수 + 단서 후 임시 위탁 |
| 영구적 장애 처리 | 머클 트리 |
| 데이터 센터 장애 대응 | 여러 데이터 센터에 걸친 데이터 다중화 |
