스택(stack)이 후입선출의 구조를 갖고 있다면 큐(queue)는 선입선출의 구조를 갖고 있다.
즉, 가장 먼저 들어온 것이 먼저 나간다.
큐는 스택과 동일하게 구현할 수 있지만 dequeue를 할 때 데이터를 뽑은 뒤 다음 데이터의 위치를 이동해야 하기에 매번 데이터 추출 때마다 이러한 행동을 반복하면 효율이 매우 떨어진다.
이를 해결하기 위해 배열의 처음과 끝이 연결되었다고 보는 자료구조로 큐를 만들었다.
큐를 구현하는 방법은 두가지가 있다.
- 큐 생성
import queue
queue = queue.Queue()

# put - enqueue
queue.put('data')

# get - dequeue
queue.get('data')

# 큐 사이즈
queue.qsize()- 리스트로 구현
def enqueue(data):
	queue_list.append(data)

def dequeue():
	queue_list.pop(0) # 인덱스 0번째 데이터를 추출하고 삭제
➡️ 리스트 형태는 마지막 원소를 추가하는 것과 pop() 같은 작업은 빠르지만 기존 큐의 get(dequeue) 작업을 진행하는 것은 느리다.
일반적인 큐는 선입선출의 특징을 갖고 있지만 다른 특징을 가진 큐도 존재한다.
LifoQueue()
LifoQueue()는 스택과 동일하게 후입선출의 구조를 갖고 있다.
데이터가 나오는 순서가 다른거지 put, get을 사용하는 건 동일하다.
PriorityQueue()
PriorityQueue()는 데이터마다 우선순위를 넣어, 우선순위가 높은 순으로 데이터를 꺼내준다.
문제
🔗 Link
https://www.acmicpc.net/problem/10845
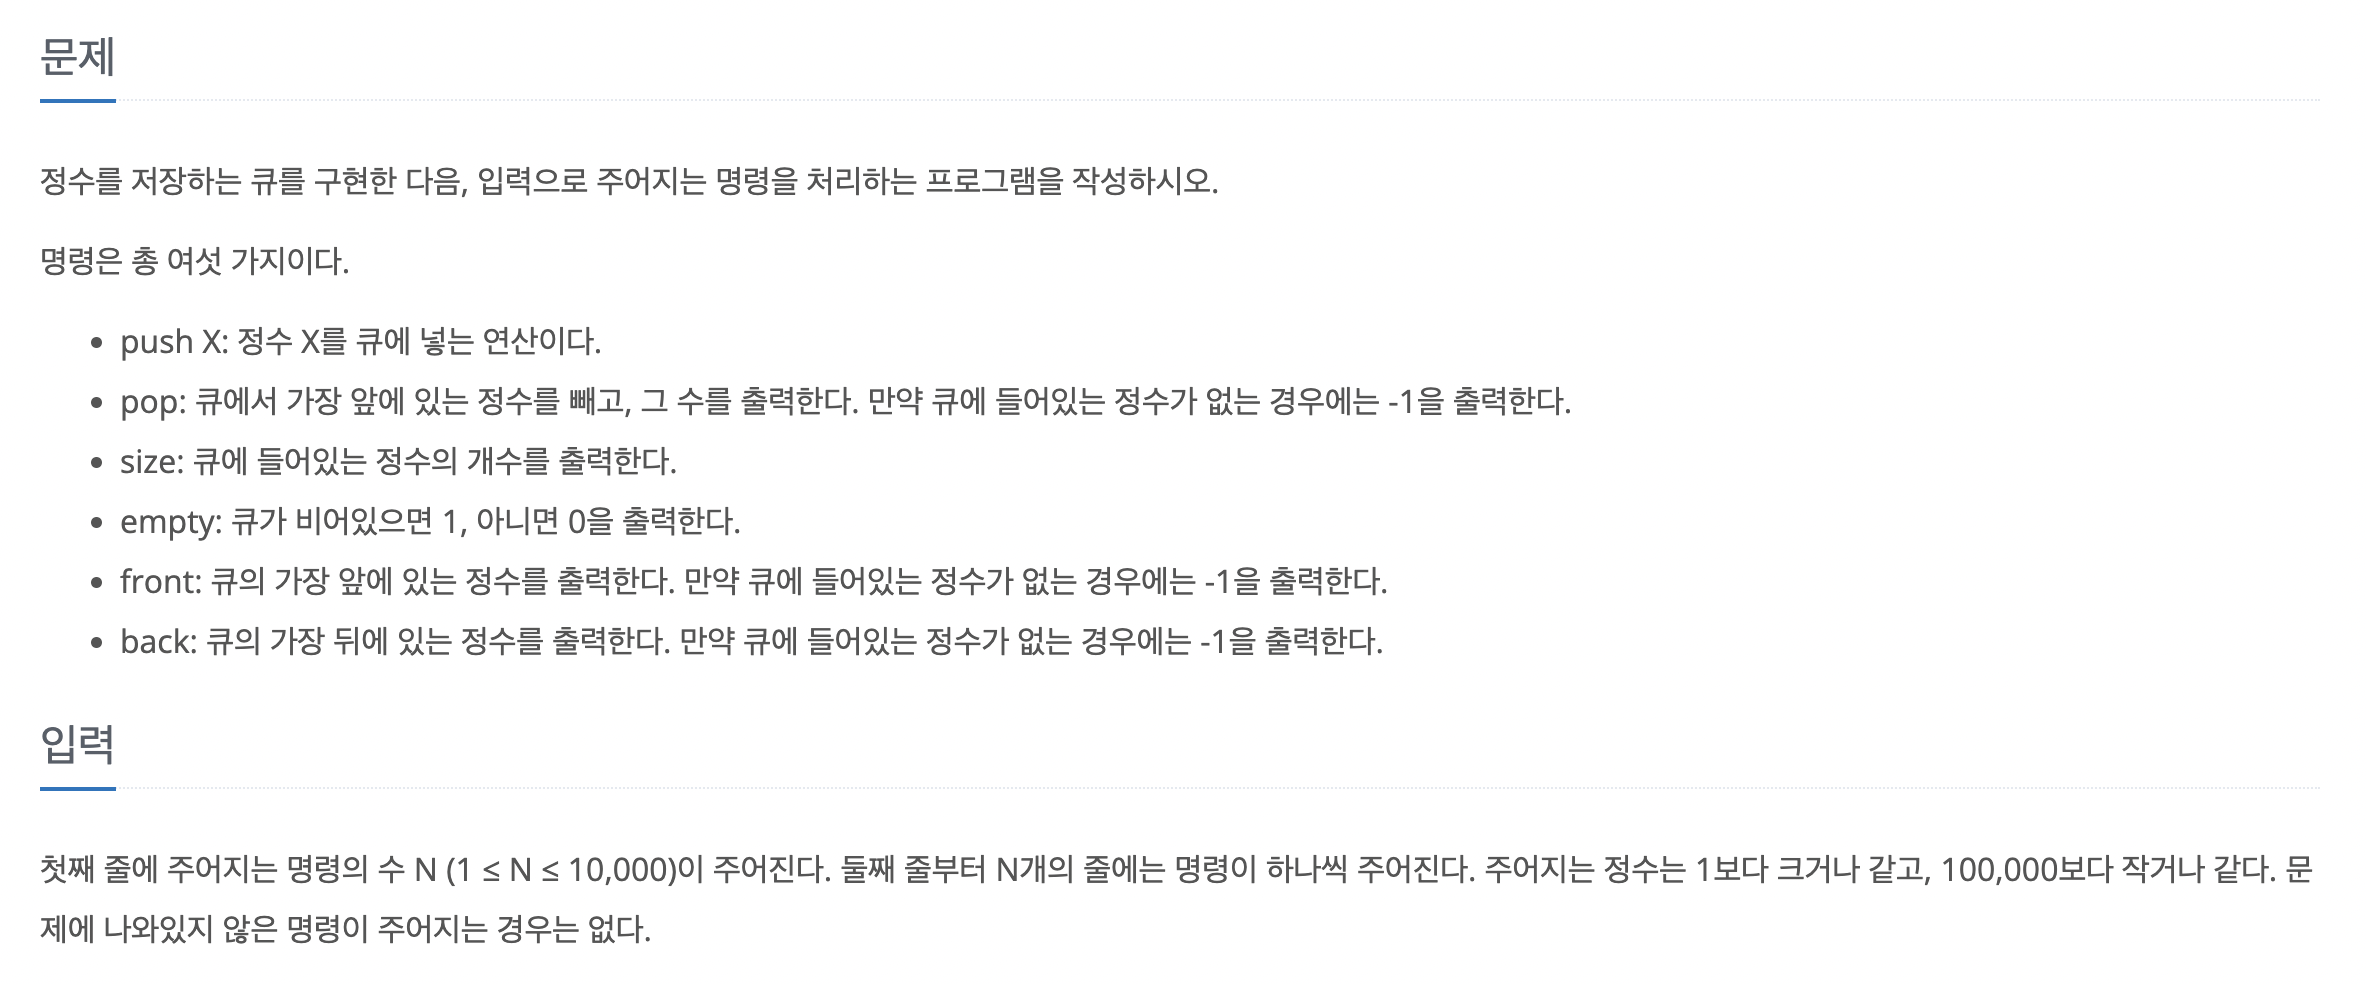
처음에는 queue를 생성해 문제를 풀고자 했지만 queue는 인덱싱이 불가해 리스트로 구현하였다.
시간: 48ms
메모리: 31120KB
import sys
input = sys.stdin.readline

num = int(input())

queue = []

for _ in range(num):
    text = list(input().strip().split(' '))
    if 'push' in text:
        queue.append(int(text[-1]))

    elif 'pop' in text:
        if len(queue) > 0:
            print(queue.pop(0))
        else:
            print(-1)

    elif 'size' in text:
        print(len(queue))

    elif 'front' in text:
        if len(queue) > 0:
            print(queue[0])
        else:
            print(-1)

    elif 'empty' in text:
        if not queue:
            print(1)
        else:
            print(0)

    else:
        if len(queue) > 0:
            print(queue[-1])
        else:
            print(-1)
하고 싶은건 다 하자 👻