ORM - Object Relational Mapping
객체지향 프로그래밍 언어와 관계형 데이터베이스 간의 데이터 변환기법
데이터베이스 종류에 관계없이 일관된 인터페이스 제공
=> 이건 마우스 예시에서 봤던거랑 똑같다
=> ORM은 인터페이스다!
따라서 DB의 종류와 상관없이 코드를 작성할 수 있다
개발자가 직접 SQL을 작성하지 않고도 데이터베이스조작가능 -> SQL 작성안해도 자바코드로 데이터베이스를 조작가능
ㄴ
ORM을 사용한 패러다임 불일치 해결
RDBM은 테이블형으로 만들지?
객체지향 프로그램은 객체기반 구조로 만들지?
그럼 둘의 패러다임이 다르잖아?
데이터베이스 한 칸에는 단일 값만 넣을 수 있지만
자바 코드에서는 데이터에 객체나 리스트까지 다들어갈 수 있다
이게 패러다임 불일치인데
ORM은 이를 해결해준다!
DB와 JAVA는 애초에 다른거니까 어긋나는 지점이 있을 수 밖에 없다
ORM은 이를 중간 인터페이스로 하여금 패러다임 불일치를 해결해준다
JDBC vs JPA
JDBC - 자바 프로그램에서 데이터베이스에 접속하고 SQL문을 실행하기 위한 도구 -근데 엄청 길고 불편해
=>자바와 데이터베이스를 잇는 기본 통신 기술(API)
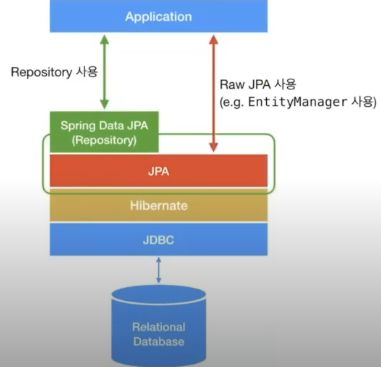
JPA - JAVA와 관계형 데이터베이스 간의 패러다임 불일치를 해결하여 DB작업을 객체 지향적으로 수행할 수 있도록 지원하는 ORM이다!
=> 이렇게 ORM을 만들어라 고 정해놓은 인터페이스!
SQL 직접 작성안해도 객체 조작을 통해 DB작업할 수 있도록 표준화된 인터페이스를 제공
JPA가 인터페이스라면 구혀ㅑㄴ제가 있어야겟지? 보통 Hibernate라는 것을 쓴다
=> Hibernate는 구현체니까
Hibernate 설정(= 방언, dialect)를 통해서 어떤 RDBMS를 사용할지 정할 수 있다
Hibernate가 JDBC를 활용해 DB와 통신한다!
Entity
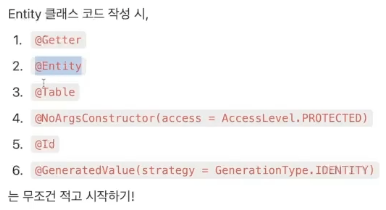
@Entity )
이 클래스가 JPA 엔티티임을 선언,
클래스 명이 데이터베이스의 테이블 이름과 같아짐
@Table )
엔티티와 매핑할 테이블 정보를 저장하는데, 필수는 아님!
이때 클래스의 복수형으로 적는 것이 좋다!(user,like같은예약어를 피하기위해)
@id )
PK 설정
@GeneratedValue )
기본 키 자동 생성 전략,
IDENTITY전략으로 1씩 자동증가도가능하다(=auto increment)
@Colum )
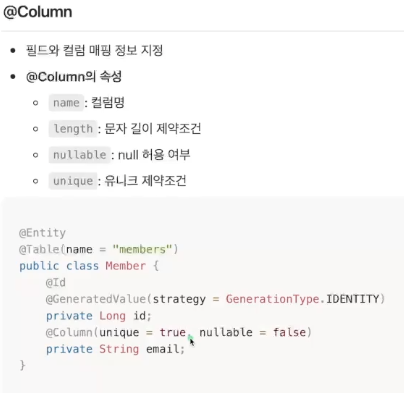
필드와 컬럼 매핑 정보 지정
length값 지정안하면 default 255이고 nullable = ture임
@NoArgsConstructor(acceses = AccessLvel.PROTECTED)
JPA도 자바의 클래스처럼 기본 생성자를 지니는데
Loimbok이 기본생성자를 만들어주는거고 접근 제어자를 protected로 하겠다는 것.
3 layer architrecture
Controller / Service / Repository
클라이언트가 요청 => 콘트롤러 => 러비스 => 레포지토리 => DB
이걸 3 레이어 아키텍처라함
목적
1. 관심사의 분리
2. 유지보수성 향상
3. 재사용성 증대
4. 확장성 개선
Controller layer
@RestController = @Controller + @ResponseBody
할 일
- HTTP 요청 매핑
- 요청 파라미터 검증
- 응답 데이터 변환
- 예외처리 및 에러 응답
하지 말아야 할 일 - 비즈니스 로직 처리 - service에서함
- 데이터베이스 직접 접근 - repository에서함
- 복잡한 데이터 변환
Service Layer
@Service
비즈니스 로직을 처리하는 역할
할 일
- 비즈니스 규칙 구현
- 데이터 유효성 검증
- 여러 데이터 소스 조합
- 트랜잭션 경계설정
하지 말아야 할 일 - HTTP 관련 처리 - Controller가 하니까?
- 데이터베이스 쿼리 작성 - Repository가 하니까
- UI 관련 로직 - 프론트엔드가 할일
Repositroy Layer
실제 DB에서 데이터를 저장하거나 가져오는 계층
@Repository를 사용하지만 extends JpaRepositroy를 하면 @Repository안붙여도됨
할 일
- CRUD 연산 구현
- 쿼리최적화
- 데이터 매핑
하지 말아야 할 일 - 비즈니스 로직
- HTTP 응답 생성
- 사용자 인터페이스 관련 작업
DTO (Data Transfer Object)
데이터를 전달하기 위한 순수 데이터 객체
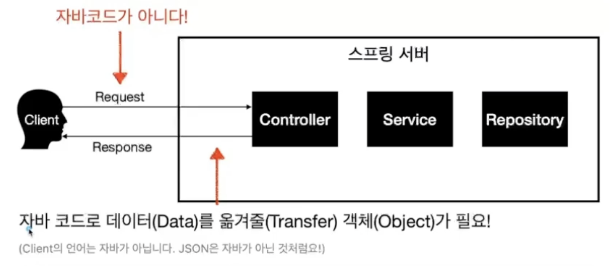
클라이언트의 요청(HTTP,JSON)을 받고 이 요청을 자바 코드로 변환해서 처리한다
=> 그럼 사용자의 요청 데이터를 자바 코드에 담아 컨트롤러에 옮겨줄 객체가 필요
=>DTO
영속성 컨텍스트
JPA(ORM 표준인터페이스)가 엔티티를 관리하는 임시 저장소
엔티티를 임시로 보관
변경사항을 추적(더티체킹)
데이터베이스와 동기화
비영속 - DB에 한번도 갔다오지않은 상태
영속 - DB를 갔다온 상태 = 엔티티가 영속성 컨텍스트에 의해 관리되는 상태
@Transactional
트랜잭션 - 여러 작업을 하나의단위로 묶어 모두 성공하거나 모두 실패하는 것=> 원자성 = atomic
@transactional 어노테이션이 붙으면 아래 메서드는 하나의 트랜잭션으로 묶이게된다
JpaRepository
데이터베이스 작업을 도와주는 인터페이스
public interface ScheduleRepositroy extends JpaRepository<Schedule, Long>{
}
//Schedule이 레포지토리가 다룰 대상 엔티티(테이블)
// Long 그 엔티티의 기본키의 데이터 타입
쿼리 사용하지않고도 쉽게 DB에 데이터를 CRUD가능
CREATE -> save(entity)
READ -> findById,findALL
Update -> 트랜잭션 안에서 엔테티의 필드만 변경->커밋 시 자동 업데이트(더티체킹)
Delete -> delte(entity),deleteById(id),deleteAll()
더티체킹
jpa의 더티체킹은 영속성 컨텍스트 내의 엔티티의 변경 사항을 자동으로 감지하여
데이터베이스에 반영하는 메커니즘
영속성 컨텍스트의 조건 ? @Transactional 내부일것, DB에 다녀올것(영속)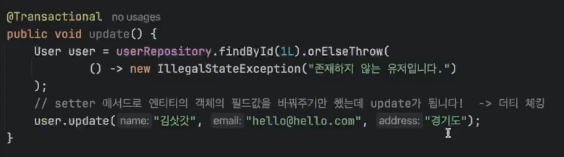
\이게 왜 더티냐? 원래 유저만들때 이름,이메일,지역 다른거였는데, 업데이트 하는 과정에서 더러워짐 -> 더러운거 업뎃해줄게 -> 더티체킹