알고리즘 Cheat Sheet 시리즈는 코딩 테스트를 풀다가 "이거 자바에선 뭐였지?", "파이썬은 어떻게 했더라?" 싶을 때 바로 펼쳐 보려고 만든 개인 참고용 정리입니다.
Java와 Python을 나란히 놓고, 문법 차이 때문에 실수하기 쉬운 부분만 짧게 정리합니다.
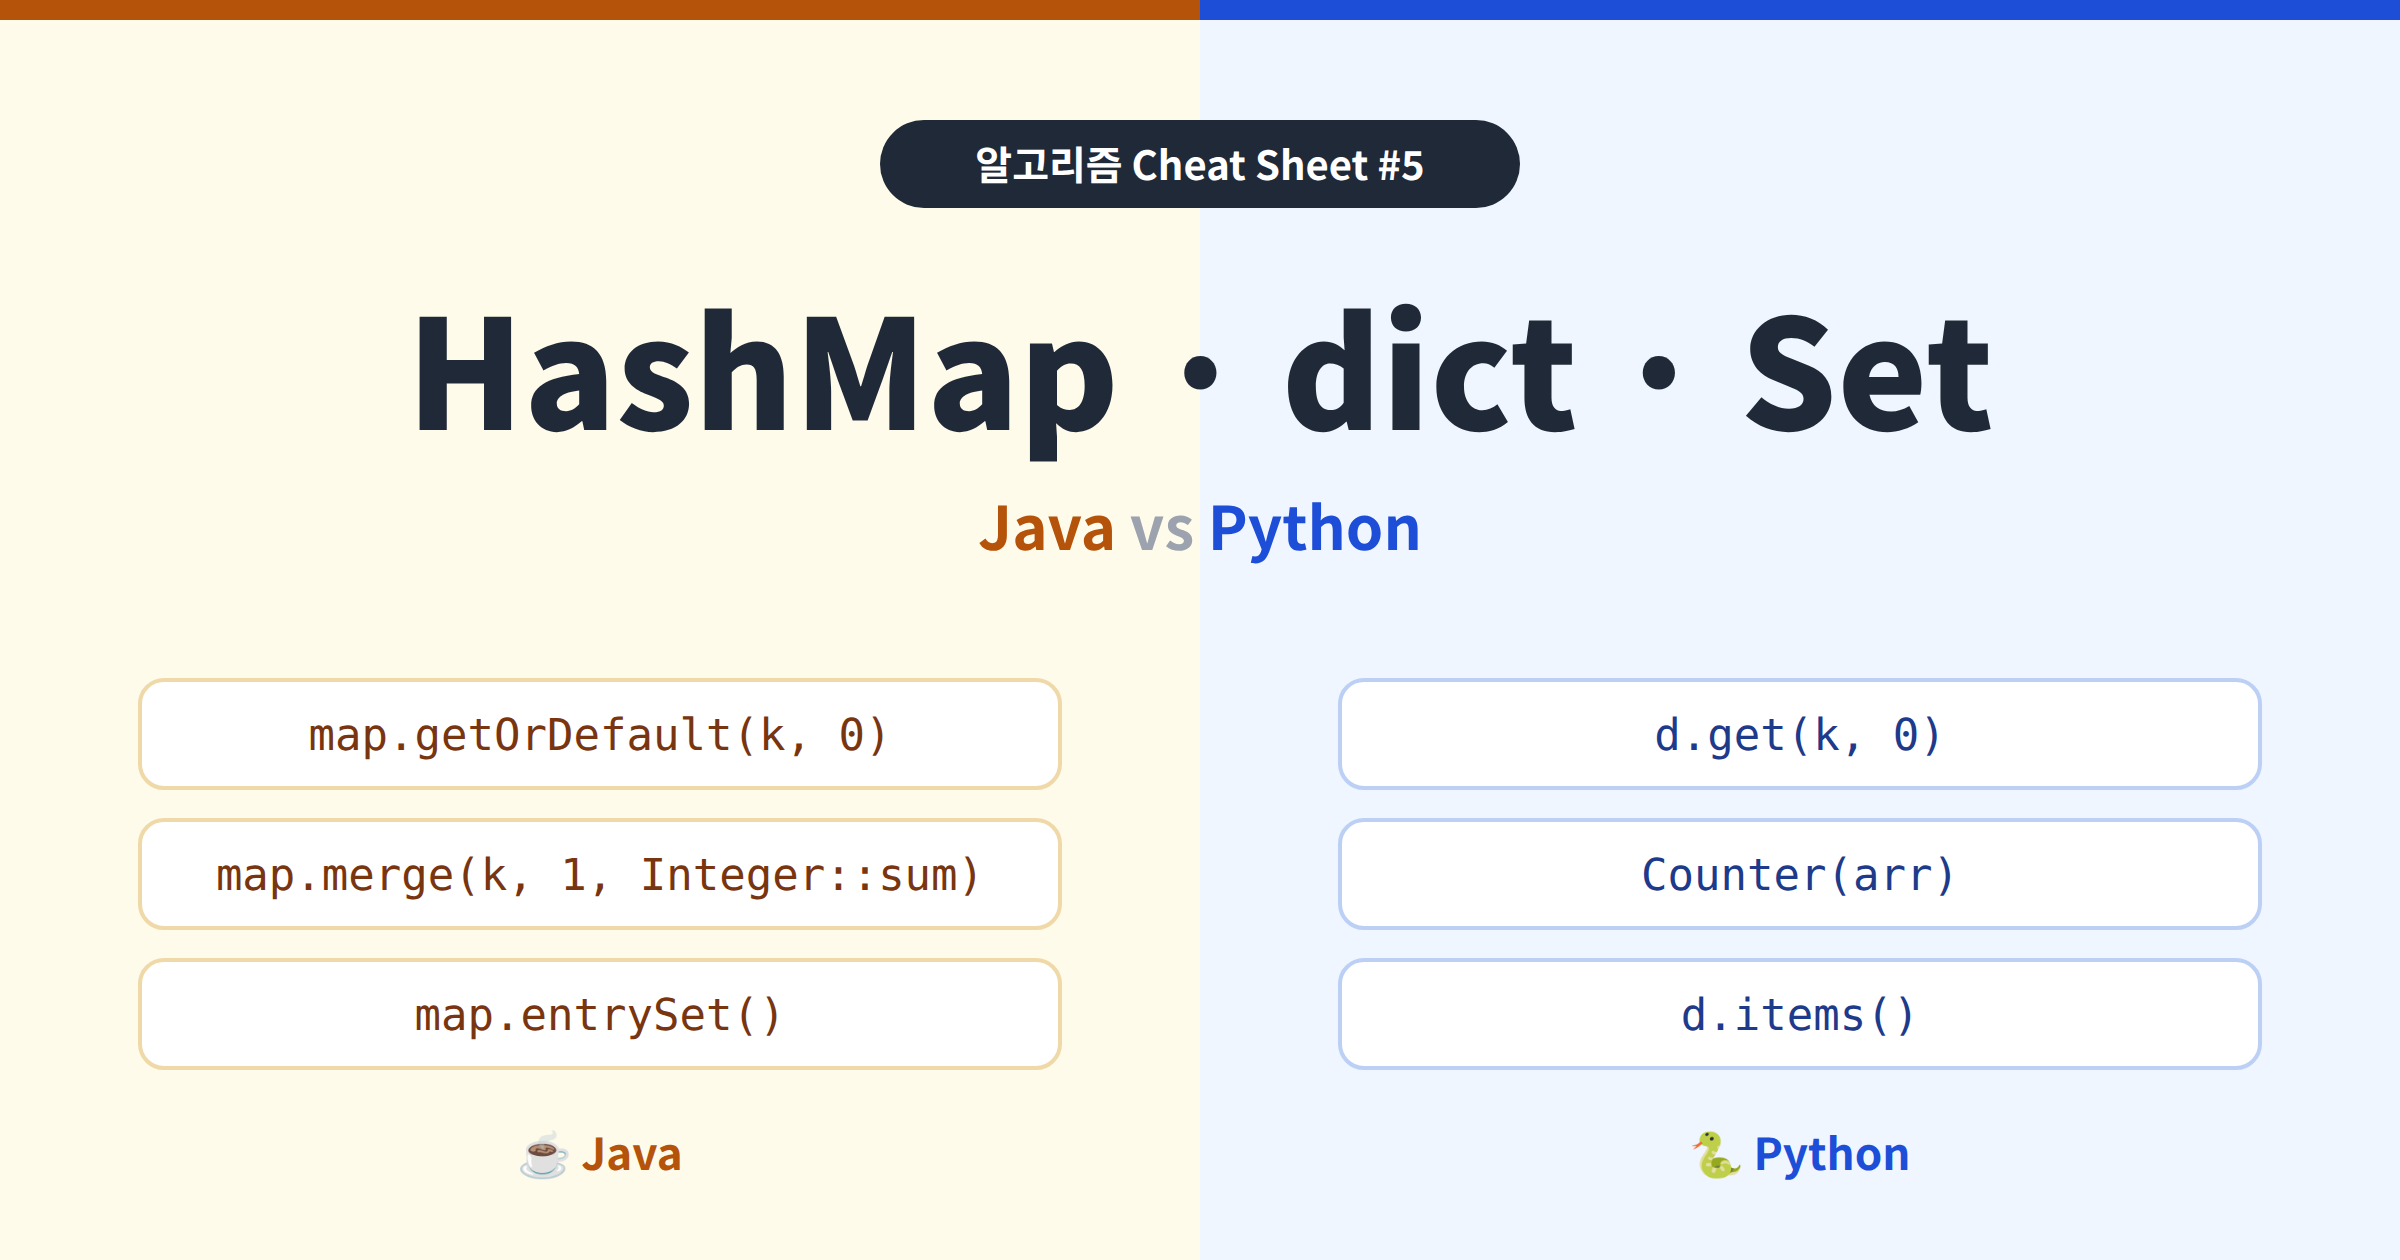
이번 주제는 HashMap · dict · Set입니다.
개수 세기, 중복 제거, 빠른 존재 여부 확인까지 코테에서 가장 많이 쓰는 자료구조입니다. 웬만한 문제는 풀 수 있어요!
조회·추가·포함 확인이 평균 O(1) 이라서, 리스트로 in / contains를 반복하다 시간 초과가 나면 가장 먼저 떠올려야 합니다.
0. 선언
import java.util.*;

Map<String, Integer> map = new HashMap<>();
Set<Integer> set = new HashSet<>();
from collections import Counter, defaultdict
d = {} # 빈 딕셔너리
s = set() # 빈 셋 ← {}는 딕셔너리| 종류 | 자바 | 파이썬 | 순서 |
|---|---|---|---|
| 기본 맵 | HashMap | dict | 자바: 보장 안 됨 / 파이썬: 넣은 순서 유지 |
| 넣은 순서 유지 | LinkedHashMap | dict | 넣은 순서 |
| 키 정렬 유지 | TreeMap | - (sorted(d)로 정렬) | 키 오름차순 |
| 기본 셋 | HashSet | set | 보장 안 됨 |
| 정렬된 셋 | TreeSet | - (sorted(s)로 정렬) | 오름차순 |
1. HashMap · dict 기본 사용
| 기능 | 자바 | 파이썬 |
|---|---|---|
| 넣기 · 수정 | map.put(k, v) | d[k] = v |
| 가져오기 | map.get(k) | d[k] |
| 없으면 기본값 | map.getOrDefault(k, 0) | d.get(k, 0) |
| 키가 있는지 | map.containsKey(k) | k in d |
| 값이 있는지 | map.containsValue(v) | v in d.values() |
| 삭제 | map.remove(k) | del d[k] / d.pop(k) |
| 없을 때만 넣기 | map.putIfAbsent(k, v) | d.setdefault(k, v) |
| 크기 | map.size() | len(d) |
| 비었는지 | map.isEmpty() | not d |
없는 키를 조회하면
| 상황 | 자바 | 파이썬 |
|---|---|---|
| 조회 | map.get(k) → null | d[k] → KeyError |
| 안전하게 조회 | map.getOrDefault(k, 0) | d.get(k, 0) |
| 삭제 | map.remove(k) → null (에러 없음) | del d[k] → KeyErrord.pop(k, None) → 안전 |
Map<String, Integer> map = new HashMap<>();
int n = map.get("a");        // ❌ NullPointerException (null을 int로 언박싱)
int m = map.getOrDefault("a", 0);   // ⭕ 0
d = {}
n = d["a"] # ❌ KeyError
m = d.get("a", 0) # ⭕ 0자바
map.get()은 에러 없이null을 주지만,int변수에 담거나+ 1을 하는 순간NullPointerException이 난다.
2. 개수 세기 (가장 많이 쓰는 패턴)
["a", "b", "a", "c", "a"] → {a: 3, b: 1, c: 1}
Map<String, Integer> count = new HashMap<>();

for (String x : arr) {
    count.put(x, count.getOrDefault(x, 0) + 1);   // 방법 1
    // count.merge(x, 1, Integer::sum);           // 방법 2 (한 줄)
}
count = {}
for x in arr:
count[x] = count.get(x, 0) + 1 # 방법 1
from collections import Counter
count = Counter(arr) # 방법 2 (한 줄)
count.most_common(2) # [('a', 3), ('b', 1)] 빈도 상위 2개| 방법 | 자바 | 파이썬 |
|---|---|---|
| 기본 | put(x, getOrDefault(x, 0) + 1) | d[x] = d.get(x, 0) + 1 |
| 한 줄 | merge(x, 1, Integer::sum) | Counter(arr) |
| 빈도순 정렬 | 아래 "값 기준 정렬" 참고 | Counter(arr).most_common() |
그룹 묶기 (키 하나에 여러 값)
Map<String, List<String>> group = new HashMap<>();
group.computeIfAbsent(key, k -> new ArrayList<>()).add(value);
group = defaultdict(list)
group[key].append(value) # 키가 없으면 빈 리스트를 자동으로 만든다
defaultdict(int)는 없는 키를0으로,defaultdict(list)는[]로 자동 생성한다.
3. 순회
| 순회 대상 | 자바 | 파이썬 |
|---|---|---|
| 키 | for (String k : map.keySet()) | for k in d: |
| 값 | for (int v : map.values()) | for v in d.values(): |
| 키 + 값 | for (Map.Entry<String, Integer> e : map.entrySet()) | for k, v in d.items(): |
for (Map.Entry<String, Integer> e : map.entrySet()) {
    String key = e.getKey();
    int value = e.getValue();
}
for key, value in d.items():
print(key, value)파이썬
d.items()는enumerate처럼 두 값을 한 번에 풀어서 받는다. 자바는Entry에서getKey(),getValue()로 꺼낸다.
정렬해서 순회
| 기준 | 자바 | 파이썬 |
|---|---|---|
| 키 오름차순 | new TreeMap<>(map) | sorted(d.items()) |
| 값 오름차순 | 아래 코드 | sorted(d.items(), key=lambda x: x[1]) |
| 값 내림차순 | 아래 코드 | sorted(d.items(), key=lambda x: -x[1]) |
List<Map.Entry<String, Integer>> entries = new ArrayList<>(map.entrySet());
entries.sort((a, b) -> Integer.compare(b.getValue(), a.getValue()));   // 값 내림차순
순회 체크포인트
- 순회하면서 삭제하면 에러가 난다. 자바는
ConcurrentModificationException, 파이썬은RuntimeError.
자바는map.entrySet().removeIf(e -> e.getValue() == 0), 파이썬은for k in list(d):처럼 키 목록을 복사해서 순회한다.
4. Set: 중복 없는 집합
| 기능 | 자바 | 파이썬 |
|---|---|---|
| 추가 | set.add(x) → boolean | s.add(x) → None |
| 삭제 | set.remove(x) | s.remove(x) (없으면 KeyError)s.discard(x) (없어도 OK) |
| 포함 여부 | set.contains(x) | x in s |
| 크기 | set.size() | len(s) |
| 리스트 → 셋 | new HashSet<>(list) | set(lst) |
| 셋 → 리스트 | new ArrayList<>(set) | list(s) |
중복 제거
List<Integer> list = List.of(3, 1, 3, 2, 1);
Set<Integer> set = new HashSet<>(list);            // [1, 2, 3] (순서 보장 X)
Set<Integer> kept = new LinkedHashSet<>(list);     // [3, 1, 2] (넣은 순서 유지)
lst = [3, 1, 3, 2, 1]
s = set(lst) # {1, 2, 3} (순서 보장 X)
kept = list(dict.fromkeys(lst)) # [3, 1, 2] (넣은 순서 유지)이미 본 값인지 확인
자바 add()는 새로 추가되면 true, 이미 있으면 false 를 반환한다. 중복 체크와 추가를 한 번에 할 수 있다.
Set<Integer> seen = new HashSet<>();
for (int x : arr) {
    if (!seen.add(x)) {
        System.out.println(x + " 중복!");
    }
}
seen = set()
for x in arr:
if x in seen:
print(x, "중복!")
seen.add(x)집합 연산
| 연산 | 자바 (원본 a가 바뀜) | 파이썬 (새 셋 반환) |
|---|---|---|
| 합집합 | a.addAll(b) | a \| b |
| 교집합 | a.retainAll(b) | a & b |
| 차집합 | a.removeAll(b) | a - b |
| 부분집합인지 | a.containsAll(b) (b ⊂ a) | b <= a |
자바 집합 연산은 원본을 바꾼다. 원본을 남기려면
Set<Integer> c = new HashSet<>(a); c.retainAll(b);처럼 복사 후 연산한다.
5. 키로 쓸 수 있는 것
| 키 | 자바 | 파이썬 |
|---|---|---|
| 숫자 · 문자열 | ⭕ | ⭕ |
좌표 (x, y) | x + "," + y 문자열 / List.of(x, y) | 튜플 (x, y) ⭕ |
| 배열 · 리스트 | int[] ❌ (주소로 비교됨) | list ❌ (TypeError: unhashable) |
Set<String> visited = new HashSet<>();
visited.add(x + "," + y);

// int[]를 키로 쓰면 값이 같아도 다른 키로 취급된다
Set<int[]> bad = new HashSet<>();
bad.add(new int[]{1, 2});
bad.contains(new int[]{1, 2});   // false
visited = set()
visited.add((x, y)) # 튜플은 OK
visited.add([x, y]) # ❌ TypeError💡 이것만 기억하자
- 없는 키 조회: 자바
null, 파이썬KeyError
둘 다getOrDefault/get(k, 0)으로 안전하게 쓰자. - 개수 세기: 자바
getOrDefault + 1또는merge, 파이썬get + 1또는Counter - 키 + 값 순회: 자바
entrySet(), 파이썬items() - 파이썬 빈 셋은
set(),{}는 딕셔너리다. - 자바
set.add()는 중복이면false중복 체크를 한 줄로! - 좌표를 키로 쓸 때: 자바는 문자열, 파이썬은 튜플
배열과 리스트는 키가 될 수 없다. - 순서:
HashMap/HashSet은 순서 보장 X, 파이썬dict는 넣은 순서 유지