2026.05.18(월)
LG CNS AM Inspire Camp 1일차
LG CNS AM Inspire Camp 에 참여하게 되었다.
풀스택 강좌 수강을 할 수 있는 것과 더불어 프로젝트 경험도 풍부하게 제공받을 수 있을 거 같아서 선택했다.
서비스를 A to Z 까지 설계해서 제작할 수 있는 점이 마음에 들어서 선택해서 수강하기로 결정 !
오늘은 OT 이후 첫 온라인 수업날인데 오전 오후에 학업 병행하느라 클라우드 특강 수강을 못 했음 (😟아쉽)
따로 공부하고 싶었지만 특강 자료는 추후에 남지 않는다길래 끝에만 잠깐 들었음 (😟2배로 아쉽)
쿠버네티스란?
컨테이너로 실행되는 여러 프로그램(서비스)을 여러 대의 서버에 걸쳐 자동으로 배치·실행·복구·확장해주는 운영(오케스트레이션) 시스템이다.
- 서버 여러 대 중 어디에 올릴지 (스케쥴링)
- 죽으면 다시 살릴지
- 트래픽이 늘면 복제본을 늘릴지 (오토 스케일)
- 버전 업데이트를 끊김 없이 할지 (롤링 업데이트)
같은 운영 문제를 자동화해준다.
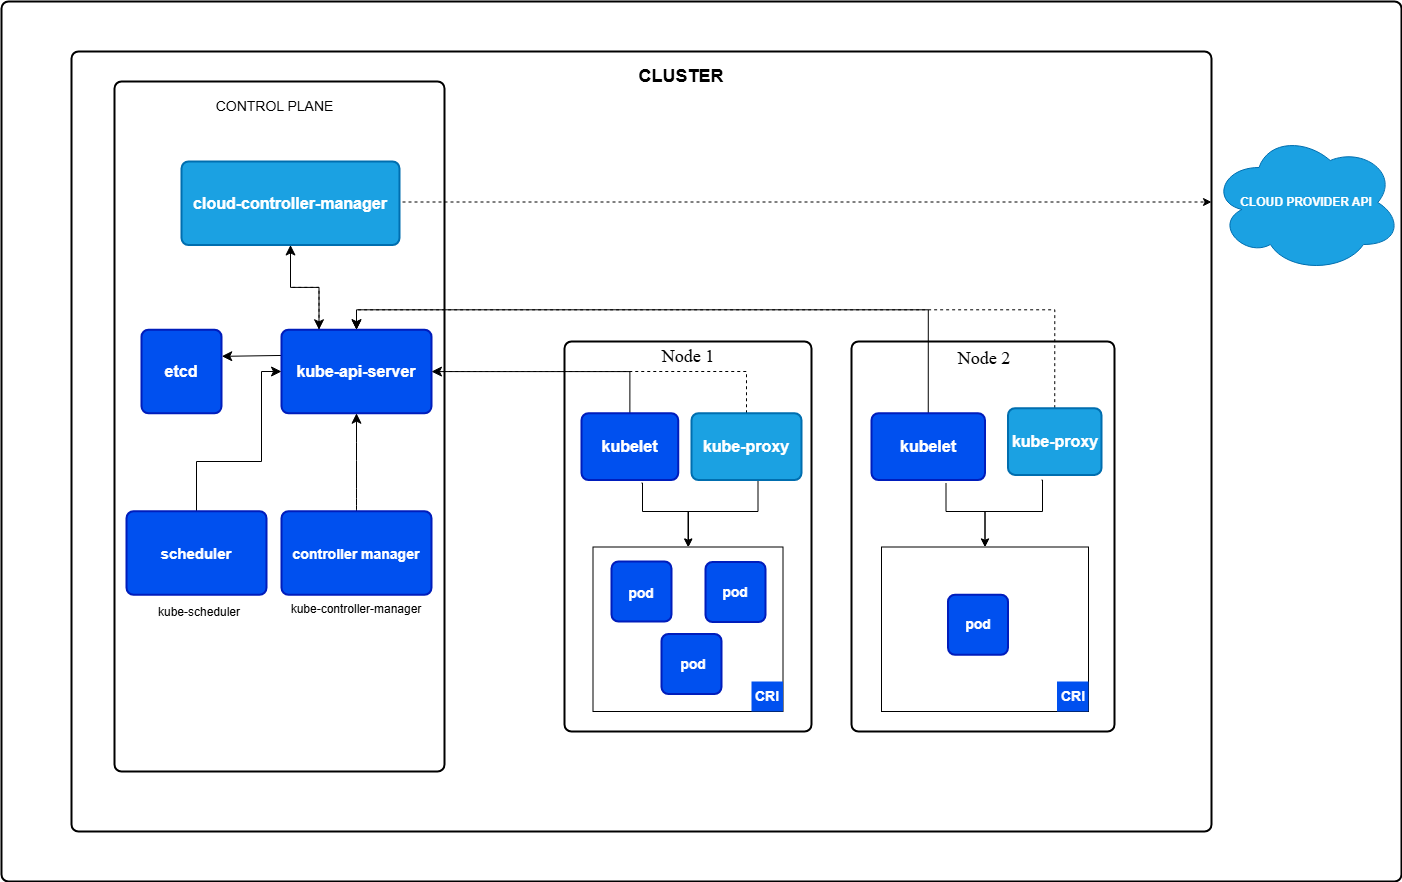
1) 큰 틀: Cluster = Control Plane + Nodes
Control Plane: “원하는 상태(Desired State)”를 저장/판단/결정하는 관리 영역
Node 1/Node 2(워커 노드): 실제로 Pod(컨테이너들) 를 실행하는 서버들
2) Control Plane 구성요소
(1) kube-api-server (중앙 관문)쿠버네티스의 유일한 공식 입구
kubectl 같은 클라이언트, 그리고 내부 컴포넌트들(스케줄러/컨트롤러/노드의 kubelet 등)이 모두 API Server와 통신
“클러스터 상태 조회/수정” 요청을 받으면 검증하고 etcd에 반영
(2) etcd (상태 저장소, 분산 KV DB)클러스터의 “정답지” 저장소
파드가 몇 개여야 하는지, 어떤 디플로이먼트가 있는지, 현재 상태가 뭔지 같은 모든 메타데이터를 저장
kube-api-server가 읽고/쓰는 핵심 저장소라서 중요함
(3) scheduler (배치 담당)“새 Pod를 만들라”는 요청이 생기면,
어떤 노드에 올릴지 결정(스케줄링)해
기준: 노드 자원(CPU/메모리), taint/toleration, affinity, 제약조건 등
(4) controller manager (상태를 맞추는 자동 조정기들)쿠버네티스의 핵심 철학: 원하는 상태(Desired) = 실제 상태(Actual) 가 되도록 계속 감시/조정
예) Deployment가 “파드 3개 유지”인데 실제로 2개면 → 새로 생성 지시
노드 장애, 레플리카 수 유지, 잡(Job) 완료 여부 등 다양한 컨트롤러가 들어있음
(5) cloud-controller-manager (클라우드 연동 담당)AWS/GCP/Azure 같은 클라우드 제공자 API와 통신하는 부분(그림 오른쪽 “CLOUD PROVIDER API”로 점선 연결)
예: Service 타입이 LoadBalancer면 실제 클라우드 로드밸런서를 만들고, 노드/라우팅/볼륨 같은 리소스를 클라우드에 요청'
3) Worker Node(노드) 구성요소
(1) kubelet (노드 에이전트)각 노드에 상주하는 “현장 직원”
API Server로부터 “이 노드에 이 Pod 띄워” 같은 스펙을 받아서,
CRI(컨테이너 런타임: containerd 등) 에게 컨테이너 실행/중지 명령을 내려 실제로 Pod를 실행
Pod 상태를 주기적으로 API Server에 보고
(2) kube-proxy (네트워킹/서비스 트래픽 라우팅)Service(서비스)라는 “고정된 접근점”을 실제 Pod들로 연결해주는 네트워크 규칙을 노드에 설정
구현은 환경에 따라 iptables/IPVS 등을 사용
결과적으로 “서비스로 들어온 트래픽이 여러 Pod로 로드밸런싱”되게 만드는 데 관여
(3) Pod + CRIPod: 쿠버네티스의 최소 배포/실행 단위(보통 컨테이너 1개 이상)
CRI: kubelet이 실제 컨테이너 런타임과 통신하는 인터페이스(노드 안에서 컨테이너를 돌리는 엔진 쪽)
4) 전체 동작 흐름(그림을 “흐름도”로 읽기)사용자가 kubectl apply 등으로 “Deployment 만들기” 요청
요청은 kube-api-server로 들어감 → 검증 후 etcd에 저장
controller manager가 “원하는 상태(예: 파드 3개)”를 보고 실제 상태와 비교 → Pod 생성이 필요함을 감지
아직 노드가 정해지지 않은 Pod를 scheduler가 보고 “Node 1에 배치” 결정
해당 노드의 kubelet이 API Server를 통해 할당된 Pod 스펙을 받아 CRI로 컨테이너 실행
외부/내부 트래픽은 Service → kube-proxy 규칙 → 실제 Pod로 전달
클라우드 리소스가 필요하면 cloud-controller-manager ↔ Cloud Provider API로 실제 로드밸런서/볼륨 등을 생성함
TIL 예고 계획
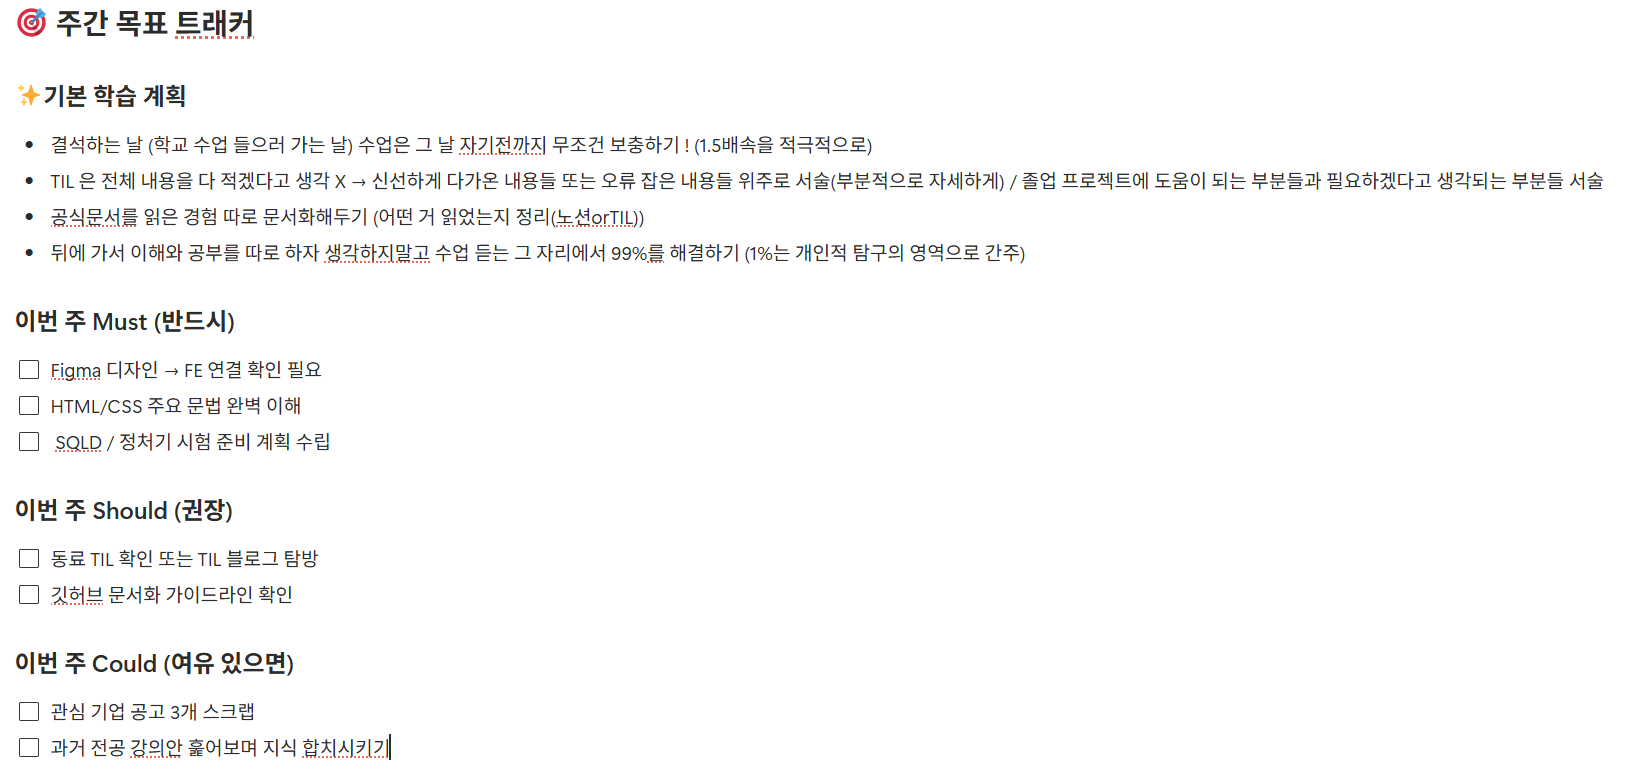
권장받은 노션 템플릿이 좀 복잡해서 DB 정리가 필요할 거 같은데 시간 날 때 천천히 하기로 했음