이제 서비스에서 필요한 데이터를 위해 파이썬을 위해서 데이터를 약간 변형시켜주었다.이전에 머신러닝에서 데이터 전처리했던 경험을 활용해 파이썬 판다스를 이용했다.(아주 간단한 파이썬 코드...)
백엔드 api를 만들면서 데이터를 가공하는 방법도 있겠지만 아직 초보자인 나는 정제된 데이터가 필요하다고 생각되어 이렇게 진행했다.
크게 두가지 필드를 변경시켰고 한가지(정확히 하자면 2개) 필드를 추가시켰다.
1. category 수 줄이기
처음 제공되는 카테고리는 다음과 같았다
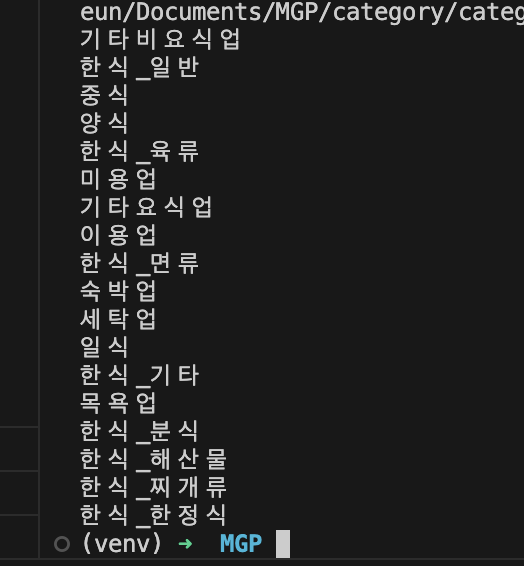
그런데 카테고리를 이대로 사용하면 화면에 카테고리가 넘칠 것 같았다. 또한 음식 위주로 보여주고 싶었고 사용자도 한눈에 카테고리를 알아볼 수 있도록 다음과 같이 구성했다
중식
양식
일식
한식
기타
import pandas as pd
import numpy as np
import json

file_path = './goodprice08.csv'
df = pd.read_csv(file_path)

# 카테고리 정제
for i,cate in enumerate(df['업종']):
    category = cate[:2]
    if category == "한식":
        df.loc[i,'업종'] = "한식"
    elif category not in ["일식", "중식", "양식"]:
        df.loc[i,'업종'] = '기타'

output_file_path = './mygoodprice2.csv'
df.to_csv(output_file_path, index=False)
한식_찌개류,.. 이런식으로 되어있기 때문에 그냥 한식으로 시작하면 한식으로 통일 시켜주고
한식, 일식, 중식, 한식, 양식으로 시작하지않으면 모두 기타로 바꿔버렸다.
2. menu 배열로 바꾸기
프론트 단에서 이런식의 메뉴를 원했다
        "name": "먹고갈래지고갈래",
        "state": "서울특별시",
        "city": "종로구",
        "category": "한식",
        "address": "서울특별시 종로구 수표로 117 (낙원동)",
        "tel": "02-367-1239",
        **"menu": [
            {
                "id": 1,
                "menu": "삼계탕",
                "price": 13000
            },
            {
                "id": 2,
                "menu": "산채비빔밥",
                "price": 7000
            }
			    ],**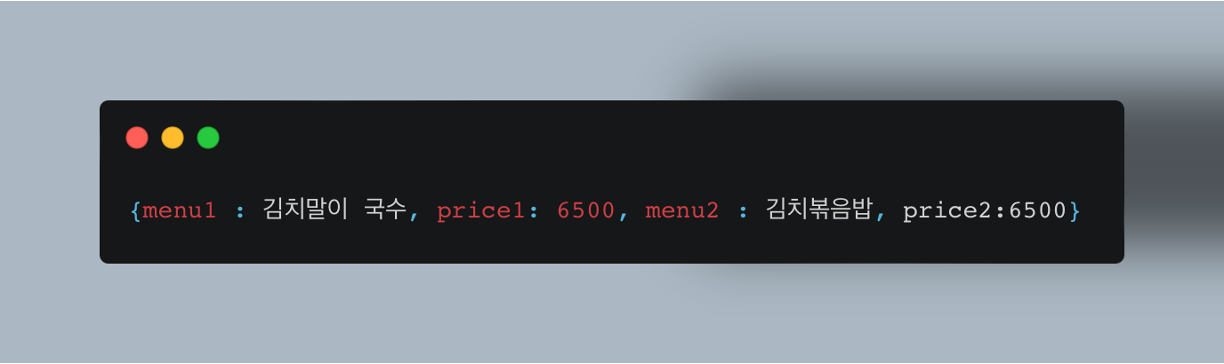
이런 메뉴에서
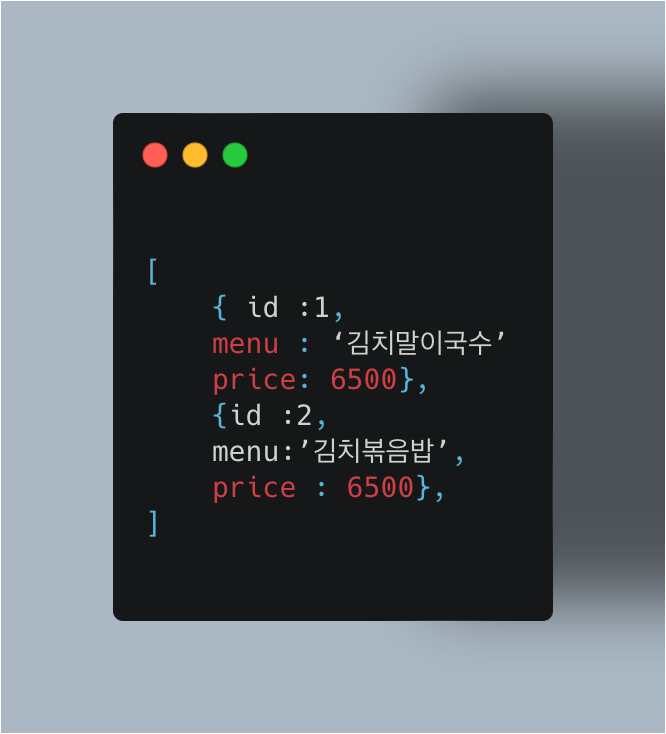
위 처럼 변경시킨 것이다.
다음과 같이 코드를 작성했다.
for i in range(len(df)):
    menu_list = []
    if not pd.isna(df.loc[i, '메뉴1']):
        menu_list.append({
            "id": 1,
            "menu": df.loc[i, '메뉴1'],
            "price": int(float(df.loc[i, '가격1'])) if not np.isnan(df.loc[i, '가격1']) else ""
        })
    if not pd.isna(df.loc[i, '메뉴2']):
        menu_list.append({
            "id": 2,
            "menu": df.loc[i, '메뉴2'],
            "price": int(float(df.loc[i, '가격2'])) if not np.isnan(df.loc[i, '가격2']) else ""
        })
    if not pd.isna(df.loc[i, '메뉴3']):
        menu_list.append({
            "id": 3,
            "menu": df.loc[i, '메뉴3'],
            "price": int(float(df.loc[i, '가격3'])) if not np.isnan(df.loc[i, '가격3']) else ""
        })

    # SON 문자열로 변환
    df.at[i, 'menu'] = json.dumps(menu_list, ensure_ascii=False)

df = df.drop(columns=['메뉴1','메뉴2','메뉴3','가격1','가격2','가격3'])

output_file_path = './mygoodprice2.csv'
df.to_csv(output_file_path, index=False)
하지만 여기서 문제가 많이 생겼다..
몽고디비와.. 정확히 말하자면 EJSON을 잘 몰랐기 때문일 것이다.
데이터 csv 파일을 처음에 몽고디비에 import 했을 때 EJSON을 잘 몰라서 배열은 안되는구나 string으로 해야하는 구나 생각했다.
(이래서 기초가 중요하다-EJSON 대한 글을 따로 작성하겠다)
df.at[i, 'menu'] = json.dumps(menu_list, ensure_ascii=False)
를 추가해주지 않으면 string형식이 되고
nest js에서 string을 다시 파싱해서 배열로 변환해야하며
배열 타입 자체로 변환하는 법을 몰랐기 때문에 쿼리문을 써야하는 필터링 작업에서 꽤나 애를 먹었다.(메뉴필터링 - 트러블슈팅에서 확인가능하다)
아무튼 이렇게해서 변환해야하는 두가지 필드는 이렇게 준비가 완료되었다.
다음 게시글은 위도, 경도를 추가한 것에 관한 글이다.