외부 API가 실패해도 20분 녹음을 잃지 않게, 음성 채점을 비동기로 바꾸기
외부 API가 실패해도 20분 녹음을 잃지 않게, 음성 채점을 비동기로 바꾸기
사용자가 영어로 말한 답변을 녹음해 올리면, STT로 텍스트를 뽑고 LLM이 채점해 피드백을 돌려주는 OPIc 연습 서비스를 만들고 있어요. 한 번 제출할 때 여러 문항을 함께 올리고, 모의고사는 15문항이에요.
처음 성능 작업의 기준은 처리량이었어요. 500VU 부하 테스트에서 처리량을 RPS 96에서 652로 끌어올렸습니다.
그런데 구조를 다시 보니 문제는 처리량이 아니라 유실이었어요. 1분 동안 말한 답변이 외부 API의 일시적인 오류 한 번, 서버 재시작 한 번에 사라질 수 있는 구조였습니다. 이 유실을 없애는 동안 재시도가 일어나는 곳은 브라우저에서 서버의 요청 안으로, 다시 워커로 옮겨갔어요.
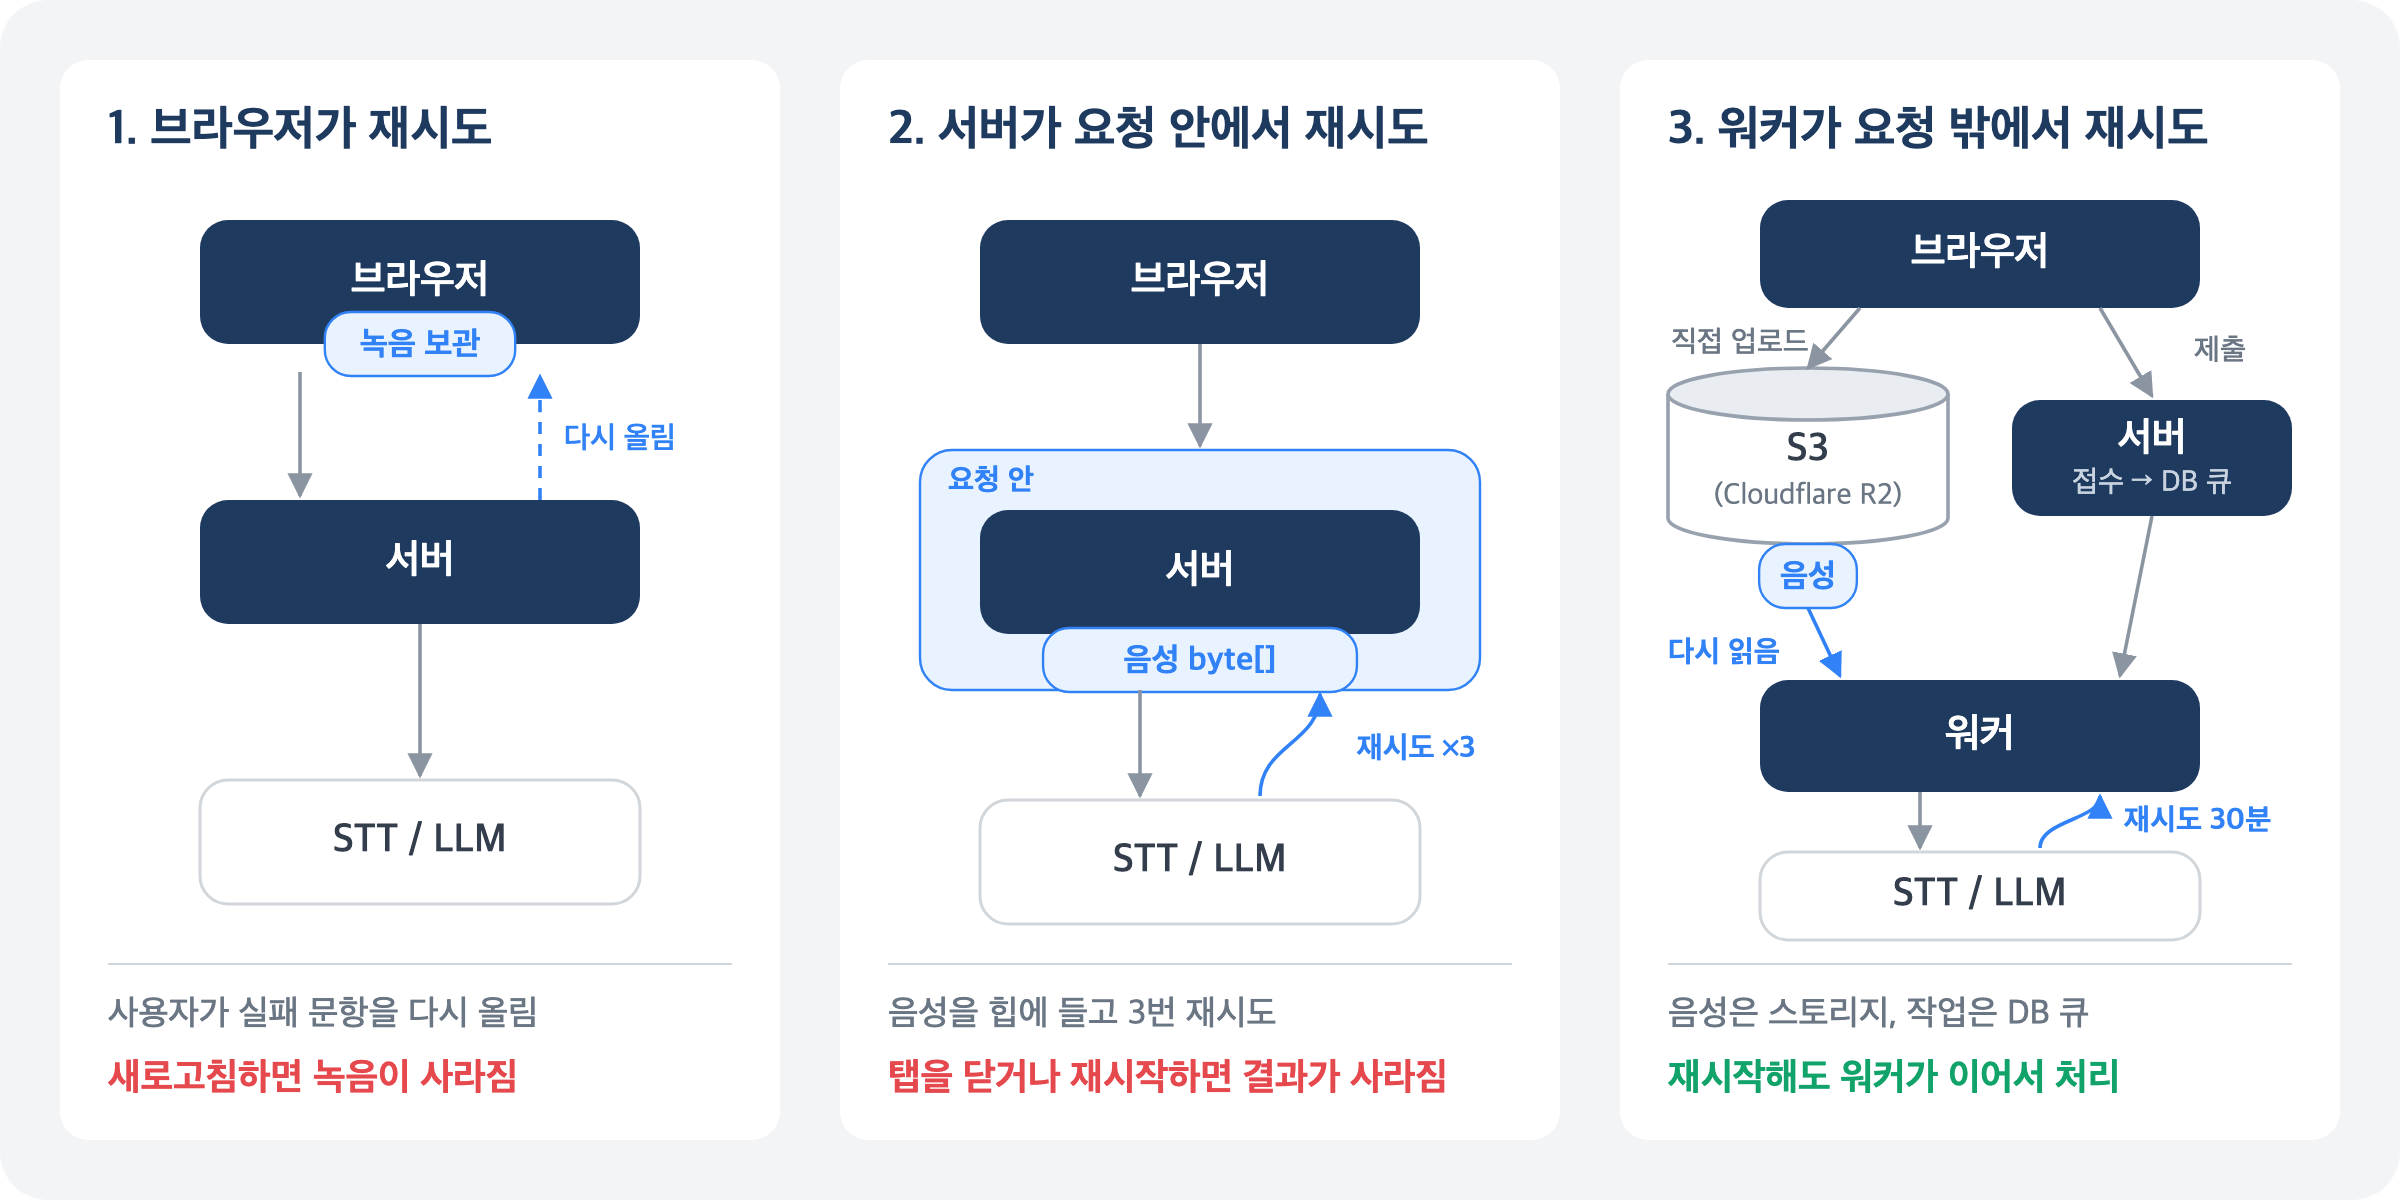
그림 1. 재시도가 일어나는 위치. 브라우저에서 요청 안으로, 다시 요청 밖의 워커로 옮겨갔다
처리량을 기준으로 만든 구조
500VU에서 가장 크게 막힌 곳은 업로드된 음성 파일을 톰캣이 디스크에 쓰는 구간이었어요. 그래서 음성 파일을 디스크에 쓰지 않고, 들어오는 스트림을 그대로 STT API로 넘기는 릴레이 방식으로 바꿨습니다. 음성 파일은 서버를 지나갈 뿐 어디에도 남지 않았어요.
이 구조는 재시도와 맞지 않았어요. 스트림은 한 번 읽으면 끝이라, 외부 API가 실패했을 때 다시 보낼 데이터가 서버에 없습니다. 그래서 처음엔 재시도를 브라우저에 맡겼어요. 서버는 실패한 문항 번호만 돌려주고, 녹음을 가지고 있는 브라우저가 그 문항만 다시 올리는 방식이에요. 다만 녹음은 브라우저 메모리에만 있어서 새로고침하면 사라졌고, 재시도도 사용자가 직접 눌러야 했어요.
1분 동안 말한 답변을 일시적인 오류 때문에 다시 녹음하게 하는 건 받아들이기 어려웠어요. 재시도를 서버로 가져오려면 음성 파일 전체를 어딘가에 보관해야 했고, 선택지는 셋이었어요.
A. 힙에 byte[]로 보관     → 메모리 복사 감수
B. 디스크 임시 파일        → 방금 없앤 디스크 병목으로 회귀
C. 외부 스토리지(S3)       → 아키텍처 변경
처리량이 기준이던 때라 아키텍처를 바꾸는 C는 과하다고 보고 A를 골랐어요. 당시 개발 일지에는 "동기 구조에서는 피할 수 없는 트레이드오프"라고 적었습니다. 비용은 부하 테스트에서 바로 드러났어요. 500VU에서 초당 800MB가 힙에 올라왔고, 2GB 힙에서 Full GC가 30초에 세 번 일어났어요.
문제는 처리량이 아니라 유실이었다
힙 비용을 줄이기 전에, 500VU가 이 서비스에 맞는 부하인지부터 계산해봤습니다. 국내 상위 AI 스피킹 앱의 MAU가 24만 정도예요. 이 규모를 가정하면 이렇습니다.
MAU 24만 × DAU 비율 25%          = DAU 6만
DAU 6만 × 하루 3회                = 하루 18만 건 제출
저녁 3시간에 40% 몰림              = 초당 6.7건 제출 (약 23문항, 공채 시즌엔 46문항)
초당 6.7건 × 처리 시간 7.5초       = 동시 제출 약 50건
500VU는 이 피크의 10배예요. 녹음하는 시간을 사이에 두고 하루에 몇 번 제출하는 서비스라, 사용자가 늘어도 동시 요청은 크게 늘지 않아요.
동시 제출 30건으로 다시 재보니, 응답 시간은 한 명일 때와 같았고 힙도 평소에는 가벼웠어요. 힙이 무거워지는 건 외부 API가 불안정할 때였어요. 재시도가 길어지는 만큼 음성 파일이 힙에 오래 남으니까요.
대신 사용자 한 명의 입장에서 보니 다른 문제가 보였어요. 15문항 모의고사는 채점이 끝나기까지 7.6초가 걸리는데, 그 사이에 사용자가 탭을 닫거나 서버가 재시작되면 결과가 하나도 남지 않았어요. 결과는 요청이 끝날 때 한꺼번에 저장되고, 서버로 가져온 재시도도 요청 안에서 돌았기 때문이에요. 받은 답변을 끝까지 처리할 책임이 요청 하나에 묶여 있었던 거예요.
그래서 질문을 바꿨어요. 채점은 누가 끝까지 책임져야 할까요? 그러려면 음성 파일은 얼마나 오래 남아 있어야 할까요?
음성 파일을 외부 스토리지에 두기
책임을 서버로 가져오려면 제출을 받는 일과 채점하는 일을 나눠야 해요. 제출은 바로 접수하고, 채점은 서버가 뒤에서 끝까지 맡는 비동기 구조입니다.
그러면 음성 파일은 요청보다 오래 남아 있어야 해요. 서버가 재시작된 뒤에도, 몇 번째 재시도에서도 다시 읽을 수 있어야 하니까요. 앞의 선택지를 다시 검토했는데, 이번에는 기준이 달랐어요. 힙을 아끼는지가 아니라 요청과 프로세스가 끝나도 남아 있는지를 봤습니다.
- 서버 로컬 디스크는 인스턴스에 묶이고, 서버가 여전히 음성 파일을 받아야 해요.
- NFS 같은 공유 파일시스템은 재시작 문제는 풀지만, 브라우저가 직접 올릴 수 없어요.
- DB BLOB도 직접 업로드가 안 되고, 파일이 쌓이면 백업과 복제가 무거워져요.
- 오브젝트 스토리지는 HTTP로 접근하니 브라우저가 직접 올릴 수 있어요.
브라우저가 스토리지에 직접 올리면 서버는 음성 파일을 아예 받지 않습니다. 업로드용 presigned URL에 파일 크기와 타입을 서명해두면, 다른 크기로 올리는 요청은 스토리지가 403으로 거절해요. 이 글에서는 S3라고 부르지만, 실제로는 이그레스 비용이 없고 S3 API와 호환되는 Cloudflare R2를 썼어요.
이렇게 하자 앞에서 적어둔 트레이드오프도 사라졌어요. 음성 파일이 요청 경로에 있는 동안에는 "스트림으로 넘길지, 복사해두고 재시도할지"를 골라야 했습니다. 파일이 프로세스 밖에 있으면 고를 필요가 없어요. 요청은 파일을 다루지 않고, 워커는 재시도할 때마다 스토리지에서 다시 읽으면 됩니다.
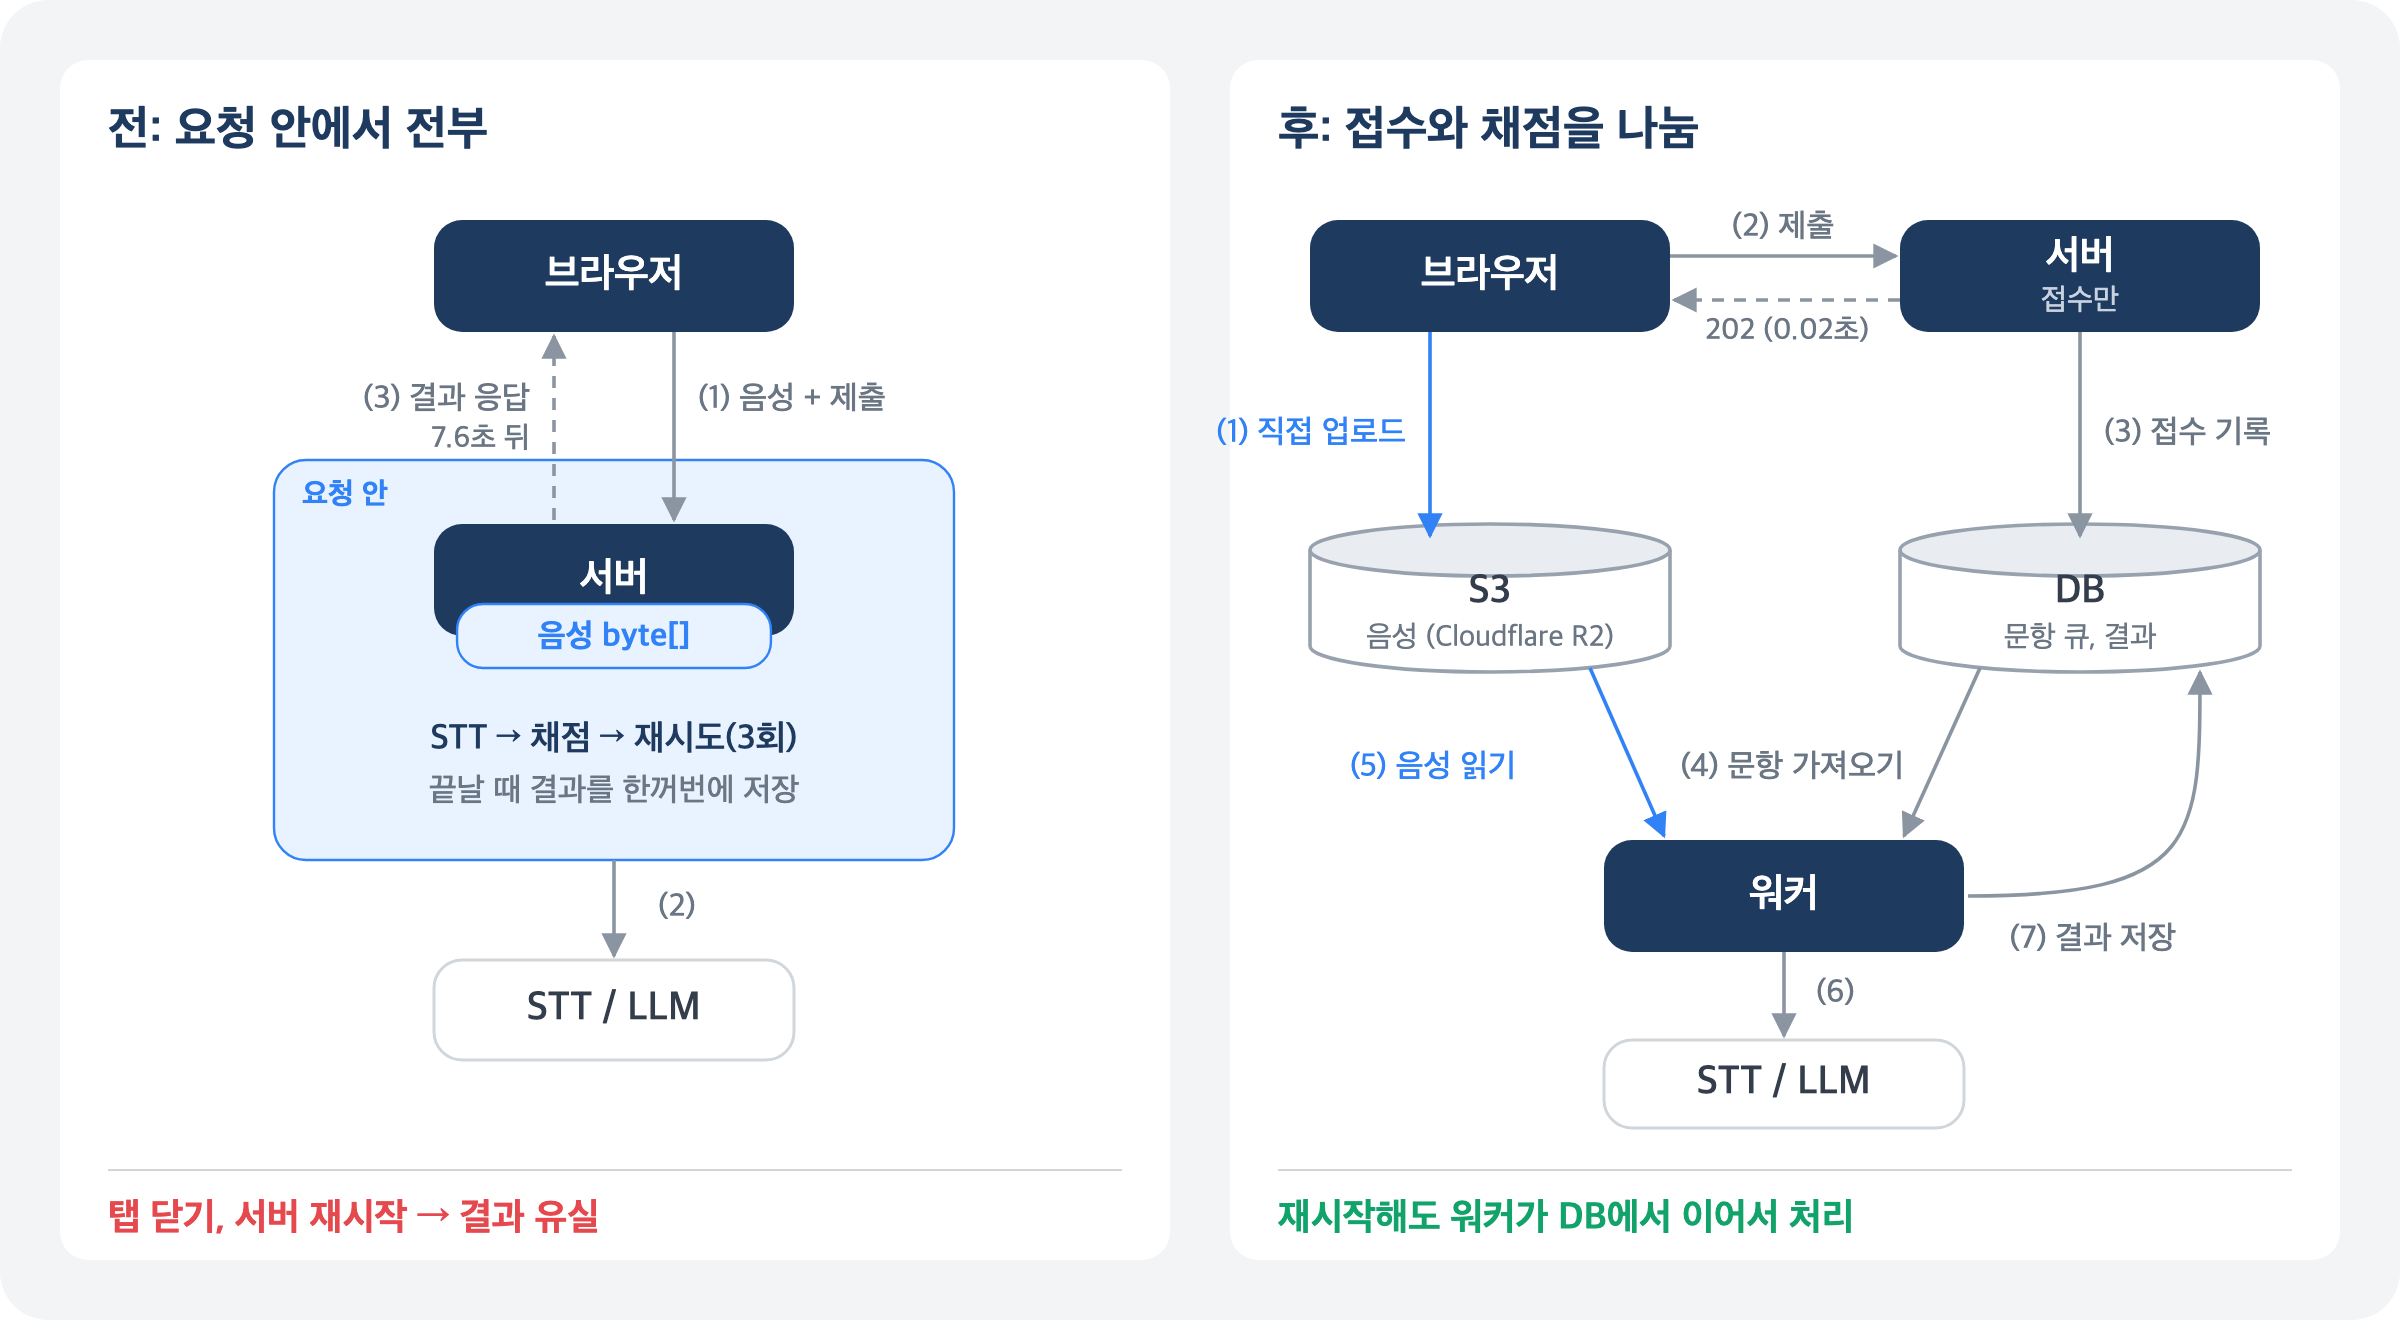
그림 2. 전: 요청 안에서 전부 처리 / 후: 브라우저가 S3에 직접 올리고, 서버는 접수만, 워커가 DB 큐에서 꺼내 처리
비동기 전환에서 정한 것들
결과는 폴링으로 전달
접수와 채점을 나누면, 서버는 접수만 하고 바로 202 Accepted를 돌려줘요. 그러면 채점이 끝난 결과는 화면이 어떻게 받아야 할까요?
SSE는 문항이 끝날 때마다 결과를 보내줄 수 있지만, 연결을 서버 메모리에 유지해야 해요. 서버가 재시작하면 연결이 끊기고, 서버가 여러 대가 되면 연결을 공유할 방법도 필요합니다. 브라우저에서 보낼 데이터가 없으니 WebSocket의 양방향 통신도 필요 없었어요.
이 전환의 기준은 "재시작해도 받은 답변을 잃지 않는다"예요. 결과 전달이 재시작에 약하면 앞에서 한 일이 의미가 없어집니다. 폴링은 매번 DB를 읽으니 서버가 방금 다시 떴어도 같은 결과를 줘요. 그래서 폴링을 택했어요.
대신 결과가 폴링 간격만큼 늦게 보일 수 있어요. 처음 30초는 2초마다 조회하고, 오래 걸릴수록 5초, 10초, 30초로 간격을 늘리다가 10분이 지나면 멈춰요. 보이지 않는 탭은 조회하지 않아요. 장애가 길어지면 결과를 기다리는 화면이 쌓이는데, 모두 2초마다 조회하면 밀린 문항을 처리하느라 DB가 가장 바쁠 때 조회도 가장 많아지기 때문이에요.
화면은 문항 단위로 채워요. 끝난 문항부터 피드백을 보여주고, 남은 문항은 "분석 중"으로 두었다가 끝나면 채워요. 30초가 지나도 남은 문항이 있으면 화면을 떠나도 된다고 안내하고, 다음 방문 때 끝난 결과를 알려줘요.
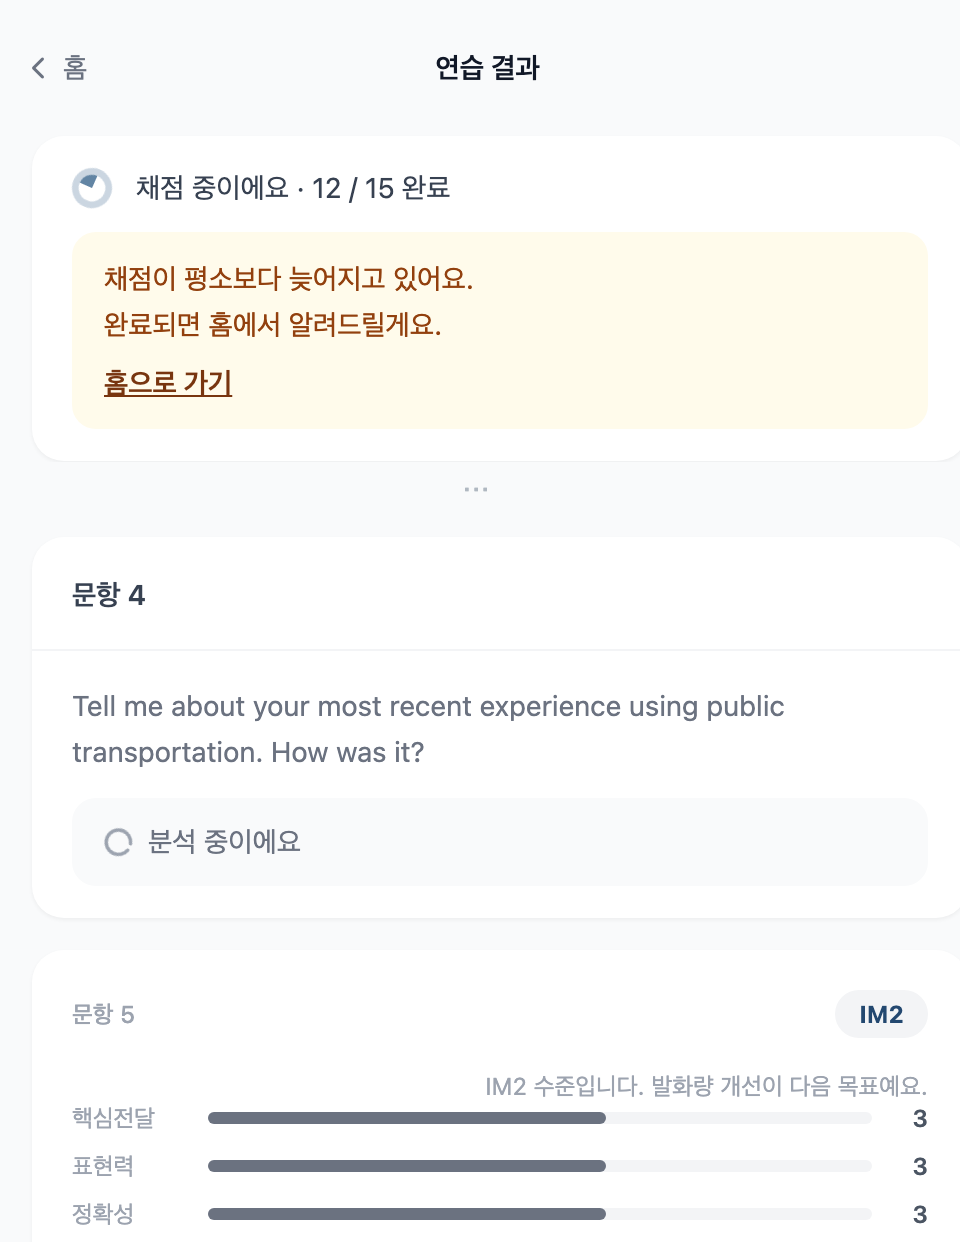 *그림 3. 15문항 중 12개가 끝난 시점. 끝난 문항은 먼저 보여주고, 30초가 지나면 떠나도 된다고 안내한다*
큐를 DB에 둔 이유
뒤에서 처리하려면 작업을 담아둘 큐가 필요해요. 큐라고 하면 Kafka 같은 메시지 큐가 먼저 떠오르지만, 꼭 별도의 큐가 필요할까요? 작업의 성격부터 봤어요.
채점 결과도, 문항의 상태(대기, 처리 중, 완료, 실패)도 DB에 있어야 해요. 큐를 DB 테이블로 두면 "결과를 저장하고 상태를 완료로 바꾸는" 일이 한 트랜잭션으로 끝나요. 큐를 따로 두면 "큐에서는 꺼냈는데 저장은 실패한" 경우를 별도로 처리해야 합니다. 초당 수천 건이 오가는 작업도 아니어서, 워커가 1초마다 DB를 조회하는 것으로 충분했어요.
재시작 문제도 함께 해결됐어요. 서버가 다시 뜨면 워커가 DB에서 끝나지 않은 문항을 다시 가져옵니다.
저장과 재시도의 단위는 제출이 아니라 문항으로 했어요. 15문항 중 12개를 끝내고 서버가 죽으면 12개는 그대로 남고, 3개만 이어서 처리해요. 제출 단위로 묶으면 "끝까지 못 가면 전부 유실"되는 문제가 그대로 남습니다.
슬롯은 몇 개가 필요할까
워커가 동시에 처리할 수 있는 문항 수를 슬롯이라고 할게요. 슬롯 수는 리틀의 법칙으로 정했어요. 동시에 처리 중인 작업 수는 유입 속도와 처리 시간의 곱이라는 관계예요. 피크에 초당 23문항이 들어오고 한 문항에 8초가 걸리니, 동시에 약 190문항을 처리하고 있어야 대기 줄이 늘지 않아요.
실제로 피크 부하를 걸어보니 슬롯 60개로는 유입의 3분의 1만 처리해서 5분 만에 대기 줄이 5,800건까지 쌓였고, 200개에서 대기 줄이 늘지 않았어요. 그래서 200개로 정했어요.
서버가 맡은 재시도의 한도
동기 구조의 재시도는 "문항마다 최대 3번"이었어요. 사용자가 요청을 붙잡고 기다렸으니, 재시도가 길어지면 사용자의 대기도 길어져서 빨리 끝내야 했죠.
그런데 3번의 재시도는 10초 안에 끝나요. 외부 API가 20초만 불안정해도 그 사이에 들어온 문항은 전부 실패로 끝납니다. 조금만 더 기다렸으면 성공했을 문항이에요.
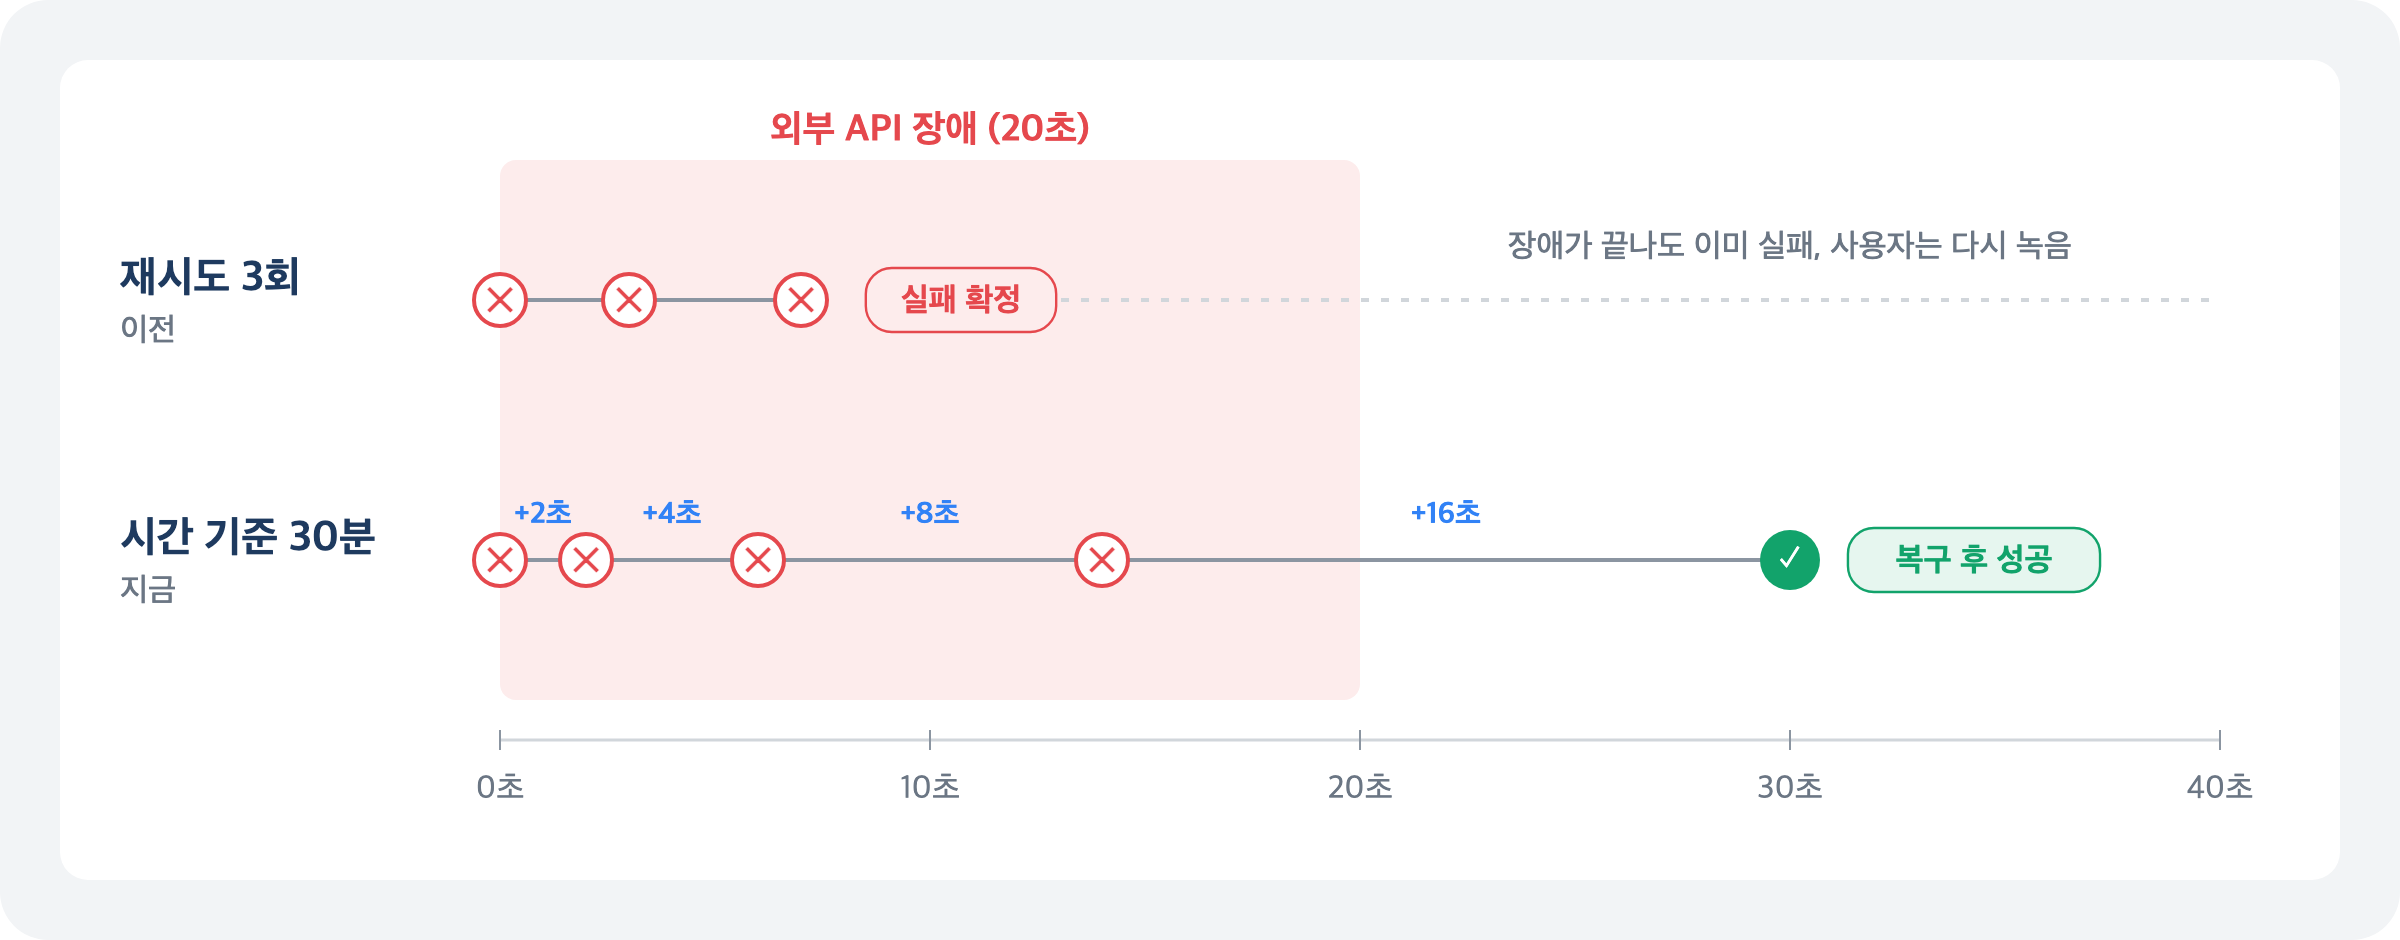
그림 4. 20초 장애에서 3회 재시도는 장애 도중에 실패를 확정하고, 시간 기준은 복구 뒤에 성공한다
그렇다면 비동기에서는 얼마나 오래 재시도해야 할까요? 이제 사용자는 요청에 묶여 있지 않아요. 그리고 사용자에게는 실패가 지연보다 훨씬 비싸요. 몇 분 늦게 받는 것과 15문항을 다시 녹음하는 것은 비교하기 어려우니까요. 그래서 횟수 대신 시간을 기준으로, 훨씬 오래 재시도하기로 했어요.
이때 생기는 문제는, 재시도를 멈춰줄 사람이 없다는 거예요. 사용자는 두세 번 시도하다 포기하지만 서버는 포기하지 않아요. 수백 개 문항이 계속 재시도하면, 이미 불안정한 외부 API에 부하를 더 얹게 돼요. 그래서 얼마나 자주 호출할지와 언제 그만둘지를 따로 정했어요.
호출 빈도는 이렇게 제한했어요.
- 지수 백오프로 간격을 2초, 4초, 8초로 늘리되 1분을 넘기지 않아요. 오래 재시도해도 문항 하나가 호출하는 건 분당 한 번 정도예요.
- 429는 다른 오류보다 길게 기다려요. 짧은 간격으로 다시 보내면 또 429를 받으니까요.
- STT가 성공한 결과는 DB에 저장해요. 채점만 실패했는데 STT부터 다시 호출하면 불필요한 호출로 429를 자초해요. 부하 테스트에서 15문항의 재시도가 STT 호출 43건과 429 21번으로 번진 적이 있습니다.
그만두는 시점은 기다리면 해결되는 실패인지에 따라 나눴어요.
- 일시적 실패(429, 5xx, 타임아웃)는 접수 후 30분까지 재시도해요.
- 영구 실패(녹음 파일이 없거나, 제공자가 파일 자체를 거절)는 다시 해도 결과가 같으니 바로 실패로 처리해요.
- LLM 응답 형식 오류(점수 누락, 범위 밖 값)는 3번까지만 재시도해요. 다시 생성하면 대개 해결되지만 매번 토큰 비용이 들고, 프롬프트나 모델의 문제라면 빨리 실패로 드러나야 하니까요.
화면에서 사라진 실패를 집계하기
동기 구조에서는 실패가 각 사용자의 화면에 흩어져 있었어요. "2번 문항 채점에 실패했어요"를 받은 사용자가 다시 시도하면 끝이었고, 전체에서 몇 건이 실패했는지는 집계되지 않았어요.
비동기로 바꾸면 실패는 화면에 바로 드러나지 않고, 워커가 뒤에서 재시도해요. 그런데 워커가 멈추면 사용자는 에러도 받지 못한 채 기다리기만 하게 돼요. 이것도 유실이에요. 받은 답변을 잃지 않는다고 하려면, 잃고 있을 때 알아챌 수 있어야 했어요.
이제 모든 문항이 하나의 큐를 거치니, 처음으로 실패를 집계하고 원인별로 나눌 수 있게 됐어요. 그래서 워커 지표를 만들었어요. 대기 중인 문항 수, 처리 중인 문항 수, 문항별 결과(완료, 재시도, 실패), 외부 API 실패율, 접수부터 완료까지 걸린 시간이에요.
알림은 CPU나 힙 같은 리소스 지표에 걸지 않았어요. 외부 API가 실패해도 서버의 CPU와 힙은 정상이고 워커는 재시도를 계속할 뿐이라, 리소스 지표에는 변화가 없어요. 대신 사용자가 겪는 증상을 기준으로 걸었어요.
- 사용자가 겪는 증상: 끝난 문항 중 실패 비율, 접수 응답이 0.5초를 넘는 비율, 접수부터 완료까지 1분을 넘는 비율
- 워커 정지: 큐에 문항이 있는데 5분 동안 워커가 한 번도 시도하지 않는 경우. 비동기 구조에서 새로 생긴, 에러 없이 기다리기만 하는 유실이에요.
- 외부 API 실패율: 재시도가 버텨주는 동안 사용자는 아직 영향을 받지 않지만, 운영자는 이 신호로 먼저 알 수 있어요.
아래는 외부 API가 호출의 45%를 실패하게 만든 로컬 실험의 대시보드예요. 외부 API 실패율은 50% 가까이 올랐지만, 문항은 재시도로 늦어졌을 뿐 실패로 끝나지 않았어요. 원인 지표는 장애를 먼저 보여주지만, 사용자가 실제로 피해를 입는지는 증상 지표를 봐야 알 수 있어요.
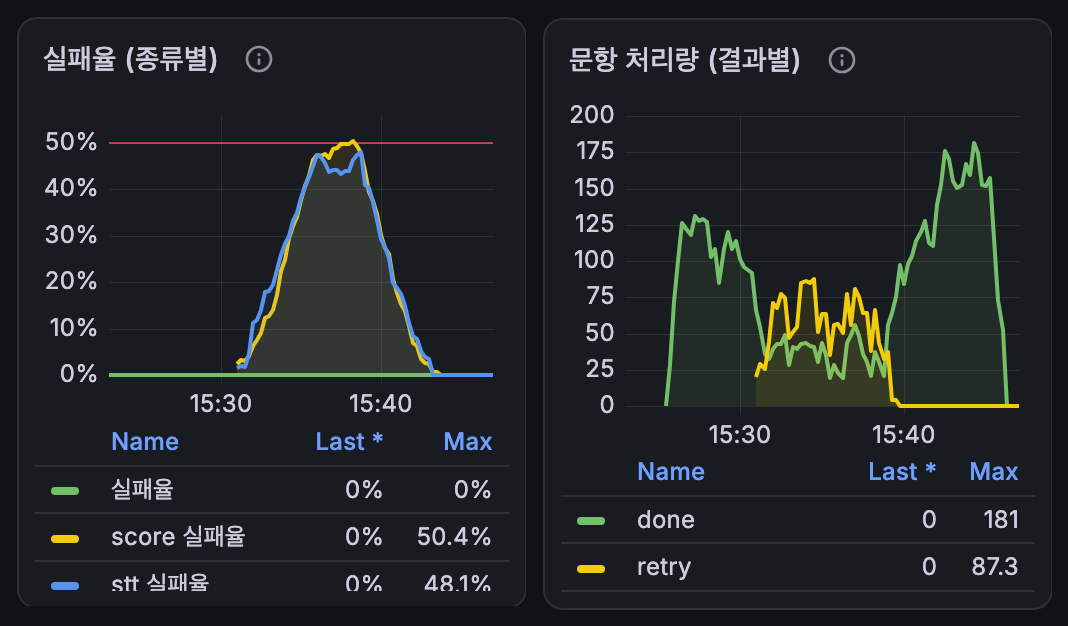
그림 5. 왼쪽: 장애를 주입한 동안 외부 API 실패율이 50% 가까이 오른다. 오른쪽: 그동안 재시도(노랑)가 늘고 완료(초록)가 줄었다가, 장애가 끝나자 밀린 문항이 한꺼번에 완료된다. 실패로 끝난 문항은 0건이라 선이 없다
전환 전후 비교
먼저 전환 전후를 같은 조건에서 비교했어요. 외부 API는 STT 3초, 채점 4.5초가 걸리는 고정 지연 mock으로 대체하고, 동시 제출 30건으로 같은 시나리오를 돌렸어요. 장애 상황은 mock이 호출마다 45% 확률로 실패하게 해서 만들었어요.
| 동시 제출 30건 | 전 (동기) | 후 (비동기) |
|---|---|---|
| 사용자가 요청에 묶여 있는 시간 | 7.6초 (채점 완료까지) | 0.02초 (접수까지) |
| 45% 실패 시 GC 뒤 남은 힙 최대 (힙 512MB) | 375MB | 215MB (-43%) |
| 같은 조건, 힙 256MB에서 OOM | 18회 | 0회 |
| 45% 실패 시 호출 증폭 | 1.50배 | 1.83배 |
| 15문항 전체 완료 시간 | 7.6초 | 10~12초 |
힙 차이는 장애 상황에서 생겼어요. 이전 구조는 재시도하는 동안 접속자마다 음성 파일을 들고 있어서, 사용량에 상한이 없었어요. 지금은 STT를 호출하는 순간의 워커만 음성 파일을 들고 있어서, 상한이 접속자 수가 아니라 슬롯 수에 문항당 음성 크기인 약 4MB를 곱한 값으로 정해져요.
유실은 서버를 직접 종료해서 확인했어요. 접수 직후에 종료한 경우와 14문항이 처리 중일 때 종료한 경우 모두, 재기동한 워커가 이어서 처리해 15문항이 전부 완료됐어요.
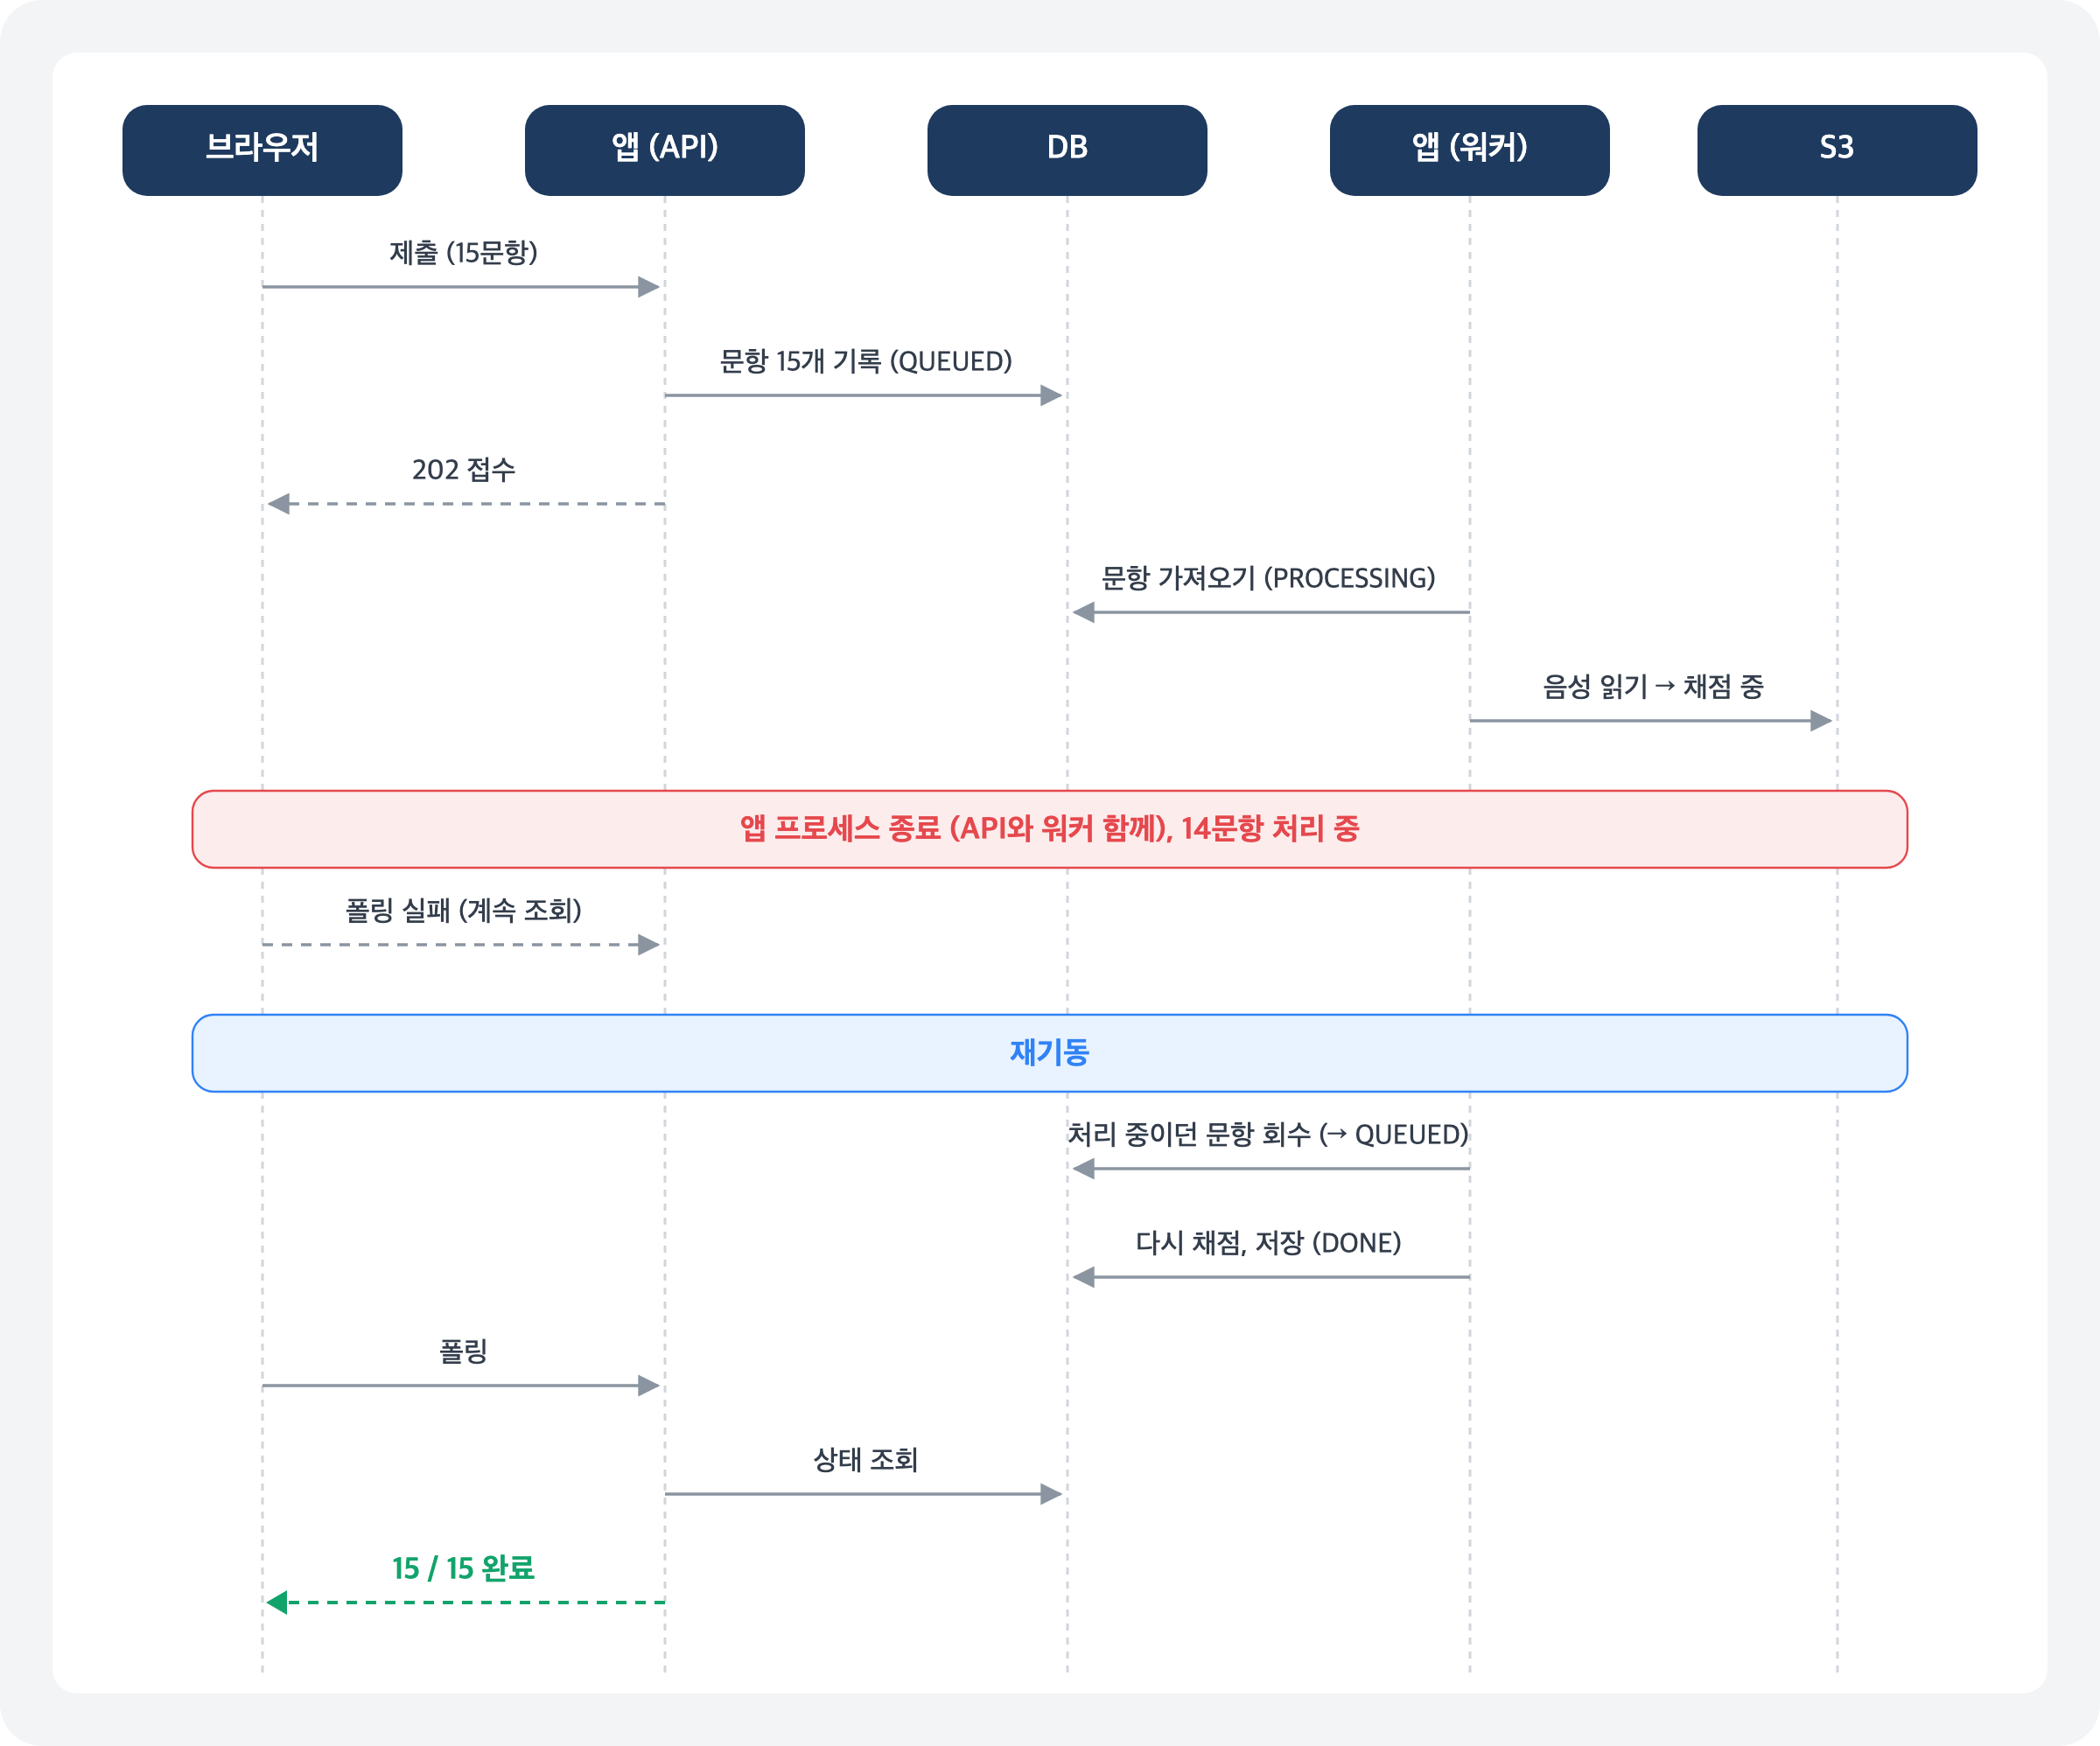
그림 6. 처리 중 앱이 종료돼도, 재기동한 워커가 이어서 처리하고 폴링은 같은 결과를 받는다
외부 API가 불안정할 때도 마찬가지예요. 45% 실패 조건에서 이전 구조는 15.8%가 실패로 끝나 사용자가 다시 제출해야 했지만, 지금은 재시도로 모두 완료됐어요.
대신 치른 비용도 있어요. 이전 구조는 3번 만에 포기했기 때문에 호출이 적었고, 지금은 성공할 때까지 재시도하니 호출이 1.83배로 늘었어요. 호출마다 45%가 실패하면 성공까지 필요한 호출 수의 기대값은 1/(1−0.45) = 1.82배라, 계산과 일치해요. 완료 시간도 스토리지 왕복과 워커가 문항을 가져가는 시간만큼 늘었어요. 비동기로 바꿔서 빨라지지는 않았어요. 달라진 건 결과를 잃지 않게 됐다는 점입니다.
앞에서 가정한 피크 부하에서도 바뀐 구조를 다시 측정했어요.
| 초당 6.7건 제출 (약 23문항, 응답을 기다리지 않고 계속), 슬롯 200 | 결과 |
|---|---|
| 접수 응답 p95 | 약 35ms |
| 대기 줄 | 늘지 않음 (평균 13~26건) |
| 접수부터 완료까지 p95 | 약 10초 |
| 외부 API 5분 완전 장애 중 접수 응답 p95 | 27~35ms |
접수는 DB에 저장만 하고 외부 API를 기다리지 않으니, 외부 API가 멈춰 있어도 접수 응답은 평소와 같았어요.
남은 문제
접수는 지켰지만, 외부 API가 5분 동안 멈췄다가 복구되자 대기 줄에 약 7천 건이 밀렸고, 20분이 지나도 거의 줄지 않았어요. 슬롯 200의 처리 능력이 유입보다 7%밖에 많지 않아서, 밀린 문항이 아주 천천히 빠지기 때문이에요. 이 속도면 다 처리하는 데 몇 시간이 걸려요.
슬롯을 늘리면 될 것 같지만, 실제 제공자는 받을 수 있는 호출량이 정해져 있어요. 슬롯을 늘려도 한도를 넘는 만큼은 429로 돌아와요. 병목은 우리 서버가 아니라 외부 API가 받아주는 양이었어요. 장애 중과 장애 이후에 외부 API를 어떻게 호출할지는 다음 글에서 다룹니다.
돌아보면 "힙이냐 재시도냐"는 둘 중 하나를 고를 문제가 아니었어요. 음성 파일을 요청 밖에 두자 둘 다 해결됐습니다. 처리량을 기준으로 볼 때는 트레이드오프였던 것이, 유실을 기준으로 보니 구조의 문제였어요.
지금 구조도 지금 규모에 맞춘 답이에요. 워커가 여러 대가 되거나 문항이 초당 수천 건으로 늘면, DB 큐와 폴링은 다시 검토해야 할 거예요.