안녕하세요!
flow가 궁금해 공식문서를 보며 공부하고 정리하는 개발자 꿈나무 김조현입니다. 이번 글에서는 크게 flow가 무엇인지, flow의 종류 중 cold flow는 무엇인지에 대하여 정리해보겠습니다.
이 글은 공식문서를 기준으로 정리 및 학습한 내용입니다.
https://kotlinlang.org/docs/coroutines-flow.html
Flow란?
flow는 비동기적으로 생성될 수 있는 값들의 순차적인 흐름을 나타낸다. suspend 함수를 호출하면 하나의 값만 반환되지만, flow를 사용하면 시간에 따라 여러 순차적인 값을 처리할 수 있다.
flow를 사용하여 데이터를 점진적으로 불러오고, 이벤트 스트림에 반응하며, 구독 스타일 API를 모델링하는 플로우 파이프라인을 만들 수 있다.
Flow의 작업 종류?
flow는 아래의 작업들을 연속적으로 수행한다.
- Emittter : 값을 생성한다.
- Intermediate operators (optional) : flow에서 값을 소비하고, 해당 값에 연산을 적용한 다음, 새로운 flow을 반환한다.
- Collector : flow에서 값을 소비한다.
소비한다 라는 말이 처음에는 와닿지 않닸다. 뭘 없애나? 라는 생각이 들었지만, 소비 라는 것은 사용한다 는 의미다. Emitter에서 생성한 값을 Collector에서 사용 한다는 것이다.
suspend fun main() {
    // The emitter produces values
    flowOf(0x4B, 0x6F, 0x74, 0x6C, 0x69, 0x6E)
        // The intermediate operator consumes values,
        // applies an operation, and returns another flow
        .map { value -> value.toChar() }
        // The collector consumes the transformed values
        .collect { updatedValue ->
            println("Say '$updatedValue'!")
        }
}
/*
Say 'K'!
Say 'o'!
Say 't'!
Say 'l'!
Say 'i'!
Say 'n'!
*/
이 예제를 보면 6개의 코드를 가지고 있는 flow목록이 있다. map이라는 Intermediate operations에서 값을 Char 타입의 새로운 값으로 반환하고, collect라는 Collector에서 값을 소비하여 println으로 출력한다.
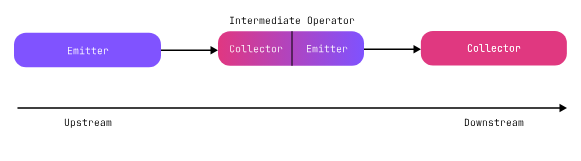
flow의 상태에서 값들은 발산 지점에서 수렴 지점으로, 상류에서 하류로 이동한다. 중간 연산자는 상류 flow를 수집하고, 그 값에 대한 연산을 적용한 후, 새로운 하류 flow 흐름을 반환한다. 이 하류 flow는 다음 수집 지점의 상류 flow가 될 수 있다.
Flow의 종류?
- Cold flows : cold flows 값을 생성하기 시작할 때, 각 collector가 새로운 독립적인 실행을 트리거한다?
- Hot flows : hot flows는 collector와 독립적으로 값을 생성하며, 모든 Collector와 동일한 값의 flow를 공유한다.
내가 이해했을 때 cold flows는 따로 놀고, hot flows는 뭉쳐서 논다? 그런 느낌이다.
Cold flows란?
Cold flows는 느긋하게 진행된다. Collector가 해당 코드를 수집할 때만 Cold flows 빌더의 코드가 실행된다. 새로운 Collector는 새로운 실행을 시작한다.
Cold flow 생성하기
Clod flow를 생성하려면, flow() 빌더 함수를 사용하면 된다. 이 함수의 블록 안에서 emit() 함수를 사용하여 값을 Collector에 전달하면 된다.
fun main() {
    // Creates a flow
    val pageFlow = flow {
        for (page in 1..3) {
            println("Loading page $page...")

            // Emits each page as it is loaded
            emit("Page $page")
        }
    }
    println("Creating a cold flow doesn't run it!")
}

// Creating a cold flow doesn't run it!
이 예시에서 flow() 빌더 함수는 Flow<T> 를 반환하지만, 해당 블록을 실행하지 않는다. Cold flows의 값을 생성하기 위해서는 아래와 같은 함수를 이용하면 된다.
- flowOf() : 제공된 값들을 기반으로 flow를 생성한다.
- .asFlow() : 기존의 반복 가능한 객체(예 : range)를 플로우로 변환한다.
import kotlinx.coroutines.*
import kotlinx.coroutines.flow.*
fun main() {
	// Creates a flow from provided values
	val predefinedPageFlow = flowOf("Page 1", "Page 2", "Page 3")
	// Creates a flow from a range
	val generatedPageFlow = (1..3).asFlow()
}
Cold flow 수집하기
Cold flow를 수집하려면, 상류 flow에서 발생하는 출력을 트리거하는 collect() 함수를 사용한다. collect()에 람다를 전달하면, 각 출력 값을 받게 된다.
suspend fun main() {
    withContext(Dispatchers.Default) {
        val pageFlow = flow {
            for (page in 1..3) {
                println("Loading page $page...")
                emit("Page $page")
            }
        }
        // Collects the flow with a lambda that receives each emitted page
        pageFlow.collect { page ->
            println("Processing $page...")
            delay(100.milliseconds)
            println("Done processing $page.")
        }
    }
}

/*
Loading page 1...
Processing Page 1...
Done processing Page 1.
Loading page 2...
Processing Page 2...
Done processing Page 2.
Loading page 3...
Processing Page 3...
Done processing Page 3.
*/
Q. 어? flow는 값을 보내는거야. collect는 값을 수집하는거야. collect의 수집이 느려진다면.... flow가 보내는 값과, collect가 수집하는 값이 꼬이게 되는 문제가 발생하진 않을까??
순서가 꼬이는 일은 발생하지 않는다. 코틀린 Flow는 기본적으로 Sequential(순차적)이다. Flow 내에서 값을 emit하고 collect하는 과정은 단일 코루틴 내에서 순차적으로 번갈아가면서 실행된다.
- flow 블록에서 emit("Page 1")을 호출한다.
- 이 때 flow 블록은 잠시 멈추고, 제어권을 collect 블록으로 넘긴다.
- collect 블록이 delay(100)을 포함한 모든 처리를 끝마친다.
- 처리가 끝나면 제어권이 다시 flow 블록으로 돌아가서 다음 루프인 emit("Page 2")를 실행한다.
즉, collect 내부의 작업이 완전히 끝나기 전까지는 다음 emit이 절대 호출되지 않기 때문에 순서가 완벽하게 보장된다.
AI가 말해준 내 질문의 포인트가 바로 이거다. "비동기니까 여러 개가 동시에 실행되서 순서가 뒤죽박죽되지 않을까?"
하지만 코루틴에서 비동기라는 것은 "스레드를 멈추지 않고 다른 작업을 할 수 있도록 양보한다"는 의미에 가깝다. 즉, delay(100) 시간이 지나면 다시 돌아와서 하던 작업을 이어서 순서대로 처리하는 것이다.
순서가 꼬이는 것은 동시성 코드를 collect 내부에 주입했을 때 발생할 수 있다.
pageFlow.collect { page ->
	launch { // 👈 매 페이지마다 새로운 코루틴을 생성하여 병렬로 실행! (순서 보장 안 됨)
		println("Processing $page...")
		delay(100)
		println("Done processing $page.")
	}
}
여러 collect가 동일한 Cold flow를 수집한다면?
suspend fun main() {
    val pageFlow = flow {
        // Reads the name of the current coroutine
        val coroutineName = currentCoroutineContext()[CoroutineName]?.name

        println("Starting emissions in $coroutineName")
        for (page in 1..3) {
            println("Loading page $page in $coroutineName")
            emit("Page $page")
        }
        println("Done emitting in $coroutineName")
    }

    withContext(Dispatchers.Default) {
        // Launches a collector that processes each page slowly
        launch(CoroutineName("a slow coroutine")) {
            pageFlow.collect {
                println("Processing $it slowly")
                delay(100.milliseconds)
                println("Done processing $it slowly")
            }
        }

        // Launches a collector that processes each page quickly
        launch(CoroutineName("a fast coroutine")) {
            pageFlow.collect {
                println("Processing $it quickly")
                delay(10.milliseconds)
                println("Done processing $it quickly")
            }
        }
    }
}
이는 flow를 동시성으로 처리하고자 하는 코드다. 이 코드를 보니 궁금한 점이 생겼다. 값을 생성하는 flow는 한 개인데, 어떻게 두 개의 collector가 값을 소비하는 것일까? 하나의 flow의 값이 다른 collector에서 소비된다면, 위 코드 예시로 봤을 때 fast는 1,2,3을 slow보다 빠르게 소비한다.
여기서 든 생각이, "그러면 slow가 소비할 값이 없어진게 아닌가?" 라는 생각이 들었다. 하지만 Cold flow는 하나의 flow에 여러 collect가 접근하는게 아니라, collect마다 각각의 flow를 가지고 소비하는 것이다. 즉, fast가 빠르게 값을 소비하는 것과 slow가 느리게 값을 소비하는 것은 아무런 관련이 없는 것이다.
Intermediate flow operations
Intermediate operators는 상류 flow에 작업을 허용하고, 새로운 하류 flow를 반환한다. 그리고 intermediate operators는 새로운 flow 파이프라인을 조립해 두었을 뿐, 누군가 최종적으로 collect를 호출하기 전까지는 작업을 실행하지 않는다.
또한 상류 flow가 hot flow일지라도, intermediate flow를 거쳐서 나온 새로운 flow는 무조건 cold flow 성질을 가진다.
// A simplified custom implementation of the default .map() operator
fun <T, R> Flow<T>.myMap(transform: suspend (value: T) -> R): Flow<R> = flow {
    // Collects values from the upstream flow
    this@myMap.collect { value ->
        // Transforms each collected value and emits the result
        emit(transform(value))
    }
}

suspend fun main() {
    // Creates a flow, applies the custom map operator, and collects the transformed values
    flowOf(1, 2, 3).myMap { 2 * it }.collect {
        println("Collecting $it")
    }
}

/*
Collecting 2
Collecting 4
Collecting 6
*/
flow 빌더 내에서 suspend fun 호출이 가능하다
순차적인 방식과 달리, flow() 빌더 함수 내에서 일시 중단 기능을 호출할 수 있다.
suspend fun loadPage(): Int {
    delay(100)
    return 3
}

suspend fun main() {
    flow {
        emit(loadPage())
    }.collect {
        println(it)
        // 3
    }
}
그러나, flow() 빌더 함수는 실행되는 동안 동일한 코루틴 컨텍스트에서 값을 반환해야 한다. emit()을 호출하는 다른 코루틴을 시작할 수 없으며, withContext()를 사용하여 코루틴 컨텍스트를 변경할 수 없다.
즉, suspend fun은 호출할 수 있지만, withContext나 launch를 사용해 코루틴 컨텍스트를 변경하는 작업을 하지 못한다는 것이다. emit()은 반드시 collect를 호출한 쪽과 동일한 코루틴 컨텍스트에서 실행되어야 한다는 엄격한 규칙이 있다.
만약에 이런 코드를 작성했다고 해보자.
// ❌ 만약 허용된다면 개발자가 무심코 작성할 법한 코드
val myFlow = flow {
    // "네트워크 작업이니까 IO 스레드로 넘어가자!"
    val result = withContext(Dispatchers.IO) {
        api.fetchData()
    }
    // 그리고 그 백그라운드 스레드에서 곧바로 값을 쏴버림
    emit(result)
}
이는 api 네트워크 요청을 백그라운드 스레드에서 처리하겠다는 의도로 작성한 코드다. 하지만 이 flow를 수집하는 쪽이 UI를 그리는 메인스레드였다면, 수집가의 스레드가 백그라운드 스레드로 끌려가게 되는 문제가 발생하게 된다. 그렇게 되면 안드로이드 UI 크래시가 발생하게 되며, flow의 제어권을 상실하고 예측하기 힘들게 된다.
이 제한은 flow() 빌더 함수에 적용된다. 만약 상류 flow를 다른 코루틴 컨텍스트에서 실행해야 한다면, .flowOn() 연산자를 사용하여 변경할 수 있다. 또는 channelFlow()를 사용하여 여러 코루틴에서 값을 출력할 수 있다.
.flowOn()을 사용하여 코루틴 컨텍스트를 변경하기
기본적으로 collector와 동일한 코루틴 컨텍스트에서 cold flow가 실행된다. 다른 코루틴 컨텍스트에서 실행하려면 .flowOn() 연산자를 사용하라. 이 연산자는 상위 flow의 코루틴 컨텍스트만 변경하고, 하위 흐름은 collector의 컨텍스트를 유지한다.
suspend fun main() {
    withContext(Dispatchers.Default + CoroutineName("downstream")) {
        flow {
            val coroutineName = currentCoroutineContext()[CoroutineName]?.name

            // Emits in the coroutine context applied with .flowOn()
            println("Emitting '1' in $coroutineName")
            // Emitting '1' in upstream
            emit(1)

        // Changes the coroutine context of the upstream flow
        }.flowOn(Dispatchers.IO + CoroutineName("upstream"))
            .collect {
            val coroutineName = currentCoroutineContext()[CoroutineName]?.name

            // Collects in the caller's coroutine context
            println("Collecting '$it' in $coroutineName")
            // Collecting '1' in downstream
        }
    }
}

/*
Emitting '1' in upstream
Collecting '1' in downstream
*/
즉, 전체적인 코루틴 컨텍스트의 이름은 downstream인데, flow를 생성하는 빌더함수를 실행할 때 .flowOn()을 연결함으로써 코루틴 컨텍스트를 생성할 때만 바꿀 수 있는 것이다. 그렇기에 하류 flow의 코루틴 컨텍스트는 바뀌지 않는 것이다.
flow에서 예외 처리하기
emitter와 collector 모두 예외 상황을 발생시킬 수 있다. flow 수집 중에 예외를 처리하지 않으면, 해당 오류는 collector에서 시작하여 호출하는 collect() 함수의 호출자에게 전달된다.
suspend fun main() {
    val myFlow = flow {
        try {
            // The emit() function calls the lambda passed to collect()
            emit('a')
        } catch (e: MyFlowException) {
            println("Collector threw $e")

            // Rethrows the downstream exception
            throw e
        }
    }
    // Wraps flow collection in try-catch
    try {
        myFlow.collect {
            // Throws an exception from the collect() lambda
            throw MyFlowException("Can't process '$it'!")
        }
    } catch (e: MyFlowException) {
        println("Flow collection failed with $e")
        // Rethrows the exception to the caller
        throw e
    }
}
collector는 emit() 함수로부터 값을 받을 때 예외를 발생시킨다. flow() 빌더 함수는 이 후의 예외를 처리한다.
flow 빌더 함수 내에서 collector가 던진 예외를 잡았을 때, 해당 예외를 다시 던져라. 이렇게 하면 예외의 투명성을 유지하고, collect()가 예외를 처리할 수 있도록 한다.
.catch() 연산자를 사용하여 상류 예외 처리하기
수집 전에 예외 상황을 처리하려면 .catch() 연산자를 사용하라. .catch() 연산자를 사용하면 상류 흐름에서 발생하는 예외를 처리할 수 있다. 예를 들어, emit() 함수를 사용하여 하류 흐름에 대체 값을 전달할 수 있다.
suspend fun main() {
	flow {
		emit("a")
		emit("b")

		throw UnsupportedOperationException(
			"I am tired of listing letters"
		)
	}.catch { upstreamException ->
		println("Upstream completed with $upstreamException!")

        // Emits a fallback value downstream
        emit("Upstream terminated with an exception!")
    }.collect {
        println("Got '$it'")
    }
}
/*
Got 'a'
Got 'b'
Upstream completed with java.lang.UnsupportedOperationException: I am tired of listing letters!
Got 'Upstream terminated with an exception!'
*/
이 예시에서, 상류 flow는 예외를 발생시키기 전에 값을 출력한다. .catch() 연산자는 예외를 처리하고, "Upstream terminated with an exception!"을 대체 값으로 출력한다.
Q. 예외를 안정적으로 수집할 수 있다면, 예외 아래에서 던지는 값을 다시 받을 수 있을까?
suspend fun main() {
    flow {
        emit("a")
        emit("b")

        throw UnsupportedOperationException(
            "I am tired of listing letters"
        )

        emit("c")
    }.catch { upstreamException ->
        println("Upstream completed with $upstreamException!")

        // Emits a fallback value downstream
        emit("Upstream terminated with an exception!")
    }.collect {
        println("Got '$it'")
    }
}
예외를 던진 후에도 수집을 이어서할까? 라는 궁금증이 생겨서 직접 실험해봤다. IntelliJ에서는 애초에 빌드해보기 전에 경고를 띄운다. 지우라고. 그래도 직접 실행해봤을 때 "Got 'c'"라는 텍스트가 출력되지 않는 것을 확인했다. 예외를 던진 후에는 flow 수집도 멈추는 것 같다.
catch 안에서 예외 발생시키기
일반적인 작동 중 예외 상황이 발생할 것으로 예상되는 경우, .catch()에서 복구 가능한 예외를 처리하고, 예상치 못한 예외는 다시 발생시켜야 한다.
sealed interface LoadingState {
    sealed interface Terminal: LoadingState
    object Started: LoadingState
    data class Percentage(val percents: Int): LoadingState
    object Failed: Terminal
    object Done: Terminal
}

fun loadBlob(url: String) = flow {
    emit(LoadingState.Started)

    val failureChancePerStep = 1 - java.lang.Math.pow(0.99, 10.0)

    repeat(10) { step ->
        if (Random.nextDouble() < failureChancePerStep)
            throw IOException("Failed to load!")
        emit(LoadingState.Percentage((step + 1) * 10))
        delay(10.milliseconds)
    }
    emit(LoadingState.Done)
}.catch { e ->
    println("Loading data failed with $e")
    if (e is IOException) {
        // Handles an expected exception
        emit(LoadingState.Failed)
    } else {
        // Rethrows unexpected exceptions, so the collect() fails with them
        throw e
    }
}

suspend fun main() {
    loadBlob("https://example.com/").collect {
        println("Got '$it'")
    }
}
위 예시에서는 .catch() 연산자는 emit() 함수를 사용하여 대체 상태를 반환한다. 예상치 못한 오류의 경우, .catch() 연산자를 통해 다시 발생시킨다. 이를 통해 collect() 함수를 호출하는 쪽은 흐름이 처리하지 않는 예외를 받을 수 있다.
.catch() 연산자는 collector에서 발생하는 예외를 처리하지 않는다. collect() 에 전달된 람다가 예외를 발생시킨 경우, try-catch 블록을 사용하여 collect() 함수를 처리해야 한다.
collect()가 .catch() 이후에 실행되므로, .catch() 를 사용해서 flow가 전달하는 값을 예외처리할 수 없다. .catch() 를 사용하여 각 값에 대해 실행되는 코드의 예외 처리를 하려면, .catch() 앞에 .onEach() 를 배치하면 된다.
.onEach() 연산자 사용하기
.onEach() 연산자는 각 값의 처리가 완료될 떄마다 람다 함수를 실행한다. 만약 .catch() 에서 .onEach() 로부터 예외가 발생하면, 해당 흐름은 완료되고 다음 값을 출력하지 않는다.
suspend fun main() {
    flowOf('a', 'o', '5', 'c')
        // Runs before each value is emitted downstream
        .onEach {
            require(!it.isDigit()) { "Digits are not allowed!" }
            println("Got '$it'")
        }
        .catch { e ->
            println("Caught an exception: $e")
        }
        .collect()
}
/*
Got 'a'
Got 'o'
Caught an exception: java.lang.IllegalArgumentException: Digits are not allowed!
*/
이 예시에서 .onEach() 연산자는 .catch() 이전에 실행되므로, flowOf()에서 전달하는 값의 예외처리를 .catch() 가 수행할 수 있게 된다.
.collect() 안에서 try-catch를 사용하면 되지 않나?
suspend fun main() {
	try {
		flowOf('a', 'o', '5', 'c')
	        .collect {
		        require(!it.isDigit()) { "Digits are not allowed!" }
				println("Got '$it'")
			}
	} catch (e: Exception) {
		println("Caught an exception: $e")
	}
}
이런 식으로도 할 수 있지 않나? 라는 생각이 들었다. 굳이 onEach()를 붙이고, catch()를 이용해야 하는걸까?
이 코드가 틀린 것은 아니다. 이런 식으로 try-catch 방식은 하나의 함수 안에서 flow의 생성과 소비까지 한 번에 이루어질 때 직관적이라는 장점이 있다.
굳이 onEach() + catch()를 사용하는 목적은 다음과 같다.
-
관심사의 분리 : 만약 Repository 에서 Flow를 만들어서 ViewModel로 전달한다고 가정할 떄, Repository 안에서 catch를 붙여 네트워크 에러를 캐시 데이터로 대체하는 등의 처리를 할 수 있다. try-catch는 최종적으로 데이터를 소비하는 collect 단계에서만 에러를 잡을 수 있지만, catch 연산자를 사용하면 스트림 중간 어디서든 에러를 조작할 수 있다.
-
안드로이드 아키텍처 패턴 : 안드로이드 UI나 ViewModel에서는 코드를 깔끔하게 체이닝하기 위해 collect 대신 .launchIn(scope)를 자주 사용한다. 이 때는 collect 블록 자체가 없으므로, 데이터 소비 로직을 onEach에 넣고 에러를 catch로 잡는 구조가 강제된다.
라고 한다. 사실 내가 flow를 직접 활용해본 적이 없어 이 두 가지의 장점이 와닿지가 않는다. 하지만 한 함수 내에서 flow의 생성과 소비가 모두 이뤄질 경우 try-catch로 감싸고, 그게 아니라면 책임 분리를 위해 onEach + catch를 사용해야 한다는 기준을 잡고 활용해보면 될 것 같다는 생각이 들었다.
예외 발생 후, 상류 flow 재시작
일부 작업은 일시적으로 실패할 수 있다. 예를 들어, 연결이 끊어진 네트워크 요청의 경우, 예외 발생 후 .retry() 연산자를 사용하여 상류 흐름을 재시작할 수 있다.
.retry() 연산자가 예외를 발생시키고, 지정된 횟수만큼 재시도하여 수집을 다시 시도한다. 예를 들어 .retry(3) 은 첫 번째 실패 시도 이후 최대 3번까지 상류 flow를 재시도 한다.
더 정확한 재시도 로직 제어를 위해서는
retryWhen()연산자를 사용하라..retry()와 마찬가지로, 예외를 받지만 현재 시도 번호도 받으며, 재시도 전에 값을 출력할 수 있다.
sealed interface LoadingState {
    sealed interface Terminal: LoadingState
    object Started: LoadingState
    data class Percentage(val percents: Int): LoadingState
    object Failed: Terminal
    object Done: Terminal
}

fun loadBlob(url: String) = flow {
    emit(LoadingState.Started)

    val failureChancePerStep = 1 - java.lang.Math.pow(0.99, 10.0)

    repeat(10) { step ->
        if (Random.nextDouble() < failureChancePerStep)
            throw IOException("Failed to load!")
        emit(LoadingState.Percentage((step + 1) * 10))
        delay(10.milliseconds)
    }
    emit(LoadingState.Done)
}.retry(3) { e ->
    if (e is IOException) {
        // This is an expected error
        // Waits for one second before retrying
        delay(1.seconds)
        true
    } else {
        // Stops retrying and rethrows unexpected exceptions
        false
    }
}

suspend fun main() {
    loadBlob("https://example.org/").collect {
        println("Got $it")
    }
}
retry() 연산자의 람다 블록의 반환 값은 Boolean이다. 그렇기에 retry()를 통해 재시도를 하기 위해서는 Boolean을 반환해줘야 한다. 위의 예시도 IOException을 던질 때는 재시도를 위해 true를 반환하고, 그 외에는 false를 반환하는 것을 볼 수 있다.
Flow 취소
Flow 수집은 결과가 더 이상 필요하지 않을 떄 수집을 중단한다. 예를 들어 요청 시간이 만료될 때 등이 있다.
Flow 수집은 collect() 함수를 호출하는 코루틴과 연결되어 있다. 해당 코루틴이 취소되면, 컬렉션도 중단되고, 상류 flow도 취소된다.
flow 수집을 취소하려면, 수집 코루틴의 Job에서 cancel() 함수를 호출하라.
val myFlow = flow {
	var i = 0
	try {
		while (true) {
			println("Emitting $i")
			emit(i)
			println("Emitted $i")
			++i
			delay(10.milliseconds)
		}
	} catch (e: Throwable) {
		println("Upstream finished with $e")
		throw e
	}
}

suspend fun main() {
	coroutineScope {
		val job = launch {
			try {
				myFlow.collect {
					println("Processing $it")
					delay(5.milliseconds)
				}
			} catch (e: Throwable) {
				println("Collection finished with $e")
				throw e
			}
		}
		delay(100.milliseconds)

		job.cancel()
	}
}
Collector가 활성 상태인 동안 CancellationException을 보냄으로써 상류 flow를 취소할 수 있다.
.take() 연산자는 위와 같은 동작을 사용하여 고정된 값만큼 수집을 한 후 중단한다. 예를 들어 .take(3) 는 상류 flow에서 처음 세 개의 값만 수집한 다음, 이를 중단한다.
.take() 연산의 단순화된 예시는 다음과 같다.
fun <T> Flow<T>.myTake(count: Int): Flow<T> = flow {
	require(count > 0)
	val cancellationException = CancellationException()
	var elementsRemaining = count
	try {
		this@myTake.collect {
			emit(it)
			--elementsRemaining
			if (elementsRemaining == 0) {
				throw cancellationException
			}
		}
	} catch (e: Throwable) {
		// 상류 flow의 실행을 취소하기 위해 던져진 CancellationException을
		// 에러가 나타나지 않도록 잡아내어 처리한다.
		// 결과적으로 .myTake() 연산자에 설정된 지정된 개수만큼의 값을 모두 받고 나면,
		// flow를 정상적으로 완료시킨다.
	} else {
		// 예상치 못한 예외는 다시 던진다.
		throw e
	}
}

suspend fun main() {
	(0..1000).asFlow().myTake(3).collect {
		println("Got $it")
	}
}
이 예시에서 .myTake() 함수는 요청된 모든 값이 출력될 때까지 상류 flow에서 값을 출력한다. 그 후에, CancellationException을 사용하여 상류 flow를 중단한다.
channelFlow()와 동시에 값을 출력하기
flow() 빌더 함수는 단일 코루틴에서 값을 방출하는 흐름에 간단하고 효율적이다. 여러 코루틴에서 값을 동시에 하나의 flow로 방출하려면 channelFlow() 빌더 함수를 사용하라. 예를 들어 여러 소스에서 데이터를 로드하는 것과 같이, 결과를 점진적으로 보고하는 동시 작업에 사용할 수 있다.
channelFlow() 빌더 함수는 채널을 사용하여 여러 코루틴에서 값을 전달하는 cold flow를 생성한다. 빌더 내에서 send() 함수를 사용하여 값을 생성한다.
fun <T> Flow<T>.myMerge(other: Flow<T>): Flow<T> = channelFlow {
	launch {
		this@myMerge.collect {
			send(it)
		}
	}
	launch {
		other.collect {
			send(it)
		}
	}
}

suspend fun main() {
    val flow1 = (0..3).asFlow().onEach { delay(20.milliseconds) }
    val flow2 = (6..9).asFlow().onEach { delay(50.milliseconds) }
    flow1.myMerge(flow2).collect { println(it) }
}
channelFlow() 빌더 함수는 버퍼 채널을 사용하므로, 생산자는 수집자가 채우기 전에 값을 보낼 수 있다. 기본적으로, 버퍼는 최대 64개의 값을 저장할 수 있다. 버퍼가 가득 차면, 생산자는 공간이 비워질 때까지 대기한다.
.buffer() 연산자를 사용하여 버퍼 용량을 변경할 수 있다. 예를 들어 .buffer(12) 는 생산자가 수집 전에 최대 12개의 값을 보내도록 허용하고, .buffer(0) 은 버퍼를 제거하여 수집 가능한 값만 전송하도록 한다.
suspend fun main() {
	val oneHundredNumbers = channelFlow {
		repeat(100) {
			println("Sending $it")
			send(it)
		}
	}

	oneHaundredNumbers.collect {
		println("Processing $it")
		delay(10.milliseconds)
	}

	oneHaundredNumbers.buffer(0).collect {
		println("Processing $it")
		delay(10.milliseconds)
	}
}
이 예시에서, oneHaundredNumbers flow는 기본 버퍼 용량을 사용하지만, oneHaundredNumbers.buffer(0) flow에는 버퍼가 없다.
기본 버퍼 용량을 사용하면, 생산자는 버퍼가 가득찰 때까지 빠르게 값을 전송한다. 이후 send() 는 버퍼에 여유 공간이 생길 때까지 대기하며, Sending 과 Processing 메시지가 번갈아 전송되기 시작한다.
.buffer(0) 를 사용하면, 각 send() 호출은 수집자가 값을 받을 때까지 대기한다. 따라서 Sending과 Processing 는 시작부터 번갈아 처리된다. 즉, .buffer(0) 은 주고 받고를 순서대로 진행하는 것이다.
마무리하며
이렇게 cold flow에 대해 정리해봤다. 사실 이런 개념은 직접 써보면서 익혀야 더 잘 이해가 되지만, 어떤식으로 flow를 사용해야 할지 아직은 감이 잘 안오는거 같다. 나중에 cold flow를 쓰게 된다면, 어떤 식으로 사용하는지, 왜 필요한지 등에 대한 내용도 추가하면 좋다고 생각한다.
다음 글에서는 hot flow에 대해 정리해보는 글로 돌아오겠습니다.
읽어주셔서 감사합니다 🙇